


Meilleurs outils LLMOps et comparaison avec le MLOps

Les plateformes LLMOps gèrent l'aspect opérationnel de l'exécution des grands modèles de langage : déploiement, surveillance, évaluation et gestion des coûts.
Nous avons examiné les principaux outils LLMOps, leurs fonctionnalités clés, leurs modèles de tarification et leurs différences afin d'aider à identifier la solution la mieux adaptée à différents cas d'utilisation.
Comparaison des outils LLMOps
Outil | Évaluation | Suivi des coûts | Fine-tuning | Ingénierie des prompts | Construction de pipelines | BLEU / ROUGE | Stockage et versionnage des données |
|---|---|---|---|---|---|---|---|
✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
MLflow | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
Lamini AI | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✕ |
TrueFoundry | ✓ | ✓ | ✓ | ✕ | ✓ | ✓ | ✕ |
Deepset AI | ✕ | ✕ | ✓ | ✓ | ✓ | ✕ | ✓ |
Nemo by NVIDIA | ✓ | ✕ | ✓ | ✓ | ✕ | ✓ | ✕ |
Fine-Tuner AI | ✓ | ✕ | ✓ | ✓ | ✕ | ✕ | ✓ |
ZenML | ✓ | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ |
Snorkel AI | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ | ✓ |
Comet | ✓ | ✓ | ✕ | ✕ | ✕ | ✓ | ✕ |
Une description de chaque critère est fournie ci-dessous :
- Évaluation : Certains outils LLMOps intègrent des fonctionnalités intégrées pour évaluer les sorties des modèles par rapport à des critères spécifiques à la tâche, tandis que d'autres s'appuient sur des frameworks externes pour une analyse plus personnalisée ou approfondie.
- Suivi des coûts : L'analyse détaillée des coûts et la surveillance des ressources utilisées pendant l'entraînement et l'inférence sont directement prises en charge par les outils ou réalisées via des intégrations.
- Fine-tuning : Certains outils LLMOps réalisent eux-mêmes le fine-tuning des grands modèles de langage, tandis que d'autres se concentrent sur la gestion ou l'orchestration du processus de fine-tuning.
- Ingénierie des prompts : La conception et l'optimisation des prompts sont directement prises en charge par certains outils, mais la plupart fournissent une infrastructure pour les soutenir plutôt que de les réaliser eux-mêmes.
- Construction de pipelines : Certains outils automatisent les workflows LLM de bout en bout, y compris la préparation des données, l'entraînement et l'évaluation. D'autres permettent quant à eux de construire des pipelines via des intégrations.
- BLEU / ROUGE : BLEU et ROUGE sont des métriques d'évaluation linguistique courantes utilisées pour évaluer la qualité du texte ; certains outils les prennent en charge nativement, tandis que d'autres s'appuient sur des bibliothèques externes.
- Stockage et versionnage des données : Le stockage sécurisé et le suivi des versions des données d'entraînement sont directement pris en charge par certains outils, tandis que d'autres s'intègrent à des solutions de stockage/versionnage tierces.
Que sont les plateformes LLMOps ?
Les plateformes LLMOps soutiennent le cycle de vie des LLM en permettant :
- Fine-tuning
- Versionnage
- Déploiement
- Surveillance
- Gestion des prompts et des expériences
Les plateformes LLMOps varient dans leur approche :
- No-code/plateformes low-code : faciles à utiliser mais moins flexibles.
- Code-first/Plateformes orientées ingénierie : nécessitent des compétences techniques mais offrent une plus grande personnalisation.
Les outils LLMOps peuvent être regroupés en trois catégories principales :
1. Plateformes MLOps s'étendant au LLMOps
Certaines plateformes de Machine Learning Operations (MLOps) incluent des boîtes à outils spécialisées conçues pour les opérations de grands modèles de langage (LLMOps).
Le MLOps est la discipline axée sur l'orchestration du cycle de vie complet du machine learning, du développement jusqu'au déploiement et à la maintenance. Étant donné que les LLM sont également des modèles de machine learning, les fournisseurs MLOps étendent naturellement leurs activités à ce domaine.
CoreWeave Forge
CoreWeave Forge, anciennement Weights & Biases, est une plateforme MLOps qui s'est étendue au LLMOps via W&B Weave. Initialement axée sur le suivi d'expériences et la surveillance des modèles pour le ML traditionnel, la plateforme a ajouté des capacités LLM à mesure que ces modèles sont devenus centraux dans le développement de l'IA.
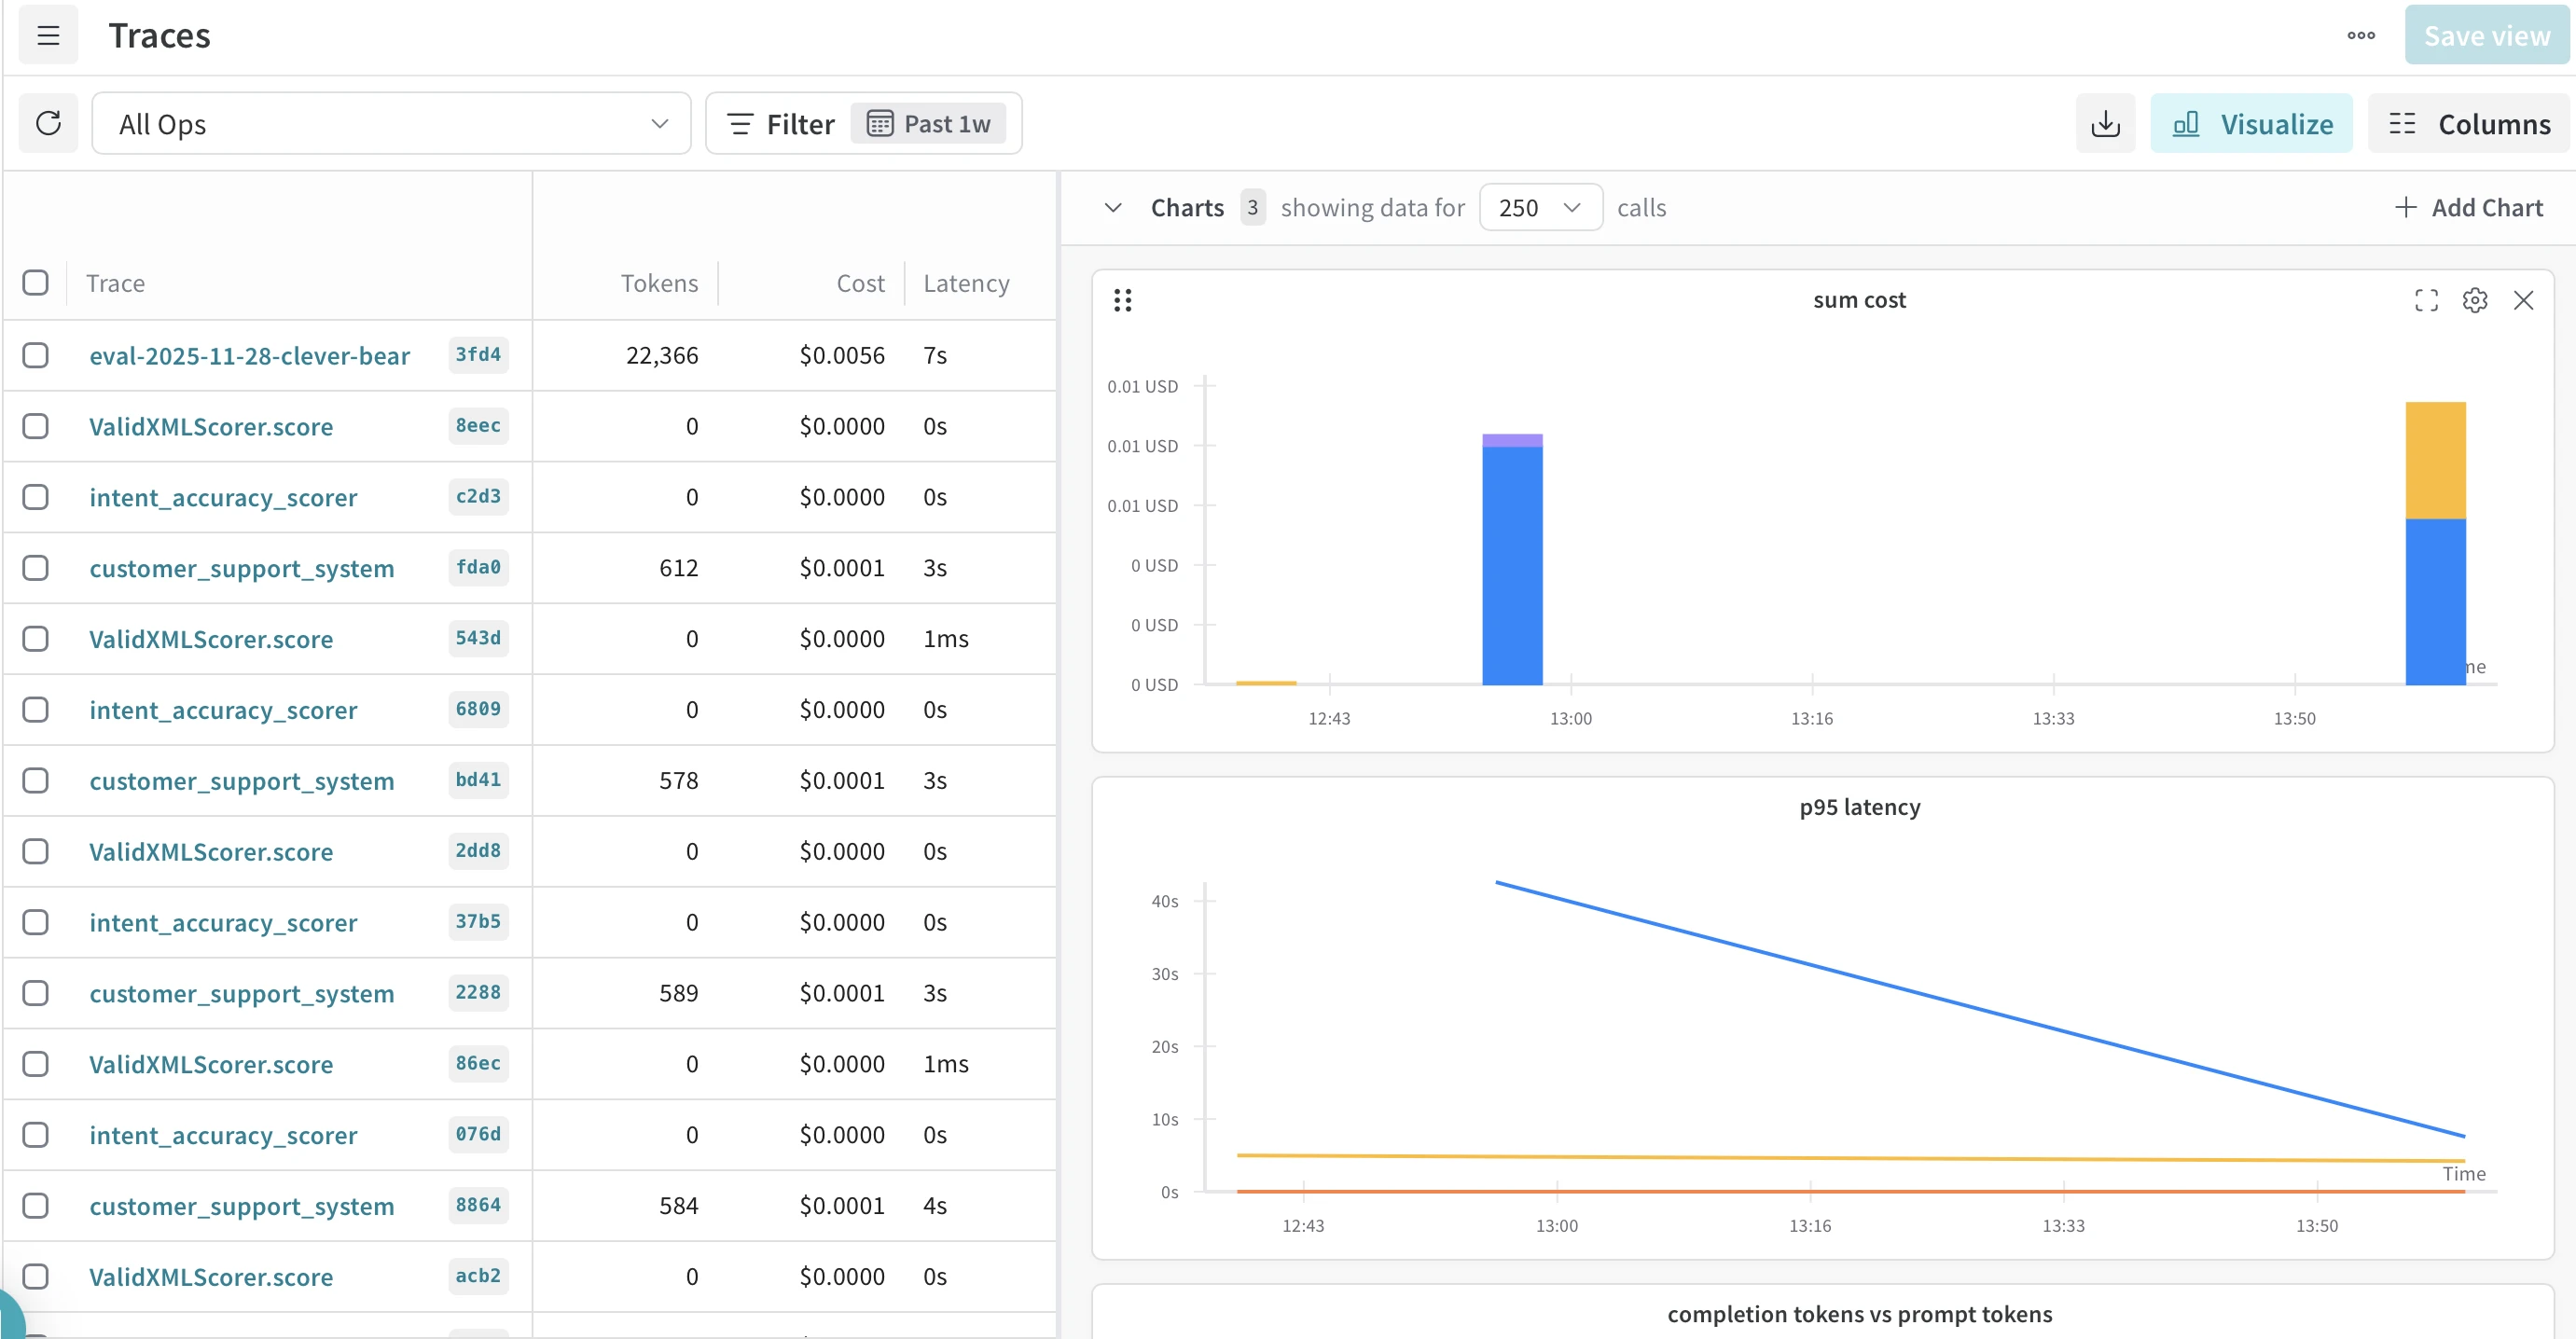
W&B Weave fournit une observabilité des LLM avec traçage automatique, versionnage des prompts, frameworks d'évaluation avec des scoreurs intégrés et visualisation de workflows multi-agents. La plateforme suit les coûts et la latence à des niveaux individuels et agrégés, aidant les équipes à identifier les requêtes coûteuses et les goulets d'étranglement de performance. Pour les pipelines complexes impliquant plusieurs agents ou appels d'outils, W&B Weave crée des arbres de traces imbriqués montrant le flux d'exécution complet, permettant le débogage des workflows multi-étapes et l'optimisation de chaque composant.
CoreWeave Forge permet aux équipes d'utiliser la même plateforme pour le fine-tuning des LLM (W&B Models), le versionnage des données et des modèles (CoreWeave Registry) et la surveillance des applications en production (W&B Weave).
Figure 1 : tableau de bord des traces W&B Weave.
MLflow
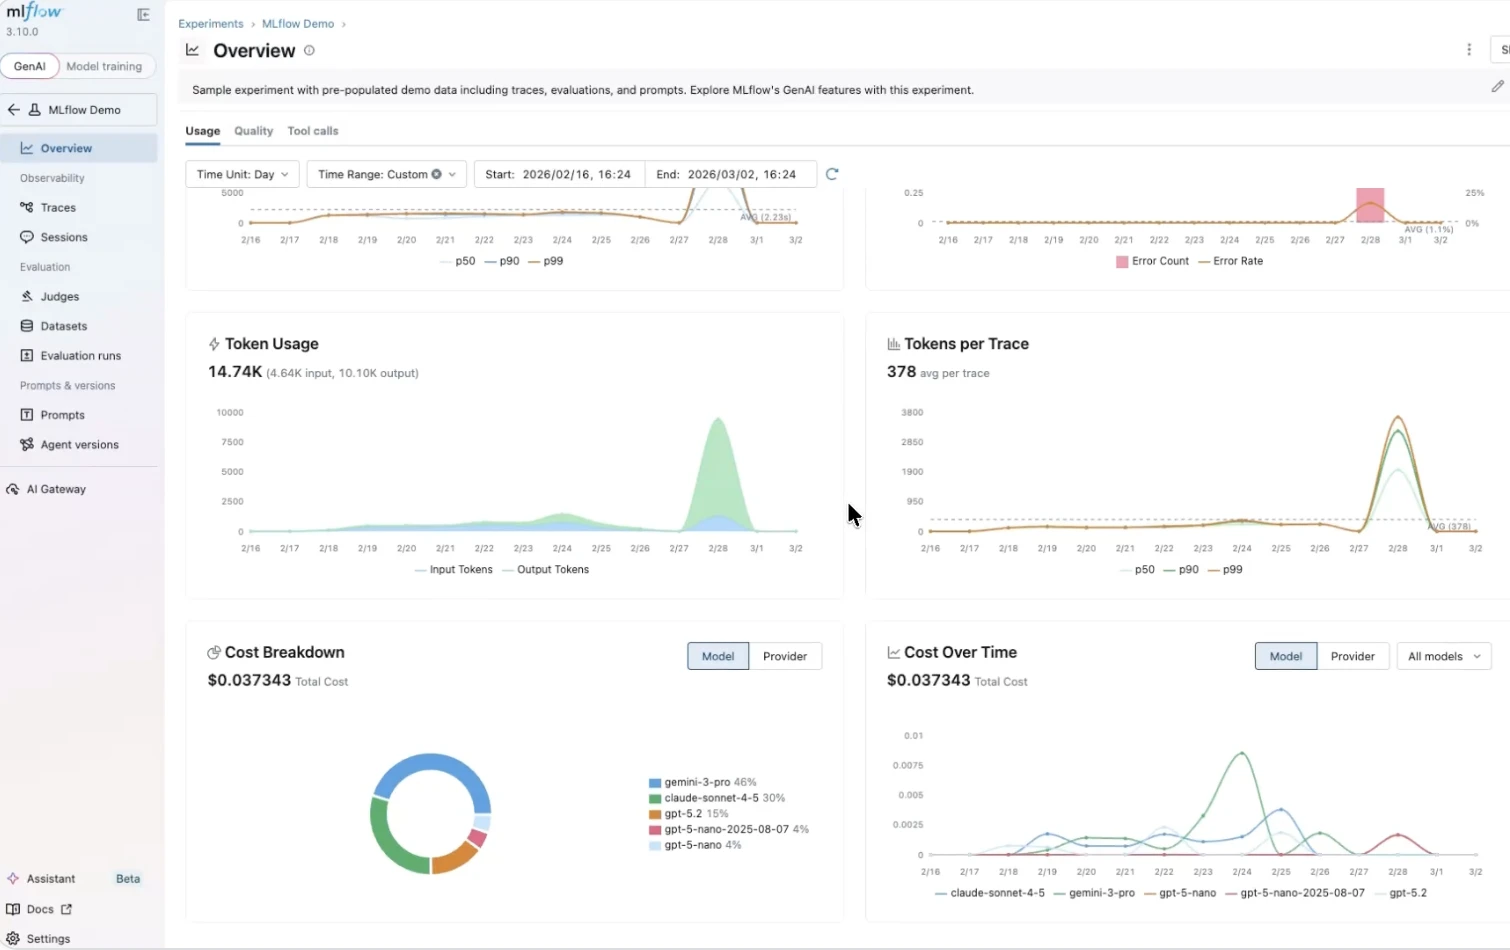
MLflow est une plateforme open source pour la gestion du cycle de vie des LLM et des agents. Les principales capacités LLMOps incluent :
- Traçage : capture les prompts, les récupérations et les appels d'outils dans les workflows d'agents
- Évaluation : notation LLM-as-a-judge avec des métriques prédéfinies pour l'hallucination et la pertinence
- Gestion des prompts : versionnage, optimisation et suivi de la traçabilité
- IA Gateway : accès centralisé aux modèles et contrôle des coûts
MLflow est compatible avec OpenTelemetry et s'intègre aux principaux fournisseurs de LLM et frameworks d'agents.
1Comet
Comet est une plateforme de suivi d'expériences et d'observabilité des modèles. Elle prend également en charge le suivi d'expériences LLM, le versionnage des prompts et l'évaluation des LLM, ce qui la rend adaptée aux équipes qui construisent et optimisent des applications LLM.
Valohai
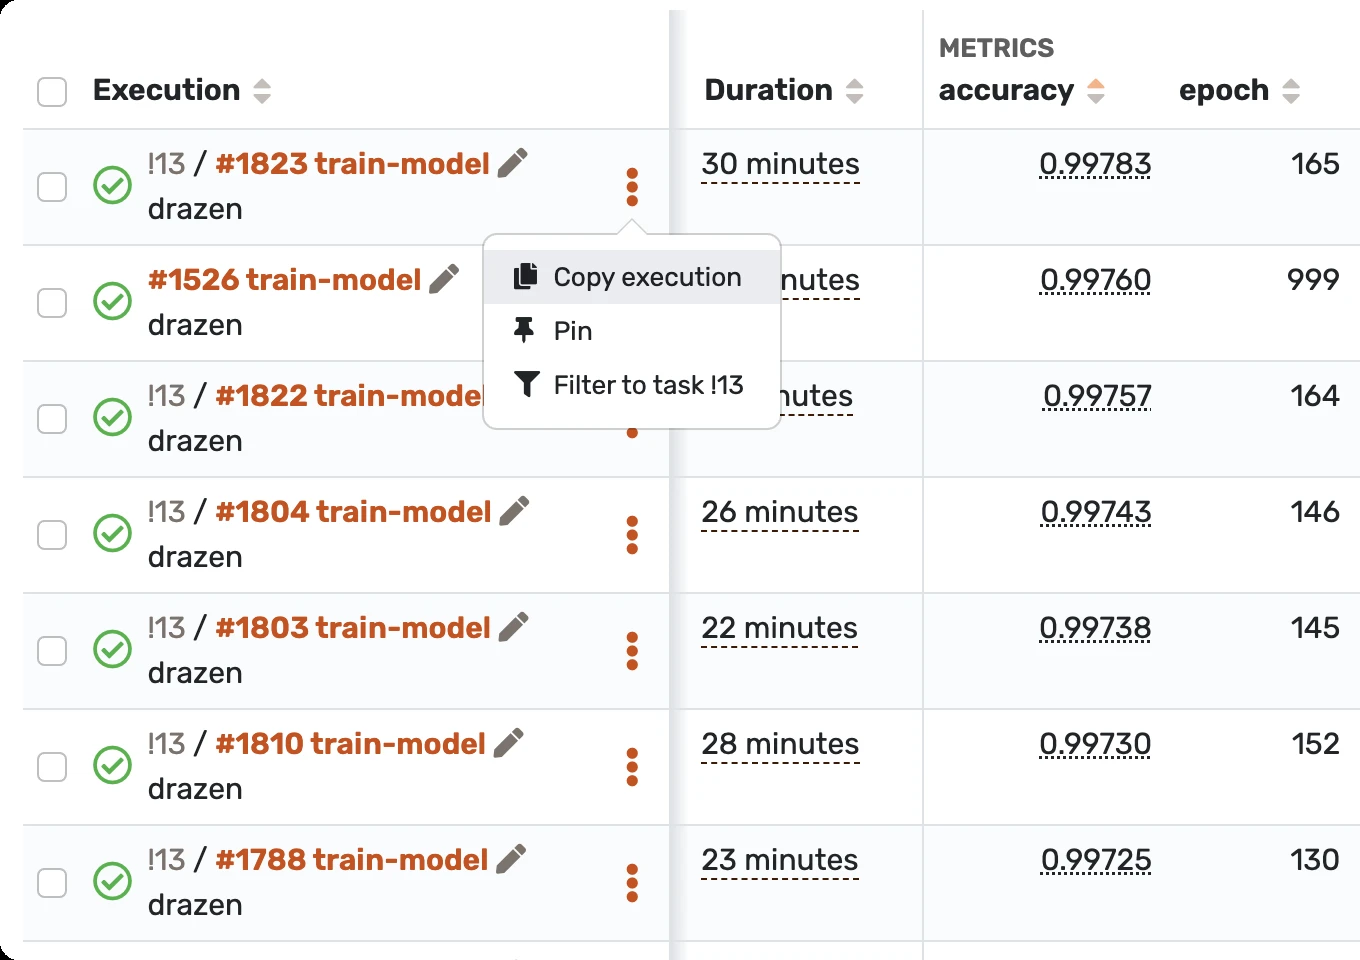
Valohai est une plateforme MLOps qui prend en charge des pipelines reproductibles pour le traitement des données, l'entraînement et le déploiement. Elle a récemment ajouté des capacités adaptées au LLMOps telles que le suivi des métadonnées, le versionnage des artefacts et l'orchestration d'entraînements à grande échelle.
Figure 2 : référentiel de connaissances Valohai.2
TrueFoundry
TrueFoundry est une plateforme ML/LLM de bout en bout qui simplifie le déploiement, le fine-tuning et la surveillance des modèles. Elle offre une infrastructure optimisée pour GPU, un registre de modèles, la gestion des prompts et une gouvernance de niveau entreprise.
Zen ML
ZenML fournit un framework de pipelines prêt pour la production pour le MLOps et le LLMOps. Il permet aux utilisateurs de construire des pipelines reproductibles, de connecter des orchestrateurs (Airflow, Kubeflow) et d'intégrer des workflows LLM tels que le RAG, le fine-tuning et l'évaluation.
2. Plateformes de données, cloud et infrastructure offrant du LLMOps
Les plateformes de données, cloud et infrastructure proposent de plus en plus de capacités LLMOps permettant aux utilisateurs d'exploiter leurs propres données pour construire et fine-tuner des LLM.
Par exemple, Databricks fournit l'entraînement, le fine-tuning de LLM et l'hébergement de modèles (étendu après l'acquisition de MosaicML).
Les leaders du cloud Amazon, Azure et Google ont tous lancé leur offre LLMOps, qui permet aux utilisateurs de déployer des modèles de différents fournisseurs.
3. Frameworks et plateformes axés sur les LLM
Cette catégorie comprend des outils qui se concentrent exclusivement sur l'optimisation et la gestion des opérations LLM. Voici une répartition des outils et de leurs principales fonctions LLMOps :
DeepLake
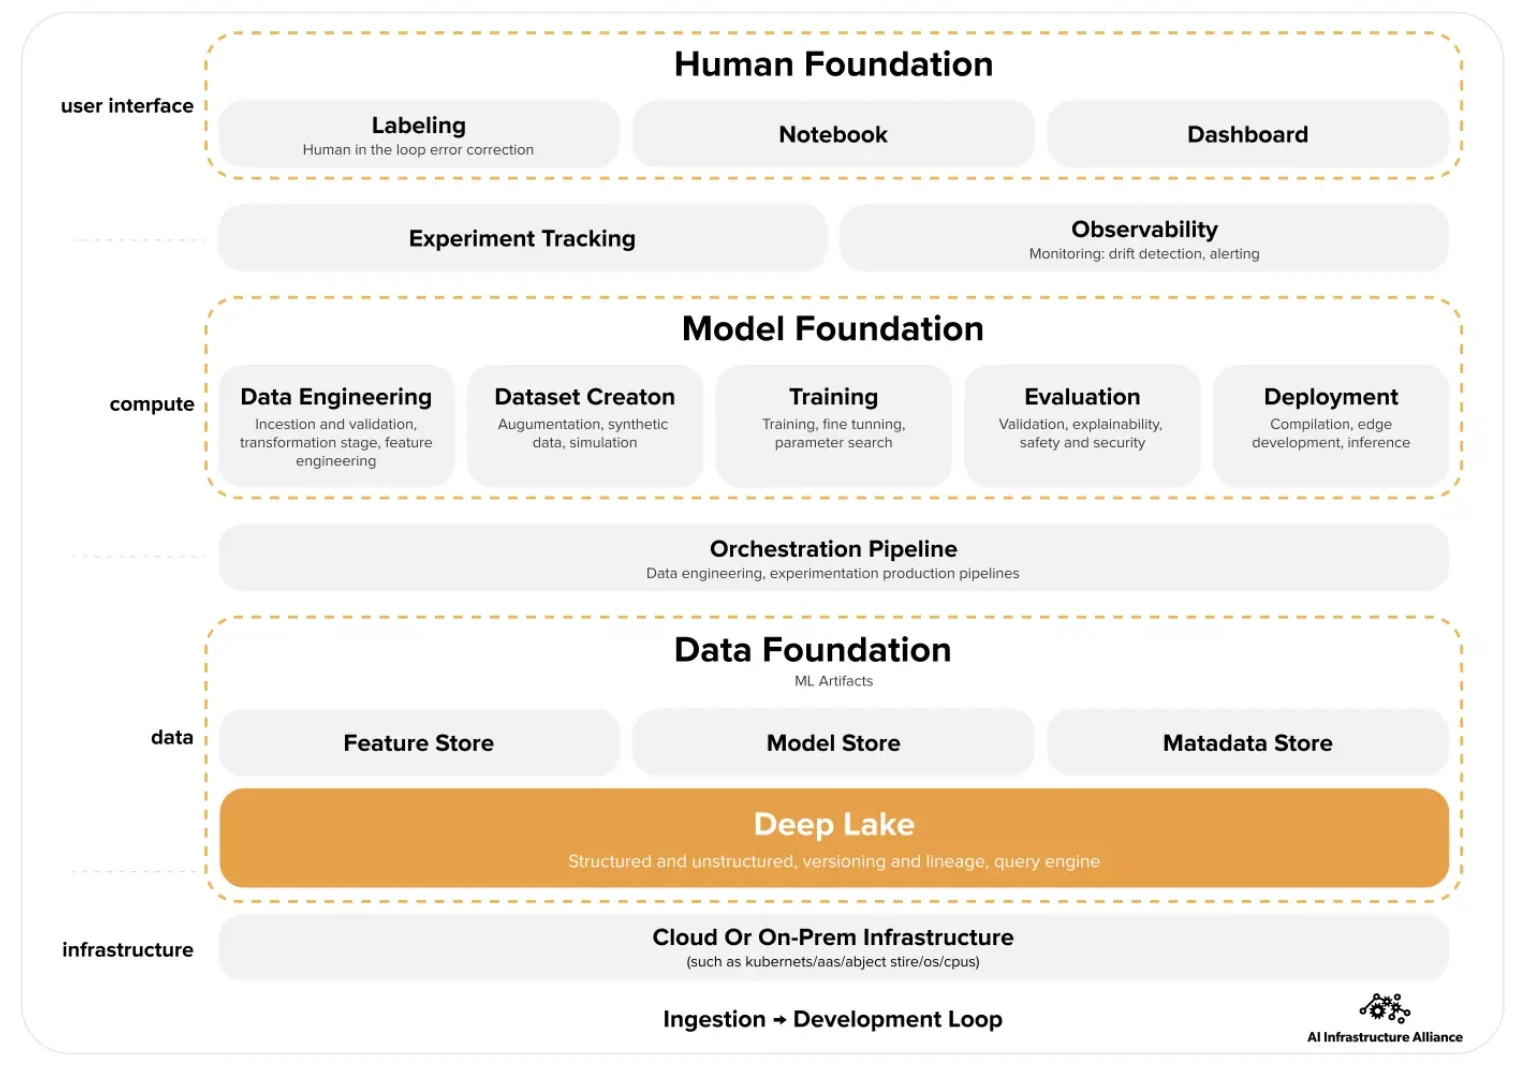
Deep Lake fournit un lac de données conçu pour l'IA, offrant stockage, versionnage et base de données vectorielle. Il prend en charge les workflows de création, d'inspection et de récupération de datasets LLM, en travaillant de manière fluide avec PyTorch et TensorFlow.
Figure 3 : l'image montre le rôle de Deep Lake dans une architecture MLOps3
Deepset AI
Haystack de Deepset est un framework de RAG et de recherche qui permet aux entreprises de créer des applications basées sur des LLM en combinant des magasins de documents, des récupérateurs et de grands modèles de langage. Il prend en charge des pipelines RAG multimodaux, l'évaluation de modèles et le déploiement en production.
Lamini AI
Lamini offre une plateforme pour construire des LLM personnalisés, prenant en charge à la fois le fine-tuning complet et l'ajustement léger. Elle est conçue pour les entreprises ayant besoin de LLM spécifiques à un domaine et fournit des API et des SDK pour intégrer les données organisationnelles.
Nemo by NVIDIA
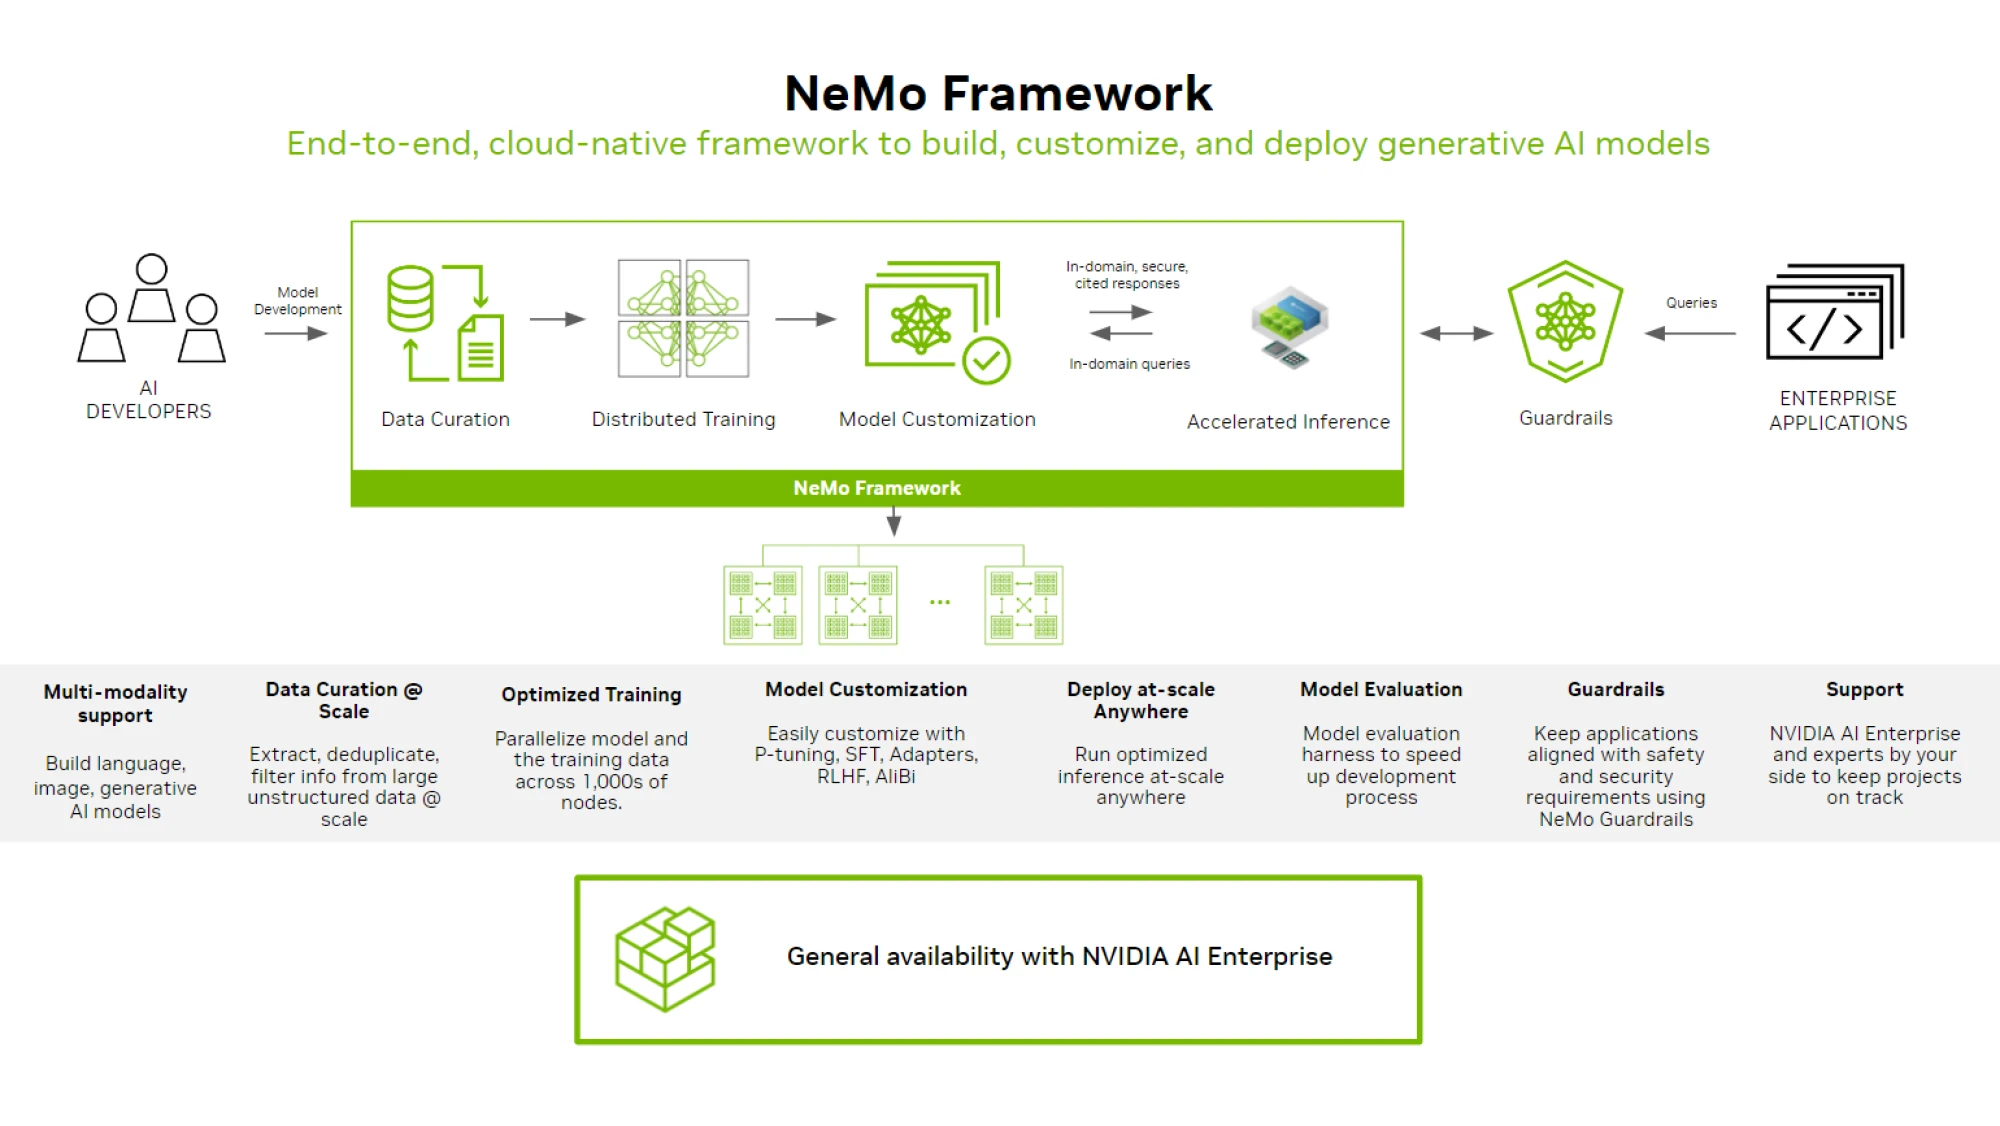
NeMo est un framework pour la construction, l'entraînement et la personnalisation de modèles de base, y compris les LLM. Il fournit des composants pour le fine-tuning supervisé, l'ajustement d'instructions, le RAG, l'évaluation de modèles et le déploiement sur NVIDIA GPU.
Figure 4 : architecture du framework NeMo.4
Snorkel AI
Snorkel AI fournit une plateforme de développement centrée sur les données pour l'étiquetage et la curation programmatiques des données d'entraînement. Elle s'étend désormais à la personnalisation de modèles de base, permettant aux organisations d'adapter des LLM avec des datasets étiquetés automatiquement de haute qualité.
Titan ML
TitanML se concentre sur l'inférence LLM efficace. Son serveur Titan Takeoff aide les équipes à exécuter des LLM sur site avec des performances optimisées, des besoins en GPU réduits et une latence améliorée. Il fournit également des fonctionnalités de quantification et de compression.
Technologies de support LLMOps
LLM
Certains fournisseurs de LLM, tels que OpenAI, Anthropic et Google, proposent des fonctionnalités partielles de cycle de vie des LLM (par exemple, fine-tuning sur certains modèles, tableaux de bord de surveillance et outils d'évaluation).
Remarque : les fournisseurs de LLM proposent des outils de fine-tuning et d'intégration, mais ils ne constituent pas des plateformes LLMOps complètes. Le LLMOps nécessite généralement des composants supplémentaires tels que la surveillance, la gouvernance, la traçabilité, des systèmes d'évaluation et la gestion des pipelines.
Frameworks d'intégration
Ces outils sont conçus pour faciliter le développement d'applications LLM, telles que les analyseurs de documents et de code, les chatbots, etc.
Bases de données vectorielles
Les bases de données vectorielles stockent des embeddings vectoriels de haute dimension générés à partir de texte, d'images ou d'autres données. Elles ne stockent pas d'enregistrements bruts et sensibles tels que les résultats de tests médicaux ; elles indexent plutôt les embeddings pour permettre la recherche sémantique et la récupération.
Outils de fine-tuning
Les outils de fine-tuning vont des bibliothèques de bas niveau aux plateformes no-code, selon le niveau de contrôle et d'expertise technique requis.
Bibliothèques et frameworks
Les frameworks Hugging Face Transformers et basés sur PEFT/LoRA sont les options les plus utilisées pour le fine-tuning. Pour les charges de travail à grande échelle, des moteurs d'entraînement tels que DeepSpeed et Megatron-LM gèrent efficacement l'entraînement distribué.
Plateformes no-code
Unsloth Studio et Hugging Face AutoTrain fournissent des interfaces web pour le fine-tuning de LLM sans écrire de code.
Unsloth Studio est open source et prend en charge les méthodes LoRA et QLoRA avec une intégration directe de Hugging Face. Hugging Face AutoTrain permet aux utilisateurs de fine-tuner des modèles en téléchargeant des données directement via l'écosystème Hugging Face.
Outils RLHF
Le RLHF, abréviation de l'apprentissage par renforcement à partir de retours humains, permet aux systèmes d'IA d'affiner leurs décisions en intégrant des conseils humains.
Dans l'apprentissage par renforcement, un agent améliore son comportement par essais et erreurs, guidé par les retours de l'environnement sous forme de récompenses ou de punitions.
En revanche, le RLHF contribue à améliorer le comportement des modèles en intégrant des données de préférence humaine dans la boucle d'entraînement. Il ne remplace pas l'étiquetage à grande échelle, mais repose sur des données de comparaison générées par l'humain. Le RLHF soutient l'alignement, la sécurité, l'amélioration de la qualité et une meilleure adéquation à l'intention de l'utilisateur.
Outils de test des LLM
Les outils de test des LLM évaluent les LLM en mesurant les performances, les capacités et les biais potentiels des modèles sur des tâches liées au langage telles que la compréhension et la génération du langage naturel. Ces outils de test peuvent inclure :
- Frameworks de test
- Datasets de benchmark
- Métriques d'évaluation.
Par exemple, Promptfoo est une CLI et une bibliothèque open source qui évalue automatiquement les sorties à l'aide de métriques personnalisées, exécute des comparaisons côte à côte entre plusieurs modèles et fournisseurs, et effectue des red teaming automatisés pour identifier les vulnérabilités. Il s'intègre aux pipelines CI/CD et s'exécute entièrement en local.
Surveillance et observabilité des LLM
Les outils de surveillance et d'observabilité des LLM assurent un fonctionnement correct, la sécurité des utilisateurs et la protection de la marque. Contrairement au ML traditionnel, les sorties des LLM sont intrinsèquement non déterministes, ce qui signifie que la même entrée peut produire des résultats différents, ce qui nécessite de tracer le contexte complet pour détecter les hallucinations.5 En pratique, les améliorations passent par des mises à jour itératives des prompts et du contexte plutôt que par un réentraînement.
La surveillance des LLM comprend des activités telles que :
- Surveillance fonctionnelle : Suivi de facteurs tels que le temps de réponse, l'utilisation des tokens, le nombre de requêtes, les coûts et les taux d'erreur.
- Surveillance des prompts : Vérification des entrées utilisateur et des prompts pour évaluer les contenus toxiques dans les réponses, mesurer les distances d'embeddings et identifier les injections de prompts malveillantes.
- Surveillance des réponses : Analyse pour découvrir les comportements hallucinatoires, les divergences de sujet, le ton et le sentiment dans les réponses.
OpenLLMetry est un exemple de bibliothèque d'observabilité open source pour les applications LLM construite sur OpenTelemetry. Elle trace les appels LLM à l'exécution dans les workflows, les tâches, les agents et les invocations d'outils, en capturant les prompts et les réponses d'API. Les traces peuvent être exportées vers la plateforme Traceloop ou toute pile d'observabilité existante compatible OpenTelemetry.6
Plateformes gérées vs configuration CPU uniquement benchmark
Nous avons comparé TrueFoundry et Amazon SageMaker à une configuration CPU uniquement pour mesurer l'impact des plateformes gérées sur le temps d'entraînement et d'évaluation.
Les deux plateformes ont réduit l'entraînement de 2 572 secondes à moins de 570, et l'évaluation de 174 secondes à environ 40. Bien que SageMaker ait été légèrement plus rapide pendant l'entraînement et TrueFoundry légèrement plus rapide pendant l'évaluation, la différence globale était négligeable ; les deux ont apporté des améliorations majeures par rapport à la configuration manuelle.
Consultez notre méthodologie de benchmark.
Pour les cas d'utilisation LLMOps tels que les tests itératifs de prompts, les mises à jour fréquentes de modèles et la surveillance en production, la charge d'une configuration CPU uniquement s'accumule rapidement, et les plateformes gérées réduisent cette friction en gérant automatiquement l'infrastructure.
Observabilité des workflows agentiques dans le LLMOps
Les applications LLM ne se limitent plus à de simples cycles prompt-réponse. Dans les workflows agentiques, un LLM peut invoquer plusieurs outils, prendre des décisions autonomes et accomplir des tâches multi-étapes de manière indépendante. Cela crée de nouveaux défis d'observabilité pour les équipes LLMOps :
Défis clés :
- Traçage des appels d'outils : Surveillance des paramètres d'entrée/sortie, de la durée et de l'état de succès de chaque invocation d'outil
- Journalisation des points de décision : Enregistrement de la raison pour laquelle l'agent a choisi un outil spécifique à chaque point de décision
- Détection de Loop : Identification et arrêt automatiques des agents bloqués dans des boucles infinies
- Attribution des coûts multi-étapes : Comprendre quelle étape a consommé combien de tokens sur un workflow de 10 étapes
Les plateformes LLMOps relèvent ces défis en fournissant un traçage de bout en bout qui capture chaque invocation d'outil, visualise les arbres de décision des agents et signale automatiquement les anomalies telles que les boucles infinies ou les pics de latence inattendus.
Ces plateformes permettent également des répartitions granulaires des coûts par étape, aidant les organisations à optimiser à la fois les performances et les dépenses sur des pipelines agentiques complexes.
Garde-fous et couches de sécurité pour l'observabilité des LLM
Les déploiements de LLM en production nécessitent des couches de sécurité qui filtrent, surveillent et bloquent les entrées et sorties nuisibles en temps réel. Du point de vue LLMOps, l'observabilité de ces systèmes de garde-fous est essentielle pour maintenir la sécurité et la conformité :
Couches de sécurité essentielles :
- Garde-fous d'entrée : Détection des tentatives d'injection de prompt, des techniques de jailbreak et des contenus malveillants avant le traitement
- Garde-fous de sortie : Notation des hallucinations, masquage des PII (informations personnelles identifiables) et filtrage des réponses toxiques
- Application des politiques : Blocage des réponses qui enfreignent les politiques de l'entreprise ou les exigences réglementaires
Une surveillance efficace des garde-fous nécessite le suivi des requêtes bloquées et de leurs causes, la mesure des taux de faux positifs pour protéger l'expérience utilisateur, l'identification des règles fréquemment déclenchées et l'analyse des tendances de sécurité dans le temps pour détecter les menaces émergentes.
Outils de garde-fous pour le LLMOps :
- Guardrails AI : validation des sorties basée sur Pydantic avec application de sorties structurées et conformité au schéma
- Lakera Guard : protection contre l'injection de prompt en temps réel avec détection et classification des menaces
- Rebuff : système de défense auto-renforçant qui apprend des tentatives d'injection de prompt
- Protect AI : analyse de sécurité des modèles ML avec détection des vulnérabilités sur l'ensemble du pipeline de déploiement
- Invariant Guardrails : système d'application à l'exécution pour les agents LLM qui intercepte les sorties des agents et les appels d'outils, bloquant l'exposition des secrets d'API, filtrant les contenus sensibles et appliquant les politiques d'appels d'outils pendant l'exécution de l'agent.7
Qu'est-ce que le LLMOps ?
LLMOps signifie Large Language Model Operations. Il désigne les pratiques, outils et infrastructures utilisés pour gérer le cycle de vie des LLM, tels que le fine-tuning, le déploiement, la surveillance, l'évaluation, la gouvernance et l'amélioration continue des modèles.
Le LLMOps n'automatise pas l'ensemble du pipeline d'IA, mais se concentre spécifiquement sur l'opérationnalisation des systèmes basés sur les LLM.
Composants clés du LLMOps :
- Sélection d'un modèle de base : Un point de départ dicte les affinements ultérieurs et le fine-tuning pour adapter les modèles de base à des domaines d'application spécifiques.
- Gestion des données : La gestion de volumes importants de données devient essentielle pour un fonctionnement précis des modèles de langage.
- Déploiement et surveillance des modèles : Assurer le déploiement efficace des modèles de langage et leur surveillance continue garantit des performances constantes.
- Ingénierie des prompts : Création de modèles de prompts efficaces pour améliorer les performances des modèles.
- Surveillance des modèles : Suivi continu des résultats des modèles, détection de la dégradation de la précision et gestion de la dérive des modèles.
- Évaluation et benchmarking : L'évaluation rigoureuse des modèles affinés par rapport à des benchmarks standardisés aide à mesurer l'efficacité des modèles de langage.
- Fine-tuning des modèles : Fine-tuning des LLM pour des tâches spécifiques et affinage des modèles pour des performances optimales.
En quoi le LLMOps diffère-t-il du MLOps ?
Le LLMOps est spécialisé et centré sur l'utilisation des grands modèles de langage. En même temps, le MLOps a une portée plus large englobant divers modèles et techniques de machine learning.
En ce sens, le LLMOps est connu comme le MLOps pour les LLM. Par conséquent, ces deux domaines divergent dans leur focalisation spécifique sur les modèles de base et les méthodologies :
Le LLMOps se concentre sur des systèmes pilotés par prompts et non déterministes plutôt que sur des pipelines statiques d'entraînement et de déploiement. Contrairement au ML conventionnel, où les améliorations passent par le réentraînement, l'optimisation du LLMOps se fait en affinant les prompts ou les données de récupération et en ajustant les systèmes externes.
Les préoccupations opérationnelles essentielles incluent :
- Détection et évaluation des hallucinations
- Versionnage et gestion des prompts
- Suivi des pipelines de récupération
- Surveillance du coût des tokens par requête
Apprentissage par transfert
Contrairement aux modèles de ML conventionnels construits à partir de zéro, les LLM commencent souvent par un modèle de base, qui est ajusté par fine-tuning avec de nouvelles données afin d'optimiser les performances pour des domaines spécifiques. Ce fine-tuning facilite des résultats à la pointe de la technologie pour des applications particulières tout en utilisant moins de données et de ressources computationnelles.
Retour humain
Les progrès dans l'entraînement des grands modèles de langage sont attribués au reinforcement learning from human feedback (RLHF). Étant donné la nature ouverte des tâches des LLM, les contributions humaines des utilisateurs finaux ont une valeur considérable pour évaluer les performances des modèles. L'intégration de cette boucle de retour dans les pipelines LLMOps simplifie l'évaluation et recueille des données pour l'affinage futur des modèles.
Réglage des hyperparamètres
Alors que le ML conventionnel se concentre principalement sur le réglage des hyperparamètres pour améliorer la précision, les LLM introduisent une dimension supplémentaire en réduisant les coûts d'entraînement et d'inférence. L'ajustement de paramètres tels que la taille des batchs et les taux d'apprentissage peut influencer considérablement la vitesse et le coût de l'entraînement. Par conséquent, un suivi méticuleux du processus de réglage et l'optimisation restent pertinents tant pour les modèles de ML classiques que pour les LLM, bien qu'avec des priorités différentes.
Métriques de performance
Les modèles de ML traditionnels reposent sur des métriques bien définies telles que l'accuracy, l'AUC et le score F1, relativement simples à calculer. En revanche, l'évaluation des LLM implique un éventail de métriques et de systèmes de notation standard distincts, comme le bilingual evaluation understudy (BLEU) et le Recall-Oriented Understudy for Gisting Evaluation (ROUGE), qui nécessitent une attention particulière lors de la mise en œuvre.
Ingénierie des prompts
Les modèles qui suivent des instructions peuvent gérer des prompts complexes ou des jeux d'instructions. La conception de ces modèles de prompts est essentielle pour obtenir des réponses précises et fiables de la part des LLM. Une ingénierie de prompt efficace atténue les risques d'hallucination du modèle, de manipulation des prompts, de fuite de données et de vulnérabilités de sécurité.
Construction de pipelines LLM
Les pipelines LLM enchaînent plusieurs invocations de LLM et peuvent s'interfacer avec des systèmes externes tels que des bases de données vectorielles ou des recherches web. Ces pipelines permettent aux LLM de s'attaquer à des tâches complexes comme les questions-réponses sur une base de connaissances ou la réponse aux requêtes des utilisateurs à partir d'un ensemble de documents. Dans le développement d'applications LLM, l'accent se déplace souvent vers la construction et l'optimisation de ces pipelines plutôt que vers la création de nouveaux LLM.
De plus, les grands modèles multimodaux étendent ces capacités en intégrant divers types de données, comme des images et du texte, renforçant ainsi la flexibilité et l'utilité des pipelines LLM.
Voici un aperçu catégorisé des principaux outils dans le paysage LLMOps et MLOps :
 Ajouter comme source préférée
LLMOps ou MLOps : lequel correspond à votre projet ?
Les deux ne s'excluent pas mutuellement. De nombreux systèmes de production combinent les deux, et le bon choix dépend de ce que vous construisez.
Le LLMOps est plus adapté lorsque votre application repose sur un modèle préentraîné de OpenAI, Anthropic, Google ou des alternatives open source telles que Llama, et que votre travail est axé sur l'ingénierie des prompts, les pipelines RAG ou l'orchestration d'agents. Il est également plus pertinent lorsque vous devez surveiller les coûts des tokens, les hallucinations et la qualité des réponses en production.
Le MLOps est plus approprié lorsque vous entraînez ou fine-tunez des modèles personnalisés sur des données spécifiques à un domaine, ou lorsque votre application nécessite des sorties déterministes et auditables, comme la détection de fraude ou la classification médicale.
Si vous fine-tunez un modèle de base et le déployez en production, les deux s'appliquent : le MLOps gère le pipeline d'entraînement, le LLMOps gère l'inférence et la surveillance.
Plateformes gérées vs configuration CPU uniquement méthodologie de benchmark
Nous avons comparé les temps d'entraînement et d'évaluation d'un modèle de classification de sentiment basé sur DistilBERT dans trois environnements : une configuration manuelle (uniquement CPU), TrueFoundry et Amazon SageMaker. Pour garantir la cohérence, nous avons utilisé le même code source, le même modèle préentraîné (distilbert-base-uncased) et les 5 000 premiers échantillons du dataset Amazon Reviews pour toutes les exécutions.
Le dataset a été filtré pour inclure les notes de 1 à 5, réétiqueté en cinq classes (0–4) et divisé en ensembles d'entraînement et de validation stratifiés 80/20. La tokenisation a été effectuée avec une longueur de séquence maximale fixe de 128.
Le modèle a été entraîné pendant une époque avec des tailles de batch identiques (16 pour l'entraînement, 32 pour l'évaluation). TrueFoundry et SageMaker ont tous deux utilisé le même type d'instance GPU, tandis que la configuration manuelle a été volontairement exécutée sur CPU pour refléter un environnement local typique ou non spécialisé.
Cette configuration met en évidence non seulement les optimisations au niveau de la plateforme offertes par les outils LLMOps modernes, mais aussi les gains de performance substantiels liés à un accès transparent au GPU. Ce benchmark illustre comment l'utilisation de plateformes gérées comme TrueFoundry et SageMaker peut réduire les temps d'entraînement et d'évaluation par rapport à l'exécution du même code manuellement sur un CPU, en particulier dans des scénarios réels aux ressources limitées.
FAQ
Le LLMOps offre des avantages significatifs aux projets de machine learning qui exploitent de grands modèles de langage :
1. Précision accrue : Garantir des données de haute qualité pour l'entraînement et un déploiement fiable améliore la précision du modèle.
2. Latence réduite : Des stratégies de déploiement efficaces entraînent une latence réduite des LLM, permettant une récupération plus rapide des données.
Remarque : L'impact sur la précision ou la latence dépend de la taille du modèle, de l'infrastructure et de l'outillage ; le LLMOps améliore la gérabilité et la fiabilité des LLM plutôt que leurs performances intrinsèques.
3. Promotion de l'équité : Promouvoir l'équité dans l'IA signifie réduire activement les biais de l'IA dans les algorithmes pour préserver l'équité et prévenir les violations de l'éthique de l'IA.
Les défis des opérations de grands modèles de langage exigent des solutions robustes pour maintenir des performances optimales :
1.) Défis de gestion des données : La gestion de vastes datasets et de données sensibles nécessite une collecte et un versionnage efficaces des données.
2.) Déploiement évolutif : Déployer une infrastructure évolutive et utiliser des technologies cloud-native pour répondre aux besoins en puissance de calcul.
3.) Optimisation des modèles : Employer des techniques de compression de modèles et affiner les modèles pour améliorer l'efficacité globale.
Les outils LLMOps sont essentiels pour surmonter les défis et fournir des modèles de meilleure qualité dans le paysage dynamique des grands modèles de langage.
Dans les applications pratiques, le LLMOps façonne divers secteurs :
Génération de contenu : Tirer parti des modèles de langage pour automatiser la création de contenu, notamment la synthèse, l'analyse de sentiment, etc.
Support client : Améliorer les chatbots et les assistants virtuels grâce aux capacités des modèles de langage.
Analyse de données : Extraire des informations à partir de données textuelles, enrichissant les processus de prise de décision.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{Meilleurs outils LLMOps et comparaison avec le MLOps}},
  year   = {2026},
  month  = may,
  howpublished    = {\url{https://aimultiple.com/llmops-tools}},
  note   = {AIMultiple. Consulté le 18 mai 2026}
}Résultats et horodatages de 78 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 5 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
15 mises à jourAjout de MLflow, Promptfoo, OpenLLMetry et Invariant Guardrails aux sections d'outils LLMOps.
Ajout d'une section sur l'observabilité du flux de travail agentique dans LLMOps.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.







Commentaires 1
Partagez vos idées
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.
This is a fantastic MLops overview and full of insight and immediate application to DevOps , Ai development at scale and how to implement design tools . Many thanks to Mr . Cem Dilmegani for his work .