


Comparez les grands modèles de vision: GPT-4o vs YOLOv8n

Les grands modèles de vision (LVMs) peuvent automatiser et améliorer des tâches visuelles telles que la détection de défauts, le diagnostic médical et la surveillance environnementale.
Nous avons évalué trois modèles de détection d’objets : YOLOv8n, DETR et GPT-4o Vision, sur 1 000 images chacun, en mesurant des métriques telles que mAP@0.5, la vitesse d’inférence, les FLOPs et le nombre de paramètres. Pour garantir une comparaison équitable, toutes les images ont été redimensionnées à 800×800 pixels et évaluées à l’aide d’un prétraitement identique, de seuils de confiance identiques et de critères de correspondance basés sur l’IoU.
Benchmark de détection d’objets : GPT-4o (Vision), YOLOv8n, DETR
mAP@0.5 : précision moyenne (Mean Average Precision) à un seuil d’intersection sur union (IoU) de 0.5, mesurant l’exactitude de la détection d’objets en équilibrant les vrais positifs et les faux positifs.
Latence (ms) : temps de traitement moyen par image, mesuré en millisecondes, indiquant la vitesse du modèle.
Résultats du benchmark
Les capacités de détection d’objets de GPT-4o restent limitées par rapport aux modèles spécialisés comme YOLOv8n et DETR.
Précision :
- DETR : mAP@0.5 = 0.55
- YOLOv8n : 0.20
- GPT-4o : 0.02
Ces résultats indiquent que GPT-4o n’est pas encore adapté aux tâches pratiques de détection d’objets.
Latence :
- YOLOv8n : 365 ms
- DETR : 3145 ms
- GPT-4o : 5150 ms
YOLOv8n offre l’inférence la plus rapide mais une précision plus faible, tandis que DETR atteint une meilleure précision au prix d’un traitement plus lent.
Tous les modèles ont été évalués avec des images d’entrée de 800×800 pour la cohérence. Le nombre de paramètres et les FLOPS étaient disponibles pour YOLOv8n et DETR, mais pas pour GPT-4o, ce qui empêche une comparaison complète de l’efficacité computationnelle.
Complexité du modèle :
- DETR : 41.52M paramètres, 59.56 GFLOPS
- YOLOv8n : 3.15M paramètres, 6.83 GFLOPS
Cela montre l’efficacité de YOLOv8n pour les applications en temps réel, tandis que DETR sacrifie la vitesse au profit d’une précision supérieure et d’une demande computationnelle plus élevée. L’absence de détails architecturaux pour GPT-4o limite une analyse plus approfondie de l’efficacité.
Consultez notre méthodologie de benchmark.
Raisons possibles des différences de performance
Les trois modèles ont montré des niveaux de précision et de vitesse différents car ils sont conçus à des fins différentes et traitent les informations visuelles de manières distinctes. GPT-4o est un LLM multimodal qui accepte à la fois du texte et des images, tandis que YOLOv8n et DETR sont des systèmes de détection d’objets qui ne fonctionnent que sur les images.
GPT-4o interprète les entrées visuelles via un pipeline de raisonnement piloté par le langage. Il peut décrire des scènes et identifier des objets, mais il n’est pas conçu pour dessiner des cadres de délimitation ou effectuer une localisation spatiale de haute précision.
Ses sorties dépendent du raisonnement multimodal plutôt que de mécanismes spécifiques à la détection. Cela le rend plus lent et moins précis pour les tâches de détection.
YOLOv8n et DETR utilisent des architectures explicitement créées pour la détection d’objets. Ils génèrent directement des cadres de délimitation plutôt que de raisonner à leur sujet.
YOLOv8n est optimisé pour la vitesse grâce à une structure légère, tandis que DETR est un détecteur basé sur Transformer qui traite les images différemment de YOLO et vise des prédictions plus précises.
Les deux modèles se concentrent uniquement sur les entrées visuelles et suivent des objectifs d’entraînement qui associent les motifs d’images aux emplacements des objets.
Les principales différences sont :
- Type d’entrée
- GPT-4o : image et texte
- YOLOv8n et DETR : image uniquement
- Fonction principale
- GPT-4o : compréhension et raisonnement multimodaux
- YOLOv8n et DETR : détection d’objets
- Mécanisme de sortie
- GPT-4o : ne dessine pas intrinsèquement de cadres de délimitation
- YOLOv8n et DETR : prédisent directement les cadres de délimitation
Étant donné que YOLOv8n et DETR ont été développés uniquement pour la détection d’objets, ils obtiennent naturellement de meilleurs résultats dans les benchmarks axés sur la précision et la latence.
La conception multimodale large de GPT-4o, non centrée sur la détection, entraîne un mAP plus faible et des temps d’inférence plus élevés lorsqu’il est évalué dans le même contexte.
Évaluation détaillée des grands modèles de vision
OpenAI GPT-4o (Vision)
GPT-4o (Vision) est une extension multimodale de OpenAI GPT-4, conçue pour traiter et générer des réponses à partir de texte et d’images.
Cette capacité permet à GPT-4o d’interpréter le contenu visuel parallèlement aux informations textuelles, permettant une gamme d’applications nécessitant la compréhension et l’analyse d’images.
- Interprétation d’images : GPT-4o peut analyser et décrire le contenu des images, notamment identifier des objets, interpréter des scènes et extraire des informations textuelles à partir des visuels. Cela le rend utile pour des tâches comme le sous-titrage d’images et la synthèse de contenu.
- Analyse de données visuelles : le modèle peut interpréter des graphiques, des diagrammes et des schémas, fournissant des informations et des explications fondées sur les données visuelles. Cette fonctionnalité est bénéfique pour les applications d’analyse de données et d’éducation.
- Compréhension de contenu multimodal : GPT-4o peut fournir des réponses plus complètes en combinant des entrées de texte et d’image. Il peut également améliorer les applications d’analyse des médias sociaux et de modération de contenu. Par exemple, il peut évaluer le sentiment ou détecter la désinformation dans les publications qui incluent à la fois du texte et des images.
Malgré ses capacités avancées, GPT-4o peut parfois produire des résultats inexacts ou peu fiables. Il peut mal interpréter des éléments visuels, négliger des détails ou générer des informations incorrectes, nécessitant une vérification humaine pour les tâches critiques.
Le modèle peut également refléter des biais présents dans ses données d’entraînement, conduisant à des interprétations faussées ou au renforcement des stéréotypes. Cela constitue une préoccupation dans les applications sensibles où l’impartialité est cruciale, notamment l’inférence démographique ou la modération de contenu.
OpenAI Sora
Sora est un modèle texte-vers-vidéo créé par OpenAI. Il génère de courts clips vidéo à partir de prompts utilisateur et peut également prolonger des vidéos existantes. Sa technologie sous-jacente est une adaptation du modèle DALL-E 3.
Sora est un transformer de diffusion, un modèle de diffusion latent de débruitage qui utilise un Transformer. Les vidéos sont initialement générées dans un espace latent en débruitant des « patches » 3D, puis converties dans l’espace standard à l’aide d’un décompresseur vidéo.
Le re-sous-titrage est utilisé pour améliorer le processus d’entraînement, dans lequel un modèle vidéo-vers-texte génère des légendes détaillées pour les vidéos.
Avec les derniers développements, les utilisateurs peuvent désormais générer des vidéos jusqu’à une résolution de 1080p, avec une durée maximale de 20 secondes, et dans des formats large, vertical ou carré. Ils peuvent également intégrer leurs propres éléments pour prolonger, remixer et fusionner du contenu existant ou créer de nouvelles vidéos à partir de prompts textuels.
Figure 1 : exemple de génération vidéo de Sora utilisant le prompt : « Un plan large et serein d’une famille de mammouths laineux dans un désert ouvert ».1
Landing IA LandingLens
LandingLens simplifie le développement et le déploiement de modèles de vision par ordinateur. Il s’adresse à divers secteurs sans nécessiter une expertise approfondie en IA ou en programmation complexe.
La plateforme standardise les solutions d’apprentissage profond, réduisant le temps de développement et permettant une mise à l’échelle mondiale facile des projets. Sans affecter la vitesse de production, les utilisateurs peuvent créer leurs propres modèles d’apprentissage profond et optimiser la précision des inspections.
Elle offre une interface utilisateur étape par étape qui simplifie le processus de développement.
Figure 2 : le diagramme illustre le flux de travail LandingLens IA, où les images d’entrée sont transformées en données, utilisées pour entraîner des modèles, déployées via le cloud, l’edge ou Docker, et continuellement améliorées grâce au retour d’expérience.2
Stable Diffusion
Stable Diffusion est un modèle d’apprentissage profond conçu pour créer des images de haute qualité à partir de descriptions textuelles :
- Stable Diffusion repose sur la diffusion. Le processus commence par l’ajout de bruit aléatoire à une image, puis le modèle apprend à reconstruire l’original en inversant ce bruit.
- Ce processus permet au modèle de générer des images entièrement nouvelles en affinant l’entrée bruitée sur plusieurs étapes jusqu’à ce qu’une image claire et cohérente émerge.
Stable Diffusion utilise un modèle de diffusion latent pour améliorer l’efficacité. Au lieu de travailler directement avec des images haute résolution, il les compresse d’abord dans un espace latent de dimension inférieure à l’aide d’un autoencodeur variationnel (VAE).
Cette approche réduit considérablement les exigences computationnelles, permettant une exécution sur du matériel grand public doté de GPU.
Applications :
En plus de générer des images à partir de texte, Stable Diffusion peut être utilisé pour diverses tâches créatives, telles que :
- Inpainting : restauration ou remplissage des parties manquantes d’une image.
- Outpainting : extension des bords d’une image pour ajouter plus de contenu.
- Traduction image-vers-image : conversion d’une image existante en un style différent ou modification de son apparence en fonction d’une entrée textuelle.
Midjourney
Midjourney est un générateur d’art qui convertit des descriptions textuelles en images de haute qualité.
Capacités
Midjourney Version 7 présente une architecture entièrement reconstruite avec des améliorations significatives de la qualité et des fonctionnalités.
Génération d’images : V7 produit des images redimensionnées en 2048 x 2048 pixels avec une précision de prompt exceptionnelle et une qualité quasi photographique. Les principales améliorations incluent des textures plus riches, un rendu précis des éléments complexes comme les mains et les visages, et une compréhension sophistiquée de l’éclairage et de la composition.
Génération vidéo : crée des clips vidéo de 5-21 secondes avec une grande cohérence entre les images. Le système génère environ 60 secondes de vidéo à partir de six images en environ trois heures, ciblant des applications professionnelles dans le marketing, la réalisation de films et la création de contenu.
Capacités 3D : la génération texte-vers-3D utilisant une modélisation de type NeRF crée des objets volumétriques et des scènes immersives. Ces fonctionnalités soutiennent le développement de jeux, la visualisation de produits et les applications architecturales.
Figure 3 : fonctionnalité d’édition d’images de Midjourney.3
DeepMind Flamingo
Flamingo de DeepMind est un modèle vision-langage conçu pour comprendre et raisonner sur des images et des vidéos en utilisant un minimum d’exemples d’entraînement (apprentissage few-shot). Voici quelques-unes des principales caractéristiques :
- Apprentissage few-shot multimodal : Flamingo peut effectuer efficacement de nouvelles tâches avec seulement quelques exemples, contrairement aux modèles d’IA traditionnels qui nécessitent de vastes ensembles de données étiquetés.
- Mécanisme Perceiver Resampler : Flamingo utilise un « Perceiver Resampler » pour traiter efficacement les entrées visuelles. Il compresse les données d’image et de vidéo dans un format pouvant être intégré dans un LLM pré-entraîné.
- Alignement vision-langage avec des couches Gated Cross-Attention : des couches spéciales Gated Cross-Attention aident Flamingo à aligner et intégrer les données visuelles avec le raisonnement textuel. Cette application peut être importante pour comprendre les conversations basées sur des images.
Flamingo utilise un traitement image par image, décomposant les vidéos en images clés et extrayant des informations pour analyser efficacement les éléments visuels.
Ses réponses contextuelles aident à générer des légendes, des descriptions et des réponses fondées sur la progression des événements dans une vidéo pour garantir une compréhension cohérente du contenu.
De plus, Flamingo présente un raisonnement temporel pour comprendre les séquences, les relations de cause à effet et les interactions complexes au fil du temps. Cela le rend très efficace pour l’analyse vidéo et les tâches de raisonnement multimodal.
OpenAI CLIP d’OpenAI (Pretraining contrastif langage–image)
CLIP est un réseau de neurones entraîné sur une variété d’images et de légendes textuelles.
Ce modèle peut effectuer diverses tâches de vision, y compris la classification zero-shot, en comprenant les images dans le contexte du langage naturel.
CLIP est entraîné sur 400 millions de paires (image, texte) pour combler efficacement l’écart entre les tâches de vision par ordinateur et le traitement du langage naturel. Cela aide CLIP à faire des prédictions de légendes ou des résumés d’images sans être explicitement entraîné pour ces tâches spécifiques.
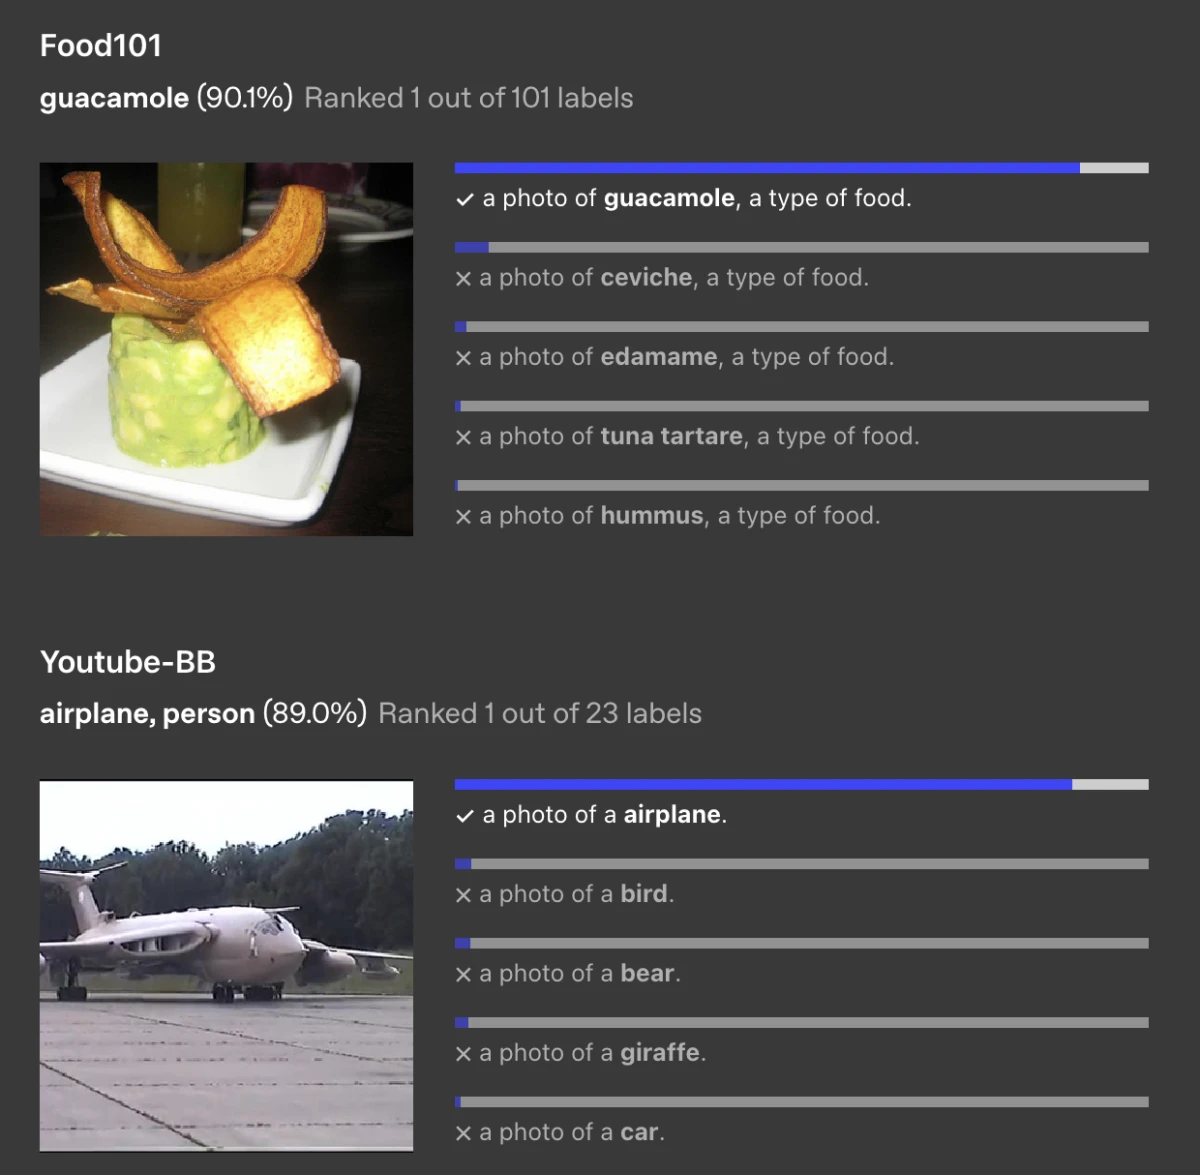
Figure 4 : identification d’images par CLIP à partir de divers ensembles de données.4
Google Vision Transformer (ViT)
Vision Transformer applique l’architecture transformer initialement utilisée dans le traitement du langage naturel aux tâches de reconnaissance d’images.
Il traite les images d’une manière similaire à la façon dont les transformers traitent les séquences de mots, et il a montré son efficacité dans l’apprentissage de caractéristiques pertinentes à partir de données d’images pour des tâches de classification et d’analyse.
Dans Vision Transformer, les images sont traitées comme une séquence de patches. Chaque patch est aplati en un vecteur unique, de manière similaire à l’utilisation des embeddings de mots dans les transformers pour le texte.
Cette approche permet à ViT d’apprendre la structure de l’image et de prédire indépendamment les étiquettes de classe.
Modèles de fondation natifs vidéo
Les modèles de fondation natifs vidéo représentent un changement fondamental par rapport aux approches traditionnelles de vision par ordinateur. Contrairement aux systèmes antérieurs qui traitaient les vidéos comme des séquences d’images indépendantes, ces modèles traitent le temps comme une dimension intégrale des données visuelles.
Innovations architecturales clés
Sora d’OpenAI illustre cette évolution à travers son architecture de transformer de diffusion :
- Patches spatiotemporels 3D : traite les données vidéo de manière holistique plutôt qu’image par image
- Cohérence temporelle : maintient la qualité visuelle et la cohérence narrative à travers les séquences
- Dépendances à longue portée : capture les relations de cause à effet et les schémas de mouvement
- Génération sensible à la physique : comprend le mouvement réaliste et les interactions entre objets
Applications actuelles
Création de contenu :
- Montage vidéo automatisé et synthèse de scènes
- Transfert de style avec cohérence temporelle
- Génération de vidéos narratives à partir de prompts textuels
Imagerie médicale :
- Analyse du mouvement cardiaque dans les échocardiogrammes
- Visualisation du flux sanguin en angiographie
- Évaluation dynamique du comportement des tissus
Sécurité et surveillance :
- Reconnaissance et suivi d’activités
- Détection d’Anomaly dans le temps
- Analyse comportementale contextuelle
Défis restants
Malgré les progrès, plusieurs limites persistent :
- Coût computationnel : la génération de vidéos longues reste gourmande en ressources
- Plausibilité physique : les scénarios complexes peuvent produire une physique irréaliste
- Cohérence des personnages : maintenir l’identité à travers de longues séquences est difficile
- Exigences d’entraînement : les ensembles de données vidéo à grande échelle avec annotations sont rares et coûteux
Inférence sur appareil et optimisation edge
Le déploiement edge permet aux modèles de vision de fonctionner localement sur les smartphones, les appareils IoT et les systèmes embarqués, éliminant la dépendance à l’infrastructure cloud.
Pourquoi le déploiement edge est important
Avantages en matière de confidentialité :
- Les données visuelles sensibles ne quittent jamais l’appareil
- Essentiel pour la santé, la surveillance et les applications personnelles
- Conformité aux réglementations sur la protection des données
Avantages en termes de performances :
- Latence quasi nulle sans allers-retours réseau
- Traitement en temps réel pour la RA et les systèmes autonomes
- Fonctionnement fiable dans les environnements hors ligne
Efficacité des coûts :
- Consommation de bande passante réduite
- Réduction des dépenses de cloud computing
- Coûts opérationnels continus minimaux
Techniques de compression de modèles
Rendre les grands modèles de vision viables sur les appareils edge nécessite une optimisation sophistiquée :
- Quantification : réduit la précision de 32 bits à des entiers de 8 bits ou 4 bits
- Taille de modèle plus petite
- Perte de précision minimale
- Élagage : supprime les paramètres et connexions redondants
- Crée des réseaux épars
- Maintient les performances avec moins de calculs
- Distillation de connaissances : transfère les connaissances des grands modèles vers les petits modèles
Qu’est-ce qu’un grand modèle de vision (LVM) ?
Les grands modèles de vision (LVMs) sont conçus pour traiter, analyser et interpréter des données visuelles, telles que des images ou des vidéos. Ils se caractérisent par leur nombre important de paramètres, souvent en millions ou en milliards. Cela leur permet d’apprendre des motifs, des caractéristiques et des relations complexes dans le contenu visuel.
Comme les grands modèles de langage (LLMs) pour le texte, les LVMs sont entraînés sur de vastes ensembles de données, ce qui leur confère des capacités de reconnaissance d’objets, de génération d’images, de compréhension de scènes et de raisonnement multimodal (intégration d’informations visuelles et textuelles).
Ces modèles peuvent prendre en charge des applications dans des domaines tels que la conduite autonome, l’imagerie médicale, la création de contenu et la réalité augmentée.
Structure et conception
Les grands modèles de vision sont construits à l’aide d’architectures de réseaux de neurones avancées. À l’origine, les réseaux de neurones convolutifs (CNN) prédominaient dans le traitement d’images en raison de leur capacité à gérer efficacement les données de pixels et à détecter des motifs hiérarchiques.
Récemment, les modèles transformer, initialement conçus pour le traitement du langage naturel, ont également été adaptés à de nombreuses tâches de vision, offrant des performances améliorées dans certains scénarios.
Entraînement
L’entraînement des grands modèles de vision consiste à leur fournir des données visuelles, telles que des images ou des vidéos Internet, accompagnées d’étiquettes ou d’annotations pertinentes dans la nouvelle approche de modélisation séquentielle. Les formateurs étiquettent des bibliothèques d’images pour alimenter les modèles.
Par exemple, dans les tâches de classification d’images, chaque image est étiquetée avec la classe à laquelle elle appartient. Le modèle apprend en ajustant ses paramètres pour minimiser la différence entre ses prédictions et les étiquettes réelles.
Ce processus nécessite une puissance de calcul importante et un ensemble de données vaste et diversifié pour garantir que le modèle puisse bien généraliser à des données nouvelles et inédites.
Figure 3 : diagramme d’entraînement des grands modèles de vision sur OpenAI.4
Consultez les services de collecte de données d’images pour en savoir plus sur les données d’entraînement pour la classification d’images.
Caractéristiques clés des grands modèles de vision
Type de modèle fait référence à l’architecture et aux principes de conception d’un modèle de vision. Il définit la manière dont le modèle traite et interprète les données visuelles, s’il intègre plusieurs modalités (par exemple, texte et images) et quels mécanismes sous-jacents (par exemple, transformers, apprentissage contrastif, diffusion) il emploie pour extract des représentations significatives :
- multimodal basé sur Transformer LLM : une architecture de modèle qui combine les transformers avec des capacités multimodales. Elle permet de comprendre simultanément les entrées visuelles et textuelles. Elle est entraînée sur des ensembles de données à grande échelle pour effectuer un raisonnement complexe sur plusieurs types de données.
- Apprentissage contrastif : une technique utilisée lors de l’entraînement des modèles pour différencier les points de données similaires et dissemblables. Ce processus consiste à maximiser la similarité des entrées liées tout en minimisant la similarité des entrées non liées. Elle est souvent utilisée dans l’apprentissage auto-supervisé pour améliorer la représentation des caractéristiques.
- Plateforme de vision IA : ce système fournit une infrastructure, des outils et des modèles pré-entraînés pour diverses tâches de vision par ordinateur, telles que la reconnaissance d’images, la détection d’objets et la segmentation. Il inclut généralement des capacités d’entraînement, de déploiement et d’inférence de modèles.
- Transformer : une architecture d’apprentissage profond qui utilise des mécanismes d’auto-attention pour traiter les données d’entrée. Elle permet aux modèles de capturer des dépendances à longue portée, ce qui la rend efficace pour les tâches liées au langage naturel et à la vision.
- Modèle de diffusion : un modèle génératif qui élimine progressivement le bruit d’une entrée bruitée initiale et l’affine étape par étape pour produire une sortie claire et structurée. Il est couramment utilisé pour la génération d’images et l’amélioration.
Objectif d’entraînement : le but ou la fonction d’optimisation qui guide la manière dont un modèle apprend à partir des données. Il détermine comment le modèle ajuste ses paramètres internes pendant l’entraînement pour améliorer ses performances sur des tâches spécifiques. Il peut s’agir de prédire le point de données suivant (autorégressif), de distinguer des entrées similaires/dissemblables (apprentissage contrastif) ou de classer des images en catégories :
- Autorégressif : une approche d’entraînement dans laquelle un modèle prédit le point de données suivant dans une séquence en fonction des entrées précédemment observées. Elle est souvent utilisée dans la modélisation du langage et les modèles de vision génératifs.
- Apprentissage contrastif : un objectif d’apprentissage auto-supervisé où le modèle apprend en distinguant les paires de données similaires et dissemblables. Il contribue à améliorer la capacité à capturer des représentations significatives sans étiquettes explicites.
- Apprentissage supervisé : un paradigme d’apprentissage où le modèle est entraîné à l’aide de données étiquetées, ce qui signifie que chaque entrée est associée à une sortie correcte correspondante. Cette approche est largement utilisée dans des tâches telles que la classification et la segmentation.
- Classification d’images : un objectif d’entraînement spécifique où un modèle apprend à classer des images dans des catégories prédéfinies en fonction de caractéristiques visuelles. Le processus d’entraînement consiste à optimiser une fonction de perte pour maximiser la précision de la classification.
- Diffusion de débruitage : une approche d’apprentissage génératif où un modèle est entraîné à récupérer des images propres à partir d’entrées bruitées. Ce processus consiste à inverser un ajout progressif de bruit pour améliorer la reconstruction et la génération d’images.
Support du fine-tuning : la capacité d’un modèle à être adapté à des tâches spécifiques en s’entraînant sur des ensembles de données plus petits et spécifiques à un domaine tout en conservant les connaissances de sa phase de pré-entraînement.
Le fine-tuning contribue à améliorer les performances sur des applications spécialisées.
Apprentissage zero-shot/few-shot : la capacité d’un modèle à effectuer des tâches avec peu ou pas de données d’entraînement spécifiques à la tâche.
L’apprentissage zero-shot permet l’inférence sur des catégories jamais vues, tandis que l’apprentissage few-shot permet l’adaptation avec un minimum d’exemples étiquetés.
Support multimodal : la capacité d’un modèle à traiter et intégrer des informations provenant de plusieurs modalités (par exemple, texte, images, audio).
Open source vs propriétaire : les modèles open source ont un code et des poids accessibles au public, ce qui permet leur modification et leur déploiement par la communauté,
les modèles propriétaires sont détenus et contrôlés par des entités privées et peuvent limiter l’accès et la personnalisation.
Déploiement edge : la capacité d’un modèle à fonctionner sur des appareils edge (par exemple, téléphones mobiles, appareils IoT) plutôt que de dépendre de serveurs cloud.
Le déploiement edge contribue à réduire la latence, améliore la confidentialité et permet un traitement en temps réel dans des environnements aux ressources limitées.
 Ajouter comme source préférée
Quels sont les cas d’utilisation des grands modèles de vision ?
Santé et imagerie médicale
- Diagnostic des maladies : détection de maladies à partir d’images médicales telles que les radiographies, les IRM ou les tomodensitométries pour identifier des tumeurs, des fractures ou des anomalies.
- Pathologie : analyse d’échantillons de tissus en pathologie pour détecter des signes de cancer.
- Ophtalmologie : diagnostic de maladies à partir d’images rétiniennes.
Véhicules autonomes et robotique
- Navigation et détection d’obstacles : aide aux véhicules autonomes et aux drones pour naviguer et éviter les obstacles en interprétant les données visuelles en temps réel.
- Robotique dans la fabrication : aide aux robots dans les tâches de tri, d’assemblage et d’inspection qualité.
Sécurité et surveillance
- Surveillance d’activités : analyse des flux vidéo pour détecter les comportements inhabituels ou suspects.
- Reconnaissance faciale : utilisée dans les systèmes de sécurité pour la vérification d’identité et le suivi. Par exemple, Amazon Rekognition est un service cloud proposé par Amazon Web Services (AWS) qui fournit des fonctionnalités d’analyse d’images et de vidéos telles que la détection et la reconnaissance de visages, l’identification d’objets et de scènes et l’extraction de texte. Il peut analyser les émotions, les tranches d’âge et les activités, ce qui serait utile pour la personnalisation et la sécurité.
Voir la vidéo ci-dessous pour voir Amazon Rekognition en action.5
Commerce de détail et eCommerce
- Recherche visuelle : permettre aux clients de rechercher des produits à l’aide d’images plutôt que de texte.
- Gestion des stocks : automatisation de la surveillance et de la gestion des stocks grâce à la reconnaissance visuelle.
Agriculture
- Surveillance et analyse des cultures : suivi de la santé et de la croissance des cultures à l’aide d’images de drones ou de satellites.
- Détection des nuisibles : identification des ravageurs et des maladies affectant les cultures.
Surveillance environnementale
- Suivi de la faune : identification et suivi de la faune pour soutenir les efforts de conservation.
- Analyse de l’utilisation des sols et de la couverture terrestre : surveillance des changements dans l’utilisation des sols et la couverture végétale au fil du temps.
Création de contenu et divertissement
- Montage cinématographique et vidéo : automatisation du montage vidéo et des processus de post-production.
- Développement de jeux : amélioration de la création d’environnements et de personnages réalistes.
- Amélioration des photos et des vidéos : amélioration de la qualité des images et des vidéos.
- Modération de contenu : détection et signalement automatiques des contenus visuels inappropriés ou nuisibles.
Quels sont les défis des grands modèles de vision ?
Ressources computationnelles
L’entraînement et le déploiement de ces modèles nécessitent une puissance de calcul et une mémoire importantes, ce qui peut les rendre gourmands en ressources.
Exigences en matière de données
Ils ont besoin d’ensembles de données vastes et diversifiés pour l’entraînement. La collecte, l’étiquetage et le traitement de ces grands ensembles de données peuvent être difficiles et coûteux. Cependant, les entreprises de crowdsourcing peuvent aider à gérer cela.
Biais et équité
Les modèles peuvent hériter des biais présents dans leurs données d’entraînement, conduisant à des résultats injustes ou contraires à l’éthique, en particulier dans des applications sensibles comme la reconnaissance faciale.
Interprétabilité et explicabilité
Comprendre comment ces modèles prennent des décisions peut être difficile, ce qui concerne les applications où la transparence est critique. Consultez l’IA explicable pour apprendre comment ce processus fonctionne et comment il sert l’éthique de l’IA.
Généralisation
Bien qu’ils obtiennent de bons résultats sur des données similaires à leur ensemble d’entraînement, ils peuvent rencontrer des difficultés avec des types de données complètement nouveaux ou différents.
Préoccupations en matière de confidentialité
L’utilisation de grands modèles visuels, en particulier dans la surveillance et la reconnaissance faciale, soulève d’importantes préoccupations en matière de confidentialité.
Défis réglementaires et éthiques
Garantir que ces modèles respectent les normes juridiques et éthiques est de plus en plus important, d’autant plus qu’ils s’intègrent davantage dans la société.
Méthodologie du benchmark de détection d’objets
Dans ce benchmark, les performances des modèles de détection d’objets YOLOv8n, DETR (DEtection TRansformer) et GPT-4o Vision ont été comparées sur l’ensemble de données de validation COCO 2017. 1000 images par modèle ont été utilisées pour la comparaison. Toutes les images ont été redimensionnées à 800×800 pixels pour garantir des dimensions d’entrée cohérentes entre les modèles.
Le modèle YOLOv8n a été chargé avec des poids pré-entraînés (yolov8n.pt) depuis le dépôt Ultralytics et l’inférence a été réalisée à l’aide de la méthode predict() via l’API YOLO d’Ultralytics. Le modèle DETR a été chargé avec l’architecture detr_resnet50 de la bibliothèque Facebook Research, et ses sorties, initialement normalisées au format [center_x, center_y, width, height], ont été remises à l’échelle et converties au format de coordonnées [x1, y1, x2, y2]. Un seuil de confiance de 0.5 a été appliqué aux résultats des deux modèles.
Le modèle GPT-4o Vision a été évalué à l’aide de l’OpenAI API pour ses capacités de détection d’objets. Pour ce modèle, les images de l’ensemble de données de validation COCO ont été téléchargées, les annotations ont été chargées et chaque image a été convertie au format approprié (redimensionnée à 800×800 pixels) avant d’être envoyée à l’API. Seules les détections appartenant aux classes COCO ont été demandées au format JSON, et les prédictions renvoyées par l’API ont été évaluées en utilisant le même seuil de confiance (0.5) et le même format de coordonnées.
Lors de l’évaluation, les cadres de délimitation prédits par les modèles ont été comparés aux cadres de vérité terrain en calculant l’intersection sur union (IoU), avec IoU ≥ 0.5 considéré comme une correspondance vrai positif. La précision moyenne (AP) a été calculée pour chaque classe, et la moyenne de toutes les classes a été rapportée comme métrique mAP@0.5. Outre la précision, les temps d’inférence ont été mesurés et comparés. De plus, la complexité des modèles a été analysée en fonction des FLOPs et du nombre total de paramètres.
Pour garantir une comparaison équitable, toutes les inférences des modèles ont été réalisées sur le même matériel (GPU/CPU identiques). Les mêmes étapes de prétraitement, à savoir le redimensionnement de toutes les images à 800×800 pixels et l’application de la normalisation nécessaire, ont été appliquées à tous les modèles. Pour le post-traitement, les prédictions ont été converties dans le même format de coordonnées, un seuil de confiance de 0.5 a été appliqué de manière cohérente et des critères uniformes de calcul de l’IoU ont été adoptés lors de l’évaluation.
Dans ce cadre, les modèles YOLOv8n, DETR et GPT-4o Vision ont été comparés en termes de performances et de vitesse de détection d’objets ; des ajustements et des méthodes supplémentaires ont été utilisés pour évaluer les capacités de GPT-4o Vision par rapport aux modèles de détection d’objets actuels.
Conclusion
Les grands modèles de vision (LVMs) changent la façon dont les machines interprètent et agissent sur les données visuelles dans divers domaines, notamment la santé, les systèmes autonomes, la sécurité et les industries créatives.
En s’appuyant sur des architectures avancées, telles que les transformers et les modèles de diffusion, les LVMs prennent en charge un large éventail de tâches complexes, notamment l’imagerie médicale, la détection d’objets en temps réel, la génération texte-image et la génération vidéo.
Leur capacité à apprendre à partir de vastes ensembles de données multimodaux permet des scénarios de déploiement flexibles, allant de l’inférence cloud à l’edge computing, permettant des applications sur mesure allant de l’inspection industrielle à la création de contenu personnalisé.
Cependant, ces capacités s’accompagnent de défis importants. Le coût computationnel de l’entraînement et du déploiement des LVMs reste élevé, nécessitant souvent du matériel puissant et une infrastructure spécialisée.
Des problèmes tels que les biais de données, l’interprétabilité limitée et les préoccupations éthiques liées à la surveillance et à la confidentialité soulignent la nécessité d’une gouvernance rigoureuse des modèles. À mesure que les LVMs continuent d’évoluer, il sera crucial de trouver un équilibre entre innovation et responsabilité pour garantir leur utilisation efficace et équitable dans divers secteurs.
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Comparez les grands modèles de vision: GPT-4o vs YOLOv8n}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/large-vision-models}},
  note   = {AIMultiple. Consulté le 10 juin 2026}
}Résultats et horodatages de 3 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant un fichier CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
11 mises à jourRemplacement des capacités de Midjourney par une description actualisée de la Version 7.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.