


Büyük Dil Model'lerinin Geleceği

Büyük Dil Model'lerinin geleceğini, kendi kendine eğitim, doğruluk kontrolü ve seyrek uzmanlık gibi LLM sınırlamalarını ele alabilecek yaklaşımları karşılaştırarak görün.
Büyük Dil Model'lerinin gelecekteki eğilimleri
1- Canlı Verilerle Gerçek Zamanlı Doğruluk Kontrolü
LLM'ler konuşmalar sırasında eğitim verilerine güvenmek yerine dış kaynaklara erişir. Model dış veritabanlarını sorgular, güncel bilgileri alır ve alıntılar sağlar.
Sınırlama: Hâlâ hatalar yapar. Alıntılar doğruluğu garanti etmez; model'ler bazen kaynakları yanlış aktarır veya alıntılanan içeriği yanlış yorumlar.
Microsoft Copilot: Microsoft ve OpenAI, GPT-6 Astra'nın Copilot Cowork ve Copilot Studio'da, ayrıca Microsoft Foundry ve GitHub Copilot'ta kullanıma sunulduğunu duyurdu. Araştırmacı ajanı, ilk araştırma için GPT'yi, teslimattan önce çıktıları doğruluk ve alıntı kalitesi açısından inceleyen Anthropic'in Claude'u ile birleştirir; bu, bağımsız sistemlere kıyasla DRACO derin araştırma benchmark'ında %13,8'lik bir iyileşmedir.1
- ChatGPT: Son olaylar sorulduğunda web'de arama yapar. Yanıtlarda kaynakları belirtir.
- Perplexity: Özellikle kaynak gösteren arama için geliştirilmiştir. Her yanıt kaynak bağlantıları içerir.
2- Sentetik eğitim verisi
Model'ler, insan etiketli veri gerektirmek yerine kendi eğitim dataset'lerini üretir.
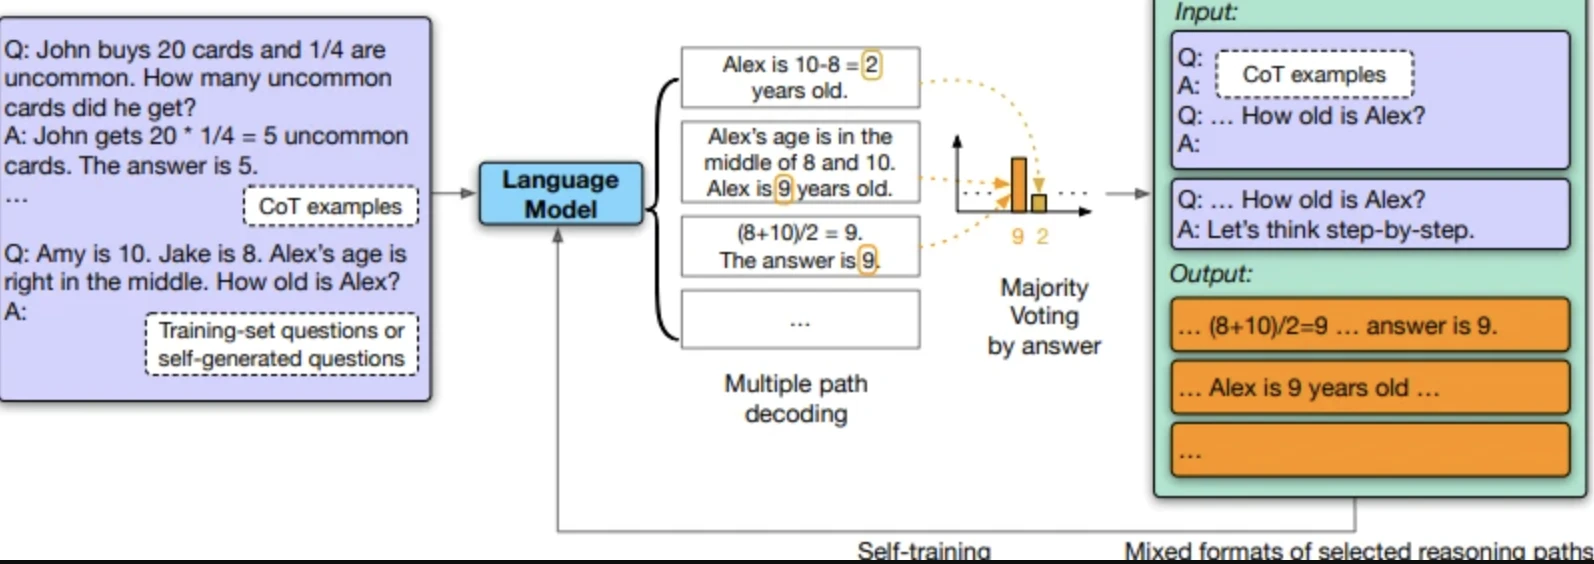
Google'ın kendi kendini geliştiren modeli (2023 araştırması):
- Model sorular oluşturur
- Yanıtları derler
- Üretilen veriler üzerinde kendini fine-tune eder
Performans iyileşti: GSM8K matematik problemlerinde %74,2'den %82,1'e, DROP okuduğunu anlama testinde %78,2'den %83,0'e.
OpenAI, Anthropic ve Google, insan etiketli dataset'leri desteklemek için sentetik veriler kullanıyor. Bu, veri etiketleme maliyetlerini azaltır ancak yeni önyargı riskleri getirir; model'ler kendi hatalarını büyütebilir.
Kaynak: "Büyük Dil Model'leri Kendini Geliştirebilir"
Mart 2026'da yapılan bir anket, yapay zeka araştırmacılarının %76'sının, hesaplama ve veriyi ölçekleme kazanımlarının platoya ulaştığına ve büyük laboratuvarların devasa yatırımlara rağmen azalan getiri bildirdiğine inandığını ortaya koydu. Bu bulgu, LLM kapasitesindeki bir sonraki sıçramanın, mevcut yaklaşımları daha fazla ölçeklemekten ziyade iyileştirilmiş eğitim verimliliği, seyrek mimariler veya akıl yürütme iyileştirmeleri gibi mimari yeniliklerden gelme olasılığının daha yüksek olduğunu göstermektedir.2
3- Seyrek Uzman Model'leri (Uzmanların Karışımı)
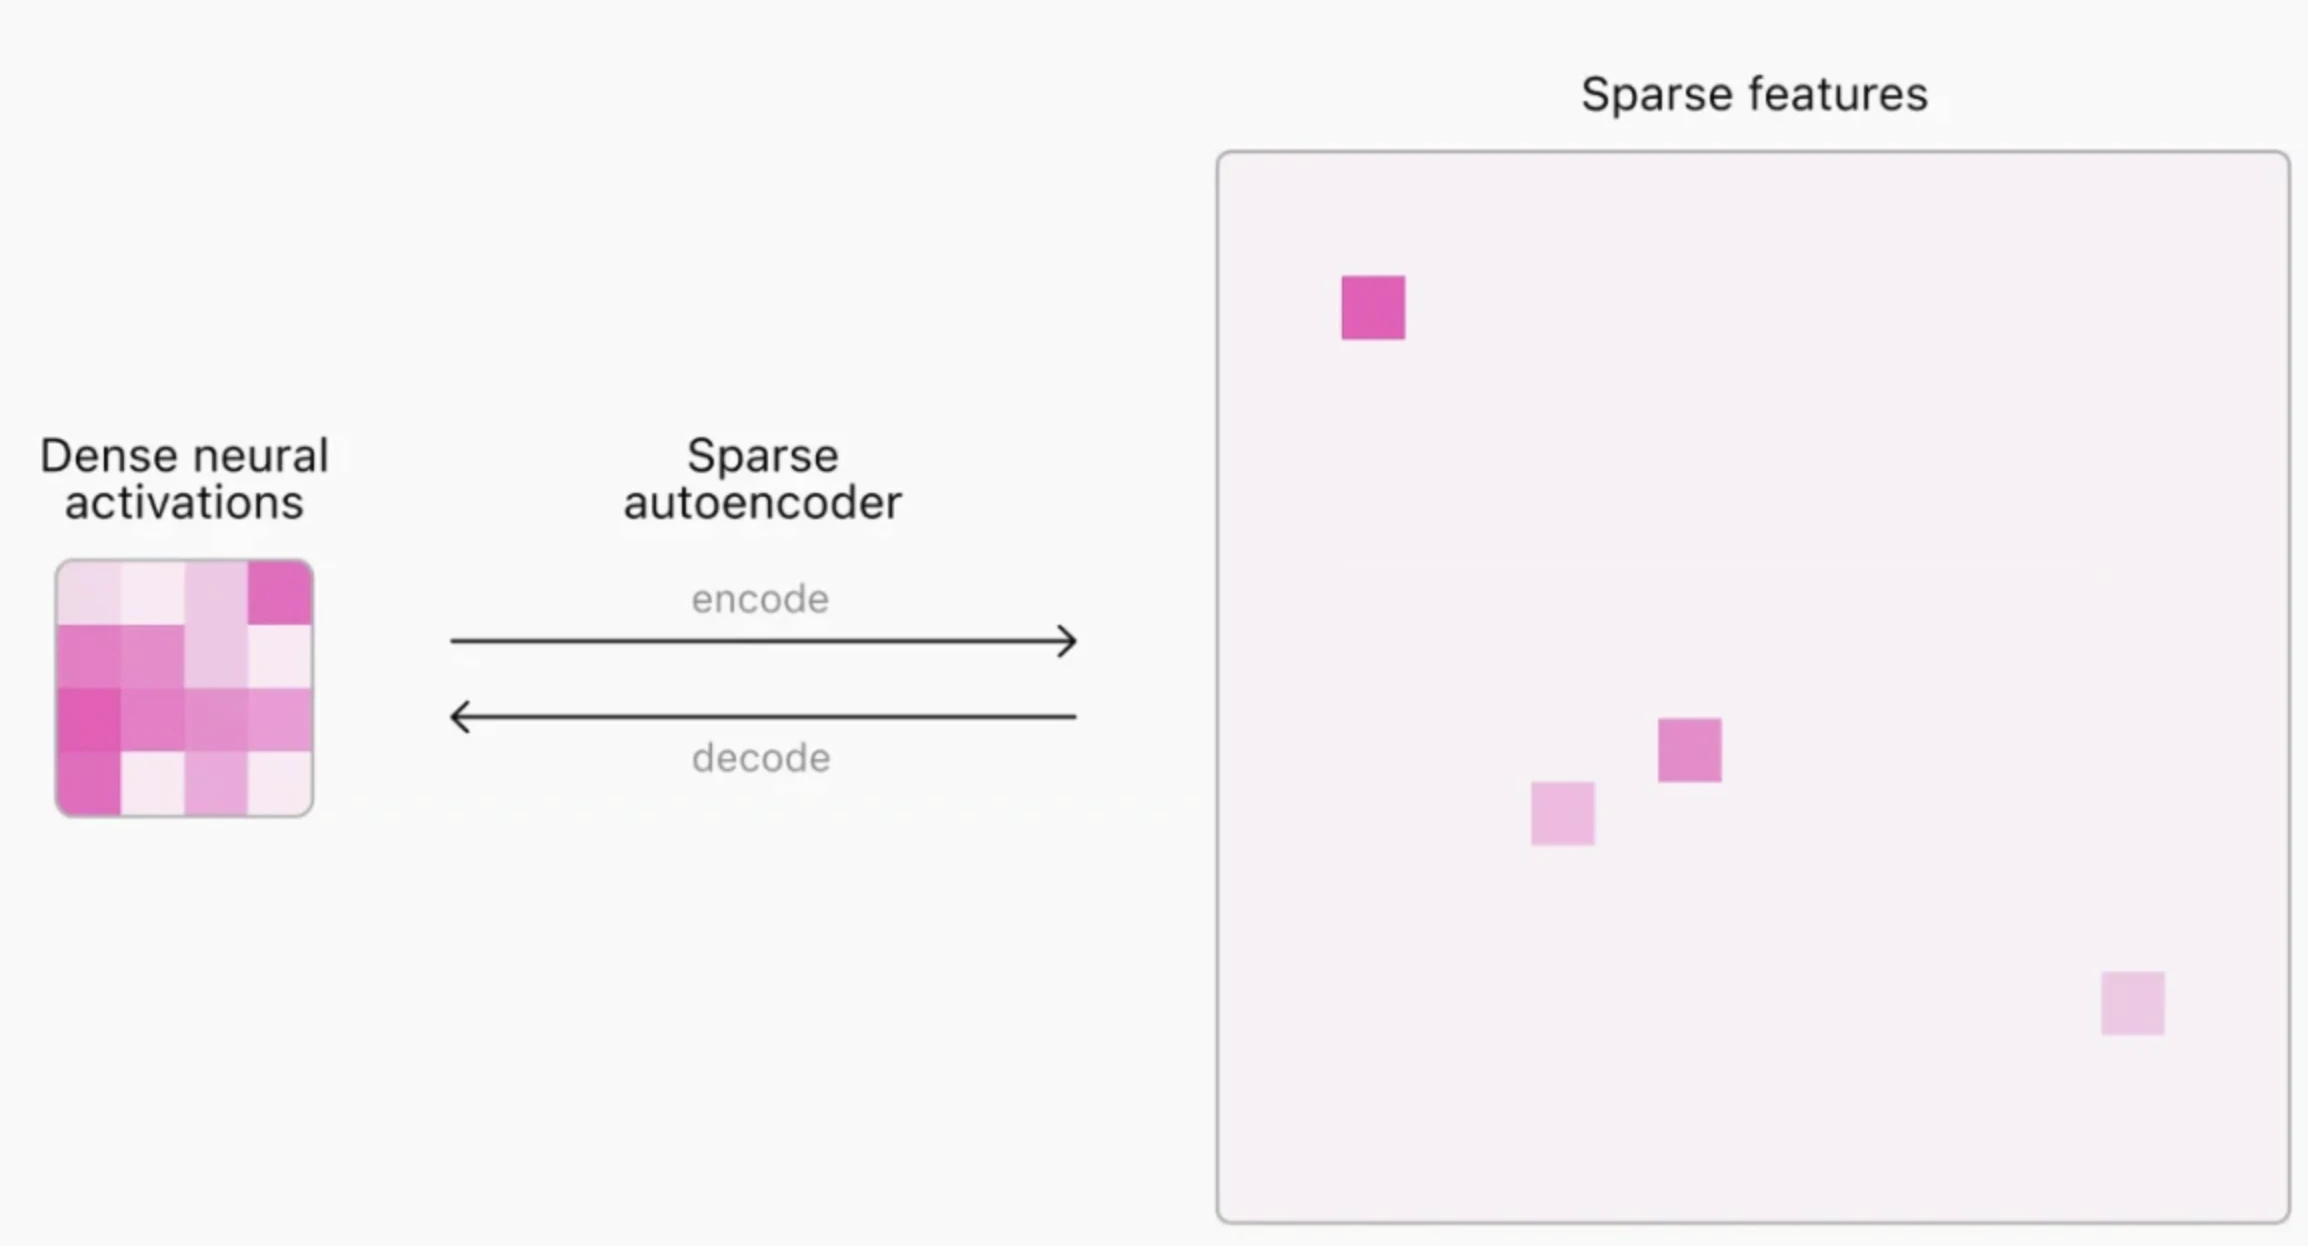
Her girdi için tüm sinir ağını etkinleştirmek yerine, göreve bağlı olarak ilgili parametre alt kümesi etkinleşir. Model, girdiyi ağ içindeki uzmanlaşmış "uzmanlara" yönlendirir. Yalnızca etkinleştirilen uzmanlar sorguyu işler.
Gerçek hayattan örnekler:
- DeepSeek V4-Pro: Toplamda 1.6T parametreye ve 49B aktif parametreye sahip bir Mixture-of-Experts modeli; daha küçük DeepSeek-V4-Flash ise 284B parametre (13B aktif) ile her ikisi de bir milyon token'lık bağlam destekliyor.3
- Qwen3.8-Max (Alibaba): Qwen 3.5 mimarisi üzerine kuruludur; 2.4 trilyon parametreye, 95B aktif parametreye ölçeklenir ve ağırlıklarını Alibaba'nın açık kaynak yapmayı taahhüt ettiği ilk Max sınıfı Qwen modelidir.
- Mistral Devstral 2: Yazılım mühendisliği için özel olarak geliştirilmiştir. 123B parametre, 256K-token bağlam penceresi, SWE-bench'te %72,2.4 Daha küçük bir varyant olan Devstral Small 2 (24B parametre), Apache 2.0 lisansıyla yerel olarak çalışır. Mistral'ın en yeni modeli, 1M bağlam penceresine sahip açık ağırlıklı çok modlu bir MoE modeli olan Mistral Large 4'tür; 6 Ekim 2026'da genel önizlemede kullanıma sunulmuştur ve ağırlıkları bu ay içinde yayınlanacak.
4- Kurumsal İş Akışı Entegrasyonu
LLM'ler bağımsız araçlar olarak kullanılmak yerine doğrudan iş süreçlerine gömülür.
Gerçek hayattan örnekler:
- Salesforce Agentforce (önceki adıyla Einstein Copilot): LLM'leri CRM operasyonlarına entegre eder. Müşteri sorularını yanıtlar, içerik üretir ve Einstein Trust Layer aracılığıyla kuruluşun CRM verilerine ve meta verilerine dayanarak Salesforce içinde eylemler yürütür.5
- Microsoft 365 Copilot: Word, Excel, PowerPoint ve Outlook genelinde gömülüdür. Belgeler taslaklar, elektronik tabloları analiz eder, sunumlar oluşturur ve e-posta zincirlerini özetler; yanıtları kurumsal bağlama dayandırmak için Microsoft Graph aracılığıyla şirket verilerinden yararlanır.6 Araştırmacı ajanı, ilk araştırmayı GPT'nin yürüttüğü ve teslimattan önce çıktıları Claude'un incelediği çoklu model mimarisi kullanır; bu, rakip yapay zeka sağlayıcılarının tek bir kurumsal ürün içinde onaylanmış ilk ticari dağıtımıdır.
- Anthropic Claude for Enterprise: Proje tabanlı bellek ayrımı, ekipler arasında çalışma bağlamlarını ayrı tutar. Claude Opus 4.6, birden fazla Claude ajanının daha büyük görevleri paralel iş akışlarına bölmesine olanak tanıyan ajan ekiplerini sundu ve Claude'u PowerPoint'e yerel bir yan panel olarak entegre etti. Anthropic'in önerisi, çoğu iş yükü için Claude Opus 5.5 ile başlamak ve zorlu akıl yürütme ile uzun ufuklu ajan görevleri için Claude Fable 5.1 kullanmaktır.7
5- Çok modlu yeteneklere sahip hibrit LLM'ler
Büyük çok modlu model'ler; metin, görüntü ve ses gibi birden çok veri biçimini bütünleştirerek farklı medya türlerinde içerik anlamalarını ve üretmelerini sağlar.
- Gemini 3.8 Flash: Google, onu uzun ufuklu yazılım mühendisliği, otonom ajanlar ve karmaşık kurumsal iş akışları için geliştirilmiş en zeki Flash modeli olarak tanımlıyor. Tanıtım fiyatlandırması, 31 Aralık 2026'ya kadar milyon input token başına $0,75 ve milyon output token başına $3,75; 1 Ocak 2027'den itibaren standart fiyatlandırma $1,50 ve $7,50 olacak. Google, eski Gemini 2.5 model'lerini yalnızca daha önce kullanan kullanıcılarla sınırlandırdı ve yeni projeleri 3.5 Flash-Lite veya 3.8 Flash'a yönlendiriyor.8
- Meta Muse Spark 1.3 ve Muse Glimmer: 8 Nisan 2026'da tanıtılan Muse Spark, Meta'nın Llama serisinin yerini aldı. Muse Spark 1.3, 1M-token bağlam penceresine sahiptir ve ağırlıkları kapalıdır; ancak Meta, yol haritasında açık ağırlıklı bir sürüm planladığını belirtiyor.9Açık ağırlıklar için Muse Glimmer, Muse Spark'tan damıtılmış, tüketici donanımında ajan görevleri için tasarlanmış, özel bir algı kodlayıcıya sahip 30 milyar parametreli bir modeldir ve Apache 2.0 lisansıyla yayınlanmıştır.10
Çok modlu yetenek, önde gelen model'lerde standarttır. Geriye kalan zorluk tutarlılıktır: model'ler yaygın görüntü-metin kombinasyonlarında iyi performans gösterir, ancak nadir görsel bağlamlarda, düşük çözünürlüklü girdilerde ve görsel ile metinsel kanıtları birleştirmeyi gerektiren çapraz modlu akıl yürütmede düşer.
6- Akıl yürütme model'leri
Sorunlar üzerinde anında yanıt üretmek yerine adım adım düşünen model'ler.
Tahminden akıl yürütmeye doğru bu geçiş, şunları mümkün kılmak için kritiktir:
- Model'lerin görevleri otonom olarak planladığı, yürüttüğü ve uyarladığı ajan davranışı.
- Çıktıların adım adım ve mantıksal olarak tutarlı olduğu yorumlanabilir yapay zeka.
- Claude 5.5 ailesi ve Fable 5.1 (Anthropic): Dört model de 1M-token bağlam penceresi, 128K maksimum çıktı, uyarlanabilir düşünme ve Haziran 2026 güvenilir bilgi kesme tarihi sunar. Milyon token başına API fiyatlandırması: Fable 5.1 $10 input / $50 output, Opus 5.5 $4 / $20, Sonnet 5.5 $2 / $10 ve Haiku 5.5 100.000 token'a kadar prompt'lar için $0,10 / $0,50 şeklindedir.11
- GPT-6 Astra (OpenAI): Standart API fiyatlandırması milyon input token başına $10 ve milyon output token başına $50'dir; Hızlı mod, 2x fiyatla 2x'e kadar daha hızlı çalışır.12
7- Alana Özgü Fine-Tune Edilmiş Model'ler
Genel amaçlı eğitim yerine belirli sektörler için özel veriler üzerinde eğitilen model'ler.
Google, Microsoft ve Meta, genel amaçlı sunumlarına ek olarak kuruma özgü kullanım durumlarını hedefleyen önemli tescilli alana özgü ve fine-tune edilmiş model'ler yayımladı.
Bu uzmanlaşmış LLM'ler; alana özgü ön eğitim, model hizalaması ve denetimli fine-tuning'den yararlanarak daha az halüsinasyon ve daha yüksek doğruluk sağlayabilir.
GitHub Copilot: Kod depoları üzerinde fine-tune edilmiştir. Temmuz 2025 itibarıyla 20 milyon geliştirici GitHub Copilot kullanıyor; bu, bir önceki yıla göre %400 artış anlamına geliyor ve Fortune 100 şirketlerinin %90'ı bunu kullanıyor. Kodu otomatik tamamlar, fonksiyonlar üretir ve hata düzeltmeleri önerir.13
BloombergGPT: Bloomberg finansal belgelerinden oluşan 363 milyar token'lık bir dataset üzerinde eğitilmiş 50 milyar parametreli LLM; duygu analizi, varlık adı tanıma ve soru yanıtlama dahil finansal NLP benchmark'larında karşılaştırılabilir boyuttaki model'lerden daha iyi performans gösterir.14
Google'ın Med-PaLM 2: Tıbbi dataset'ler üzerinde fine-tune edilmiştir; ABD Tıbbi Lisans Sınavı (USMLE) tarzı sorularda %85+ doğruluk elde etmiştir ve bu benchmark'ta uzman düzeyinde performansa ulaşan ilk LLM olmuştur. Google Cloud'un sağlık hizmetleri temel model'leri ailesine güç verir.15
ChatLAW: Çin hukuku alanındaki dataset'ler üzerinde özel olarak eğitilmiş açık kaynaklı bir dil modelidir.16
8- Etik yapay zeka ve önyargı azaltma
- Anthropic ve OpenAI 2025 ortasında karşılıklı bir hizalama değerlendirmesi yürüterek birbirlerinin genel kullanıma açık model'lerini dalkavukluk, ihbar eğilimleri ve kendini koruma davranışları açısından test etti. Çalışma, test edilen tüm model'lerde dalkavukluk buldu; buna sanrısal inançlar sergileyen simüle edilmiş kullanıcıların zararlı kararlarını onaylayan model'ler de dahildir. Anthropic daha sonra bu davranışı yeni model'lerde benchmark etmek için özel olarak Bloom test framework'ünü geliştirdi.
- Anthropic ayrıca, büyük işletim sistemlerindeki ve web tarayıcılarındaki siber güvenlik açıklarını bulmak ve düzeltmek için özel olarak küçük bir kuruluş grubunun kullanımına sunulan, yalnızca davetle erişilebilen bir model olan Claude Mythos Preview'ı (Project Glasswing) yayımladı. Anthropic, bu modeli genel kullanıma sunmayı planlamadığını belirtti. Kontrollü erişim yaklaşımı, risk profilinin kısıtlı dağıtım gerektirdiği durumlarda yüksek yetenekli uzman model'lerin dağıtımı için yeni bir framework temsil eder. Anthropic'in API fiyatlandırma sayfası ayrıca ek model'leri arasında Claude Mythos 5.1'i de listeler; fiyatı milyon token başına $10 input / $50 output'tur.
- Google DeepMind: Yapay zeka ajanlarının gündeme getirdiği değer hizalaması, manipülasyon riskleri, insan biçimcilik, gizlilik ve eşitlik gibi etik ve toplumsal soruların ilk sistematik incelemesini sunan "The Ethics of Advanced AI Assistants" başlıklı çalışmayı yayımladı. Şirketin Responsible AI değerlendirmesi, 350'den fazla çekişmeli kırmızı takım egzersizini içerdi ve zararlı manipülasyon için özel olarak yeni bir Kritik Yetenek Düzeyi getirerek bunu siber saldırılar ve KBRN tehditleriyle birlikte frontier düzeyinde bir risk olarak ele aldı.
Büyük Dil Model'lerinin sınırlamaları (LLM'ler)
1- Halüsinasyonlar
Model'ler kulağa makul gelen ancak yanlış bilgiler üretir.
Vectara halüsinasyon liderlik tablosu, sektörde en yaygın şekilde referans gösterilen temellendirilmiş özetleme benchmark'ıdır. Orijinal Vectara dataset'inde, Google'ın Gemini model'leri sürekli olarak en üst sıralarda yer alır; Gemini Flash varyantları %1'in altında halüsinasyon oranlarına ulaşır. OpenAI'nin GPT ailesi %0,8 ile %2,0 arasında kümelenir.
Vectara, 2025 sonlarında önemli ölçüde daha zorlu bir benchmark başlattı: 7.700 makale (1.000'den fazla), 32K token'a kadar daha uzun belgeler ve hukuk, tıp, finans ile teknolojiyi kapsayan içerik. Yeni dataset üzerindeki bulgular sezgisel olmayan bir örüntüyü ortaya koyuyor: Karmaşık görevlerde üstün olan akıl yürüten ve düşünen model'ler, temellendirilmiş özetlemede daha küçük ve daha hızlı model'lerden sıklıkla daha fazla halüsinasyon üretiyor. Düşünme sınıfındaki çoğu model, daha zor dataset'te %10'un üzerinde halüsinasyon oranları gösterirken; Gemini Flash varyantları gibi daha hafif model'ler daha düşük oranları koruyor.17
Not: Hiçbir tek başına benchmark, herhangi bir model için kesin bir "halüsinasyon oranı" vermez. Sorumlu bir değerlendirme, farklı şeyleri ölçen az iki benchmark'a çapraz referans verir: biri temellendirilmiş görev (Vectara), biri açık uçlu bilgi görevi ve tam model sürümü ile çağrı koşullarını belirtir.
Tüm model'ler halüsinasyon üretir. Sıklık, standart benchmark'larda en iyi performans gösterenler için 2021'de yaklaşık %21'den %5'in altına önemli ölçüde düştü, ancak ortadan kalkmadı. Kritik uygulamalar hâlâ insan doğrulaması gerektirir.
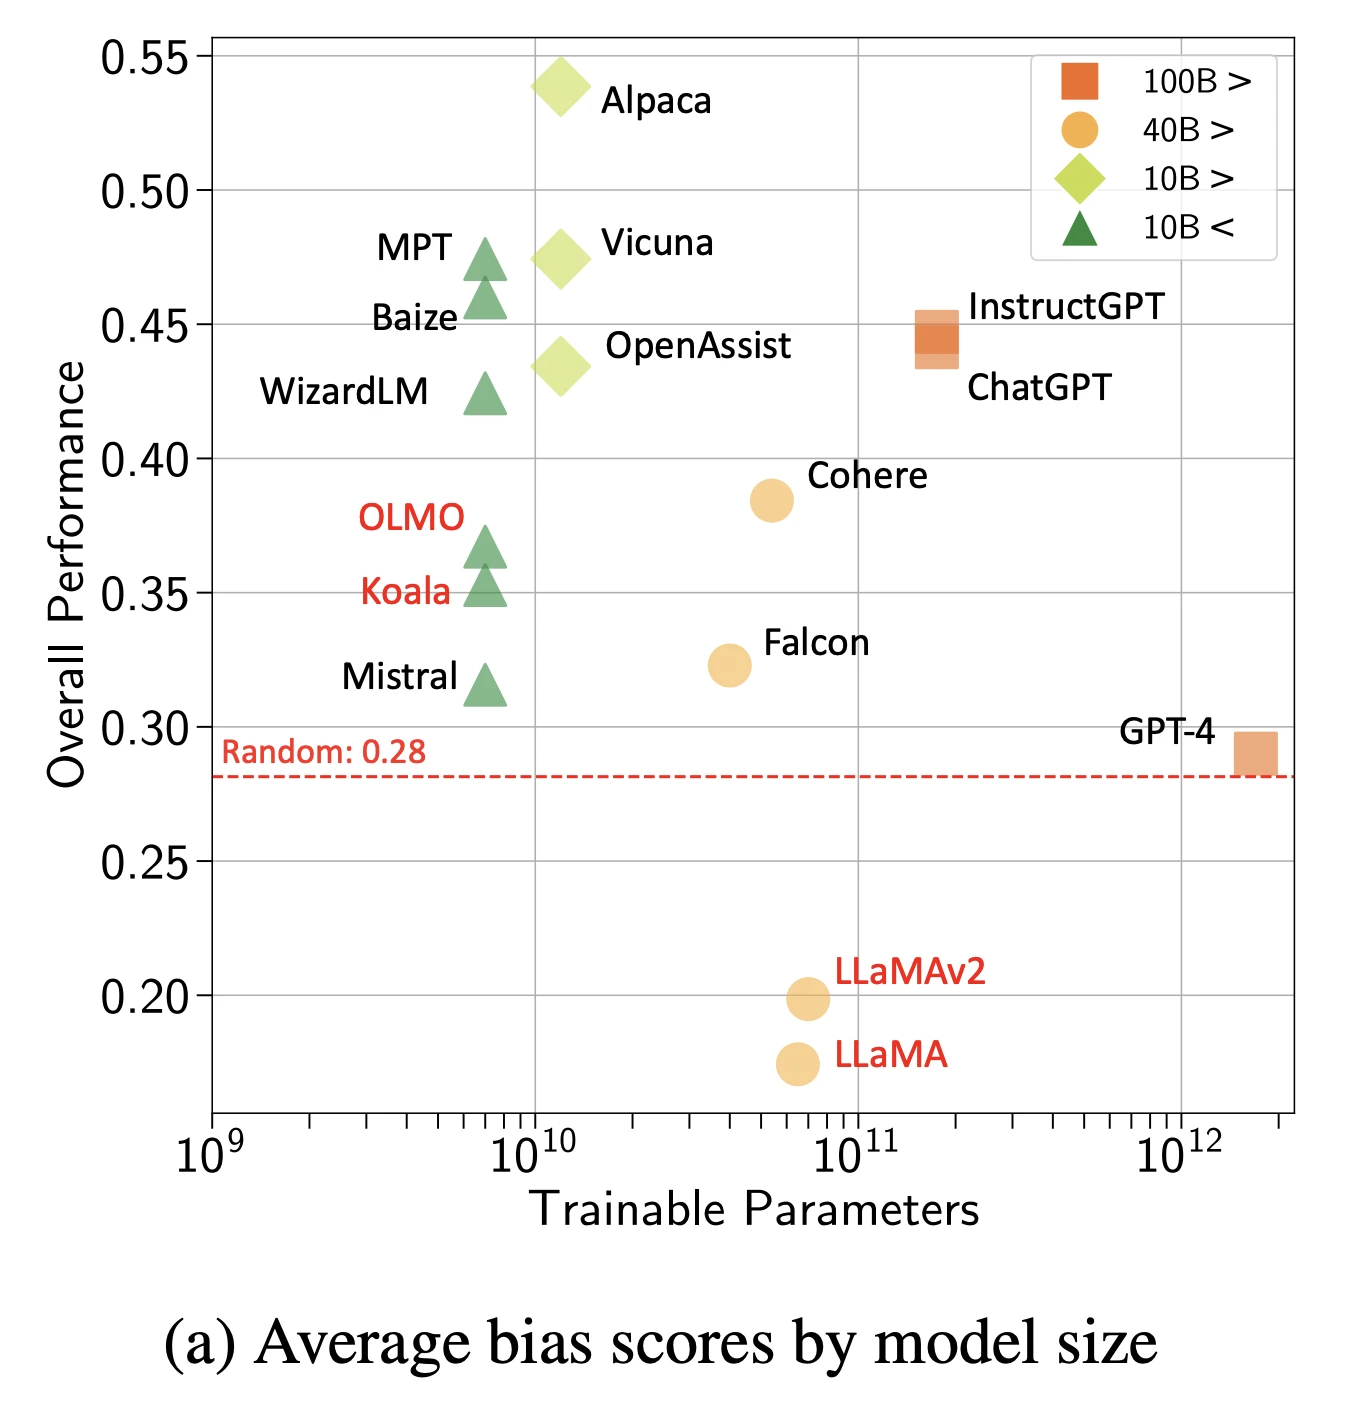
2- Önyargı
Model'ler eğitim verilerindeki toplumsal önyargıları emer ve büyütür.
Kaynak: Model'lere ve boyuta göre genel önyargı puanları.18
Gözlemlenen önyargı türleri:
- Meslek önerilerinde cinsiyet önyargısı
- Özgeçmiş tarama simülasyonlarında ırksal önyargı
- Sağlık önerilerinde yaş önyargısı
- Eğitim içeriğinde sosyoekonomik önyargı
3- Toksisite
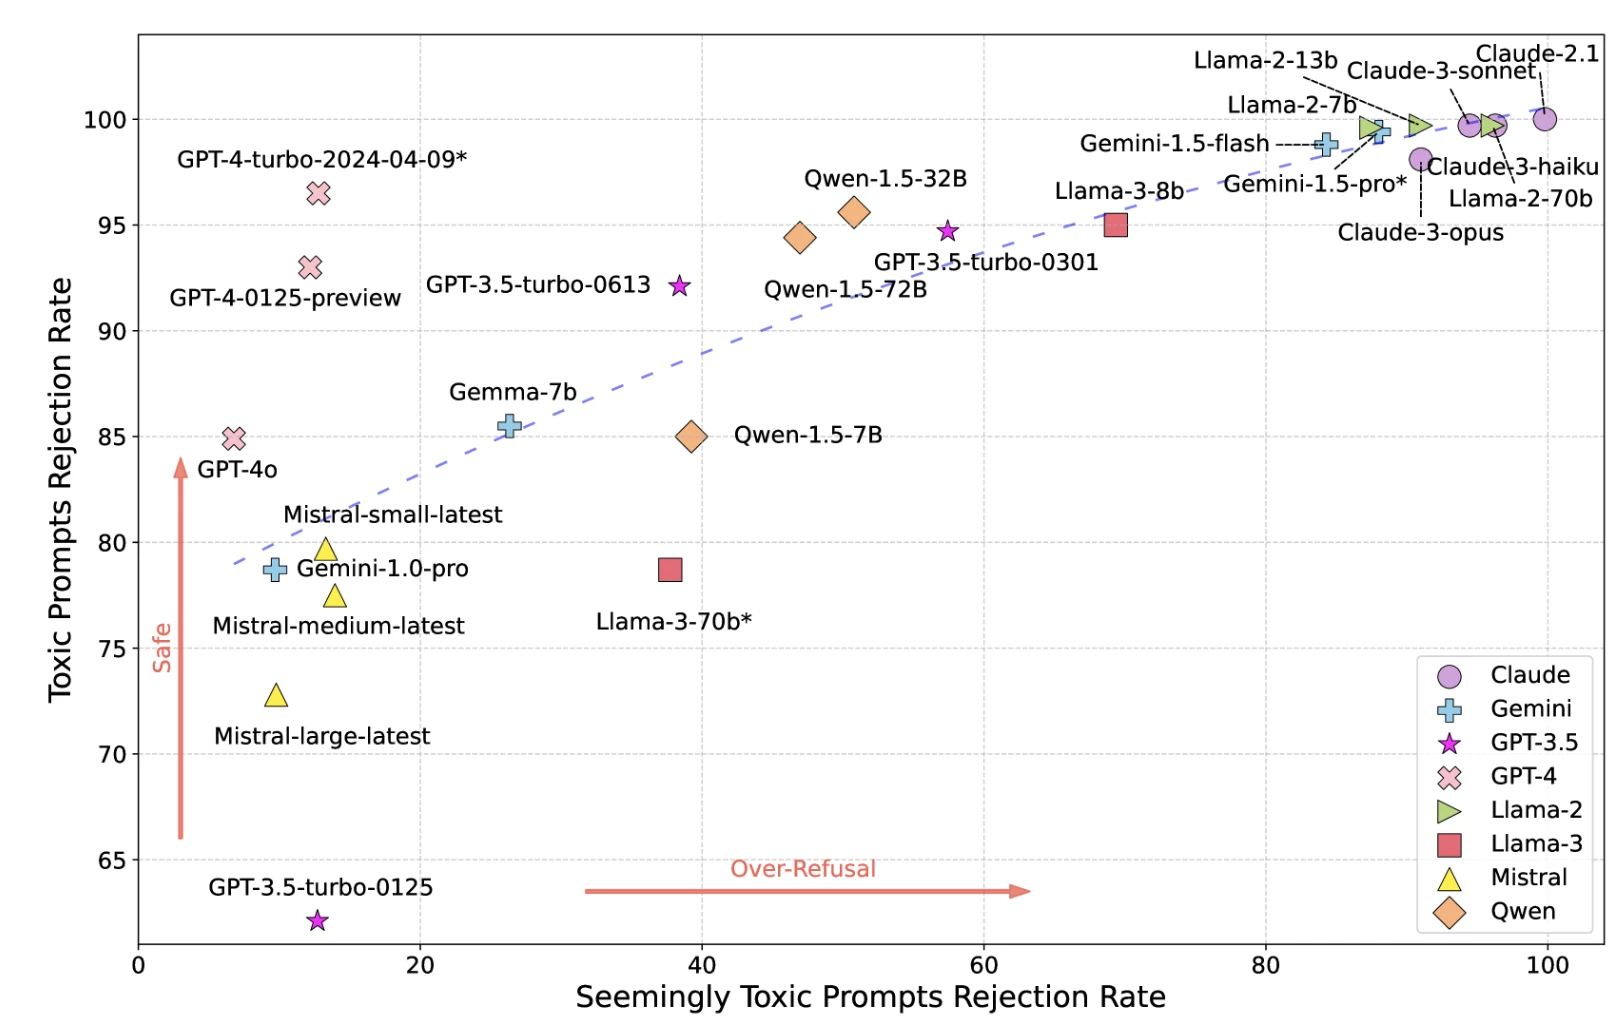
Model'ler güvenlik önlemlerine rağmen zararlı, saldırgan veya toksik içerik üretebilir.
Kaynak: UCLA, UC Berkeley araştırmacılarından LLM'lerin toksisite haritası19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* ve Gemini-1.5-pro* moderatör olarak kullanıldığından sonuçlar bu 3 model üzerinde önyargılı olabilir.
Sıkı güvenlik önlemleri toksisiteyi azaltır, ancak yanlış pozitifleri artırır (zararsız istekleri reddetme). Gevşek önlemler toksisitenin geçmesine izin verir.
4- Bağlam Penceresi Sınırlamaları
Her modelin tek bir oturumda işleyebileceği token sayısı olan sabit bir bellek kapasitesi vardır. Bu sınırı aşarsanız model ya önceki içeriği keser ya da isteği reddeder. Model'ler arasındaki pratik fark, gerçek iş yükleri için önemli olacak kadar geniştir.
- Llama 4 Scout (Meta): 10M token'lık bağlam penceresi, büyük açık ağırlıklı sürümler arasındaki en geniş bağlam penceresidir. Meta o zamandan beri frontier çalışmalarını Muse serisine taşıdığı için Scout artık güncellenmemektedir.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1: Dördünde de 1M-token bağlam penceresi ve 128K maksimum çıktı bulunur. Claude 4.6 ve sonraki model'ler (Haiku 5.5 hariç) standart ücretlerle tam 1M pencereyi faturalandırır.
- GPT-6.1 Sol: 1.050.000-token bağlam penceresi. OpenAI, amiral gemisi model'lerinde uzun bağlamlı istekler için daha yüksek ücretler alır.20
- Gemini 4 Argon: Google, çıktı token sınırını 64K'den 1M token'a yükseltti.21
- DeepSeek V4.1 Flash ve V4-Pro: 1M bağlam, 384K'ya kadar çıktı.22
Geniş bir bağlam penceresi, bu pencere boyunca otomatik olarak daha iyi performans anlamına gelmez. Çoğu modelde hatırlama, uzun bağlamların ortasına doğru düşer ve maliyetler girdi uzunluğuyla ölçeklenir; aynı model üzerinde 1M token işlemek, 10K token işlemekten önemli ölçüde daha maliyetlidir. Çoğu üretim iş yükü için pratik soru, hangi modelin en geniş pencereye sahip olduğu değil; kullanım senaryonuzun gerçekten gerektirdiği bağlam uzunluklarında hangi modelin güvenilir şekilde getirme yaptığıdır.
5- Statik Bilgi Kesme Tarihi
Model'ler belirli bir kesme tarihine sahip önceden eğitilmiş bilgiye dayanır. Dış kaynaklara bağlanmadıkça eğitimden sonraki bilgilere erişemezler.
Sorunlar:
- Güncel olaylar hakkında güncelliğini yitirmiş bilgiler
- Son gelişmeleri ele alamama
- Dinamik alanlarda (teknoloji, finans, tıp) daha az ilgililik
Çözüm: Web araması entegrasyonu. ChatGPT, Claude ve Perplexity gerçek zamanlı arama sunar. Ancak arama halüsinasyonları ortadan kaldırmaz; model'ler bazen arama sonuçlarını yanlış yorumlar.
Başlıca LLM Platformları
GPT-6
GPT-6 Astra, 4 Eylül 2026'da genel kullanıma sunuldu; GPT-6 Sol ve GPT-6 Luna, 22 Eylül 2026'da onu izledi.
En büyük iyileştirmeleri kodlama, bilgisayar kullanımı, bilimsel akıl yürütme ve siber güvenlik alanlarındadır; zorlu problem çözme benchmark'larında özellikle büyük kazanımlar elde etmiştir. Ayrıca talimatları daha güvenilir şekilde izler ve daha az hata yapar.
GPT-6.1 Sol, ChatGPT Work ve Codex aracılığıyla Plus, Pro, Business, Enterprise ve Edu kullanıcılarına sunulmuştur; ancak normal ChatGPT görüşmelerinde henüz mevcut değildir. Geliştiriciler buna gpt-6.1-sol olarak erişir.
API fiyatlandırması (standart, milyon token başına): gpt-6-astra $10 input / $50 output; gpt-6.1-sol $2 / $10; gpt-6-luna $0,10 / $0.50.
Sınırlamalar: Astra, bu listedeki en yüksek taban fiyatı Claude Fable 5.1 ile paylaşır; milyon token başına $10/$50. OpenAI, Astra'nın Hazırlık Framework'ü kapsamında Kritik siber güvenlik eşiğini karşıladığını söylüyor ve lansman sürümü, kavram kanıtı exploit'leri yazmak gibi ileri siber görevleri reddediyor. Hâlâ halüsinasyon üretir ve eğitim kesme tarihinden sonraki her şey için web aramasına ihtiyaç duyar.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
Anthropic, Fable 5.1'i zorlu akıl yürütme ve uzun ufuklu ajan görevleri için, Opus 5.5'i uzun süreli ajan kodlama ve bilgi çalışmaları için, Sonnet 5.5'i hız-zekâ dengesi olarak ve Haiku 5.5'i sınıflandırma ve yönlendirme gibi yüksek hacimli, gecikmeye duyarlı görevler için konumlandırır.
Milyon token başına fiyatlandırma: Fable 5.1 $10/$50, Opus 5.5 $4/$20, Sonnet 5.5 $2/$10, Haiku 5.5 $0,10/$0,50'den başlar.
Sınırlamalar: Claude 4.7 ve sonraki model'ler aynı metin için yaklaşık %30 daha fazla token üreten daha yeni bir tokenizer kullanır; bu da liste fiyatlarına kıyasla efektif maliyeti artırır.
Gemini 3.8 Flash / Gemini 4 Argon
Google, karmaşık kodlama, otonom iş akışları ve akıl yürütmeye odaklanan daha hızlı, düşük maliyetli bir model olan Gemini 3.8 Flash'ı, uzmanlaşmış bir siber güvenlik modeli olan Flash Cyber ile birlikte tanıttı.
Flash, HLE-Verified'da %54,9 puan alır ve 2026 sonuna kadar milyon input token başına $0,75 ve milyon output token başına $3,75 tutarındadır; ancak karmaşık görevler daha fazla token tüketebilir.
Flash Cyber, Google'ın dahili güvenlik açığı keşfetme benchmark'ında %70'in üzerinde ve harici bir yama benchmark'ında %47,2 başarı elde eder; erişim güvenilir savunucularla sınırlandırılmıştır.
Fiyatlandırma: milyon input token başına $0,75 ve milyon output token başına $3,75 şeklindedir.23
Google'ın Gemini 4 Argon modeli, yazılım mühendisliği, finans, hukuk ve siber güvenlik alanlarındaki karmaşık, uzun süreli görevlere odaklanır. 1 milyon output token'a kadar destekler, DeepSWE'de %77,9 ve AutomationBench'te %51,3 puan alır ve güvenlik açıklarını otonom olarak keşfedip yamalayabilir. Google, onu dahili olarak büyük ölçekli kod taşımaları ve veri merkezi optimizasyonları için kullandığını bildiriyor.
Fiyatlandırma, milyon input token başına $2 ve milyon output token başına $10 ile başlar; tanıtım döneminden sonra iki katına çıkar. Erişim şu anda güvenilir test kullanıcıları ve siber güvenlik savunucularıyla sınırlıdır.21
Meta Muse Spark 1.3 / Muse Glimmer
Meta'nın Muse Spark 1.3 modeli, uzun ve karmaşık iş akışları ile kodlama görevleri için yapay zeka ajanlarını geliştirmeye odaklanır. Meta'nın dahili mühendislik testleri, sürüm 1.2 ile karşılaştırıldığında kodlama görevleri için %20 daha az araç çağrısı ve %25 daha az token gösteriyor. Meta ayrıca prompt enjeksiyonlarına karşı daha iyi direnç ve geri alınamaz eylemler konusunda daha iyi muhakeme bildiriyor.
Model, Muse Code ve Meta Model API aracılığıyla kullanılabilir; açık ağırlıkların gelecekteki bir sürümde yayınlanması planlanıyor.24
Açık ağırlıklar: Muse Glimmer, Apache 2.0 lisanslı, tek bir GPU üzerinde çalışan ve araç kullanımı, uzun görevler ve hata kurtarma için ayarlanmış 30B parametreli açık bir modeldir.
Kimler kullanıyor: Muse Spark, Meta'nın ekosisteminde halihazırda bulunan ve API erişimi isteyen ekipler için uygundur. Muse Glimmer, şirket içi ve yerel dağıtımlar ile satıcıya bağımlılıktan kaçınan geliştiriciler için uygundur.
Sınırlamalar: Muse Spark'ın ağırlıkları kapalıdır. Llama 4 model'leri indirilebilir durumda kalmaya devam ediyor ancak artık Meta'nın frontier serisi değildir.
DeepSeek V4
V4-Pro, toplamda 1.6T parametreye ve 49B aktif parametreye sahip, bir milyon token'lık bağlama sahip bir Mixture-of-Experts modelidir.
10 Eylül 2026'da DeepSeek, mimari ailesindeki en küçük model olan ve yerel çok modlu görsel anlama özelliğine sahip V4.1-Flash'ı yayımladı. V4.1 Flash görüntüyü destekler, ancak V4-Pro desteklemez.25
API fiyatlandırması (milyon token başına, yoğun saatler): V4.1 Flash $0,30 input (cache miss) ve $1,20 output tutarındadır; V4-Pro $1,32 input ve $3,96 output tutarındadır. Yoğun saatler dışındaki ücretler, yoğun saat ücretlerinin yarısıdır.22
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Büyük Dil Model'lerinin Geleceği}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Erişim tarihi: 25 Haziran 2026}
}
Değişiklik günlüğü
12 güncellemePopüler LLM'ler için halüsinasyon karşılaştırma grafiği kaldırıldı.
Test edilen modelleri ve puanlamayı ayrıntılı olarak açıklayan bir kıyaslama metodolojisi bölümü eklendi.
GPT-5.2, Gemini 3.1 Pro ve DeepSeek V3.2 yerine GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 ve Claude Opus 4.7 eklendi.
Güncellendi 'Domain-Specific Fine-Tuned Models' bölümündeki 'Gerçek hayat örnekleri' verileri.
Gelecekteki büyük dil modelleri eğilimleri bölümü, yeni gerçek zamanlı doğrulama örnekleriyle güncellendi.
Referans Linkleri

Daha önce proje yönetimi ve danışmanlık firmalarında işe alım uzmanı olarak çalıştı. Sıla, Sosyal Psikoloji alanında yüksek lisans derecesine ve Uluslararası İlişkiler alanında lisans derecesine sahiptir.




Yorumlar 1
Düşüncelerinizi Paylaşın
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.