


Büyük Multimodal Model'ler (LMM'ler) vs LLM'ler

LLM'leri ve LMM'leri, aşağıdaki tabloda model'in adına tıklayarak benchmark skorlarını ve gerçek dünyadaki gecikme sürelerini karşılaştırarak değerlendirin. Ayrıca genel verimliliği ve değeri yargılamak için girdi ve çıktı fiyatlandırmalarını da tartabilirsiniz.
Açık ağırlıklı büyük multimodal model'ler
*Ses yalnızca E2B, E4B ve 12B model'lerinde yerleşiktir.
Gemma 4 (Google DeepMind)
Beş boyutta mevcuttur: E2B, E4B, 12B, 26B A4B ve 31B. Aile; tüm model'lerde değişken en boy oranları ve çözünürlüklerle metni ve görüntüleri işler. Ayrıca video ve sesi destekler; ses, E2B, E4B ve 12B model'lerinde yerleşik olarak bulunur.1
12B varyantı mimari açıdan en dikkat çekici olanıdır. Google görüntü encoder'ını hafif bir embedding modülüyle değiştirdi ve ses encoder'ını tamamen kaldırarak ham ses sinyalini metin token'larıyla aynı boyutsal uzaya yansıttı. Pipeline'da hiçbir multimodal encoder olmadan gecikme düşer ve model, GPU'sunda 16GB belleğe sahip bir dizüstü bilgisayarda çalışacak kadar küçülür.
Kimi K3 (Moonshot AI)
Kimi Delta Attention ve Attention Residuals üzerine inşa edilmiş 2.8T parametreli bir model'dir; yerleşik görüntü yeteneklerine ve 1 milyon token'lık bağlam penceresine sahiptir. Moonshot, onu 3 trilyon parametre sınıfındaki ilk açık model olarak tanımlıyor.
Görüntü encoder'ı MoonViT-V2, model'in sonraki token tahmini hedefi aracılığıyla sıfırdan eğitildi ve SigLIP gibi kontrastif olarak önceden eğitilmiş bir görüntü model'inden başlatılmadı.2
MiniMax M3
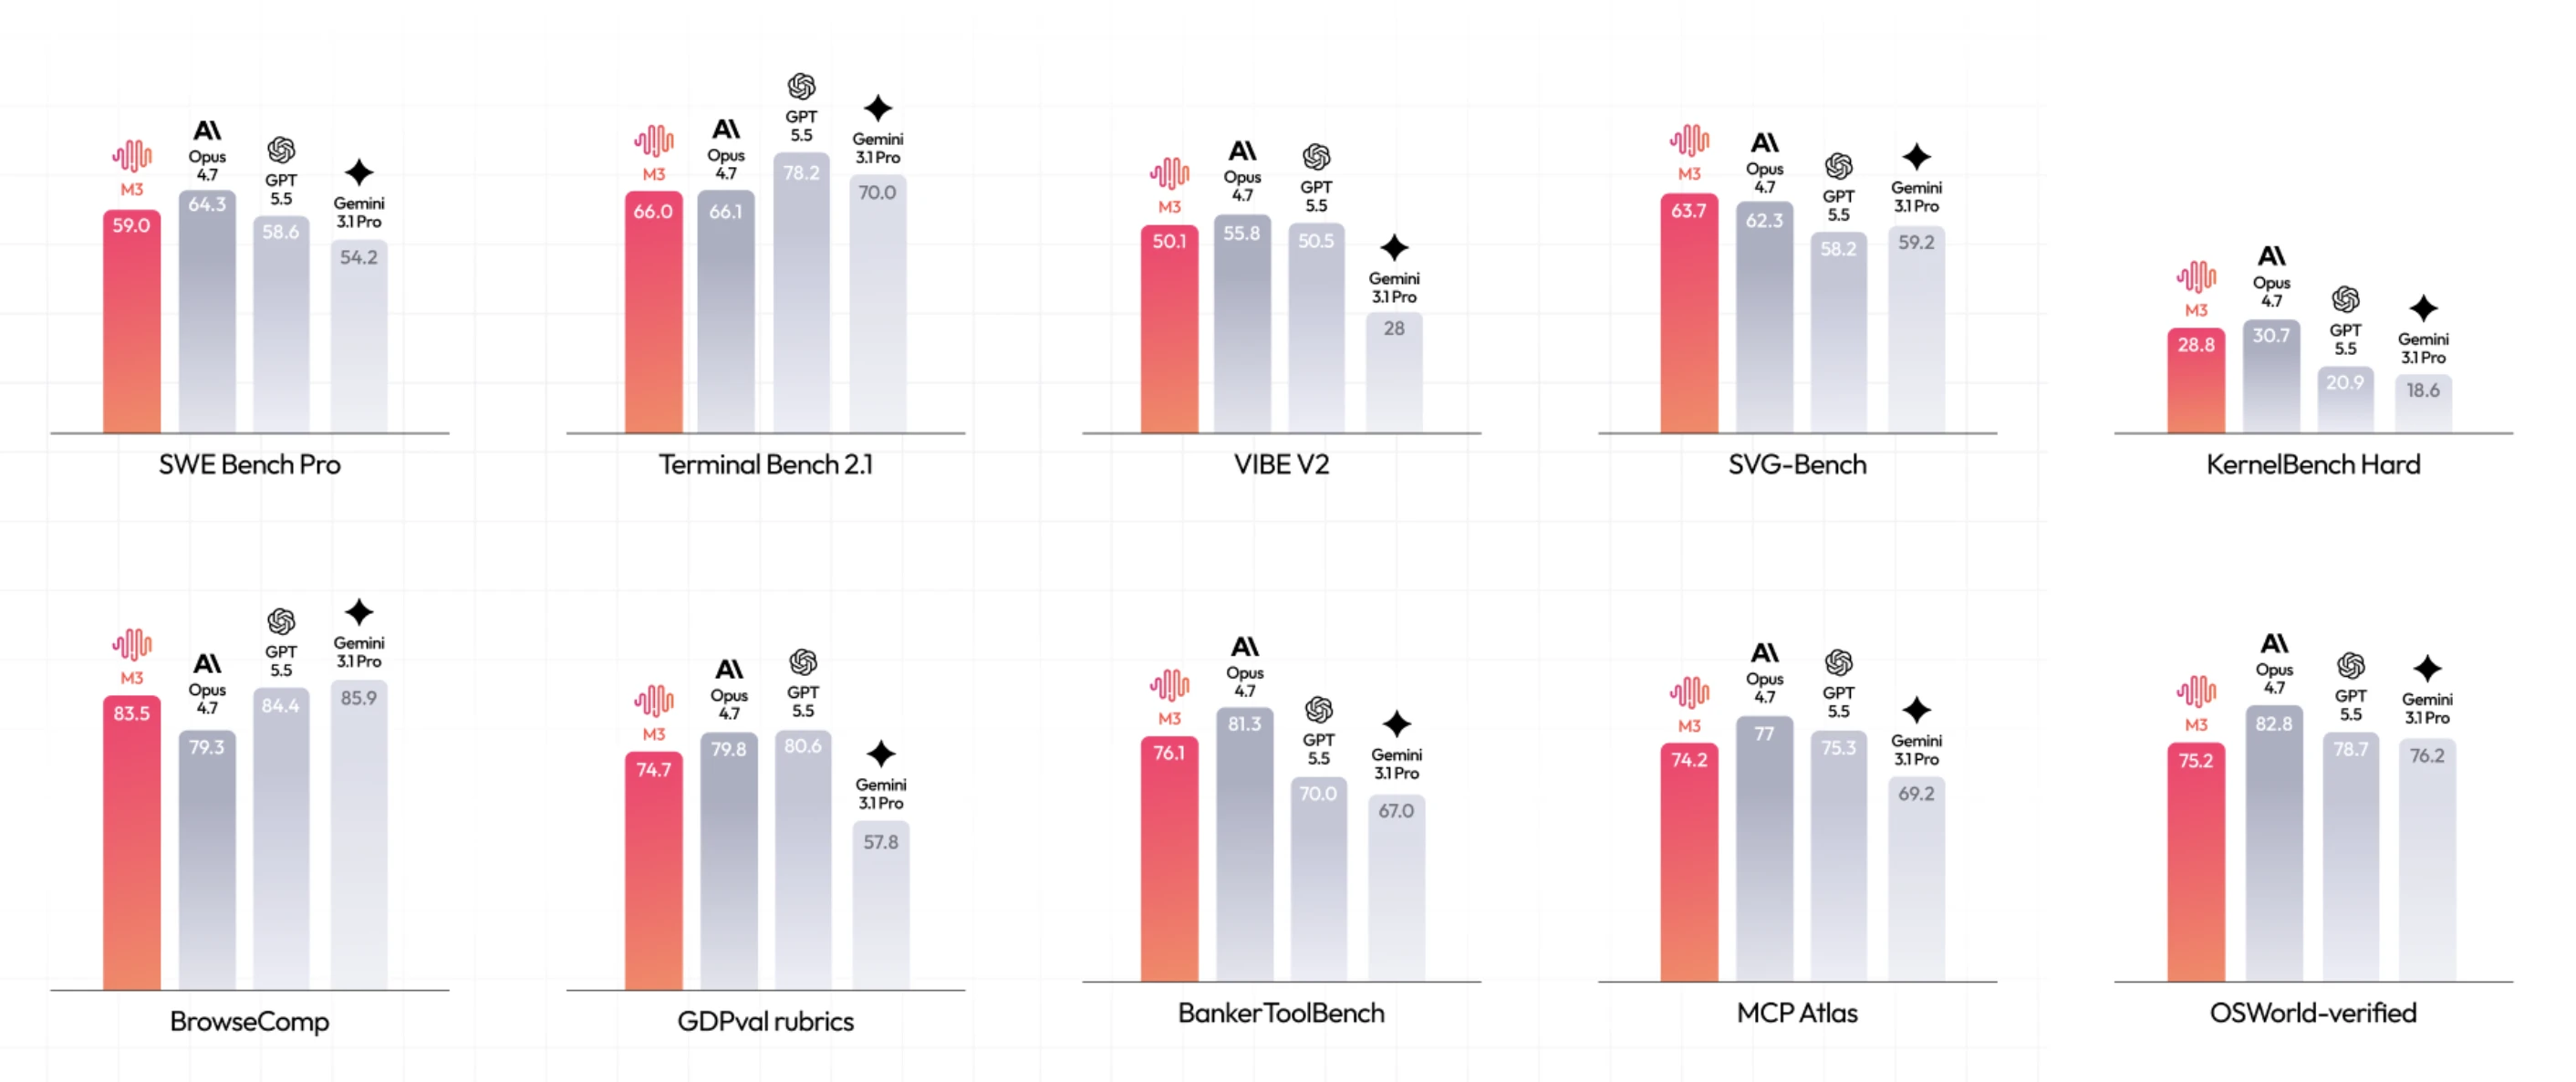
Yaklaşık 428B parametreye ve 23B aktif parametreye sahip, karma modaliteler (metin, görüntü ve video) üzerinde eğitilmiş doğal multimodal bir model'dir. MiniMax, onu tek bir sistemde uç kodlama performansını, 1M token'lık bağlam penceresini ve doğal multimodaliteyi birleştiren ilk açık ağırlıklı model olarak sunuyor. Ayrıca ekran görüntülerinden bir masaüstü bilgisayarı çalıştırabiliyor.
Şekil 1: Minimax M3 benchmark sonuçları.3
GLM-5.3-Flash (Z.ai)
GLM-5 serisindeki ilk doğal multimodal model'dir; toplam 320B parametreye ve 18B aktif parametreye sahip olup seyrek ile doğrusal dikkati birleştiren ilk açık kaynaklı uç model'dir.
Z.ai, hibrit tasarımın dikkat hesaplamasını ve KV önbelleğini GLM-5.3'e kıyasla 3.01x ve 4.44x azalttığını bildiriyor.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash, DeepSeek mimari ailesindeki en küçük model'dir ve seride doğal görsel anlamayı destekleyen ilk model'dir.
Girdi için sekiz milyar, çıktı için 16 milyar aktif parametre kullanan, Causal Encoder-Decoder mimarisine sahip 552 milyar parametreli bir Mixture of Experts tasarımı kullanır. Hem V4 Flash'ı hem de deneysel V4 Flash Vision Exp'i değiştirdi; bu model adları artık uyumluluk için yeni endpoint'e yönlendiriliyor.5
Tescilli büyük multimodal model'ler
GPT-6 Astra (OpenAI)
OpenAI, Astra'yı bilgisayar kullanımı, tarama, yazılım mühendisliği, siber güvenlik, bilim ve profesyonel işlerde son teknoloji olarak konumlandırıyor; FrontierMath Tier 4'te %98 ve ARC-AGI-3'te %99,9 skor elde ediyor.6
Şirketin Hazırlık Çerçevesi kapsamında siber güvenlik yeteneğinin Kritik düzeyine ulaşan ilk model'dir ve herkese açık sürüm bu nedenle gelişmiş siber çalışmaları reddeder. Model, metin ve görüntüleri kabul eder ve metin döndürür.
Gemini Omni (Google DeepMind)
Gemini Omni, Google'ın doğal olarak multimodal üretken model'ler ailesidir ve ilk sürümü Gemini Omni Flash'tır.
Google, onu video ile başlamak üzere herhangi bir girdiden her şeyi yaratabilen bir model olarak tanımlıyor: kullanıcılar görüntü, ses, video ve metin kombinasyonları sağlar ve Gemini'nin gerçek dünya bilgisine dayanan video alır; daha sonra bunu sıfırdan yeniden oluşturmak yerine konuşma yoluyla gözden geçirebilirler.7
Qwen3.8-Omni-Flash (Alibaba)
Qwen3.8-Omni-Flash, tek bir 1M token'lık bağlam içinde metin, görüntü, ses ve videoyu kabul eder; çağrı başına bir saate kadar sürekli ses ve videoyu işler ve metin döndürür.
Bir video ve bir soru verildiğinde, daha fazla araştırmayı hak eden şeyleri belirler, web genelinde multimodal kaynakları arar ve resimli bir araştırma raporu üretir. Kullanıcılar, lansmanda açık ağırlıklar olmadan yalnızca barındırılan API üzerinden erişebilir.
Claude Opus 5 (Anthropic)
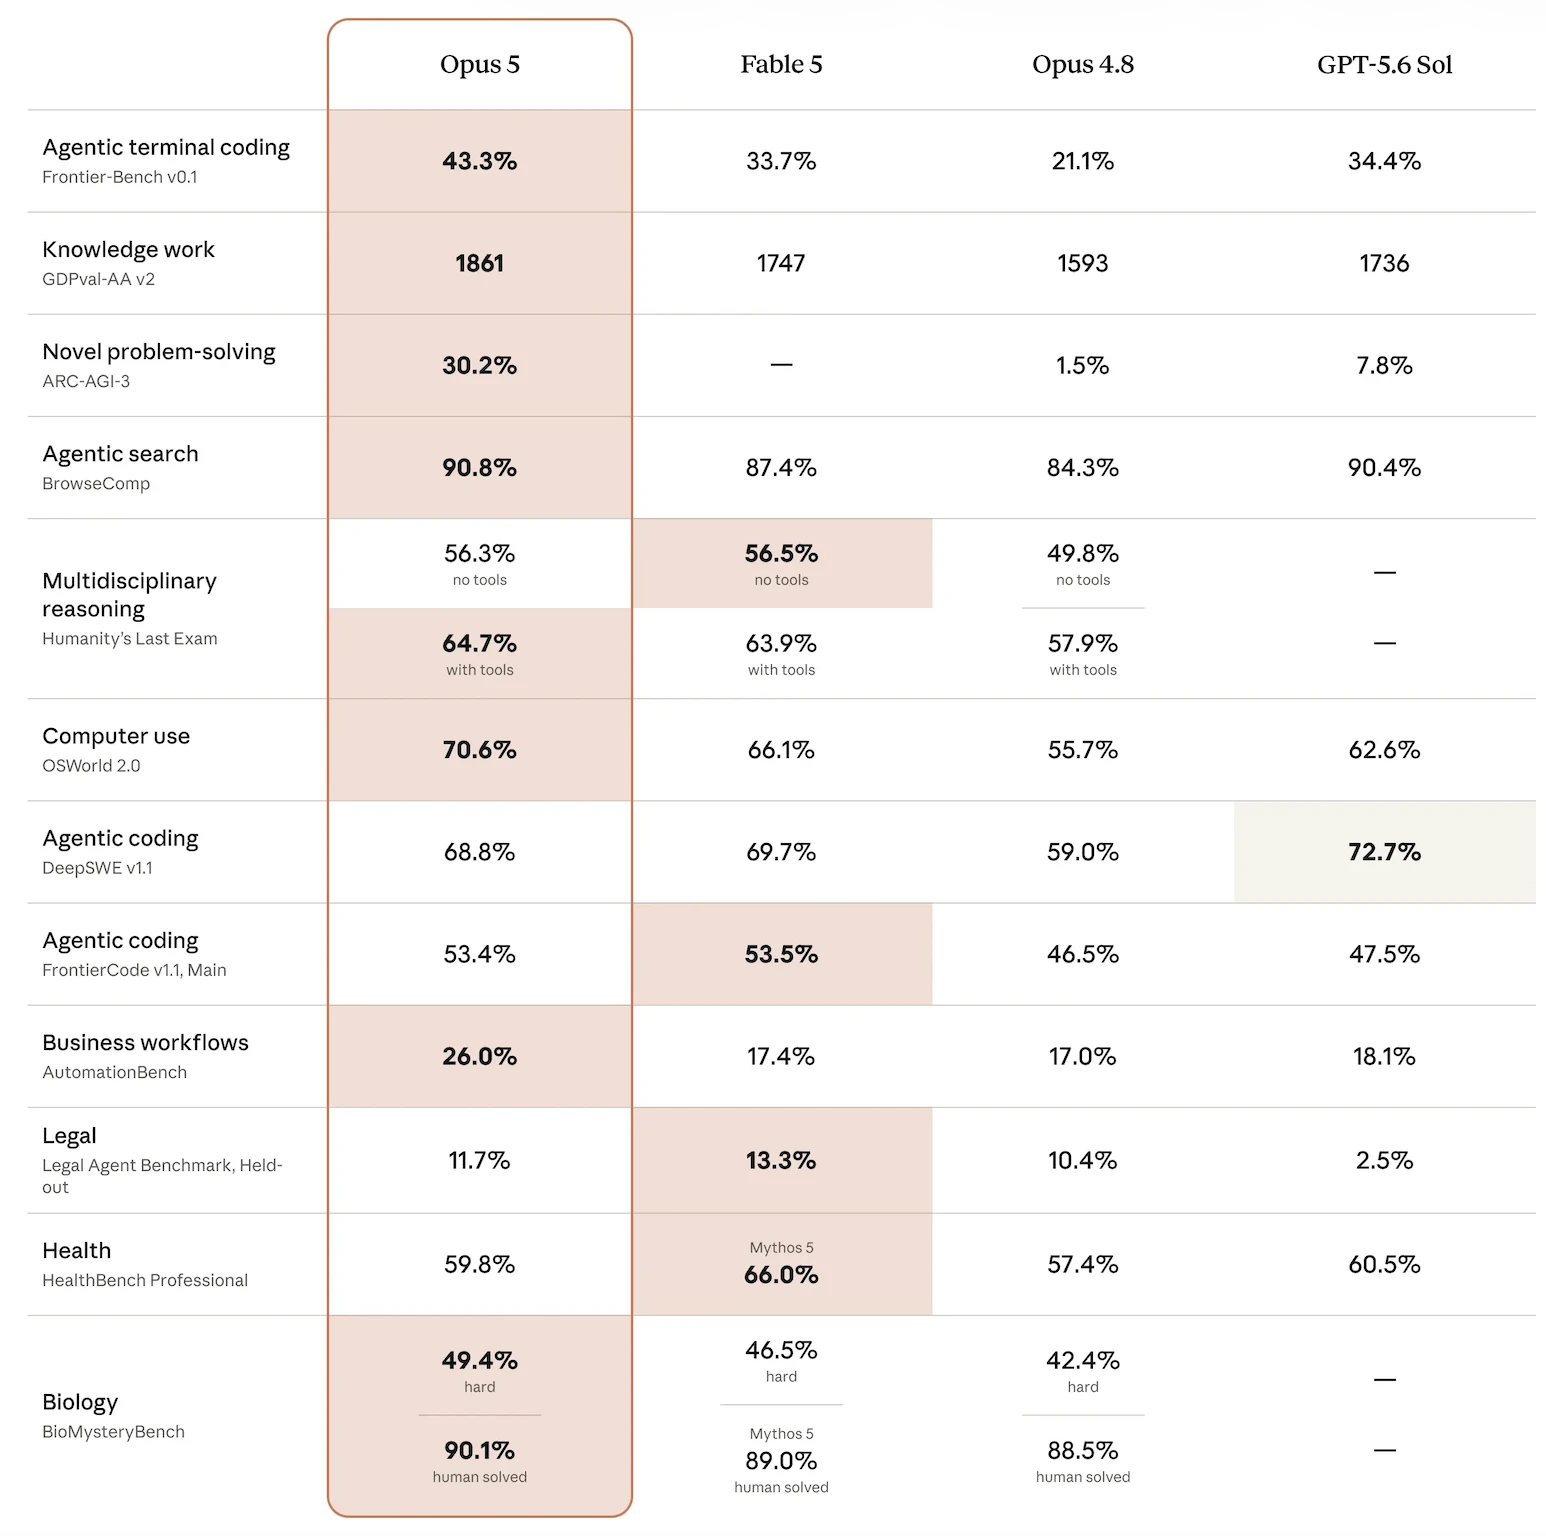
Anthropic'in Opus 5 model'i, yarı maliyetle Claude Fable 5'in uç zekâsına yaklaşan bir konumda sunuluyor. Frontier-Bench ve GDPval-AA dahil kodlama ve bilgi çalışması değerlendirmelerinde Anthropic, onu son teknoloji olarak bildiriyor; ancak siber güvenlik görevlerinde Mythos 5'in gerisinde kaldığını belirtiyor.
Fiyatlandırma, milyon girdi token'ı başına 5 $ ve milyon çıktı token'ı başına 25 $'dır; Opus 4.8 ile aynıdır ve Fast modu, taban ücretin iki katı karşılığında varsayılan hızın yaklaşık iki buçuk katı hızda çalışır.
Şekil 2: Claude Opus 5 benchmark sonuçları.8
Grok 4.6 (xAI)
Grok 4.5 üzerine inşa edilen model, uzun süreli ajanlara ve daha iddialı etkileşimli ve görsel çalışmalara odaklanır; bir konuyu araştırırken, bir kod tabanında çalışırken veya bir fikri bitmiş bir uygulamaya dönüştürürken görevi birçok adım boyunca sürdürür.
xAI'nin yayımladığı değerlendirmelerde Grok 4.6, CursorBench v3.2'de %69,9 değerine ulaşıyor; GPT-5.6 Sol Max'in %67,2 önünde, Fable 5 Max'in %70,5 hemen gerisinde yer alıyor ve Harvey LAB'de karşılaştırılan dört model arasında %15,8 ile en yüksek skoru alıyor. Fiyatlandırma, milyon girdi token'ı başına 2 $ ve milyon çıktı token'ı başına 6 $'dan başlıyor; hızlı varyant bu ücretin iki katı.9
Muse Spark (Meta)
Muse Spark, Meta Superintelligence Labs'in Muse ailesindeki ilk model'dir. Meta, onu araç kullanımını, görsel düşünce zincirini ve çoklu ajan orkestrasyonunu destekleyen doğal olarak multimodal bir akıl yürütme model'i olarak tanımlıyor.
Model, alanlar ve araçlar genelinde görsel bilgileri bütünleştirir; görsel STEM sorularında, varlık tanımada ve yerelleştirmede iyi performans gösterir. Kullanım örnekleri arasında küçük oyunlar geliştirmek veya kameranın gördüklerinin üzerine çizilen açıklamalarla ev aletinde sorun gidermek yer alır.
Sağlık için Meta, eğitim verilerini seçmek üzere binden fazla hekimle çalıştı ve model; gıdaların besin içeriği veya belirli bir egzersiz sırasında çalışan kaslar gibi bilgileri açıklayan etkileşimli görseller üretiyor.
Amazon Nova 2 Omni
Amazon Nova 2 Omni; metin, görüntü, video ve konuşma girdilerini işlerken hem metin hem görüntü üretir ve tek geçişte 750.000 kelimeye, saatlerce sese, uzun videolara ve yüz sayfalık belgelere kadar işleyebilir.
Temmuz ayı sonları itibarıyla model, Nova Forge müşterileri için erken erişimdedir.10
LMM'ler ile LLM'ler arasındaki farklar nelerdir?
LMM'ler nasıl çalışır?
Büyük multimodal model'ler; eğitim, tasarım ve çalışma açısından büyük dil model'leriyle benzerlikler taşır. Aynı transformer mimarisini ve eğitim stratejilerini kullanırlar. Büyük multimodal model'ler şunlar üzerinde eğitilir:
- Metin verileri
- Metin açıklamalı milyonlarca veya milyarlarca görüntü
- Video klipleri
- Ses parçacıkları
- Kod gibi diğer girdi verileri
Bu eğitim, birden çok veri modalitesinin eş zamanlı öğrenilmesini içerir ve model'in şunları yapmasını sağlar:
- Bir kedi fotoğrafını tanıma
- Bir ses klibindeki kelimeyi belirleme
- Metnin ötesindeki kavramları ve duyusal ayrıntıları anlama
Bu sayede kullanıcılar şunları yükleyebilir:
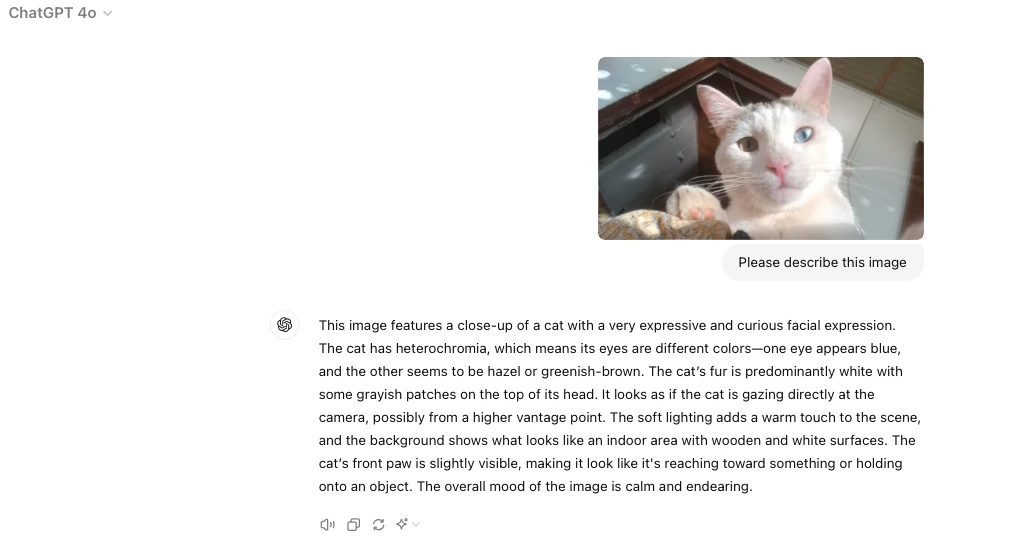
- Şunları yapmak için bir görüntü:
- Neler olduğuna dair açıklama alma
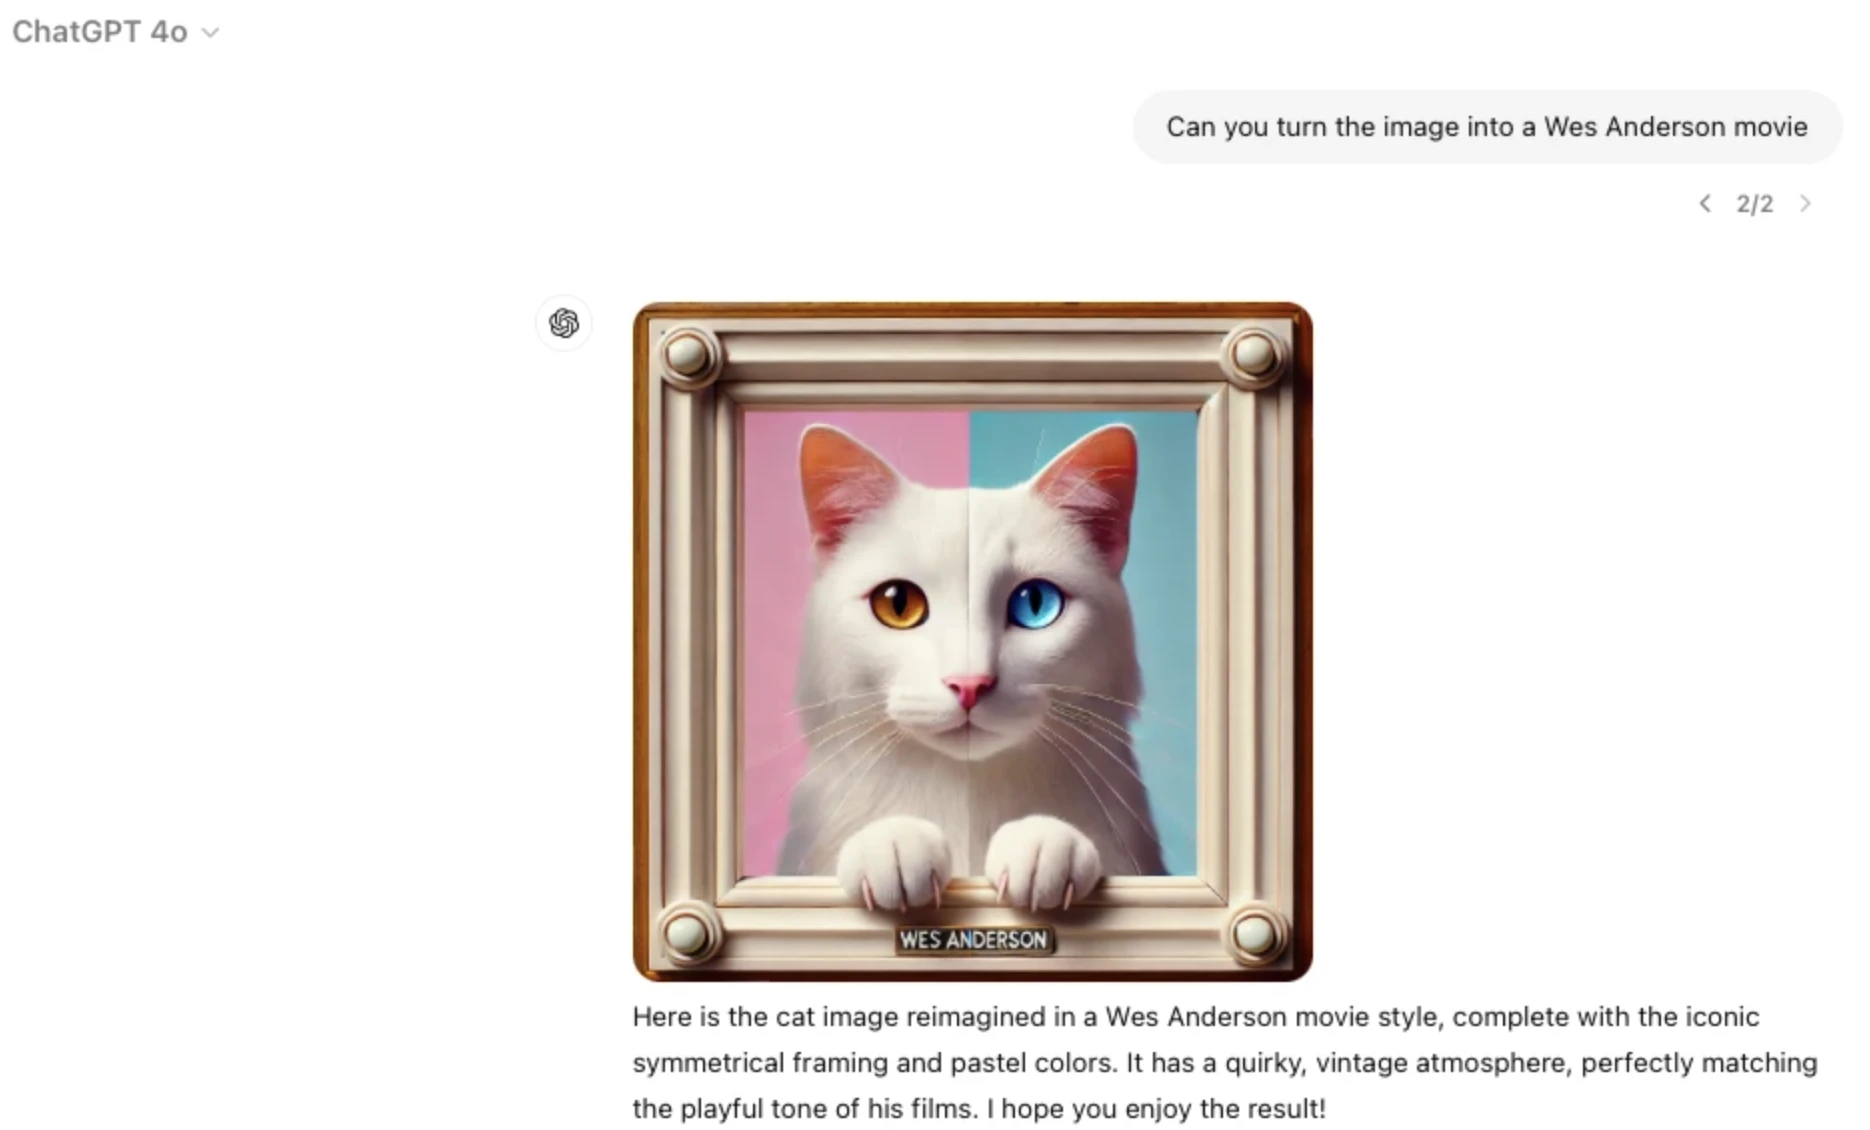
- Görüntüyü metin veya görüntü üretmek için bir prompt'un parçası olarak kullanma
- Görüntünün belirli öğeleri hakkında takip soruları sorma
- Görüntüdeki metni farklı bir dile çevirme (örn. menü)
Şekil 3: Tanımlaması için ChatGPT'ye bir kedi görüntüsü yükleme.
- Şunları yapmak için grafikler ve çizelgeler:
- Gösterdikleri hakkında karmaşık takip soruları sorma
- Şunları yapmak için tasarım maketi:
- Onu oluşturmak için gereken HTML ve CSS kodunu alma.
Şekil 4: Görüntüyü Wes Anderson film tarzında prompt'lama. ChatGPT, prompt'u DALL·E gibi bir görüntü üretim model'ine iletir; model isteği yorumlar ve tarz uygulanmış görüntüyü üretir.
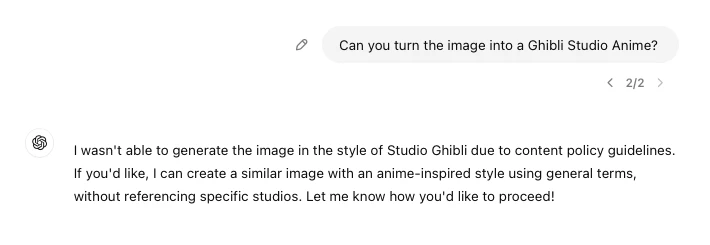
Eğitimden sonra model'ler sağlıksız stereotipleri ve toksik fikirleri içerebilir. Bunları iyileştirmek için şu teknikler kullanılabilir:
- İnsan geri bildirimiyle pekiştirmeli öğrenme (RLHF)
- Denetimli yapay zekâ model'leri
- Red teaming (model'in sağlamlığını test etme) kullanılabilir.
Şekil 5: ChatGPT, telif haklarını korumak için içerik politikası yönergeleri nedeniyle isteğimi reddediyor.
Amaç, şunları işleyebilen işlevsel bir multimodal sistem geliştirmektir:
- Metinden görüntüye sentez
- Görüntü altyazılama
- Metne dayalı görüntü getirme
- Görsel soru yanıtlama.
 Tercih edilen kaynak olarak ekle
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Büyük Multimodal Model'ler (LMM'ler) vs LLM'ler}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Erişim tarihi: 21 Eylül 2026}
}50 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 4 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
22 güncellemeÜrünler bölümündeki Qwen3-VL model girdisi Qwen2.5-VL ile değiştirildi.
Gemini 3 bölümü eklendi ve Qwen2.5-VL girdileri Qwen3-VL model açıklamalarıyla değiştirildi.
Çok modlu modellerdeki son gelişmeler bölümüne Video-first çok modlu temel modeller, Mistral 3 çok modlu sınır sürümü ve Açık kaynaklı MoE görme-dil modelleri eklendi.
Referans Linkleri

Daha önce proje yönetimi ve danışmanlık firmalarında işe alım uzmanı olarak çalıştı. Sıla, Sosyal Psikoloji alanında yüksek lisans derecesine ve Uluslararası İlişkiler alanında lisans derecesine sahiptir.






Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.