


LLM Orchestrierung: 21 Frameworks und Gateways

Die Optimierung der LLM-Orchestrierung ist entscheidend, um die Leistung zu verbessern und gleichzeitig den Ressourcenverbrauch zu kontrollieren. Um zu bewerten, wie verschiedene Orchestrierungsansätze in der Praxis abschneiden, haben wir folgende Benchmarks durchgeführt:
- Agentische Orchestrierungs-Frameworks: Unter Verwendung eines identischen Reiseplanungs-Workflows mit fünf Agenten, der jeweils 100 Mal ausgeführt wurde, wurden Pipeline-Latenz, Token-Verbrauch, Agent-zu-Agent-Übergänge und Agent-zu-Tool-Ausführungslücken gemessen.
- KI-Gateways: OpenRouter, SambaNova, TogetherAI, Groq und KI/ML API wurden hinsichtlich First-Token-Latenz, Gesamtlatenz und Anzahl der Ausgabe-Tokens mit 300 kurzen (≈18 Tokens) und langen (≈203 Tokens) Prompt-Tests getestet.
Entdecken Sie ausgewählte LLM-Orchestrierungs-Tools, einschließlich Entwickler-Frameworks und Enterprise-Gateways:
Was ist Orchestrierung in LLM?
LLM-Orchestrierung umfasst die Verwaltung und Integration mehrerer LLM (LLMs), um komplexe Aufgaben effizient auszuführen. Sie gewährleistet die Interaktion zwischen Modellen, Workflows, Datenquellen und Pipelines und optimiert die Leistung als einheitliches System. Organisationen nutzen LLM-Orchestrierung für Aufgaben wie die Generierung natürlicher Sprache, maschinelle Übersetzung, Entscheidungsfindung und Chatbots.
Während LLMs über starke grundlegende Fähigkeiten verfügen, sind sie in Bezug auf Echtzeit-Lernen, das Beibehalten von Kontext und die Lösung mehrstufiger Probleme eingeschränkt. Auch die Verwaltung mehrerer LLMs über verschiedene Anbieter-APIs hinweg erhöht die Orchestrierungskomplexität.
LLM-Orchestrierungs-Frameworks adressieren diese Herausforderungen, indem sie Prompt-Engineering, API-Interaktionen, Datenabruf und Zustandsverwaltung optimieren. Diese Frameworks ermöglichen es LLMs, effizient zu kollaborieren, und verbessern ihre Fähigkeit, genaue und kontextbewusste Ergebnisse zu erzeugen.
Was ist die beste Plattform für LLM-Orchestrierung?
LLM-Orchestrierungs-Frameworks können die Nutzung von Großen Sprachmodellen (LLMs) in verschiedenen Anwendungen verwalten, koordinieren und optimieren. Ein LLM-Orchestrierungssystem ermöglicht die Integration mit verschiedenen KI-Komponenten, erleichtert Prompt-Engineering, verwaltet Workflows und verbessert das Leistungs-Monitoring.
Sie sind besonders nützlich für Anwendungen mit Multi-Agenten-Systemen, Retrieval-Augmented Generation (RAG), konversationeller KI und autonomer Entscheidungsfindung.
Um die Navigation zu erleichtern, sind die Tools in zwei Kategorien unterteilt:
1. Gateway-basierte Plattformen
Gateway-Plattformen sind unternehmensorientierte Lösungen, die den Zugriff auf LLMs zentralisieren, Sicherheitsrichtlinien durchsetzen, Compliance verwalten und Nutzungsüberwachung bieten. Diese Plattformen sind ideal für Organisationen, die eine kontrollierte, skalierbare und verwaltete LLM-Bereitstellung benötigen.
Hier sind einige der KI-Gateways und ihre GitHub-Scores:
KI-Gateway-Benchmark-Ergebnisse
Unser Benchmark verwendete First-Token-Latenz (FTL) und Gesamtlatenz mit Token-Ausgabe, um zu bewerten, wie effizient Gateways Anbieter auswählen und Antworten liefern. Hier sind einige unserer Ergebnisse:
- Top-Performer:
- Groq: Schnellste FTL für lange Prompts (0.14 s) und niedrige Gesamtlatenz (2.7 s) mit 1.900 Tokens
- SambaNova: Gleichstand für schnellste FTL bei kurzen Prompts (0.13 s) und zweitniedrigste Gesamtlatenz (3 s), während die höchste Token-Anzahl (1.997) erzeugt wird.
- Mittlere Performer:
- OpenRouter: FTL 0.40–0.45 s, Gesamtlatenz 25 s für lange Prompts, moderate Token-Ausgabe
- TogetherAI: FTL 0.43–0.45 s, Gesamtlatenz 11 s mit 1.812 Tokens
- Schwächster Performer: KI/ML API, höchste FTL (0.84–0.90 s) und Gesamtlatenz (13 s), trotz moderater Token-Ausgabe.
Für weitere Details und zur Methodik lesen Sie bitte unseren KI-Gateway-Benchmark-Artikel.
Hier ist eine Liste gateway-basierter Plattformen für LLM-Orchestrierung, alphabetisch sortiert:
Bifrost von Maxim KI
Bifrost ist ein KI-Gateway, das den Zugriff auf über 15+ LLM-Anbieter über eine einzige, zu OpenAI kompatible API vereinheitlicht und automatisches Failover, Lastausgleich und zentrale Governance-Richtlinien unterstützt.
Einzigartige Funktion: Integration des Model Context Protocol (MCP), die Streaming, plugin-basiertes Monitoring und Analysen für LLMs mehrerer Anbieter ermöglicht.
Cloudflare KI Gateway
Cloudflare KI Gateway ist ein KI-Inferenz-Proxy und eine Orchestrierungsplattform, die Zugriff auf mehrere große Sprachmodelle bietet und einheitliche Abrechnung, Kostenüberwachung und automatisierte Resilienzfunktionen für technische KI-Workloads bereitstellt.
Einzigartige Funktion: Multi-Provider-Failover und Edge-basiertes Stream-Buffering, das lang laufende Anwendungs-Streaming-Antworten vor Verbindungsabbrüchen schützt, indem Inferenzausgaben direkt im globalen Netzwerk von Cloudflare zwischengespeichert werden.
Kong
Kong KI Gateway ist ein semantisches KI-Gateway, das LLM-Verkehr zentralisiert und absichert und es Organisationen ermöglicht, mehrere KI-Modelle für Compliance und Ressourcenverfolgung zu integrieren, zu verwalten und zu überwachen.
Einzigartige Funktion: Semantische Prompt-Sicherheit, einschließlich PII-Bereinigung und fortschrittlicher Prompt-Vorlagen zum Schutz sensibler Informationen.
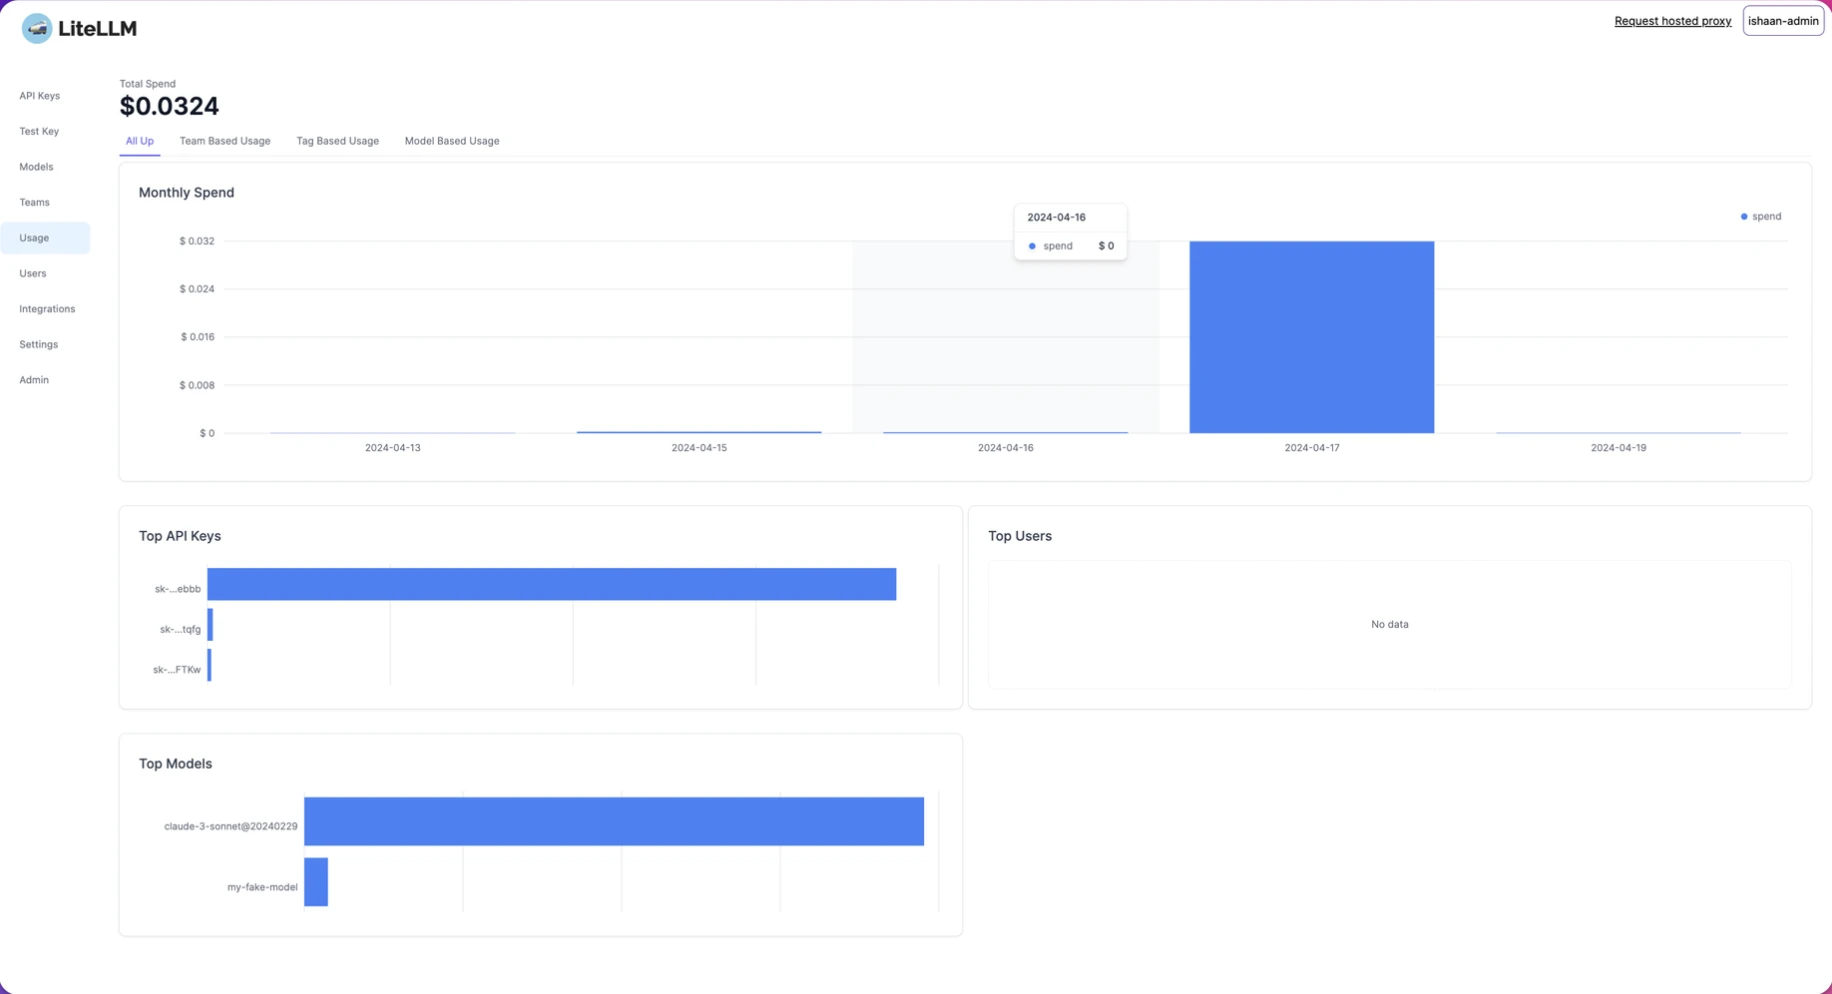
LiteLLM
LiteLLM bietet Zugriff auf mehrere LLMs über eine einheitliche Schnittstelle und bietet sowohl einen Proxy-Server (LLM-Gateway) als auch ein Python SDK für zentrales Management und System-Observability.
Einzigartige Funktion: Python SDK-Integration für programmatisches LLM-Management und Observability, die es Entwicklern ermöglicht, zentrale KI-Steuerungen direkt in den Code einzubetten.
Prisma AIRS KI Gateway (ehemals Portkey)
Prisma AIRS KI ist ein KI-Gateway und eine Orchestrierungsplattform, die Entwickler mit mehreren LLMs verbindet und programmatisches Routing, Failover, Kostenüberwachung und Bereitstellungsfunktionen für technische KI-Teams unterstützt.
Einzigartige Funktion: Multimodale LLM-Unterstützung, einschließlich Text-, Bild-, Audio- und Vision-Modellen mit Fine-Tuning-Fähigkeiten für verbesserte Ausgabekonsistenz.
2. Entwickler-Frameworks
Entwickler-Frameworks sind für Ingenieure und KI-Entwickler konzipiert, die volle Kontrolle über den Aufbau und die Orchestrierung von LLM-Workflows haben möchten. Sie bieten SDKs, APIs und vorgefertigte Module, um Modelle zu verketten, Prompts zu verwalten und Multi-LLM-Interaktionen zu handhaben.
Hier ist die vollständige Liste der LLM-Orchestrierungs-Tools für Entwickler und ihre GitHub-Sterne in alphabetischer Reihenfolge:
Benchmark-Ergebnisse
Wichtige Erkenntnisse aus dem Benchmark der Orchestrierungs-Frameworks:
- LangGraph: Führt am schnellsten aus, mit der effizientesten Zustandsverwaltung
- LangChain: Verbraucht mehr Tokens aufgrund schwererer Speicher- und Verlaufsverarbeitung
- AutoGen: Leistet moderate Arbeit mit konsistentem Koordinationsverhalten
- CrewAI: Erfährt die längsten Verzögerungen aufgrund autonomer Abwägung vor Tool-Aufrufen.
Für die Methodik und eine detailliertere Analyse des Benchmarks lesen Sie bitte den Agentic Orchestration Benchmark.
Die unten erläuterten Tools sind in alphabetischer Reihenfolge aufgeführt:
Agency Swarm
Agency Swarm ist ein Multi-Agenten-System (MAS)-Framework, das Tools zum Aufbau, zur Orchestrierung und Verwaltung von Schwärmen von KI-Agenten bereitstellt und das OpenAI Agents SDK nutzt.
Hauptfunktionen:
- Sunterstützt Multi-Agenten-Koordination, sodass mehrere KI-Agenten Daten austauschen und Workflows gleichzeitig ausführen können.
- Enthält Simulations- und Visualisierungstools, die helfen, Agenteninteraktionen in einer simulierten Umgebung zu testen und zu überwachen.
- Ermöglicht umgebungsbasierte KI-Interaktionen, da KI-Agenten dynamisch auf sich ändernde Bedingungen reagieren können.
AutoGen
AutoGen, entwickelt von Microsoft, ist ein Open-Source-Multi-Agenten-Orchestrierungs-Framework, das die Automatisierung von KI-Aufgaben mithilfe konversationeller Agenten vereinfacht.
Hauptfunktionen:
- Multi-Agenten-Konversations-Framework, das es KI-Agenten ermöglicht, zu kommunizieren und Aufgaben zu koordinieren.
- Funktioniert mit mehreren Modellanbietern, einschließlich OpenAI und Azure
- Modulare, konfigurierbare Architektur, ein anpassbares Setup für verschiedene KI-Anwendungen.
crewAI
crewAI ist ein Open-Source-Multi-Agenten-Framework. Es ermöglicht rollenspielenden KI-Agenten, bei strukturierten Aufgaben zu kollaborieren.
Hauptfunktionen:
- Agentenbasierte Workflow-Automatisierung, die KI-Agenten bestimmte Rollen bei der Aufgabenausführung zuweist.
- Unterstützt sowohl technische als auch nicht-technische Benutzer
- Enterprise-Version (crewAI+) verfügbar
Haystack
Haystack ist ein Open-Source-Python-Framework, das die flexible Erstellung von KI-Pipelines mithilfe eines komponentenbasierten Ansatzes ermöglicht. Es unterstützt Informationsabruf und Q&A-Anwendungen.
Hauptfunktionen:
- Komponentenbasiertes KI-Systemdesign, ein modularer Ansatz zum Zusammenstellen von KI-Funktionen.
- Integration mit Vektordatenbanken und LLM-Anbietern, die es ermöglicht, mit verschiedenen Datenspeichern und KI-Modellen zu arbeiten.
- Unterstützt semantische Suche und Informationsextraktion, was erweiterte Suche und Wissensabruf ermöglicht.
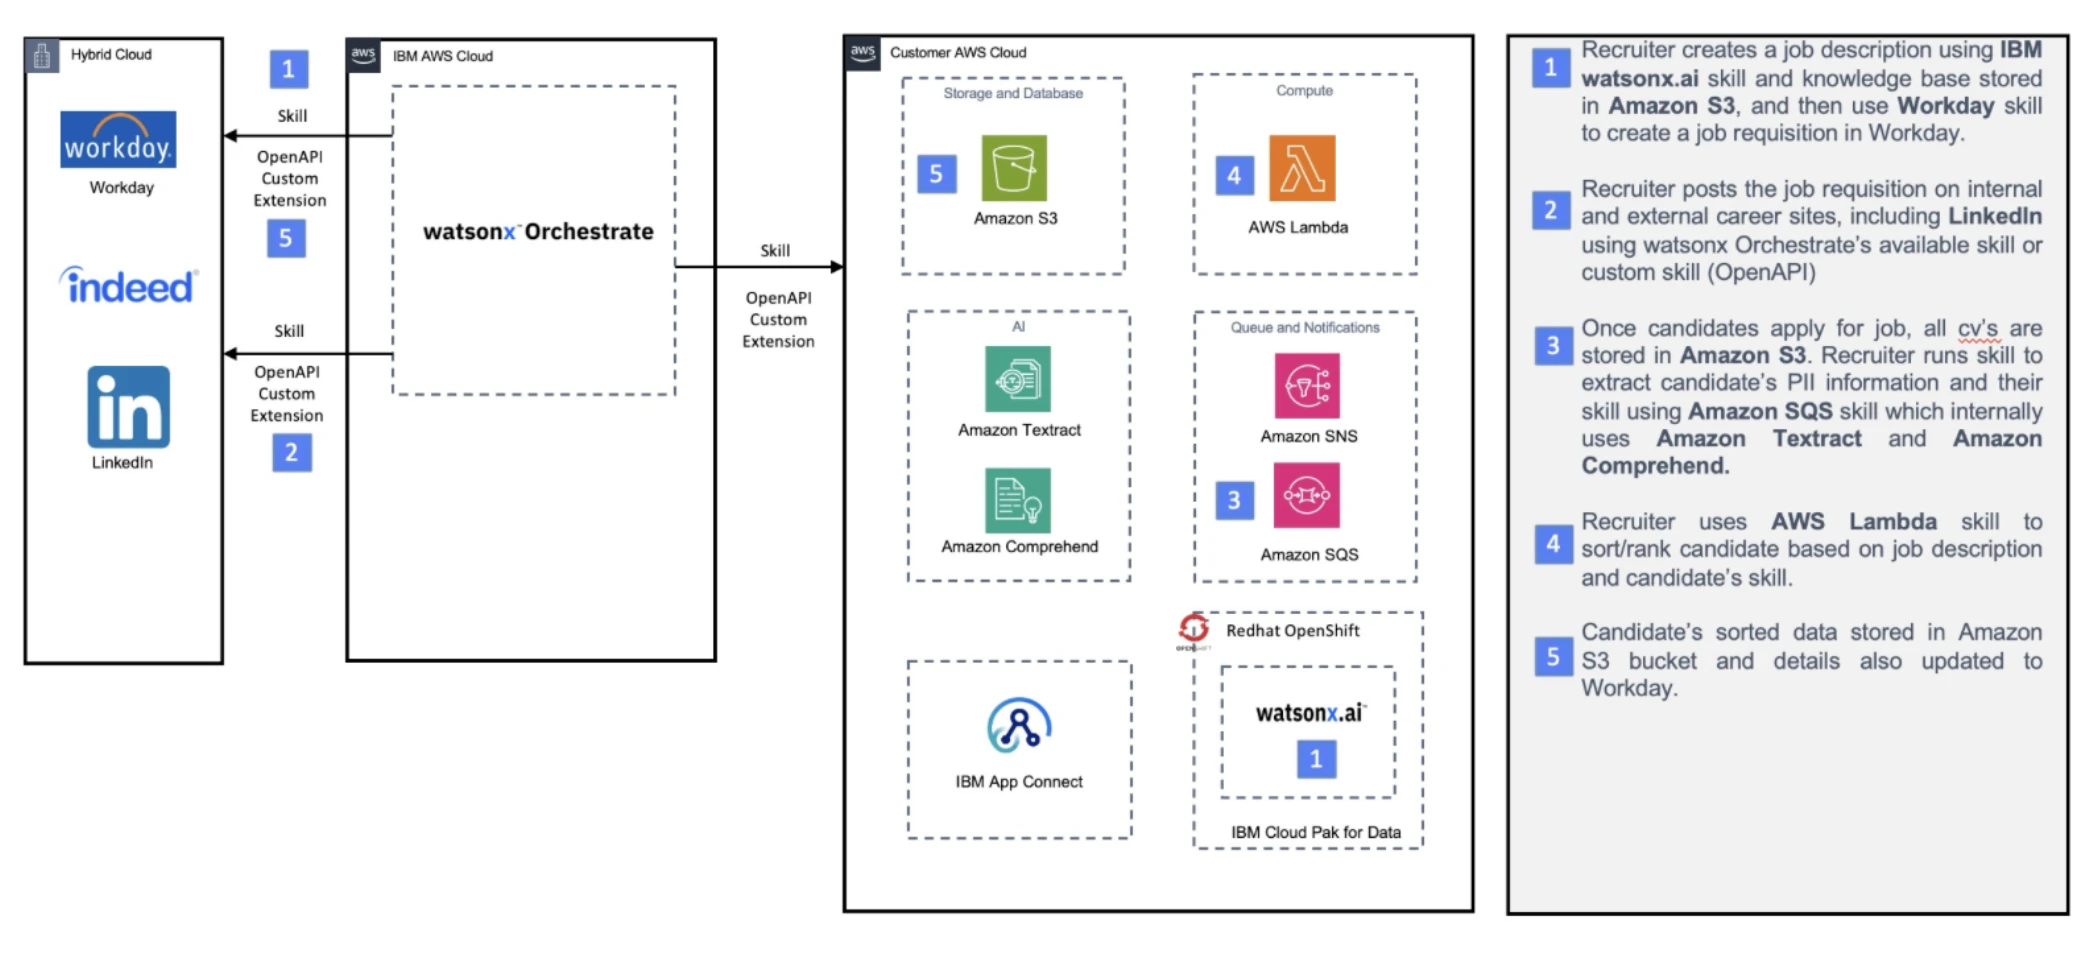
IBM watsonx orchestrate
IBM watsonx orchestrate ist ein proprietäres KI-Orchestrierungs-Framework, das Natural Language Processing (NLP) nutzt, um Unternehmens-Workflows zu automatisieren.
Hauptfunktionen:
- KI-gestützte Workflow-Automatisierung, die repetitive Geschäftsprozesse mithilfe von KI automatisieren kann.
- Vorgefertigte Anwendungen und Skillsets, die gebrauchsfertige KI-Tools für verschiedene Branchen bereitstellen.
- Enterprise-orientierte Integration, die mit bestehender Unternehmenssoftware und Workflows verbunden wird.
LangChain
LangChain ist ein Open-Source-Python-Framework zum Erstellen von LLM-Anwendungen, mit Schwerpunkt auf Tool-Augmentation und Agenten-Orchestrierung. Es bietet Schnittstellen für Embedding-Modelle, LLMs und Vektorspeicher.
Hauptfunktionen:
- RAG Unterstützung
- Integration mit mehreren LLM-Komponenten
- ReAct-Framework für Denken und Handeln
LlamaIndex
LlamaIndex ist ein Open-Source-Datenintegrations-Framework, das für die Erstellung kontextangereicherter LLM-Anwendungen entwickelt wurde. Es ermöglicht den einfachen Abruf von Daten aus mehreren Quellen.
Hauptfunktionen:
- Datenkonnektoren für über 160 Quellen, die es der KI ermöglichen, auf vielfältige strukturierte und unstrukturierte Daten zuzugreifen.
- Retrieval-Augmented Generation (RAG) Unterstützung
- Suite von Evaluierungsmodulen für das Leistungs-Tracking
LOFT
LOFT, entwickelt von Master of Code Global, ist ein Large Language Model-Orchestrator-Framework, das zur Optimierung KI-gesteuerter Kundeninteraktionen entwickelt wurde. Es nutzt eine warteschlangenbasierte Architektur, die für die Verwaltung gleichzeitiger Anfragen und Multi-Benutzer-Bereitstellungen konzipiert ist.
Hauptfunktionen:
- Framework-agnostisch: Integriert sich in jedes Backend-System ohne Abhängigkeiten von HTTP-Frameworks.
- Dynamisch berechnete Prompts: Unterstützt individuell generierte Prompts für personalisierte Benutzerinteraktionen.
- Ereigniserkennung und -behandlung: Bietet integrierte Mechanismen zur Erkennung und Verwaltung chatbasierter Ereignisse, einschließlich Halluzinationsfilterung.
Microchain
Microchain ist ein leichtgewichtiges, quelloffenes LLM-Orchestrierungs-Framework, das für seine Einfachheit bekannt ist, aber nicht aktiv gepflegt wird.
Hauptfunktionen:
- Unterstützung für Chain-of-Thought-Denken, das der KI hilft, komplexe Probleme Schritt für Schritt zu zerlegen.
- Minimalistischer Ansatz für KI-Orchestrierung.
Orq KI
Orq ist eine generative KI-Kollaborationsplattform und ein LLMOps-Tool, das zur Verwaltung des Bereitstellungslebenszyklus von LLM-Anwendungen entwickelt wurde. Es bietet Funktionen für technische und nicht-technische Teams, um KI-Funktionen zu erstellen, bereitzustellen und zu überwachen.
Hauptfunktionen:
- Serverlose LLM-Orchestrierung: Bietet Bereitstellungsinfrastruktur über eine einheitliche API mit integriertem Routing, Versionskontrolle, Fallbacks und Wiederholungen.
- Observability & Evaluierung: Bietet Echtzeit-Monitoring, Traces, Logs und benutzerdefinierte Evaluatoren, um die Leistung und Ausgabequalität von LLM zu gewährleisten.
- KI-Gateway & RAG: Gewährt Single-Point-Zugriff auf mehrere KI-Modelle und Tools zum Aufbau von Retrieval-Augmented Generation (RAG) Pipelines.
Semantic Kernel
Semantic Kernel (SK) ist ein Open-Source-KI-Orchestrierungs-Framework von Microsoft. Es hilft Entwicklern, große Sprachmodelle (LLMs) wie OpenAIs GPT mit traditioneller Programmierung zu integrieren, um KI-gestützte Anwendungen zu erstellen.
Hauptfunktionen:
- Speicher- und Kontextbehandlung: SK ermöglicht das Speichern und Abrufen vergangener Interaktionen und hilft, den Kontext über Gespräche hinweg aufrechtzuerhalten.
- Embeddings & Vektorsuche: Unterstützt embedding-basierte Suchen und ist damit kompatibel mit Anwendungsfällen der Retrieval-Augmented Generation (RAG).
- Multimodale Unterstützung: Funktioniert mit Text, Code, Bildern und mehr.
Wie wählt man das richtige LLM-Orchestrierungs-Framework aus?
Die Anzahl der GitHub-Sterne kann auf Popularität hindeuten, aber die ideale Wahl hängt von mehreren Faktoren ab, einschließlich der technischen Expertise Ihres Teams, der Projektgröße, dem Budget und den gewünschten Integrationen.
Berücksichtigen Sie die technische Expertise des Teams:
- Für hochgradig technische Teams wie Entwickler und Datenwissenschaftler, die granulare Kontrolle und Flexibilität benötigen, sind Frameworks wie LangChain, AutoGen und LlamaIndex ausgezeichnete Wahlmöglichkeiten. Sie sind code-first und erfordern ein starkes Verständnis von Python und KI-Prinzipien.
- Für Business-Anwender oder Teams mit einer Präferenz für Low-Code/No-Code sind Plattformen mit Fokus auf deklarative Schnittstellen besser geeignet. Loft und crewAI bieten vereinfachte Workflows, die schnelles Prototyping ohne umfangreiche Programmierung ermöglichen.
Überprüfen Sie die Projektgröße:
- Für komplexe Multi-Agenten-Systeme bieten speziell für diesen Zweck entwickelte Frameworks wie AutoGen, crewAI oder Agency Swarm die notwendige Architektur, damit Agenten kommunizieren und kollaborieren können.
- Für groß angelegte, unternehmenskritische Anwendungen, die hohen Durchsatz, Sicherheit und dedizierten Support erfordern, sind proprietäre Lösungen wie IBM watsonx orchestrate oft die bevorzugte Option.
- Für leichte, Proof-of-Concept (POC)-Anwendungen kann ein minimalistisches Framework ausreichend sein, da seine Einfachheit den Overhead reduziert.
Denken Sie an Budgetbeschränkungen:
- Open-Source-Frameworks wie LangChain und Haystack sind kostenlos nutzbar, bringen aber die „versteckten Kosten“ für Cloud-Infrastruktur, Wartung und ein spezialisiertes Team mit sich.
- Proprietäre Lösungen können eine vorhersehbare Preisstruktur bieten, die Support umfasst und für Organisationen ohne ein dediziertes MLOps-Team kosteneffizienter sein kann.
Berücksichtigen Sie Ihren bestehenden Technologie-Stack.
- Wenn Ihr Unternehmen in ein bestimmtes Ökosystem investiert ist, ist das Entfernen von Frameworks, die nicht mit diesem Ökosystem arbeiten können, ein hilfreicher Schritt. Beispielsweise kann Semantic Kernel für Microsoft-Umgebungen oder Haystack für dokumentretrieval-orientierte Anwendungen Integration bieten.
Wie funktionieren LLM-Orchestrierungs-Tools?
LLM-Orchestrierungs-Frameworks verwalten die Interaktion zwischen verschiedenen Komponenten von LLM-gesteuerten Anwendungen und gewährleisten strukturierte Workflows und eine effiziente Ausführung. Die Orchestrierungsschicht spielt eine zentrale Rolle bei der Koordination von Prozessen wie Prompt-Verwaltung, Ressourcenzuweisung, Datenvorverarbeitung und Modellinteraktionen.
Orchestrierungsschicht
Die Orchestrierungsschicht fungiert als zentrales Steuerungssystem innerhalb einer LLM-gestützten Anwendung. Sie verwaltet die Interaktionen zwischen verschiedenen Komponenten, einschließlich LLMs, Prompt-Vorlagen, Vektordatenbanken und KI-Agenten. Durch die Überwachung dieser Elemente gewährleistet die Orchestrierung eine kohäsive Leistung über verschiedene Aufgaben und Umgebungen hinweg.
Wichtige Orchestrierungsaufgaben
Prompt-Chain-Verwaltung
- Das Framework strukturiert und verwaltet LLM-Eingaben (Prompts), um die Ausgabe zu optimieren.
- Es bietet ein Repository von Prompt-Vorlagen, das eine dynamische Auswahl basierend auf Kontext und Benutzereingaben ermöglicht.
- Es sequenziert Prompts logisch, um strukturierte Gesprächsverläufe aufrechtzuerhalten.
- Es bewertet Antworten, um die Ausgabequalität zu verbessern, Inkonsistenzen zu erkennen und die Einhaltung von Richtlinien sicherzustellen.
- Faktenprüfungsmechanismen können implementiert werden, um Ungenauigkeiten zu reduzieren, wobei markierte Antworten zur menschlichen Überprüfung weitergeleitet werden.
LLM-Ressourcen- und Leistungsverwaltung
- Orchestrierungs-Frameworks überwachen die LLM-Leistung durch Benchmark-Tests und Echtzeit-Dashboards.
- Sie bieten Diagnosetools für die Ursachenanalyse (RCA), um das Debugging zu erleichtern.
- Sie weisen Rechenressourcen effizient zu, um die Leistung zu optimieren.
Datenverwaltung und Vorverarbeitung
- Der Orchestrator ruft Daten aus festgelegten Quellen mithilfe von Konnektoren oder APIs ab.
- Die Vorverarbeitung wandelt Rohdaten in ein Format um, das mit LLMs kompatibel ist, und stellt so Datenqualität und Relevanz sicher.
- Sie verfeinert und strukturiert Daten, um deren Eignung für die Verarbeitung durch verschiedene Algorithmen zu verbessern.
LLM-Integration und -Interaktion
- Der Orchestrator initiiert LLM-Operationen, verarbeitet die generierte Ausgabe und leitet sie an das entsprechende Ziel weiter.
- Er verwaltet Speicher, die das kontextuelle Verständnis verbessern, indem frühere Interaktionen bewahrt werden.
- Feedback-Mechanismen bewerten die Ausgabequalität und verfeinern Antworten auf Basis historischer Daten.
Observability- und Sicherheitsmaßnahmen
- Der Orchestrator unterstützt Monitoring-Tools, um das Modellverhalten zu verfolgen und die Zuverlässigkeit der Ausgabe sicherzustellen.
- Er implementiert Sicherheits-Frameworks, um Risiken im Zusammenhang mit ungeprüften oder ungenauen Ausgaben zu mindern.
Zusätzliche Verbesserungen
Workflow-Integration
- Bindet Tools, Technologien oder Prozesse in bestehende operative Systeme ein, um Effizienz, Konsistenz und Produktivität zu verbessern.
- Gewährleistet reibungslose Übergänge zwischen verschiedenen Modellanbietern, während die Prompt- und Ausgabequalität erhalten bleibt.
Modellanbieter wechseln
- Einige Frameworks ermöglichen den Wechsel von Modellanbietern mit minimalen Änderungen und reduzieren so operative Reibungsverluste.
- Das Aktualisieren von Anbieter-Importen, das Anpassen von Modellparametern und das Ändern von Klassenreferenzen erleichtern Übergänge.
Prompt-Verwaltung
- Wahrt die Konsistenz beim Prompting und hilft Benutzern gleichzeitig, produktiver zu iterieren und zu experimentieren.
- Integriert sich mit CI/CD-Pipelines, um die Zusammenarbeit zu optimieren und die Änderungsverfolgung zu automatisieren.
- Einige Systeme verfolgen Prompt-Änderungen automatisch und helfen, unerwartete Auswirkungen auf die Prompt-Qualität zu erkennen.
Aufkommendes Muster: Context Engineering
Mit der Weiterentwicklung der LLM-Orchestrierung ist eine neue Disziplin entstanden: Context Engineering. Sie konzentriert sich auf die Optimierung der Informationen, die in die Eingabe eines LLMs aufgenommen werden, insbesondere bei der Kombination von Echtzeit-Abruf, vergangenen Interaktionen und Speicher, um Antwortqualität und Effizienz zu verbessern.
Diese Praxis kann als Orchestrierungsmuster betrachtet werden, bei dem Kontext zu einer verwalteten Ressource wird, die abgerufen, gefiltert und präzise geformt wird, um Benutzerabsicht und Token-Limits zu entsprechen.
Zu den Schlüsselelementen dieses Orchestrierungsmusters gehören:
- Context Broker: Eine zentralisierte Einheit in der Orchestrierungsschicht, die Eingaben aus Speicher, Abrufmodulen und jüngsten Interaktionen sammelt und normalisiert. Sie gewährleistet Konsistenz über alle kontextbewussten Workflows hinweg.
- Module und Pfade: Spezialisierte Komponenten (wie Zusammenfasser, Abrufmaschinen oder Speicherabfragen) werden selektiv durch dynamische Tool-Dispatch-Mechanismen basierend auf der Art der Benutzeranfrage oder dem Systemzustand aktiviert.
- Context Packing: Abgerufene und erinnerte Inhalte werden bewertet, komprimiert und in strukturierte Prompts organisiert. Diese selektive Verpackung stellt sicher, dass hochwertige Informationen in das Eingabefenster des LLMs passen, ohne Token-Beschränkungen zu überschreiten.
- Guardrails und Anpassung: Integrierte Beschränkungen können Abruf-only-Antworten erzwingen, und langfristige Speicheraktualisierungen stellen sicher, dass das System die Kontextauswahl verfeinert.
Dieses Muster ist zunehmend unerlässlich in Systemen, die Retrieval-Augmented Generation (RAG), Multi-Agenten-Kollaboration und LLM-gestützte Copiloten verwenden, bei denen jede Anfrage die richtigen Module auslösen und die relevantesten Informationen liefern muss.
 Als bevorzugte Quelle hinzufügen
4 LLM-Orchestrierungs-Best Practices
1. Beginnen Sie mit einer soliden, modularen Architektur
- Aufgabenzerlegung: Definieren Sie Ihren Workflow klar und zerlegen Sie das Problem in kleine, klar abgegrenzte und testbare Schritte. Entwerfen Sie Ihre Pipeline so, dass Schlüsselfunktionen (z. B. Prompt-Erstellung, Speicherzugriff, fortgeschrittene Logik) in eigene Module isoliert werden.
- Iteratives Design: Beginnen Sie mit dem einfachsten funktionierenden Prototyp (einem „Minimum Viable Product“) und fügen Sie schrittweise Komplexität hinzu. Validieren Sie, dass jeder Schritt, vom Datenabruf bis zur endgültigen Ausgabe, isoliert funktioniert, bevor Sie ihn in eine komplexe Kette integrieren.
2. Dynamisches Modell-Routing und -Auswahl
- Optimieren Sie auf Kosten und Geschwindigkeit: Vermeiden Sie es, das teuerste und größte LLM für jede Aufgabe zu verwenden. Implementieren Sie im Orchestrator Logik, um einfache Anfragen (wie Klassifizierung oder Zusammenfassung) an günstigere, kleinere Modelle weiterzuleiten und Spitzenmodelle für komplexe Denk- oder Mehrschrittanalysen zu reservieren.
- Anbieterunabhängigkeit: Strukturieren Sie Ihre Orchestrierungsschicht so, dass ein einfacher Wechsel zwischen Modellanbietern (z. B. OpenAI, Anthropic, Google) möglich ist, um Vendor-Lock-in zu vermeiden, API-Ratenlimits zu verwalten und von den leistungsfähigsten Modellen zu profitieren, wenn sich der Markt weiterentwickelt.
3. Implementieren Sie robuste Observability und Überwachung
- Alles protokollieren: Protokollieren Sie die Eingaben und Ausgaben jedes einzelnen Schritts in der Kette, nicht nur das Endergebnis. Dies ist entscheidend für das Debugging mehrstufiger Konversationsflüsse und die Durchführung von Ursachenanalysen (RCA) bei Fehlern.
- Wichtige Metriken verfolgen: Überwachen Sie Latenz, Durchsatz, Token-Verbrauch (zur Kostenkontrolle) und Modellfehlerraten in Echtzeit. Automatisierte Warnungen sollten so konfiguriert werden, dass Spitzen bei Halluzinationen oder Ausfällen sofort gemeldet werden.
4. Prüfen Sie Governance- und Sicherheits-Guardrails
- Pre- und Post-Processing-Prüfungen: Umgeben Sie alle LLM-Aufrufe mit Guardrails. Verwenden Sie Pre-Processing-Prüfungen (z. B. Inhaltsfilterung, Blacklisting unerwünschter Themen) für Benutzereingaben und Post-Processing-Prüfungen (z. B. Überprüfung des strukturierten Ausgabeformats, Sicherheitsprüfungen) für die Modellantwort vor der Auslieferung.
- Compliance: Implementieren Sie bei sensiblen Daten frühzeitig im Designprozess Berechtigungsebenen, Anonymisierung und Verschlüsselung, um Compliance-Anforderungen (z. B. HIPAA, DSGVO) zu erfüllen.
4 LLM-Orchestrierungs-Herausforderungen und Mitigationsstrategien
Hier sind einige Probleme im Zusammenhang mit der LLM-Orchestrierung und Methoden zu deren Bewältigung: Kernherausforderungen bei der Multi-LLM-Orchestrierung
1. Koordination und Workflow-Deadlocks
Aufgrund der nicht-deterministischen Natur des LLMs ist es schwierig, klare Übergaben zwischen spezialisierten LLM-Rollen zu definieren. Dies führt zu Aufgabenüberlappung (redundanter Token-Verbrauch) oder Workflow-Deadlocks (eine LLM-Instanz wartet unbegrenzt auf eine mehrdeutige Ausgabe einer anderen).
Mitigation durch strukturierten Workflow und Kommunikation
- Verwenden Sie einen Workflow-Controller, um das Ziel in einen gerichteten azyklischen Graphen (DAG) von Teilaufgaben zu zerlegen.
- Erzwingen Sie ein Pydantic/JSON-Kommunikationsprotokoll für alle Aufgabenübergaben. Dies zwingt das LLM, maschinenlesbare, schema-validierte Daten auszugeben, wodurch Fortschrittssignale eindeutig werden und Zyklen vermieden werden.
2. Kontextdrift und Speicherinkonsistenz
Das feste Kontextfenster des LLMs und seine inhärente Zustandslosigkeit machen es anfällig für Kontextdrift, bei der eine LLM-Rolle das Gesamtziel oder entscheidende frühere Fakten vergisst. In einem Multi-LLM-Setup führt dies zu widersprüchlichen Entscheidungen und inkonsistenten Gesamtergebnissen.
Mitigation durch externalisierte Wissensbasis mit RAG
- Implementieren Sie ein externes Speichersystem (Vektordatenbank oder Wissensgraph). Spezialisierte LLM-Rollen speichern wichtige Fakten, Entscheidungen und Ausgaben als strukturierte Daten. Wenn eine LLM-Instanz Kontext benötigt, verwendet sie Retrieval Augmented Generation (RAG), um diese externe Quelle abzufragen, und stellt so sicher, dass die relevantesten, nicht-redundanten Informationen abgerufen werden.
3. Nicht-deterministische Ausgabe und kaskadierte Halluzination
Die probabilistische Ausgabe des LLMs bedeutet, dass Antworten unzuverlässig sind. Wenn eine LLM-Instanz (der Produzent) Informationen erfindet (halluziniert), behandelt eine nachgelagerte LLM-Instanz (der Konsument) diese als Tatsache, was zu einem vollständigen kaskadierten Ausfall des Multi-LLM-Workflows führt.
Mitigation durch Konsensmechanismen und Validierung
- Setzen Sie ein Konsensmuster für kritische Ausgaben ein. Der Workflow-Controller leitet die anfängliche Ausgabe an eine sekundäre LLM-Validator-Rolle oder eine externe Datenbank/API zur Faktenprüfung weiter. Der Workflow wird fortgesetzt, wenn die Ausgabe erfolgreich verifiziert wurde, wodurch das Risiko nicht-deterministischer Modellfehler effektiv gemindert wird.
4. Ressourcenkonflikte und Kostenüberschreitung
Die Skalierung von Multi-LLM-Workflows erzeugt eine hohe Nachfrage nach der LLM-API (eine kostspielige, ratenbegrenzte Ressource). Dies führt zu Ratenlimit-Fehlern (API-Drosselung) und massivem Token-Verbrauch (Kostenüberschreitung) durch redundante Arbeit oder Schleifen.
Mitigation durch asynchrone Warteschlangen und Budget-Guardrails
- Nutzen Sie eine asynchrone Aufgabenwarteschlange (z. B. Celery) mit einem Ratenbegrenzer, um die Ausführungsparallelität von API-Aufrufen zu steuern.
- Implementieren Sie Observability-Tools, um den Token-Verbrauch pro Aufgabe zu verfolgen und automatische Token-Budgets (Circuit Breakers) einzurichten, die jede außer Kontrolle geratene LLM-Instanz beenden oder pausieren, um die Betriebskosten in Echtzeit zu verwalten.
Ist Orchestrierung eine Schlüsselkomponente für LLM?
Ja. Orchestrierung ist eine Schlüsselkomponente in LLM-basierten Systemen, aber sie ist keine Kernmodellkomponente wie die Modellgewichte oder der Tokenizer. Stattdessen ist sie eine Systemebene-Fähigkeit, die LLMs in realen Anwendungen nutzbar macht.
Unter den wesentlichen Komponenten steht die Orchestrierung typischerweise neben:
- LLM-Modell: Ein Large Language Model (LLM) verarbeitet riesige Datenmengen, um menschenähnlichen Text zu verstehen und zu generieren. Open-Source-Modelle bieten Flexibilität, während Closed-Source-Modelle Benutzerfreundlichkeit und Support bieten. Allzweck-LLMs bewältigen verschiedene Aufgaben, während domänenspezifische Modelle auf spezialisierte Branchen zugeschnitten sind.
- Prompts: Effektive Prompts lenken die Antworten von LLMs.
- Zero-Shot-Prompts: Generieren Antworten ohne vorherige Beispiele.
- Few-Shot-Prompts: Verwenden einige Beispiele, um die Genauigkeit zu verbessern. Erfahren Sie mehr über Few-Shot-Learning-Prompting und andere LLM-Fine-Tuning-Methoden.
- Chain-of-Thought-Prompts: Fördern logisches Denken für bessere Antworten.
- Vektordatenbank: Speichert strukturierte Daten als numerische Vektoren. LLMs verwenden Ähnlichkeitssuchen, um relevanten Kontext abzurufen, was die Genauigkeit verbessert und veraltete Antworten verhindert.
- Erfahren Sie mehr über Vektordatenbanken LLMs, Open-Source-Vektordatenbank-Tools und Vektordatenbank-Anwendungsfälle.
- Agenten und Tools: Erweitern die Fähigkeiten von LLMs, indem sie Websuchen ausführen, Code ausführen oder Datenbanken abfragen. Diese verbessern KI-gesteuerte Automatisierung und Geschäftslösungen.
- Orchestrator (Steuerungsschicht): Integriert LLMs, Prompts, Vektordatenbanken und Agenten zu einem kohäsiven System. Gewährleistet reibungslose Koordination für effiziente KI-gestützte Anwendungen.
- Monitoring: Verfolgt die Leistung, erkennt Anomalien und protokolliert Interaktionen. Gewährleistet qualitativ hochwertige Antworten und hilft, Fehler in LLM-Ausgaben zu mindern.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orchestrierung: 21 Frameworks und Gateways}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Abgerufen am 21. Oktober 2026}
}Ergebnisse und Zeitstempel von 212 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 5 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
9 AktualisierungenDer FAQ-Abschnitt und der Nexos.ai-Eintrag aus der Liste der KI-Gateways wurden entfernt.
Benchmark-Ergebnisse wurden der Einleitung und einem neuen Abschnitt hinzugefügt.
Der Abschnitt „LLM-Orchestrierungstools“ wurde um eine neue Kategorisierung der Tools in „Gateway-basierte Plattformen“ und „Entwickler-Frameworks“ erweitert.
Referenzlinks










Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.