


Top 6 Open-Source-Tools zur Erkennung sensibler Daten
Die folgenden Tools wurden auf Basis der GitHub-Aktivität ausgewählt und absteigend nach der Anzahl der GitHub-Sterne sortiert. Sie decken die wichtigsten Anwendungsfälle für die Erkennung sensibler Daten ab: Metadatenkatalogisierung mit Lineage, agentenloses Scannen und API-basierte Erkennung von PII, PCI-Daten und ruhenden Zugangsdaten.
Eine Sache, die vor der Liste offen gesagt werden sollte: Diese sechs Tools tun nicht alle dasselbe, und einige Namen auf dieser Liste sind streng genommen keine Tools zur Erkennung sensibler Daten.
DataHub, Apache Atlas und Marquez sind Plattformen für Metadatenkataloge und Data Lineage; sie helfen Ihnen zu verstehen, welche Daten Sie haben und wohin sie fließen, was eine Voraussetzung für die Erkennung ist, aber nicht dasselbe wie das Scannen nach PII.
- OpenDLP ist das einzige Tool hier, das speziell für das Auffinden ruhender sensibler Daten entwickelt wurde.
- Piiano Vault ist ein Speichersystem für Daten, von denen Sie bereits wissen, dass sie sensibel sind.
- Nightfall ist eine kommerzielle Erkennungs-Engine mit darum herum aufgebauten Open-Source-Scanner-Skripten.
Jedes passt zu einer anderen Phase des Datensicherheitsproblems.
Lesen Sie mehr: Tools zur Erkennung und Klassifizierung sensibler Daten, DLP-Software.
Administrative Funktionen
Tool | Grafisches Dashboard | Suchbasiert | Data Lineage | Föderiertes Datenbanksystem |
|---|---|---|---|---|
DataHub | ✓ | ✓ | ✓ | ✓ |
Apache – Atlas | ✓ | ✓ | ✓ | ✕ |
Marquez | ✓ | ✓ | ✓ | Nicht angegeben. |
OpenDLP | ✕ | ✕ | ✕ | ✕ |
Piiano Vault – ReDiscovery | ✕ | Nicht angegeben. | ✕ | ✕ |
Nightfall KI – Sensitive data scanner | ✓ | ✓ | ✕ | ✕ |
Funktionsbeschreibungen:
- Grafisches Dashboard – ermöglicht die Visualisierung Ihrer Datenfunde.
- Suchbasierte Funktionalität – ermöglicht die Suche nach Datenbeständen.
- Data Lineage – ermöglicht Benutzern zu visualisieren, wie Daten im Laufe der Zeit systemweit erzeugt, transformiert, übertragen und verwendet werden.
- Föderiertes Datenbanksystem – bildet mehrere autonome Datenbanksysteme in einer einzigen föderierten Datenbank ab.
Diese Funktionalität (insbesondere Data Lineage und Suchfunktionen) ermöglicht Unternehmen:
- Den Speicherort ihrer personenbezogenen Daten (PII), Daten der Kartenzahlungsindustrie (PCI) usw. zu ermitteln, die über mehrere Datenbanken, Apps und Endbenutzergeräte verteilt gespeichert sind.
- Branchenspezifische Datenschutz- und Privatsphäre-Standards wie die Datenschutz-Grundverordnung (DSGVO) und den California Consumer Privacy Act (CCPA) einzuhalten.
Datensicherheitsfunktionen
Funktionsbeschreibungen:
- Datenmaskierung – ermöglicht das Verbergen von Daten durch Ändern ihrer ursprünglichen Buchstaben und Zahlen, sodass sie für unbefugte Eindringlinge wertlos, für autorisierte Mitarbeiter jedoch weiterhin nutzbar sind.
- Data Loss Prevention(DLP) – erkennt potenzielle Datenschutzverletzungen und verhindert sie, indem sensible Daten blockiert werden.
Kategorien und GitHub-Sterne
Toolauswahl & Sortierung:
- Anzahl der Bewertungen: 10+ GitHub-Sterne.
- Sortierung: Tools werden absteigend nach GitHub-Sternen sortiert.
DataHub
DataHub ist eine Open-Source-Metadatenplattform für Datenentdeckung, Observability und Governance, ursprünglich von LinkedIn entwickelt und heute von Acryl Data sowohl als Open-Source-Projekt (Apache 2.0) als auch als kommerzielles Cloud-Angebot gepflegt. Es ist mit großem Abstand das am aktivsten entwickelte Tool auf dieser Liste: 3.000+ Organisationen betreiben DataHub weltweit in Produktion, darunter Hyperscale-Technologieunternehmen, regulierte Finanzinstitute und Gesundheitsdienstleister.
Was DataHub tatsächlich für die Erkennung sensibler Daten leistet
DataHub ist ein Metadatenkatalog, kein Scanner. Es zeigt Ihnen, welche Datenbestände in Ihrem Stack vorhanden sind, wem sie gehören, wie sie durch Pipelines fließen und wie ihre Qualität aussieht, aber es durchsucht keine Dateisysteme oder Datenbanken nach PII-Mustern wie OpenDLP. Der Anwendungsfall für Datenentdeckung, den es löst, lautet: „Wir haben 200 Datenquellen und wissen nicht, was darin enthalten ist oder wer sie nutzt.“ Der Anwendungsfall für die Erkennung sensibler Daten, den es nicht löst, lautet: „Wir müssen alle Dateien mit Sozialversicherungsnummern auf unseren Windows-Endpunkten finden.“
Wichtige Funktionen:
- Spaltenebenen-Data-Lineage: Verfolgt den Datenfluss von der Quelle bis zur Nutzung über Plattformen hinweg. Neue Unterstützung im Jahr 2026 umfasst dynamische Tabellen in Snowflake, zu Quell-Data-Warehouses zurückgeführtes Sigma, Glue und Iceberg, Athena-Zuordnung zum Katalog statt roher S3-Pfade sowie Power BI über den offiziellen M-Query-Parser von Microsoft.
- 90+ native Konnektoren: Snowflake, BigQuery, Redshift, Hive, Athena, Postgres, MySQL, SQL Server, Looker, Power BI, Tableau, Okta, LDAP, S3, Delta Lake und andere. Neue Konnektoren, die in Q2 2026 veröffentlicht wurden, umfassen Airbyte, Matillion, dltHub, Informatica und ThoughtSpot. In Entwicklung: Monte Carlo, SAP Datasphere, AWS QuickSight und Streaming-Konnektoren für Firehose und Kinesis.
- MCP-Server-Unterstützung: Native Unterstützung für KI-Agenten über MCP, LLM-Integrationen und Kontextverwaltung, sodass KI-Assistenten DataHub-Metadaten direkt abfragen können, ohne die Tools zu wechseln.
- Google Cloud vertiefte Integration (April 2026): DataHub erweiterte seinen Google Cloud Knowledge Catalog-Konnektor, um die Gemini Enterprise Agent Platform, Bigtable, Spanner, Pub/Sub und Dataproc Metastore zusätzlich zu BigQuery und Google Cloud Storage zu unterstützen.
Hinweis: DataHubs Architektur führt mehrere miteinander verbundene Dienste aus. Produktionsbereitstellungen erfordern in der Regel Kubernetes. Die Einrichtungskomplexität ist der am häufigsten genannte Schmerzpunkt in der Community, und sie ist mit der Einführung von KI-Funktionen nicht einfacher geworden. Wenn Ihr Team keine Kubernetes-Erfahrung hat, planen Sie Zeit für die Lernkurve ein, bevor Sie sich für eine Produktionseinführung entscheiden.
Apache – Atlas
Apache Atlas ist eine Open-Source-Plattform für Metadatenverwaltung und Governance, die in erster Linie für Hadoop- und Big-Data-Ökosysteme entwickelt wurde. Sie unterstützt Klassifizierung, Lineage-Tracking und Suche über Datenbestände in Umgebungen, die auf Hive, HBase, Kafka, Spark, Sqoop und Storm aufbauen.
Wichtige Funktionen
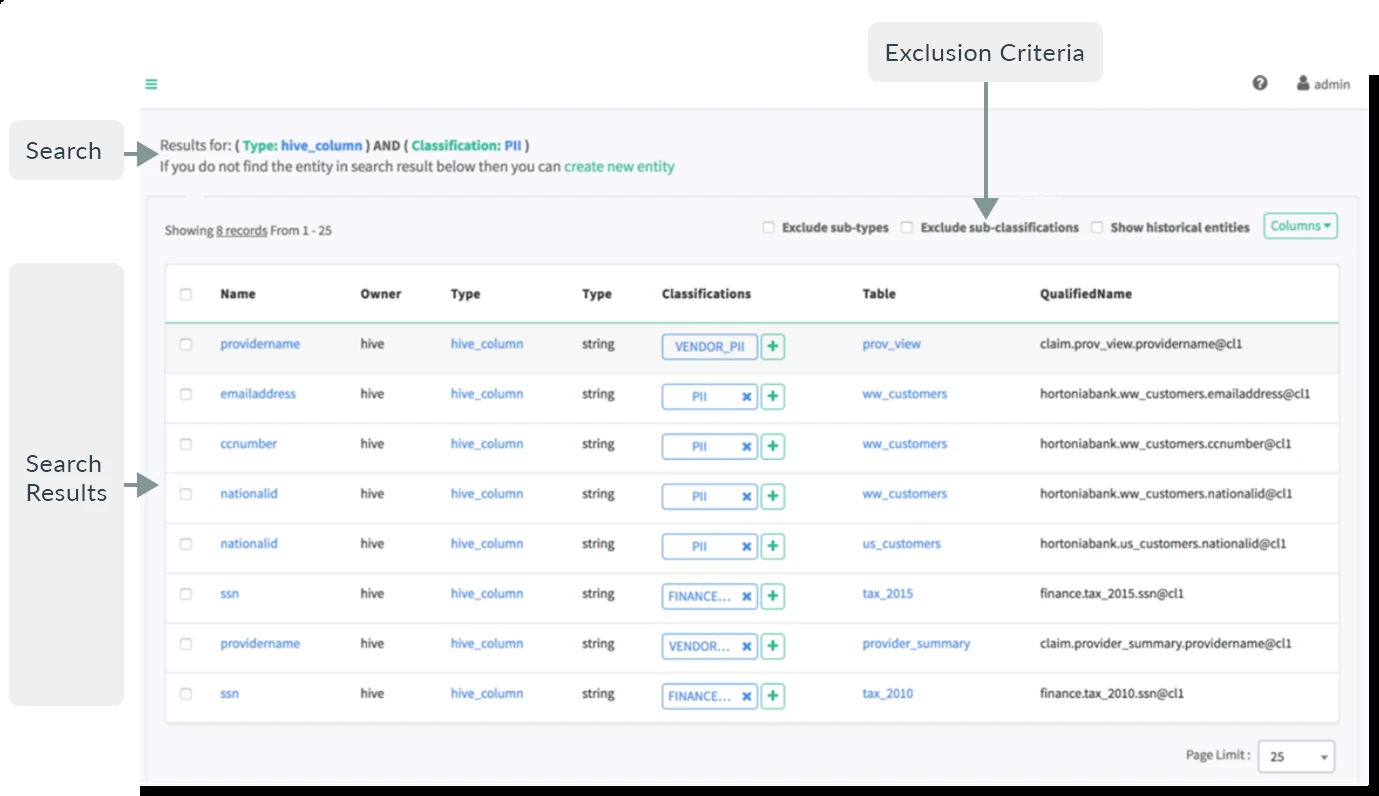
- Dynamische Klassifizierung: Atlas ermöglicht das Erstellen benutzerdefinierter Klassifizierungen wie PII, EXPIRES_ON, DATA_QUALITY und SENSITIVE. Diese können auf Entitäts- oder Attributebene angewendet werden, was nützlich ist, um sensible Spalten in Hive-Tabellen zu kennzeichnen, ohne einen separaten Katalog aufzubauen.
- Metadatentypen: Die Plattform bietet vordefinierte Metadatentypen für Hadoop- und Nicht-Hadoop-Umgebungen, darunter HBase, Hive, Sqoop, Kafka und Storm.
- SQL-ähnliche Abfragesprache (DSL): Atlas unterstützt eine domänenspezifische Sprache, die SQL-ähnliche Abfragefunktionen für die Suche nach Entitäten bietet. Nützlich für Analysten, die mit SQL vertraut sind und den Metadatenkatalog abfragen müssen, ohne eine neue Syntax erlernen zu müssen.
- Integration mit externen Tools: Apache Hive, Apache Spark, Kafka und Presto, wodurch es für Big-Data-Umgebungen geeignet ist.
Hinweise:
- Die Konfiguration von Atlas in einer Multi-Cloud-Umgebung ist komplex, insbesondere bei der Überbrückung von AWS, Azure und Databricks-APIs. Atlas verfügt nicht über native Konnektoren für diese Plattformen; zusätzliche Konfiguration ist erforderlich, um Lineage aus AWS Redshift oder Azure Synapse aufzuzeichnen.
- Cloud-native Katalogisierungsdienste (z. B. AWS Glue) können ein Lineage-Tracking mit geringerem Aufwand für Teams bieten, die bereits an einen einzigen Cloud-Anbieter gebunden sind.
- Atlas eignet sich am besten für Organisationen, die Hadoop, Spark und Hive in großem Umfang betreiben. Teams ohne Hadoop-zentrierten Stack werden feststellen, dass seine Architektur unnötige Komplexität mit sich bringt.
Marquez
Marquez ist ein Open-Source-Metadatendienst zum Sammeln, Aggregieren und Visualisieren von Metadaten des Datenökosystems. Er wurde bei WeWork entwickelt und 2019 als Open Source veröffentlicht. Marquez ist ein Projekt in der Abschlussphase der LF KI & Data Foundation und hat diese im September 2023 abgeschlossen.
Was Marquez tatsächlich tut
Marquez konzentriert sich ausschließlich auf Lineage-Tracking, nicht auf Erkennung. Es ist die Referenzimplementierung des OpenLineage-Standards, der offenen Spezifikation dafür, wie Pipelines Lineage-Metadaten melden. Wenn Sie Apache Airflow, Apache Spark, Apache Flink, dbt oder Dagster verwenden, können diese Tools OpenLineage-Ereignisse ausgeben, die Marquez sammelt und visualisiert. Das Ergebnis ist ein Lineage-Diagramm, das zeigt, wie Datasets durch Ihre Pipelines fließen, welche Jobs sie erzeugt haben und wie vergangene Ausführungen aussehen.
Das macht Marquez nützlich für: zu verstehen, was bricht, wenn sich ein vorgelagertes Dataset ändert; Pipeline-Fehler durch Nachverfolgen der Datenherkunft zu debuggen; und zu wissen, welche Jobs ein bestimmtes Dataset konsumieren, bevor Sie es verwerfen. Es ist kein Tool zum Scannen von Endpunkten auf PII.
Hinweis zur Community-Aktivität
Anfang 2026 sind offene Issues auf Marquez' GitHub, die bis Mai 2025 zurückreichen, weiterhin unbeantwortet. Die Commit-Geschwindigkeit hat sich im Vergleich zu DataHub und OpenMetadata verlangsamt. Wenn Sie einen schnelllebigen Katalog mit reaktionsschnellen Maintainern benötigen, ist Marquez die langsamere Option. Wenn Sie einen stabilen, leichtgewichtigen Lineage-Speicher benötigen, der den OpenLineage-Standard ohne den Infrastrukturaufwand von DataHub implementiert, erfüllt Marquez diese Aufgabe weiterhin gut.
Wichtige Funktionen:
- OpenLineage-Referenzimplementierung: Funktioniert sofort mit jeder OpenLineage-Integration. Das ist Marquez' stärkstes Differenzierungsmerkmal: Kein anderes Tool auf dieser Liste ist die kanonische Implementierung des Lineage-Standards.
- Lineage-Diagramm-Visualisierung: Die Web-UI bietet eine interaktive Ansicht, wie Datasets durch Workflows verbunden und transformiert werden. Nützlich, um Pipeline-Abhängigkeiten zu verstehen und Fehler nachzuverfolgen.
- REST-API und GraphQL: Die Lineage-API ermöglicht die Automatisierung von Aufgaben wie Backfills und Ursachenanalyse durch programmatisches Durchlaufen des Abhängigkeitsbaums. Der GraphQL-Endpunkt befindet sich derzeit in der Beta-Phase.
- Geringer Infrastrukturaufwand: Marquez läuft auf PostgreSQL und benötigt weder Kafka, Elasticsearch noch eine Graphdatenbank, anders als DataHub oder Atlas. Für Teams, die Lineage-Tracking ohne komplexen Stack wünschen, ist genau diese Einfachheit der Punkt.
Beispielworkflow: Um Lineage-Metadaten zu untersuchen, navigieren Sie zur Marquez-UI und suchen Sie über das Suchfeld nach einem Job (z. B. etl_delivery_7_days). Aus dem Ausgabe-Dataset des Jobs können Sie den Dataset-Namen, das Schema, die Beschreibung und die vorgelagerten Eingaben einsehen. Das Lineage-Diagramm zeigt alles, was in dieses Dataset einfließt oder davon abhängt.
 Als bevorzugte Quelle hinzufügen
Piiano Vault – ReDiscovery
Piiano Vault ist ein Privacy Vault zum Speichern und Sichern sensibler personenbezogener Daten in Ihrer eigenen Cloud-Umgebung. Es ist kein Datenentdeckungs-Scanner; diese Unterscheidung ist wichtig genug, um sie klar zu benennen, bevor beschrieben wird, was es tut.
Der Anwendungsfall, den Vault löst, lautet: „Wir wissen, welche Felder sensibel sind (Kreditkartennummern, SSNs, Namen, E-Mails, Telefonnummern), und wir möchten sie aus unseren Anwendungsdatenbanken in einen zentralen, zugriffskontrollierten Speicher verschieben.“ Vault wird zum maßgeblichen Speicher für diese Felder. Die Anwendungsdatenbank enthält einen Token oder eine Referenz; der tatsächliche Wert liegt in Vault. Dies ist ein Architekturmuster für den Datenschutz, kein Erkennungstool.
Vault wird über Docker oder Kubernetes bereitgestellt (Helm-Charts verfügbar). Es gibt SDKs für Python (Django ORM), TypeScript, Java und Go. Das Repository vault-releases wurde zuletzt im August 2025 aktualisiert.
Nightfall
Nightfall ist eine kommerzielle, KI-native DLP-Plattform. Seine GitHub-Repositories enthalten Open-Source-Scanner-Skripte (Apache 2.0), die kommerzielle Erkennungs-API von Nightfall einbinden. Diese Unterscheidung ist für die „Open-Source“-Einordnung wichtig: Die Scanner-Skripte sind Open Source, aber die Erkennungs-Engine, die tatsächlich PII, Zugangsdaten und Zahlungsdaten identifiziert, ist der proprietäre Dienst von Nightfall. Die Ausführung von Scans erfordert einen Nightfall-API-Schlüssel und ruft die kommerzielle API von Nightfall auf. Die free-Stufe ermöglicht bis zu 100 Scans pro Monat für öffentliche und private Repositories.
Dies ist das leistungsfähigste Tool auf dieser Liste für die Erkennung sensibler Daten in modernen Umgebungen. Nightfall deckt GitHub-Repositories, S3-Buckets, Salesforce-Exporte und ähnliche Quellen ab, ist jedoch nicht vollständig Open Source. Wenn Ihre Anforderung null Abhängigkeit von einem kommerziellen Anbieter ist, erfüllt Nightfall dies nicht.
Funktionen des Open-Source-Scanners (free-Stufe):
- Scannt den gesamten Commit-Verlauf öffentlicher und privater Repositories.
- Erkennt Zugangsdaten, Secrets, PII und Kreditkartennummern mithilfe der ML-Erkennungsmodelle von Nightfall.
- Führt bis zu 100 Scans pro Monat kostenlos aus.
- Sendet Warnungen an Slack, wenn Verstöße erkannt werden.
- Überträgt Ergebnisse an ein SIEM, ein Reporting-Tool oder einen Webhook-Endpunkt.
Besonderes Merkmal: Nightfall kann Warnungen an Slack senden, wenn Verstöße erkannt werden, und Ergebnisse an ein SIEM, ein Reporting-Tool oder einen Webhook-Endpunkt übertragen.
Beispielanwendungsfall: Scannen Sie ein Salesforce-Backup, um ruhende sensible Daten zu erkennen. Der Scanner (1) übermittelt Backup-Dateien zur Überprüfung an die API von Nightfall, (2) führt einen lokalen Webhook-Server aus, um Ergebnisse zu empfangen, und (3) exportiert die Ergebnisse in eine CSV-Datei.
Weiterführende Literatur
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Sezer, Sena},
  title  = {{Top 6 Open-Source-Tools zur Erkennung sensibler Daten}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/open-source-sensitive-data-discovery}},
  note   = {AIMultiple. Abgerufen am 21. August 2026}
}Ergebnisse und Zeitstempel von 18 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 3 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
2 AktualisierungenDataHubs Hauptfunktionen um über 90 Konnektoren, neue 2026-Integrationen und MCP-Server-Unterstützung erweitert.
Die Einleitung zur Werkzeugliste wurde aktualisiert.
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.