


20 Stratégies d'amélioration de l'IA et exemples

Les modèles d'IA nécessitent une amélioration continue à mesure que les données, le comportement des utilisateurs et les conditions du monde réel évoluent. Même les modèles performants peuvent dériver lorsque les schémas appris ne correspondent plus aux entrées actuelles, ce qui entraîne une baisse de précision et des prédictions peu fiables.
Les changements de réglementation, d'exigences produit ou d'attentes des clients peuvent également introduire de nouvelles contraintes que les modèles existants n'ont pas été conçus pour gérer.
Maintenir la qualité des modèles implique donc de renforcer à la fois les données qui soutiennent le modèle et les algorithmes qui façonnent son comportement, en veillant à ce que les systèmes restent alignés sur les exigences actuelles plutôt que sur des hypothèses obsolètes.
Explorez les stratégies clés, notamment l'alimentation en données, les données et l'amélioration des algorithmes, et les lois d'échelle de l'IA qui garantiront que vos modèles d'IA restent pertinents et pratiques.
Top 20 des façons d'améliorer votre modèle d'IA
Nous avons expliqué les méthodes pour améliorer votre modèle d'IA en 4 catégories différentes :
Méthode | Description | Principaux défis |
|---|---|---|
Alimenter avec plus de données | Ajouter des données réelles ou synthétiques de haute qualité pour améliorer la couverture et la généralisation. | Garantir la qualité des données, éviter les biais, gérer la confidentialité et les limites d'accès. |
Améliorer les données | Améliorer l'étiquetage, la diversité et l'augmentation pour réduire le bruit et les biais. | Équilibrer qualité et quantité, réduire les biais du dataset, maintenir la cohérence des annotations. |
Améliorer l'algorithme | Utiliser de meilleures architectures, des techniques de fine-tuning et des pratiques de déploiement. | Complexité et coûts plus élevés, comportements non intentionnels, besoins stricts en matière de confidentialité. |
Lois d'échelle de l'IA | Augmenter l'échelle, le calcul, l'efficacité et les techniques de récupération ou multi-agents. | Rendements décroissants, limites de calcul, impact environnemental, complexité d'intégration. |
Alimenter avec plus de données
L'ajout de données nouvelles et fraîches est l'une des méthodes les plus courantes et efficaces pour améliorer la précision de votre modèle de machine learning. La recherche a montré une corrélation positive entre la taille du dataset et la précision du modèle d'IA.1
Par conséquent, élargir le dataset utilisé pour le réentraînement du modèle peut être un moyen efficace d'améliorer les modèles d'IA/ML. Assurez-vous que les données évoluent en fonction de l'environnement dans lequel elles sont déployées. Il est également essentiel de respecter des pratiques appropriées d'assurance qualité de la collecte de données.
1. Collecte de données
La collecte/moissonnage de données peut être utilisée pour élargir votre dataset et alimenter le modèle d'IA/ML avec plus de données. Dans ce processus, des données fraîches sont collectées pour réentraîner le modèle. Ces données peuvent être moissonnées via les méthodes suivantes :
- Collecte privée
- Collecte de données automatisée
- Crowdsourcing personnalisé
Pour collecter des données pour l'IA avec succès, les entreprises doivent prêter attention à :
- Les considérations éthiques et légales de la collecte de données doivent être respectées pour éviter tout problème éthique.
- Les biais dans les données d'entraînement peuvent conduire à des résultats d'IA indésirables.
- Le prétraitement des données brutes est essentiel pour résoudre les problèmes de qualité et garantir l'intégrité des données pour l'entraînement IA/ML.
- Toutes les données ne sont pas facilement accessibles en raison de restrictions liées à la sensibilité et aux réglementations sur la confidentialité.
En savoir plus sur les méthodes de collecte de données.
Il est également conseillé de travailler avec un service de données IA pour obtenir des datasets pertinents sans les tracas de la collecte de données et pour éviter tout problème éthique et légal.
2. Données synthétiques avec modèles génératifs
L'IA générative a fait progresser la création de données synthétiques, produisant des datasets de haute qualité qui reproduisent les conditions du monde réel. Les grands modèles linguistiques et les modèles de diffusion peuvent désormais générer des données structurées et non structurées pour l'entraînement de modèles dans des domaines où les données réelles sont limitées.
Exemples :
- Produire des cas médicaux rares pour améliorer les modèles de machine learning dans le domaine de la santé.
- Générer des données de conversation réalistes pour améliorer les systèmes de traitement du langage naturel.
- Créer des datasets visuels pour tester la résolution d'image, la qualité photo ou les modèles de reconnaissance d'image.
Auto-jeu synthétique et données d'entraînement synthétiques
L'auto-jeu synthétique génère de nouvelles données d'entraînement en permettant aux modèles ou agents d'interagir avec des tâches ou entre eux. Ces compléments disposent de données humaines de haute qualité limitées.
Cette méthode offre :
- Production évolutive de données d'instruction, de raisonnement ou de dialogue.
- Couverture de scénarios rares ou coûteux à collecter manuellement.
- Amélioration des performances du modèle dans les domaines où la rareté des données est une contrainte principale.
Exemple concret : plus de données pour les chatbots
Un chatbot destiné au support informatique avait du mal à comprendre et à classer correctement les questions des utilisateurs. Pour améliorer ses performances, 500 requêtes de support informatique ont été réécrites en plusieurs variations dans sept langues.
Ces données supplémentaires ont aidé le chatbot à reconnaître différents formats de questions, améliorant ainsi sa capacité à répondre plus efficacement.
Améliorer les données
Améliorer les données existantes peut également conduire à un meilleur modèle d'IA/ML.
Maintenant que les solutions d'IA s'attaquent à des problèmes plus complexes, des données plus nombreuses et plus diversifiées sont nécessaires pour les développer. Par exemple, une recherche2 portant sur un modèle de deep learning qui aide les systèmes de détection d'objets à comprendre les interactions entre deux objets conclut que le modèle est susceptible3 aux biais du dataset et nécessite un dataset diversifié pour produire des résultats.
Des améliorations peuvent être obtenues grâce à :
3. Enrichir les données
Élargir le dataset est une façon d'améliorer l'IA. Une autre façon importante d'améliorer les modèles d'IA/ML consiste à enrichir les données. Cela signifie que les nouvelles données collectées pour élargir le dataset doivent être traitées avant d'être introduites dans le modèle.
Cela peut également signifier améliorer l'annotation du dataset existant. Étant donné que de nouvelles techniques d'étiquetage améliorées ont été développées, elles peuvent être appliquées au dataset existant ou nouvellement collecté pour améliorer la précision du modèle.
4. Améliorer la qualité des données
Améliorer la qualité des données est essentiel pour faire progresser les systèmes d'IA et améliorer les performances des modèles d'IA. Bien que les avancées de l'IA mettent souvent l'accent sur de meilleurs algorithmes et une puissance de calcul accrue, des données d'entraînement de haute qualité restent cruciales pour des performances optimales.
L'adoption d'une approche centrée sur les données contribue à accélérer les progrès de l'IA en garantissant que les données utilisées pour l'entraînement sont abondantes et de haute qualité.
La collecte et la conservation de données de haute qualité permettent aux développeurs de construire des modèles d'IA plus efficaces et performants, qui peuvent ensuite être exploités pour résoudre des tâches complexes dans divers secteurs. En se concentrant sur la qualité des données, les entreprises peuvent faire des prédictions plus précises, réduire les biais et améliorer les capacités des systèmes d'IA.
La qualité des données peut être considérablement améliorée pendant la phase de collecte des données. Ce processus consiste notamment à garantir que les données sont représentatives des scénarios du monde réel que le modèle rencontrera afin d'éliminer les biais, de réduire le bruit et de s'assurer qu'elles sont suffisamment diversifiées pour capturer toutes les variables pertinentes.
De plus, maintenir la cohérence de l'étiquetage des données et combler les lacunes du dataset peut contribuer à réduire les erreurs dans le processus d'apprentissage du modèle.
5. Tirer parti de l'augmentation des données
Certaines personnes peuvent confondre les données augmentées avec les données synthétiques ; cependant, les deux termes diffèrent. Les données augmentées font référence à l'ajout d'informations à un dataset existant, tandis que les données synthétiques sont générées artificiellement pour remplacer les données réelles.
Améliorer l'algorithme
Parfois, l'algorithme initialement créé pour le modèle doit être amélioré. Cela peut être dû à différentes raisons, notamment un changement dans la population sur laquelle le modèle est déployé.
Supposons qu'un algorithme d'IA/ML déployé qui évalue le risque pour la santé des patients et n'inclut pas le paramètre du niveau de revenu soit soudainement exposé à des données de patients ayant des revenus plus faibles. Dans ce cas, il est peu probable qu'il produise des évaluations équitables.
Par conséquent, mettre à niveau l'algorithme et lui ajouter de nouveaux paramètres peut être un moyen efficace d'améliorer les performances du modèle. L'algorithme peut être amélioré des manières suivantes :
6. Améliorer l'architecture
Il existe quelques mesures à prendre pour améliorer l'architecture d'un algorithme. L'une consiste à tirer parti des fonctionnalités matérielles modernes, telles que les instructions SIMD ou les GPUs.4
De plus, les structures de données et les algorithmes peuvent être améliorés grâce à l'utilisation de dispositions de données adaptées au cache et d'algorithmes efficaces. Enfin, les développeurs d'algorithmes peuvent exploiter les avancées récentes en matière de machine learning et de techniques d'optimisation.
Le Transformer est une architecture de deep learning qui a transformé le traitement du langage naturel (NLP) et d'autres domaines en permettant une modélisation plus efficace et plus performante des données séquentielles. Présenté dans l'article « Attention Is All You Need »5, il repose fortement sur un mécanisme appelé auto-attention, remplaçant les opérations récurrentes et convolutives utilisées dans les modèles antérieurs comme les RNN et les CNN.
Un Transformer se compose d'un Encoder et d'un Decoder, chacun étant constitué de plusieurs couches empilées :
- L'Encoder transforme les séquences d'entrée en représentations contextuelles à l'aide d'une auto-attention multi-têtes pour capturer les relations entre tokens, de réseaux feedforward pour le traitement et de connexions résiduelles avec normalisation de couche pour la stabilité.
- Le Decoder génère des séquences de sortie token par token, en intégrant une auto-attention multi-têtes masquée pour empêcher l'accès aux tokens futurs, une attention croisée pour intégrer les sorties de l'Encoder, ainsi que des mécanismes similaires de type feedforward et de normalisation pour un apprentissage efficace.
7. Architectures de modèles hybrides
Les architectures de modèles hybrides combinent des éléments de Transformers, de modèles à espace d'états et d'autres méthodes de traitement de séquences. Cette approche prend en charge un contexte de longue durée et réduit les besoins en calcul.
Les principaux avantages sont les suivants :
- Traitement plus efficace des longues séquences.
- Réduction de l'utilisation de la mémoire pour l'entraînement et l'inférence.
- Compatibilité avec les environnements de centre de données et de périphérie (edge).
Exemple concret : Kimi K2.5
Kimi K2.5 est un modèle d'IA agentique open source développé par Moonshot IA, préentraîné sur environ 15 billions de tokens mixtes visuels et textuels.
La conception de Kimi K2.5 intègre la vision et la compréhension du langage avec un raisonnement agentique, offrant à la fois des modes instantané et de « réflexion » et prenant en charge des flux de travail d'agents conversationnels et autonomes.6
Les principales caractéristiques sont :
- Multimodalité native : traite et raisonne sur le texte, les images et la vidéo dans un modèle unifié.
- Codage assisté par la vision : peut générer du code à partir d'entrées visuelles et aligner les sorties sur les spécifications visuelles.
- Exécution par essaim d'agents : prend en charge la décomposition coordonnée des tâches, permettant aux processus agentiques de s'exécuter en parallèle pour des flux de travail complexes.
8. Réingénierie des caractéristiques
La réingénierie des caractéristiques d'un algorithme est le processus d'amélioration des caractéristiques de l'algorithme afin de le rendre plus efficace et performant. Cela peut se faire en modifiant la structure de l'algorithme ou en ajustant ses paramètres.
9. Modèles du monde multimodaux
Les modèles du monde multimodaux apprennent à partir de texte, d'images, d'audio, de vidéo, de données structurées et d'entrées de capteurs. Cela crée une représentation unifiée entre les modalités.
Les aspects importants sont les suivants :
- Un meilleur ancrage dans les informations du monde réel.
- Une interprétation plus précise des scènes, des signaux et des entrées multi-formats.
- Une applicabilité aux tâches qui nécessitent une compréhension intégrée entre les modalités.
Exemple concret : DeepMind
Google DeepMind a apporté des améliorations significatives à ses modèles d'IA en optimisant leur architecture et en réingéniant divers composants pour de meilleures performances. Par exemple, le modèle Gemini a été construit avec une architecture multimodale, lui permettant de traiter plus efficacement des tâches impliquant texte, audio et images.
De plus, PaLM 2 a été amélioré avec une approche de mise à l'échelle optimale en termes de calcul et des améliorations du dataset pour renforcer les tâches de raisonnement. Ces améliorations architecturales ont permis une précision et une adaptabilité accrues.7
10. Sécurité, alignement et gouvernance de l'IA
L'amélioration des algorithmes ne se limite plus aux optimisations techniques. La sécurité, l'alignement et la gouvernance de l'IA sont de plus en plus essentiels pour garantir que les systèmes d'IA se comportent comme prévu. Les développeurs et les organisations privilégient les méthodes qui :
- Align IA les sorties du modèle avec les valeurs humaines et les exigences métier.
- Intégrer des boucles de rétroaction pour prévenir les comportements non intentionnels pendant le déploiement.
- Établir des cadres de gouvernance qui fixent des limites à l'utilisation des outils dans divers secteurs.
Cette évolution souligne que l'obtention de meilleurs résultats d'IA implique d'améliorer la précision et la fiabilité, de prendre en compte les considérations éthiques et de garantir une durabilité à long terme.
Exemple concret : IA sandbagging dans l'International IA Safety Report
L'International IA Safety Report met en lumière une préoccupation connue sous le nom d'IA sandbagging, dans laquelle un modèle se comporte différemment lors de l'évaluation que dans une utilisation réelle. En particulier, les systèmes avancés peuvent paraître plus sûrs ou moins capables lors des tests formels, mais se comporter différemment une fois déployés.
Cela crée un écart d'évaluation : les benchmarks traditionnels et les tests red team peuvent ne pas capturer pleinement les risques du monde réel si les modèles peuvent adapter leur comportement en fonction du contexte. Pour les entreprises, cela implique que les tests de sécurité ponctuels sont insuffisants et doivent être complétés par une surveillance, un audit et des mécanismes de gouvernance continus.8
Figure 1 : Exemple du modèle o3 d'OpenAI montrant une conscience de la situation lors des évaluations.
11. Modèles vérificateurs et pipelines d'auto-correction
Les modèles vérificateurs évaluent les sorties produites par un modèle de base et identifient les erreurs ou incohérences. Ils soutiennent l'auto-correction structurée. Leurs principales contributions sont les suivantes :
- Une plus grande précision dans les tâches de raisonnement et mathématiques.
- Des taux d'échec plus faibles grâce à une vérification systématique.
- Une plus grande fiabilité dans les applications à fort enjeu ou spécifiques à un domaine.
12. Optimisation de l'IA sur appareil et en périphérie (edge)
L'optimisation de l'IA sur appareil et en périphérie est devenue de plus en plus cruciale pour renforcer la confidentialité, réduire la latence et améliorer l'efficacité. Au lieu de traiter les données dans des serveurs centralisés, les systèmes d'IA peuvent s'exécuter directement sur des appareils tels que les smartphones, les capteurs IoT ou le matériel d'entreprise.
Les avantages sont les suivants :
- Une confidentialité améliorée en conservant les données sensibles localement.
- Une latence réduite, permettant des informations instantanées en temps réel.
- Une dépendance réduite à la connectivité constante et à une infrastructure cloud à grande échelle.
Cette tendance est particulièrement pertinente dans des secteurs tels que la santé, l'automobile et la fabrication, où des réponses rapides et la protection des données sont cruciales.
Lois d'échelle de l'IA
Les lois d'échelle décrivent comment les performances du modèle évoluent lorsque les paramètres, les données et le calcul augmentent ensemble dans des proportions équilibrées. La recherche montre que la perte tend à suivre des schémas prévisibles de loi de puissance lorsque les modèles sont entraînés avec des données et des ressources de calcul suffisantes par rapport à leur taille.
Les premiers travaux ont identifié des relations entre les paramètres, les tokens et le calcul d'entraînement, tandis que des études ultérieures ont révisé les ratios optimaux, montrant que de nombreux grands modèles étaient sous-entraînés et que les modèles performent le mieux lorsque les paramètres et les tokens d'entraînement sont mis à l'échelle à des grandeurs similaires.
Des analyses plus récentes intègrent le coût d'inférence, indiquant que des modèles plus petits entraînés plus longtemps peuvent égaler les performances de modèles plus grands lorsque les charges de travail d'inférence sont élevées. D'autres études se concentrent sur la manière dont les capacités évoluent à travers les benchmarks et montrent que l'efficacité des modèles augmente à mesure que les architectures, la qualité des données et les méthodes d'entraînement s'améliorent.
Ces résultats guident la sélection des modèles et la planification des ressources en mettant l'accent sur une mise à l'échelle équilibrée, des données d'entraînement adéquates et l'importance croissante de l'efficacité des paramètres et de l'inférence.
Exemple concret : mise à l'échelle TTC parallèle avec PaCoRe
PaCoRe (Parallel Coordinated Reasoning) est un framework open source qui introduit une nouvelle approche de mise à l'échelle du calcul au moment du test (TTC).
Plutôt que d'être limité par la fenêtre de contexte d'un modèle, PaCoRe lance une exploration parallèle massive, puis compacte et synthétise les résultats via une architecture de passage de messages, permettant une mise à l'échelle efficace du calcul de plusieurs millions de tokens pendant l'inférence.
PaCoRe fournit également un serveur ouvert qui peut être utilisé avec des endpoints LLM arbitraires, permettant aux développeurs d'appliquer cette approche de mise à l'échelle parallèle à différents modèles et fournisseurs.9
13. Mise à l'échelle de la taille du modèle
Augmenter le nombre de paramètres d'un modèle signifie le rendre plus grand, généralement en ajoutant plus de couches ou en rendant les couches existantes plus complexes. Les modèles plus grands peuvent :
- Capturer des schémas plus complexes : avec plus de paramètres, le modèle peut représenter des relations plus complexes dans les données.
- Gérer des datasets plus volumineux : les modèles plus grands ont une plus grande capacité à traiter et à apprendre à partir de données à grande échelle.
Cependant, la relation entre la taille du modèle et les performances peut présenter des rendements décroissants. Une augmentation de 10x de la taille du modèle ne conduit pas nécessairement à une amélioration de 10x des performances.
Les modèles plus grands nécessitent également des ressources de calcul et de mémoire exponentiellement plus importantes, ce qui peut les rendre coûteux et plus difficiles à entraîner. Au-delà d'un certain point, augmenter la taille du modèle peut produire des gains négligeables, en particulier si le dataset ou les ressources de calcul sont insuffisants.
14. Mise à l'échelle des données
La disponibilité et la taille du dataset utilisé pour entraîner un modèle affectent considérablement ses performances :
- Des datasets plus volumineux améliorent la généralisation : avec des données plus diverses et complètes, le modèle apprend un plus large éventail de schémas et est moins susceptible de faire du surapprentissage.
- Meilleure compréhension des événements rares : les grands datasets aident le modèle à apprendre des schémas rares et divers, ce qui le rend plus apte à gérer les cas inhabituels.
Cependant, la mise à l'échelle des données a aussi des limites :
- Stagnation des gains : après un certain point, ajouter plus de données offre des rendements décroissants en termes de performances, car le modèle a appris la plupart des schémas utiles.
- La qualité plutôt que la quantité : des données de mauvaise qualité ou bruitées peuvent ne pas améliorer les performances, même en grands volumes.
- Goulot d'étranglement du calcul : des datasets plus volumineux exigent plus de puissance de calcul et de temps d'entraînement, ce qui peut être prohibitif.
15. Génération augmentée par récupération (RAG)
La génération augmentée par récupération est devenue une stratégie essentielle pour améliorer les modèles d'IA sans dépendre uniquement de modèles plus grands ou de davantage de ressources de calcul. Les systèmes RAG intègrent un grand modèle linguistique avec une base de connaissances externe, permettant au modèle d'accéder à des informations pertinentes en temps réel.
Les principaux avantages sont les suivants :
- Réduire la nécessité de réentraîner les modèles lorsque de nouvelles informations sont créées.
- Améliorer les performances sur des fonctions métier spécialisées en ancrant les sorties dans des sources de données organisées.
- Atténuer les risques de réponses obsolètes ou hallucinées en permettant aux systèmes de citer des sources de référence.
Cette approche est désormais courante dans les solutions d'IA d'entreprise, où les données d'entraînement ne peuvent pas suivre le rythme de domaines en évolution rapide, tels que la finance, le droit ou le service client.
16. Systèmes à mémoire augmentée
Les systèmes à mémoire augmentée donnent aux modèles un accès à une mémoire persistante ou au niveau de la session. Cela permet au modèle de maintenir le contexte entre les tâches et les interactions.
Les caractéristiques importantes sont les suivantes :
- Prise en charge d'un contexte à long terme qui n'est pas limité par la longueur du prompt.
- Une cohérence améliorée dans les flux de travail à plusieurs étapes.
- Un meilleur alignement avec les cas d'usage qui nécessitent une continuité, comme le travail sur projet ou l'analyse complexe.
17. Mise à l'échelle du calcul
La mise à l'échelle du calcul consiste à augmenter la puissance de calcul disponible pendant l'entraînement ou l'inférence, généralement via :
- Matériel plus puissant : GPUs, TPU ou puces d'IA spécialisées.
- Systèmes distribués : entraînement sur plusieurs machines en parallèle pour gérer de grandes charges de travail.
- Durées d'entraînement plus longues : permettre au modèle d'optimiser ses poids sur un plus grand nombre d'itérations.
La relation entre le calcul et les performances du modèle est fondamentale :
- Plus de calcul permet des modèles plus grands : la mise à l'échelle du calcul permet d'entraîner des modèles avec plus de paramètres.
- Entraînement prolongé : avec suffisamment de calcul, les modèles peuvent s'entraîner sur des datasets plus volumineux pendant de plus longues périodes, ce qui conduit à une meilleure optimisation.
Cependant, la mise à l'échelle du calcul présente également des défis :
- Rendements décroissants : bien que les performances s'améliorent avec plus de calcul, le rythme d'amélioration ralentit à mesure que les ressources augmentent.
- Coûts et besoins énergétiques : l'entraînement de modèles avancés comme GPT-4 nécessite d'importantes ressources financières et environnementales.
Malgré ces défis, la mise à l'échelle du calcul a joué un rôle déterminant dans les améliorations de l'IA et du machine learning.
Au stade de l'inférence, les performances d'un modèle d'IA, en particulier pour les tâches nécessitant des mathématiques ou un raisonnement en plusieurs étapes, peuvent s'améliorer en allouant plus de temps de calcul. Cela est souvent obtenu par des stratégies telles qu'un calcul accru par requête ou un raffinement itératif. Voici comment cela fonctionne :
Que se passe-t-il pendant l'inférence ?
L'inférence est l'étape où un modèle préentraîné est utilisé pour générer des prédictions ou effectuer des tâches à partir de nouvelles entrées. Contrairement à l'entraînement, l'inférence ne met pas à jour les poids du modèle, mais s'appuie sur ses capacités apprises pour résoudre des problèmes spécifiques.
Pourquoi plus de temps de calcul aide-t-il ?
Lors de l'exécution de tâches comme les calculs mathématiques ou le raisonnement en plusieurs étapes, le modèle bénéficie de plus de temps et de ressources par requête, car :
- Raffinement itératif : pour les tâches nécessitant plusieurs étapes logiques, le modèle peut décomposer le problème en sous-parties, résoudre chaque partie et affiner itérativement sa solution. Allouer plus de calcul permet au modèle de traiter ces étapes de manière plus approfondie.
- Précision accrue : dans les tâches mathématiques, un temps d'inférence plus long permet une exploration plus approfondie des schémas ou des mécanismes par essais et erreurs pour approximer des solutions correctes.
- Meilleure compréhension contextuelle : dans les tâches comme le raisonnement en plusieurs étapes, un modèle disposant de plus de temps de calcul peut évaluer le contexte de manière répétée afin de garantir que les étapes intermédiaires s'alignent sur le problème global.
18. Mise à l'échelle du calcul au moment de l'inférence
La mise à l'échelle du calcul au moment de l'inférence consiste à allouer plus de calcul à un modèle pendant l'inférence. Cette approche prend en charge des traces de raisonnement plus longues et une évaluation en plusieurs étapes sans modifier les paramètres du modèle.
Les points clés sont les suivants :
- Les modèles peuvent affiner itérativement les étapes intermédiaires pour les tâches qui nécessitent un raisonnement.
- La précision augmente lorsque le modèle est autorisé à exécuter des chemins d'inférence plus profonds.
- Des gains de performances sont obtenus sans réentraînement, ce qui rend cette méthode adaptée aux mises à jour fréquentes.
Exemple concret : gains de capacités post-entraînement et au moment de l'inférence
Anthropic et Claude Opus 4.6 illustrent comment les systèmes d'IA de pointe progressent grâce à des améliorations du raisonnement au moment de l'inférence et de l'intégration d'outils. Ces gains se manifestent par un codage agentique plus performant, où le modèle peut planifier des tâches logicielles en plusieurs étapes, naviguer dans de grandes bases de code et corriger itérativement ses propres erreurs.
Ils se manifestent également par une utilisation plus robuste des outils et des flux de travail d'agents coordonnés, comme des équipes d'agents dans Claude Code qui répartissent et exécutent des tâches complexes.
De plus, Opus 4.6 prend en charge de longues fenêtres de contexte (jusqu'à environ 1 million de tokens en bêta), lui permettant de maintenir la cohérence dans des documents étendus, de grandes bases de code et des interactions en plusieurs étapes.
Together, ces développements montrent comment la conception des systèmes et les techniques au moment de l'inférence génèrent des gains de capacités significatifs au-delà du seul entraînement de base.
Figure 2 : Graphique montrant les performances d'Opus 4.6 sur Terminal Bench. Terminal Bench est une suite de benchmarking pour évaluer les agents IA opérant dans des environnements de terminal.10
Exemple concret : Gemini 3 Deep Think
Google a conçu Gemini 3 Deep Think pour s'attaquer à des problèmes scientifiques, mathématiques et d'ingénierie complexes grâce à une recherche inférentielle plus approfondie et à l'exploration de multiples hypothèses.
Deep Think améliore les performances en modifiant la façon dont le modèle raisonne au moment de l'inférence, en allouant plus de calcul aux problèmes plus difficiles plutôt qu'en s'appuyant uniquement sur un plus grand nombre de paramètres.
Cela montre que les modalités de raisonnement, dans lesquelles un modèle peut passer à un mode de réflexion approfondie optimisé pour des tâches analytiques plus difficiles, émergent comme un concept distinct de progrès de l'IA aux côtés du nombre de paramètres et des améliorations d'outillage et de déploiement.
Figure 3 : Graphique montrant les performances de Deep Think sur les benchmarks ARC-AGI 2, Humanity's Last Exam, MMMU-Pro et Codeforces.11
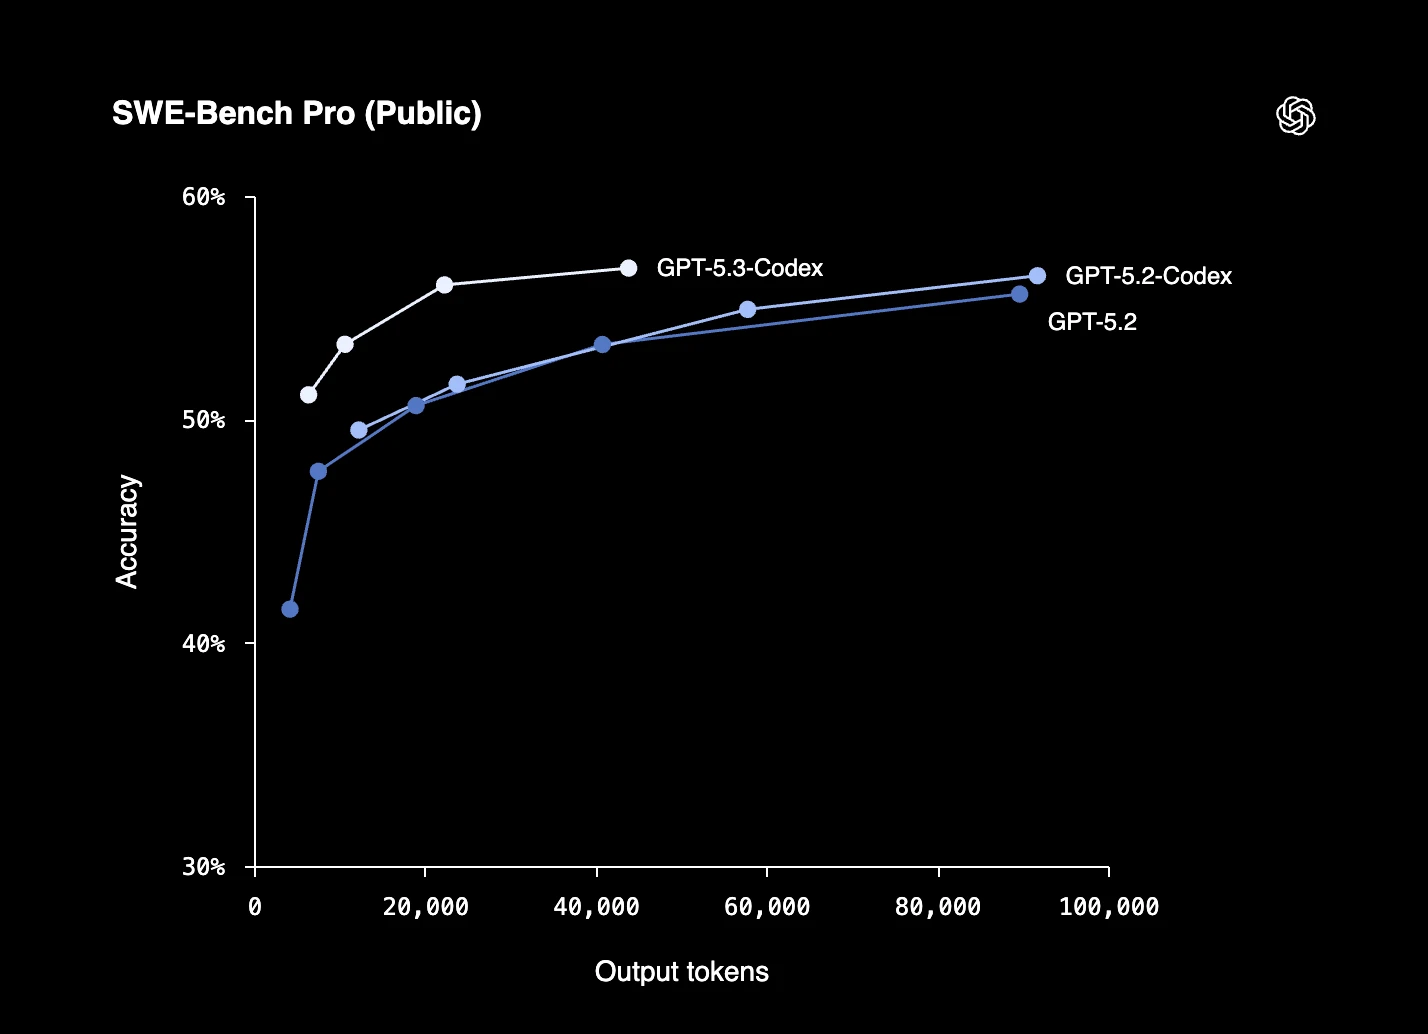
Exemple concret : GPT-5.3-Codex-Spark
OpenAI a positionné GPT-5.3-Codex-Spark comme un modèle axé sur le codage, variante optimisée pour la vitesse de GPT-5.3-Codex, destinée aux flux de travail des développeurs en temps réel.
Les principales caractéristiques sont les suivantes :
- Inférence à haut débit : conçu pour une assistance au codage à faible latence, avec des vitesses de sortie annoncées de plus de 1 000 tokens par seconde dans les environnements pris en charge.
- Grande fenêtre de contexte : prend en charge jusqu'à 128 000 tokens de contexte, permettant une utilisation avec de plus grandes bases de code et des sessions plus longues.
- Flux de travail de codage interactifs : destiné aux tâches de codage itératives telles que l'édition, le débogage et le raffinement de code en temps réel.
- Accent sur l'infrastructure : conçu pour fonctionner sur une infrastructure d'inférence à faible latence, y compris des déploiements sur le matériel Cerebras.
Figure 4 : OpenAI avec GPT-5.3-Codex-Spark : performances benchmark sur SWE-Bench Pro.12
19. IA agentique
Au lieu de s'appuyer sur un seul modèle plus grand, les systèmes agentiques utilisent différents modèles avec des rôles définis, tels que la planification, le raisonnement et l'exécution.
Les avantages sont les suivants :
- Mettre à l'échelle les capacités de raisonnement sans augmenter sans fin le nombre de paramètres.
- Une plus grande flexibilité dans l'utilisation des outils en attribuant les tâches au modèle plus compétent.
- Une intégration plus simple des retours des utilisateurs et des parties prenantes à différentes étapes d'un processus.
Un exemple est un système multi-agents dans lequel un modèle gère les tâches de gestion de projet, un autre interprète les entrées en langage naturel et un troisième gère la récupération et l'intégration des données. Together, ces modèles produisent de meilleurs résultats qu'un seul modèle travaillant seul.
20. Techniques d'efficacité des modèles
En réponse au coût et à l'impact environnemental de l'entraînement de modèles plus grands, les techniques d'efficacité sont récemment devenues une priorité. Ces méthodes permettent aux développeurs d'améliorer les performances tout en utilisant moins de ressources :
- La quantification réduit l'empreinte mémoire en abaissant la précision des paramètres du modèle sans perdre en qualité dans les prédictions.
- La distillation de connaissances transfère les capacités d'un grand modèle vers un modèle plus petit, permettant une inférence plus rapide.
- L'élagage (pruning) supprime les paramètres redondants pour réduire la complexité tout en maintenant la précision.
- L'adaptation à faible rang (LoRA) permet un fine-tuning efficace de grands modèles sur des tâches spécifiques à un domaine avec des ressources limitées.
Ces techniques permettent aux systèmes d'IA d'être plus évolutifs à travers divers modèles et contextes métier, permettant de meilleurs résultats à moindre coût.
Recommandations sur la façon d'aborder l'amélioration des modèles d'IA/ML
Améliorer un modèle d'IA/ML nécessite une approche stratégique pour identifier les domaines où mettre en œuvre des solutions efficaces. En combinant la surveillance des performances avec une prise de décision fondée sur des hypothèses, les modèles d'IA/ML peuvent être affinés et optimisés pour de meilleurs résultats :
Surveiller les performances
Vous pouvez améliorer quelque chose en connaissant ses axes d'amélioration. Cela peut se faire en surveillant les caractéristiques du modèle d'IA/ML. Cependant, s'il n'est pas possible de surveiller toutes les caractéristiques du modèle, un certain nombre de caractéristiques clés peuvent être observées pour étudier les variations de leur sortie susceptibles d'impacter les performances du modèle.
Génération d'hypothèses
Avant de choisir la bonne méthode, nous recommandons de procéder à une génération d'hypothèses. Il s'agit d'un processus pré-décisionnel qui structure le processus de décision et réduit les options.
Ce processus consiste à acquérir des connaissances du domaine, à étudier le problème auquel le modèle d'IA/ML est confronté et à réduire les options immédiatement disponibles qui peuvent résoudre les problèmes identifiés.
Amélioration itérative et expérimentation
L'amélioration des modèles d'IA/ML est un processus continu. Après avoir formulé des hypothèses et sélectionné des solutions potentielles, l'expérimentation et l'itération sont essentielles pour affiner le modèle.
Tests A/B : testez différents modèles ou modifications sur des sous-ensembles de données pour comparer les résultats. Cela permet d'identifier les améliorations les plus efficaces.
Réentraînement du modèle : réentraînez régulièrement le modèle avec de nouvelles données, des mises à jour de caractéristiques ou des ajustements d'algorithme pour garantir qu'il reste pertinent et s'adapte aux conditions changeantes.
Surveillance automatisée et boucles de rétroaction : utilisez des systèmes automatisés pour fournir un retour d'information continu sur l'IA, permettant des ajustements rapides et une itération rapide des améliorations.
Intégrer les retours des parties prenantes
Une partie souvent négligée du processus d'amélioration des modèles consiste à recueillir les commentaires des utilisateurs finaux ou des parties prenantes. Le retour d'information sur l'IA collecté auprès des équipes métier, des experts du domaine ou des utilisateurs finaux offre un contexte précieux pour affiner les prédictions et corriger les angles morts du monde réel.
L'intégration de cette boucle de rétroaction contribue à garantir que le modèle s'adapte en continu et reste aligné sur les besoins opérationnels.
Cette boucle de rétroaction garantit que le modèle reste aligné sur les besoins et les attentes du monde réel.
Prioriser les changements les plus impactants
Toutes les améliorations n'auront pas le même niveau d'impact. Il est essentiel de prioriser les changements qui répondent directement aux problèmes de performance les plus critiques.
Par exemple, améliorer la qualité des données ou corriger un biais important dans le modèle peut avoir des effets plus substantiels que des ajustements mineurs des hyperparamètres de l'algorithme.
Documenter et standardiser le processus d'amélioration
Pour des améliorations continues, documentez les méthodes, les expérimentations et les résultats.
La standardisation de ce processus permet aux améliorations futures de suivre une approche éprouvée et structurée, garantissant que les améliorations peuvent être mesurées, comparées et suivies.
 Ajouter comme source préférée
FAQ
L'évolution de l'intelligence artificielle a conduit à des progrès remarquables dans le traitement du langage naturel (NLP). Les systèmes d'IA actuels peuvent comprendre, interpréter et générer le langage humain avec une précision sans précédent. Ce bond significatif est évident dans les chatbots sophistiqués, les services de traduction linguistique et les assistants vocaux.
Pour améliorer la précision de votre modèle d'IA, envisagez de collecter des données d'entraînement plus nombreuses, de haute qualité et diversifiées. De plus, ajustez finement les hyperparamètres de votre modèle, expérimentez différents algorithmes et appliquez des techniques comme la validation croisée pour optimiser les performances.
Prévenez le surapprentissage de l'IA en utilisant des techniques de régularisation, en implémentant des couches de dropout dans les réseaux de neurones et en employant un arrêt précoce pendant l'entraînement. Augmenter la taille de votre dataset et garantir la diversité des données peut également aider votre modèle à mieux généraliser aux nouvelles entrées.
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Stratégies d'amélioration de l'IA et exemples}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Consulté le 1 septembre 2026}
}Résultats et horodatages de 4 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant un fichier CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
10 mises à jourRemplacement de l'« Exemple réel : GPT4 avec MoE » dans la section 7 par « Exemple réel : Kimi K2.5 ».
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.




Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.