


LLM Orkestrasyonu: 21 Framework ve Ağ Geçidi

LLM orkestrasyonunu optimize etmek, kaynak kullanımını kontrol altında tutarken performansı artırmanın anahtarıdır. Farklı orkestrasyon yaklaşımlarının pratikte nasıl performans gösterdiğini değerlendirmek için şunları kıyasladık:
- Ajan tabanlı orkestrasyon framework'leri: Aynı beş ajanlı seyahat planlama iş akışını her biri 100 kez çalıştırarak; pipeline gecikmesini, token kullanımını, ajandan ajana geçişleri ve ajandan araca yürütme boşluklarını ölçtük.
- Yapay zeka ağ geçitleri: OpenRouter, SambaNova, TogetherAI, Groq ve AI/ML API; 300 kısa (≈18 token) ve uzun (≈203 token) prompt testiyle ilk token gecikmesi, toplam gecikme ve çıktı token sayısı açısından test edildi.
Seçili LLM orkestrasyon araçlarını keşfedin; geliştirici framework'leri ve kurumsal ağ geçitleri dahil:
LLM'de orkestrasyon nedir?
LLM orkestrasyonu, karmaşık görevleri verimli bir şekilde yerine getirmek için birden fazla Büyük Dil Modelini (LLM'leri) yönetmeyi ve entegre etmeyi içerir. Model'ler, iş akışları, veri kaynakları ve pipeline'lar arasındaki etkileşimi sağlar ve birleşik bir sistem olarak performansı optimize eder. Kuruluşlar, doğal dil üretimi, makine çevirisi, karar verme ve chatbot'lar gibi görevler için LLM orkestrasyonunu kullanır.
LLM'ler güçlü temel yeteneklere sahip olsa da gerçek zamanlı öğrenme, bağlamı koruma ve çok adımlı sorunları çözme konusunda sınırlıdır. Ayrıca, çeşitli sağlayıcı API'leri arasında birden fazla LLM'i yönetmek orkestrasyon karmaşıklığını artırır.
LLM orkestrasyon framework'leri; prompt mühendisliğini, API etkileşimlerini, veri alımını ve durum yönetimini düzene sokarak bu zorlukların üstesinden gelir. Bu framework'ler, LLM'lerin verimli bir şekilde işbirliği yapmasını sağlayarak doğru ve bağlama duyarlı çıktılar üretme yeteneklerini artırır.
LLM orkestrasyonu için en iyi platform nedir?
LLM orkestrasyon framework'leri, çeşitli uygulamalarda Büyük Dil Modellerinin (LLM'lerin) kullanımını yönetebilir, koordine edebilir ve optimize edebilir. Bir LLM orkestrasyon sistemi, farklı yapay zeka bileşenleriyle entegrasyonu sağlar, prompt mühendisliğini kolaylaştırır, iş akışlarını yönetir ve performans izlemeyi geliştirir.
Bunlar özellikle çok ajanlı sistemler, erişim-artırılmış üretim (RAG), konuşmaya dayalı yapay zeka ve otonom karar verme içeren uygulamalar için faydalıdır.
Gezinmeyi kolaylaştırmak için araçlar iki kategoriye ayrılmıştır:
1. Ağ geçidi tabanlı platformlar
Ağ geçidi platformları, LLM'lere erişimi merkezileştiren, güvenlik politikalarını uygulayan, uyumluluğu yöneten ve kullanım izleme sağlayan kurumsal odaklı çözümlerdir. Bu platformlar, kontrollü, ölçeklenebilir ve yönetilen LLM dağıtımına ihtiyaç duyan kuruluşlar için idealdir.
İşte bazı yapay zeka ağ geçitleri ve GitHub puanları:
Yapay zeka ağ geçidi benchmark sonuçları
Benchmark'ımız, ağ geçitlerinin sağlayıcıları ne kadar verimli seçtiğini ve yanıtları ne kadar verimli ilettiğini değerlendirmek için ilk token gecikmesi (FTL) ve token çıktısıyla toplam gecikmeyi kullandı. İşte sonuçlarımızdan bazıları:
- En iyi performans gösterenler:
- Groq: Uzun prompt'lar için en hızlı FTL (0.14 sn) ve düşük toplam gecikme (2.7 sn), 1.900 token ile
- SambaNova: Kısa prompt'larda en hızlı FTL'de eşit (0.13 sn) ve en düşük ikinci toplam gecikme (3 sn) ile en yüksek token sayısını (1.997) üretirken
- Orta düzey performans gösterenler:
- OpenRouter: FTL 0.40–0.45 sn, uzun prompt'lar için toplam gecikme 25 sn, orta düzey token çıktısı
- TogetherAI: FTL 0.43–0.45 sn, toplam gecikme 11 sn ve 1.812 token
- En düşük performans gösteren: AI/ML API, en yüksek FTL (0.84–0.90 sn) ve toplam gecikme (13 sn), orta düzey token çıktısına rağmen.
Daha fazla ayrıntı ve metodoloji için lütfen yapay zeka ağ geçidi benchmark makalemizi inceleyin.
İşte alfabetik sıraya göre sıralanmış LLM orkestrasyonu için ağ geçidi tabanlı platformların listesi:
Bifrost, Maxim AI tarafından
Bifrost, 15+ LLM sağlayıcısına tek bir OpenAI uyumlu API üzerinden erişimi birleştiren; otomatik yük devretme, yük dengeleme ve merkezi yönetişim politikalarını destekleyen bir yapay zeka ağ geçididir.
Benzersiz özellik: Model Context Protocol (MCP) entegrasyonu; çok sağlayıcılı LLM'ler için akış, eklenti tabanlı izleme ve analitik sağlar.
Cloudflare AI Ağ Geçidi
Cloudflare AI Ağ Geçidi, teknik yapay zeka iş yükleri için birleşik faturalandırma, maliyet izleme ve otomatik dayanıklılık özellikleri sağlayan, birden fazla büyük dil modeline erişim sunan bir yapay zeka inference proxy ve orkestrasyon platformudur.
Benzersiz özellik: Çoklu sağlayıcılı yük devretme ve uç tabanlı akış tamponlama; uzun süre çalışan uygulama akış yanıtlarını, inference çıktısını doğrudan Cloudflare'ın küresel ağında önbelleğe alarak bağlantı kopmalarından korur.
Kong
Kong AI Ağ Geçidi, LLM trafiğini merkezileştiren ve güvence altına alan; kuruluşların uyumluluk ve kaynak takibi için birden fazla yapay zeka modelini entegre etmesine, yönetmesine ve izlemesine olanak tanıyan semantik bir yapay zeka ağ geçididir.
Benzersiz özellik: Hassas bilgileri korumak için PII sanitasyonu ve gelişmiş prompt şablonları dahil semantik prompt güvenliği.
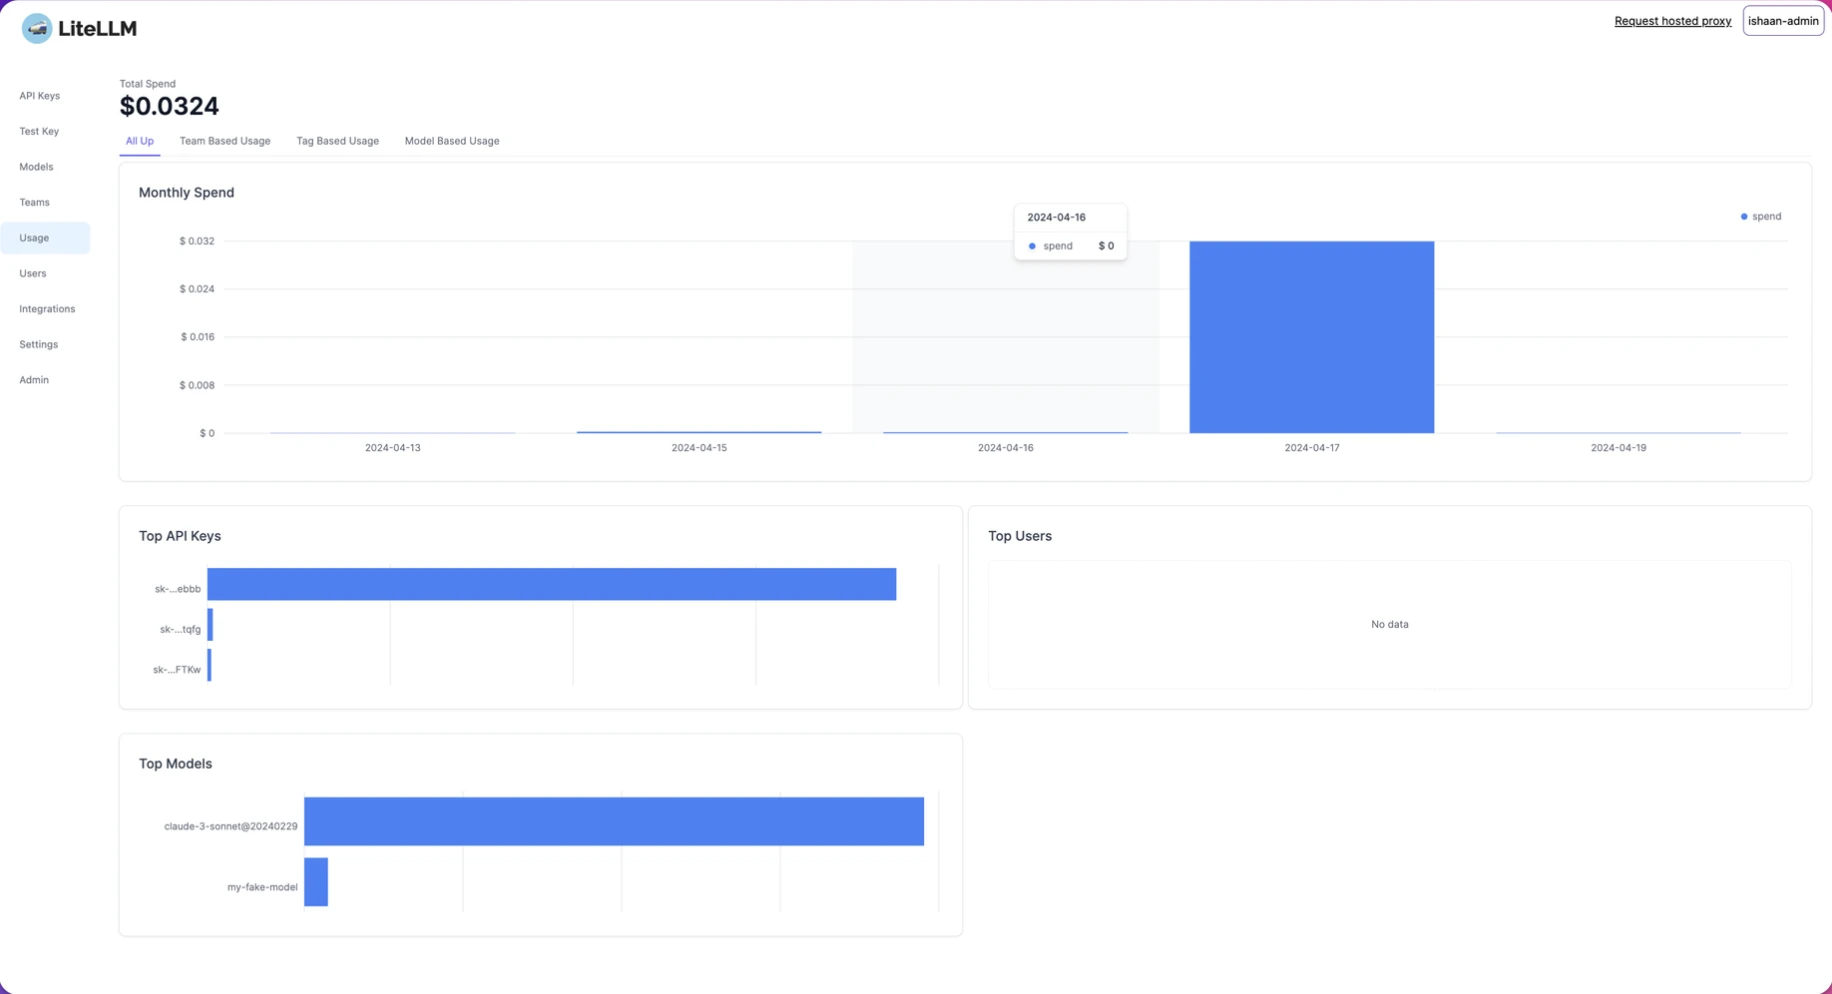
LiteLLM
LiteLLM, birleşik bir arayüz üzerinden birden fazla LLM'e erişim sağlar; merkezi yönetim ve sistem gözlemlenebilirliği için hem bir Proxy Sunucusu (LLM Ağ Geçidi) hem de bir Python SDK sunar.
Benzersiz özellik: Programatik LLM yönetimi ve gözlemlenebilirlik için Python SDK entegrasyonu; geliştiricilerin merkezi yapay zeka kontrollerini doğrudan koda gömmesine olanak tanır.
Prisma AIRS Yapay Zeka Ağ Geçidi (Eski adıyla Portkey)
Prisma AIRS AI, geliştiricileri birden fazla LLM'e bağlayan; teknik yapay zeka ekipleri için programatik yönlendirme, yük devretme, maliyet izleme ve dağıtım özelliklerini destekleyen bir yapay zeka ağ geçidi ve orkestrasyon platformudur.
Benzersiz özellik: Gelişmiş çıktı tutarlılığı için fine-tuning yetenekleriyle metin, resim, ses ve görüş model'lerini içeren çok modlu LLM desteği.
2. Geliştirici framework'leri
Geliştirici framework'leri, LLM iş akışlarını oluşturma ve orkestrasyon üzerinde tam kontrol isteyen mühendisler ve yapay zeka geliştiricileri için tasarlanmıştır. Model'leri zincirlemek, prompt'ları yönetmek ve çoklu LLM etkileşimlerini ele almak için SDK'lar, API'ler ve önceden oluşturulmuş modüller sunarlar.
İşte geliştiriciler için LLM orkestrasyon araçlarının ve GitHub yıldızlarının alfabetik sıraya göre tam listesi:
Benchmark sonuçları
Orkestrasyon framework'leri benchmark'ından önemli bulgular:
- LangGraph: En hızlı şekilde çalışır ve en verimli durum yönetimine sahiptir
- LangChain: Daha ağır bellek ve geçmiş işleme nedeniyle daha fazla token tüketir
- AutoGen: Tutarlı koordinasyon davranışıyla orta düzeyde performans gösterir
- CrewAI: Araç çağrılarından önce otonom değerlendirme nedeniyle en uzun gecikmeleri yaşar.
Benchmark'ın metodolojisi ve daha ayrıntılı analizi için lütfen ajana dayalı orkestrasyon benchmark'ına göz atın.
Aşağıda açıklanan araçlar alfabetik sıraya göre listelenmiştir:
Agency Swarm
Agency Swarm, OpenAI agents SDK'sını kullanarak yapay zeka ajan sürülerini oluşturmak, orkestrasyonunu yapmak ve yönetmek için araçlar sağlayan bir Çoklu Ajan Sistemi (MAS) framework'üdür.
Temel özellikler:
- Çok ajanlı koordinasyonu destekler; birden fazla yapay zeka ajanının eşzamanlı olarak veri alışverişi yapmasına ve iş akışlarını yürütmesine olanak tanır.
- Simülasyon ve görselleştirme araçları içerir; bunlar, ajan etkileşimlerini simüle edilmiş bir ortamda test etmeye ve izlemeye yardımcı olur.
- Ortama dayalı yapay zeka etkileşimlerini sağlar; yapay zeka ajanları değişen koşullara dinamik olarak yanıt verebilir.
AutoGen
Microsoft tarafından geliştirilen AutoGen, konuşmaya dayalı ajanlar kullanarak yapay zeka görev otomasyonunu basitleştiren açık kaynaklı çok ajanlı orkestrasyon framework'üdür.
Temel özellikler:
- Çok ajanlı konuşma framework'ü; yapay zeka ajanlarının iletişim kurmasına ve görevleri koordine etmesine olanak tanır.
- Birden fazla model sağlayıcısıyla çalışır; OpenAI ve Azure dahil.
- Modüler, yapılandırılabilir mimari; çeşitli yapay zeka uygulamaları için özelleştirilebilir bir kurulum.
crewAI
crewAI açık kaynaklı çok ajanlı bir framework'tür. Rol yapma tabanlı yapay zeka ajanlarının yapılandırılmış görevler üzerinde işbirliği yapmasını sağlar.
Temel özellikler:
- Ajan tabanlı iş akışı otomasyonu; görev yürütmede yapay zeka ajanlarına belirli roller atar.
- Hem teknik hem teknik olmayan kullanıcıları destekler
- Enterprise sürümü (crewAI+) mevcuttur
Haystack
Haystack, bileşen tabanlı bir yaklaşımla esnek yapay zeka pipeline'ı oluşturmayı sağlayan açık kaynaklı bir Python framework'üdür. Bilgi erişimi ve soru-cevap uygulamalarını destekler.
Temel özellikler:
- Bileşen tabanlı yapay zeka sistemi tasarımı; yapay zeka işlevlerini bir araya getirmek için modüler bir yaklaşımdır.
- Vektör veritabanları ve LLM sağlayıcılarıyla entegrasyon; çeşitli veri depolama ve yapay zeka model'leriyle çalışmayı sağlar.
- Semantik arama ve bilgi çıkarımını destekler; gelişmiş arama ve bilgi erişimini sağlar.
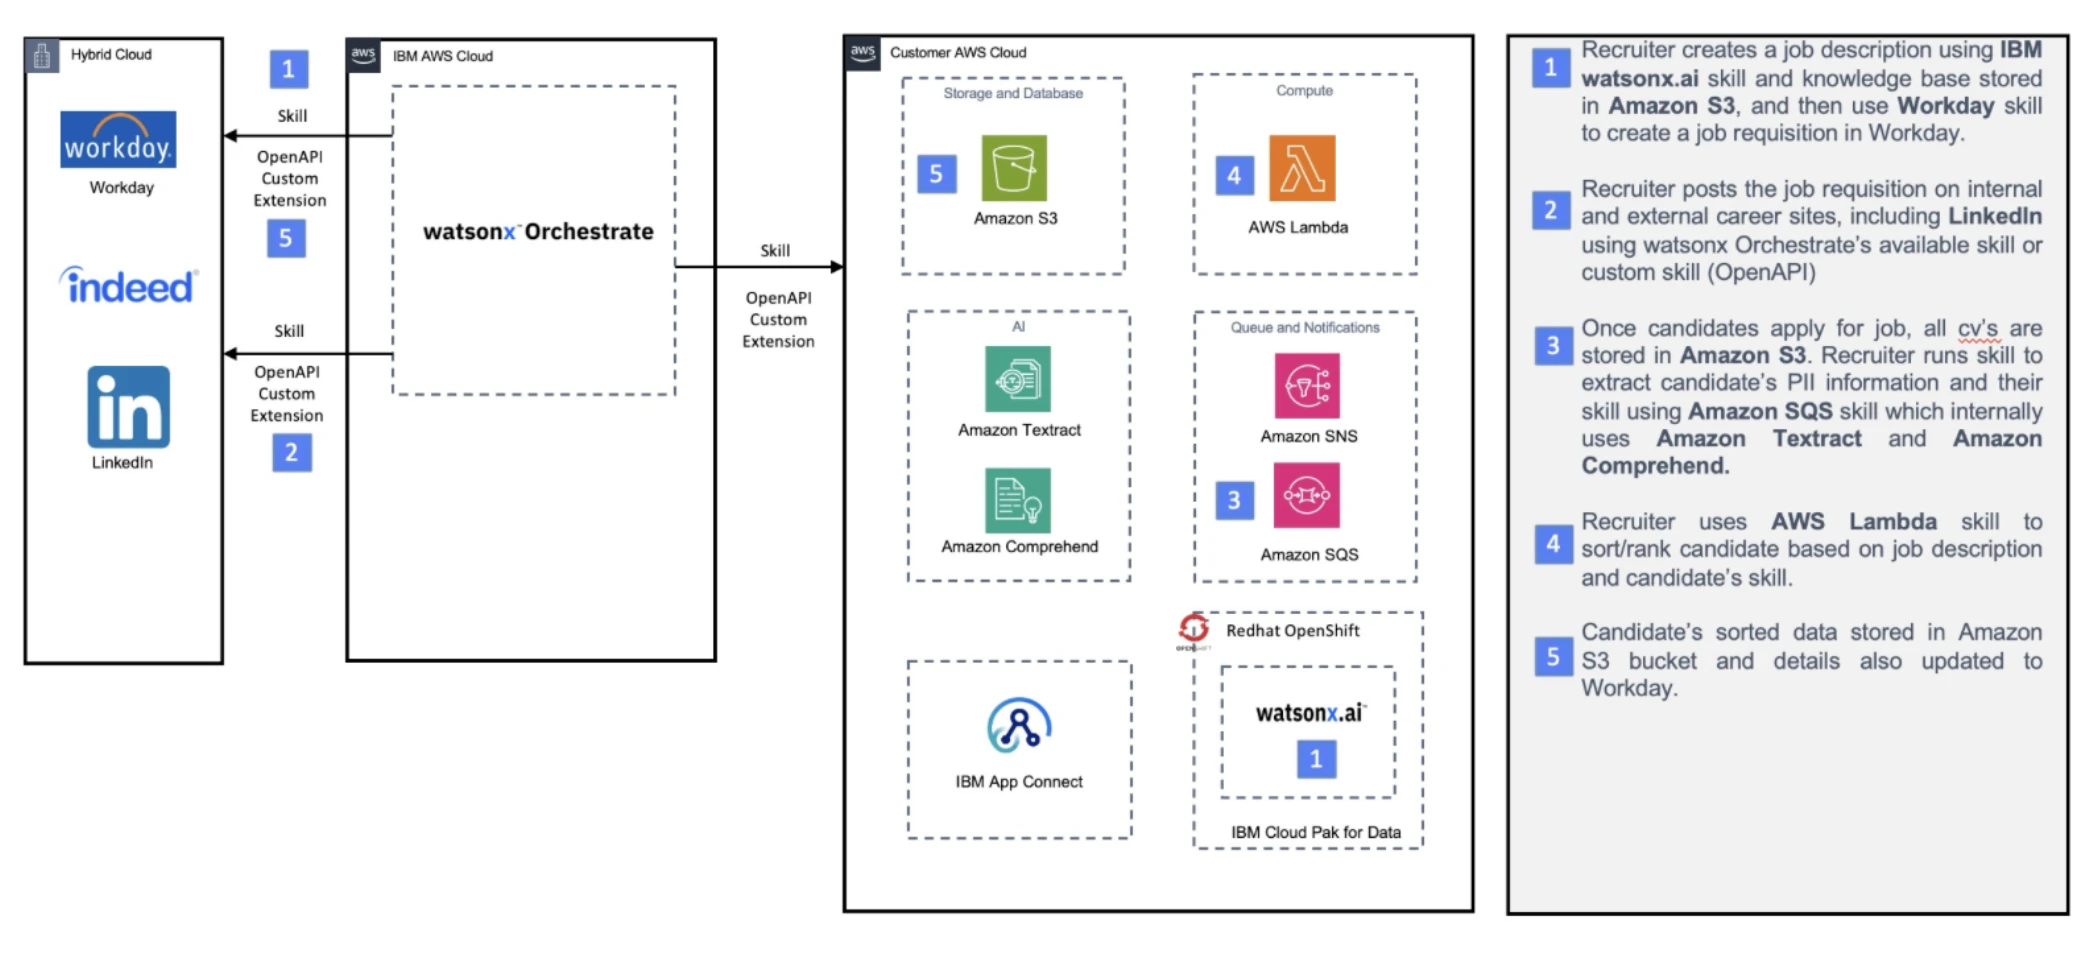
IBM watsonx orchestrate
IBM watsonx orchestrate, kurumsal iş akışlarını otomatikleştirmek için doğal dil işleme (NLP) kullanan özel bir yapay zeka orkestrasyon framework'üdür.
Temel özellikler:
- Yapay zeka destekli iş akışı otomasyonu; tekrarlayan iş süreçlerini yapay zeka kullanarak otomatikleştirebilir.
- Önceden oluşturulmuş uygulamalar ve yetenek setleri; farklı sektörler için kullanıma hazır yapay zeka araçları sağlar.
- Kurumsal odaklı entegrasyon; mevcut kurumsal yazılımlar ve iş akışlarıyla bağlantı kurar.
LangChain
LangChain, araç artırma ve ajan orkestrasyonuna odaklanarak LLM uygulamaları oluşturmak için açık kaynaklı bir Python framework'üdür. Embedding model'leri, LLM'ler ve vektör depoları için arayüzler sağlar.
Temel özellikler:
- RAG desteği
- Birden fazla LLM bileşeniyle entegrasyon
- ReAct framework'ü muhakeme ve eylem için
LlamaIndex
LlamaIndex, bağlamla zenginleştirilmiş LLM uygulamaları oluşturmak için tasarlanmış açık kaynaklı bir veri entegrasyonu framework'üdür. Birden fazla kaynaktan verilere kolay erişimi sağlar.
Temel özellikler:
- 160'tan fazla kaynak için veri bağlayıcıları; yapay zekanın çeşitli yapılandırılmış ve yapılandırılmamış verilere erişmesini sağlar.
- Erişim-artırılmış üretim (RAG) desteği
- Performans takibi için değerlendirme modülleri paketi
LOFT
Master of Code Global tarafından geliştirilen LOFT, yapay zeka destekli müşteri etkileşimlerini optimize etmek için tasarlanmış bir Büyük Dil Modeli-Orkestratör Framework'üdür. Eşzamanlı istekleri ve çok kullanıcılı dağıtımları yönetmek için tasarlanmış kuyruk tabanlı bir mimari kullanır.
Temel özellikler:
- Framework agnostiği: HTTP framework'lerine bağımlılık olmadan herhangi bir arka uç sistemine entegre olur.
- Dinamik olarak hesaplanan prompt'lar: Kişiselleştirilmiş kullanıcı etkileşimleri için özel olarak üretilen prompt'ları destekler.
- Olay algılama ve işleme: Halüsinasyon filtreleme dahil sohbet tabanlı olayları algılamak ve yönetmek için yerleşik mekanizmalar sunar.
Microchain
Microchain, sadeliğiyle bilinen ancak aktif olarak bakımı yapılmayan hafif, açık kaynaklı bir LLM orkestrasyon framework'üdür.
Temel özellikler:
- Zincirleme düşünce muhakemesi desteği; yapay zekanın karmaşık sorunları adım adım parçalamasına yardımcı olur.
- Yapay zeka orkestrasyonuna minimalist yaklaşım.
Orq AI
Orq, LLM uygulamalarının dağıtım yaşam döngüsünü yönetmek için tasarlanmış üretken yapay zeka işbirliği platformu ve LLMOps aracıdır. Teknik ve teknik olmayan ekiplerin yapay zeka işlevlerini oluşturması, dağıtması ve izlemesi için özellikler sağlar.
Temel özellikler:
- Serverless LLM orkestrasyonu: Yerleşik yönlendirme, sürüm kontrolü, fallback'ler ve yeniden denemeler içeren birleşik bir API kullanarak dağıtım altyapısı sağlar.
- Gözlemlenebilirlik ve değerlendirme: LLM performansını ve çıktı kalitesini sağlamak için gerçek zamanlı izleme, trace'ler, log'lar ve özel değerlendiriciler sunar.
- Yapay zeka ağ geçidi ve RAG: Erişim-artırılmış üretim (RAG) pipeline'ları oluşturmak için birden fazla yapay zeka modeline ve aracına tek noktadan erişim sağlar.
Semantic Kernel
Semantic Kernel (SK), Microsoft tarafından geliştirilen açık kaynaklı bir yapay zeka orkestrasyon framework'üdür. Geliştiricilerin, OpenAI'ın GPT'si gibi büyük dil modellerini (LLM'leri) geleneksel programlamayla entegre ederek yapay zeka destekli uygulamalar oluşturmasına yardımcı olur.
Temel özellikler:
- Bellek ve bağlam yönetimi: SK, geçmiş etkileşimlerin depolanmasına ve alınmasına olanak tanıyarak konuşmalarda bağlamın korunmasına yardımcı olur.
- Embedding'ler ve vektör arama: Embedding tabanlı aramaları destekler; erişim-artırılmış üretim (RAG) kullanım durumlarıyla uyumludur.
- Çok modlu destek: Metin, kod, görüntü ve daha fazlasıyla çalışır.
Doğru LLM orkestrasyon framework'ü nasıl seçilir?
GitHub yıldızlarının sayısı popülerliği gösterebilir; ancak ideal seçim ekibinizin teknik uzmanlığı, proje ölçeği, bütçe ve istenen entegrasyonlar dahil çeşitli faktörlere bağlıdır.
Ekibin teknik uzmanlığını göz önünde bulundurun:
- Yüksek düzeyde teknik ekipler için; ayrıntılı kontrol ve esneklik isteyen geliştiriciler ve veri bilimciler gibi, LangChain, AutoGen ve LlamaIndex gibi framework'ler mükemmel seçimlerdir. Bunlar önce kod yaklaşımını benimser ve Python ile yapay zeka ilkelerine güçlü bir hakimiyet gerektirir.
- Düşük kodlu/kodsuz tercih eden iş kullanıcıları veya ekipler için, bildirime dayalı arayüzlere odaklanan platformlar daha uygundur. Loft ve crewAI, kapsamlı kodlama olmadan hızlı prototiplemeye olanak tanıyan basitleştirilmiş iş akışları sunar.
Proje ölçeğini göz önünde bulundurun:
- Karmaşık, çok ajanlı sistemler için; AutoGen, crewAI veya Agency Swarm gibi bu amaç için özel olarak tasarlanmış framework'ler, ajanların iletişim kurması ve işbirliği yapması için gerekli mimariyi sağlar.
- Yüksek verim, güvenlik ve özel destek gerektiren büyük ölçekli, görev açısından kritik kurumsal uygulamalar için; IBM watsonx orchestrate gibi özel çözümler genellikle tercih edilen seçenektir.
- Hafif, kavram kanıtı (POC) uygulamaları için; minimalist bir framework yeterli olabilir, çünkü sadeliği ek yükü azaltır.
Bütçe kısıtlarını düşünün:
- Açık kaynaklı framework'ler; LangChain ve Haystack gibi, kullanımı ücretsiz'dir ancak bulut altyapısı, bakım ve uzman bir ekibin “gizli maliyetleriyle” birlikte gelir.
- Özel çözümler, destek içeren öngörülebilir bir fiyatlandırma yapısı sunabilir ve özel bir MLOps ekibi olmayan kuruluşlar için daha uygun maliyetli olabilir.
Mevcut teknoloji yığınınızı göz önünde bulundurun.
- Şirketiniz belirli bir ekosisteme yatırım yaptıysa, o ekosistemle çalışamayan framework'leri elemek faydalı bir adımdır. Örneğin, Microsoft ortamları için Semantic Kernel veya belge erişimine odaklı uygulamalar için Haystack entegrasyon sağlayabilir.
LLM orkestrasyon araçları nasıl çalışır?
LLM orkestrasyon framework'leri, LLM destekli uygulamaların farklı bileşenleri arasındaki etkileşimi yönetir; yapılandırılmış iş akışları ve verimli yürütme sağlar. Orkestrasyon katmanı; prompt yönetimi, kaynak tahsisi, veri ön işleme ve model etkileşimleri gibi süreçleri koordine etmede merkezi bir rol oynar.
Orkestrasyon katmanı
Orkestrasyon katmanı, LLM destekli bir uygulama içinde merkezi kontrol sistemi olarak görev yapar. LLM'ler, prompt şablonları, vektör veritabanları ve yapay zeka ajanları dahil çeşitli bileşenler arasındaki etkileşimleri yönetir. Orkestrasyon, bu öğeleri denetleyerek farklı görevler ve ortamlar arasında tutarlı performans sağlar.
Temel orkestrasyon görevleri
Prompt zinciri yönetimi
- Framework, çıktıyı optimize etmek için LLM girdilerini (prompt'ları) yapılandırır ve yönetir.
- Bağlam ve kullanıcı girdilerine göre dinamik seçime olanak tanıyan bir prompt şablonları deposu sağlar.
- Yapılandırılmış konuşma akışlarını sürdürmek için prompt'ları mantıksal olarak sıralar.
- Çıktı kalitesini iyileştirmek, tutarsızlıkları tespit etmek ve yönergelere uyumu sağlamak için yanıtları değerlendirir.
- Yanlışlıkları azaltmak için doğruluk kontrol mekanizmaları uygulanabilir; işaretlenen yanıtlar insan incelemesine yönlendirilir.
LLM kaynak ve performans yönetimi
- Orkestrasyon framework'leri, benchmark testleri ve gerçek zamanlı panolar aracılığıyla LLM performansını izler.
- Hata ayıklamayı kolaylaştırmak için kök neden analizi (RCA) araçları sağlarlar.
- Performansı optimize etmek için hesaplama kaynaklarını verimli bir şekilde tahsis ederler.
Veri yönetimi ve ön işleme
- Orkestratör, bağlayıcılar veya API'ler kullanarak belirtilen kaynaklardan veri alır.
- Ön işleme, ham verileri LLM'lerle uyumlu bir biçime dönüştürerek veri kalitesini ve ilgililiğini sağlar.
- Farklı algoritmalar tarafından işlenmeye uygunluğunu artırmak için verileri iyileştirir ve yapılandırır.
LLM entegrasyonu ve etkileşimi
- Orkestratör, LLM işlemlerini başlatır, üretilen çıktıyı işler ve uygun hedefe yönlendirir.
- Önceki etkileşimleri koruyarak bağlamsal anlayışı geliştiren bellek depolarını yönetir.
- Geri bildirim mekanizmaları, çıktı kalitesini değerlendirir ve geçmiş verilere dayanarak yanıtları iyileştirir.
Gözlemlenebilirlik ve güvenlik önlemleri
- Orkestratör, model davranışını izlemek ve çıktı güvenilirliğini sağlamak için izleme araçlarını destekler.
- Doğrulanmamış veya hatalı çıktılarla ilişkili riskleri azaltmak için güvenlik framework'leri uygular.
Ek iyileştirmeler
İş akışı entegrasyonu
- Verimliliği, tutarlılığı ve üretkenliği artırmak için araçları, teknolojileri veya süreçleri mevcut operasyonel sistemlere gömer.
- Prompt ve çıktı kalitesini korurken farklı model sağlayıcıları arasında sorunsuz geçişleri sağlar.
Model sağlayıcılarını değiştirme
- Bazı framework'ler, operasyonel sürtünmeyi azaltarak minimum değişiklikle model sağlayıcılarının değiştirilmesine olanak tanır.
- Sağlayıcı içe aktarımlarını güncellemek, model parametrelerini ayarlamak ve sınıf referanslarını değiştirmek geçişleri kolaylaştırır.
Prompt yönetimi
- Kullanıcıların daha verimli yineleme yapmasına ve deneme yapmasına yardımcı olurken prompt tutarlılığını korur.
- İşbirliğini kolaylaştırmak ve değişiklik takibini otomatikleştirmek için CI/CD pipeline'larıyla entegre olur.
- Bazı sistemler prompt değişikliklerini otomatik olarak izleyerek prompt kalitesi üzerindeki beklenmedik etkileri yakalamaya yardımcı olur.
Yeni ortaya çıkan desen: bağlam mühendisliği
LLM orkestrasyonu geliştikçe yeni bir disiplin ortaya çıktı: bağlam mühendisliği. Özellikle gerçek zamanlı erişim, geçmiş etkileşimler ve belleği birleştirerek yanıt kalitesini ve verimliliğini artırmak için LLM girdisine hangi bilgilerin dahil edileceğini optimize etmeye odaklanır.
Bu pratik, bağlamın alınan, filtrelenen ve kullanıcı niyeti ile token limitlerine uyacak şekilde hassas biçimde şekillendirilen yönetilen bir kaynak haline geldiği bir orkestrasyon deseni olarak ele alınabilir.
Bu orkestrasyon deseninin temel öğeleri şunlardır:
- Bağlam aracısı: Orkestrasyon katmanında; bellekten, erişim modüllerinden ve son etkileşimlerden girdileri toplayan ve normalize eden merkezi bir birimdir. Tüm bağlama duyarlı iş akışlarında tutarlılığı sağlar.
- Modüller ve yollar: Özetleyiciler, erişim motorları veya bellek aramaları gibi uzmanlaşmış bileşenler; kullanıcı sorgusunun veya sistem durumunun niteliğine göre dinamik araç sevki mekanizmaları aracılığıyla seçici olarak etkinleştirilir.
- Bağlam paketleme: Alınan ve hatırlanan içerik sıralanır, sıkıştırılır ve yapılandırılmış prompt'lar halinde düzenlenir. Bu seçici paketleme, yüksek değerli bilgilerin token kısıtlarını aşmadan LLM girdi penceresine sığmasını sağlar.
- Korkuluklar ve uyarlama: Yerleşik kısıtlamalar yalnızca erişime dayalı yanıtları zorunlu kılabilir; uzun süreli bellek güncellemeleri sistemin bağlam seçimini iyileştirmesini sağlar.
Bu desen; erişim-artırılmış üretim (RAG), çok ajanlı işbirliği ve LLM destekli copilot'lar kullanan sistemlerde giderek daha önemli hale gelmektedir; bu sistemlerde her sorgu doğru modülleri tetiklemeli ve en ilgili bilgiyi yüzeye çıkarmalıdır.
 Tercih edilen kaynak olarak ekle
4 LLM orkestrasyonu en iyi uygulamaları
1-Sağlam, modüler bir mimariyle başlayın
- Görev ayrıştırma: İş akışınızı net bir şekilde tanımlayın ve sorunu küçük, belirgin ve test edilebilir adımlara bölün. Pipeline'ınızı, temel işlevler (örn. prompt oluşturma, bellek erişimi, gelişmiş mantık) kendi modüllerinde yalıtılacak şekilde tasarlayın.
- Yinelemeli tasarım: En basit çalışan prototiple (“minimum uygulanabilir ürün”) başlayın ve karmaşıklığı kademeli olarak artırın. Karmaşık bir zincire entegre etmeden önce veri erişiminden nihai çıktıya kadar her adımın tek başına çalıştığını doğrulayın.
2-Dinamik model yönlendirme ve seçimi
- Maliyet ve hız için optimize edin: Her görev için en pahalı, en büyük LLM'i kullanmaktan kaçının. Basit sorguları (sınıflandırma veya özetleme gibi) daha ucuz, daha küçük model'lere yönlendirmek ve üst düzey model'leri karmaşık muhakeme veya çok adımlı analiz için ayırmak için orkestratörde mantık uygulayın.
- Sağlayıcı agnostiği: Satıcı bağımlılığını azaltmak, API hız limitlerini yönetmek ve pazar geliştikçe en iyi performans gösteren model'lerden yararlanmak için orkestrasyon katmanınızı model sağlayıcıları (örn. OpenAI, Anthropic, Google) arasında kolay geçişe izin verecek şekilde yapılandırın.
3-Sağlam gözlemlenebilirlik ve izleme uygulayın
- Her şeyi loglayın: Zincirdeki her adımın girdilerini ve çıktılarını loglayın, yalnızca nihai sonucu değil. Bu, çok adımlı konuşma akışlarında hata ayıklamak ve hatalar üzerinde kök neden analizi (RCA) yapmak için çok önemlidir.
- Temel metrikleri izleyin: Gecikme, verim, token tüketimi (maliyet kontrolü için) ve model hata oranlarını gerçek zamanlı olarak izleyin. Halüsinasyon veya hata artışlarını hemen işaretlemek için otomatik uyarılar yapılandırılmalıdır.
4-Yönetişim ve güvenlik korkuluklarını kontrol edin
- Ön ve son işlem kontrolleri: Tüm LLM çağrılarını korkuluklarla sarın. Kullanıcı girdisinde ön işlem kontrolleri (örn. içerik filtreleme, izin verilmeyen konuları kara listeye alma) ve teslimden önce model yanıtı üzerinde son işlem kontrolleri (örn. yapılandırılmış çıktı biçimini doğrulama, güvenlik kontrolleri) kullanın.
- Uyumluluk: Hassas veriler için uyumluluğu (örn. HIPAA, GDPR) sürdürmek amacıyla tasarım sürecinin erken aşamalarında izin katmanları, anonimleştirme ve şifreleme uygulayın.
4 LLM orkestrasyonu zorlukları ve azaltma stratejileri
İşte LLM orkestrasyonuyla ilişkili bazı sorunlar ve bunların üstesinden gelme yöntemleri: Çoklu LLM Orkestrasyonunda Temel Zorluklar
1.Koordinasyon ve iş akışı kilitlenmeleri
LLM'in deterministik olmayan doğası nedeniyle, uzmanlaşmış LLM rolleri arasında net devir teslimler tanımlamak zordur. Bu, görev çakışmasına (gereksiz token kullanımı) veya iş akışı kilitlenmelerine (bir LLM Instance'ı başka birinden belirsiz bir çıktıyı süresiz olarak bekler) yol açar.
Yapılandırılmış iş akışı ve iletişimle azaltın
- Hedefi, alt görevlerden oluşan bir Yönlendirilmiş Döngüsüz Graf'a (DAG) ayrıştırmak için bir iş akışı denetleyicisi kullanın.
- Tüm görev devirleri için Pydantic/JSON İletişim Protokolü uygulayın. Bu, LLM'i makine tarafından okunabilir, şema ile doğrulanmış veriler çıkarmaya zorlar; ilerleme sinyallerini netleştirir ve döngüleri önler.
2. Bağlamsal sapma ve bellek tutarsızlığı
LLM'in sabit bağlam penceresi ve doğal durumsuzluğu, onu bağlamsal sapmaya yatkın hale getirir; bu durumda bir LLM Rolü genel hedefi veya kritik önceki olguları unutur. Çoklu LLM kurulumunda bu, çelişkili kararlar ve tutarsız genel çıktılar yaratır.
RAG ile dışsallaştırılmış bilgi tabanı kullanarak azaltın
- Harici bir bellek sistemi (Vektör Veritabanı veya Bilgi Grafiği) uygulayın. Uzmanlaşmış LLM rolleri, önemli olguları, kararları ve çıktıları yapılandırılmış veriler olarak kaydeder. Bir LLM Instance'ı bağlama ihtiyaç duyduğunda, en ilgili ve gereksiz olmayan bilgiyi aldığından emin olmak için bu harici kaynağı sorgulamak üzere Erişim Artırılmış Üretim'i (RAG) kullanır.
3. Deterministik olmayan çıktı ve kademeli halüsinasyon
LLM'in olasılıksal çıktısı, yanıtların güvenilmez olduğu anlamına gelir. Bir LLM Instance'ı (üretici) bilgi uydurduğunda (halüsinasyon gördüğünde), aşağı akıştaki LLM Instance'ı (tüketici) bunu gerçek olarak kabul eder ve bu da çoklu LLM iş akışının tamamen kademeli olarak başarısız olmasına yol açar.
Konsensüs mekanizmaları ve doğrulamayla azaltın
- Kritik çıktılar için bir konsensüs deseni kullanın. İş Akışı Denetleyicisi, ilk çıktıyı doğrulama için ikincil bir LLM Doğrulayıcı Rolüne veya Harici Veritabanı/API'ye yönlendirir. Çıktı başarıyla doğrulanırsa iş akışı devam eder; bu, modelin deterministik olmayan hataları riskini etkili şekilde azaltır.
4. Kaynak çekişmesi ve maliyet aşımı
Çoklu LLM iş akışlarını ölçeklendirmek, LLM API'sine (maliyetli, hız limitli bir kaynak) yüksek talep yaratır. Bu, hız limiti hatalarına (API kısıtlaması) ve gereksiz iş veya döngülerden kaynaklanan büyük token tüketimine (maliyet aşımı) yol açar.
Asenkron kuyruklama ve bütçe korkuluklarıyla azaltın
- API çağrılarının yürütme eşzamanlılığını kontrol etmek için hız sınırlayıcılı asenkron bir görev kuyruğu (örn. Celery) kullanın.
- Görev başına token kullanımını izlemek için gözlemlenebilirlik araçları uygulayın ve kontrolden çıkan herhangi bir LLM Instance'ını sonlandıran veya duraklatan otomatik token bütçeleri (devre kesiciler) belirleyin; operasyonel maliyeti gerçek zamanlı yönetin.
Orkestrasyon önemli bir LLM bileşeni midir?
Evet. Orkestrasyon, LLM tabanlı sistemlerde önemli bir bileşendir; ancak model ağırlıkları veya tokenizer gibi bir çekirdek model bileşeni değildir. Bunun yerine, LLM'leri gerçek dünya uygulamalarında kullanılabilir kılan sistem düzeyinde bir yetenektir.
Temel bileşenler arasında orkestrasyon genellikle şunlarla birlikte yer alır:
- LLM model: Bir Büyük Dil Modeli (LLM), insan benzeri metinleri anlamak ve üretmek için büyük miktarda veriyi işler. Açık kaynaklı model'ler esneklik sunarken kapalı kaynaklı olanlar kullanım kolaylığı ve destek sağlar. Genel amaçlı LLM'ler çeşitli görevleri yerine getirirken alana özgü model'ler uzmanlaşmış sektörlere hitap eder.
- Prompt'lar: Etkili prompt'lar LLM yanıtlarını yönlendirir.
- Zero-shot prompt'lar: Önceden örnek olmadan yanıt üretir.
- Few-shot prompt'lar: Doğruluğu artırmak için birkaç örnek kullanır. few-shot öğrenme promptlaması ve diğer LLM fine-tuning yöntemleri hakkında daha fazla bilgi edinin.
- Zincirleme düşünce prompt'ları: Daha iyi yanıtlar için mantıksal muhakemeyi teşvik eder.
- Vektör veritabanı: Yapılandırılmış verileri sayısal vektörler olarak depolar. LLM'ler, ilgili bağlamı almak için benzerlik aramalarını kullanır; doğruluğu artırır ve güncel olmayan yanıtları önler.
- vektör veritabanları LLM'ler, açık kaynak vektör veritabanı araçları ve vektör veritabanı kullanım durumları hakkında daha fazla bilgi edinin.
- Ajanlar ve araçlar: Web aramaları yaparak, kod yürüterek veya veritabanlarını sorgulayarak LLM yeteneklerini genişletir. Bunlar yapay zeka destekli otomasyonu ve iş çözümlerini geliştirir.
- Orkestratör (Kontrol katmanı): LLM'leri, prompt'ları, vektör veritabanlarını ve ajanları uyumlu bir sistemde bütünleştirir. Verimli yapay zeka destekli uygulamalar için sorunsuz koordinasyon sağlar.
- İzleme: Performansı izler, anormallikleri tespit eder ve etkileşimleri loglar. Yüksek kaliteli yanıtlar sağlar ve LLM çıktılarındaki hataları azaltmaya yardımcı olur.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orkestrasyonu: 21 Framework ve Ağ Geçidi}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Erişim tarihi: 21 Ekim 2026}
}212 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 5 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
9 güncellemeSSS bölümü ve yapay zeka ağ geçitleri listesindeki Nexos.ai maddesi kaldırıldı.
Girişe ve yeni bir bölüme karşılaştırma sonuçları eklendi.
LLM Orkestrasyon Araçları bölümü, araçların "Ağ Geçidi Tabanlı Platformlar" ve "Geliştirici Çerçeveleri" olarak yeni bir kategorizasyonuyla genişletildi.
Referans Linkleri










Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.