


Lokale KI-Agenten: Goose, Observer KI, AnythingLLM

Lokale KI-Agenten werden oft als offline, gerätegebunden oder vollständig lokal beschrieben. Wir haben drei Tage damit verbracht, das Ökosystem lokaler KI-Agenten zu kartieren, die autonom auf persönlicher Hardware laufen, ohne auf externe APIs oder Cloud-Dienste angewiesen zu sein.
Unsere Analyse gliedert die führenden Lösungen in drei Schlüsselbereiche, basierend auf praxisnahen Tests über Entwickler-Agenten, Automatisierungstools und Produktivitätsassistenten.
Kategorisierung lokaler KI-Agenten
Kategorie | Tools/Frameworks | Primäre Anwendungsfälle (Lokal / Offline) |
|---|---|---|
Entwickler- & Systemagenten | Goose, Localforge, Devika, Roo Code (Boomerang Mode), Continue.dev, Cursor, CodeGenie, SuperCoder, Aider, Cline, Kilo Code | Lokale Code-Entwicklung, Debugging, Datei-/Prozessautomatisierung, lokale DevOps-Aufgaben |
Lokale Automatisierungs- & Steuerungsagenten | Observer KI, Browser-Use, DeepBrowser | Lokale Browsersteuerung, Dateiautomatisierung, App-Interaktion, On-Device-Workflows |
Wissens- & Produktivitätsagenten | AnythingLLM (Desktop), LocalGPT (Single-User), PrivateGPT | Offline-Dokument-Q&A, Zusammenfassung, lokale Suche/RAG |
Kategoriebeschreibungen ansehen.
1. Entwickler- & Systemagenten
*Ausführungstypen:
- Vollständig lokal: Das Tool läuft nativ auf persönlicher Hardware mit lokalen Laufzeitumgebungen. Werkzeuge, die vollständig offline betrieben werden können.
- Hybrid lokal: Das Kernmodell oder die Aufgabenausführung erfolgt lokal, aber einige Funktionen wie IDE-Integration, Kontextindizierung, Synchronisierung oder Reasoning sind weiterhin auf Cloud-Dienste oder APIs angewiesen.
** Erklärung zur Spalte „Auf der Maschine“:
- Vollständig gerätegebunden: Kompletter Offline-Betrieb – Inferenz, Reasoning und Ausführung laufen alle lokal.
- Lokale Inferenz, Cloud-unterstützt: Das Kernmodell läuft lokal, aber IDE- oder Verwaltungsfunktionen nutzen Online-Dienste.
- Lokale Ausführung, Remote-Reasoning: Code läuft lokal, aber externe APIs übernehmen Reasoning- oder Planungsschritte.
Goose
Goose ist ein Open-Source-Entwicklungsagent, der darauf ausgelegt ist, vollständig auf lokaler Hardware zu arbeiten.1
Kernfunktionen:
- Nutzt lokale LLM-Laufzeitumgebungen für Reasoning und Codegenerierung
- Führt mehrstufige Aufgaben wie Schreiben, Testen und Debuggen von Code aus
- Interagiert direkt mit dem lokalen Dateisystem und Entwicklertools
- Benötigt keine Netzwerkverbindung, wenn es mit lokalen Modellen konfiguriert ist.
Goose erfüllt eine strenge Definition eines lokalen autonomen Agenten, da Beobachtung, Reasoning und Aktion auf dem Gerät erfolgen.
Roo Code(Boomerang Mode)
Roo Code ist ein IDE-integrierter Coding-Assistent, der auf iterative Verfeinerung setzt.
- Der Boomerang-Modus ermöglicht die lokale Ausführung von Aktionen
- Das Reasoning stützt sich in der Regel auf Cloud-basierte Modelle
- IDE-Koordinations- und Verwaltungsfunktionen sind nicht vollständig lokal
Daher sollte Roo Code als hybrider Human-in-the-Loop-Entwickler-Agent und nicht als vollständig lokales System eingestuft werden.
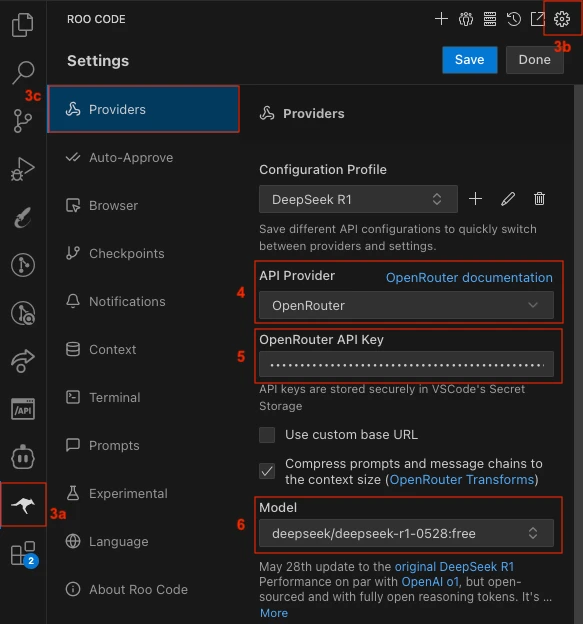
Konfiguration lokaler KI-Agenten in Roo Code:
Roo Code ermöglicht es Entwicklern, benutzerdefinierte Konfigurationsprofile zu erstellen, die festlegen, wie es sich mit verschiedenen KI-Modellen verbindet, einschließlich lokal gehosteter LLMs.
Über Einstellungen → Anbieter können Sie Profile über OpenRouter oder andere unterstützte Anbieter hinzufügen und dann ein lokales Modell auswählen, das über Ollama oder LM Studio läuft.
Jedes Konfigurationsprofil kann seine eigenen Parameter speichern, einschließlich Temperatur, Reasoning-Tiefe und Token-Limits. Dadurch können Sie zwischen schlanken Cloud-Modellen und vollständig lokalen Laufzeitumgebungen für die On-Device-Inferenz wechseln.
Cursor
Cursor erlaubt die Nutzung lokaler LLMs für die Inferenz, bleibt aber für Folgendes von Cloud-Diensten abhängig:
- Code-Indizierung
- Bearbeitungsanwendung
- Workflow-Koordination
Daher unterstützt Cursor lokale Inferenz, aber keinen vollständig lokalen Agenten-Loop und kann nicht offline betrieben werden.
So verwenden Sie ein lokales LLM in Cursor:
Quelle: Logan Hallucinates2
Aider
Aider ist ein Open-Source-KI-Coding-Assistent auf Kommandozeilenbasis, der für die direkte Arbeit mit lokalen Git-Repositories entwickelt wurde. Er modifiziert Code, indem er Patches und Commits generiert, statt über eine IDE-Schnittstelle zu arbeiten.
Aider wird oft mit Cloud-gehosteten Modellen verwendet, aber:
- Das Tool selbst läuft lokal.
- In Kombination mit einer lokalen Modell-Laufzeitumgebung kann es vollständig auf dem Gerät betrieben werden.
Die Offline-Fähigkeit hängt daher von der Modellwahl ab und ist keine intrinsische Eigenschaft des Tools.
2. Lokale Automatisierungs- & Steuerungsagenten
Observer KI
Observer KI ist ein Open-Source-Agenten-Framework für lokale Automatisierung.
Kernfunktionen:
- Führt Agenten mit lokalen LLMs aus
- Beobachtet den Bildschirmzustand per OCR oder Screenshots
- Führt Python-Code über eine eingebettete Ausführungsumgebung aus
- Benötigt keine Cloud-Anbindung
Observer KI stellt die Infrastruktur für Agentenverhalten bereit, statt eine feste Agentenrichtlinie vorzugeben, und lässt sich am besten als lokales Control-Loop-Framework beschreiben.
Browser-Use
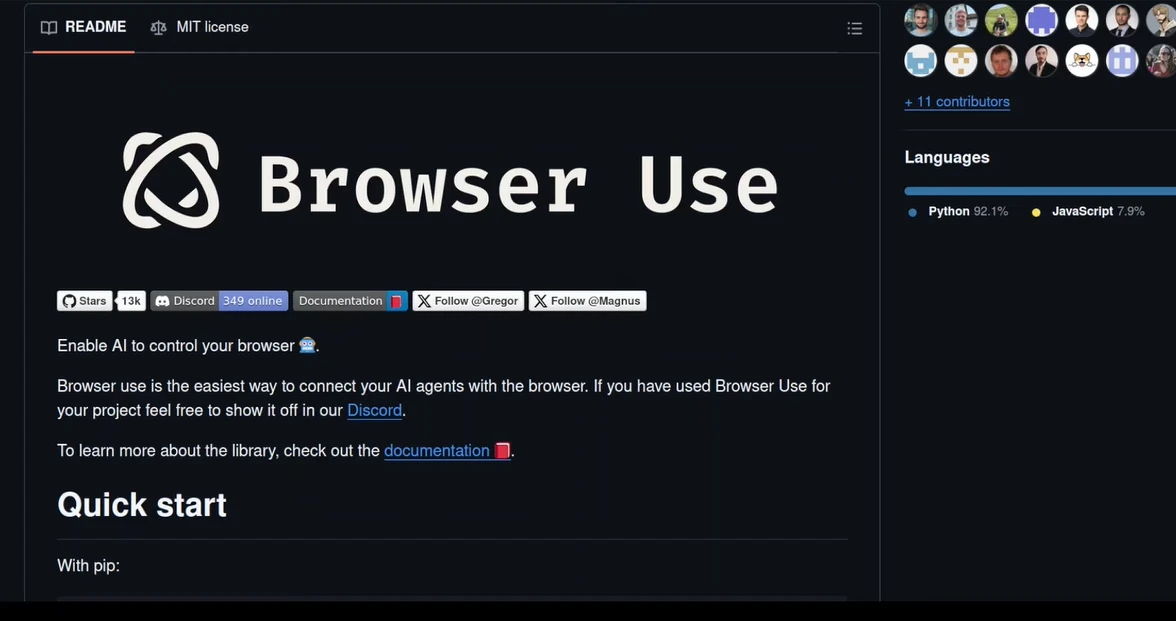
Browser-Use ermöglicht KI-gesteuerte Browser-Interaktion über Playwright.
- Browser-Aktionen werden lokal ausgeführt
- Das Reasoning kann entweder mit lokalen oder Remote-Modellen durchgeführt werden
- Offline-Betrieb ist möglich, wenn es mit lokaler Inferenz kombiniert wird
Damit gehört Browser-Use standardmäßig eindeutig zur hybriden Automatisierungskategorie.
So verwenden Sie ein lokales LLM in Browser-Use:
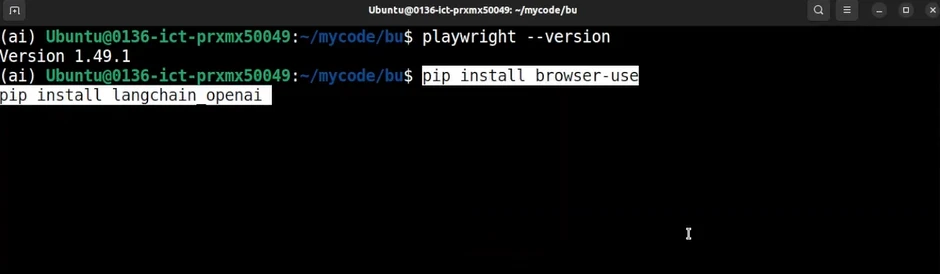
Eine Möglichkeit zur Installation ist der Befehl pip install browser-use, der sowohl die Python-Schnittstelle als auch die lokale Browsersteuerung auf demselben Rechner einrichtet.
Beim späteren Ausführen (zum Beispiel mit python -m browser_use) öffnet und steuert es lokal eine Browser-Instanz und führt Aktionen und Reasoning entweder über ein lokales LLM (z. B. über Ollama) oder über verbundene APIs aus:
Browser-Use lokal einrichten3
Für alle, die das vollständige Setup in Aktion sehen möchten, gibt es hier eine Schritt-für-Schritt-Videoanleitung, die zeigt, wie man Browser-Use auf einem lokalen Rechner installiert und ausführt:
Die exemplarische Vorgehensweise deckt alles ab – von der Installation von Abhängigkeiten wie Playwright und LangChain bis zur Verbindung von Browser-Use mit einem lokalen Modell über Ollama.3
3. Wissens- & Produktivitätsagenten
AnythingLLM (Desktop)
Wenn AnythingLLM Desktop mit lokalen Modellen konfiguriert ist:
- Führt die Dokumentindizierung lokal durch
- Führt das Agenten-Reasoning auf dem Gerät aus
- Unterstützt begrenzte Aktionsfähigkeiten (z. B. Schreiben von Dateien)
- Benötigt keine Cloud-Anbindung
Obwohl seine Autonomie im Vergleich zu Systemagenten eingeschränkt ist, gilt es unter einer engen Aufgabendefinition als lokaler Produktivitätsagent.
Ein beispielhafter Einsatz eines lokalen KI-Agenten
Wir haben AnythingLLM Desktop getestet, um zu sehen, wie ein lokaler, gerätegebundener Agent von der Einrichtung bis zur endgültigen Ausgabe funktioniert.
1. Einrichten des Arbeitsbereichs
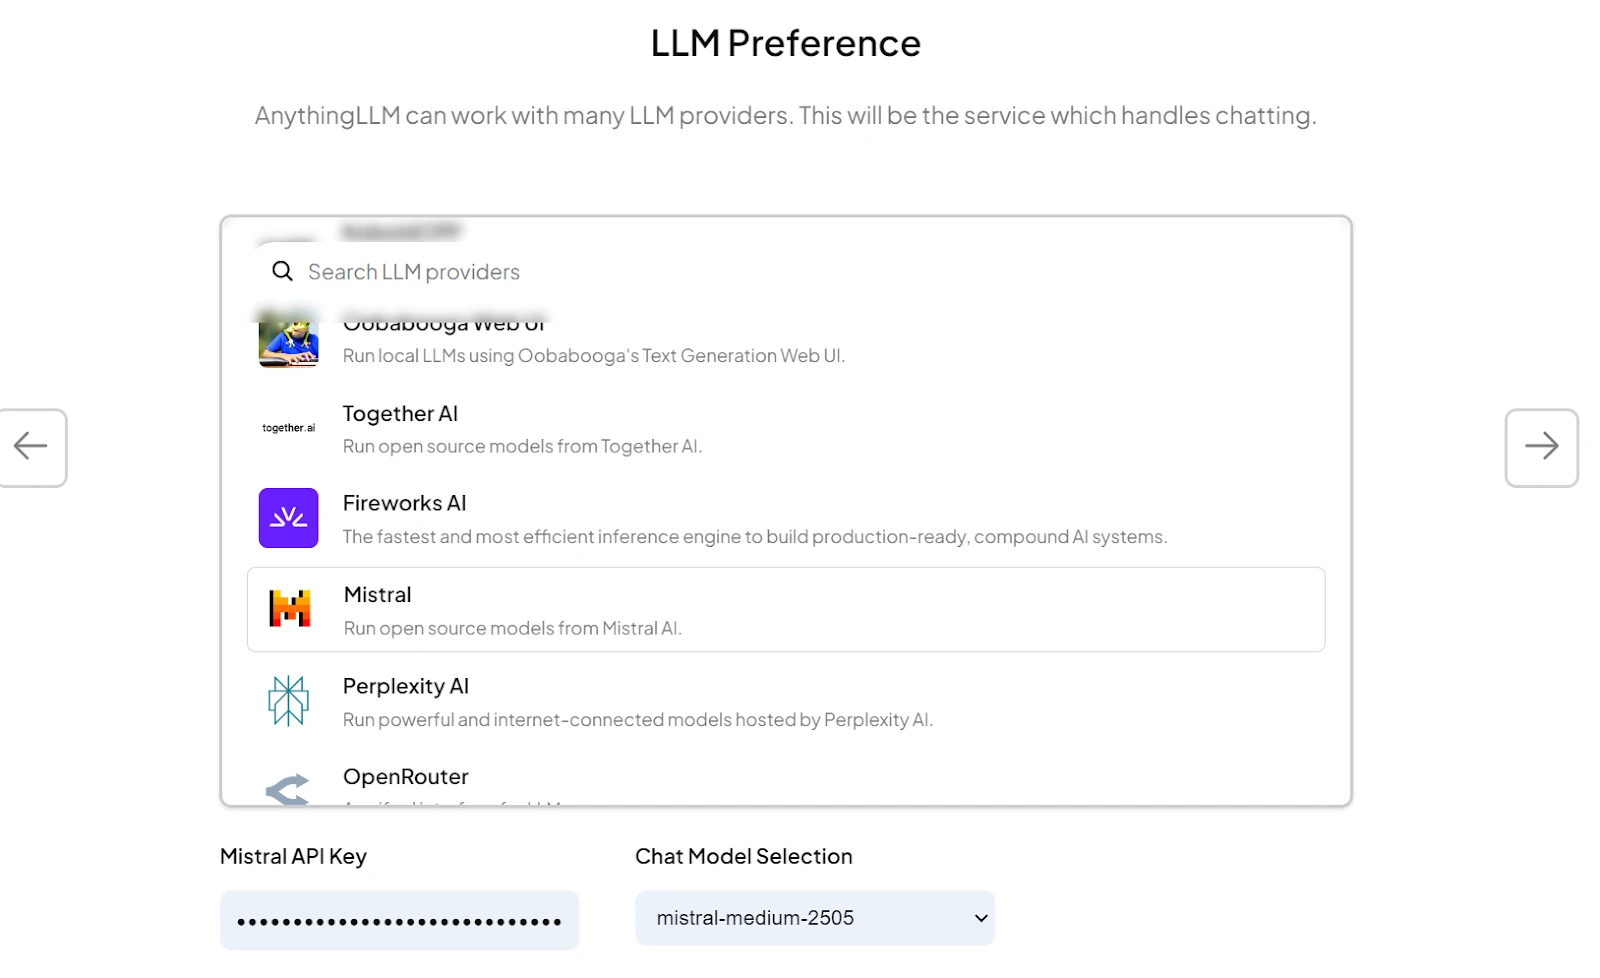
Wir öffneten die Arbeitsbereichseinstellungen und gingen zu Agentenkonfiguration.
Dort wählten wir einen LLM-Anbieter und das Modell mistral-medium-2505.
Nach dem Klicken auf „Arbeitsbereichs-Agent aktualisieren“ bestätigte der Arbeitsbereich, dass die Einrichtung abgeschlossen war.
2. Aktivieren von Agenten-Fähigkeiten
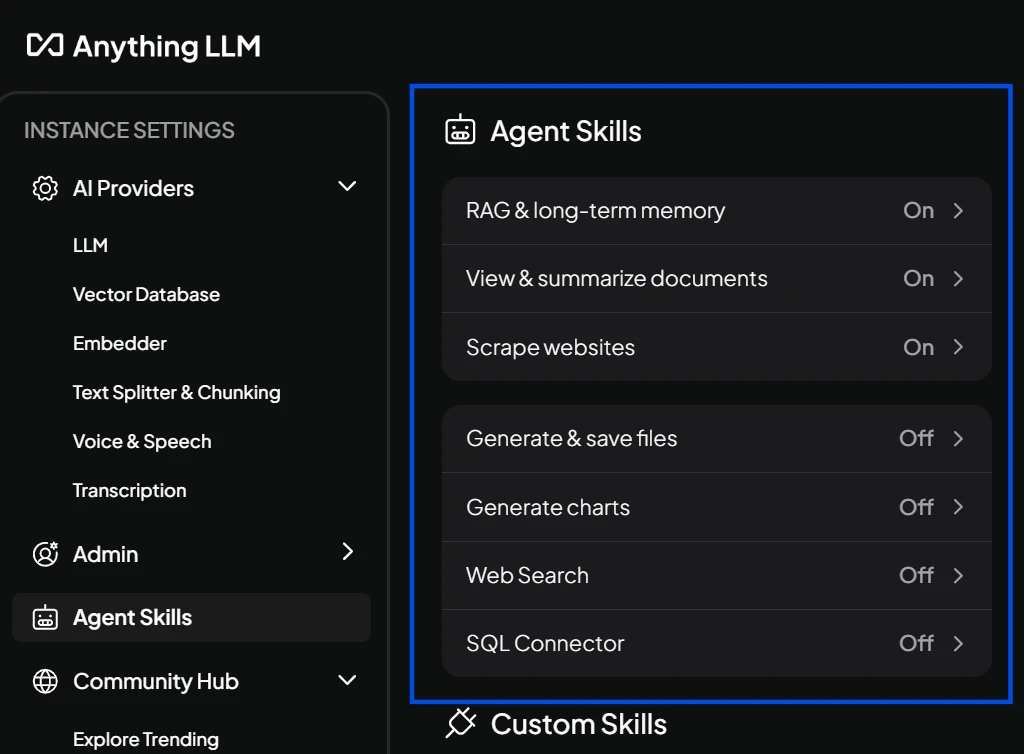
Als Nächstes öffneten wir das Panel „Agenten-Fähigkeiten konfigurieren“.
Dieses Menü ermöglicht es, integrierte Agentenfunktionen mit einem einzigen Klick zu aktivieren. Es ist keine Programmierung erforderlich.
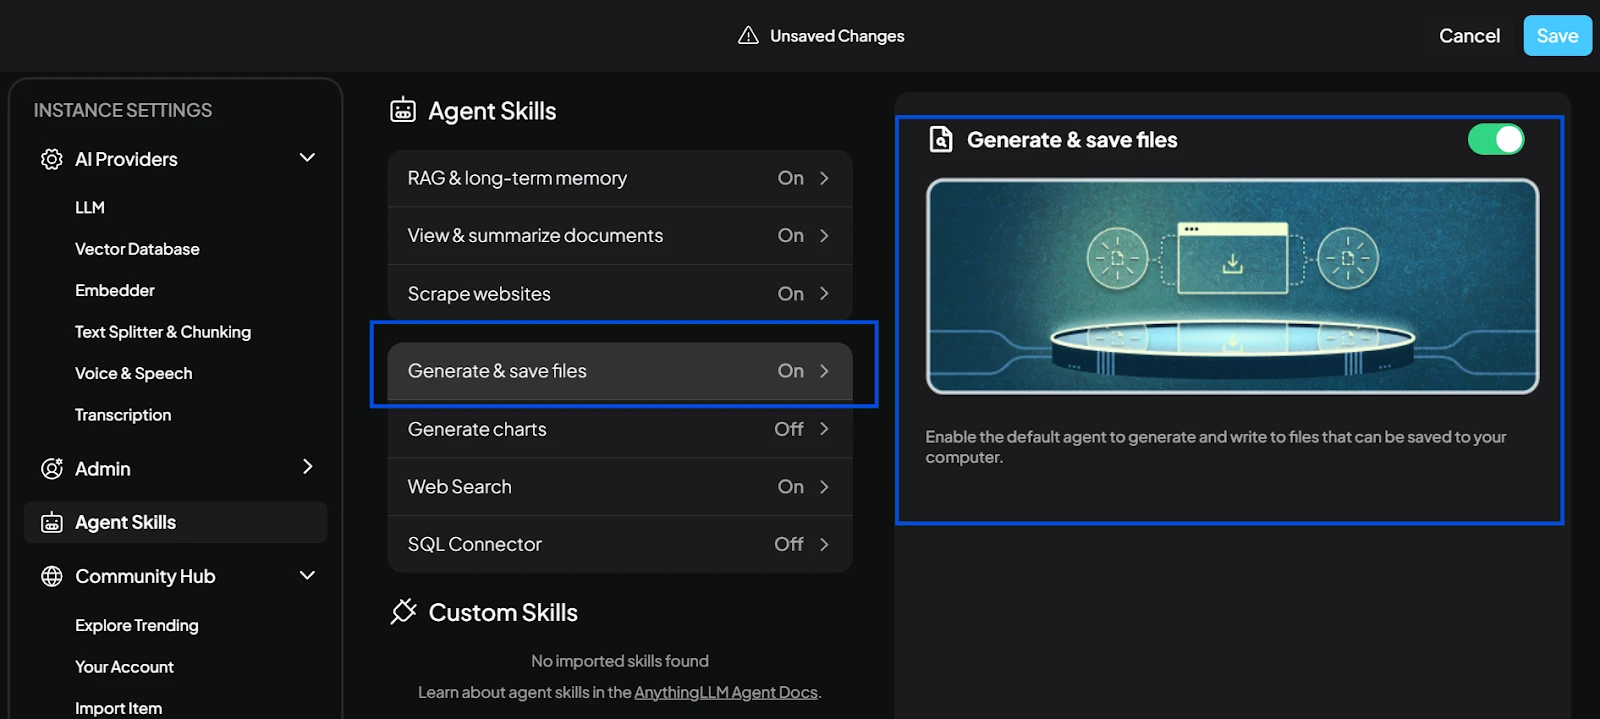
3. Testen der Fähigkeit „Speichern Files“
Wir aktivierten die Fähigkeit „Speichern Files“, sodass der Agent Ausgaben direkt auf dem lokalen Rechner speichern konnte.
Nach dem Einschalten und Speichern der Änderung war der Agent bereit.
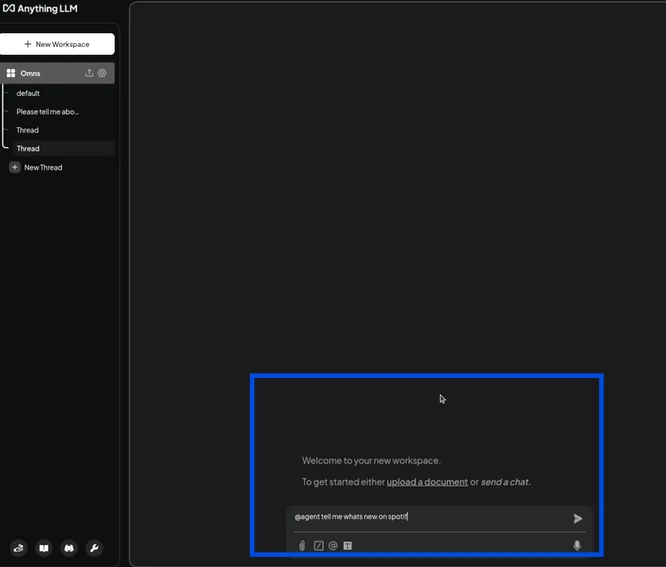
Um sie zu testen, kehrten wir zum Chatfenster zurück und verwendeten einen der Beispiel-Prompts aus der Dokumentation.
Dies bestätigte, dass der Agent eine Datei generieren und für das lokale Speichern vorbereiten konnte.
4. Ausführen des Agenten im Chat
Wir baten den Agenten, ein historisches Thema zu summarize, und riefen ihn mit @agent auf.
Wir änderten den Befehl, um die Ausgabe als einfache Textdatei statt als PDF zu speichern.
Das System bestätigte, dass der Agenten-Chat-Modus aktiv war, und zeigte, wie die Schleife verlassen werden kann.
Der Agent erstellte die Zusammenfassung und bereitete die Datei zum Speichern vor.
5. Lokales Speichern der Datei
Zum Speichern der Ausgabe verwendeten wir den Beispielbefehl aus der AnythingLLM-Dokumentation:
„@agent kann diese Informationen als PDF in meinem Desktop-Ordner speichern?“
Wir führten dieselbe Struktur im Chat aus, jedoch für eine Textdatei.
Ein Dateibrowser-Fenster öffnete sich, und wir speicherten die Ausgabe auf dem Gerät.
Die Datei erschien im Downloads-Ordner, was darauf hindeutet, dass der gesamte Prozess – Reasoning, Ausführung und Speichern – vollständig auf dem Gerät durchgeführt wurde.
Beschreibungen der Kategorien lokaler KI-Agenten
- Entwickler- & Systemagenten (Aktionsschicht): Agenten, die direkt auf Ihrem Gerät laufen, um Programmier-, System- und Workflow-Automatisierungsaufgaben lokal auszuführen.
- Lokale Automatisierungs- & Steuerungsagenten: Agenten, die reale Aktionen auf Ihrem Rechner automatisieren, indem sie den Browser, die UI oder das Betriebssystem steuern.
- Wissens- & Produktivitätsagenten: Lokale Assistenten für Chat, Zusammenfassung und Dokumentenverarbeitung, ohne Daten in die Cloud zu senden.
Architektur-Ebenen im lokalen Agenten-Stack
- Aktionsschicht (Agenten): Systeme, die den Zustand beobachten, Tools aufrufen und auf die lokale Umgebung einwirken.
- Reasoning- und Orchestrierungsschicht (Frameworks): Bibliotheken wie LangGraph oder LlamaIndex, die Planung, Speicher und Koordination unterstützen. Sie sind selbst keine Agenten.
- Ausführungsschicht (lokale Laufzeitumgebungen): Modell-Laufzeitumgebungen wie Ollama oder LM Studio, die lokale Inferenz ermöglichen.
Hardware: Was lokale Agenten wirklich brauchen
Das Modell und das Framework sind nur die halbe Geschichte. Die Hardware entscheidet, was tatsächlich möglich ist. Für den lokalen Betrieb von Sprachmodellen sind zwei Werte am wichtigsten: wie viel Speicher vorhanden ist und wie schnell dieser Speicher ist.
RAM (oder VRAM) legt die Obergrenze für die Modellgröße fest
Ein Modell muss in den Speicher passen, bevor es laufen kann. Eine grobe Orientierung für 4-Bit-quantisierte Modelle: Ein 3B-Modell benötigt etwa 2 GB, ein 7–8B-Modell etwa 5–6 GB, ein 13B-Modell etwa 8–10 GB und ein 70B-Modell etwa 40–48 GB. Planen Sie zusätzlichen Spielraum für Kontext, das Betriebssystem und andere laufende Anwendungen ein. In der Praxis ist der Speicher häufiger der Engpass als die Rechenleistung, und auf Copilot+-PCs liegt das empfohlene Ziel für eine komfortable lokale LLM-Nutzung bei mindestens 32 GB RAM.4
Speicherbandbreite bestimmt die Geschwindigkeit
Sobald ein Modell hineinpasst, hängt die Geschwindigkeit der Token-Generierung hauptsächlich davon ab, wie schnell das System die Gewichte des Modells aus dem Speicher lesen kann. Deshalb ist die hohe Speicherbandbreite von Apple Silicon (bis zu 800 GB/s beim M4 Max) der praktische Vorteil für die LLM-Inferenz – nicht die Anzahl der Neural Engines.5
NPU-TOPS sind weniger wichtig, als das Marketing nahelegt
Eine Neural Processing Unit ist ein Chip, der für KI-Mathematik entwickelt wurde; ihre Leistung wird in TOPS (Billionen Operationen pro Sekunde) angegeben. Die Copilot+-PC-Zertifizierung von Microsoft erfordert mindestens 40 TOPS. Diese Schwelle ist auf die eigenen On-Device-Funktionen von Microsoft ausgerichtet (Live-Untertitel, Bildeffekte, Recall) und nicht auf den Betrieb eines Chat-artigen LLM. Bei LLM-Workloads dominieren RAM und Bandbreite. Die NPU-Leistung ist ein nützliches Unterscheidungskriterium, aber nicht die wichtigste Kennzahl.
Eine praktische Faustregel:
- Für 3B-Assistentenmodelle genügt ein aktueller Laptop mit 16 GB gemeinsamem Speicher oder RAM.
- Für 7–8B-Modelle mit komfortabler Geschwindigkeit sind 32 GB RAM und hohe Speicherbandbreite das Ziel. Apple Silicon, die Snapdragon-X-Serie und aktuelle Intel/AMD-Copilot+-PCs funktionieren alle; die Unterschiede zeigen sich in Tokens pro Sekunde, nicht darin, ob das Modell läuft.
- Für größere Modelle (30B und mehr) teilen sich die Optionen. Apple Silicon mit viel Speicher (Mac Studio- oder MacBook-Pro-Konfigurationen mit 64–192 GB gemeinsamem Speicher) kann große Modelle ausführen, die in keine diskrete Consumer-GPU passen. Die Alternative ist eine Workstation mit einer oder mehreren diskreten GPUs mit hohem VRAM. Beide Wege funktionieren; sie haben unterschiedliche Kosten- und Leistungsprofile.
 Als bevorzugte Quelle hinzufügen
Praktische Anleitung
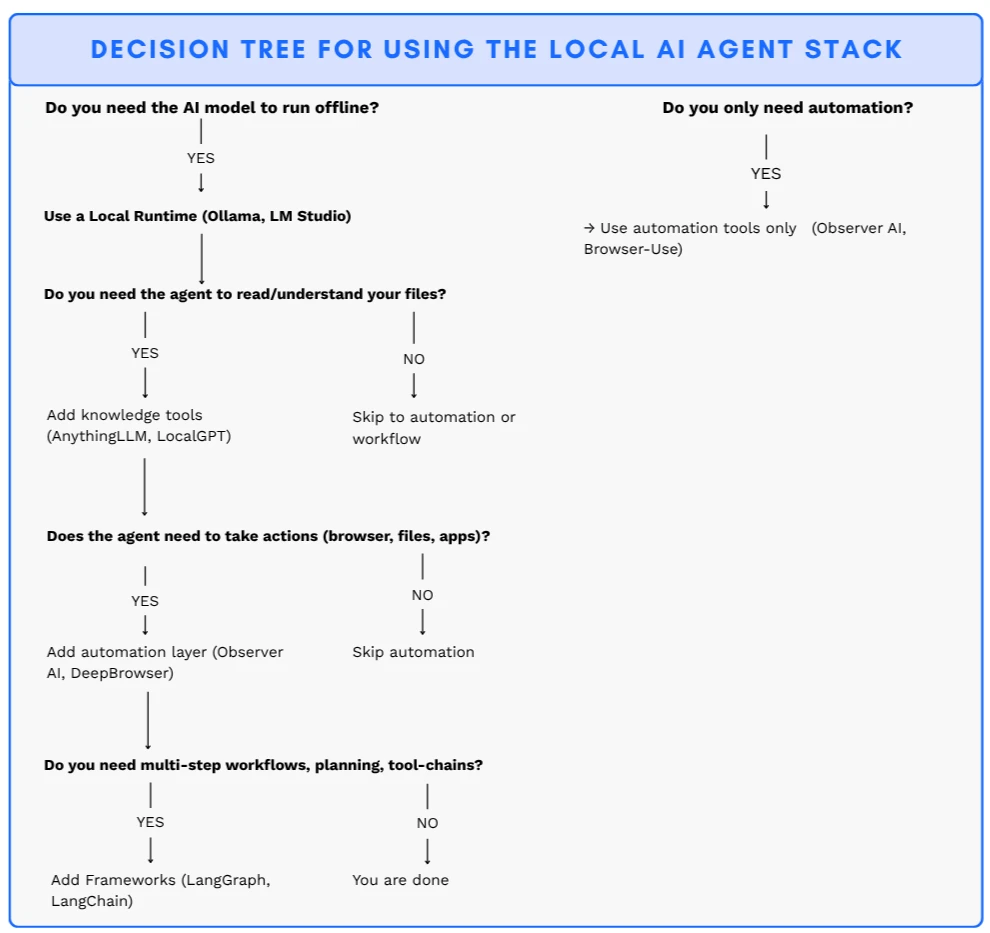
Lokale KI-Systeme sollten schrittweise aufgebaut werden:
- Beginnen Sie mit einer lokalen Laufzeitumgebung, wenn Offline-Inferenz erforderlich ist.
- Fügen Sie eine Wissensebene hinzu, wenn Dokumentverständnis benötigt wird.
- Setzen Sie Automatisierungs- oder Steuerungsagenten ein, wenn reale Aktionen erforderlich sind.
- Verwenden Sie Orchestrierungs-Frameworks für komplexe, mehrstufige Workflows.
In den meisten Fällen ist ein vollständig geschichteter Stack unnötig.
So gehen Sie den lokalen KI-Agenten-Stack an
Beginnen Sie mit der kleinsten Menge an Ebenen, die Ihr Anwendungsfall erfordert. Wenn Ihr Agent Offline-Reasoning benötigt, beginnen Sie mit einer lokalen Laufzeitumgebung wie Ollama oder LM Studio. Wenn er Ihre Dateien verstehen muss, fügen Sie eine Wissensebene wie AnythingLLM oder LocalGPT hinzu. Für Agenten, die Aktionen ausführen müssen (Apps öffnen, den Browser steuern, Dateien verwalten), fügen Sie eine lokale Automatisierungsebene hinzu. Verwenden Sie Frameworks wie LangGraph oder LlamaIndex, wenn Sie mehrstufige Workflows, Planungsschleifen oder komplexe Toolchains benötigen.
Warum einen Agenten lokal betreiben
Datenschutz ist eine rechtliche Frage, keine Präferenz
Mit dem Digital Omnibus gelten die Hochrisiko-Pflichten des EU-KI-Gesetzes nun ab dem 2. Dezember 2027 für eigenständige Systeme (Anhang III) und ab dem 2. August 2028 für KI in regulierten Produkten; die Transparenzpflichten nach Artikel 50 gelten bereits seit dem 2. August 2026.6 Die Strafen können bis zu 15 Millionen Euro oder 3 % des weltweiten Jahresumsatzes betragen. Ein Modell, das auf Ihrer eigenen Hardware läuft, verarbeitet Daten in Ihrer Umgebung, ohne sie an einen Cloud-Anbieter zu übermitteln. Das Risiko einer grenzüberschreitenden Datenübertragung entfällt.7
Latenz
Cloud-API-Aufrufe verursachen 200–500ms Netzwerkverzögerung, bevor das erste Token erscheint. On-Device-Inferenz reduziert dies auf unter 20ms. Für Sprachagenten, Code-Vervollständigung und alles, was eine UI in Echtzeit berührt, ist dies der Unterschied zwischen flüssig und träge
Kosten bei hohem Volumen
Cloud-Aufrufe sind pro Anfrage günstig und in großen Mengen teuer. Ein lokales Modell hat feste Hardwarekosten und keine Token-basierte Abrechnung. Der Zielkonflikt bleibt real: Lokale Agenten sind durch das Modell begrenzt, das in den Speicher passt, und durch die Hardware auf dem Schreibtisch. Die nächsten Abschnitte behandeln beides.
FAQs
Lokale KI-Agenten arbeiten autonom auf persönlicher Hardware, ohne auf externe APIs oder Cloud-Infrastruktur angewiesen zu sein.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Lokale KI-Agenten: Goose, Observer KI, AnythingLLM}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/local-ai-agent}},
  note   = {AIMultiple. Abgerufen am 30. Juli 2026}
}Ergebnisse und Zeitstempel von 19 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 4 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
3 AktualisierungenAbschnitte "Warum einen Agenten lokal betreiben" und lokale Hardwareanforderungen hinzugefügt.
Die Abschnitte „Frameworks“ und „Lokale Laufzeiten & Infrastruktur“ wurden entfernt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.




Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.