


Multimodale KI-Modelle beim visuellen Denken vergleichen

Wir haben 40 führende multimodale KI-Modelle im visuellen Denken anhand von 200 visuellen Fragen einem Benchmark unterzogen. Die Evaluierung bestand aus zwei Tracks: 100 Fragen zum Diagrammverständnis, die Interpretation von Datenvisualisierungen testeten, und 100 Fragen zur visuellen Logik, die Mustererkennung und räumliches Denken bewerteten.
Benchmark zum visuellen Denken
Siehe unsere Benchmark-Methodik, um unsere Testverfahren zu erfahren.
Jedes Modell schneidet bei visueller Logik schlechter ab als bei Diagrammen. Der Abstand ist am kleinsten für qwen3.8-flash (58 % vs. 78 %) und am größten für claude-sonnet-4.5 (35 % vs. 77 %).
- gemini-4-argon hat in beiden Kategorien die höchste Punktzahl: 62 % bei visueller Logik und 87 % beim Diagrammverständnis. Es liegt außerdem insgesamt mit 74,5 % auf Platz eins, 1 Punkt vor gemini-3.7-flash und claude-opus-5.5 (73,5 % jeweils). Das ist ein Unterschied von 2 Fragen von 200, daher liegen die ersten drei nur wenige Fragen auseinander.
- gemini-3.5-flash-lite (36,5 %) und llama-4-maverick (38,5 %) liegen wegen der visuellen Logik insgesamt auf den letzten Plätzen. Sie beantworten 22 % bzw. 19 % dieser Fragen richtig, und claude-haiku-4.5 beantwortet 20 %. Alle drei liegen nahe an den 20 %, die zufälliges Raten bei fünf Optionen ergibt. Bei Diagrammen liegen dieselben drei Modelle ebenfalls auf den letzten Plätzen, mit 51 % bis 61 %.
Kosten- & Latenzvergleich
Benchmark-Fragen dazu, wo LLMs am besten abschneiden und am meisten zu kämpfen haben
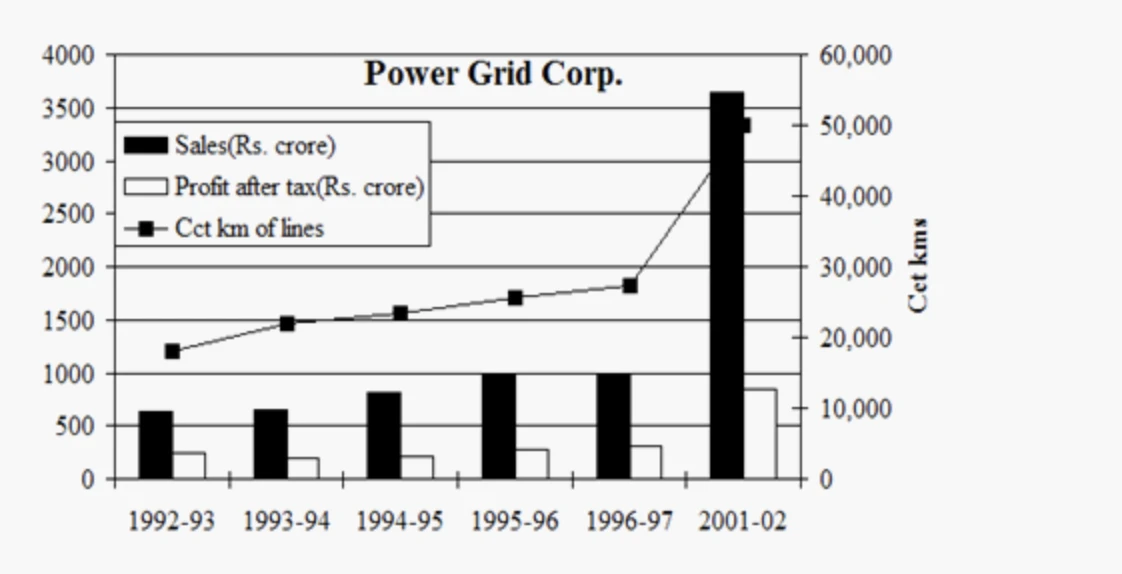
Diagramm-Frage mit der niedrigsten LLM-Erfolgsquote
Abbildung 1: Balkendiagramm von Power Grid Corp. mit Umsatz (schwarze Balken) und Gewinn nach Steuern (weiße Balken) für 1992-93 bis 1996-97 und 2001-02, mit einer Linie für Leitungskilometer auf einer zweiten y-Achse.
Hinweis: Alle Diagramme stammen von Hitbullseye.1
Frage: Die Rentabilität (Gewinn / Umsatz) ist am höchsten in: A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
Keines der 40 Modelle antwortete richtig (die Antwort ist D, 1996-97), und 38 von ihnen wählten 1992-93. Die Berechnung ist eine einzige Division pro Jahr, daher liegt die Schwierigkeit im Lesen des Diagramms.
Die Gewinnbalken sind klein und weiß, nur ein paar hundert Crore auf einer 0-4.000-Achse mit Gitterlinien alle 500. Die Unterschiede zwischen den Jahren belaufen sich auf wenige Pixel. Die zweite y-Achse und die überlagerte Linie sorgen für Unruhe. Die Modelle mussten diese kurzen weißen Balken mit viel höheren schwarzen Balken vergleichen, und ein kleines falsches Ablesen der Balkenhöhe genügte, um die Antwort zu ändern.
Diagramm-Frage mit der höchsten LLM-Erfolgsquote
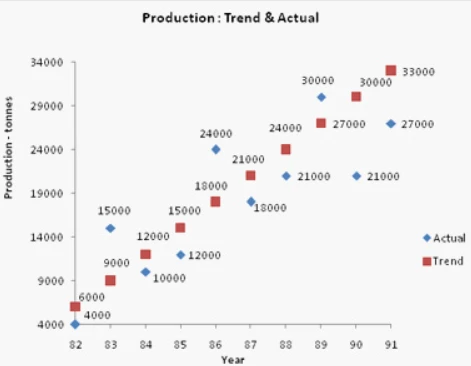
Abbildung 2: Streudiagramm mit tatsächlicher und Trend-Produktion (in Tonnen) von 1982 bis 1991. Blaue Rauten markieren die tatsächlichen Werte, rote Quadrate die Trendwerte, und jeder Punkt ist mit seinem Wert beschriftet.
Frage: Der Trend wurde wie folgt festgestellt: A. Die diesjährige Produktion ist das Eineinhalbfache der Vorjahresproduktion. B. Die diesjährige Produktion ist doppelt so hoch wie die Vorjahresproduktion. C. Die diesjährige Produktion ist dreitausend Tonnen höher als die Vorjahresproduktion. D. Die diesjährige Produktion ist viertausendfünfhundert Tonnen höher als die Vorjahresproduktion.
Alle Modelle beantworteten diese Frage richtig. Die Trendpunkte steigen jedes Jahr um denselben Betrag (6.000, 9.000, 12.000 und so weiter bis 33.000). Da jeder Punkt seinen Wert als Beschriftung trägt, konnten die Modelle die Zahlen direkt ablesen, statt Positionen anhand der Achse zu schätzen.
Das Power-Grid-Diagramm erforderte den Vergleich der Höhen kleiner Balken. Hier ist keine Höhenschätzung nötig: Die Beschriftungen liefern exakte Werte, und der einzige verbleibende Schritt ist eine einfache Subtraktion.
Frage zur visuellen Logik mit der höchsten LLM-Erfolgsquote
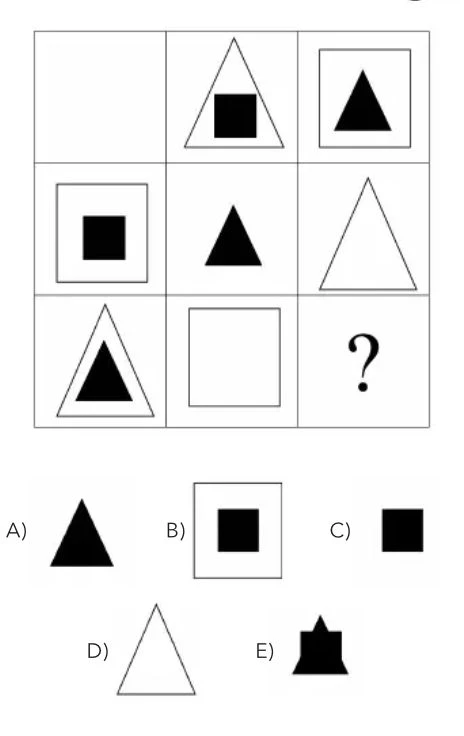
Abbildung 4: Ein 3×3-Gitter, in dem jede Zelle ein weißes oder schwarzes Dreieck oder Quadrat enthält, entweder allein oder ineinander verschachtelt. Die Zelle unten rechts fehlt, und fünf Optionen sind angegeben.
Frage: Welche Option vervollständigt das Gitter?
38 der 40 Modelle antworteten richtig (die Antwort ist C, ein schwarzes Quadrat). Nur claude-haiku-4.5 und llama-4-maverick lagen daneben. Jede Zeile und Spalte enthält ein weißes Dreieck, ein weißes Quadrat, ein schwarzes Dreieck und ein schwarzes Quadrat genau einmal. Das fehlende Teil lässt sich daher finden, indem man auflistet, was bereits vorhanden ist.
Im Sechseck-Gitter hing die Regel davon ab, wie die Formen in Bereiche aufgeteilt waren. Hier ist jedes Element eine separate, klar gezeichnete Form, die Modelle identifizieren und zählen können.
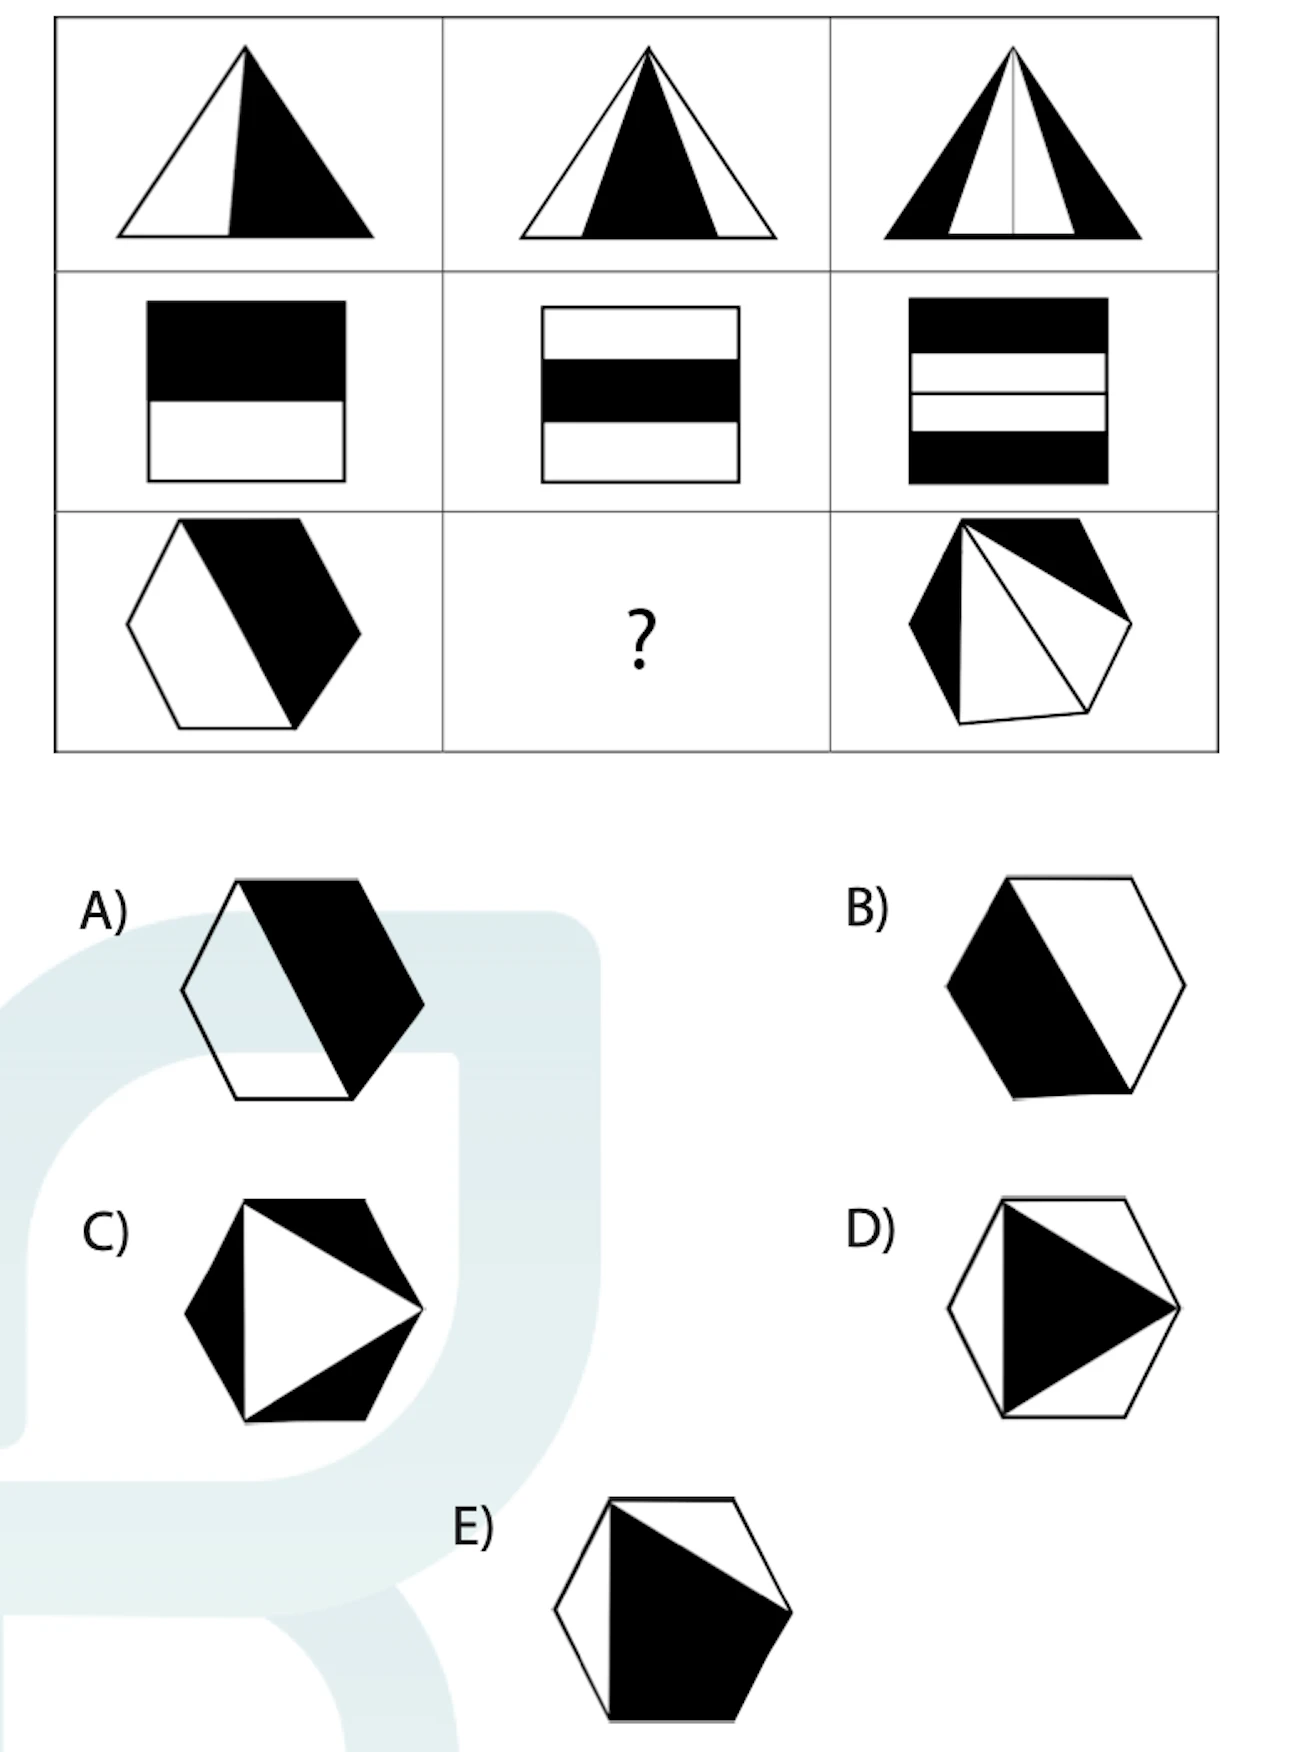
Frage zur visuellen Logik mit der niedrigsten LLM-Erfolgsquote
Abbildung 3: Ein 3×3-Gitter aus Formen: Dreiecke in der ersten Reihe, Rechtecke in der zweiten und Sechsecke in der dritten. Jede Form ist in schwarze und weiße Bereiche unterteilt, und das mittlere Sechseck fehlt. Fünf Sechsecke sind als Optionen angegeben.
Frage: Welche Option vervollständigt das Gitter?
Keines der 40 Modelle antwortete richtig. Die Frage enthält keine Zahlen oder Berechnungen; die einzige Aufgabe besteht darin zu erkennen, wie sich die schwarzen und weißen Bereiche in jeder Zeile verändern.
Benchmark-Methodik
Wir haben 40 bildfähige Modelle anhand von 200 bildbasierten Multiple-Choice-Fragen evaluiert.
- Reasoning: Jedes Modell wurde auf den höchsten Reasoning-Aufwand eingestellt, den es unterstützt (max, xhigh oder high, je nach Modell). Bei einigen Modellen wurde kein Parameter für den Reasoning-Aufwand akzeptiert, daher galt der Standardwert des Anbieters:
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro und qwen3.8-flash haben standardmäßig dennoch Reasoning verwendet.claude-haiku-4.5 und gemini-3.5-flash-lite erzeugten keine Reasoning-Tokens.kimi-k2.5 zeigte nur bei 34 seiner 200 Aufrufe Reasoning.
- Temperatur: Nicht festgelegt, daher galt der Standardwert des jeweiligen Anbieters.
- Max. Tokens: Festgelegt auf 1.000.000, damit die Ausgabelänge das Reasoning nicht einschränkt. Wenn ein Anbieter diesen Wert ablehnte, wurde das eigene maximale Ausgabelimit des Modells verwendet.
- Durchläufe: Jede Frage wurde einmal pro Modell ausgeführt, insgesamt 7.600 Aufrufe.
- Wiederholungen: Fehlgeschlagene Aufrufe wurden bis zu 3-mal im Abstand von 60 Sekunden wiederholt. Bei 4 Fragen zur visuellen Logik lieferte muse-wonder nie eine Antwort: Sein Anbieter schloss die Verbindung bei jedem Versuch nach etwa 6.5 Minuten. Diese 4 Fragen werden als falsch gewertet, daher wurde keine Frage ausgeschlossen.
- Kosten und Latenz: Die Kosten sind die abgerechneten Kosten, die das Gateway für jeden Aufruf meldete. Die Latenz ist die Dauer des erfolgreichen Aufrufs, ohne Wartezeiten durch Wiederholungen.
Der Benchmark bestand aus 200 Fragen in zwei Kategorien: Diagrammverständnis (100 Fragen) und visuelle Logik (100 Fragen). Bei Diagrammfragen wird das Diagramm als Bild gesendet, während Frage und Optionen als Text vorliegen. Bei Fragen zur visuellen Logik befindet sich die gesamte Frage einschließlich der Optionen im Bild. Die meisten Diagrammfragen haben vier Optionen (89 von 100), die übrigen haben fünf oder weniger. Fragen zur visuellen Logik haben fünf Optionen (A-E).
Fragen:
- Diagrammverständnis (100 Fragen). Wir bewerteten die Fähigkeit der Modelle, Informationen aus Datenvisualisierungen zu extract, zu interpretieren und zu analysieren:
- Balkendiagramme (40): einzelne, gruppierte und zweiachsige Balkendiagramme
- Streudiagramme (26): Ablesen von Werten und Trends aus beschrifteten Punkten
- Kreisdiagramme (14): Prozentverteilungen und proportionales Denken
- Liniendiagramme (10): Einzel- und Mehrreihen-Trends im Zeitverlauf
- Kombinierte Darstellungen (10): ein Diagramm, das zusammen mit einem zweiten Diagramm oder einer Datentabelle gezeigt wird
- Visuelle Logik (100 Fragen). Wir bewerteten abstraktes Denken und räumliche Intelligenz anhand von:
- Mustererkennung: Erkennen von Sequenzen und Vervollständigen visueller Muster
- Räumliches Denken: Transformationen von Formen und Überlagern von Figuren
- Mathematische Logik: numerische Muster, algebraisches Denken und Kombinatorik
- Abstraktes Denken: Symbolmanipulation, logische Deduktion und Regelinferenz
 Als bevorzugte Quelle hinzufügen
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Multimodale KI-Modelle beim visuellen Denken vergleichen}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Abgerufen am 14. Oktober 2026}
}Ergebnisse und Zeitstempel von 22.9 Tausend Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 4 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
6 AktualisierungenDie Anzahl der bewerteten Modelle im Abschnitt „Visual Reasoning Benchmark“ wurde aktualisiert.
Die Einstellung des max tokens-Parameters in der Benchmark-Methodik wurde ersetzt.




Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.