


20 Estrategias para la mejora de la IA y ejemplos

Los modelos de IA requieren una mejora continua a medida que evolucionan los datos, el comportamiento de los usuarios y las condiciones del mundo real. Incluso los modelos con buen rendimiento pueden desviarse cuando los patrones que aprendieron ya no coinciden con las entradas actuales, lo que reduce la precisión y genera predicciones poco fiables.
Los cambios en las normativas, los requisitos de los productos o las expectativas de los clientes también pueden introducir nuevas limitaciones que los modelos existentes no fueron diseñados para manejar.
Por tanto, mantener la calidad del modelo implica reforzar tanto los datos que respaldan el modelo como los algoritmos que determinan su comportamiento, garantizando que los sistemas sigan alineados con los requisitos actuales en lugar de con supuestos obsoletos.
Explore estrategias clave, como la alimentación de datos, la mejora de datos y algoritmos, y las leyes de escalado de IA, que garantizarán que sus modelos de IA sigan siendo pertinentes y prácticos.
Las 20 mejores formas de mejorar su modelo de IA
Hemos explicado métodos para mejorar su modelo de IA en 4 categorías diferentes:
Método | Descripción | Desafíos clave |
|---|---|---|
Alimentar más datos | Añadir datos reales o sintéticos de alta calidad para mejorar la cobertura y la generalización. | Garantizar la calidad de los datos, evitar sesgos y gestionar los límites de privacidad y acceso. |
Mejorar los datos | Mejorar el etiquetado, la diversidad y el aumento de datos para reducir el ruido y el sesgo. | Equilibrar la calidad frente a la cantidad, reducir el sesgo del dataset y mantener la coherencia de las anotaciones. |
Mejorar el algoritmo | Utilizar mejores arquitecturas, técnicas de fine-tuning y prácticas de despliegue. | Mayor complejidad y coste, comportamientos no deseados y estrictas necesidades de privacidad. |
Leyes de escalado de IA | Aumentar la escala, la computación, la eficiencia y las técnicas de recuperación o multiagente. | Rendimientos decrecientes, límites de computación, impacto ambiental y complejidad de integración. |
Alimentar más datos
Añadir datos nuevos y actualizados es uno de los métodos más comunes y eficaces para mejorar la precisión de su modelo de aprendizaje automático. Las investigaciones han demostrado una correlación positiva entre el tamaño del dataset y la precisión del modelo de IA.1
Por lo tanto, ampliar el dataset que se utiliza para el reentrenamiento del modelo puede ser una forma eficaz de mejorar los modelos de IA/ML. Asegúrese de que los datos cambien según el entorno en el que se implemente. También es esencial adherirse a prácticas adecuadas de control de calidad en la recopilación de datos.
1. Recopilación de datos
La recopilación/extracción de datos puede utilizarse para ampliar su dataset e incorporar más datos al modelo de IA/ML. En este proceso, se recopilan datos nuevos para reentrenar el modelo. Estos datos pueden obtenerse mediante los siguientes métodos:
- Recopilación privada
- Recopilación automatizada de datos
- Crowdsourcing personalizado
Para recopilar datos con éxito para la IA, las empresas deben tener en cuenta:
- Las consideraciones éticas y legales en la recopilación de datos deben respetarse para evitar cualquier problema ético.
- El sesgo en los datos de entrenamiento puede provocar resultados no deseados de la IA.
- El preprocesamiento de los datos brutos es esencial para abordar los problemas de calidad y garantizar la integridad de los datos para el entrenamiento de IA/ML.
- No todos los datos son fácilmente accesibles debido a restricciones relacionadas con la sensibilidad y las normativas de privacidad.
Obtenga más información sobre los métodos de recopilación de datos.
También se recomienda trabajar con un servicio de datos de IA para obtener datasets relevantes sin la molestia de recopilar datos y para evitar problemas éticos y legales.
2. Datos sintéticos con modelos generativos
La IA generativa ha avanzado en la creación de datos sintéticos, produciendo datasets de alta calidad que replican condiciones del mundo real. Los grandes modelos de lenguaje y los modelos de difusión ahora pueden generar datos estructurados y no estructurados para entrenar modelos en dominios donde los datos reales son limitados.
Algunos ejemplos son:
- Producir casos médicos poco frecuentes para mejorar los modelos de aprendizaje automático en el sector sanitario.
- Generar datos de conversación realistas para mejorar los sistemas de procesamiento del lenguaje natural.
- Crear datasets visuales para probar la resolución de imágenes, la calidad fotográfica o los modelos de reconocimiento de imágenes.
Autoaprendizaje sintético y datos de entrenamiento sintéticos
El autoaprendizaje sintético genera nuevos datos de entrenamiento al permitir que los modelos o agentes interactúen con tareas o entre sí. Estos complementos cuentan con datos humanos de alta calidad limitados.
Este método proporciona:
- Producción escalable de datos de instrucciones, razonamiento o diálogo.
- Cobertura de escenarios que son raros o costosos de recopilar manualmente.
- Mejora del rendimiento del modelo en dominios donde la escasez de datos es una limitación principal.
Ejemplo real: más datos para chatbots
Un chatbot de soporte de TI tenía dificultades para comprender y clasificar con precisión las preguntas de los usuarios. Para mejorar su rendimiento, 500 consultas de soporte de TI se reescribieron en múltiples variaciones en siete idiomas.
Estos datos adicionales ayudaron al chatbot a reconocer diferentes formatos de preguntas, mejorando su capacidad para responder de forma más eficaz.
Mejorar los datos
Mejorar los datos existentes también puede dar como resultado un modelo de IA/ML mejorado.
Ahora que las soluciones de IA abordan problemas más complejos, se requieren datos mejores y más diversos para desarrollarlas. Por ejemplo, una investigación2 sobre un modelo de aprendizaje profundo que ayuda a los sistemas de detección de objetos a comprender las interacciones entre dos objetos concluye que el modelo es susceptible3 al sesgo del dataset y requiere un dataset diverso para producir resultados.
Las mejoras pueden lograrse mediante:
3. Enriquecer los datos
Ampliar el dataset es una forma de mejorar la IA. Otra forma importante de mejorar los modelos de IA/ML es enriquecer los datos. Esto significa que los nuevos datos que se recopilan para ampliar el dataset deben procesarse antes de introducirse en el modelo.
Esto también puede significar mejorar la anotación del dataset existente. Dado que se han desarrollado técnicas de etiquetado nuevas y mejoradas, pueden aplicarse al dataset existente o recién recopilado para mejorar la precisión del modelo.
4. Mejorar la calidad de los datos
Mejorar la calidad de los datos es esencial para avanzar en los sistemas de IA y mejorar el rendimiento de los modelos de IA. Aunque los avances en IA suelen hacer hincapié en mejores algoritmos y más potencia de cómputo, los datos de entrenamiento de alta calidad siguen siendo fundamentales para un rendimiento óptimo.
Adoptar un enfoque centrado en los datos ayuda a acelerar el progreso de la IA al garantizar que los datos utilizados para el entrenamiento sean abundantes y de alta calidad.
La recopilación y curación de datos de alta calidad permiten a los desarrolladores crear modelos de IA más eficientes y eficaces, que luego pueden aprovecharse para resolver tareas complejas en diversas industrias. Al centrarse en la calidad de los datos, las empresas pueden hacer predicciones más precisas, reducir el sesgo y mejorar las capacidades de los sistemas de IA.
La calidad de los datos puede mejorarse significativamente durante la fase de recopilación de datos. Este proceso incluye garantizar que los datos sean representativos de los escenarios del mundo real que encontrará el modelo para eliminar el sesgo, reducir el ruido y asegurarse de que sean lo suficientemente diversos como para captar todas las variables relevantes.
Además, mantener la coherencia en el etiquetado de los datos y abordar las lagunas del dataset puede ayudar a reducir los errores en el proceso de aprendizaje del modelo.
5. Aprovechar el aumento de datos
Algunas personas pueden confundir los datos aumentados con los datos sintéticos; sin embargo, los dos términos son diferentes. Los datos aumentados se refieren a añadir información a un dataset existente, mientras que los datos sintéticos se generan artificialmente para sustituir a los datos reales.
Mejorar el algoritmo
A veces, es necesario mejorar el algoritmo que se creó inicialmente para el modelo. Esto puede deberse a diferentes motivos, incluido un cambio en la población sobre la que se despliega el modelo.
Supongamos que un algoritmo de IA/ML implementado que evalúa el riesgo de salud del paciente y no incluye el parámetro del nivel de ingresos se expone de repente a datos de pacientes con niveles de ingresos más bajos. En ese caso, es poco probable que produzca evaluaciones justas.
Por lo tanto, actualizar el algoritmo y añadirle nuevos parámetros puede ser una forma eficaz de mejorar el rendimiento del modelo. El algoritmo puede mejorarse de las siguientes maneras:
6. Mejorar la arquitectura
Hay algunas cosas que se pueden hacer para mejorar la arquitectura de un algoritmo. Una forma es aprovechar las características modernas del hardware, como las instrucciones SIMD o las GPUs.4
Además, las estructuras de datos y los algoritmos pueden mejorarse mediante el uso de diseños de datos que aprovechan la caché y algoritmos eficientes. Por último, los desarrolladores de algoritmos pueden aprovechar los avances recientes en aprendizaje automático y técnicas de optimización.
El Transformer es una arquitectura de aprendizaje profundo que cambió el procesamiento del lenguaje natural (NLP) y otros campos al permitir un modelado más eficiente y eficaz de datos secuenciales. Presentado en el artículo “Attention Is All You Need”5, se basa en gran medida en un mecanismo llamado autoatención, sustituyendo las operaciones recurrentes y convolucionales utilizadas en modelos anteriores como los RNN y las CNN.
Un Transformer consta de un codificador y un descodificador, cada uno formado por múltiples capas apiladas:
- El codificador transforma las secuencias de entrada en representaciones conscientes del contexto mediante autoatención de múltiples cabezas para capturar las relaciones entre tokens, redes feedforward para el procesamiento y conexiones residuales con normalización de capas para la estabilidad.
- El descodificador genera secuencias de salida token a token, incorporando autoatención de múltiples cabezas enmascarada para evitar el acceso a tokens futuros, atención cruzada para integrar las salidas del codificador y mecanismos similares de feedforward y normalización para un aprendizaje eficiente.
7. Arquitecturas de modelos híbridos
Las arquitecturas de modelos híbridos combinan elementos de Transformers, modelos de espacio de estados y otros métodos de procesamiento de secuencias. Este enfoque admite un contexto de larga duración y reduce los requisitos de cómputo.
Entre las principales ventajas se incluyen:
- Procesamiento más eficiente de secuencias largas.
- Reducción del uso de memoria para el entrenamiento y la inferencia.
- Compatibilidad con entornos de centros de datos y de borde.
Ejemplo real: Kimi K2.5
Kimi K2.5 es un modelo de IA agéntica de código abierto desarrollado por Moonshot IA, preentrenado con aproximadamente 15 billones de tokens mixtos visuales y de texto.
El diseño de Kimi K2.5 integra visión y comprensión del lenguaje con razonamiento agéntico, ofreciendo modos instantáneo y de “pensamiento” y admitiendo flujos de trabajo conversacionales y de agentes autónomos.6
Las características clave son:
- Multimodalidad nativa: Procesa y razona sobre texto, imágenes y vídeo en un modelo unificado.
- Codificación asistida por visión: Puede generar código a partir de entradas visuales y alinear las salidas con especificaciones visuales.
- Ejecución de enjambre de agentes: Admite la descomposición coordinada de tareas, lo que permite que los procesos agénticos se ejecuten en paralelo para flujos de trabajo complejos.
8. Reingeniería de características
La reingeniería de características de un algoritmo es el proceso de mejorar las características del algoritmo para hacerlo más eficiente y eficaz. Esto puede hacerse modificando la estructura del algoritmo o ajustando sus parámetros.
9. Modelos de mundo multimodales
Los modelos de mundo multimodales aprenden de texto, imágenes, audio, vídeo, datos estructurados y entradas de sensores. Esto crea una representación unificada entre modalidades.
Los aspectos importantes incluyen:
- Mejor conexión con la información del mundo real.
- Interpretación más precisa de escenas, señales y entradas multiformato.
- Aplicabilidad a tareas que requieren una comprensión integrada entre modalidades.
Ejemplo real: DeepMind
Google DeepMind realizó mejoras significativas en sus modelos de IA optimizando su arquitectura y rediseñando varios componentes para obtener un mejor rendimiento. Por ejemplo, el modelo Gemini se construyó con una arquitectura multimodal, lo que le permite manejar tareas de texto, audio e imágenes de forma más eficaz.
Además, PaLM 2 se mejoró con un enfoque de escalado óptimo en cómputo y mejoras en el dataset para mejorar las tareas de razonamiento. Estas actualizaciones arquitectónicas permitieron una mayor precisión y adaptabilidad.7
10. Seguridad, alineación y gobernanza de la IA
Mejorar los algoritmos ya no se limita a las optimizaciones técnicas. La seguridad, la alineación y la gobernanza de la IA son cada vez más críticas para garantizar que los sistemas de IA se comporten según lo previsto. Los desarrolladores y las organizaciones están priorizando métodos que:
- Align IA alinea las salidas de los modelos con los valores humanos y los requisitos empresariales.
- Incorporar bucles de retroalimentación para evitar comportamientos no deseados durante el despliegue.
- Establecer marcos de gobernanza que fijen límites para el uso de herramientas en diversas industrias.
Este cambio pone de relieve que lograr mejores resultados de IA implica mejorar la precisión y la fiabilidad, abordar las consideraciones éticas y garantizar la sostenibilidad a largo plazo.
Ejemplo real: IA sandbagging en el Informe Internacional de Seguridad de la IA
El Informe Internacional de Seguridad de la IA destaca una preocupación conocida como IA sandbagging, en la que un modelo se comporta de manera diferente durante la evaluación que en el uso real. En particular, los sistemas avanzados pueden parecer más seguros o menos capaces durante las pruebas formales, pero comportarse de manera diferente una vez implementados.
Esto crea una brecha de evaluación: los benchmarks tradicionales y las pruebas de equipos rojos pueden no captar plenamente los riesgos del mundo real si los modelos pueden adaptar su comportamiento según el contexto. Para las empresas, esto implica que las pruebas de seguridad puntuales son insuficientes y deben complementarse con mecanismos permanentes de monitoreo, auditoría y gobernanza.8
Figura 1: Ejemplo del modelo o3 de OpenAI que muestra conciencia situacional durante las evaluaciones.
11. Modelos verificadores y pipelines de autocorrección
Los modelos verificadores evalúan las salidas producidas por un modelo base e identifican errores o incoherencias. Respaldan la autocorrección estructurada. Sus principales contribuciones incluyen:
- Mayor precisión en tareas de razonamiento y matemáticas.
- Menores tasas de fallo mediante comprobaciones sistemáticas.
- Mayor fiabilidad en aplicaciones de alto riesgo o específicas de un dominio.
12. Optimización de IA en dispositivos y en el borde
La optimización de la IA en dispositivos y en el borde se ha vuelto cada vez más crucial para mejorar la privacidad, reducir la latencia y aumentar la eficiencia. En lugar de procesar los datos en servidores centralizados, los sistemas de IA pueden ejecutarse directamente en dispositivos como smartphones, sensores IoT o hardware empresarial.
Entre los beneficios se incluyen:
- Mejora de la privacidad al mantener los datos confidenciales en local.
- Menor latencia, lo que permite obtener información en tiempo real y de forma instantánea.
- Reducción de la dependencia de la conectividad constante y de la infraestructura de nube a gran escala.
Esta tendencia es especialmente relevante en sectores como la atención sanitaria, la automoción y la fabricación, donde la rapidez de respuesta y la protección de datos son cruciales.
Leyes de escalado de la IA
Las leyes de escalado describen cómo cambia el rendimiento del modelo a medida que los parámetros, los datos y la computación escalan juntos en proporciones equilibradas. Las investigaciones muestran que la pérdida tiende a seguir patrones predecibles de ley de potencia cuando los modelos se entrenan con datos y recursos de cómputo suficientes en relación con su tamaño.
Los primeros trabajos identificaron relaciones entre parámetros, tokens y cómputo de entrenamiento, mientras que estudios posteriores revisaron las proporciones óptimas, mostrando que muchos modelos grandes estaban subentrenados y que los modelos rinden mejor cuando los parámetros y los tokens de entrenamiento se escalan a magnitudes similares.
Los análisis más recientes incorporan el coste de inferencia, lo que indica que los modelos más pequeños entrenados durante más tiempo pueden igualar el rendimiento de los modelos más grandes cuando las cargas de trabajo de inferencia son altas. Otros estudios se centran en cómo escalan las capacidades en distintos benchmarks y muestran que la eficiencia de los modelos aumenta a medida que mejoran las arquitecturas, la calidad de los datos y los métodos de entrenamiento.
Estos hallazgos guían la selección de modelos y la planificación de recursos al hacer hincapié en el escalado equilibrado, los datos de entrenamiento adecuados y la creciente importancia de la eficiencia de los parámetros y de la inferencia.
Ejemplo real: escalado TTC paralelo con PaCoRe
PaCoRe (Razonamiento Coordinado en Paralelo) es un framework de código abierto que introduce un nuevo enfoque para escalar el cómputo en tiempo de prueba (TTC).
En lugar de estar limitado por la ventana de contexto de un modelo, PaCoRe lanza una exploración paralela masiva y, a continuación, compacta y sintetiza los resultados mediante una arquitectura de paso de mensajes, lo que permite un escalado de cómputo efectivo de varios millones de tokens durante la inferencia.
PaCoRe también incluye un servidor abierto que puede utilizarse con endpoints arbitrarios de LLM, lo que permite a los desarrolladores aplicar este enfoque de escalado paralelo en diferentes modelos y proveedores.9
13. Escalar el tamaño del modelo
Aumentar el número de parámetros de un modelo significa hacerlo más grande, normalmente añadiendo más capas o haciendo que las capas existentes sean más complejas. Los modelos más grandes pueden:
- Capturar patrones más complejos: Con más parámetros, el modelo puede representar relaciones más intrincadas en los datos.
- Manejar datasets más grandes: Los modelos más grandes tienen mayor capacidad para procesar y aprender de datos a gran escala.
Sin embargo, la relación entre el tamaño del modelo y el rendimiento puede presentar rendimientos decrecientes. Un aumento de 10x en el tamaño del modelo no implica necesariamente una mejora de 10x en el rendimiento.
Los modelos más grandes también requieren exponencialmente más recursos de cómputo y memoria, lo que puede hacerlos costosos y más difíciles de entrenar. A partir de cierto punto, aumentar el tamaño del modelo puede producir ganancias insignificantes, especialmente si el dataset o los recursos de cómputo son insuficientes.
14. Escalar los datos
La disponibilidad y el tamaño del dataset utilizado para entrenar un modelo afectan significativamente a su rendimiento:
- Los datasets más grandes mejoran la generalización: Con datos más diversos y completos, el modelo aprende una gama más amplia de patrones y es menos propenso a sobreajustarse.
- Mejor comprensión de eventos poco frecuentes: Los datasets grandes ayudan al modelo a aprender patrones raros y diversos, lo que le permitiría manejar mejor casos inusuales.
Sin embargo, el escalado de datos también tiene límites:
- Estabilización de las ganancias: A partir de cierto punto, añadir más datos produce rendimientos decrecientes en el rendimiento porque el modelo ya ha aprendido la mayoría de los patrones útiles.
- Calidad antes que cantidad: Los datos de mala calidad o ruidosos pueden no mejorar el rendimiento, incluso en grandes volúmenes.
- Cuello de botella de cómputo: Los datasets más grandes exigen más potencia de cómputo y tiempo de entrenamiento, lo que puede resultar prohibitivo.
15. Generación aumentada por recuperación (RAG)
La generación aumentada por recuperación se ha convertido en una estrategia esencial para mejorar los modelos de IA sin depender únicamente de modelos más grandes o de mayores recursos de cómputo. Los sistemas RAG integran un modelo de lenguaje de gran tamaño con una base de conocimientos externa, lo que permite al modelo acceder a información relevante en tiempo real.
Entre las principales ventajas se incluyen:
- Reducir la necesidad de reentrenar los modelos cuando se crea nueva información.
- Mejorar el rendimiento en funciones empresariales especializadas al basar las salidas en fuentes de datos seleccionadas.
- Mitigar los riesgos de respuestas obsoletas o alucinadas al permitir que los sistemas citen fuentes de contexto.
Este enfoque es ahora habitual en las soluciones empresariales de IA, donde los datos de entrenamiento no pueden seguir el ritmo de dominios que cambian rápidamente, como las finanzas, el derecho o el servicio de atención al cliente.
16. Sistemas aumentados con memoria
Los sistemas aumentados con memoria dan a los modelos acceso a una memoria persistente o a nivel de sesión. Esto permite al modelo mantener el contexto entre tareas e interacciones.
Entre las características importantes se incluyen:
- Compatibilidad con contexto a largo plazo que no está limitado por la longitud del prompt.
- Mayor coherencia en flujos de trabajo de varios pasos.
- Mejor alineación con casos de uso que requieren continuidad, como el trabajo en proyectos o el análisis complejo.
17. Escalar la computación
Escalar la computación implica aumentar la potencia de cómputo disponible durante el entrenamiento o la inferencia, normalmente mediante:
- Hardware más potente: GPUs, TPUs o chips de IA especializados.
- Sistemas distribuidos: Entrenar en varias máquinas en paralelo para manejar grandes cargas de trabajo.
- Duraciones de entrenamiento más largas: Permitir que el modelo optimice sus pesos en más iteraciones.
La relación entre la computación y el rendimiento del modelo es fundamental:
- Más cómputo permite modelos más grandes: Escalar la computación permite entrenar modelos con más parámetros.
- Entrenamiento prolongado: Con suficiente cómputo, los modelos pueden entrenarse con datasets más grandes durante más tiempo, lo que conduce a una mejor optimización.
Sin embargo, el escalado de la computación también presenta desafíos:
- Rendimientos decrecientes: Aunque el rendimiento mejora con más cómputo, la tasa de mejora se ralentiza a medida que aumentan los recursos.
- Costes y demanda energética: Entrenar modelos avanzados como GPT-4 requiere amplios recursos financieros y medioambientales.
A pesar de estos desafíos, el escalado de la computación ha sido fundamental para impulsar las mejoras en el aprendizaje automático de la IA.
En la fase de inferencia, el rendimiento de un modelo de IA, especialmente en tareas que requieren matemáticas o razonamiento de varios pasos, puede mejorar asignando más tiempo de cómputo. Esto suele lograrse mediante estrategias como un mayor cómputo por consulta o el refinamiento iterativo. Así es como funciona:
¿Qué ocurre durante la inferencia?
La inferencia es la etapa en la que un modelo preentrenado se utiliza para generar predicciones o realizar tareas a partir de nuevas entradas. A diferencia del entrenamiento, la inferencia no actualiza los pesos del modelo, sino que se basa en sus capacidades aprendidas para resolver problemas específicos.
¿Por qué ayuda más tiempo de cómputo?
Al realizar tareas como cálculos matemáticos o razonamiento de varios pasos, el modelo se beneficia de más tiempo y recursos por consulta porque:
- Refinamiento iterativo: Para tareas que requieren múltiples pasos lógicos, el modelo puede dividir el problema en partes más pequeñas, resolver cada parte y refinar iterativamente su solución. Asignar más cómputo permite al modelo procesar estos pasos de forma más exhaustiva.
- Mayor precisión: En tareas matemáticas, un mayor tiempo de inferencia permite una exploración más profunda de patrones o mecanismos de ensayo y error para aproximar soluciones correctas.
- Mejor comprensión contextual: En tareas como el razonamiento de varios pasos, un modelo con más tiempo de cómputo puede evaluar el contexto repetidamente para garantizar que los pasos intermedios se alineen con el problema general.
18. Escalado del cómputo en tiempo de inferencia
El escalado del cómputo en tiempo de inferencia se refiere a asignar más computación a un modelo durante la inferencia. Este enfoque admite trazas de razonamiento más largas y una evaluación de varios pasos sin modificar los parámetros del modelo.
Entre los puntos clave se incluyen:
- Los modelos pueden refinar iterativamente los pasos intermedios para tareas que requieren razonamiento.
- La precisión aumenta cuando se permite al modelo ejecutar rutas de inferencia más profundas.
- Las ganancias de rendimiento se logran sin reentrenamiento, lo que hace que este método sea adecuado para actualizaciones frecuentes.
Ejemplo real: ganancias de capacidad posteriores al entrenamiento y en tiempo de inferencia
El modelo Anthropic Claude Opus 4.6 ilustra cómo los sistemas de IA de vanguardia avanzan mediante mejoras en el razonamiento en tiempo de inferencia y la integración de herramientas. Estas ganancias se manifiestan en una codificación agéntica más capaz, donde el modelo puede planificar tareas de software de varios pasos, navegar por bases de código extensas y corregir iterativamente sus propios errores.
También aparecen en un uso más potente de herramientas y flujos de trabajo coordinados de agentes, como los equipos de agentes de Claude Code que dividen y ejecutan tareas complejas.
Además, Opus 4.6 admite ventanas de contexto largas (hasta ~1 millón de tokens en beta), lo que le permite mantener la coherencia en documentos extensos, bases de código e interacciones de varios pasos.
Together, estos avances destacan cómo el diseño del sistema y las técnicas de tiempo de inferencia están impulsando ganancias de capacidad significativas más allá del entrenamiento base por sí solo.
Figura 2: Gráfico que muestra el rendimiento de Opus 4.6 en Terminal Bench. Terminal Bench es un conjunto de benchmarks para evaluar agentes de IA que operan en entornos de terminal.10
Ejemplo real: Gemini 3 Deep Think
El Google Gemini 3 Deep Think está diseñado para abordar problemas científicos, matemáticos y de ingeniería complejos con una búsqueda inferencial más profunda y exploración de múltiples hipótesis.
Deep Think mejora el rendimiento al cambiar la forma en que el modelo razona en el momento de la inferencia, asignando más cómputo a los problemas más difíciles en lugar de depender únicamente de un mayor número de parámetros.
Esto demuestra que las modalidades de razonamiento, en las que un modelo puede cambiar a un modo de pensamiento profundo optimizado para tareas analíticas más difíciles, están surgiendo como un concepto diferenciado del progreso de la IA, junto con el número de parámetros y las mejoras de herramientas/despliegue.
Figura 3: Gráfico que muestra el rendimiento de Deep Think en los benchmarks ARC-AGI 2, Humanity’s Last Exam, MMMU-Pro y Codeforces.11
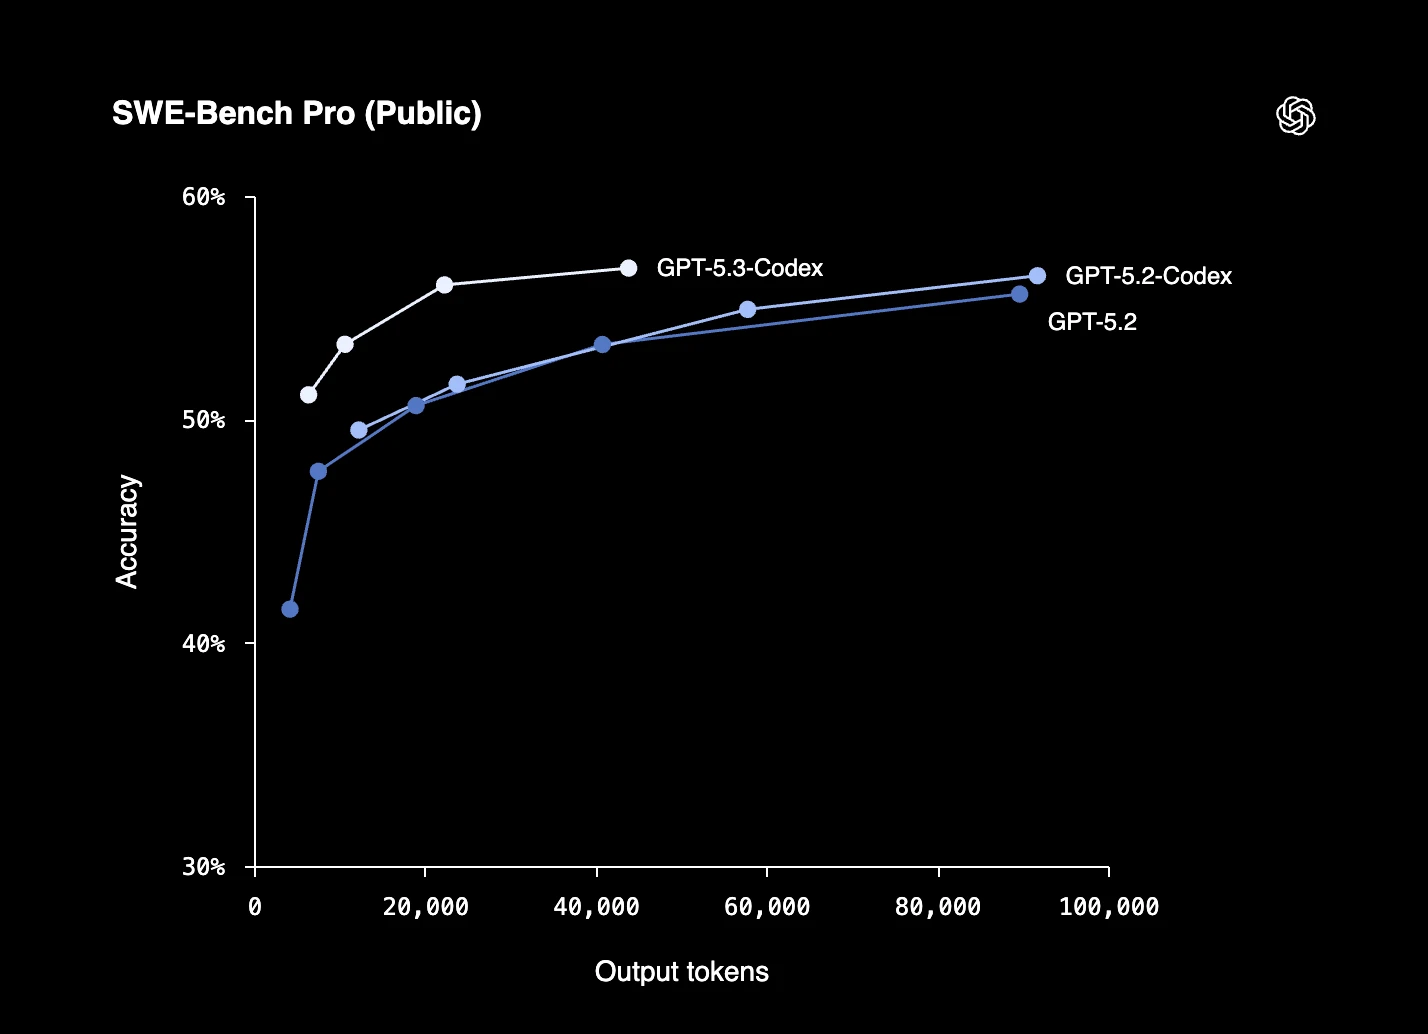
Ejemplo real: GPT-5.3-Codex-Spark
El modelo OpenAI GPT-5.3-Codex-Spark es un modelo centrado en la programación, posicionado como una variante optimizada en velocidad de GPT-5.3-Codex, destinada a flujos de trabajo de desarrollo en tiempo real.
Entre las características clave se incluyen:
- Inferencia de alto rendimiento: Diseñado para asistencia de codificación de baja latencia, con velocidades de salida de más de 1.000 tokens por segundo en entornos compatibles.
- Ventana de contexto amplia: Admite hasta 128.000 tokens de contexto, lo que permite trabajar con bases de código más grandes y sesiones más largas.
- Flujos de trabajo de codificación interactivos: Orientado a tareas de codificación iterativas como edición, depuración y refinamiento de código en tiempo real.
- Énfasis en la infraestructura: Diseñado para ejecutarse en infraestructura de inferencia de baja latencia, incluidos despliegues en hardware de Cerebras.
Figura 4: Rendimiento en el benchmark SWE-Bench Pro de OpenAI con GPT-5.3-Codex-Spark.12
19. IA agéntica
En lugar de depender de un único modelo más grande, los sistemas agénticos utilizan diferentes modelos con roles definidos, como planificación, razonamiento y ejecución.
Entre las ventajas se incluyen:
- Escalar las capacidades de razonamiento sin aumentar sin cesar el número de parámetros.
- Mayor flexibilidad en el uso de herramientas al asignar tareas al modelo más capaz.
- Incorporación más directa de comentarios de usuarios y partes interesadas en diferentes etapas de un proceso.
Un ejemplo es un sistema multiagente en el que un modelo gestiona las tareas de gestión de proyectos, otro interpreta las entradas de lenguaje natural y un tercero gestiona la recuperación e integración de datos. Together, estos modelos ofrecen mejores resultados que un único modelo trabajando solo.
20. Técnicas de eficiencia de modelos
En respuesta al coste y al impacto medioambiental del entrenamiento de modelos más grandes, las técnicas de eficiencia se han convertido recientemente en un foco de atención. Estos métodos permiten a los desarrolladores mejorar el rendimiento utilizando menos recursos:
- Cuantización reduce la huella de memoria al reducir la precisión de los parámetros del modelo sin perder calidad en las predicciones.
- Destilación de conocimiento transfiere las capacidades de un modelo grande a un modelo más pequeño, permitiendo una inferencia más rápida.
- Poda elimina parámetros redundantes para reducir la complejidad manteniendo la precisión.
- Adaptación de bajo rango (LoRA) permite un fine-tuning eficiente de modelos grandes en tareas específicas de dominio con recursos limitados.
Estas técnicas permiten que los sistemas de IA sean más escalables en diversos modelos y contextos empresariales, lo que permite obtener mejores resultados a un menor coste.
Recomendaciones sobre cómo abordar la mejora de modelos de IA/ML
Mejorar un modelo de IA/ML requiere un enfoque estratégico para identificar áreas donde implementar soluciones eficaces. Combinando la monitorización del rendimiento con la toma de decisiones basada en hipótesis, los modelos de IA/ML pueden refinarse y optimizarse para obtener mejores resultados:
Supervisar el rendimiento
Puede mejorar algo conociendo sus áreas de mejora. Esto puede lograrse supervisando las características del modelo de IA/ML. Sin embargo, si no se pueden supervisar todas las características del modelo, se puede observar un número seleccionado de características clave para estudiar las variaciones en su salida que puedan afectar al rendimiento del modelo.
Generación de hipótesis
Antes de seleccionar el método adecuado, recomendamos realizar una generación de hipótesis. Se trata de un proceso predecisional que estructura el proceso de decisión y reduce las opciones.
Este proceso implica adquirir conocimiento del dominio, estudiar el problema al que se enfrenta el modelo de IA/ML y reducir las opciones disponibles que pueden abordar los problemas identificados.
Mejora iterativa y experimentación
La mejora de un modelo de IA/ML es un proceso continuo. Después de formular hipótesis y seleccionar posibles soluciones, la experimentación y la iteración son clave para refinar el modelo.
Pruebas A/B: Pruebe diferentes modelos o cambios en subconjuntos de datos para comparar resultados. Esto ayuda a identificar qué mejoras son más eficaces.
Reentrenamiento del modelo: Reentrene periódicamente el modelo con nuevos datos, actualizaciones de características o ajustes de algoritmos para garantizar que siga siendo pertinente y se adapte a las condiciones cambiantes.
Monitorización automatizada y bucles de retroalimentación: Utilice sistemas automatizados para proporcionar retroalimentación continua de la IA, lo que permite ajustes rápidos e iteraciones rápidas sobre las mejoras.
Incorporar la retroalimentación de las partes interesadas
Una parte a menudo pasada por alto del proceso de mejora del modelo es recopilar las aportaciones de los usuarios finales o de las partes interesadas. La retroalimentación de la IA recopilada de equipos empresariales, expertos del dominio o usuarios finales ofrece un contexto valioso para refinar las predicciones y abordar los puntos ciegos del mundo real.
La integración de este bucle de retroalimentación ayuda a garantizar que el modelo se adapte continuamente y permanezca alineado con las necesidades operativas.
Este bucle de retroalimentación garantiza que el modelo siga alineado con las necesidades y expectativas del mundo real.
Priorizar los cambios más impactantes
No todas las mejoras tendrán el mismo nivel de impacto. Es esencial priorizar los cambios que abordan directamente los problemas de rendimiento más críticos.
Por ejemplo, mejorar la calidad de los datos o abordar un sesgo significativo en el modelo podría tener efectos más sustanciales que ajustes menores en los hiperparámetros del algoritmo.
Documentar y estandarizar el proceso de mejora
Para mejoras continuas, documente los métodos, los experimentos y los resultados.
Estandarizar este proceso permite que las mejoras futuras sigan un enfoque probado y estructurado, garantizando que las mejoras puedan medirse, compararse y rastrearse.
 Añadir como fuente preferida
Preguntas frecuentes
La evolución de la inteligencia artificial ha dado lugar a un progreso notable en el procesamiento del lenguaje natural (NLP). Los sistemas de IA actuales pueden comprender, interpretar y generar el lenguaje humano con una precisión sin precedentes. Este gran avance es evidente en chatbots sofisticados, servicios de traducción de idiomas y asistentes activados por voz.
Para mejorar la precisión de su modelo de IA, considere recopilar más datos de entrenamiento diversos y de alta calidad. Además, realice fine-tuning de los hiperparámetros de su modelo, experimente con diferentes algoritmos y aplique técnicas como la validación cruzada para optimizar el rendimiento.
Prevenga el sobreajuste de la IA mediante técnicas de regularización, implementando capas de dropout en redes neuronales y empleando una parada temprana durante el entrenamiento. Aumentar el tamaño de su dataset y garantizar la diversidad de los datos también puede ayudar a que su modelo generalice mejor a nuevas entradas.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Estrategias para la mejora de la IA y ejemplos}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Recuperado el 15 de junio de 2026}
}Resultados y marcas de tiempo de 4 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene un archivo CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
10 actualizacionesSe reemplazó el "Ejemplo de la vida real: GPT4 con MoE" en la sección 7 por "Ejemplo de la vida real: Kimi K2.5".
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Anteriormente trabajó como reclutadora en empresas de gestión de proyectos y consultoría. Sıla tiene un máster en Psicología Social y una licenciatura en Relaciones Internacionales.





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.