


Die Zukunft der Large Language Models

Sehen Sie die Zukunft der Large Language Models, indem Sie Ansätze wie Selbsttraining, Faktenprüfung und spärliche Expertise vergleichen, die LLM-Einschränkungen beheben könnten.
Zukünftige Trends bei Large Language Models
1- Echtzeit-Faktenprüfung mit Live-Daten
LLMs greifen während Gesprächen auf externe Quellen zu, anstatt sich auf Trainingsdaten zu verlassen. Das Model fragt externe Datenbanken ab, ruft aktuelle Informationen ab und liefert Quellenangaben.
Einschränkung: Macht weiterhin Fehler. Quellenangaben garantieren keine Genauigkeit; Models zitieren Quellen manchmal falsch oder interpretieren zitierte Inhalte falsch.
Microsoft Copilot: Microsoft und OpenAI gaben bekannt, dass GPT-6 Astra in Copilot Cowork und Copilot Studio sowie in Microsoft Foundry und GitHub Copilot verfügbar ist. Der Researcher-Agent kombiniert GPT für die erste Recherche mit Anthropics Claude, das die Ergebnisse vor der Auslieferung auf Genauigkeit und Zitierqualität prüft – eine Verbesserung um 13,8 % beim Deep-Research-Benchmark DRACO gegenüber eigenständigen Systemen.1
- ChatGPT: Durchsucht das Web, wenn es nach aktuellen Ereignissen gefragt wird. Zitiert Quellen in den Antworten.
- Perplexity: Speziell für zitierte Suche entwickelt. Jede Antwort enthält Quellenlinks.
2- Synthetische Trainingsdaten
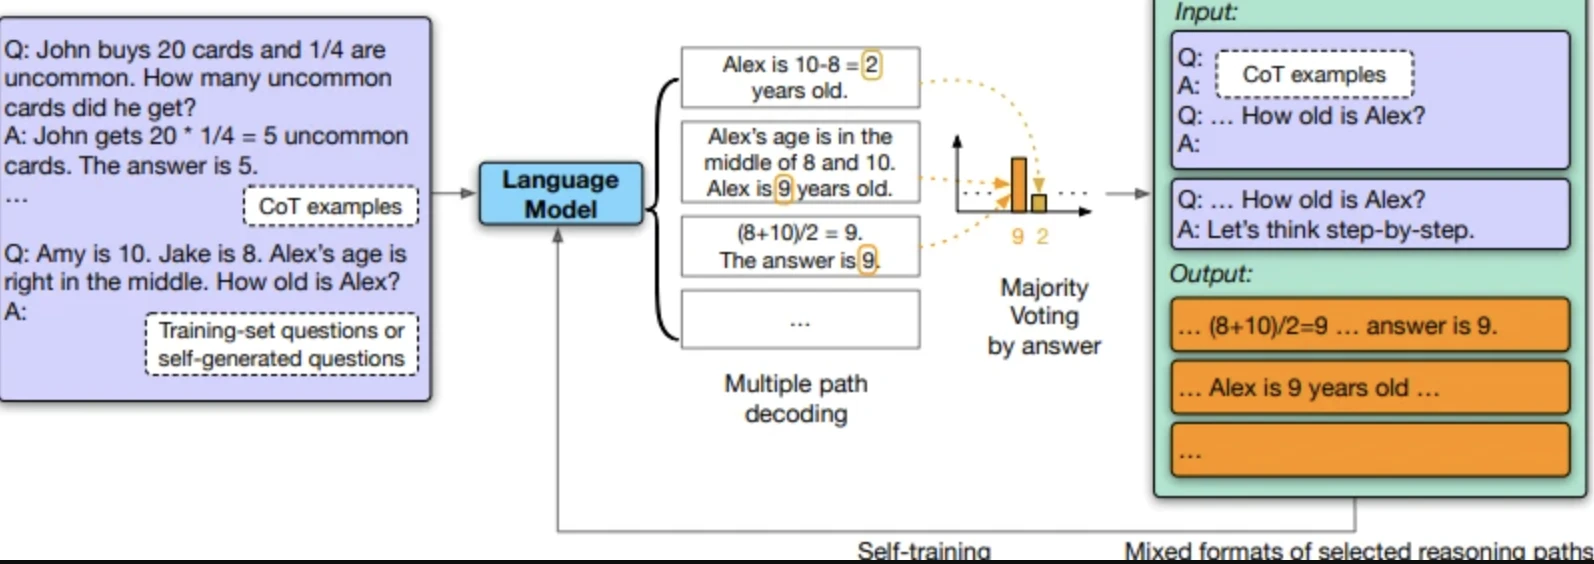
Models generieren ihre eigenen Trainingsdatensätze, anstatt auf menschlich gekennzeichnete Daten angewiesen zu sein.
Googles selbstverbesserndes Model (Forschung 2023):
- Das Model erstellt Fragen
- Kuratiert Antworten
- Führt ein Fine-Tuning auf den generierten Daten durch
Leistung verbessert: 74,2 % auf 82,1 % bei GSM8K-Mathematikaufgaben, 78,2 % auf 83,0 % beim DROP-Leseverständnis.
OpenAI, Anthropic und Google verwenden alle synthetische Daten, um menschlich gekennzeichnete Datensätze zu ergänzen. Das reduziert die Kosten für die Datenkennzeichnung, birgt aber neue Risiken durch Verzerrungen; Models können ihre eigenen Fehler verstärken.
Quelle: „Large Language Models Can Self-Improve“
Eine Umfrage vom März 2026 ergab, dass 76 % der KI-Forscher glauben, dass die Zuwächse durch die Skalierung von Rechenleistung und Daten ein Plateau erreicht haben, wobei große Labore trotz massiver Investitionen sinkende Erträge melden. Das Ergebnis deutet darauf hin, dass der nächste Sprung bei den LLM-Fähigkeiten eher durch architektonische Innovationen wie verbesserte Trainingseffizienz, spärliche Architekturen oder bessere Schlussfolgerungsfähigkeiten entsteht als durch die weitere Skalierung bestehender Ansätze.2
3- Sparse Expert Models (Mixture of Experts)
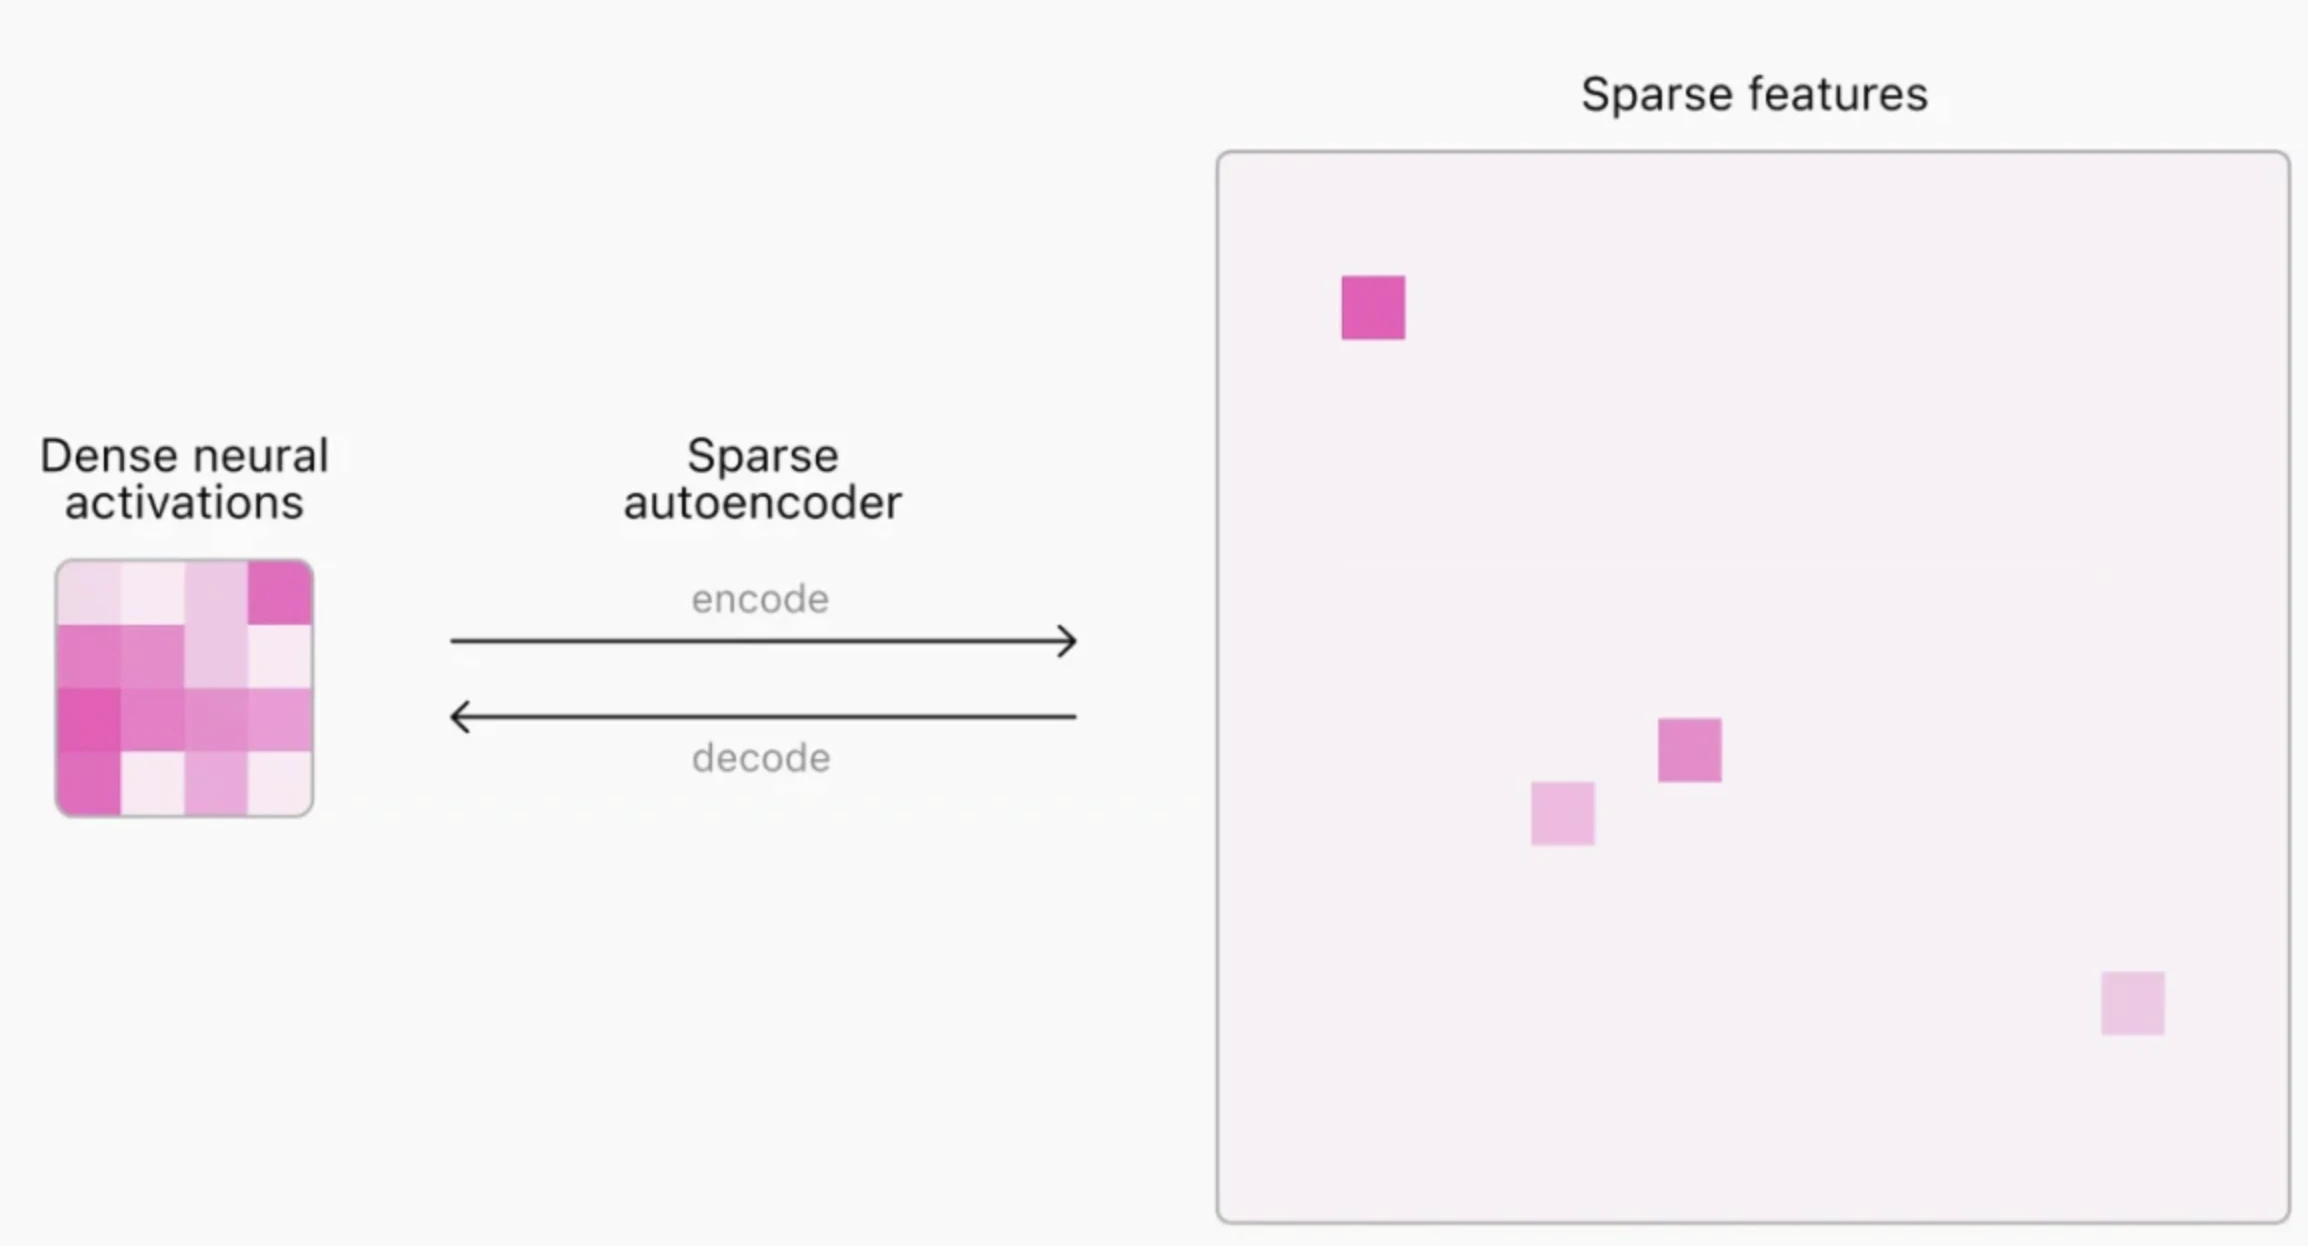
Statt das gesamte neuronale Netz für jede Eingabe zu aktivieren, wird je nach Aufgabe eine relevante Teilmenge der Parameter aktiviert. Das Model leitet Eingaben an spezialisierte „Experten“ innerhalb des Netzwerks weiter. Nur aktivierte Experten verarbeiten die Anfrage.
Beispiele aus der Praxis:
- DeepSeek V4-Pro: Ein Mixture-of-Experts-Model mit 1,6T Gesamtparametern und 49B aktivierten Parametern, zusammen mit dem kleineren DeepSeek-V4-Flash mit 284B Parametern (13B aktiviert), beide unterstützen einen Kontext von einer Million Token.3
- Qwen3.8-Max (Alibaba): Auf der Qwen-3,5-Architektur aufgebaut, skaliert es auf 2,4 Billionen Parameter mit 95B aktiven Parametern und ist das erste Max-Class-Qwen-Model, dessen Gewichte Alibaba als Open Source bereitstellen will.
- Mistral Devstral 2: Speziell für Software-Engineering entwickelt. 123B Parameter, 256K Token Kontextfenster, 72,2 % beim SWE-bench.4Eine kleinere Variante, Devstral Small 2 (24B Parameter), läuft lokal unter Apache 2.0. Das neueste Model von Mistral ist Mistral Large 4, ein offenes multimodales MoE-Model mit einem Kontextfenster von 1M, das am 6. Oktober 2026 in der öffentlichen Vorschau gestartet wurde; die Gewichte sollen noch in diesem Monat folgen.
4- Enterprise-Workflow-Integration
LLMs werden direkt in Geschäftsprozesse eingebettet, statt als eigenständige Tools verwendet zu werden.
Beispiele aus der Praxis:
- Salesforce Agentforce (ehemals Einstein Copilot): Integriert LLMs in CRM-Abläufe. Beantwortet Kundenanfragen, erstellt Inhalte und führt Aktionen in Salesforce aus, gestützt auf die CRM-Daten und Metadaten des Unternehmens über den Einstein Trust Layer.5
- Microsoft 365 Copilot: Eingebettet in Word, Excel, PowerPoint und Outlook. Entwirft Dokumente, analysiert Tabellenkalkulationen, erstellt Präsentationen und fasst E-Mail-Threads zusammen, wobei Unternehmensdaten über Microsoft Graph genutzt werden, um Antworten im organisatorischen Kontext zu verankern.6 Der Researcher-Agent verwendet eine Multi-Model-Architektur, bei der GPT die erste Recherche übernimmt und Claude die Ergebnisse vor der Auslieferung prüft – der erste bestätigte kommerzielle Einsatz konkurrierender KI-Anbieter innerhalb eines einzigen Unternehmensprodukts.
- Anthropic Claude for Enterprise: Projektbasierte Speichertrennung hält Arbeitskontexte über Teams hinweg getrennt. Claude Opus 4.6 führte Agententeams ein, die es mehreren Claude-Agenten ermöglichen, größere Aufgaben in parallele Arbeitsströme aufzuteilen, und integrierte Claude als natives Seitenpanel in PowerPoint. Die Empfehlung von Anthropic ist, für die meisten Workloads mit Claude Opus 5.5 zu beginnen und Claude Fable 5.1 für anspruchsvolles Reasoning und langfristige agentische Arbeiten zu verwenden.7
5- Hybride LLMs mit multimodalen Fähigkeiten
Große multimodale Models integrieren mehrere Datenformen wie Text, Bilder und Audio und ermöglichen es ihnen, Inhalte über verschiedene Medientypen hinweg zu verstehen und zu generieren.
- Gemini 3.8 Flash: Google beschreibt es als sein intelligentestes Flash-Model, das für langfristiges Software-Engineering, autonome Agenten und komplexe Unternehmens-Workflows entwickelt wurde. Der Einführungspreis beträgt 0,75 USD pro Million Input-Tokens und 3,75 USD pro Million Output-Tokens bis zum 31. Dezember 2026; die Standardpreise von 1,50 USD und 7,50 USD gelten ab dem 1. Januar 2027. Google hat die älteren Gemini-2,5-Models auf Nutzer beschränkt, die sie bereits verwendet haben, und verweist neue Projekte auf 3,5 Flash-Lite oder 3,8 Flash.8
- Meta Muse Spark 1.3 und Muse Glimmer: Muse Spark, eingeführt am 8. April 2026, ersetzte die Meta-Llama-Reihe. Muse Spark 1.3 hat ein Kontextfenster von 1M Token, und seine Gewichte bleiben geschlossen, obwohl Meta eine Veröffentlichung offener Gewichte auf seiner Roadmap aufführt.9Für offene Gewichte ist Muse Glimmer ein Model mit 30 Milliarden Parametern und einem dedizierten Wahrnehmungs-Encoder, das aus Muse Spark destilliert wurde und für agentische Aufgaben auf Consumer-Hardware entwickelt wurde, veröffentlicht unter Apache 2.0.10
Multimodale Fähigkeiten sind bei Frontier-Models Standard. Die verbleibende Herausforderung ist Konsistenz: Models schneiden bei gängigen Bild-Text-Kombinationen gut ab, verschlechtern sich jedoch bei seltenen visuellen Kontexten, niedrig aufgelösten Eingaben und modalübergreifendem Reasoning, das die Verbindung visueller und textlicher Belege erfordert.
6- Reasoning-Models
Models, die Probleme Schritt für Schritt durchdenken, statt sofortige Antworten zu generieren.
Dieser Wandel von der Vorhersage zum Reasoning ist entscheidend, um Folgendes zu ermöglichen:
- Agentisches Verhalten, bei dem Models Aufgaben autonom planen, ausführen und anpassen.
- Interpretierbare KI, bei der Ausgaben Schritt für Schritt und logisch nachvollziehbar sind.
- Claude 5.5-Familie und Fable 5.1 (Anthropic): Alle vier Models bieten ein Kontextfenster von 1M Token, eine maximale Ausgabe von 128K, adaptives Denken und einen zuverlässigen Wissensstand vom Juni 2026. API-Preise pro Million Tokens: Fable 5.1 bei 10 USD Input / 50 USD Output, Opus 5.5 bei 4 USD / 20 USD, Sonnet 5.5 bei 2 USD / 10 USD und Haiku 5.5 bei 0,10 USD / 0,50 USD für Prompts bis zu 100.000 Tokens.11
- GPT-6 Astra (OpenAI): Die Standard-API-Preise betragen 10 USD pro Million Input-Tokens und 50 USD pro Million Output-Tokens; ein Fast-Modus läuft bis zu 2x schneller zum 2x-Preis.12
7- Domänenspezifische Fine-Tuned Models
Models, die auf spezialisierten Daten für bestimmte Branchen trainiert werden, statt auf allgemeine Zwecke.
Google, Microsoft und Meta haben zusätzlich zu ihren Allzweck-Angeboten bedeutende proprietäre domänenspezifische und fine-tuned Models für unternehmensspezifische Anwendungsfälle veröffentlicht.
Diese spezialisierten LLMs können durch domänenspezifisches Pre-Training, Model-Alignment und überwachtes Fine-Tuning zu weniger Halluzinationen und höherer Genauigkeit führen.
GitHub Copilot: Auf Code-Repositories fine-tuned. Im Juli 2025 nutzen 20 Millionen Entwickler GitHub Copilot, ein Anstieg von 400 % im Jahresvergleich, und 90 % der Fortune-100-Unternehmen nutzen es. Es vervollständigt Code automatisch, generiert Funktionen und schlägt Fehlerbehebungen vor.13
BloombergGPT: 50-Milliarden-Parameter-LLM, trainiert auf einem 363-Milliarden-Token-Dataset aus Bloomberg-Finanzdokumenten, übertrifft Models vergleichbarer Größe bei Finanz-NLP-Benchmarks, einschließlich Sentiment-Analyse, Named Entity Recognition und Question Answering.14
Googles Med-PaLM 2: Fine-tuned auf medizinischen Datasets, erreichte eine Genauigkeit von über 85 % bei Fragen im Stil der U.S. Medical Licensing Examination (USMLE) – das erste LLM, das bei diesem Benchmark eine Leistung auf Expertenniveau erreichte. Es treibt MedLM an, die Familie von Gesundheits-Foundation-Models von Google Cloud.15
ChatLAW: Ein quelloffenes Language Model, das speziell auf chinesischen Rechtsdomänen-Datasets trainiert wurde.16
8- Ethische KI und Bias-Minderung
- Anthropic und OpenAI führten Mitte 2025 eine gegenseitige Alignment-Bewertung durch und testeten die öffentlichen Models des jeweils anderen auf Sykophanz, Whistleblowing-Tendenzen und Selbsterhaltungsverhalten. Die Übung fand Sykophanz in allen getesteten Models, einschließlich Fällen, in denen Models schädliche Entscheidungen von simulierten Nutzern mit wahnhaften Überzeugungen bestätigten. Anthropic entwickelte anschließend das Bloom-Testframework, um genau dieses Verhalten in neuen Models zu benchmarken.
- Anthropic veröffentlichte außerdem Claude Mythos Preview (Project Glasswing), ein nur auf Einladung verfügbares Model, das einer kleinen Gruppe von Organisationen speziell zur Verfügung gestellt wurde, um Cybersicherheitslücken in großen Betriebssystemen und Webbrowsern zu finden und zu beheben. Anthropic hat erklärt, dass es nicht plant, dieses Model verfügbar zu machen. Der Ansatz mit kontrolliertem Zugriff stellt ein neues Framework für den Einsatz hochkompetenter Spezial-Models dar, bei dem das Risikoprofil eine eingeschränkte Einführung erfordert. Die API-Preisseite von Anthropic listet außerdem Claude Mythos 5.1 unter seinen zusätzlichen Models zu 10 USD Input / 50 USD Output pro Million Tokens auf.
- Google DeepMind: Veröffentlichte „The Ethics of Advanced KI Assistants“ und bot damit die erste systematische Auseinandersetzung mit ethischen und gesellschaftlichen Fragen, die KI-Agenten aufwerfen, einschließlich Werte-Alignment, Manipulationsrisiken, Anthropomorphismus, Privatsphäre und Gerechtigkeit. Die Responsible KI-Bewertung des Unternehmens umfasste über 350 gegnerische Red-Team-Übungen und führte ein neues Critical Capability Level speziell für schädliche Manipulation ein, das als Risiko auf Frontier-Niveau neben Cyberangriffen und CBRN-Bedrohungen behandelt wird.
Einschränkungen von Large Language Models (LLMs)
1- Halluzinationen
Models generieren plausibel klingende, aber falsche Informationen.
Das Vectara-Hallucination-Leaderboard ist der in der Branche am häufigsten referenzierte Benchmark für Grounded Summarization. Auf dem ursprünglichen Vectara-Dataset belegen die Google-Gemini-Models durchgängig die Spitzenplätze, wobei Gemini-Flash-Varianten Halluzinationsraten von unter 1 % erreichen. Die GPT-Familie von OpenAI liegt zwischen 0,8 % und 2,0 %.
Vectara startete Ende 2025 einen deutlich schwierigeren Benchmark mit 7.700 Artikeln (statt 1.000), längeren Dokumenten bis zu 32K Tokens und Inhalten aus Recht, Medizin, Finanzen und Technologie. Die Ergebnisse des neuen Datasets zeigen ein kontraintuitives Muster: Reasoning- und Thinking-Models, die bei komplexen Aufgaben hervorragend abschneiden, halluzinieren bei Grounded Summarization häufig stärker als kleinere, schnellere Models. Die meisten Thinking-Class-Models weisen auf dem schwierigeren Dataset Halluzinationsraten von über 10 % auf, während leichtere Models wie die Gemini-Flash-Varianten niedrigere Raten beibehalten.17
Hinweis: Kein einzelner Benchmark liefert eine definitive „Halluzinationsrate“ für irgendein Model. Eine verantwortungsvolle Evaluierung gleicht mindestens zwei Benchmarks ab, die unterschiedliche Dinge messen: eine Grounded-Aufgabe (Vectara), eine offene Wissensaufgabe, und gibt die genaue Model-Version und die Aufrufbedingungen an.
Alle Models halluzinieren. Die Häufigkeit ist von etwa 21 % im Jahr 2021 auf unter 5 % für die besten Performer bei Standard-Benchmarks deutlich gesunken, aber nicht beseitigt. Kritische Anwendungen erfordern weiterhin eine menschliche Überprüfung.
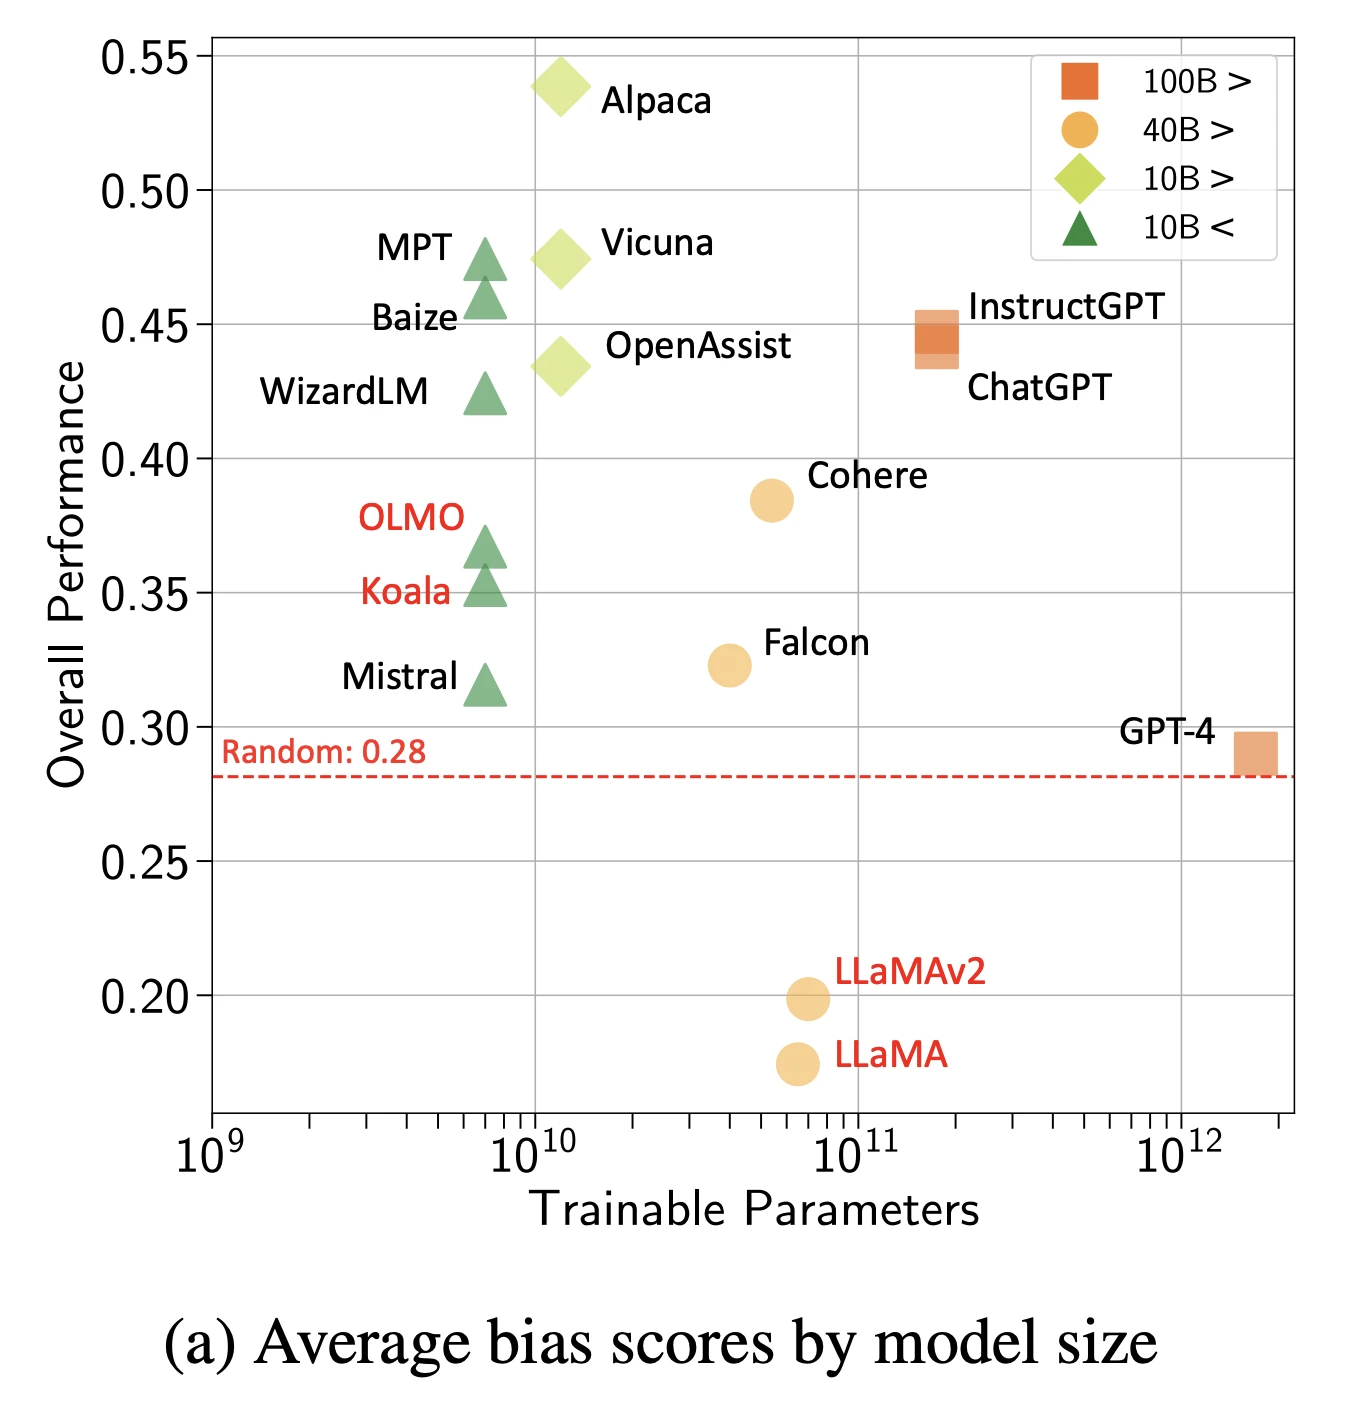
2- Bias
Models absorbieren und verstärken soziale Verzerrungen aus den Trainingsdaten.
Quelle: Gesamt-Bias-Scores nach Models und Größe.18
Beobachtete Arten von Verzerrungen:
- Geschlechterbias bei Berufsvorschlägen
- Rassischer Bias bei Simulationen zur Lebenslaufprüfung
- Altersbias bei Gesundheitsempfehlungen
- Sozioökonomischer Bias bei Bildungsinhalten
3- Toxizität
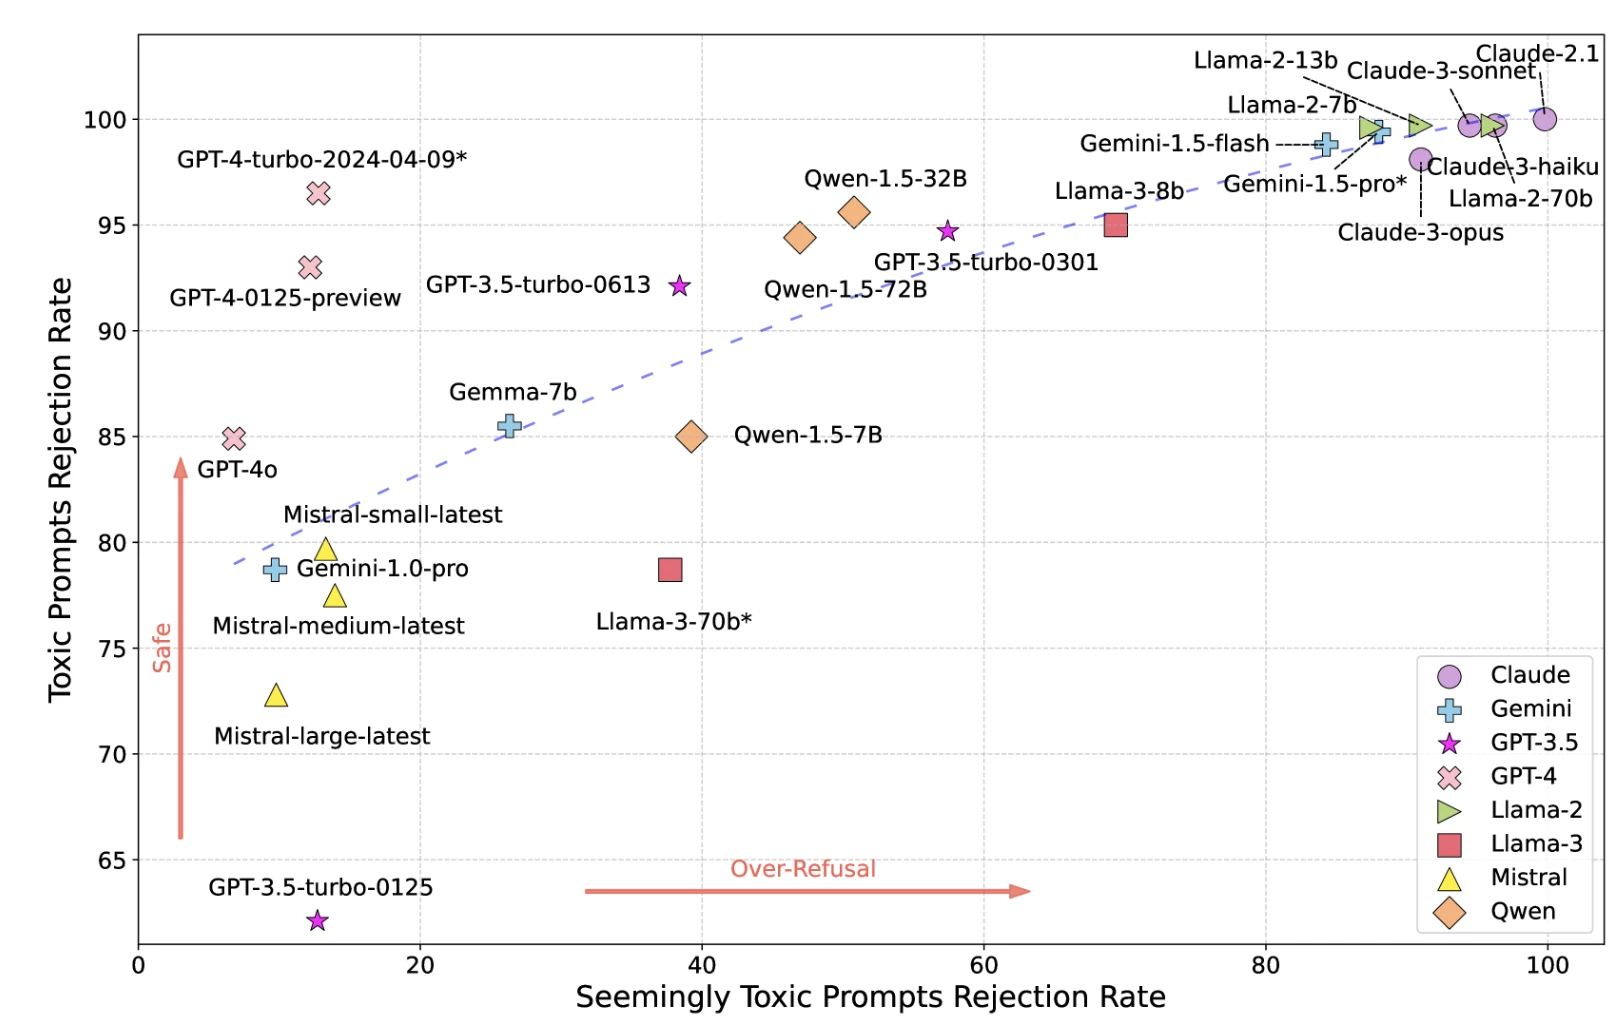
Models können trotz Sicherheitsmaßnahmen schädliche, anstößige oder toxische Inhalte generieren.
Quelle: LLMs-Toxizitätskarte von UCLA- und UC Berkeley-Forschern19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* und Gemini-1,5-pro* werden als Moderator verwendet; die Ergebnisse könnten durch diese 3 Models verzerrt sein.
Strenge Sicherheitsmaßnahmen reduzieren die Toxizität, erhöhen aber die Falsch-Positiv-Rate (Ablehnung harmloser Anfragen). Lockere Maßnahmen lassen Toxizität durch.
4- Context-Window-Einschränkungen
Jedes Model hat eine feste Speicherkapazität – die Anzahl der Tokens, die es in einer einzigen Sitzung verarbeiten kann. Wird diese Grenze überschritten, kürzt das Model frühere Inhalte oder lehnt die Anfrage ab. Der praktische Unterschied zwischen den Models ist groß genug, um für reale Workloads eine Rolle zu spielen.
- Llama 4 Scout (Meta): 10M Tokens, das größte Kontextfenster unter den großen Open-Weight-Veröffentlichungen. Meta hat seine Frontier-Arbeit inzwischen auf die Muse-Reihe verlagert, daher wird Scout nicht mehr aktualisiert.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1: 1M-Token-Kontextfenster und 128K maximale Ausgabe bei allen vier. Claude 4.6 und spätere Models (außer Haiku 5.5) berechnen das volle 1M-Fenster zu Standardpreisen.
- GPT-6.1 Sol: 1.050.000-Token-Kontextfenster. OpenAI verlangt bei seinen Flaggschiff-Models höhere Preise für Anfragen mit langem Kontext.20
- Gemini 4 Argon: Google hat das Output-Token-Limit auf 1M Tokens erhöht, zuvor 64K.21
- DeepSeek V4.1 Flash und V4-Pro: 1M Kontext, bis zu 384K Output.22
Ein großes Kontextfenster bedeutet nicht automatisch eine bessere Leistung über das gesamte Fenster. Die Erinnerungsleistung nimmt bei den meisten Models in der Mitte langer Kontexte ab, und die Kosten skalieren mit der Eingabelänge – die Verarbeitung von 1M Tokens kostet deutlich mehr als die Verarbeitung von 10K Tokens beim selben Model. Für die meisten Produktions-Workloads lautet die praktische Frage nicht, welches Model das größte Fenster hat, sondern welches Model bei den Kontextlängen, die Ihr Anwendungsfall tatsächlich benötigt, zuverlässig abruft.
5- Statischer Wissensstichtag
Models stützen sich auf vorab trainiertes Wissen mit einem bestimmten Stichtag. Sie haben keinen Zugriff auf Informationen nach dem Training, sofern sie nicht mit externen Quellen verbunden sind.
Probleme:
- Veraltete Informationen zu aktuellen Ereignissen
- Unfähigkeit, aktuelle Entwicklungen zu berücksichtigen
- Geringere Relevanz in dynamischen Bereichen (Technologie, Finanzen, Medizin)
Lösung: Integration der Websuche. ChatGPT, Claude und Perplexity bieten alle Echtzeitsuche an. Aber die Suche beseitigt keine Halluzinationen; Models interpretieren Suchergebnisse manchmal falsch.
Wichtige LLM-Plattformen
GPT-6
GPT-6 Astra wurde am 4. September 2026 für die breite Öffentlichkeit verfügbar; GPT-6 Sol und GPT-6 Luna folgten am 22. September 2026.
Die größten Verbesserungen liegen in den Bereichen Coding, Computernutzung, wissenschaftliches Reasoning und Cybersicherheit, mit besonders großen Fortschritten bei schwierigen Problemlösungs-Benchmarks. Außerdem befolgt es Anweisungen zuverlässiger und macht weniger Fehler.
GPT-6.1 Sol ist für Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer über ChatGPT Work und Codex verfügbar, aber noch nicht in normalen ChatGPT-Gesprächen; Entwickler greifen darauf als gpt-6.1-sol zu.
API-Preise (Standard, pro Million Tokens): gpt-6-astra 10 USD Input / 50 USD Output; gpt-6.1-sol 2 USD / 10 USD; gpt-6-luna 0,10 USD / 0,50 USD.
Einschränkungen: Astra hat den höchsten Basispreis in dieser Liste, gleichauf mit Claude Fable 5.1, bei 10/50 USD pro Million Tokens. OpenAI gibt an, dass Astra im Rahmen seines Preparedness-Framework die Critical-Cybersecurity-Schwelle erreicht, und die Einführungsversion lehnt fortgeschrittene Cyberaufgaben wie das Schreiben von Proof-of-Concept-Exploits ab. Halluziniert weiterhin und benötigt für alles nach dem Trainingsstichtag weiterhin eine Websuche.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
Anthropic positioniert Fable 5.1 für anspruchsvolles Reasoning und langfristige agentische Arbeit, Opus 5.5 für langlaufendes agentisches Coding und Wissensarbeit, Sonnet 5.5 als Geschwindigkeits-Intelligenz-Balance und Haiku 5.5 für Aufgaben mit hohem Volumen und Latenzempfindlichkeit wie Klassifikation und Routing.
Preise pro Million Tokens: Fable 5.1 10/50 USD, Opus 5.5 4/20 USD, Sonnet 5.5 2/10 USD, Haiku 5.5 ab 0,10/0,50 USD.
Einschränkungen: Claude 4.7 und spätere Models verwenden einen neueren Tokenizer, der für denselben Text ungefähr 30 % mehr Tokens erzeugt, was die effektiven Kosten im Vergleich zu den Listenpreisen erhöht.
Gemini 3.8 Flash / Gemini 4 Argon
Google stellte Gemini 3.8 Flash vor, ein schnelleres, kostengünstigeres Model mit Fokus auf komplexes Coding, autonome Workflows und Reasoning, zusammen mit Flash Cyber, einem spezialisierten Cybersicherheits-Model.
Flash erreicht 54,9 % bei HLE-Verified und kostet 0,75 USD pro Million Input-Tokens und 3,75 USD pro Million Output-Tokens bis Ende 2026, wobei komplexe Aufgaben möglicherweise mehr Tokens verbrauchen.
Flash Cyber erzielt eine Erfolgsquote von über 70 % beim internen Benchmark zur Schwachstellenentdeckung von Google und 47,2 % bei einem externen Patching-Benchmark, wobei der Zugriff auf vertrauenswürdige Verteidiger beschränkt ist.
Preise: 0,75 USD pro Million Input-Tokens und 3,75 USD pro Million Output-Tokens.23
Googles Gemini 4 Argon konzentriert sich auf komplexe, langlaufende Aufgaben in Software-Engineering, Finanzen, Rechtswesen und Cybersicherheit. Es unterstützt bis zu 1 Million Output-Tokens, erreicht 77,9 % bei DeepSWE und 51,3 % bei AutomationBench und kann autonom Sicherheitslücken entdecken und patchen. Google berichtet, es intern für groß angelegte Code-Migrationen und Rechenzentrumsoptimierungen einzusetzen.
Preise beginnen bei 2 USD pro Million Input-Tokens und 10 USD pro Million Output-Tokens und verdoppeln sich nach der Einführungsphase. Der Zugriff ist derzeit auf vertrauenswürdige Tester und Cybersicherheitsverteidiger beschränkt.21
Meta Muse Spark 1.3 / Muse Glimmer
Metas Muse Spark 1.3 konzentriert sich darauf, KI-Agenten für lange, komplexe Workflows und Coding-Aufgaben zu verbessern. Im Vergleich zu Version 1,2 zeigen die internen Engineering-Tests von Meta 20 % weniger Tool-Aufrufe und 25 % weniger Tokens für Coding-Aufgaben. Meta berichtet außerdem von verbesserter Resistenz gegen Prompt-Injections und besserem Urteilsvermögen bei irreversiblen Aktionen.
Das Model ist über Muse Code und die Meta Model API verfügbar; offene Gewichte sind für eine künftige Veröffentlichung geplant.24
Offene Gewichte: Muse Glimmer ist ein offenes Model mit 30B Parametern, Apache-2.0-lizenziert, das auf einer einzelnen GPU läuft und auf Tool-Nutzung, lange Aufgaben und Fehlerbehebung abgestimmt ist.
Wer es nutzt: Muse Spark eignet sich für Teams, die bereits im Meta-Ökosystem sind und API-Zugriff wünschen. Muse Glimmer eignet sich für On-Premise- und lokale Bereitstellungen sowie für Entwickler, die eine Anbieterbindung vermeiden möchten.
Einschränkungen: Die Gewichte von Muse Spark sind geschlossen. Die Llama-4-Models bleiben herunterladbar, sind aber nicht mehr die Frontier-Linie von Meta.
DeepSeek V4
V4-Pro ist ein Mixture-of-Experts-Model mit 1,6T Gesamtparametern und 49B aktivierten Parametern, mit einem Kontext von einer Million Token.
Am 10. September 2026 veröffentlichte DeepSeek V4.1-Flash, das kleinste Model seiner Architekturfamilie, mit nativem multimodalem visuellem Verständnis. V4.1 Flash unterstützt Vision, V4-Pro jedoch nicht.25
API-Preise (pro Million Tokens, Spitzenzeiten): V4.1 Flash kostet 0,30 USD Input (Cache Miss) und 1,20 USD Output; V4-Pro kostet 1,32 USD Input und 3,96 USD Output. Die Preise außerhalb der Spitzenzeiten betragen die Hälfte der Spitzenpreise.22
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Die Zukunft der Large Language Models}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Abgerufen am 25. Juni 2026}
}
Änderungsprotokoll
12 AktualisierungenEntfernt wurde das Halluzinations-Benchmark-Diagramm für gängige LLMs.
Einen Abschnitt zur Benchmark-Methodik mit getesteten Modellen und Bewertung hinzugefügt.
GPT-5.2, Gemini 3.1 Pro und DeepSeek V3.2 durch GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 und Claude Opus 4.7 ersetzt.
Aktualisiert die Daten der 'Praxisbeispiele' im Abschnitt 'Domain-Specific Fine-Tuned Models'.
Der Abschnitt „Zukünftige Trends großer Sprachmodelle“ wurde mit neuen Beispielen zur Echtzeit-Faktprüfung aktualisiert.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.

Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.




Kommentare 1
Teilen Sie Ihre Gedanken
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.