


Vergleichen Sie 9 große Sprachmodelle im Gesundheitswesen

Wir haben 9 LLMs mithilfe des MedQA-Datasets verglichen, einem Benchmark für klinische Prüfungen auf Graduierten-Niveau, der aus USMLE-Fragen abgeleitet ist. Jedes Model beantwortete dieselben klinischen Multiple-Choice-Szenarien mit einem standardisierten Prompt und ermöglichte so einen direkten Vergleich der Genauigkeit.
Wir haben außerdem die Latenz pro Frage erfasst, indem wir die Gesamtlaufzeit durch die Anzahl der abgeschlossenen MedQA-Aufgaben geteilt haben.
Benchmark-Ergebnisse für LLMs im Gesundheitswesen
Benchmark-Methodik: Dieser Benchmark bewertet die Leistung beim überwachten Fine-Tuning von LLMs im Gesundheitswesen im Vergleich zu großen Allzweckmodels (GPT-4) bei medizinischen Frage-Antwort-Aufgaben. Siehe Benchmark-Datenquellen.
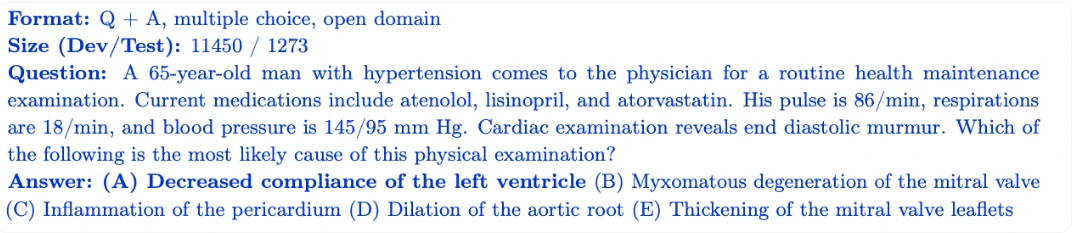
MedQA: Multiple-Choice-Fragen für medizinische Prüfungen, die auf dem United States Medical Licensing Examination basieren.
Abbildung 1: Beispiel für eine klinische Multiple-Choice-Frage im USMLE-Stil.
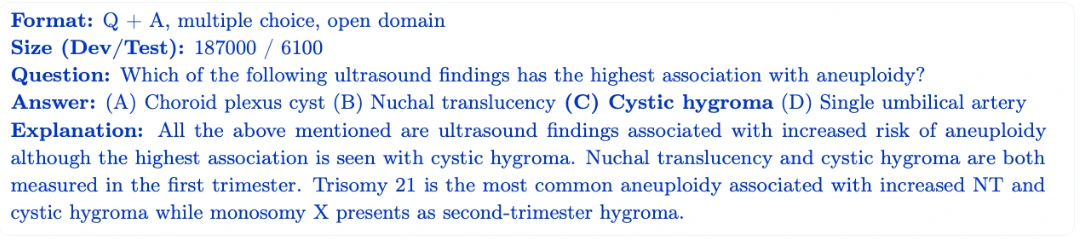
MedMCQA: Umfangreicher Dataset zur Multiple-Choice-Fragebeantwortung (MCQA), der darauf ausgelegt ist, reale Fragen aus medizinischen Aufnahmeprüfungen zu bearbeiten.
Abbildung 2: Eine umfangreiche Multiple-Choice-Frage aus einer medizinischen Aufnahmeprüfung, bei der das Model die richtige Antwort auswählen und zugehörige Erklärungen zu klinischen Befunden interpretieren muss.
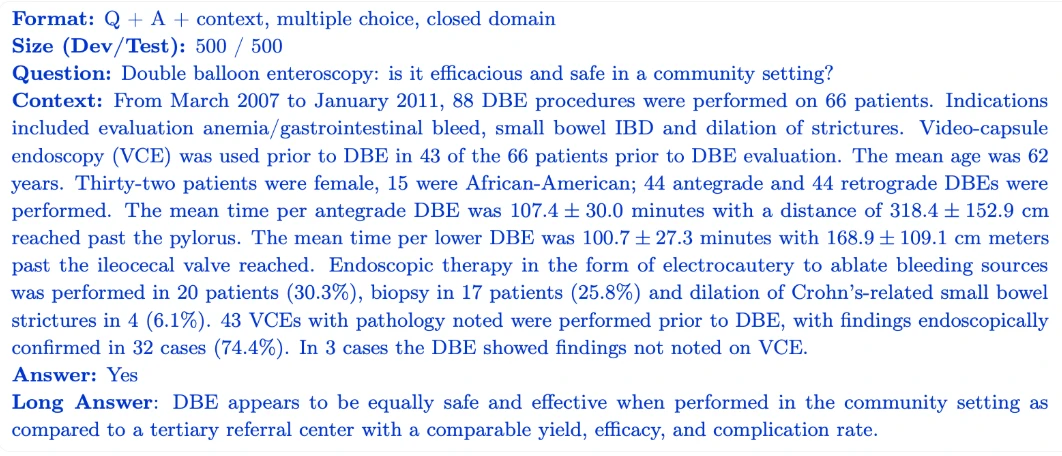
PubMedQA: Biomedizinisches Frage-Antwort-Benchmark mit Ja/Nein/Vielleicht-Antworten.
Abbildung 3: Eine biomedizinische Ja/Nein/Vielleicht-Frage, bei der das Model die Richtigkeit einer klinischen Behauptung anhand des bereitgestellten Studienkontexts beurteilen muss.
Beispiele für LLMs im Gesundheitswesen
BERT-ähnlich (nur Encoder)
Diese Models sind für die Codierung und Darstellung biomedizinischer Texte optimiert und zeichnen sich durch die Extraktion von Merkmalen für Aufgaben wie die Klassifizierung aus.
ChatGPT / LLaMA-artig (Decoder, instruktions-/chat-abgestimmt)
Basierend auf LLaMA-artigen Architekturen und optimiert für interaktive Aufgaben und klinische Dialoge.
GPT / PaLM-artig (nur Decoder, generativ)
Ähnlich wie GPT-3 oder PaLM aufgebaut, sind diese Models für die allgemeine Textgenerierung und Zusammenfassung fine-getuned.
Allzweck-LLMs im Gesundheitswesen
*Llama 3.1 Instruct Turbo mit 405B Parametern. Siehe Benchmark-Methodik.
Wichtigste Erkenntnisse:
- o1: Bestes Model
- 03 mini: Beste Budgetoption
- GPT 4.1: Beste Geschwindigkeit und Antwortzeit
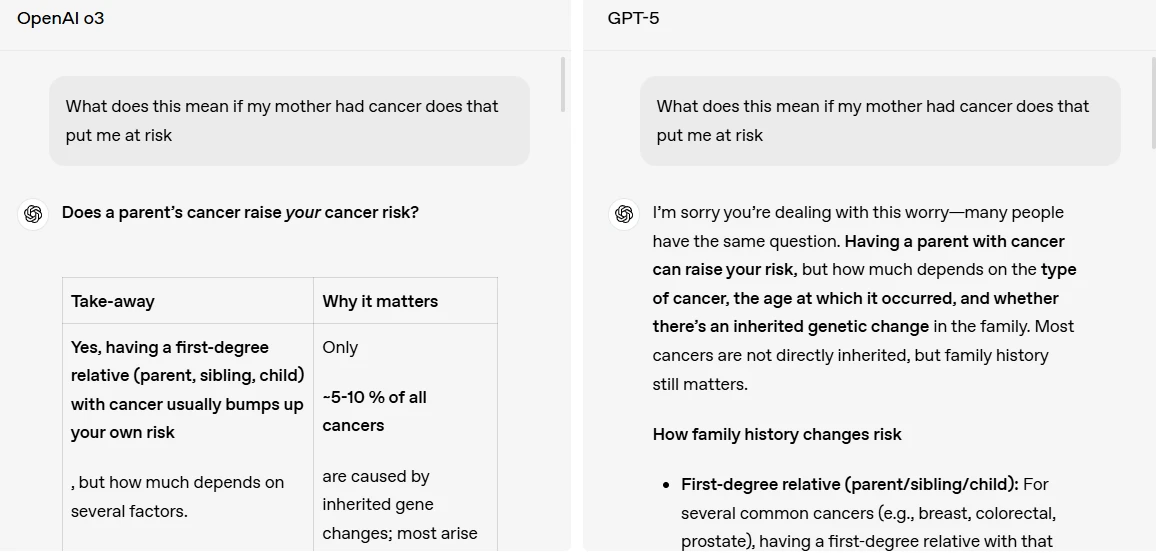
- Über Genauigkeit und Eingabekosten hinaus unterscheiden sich Models auch in ihren zugrunde liegenden Ansätzen zur medizinischen Fragebeantwortung.
Abbildung 4: Abbildung, die Unterschiede zwischen den Antworten von GPT-5 und o3 zeigt.
Fine-Tuning medizinischer LLMs
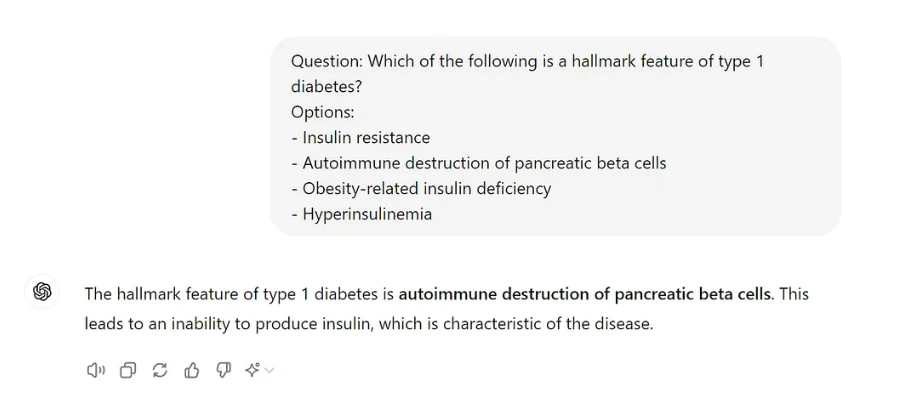
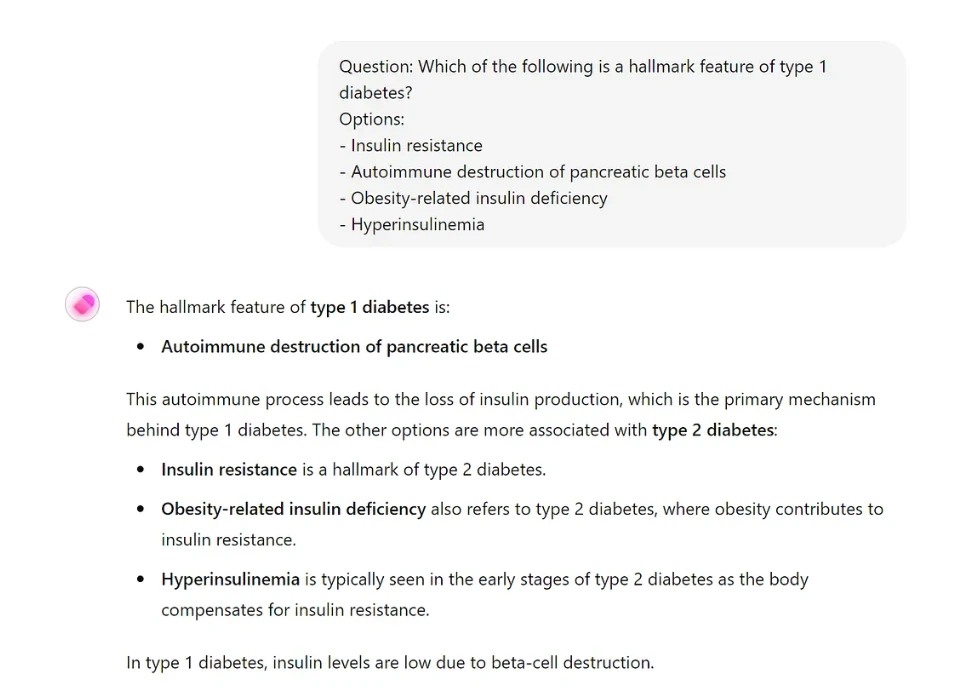
Die Leistung des Standard-ChatGPT-Models (4o-Model) wird mit dem bestehenden Assistenten „Clinical Medicine Handbook“ verglichen. Beide Models erhalten denselben Prompt, und ihre Antworten werden analysiert:
GPT 4o
Abbildung 5: Die Abbildung zeigt, dass die Antwort des Default-Models GPT 4o genau, aber auch stark zusammengefasst ist.1
Feinabgestimmtes medizinisches LLM
Abbildung 6: Die Abbildung zeigt die Antwort des spezialisierten Agents.1
Anwendungen von Allzweck-LLMs
Sie können diese Models im Gesundheitswesen nutzen, indem Sie Folgendes einsetzen:
- Kontinuierliches Pretraining mit medizinischen Daten, um dem Model zu helfen, medizinische Sprache besser zu erkennen, indem es klinischen Notizen und biomedizinischer Literatur (wie PubMed) ausgesetzt wird.
- RAG , um Daten aus verifizierten klinischen Dokumenten abzurufen und zur Laufzeit präzise Antworten zu erzeugen.
- Instruktions-Fine-Tuning, um das Model in die Lage zu versetzen, zu lernen, wie es klinische Fragen beantwortet oder Symptome aus Text extrahiert.
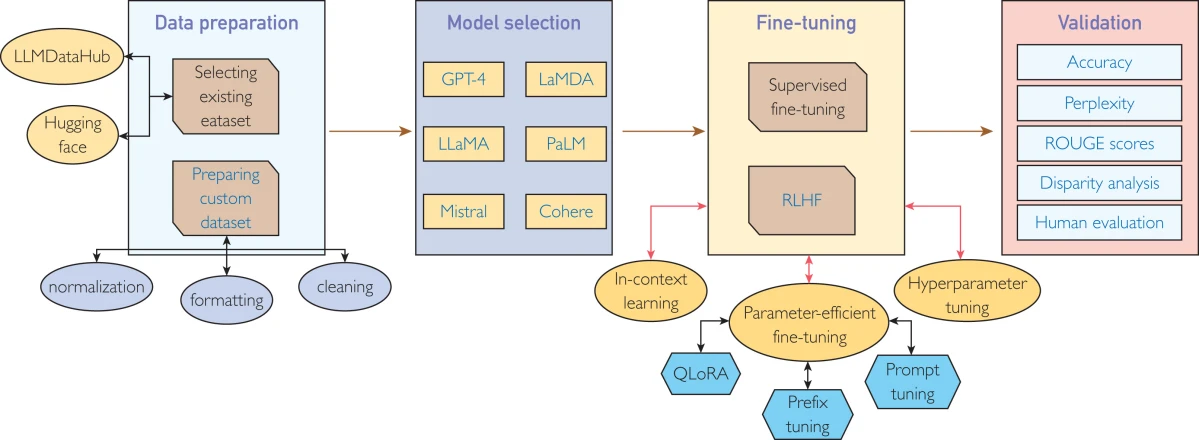
Abbildung 7: Ein allgemeiner Workflow des LLM-Fine-Tunings für spezialisierte Anwendungsfälle.
Wo Gesundheitsorganisationen LLMs einsetzen
Gesundheitsorganisationen testen LLMs sowohl in klinischen als auch in administrativen Workflows. Zu den häufigsten Anwendungen gehören klinische Dokumentation und Transkription, EHR-Zusammenfassung, Literatursuche, Entwurf von Patientennachrichten, medizinische Kodierung, vorherige Genehmigung, Aus- und Weiterbildung von Klinikern sowie patientenorientierte Erklärungen.
Die Wahl des geeigneten Models hängt weniger vom Anwendungsfall-Label als von den Workload-Anforderungen ab. Patientenorientierte und klinische Entscheidungsunterstützungsanwendungen erfordern in der Regel höhere medizinische Genauigkeit, Sicherheitsbewertung, Prüfbarkeit und Datenschutzkontrollen, während bei administrativen Workloads Kosten, Latenz, Kontextlänge und Integration in bestehende Systeme stärker gewichtet werden können.
 Als bevorzugte Quelle hinzufügen
Methodik für große Sprachmodelle im Gesundheitswesen
Benchmark-Methodik: Dieser Benchmark bewertet 9 beliebte allgemeine LLMs anhand medizinischer Fragen auf Graduierten-Niveau unter Verwendung des MedQA-Dataset, dessen Inhalte aus dem United States Medical Licensing Examination (USMLE) stammen. Jede Frage enthält ein klinisches Szenario und Multiple-Choice-Antwortoptionen.
LLM-Ausgaben: Jedes Model wurde aufgefordert, eine strukturierte Antwort zurückzugeben (z. B. „Antwort: C“).8
Latenz: Die durchschnittliche Zeit, die ein Model benötigt, um eine Antwort auf einen einzelnen MedQA-Prompt zu generieren. Wenn beispielsweise 100 Fragen insgesamt 1.115 Sekunden dauern, beträgt die durchschnittliche Latenz 11,15 Sekunden pro Frage.
LLMs im Gesundheitswesen: Benchmark-Datenquellen
- Ergebnisse von Me-LLaMA 70B9
- Ergebnisse von Meditron 70B10
- Ergebnisse von Med-PaLM 211
- ChatGPT & GPT-411
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Vergleichen Sie 9 große Sprachmodelle im Gesundheitswesen}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-language-models-in-healthcare}},
  note   = {AIMultiple. Abgerufen am 4. September 2026}
}Ergebnisse und Zeitstempel von 25 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 4 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
15 AktualisierungenDrei Anwendungsfälle ergänzt: Arzneimittelforschung und -entwicklung, Radiologie und medizinische Bildgebung sowie Gesundheitskompetenz.
Der Abschnitt „Klinische Entscheidungsunterstützung“ wurde um MedGemma und eine neue Abbildung erweitert.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.

Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.

Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.