


Spracherkennung: 12 Anwendungsfälle & Beispiele
Unternehmen erzeugen große Mengen an Sprachdaten aus Anrufen, Besprechungen und Sprachschnittstellen, aber die manuelle Verarbeitung dieser Daten ist langsam und schwer skalierbar.
Die Spracherkennung (auch automatische Spracherkennung oder Speech-to-Text genannt) wandelt gesprochene Sprache in Text um und ermöglicht es Systemen, sprachbasierte Arbeitsabläufe wie Anruftranskription, Sprachassistenten und Besprechungszusammenfassungen zu analysieren und zu automatisieren.
Erkunden Sie, wie Spracherkennung funktioniert, welche Algorithmen beteiligt sind, ihre Anwendungen in verschiedenen Branchen und Beispiele aus der Praxis.
12 Anwendungsfälle für Spracherkennung
Spracherkennung wird in vielen Branchen eingesetzt, um gesprochene Sprache in Text umzuwandeln und sprachbasierte Interaktionen mit Systemen zu ermöglichen. Die folgenden Beispiele zeigen häufige Anwendungsfälle der Spracherkennung in Sektoren wie Kundenservice, Vertrieb, Automobilindustrie, Gesundheitswesen und Technologie.
Kundenservice und Support
- Interactive Voice Response (IVR)-Systeme: IVR-Systeme leiten Anrufer automatisch an die zuständige Abteilung weiter, indem sie gesprochene Anfragen erkennen. Sie reduzieren das Anrufaufkommen und die Wartezeiten, indem sie einfache Anfragen mithilfe vorab aufgezeichneter Antworten oder Text-to-Speech-Systeme bearbeiten. Die automatische Spracherkennung (ASR) ermöglicht es IVR-Systemen, Kundenanfragen in Echtzeit zu verstehen und zu beantworten.
- Automatisierung des Kundensupports und Chatbots: Spracherkennung ermöglicht es sprachbasierten Chatbots und virtuellen Assistenten, Routineanfragen im Kundenservice zu bearbeiten, z. B. die Beantwortung von FAQs, die Anleitung bei Fehlerbehebungsschritten und die Unterstützung bei Kontoanfragen.
- Stimmungsanalyse und Anrufüberwachung: Die Stimmungsanalyse klassifiziert Gespräche als positiv, negativ oder neutral und hilft Unternehmen, die Servicequalität zu überwachen und Kundenanliegen zu identifizieren.
- Mehrsprachige Unterstützung: Spracherkennungsmodelle können so trainiert werden, dass sie mehrere Sprachen erkennen. Wenn sie in Chatbots oder IVR-Systeme integriert sind, können sie die Sprache des Benutzers erkennen und zum entsprechenden Modell wechseln, wodurch Unternehmen internationale Kunden bedienen können (siehe Abbildung 1).
- Kundenauthentifizierung mit Stimmbiometrie: Stimmbiometrie nutzt Spracherkennungstechnologien, um die Stimme eines Sprechers zu analysieren und extract Merkmale wie Akzent und Sprechgeschwindigkeit zu extrahieren, um die Identität zu überprüfen.
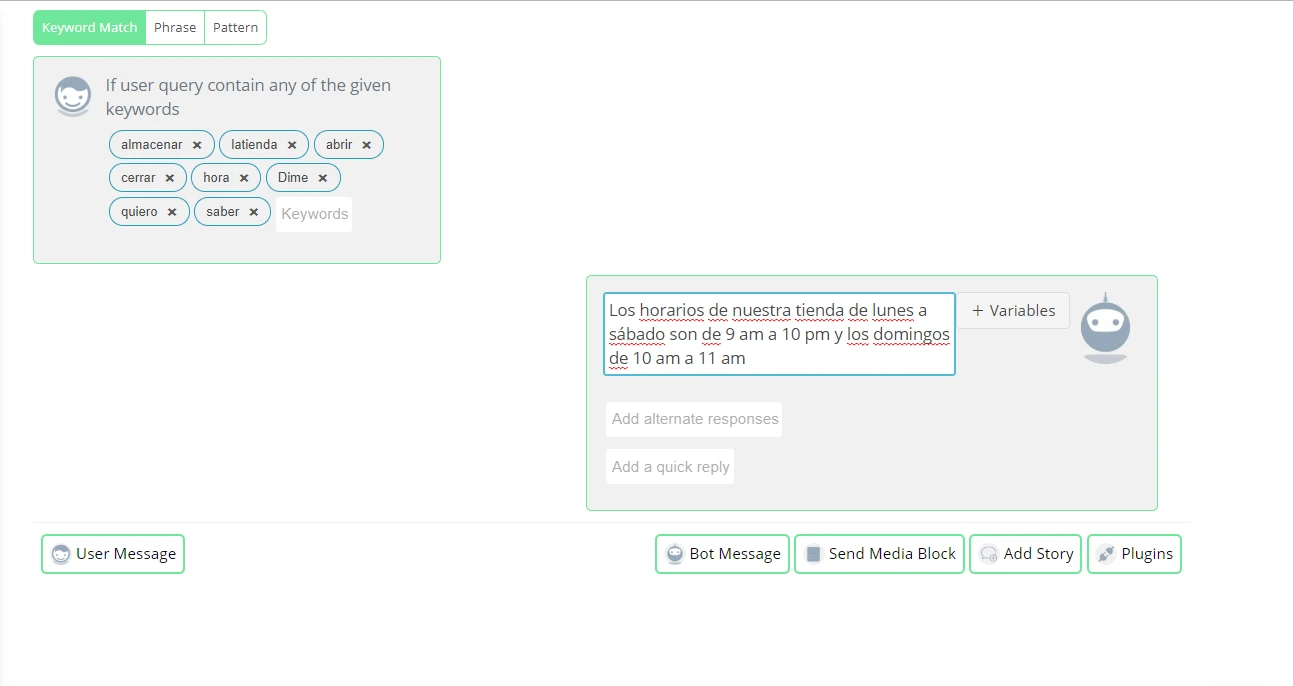
Abbildung 1: Bild, das zeigt, wie ein mehrsprachiger Chatbot Wörter in einer anderen Sprache erkennt.
Vertrieb und Marketing
- Virtuelle Vertriebsassistenten: KI-gestützte Vertriebsassistenten interagieren mit Kunden per Sprache und helfen, Kaufentscheidungen zu lenken. Spracherkennung ermöglicht es diesen Systemen, gesprochene Anfragen zu verstehen und basierend auf der Kundenabsicht zu antworten.
- Transkriptionsdienste: Spracherkennung wandelt Aufzeichnungen von Verkaufsgesprächen und Besprechungen in schriftliche Transkripte um und ermöglicht so eine einfachere Dokumentation und Analyse.
Automobilindustrie
- Sprachaktivierte Steuerungen: Sprachaktivierte Steuerungen ermöglichen es Benutzern, mit Geräten und Anwendungen per Sprachbefehl zu interagieren. Fahrer können Funktionen wie Klimaanlage, Telefonanrufe oder Navigationssysteme bedienen.
- Sprachunterstützte Navigation: Sprachunterstützte Navigation liefert Echtzeit-Sprachanweisungen, indem sie die Spracheingabe des Fahrers für das Ziel nutzt. Fahrer können Echtzeit-Verkehrsinformationen abrufen oder nahegelegene Points of Interest per Sprachbefehl suchen, ohne physische Bedienelemente zu verwenden.
Gesundheitswesen
- Medizinische Transkription: Die medizinische Transkription, auch als MT bezeichnet, ist der Prozess der Umwandlung sprachlich aufgezeichneter medizinischer Berichte in ein schriftliches Textdokument. Die folgenden sind die Hauptschritte im medizinischen Transkriptionsprozess:
- Aufzeichnung des Diktats des Arztes.
- Transkribieren der Sprache in Text mithilfe von Spracherkennungssystemen (einige Systeme umfassen auch die Sprecher-Diarisierung, um zwischen Sprechern zu unterscheiden).
- Bearbeiten des transkribierten Textes zur besseren Genauigkeit und Korrigieren von Fehlern nach Bedarf.
- Formatieren des Dokuments gemäß den gesetzlichen und medizinischen Anforderungen.
- Virtuelle medizinische Assistenten: Virtuelle medizinische Assistenten (VMAs) nutzen Spracherkennung, natürliche Sprachverarbeitung und maschinelle Lernalgorithmen, um mit Patienten per Sprache oder Text zu kommunizieren. Spracherkennungssoftware ermöglicht es VMAs, auf Sprachbefehle zu reagieren, Informationen aus elektronischen Gesundheitsakten (EHRs) abzurufen und den medizinischen Transkriptionsprozess zu automatisieren.
- Integration elektronischer Gesundheitsakten (EHR): Fachkräfte im Gesundheitswesen können Sprachbefehle verwenden, um im EHR-System zu navigieren, auf Patientendaten zuzugreifen und Daten in bestimmte Felder einzugeben.
Praxisbeispiele für Spracherkennung
Azure Speech
Azure Speech ist ein cloudbasierter KI-Dienst von Microsoft (Teil der Azure AI Foundry-Tools), der Anwendungen die Verarbeitung und Generierung gesprochener Sprache ermöglicht. Er bietet Funktionen wie:
Speech-to-Text (automatische Spracherkennung): Wandelt gesprochenes Audio in geschriebenen Text um und unterstützt mehrere Transkriptionsmodi:
- Echtzeit-Transkription für Streaming-Audio
- Schnelle Transkription für aufgezeichnete Dateien
- Batch-Transkription für große Audiomengen
Entwickler können außerdem benutzerdefinierte Sprachmodelle erstellen, um die Erkennungsgenauigkeit für domänenspezifisches Vokabular oder laute Umgebungen zu verbessern.
Text-to-Speech (Sprachsynthese): Wandelt geschriebenen Text mithilfe neuronaler Stimmen in natürlich klingendes Audio um. Entwickler können Stimmmerkmale wie Tonhöhe, Geschwindigkeit und Aussprache mithilfe der Speech Synthesis Markup Language (SSML) steuern.
Azure Speech unterstützt auch benutzerdefinierte neuronale Stimmen, sodass Unternehmen eine einzigartige Stimme für ihre Anwendungen erstellen können.
Sprachübersetzung: Bietet mehrsprachige Echtzeit-Sprachübersetzung und ermöglicht Speech-to-Speech- oder Speech-to-Text-Übersetzung in verschiedene Sprachen.
Benutzerdefinierte Sprachmodelle: Entwickler können benutzerdefinierte Modelle mit ihren eigenen Daten trainieren, um die Erkennung zu verbessern für:
- Branchenspezifische Terminologie
- Akzente und Sprechstile
- Laute Audiobedingungen
Sprach-Avatare und konversationelle KI: Azure Speech kann synthetische sprechende Avatare generieren und Echtzeit-Sprachinteraktionen ermöglichen, was konversationelle KI-Systeme und Sprachagenten unterstützt.
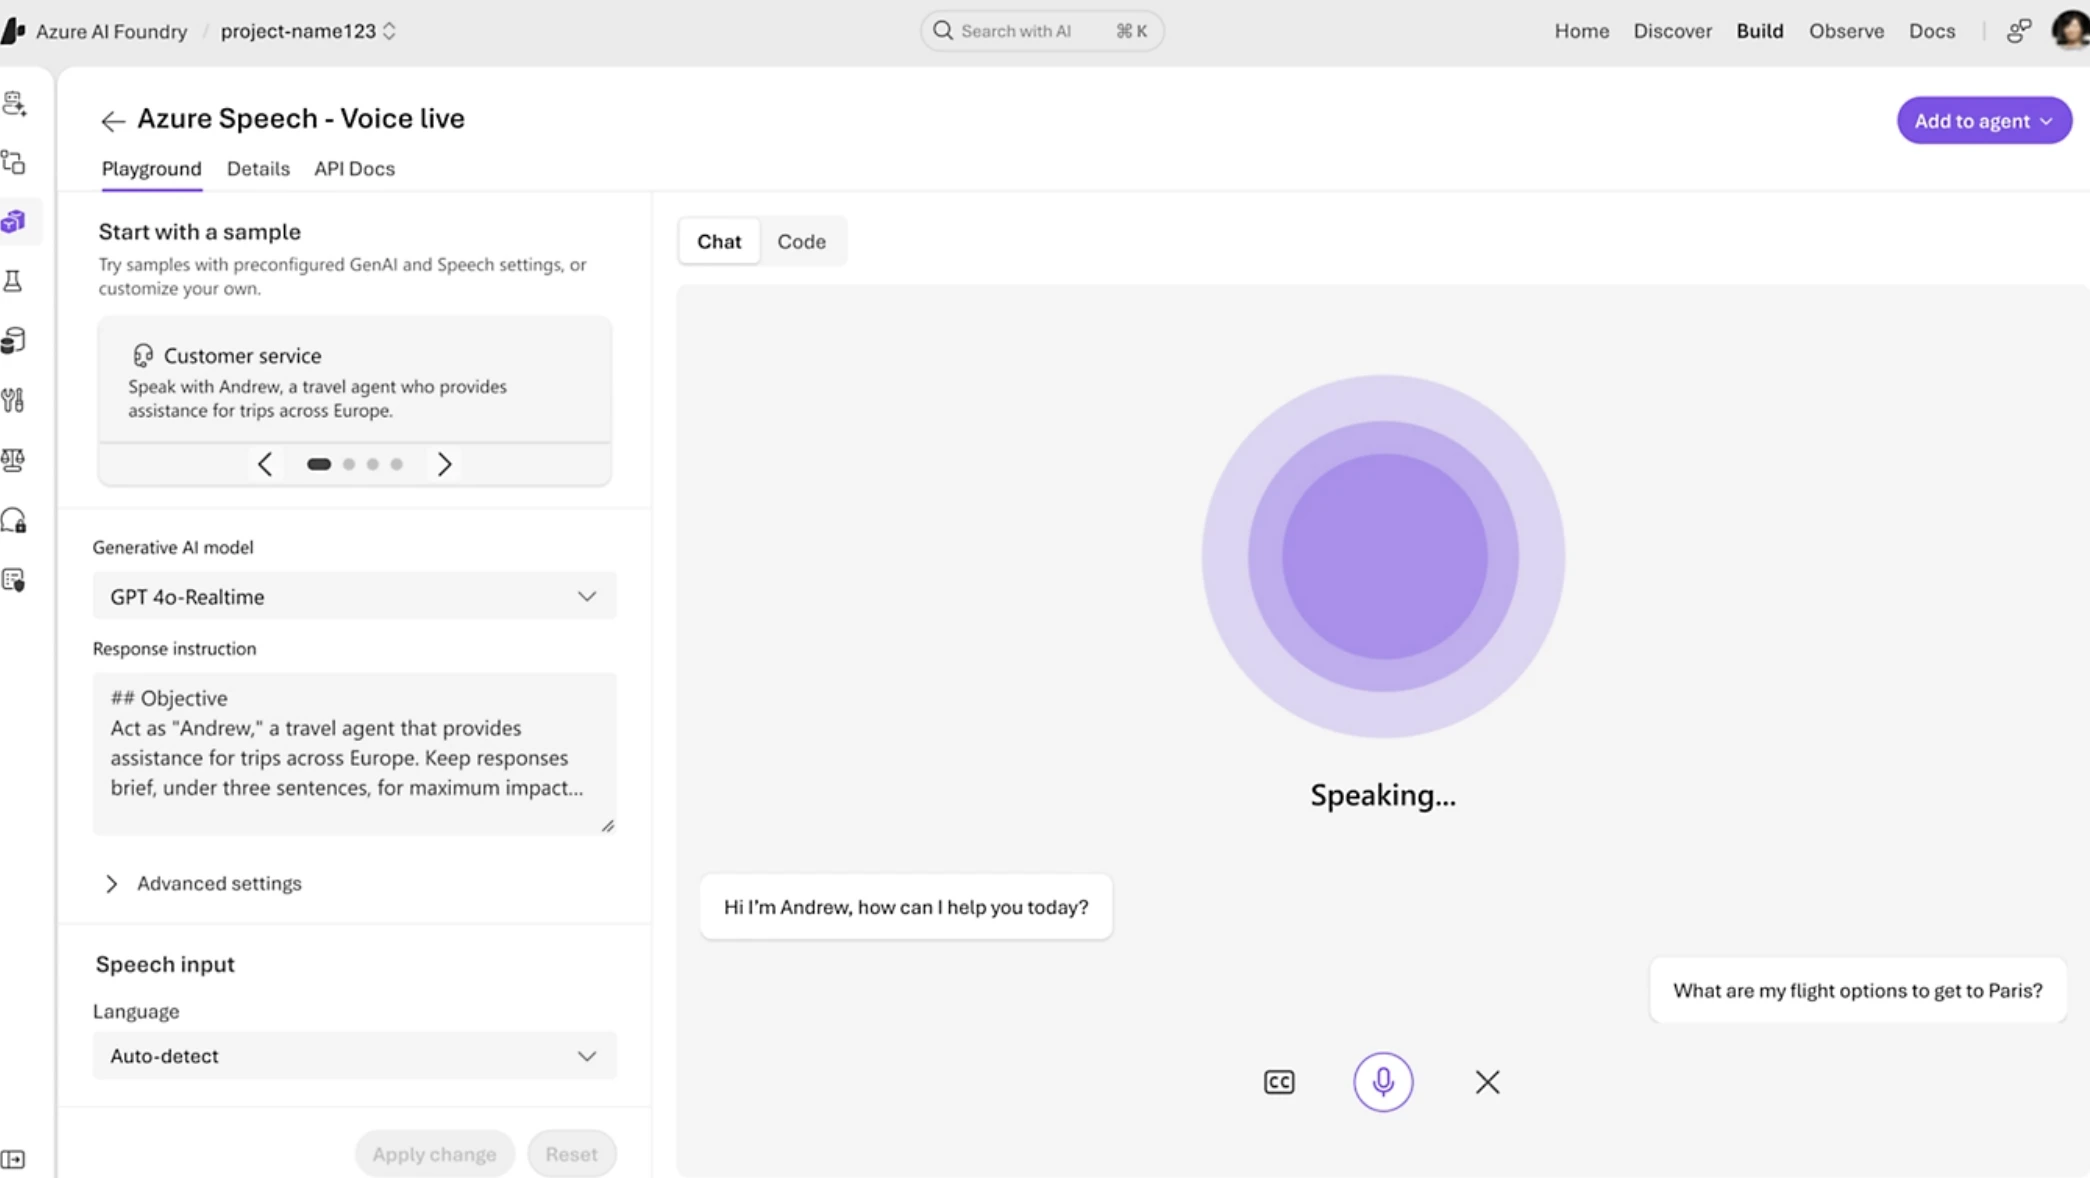
Abbildung 2: Ein Beispiel für den Azure Voice KI-Agenten, Voice Live.1
Deepgram
Deepgram bietet APIs zur Integration von Sprachfunktionen wie Speech-to-Text-Transkription, Text-to-Speech-Synthese und Stimmintelligenz.2
- Speech-to-Text-Transkription: Wandelt Audio sowohl für Echtzeit-Streaming als auch für vorab aufgezeichnete Audiodateien in Text um.
- Text-to-Speech: Erzeugt aus Text natürlich klingende Sprache für Sprachschnittstellen und Assistenten.
- Sprecher-Diarisierung: Erkennt und trennt verschiedene Sprecher in einer Audioaufnahme.
- Schlüsselworterkennung und Audio-Intelligenz: Erkennt bestimmte Wörter oder Phrasen und extrahiert Erkenntnisse aus Audiodaten.
- Benutzerdefinierte Sprachmodelle: Ermöglicht Unternehmen, die Erkennungsgenauigkeit mithilfe domänenspezifischer Daten zu verbessern.
Deepgrams Anwendungsfälle umfassen:
- Kundenservice: Transkribieren und Analysieren von Callcenter-Gesprächen, um die Servicequalität zu überwachen und extract Erkenntnisse zu extrahieren.
- Medien und Rundfunk: Erstellen von Untertiteln und Transkripten für Podcasts, Interviews und Livestreams.
- Gesundheitswesen und Rechtswesen: Umwandeln gesprochener Diktate und Gespräche in schriftliche Dokumentation.
- Business Analytics: Extrahieren von Schlüsselwörtern, Stimmungen und Erkenntnissen aus großen Mengen von Audiodaten.
AssemblyAI
AssemblyAI wird in der Callcenter-Analyse eingesetzt, bei der Kundensupportanrufe transkribiert und zur Qualitätsüberwachung und Erkenntnisgewinnung analysiert werden; bei der Meeting-Transkription, die Transkripte und Zusammenfassungen virtueller Besprechungen erstellt; und bei der Medientranskription, die Untertitel, Transkripte und durchsuchbare Audio- oder Videoinhalte ermöglicht.
Es wird auch für die Inhaltsmoderation verwendet, um unangemessene oder eingeschränkte Sprache in Audiostreams zu erkennen, sowie für die Analyse von Sprachdaten, wobei Informationen wie Themen, Entitäten und Stimmungen aus großen Mengen aufgezeichneter Gespräche extrahiert werden.3
- Speech-to-Text-Transkription: Wandelt Audiostreams oder -dateien in Text mit Zeitstempeln, Konfidenzwerten und anderen Metadaten um.
- Echtzeit-Streaming-Transkription: Verarbeitet Live-Audio mit geringer Latenz für Sprachagenten und Echtzeitanwendungen.
- Audio-Intelligenz: Extrahiert Erkenntnisse aus Sprache, einschließlich Sprecher-Diarisierung, Stimmungsanalyse, Themenerkennung und Entitätserkennung.
- Zusammenfassung und Sprachverständnis: Erstellt Zusammenfassungen und strukturierte Ausgaben aus Transkripten zur Unterstützung nachgelagerter Arbeitsabläufe.
- Inhaltsmoderation und PII-Redaktion: Erkennt oder entfernt sensible oder unangemessene Inhalte aus Audioaufnahmen.
- Mehrsprachigkeit und Spracherkennungsfunktionen: Unterstützt die Transkription über mehrere Sprachen und Akzente hinweg.
Google Cloud Speech-to-Text
Google Cloud Speech-to-Text ermöglicht es Entwicklern, die API zu integrieren, um Audiodateien zu transkribieren, Live-Sprachstreams zu verarbeiten und sprachgesteuerte Funktionen wie Befehle oder Suche zu erstellen.4
- Echtzeit- und Batch-Transkription: Transkribiert sowohl Streaming-Audio als auch vorab aufgezeichnete Dateien.
- Mehrsprachige Unterstützung: Erkennt Sprache in mehr als 100 Sprachen und Varianten.
- Fortschrittliche Sprach-KI-Modelle: Verwendet die Sprachmodelle von Google (z. B. Chirp 3), die mit großen Audiodatensätzen trainiert wurden, um eine verbesserte Genauigkeit zu erzielen.
- Chirp 3 ist das neueste Sprach-KI-Modell von Google für die automatische Spracherkennung (ASR). Es ist ein mehrsprachiges generatives Modell, das darauf ausgelegt ist, gesprochenes Audio mit höherer Genauigkeit und Geschwindigkeit in Text umzuwandeln. Das Modell verbessert die Transkriptionsqualität und unterstützt Funktionen wie Sprecher-Diarisierung (Erkennen verschiedener Sprecher), automatische Erkennung der Sprache und mehrsprachige Spracherkennung.
- Automatische Interpunktion und Sprechermerkmale: Fügt Transkripten Satzzeichen hinzu und kann zwischen Sprechern in Aufnahmen unterscheiden.
Was ist Spracherkennung?
Spracherkennung, auch bekannt als automatische Spracherkennung (ASR), Speech-to-Text (STT) und Computerspracherkennung, ist eine Technologie, die es einem Computer ermöglicht, gesprochene Sprache zu erkennen und in Text umzuwandeln.
Die Spracherkennungstechnologie verwendet KI und maschinelle Lernmodelle, um verschiedene Akzente, Dialekte und Sprachmuster genau zu identifizieren und zu transkribieren.
Spracherkennung vs. Stimmerkennung
Spracherkennung wird häufig mit Stimmerkennung verwechselt, doch sie beziehen sich auf unterschiedliche Konzepte. Spracherkennung wandelt gesprochene Wörter in geschriebenen Text um und konzentriert sich darauf, die von einem Benutzer gesprochenen Wörter und Sätze zu identifizieren, unabhängig von der Identität des Sprechers.
Andererseits geht es bei der Stimmerkennung darum, die Stimme eines Sprechers zu erkennen oder zu verifizieren, mit dem Ziel, die Identität eines unbekannten Sprechers zu bestimmen, anstatt den Inhalt der Sprache zu verstehen.
Was sind die Merkmale von Spracherkennungssystemen?
Spracherkennungssysteme bestehen aus mehreren Komponenten, die zusammenarbeiten, um menschliche Sprache zu verstehen und zu verarbeiten. Zu den wichtigsten Merkmalen effektiver Spracherkennung gehören:
Audio-Vorverarbeitung
Nachdem Sie das rohe Audiosignal von einem Eingabegerät erhalten haben, müssen Sie es vorverarbeiten, um die Qualität der Spracheingabe zu verbessern. Das Hauptziel der Audio-Vorverarbeitung besteht darin, relevante Sprachdaten zu erfassen, indem unerwünschte Artefakte entfernt und Rauschen reduziert werden.
Merkmalsextraktion
In dieser Phase wird das vorverarbeitete Audiosignal in eine informativere Darstellung umgewandelt. Dadurch werden rohe Audiodaten für maschinelle Lernmodelle in Spracherkennungssystemen besser handhabbar.
Sprachmodell-Gewichtung
Die Sprachgewichtung weist bestimmten Wörtern und Phrasen, wie z. B. Produktreferenzen, in Audio- und Sprachsignalen mehr Gewicht zu. Dadurch werden diese Schlüsselwörter bei einer nachfolgenden Spracherkennung durch Spracherkennungssysteme mit höherer Wahrscheinlichkeit erkannt.
Akustische Modellierung
Sie ermöglicht es Spracherkennern, phonetische Einheiten innerhalb eines Sprachsignals zu erfassen und zu unterscheiden. Akustische Modelle werden mit großen Datensätzen trainiert, die Sprachproben von einer vielfältigen Gruppe von Sprechern mit unterschiedlichen Akzenten, Sprechstilen und Hintergründen enthalten.
Sprecherkennzeichnung
Sie ermöglicht es Spracherkennungsanwendungen, die Identitäten mehrerer Sprecher in einer Audioaufnahme zu bestimmen. Sie weist jedem Sprecher in einer Audioaufnahme eindeutige Kennzeichnungen zu, sodass identifiziert werden kann, welcher Sprecher zu einem bestimmten Zeitpunkt gesprochen hat.
Schimpfwortfilterung
Der Prozess des Entfernens beleidigender, unangemessener oder expliziter Wörter oder Phrasen aus Audiodaten.
Was sind die verschiedenen Spracherkennungsalgorithmen?
Die Spracherkennung verwendet verschiedene Algorithmen und Berechnungstechniken, um gesprochene Sprache in geschriebene Sprache umzuwandeln. Im Folgenden sind einige der am häufigsten verwendeten Methoden zur Spracherkennung aufgeführt:
Hidden Markov Models (HMMs)
Das Hidden-Markov-Modell ist ein statistisches Markov-Modell, das häufig in traditionellen Spracherkennungssystemen verwendet wird. HMMs erfassen die Beziehung zwischen den akustischen Merkmalen und modellieren die zeitliche Dynamik von Sprachsignalen.
Verarbeitung natürlicher Sprache (NLP)
NLP ist ein Teilgebiet der künstlichen Intelligenz, das sich auf die Interaktion zwischen Menschen und Maschinen durch natürliche Sprache konzentriert. Einige der wichtigsten Aufgaben von NLP in Spracherkennungssystemen:
- Schätzen der Wahrscheinlichkeit von Wortfolgen im erkannten Text
- Umgangssprachliche Ausdrücke und Abkürzungen in einer gesprochenen Sprache in eine schriftliche Standardform umwandeln
- Phonetische Einheiten aus akustischen Modellen den entsprechenden Wörtern in der Zielsprache zuordnen.
Sprecher-Diarisierung (SD)
Sprecher-Diarisierung oder Sprecherkennzeichnung ist der Prozess der Identifizierung und Zuordnung von Sprachsegmenten zu den jeweiligen Sprechern (Abbildung 1). Sie ermöglicht die sprecherspezifische Stimmerkennung und die Identifizierung von Personen in einem Gespräch.
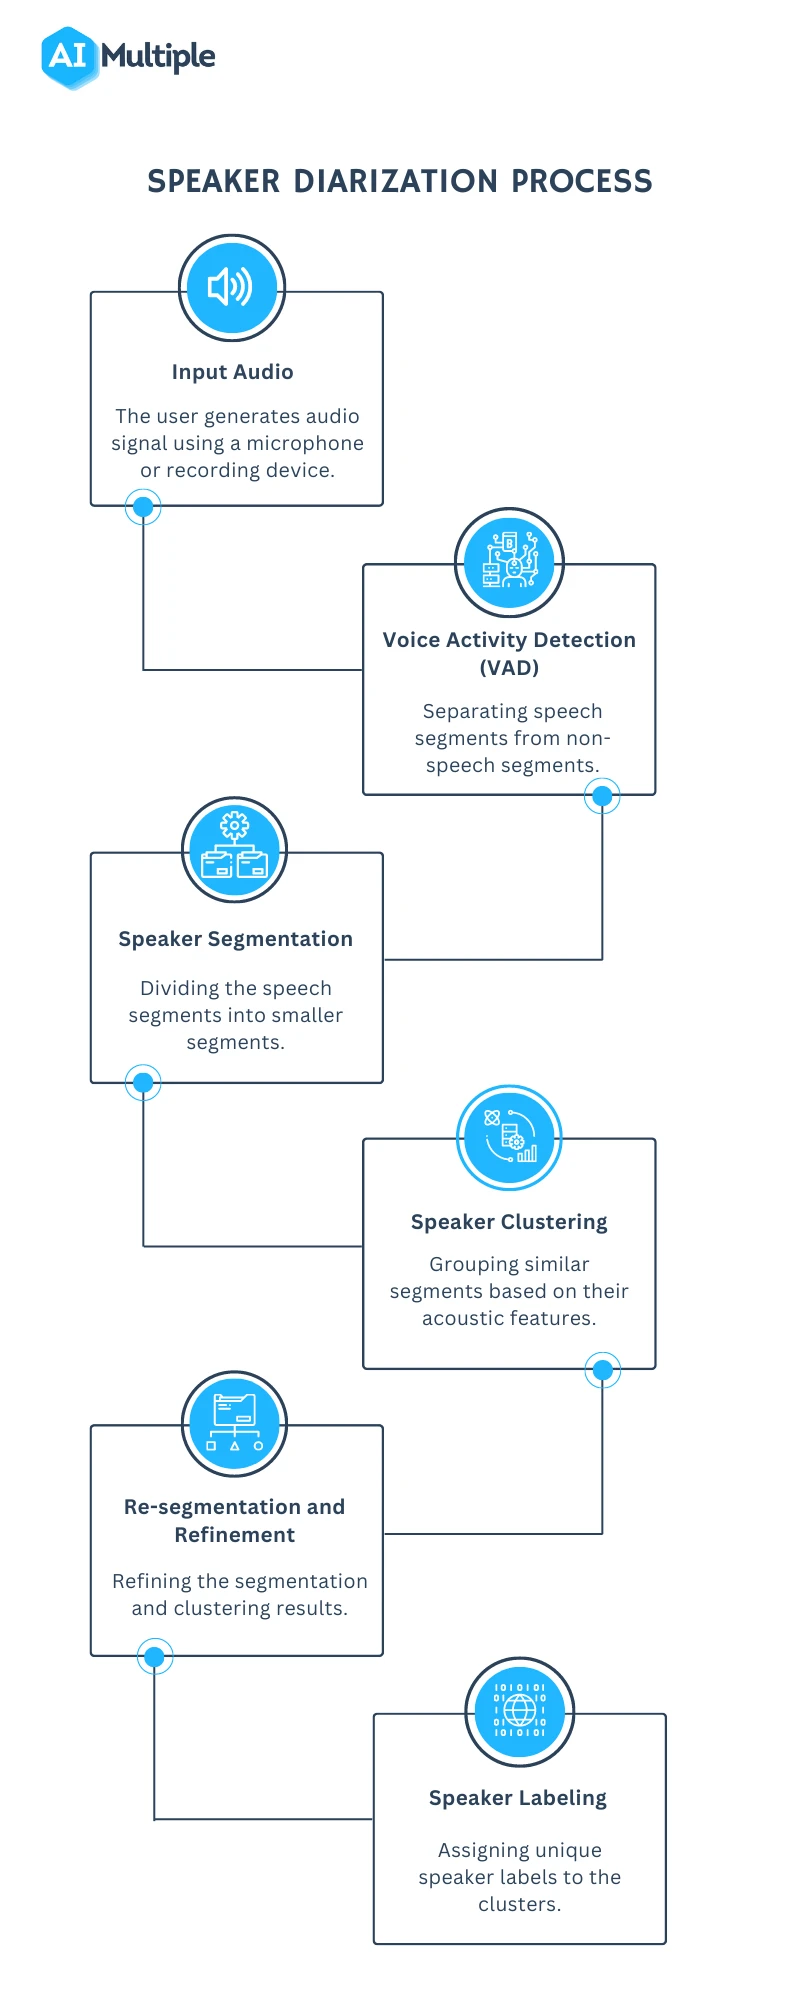
Abbildung 3: Ein Flussdiagramm, das den Prozess der Sprecher-Diarisierung veranschaulicht
Dynamic Time Warping (DTW)
Spracherkennungsalgorithmen verwenden den Dynamic-Time-Warping-Algorithmus (DTW), um eine optimale Ausrichtung zwischen zwei Sequenzen zu finden (Abbildung 4).
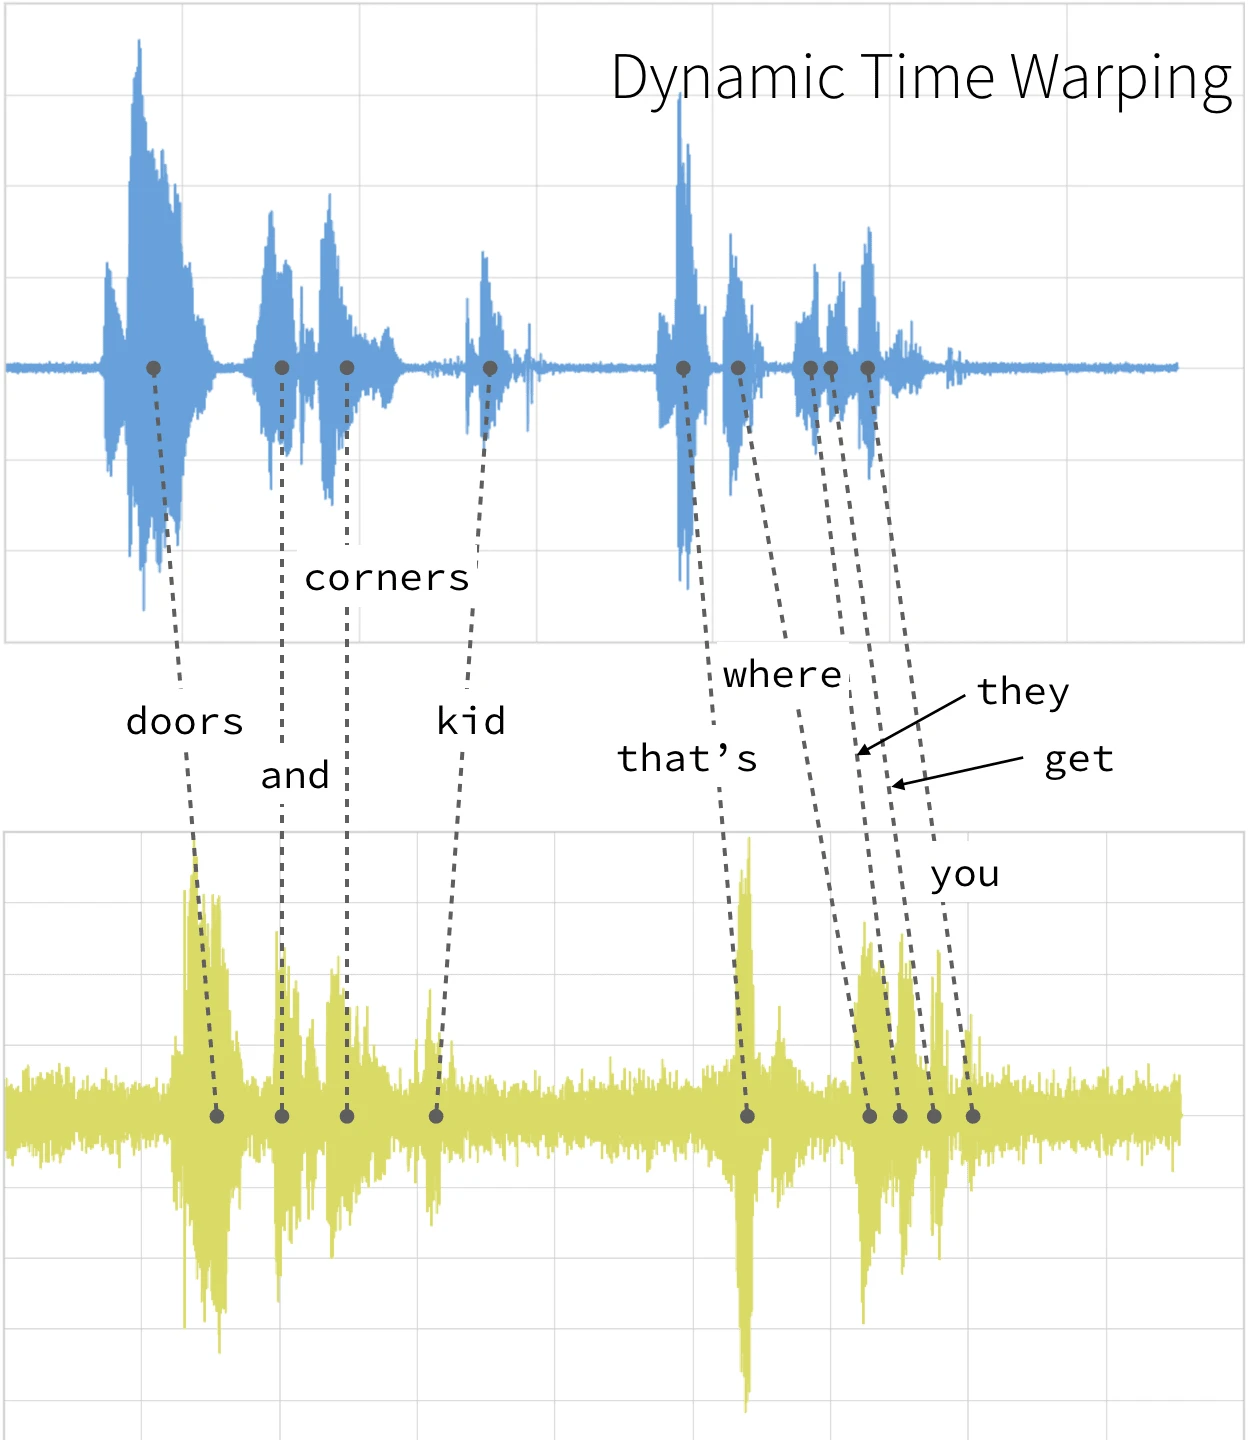
Abbildung 4: Ein Spracherkenner, der Dynamic Time Warping verwendet, um die optimale Distanz zwischen Elementen zu bestimmen.5
Tiefe neuronale Netze
Neuronale Netze verarbeiten und transformieren Eingabedaten, indem sie die nichtlineare Frequenzwahrnehmung des menschlichen Hörsystems simulieren.
Connectionist Temporal Classification (CTC)
Es handelt sich um ein Trainingsziel, das 2006 von Alex Graves eingeführt wurde. CTC ist besonders nützlich für Sequenzlabeling-Aufgaben und End-to-End-Spracherkennungssysteme. Es ermöglicht dem neuronalen Netz, die Beziehung zwischen Eingabe-Frames zu entdecken und Eingabe-Frames mit Ausgabelabels auszurichten.
 Als bevorzugte Quelle hinzufügen
Was sind die Herausforderungen der Spracherkennung?
Obwohl die Spracherkennungstechnologie viele Vorteile bietet, steht sie dennoch vor einer Reihe von Herausforderungen, die angegangen werden müssen. Zu den wichtigsten Einschränkungen der Spracherkennung gehören:
Akustische Herausforderungen
Akzente und Dialekte
Akzente und Dialekte unterscheiden sich in Aussprache, Wortschatz und Grammatik, was es für Spracherkennungsanwendungen schwierig macht, Sprache genau zu erkennen.
Angenommen, ein Spracherkennungsmodell wurde hauptsächlich mit amerikanischen englischen Akzenten trainiert. Wenn ein Sprecher mit einem starken schottischen Akzent das System verwendet, kann er aufgrund von Ausspracheunterschieden auf Schwierigkeiten stoßen. Beispielsweise wird das Wort „water“ in beiden Akzenten unterschiedlich ausgesprochen. Wenn das System mit dieser Aussprache nicht vertraut ist, kann es Schwierigkeiten haben, das Wort „water“ zu erkennen.
Lösung: Die Bewältigung dieser Herausforderungen ist entscheidend, um die Genauigkeit von Spracherkennungsanwendungen zu verbessern. Um Aussprachevariationen zu überwinden, ist es wichtig, die Trainingsdaten um Stichproben von Sprechern mit unterschiedlichen Akzenten zu erweitern. Dieser Ansatz hilft dem System, ein breiteres Spektrum an Sprachmustern zu erkennen und zu verstehen.
Hintergrundgeräusche
Hintergrundgeräusche (z. B. Verkehr, Übersprechen) machen es für Spracherkennungsanwendungen schwierig, Sprache von Hintergrundgeräuschen zu unterscheiden (siehe Abbildung 5).
Lösung: Vorverarbeitungstechniken können eingesetzt werden, um Hintergrundgeräusche bei der Spracherkennung zu reduzieren, was dazu beitragen kann, die Leistung von Spracherkennungsmodellen in lauten Umgebungen zu verbessern.
Sie können beispielsweise Datenerweiterungstechniken verwenden, um die Auswirkungen von Rauschen auf Audiodaten zu verringern. Die Datenerweiterung hilft, Spracherkennungsmodelle mit verrauschten Daten zu trainieren, um die Modellgenauigkeit in realen Umgebungen zu verbessern.
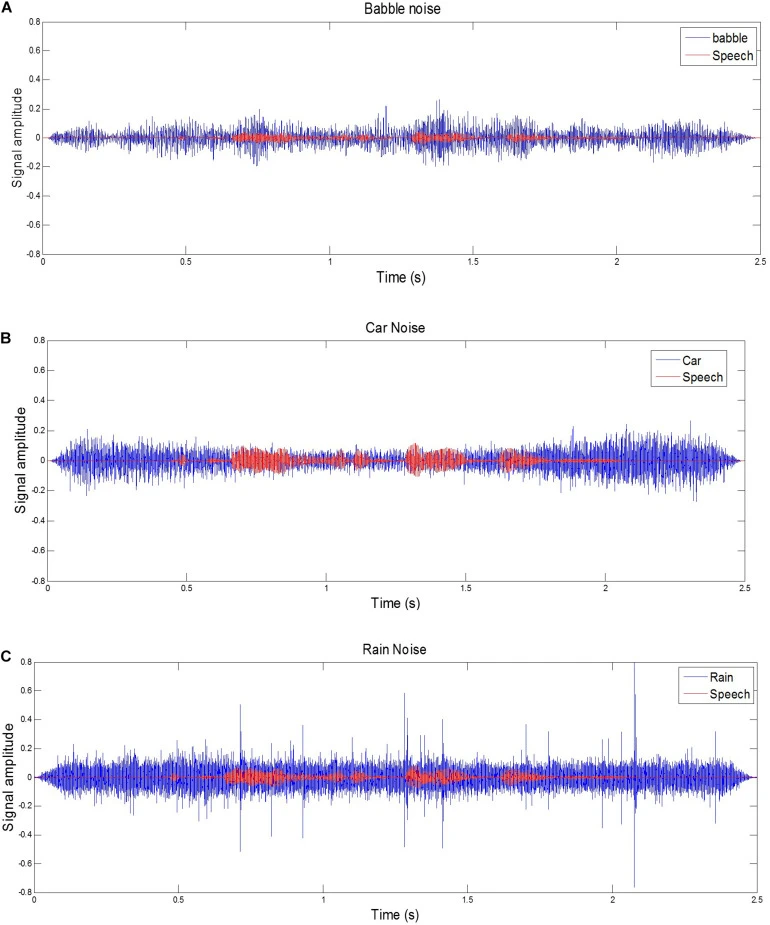
Abbildung 5: Beispiele eines Zielsatzes („The clown had a funny face“) im Hintergrundgeräusch von Gemurmel, Automatisch und Regen.6
Sprachliche Herausforderungen
Out-of-Vocabulary-Wörter
Da das Spracherkennermodell nicht auf OOV-Wörtern trainiert wurde, kann es sie fälschlicherweise als andere Wörter erkennen oder sie bei ihrem Auftreten nicht transkribieren.
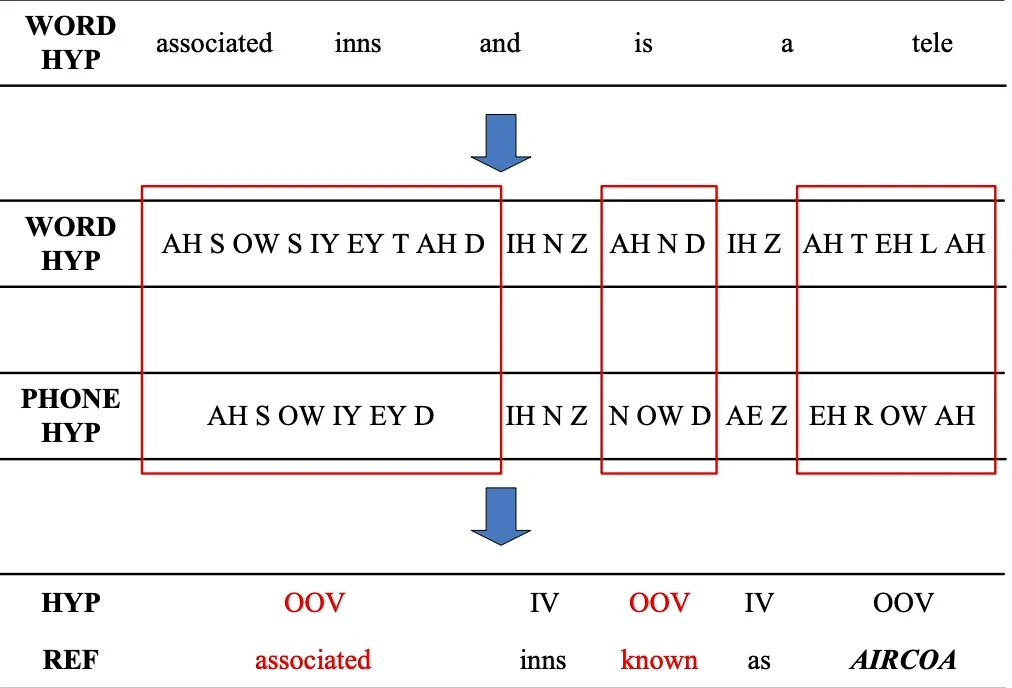
Abbildung 6: Ein Beispiel für die Erkennung eines OOV-Wortes.
Lösung: Die Wortfehlerrate (WER) ist eine gängige Metrik zur Messung der Genauigkeit eines Spracherkennungs- oder maschinellen Übersetzungssystems. Die Wortfehlerrate kann wie folgt berechnet werden:
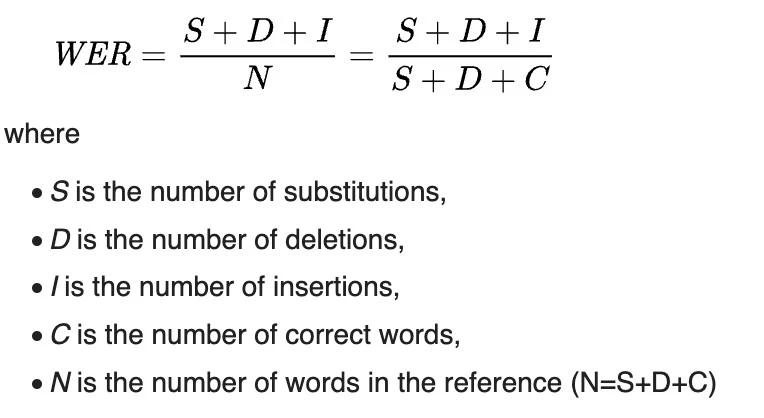
Abbildung 7: Veranschaulichung, wie die Wortfehlerrate (WER) berechnet wird.7
Homophone
Homophone sind Wörter, die identisch ausgesprochen werden, aber unterschiedliche Bedeutungen haben, wie z. B. „to“, „too“ und „two“.
Lösung: Die semantische Analyse ermöglicht es Spracherkennungsprogrammen, das passende Homophon anhand seiner beabsichtigten Bedeutung in einem gegebenen Kontext auszuwählen. Die Berücksichtigung von Homophonen verbessert die Fähigkeit des Spracherkennungsprozesses, gesprochene Wörter genau zu verstehen und zu transkribieren.
Technische/Systemherausforderungen
Datenschutz und Datensicherheit
Spracherkennungssysteme beinhalten die Verarbeitung und Speicherung sensibler und persönlicher Informationen, wie z. B. Finanzinformationen. Eine unbefugte Partei könnte die erfassten Informationen verwenden, was zu Datenschutzverletzungen führen kann.
Lösung: Sie können sensible und persönliche Audioinformationen verschlüsseln, die zwischen dem Gerät des Benutzers und der Spracherkennungssoftware übertragen werden. Eine weitere Technik zur Gewährleistung von Datenschutz und Datensicherheit in Spracherkennungssystemen ist das Data Masking. Data-Masking-Algorithmen maskieren und ersetzen sensible Sprachdaten durch strukturell identische, aber akustisch unterschiedliche Daten.
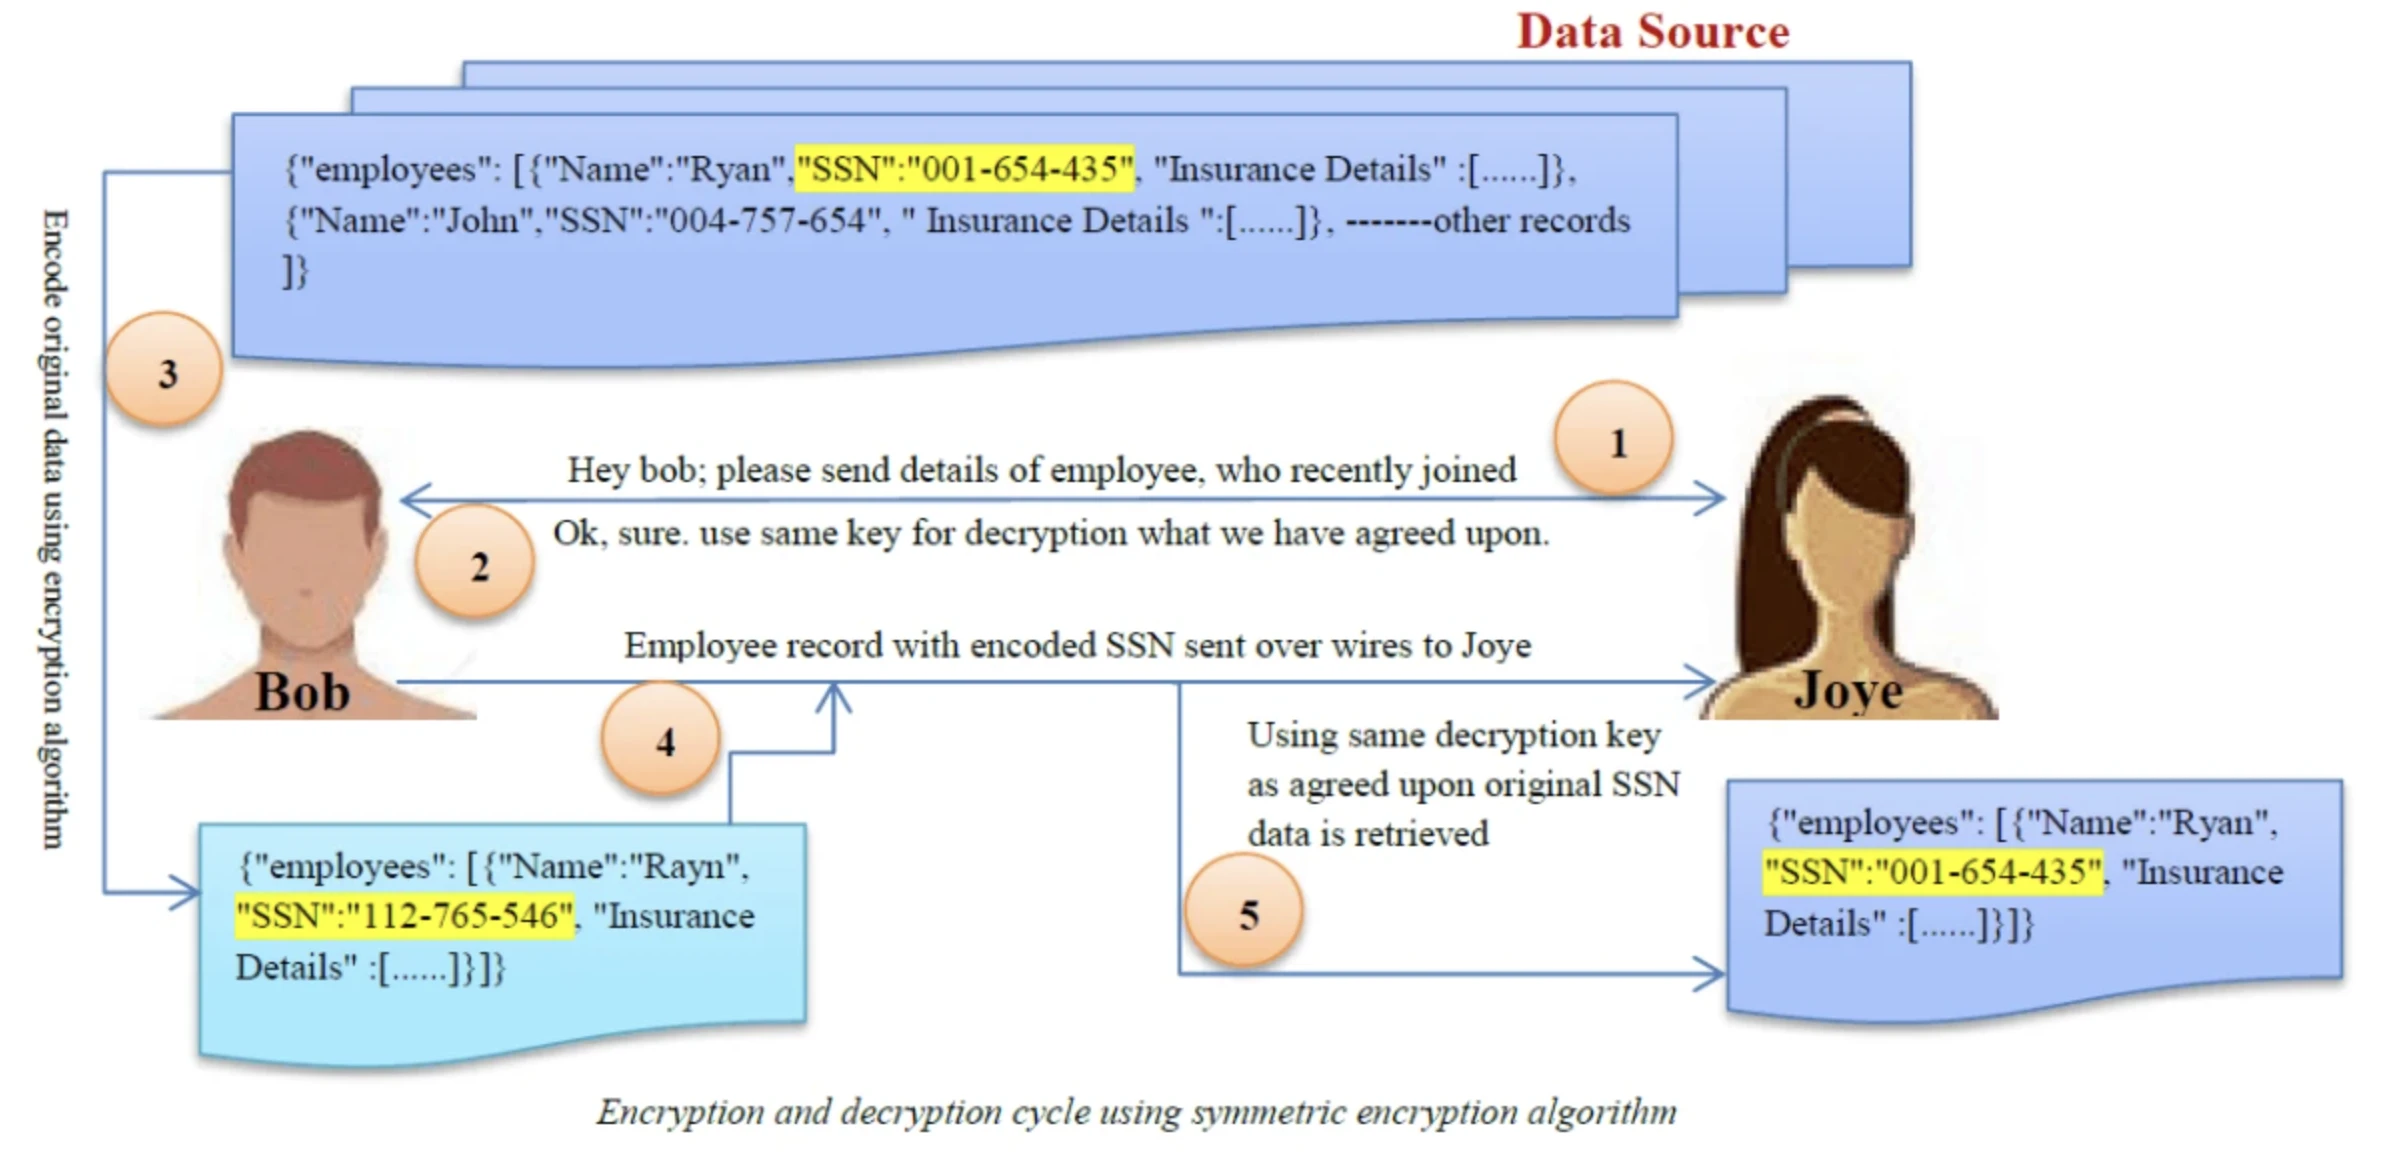
Abbildung 8: Ein Beispiel dafür, wie Data Masking funktioniert.
Begrenzte Trainingsdaten
Begrenzte Trainingsdaten wirken sich direkt auf die Leistung von Spracherkennungssoftware aus. Bei unzureichenden Trainingsdaten kann das Spracherkennungsmodell Schwierigkeiten haben, verschiedene Akzente zu verallgemeinern oder weniger gebräuchliche Wörter zu erkennen.
Lösung: Um die Qualität und Quantität der Trainingsdaten zu verbessern, können Sie den vorhandenen Datensatz mithilfe von Datenerweiterung und synthetischer Datengenerierung erweitern.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{karatas2026,
  author = {Karatas, Gulbahar},
  title  = {{Spracherkennung: 12 Anwendungsfälle & Beispiele}},
  year   = {2026},
  month  = mar,
  howpublished    = {\url{https://aimultiple.com/speech-recognition}},
  note   = {AIMultiple. Abgerufen am 9. März 2026}
}
Änderungsprotokoll
1 AktualisierungenAzure Speech, Deepgram, AssemblyAI und Google Cloud Speech-to-Text zum Abschnitt „Spracherkennung in der Praxis“ hinzugefügt.
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.