


En İyi Yapay Zeka Web Kazıma Araçları Kıyaslandı

En iyi yapay zeka web kazıma araçlarını, en çok ziyaret edilen alan adlarından 10 tanesinin her birinde 500 URL üzerinde araç başına 5.000 olmak üzere toplam 25.000 istekle test ettik; performanslarını gördük ve her birinin yapay zekayı nasıl kullandığını karşılaştırdık.
Yapay zeka web kazıma benchmark'ı
Test süreciyle ilgili daha fazla ayrıntı için benchmark metodolojisi bölümüne bakın.
Eksiksizlik ve doğruluk karşılaştırması
Her alan adı için ilgili sayfa türünde önem taşıyan alanları istedik: e-ticaret sayfalarında fiyat ve para birimi; sosyal sayfalarda gönderi metni, beğeniler ve yazar. Bu araçların ne kadar iyi performans gösterdiğini ölçmek için üç metrik kullandık: başarı, eksiksizlik ve doğruluk. Üçünün de gerekli olmasının nedeni, bir aracın her şeyi döndürmeden bir şeyler döndürebilmesi ya da her şeyi döndürüp hiçbirinin doğru olmamasıdır.
Başarı: istediğimiz alanlardan en az birini döndüren isteklerin oranı.
Eksiksizlik: istediğimiz alanlardan gerçekten dönenlerin, istekler genelinde ortalaması alınmış oranı.
Doğruluk: kontrol edilebilir alanlardan doğru değerle dönenlerin, bir referansa veya diğer araçların üzerinde uzlaştığı değere göre kontrol edilmiş oranı. Hiç dönmeyen bir alan yanlış sayılır.
İstatistiksel metodoloji
Güven aralıkları bootstrap yüzdelik yeniden örnekleme kullanılarak hesaplandı:
Yeniden örnekleme sayısı: 10.000
Güven düzeyi: %95
Yeniden örnekleme birimi: URL; beş sağlayıcı da aynı çekilişte yeniden örneklenir
Metrikler: başarı oranı, eksiksizlik, doğruluk ve tamamlanma süresi
Örneklem boyutu: Sağlayıcı başına N = 5.000 URL (10 alan adının her birinde 500)
Alan adı puanları önce hesaplanır, ardından on alan adının ortalaması alınır
Yapay zeka web kazıma benchmark sonuçları
10 alan adındaki 5.000 URL üzerinde her aracı kendi API'sinin tasarlandığı şekilde çağırdık. Bright Data, Apify ve Firecrawl tek istekte URL listesi kabul ettiğinden istek başına 100 URL gönderdik. Oxylabs ve ScrapingBee istek başına tek URL kabul ettiğinden onları teker gönderdik. Eşzamanlılık her araç için aynıydı: beş paralel istek; bu yüzden tek fark, her API'nin desteklediği özelliklerdi.
- Bright Data üç kalite ölçütünün hepsinde en yüksek puanı aldı: %85 başarı, %76 eksiksizlik, %60 doğruluk.
- Bu alandaki en yüksek doğruluk %60 oldu. Kontrol edilebilir alanların beşte ikisi eksik veya hatalı döndü.
- Eksiksizlik, Bright Data'nın %76'sından Apify'nin %32'sine kadar değişti; Oxylabs %59, Firecrawl %53 ve Scraping Bee %41 oldu.
- Firecrawl, URL başına yarım saniyenin altında süreyle en hızlıydı; Bright Data'nın 4,6 saniyesine karşı doğrulukta 22 puan daha düşüktü. Oxylabs 35 saniye ile en yavaştı.
Her satıcı yapay zekaya farklı bir yaklaşım benimsiyor ve amacımız bu yaklaşımları ve getirdikleri ödünleri karşılaştırmaktı.
Benchmark'tan yapay zeka web kazıma araçları hakkında temel bulgular
- Başarısızlıklar veri gibi görünebilir. Bir araç, genellikle sayfa bir anti-bot duvarına takıldığı için fiyatı okuyamadığında, başarısızlık yerine 0 döndürebilir. Null yeniden denenebilir veya atlanabilir, ancak 0 doğrulamadan fark edilmeden geçer. Apify ve Oxylabs bu durumlarda null döndürdü. Firecrawl'ın belgeleri, modelin bir değeri tahmin etmemesi için her şema alanına "Sayfada bulunamazsa null döndür" eklenmesini önerir.
- Ekstra alanlar: fiyat ve para birimi isteyen bir prompt aynı zamanda marka, açıklama veya görsel URL'leri de döndürebilir. Şema, yanıtı adlandırdığınız alanlarla sınırlar. Bright Data çıktı şemasını oluşturma anında kilitler; böylece her çağrı aynı alanları döndürür.
- Yanlış öğe: indirimli ve orijinal fiyatı, vergili ve vergisiz fiyatları veya bölgesel fiyat seçeneklerini gösteren sayfalarda bir araç yanlış sayıyı extract edebilir.
- Değişen sayılar: prompt'tan JSON'a araçlar ondalık basamak ekleyebilir, değerleri kesebilir veya sayfada görünmeyen döviz çevrimli yaklaşık değerler döndürebilir.
- Konum fiyatı değiştirir: bazı siteler ziyaretçinin IP konumuna göre fiyat belirler; bu yüzden ABD proxy'lerindeki bir araç, Avrupalı bir kullanıcıdan farklı bir fiyat görür.
Şema ve proxy bölgesi, bunların çoğunu verinize ulaşmadan önce yakalamanızı sağlayan parametrelerdir.
Yapay zeka web kazıma araçları fiyatlandırması
Kadoa, fiyat yayınlamadığı için fiyatlandırma grafiğinde yer almıyor. Kadoa, tüketime dayalı bir Flex katmanı ve satış üzerinden fiyatlandırılan bir Enterprise katmanı sunuyor.
Yapay zeka web kazıma araçları karşılaştırması
İlk kazıyıcıya ulaşma süresi: Daha sonra kimlikle çağırdığınız bir kazıyıcı oluşturan araçlar için kurulumun ne kadar sürdüğü. “Tek HTTP çağrısı”, hiçbir oluşturma adımının bulunmadığı anlamına gelir.
Kullanıcı tanımlı çıktı şeması: Kazıma çalışmadan önce çıktı alanlarını ve türlerini, bunları bir prompt'ta tanımlayıp yapıyı çalışma zamanında LLM'in belirlemesine bırakmak yerine kendinizin ayarlayıp ayarlayamayacağı.
Bir kez oluştur, çok kez çağır endpoint: Kazıyıcının bir kez oluşturulup satıcı tarafında saklanıp sonra yalnızca bir URL ile çağrılıp çağrılmadığı. Burada LLM (veya kayıt tabanlı araçlar için tıklama akışınız) oluşturma anında çalışır ve çıktısı, sahip olduğunuz ve yerinde değiştirebileceğiniz bir kazıyıcıya dondurulur; planlayıcılar, webhook'lar ve entegrasyonlar da buna bağlanır. Bu olmadığında, çıkarım her çağrıda yeniden hesaplanır ve tüm tanım her istekle birlikte taşınır.
Kendi kendini iyileştiren kayıtlı kazıyıcı: Hedef site değiştiğinde kayıtlı bir kazıyıcının, sıfırdan yeniden oluşturulmadan onarılıp onarılmadığı. Düzeltme, aynı kayıtlı kazıyıcıya mevcut tanımlayıcısı altında uygulanır; böylece tetikleyiciler, planlamalar ve entegrasyonlar çalışmaya devam eder.
* Kadoa, kazıyıcıyı saklar ve kimlikle çağırır, ancak hedef URL'ler iş akışı oluşturulduğunda bağlanır. Yeni bir URL'ye yönlendirmek, çalıştırmadan önce ayrı bir metadata güncellemesi gerektirir.
Her çağrıda sayfa üzerinde LLM çalıştıran araçlar burada sayılmaz: onarılacak kalıcı bir çıkarım mantığı yoktur; bu, onları yerleşim değişikliklerine toleranslı kılar ancak aynı zamanda incelenecek, sürümlenecek veya onaylanacak bir yapıt olmadığı anlamına gelir. İşaret edebileceğiniz bir tanımlayıcısı olmayan iç önbellekler de böyledir; çünkü yine incelenecek, sürümlenecek veya onaylanacak hiçbir şey yoktur.
Sürekli değişen sayfalar gibi şeylerin ötesinde, ajan tabanlı pipeline'larda genellikle çağırabileceğiniz basit bir API'ye ihtiyaç duyarsınız: bir URL verin, yapılandırılmış veri alın. Ancak düzenli olarak kazımanız gereken her alan adı için her zaman hazır bir kazıyıcı API'si bulamazsınız; bulduğunuzda da istediğiniz alanlar orada olmayabilir veya şemayı kendi ihtiyaçlarınıza göre özelleştirmeniz gerekebilir. Bu sorunları ele alan farklı yaklaşımlar vardır.
Bir kez oluştur, çok kez çağır yapay zeka web kazıma platformları
Kendi kazıyıcınızı oluşturursanız, tarayıcıyı yazmanız, proxy'leri bağlamanız, başsız tarayıcıları çalıştırmanız ve kuyrukları, yeniden denemeleri ve anti-bot önlemlerini kendiniz yönetmeniz gerekir.
Yapay zeka web kazıma araçları bu işi azaltır. Bright Data Scraper Studio, Browse AI ve Kadoa gibi bir kez oluştur, çok kez çağır platformları, bir prompt'tan veya bir tıklama kaydından kazıyıcıyı bir kez oluşturur ve onu bir URL ile çağırabilmeniz için saklar.
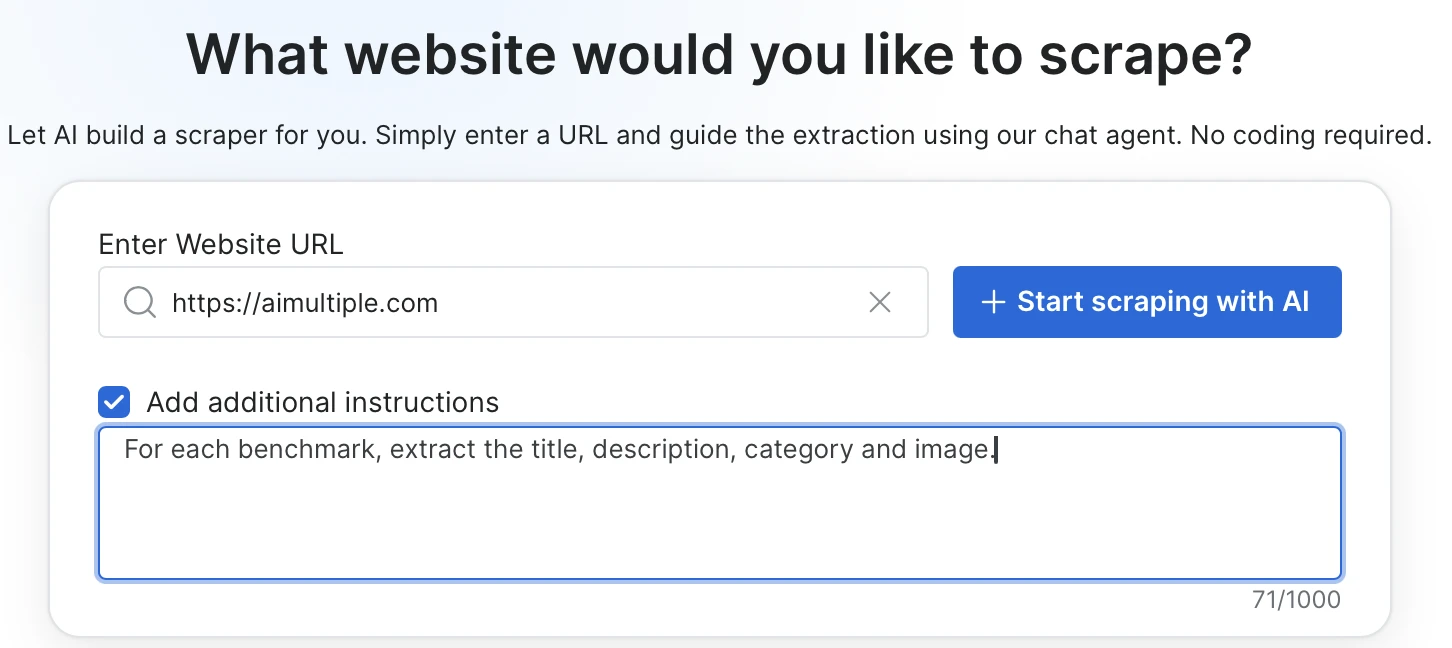
Bright Data Scraper Studio, bir prompt'tan kazıyıcı oluşturur ve ardından onu kararlı bir API olarak sunar. Tek seferlik kurulumdan sonra her çağrı yalnızca bir URL alır.
Extract etmek istediğiniz alanları sade bir dille tanımlarsınız ve isteğe bağlı olarak CSS seçiciler, gerekli sayfa içi eylemler veya sayfa yükleme davranışı ekleyebilirsiniz.
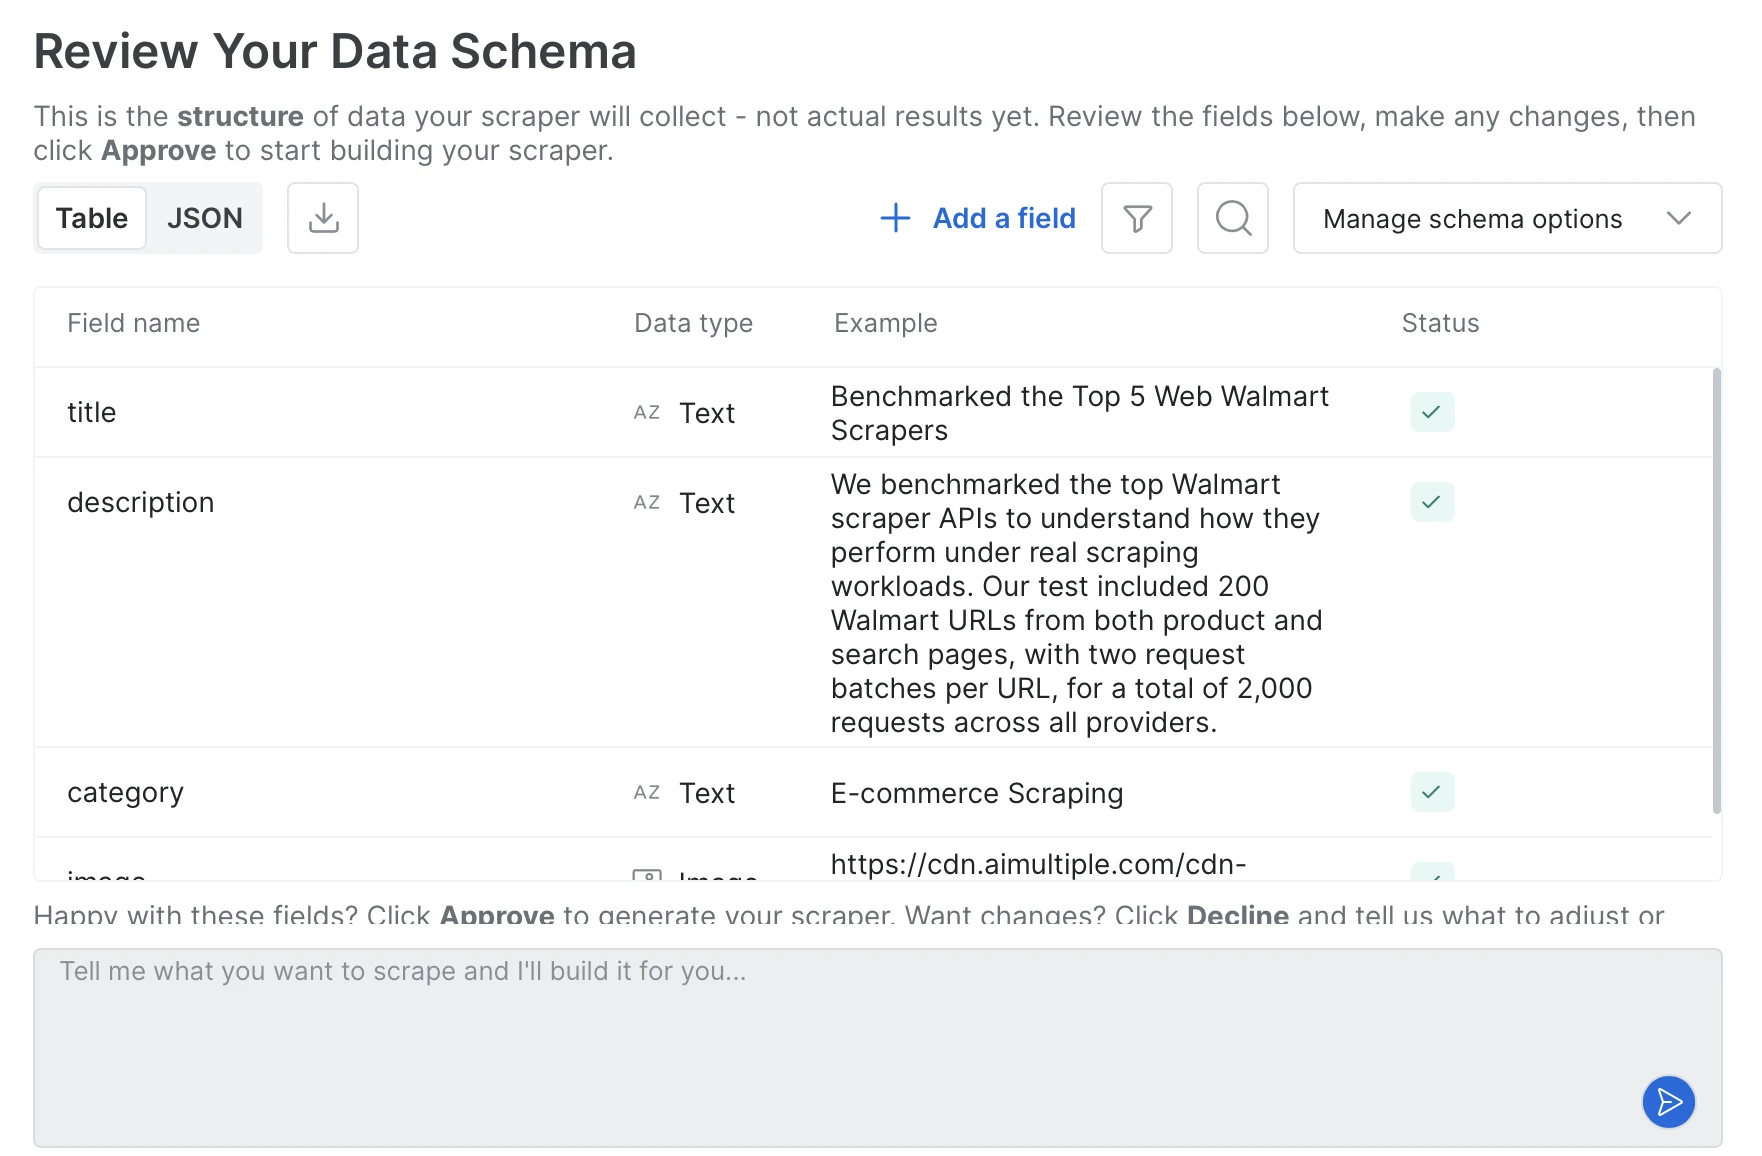
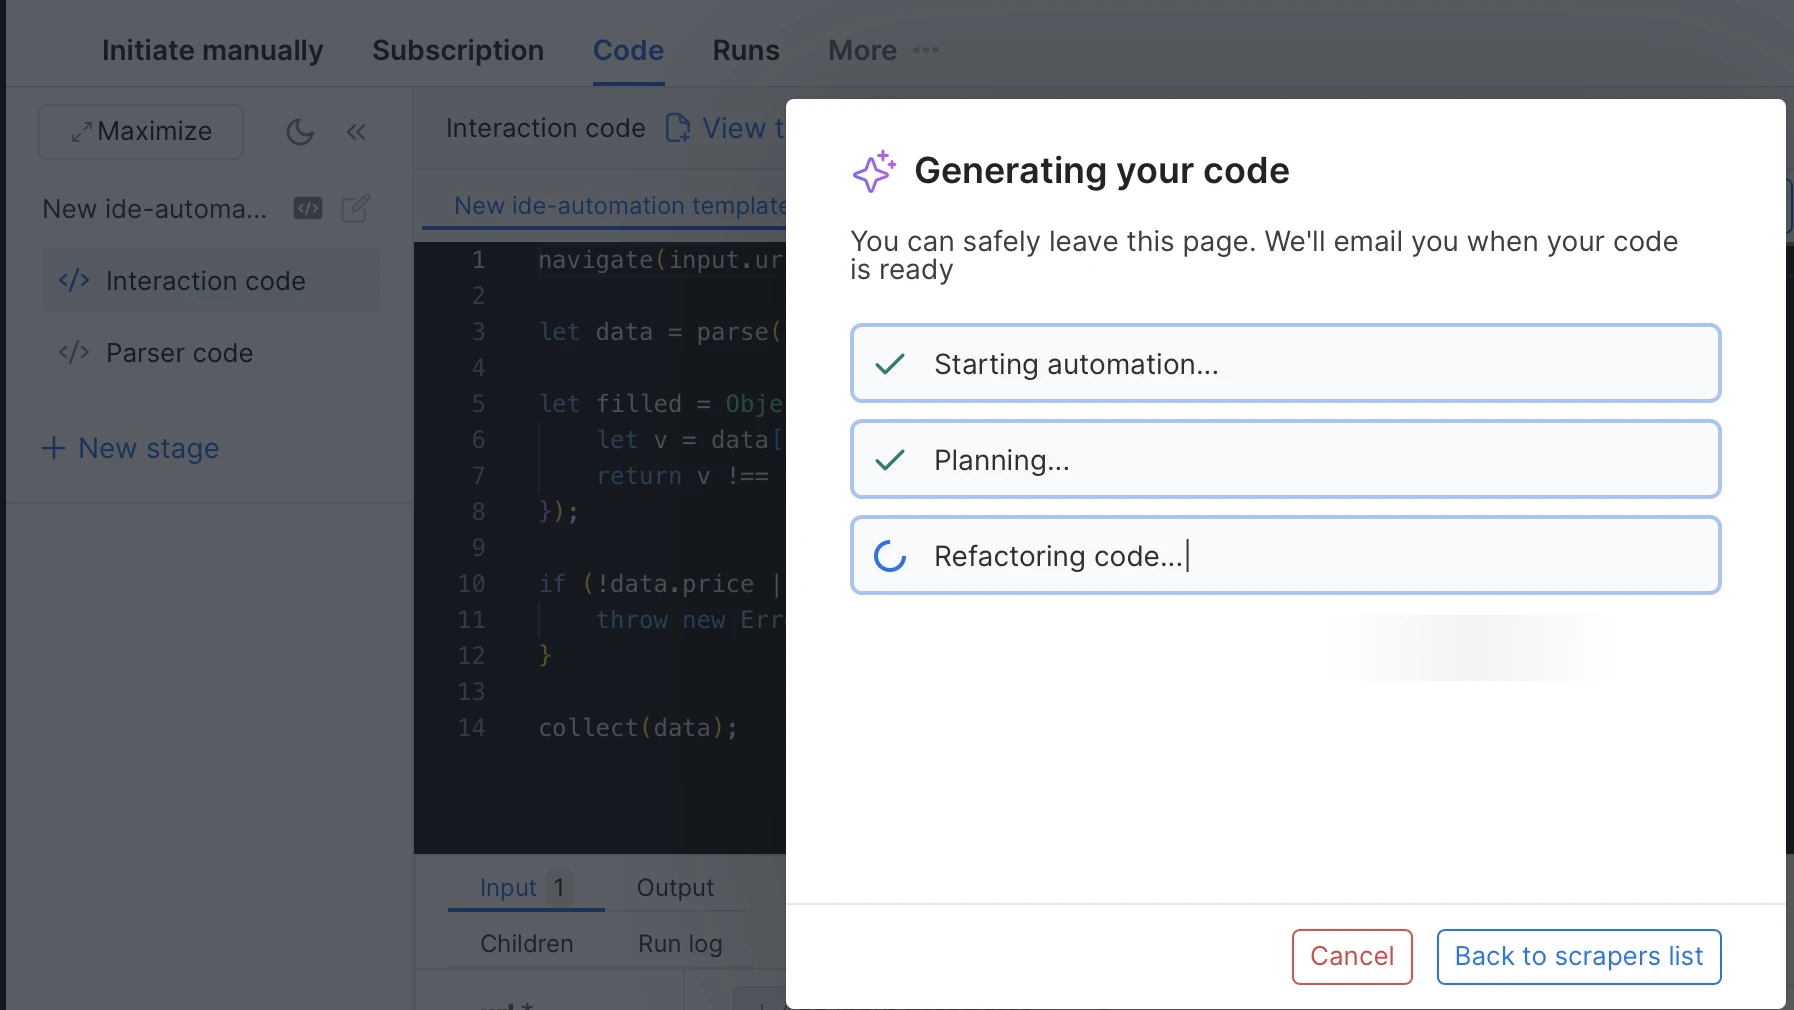
Scraper Studio ajanı, prompt'tan çıktı şemasını oluşturur. Şemayı inceler, alan ekler veya çıkarır ya da türleri değiştirirsiniz; ardından ajan kazıyıcı kodunu yazar.
- Bir kez oluştur, çok kez çağır endpoint: Şemayı onayladığınızda, kazıyıcı sabit bir tanımlayıcıyla uzun ömürlü bir endpoint olarak kaydedilir. Her çağrı yalnızca bir URL ile aynı endpoint'e gider ve çıktı şeması çağrılar arasında aynı kalır. Testlerimizde özel bir kazıyıcı oluşturmak ortalama 10 dakika sürdü.
- İki oluşturma yöntemi: Tarayıcıda Ajan ile sohbet edebilir veya tek bir komutla URL ve prompt alan Bright Data CLI'yi kullanarak kazıyıcıyı terminalinizden oluşturabilirsiniz. Her ikisi de aynı kazıyıcıyı üretir.
- Kodlama ajanı iş akışı: Terminal komutları Claude Code, Cursor ve Codex'te değiştirilmeden çalışır; böylece ajan editörden ayrılmadan kazıyıcıyı oluşturabilir, çalıştırabilir veya kendi kendine iyileştirebilir. Ayrıca kazıyıcının tanımlayıcısını ajanın kurallar dosyasına sabitleyebilirsiniz; böylece gelecekteki oturumlar onu yeniden kullanır.
- Teslimat: API, SDK, CLI, webhook'lar veya S3, GCS, Azure ya da OSS üzerinde bulut depolamaya doğrudan teslimat.
- Önceden oluşturulmuş kazıyıcılarla birlikte: Bright Data, Amazon, LinkedIn ve Zillow gibi popüler siteler için hazır kazıyıcılardan oluşan bir kitaplık korur.
Otomatik kendi kendini iyileştirme
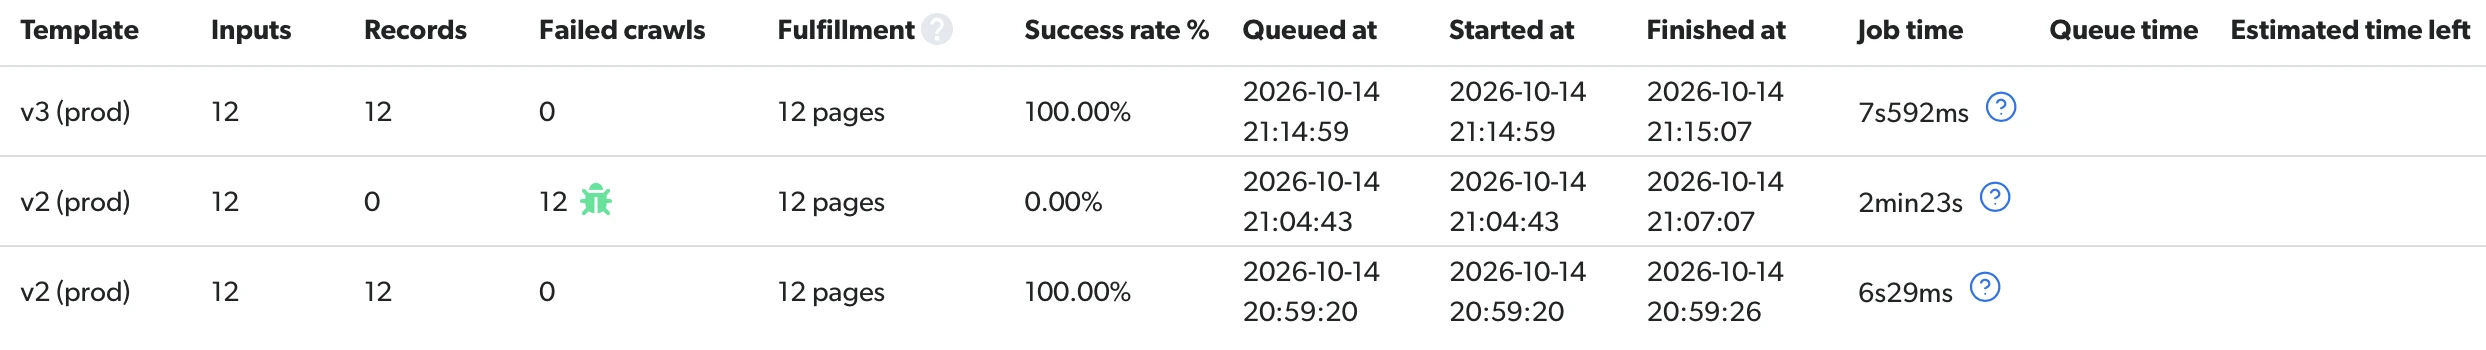
Bright Data'nın Scraper Studio'su kayıtlı bir kazıyıcıyı kendi başına onarabilir. Bunu, barındırdığımız ürün sayfalarında başlık, fiyat, para birimi, satıcı ve stok durumu isteyerek test ettik. İlk çalıştırma %100 başarıyla kayıtlar döndürdü.
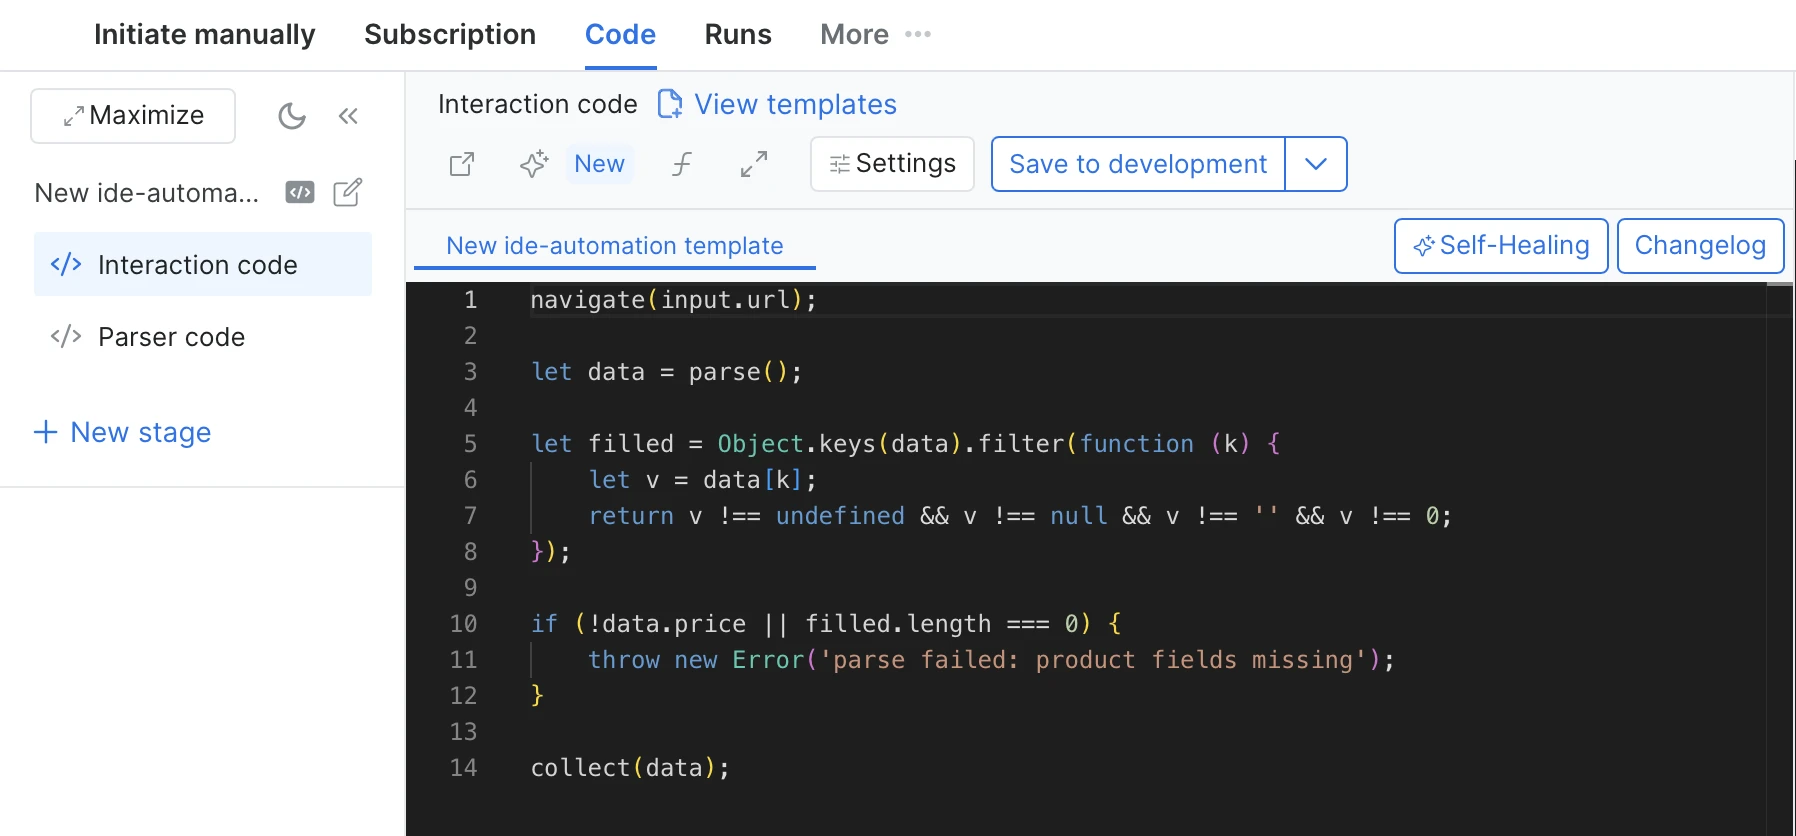
Oluşturulan koda bir kontrol ekledik. Fiyat eksikse veya hiç alan dönmezse, çalıştırma boş bir kayıt toplamak yerine hata fırlatır.
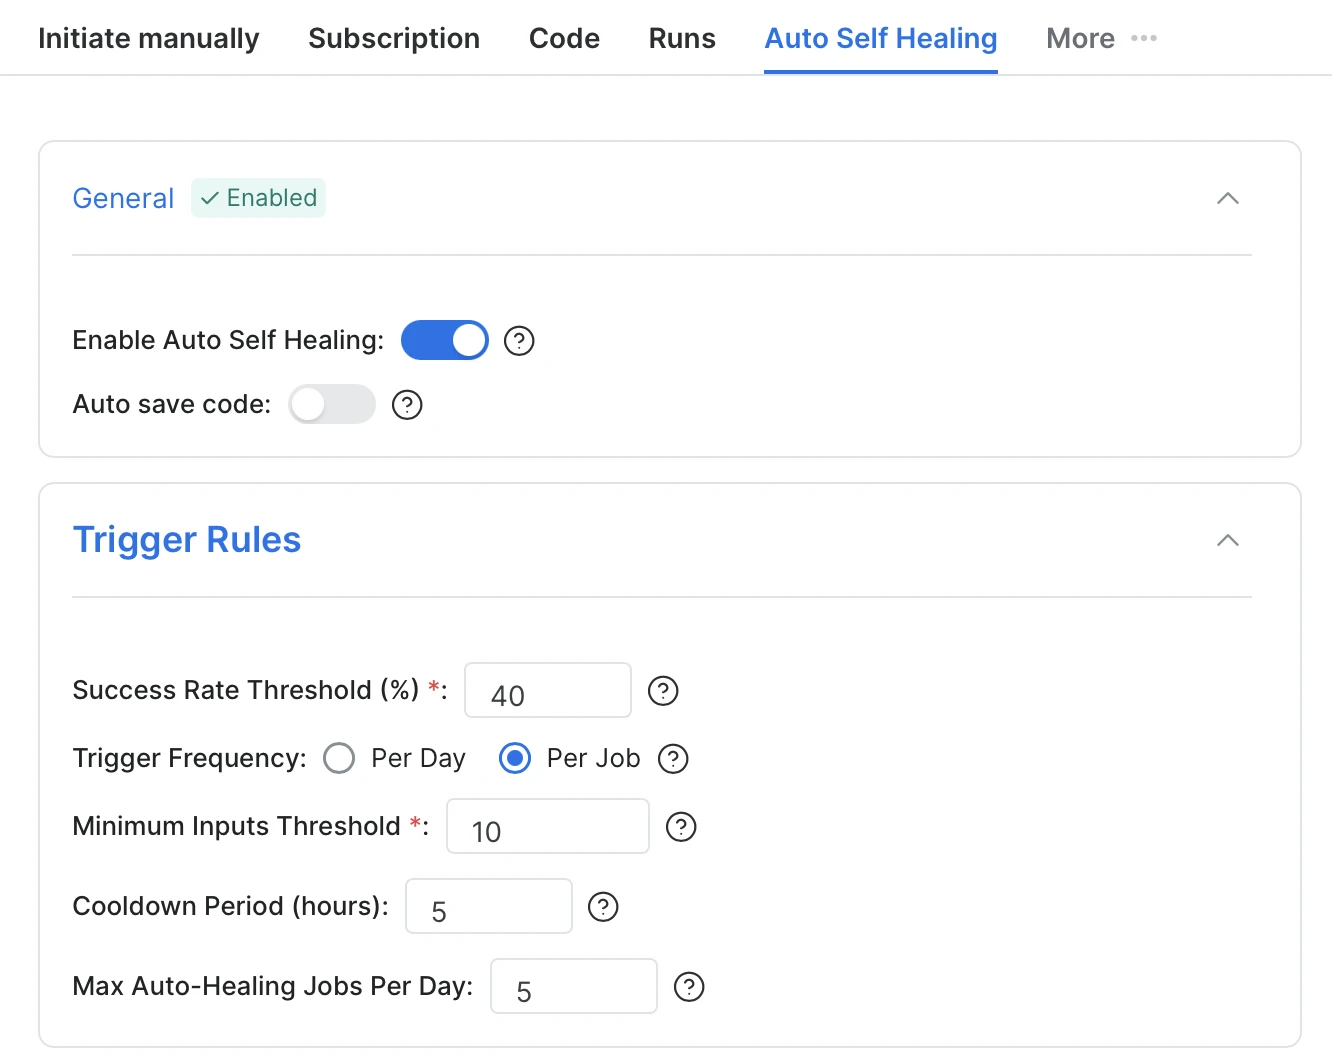
Otomatik Kendi Kendini İyileştirme'yi varsayılan tetikleyici kurallarıyla etkinleştirdik: iyileştirme, başarı oranı %40'ın altına düştüğünde başlar, her işin ardından ve en az 10 girdili çalıştırmalarda kontrol edilir. Otomatik kod kaydetmeyi kapalı bıraktık; böylece herhangi bir yeniden yazma onay bekler.
Ardından aynı URL'lerin arkasındaki sayfaları yeniden tasarladık; HTML'deki her değeri düz metin olarak bırakırken etiketleri ve sınıf adlarını değiştirdik. Sonraki çalıştırma 12 başarısız tarama ve %0 başarı bildirdi ve iyileştirme biz istemeden başladı.
İyileştirilen sürüm, aynı URL'lerde tüm kayıtları %100 oranında döndürdü.
Aynı URL'ler orijinal yerleşimde %100, yeniden tasarımın ardından %0 ve Otomatik Kendi Kendini İyileştirme toplayıcıyı yeniden yazdıktan sonra tekrar %100 puan aldı.
Bu, bir pipeline içinde tuttuğunuz kazıyıcılar için önemlidir: site yerleşimini değiştirdiğinde, oluşturduğunuz kazıyıcı, başarı oranı belirlediğiniz eşiğin altına düştüğü sürece kendini onarır ve çalışmaya devam eder.
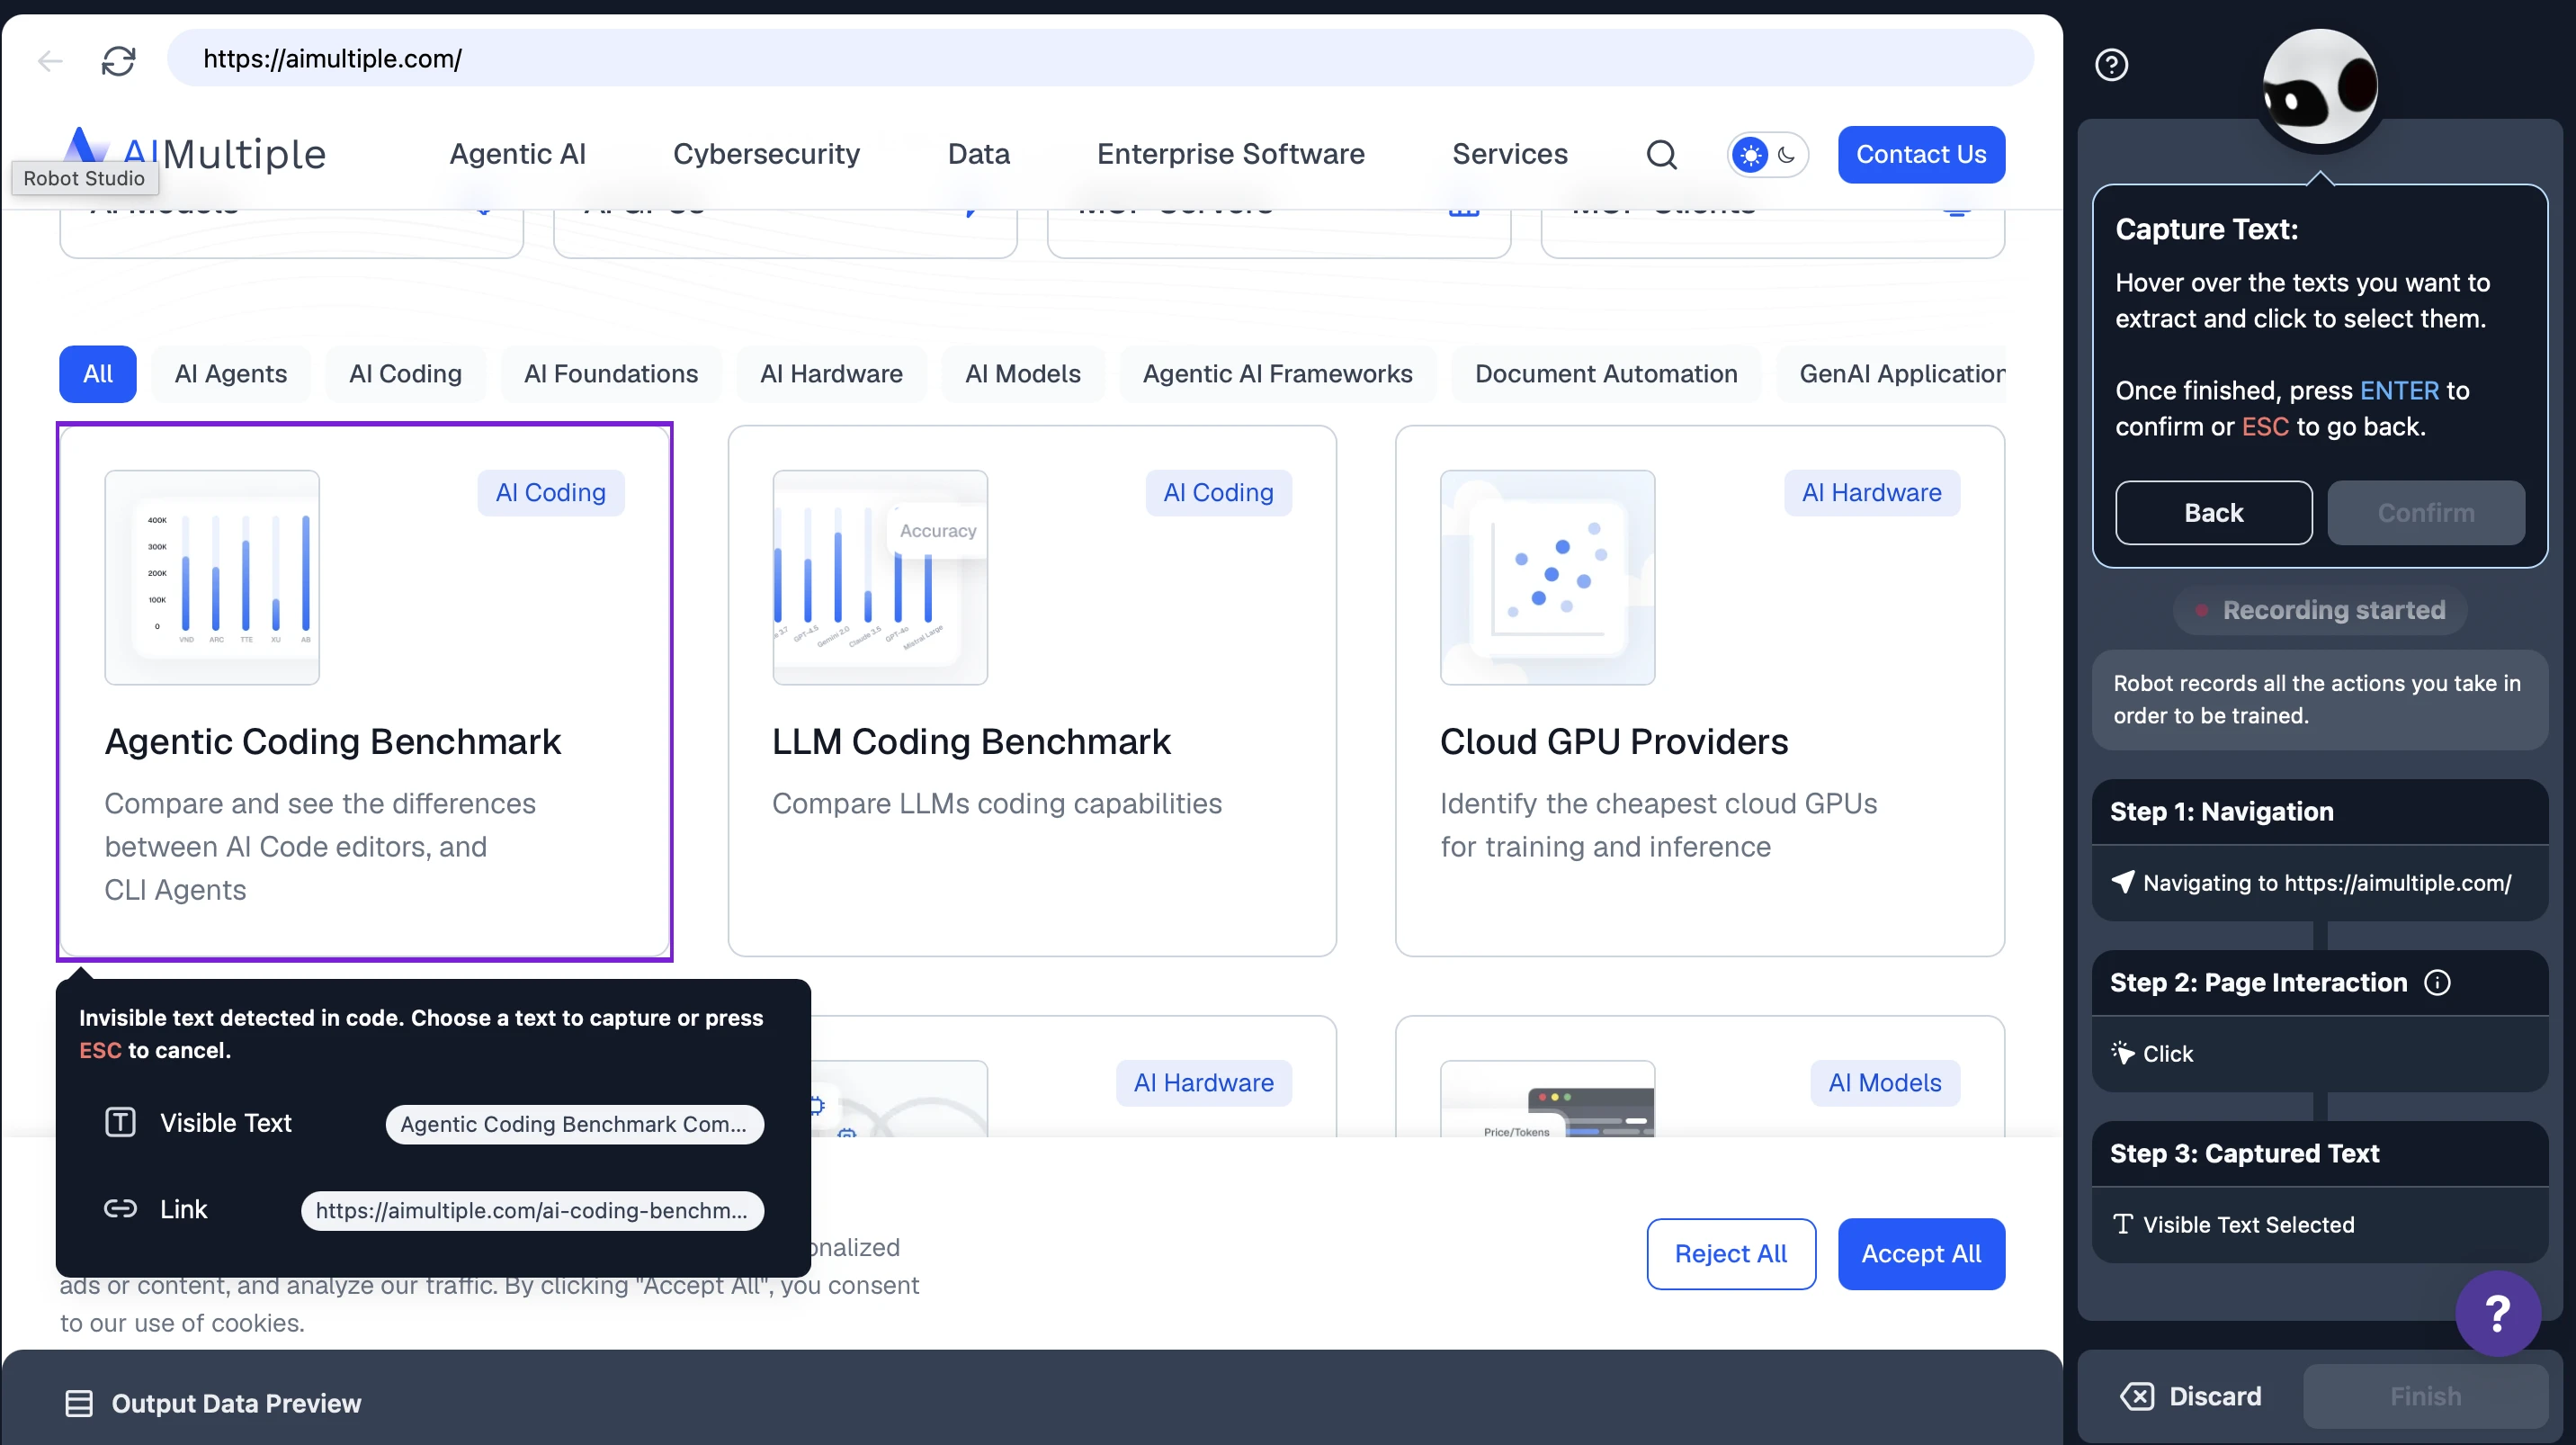
Browse AI, robot adı verilen kazıyıcıları görsel bir kayıttan oluşturur. Hedef sayfayı açar ve yakalanacak alanlara tıklarsınız. Robot, gezinme adımlarını ve seçilen alanları kayıt olarak saklar ve her çalıştırmada yeniden oynatır.
- Robot Studio ile görsel kurulum: Kazıyıcılar, tıkla → alanı yakala → kaydet akışıyla oluşturulur.
- Yerleşik izleme ve uyarı: Saatlik, günlük veya haftalık programlar, değişiklik algılama ve aynı üründe e-posta veya webhook uyarıları.
- Şema yakalanan alanlardan oluşturulur: Her alan için ayrı bir yakalama adımı eklenir; prompt'tan şemaya dönüşüm yoktur.
- Otomatik uyarlama: Browse AI'nın motoru, bir site değiştiğinde kazıma kodunu uyarlar ve çoğu robot müdahale olmadan çalışmaya devam eder. Uyarlama yeterli olmadığında robotu yeniden eğitirsiniz; bu, geçmişini, çalıştırmalarını ve iş akışlarını korur.
Kadoa, iş akışı adı verilen bir kazıyıcıyı bir prompt'tan oluşturur ve oluşturulan kod olarak saklar; böylece izlenecek ve onarılacak somut bir yapıt olur.
- Bir kez oluştur, çok kez çağır endpoint: Kayıtlı bir iş akışı kalıcı bir kimlik alır ve
PUT /v4/workflows/{id}/runile çağrılır. İstek yalnızca değişkenleri ve bir satır sınırını taşır; şema ve çıkarım kodu Kadoa tarafında kalır. Aynı iş akışını farklı bir URL'ye yönlendirmek önce metadata'sını güncellemek anlamına gelir; bu nedenle içinde URL bulunan tek bir çağrı değildir. - Prompt'tan tipli şemaya: Kurulum prompt'unda veriyi tanımlarsınız ve Kadoa, görsel veya JSON görünümünde düzenleyebileceğiniz bir şema önerir. Alanlar STRING, NUMBER, MONEY, DATE ve LINK gibi türler taşır ve anahtar olarak işaretlenebilir.
- Kendi kendini iyileştiren kayıtlı kazıyıcı: Onarım, bir planlamadan ziyade başarısız bir çalıştırmayla tetiklenir. Kadoa, aynı iş akışı kimliği altında çıkarım kodunu yeniden oluşturur ve önceden çıkarılan verilere karşı doğrular; böylece planlamalar ve entegrasyonlar çalışmaya devam eder. Düzeltme yayına girmeden önce onay adımı yoktur. Otomatik kurtarma başarısız olduğunda Kadoa'nın operasyon ekibine bir talep gider.
- Kodlama ajanı iş akışı: 40'tan fazla araca sahip barındırılan bir MCP sunucusu, ayrıca birinci taraf Node ve Python SDK'ları ve bir CLI (
kadoa create,kadoa run,kadoa export). - Teslimat: Çekme için API, SDK, CLI, MCP ve Google Sheets; itme için S3, GCS, Azure Blob, webhook'lar, WebSocket'ler, e-posta ve Slack; paylaşım için Snowflake ve Databricks. Bulut depolama bağlayıcıları self-servis yerine destek aracılığıyla kurulur.
Tek seferlik yapay zeka çıkarım API'leri
Tek seferlik yapay zeka çıkarım API'leri hiçbir kazıyıcı saklamaz. Her çağrı, bir URL'yi bir prompt veya şemayla birlikte gönderir; araç sayfayı getirir ve istek anında LLM çıkarımı çalıştırır. Oxylabs AI Studio, Apify'nin AI Web Scraper Actor'ü, Firecrawl ve ScrapingBee bu şekilde çalışır.
Oxylabs AI Studio, tek bir SDK (pip install oxylabs-ai-studio) altında beş ayrı yapay zeka uygulamasından oluşan bir pakettir: AiScraper, AiCrawler, BrowserAgent, AiSearch ve AiMap. Sunucu tarafında hiçbir şey kalıcı değildir; her kazıma çağrısı taze bir getirme artı LLM çıkarımı çalıştırır.
- AiScraper akışı: generate_schema(prompt=…) isteğe bağlı olarak bir JSON şeması üretmesi için LLM'i çağırır; ardından scrape(url, schema) sayfayı getirir ve LLM çıkarımını çalıştırır. Şemayı kendi tarafınızda tutabilir ve yeniden kullanabilirsiniz, ancak sunucu uzun ömürlü bir kazıyıcı kaydetmez.
- Beş uygulama, tek SDK: Tek URL'li yapılandırılmış çıkarım için AiScraper, prompt güdümlü site dolaşımı için AiCrawler, sayfa içi eylemler için BrowserAgent, doğal dilde arama artı çıkarım için AiSearch ve bir sitenin filtrelenmiş URL haritaları için AiMap.
- Çıktı biçimleri: markdown (varsayılan), json, csv, toon (token için optimize edilmiş bir biçim), screenshot ve html (yalnızca tarayıcı aracısı).
- Elle yazılmış şemalar:
generate_schemaisteğe bağlıdır.schemaparametresi yazdığınız herhangi bir JSON Şemasını alır ve Oxylabs'ın kendi örnekleri elle yazılmış bir Pydantic modeli geçirir. JSON, CSV ve TOON çıktısı için bir şema zorunludur. - Önemli parametreler: render_javascript=”otomatik”, JS oluşturmanın gerekip gerekmediğine hizmetin karar vermesini sağlar; geo_location proxy konumu için bir ISO ülke kodu veya adı alır ve max_credits istek başına harcama sınırı belirler.
Apify, "Actors" adı verilen yürütülebilir kazıma ve otomasyon programlarının platformunda oluşturulup çalıştırıldığı açık bir geliştirici ekosistemi sunar. Kendi Actor'ünüzü sıfırdan yazabilir, hazır bir şablondan başlayabilir veya başkalarının Apify Store'da yayınladığı Actor'ları kullanabilirsiniz.
- Yapay zeka çıkarım actor'ü: Apify ayrıca doğal dilde bir prompt alan ve herhangi bir URL'den yapılandırılmış JSON döndüren hazır bir apify/ai-web-scraper Actor'üne sahiptir. Prompt'u her çalıştırmada yeniden girersiniz ve JSON çıktısının çağrılar arasında tutarlı kalacağı garanti edilmez; bu, prompt güdümlü araçlar için yaygın bir davranıştır.
- Yalnızca prompt: Actor girişinin beş alanı vardır:
startUrls,extractionMode,prompt,maxPagesToVisitvemaxCrawlDepth. Kullanıcı tanımlı bir çıktı şeması için parametre yoktur. - Kendi actor'ünüzü oluşturun: Hedef siteniz için hazır bir kazıyıcı yoksa veya hiçbiri istediğiniz veri alanlarını kazımıyorsa, kendi Actor'ünüzü yazar ve hangi alanları extract edeceğinize, bunların sayfada nerede yaşadığına ve geri kalanını nasıl ele alacağınıza karar verirsiniz. Bunun ne kadar süreceği kodlama becerilerinize ve sitenin karmaşıklığına bağlıdır. Kendi başınıza oluşturmak istemezseniz Apify profesyonel hizmetlerinden de yardım alabilirsiniz.
- Önceden oluşturulmuş kazıyıcılarla birlikte: Apify Store, geliştiricilerin yayınladığı Actor'ları listeler. Popüler siteler için çoğu kazıyıcı üçüncü taraf geliştiriciler tarafından yayınlanır ve korunur.
- Platform hizmetleri: Actor'lar kutudan çıktığı gibi planlama, izleme, dataset depolama, proxy havuzu ve API erişimiyle gelir.
- Ajan erişimi: Apify'nin MCP sunucusu, bir kodlama ajanının Actor'ları aramasını ve çalıştırmasını sağlar; ancak ajan içinden bir Actor oluşturmak veya sürdürmek için yerleşik bir akışı yoktur.
- Bakım sahipliği: Actor'ü kendiniz oluşturduysanız, site değiştiğinde onu siz düzeltirsiniz. Store'dan bir tane kullanıyorsanız, düzeltmeyi Actor sahibinin kendi zaman çizelgesinde yayınlamasını beklersiniz.
Firecrawl, tek bir senkron çağrıda bir URL artı bir prompt veya JSON şemasını JSON'a dönüştürür. Her istek, çağrı yapıldığı anda çıkarım pipeline'ını çalıştırır.
- Prompt veya şema: Bir şema, çağrıdan önce alan adlarını ve türlerini sabitler; böylece yanıt yalnızca adlandırdığınız alanları içerir. Bir prompt ise yapıyı modele bırakır; yazması daha hızlıdır ancak çağrılar arasında değişebilir.
- Sayfa türü biçimleri:
product,menu,branding,audiovevideo, Firecrawl tarafından belirlenen sabit bir yapı döndürür.productbaşlık, fiyat, stok durumu, varyantlar ve indirimli fiyatı kapsar. Parametre almazlar ve LLM olmadan çalışırlar. deterministicJson: Bir şema alır ve site başına oluşturulan bir çıkarıcıyı önbelleğe alır; böylece tekrarlanan kazımalar LLM'i atlar.jsonbiçimiyle birleştirilemez.- İstek başına yürütme: Her çağrı kendi prompt'unu veya şemasını taşır ve istek anında çalışır; bu nedenle çıktı sayfayı o anki haliyle yansıtır ve önceden kaydedilecek hiçbir şey yoktur.
- Kodlama ajanı desteği: Resmî MCP sunucusu ve CLI; Claude Code, Cursor, Codex CLI ve Gemini CLI için hızlı başlangıçlar ve ayrıca resmî bir Claude eklentisi.
- Ajan: Firecrawl ayrıca URL'nin isteğe bağlı olduğu bir Agent ürünü sunar. Ne istediğinizi tanımlarsınız ve ajan onu bulmak için web'de gezinir.
ScrapingBee, Firecrawl gibi tek seferlik çıkarım API'sidir: her çağrı bağımsızdır ve hiçbir şey saklamaz. ScrapingBee, istediğiniz veriyi nasıl tanımladığınız konusunda farklılık gösterir.
- Üç çıkarım modu: Doğal dilde tek bir alan için ai_query (bir dize döndürür), her alanın kendi açıklamasına sahip olduğu bir JSON şeması için ai_extract_rules ve türler, enum'lar ve iç içe çıktı içeren aynı yaklaşımın gelişmiş bir biçimi.
- ai_selector: LLM'i sayfanın belirli bir bölümüne odaklamak için bir CSS seçici geçirin. Tam DOM'u okumasına izin vermekten daha hızlı ve daha doğrudur.
- Aynı çağrıda klasik kazıma: JS ağırlıklı siteler için render_js, screenshot, yapay zeka olmadan CSS/XPath çıkarımı için extract_rules ve tek bir zarfta HTML, cookie'ler, XHR'ler ve iframe'ler elde etmek için json_response.
Pipeline'ınız için doğru aracı nasıl seçersiniz?
Doğru araç, pipeline'ınızın aynı siteleri ne sıklıkta kazıdığına ve kazıyıcıyı kimin koruduğuna bağlıdır:
Tek seferlik veya ara sıra kazıma
Tek seferlik veya ara sıra kazıma için Firecrawl, ScrapingBee ve Oxylabs AI Studio gibi tek seferlik yapay zeka çıkarım API'leri en hızlı seçenektir. Her çağrıda bir prompt veya şema gönderirsiniz ve oluşturulacak kazıyıcı yoktur.
Bir pipeline içinde tekrarlanan kazıma
Tekrarlanan kazıma için veya özel veri alanlarına ihtiyaç duyduğunuzda, Bright Data Scraper Studio, Browse AI veya Kadoa gibi bir kez oluştur, çok kez çağır platformu daha uygundur. Saklanan kazıyıcı her çağrıda aynı şemayı döndürür ve pipeline'ınız yalnızca URL'leri iletir.
Kurulum ne kadar sürer
Oluşturma süresi yaklaşıma göre değişir. Sıfırdan bir kazıyıcı veya actor yazmak, tarayıcı, proxy bağlantısı ve yeniden denemeler size ait olduğu için genellikle günler ila haftalar sürer. Prompt tabanlı platformlar şemayı ve kodu dakikalar içinde oluşturur. Kayıt tabanlı araçlar da nokta ve tıklama kurulumu sayesinde dakikalar içinde tamamlanır. Tek seferlik yapay zeka çıkarım API'leri oluşturma adımını atlar; ilk yanıt tek bir HTTP çağrısıyla gelir.
Hazır bir kazıyıcı tarafından zaten kapsanan site
Popüler bir site için hazır bir kazıyıcı genellikle kendinizinkini oluşturmaktan daha hızlıdır; ancak onu kimin çalışır durumda tuttuğu nereden geldiğine bağlıdır. Bright Data'nınki gibi satıcı tarafından korunan bir kitaplık, site değiştiğinde satıcı tarafından güncellenir. Apify Store'daki çoğu popüler site Actor'ü gibi üçüncü taraf bir kazıyıcı ise sahibinin planlamasına göre düzeltilir.
Hazır hiçbir şeyle kapsanmayan site
Hazır bir kazıyıcısı olmayan siteler için soru, yerleşim değiştiğinde kazıyıcıyı kimin düzelteceğidir. Kendiniz oluşturursanız, onu siz korursunuz. Browse AI gibi kayıt tabanlı bir araçta robot çoğu değişikliğe kendiliğinden uyum sağlar; yapamadığında onu yeniden eğitirsiniz. Yapay zeka ile kendi kendini iyileştirmede araç, kayıtlı kazıyıcınızı aynı kimlik altında onarır: Bright Data düzeltmeyi yayına girmeden önce onayınıza gösterirken Kadoa otomatik olarak uygular.
Kodlama ajanlarıyla geliştirme
İş akışınız Claude Code, Cursor veya Codex üzerinden ilerliyorsa, aracın, ajanın uçtan uca yönetebileceği bir CLI veya MCP entegrasyonu sunup sunmadığı ya da ajanın yalnızca düz bir HTTP API'sini çağırıp çağıramayacağı önemlidir.
 Tercih edilen kaynak olarak ekle
Yapay zeka web kazıma benchmark metodolojisi
Benchmark alan adları:
Yapay zeka web kazıma benchmark'ındaki on alan adı, Semrush'un en çok ziyaret edilen siteler sıralamasından gelir. Beşi e-ticarettir (amazon, ebay, etsy, aliexpress, walmart) ve beşi sosyaldir (facebook, instagram, reddit, tiktok, x). Her birinden 500 URL, toplamda 5.000 URL topladık ve hepsini beş aracın tamamına gönderdik; bu da 25.000 istek eder.
Prompt'lar:
Her araç, belirli bir sayfa türü için hiçbir araca özel ayar yapılmadan tam olarak aynı prompt'u aldı:
- E-ticaret: Extract ürünün fiyatını ve para birimini çıkar ve json döndür
- Sosyal: Extract gönderi metnini, beğeni sayısını ve gönderinin yazar kullanıcı adını çıkar ve json döndür
Bright Data, prompt'u diğerlerinden bir adım önce alır. Her çağrıda bir prompt'tan kazımak yerine, prompt'u bir kez verirsiniz ve o bir kazıyıcı oluşturup tekrar çağıracağınız bir collector kimliği döndürür. Bu oluşturma adımı kazıma değildir; aracın bir API üretmesidir ve herhangi bir benchmark başlamadan önce alan adı başına bir kez gerçekleşir; bu nedenle sürelere dahil edilmez. Collector kimliğinden itibaren, sürecin diğer dördüyle eşleştiği noktadan ölçtük. Sıfır atış olarak kalması için Bright Data'nın oluşturduğu şema, API'den döndüğü haliyle hiçbir inceleme ve düzeltme olmadan otomatik kabul edildi.
Her araç, kendi API'sinin kurulduğu şekilde çağrıldı. Bright Data, Apify ve Firecrawl tek istekte URL listesi alacak şekilde tasarlandığından istek başına 100 URL gönderdik. Oxylabs ve ScrapingBee bu şekilde tasarlanmamıştır; onların API'leri teker URL alır; bu yüzden onları böyle çağırdık. Eşzamanlılık her araç için aynıydı: beş paralel istek.
Metrikler:
Başarı, istenen alanlardan en az birini döndüren isteklerin oranıdır. Boş dizeler, bir sayının yerine geçen sıfırlar ve prompt'u tekrar eden yanıtlar alan sayılmaz.
Eksiksizlik, istenen alanlardan kaçının döndüğünün istekler genelinde ortalamasıdır. Yalnızca yazarın geldiği bir sosyal sayfa üçte bir puan alır.
Doğruluk, doğru olan kontrol edilebilir değerlerin oranıdır. Aracın hiç döndürmediği bir alan yanlış sayılır; çünkü aşağı akışta eksik bir değer ile yanlış bir değer aynı maliyete sahiptir.
Her ölçüm alan adı başına hesaplanır, ardından on alan adının ortalaması alınır.
Doğru yanıtın belirlenmesi
İki yöntem kullandık. Temel doğrunun mevcut olduğu yerlerde ona karşı puanladık: bazı yanıtlar URL'nin kendisinde bulunur; örneğin bir x.com veya tiktok.com bağlantısındaki yazar kullanıcı adı. Diğerleri için ürün fiyatları ve Reddit oy sayıları gibi beş aracın dışında bağımsız bir referans topladık.
Temel doğrunun olmadığı yerlerde uzlaşıya göre puanladık. Bir alan yalnızca beş araçtan en az dördü bu şekilde yanıtladığında bu yöntemle kesinleşir. Ardından puanlanan aracı bir kenara koyar ve geri kalanına bakarız: aynı değer bunların yarısından fazlasında ve en az ikisinde görünüyorsa o değer referans olur. Bir araç kendi yanıtı üzerinde asla oy kullanmaz ve diğerlerinin üzerinde uzlaşamadığı bir alan doğruluk puanının dışında bırakılır.
Sayıların tam olarak eşleşmesi gerekmez. Bir değer, referansın %10'u içinde doğru sayılır; üzerine küçük bir mutlak taban eklenir; böylece 5 beğenili bir gönderi bir farkla başarısız olmazken 90.000 beğenili bir gönderi yine yüzdeye göre değerlendirilir.
Güven aralıkları
Tüm rakamlar, URL düzeyinde 10.000 bootstrap yeniden örneklemesinden elde edilen %95 güven aralıklarını taşır. Her sayının arkasındaki istek başına veriler sonuçlarla birlikte yayınlanır.
SSS'ler
Evet. Crawl4AI, Skyvern ve Browser Use gibi açık kaynak kitaplıklar kendi kendine barındırma için ücretsiz'dir ve Browse AI, Firecrawl ve Thunderbit dahil çoğu ticari araç, kullanım sınırları olan bir ücretsiz katman sunar.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{En İyi Yapay Zeka Web Kazıma Araçları Kıyaslandı}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Erişim tarihi: 14 Ekim 2026}
}25.1 bin veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 7 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
5 güncellemeEklendi: en iyi e-ticaret sitelerinde AI web kazıma araçlarını karşılaştıran bir kıyaslama bölümü.
Araç listesi Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern ve diğerlerinin adlandırılmış girdileriyle değiştirildi ve bir SSS bölümü eklendi.
Yapay zeka web kazıma araçlarına girişi, Otonom Yapay Zeka Ajanları, Vizyon Tabanlı Kazıma (VLM) ve Kendi Kendini Onaran kazıyıcıların açıklamasıyla değiştirdi.








Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.