


Görsel Muhakemede Multimodal AI Model'lerini Karşılaştırın

40 önde gelen multimodal AI model'lerini görsel muhakeme üzerinde 200 görsel tabanlı soru kullanarak benchmark ettik. Değerlendirme iki parkurdan oluştu: veri görselleştirme yorumlamayı test eden 100 grafik anlama sorusu ve örüntü tanıma ile uzamsal muhakemeyi ölçen 100 görsel mantık sorusu.
Görsel muhakeme benchmark'ı
Test prosedürlerimizi öğrenmek için benchmark metodolojimize bakın.
Her model görsel mantıkta grafiklerden daha düşük puan alıyor. Fark en küçük qwen3.8-flash için (%58 vs %78) ve en büyük claude-sonnet-4.5 için (%35 vs %77).
- gemini-4-argon her iki kategoride de en yüksek puana sahip: görsel mantıkta %62 ve grafik anlamada %87. Ayrıca %74,5 ile genel sıralamada birincidir; gemini-3.7-flash ve claude-opus-5.5’in (%73,5 her biri) 1 puan önündedir. Bu, 200 üzerinden 2 soruluk bir farktır; dolayısıyla ilk üç model birbirine birkaç soru mesafesindedir.
- gemini-3.5-flash-lite (%36,5) ve llama-4-maverick (%38,5) görsel mantık nedeniyle genel olarak son sıradadır. Bu sorularda doğru yanıt oranları sırasıyla %22 ve %19 olur; claude-haiku-4.5 ise %20 ile yanıtlar. Her üçü de beş seçenekle rastgele tahminin verdiği %20 civarındadır. Grafiklerde aynı üç model de %51 ile %61 arasında kalarak son sırada yer alır.
Maliyet & gecikme karşılaştırması
Benchmark soruları: LLM'lerin en çok başarılı olduğu ve en çok zorlandığı alanlar
En düşük LLM başarı oranına sahip grafik sorusu
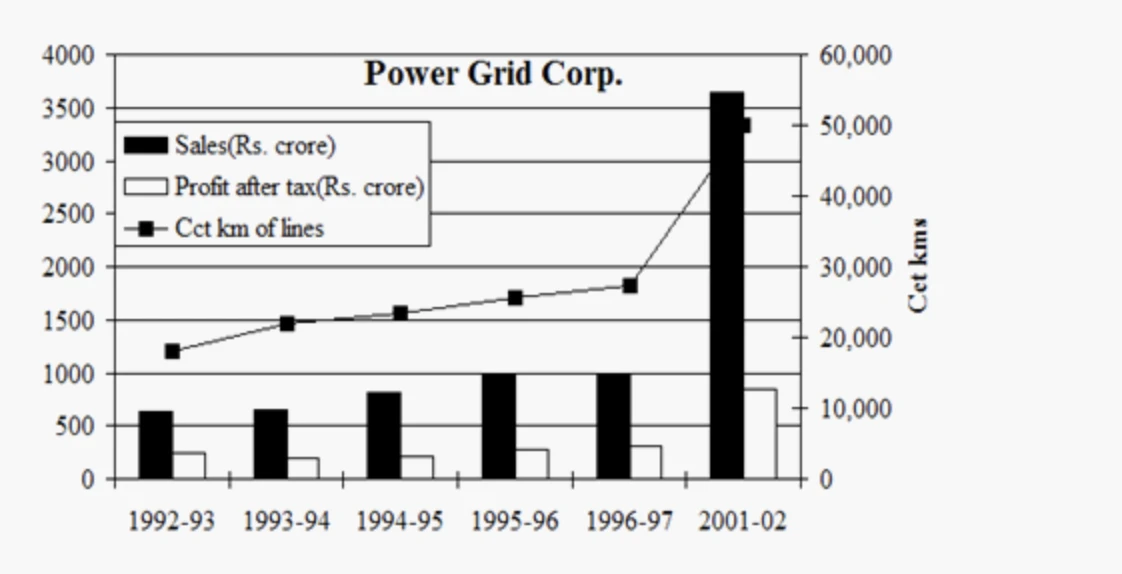
Şekil 1: Power Grid Corp. için Satışları (siyah çubuklar) ve vergi sonrası kârı (beyaz çubuklar) 1992-93 ile 1996-97 arası ve 2001-02 için gösteren, ikinci y ekseninde hatların devre km değerlerini veren çizgi içeren çubuk grafik.
Not: Tüm grafikler Hitbullseye'den alınmıştır.1
Soru: Kârlılık (Kâr / Satışlar) en yüksek şu dönemde: A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
40 modelden hiçbiri doğru yanıtlamadı (doğru yanıt D, 1996-97); 38 tanesi 1992-93 seçeneğini işaretledi. Hesaplama yılda tek bir bölme işleminden ibarettir; bu nedenle zorluk grafiği okumaktadır.
Kâr çubukları küçük ve beyazdır; 0-4.000 ekseninde yalnızca birkaç yüz crore, her 500 birimde kılavuz çizgileri bulunur. Yıllar arasındaki farklar birkaç piksele iner. İkinci y ekseni ve üzerine bindirilen çizgi karmaşa ekler. Model'ler bu kısa beyaz çubukları çok daha uzun siyah çubuklarla karşılaştırmak zorundaydı ve çubuk yüksekliğindeki küçük bir yanlış okuma yanıtı değiştirmeye yetiyordu.
En yüksek LLM başarı oranına sahip grafik sorusu
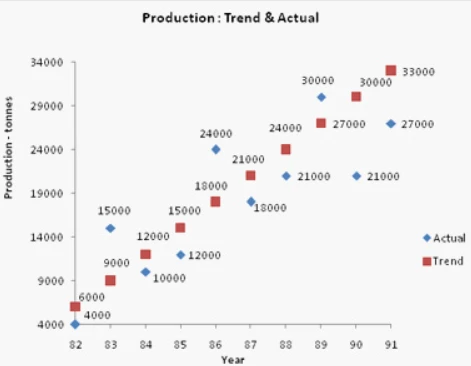
Şekil 2: 1982'den 1991'e kadar gerçek ve trend üretimi (ton cinsinden) gösteren dağılım grafiği. Mavi elmaslar gerçek değerleri, kırmızı kareler trend değerlerini işaret eder ve her nokta değeriyle etiketlenmiştir.
Soru: Trend şu şekilde belirlenmiştir: A. Bu yılın üretimi geçen yılın bir buçuk katıdır. B. Bu yılın üretimi geçen yılın iki katıdır. C. Bu yılın üretimi geçen yıldan üç bin ton daha fazladır. D. Bu yılın üretimi geçen yıldan dört bin beş yüz ton daha fazladır.
Model'lerin tümü bu soruyu doğru yanıtladı. Trend noktaları her yıl aynı miktarda artar (6.000, 9.000, 12.000 ve bu şekilde 33.000’e kadar). Her nokta değerini etiket olarak taşıdığından model'ler eksene göre konum tahmin etmek yerine sayıları doğrudan okuyabildi.
Power Grid grafiği küçük çubukların yüksekliklerini karşılaştırmayı gerektiriyordu. Burada yükseklik tahminine gerek yok: etiketler kesin değerleri veriyor ve geriye yalnızca basit bir çıkarma işlemi kalıyor.
En yüksek LLM başarı oranına sahip görsel mantık sorusu
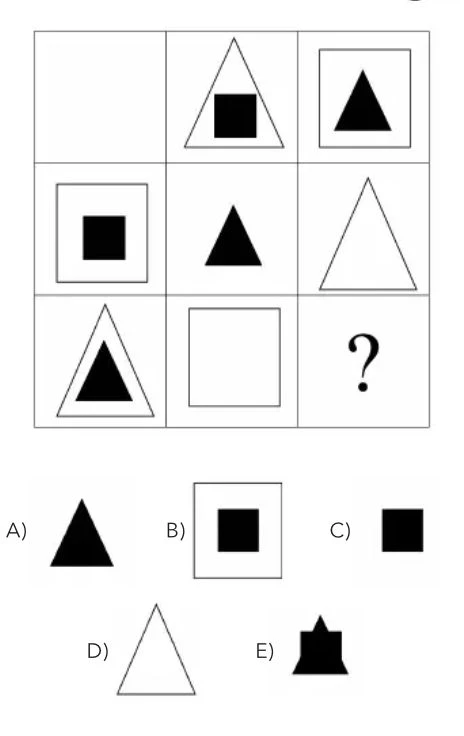
Şekil 4: 3×3'lük bir ızgarada her hücrede beyaz veya siyah üçgen ya da kare tek başına veya iç içe geçmiş olarak bulunur. Sağ alt hücre eksiktir ve beş seçenek verilmiştir.
Soru: Izgarayı hangi seçenek tamamlar?
38 tanesi, 40 model arasından doğru yanıtladı (doğru yanıt C, siyah bir kare). Yalnızca claude-haiku-4.5 ve llama-4-maverick kaçırdı. Her satır ve sütunda beyaz bir üçgen, beyaz bir kare, siyah bir üçgen ve siyah bir kare tam olarak bir kez bulunur. Eksik parça bu nedenle mevcut olanları listeleyerek bulunabilir.
Altıgen ızgarada kural, şekillerin bölgelere nasıl ayrıldığına bağlıydı. Burada her öğe, model'lerin tanıyıp sayabileceği ayrı ve net çizilmiş bir şekildir.
En düşük LLM başarı oranına sahip görsel mantık sorusu
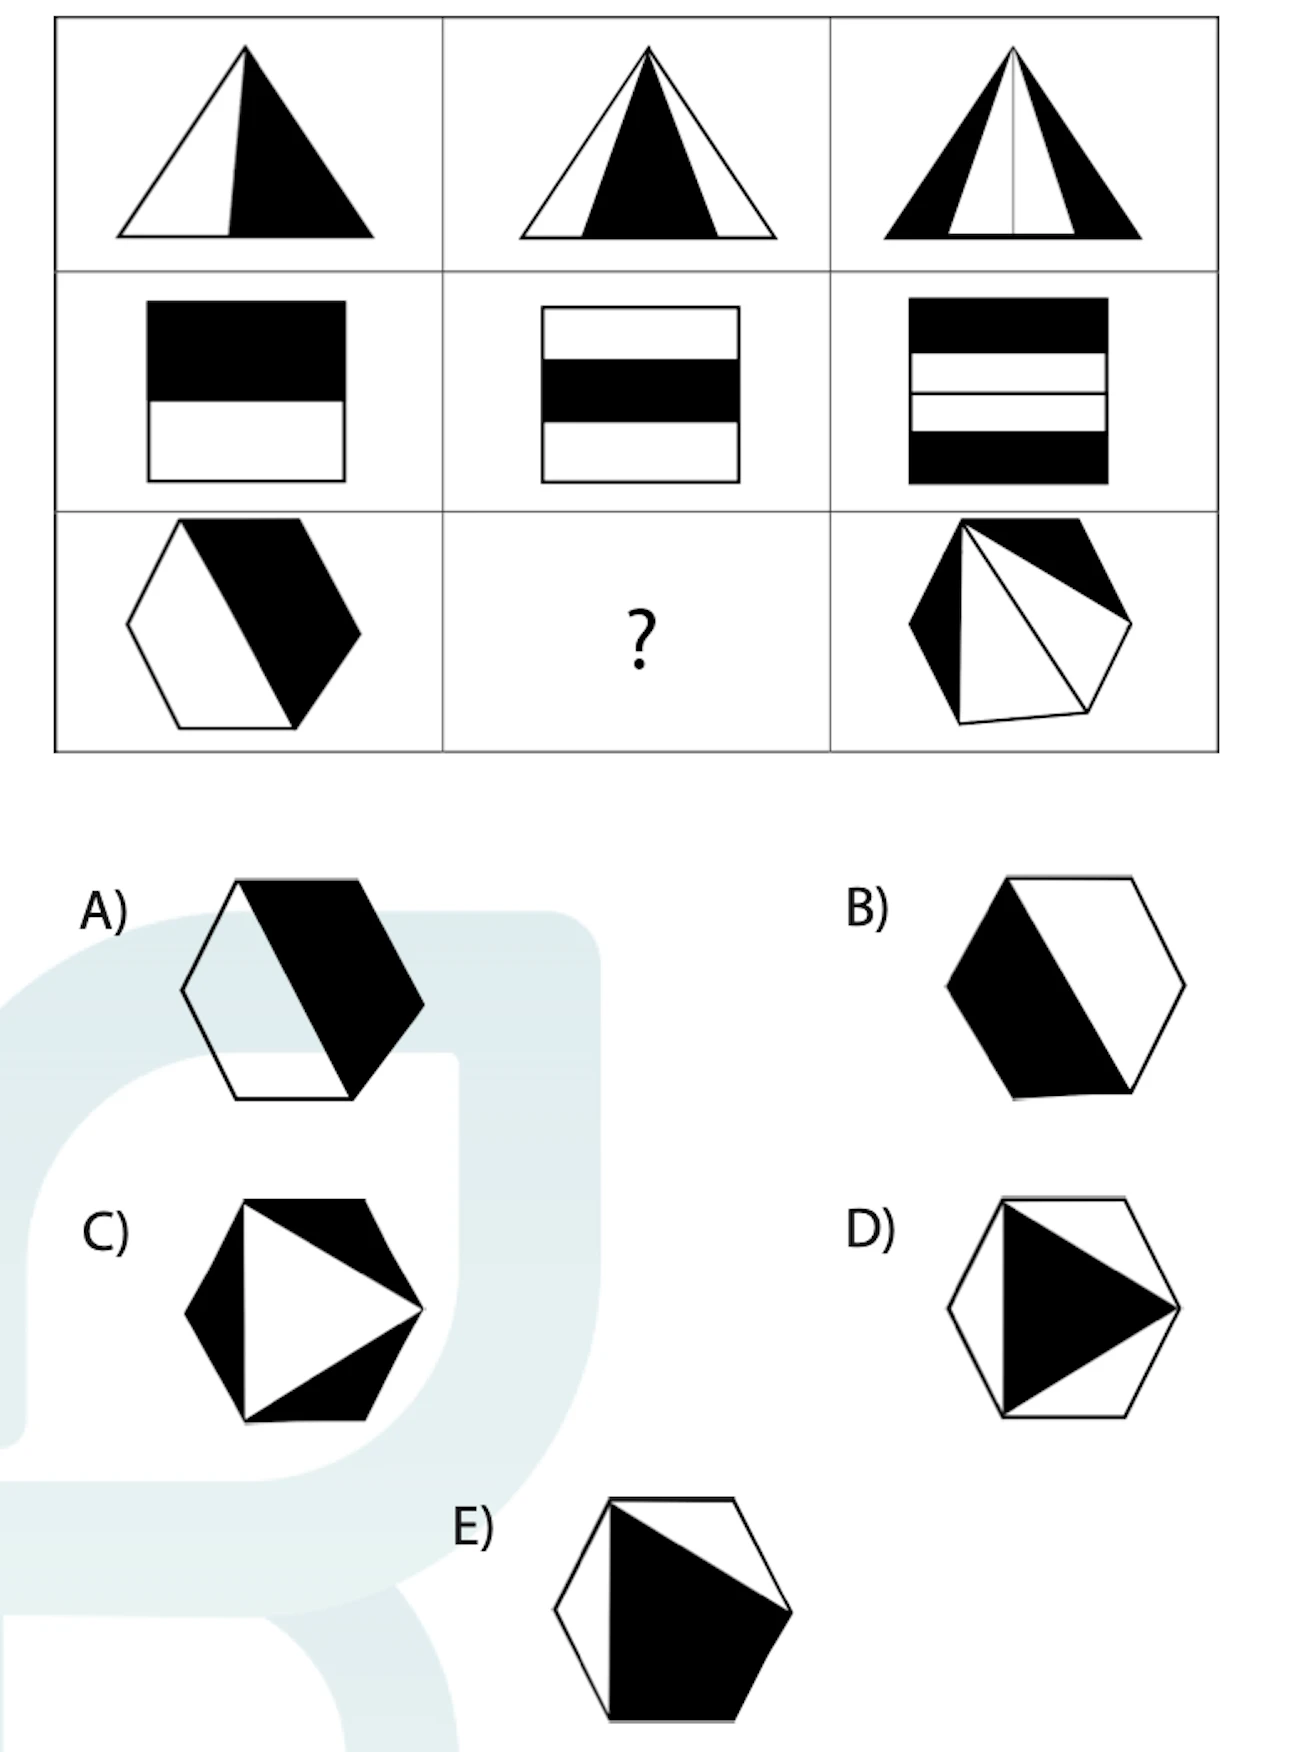
Şekil 3: 3×3'lük bir şekil ızgarası: ilk sırada üçgenler, ikinci sırada dikdörtgenler ve üçüncü sırada altıgenler yer alır. Her şekil siyah ve beyaz bölgelere ayrılmıştır ve ortadaki altıgen eksiktir. Seçenek olarak beş altıgen verilmiştir.
Soru: Izgarayı hangi seçenek tamamlar?
40 modelden hiçbiri doğru yanıtlamadı. Soruda sayı veya hesaplama yoktur; tek görev, siyah ve beyaz bölgelerin her satırda nasıl değiştiğini görmektir.
Benchmark metodolojisi
Görme yeteneğine sahip 40 model'i, 200 görüntü tabanlı çoktan seçmeli soru üzerinde değerlendirdik.
- Akıl Yürütme: Her model, desteklediği en yüksek akıl yürütme çabasına ayarlandı (modele bağlı olarak max, xhigh veya high). Bazı model'lerde akıl yürütme çabası parametresi kabul edilmedi; bu nedenle sağlayıcının varsayılanı uygulandı:
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro ve qwen3.8-flash varsayılan olarak yine de akıl yürüttü.claude-haiku-4.5 ve gemini-3.5-flash-lite hiç akıl yürütme token'ları üretmedi.kimi-k2.5 yalnızca 200 çağrısının 34’ünde akıl yürüttü.
- Sıcaklık: Ayarlanmadı; bu nedenle her sağlayıcının varsayılanı uygulandı.
- Maks token: Akıl yürütmeyi çıktı uzunluğunun sınırlamaması için 1.000.000 olarak ayarlandı. Bir sağlayıcı bu değeri reddederse modelin kendi maksimum çıktı sınırı kullanıldı.
- Çalıştırmalar: Her soru model başına bir kez çalıştırıldı; toplamda 7.600 çağrı yapıldı.
- Yeniden Denemeler: Başarısız çağrılar, 60 saniye arayla en fazla 3 kez yeniden denendi. 4 görsel mantık sorusunda muse-wonder hiç yanıt döndürmedi: sağlayıcısı her denemede yaklaşık 6.5 dakika sonra bağlantıyı kapattı. Bu 4 soru yanlış sayıldı; bu nedenle hiçbir soru hariç tutulmadı.
- Maliyet ve gecikme: Maliyet, ağ geçidinin her çağrı için bildirdiği faturalandırılan maliyettir. Gecikme, yeniden deneme beklemeleri hariç başarılı çağrının süresidir.
Benchmark, iki kategoride 200 sorudan oluştu: Grafik Anlama (100 soru) ve Görsel Mantık (100 soru). Grafik soruları, grafiği görüntü olarak, soruyu ve seçenekleri metin olarak gönderir. Görsel mantık soruları, seçenekler dahil tüm soruyu görüntünün içine yerleştirir. Çoğu grafik sorusunun dört seçeneği vardır (89 / 100), geri kalanında beş veya daha az seçenek bulunur. Görsel mantık sorularının beş seçeneği vardır (A-E).
Sorular:
- Grafik anlama (100 soru). Model'lerin veri görselleştirmelerinden bilgi extract etme, yorumlama ve analiz etme becerilerini değerlendirdik:
- Çubuk grafikler (40): tekli, gruplu ve çift eksenli çubuk grafikler
- Dağılım grafikleri (26): etiketli noktalardan değerleri ve trendleri okuma
- Pasta grafikler (14): yüzde dağılımları ve orantısal akıl yürütme
- Çizgi grafikler (10): zaman içinde tekli ve çok serili trendler
- Birleşik gösterimler (10): bir grafiğin ikinci bir grafik veya veri tablosuyla birlikte gösterilmesi
- Görsel mantık (100 soru). Soyut akıl yürütme ve uzamsal zekayı şu yollarla değerlendirdik:
- Örüntü tanıma: dizileri belirleme ve görsel örüntüleri tamamlama
- Uzamsal akıl yürütme: şekil dönüşümleri ve şekilleri üst üste bindirme
- Matematiksel mantık: sayısal örüntüler, cebirsel akıl yürütme ve kombinasyon bilimi
- Soyut düşünme: sembol manipülasyonu, mantıksal tümdengelim ve kural çıkarımı
 Tercih edilen kaynak olarak ekle
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Görsel Muhakemede Multimodal AI Model'lerini Karşılaştırın}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Erişim tarihi: 10 Haziran 2026}
}22.9 bin veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 4 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
6 güncellemeGörsel akıl yürütme karşılaştırma bölümündeki kıyaslanan model sayısını güncelledi.
Kıyaslama metodolojisindeki maksimum jeton parametre ayarı değiştirildi.
Referans Linkleri






Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.