


KI-Halluzinationserkennungs-Tools: W&B Weave & Comet

Wir haben drei Hallucination-Detection-Tools einem Benchmark unterzogen: W&B Weave HallucinationFree Scorer (Teil von CoreWeave Forge, ehemals Weights & Biases), Arize Phoenix HallucinationEvaluator und Comet Opik Hallucination Metric – über 100 Testfälle hinweg.
Jedes Tool wurde anhand von Genauigkeit, Präzision, Trefferquote und Latenz bewertet.
Benchmark der KI-Halluzinationserkennungs-Tools
Wir haben 100 Antworten (50 korrekt, 50 halluziniert) aus faktischen Q&A-Szenarien anhand ihres Quellkontexts getestet.
Vergleich von Genauigkeit und Latenz
Weitere Details zum Testverfahren finden Sie im Abschnitt Benchmark-Methodik.
W&B Weave und Arize Phoenix erzielten nahezu identische Genauigkeit mit 91 % bzw. 90 %. Beide Tools zeigten eine zuverlässige Leistung über das gesamte Dataset hinweg. Comet Opik lag mit einer Genauigkeit von 72 % zurück und klassifizierte nur 72 von 100 Tests korrekt – ein deutlicher Rückstand, der auf seinen konservativen Ansatz zurückzuführen ist.
In Bezug auf die Geschwindigkeit war Arize Phoenix mit 2 Sekunden pro Test der Sieger und eignet sich daher für Echtzeitanwendungen. W&B Weave verarbeitete Tests in 4 Sekunden, was für die meisten Produktionsanwendungen angemessen ist. Comet Opik war mit 8,5 Sekunden pro Test deutlich langsamer, was sich in latenzempfindlichen Anwendungen auf die Benutzererfahrung auswirken könnte.
F1-Score, Präzision und Trefferquote
Die F1-Scores (harmonisches Mittel aus Präzision und Trefferquote) bestätigten diese Muster: W&B Weave mit 90,5 % und Phoenix mit 89,4 % erzielten beide eine starke, ausgewogene Leistung. Opiks 61,1 % spiegelten dagegen den Zielkonflikt zwischen perfekter Präzision und schwacher Trefferquote wider. Opiks null falsch positive Ergebnisse gingen zulasten von 28 falsch negativen, weshalb es sich nur für Szenarien eignet, in denen Fehlalarme teurer sind als übersehene Erkennungen.
Die Trefferquote (Fähigkeit, tatsächliche Halluzinationen zu erkennen) zeigte unterschiedliche Strategien. W&B Weave führte mit einer Trefferquote von 86 % und erkannte 43 von 50 Halluzinationen, verpasste aber nur 7. Phoenix folgte knapp dahinter mit 84 % und erkannte 42 Halluzinationen, verpasste jedoch 8. Die Trefferquote von Comet Opik war mit 44 % deutlich niedriger: Es erkannte nur 22 Halluzinationen und verpasste 28; mehr als die Hälfte aller tatsächlichen Halluzinationen blieb unerkannt.
Die Präzision (Zuverlässigkeit der Warnungen) zeigte deutliche Unterschiede. Comet Opik erreichte eine perfekte Präzision von 100 % bei null falsch positiven Ergebnissen: Wenn es etwas als Halluzination markierte, war dies immer korrekt. Phoenix (95,5 %) und Weave (95,6 %) zeigten nahezu identische Präzision und produzierten jeweils nur 2 falsch positive Ergebnisse aus 50 legitimen Antworten, was eine hohe Zuverlässigkeit ohne übermäßige Konservativität belegt.
Faktoren, die Leistungsunterschiede beeinflussen könnten
Die beobachteten Leistungsunterschiede sind möglicherweise auf die Designphilosophie, die Schwellenwertauswahl und die Interpretation von Grounding zurückzuführen.
Unterschiede in Erkennungsstrategie und Optimierungszielen
- Die Tools scheinen eher auf unterschiedliche Fehler-Zielkonflikte als auf dasselbe Ziel optimiert zu sein.
- W&B Weave und Arize Phoenix streben eine ausgewogene Leistung an und halten eine hohe Präzision aufrecht, während sie dennoch die meisten Halluzinationen erkennen.
- Comet Opik verfolgt eine sehr konservative Strategie und priorisiert null falsch positive Ergebnisse, auch wenn viele Halluzinationen übersehen werden.
- Diese strategische Entscheidung erklärt unmittelbar Opiks perfekte Präzision und deutlich niedrigere Trefferquote.
Präzision-Trefferquote-Zielkonflikte im Tool-Design
- Comet Opiks null falsch positive Ergebnisse deuten auf einen strengen Entscheidungsschwellenwert hin, bei dem Halluzinationen nur markiert werden, wenn die Konfidenz sehr hoch ist.
- W&B Weave und Phoenix verwenden weniger restriktive Schwellenwerte und lassen einige falsch positive Ergebnisse zu, um eine deutlich höhere Trefferquote zu erzielen.
- Diese Schwellenwertunterschiede können zu Folgendem führen:
- Ähnliche Präzision bei Weave und Phoenix
- Große Unterschiede in der Trefferquote zwischen Opik und den beiden anderen Tools
- Entsprechende Unterschiede beim F1-Score und bei der Gesamtgenauigkeit
Variationen bei der LLM-as-a-judge-Implementierung
- Obwohl alle drei Tools einen LLM-as-a-judge-Ansatz verwenden, unterscheiden sich ihre Implementierungen.
- W&B Weave legt den Schwerpunkt auf Chain-of-Thought-Argumentation, was die Sensitivität für subtile, nicht belegte Behauptungen verbessern kann.
- Arize Phoenix integriert labelbasierte Ausgaben mit Konfidenzwerten und unterstützt so differenziertere Urteile.
- Comet Opik konzentriert sich auf binäre Entscheidungen mit hoher Konfidenz, was Fehlalarme reduziert, aber die Sensitivität für Grenzfälle bei Halluzinationen einschränkt.
Durch die Bewertungstiefe bedingte Latenzunterschiede
- Die geringere Latenz von Arize Phoenix deutet auf eine leichtere oder stärker optimierte Evaluierungs-Pipeline hin, die für den Echtzeiteinsatz geeignet ist.
- Die moderate Latenz von W&B Weave passt zu umfangreicherem Reasoning und Trace-Logging.
- Die höhere Latenz von Comet Opik spiegelt wahrscheinlich umfangreichere interne Reasoning- oder Verifikationsschritte wider, was das konservative Design unterstreicht.
KI-Halluzinationserkennungs-Tools
W&B Weaves HallucinationFree Scorer
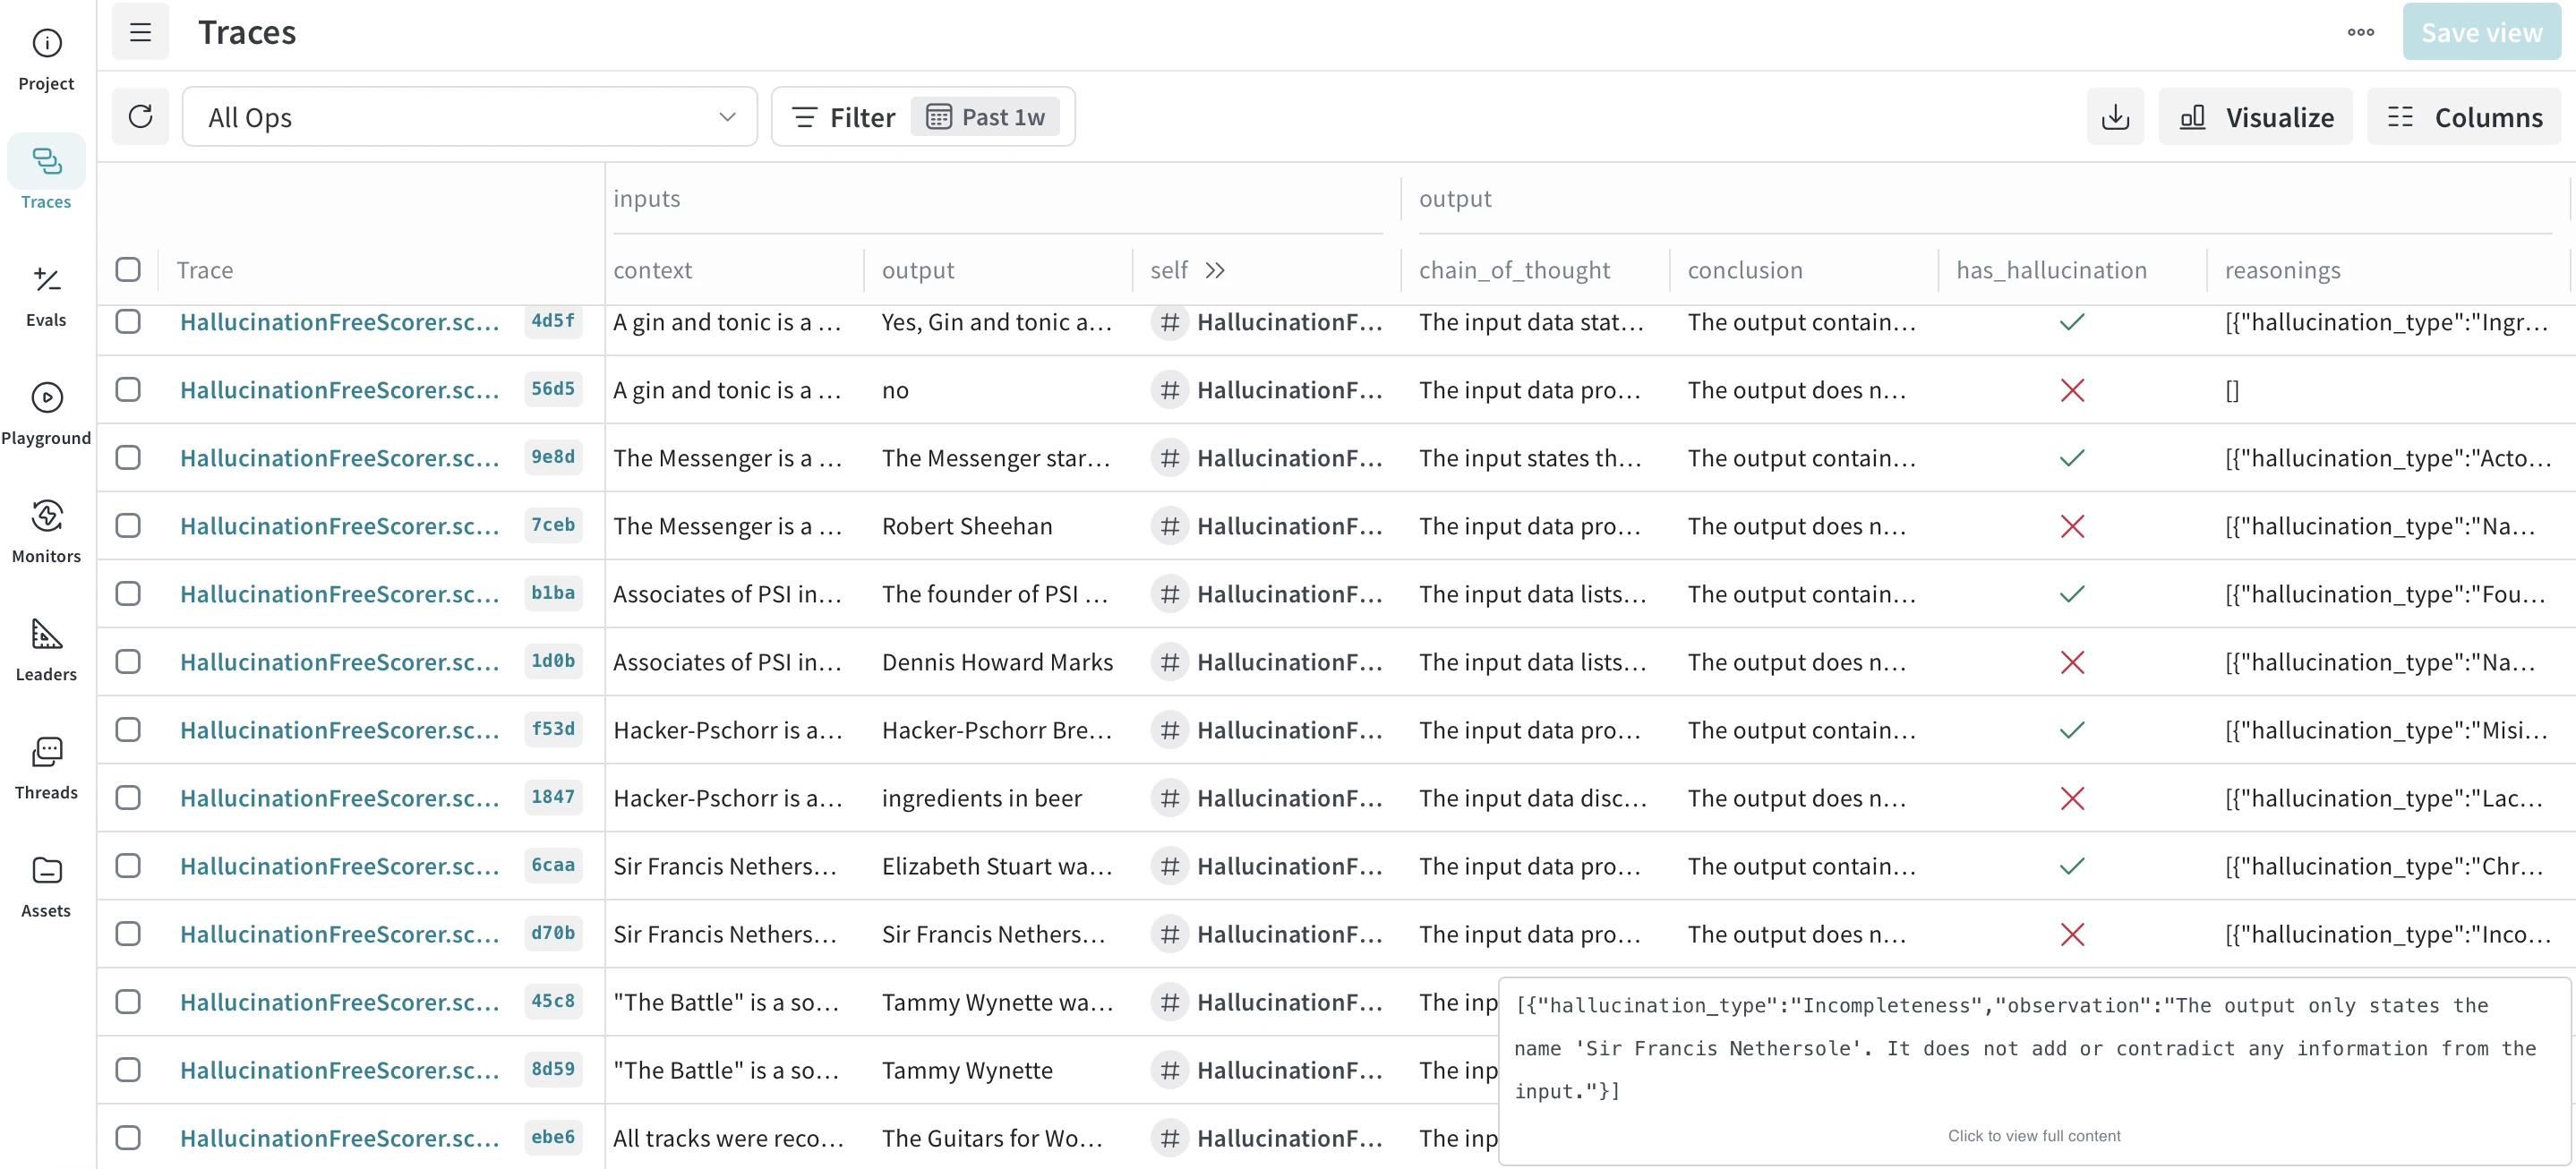
Abbildung 1: W&B Weaves Traces-Dashboard.
CoreWeave Forge wird mit einem HallucinationFree Scorer geliefert, der LLM-Ausgaben markiert, die Behauptungen enthalten, die nicht im Quellkontext vorkommen. Er führt einen LLM-Judge über jede Antwort aus und liefert ein Grounded/Ungrounded-Urteil zusammen mit der dahinterstehenden Begründung.
Der Scorer nimmt zwei Eingaben entgegen: den Kontext (Quellmaterial) und die Ausgabe (LLM-generierte Antwort). Anschließend verwendet er ein Language Model, um zu analysieren, ob die Ausgabe Informationen enthält, die nicht im Kontext vorhanden sind. Das Ergebnis enthält ein Boolesches Flag has_hallucination und eine Begründung, die Entscheidung erklärt.
Hauptmerkmale:
- Chain-of-Thought-Argumentation: Jede Auswertung enthält eine Erklärung, warum die Ausgabe als Halluzination markiert wurde oder nicht.
- Binäre Klassifikation: Liefert klare Wahr/Falsch-Entscheidungen mit unterstützenden Belegen.
- Integration mit Weave-Tracing: Ergebnisse werden automatisch im Weave-Dashboard protokolliert und visualisiert.
- Anpassbares Model: Unterstützt verschiedene LLM-Judges, darunter OpenAI, Anthropic und andere Anbieter.
Arize Phoenix’ HallucinationEvaluator
Arize Phoenix bündelt einen HallucinationEvaluator, der Antworten markiert, die von ihrem Referenzmaterial abweichen. Für jede Ausgabe entscheidet ein LLM-Judge, ob die Antwort im bereitgestellten Kontext verankert ist, und fügt seinem Urteil einen Konfidenzwert hinzu.
Der Evaluator nimmt drei Eingaben entgegen: die Nutzeranfrage (Input), den Referenztext (Kontext) und die Model-Antwort (Output). Er analysiert, ob die Antwort Informationen enthält, die nicht aus dem Kontext abgeleitet werden können, und liefert ein labelbasiertes Ergebnis („faktisch“ oder „halluziniert“) zusammen mit einer Erklärung und einem Konfidenzwert.
Hauptmerkmale:
- Ausgewogene Leistung: Liefert Ergebnisse sowohl bei den Metriken Präzision als auch Trefferquote.
- Labelbasierte Ausgabe: Gibt kategoriale Labels („faktisch“ oder „halluziniert“) statt nur numerischer Scores zurück.
- Detaillierte Erklärungen: Liefert eine Begründung für jede Evaluierungsentscheidung.
Comet Opiks Hallucination Metric
Comet Opiks Hallucination Metric bewertet jede LLM-Antwort anhand des Quellkontexts und liefert ein binäres Urteil darüber, ob die Ausgabe diesem Kontext treu bleibt. Die Prüfung läuft über einen LLM-Judge, der darauf abgestimmt ist, nur Fälle mit hoher Konfidenz zu markieren, in denen Behauptungen nicht belegt sind.
Die Metrik akzeptiert drei Eingaben: die Nutzeranfrage (Input), das Quellmaterial (Kontext) und die Model-Antwort (Output). Sie bewertet, ob die Ausgabe Behauptungen enthält, die nicht durch den Kontext gestützt werden.
Das Ergebnis enthält einen binären Score (0 für keine Halluzination, 1 für erkannte Halluzination) und eine detaillierte Begründung, die Bewertung erklärt.
Hauptmerkmale:
- Detaillierte Erklärungen: Jede Auswertung liefert eine umfassende Begründung, warum der Inhalt markiert oder freigegeben wurde.
- Analyse mit drei Eingaben: Berücksichtigt für die Bewertung Anfrage, Kontext und Antwort gemeinsam.
- Experiment-Tracking: Ergebnisse werden automatisch im Experiment-Tracking-System von Opik protokolliert.
- Konservativer Ansatz: Darauf ausgelegt, falsch positive Ergebnisse zu minimieren, indem nur Halluzinationen mit hoher Konfidenz markiert werden.
Galileo Luna-2
Galileo Luna-2 ist eine Hallucination-Detection- und Runtime-Guardrail-Schicht, die in Galileos breitere KI-Observability-Plattform integriert ist. 1
Das System ist darauf ausgelegt, inline in Produktions-Inference-Pfaden zu laufen und nicht fundierte Inhalte zu blockieren, bevor sie den Nutzer erreichen, während Signals, Galileos automatisierte Fehleranalyse-Ebene, Ursachen von Produktionsfehlern ohne manuelle Protokollprüfung aufdeckt.
Hauptmerkmale:
Multi-method detection: Kombiniert Embedding-Ähnlichkeit, Chain-of-Thought-Analyse und G-Eval-Faktizitätsbewertung, statt sich auf eine einzige Bewertungsstrategie zu verlassen.
Runtime-Guardrails: Luna-2 kann nicht fundierte Ausgaben inline im Inference-Pfad blockieren oder umschreiben, nicht nur nachträglich markieren.
End-to-End-Observability: Erfasst Eingaben, Ausgaben und interne Reasoning-Traces über mehrstufige Agenten-Workflows hinweg, wobei Signals die Ursachenanalyse automatisiert.
DeepEval
DeepEval ist ein Open-Source-LLM-Evaluierungs-Framework von Confident KI, das sich wie Pytest anfühlen soll, aber für LLM-Anwendungen gedacht ist. Seine HallucinationMetric verwendet einen LLM-as-a-judge, um zu entscheiden, ob die Model-Ausgabe sachlich mit dem bereitgestellten Kontext übereinstimmt, und das Framework ist dafür ausgelegt, in jeder CI/CD-Pipeline zu laufen.23
Die Metrik nimmt drei erforderliche Eingaben entgegen: die Nutzeranfrage (input), die Model-Antwort (actual_output) und das Referenzmaterial (context). Sie bewertet jede Ausgabe mit der Formel Hallucination = (Anzahl widersprüchlicher Kontexte) / (Gesamtzahl der Kontexte), wobei niedrigere Werte eine bessere Verankerung anzeigen. Eine Ausgabe gilt als bestanden, wenn ihr Wert bei oder unter dem konfigurierten Schwellenwert liegt.
Hauptmerkmale:
- Vertrauter Test-Workflow: Hallucination-Prüfungen werden wie normale Unit-Tests geschrieben und ausgeführt, sodass Teams, die bereits Pytest verwenden, kein neues Tool erlernen müssen.
- Anpassbare Strenge: Teams können den Bestehens-Schwellenwert lockern oder verschärfen oder für besonders kritische Inhalte in einen strikten Bestanden/Nicht-bestanden-Modus wechseln.
- Erklärungen für jedes Ergebnis: Jedes Urteil enthält eine Begründung, sodass klar ist, warum eine Ausgabe markiert wurde.
Was ist eine KI-Halluzination?
KI-Halluzinationen sind Ausgaben, die kohärent wirken, aber nicht faktenbasiert sind. Das Model erzeugt diese Behauptungen mit großer Sicherheit, auch wenn der Quellkontext oder die Trainingsdaten sie nicht stützen. Eine Übersichtsarbeit zu diesem Thema führt dies darauf zurück, dass Models sich eher auf sprachliche Vorannahmen stützen als auf überprüfbare Belege aus dem bereitgestellten Kontext.4 Das Problem tritt in besonders sensiblen Bereichen auf, etwa im Gesundheitswesen, in der Rechtsberatung, in der Unternehmenssuche und im Kundensupport, weshalb die Erkennung fundierter Ausgaben zu einem Standardbestandteil der LLM-Bereitstellung geworden ist.
Quellen und Taxonomie von Halluzinationen
Halluzinationen haben zwei Hauptquellen. Modellinterne Faktoren umfassen eine übermäßige Abhängigkeit von statistischen Mustern, Lücken in den Trainingsdaten und die probabilistische Natur der Sequenzgenerierung. Eine Analyse zur Erkennung und Eindämmung von Halluzinationen stellt fest, dass LLMs oft wahrscheinliche Fortsetzungen ableiten, anstatt überprüfbare Belege abzurufen, was zu selbstsicheren, aber falschen Ausgaben führt.5
Kontextbezogene Faktoren umfassen Abruf-Fehler in RAG-Systemen, mehrdeutige Prompts, unvollständige Verankerung und bei multimodale Models Objektverwechslungen oder erfundene Szenendetails.
Halluzinationserkennung in agentischen Workflows
Mehrstufige Agenten bringen Halluzinationsrisiken mit sich, die einstufige LLMs nicht haben: Eine erfundene Behauptung in einem frühen Schritt pflanzt sich in spätere Tool-Aufrufe, Abrufe und endgültige Ausgaben fort.
Zentrale Herausforderungen bei der agentischen Halluzinationserkennung:
- Fehlerfortpflanzung: Eine erfundene Tatsache in der Planungsphase kann Tool-Auswahl, Datenabruf und endgültige Antworten beeinflussen.
- Halluzinationen bei Tool-Aufrufen: Agenten können Tools mit falschen Parametern aufrufen oder Tool-Ausgaben falsch interpretieren.
- Zustandskorruption: Im Agentenspeicher abgelegte halluzinierte Informationen beeinflussen künftige Reasoningschritte.
- Zuordnungskomplexität: Die Identifizierung des Schritts, der die Halluzination eingeführt hat, erfordert End-to-End-Tracing.
Erkennungsansätze für agentische Systeme:
- Verifikation auf Schrittebene: Jede Zwischenausgabe wird validiert, bevor der Agent mit der nächsten Aktion fortfährt.
- Validierung von Tool-Ausgaben: Tool-Antworten werden mit erwarteten Formaten und bekannten Einschränkungen abgeglichen.
- Trajektorienanalyse: Die gesamte Abfolge der Agentenentscheidungen wird überprüft, um zu erkennen, wo das Reasoning von fundierten Informationen abgewichen ist.
- Konsistenzprüfungen über Schritte hinweg: Behauptungen aus verschiedenen Phasen werden verglichen, um Widersprüche zu erkennen.
W&B Weaves HallucinationFree Scorer und Arize Phoenix’ HallucinationEvaluator können bei jedem Agentenschritt angewendet werden, während ihre integrierten Dashboards den vollständigen Ausführungs-Trace für die Ursachenanalyse anzeigen.
 Als bevorzugte Quelle hinzufügen
Halluzinationsprävention in Echtzeit
Die Erkennung nach der Generierung macht Probleme sichtbar, verhindert aber nicht, dass schlechte Ausgaben die Nutzer erreichen. Die Echtzeit-Prävention führt die Prüfung inline aus, bevor die Antwort ausgeliefert wird.
Präventionsmechanismen:
- Output-Guardrails: Filter, die generierte Inhalte anhand von Faktizitätskriterien analysieren, bevor sie an den Nutzer zurückgegeben werden.
- Konfidenzschwellenwerte: Antworten werden blockiert oder markiert, wenn die interne Konfidenz des Models unter akzeptable Werte fällt.
- Abruf-Validierungs-Gates: Es wird überprüft, ob generierte Behauptungen durch abgerufene Dokumente gestützt werden, bevor die Antwort finalisiert wird.
- Fallback-Strategien: Eine sichere Standardantwort wird zurückgegeben oder es wird an Prüfwarteschlangen eskaliert, wenn das Halluzinationsrisiko hoch ist.
Tool-Funktionen für die Echtzeit-Prävention:
- W&B Weave integriert das Hallucination-Scoring in Produktions-Pipelines und ermöglicht automatisierte Prüfungen, bevor Antworten ausgeliefert werden.
- Arize Phoenix bietet Echtzeit-Monitoring mit Alerting-Funktionen, die risikoreiche Ausgaben zur sofortigen Überprüfung markieren.
- Comet Opik bietet Experiment-Tracking mit automatisierter Evaluierung, sodass Teams Qualitäts-Gates festlegen können, die Antworten blockieren, die Halluzinationsschwellenwerte überschreiten.
Ansätze zur Halluzinationserkennung
Drei Ansätze sind direkt relevant für die Funktionsweise von Weave, Phoenix und Opik:
1. Konsistenzbasierte Methoden
Konsistenzbasierte Methoden bewerten eine Antwort, indem sie mithilfe von semantischer Ähnlichkeit, n-Gramm-Überlappung oder Frage-Antwort-Verifikation mit mehreren alternativen Generierungen vergleichen. Wenn sich Antworten gegenseitig widersprechen oder logische Inkonsistenzen enthalten, steigt die Wahrscheinlichkeit einer Halluzination. Eine verwandte Technik, die semantische Entropie, gruppiert Antworten nach Bedeutung statt nach Formulierung und nutzt konzeptuelle Instabilität als Halluzinationssignal.
2. Wahrscheinlichkeits- und konfidenzbasierte Erkennung
Token-bezogene Wahrscheinlichkeiten, Entropiewerte, Kalibrierungskurven und margenbasierte Konfidenzschätzungen machen die interne Einschätzung des Models über seine eigene Ausgabe sichtbar. Segmente mit geringer Konfidenz korrelieren oft mit höheren Halluzinationsraten. Rohe Entropie kann aufgrund variabler Formulierungen irreführend sein, aber Konfidenzsignale bleiben in Kombination mit konsistenzbasierten Indikatoren nützlich. Arize Phoenix gibt neben seinem Label auch einen Konfidenzwert aus, was in diese Kategorie passt.
3. Referenz- oder kontextbasierte Erkennung
Die referenzbasierte Evaluierung vergleicht die Model-Ausgabe mit dem bereitgestellten Kontext oder externen Quellen und ist der Kernmechanismus hinter Qualitätsprüfungen für RAG. Typische Techniken umfassen Entailment-Modelle, die prüfen, ob abgerufene Dokumente die Antwort stützen, Alignment- und Grounding-Methoden, die Evidenzunterstützung validieren, sowie Faktizitätsmetriken, die messen, ob Behauptungen mit dem unterstützenden Text übereinstimmen. Alle drei im Benchmark untersuchten Tools arbeiten hauptsächlich in diesem Modus: Sie nehmen einen Kontext-Input entgegen und beurteilen, ob die Ausgabe innerhalb dieses Kontexts bleibt.
KI-Halluzinationserkennungstechniken und -algorithmen
Erkennungsmethoden arbeiten auf drei Granularitätsebenen:
- Token-Ebene: Markiert verdächtige Abschnitte innerhalb einer Ausgabe. Verwendet menschlich annotierte Halluzinations-Datasets, Divergenzen zwischen Prior- und Posterior-Token-Wahrscheinlichkeiten bei gegebenem Kontext oder Sequence-Labeling-Klassifikatoren.
- Satzebene: Beurteilt ganze Aussagen. Samplingbasierte Selbstkonsistenzprüfungen vergleichen mehrere Generierungen auf Instabilität, semantische Entropie markiert konzeptuelle Unsicherheit ohne Labels, und Entailment-Klassifikatoren erkennen unbelegte oder widersprüchliche Behauptungen.
- Workflow-Ebene: Verfolgt mehrstufige Pipelines anhand von Provenienzgraphen, Entailment-Prüfungen auf Schrittebene, Validierung von Zwischen-Reasoning und Abhängigkeits-Tracing für mehrstufige Aufgaben.
Die drei von uns im Benchmark untersuchten Tools arbeiten hauptsächlich auf Satzebene, wobei Weave und Phoenix über ihre Tracing-Dashboards auch die Workflow-Ebene erreichen.
Industrielle Muster und Best Practices
Produktionsteams verlassen sich selten auf eine einzige Methode. Zu den gängigen Mustern gehören:
- Mehrschichtige Erkennung: Konsistenzprüfungen, Wahrscheinlichkeits-Scoring und Entailment-Validierung laufen in derselben Pipeline.
- Echtzeit-Monitoring: Dashboards verfolgen Drift und Konfidenzverschiebungen im Zeitverlauf.
- Prompt-Tuning: Prompts werden verfeinert, um Mehrdeutigkeiten zu reduzieren, die zu nicht fundierten Ausgaben führen.
- Expertenprüfung: Vorbehalten für rechtliche, medizinische oder finanzielle Inhalte, bei denen Fehler reale Kosten verursachen.
- CI/CD-Integration: Automatisierte Qualitätsprüfungen laufen vor der Bereitstellung, damit Regressionen früh erkannt werden.
- Agenten-Monitoring: Plugins beobachten Tool-Aufrufe und Zwischen-Reasoningschritte, um Anomalien zu erkennen, sobald sie auftreten.
Methodik des Benchmarks der KI-Halluzinationserkennungs-Tools
Der Benchmark verwendete ein kontrolliertes Dataset mit 50 Wissenselementen aus faktischen Frage-Antwort-Szenarien. Jedes Element enthielt einen Quellkontext, eine Frage, eine in diesem Kontext fundierte korrekte Antwort und eine halluzinierte Antwort mit erfundenen Informationen. Beispielsweise fragte ein Test nach dem Standort des Hauptsitzes der Oberoi Group, wobei die korrekte Antwort „Delhi“ gegen die halluzinierte Antwort „Mumbai“ getestet wurde.
Jedes Wissenselement erzeugte zwei Testfälle: einen mit der korrekten Antwort (erwartet: keine Halluzination) und einen mit der halluzinierten Antwort (erwartet: Halluzination erkannt). Dadurch entstand eine ausgewogene 50/50-Aufteilung mit insgesamt 100 Testfällen. Alle drei Tools verarbeiteten dieselben Testfälle nacheinander und erhielten jeweils identische Eingaben (Kontext, Frage und Ausgabe).
Wir haben die Latenz für jeden Testfall einzeln gemessen, um einen fairen Vergleich zu gewährleisten und die Fallstricke paralleler Verarbeitung oder Batch-Evaluierung zu vermeiden, die Ergebnisse verzerren könnten. Die Ground-Truth-Labels wurden manuell überprüft, um die Genauigkeit bei der Berechnung von True Positives, False Positives, True Negatives und False Negatives sicherzustellen.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{KI-Halluzinationserkennungs-Tools: W&B Weave & Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Abgerufen am 18. Juni 2026}
}Ergebnisse und Zeitstempel von 0 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 0 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
3 AktualisierungenGalileo Luna-2 und DeepEval als neue Tool-Abschnitte neben den getesteten Halluzinationserkennungs-Tools hinzugefügt.
„Hallucination detection in agentic workflows“ wurde dem Abschnitt „What is AI hallucination?“ hinzugefügt.
Referenzlinks
Zuvor arbeitete sie als Personalvermittlerin in Projektmanagement- und Beratungsunternehmen. Sıla hat einen Master of Science in Sozialpsychologie und einen Bachelor of Arts in Internationalen Beziehungen.







Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.