


Principales herramientas de LLMOps y compáralas con MLOps

Las plataformas de LLMOps gestionan el aspecto operativo de la ejecución de large language models: despliegue, monitoreo, evaluación y gestión de costes.
Examinamos las principales herramientas de LLMOps, sus funciones clave, sus pricing models y en qué se diferencian entre sí para ayudar a identificar la mejor opción para distintos casos de uso.
Comparación de herramientas de LLMOps
Herramienta | Evaluación | Seguimiento de costes | Fine-tuning | Ingeniería de prompts | Construcción de pipelines | BLEU / ROUGE | Almacenamiento y versionado de datos |
|---|---|---|---|---|---|---|---|
✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
MLflow | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
Lamini AI | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✕ |
TrueFoundry | ✓ | ✓ | ✓ | ✕ | ✓ | ✓ | ✕ |
Deepset AI | ✕ | ✕ | ✓ | ✓ | ✓ | ✕ | ✓ |
Nemo by NVIDIA | ✓ | ✕ | ✓ | ✓ | ✕ | ✓ | ✕ |
Fine-Tuner AI | ✓ | ✕ | ✓ | ✓ | ✕ | ✕ | ✓ |
ZenML | ✓ | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ |
Snorkel AI | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ | ✓ |
Comet | ✓ | ✓ | ✕ | ✕ | ✕ | ✓ | ✕ |
A continuación se ofrece un desglose de cada métrica:
- Evaluación: Algunas herramientas de LLMOps incluyen capacidades integradas para evaluar los outputs de los models según criterios específicos de cada tarea, mientras que otras dependen de frameworks externos para un análisis más personalizado o profundo.
- Seguimiento de costes: El análisis detallado de costes y la supervisión de los recursos utilizados durante el entrenamiento y la inference están soportados directamente por algunas herramientas o se logran mediante integraciones.
- Fine-tuning: Algunas herramientas de LLMOps realizan el fine-tuning de large language models ellas mismas, mientras que otras se centran en gestionar u orquestar el proceso de fine-tuning.
- Ingeniería de prompts: El diseño y la optimización de prompts lo gestionan directamente algunas herramientas, pero la mayoría proporciona infraestructura para respaldarlo en lugar de hacerlo por sí mismas.
- Construcción de pipelines: Ciertas herramientas automatizan flujos de trabajo LLM de extremo a extremo, incluida la preparación de datos, el entrenamiento y la evaluación. Mientras tanto, otras permiten la creación de pipelines mediante integraciones.
- BLEU / ROUGE: BLEU y ROUGE son métricas comunes de evaluación del lenguaje que se utilizan para evaluar la calidad del texto; algunas herramientas las soportan de forma nativa, mientras que otras dependen de bibliotecas externas.
- Almacenamiento y versionado de datos: El almacenamiento seguro y el seguimiento de versiones de los datos de entrenamiento son gestionados directamente por algunas herramientas, mientras que otras se integran con soluciones de almacenamiento/versionado de terceros.
¿Qué son las plataformas de LLMOps?
Las plataformas de LLMOps soportan el ciclo de vida de los LLMs al permitir:
- Fine-tuning
- Versionado
- Despliegue
- Monitoreo
- Gestión de prompts y experimentos
Las plataformas de LLMOps varían en su enfoque:
- No-code/Plataformas low-code: fáciles de usar pero menos flexibles.
- Code-first/Plataformas orientadas a ingeniería: requieren habilidades técnicas pero ofrecen mayor personalización.
Las herramientas de LLMOps pueden agruparse en tres categorías principales:
1. Plataformas de MLOps que se extienden a LLMOps
Algunas plataformas de Machine Learning Operations (MLOps) incluyen kits de herramientas especializados adaptados para las operaciones de large language models (LLMOps).
MLOps es la disciplina centrada en orquestar todo el ciclo de vida del machine learning, desde el desarrollo hasta el despliegue y el mantenimiento. Dado que los LLMs también son machine learning models, los proveedores de MLOps están expandiéndose naturalmente a este ámbito.
CoreWeave Forge
CoreWeave Forge, anteriormente Weights & Biases, es una plataforma de MLOps que se expandió a LLMOps a través de W&B Weave. Originalmente centrada en el seguimiento de experimentos y el monitoreo de models para ML tradicional, la plataforma añadió capacidades de LLM a medida que estos models se volvieron centrales para el desarrollo de IA.
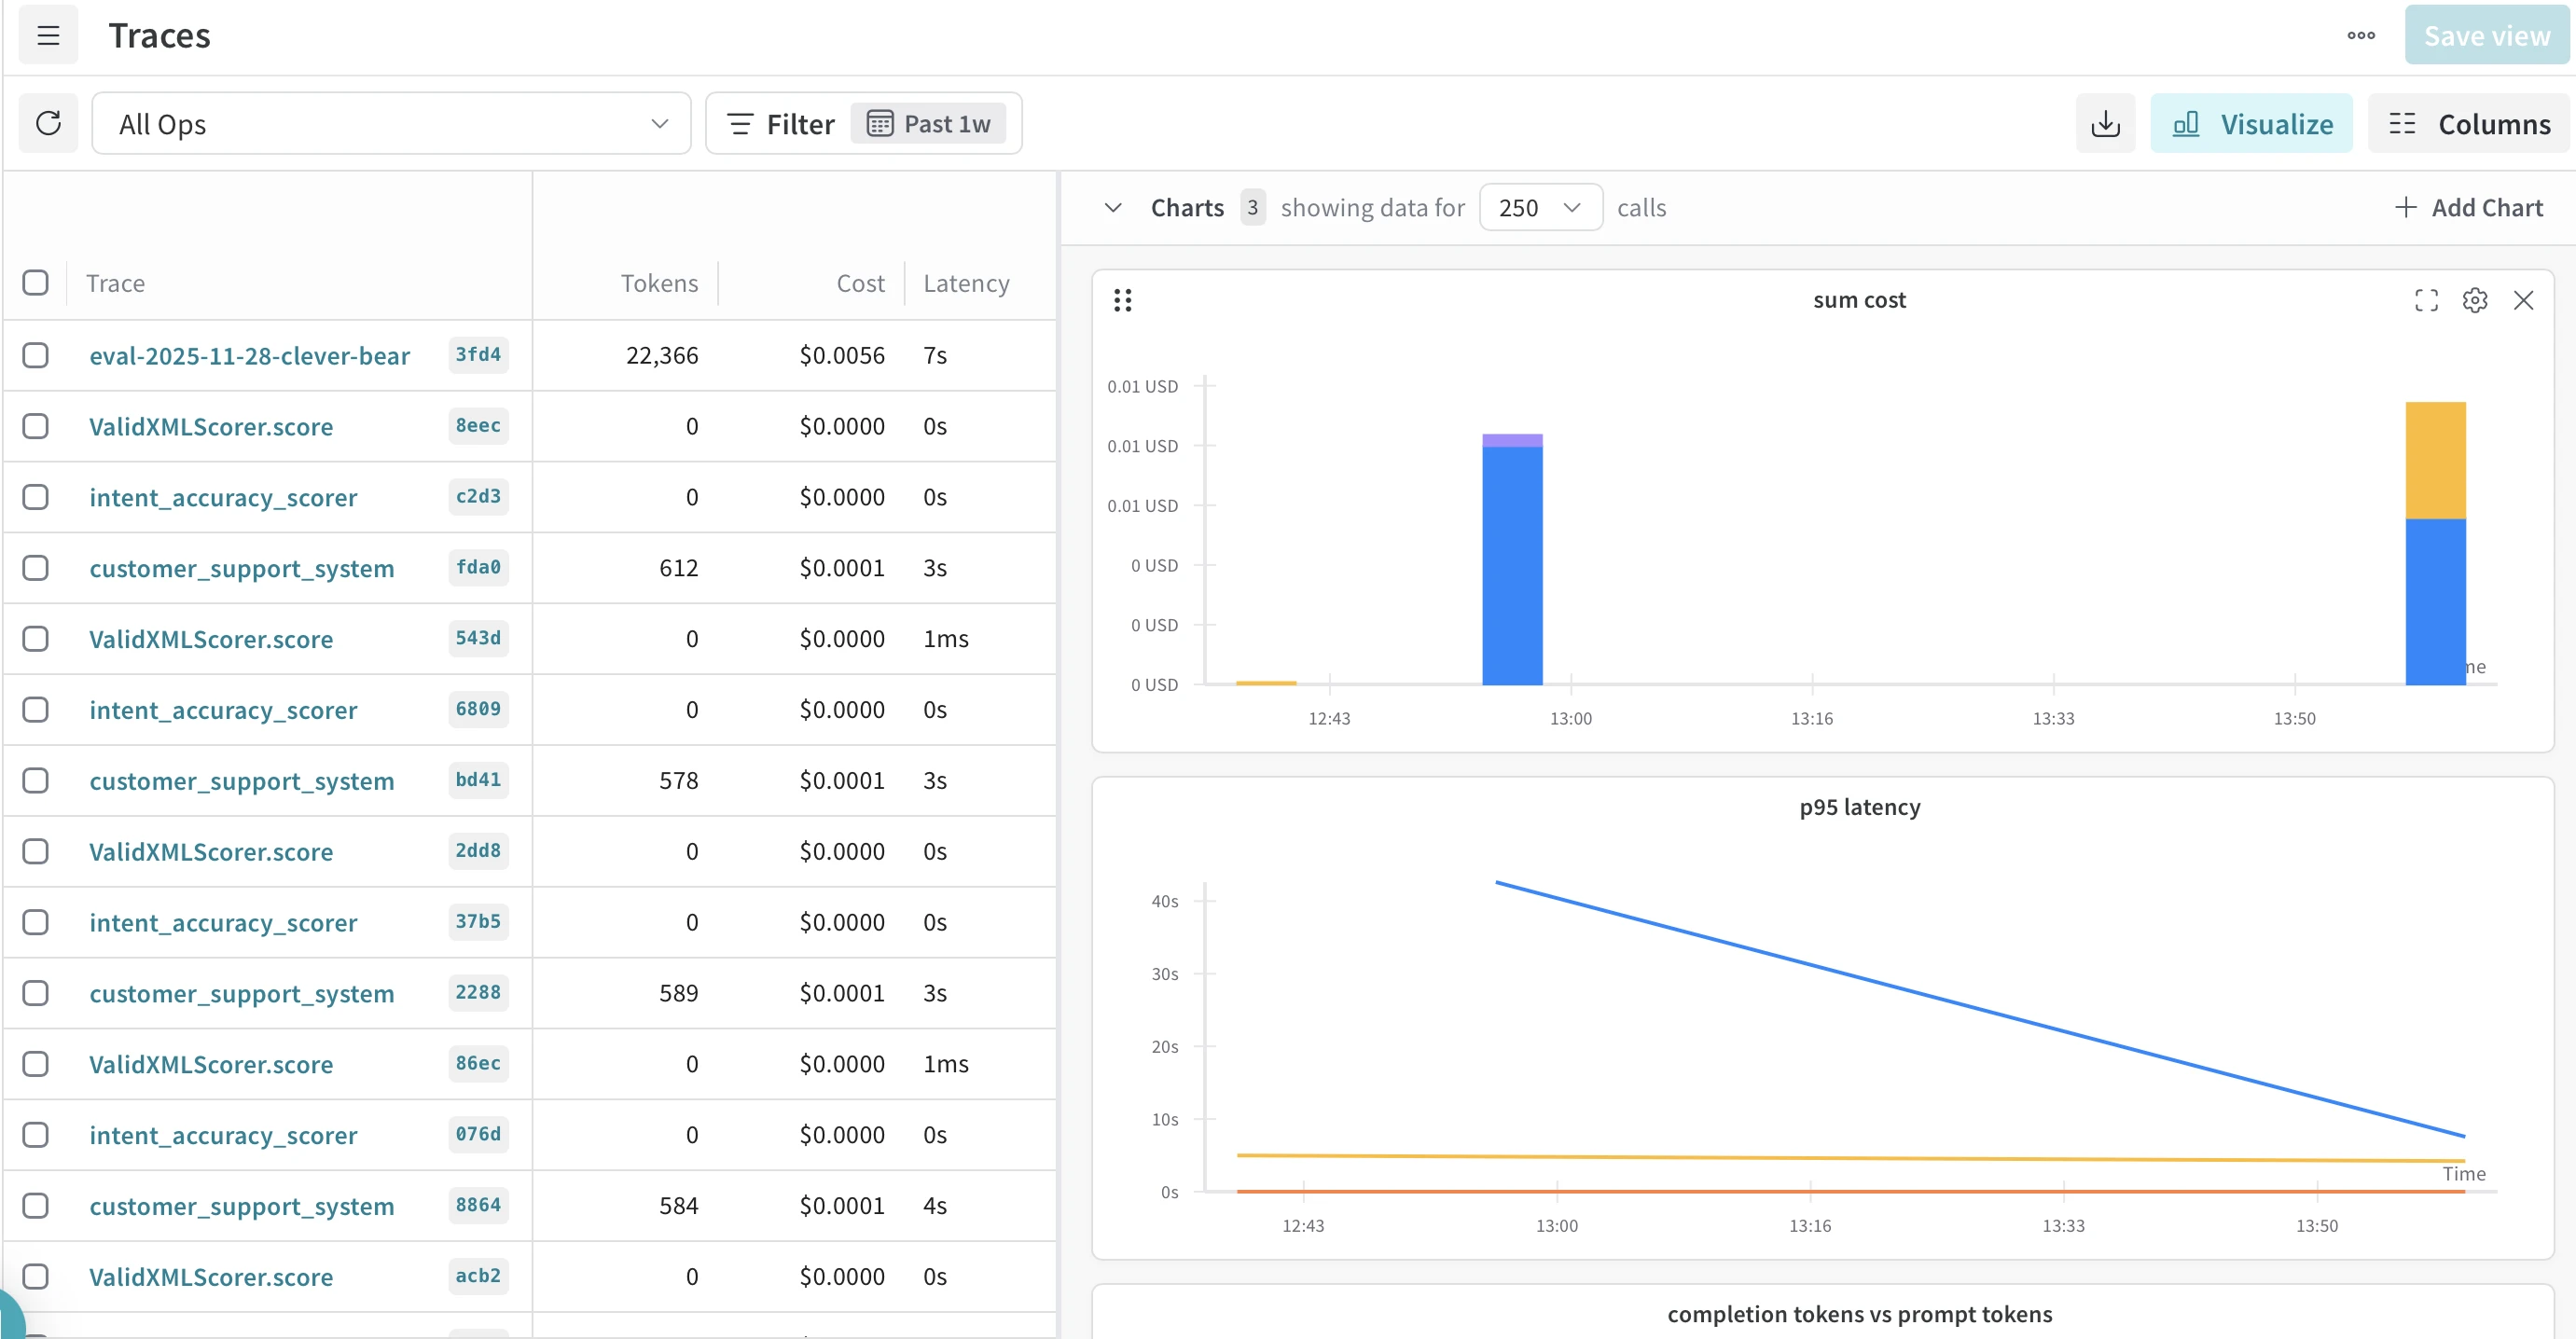
W&B Weave proporciona LLM observabilidad con rastreo automático, versionado de prompts, frameworks de evaluación con puntuadores integrados y visualización de flujos de trabajo multiagente. La plataforma realiza un seguimiento de costes y latencia a nivel individual y agregado, lo que ayuda a los equipos a identificar consultas costosas y cuellos de botella de rendimiento. Para pipelines complejos con múltiples agentes o llamadas a herramientas, W&B Weave crea árboles de rastreo anidados que muestran el flujo completo de ejecución, lo que permite depurar flujos de trabajo de varios pasos y optimizar cada componente.
CoreWeave Forge permite a los equipos utilizar la misma plataforma para el fine-tuning de LLMs (W&B Models), el versionado de datos y models (CoreWeave Registry) y la supervisión de aplicaciones en producción (W&B Weave).
Figura 1: Panel de rastreo de W&B Weave.
MLflow
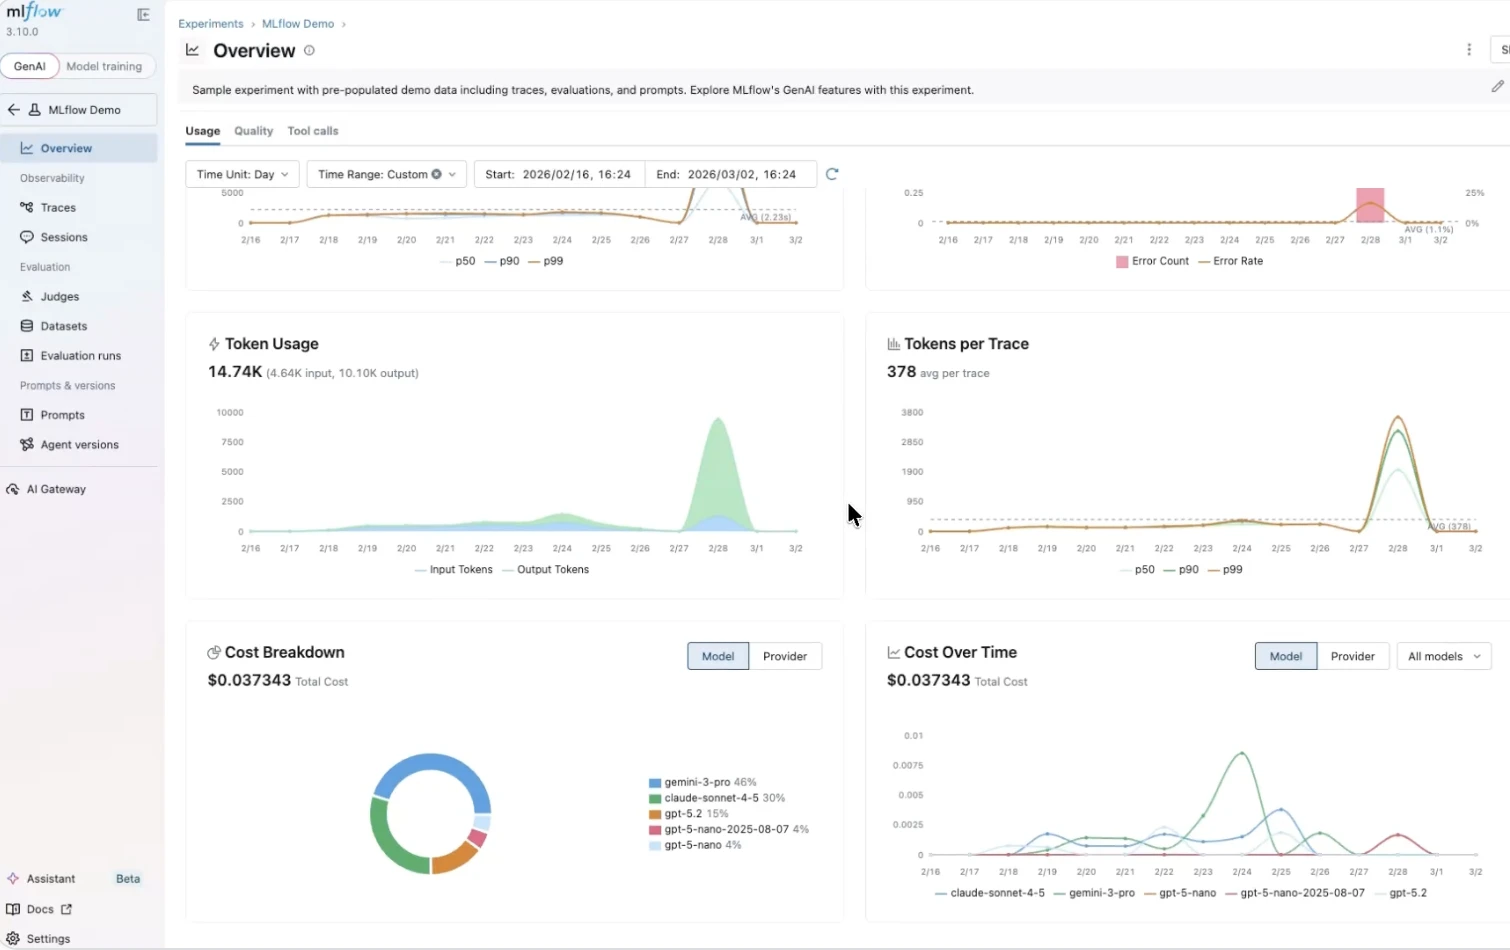
MLflow es una plataforma de código abierto para gestionar el ciclo de vida de los LLM y los agentes. Las capacidades clave de LLMOps incluyen:
- Rastreo: captura prompts, recuperaciones y llamadas a herramientas en los flujos de trabajo de los agentes
- Evaluación: puntuación de LLM-as-a-judge con métricas predefinidas para la alucinación y la relevancia
- Gestión de prompts: versionado, optimización y seguimiento de linaje
- IA Gateway: acceso centralizado a models y control de costes
MLflow es compatible con OpenTelemetry y se integra con los principales proveedores de LLM y frameworks de agentes.
1Comet
Comet es una plataforma de seguimiento de experimentos y observabilidad de models. También admite el seguimiento de experimentos de LLM, el versionado de prompts y la evaluación de LLM, lo que la hace adecuada para equipos que crean y optimizan aplicaciones de LLM.
Valohai
Valohai es una plataforma de MLOps que soporta pipelines reproducibles para el procesamiento de datos, el entrenamiento y el despliegue. Recientemente añadió capacidades compatibles con LLMOps, como el seguimiento de metadatos, el versionado de artefactos y la orquestación del entrenamiento a gran escala.
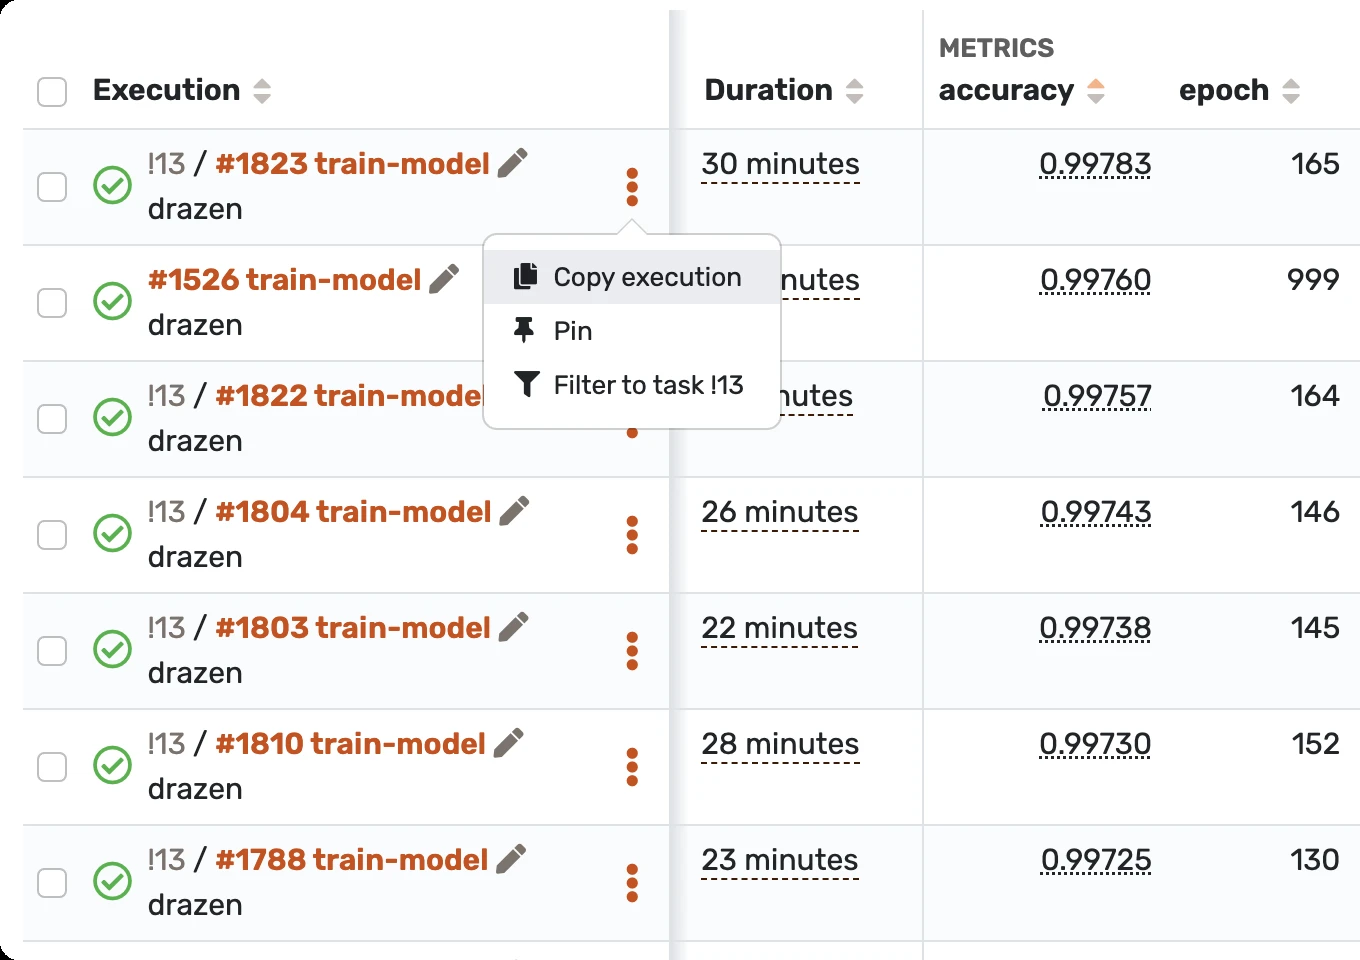
Figura 2: Repositorio de conocimiento de Valohai.2
TrueFoundry
TrueFoundry es una plataforma integral de ML/LLM que simplifica el despliegue de models, el fine-tuning y la supervisión. Ofrece infraestructura optimizada para GPU, registro de models, gestión de prompts y gobernanza de nivel empresarial.
Zen ML
ZenML proporciona un framework de pipelines listo para producción para MLOps y LLMOps. Permite a los usuarios crear pipelines reproducibles, conectar orquestadores (Airflow, Kubeflow) e integrar flujos de trabajo de LLM como RAG, fine-tuning y evaluación.
2. Plataformas de datos, nube e infraestructura que ofrecen LLMOps
Las plataformas de datos, nube e infraestructura ofrecen cada vez más capacidades de LLMOps que permiten a los usuarios aprovechar sus propios datos para crear y realizar fine-tuning de LLMs.
Por ejemplo, Databricks ofrece entrenamiento de LLM, fine-tuning y alojamiento de models (ampliado tras la adquisición de MosaicML).
Los líderes de la nube Amazon, Azure y Google han lanzado su oferta de LLMOps, que permite a los usuarios desplegar models de diferentes proveedores.
3. Frameworks y plataformas centrados en LLM
Esta categoría incluye herramientas que se centran exclusivamente en optimizar y gestionar las operaciones de LLM. Aquí hay un desglose de las herramientas y sus funciones principales de LLMOps:
DeepLake
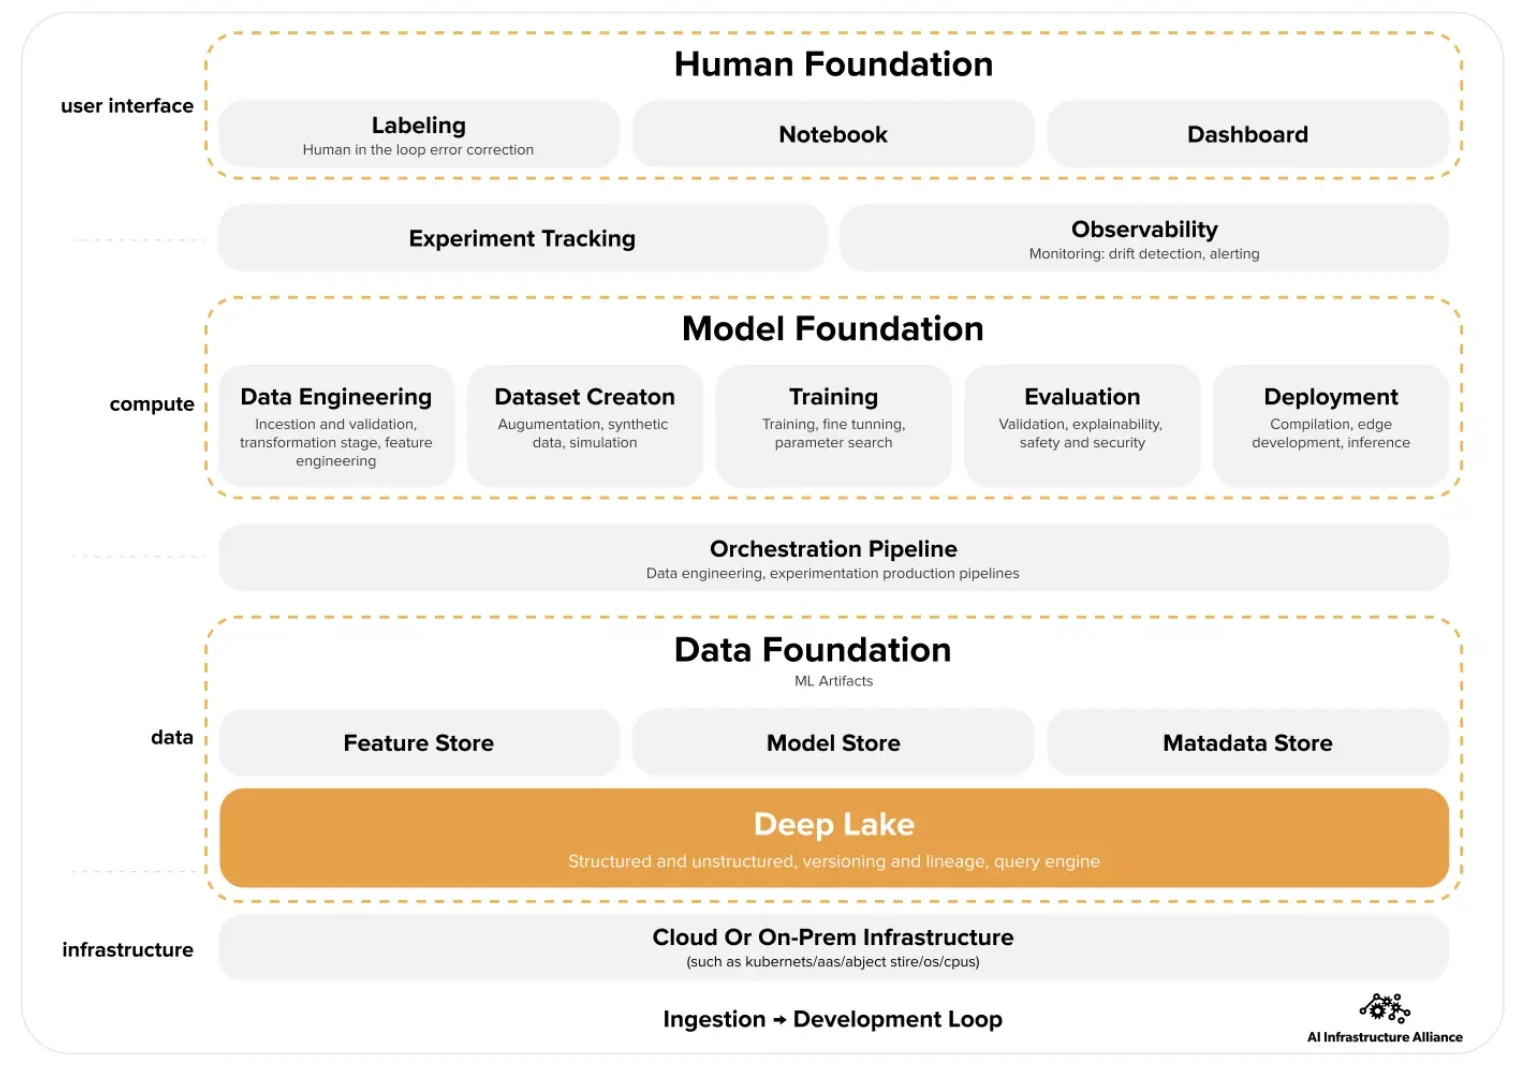
Deep Lake proporciona un data lake diseñado para IA, que ofrece almacenamiento, versionado y una base de datos vectorial. Soporta flujos de trabajo para la creación, inspección y recuperación de datasets de LLM, y se integra perfectamente con PyTorch y TensorFlow.
Figura 3: La imagen muestra el papel de Deep Lake en una arquitectura de MLOps3
Deepset AI
Haystack de Deepset es un framework de RAG y búsqueda que permite a las empresas crear aplicaciones basadas en LLM combinando almacenes de documentos, recuperadores y large language models. Soporta pipelines de RAG multimodales, evaluación de models y despliegue en producción.
Lamini AI
Lamini ofrece una plataforma para crear LLMs personalizados, con soporte tanto para fine-tuning completo como para ajuste ligero. Está pensada para empresas que necesitan LLMs específicos de dominio y proporciona APIs y SDKs para integrar datos organizacionales.
Nemo by NVIDIA
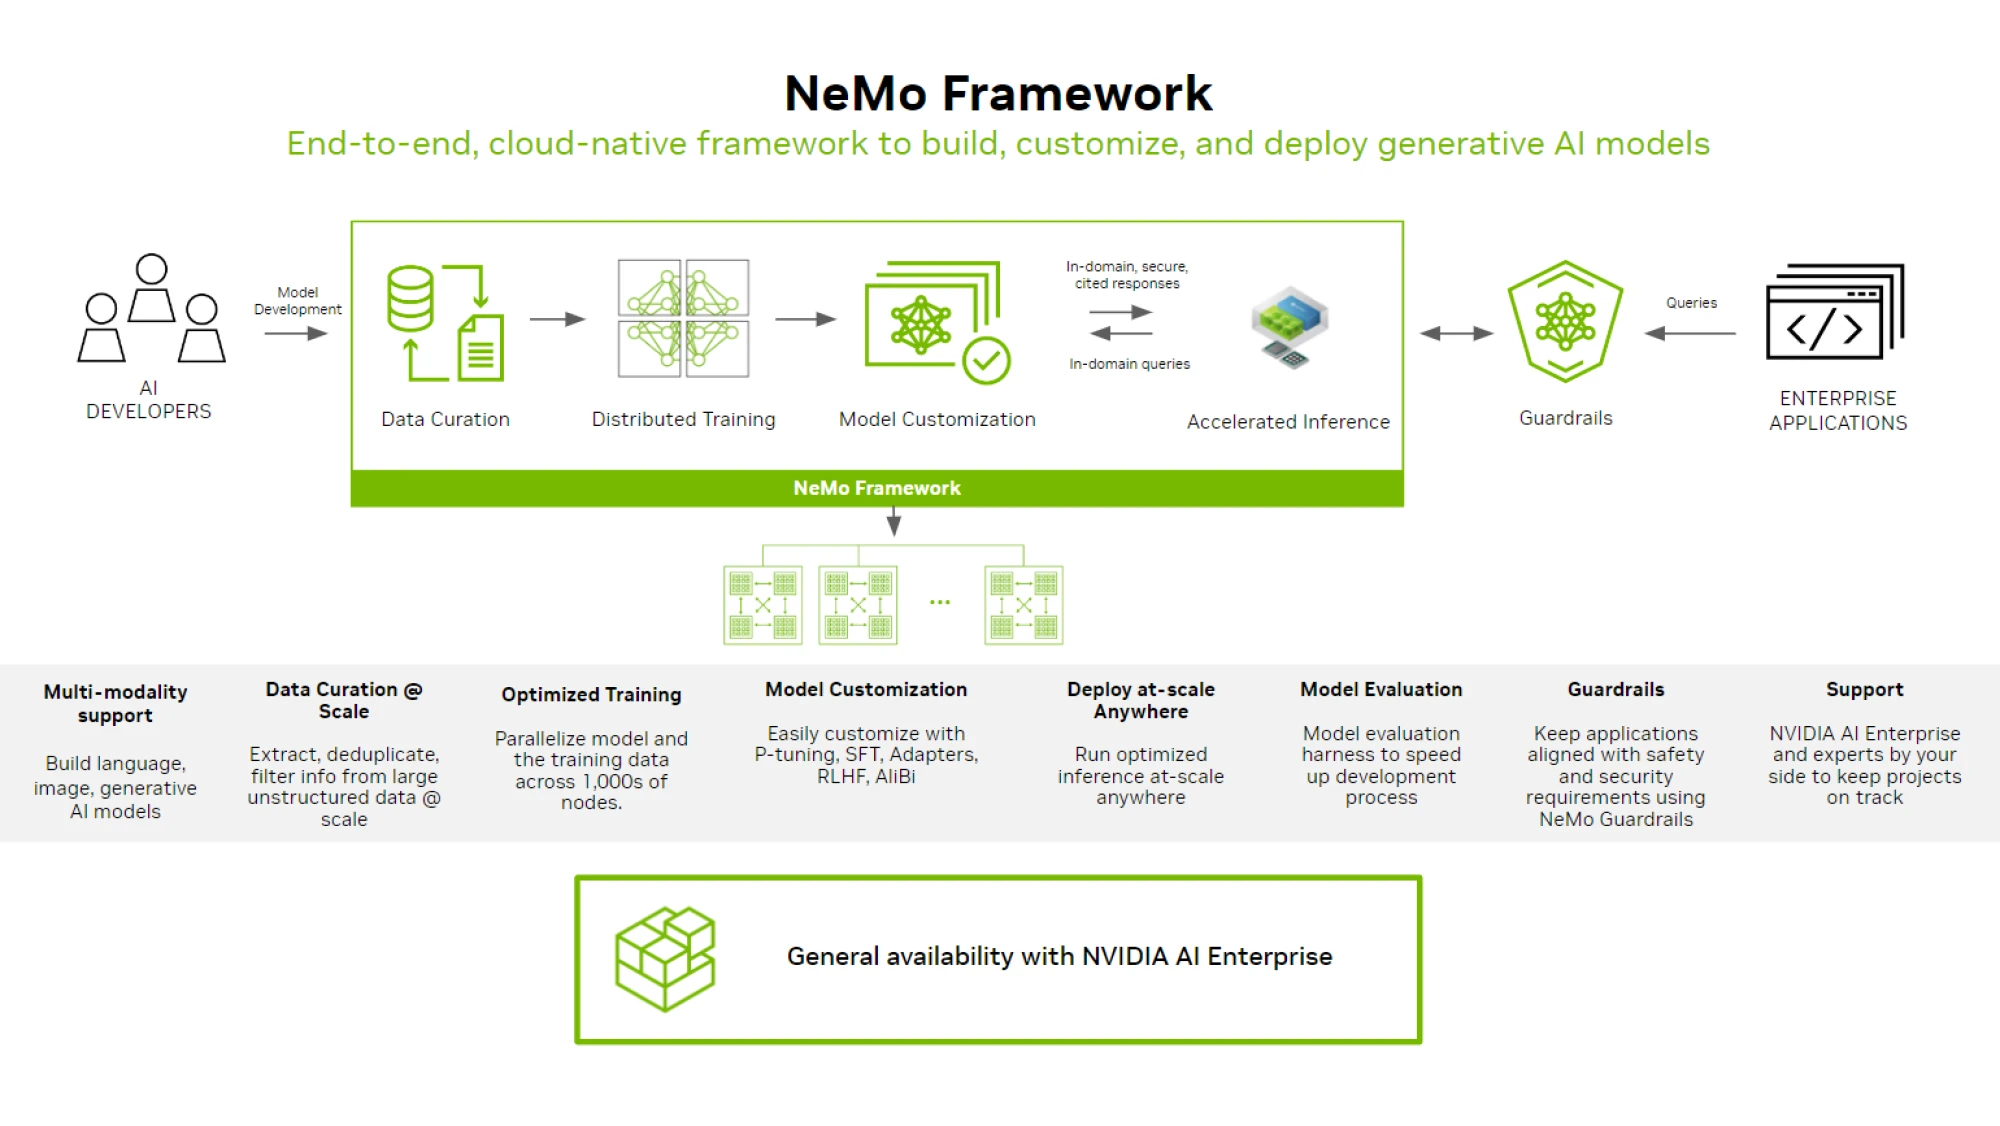
NeMo es un framework para crear, entrenar y personalizar foundation models, incluidos los LLMs. Proporciona componentes para fine-tuning supervisado, ajuste por instrucciones, RAG, evaluación de models y despliegue en NVIDIA GPUs.
Figura 4: Arquitectura del framework NeMo.4
Snorkel AI
Snorkel AI proporciona una plataforma de desarrollo centrada en datos para el etiquetado programático y la curación de datos de entrenamiento. Ahora se extiende a la personalización de foundation models, lo que permite a las organizaciones adaptar LLMs con datasets de alta calidad etiquetados automáticamente.
Titan ML
TitanML se centra en la inference eficiente de LLM. Su Titan Takeoff Server ayuda a los equipos a ejecutar LLMs en local con un rendimiento optimizado, requisitos reducidos de GPU y una latencia mejorada. También ofrece funciones de cuantización y compresión.
Tecnologías de soporte para LLMOps
LLMs
Algunos proveedores de LLM, como OpenAI, Anthropic y Google, ofrecen funciones parciales del ciclo de vida de LLM (p. ej., fine-tuning en models seleccionados, paneles de monitoreo y herramientas de evaluación).
Nota: Los proveedores de LLM ofrecen herramientas para el fine-tuning y la integración, pero no son plataformas completas de LLMOps. LLMOps normalmente requiere componentes adicionales como supervisión, gobernanza, linaje, sistemas de evaluación y gestión de pipelines.
Frameworks de integración
Estas herramientas están diseñadas para facilitar el desarrollo de LLM aplicaciones, como analizadores de documentos y código, chatbots, etc.
Bases de datos vectoriales
Las bases de datos vectoriales almacenan embeddings vectoriales de alta dimensión generados a partir de texto, imágenes u otros datos. No almacenan registros crudos o sensibles, como resultados de pruebas médicas; en su lugar, indexan embeddings para permitir la búsqueda semántica y la recuperación.
Herramientas de fine-tuning
Las herramientas de fine-tuning van desde bibliotecas de bajo nivel hasta plataformas no-code, según el nivel de control y la experiencia técnica requeridos.
Bibliotecas y frameworks
Hugging Face Transformers y los frameworks basados en PEFT/LoRA son las opciones más utilizadas para fine-tuning. Para cargas de trabajo a gran escala, motores de entrenamiento como DeepSpeed y Megatron-LM gestionan el entrenamiento distribuido de manera eficiente.
Plataformas no-code
Unsloth Studio y Hugging Face AutoTrain proporcionan interfaces web para fine-tuning de LLMs sin escribir código.
Unsloth Studio es de código abierto y es compatible con los métodos LoRA y QLoRA con integración directa con Hugging Face. Hugging Face AutoTrain permite a los usuarios hacer fine-tuning de models subiendo datos directamente a través del ecosistema de Hugging Face.
Herramientas de RLHF
RLHF, abreviatura de aprendizaje por refuerzo a partir de retroalimentación humana, permite a los sistemas de IA refinar sus decisiones incorporando orientación humana.
En el aprendizaje por refuerzo, un agente mejora su comportamiento mediante ensayo y error, guiado por la retroalimentación del entorno en forma de recompensas o castigos.
Por el contrario, RLHF ayuda a mejorar el comportamiento del model integrando datos de preferencias humanas en el bucle de entrenamiento. No reemplaza el etiquetado a gran escala, sino que se basa en datos de comparación generados por humanos. RLHF favorece la alineación, la seguridad, la mejora de la calidad y una mayor adherencia a la intención del usuario.
Herramientas de prueba de LLM
Las herramientas de prueba de LLM evalúan los LLMs mediante la evaluación del rendimiento, las capacidades y los posibles sesgos de los models en tareas relacionadas con el lenguaje, como la comprensión y la generación de lenguaje natural. Las herramientas de prueba pueden incluir:
- Frameworks de prueba
- Datasets de benchmark
- Métricas de evaluación.
Por ejemplo, Promptfoo es una CLI y biblioteca de código abierto que puntúa automáticamente los outputs mediante métricas personalizadas, ejecuta comparaciones en paralelo entre múltiples models y proveedores, y realiza red-teaming automatizado para identificar vulnerabilidades. Se integra con pipelines de CI/CD y se ejecuta completamente en local.
Monitoreo y observabilidad de LLM
Las herramientas de monitoreo y observabilidad de LLM garantizan el funcionamiento correcto, la seguridad del usuario y la protección de la marca. A diferencia del ML tradicional, los outputs de LLM son inherentemente no deterministas, lo que significa que la misma entrada puede producir resultados diferentes, lo que requiere rastrear todo el contexto para detectar alucinaciones.5 En la práctica, las mejoras se logran mediante actualizaciones iterativas de prompts y contexto, en lugar de reentrenamiento.
El monitoreo de LLM incluye actividades como:
- Monitoreo funcional: Realizar un seguimiento de factores como el tiempo de respuesta, el uso de tokens, el número de solicitudes, los costes y las tasas de error.
- Monitoreo de prompts: Comprobar las entradas y los prompts de los usuarios para evaluar contenido tóxico en las respuestas, medir distancias de embeddings e identificar inyecciones maliciosas de prompts.
- Monitoreo de respuestas: Analizar para descubrir comportamientos alucinatorios, divergencia temática, tono y sentimiento en las respuestas.
OpenLLMetry es un ejemplo de biblioteca de observabilidad de código abierto para aplicaciones de LLM construida sobre OpenTelemetry. Rastrea las llamadas de LLM en tiempo de ejecución en flujos de trabajo, tareas, agentes e invocaciones de herramientas, capturando prompts y respuestas de API. Los rastreos se pueden exportar a la plataforma Traceloop o a cualquier stack de observabilidad compatible con OpenTelemetry existente.6
Plataformas gestionadas frente a configuración solo con CPU benchmark
Evaluamos TrueFoundry y Amazon SageMaker frente a una configuración solo con CPU para medir el impacto en el rendimiento de las plataformas gestionadas en el tiempo de entrenamiento y evaluación.
Ambas plataformas redujeron el entrenamiento de 2.572 segundos a menos de 570, y la evaluación de 174 segundos a alrededor de 40. Si bien SageMaker fue ligeramente más rápido durante el entrenamiento y TrueFoundry fue ligeramente más rápido durante la evaluación, la diferencia general fue insignificante; ambas ofrecieron mejoras importantes respecto a la configuración manual.
Consulte nuestra metodología de benchmark.
Para casos de uso de LLMOps como las pruebas iterativas de prompts, las actualizaciones frecuentes de models y el monitoreo en producción, la sobrecarga de una configuración solo con CPU se acumula rápidamente; las plataformas gestionadas reducen esta fricción al encargarse de la infraestructura automáticamente.
Observabilidad de flujos de trabajo agénticos en LLMOps
Las aplicaciones de LLM ya no se limitan a ciclos simples de prompt-respuesta. En los flujos de trabajo agénticos, un LLM puede invocar múltiples herramientas, tomar decisiones autónomas y completar tareas de varios pasos de manera independiente. Esto crea nuevos desafíos de observabilidad para los equipos de LLMOps:
Desafíos clave:
- Rastreo de llamadas a herramientas: Supervisar los parámetros de entrada/salida, la duración y el estado de éxito de cada invocación de herramienta
- Registro de puntos de decisión: Registrar por qué el agente eligió una herramienta específica en cada punto de decisión
- Detección de Loop: Identificar y terminar automáticamente agentes atascados en bucles infinitos
- Atribución de costes en varios pasos: Comprender qué paso consumió cuántos tokens en un flujo de trabajo de 10 pasos
Las plataformas de LLMOps abordan estos desafíos proporcionando rastreo de extremo a extremo que captura cada invocación de herramienta, visualiza los árboles de decisión de los agentes y marca automáticamente anomalías como bucles infinitos o picos de latencia inesperados.
Estas plataformas también permiten desgloses de costes granulares por paso, lo que ayuda a las organizaciones a optimizar tanto el rendimiento como el gasto en pipelines agénticos complejos.
Guardrails y capas de seguridad para la observabilidad de LLM
Los despliegues de LLM en producción requieren capas de seguridad que filtren, supervisen y bloqueen entradas y salidas dañinas en tiempo real. Desde la perspectiva de LLMOps, la observabilidad de estos sistemas de guardrails es fundamental para mantener la seguridad y el cumplimiento:
Capas de seguridad principales:
- Guardrails de entrada: Detectar intentos de inyección de prompts, técnicas de jailbreak y contenido malicioso antes del procesamiento
- Guardrails de salida: Puntuar las alucinaciones, enmascarar la PII (información de identificación personal) y filtrar respuestas tóxicas
- Aplicación de políticas: Bloquear respuestas que violen las políticas de la empresa o los requisitos normativos
El monitoreo eficaz de los guardrails requiere rastrear las solicitudes bloqueadas y sus causas, medir las tasas de falsos positivos para proteger la experiencia del usuario, identificar las reglas que se activan con frecuencia y analizar las tendencias de seguridad a lo largo del tiempo para detectar amenazas emergentes.
Herramientas de guardrails para LLMOps:
- Guardrails AI: Validación de salidas basada en Pydantic con aplicación de salidas estructuradas y cumplimiento de esquemas
- Lakera Guard: Protección contra inyección de prompts en tiempo real con detección y clasificación de amenazas
- Rebuff: Sistema de defensa autoendurecible que aprende de los intentos de inyección de prompts
- Protect AI: Escaneo de seguridad de models de ML con detección de vulnerabilidades en todo el pipeline de despliegue
- Invariant Guardrails: Sistema de aplicación en tiempo de ejecución para agentes de LLM que intercepta las salidas de los agentes y las llamadas a herramientas, bloqueando la exposición de secretos de API, filtrando contenido sensible y aplicando políticas de llamadas a herramientas mientras el agente se ejecuta.7
¿Qué es LLMOps?
LLMOps significa Large Language Model Operations (Operaciones de Large Language Models). Se refiere a las prácticas, herramientas e infraestructura utilizadas para gestionar el ciclo de vida de los LLMs, como el fine-tuning, el despliegue, la supervisión, la evaluación, la gobernanza y la mejora continua de los models.
LLMOps no automatiza todo el pipeline de IA, sino que se centra específicamente en operacionalizar los sistemas basados en LLM.
Componentes clave de LLMOps:
- Selección de un foundation model: Un punto de partida dicta los refinamientos posteriores y el fine-tuning para que los foundation models se adapten a dominios de aplicación específicos.
- Gestión de datos: La gestión de grandes volúmenes de datos resulta fundamental para el funcionamiento preciso de los language models.
- Despliegue y monitoreo de models: Garantizar el despliegue eficiente de los language models y su supervisión continua asegura un rendimiento constante.
- Ingeniería de prompts: Crear plantillas de prompts eficaces para mejorar el rendimiento del model.
- Monitoreo de models: Seguimiento continuo de los resultados de los models, detección de la degradación de la precisión y tratamiento de la deriva del model.
- Evaluación y benchmarking: La evaluación rigurosa de los models refinados frente a benchmarks estandarizados ayuda a medir la eficacia de los language models.
- Fine-tuning de models: Aplicar fine-tuning a LLMs para tareas específicas y refinar los models para un rendimiento óptimo.
¿En qué se diferencia LLMOps de MLOps?
LLMOps está especializado y centrado en la utilización de large language models. Al mismo tiempo, MLOps tiene un alcance más amplio que abarca diversos machine learning models y técnicas.
En este sentido, LLMOps se conoce como MLOps para LLMs. Por lo tanto, estos dos divergen en su enfoque específico sobre los foundation models y las metodologías:
LLMOps se centra en sistemas no deterministas guiados por prompts, en lugar de pipelines estáticos de entrenamiento y despliegue. A diferencia del ML convencional, donde las mejoras provienen del reentrenamiento, la optimización de LLMOps se produce refinando los prompts o los datos de recuperación y ajustando los sistemas externos.
Las preocupaciones operativas principales incluyen:
- Detección y evaluación de alucinaciones
- Versionado y gestión de prompts
- Seguimiento de pipelines de recuperación
- Monitoreo del coste de tokens por consulta
Aprendizaje por transferencia
A diferencia de los machine learning models convencionales creados desde cero, los LLMs suelen comenzar con un base model, que se somete a fine-tuning con datos nuevos para optimizar el rendimiento en dominios específicos. Este fine-tuning facilita resultados de vanguardia para aplicaciones concretas, utilizando menos datos y recursos computacionales.
Retroalimentación humana
Los avances en el entrenamiento de large language models se atribuyen al aprendizaje por refuerzo a partir de retroalimentación humana (RLHF). Dada la naturaleza abierta de las tareas de LLM, la aportación humana de los usuarios finales tiene un valor considerable para evaluar el rendimiento del model. Integrar este bucle de retroalimentación en los pipelines de LLMOps simplifica la evaluación y recopila datos para el futuro refinamiento del model.
Ajuste de hiperparámetros
Mientras que el ML convencional se centra principalmente en el ajuste de hiperparámetros para mejorar la precisión, los LLMs introducen una dimensión adicional al reducir los costes de entrenamiento e inference. Ajustar parámetros como el tamaño de los lotes y las tasas de aprendizaje puede influir sustancialmente en la velocidad y el coste del entrenamiento. En consecuencia, el seguimiento meticuloso del proceso de ajuste y la optimización siguen siendo pertinentes tanto para los machine learning models clásicos como para los LLMs, aunque con enfoques diferentes.
Métricas de rendimiento
Los machine learning models tradicionales se basan en métricas bien definidas, como la precisión, AUC y la puntuación F1, que son relativamente fáciles de calcular. En cambio, evaluar LLMs implica un conjunto de métricas estándar y sistemas de puntuación distintos, como BLEU (bilingual evaluation understudy) y ROUGE (Recall-Oriented Understudy for Gisting Evaluation), que requieren una atención especializada durante su implementación.
Ingeniería de prompts
Los models que siguen instrucciones pueden manejar prompts o conjuntos de instrucciones complejos. La elaboración de estas plantillas de prompts es fundamental para obtener respuestas precisas y fiables de los LLMs. Una ingeniería de prompts eficaz mitiga los riesgos de alucinación del model, manipulación de prompts, fuga de datos y vulnerabilidades de seguridad.
Construcción de pipelines de LLM
Los pipelines de LLM encadenan múltiples invocaciones de LLM y pueden interactuar con sistemas externos, como bases de datos vectoriales o búsquedas web. Estos pipelines permiten a los LLMs abordar tareas complejas como Q&A de bases de conocimiento o responder a consultas de usuarios basadas en un conjunto de documentos. En el desarrollo de aplicaciones de LLM, el énfasis a menudo se desplaza hacia la construcción y optimización de estos pipelines en lugar de crear LLMs nuevos.
Además, los large multimodal models amplían estas capacidades al incorporar diversos tipos de datos, como imágenes y texto, lo que mejora la flexibilidad y la utilidad de los pipelines de LLM.
A continuación se ofrece una visión general categorizada de las herramientas clave en el panorama de LLMOps y MLOps:
 Añadir como fuente preferida
¿LLMOps o MLOps: cuál se adapta a tu proyecto?
Ambas no son mutuamente excluyentes. Muchos sistemas de producción combinan ambas, y la elección correcta depende de lo que estés construyendo.
LLMOps es la mejor opción cuando tu aplicación se basa en un pretrained model de OpenAI, Anthropic, Google o alternativas de código abierto como Llama, y tu trabajo se centra en la ingeniería de prompts, pipelines de RAG u orquestación de agentes. También es más relevante cuando necesitas monitorear los costes de tokens, las alucinaciones y la calidad de las respuestas en producción.
MLOps es más apropiado cuando estás entrenando o haciendo fine-tuning de custom models con datos específicos de dominio, o cuando tu aplicación requiere outputs deterministas y auditables, como la detección de fraude o la clasificación médica.
Si estás haciendo fine-tuning de un foundation model y desplegándolo en producción, se aplican ambas: MLOps se encarga del pipeline de entrenamiento; LLMOps se encarga de la inference y el monitoreo.
Plataformas gestionadas frente a configuración solo con CPU metodología de benchmark
Evaluamos los tiempos de entrenamiento y evaluación de un model de clasificación de sentimientos basado en DistilBERT en tres entornos: una configuración manual (solo con CPU), TrueFoundry y Amazon SageMaker. Para garantizar la coherencia, utilizamos el mismo codebase, el pretrained model (distilbert-base-uncased) y las primeras 5.000 muestras del dataset de Amazon Reviews en todas las ejecuciones.
El dataset se filtró para incluir valoraciones de 1 a 5, se reetiquetó en cinco clases (0–4) y se dividió en conjuntos estratificados de entrenamiento y validación 80/20. La tokenización se realizó con una longitud máxima de secuencia fija de 128.
El model se entrenó durante una época con tamaños de lote idénticos (16 para entrenamiento, 32 para evaluación). Tanto TrueFoundry como SageMaker utilizaron el mismo tipo de instancia de GPU, mientras que la configuración manual se ejecutó intencionalmente en CPU para reflejar un entorno local típico o no especializado.
Esta configuración destaca no solo las optimizaciones a nivel de plataforma que ofrecen las herramientas modernas de LLMOps, sino también las importantes mejoras de rendimiento derivadas del acceso sin fricciones a GPU. El benchmark ilustra cómo el uso de plataformas gestionadas como TrueFoundry y SageMaker puede reducir el tiempo de entrenamiento y evaluación en comparación con ejecutar el mismo código manualmente en una CPU, especialmente en escenarios reales con recursos limitados.
Preguntas frecuentes
LLMOps ofrece ventajas significativas a los proyectos de machine learning que aprovechan large language models:
1. Mayor precisión: Garantizar datos de alta calidad para el entrenamiento y un despliegue fiable mejora la precisión del model.
2. Latencia reducida: Las estrategias de despliegue eficientes reducen la latencia en los LLMs, lo que permite una recuperación de datos más rápida.
Nota: El impacto en la precisión o la latencia depende del tamaño del model, la infraestructura y las herramientas; LLMOps mejora la manejabilidad y la fiabilidad de los LLMs, más que su rendimiento inherente como models.
3. Fomento de la equidad: Promover la equidad en la IA significa reducir activamente los sesgos de la IA en los algoritmos para defender la equidad y prevenir las violaciones de la ética de la IA.
Los desafíos en las operaciones de large language models requieren soluciones sólidas para mantener un rendimiento óptimo:
1.) Desafíos de la gestión de datos: Gestionar datasets extensos y datos sensibles exige una recopilación y un versionado de datos eficientes.
2.) Despliegue escalable: Desplegar infraestructura escalable y utilizar tecnologías nativas de la nube para satisfacer los requisitos de potencia computacional.
3.) Optimización de models: Emplear técnicas de compresión de models y refinar los models para mejorar la eficiencia general.
Las herramientas de LLMOps son fundamentales para superar los desafíos y ofrecer models de mayor calidad en el dinámico panorama de los large language models.
En aplicaciones prácticas, LLMOps está dando forma a diversas industrias:
Generación de contenido: Aprovechar los language models para automatizar la creación de contenido, incluidos el resumen, el análisis de sentimientos y más.
Servicio de atención al cliente: Mejorar los chatbots y los asistentes virtuales con la capacidad de los language models.
Análisis de datos: Extraer información de los datos textuales, enriqueciendo los procesos de toma de decisiones.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{Principales herramientas de LLMOps y compáralas con MLOps}},
  year   = {2026},
  month  = may,
  howpublished    = {\url{https://aimultiple.com/llmops-tools}},
  note   = {AIMultiple. Recuperado el 18 de mayo de 2026}
}Resultados y marcas de tiempo de 78 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 5 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
15 actualizacionesAñadidos MLflow, Promptfoo, OpenLLMetry e Invariant Guardrails a las secciones de herramientas LLMOps.
Se añadió una sección sobre la observabilidad del flujo de trabajo agéntico en LLMOps.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Siguiente para leer
Las mejores herramientas de gestión de vulnerabilidades


Mejores herramientas de IA emocional probadas

Las mejores herramientas de reconocimiento de imágenes comparadas

Las 25 mejores herramientas de control de versiones
Compara las 20 principales herramientas de orquestación de contenedores

Las 6 mejores herramientas de escaneo de vulnerabilidades

Comentarios 1
Comparte tus ideas
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.
This is a fantastic MLops overview and full of insight and immediate application to DevOps , Ai development at scale and how to implement design tools . Many thanks to Mr . Cem Dilmegani for his work .