


As 10 principais plataformas de AIOps comparadas
As plataformas de AIOps aplicam aprendizado de máquina e TI agêntica a tarefas de operações de TI, como detecção de anomalias, correlação de eventos e análise de causa raiz. Comparamos as 10 principais plataformas de AIOps com base em seus recursos principais e diferenciadores, planos de preços e principais casos de uso.
Principais recursos das plataformas de AIOps
Produto | Detecção de anomalias com ML | Remediação automatizada | Correlação de eventos / redução de ruído | RCA automatizada / com IA | Análise preditiva |
|---|---|---|---|---|---|
Limitado | ✓ | Limitado | Limitado | Limitado | |
BigPanda | Limitado | Limitado | ✓ | ✓ | Limitado |
Datadog | ✓ | ✓ | ✓ | ✓ | Limitado |
Dynatrace | ✓ | ✓ | ✓ | ✓ | ✓ |
IBM Instana | ✓ | Limitado | ✓ | ✓ | Limitado |
LogicMonitor | ✓ | Limitado | ✓ | ✓ | ✓ |
New Relic | ✓ | Limitado | ✓ | ✓ | Limitado |
OpenText OpsBridge | ✓ | ✓ | ✓ | ✓ | ✓ |
Splunk ITSI | ✓ | ✓ | ✓ | ✓ | ✓ |
Zenoss Cloud | ✓ | Limitado | ✓ | ✓ | ✓ |
Nota: Todas as tabelas estão classificadas em ordem alfabética. Nossos assinantes são listados primeiro.
Recursos diferenciadores das ferramentas de AIOps
As 10 principais plataformas de AIOps comparadas
NinjaOne
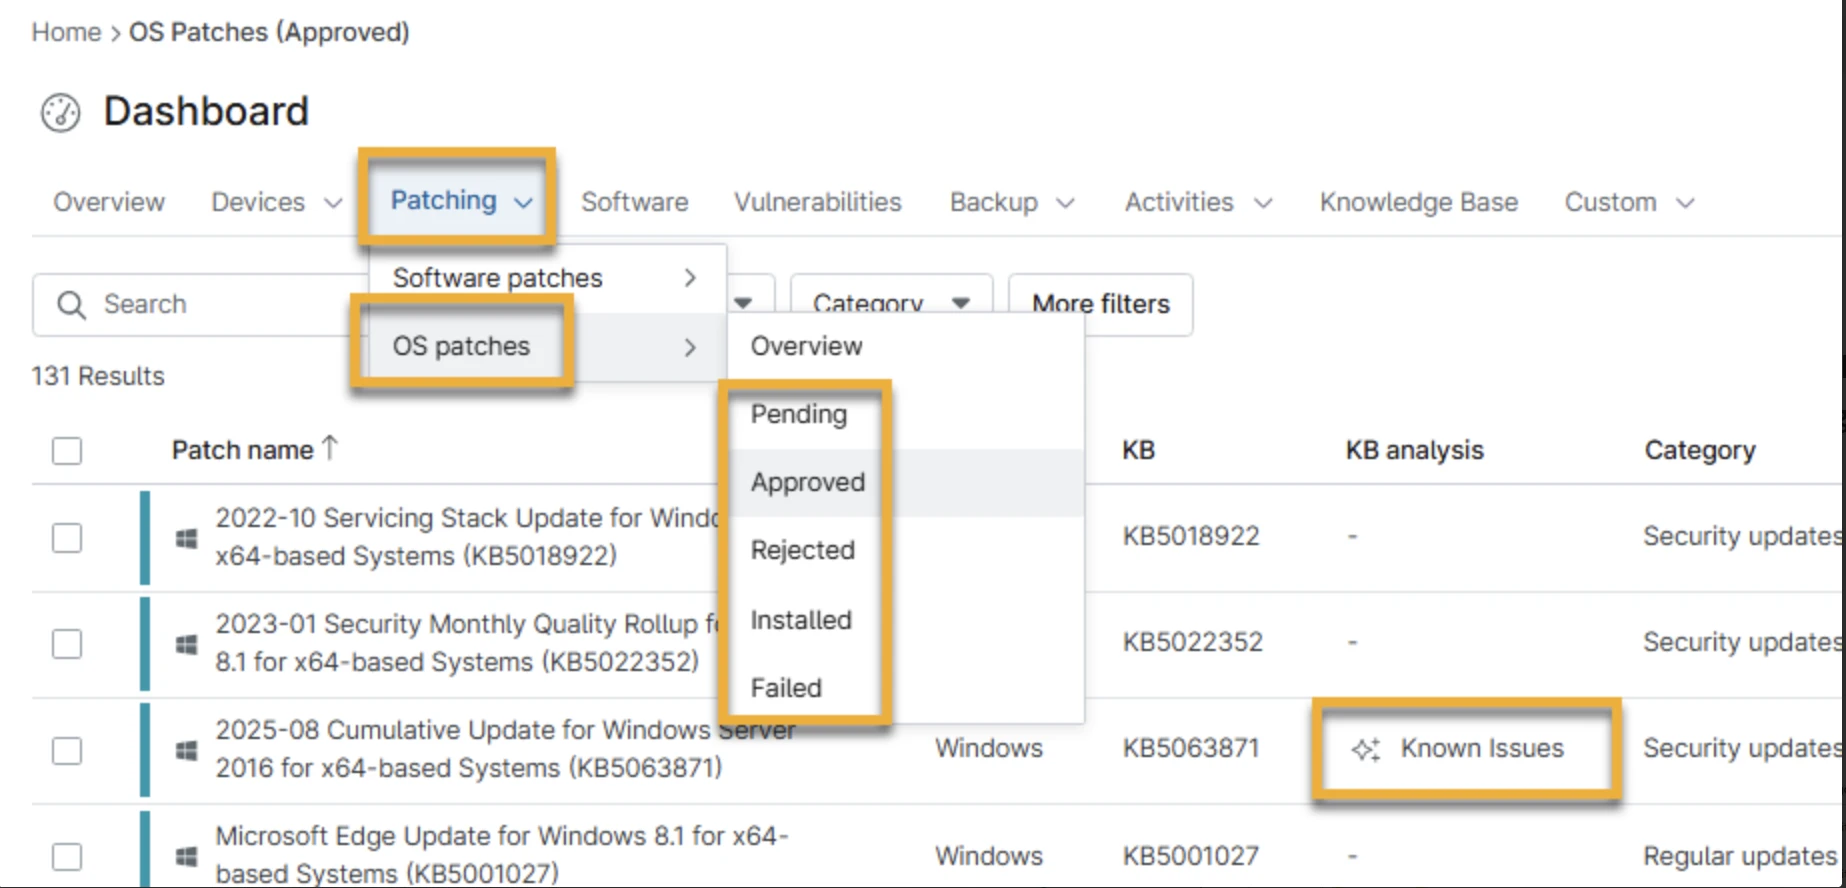
O NinjaOne conta com o Patch Intelligence IA, que combina IA generativa, informações de patches de terceiros e telemetria anônima de falhas/rollbacks do NinjaOne. Ele reavalia o status do patch a cada seis horas e pode alterar automaticamente um patch aprovado para Manual ou Rejeitar quando detecta problemas conhecidos ou taxas elevadas de falhas/rollbacks.
O Katana IA (acesso antecipado) analisa a telemetria do dispositivo, o histórico de alertas e a atividade para summarize problemas e revelar possíveis causas raiz. Ele correlaciona alertas relacionados, prioriza o que corrigir em seguida e recomenda scripts. Um técnico aprova qualquer ação antes de ela ser executada, e as recomendações e ações são registradas. Por meio do servidor MCP do NinjaOne, agentes de IA externos podem consultar e agir sobre dados de endpoints sob as mesmas permissões baseadas em funções.
Figura 1: Imagem mostrando como os dados do Patch Intelligence IA aparecem na coluna KB Analysis em Patching.
BigPanda
O L1 Agent da BigPanda executa runbooks predefinidos do cliente por meio de um worker conteinerizado on-premises. O worker faz conexões mTLS de saída, não mantém credenciais permanentes, obtém credenciais de curta duração por meio de uma função de serviço definida pelo cliente e executa fluxos de trabalho pré-registrados. Etapas de diagnóstico somente leitura podem ser executadas sem aprovação; ações corretivas, como reiniciar um serviço, exigem aprovação explícita.
Datadog
O Bits Investigation da Datadog executa um ciclo iterativo: formula uma hipótese de causa raiz, consulta a telemetria, avalia as evidências e, em seguida, revisa ou elimina hipóteses.
Ele pode inspecionar métricas, logs, traces, estado do monitor, RUM, Synthetics, dependências de serviços, incidentes, dashboards e fontes externas, como o Confluence. A UI registra a investigação tanto como um log cronológico de etapas quanto como uma árvore de hipóteses.
Dynatrace
O Dynatrace armazena sua topologia Smartscape como nós e relacionamentos no Grail. O DQL pode pesquisar essa topologia e seguir relacionamentos entre serviços, processos, hosts, recursos de nuvem e componentes do Kubernetes.
O Davis do Dynatrace correlaciona eventos que compartilham uma causa raiz inferida em um único problema e armazena a entidade Smartscape de causa raiz identificada, além das entidades afetadas. Como o Grail armazena a topologia junto com logs, spans, métricas e eventos, as consultas DQL podem percorrer dependências e enriquecer a telemetria com contexto de entidade.
IBM Instana
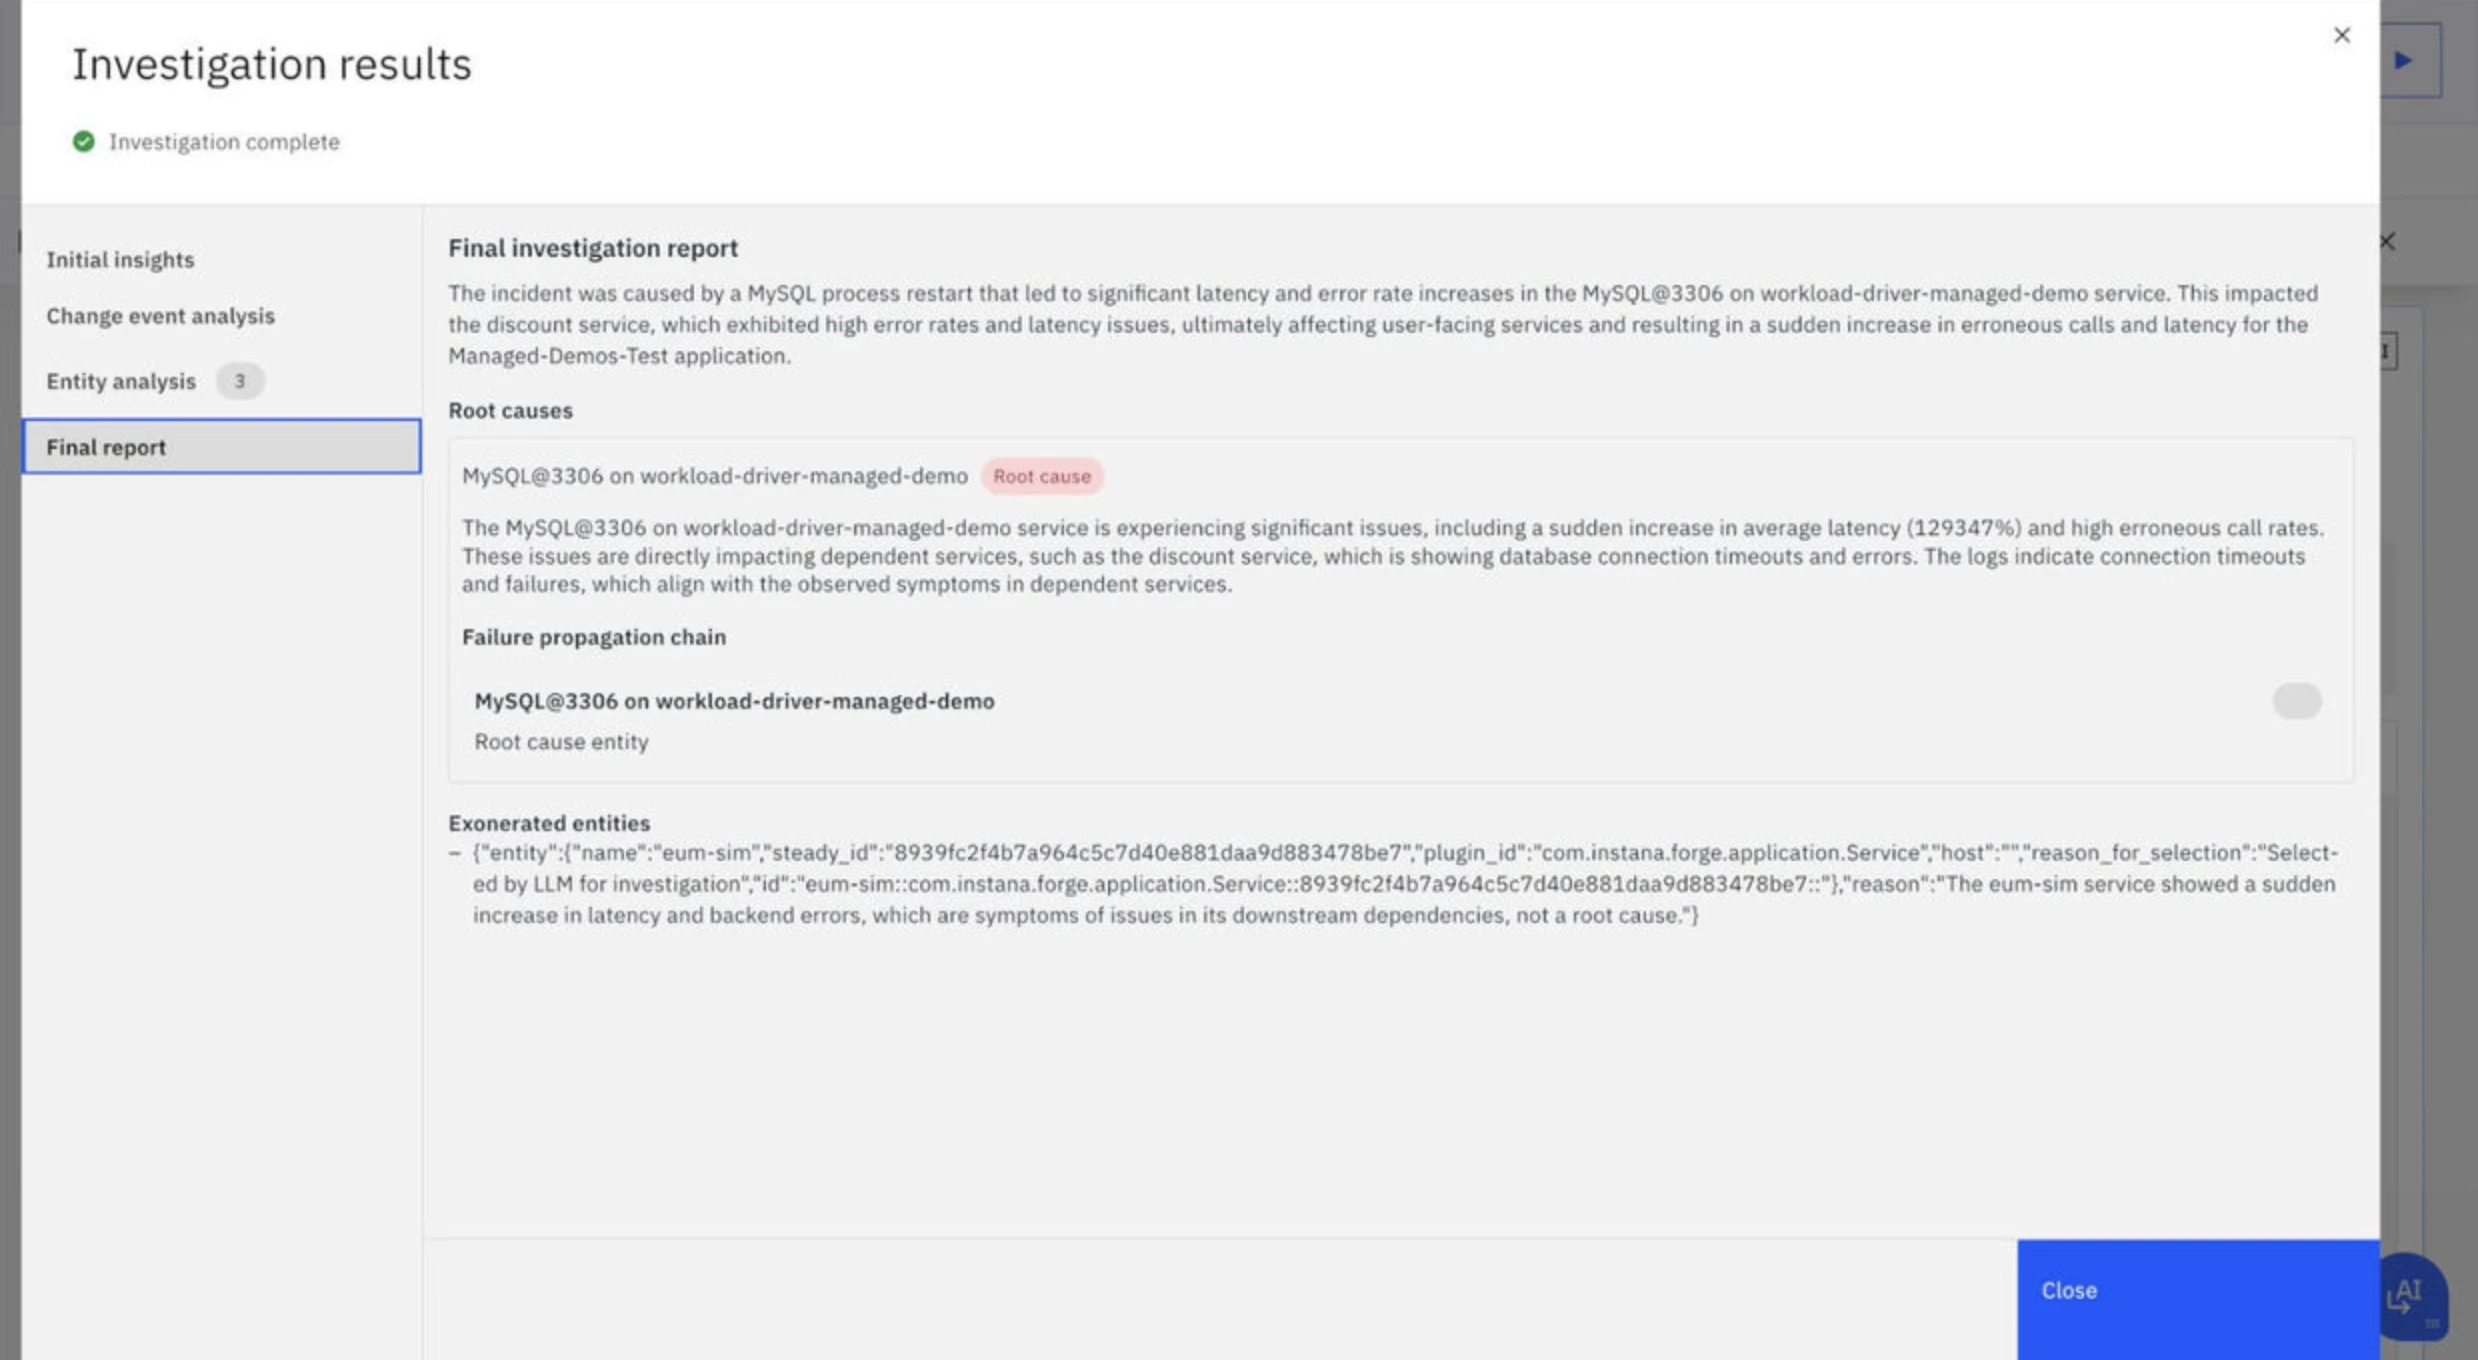
O Intelligent Incident Investigation do Instana cria e testa hipóteses no ambiente monitorado. A investigação registra quais hipóteses foram testadas, quais evidências foram coletadas e quais componentes foram inspecionados.
Uma vez aceita uma causa, o Instana pode gerar um runbook de remediação passo a passo e produzir um script Bash ou um playbook do Ansible para as etapas de remediação individuais e, em seguida, exportá-lo para revisão e implantação.
Figura 2: Painel de investigação Agentic IA do IBM Instana.1
LogicMonitor
O Edwin IA Investigation do LogicMonitor consome alertas, métricas, logs, solicitações de mudança, resultados de diagnóstico e saídas de remediação para criar uma linha do tempo do incidente, análise de impacto e causa provável.
O Edwin correlaciona alertas em “Insights”, e seu agente pode operar globalmente ou no contexto de um alerta/Insight específico. O sistema de investigação trabalha sobre os objetos de incidentes correlacionados do LogicMonitor e os metadados associados.
New Relic
O MCP servidor da New Relic dá a agentes de IA externos acesso a funções específicas de observabilidade. As ferramentas disponíveis incluem converter perguntas em linguagem natural em NRQL, gerar relatórios de alertas e de impacto no usuário, analisar o impacto de implantações, pesquisar traces, detectar traces anômalos e mapear dependências de serviços upstream e downstream.
OpenText OpsBridge
Para operações de TI, o Aviator da OpenText pode trabalhar com os produtos de observabilidade, gerenciamento de serviços, automação, CMDB e gerenciamento de ativos da OpenText.
A OpenText também fornece o Aviator Studio para criar e implantar agentes personalizados, enquanto o Service Management Aviator cuida dos fluxos de trabalho privados de IA generativa para casos de uso de suporte e gerenciamento de serviços.
Splunk ITSI
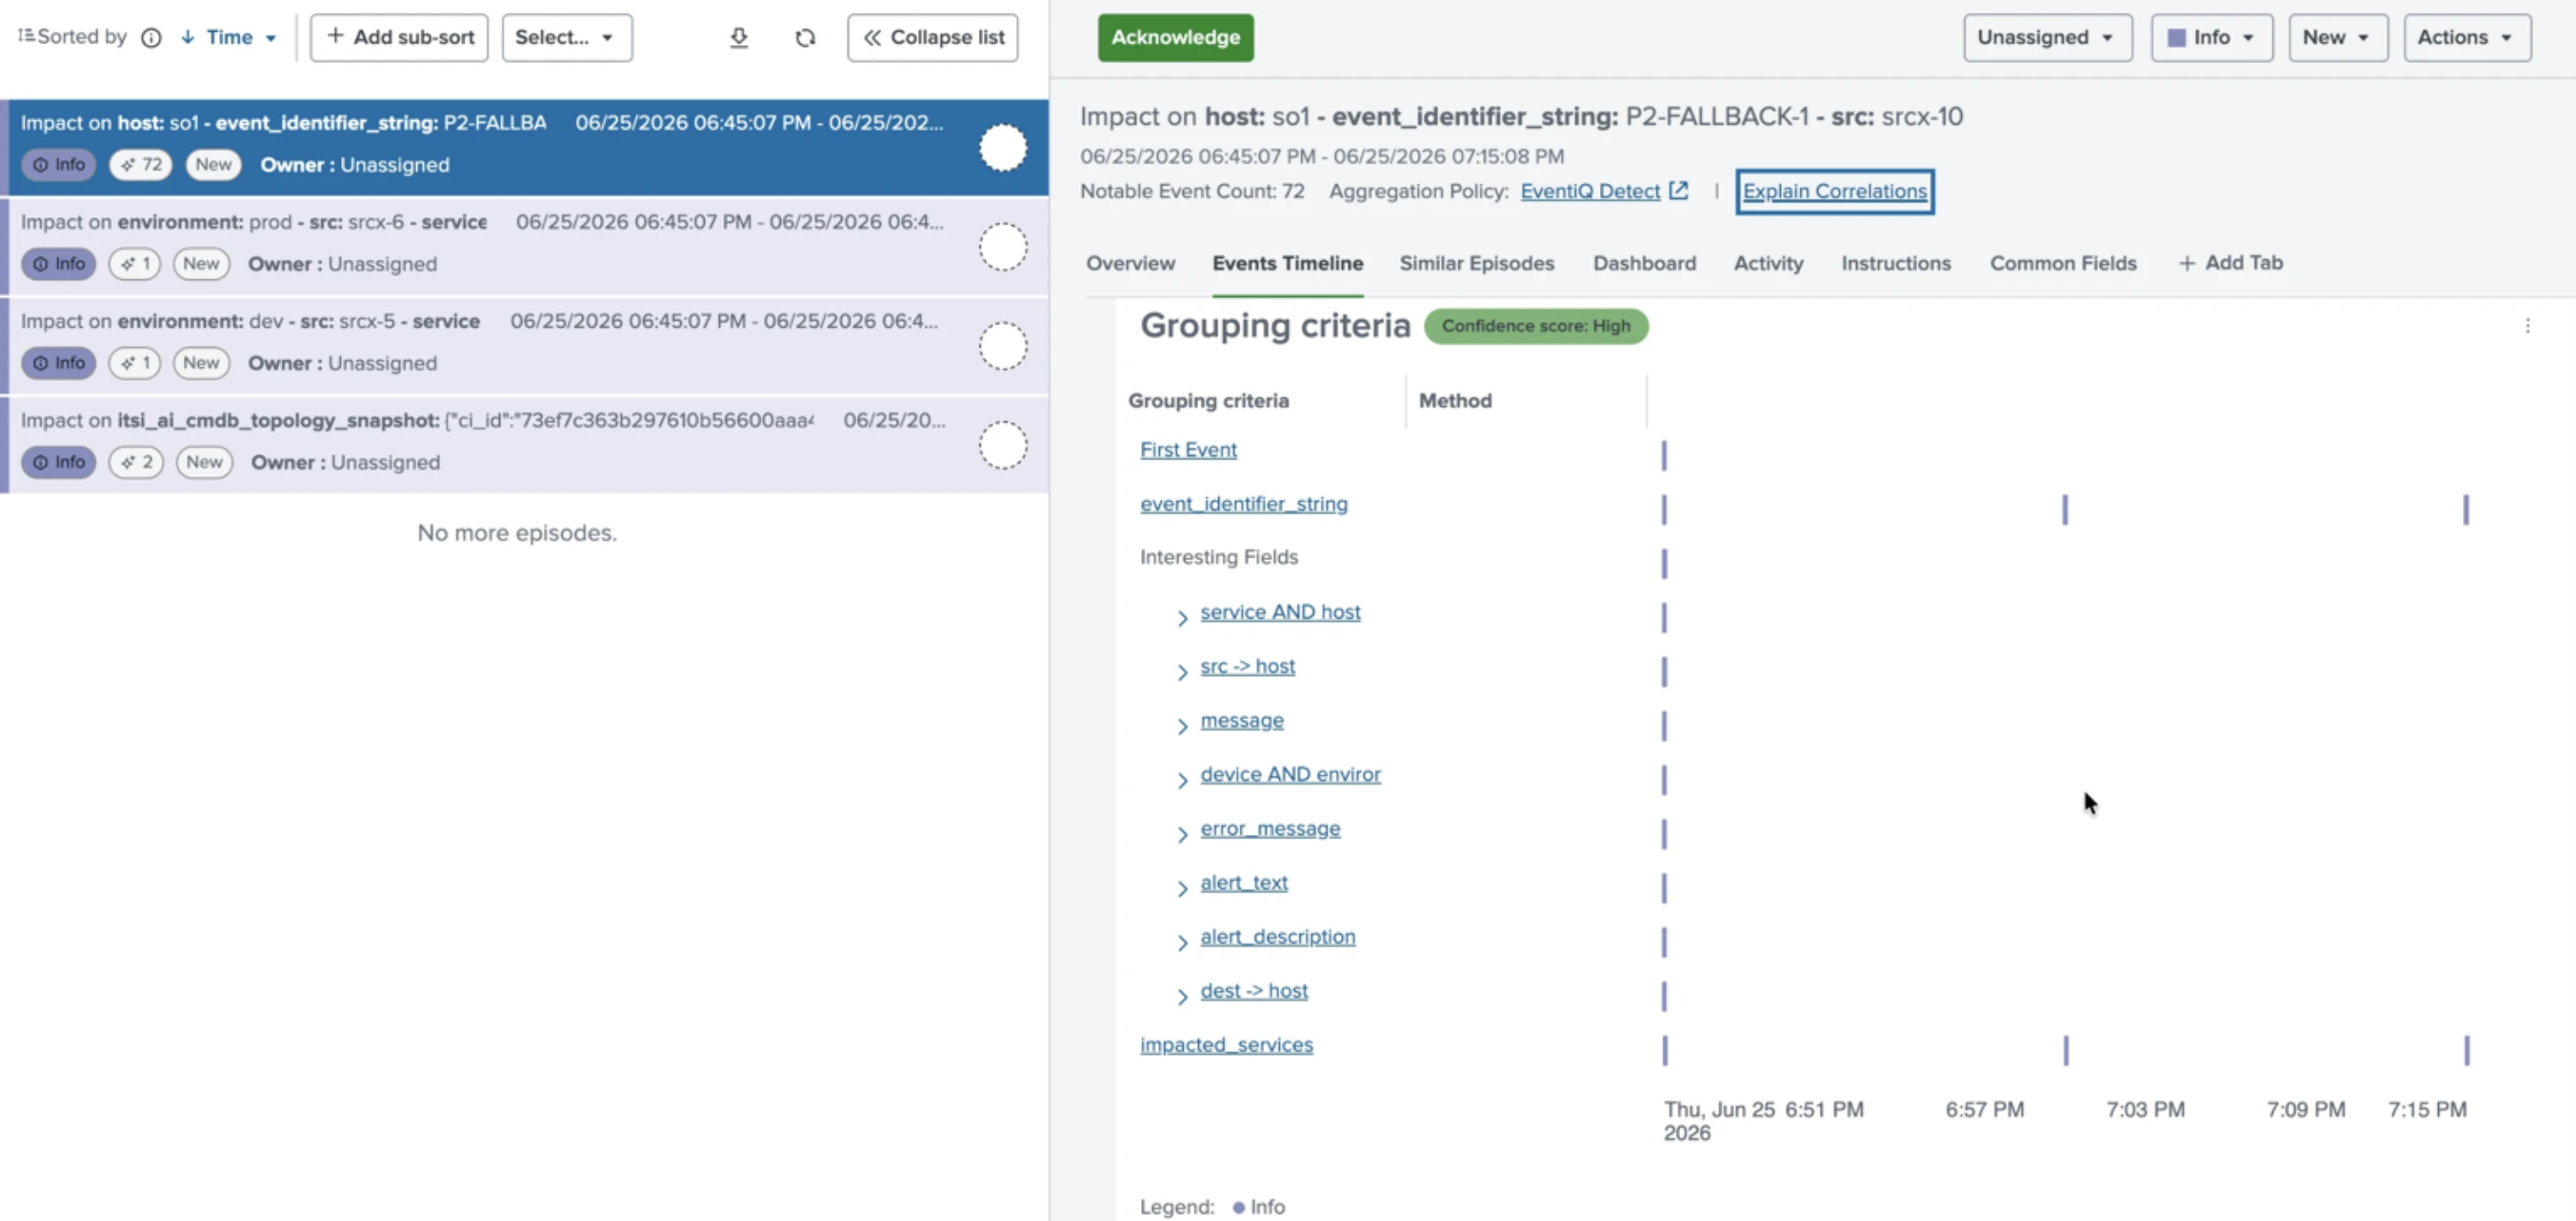
O Event iQ Detect analisa dados históricos de eventos notáveis para recomendar quais campos devem ser usados para agrupar alertas em episódios.
A correlação atual suporta correspondência exata, correspondência normalizada, extração de padrões, correspondência difusa, similaridade semântica, topologia de serviços compartilhados e relacionamentos CMDB pai/filho. A similaridade semântica usa limites de confiança configuráveis, enquanto as políticas de agregação podem classificar campos e combiná-los com lógica AND/OR.
Figura 3: Exemplo de agrupamento de alertas do Event iQ Detect no ITSI.2
Zenoss Cloud
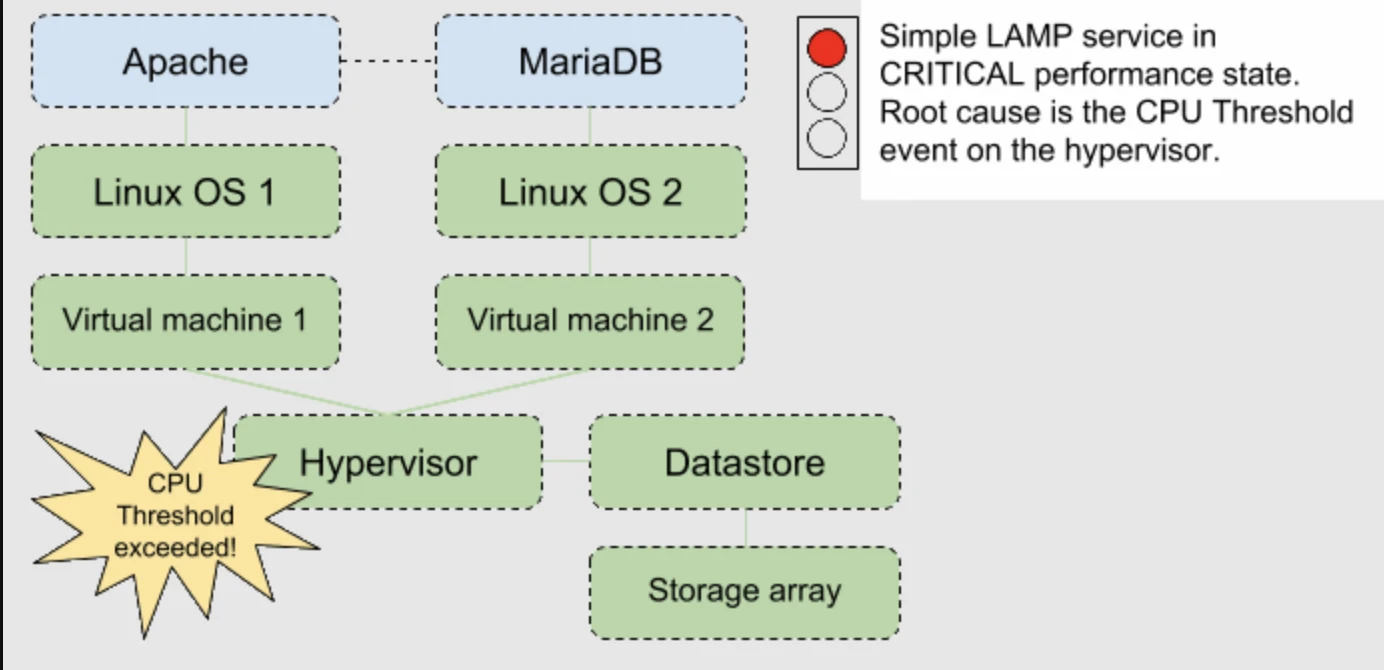
O Zenoss Service Impact mantém um modelo de dependência que vincula os serviços à infraestrutura da qual dependem: por exemplo, processos de aplicação → SO → VM → hipervisor → datastore/armazenamento. O modelo é atualizado quando a infraestrutura monitorada é movida ou alterada.
Quando uma dependência gera um evento de estado ou de limite, o Service Impact propaga seu efeito pelo modelo de dependência e pode identificar o evento de infraestrutura subjacente responsável pelo estado no nível do serviço.
Figura 4: Exemplo de um evento de hipervisor do Zenoss Service Impact.3
Casos de uso de AIOps com exemplos reais
Detecção de Anomaly
A detecção de Anomaly sinaliza desvios do comportamento normal antes que ocorram interrupções. O Watchdog do Datadog calcula proativamente uma linha de base do comportamento esperado e detecta padrões anômalos sem configuração manual de alertas, olhando para trás por até três semanas para considerar a sazonalidade.
O Watchdog também analisa logs ingeridos na entrada em busca de padrões anômalos, como aumentos repentinos no status de aviso ou erro.4
Análise automatizada de causa raiz
A análise automatizada de causa raiz rastreia um incidente até a falha originária em sistemas distribuídos. O mecanismo de causação do Davis IA da Dynatrace coleta todos os traces distribuídos ao longo da pilha horizontal quando um evento é acionado, continuando a análise automaticamente quando um serviço chamado também é marcado como não íntegro.5
Redução de ruído de alertas
A redução de ruído de alertas agrupa alertas relacionados para reduzir a fadiga operacional. O Intelligent Alert Grouping da PagerDuty consolida alertas relacionados em um único incidente usando aprendizado de máquina.6
O BigPanda aplica mecanismos de deduplicação exatos, temporais e baseados em padrões para mesclar alertas em incidentes.7
Monitoramento da integridade da infraestrutura
O monitoramento preditivo da integridade da infraestrutura tem como alvo endpoints e dispositivos. O NinjaOne oferece visibilidade em tempo real de métricas no nível do dispositivo, incluindo carga de CPU, utilização de memória e integridade do disco, com alertas baseados em limites que são acionados antes que os usuários finais relatem problemas.
Remediação assistida por IA
A remediação automatizada ou assistida por IA passa da detecção à ação. O Dynatrace Davis CoPilot for Workflows incorpora IA generativa para auto-summarize problemas, propor etapas de remediação e editar de forma autônoma manifestos do Kubernetes para auto-scaling por meio de automações do GitHub. 8
 Adicionar como fonte preferencial
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{ermut2026,
  author = {Ermut, Sıla},
  title  = {{As 10 principais plataformas de AIOps comparadas}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/aiops-platforms}},
  note   = {AIMultiple. Acessado em 13 novembro 2026}
}Resultados e carimbos de data/hora de 30 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 3 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Links de referência
Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.





Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.