


Otimização de Custos do Kubernetes: 8 Passos e 23 Ferramentas

Os clusters Kubernetes podem parecer totalmente saudáveis enquanto a fatura aumenta. O autoscaling está configurado, os painéis estão verdes e os gastos aumentam mesmo assim. Em uma pesquisa, 42% de 455 engenheiros de plataforma apontaram o custo como seu principal desafio no Kubernetes, enquanto 88% viram o custo total de propriedade aumentar ano após ano.1
Reunimos 68 estudos de caso de otimização de custos do Kubernetes e mapeamos cada caso de uso mencionado para cada fornecedor que o publicou:
Células mais escuras significam mais menções. Células em branco significam que a ferramenta não tem caso publicado para esse caso de uso.
Continue rolando para um guia de 8 passos com exemplos reais para reduzir gastos com clusters e a comparação de ferramentas de otimização de custos do Kubernetes.
1. Meça antes de mudar qualquer coisa
Cada número no restante deste guia é um delta, e um delta precisa de um ponto de partida. Sem uma linha de base capturada antes da primeira mudança, não há como saber se o passo 1 funcionou, nem como atribuir a economia do passo 3 à consolidação e não ao rightsizing que a precedeu. Isso importa mais aqui do que na maioria do trabalho de engenharia, porque todas as seis ações reduzem a mesma fatura e suas economias não se somam. Liberar capacidade no passo 1 não produz nada na fatura até que o passo 3 remova os nós.
Meça quatro coisas:
- Solicitado versus utilizado de CPU e memória, por workload. A lacuna é seu backlog do passo 1, ordenado por tamanho.
- Custo por namespace e por workload. É isso que torna as cotas do passo 2 uma negociação em vez de uma imposição.
- Eficiência de bin packing, alocável versus solicitado por nó. O alvo do passo 3.
- Custo ocioso por hora do dia e dia da semana em não produção. Dimensiona o passo 5 antes de você construí-lo.
Meça ao longo de pelo menos um ciclo de negócios completo. Sete dias é o mínimo e trinta é melhor. A janela não é cautela processual. O passo 1 define as solicitações de memória no máximo observado, e um máximo observado é tão bom quanto a janela que o observou. Um máximo obtido em 48 horas perde um job em lote semanal e produz um OOMKill no domingo seguinte.
Ferramentas
- Alocação de custos: OpenCost, o projeto CNCF por trás do modelo de alocação, é o piso gratuito. A camada gratuito do Kubecost envolve o mesmo mecanismo em uma UI até 250 núcleos.
- Utilização: Prometheus com kube-state-metrics é o substrato. O Robusta KRR lê isso diretamente sem instalar nada no cluster.
- Gastos mais amplos: Onde o Kubernetes é uma parte de uma fatura que finanças também precisa explicar, CloudZero, Vantage e Finout ficam acima dessa camada em vez de substituí-la.
Ambas as ferramentas de custo atribuem por label, então a rotulagem vem primeiro. Gastos não rotulados são o motivo mais comum para uma linha de base se tornar inútil três semanas depois.
Cada ação abaixo declara a recomendação, o método, a configuração e uma empresa que deu esse passo. Cada estudo de caso e cada estatística traz um link de origem.
2. Defina cotas de namespace como guardrails
A economia decai à medida que as equipes implantam novos workloads sem requests especificadas. Um LimitRange fornece requests padrão para contêineres que as omitem, e um ResourceQuota limita o que um namespace pode consumir no agregado.
Implante o LimitRange antes do ResourceQuota. Uma vez que uma cota restringe um recurso, qualquer pod sem uma request para esse recurso é rejeitado na admissão, então a ordem inversa quebra as implantações.2
Cada load balancer é cobrado separadamente pelo provedor de nuvem, e volumes órfãos continuam a cobrar depois que seus pods desaparecem.
2. Faça o rightsizing de solicitações de CPU e memória
As requests determinam a contagem de nós, e a contagem de nós determina a fatura. A maioria dos clusters opera muito abaixo da capacidade pela qual pagam, porque as requests foram definidas uma vez e nunca revisadas. Uma análise de 23.000 clusters de produção na AWS, Azure e Google Cloud encontrou utilização média de CPU em 8%, memória em 20% e GPU em 5%. 3
Defina as requests de CPU próximas ao percentil 95 do uso observado. Defina as requests de memória no máximo observado em vez de um percentil, e defina o limite de memória igual à request. Um percentil deixa o contêiner com falta durante o tráfego restante, e como o limite corresponde à request, essa falta chega como OOMKill em vez de lentidão.
Omita o limite de CPU. O throttling de CPU degrada a latência sem matar o pod, e a request reserva o que o workload precisa.
O Vertical Pod Autoscaler no modo somente recomendação produz esses números sem risco de produção.
Leia as recomendações com kubectl describe vpa payments-api e compare o valor alvo com a request atual.
Estudo de caso real: Tryg Insurance
A Tryg Insurance é a maior seguradora geral da região nórdica e executa Kubernetes na infraestrutura Oracle Cloud. Sua equipe de engenharia combinou o Horizontal Pod Autoscaler e o Vertical Pod Autoscaler para fazer o rightsizing de workloads dinamicamente, mantendo os níveis de serviço, e reduziu os custos de nuvem do Kubernetes em 50% usando apenas autoscalers de código aberto, sem nenhuma plataforma comercial de otimização.4
4. Consolide nós com o Karpenter e escale workloads ociosos para zero
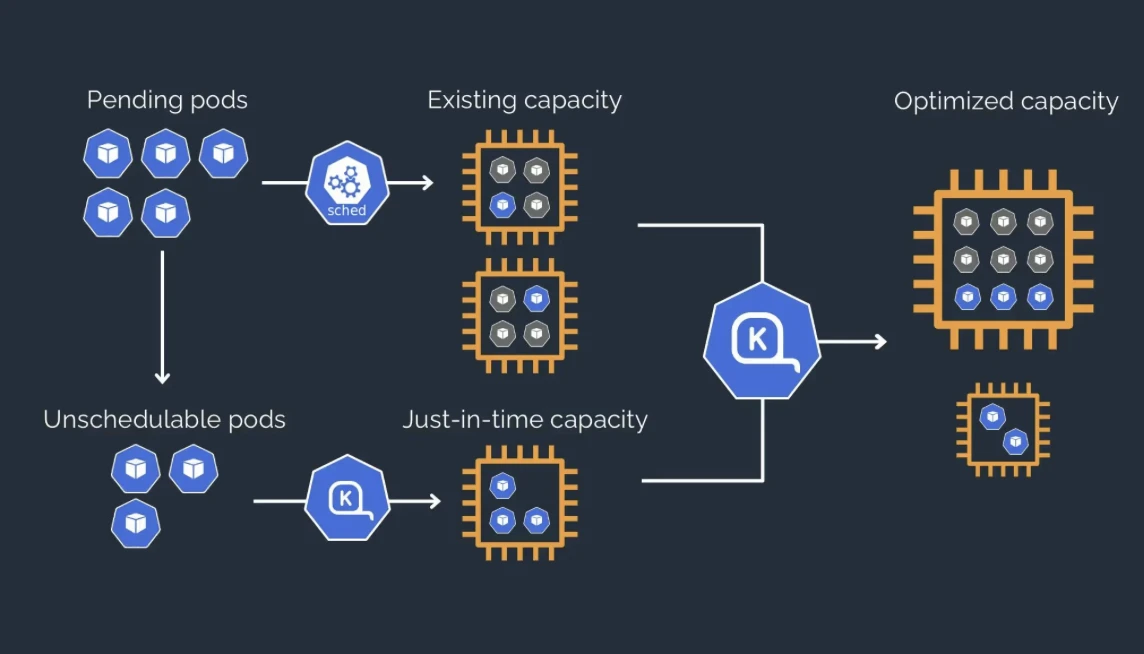
O rightsizing libera capacidade, mas essa capacidade fica em nós que continuam em execução até que algo os remova. O Karpenter provisiona instâncias em tempo e reempacota workloads em menos nós. O KEDA escala workloads orientados por fila para zero réplicas, o que um Horizontal Pod Autoscaler padrão não consegue fazer.
Defina a política de consolidação como WhenEmptyOrUnderutilized. A alternativa, WhenEmpty, restringe a interrupção a nós que não contêm nenhum pod de workload, e esses raramente ocorrem sem intervenção. 5
Uma lista estreita de instâncias prejudica isso, porque o Karpenter não consegue encontrar outliers baratos e sua resiliência a spot cai. Você deve deixá-lo escolher entre famílias inteiras de instâncias.
Estudo de caso real: Adidas
A Adidas executa vários clusters Kubernetes no AWS EKS. Sua equipe de engenharia de plataforma adotou o Karpenter para provisionamento de nós, adicionou o KEDA para escalonamento orientado por eventos, auto-criou objetos do Vertical Pod Autoscaler por meio de políticas Kyverno e usou o kube-downscaler para ambientes ociosos. Eles reduziram o custo de execução de seus clusters Kubernetes na AWS em até 50%, usando uma stack totalmente de código aberto.6
5. Prepare-se adequadamente antes de mover workloads para spot
Instâncias spot oferecem o maior desconto disponível e a aplicabilidade mais restrita. Nada deve ir para spot até que PodDisruptionBudgets, diversificação de instâncias, distribuição de topologia e tratamento de encerramento estejam todos implementados.
Um PodDisruptionBudget que não deixa folga bloqueia toda interrupção voluntária, incluindo a consolidação do Karpenter, então os valores precisam de folga. 7
Estudo de caso real: Delivery Hero
A Delivery Hero opera 390 aplicativos em 43 países, com cerca de 90% dos workloads executados no AWS EKS. Sua equipe migrou para Spot Instances ao longo de aproximadamente seis meses, incorporando tratamento de encerramento e um descheduler ao processo em vez de alternar diretamente os tipos de capacidade.
- Os custos de infraestrutura caíram cerca de 70%
- Os descontos spot chegaram a até 90% em relação ao preço sob demanda
- A plataforma absorve picos de tráfego de 4 a 5 vezes o volume normal.8
6. Desligue a não produção em uma programação
Os ambientes de desenvolvimento e staging carregam pouca ou nenhuma carga durante a noite e nos fins de semana. O desligamento programado é tecnicamente simples e sem controvérsia política, o que o torna a economia mais rápida de entregar e uma primeira ação útil onde mudanças mais difíceis precisarão de apoio depois.
Aplique a programação por padrão em todos os namespaces de não produção e exija que as equipes optem explicitamente por sair. Uma política que exige ação para entrar alcança menos equipes do que uma que exige ação para sair.
A economia chega à fatura se a consolidação de nós estiver em execução, pois implantações reduzidas deixam nós vazios para trás.
Estudo de caso real: Bud Financial
O Bud Financial enriquece dados de transações financeiras para o setor de serviços financeiros e executa cerca de 25 clusters no Google Kubernetes Engine. Sua equipe usou pausa e retomada programadas para reduzir os nós do cluster durante a noite e nos fins de semana, juntamente com reequilíbrio diário.
- Os custos caíram 47% apenas com a mudança de programação
- A programação removeu 80 horas de operação do cluster por semana
- A utilização de recursos subiu acima de 90%.9
7. Migre workloads compatíveis para ARM
Instâncias baseadas em ARM mudam o preço unitário em vez de competir pela mesma capacidade ociosa das ações acima, então essas economias genuinamente se somam às demais. Os bloqueadores serão dependências sem builds ARM64.
Os usuários devem dimensionar isso por workload em vez de em todo o parque, e criar imagens multiarquitetura antes de agendar qualquer coisa.
Estudo de caso real: Pinterest
O Pinterest migrou seu workload de web API para instâncias AWS Graviton executando em ARM64, motivado tanto pela redução de custos quanto de carbono.
- Os custos caíram 47%
- O consumo de computação caiu 38%
- As emissões de carbono caíram 62%.10
8. Quando o ajuste se esgotar, mude a arquitetura
As seis ações acima ajustam workloads dentro dos clusters existentes. Uma vez esgotadas, ganhos adicionais exigem mudança arquitetural em vez de mais ajustes.
Dois resultados publicados marcam o limite prático. A InCred Finance reduziu gastos em 30% em clusters que sua equipe considerava otimizados11, e a Yotpo alcançou 30–40% enquanto executava 80% dos workloads em instâncias spot12. Além desse intervalo, o desperdício restante não está mais dentro dos clusters, mas no número de clusters. Cada um carrega uma cobrança de plano de controle e forma uma ilha de agendamento que o bin packing não consegue cruzar.
Multitenancy remove ambos os custos. Em vez de dedicar um cluster a cada cliente, equipe ou ambiente, clusters virtuais rodam em infraestrutura física compartilhada. Cada tenant recebe seu próprio servidor de API e plano de controle virtual, enquanto os nós são agrupados. Isso elimina a cobrança de plano de controle por cluster e permite bin packing no pool de nós compartilhado, em vez de dentro de propriedades isoladas.
yaml
bash
Dois mecanismos estão disponíveis. Namespaces são sempre mais baratos, então a escolha é feita pela separação que os tenants exigem, não pelo custo.
- Namespaces particionam um único cluster e não adicionam plano de controle próprio. Eles são suficientes quando os tenants confiam uns nos outros e podem compartilhar um servidor de API e um conjunto de CRDs.
- Clusters virtuais dão a cada tenant seu próprio servidor de API, rodando como workload no host. Esse custo se justifica em dois casos: tenants que precisam de seus próprios recursos com escopo de cluster, e requisitos de isolamento que um servidor de API compartilhado não consegue atender.
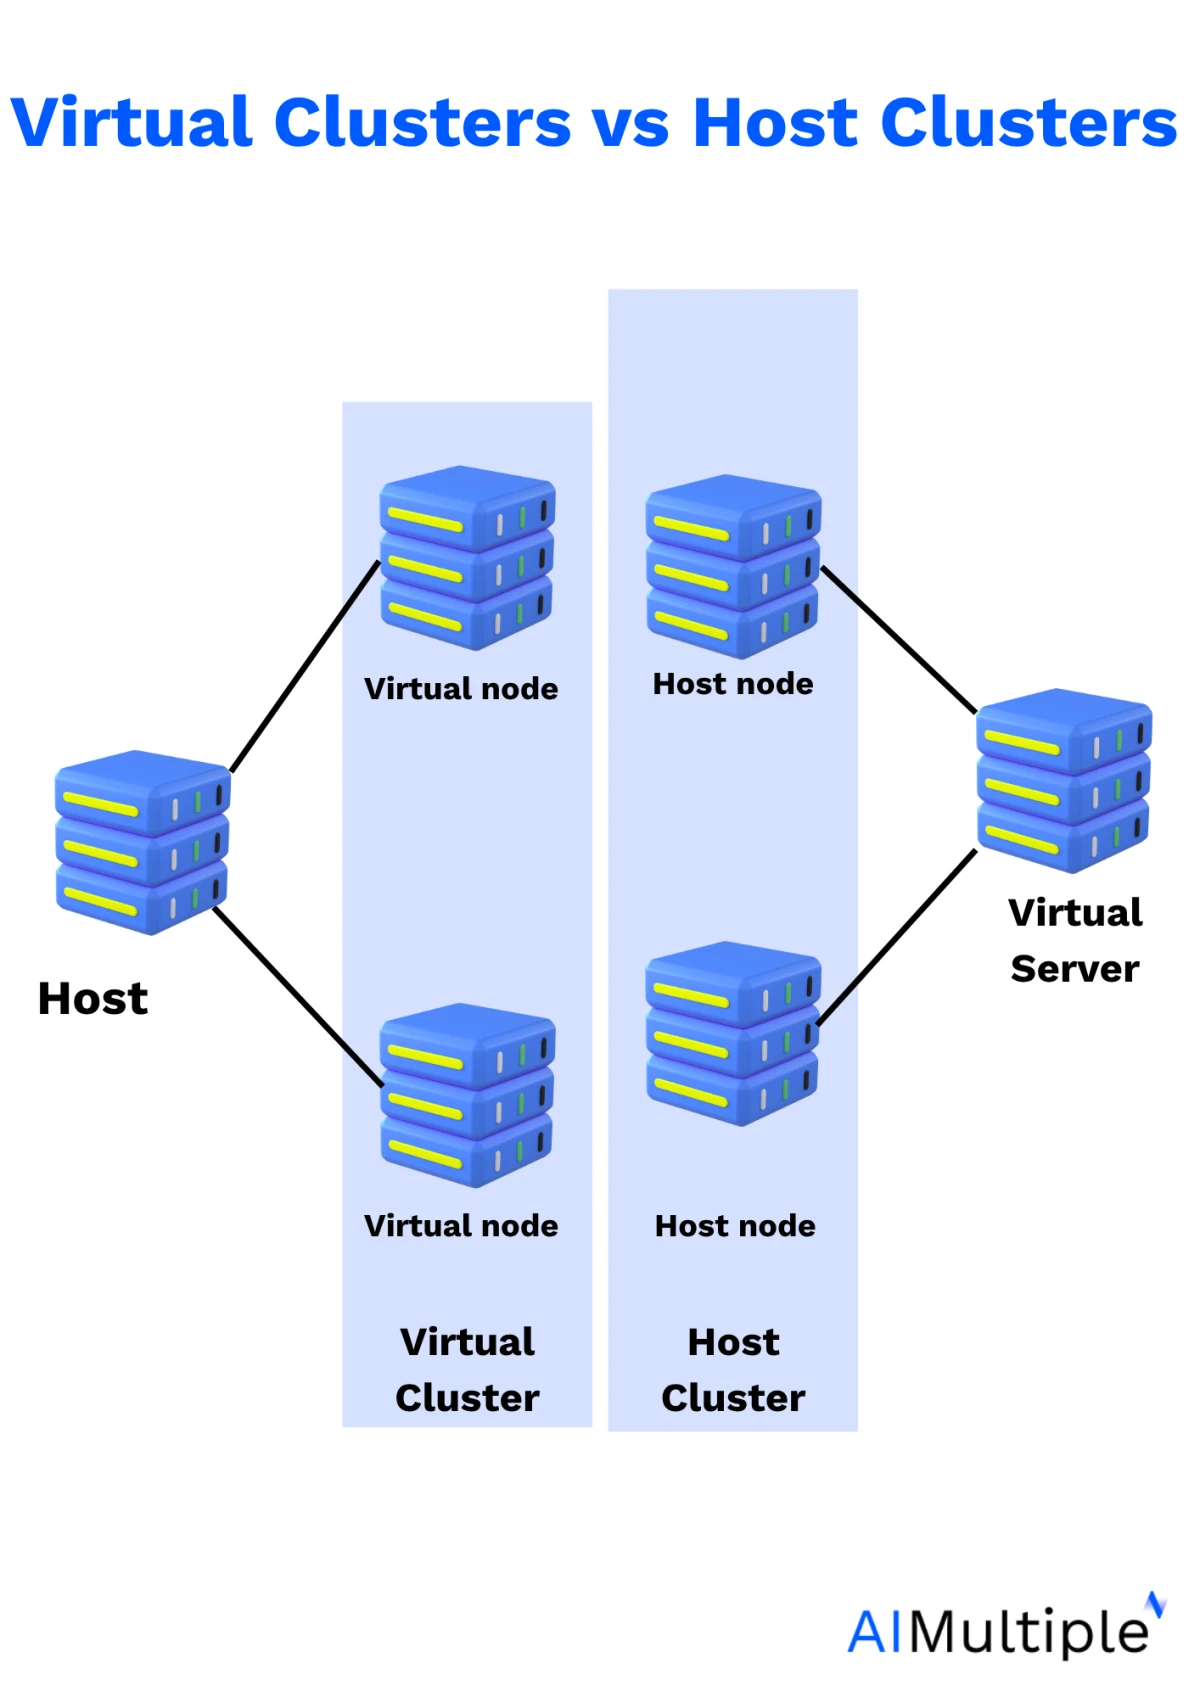
Estudo de caso real: Atlan
A Atlan é uma empresa de catálogo de dados que hospeda a plataforma para cerca de 95% de seus clientes, muitos em saúde e finanças onde o isolamento de dados é contratual. Ela rodava um cluster EKS completo por cliente e passou de 100 clusters, um parque caro de executar 24 horas por dia e difícil de manter. A partir do primeiro trimestre de 2022, avaliou opções de multitenancy e reconstruiu no vCluster, dando a cada cliente um cluster virtual em vez de físico.
- Os clusters EKS físicos caíram de mais de 100 para 20, ainda atendendo a 100+ clientes
- Os gastos com Kubernetes caíram em $600.000.13
 Adicionar como fonte preferencial
Ordem de execução
Os compromissos ficam por último, apesar de serem a ação mais fácil. Comprá-los antes do rightsizing prende de um a três anos do desperdício que o rightsizing estava prestes a remover. É o erro de sequenciamento mais caro disponível e é comum porque exige uma compra em vez de trabalho de engenharia.
A ação 7 é um desvio, não um passo. Siga-a quando as seis primeiras estiverem concluídas e o resultado ainda for insuficiente, pois ela muda quantos clusters rodam, e não a eficiência com que cada um roda.
Ferramentas de otimização de custos do Kubernetes
Plotamos ferramentas com três ou mais estudos de caso publicados cobrindo 47 dos 68 estudos de caso no dataset:
- Horizontal: quantos estudos de caso cada ferramenta tem, contados uma vez cada.
- Vertical: quantas categorias distintas de casos de uso esses casos abrangem, de dez. Uma ferramenta conta uma vez por categoria, não importa quantas vezes apareça lá, então as CAST IA’s 12 menções separadas de rightsizing contribuem com 1 para sua pontuação de 10.
- Tamanho da bolha: em quantos dos oito estágios de estratégia a ferramenta aparece.
Frameworks de código aberto
Frameworks de código aberto podem ser implantados para estágios de 0 a 6. Os usuários assumem as atualizações, a rotatividade de versões, a conta de retenção do Prometheus e as decisões de julgamento que um recomendador comercial tomaria por eles.
Cada uma delas possui um campo diferente, e é por isso que várias rodam ao mesmo tempo.
- Robusta KRR ou VPA em
updateMode: "Off"produz o backlog do passo 1. Não escreve nada. - Karpenter é dono dos nós: provisionamento, consolidação, seleção de instâncias, diversificação de spot, arquitetura. Carrega os passos 3, 4 e 6.
- KEDA é dono da contagem de réplicas, incluindo escalar para zero, o que o HPA sozinho não consegue fazer.
- py-kube-downscaler ou kube-green é dono da programação de não produção. A economia mais barata da lista.
- OpenCost mede o tempo todo e não participa de nada.
Plataformas comerciais
Cada ferramenta comercial assume uma de três posições na camada de nós. Essa é a decisão, e importa mais do que preço ou contagem de recursos, porque o manifesto NodePool do passo 3 ou sobrevive ou não.
- Deixe como está: StormForge, PerfectScale, Sedai e Kubex fazem rightsizing de workloads. Eles precisam do Karpenter ou Cluster Autoscaler por baixo e nunca o tocam. A adição mais segura a uma configuração existente.
- Trabalhe com isso: O ScaleOps adiciona bin packing sobre o Karpenter. O nOps ajusta um Cluster Autoscaler ou Karpenter existente em vez de substituir o seu. Mais cobertura, provisioner ainda é seu.
- Substitua: CAST IA e Spot Ocean instalam seu próprio provisioner e descartam o manifesto. Cobertura mais ampla, menos controle.
- Ferramentas de visibilidade ficam do lado de fora: OpenCost, Kubecost, CloudZero, Vantage e Finout são somente leitura, então não conflitam com nada e se combinam livremente. Execute uma independentemente do que mais for adotado.
Como combinar essas ferramentas
A fatura é baseada nos nós em execução, não nas requests declaradas. O rightsizing reduz as requests, o que libera espaço nos nós existentes, mas não remove nenhum deles, então a fatura permanece inalterada até que uma ferramenta de nós consolide esse espaço. Ferramentas de nós sozinhas falham pelo motivo inverso: elas empacotam quaisquer requests que recebem, então requests superdimensionadas são empacotadas com mais força.
Duas maneiras de cobrir ambas as camadas:
- Duas ferramentas: VPA, StormForge ou PerfectScale para requests, mais Karpenter para nós. Mais barato, e a camada de nós permanece sob controle direto.
- Uma plataforma: CAST IA, Zesty ou Spot Ocean fazem ambos em um único produto. Mais caro, e o provisioner deles substitui o Karpenter.
Cinco combinações de ferramentas que quebram tudo:
- Dois rightsizers mutantes em uma implantação: VPA em
Autojunto com StormForge, ScaleOps, PerfectScale ou Zesty significa dois controllers escrevendo números diferentes no mesmo campo. Um admission controller mutante por workload. - Karpenter e Cluster Autoscaler em um grupo de nós: Ambos provisionam contra os mesmos pods não agendáveis, então o cluster acaba com aproximadamente o dobro dos nós de que precisa.
- VPA e HPA na mesma métrica: O uso sobe, o VPA aumenta a request, a utilização medida cai porque é uso sobre request, o HPA remove réplicas, a carga por pod sobe, repita. Seguro quando o HPA escala em algo que o VPA não toca, como profundidade de fila via KEDA.
- Duas ferramentas de compromisso em uma conta pagadora: Ambas compram contra o mesmo gasto não coberto, travando o excesso de compromisso por um a três anos.
- Duas plataformas completas: CAST IA, Zesty e Spot Ocean instalam, cada uma, seu próprio provisioner e esperam ser donos dele.
Examine todos os estudos de caso que reunimos:
Leitura adicional sobre custos de nuvem
Leia mais para dominar o posicionamento de pods e reduzir seus gastos com computação em nuvem:
- Compare as principais ferramentas de orquestração de contêineres
- Compare 20+ orquestradores de nuvem
- Principais agendadores de jobs de nuvem híbrida
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{Otimização de Custos do Kubernetes: 8 Passos e 23 Ferramentas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/kubernetes-cost-optimization}},
  note   = {AIMultiple. Acessado em 15 outubro 2026}
}Resultados e carimbos de data/hora de 249 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 6 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Links de referência
A seguir, leia
As 15 melhores ferramentas de otimização para mecanismos de resposta

Otimização para Mecanismos de Resposta (AEO): Dicas e Melhores Práticas
Melhores 10 nuvens de GPU serverless e 14 GPUs econômicas


Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.