


Le migliori 10 piattaforme AIOps a confronto
Le piattaforme AIOps applicano l'apprendimento automatico e l'IT agentico alle attività operative IT come il rilevamento delle anomalie, la correlazione degli eventi e l'analisi delle cause principali. Abbiamo confrontato le migliori 10 piattaforme AIOps in base alle loro caratteristiche chiave e distintive, ai piani tariffari e ai casi d'uso principali.
Funzionalità principali delle piattaforme AIOps
Prodotto | Rilevamento anomalie ML | Rimedio automatico | Correlazione eventi / riduzione del rumore | RCA automatica / IA | Analisi predittiva |
|---|---|---|---|---|---|
Limitato | ✓ | Limitato | Limitato | Limitato | |
BigPanda | Limitato | Limitato | ✓ | ✓ | Limitato |
Datadog | ✓ | ✓ | ✓ | ✓ | Limitato |
Dynatrace | ✓ | ✓ | ✓ | ✓ | ✓ |
IBM Instana | ✓ | Limitato | ✓ | ✓ | Limitato |
LogicMonitor | ✓ | Limitato | ✓ | ✓ | ✓ |
New Relic | ✓ | Limitato | ✓ | ✓ | Limitato |
OpenText OpsBridge | ✓ | ✓ | ✓ | ✓ | ✓ |
Splunk ITSI | ✓ | ✓ | ✓ | ✓ | ✓ |
Zenoss Cloud | ✓ | Limitato | ✓ | ✓ | ✓ |
Nota: tutte le tabelle sono ordinate alfabeticamente. I nostri abbonati sono elencati per primi.
Funzionalità distintive degli strumenti AIOps
Le migliori 10 piattaforme AIOps a confronto
NinjaOne
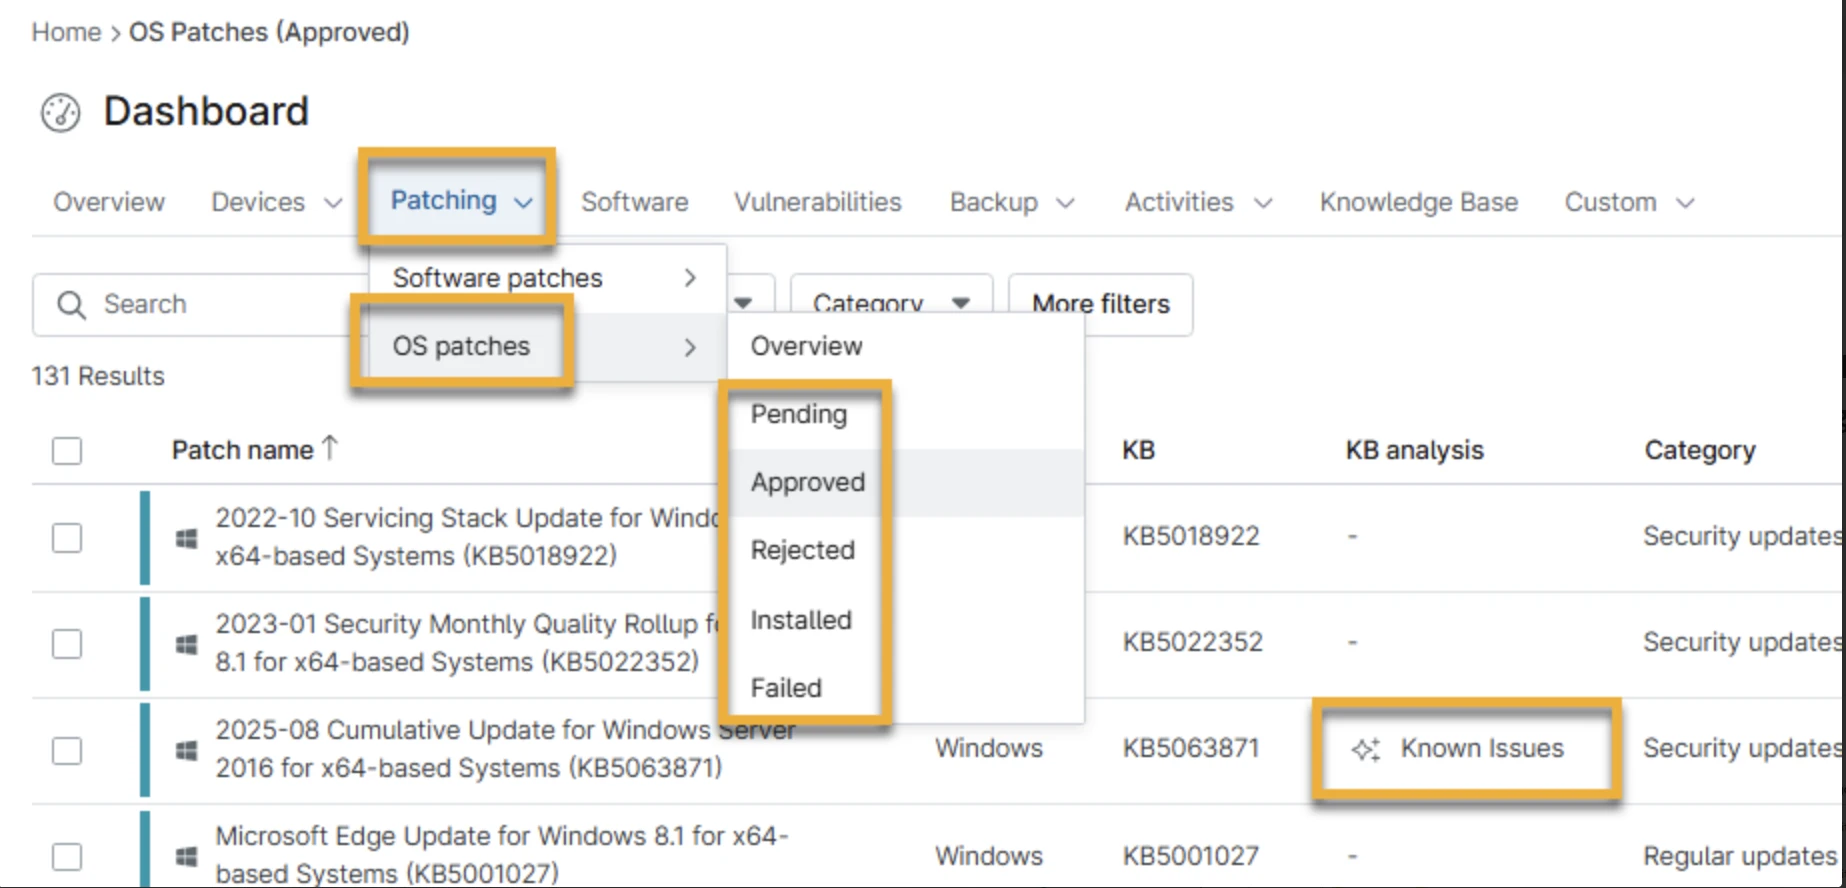
NinjaOne’s Patch Intelligence IA combina l'IA generativa, le informazioni sulle patch di terze parti e la telemetria anonimizzata di failure/rollback di NinjaOne. Rivaluta lo stato delle patch ogni sei ore e può modificare automaticamente una patch altrimenti approvata in Manual o Reject quando rileva problemi noti o tassi elevati di failure/rollback.
Katana IA (accesso anticipato) analizza la telemetria dei dispositivi, la cronologia degli avvisi e l'attività per summarize i problemi e far emergere le probabili cause principali. Correla gli alert correlati, assegna priorità a cosa correggere successivamente e consiglia script. Un tecnico approva qualsiasi azione prima che venga eseguita, e le raccomandazioni e le azioni vengono registrate. Tramite il server MCP di NinjaOne, gli agenti IA esterni possono interrogare e agire sui dati degli endpoint con le stesse autorizzazioni basate sui ruoli.
Figura 1: Immagine che mostra come i dati di Patch Intelligence IA appaiono nella colonna KB Analysis sotto Patching.
BigPanda
L'Agente L1 di BigPanda esegue runbook predefiniti del cliente tramite un worker containerizzato on-premise. Il worker effettua connessioni mTLS in uscita, non conserva credenziali permanenti, ottiene credenziali a breve durata tramite un ruolo di servizio definito dal cliente ed esegue flussi di lavoro pre-registrati. I passaggi diagnostici in sola lettura possono essere eseguiti senza approvazione; le azioni correttive come il riavvio di un servizio richiedono un'approvazione esplicita.
Datadog
Datadog’s Bits Investigation esegue un ciclo iterativo: formula un'ipotesi di causa principale, interroga la telemetria, valuta le prove, quindi rivede o elimina le ipotesi.
Può ispezionare metriche, log, tracce, stato dei monitor, RUM, Synthetics, dipendenze dei servizi, incidenti, dashboard e fonti esterne come Confluence. L'interfaccia utente registra l'indagine sia come registro cronologico dei passaggi sia come albero delle ipotesi.
Dynatrace
Dynatrace memorizza la topologia Smartscape come nodi e relazioni in Grail. DQL può eseguire ricerche su questa topologia e seguire le relazioni tra servizi, processi, host, risorse cloud e componenti Kubernetes.
Davis di Dynatrace correla gli eventi che condividono una causa principale dedotta in un unico problema e memorizza l'entità Smartscape identificata come causa principale insieme alle entità interessate. Poiché Grail memorizza la topologia insieme a log, span, metriche ed eventi, le query DQL possono attraversare le dipendenze e arricchire la telemetria con il contesto delle entità.
IBM Instana
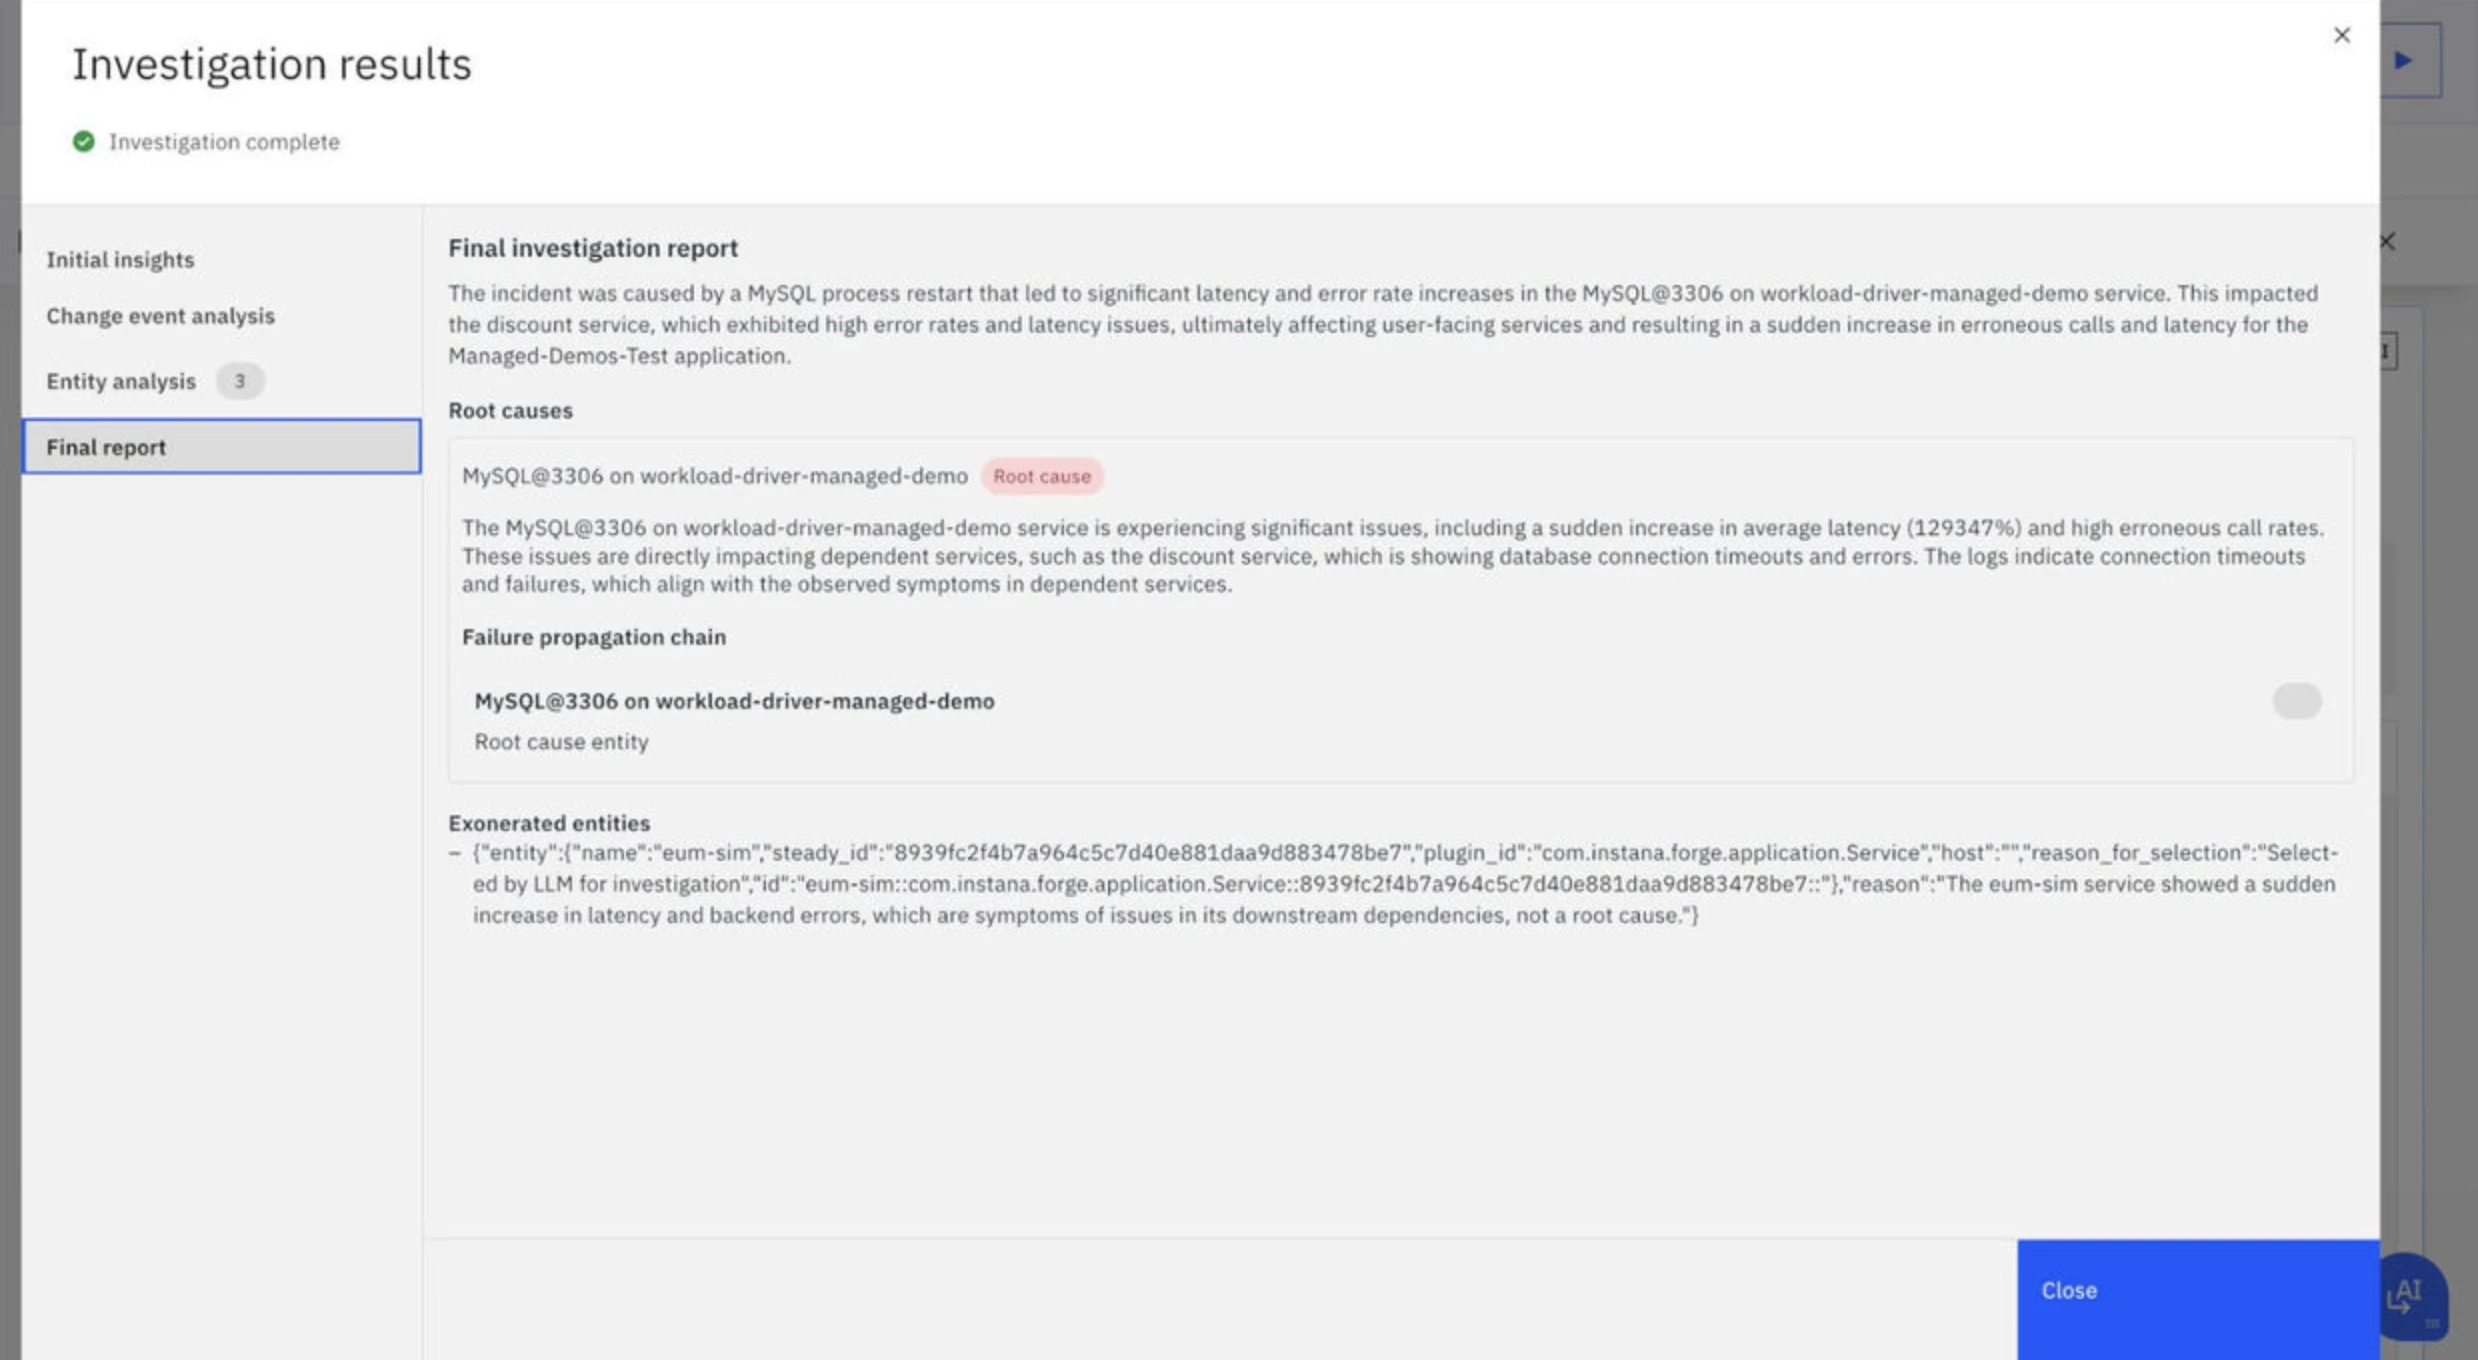
Intelligent Incident Investigation di Instana crea e verifica ipotesi rispetto all'ambiente monitorato. L'indagine registra quali ipotesi ha verificato, quali prove ha raccolto e quali componenti ha ispezionato.
Una volta accettata una causa, Instana può generare un runbook di risoluzione passo-passo e produrre uno script Bash o un playbook Ansible per i singoli passaggi di risoluzione, quindi esportarlo per la revisione e la distribuzione.
Figura 2: Dashboard di indagine IA agentica di IBM Instana.1
LogicMonitor
Edwin IA Investigation di LogicMonitor utilizza alert, metriche, log, richieste di modifica, risultati diagnostici e output di risoluzione per costruire una cronologia dell'incidente, un'analisi dell'impatto e la causa probabile.
Edwin correla gli alert in “Insights”, e il suo agente può operare sia globalmente sia nel contesto di uno specifico alert/Insight. Il sistema di indagine lavora sugli oggetti incidente correlati di LogicMonitor e sui metadati associati.
New Relic
Il server MCP di New Relic dà agli agenti IA esterni accesso a specifiche funzioni di osservabilità. Gli strumenti disponibili includono la conversione di domande in linguaggio naturale in NRQL, la generazione di report su alert e impatto sugli utenti, l'analisi dell'impatto del deployment, la ricerca di tracce, il rilevamento di tracce anomale e la mappatura delle dipendenze dei servizi upstream e downstream.
OpenText OpsBridge
Per le operazioni IT, Aviator di OpenText può lavorare con i prodotti OpenText di osservabilità, gestione dei servizi, automazione, CMDB e gestione degli asset.
OpenText fornisce anche Aviator Studio per creare e distribuire agenti personalizzati, mentre Service Management Aviator gestisce flussi di lavoro di IA generativa privata per casi d'uso di supporto e gestione dei servizi.
Splunk ITSI
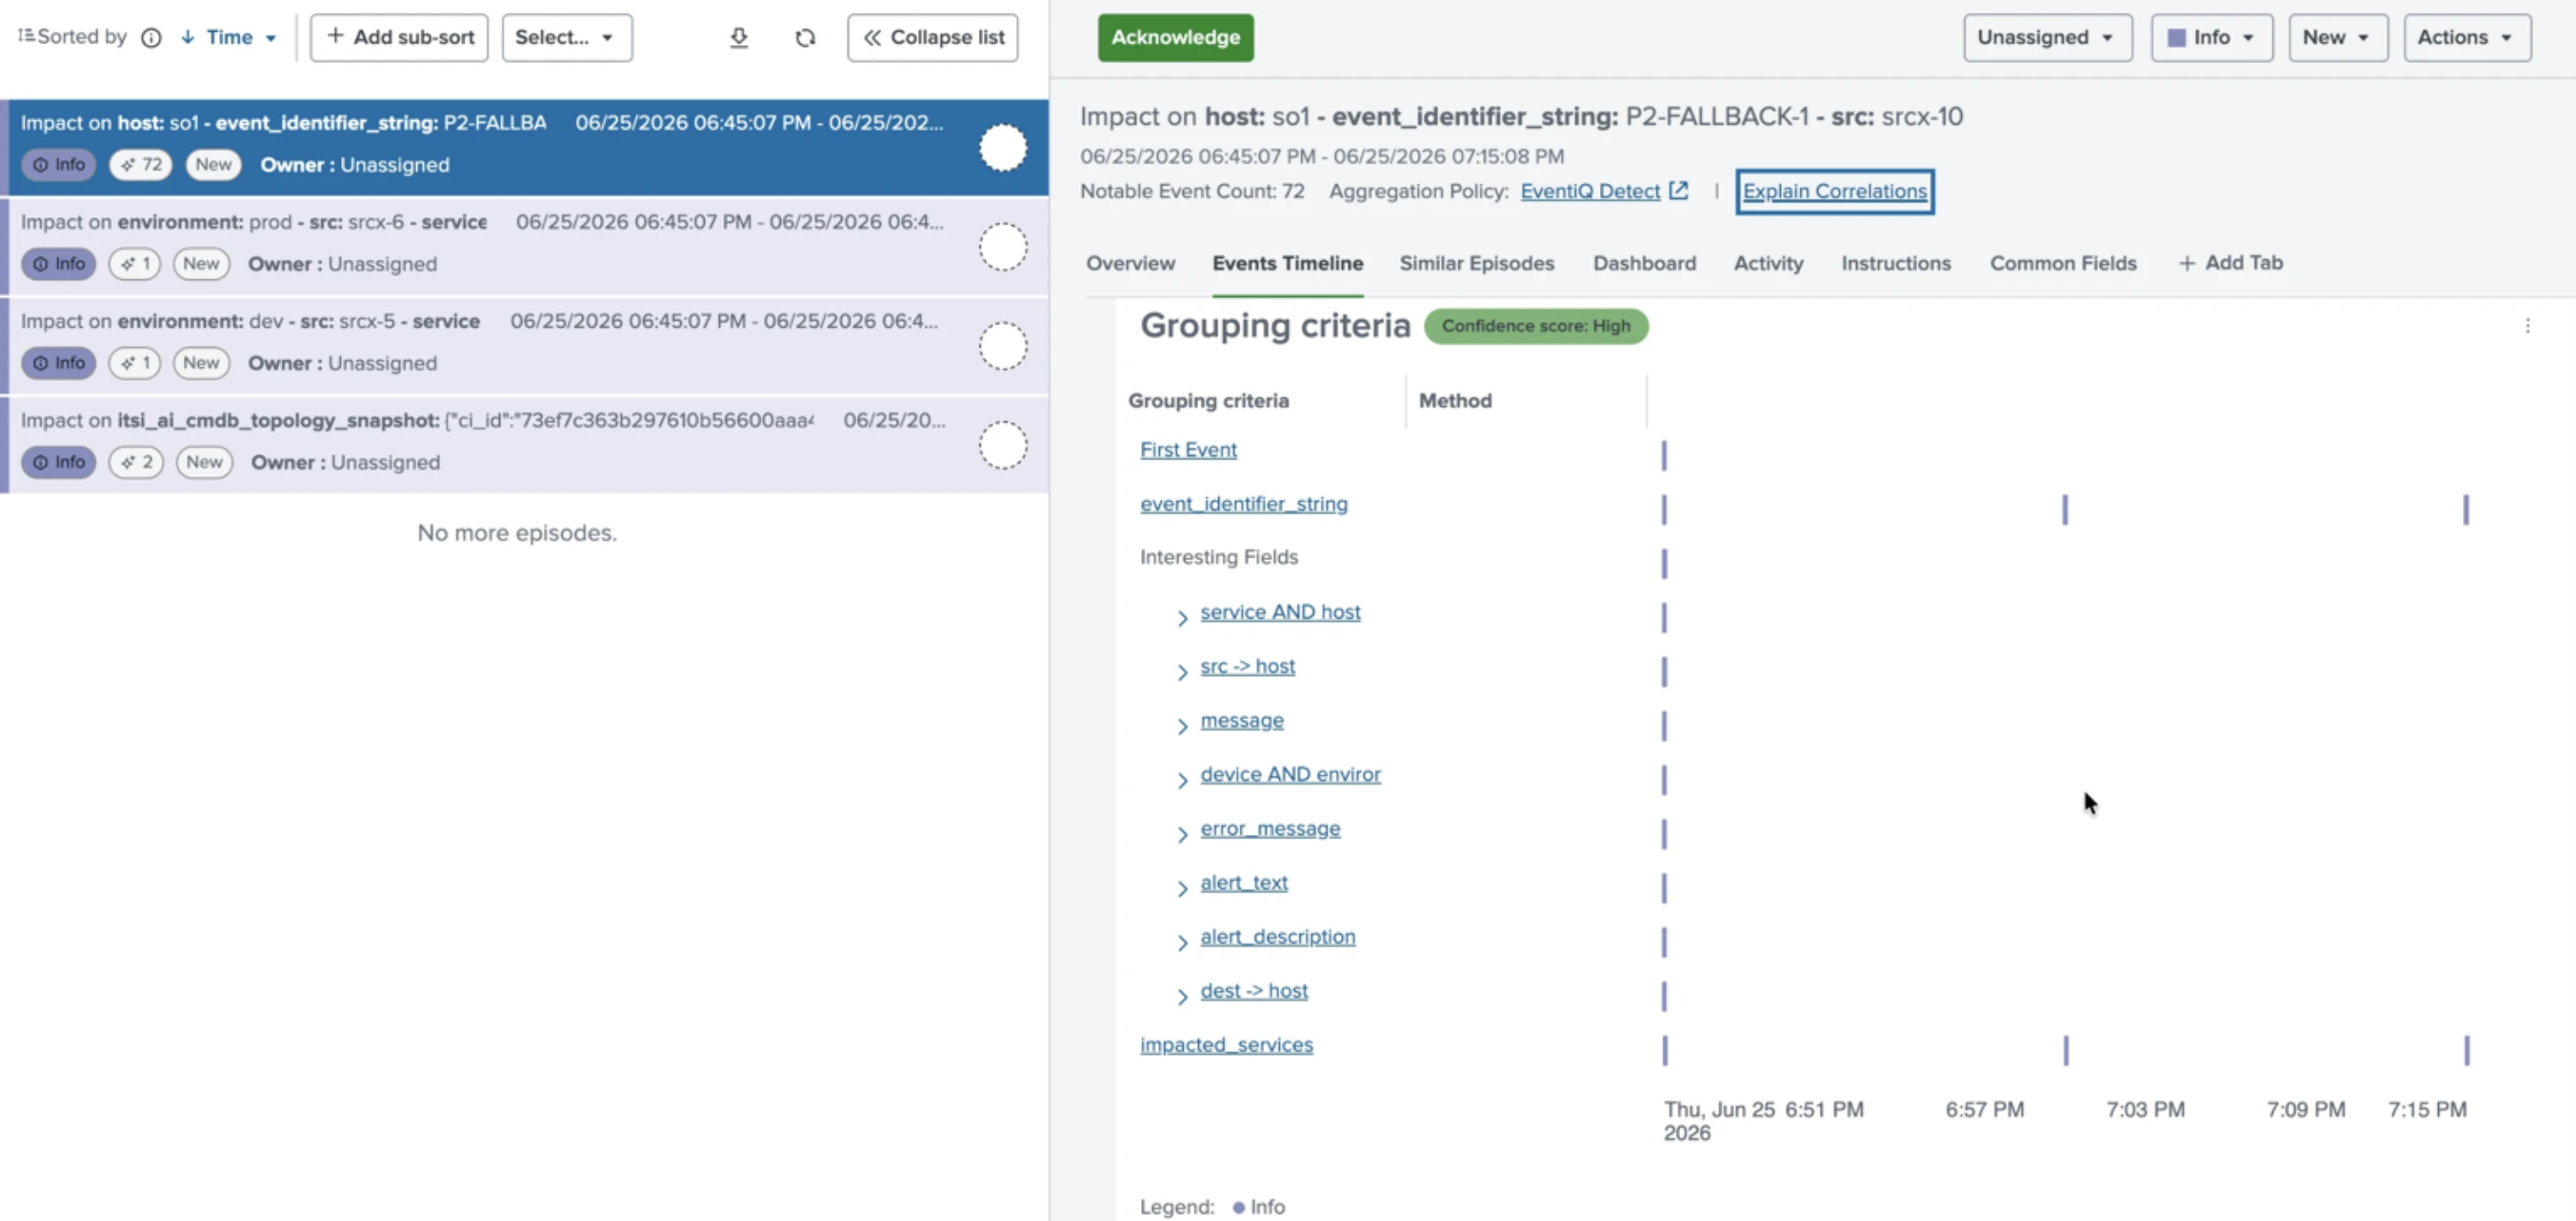
Event iQ Detect analizza i dati storici degli eventi rilevanti per consigliare quali campi utilizzare per raggruppare gli alert in episodi.
La correlazione attuale supporta corrispondenza esatta, corrispondenza normalizzata, estrazione di pattern, corrispondenza fuzzy, similarità semantica, topologia dei servizi condivisa e relazioni CMDB padre/figlio. La similarità semantica utilizza soglie di confidenza configurabili, mentre i criteri di aggregazione possono classificare i campi e combinarli con logica AND/OR.
Figura 3: Esempio di raggruppamento degli alert da Event iQ Detect in ITSI.2
Zenoss Cloud
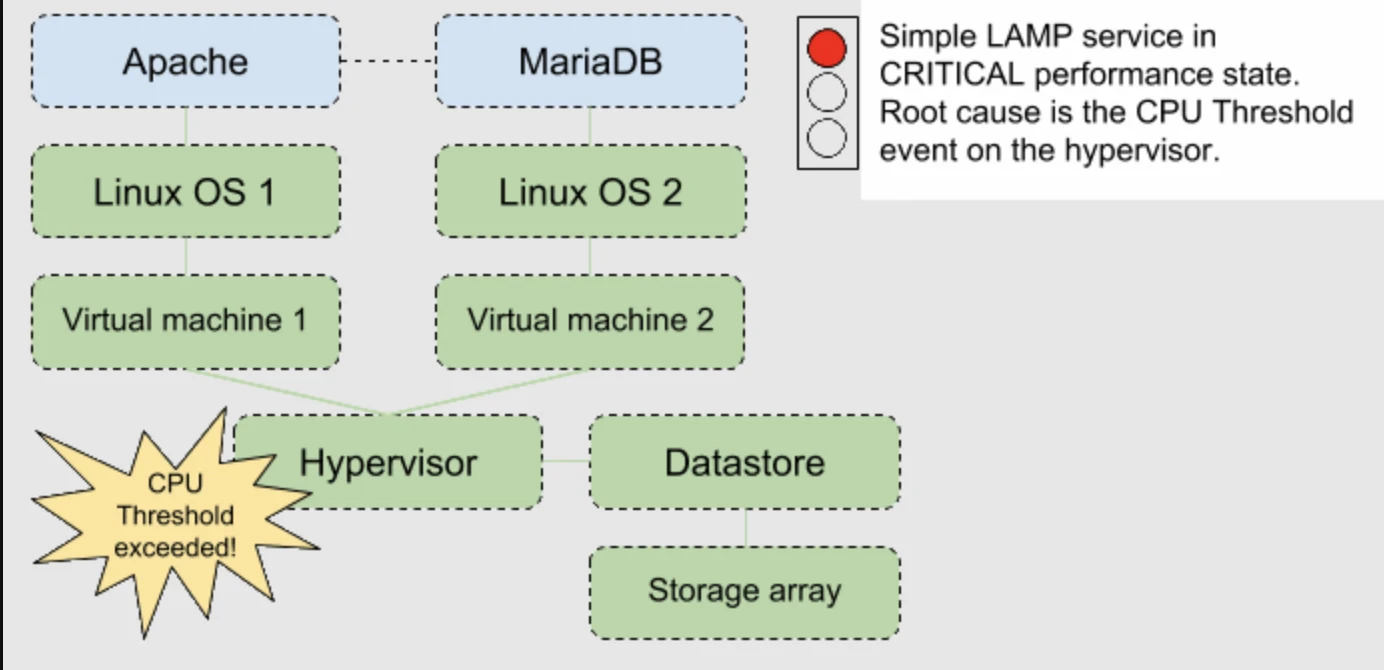
Zenoss Service Impact mantiene un modello di dipendenza che collega i servizi all'infrastruttura da cui dipendono: ad esempio, processi applicativi → OS → VM → hypervisor → datastore/storage. Il modello viene aggiornato quando l'infrastruttura monitorata si sposta o cambia.
Quando una dipendenza genera un evento di stato o di soglia, Service Impact propaga il suo effetto attraverso il modello di dipendenza e può identificare l'evento infrastrutturale sottostante responsabile dello stato a livello di servizio.
Figura 4: Esempio di un evento hypervisor da Zenoss Service Impact.3
Casi d'uso AIOps con esempi reali
Anomaly il rilevamento
Anomaly il rilevamento segnala deviazioni dal comportamento normale prima che si verifichino interruzioni. Datadog Watchdog calcola in modo proattivo una baseline del comportamento previsto e rileva pattern anomali senza configurazione manuale degli alert, guardando indietro fino a tre settimane per tenere conto della stagionalità.
Watchdog analizza anche i log acquisiti all'ingresso per individuare pattern anomali come aumenti improvvisi di stato warning o error.4
Analisi automatica delle cause principali
L'analisi automatica delle cause principali risale all'origine di un incidente attraverso sistemi distribuiti. Il motore di causalità Davis IA di Dynatrace raccoglie tutte le tracce distribuite lungo lo stack orizzontale quando si verifica un evento, continuando l'analisi automaticamente quando un servizio chiamato viene contrassegnato come non integro.5
Riduzione del rumore degli alert
La riduzione del rumore degli alert raggruppa gli alert correlati per ridurre l'affaticamento operativo. Intelligent Alert Grouping di PagerDuty consolida gli alert correlati in un unico incidente utilizzando l'apprendimento automatico.6
BigPanda applica meccanismi di deduplicazione esatta, temporale e basata su pattern per unire gli alert in incidenti.7
Monitoraggio dello stato dell'infrastruttura
Il monitoraggio predittivo dello stato dell'infrastruttura si concentra su endpoint e dispositivi. NinjaOne fornisce visibilità in tempo reale sulle metriche a livello di dispositivo, tra cui carico CPU, utilizzo della memoria e salute del disco, con avvisi basati su soglie che scattano prima che gli utenti finali segnalino problemi.
Risoluzione assistita dall'IA
La risoluzione automatica o assistita dall'IA passa dal rilevamento all'azione. Dynatrace Davis CoPilot for Workflows integra IA generativa per auto-summarize i problemi, proporre passaggi di risoluzione e modificare autonomamente i manifest Kubernetes per lo auto-scaling tramite le automazioni GitHub. 8
 Aggiungi come fonte preferita
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{ermut2026,
  author = {Ermut, Sıla},
  title  = {{Le migliori 10 piattaforme AIOps a confronto}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/aiops-platforms}},
  note   = {AIMultiple. Consultato il 13 novembre 2026}
}Risultati e timestamp di 30 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 3 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Collegamenti di riferimento
In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.
Prossimo da leggere
Le migliori piattaforme CRM agentiche

Confronta oltre 20 piattaforme e librerie di IA responsabile

Strumenti per Agenti IA: Confronto di 15+ Piattaforme



Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.