


Le migliori alternative a Common Crawl: Bright Data e Webz.io

Common Crawl pubblica una scansione mensile gratuito di pagine che scarichi e filtri tu stesso. Abbiamo testato cinque alternative che vendono pagine già raccolte e abbiamo confrontato ciò che ciascuna archivia e consegna.
Common Crawl alternative a confronto: funzionalità
- Consegna in blocco al proprio storage: il venditore scrive i dati selezionati nel tuo bucket S3, Google Cloud o Azure, oppure nel tuo webhook. Il bucket pubblico di Common Crawl, che scarichi da solo, non conta.
- Indica quanto conserva per un dominio: vedi quante pagine conserva per un dominio prima di scaricarle.
- Scraping live disponibile dallo stesso fornitore: la stessa azienda vende anche il recupero live di qualsiasi URL, per le pagine che l'archivio non ha.
- Flusso push continuo di nuove pagine: nuove pagine o post arrivano da soli man mano che vengono scansionati. Le ricerche pianificate, come Exa Monitors, non contano.
- Filtro per data di pubblicazione: il filtro data si riferisce a quando il contenuto è stato pubblicato, non a quando è stato scansionato.
- Dati del grafo dei link: dati su quali siti e pagine si collegano tra loro.
Prezzi e crediti gratuito
Bright Data consente 100 gratuito ricerche nell'archivio al giorno, e ciascuna mostra il costo di consegna prima di pagare. I suoi crediti gratuito mensili non coprono Web Archive o Data Firehose, e Data Firehose viene configurato tramite il team commerciale.
La tariffa di Webz.io è il prezzo con carta per un ordine Archive; i pacchetti di crediti e le esportazioni più vecchie hanno prezzi definiti dal team commerciale.
Exa fattura anche la ricerca, a $7 per 1.000 richieste, quindi trovare 1.000 pagine con 10 risultati per ricerca aggiunge circa $0,70.
Ahrefs Firehose fattura solo le corrispondenze nuove e de-duplicate, e i suoi piani a pagamento costano da $39 a $299 al mese.
Le regole di fatturazione differiscono tra i prodotti dello stesso fornitore, quindi controlla la documentazione del prodotto che intendi usare.
API di archiviazione web
Bright Data Web Archive API vende pagine che l'Unlocker di Bright Data e le SERP API hanno già raccolto per i clienti. Unlocker risolve i CAPTCHA e gestisce i sistemi anti-bot come Cloudflare, Akamai e DataDome, quindi l'archivio contiene pagine di siti che bloccano i crawler. Il crawler di Common Crawl segue robots.txt e tralascia questi siti.
Il pool segue ciò che i clienti raccolgono tramite scraping piuttosto che un programma di scansione. Conteneva più di 115 PB in circa 800 miliardi di pagine da circa 380 milioni di domini e aggiunge circa 1.6 miliardi di pagine al giorno. Data Firehose invia lo stesso tipo di pagine man mano che vengono raccolte, quindi il cliente non deve cercarle.
- Le pagine più vecchie di 24 ore vengono prima ripristinate da S3 Glacier Deep Archive, quindi la loro consegna può richiedere fino a 72 ore.
- Ogni ricerca richiede un intervallo di tempo e una ricerca che dura più di 30 secondi restituisce un ID di ricerca da interrogare invece dei risultati.
- Un'esportazione dei metadati restituisce gli URL e i metadati di una ricerca come CSV compresso con gzip, senza il contenuto della pagina.
Data Firehose
Bright Data configura ogni feed Firehose con il cliente prima che arrivi il primo record: domini target, categorie, lingue e paesi, e se le nuove scansioni dello stesso URL vengono conservate. Le nuove scansioni sono importanti per il monitoraggio dei prezzi, dove ogni nuova copia di una pagina di prodotto può riportare un nuovo prezzo, mentre un catalogo prodotti ha bisogno solo di una copia per pagina.
Le pagine arrivano quindi come HTML grezzo, output analizzato, immagini o video, tramite Amazon S3, un webhook o uno stream, una alla volta o in batch per tempo o dimensione. Vengono consegnate solo le pagine che hanno restituito stato HTTP 200, e la pausa, le modifiche ai filtri e il volume passano da un'API.
Web Archive API
Abbiamo usato direttamente l'API Web Archive. Una ricerca filtra il pool per intervallo di tempo, dominio, pattern URL, categoria, lingua e paese e restituisce il numero di record e il costo di consegna prima che venga consegnato alcunché. Un dump scrive quindi le pagine corrispondenti su Amazon S3, Azure Blob Storage, Google Cloud Storage o un webhook.
Abbiamo cercato nell'archivio zillow.com e redfin.com, abbiamo ricevuto una consegna campione tramite webhook e aperto i file.
Filtri
Tutto passa attraverso un singolo oggetto filters con 20 campi: intervallo di tempo, dominio, pattern URL, categoria, lingua, paese ed esito della raccolta. L'intervallo di tempo è obbligatorio e la categoria è un elenco chiuso di 30 valori, quindi le pagine vengono classificate in ingresso.
Due campi descrivono come è stata raccolta la pagina piuttosto che cosa contiene. ip_country filtra per il paese dell'IP di uscita che ha raccolto la pagina, confermando che l'archivio è un sottoprodotto della rete proxy. captcha e robots_block restituiscono solo i record in cui è scattato un CAPTCHA o è stata applicata una regola robots, quindi i tentativi bloccati vengono archiviati anziché scartati.
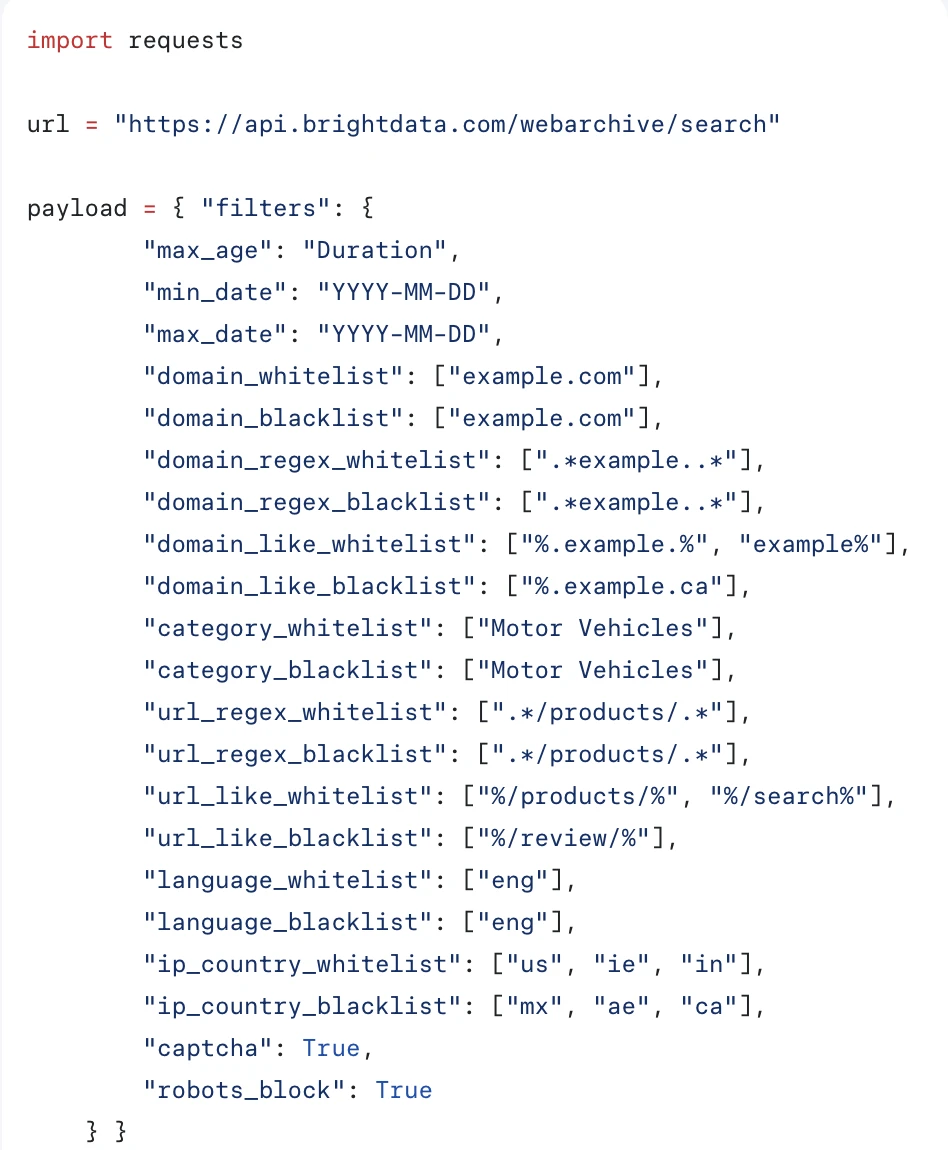
Ricerca e costi
La ricerca è gratuito, fino a 100 query al giorno, e la risposta contiene tutto ciò che serve per dimensionare un lavoro prima di pagare: il numero di record corrispondenti, il costo di consegna stimato e una suddivisione che mostra quante pagine si trovano nel livello cache di 24 ore rispetto al livello archivio.
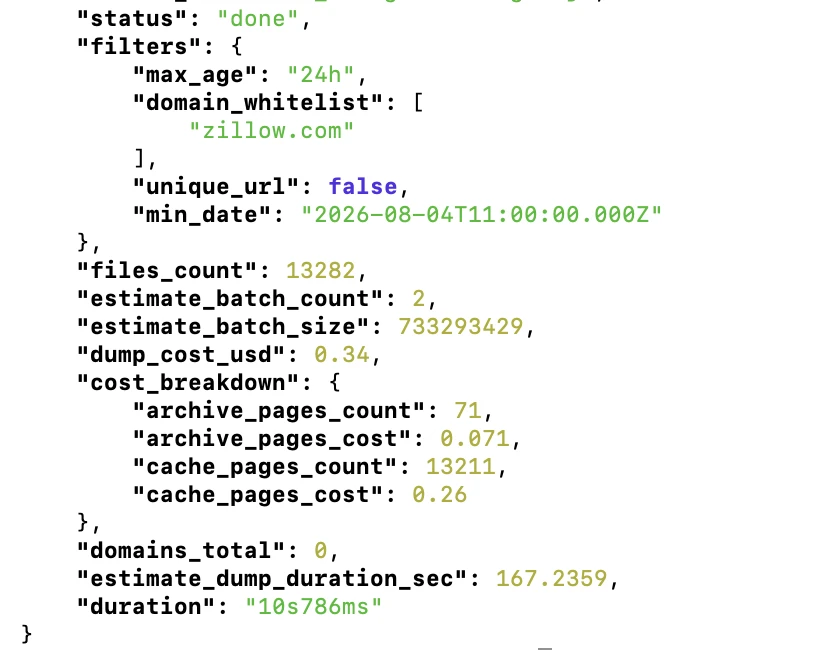
- Copertura dei siti che bloccano i crawler: Common Crawl non contiene alcuna pagina per zillow.com in un'intera scansione mensile. Bright Data ha restituito 13.282 record per una singola finestra di 24 ore.
- La velocità delle query scala con la finestra: Una query di 240 giorni su redfin.com ha restituito 59.831 record in 1 minuto e 53 secondi. La query zillow.com su 24 ore è stata completata in 10,8 secondi.
- Due livelli di archiviazione: I dati delle ultime 24 ore costano $0,2 per 1.000 pagine. Tutto ciò che è più vecchio passa a S3 Glacier Deep Archive a $1 per 1.000. Il tempo di consegna segue: il nostro lavoro su 24 ore è arrivato in circa 30 secondi, mentre il lavoro su 240 giorni è rimasto in
restoring_archive_dataper decine di minuti. - Consegna al proprio storage: Amazon S3, Azure Blob Storage, Google Cloud Storage o webhook. Abbiamo testato il percorso webhook; dieci pagine sono arrivate come un singolo tar con un
.html.gze un.meta.jsonper pagina. - Campione prima di impegnarsi:
max_entrieslimita il numero di file inclusi in una consegna, quindi una query da 59.831 record può essere campionata con dieci pagine per una frazione di centesimo.
Ottieni 100 gratuito ricerche nell'archivio al giorno con Bright Data
Ottieni accesso gratuitoCosa c'è realmente nei file
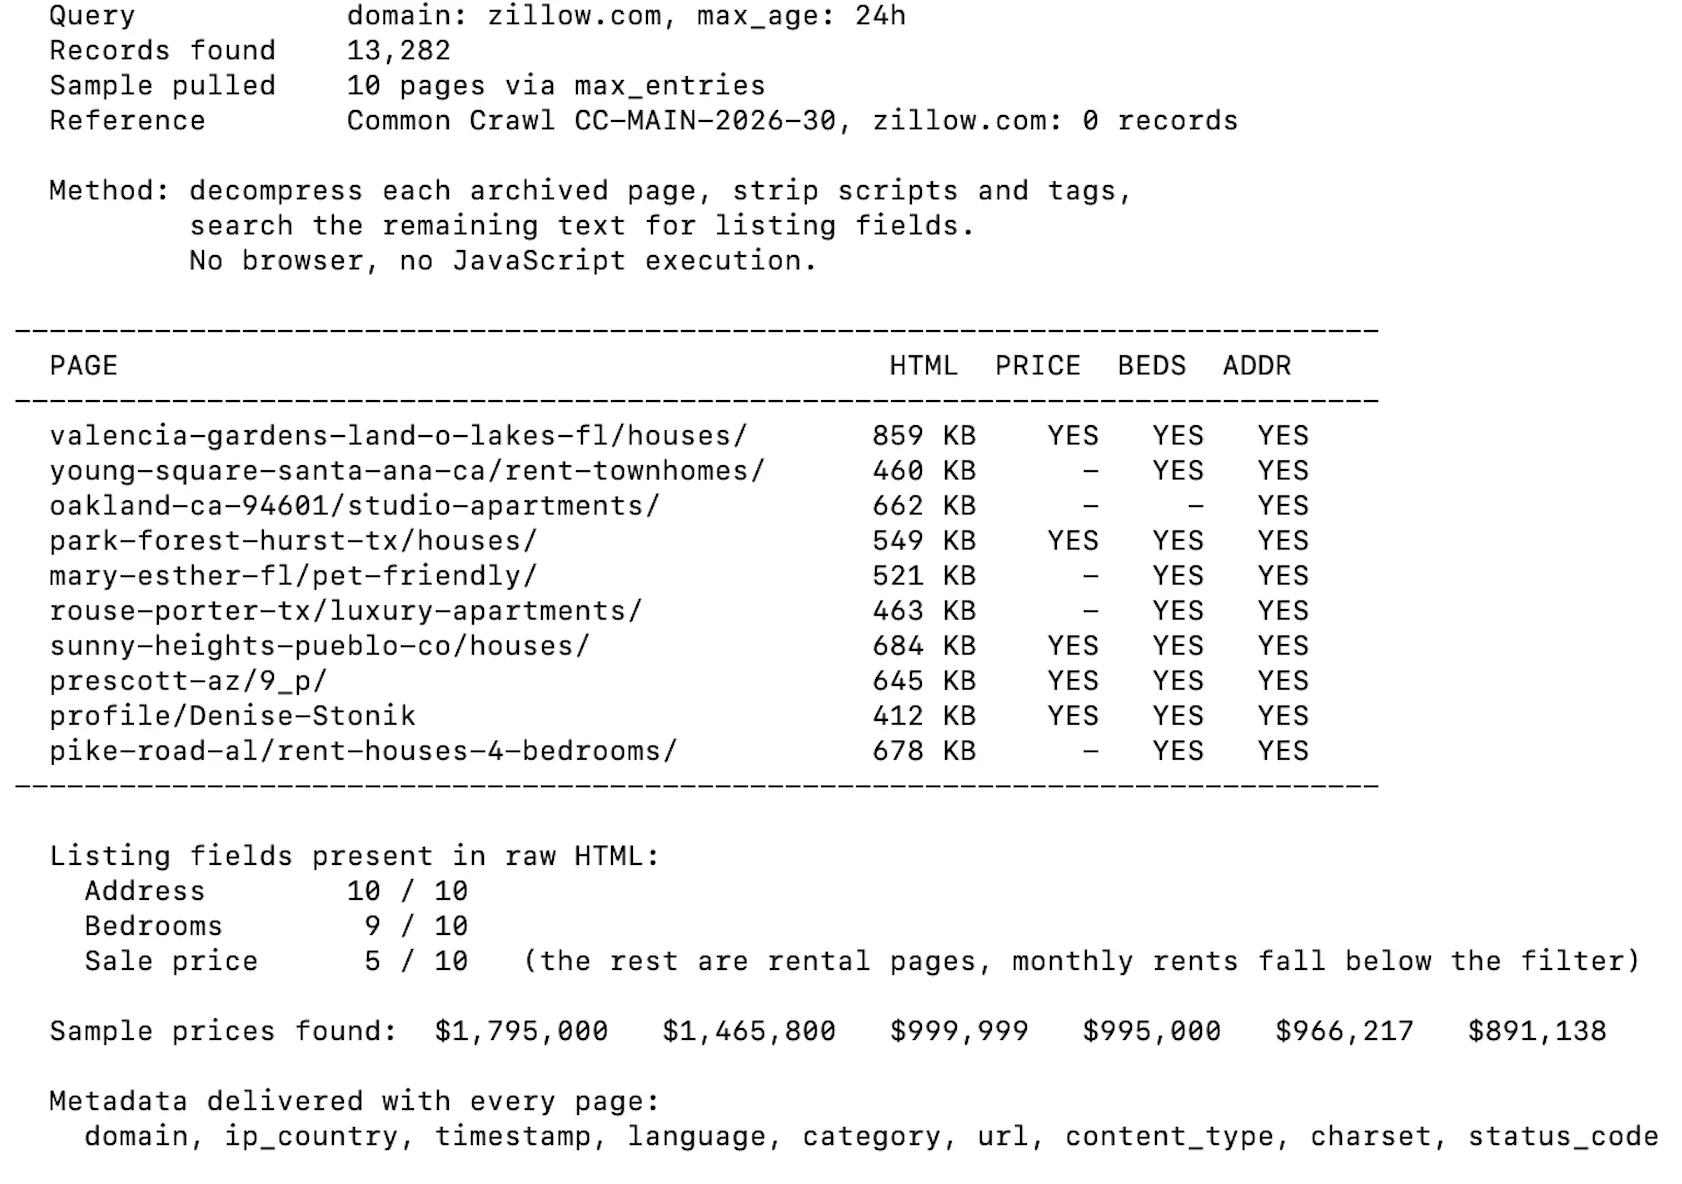
Ogni pagina arriva come l'ha inviata il server, con nove campi di metadati: domain, url, timestamp, language, category, ip_country, content_type, charset e status_code. Per verificare se quell'HTML grezzo è utilizzabile senza un browser, abbiamo aperto dieci pagine Zillow archiviate, rimosso script e tag e cercato i campi degli annunci nel testo rimanente.
Webz.io raccoglie post da siti di notizie, blog, forum e siti di recensioni e li restituisce come record JSON strutturati, mentre Common Crawl conserva la pagina grezza. Il suo Firehose invia nuovi post in base ai filtri configurati per ciascun cliente, mentre l'Archivio e i dump in blocco coprono gli anni passati.
- L'Archivio self-service copre fino a cinque anni indietro. I dump in blocco di interi mesi non filtrati risalgono al 2008 per le notizie e a dicembre 2014 per blog e forum, e vengono forniti da AWS Glacier su richiesta.
- Le entità includono il proprio sentiment in inglese, tedesco, spagnolo e italiano, e i campi di arricchimento compaiono solo nei dati dal 2015 circa in poi.
- Un ordine nell'Archivio deve corrispondere ad almeno 10 post negli ultimi 30 giorni e consegna solo NDJSON. I Files si dividono a 500 MB e il link per il download rimane valido per sette giorni.
- L'API News copre circa un anno per le notizie, mentre i post di blog e forum restano ricercabili per circa 31 giorni.
- Un campo `ai_allow` mostra se Webz.io ha rilevato una restrizione a livello di fonte sull'addestramento dell'IA, e le query possono filtrare su di esso.
Il generatore di query
Le query combinano un'espressione booleana sul testo con condizioni a livello di campo, unite da AND. Ogni condizione è composta da una proprietà, un operatore e un valore.
Un dettaglio vale la pena conoscerlo prima di usarlo: l'operatore etichettato Equals non richiede una corrispondenza esatta. Abbiamo inserito redfin nel campo del titolo del sito e ha trovato un sito il cui titolo è “Redfin Real Estate News”.
Cosa viene restituito
Ogni risultato include il testo completo insieme a entities, sentiment, social, categories, language, domain_rank, country e un oggetto syndication che registra se la stessa notizia è apparsa altrove. Non esiste un campo HTML grezzo. La pagina del prodotto descrive ciò che si ottiene come “l'intero testo di ogni articolo, post, thread o recensione” e la consegna avviene “tramite API o eseguendo una query direttamente”.
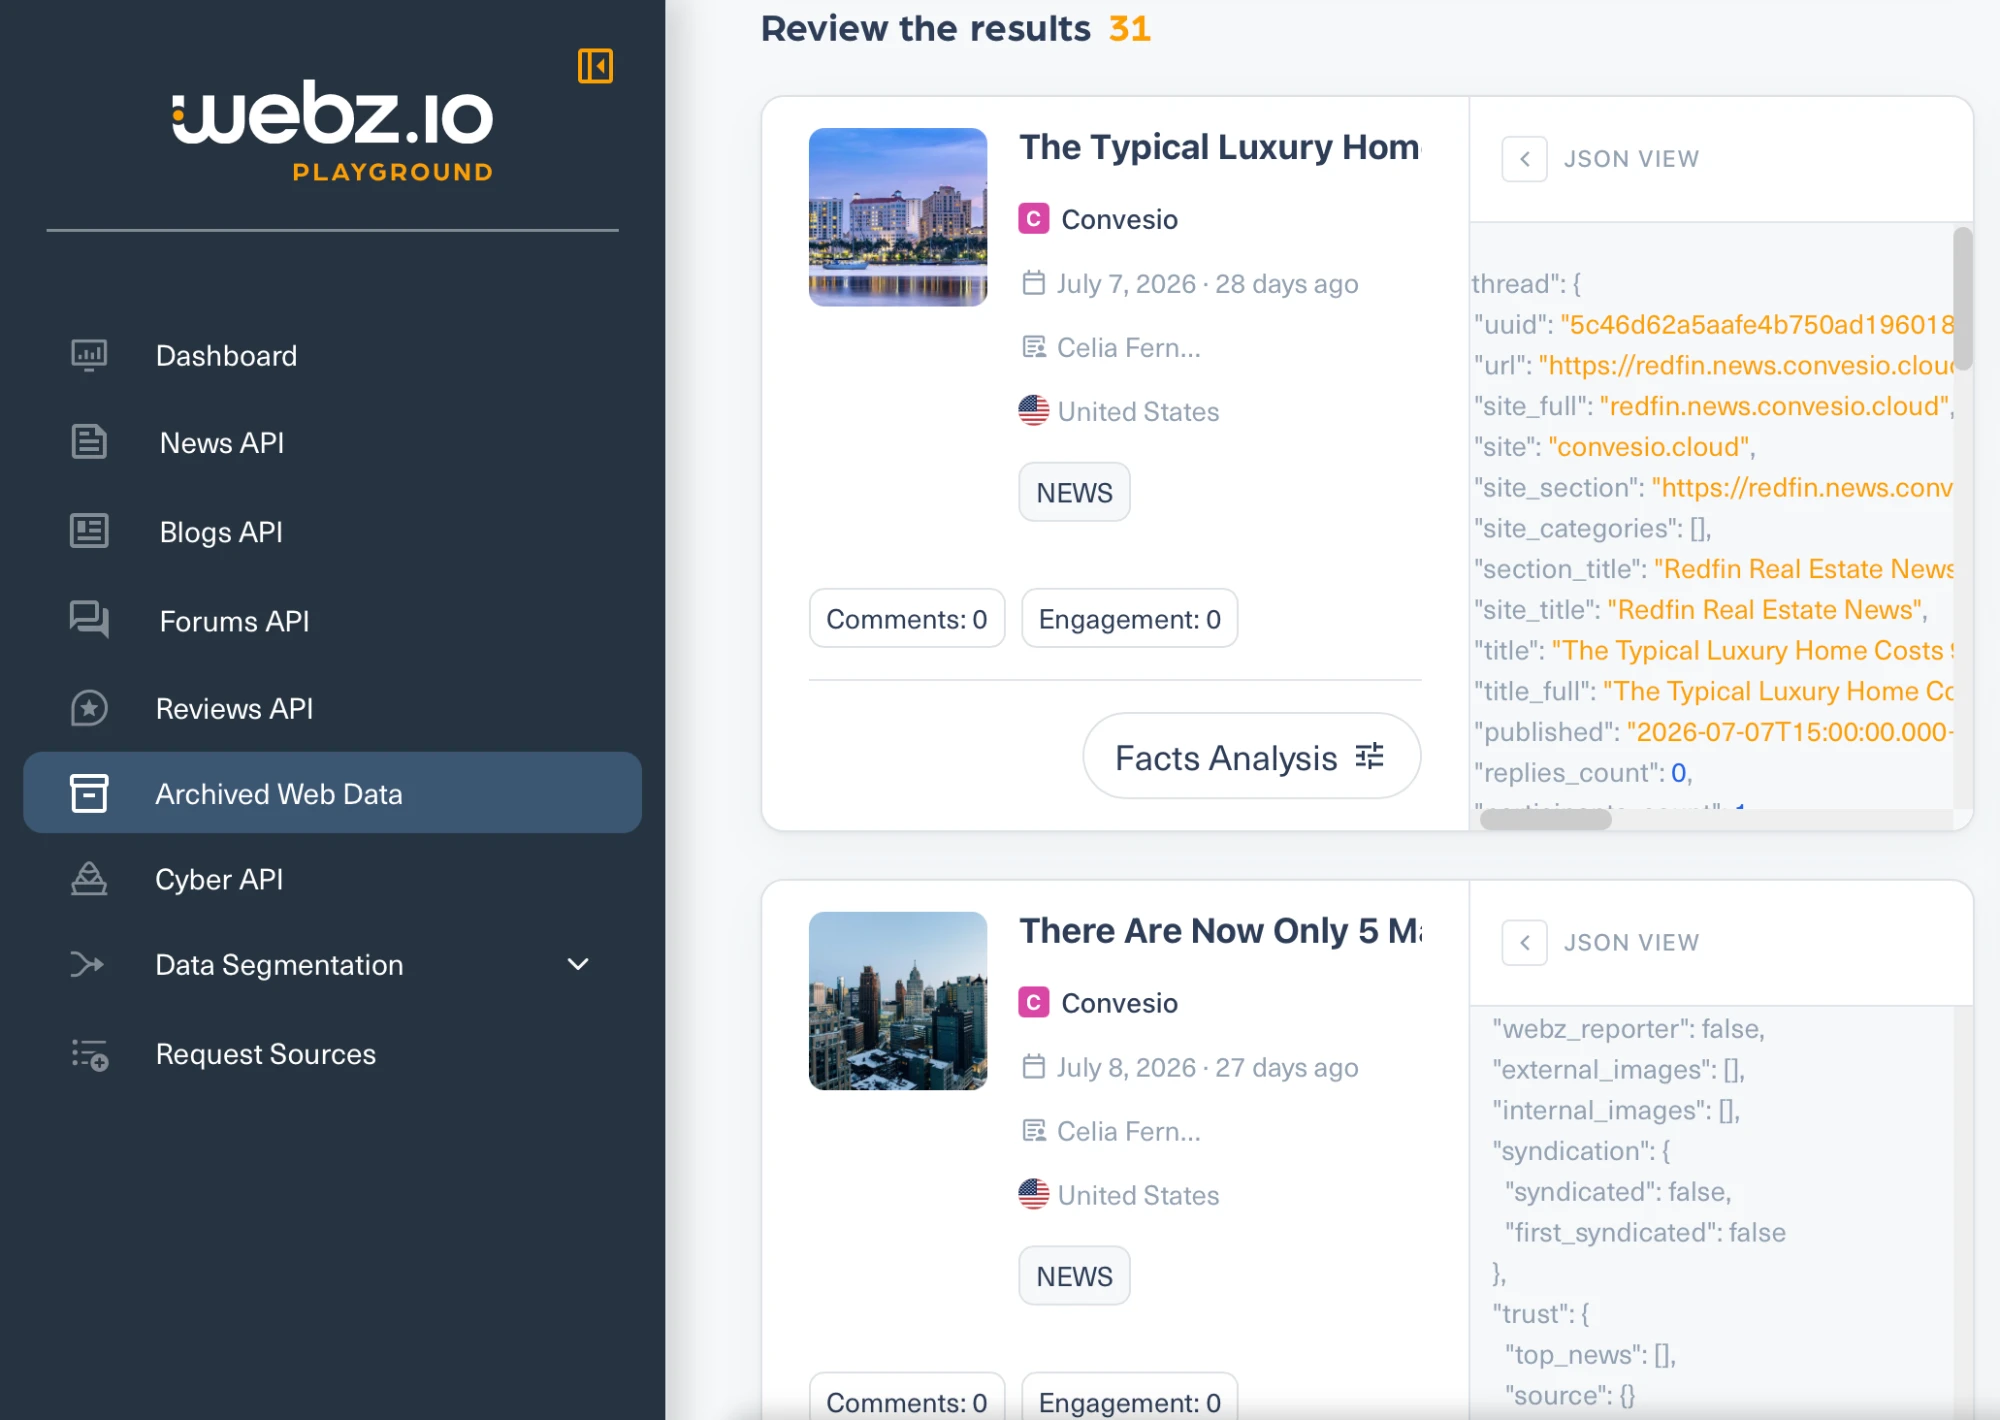
- L'archivio contiene editori, non siti di annunci. La ricerca di Redfin ha restituito il blog di notizie aziendali di Redfin, ospitato su
convesio.cloud, invece delle pagine di redfin.com. Interrogare direttamente il campo del dominio del sito perredfin.comnon ha restituito nulla, mentreconvesio.cloudeyahoo.comhanno restituito risultati, quindi la risposta vuota riflette la copertura piuttosto che una query errata. - La raccolta in blocco è limitata dal contratto. I termini di servizio vietano un filtro asterisco catch-all e filtri verticali come
site_type:newsolanguage:english, che sono esattamente le forme di query che userebbe un acquirente di corpus. L'interfaccia stessa suggerisce di aggiungeresite_type:newsper restringere una ricerca.
Exa ha costruito il proprio indice web e vende ricerche su di esso. Exa dichiara che il suo indice traccia oltre 2 trilioni di URL e serve 100 miliardi di pagine.
Per questo confronto la parte rilevante non è l'endpoint di ricerca ma /contents, che restituisce il testo di una pagina dalla cache di Exa invece di recuperarlo dal vivo.
Opzioni cache o live
Un singolo parametro lo controlla. maxAgeHours impostato a 24 significa usare la copia in cache se ha meno di un giorno, altrimenti esegue la scansione. Impostato a 0 esegue sempre la scansione. Impostato a -1 non esegue mai la scansione, restituendo solo ciò che è già archiviato. Il valore massimo accettato è 720 ore, quindi il parametro non può riferirsi a nulla di più vecchio di 30 giorni.
Abbiamo eseguito due richieste con il limite di età impostato in modo che Exa non esegua mai la scansione e restituisca solo ciò che ha già archiviato. La prima richiedeva una pagina cittadina di Redfin.
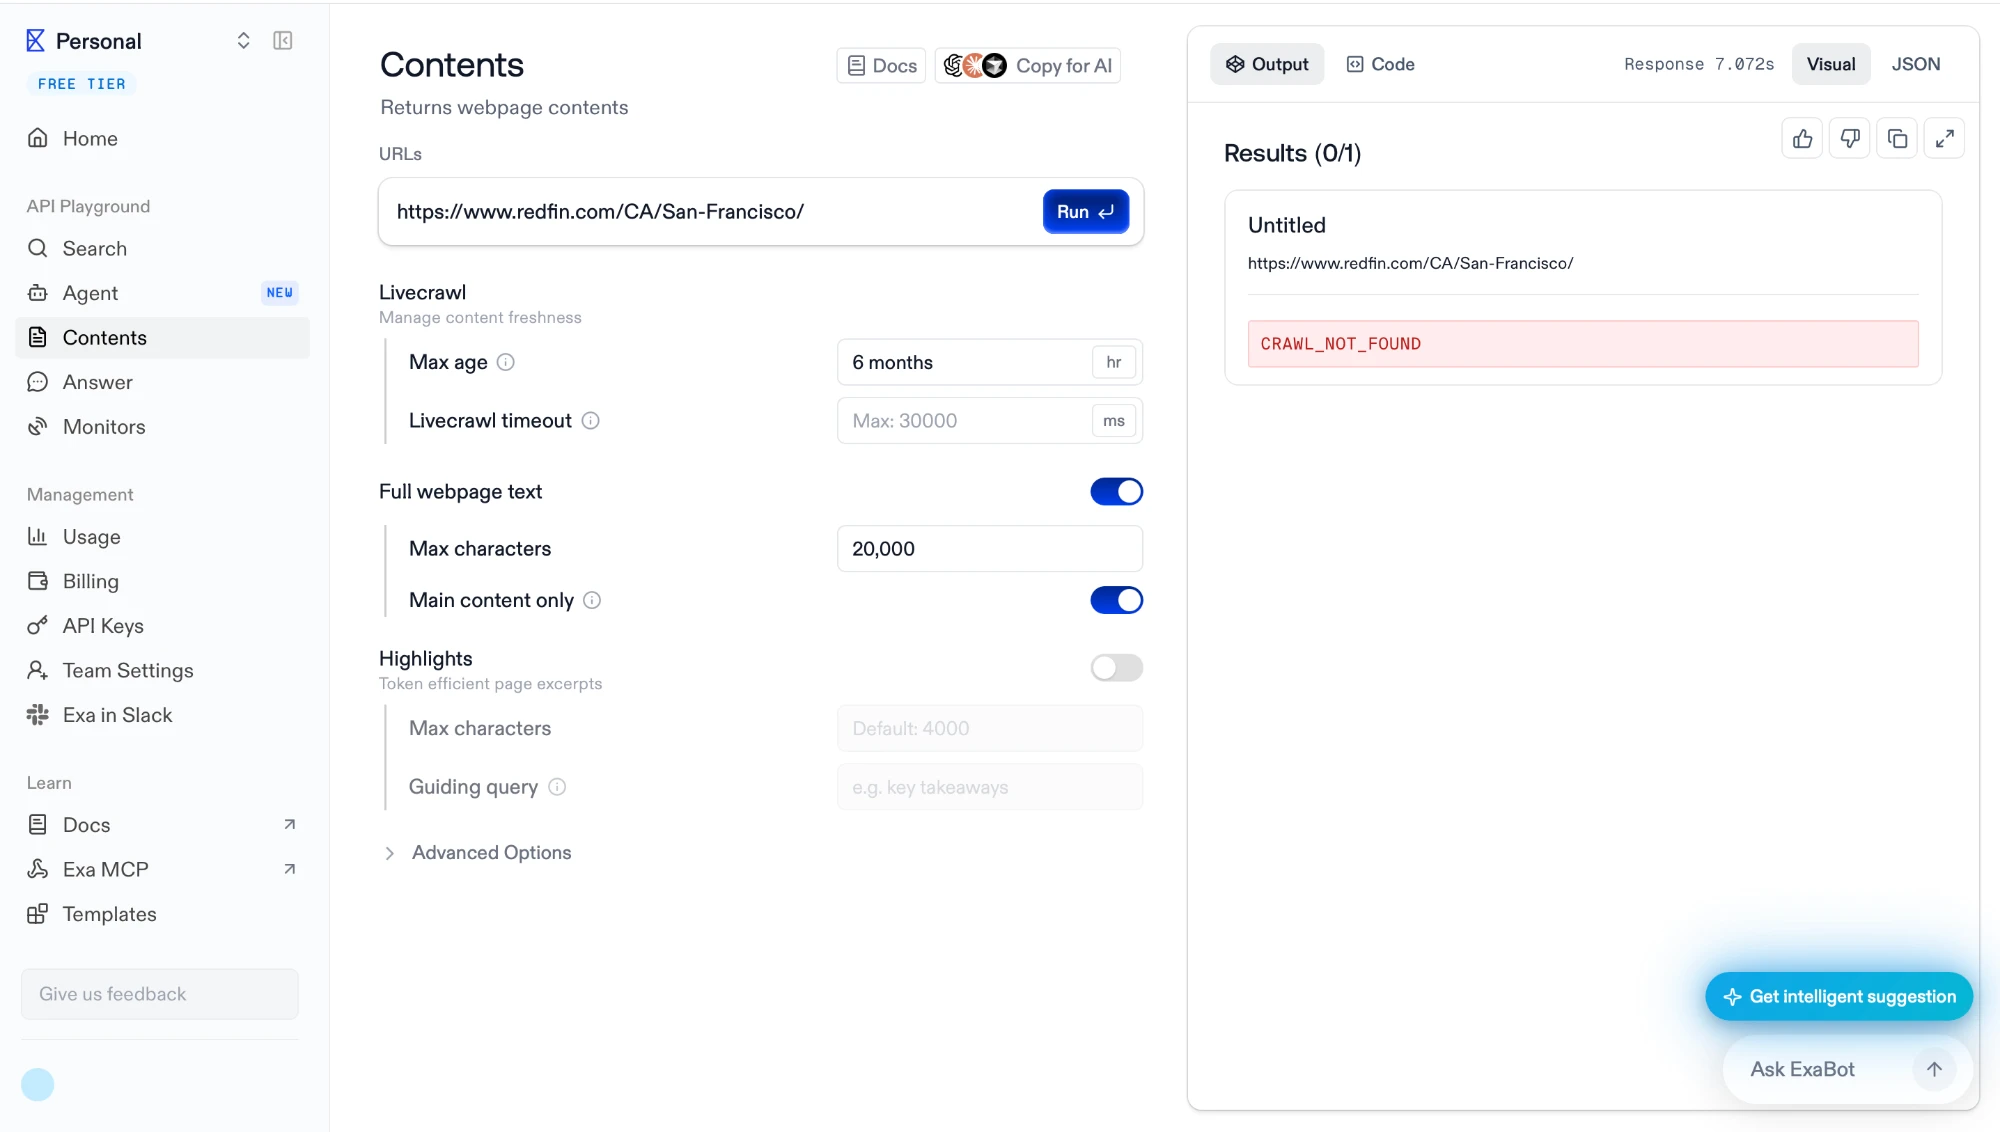
Ha restituito CRAWL_NOT_FOUND dopo 7,07 secondi. La seconda richiedeva la homepage di Redfin.
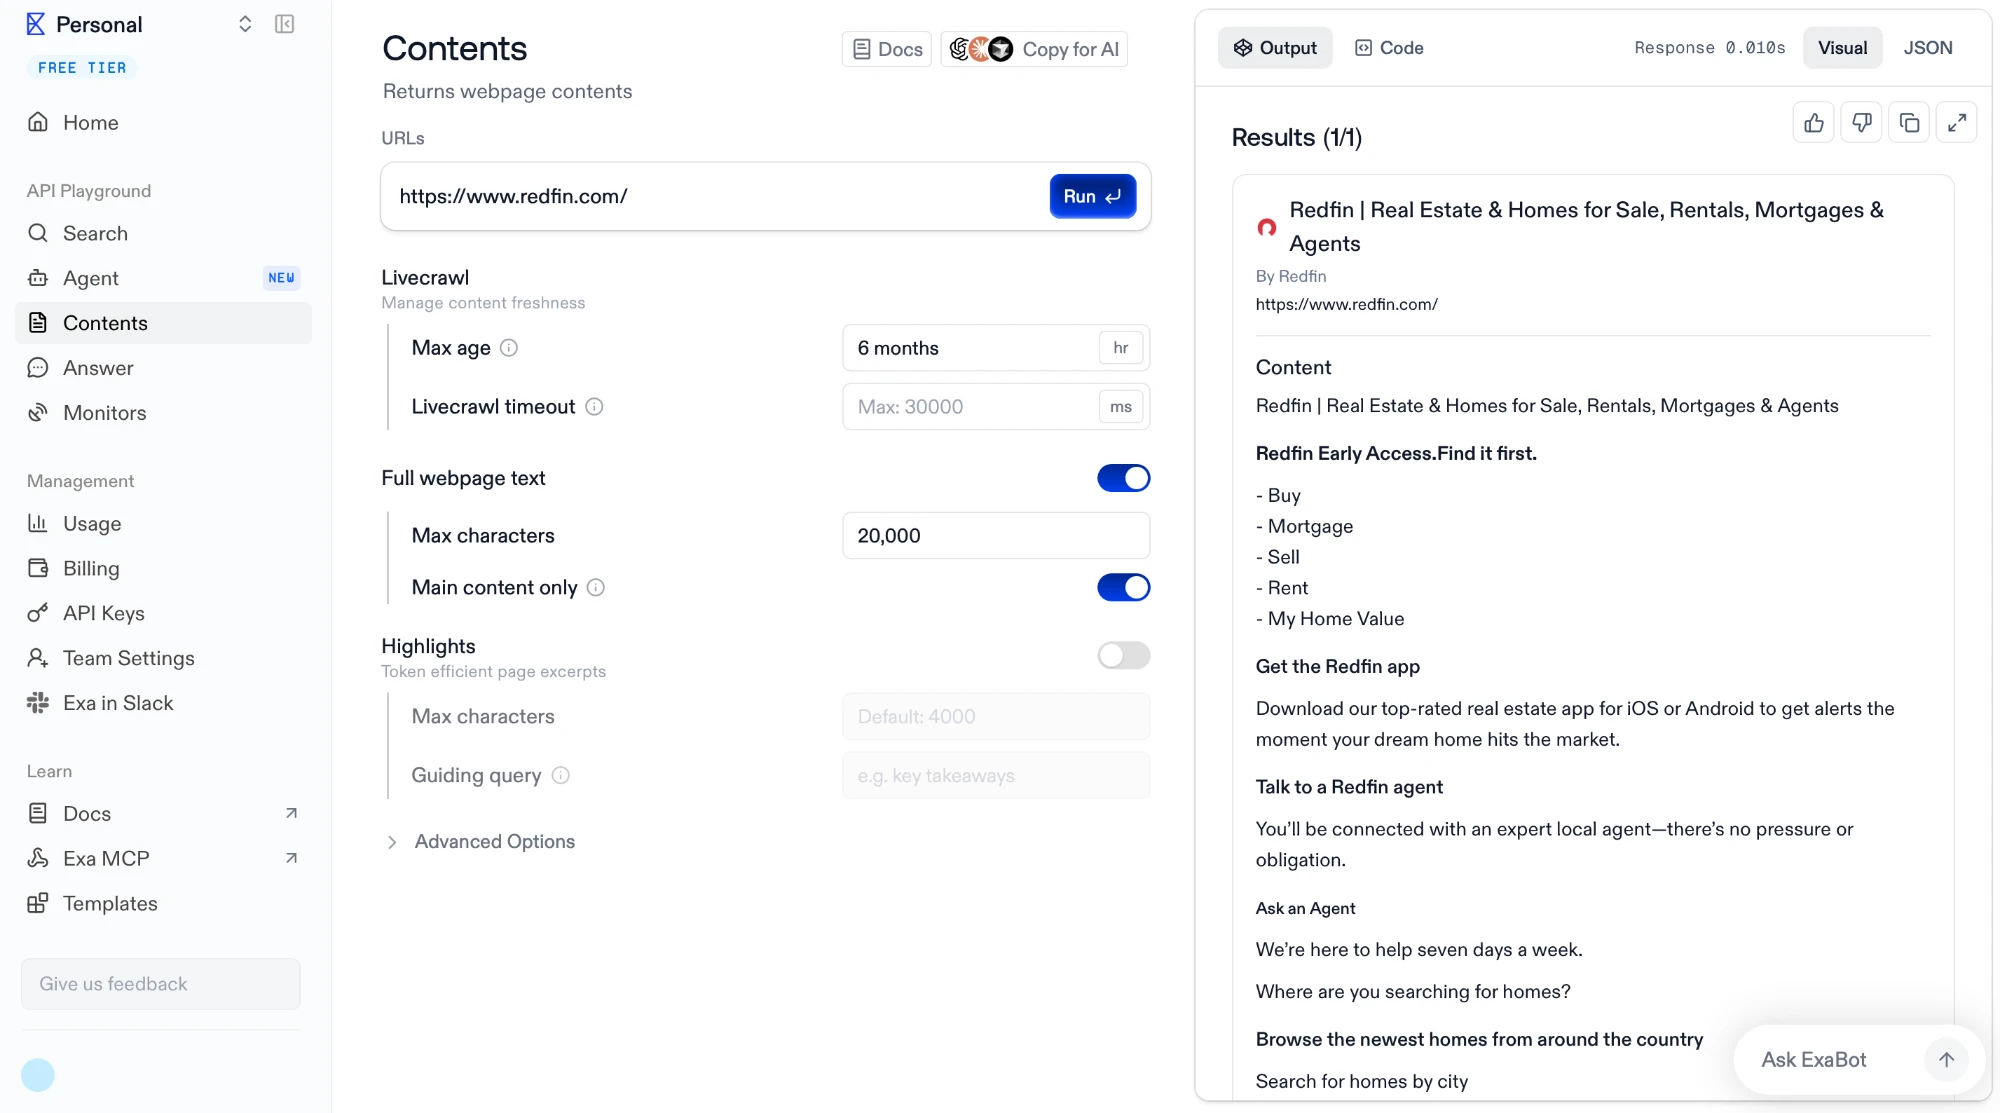
Ha restituito l'intero contenuto della pagina in 0.010 secondi. Dieci millisecondi sono meno di un round trip di rete, quindi quella risposta proveniva dallo storage, non da un fetch. La cache è reale e il fallimento di sette secondi è stato Exa che cercava senza trovare.
Nella stessa schermata sono visibili altre due impostazioni predefinite. Il contenuto è limitato a 20.000 caratteri e “solo contenuto principale” è attivo, quindi la navigazione e il boilerplate vengono rimossi dalla logica di Exa piuttosto che dalla tua.
La copertura è discontinua a livello di pagina
La homepage era in cache; la pagina della città di San Francisco no. La ricerca sul dominio mostra perché non si tratta di una semplice questione di presenza o assenza.
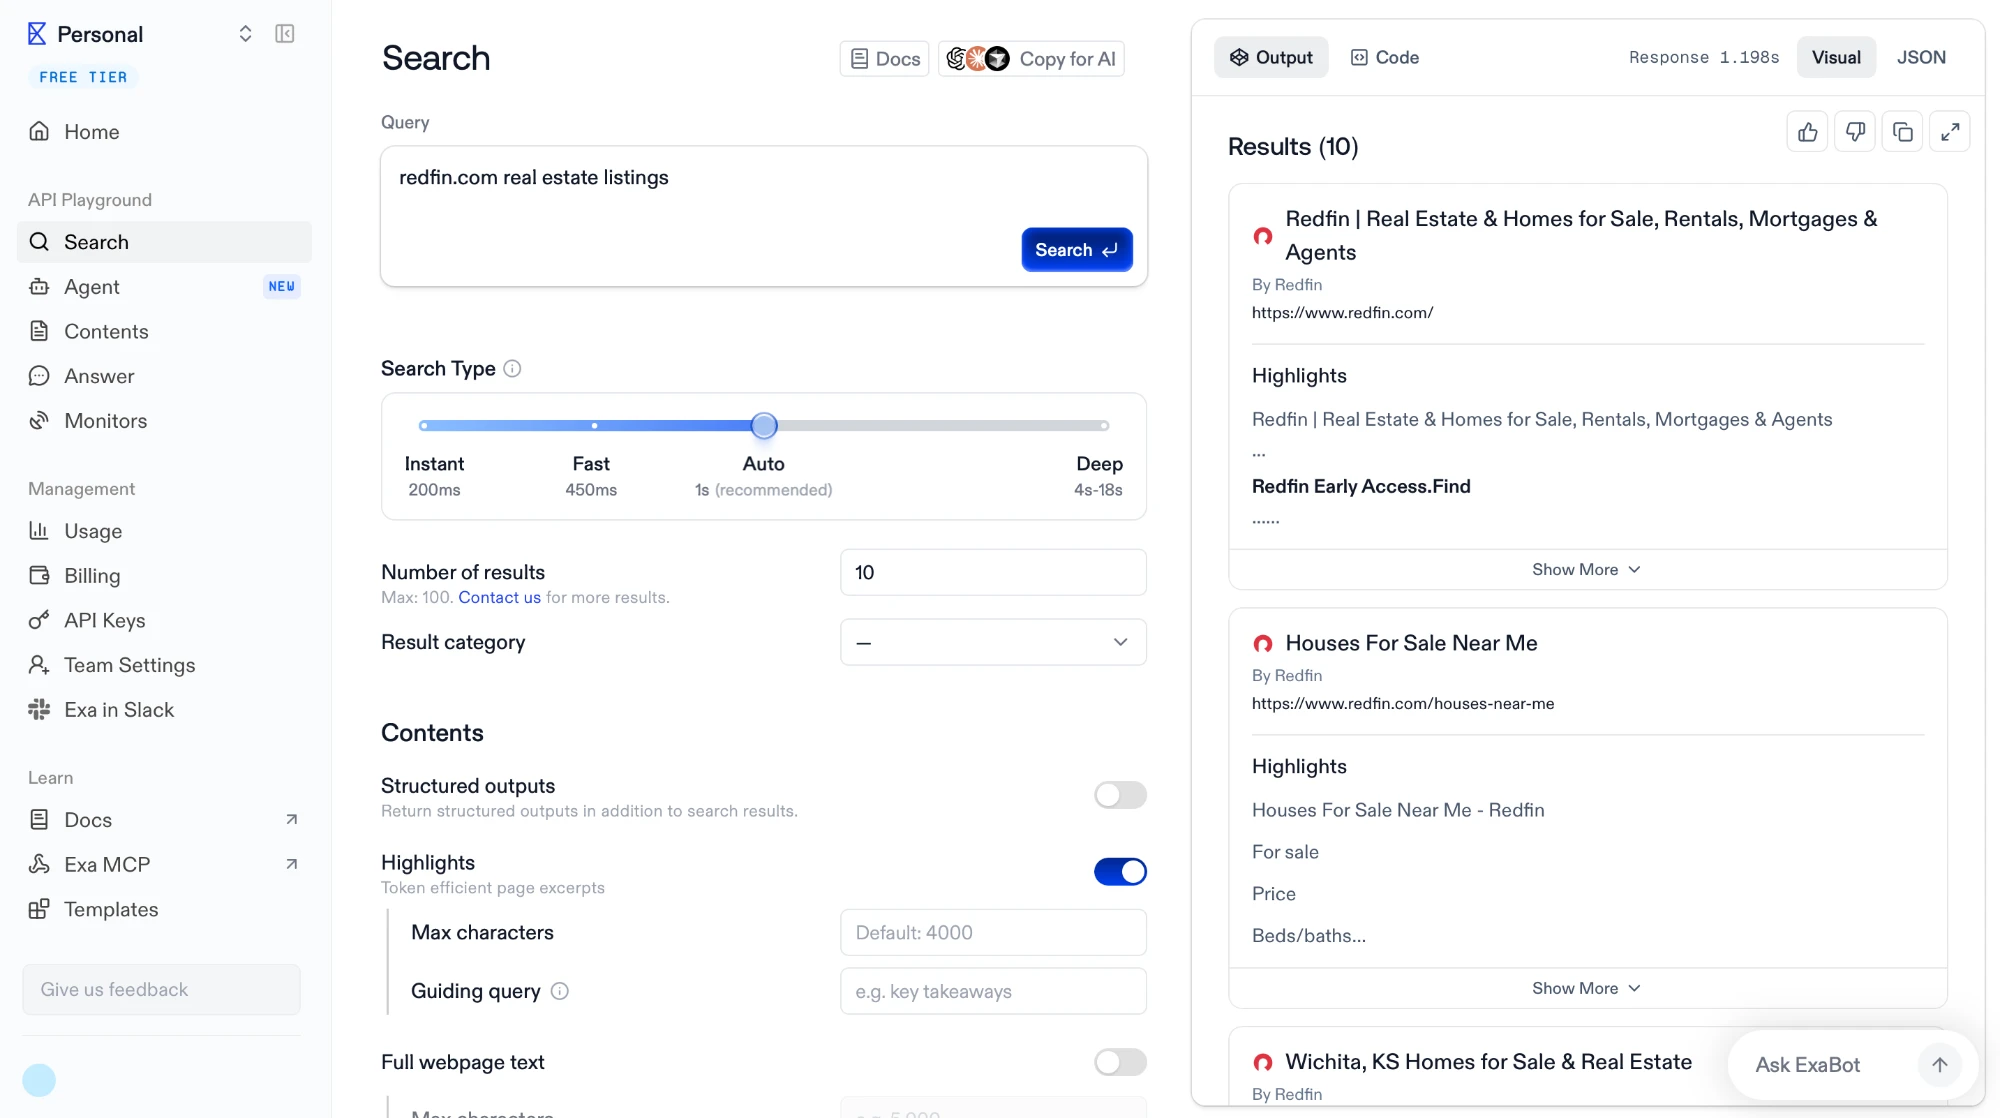
La query ha restituito la homepage di Redfin, una pagina “Houses For Sale Near Me” e una pagina della città di Wichita, quindi le pagine profonde esistono nell'indice. La copertura è distribuita su un dominio anziché essere completa o vuota.
Limitazioni
La stessa schermata contiene la frase che separa Exa dagli archivi in questo confronto: “Numero di risultati: 10. Massimo: 100. Contattaci per altri risultati.”
Non c'è un conteggio totale. Common Crawl ha risposto a questa domanda con una query SQL e Bright Data ha risposto con un campo files_count.
Nessuna esportazione in blocco, nessuna consegna al proprio storage, nessun firehose. Il livello Enterprise menziona indici personalizzati, ovvero indici su misura serviti tramite l'API anziché dati consegnati.
Ahrefs Firehose trasmette in streaming le pagine scansionate da AhrefsBot che corrispondono alle regole del cliente, ma ogni evento contiene il testo modificato di una pagina, mentre Common Crawl archivia l'intera pagina. Le regole usano la sintassi Lucene e vengono applicate al testo aggiunto o rimosso dall'ultima scansione.
- Un evento contiene URL, titolo, data di pubblicazione e i blocchi di testo inseriti e rimossi con un po' di contesto circostante. Gli eventi arrivano tramite Server-Sent Events, restano nel buffer per circa 24 ore e un client riprende con l'ultimo ID evento.
- URL Watch esegue nuovamente la scansione di un elenco scelto di URL secondo una pianificazione e conserva il diff di ogni scansione e uno snapshot renderizzato.
- Smart Digest, in beta, fa leggere a un agente le corrispondenze di un tap secondo una pianificazione da oraria a settimanale e invia via email un report su ciò che è cambiato.
- I dati sui backlink e sui domini referenti provengono dall'API Site Explorer di Ahrefs, un prodotto separato da Firehose.
Creazione della regola
Abbiamo configurato Firehose per monitorare i modelli appena elencati su OpenRouter e gli annunci di modelli dai laboratori di IA, con un tap e due regole. Una regola può partire da una descrizione in linguaggio naturale, un generatore visuale o una query Lucene digitata direttamente. La prima regola, domain:openrouter.ai, individua le nuove pagine dei modelli su OpenRouter. Abbiamo aggiunto una seconda regola allo stesso tap per i siti di OpenAI (openai.com), Anthropic (anthropic.com), Google (blog.google e deepmind.google), Mistral (mistral.ai), xAI (x.ai) e Meta (ai.meta.com). Corrisponde alle pagine di quei siti i cui titoli contengono “introducing”, “model” o “launch”.
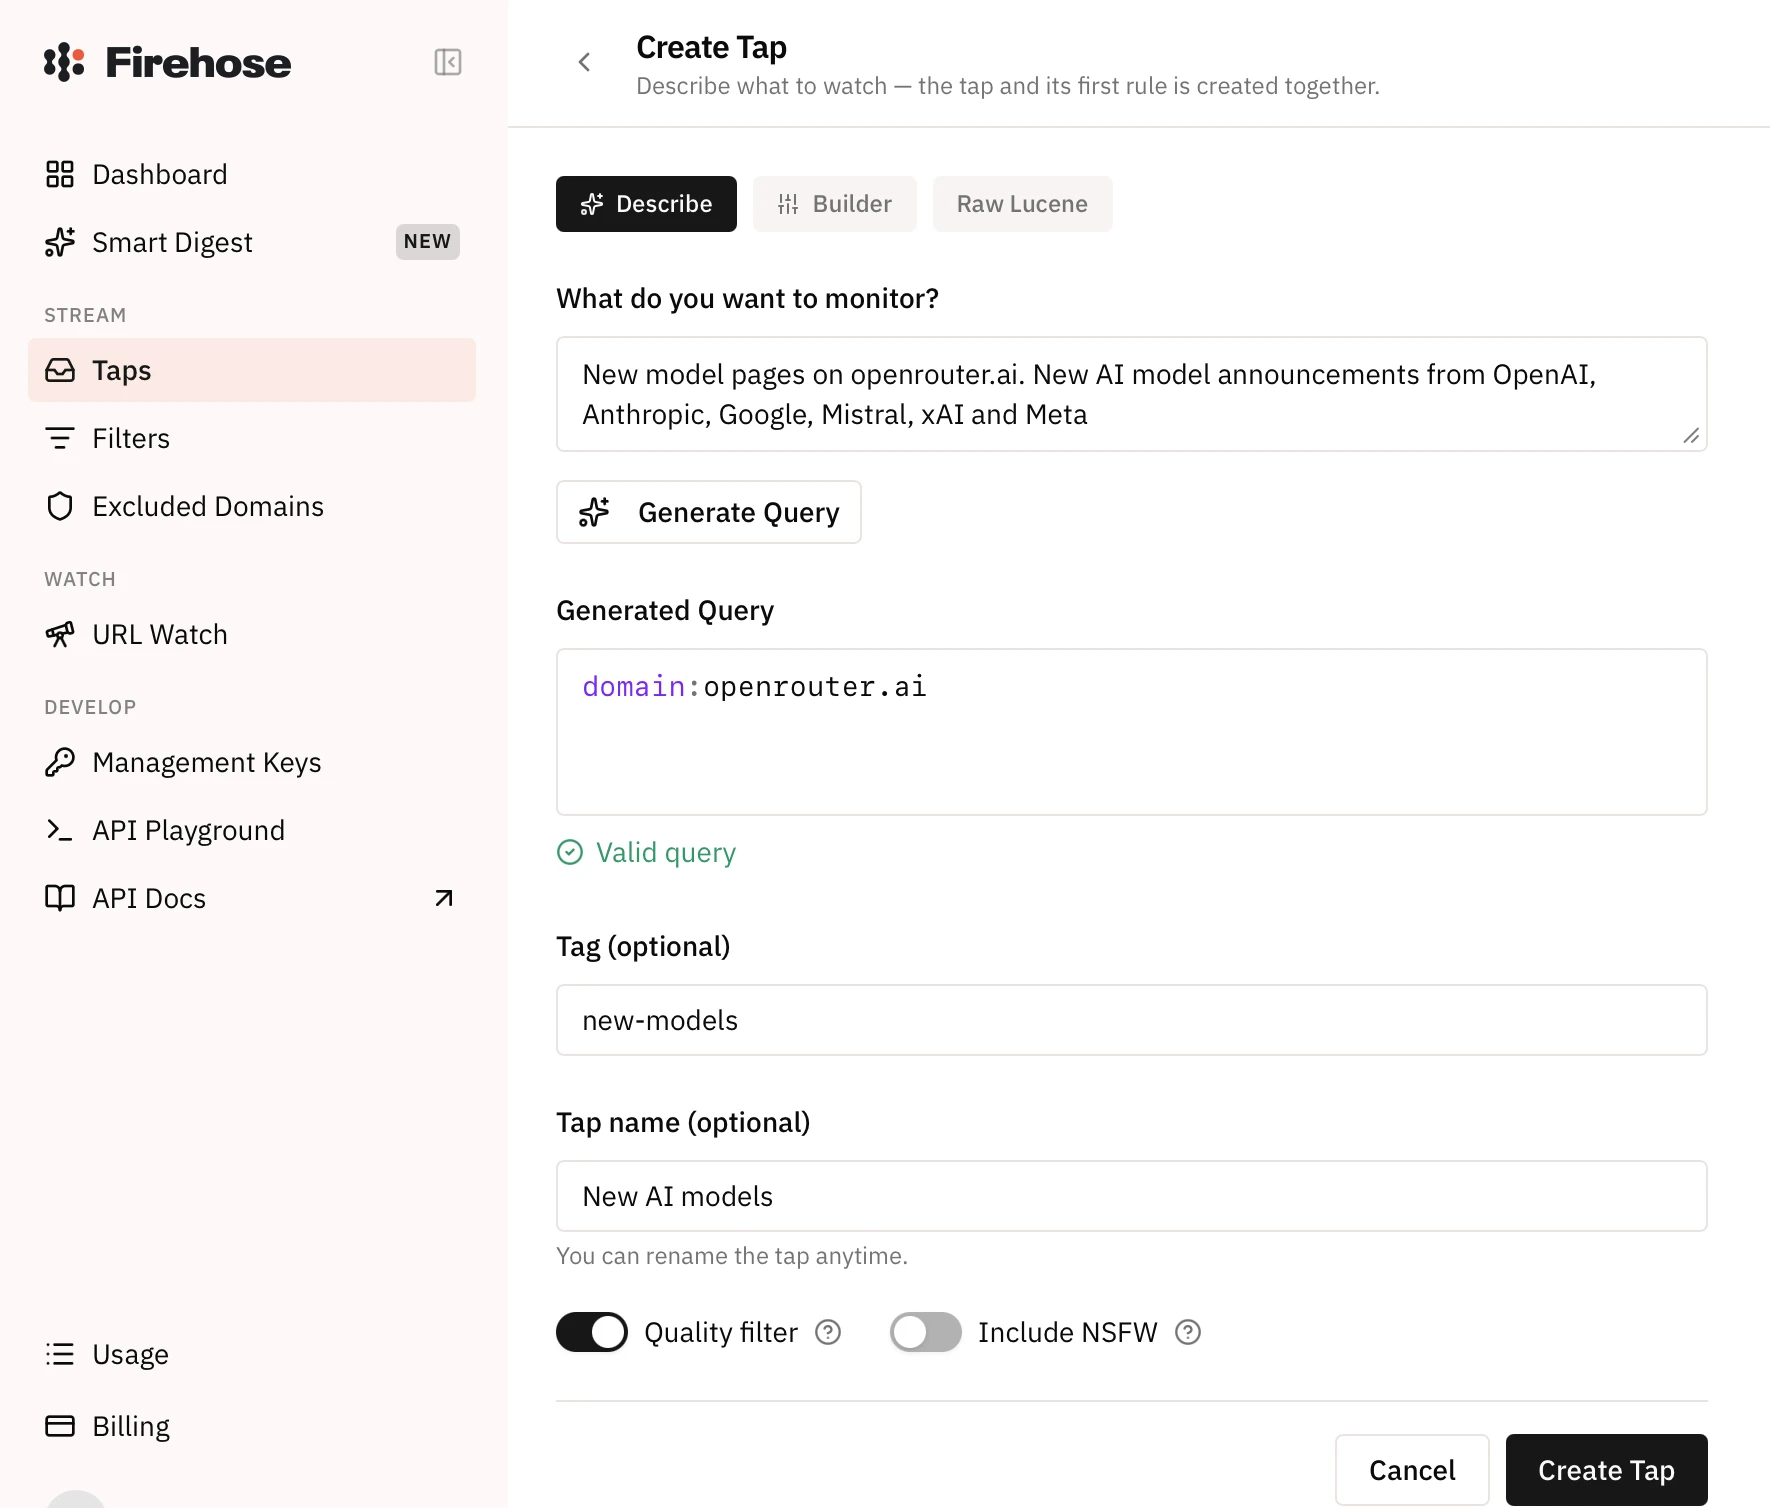
L'anteprima spiega la regola in parole semplici (“Domain is openrouter.ai”) invece di elencare pagine di esempio, quindi la portata di una regola si vede solo dopo l'arrivo delle corrispondenze. Una nuova regola corrisponde alle pagine scansionate dopo la sua attivazione e non cerca nelle scansioni passate. Il filtro qualità è attivo per impostazione predefinita e lascia passare solo le pagine pubblicate negli ultimi 7 giorni, escludendo impaginazione, pagine tag e URL con stringhe di query.
Cosa contiene una corrispondenza
Entro circa 90 minuti dall'attivazione del tap, ha restituito 10 corrispondenze, tutte dalla regola OpenRouter. Erano le pagine tedesche, spagnole, francesi e inglesi di tre modelli che OpenRouter aveva aggiunto al suo catalogo quella mattina: Gemini 2.5 Pro TTS, Gemini 2.5 Flash TTS e Pixtral Large 2502.
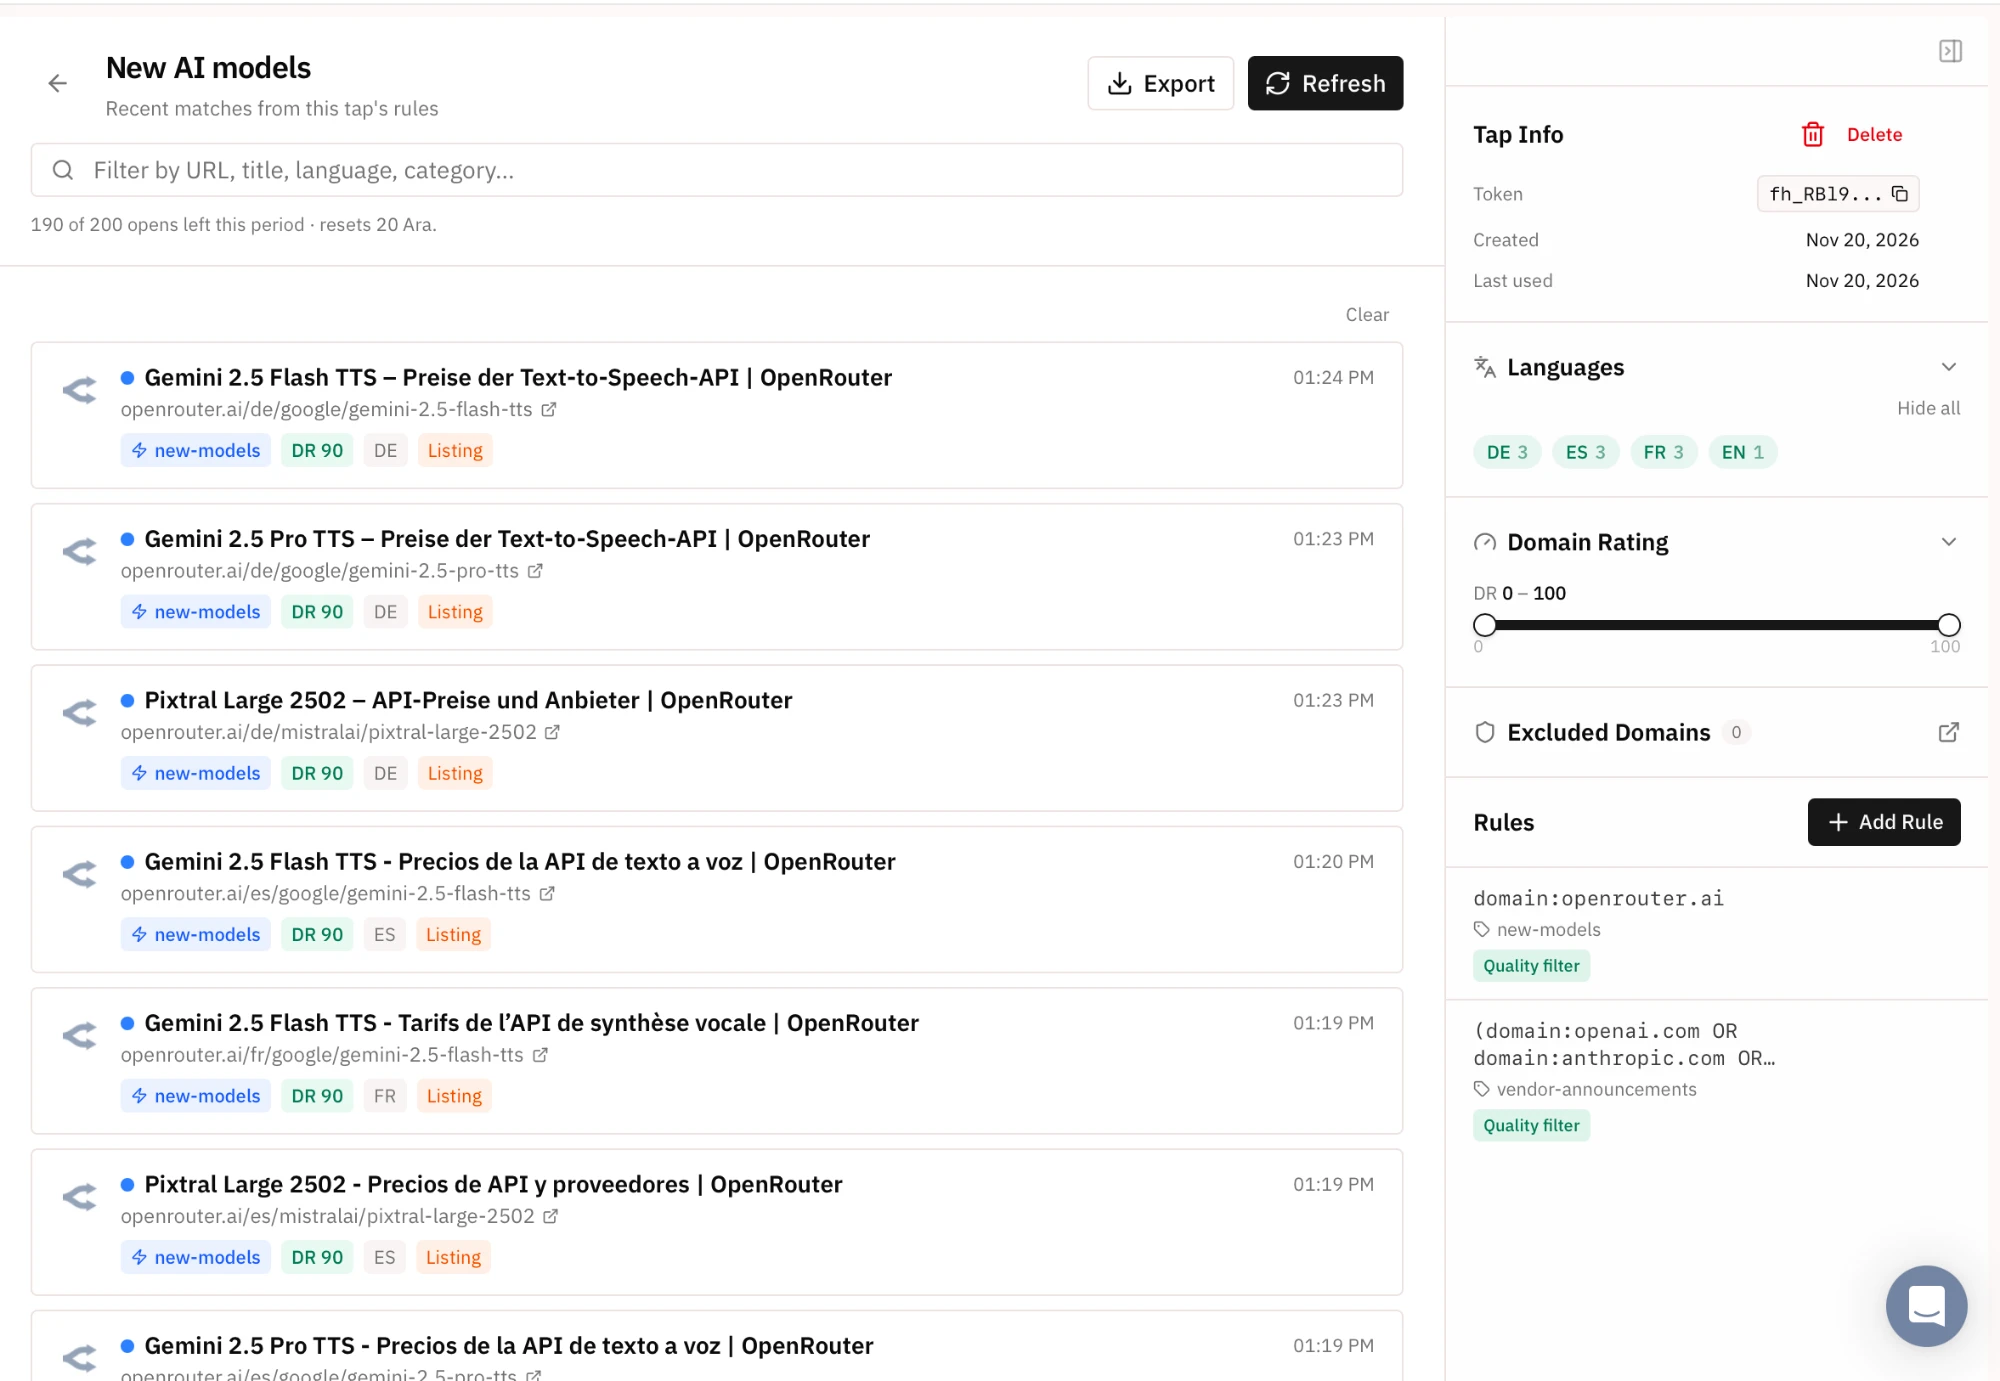
Firehose segnala una pagina nuova per il suo crawler, non un prodotto nuovo, quindi i siti di catalogo come OpenRouter portano modelli più vecchi in un feed di monitoraggio dei rilasci.
URL Watch
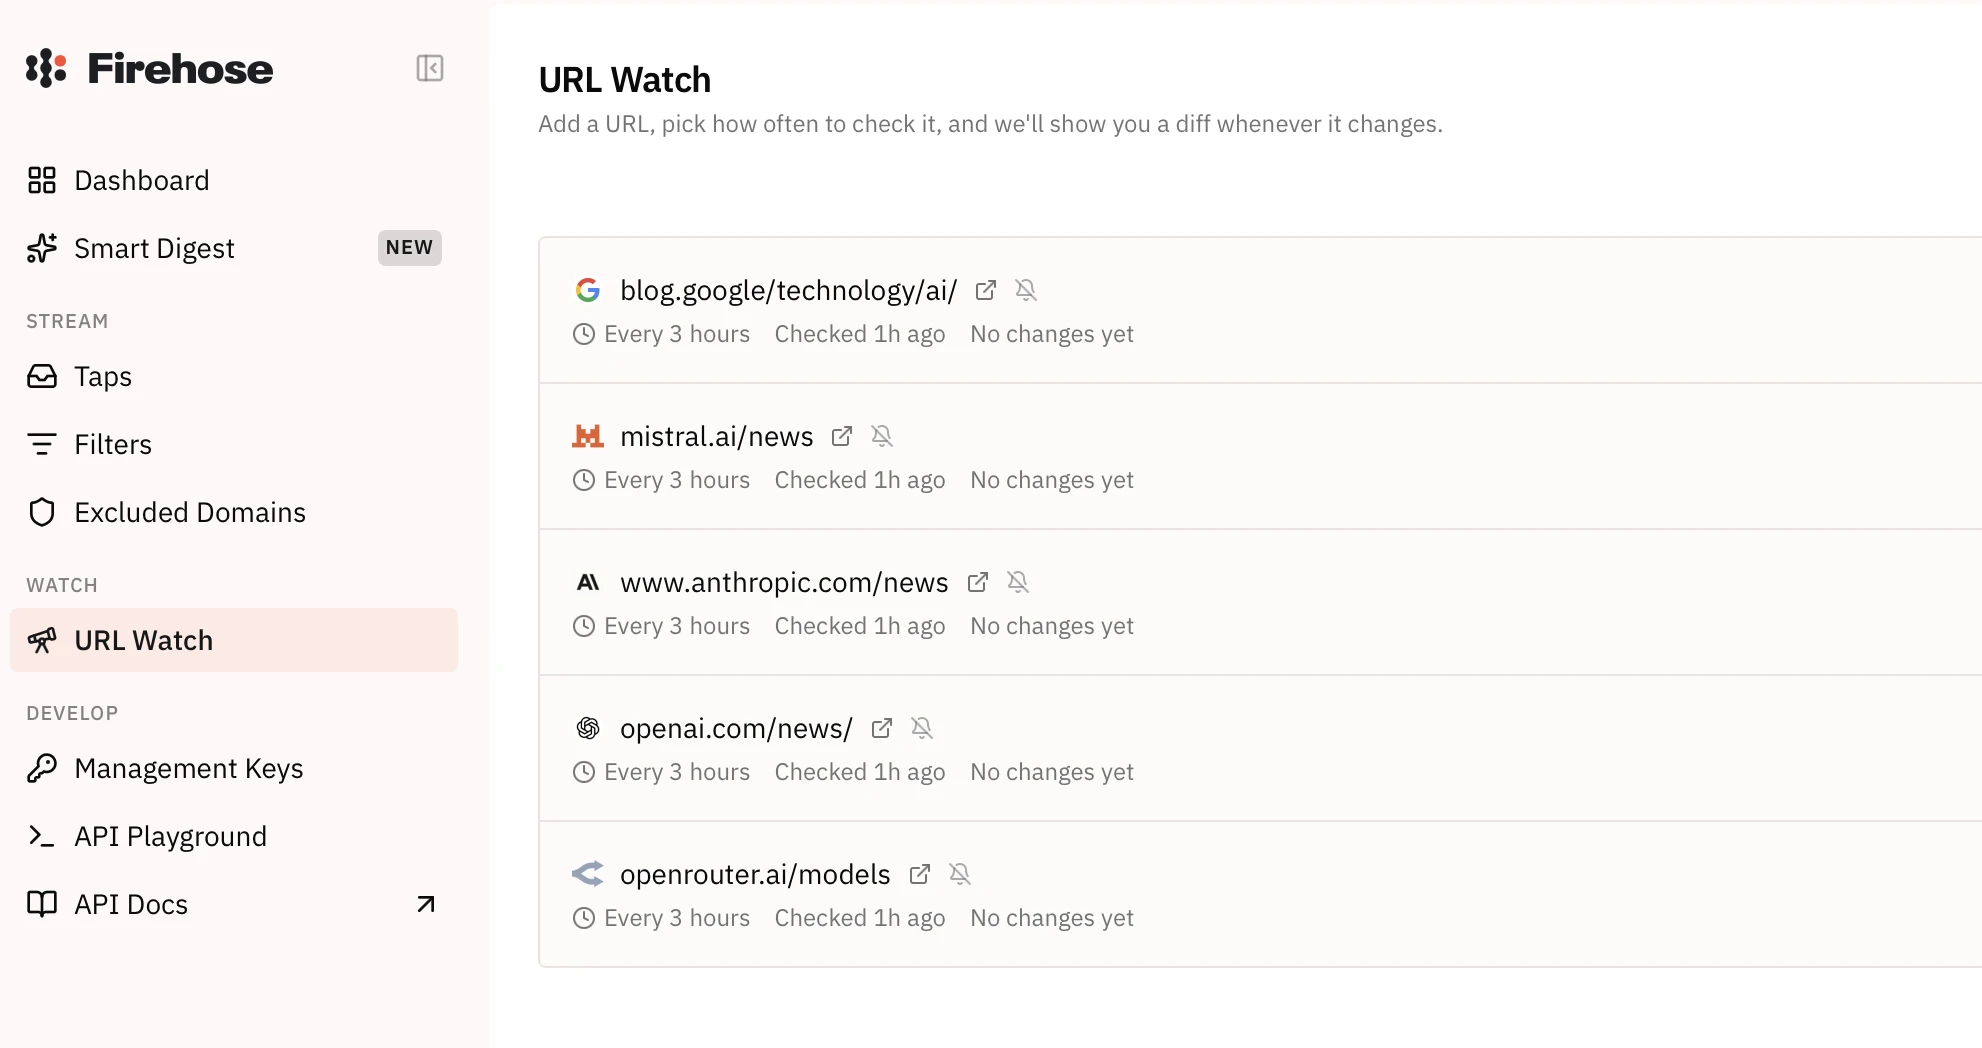
URL Watch funziona al contrario: invece di aspettare che il crawler raggiunga una pagina, Firehose ricontrolla le pagine scelte dal cliente secondo una pianificazione fissa e mostra un diff quando una cambia. Abbiamo monitorato l'elenco dei modelli di OpenRouter e le pagine di notizie di OpenAI, Anthropic, Mistral e Google, ciascuna ogni 3 ore.
Come funziona Common Crawl
Common Crawl è un'organizzazione non profit che pubblica una scansione del web aperto circa una volta al mese e la regala. Non servono account, chiavi o quote. Il compromesso è che ricevi file invece di un servizio: non ti viene consegnato nulla e qualsiasi cosa oltre la ricerca di una singola pagina richiede di eseguire la propria elaborazione.
Scelta del formato
Ogni scansione è disponibile in diversi formati. Le risposte HTTP grezze contengono l'HTML originale. Un extract dei metadati contiene link, titoli e intestazioni come JSON. Una versione in testo semplice contiene il testo dell'articolo senza markup. Due insiemi più piccoli coprono i file robots.txt e le risposte non-200.
La scelta è importante perché è unidirezionale. Il testo semplice è molto più piccolo e rapido da utilizzare, ma tag, attributi e JSON-LD incorporati non ci sono, quindi l'estrazione strutturata deve partire dall'insieme grezzo.
Non c'è consegna filtrata. Scegli un formato, scarichi ciò che ti serve e lo elabori da solo.
Trovare una pagina
Esistono due meccanismi e rispondono a domande diverse. Il server CDX gestisce le ricerche di singoli URL tramite un modulo web o un'API. L'indice colonnare, pubblicato come Parquet, gestisce le domande in blocco tramite SQL.
L'interfaccia CDX chiede due cose: quale scansione mensile cercare, da un elenco che risale al 2008, e un pattern URL.
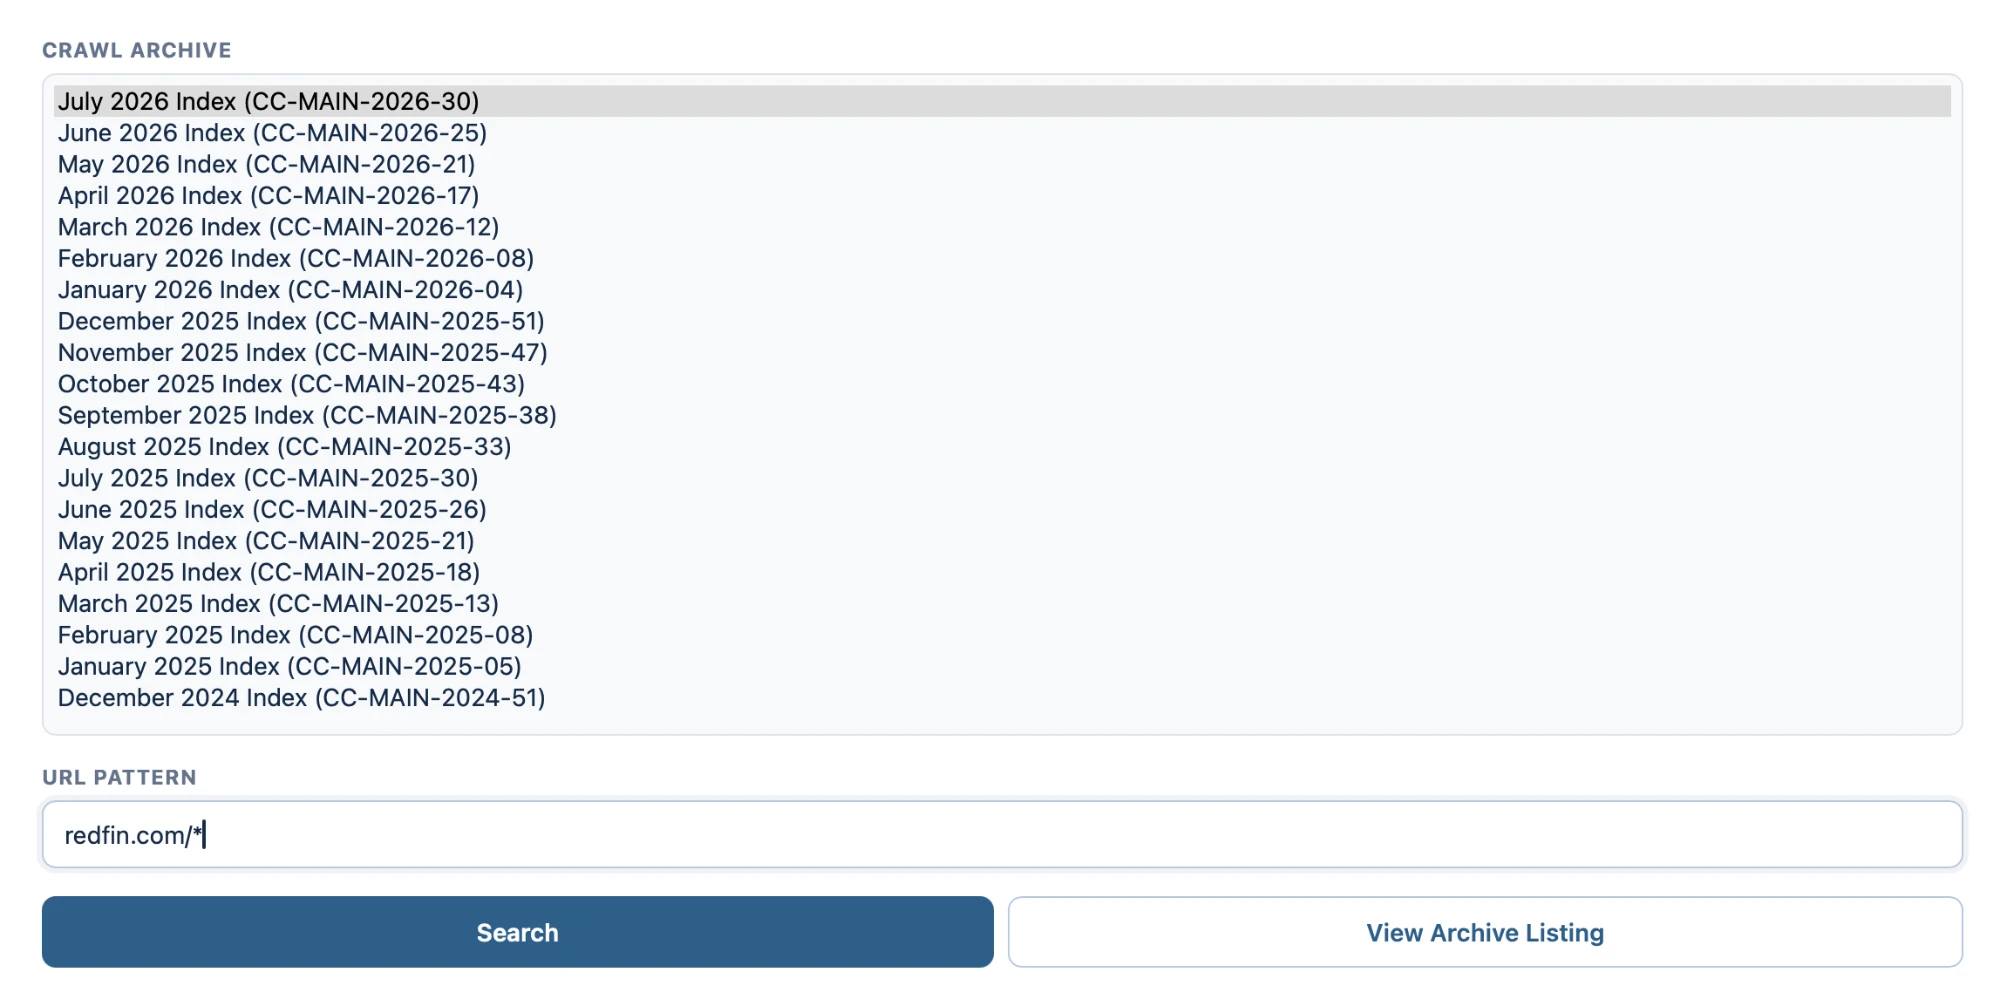
I risultati vengono restituiti come JSON, una riga per acquisizione. Tre campi contano più degli altri: il nome del file WARC, un offset in byte e la lunghezza del record.
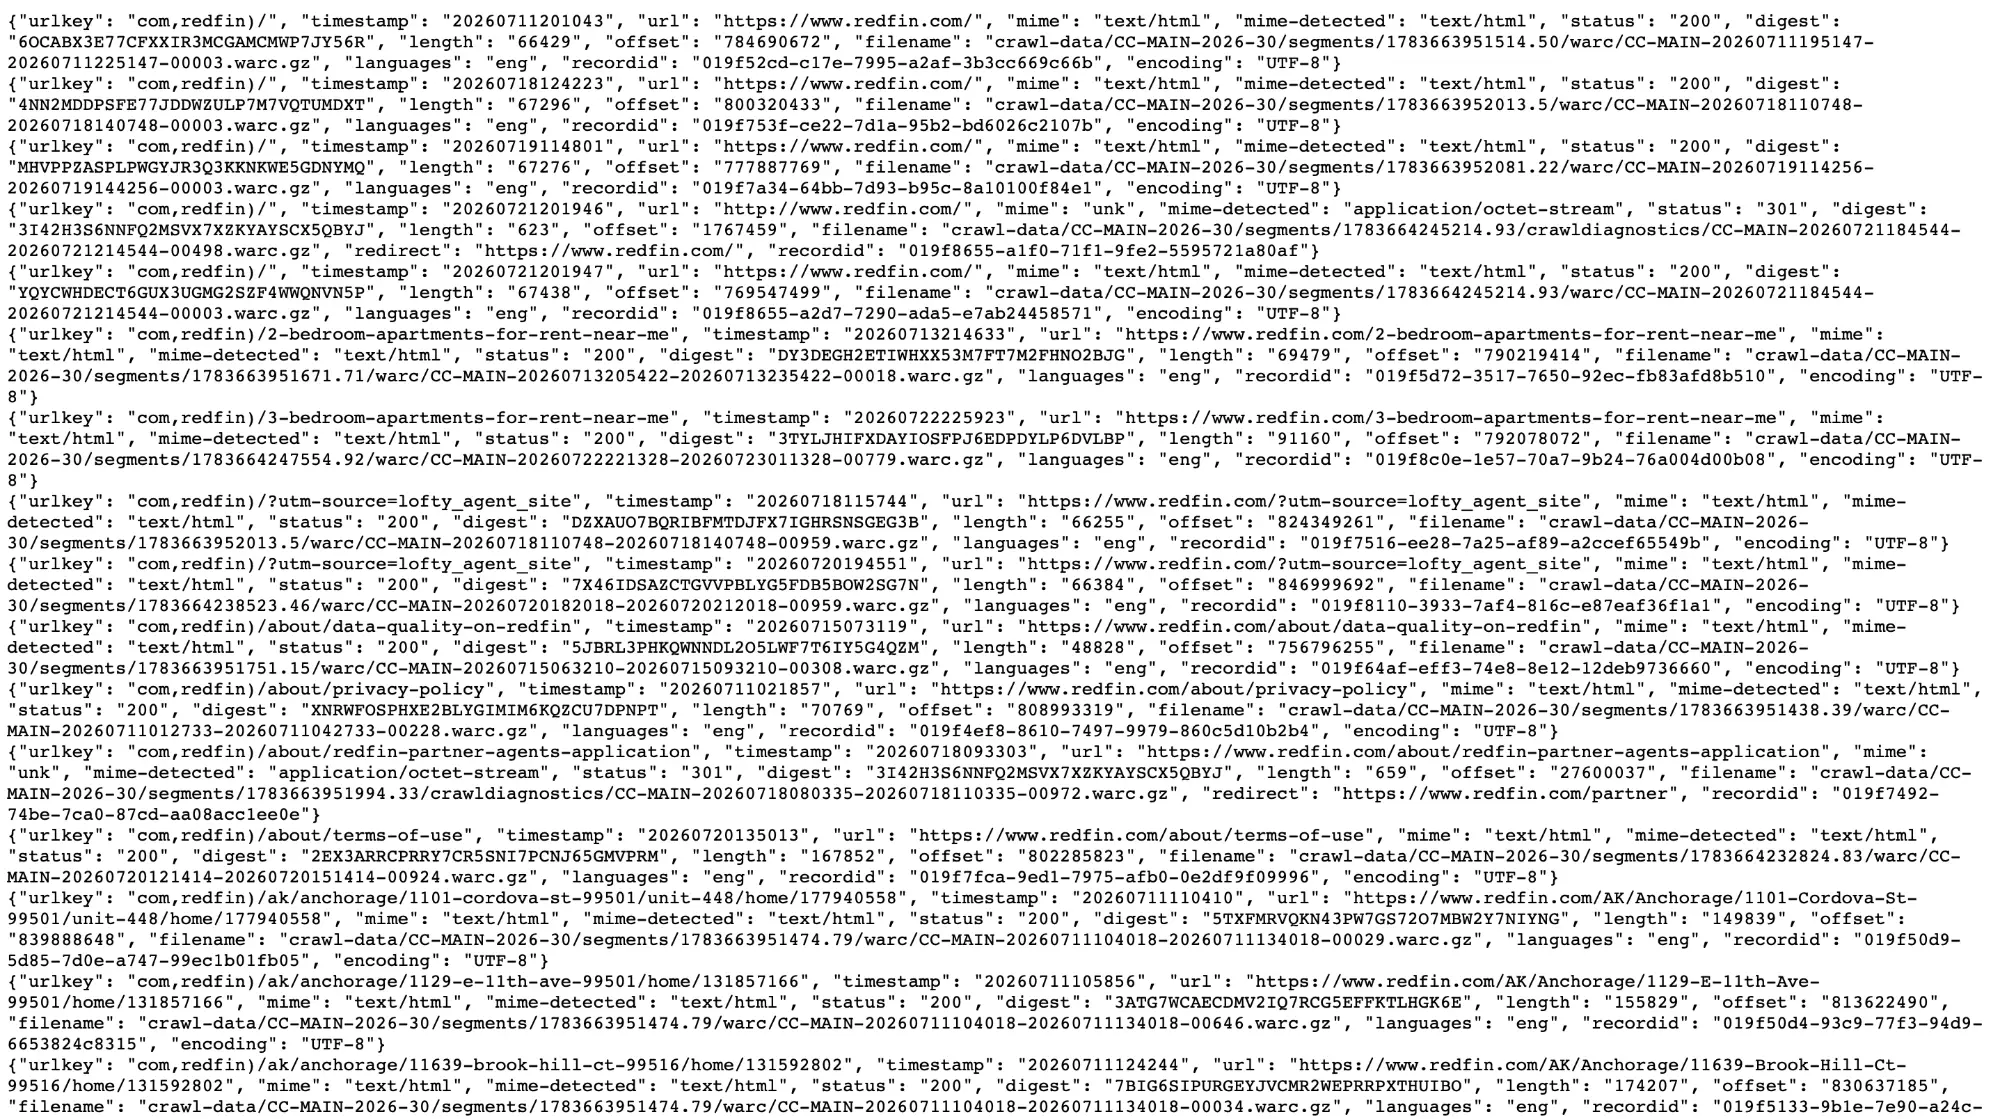
Nell'output sono visibili due cose. Lo stesso URL appare diverse volte con timestamp diversi, quindi una singola scansione mensile non è un singolo snapshot. E le risposte fallite vengono archiviate separatamente, con reindirizzamenti ed errori in una cartella crawldiagnostics anziché accanto ai fetch riusciti.
Estrarre una pagina senza scaricare il file che la contiene
Il nome del file, l'offset e la lunghezza consentono di richiedere un singolo record con un header Range HTTP. Lo abbiamo testato su una pagina di annunci Redfin.
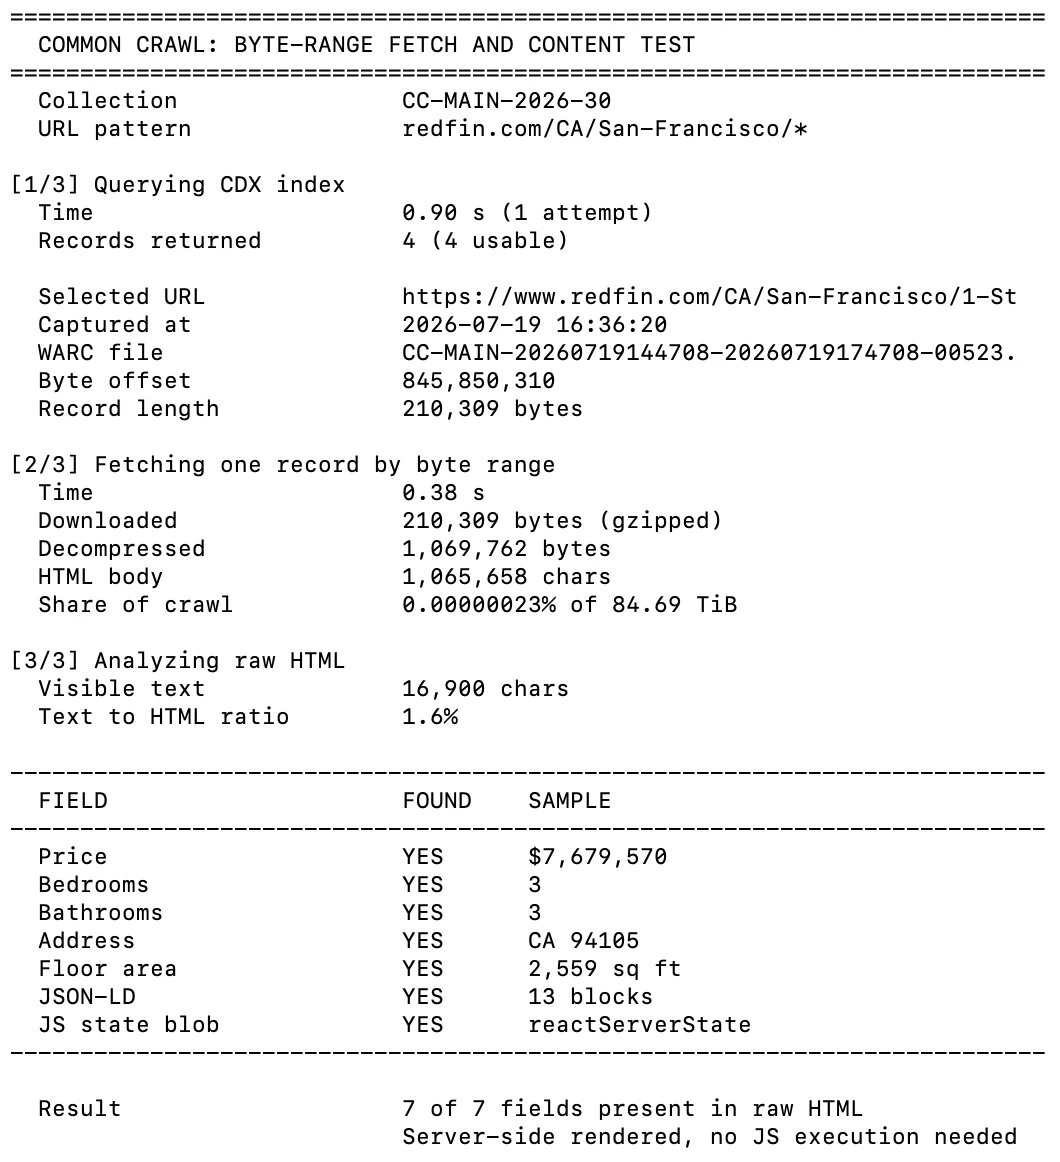
La ricerca CDX ha risposto in meno di un secondo e il fetch del range di byte ha richiesto 0,38 secondi per 210 KB. Tutti i sette campi dell'annuncio che abbiamo cercato, inclusi prezzo, camere da letto e indirizzo, erano presenti nell'HTML grezzo senza eseguire JavaScript.
Filtro in blocco con SQL
Per qualsiasi cosa più grande di un singolo URL, la strada è l'indice colonnare. È in formato Parquet, è interrogabile tramite HTTPS ed espone 33 colonne che coprono URL, host, TLD, lingua, tipo MIME, stato del fetch e timestamp.
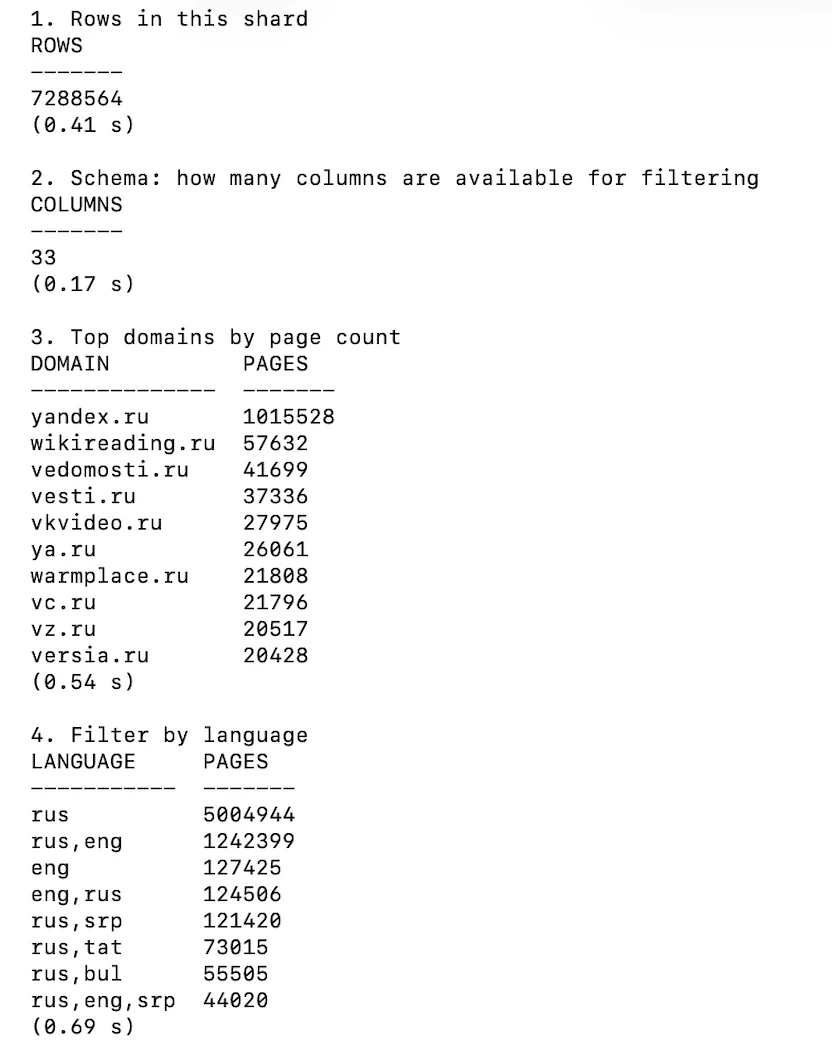
Le query su un singolo shard di 7.29 milioni di righe sono state completate in ben meno di un secondo ciascuna, senza scrivere nulla su disco. Un dettaglio da conoscere prima di usarlo: gli shard sono indicizzati per nome host invertito, quindi ogni file contiene una stretta porzione alfabetica anziché un campione casuale. Interrogare uno shard arbitrario per un dominio specifico di solito non restituisce nulla.
Quanto contiene per un dato dominio
Abbiamo interrogato l'indice per due domini, redfin.com e zillow.com, individuando lo shard che copre ciascuno e contandone le righe.
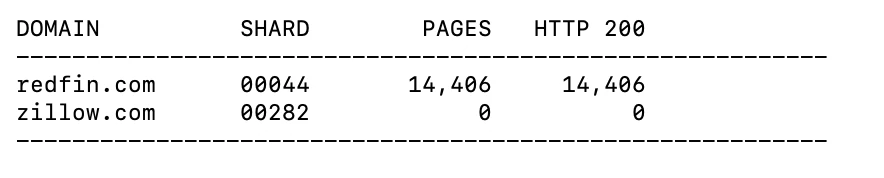
redfin.com ha restituito 14.406 pagine, tutte con stato HTTP 200. zillow.com non ne ha restituita alcuna. Non si tratta di copertura parziale né di un fetch fallito; il dominio non è nell'indice. Common Crawl rispetta robots.txt, quindi un sito che vieta il suo crawler è assente anziché essere rappresentato in modo sporadico.
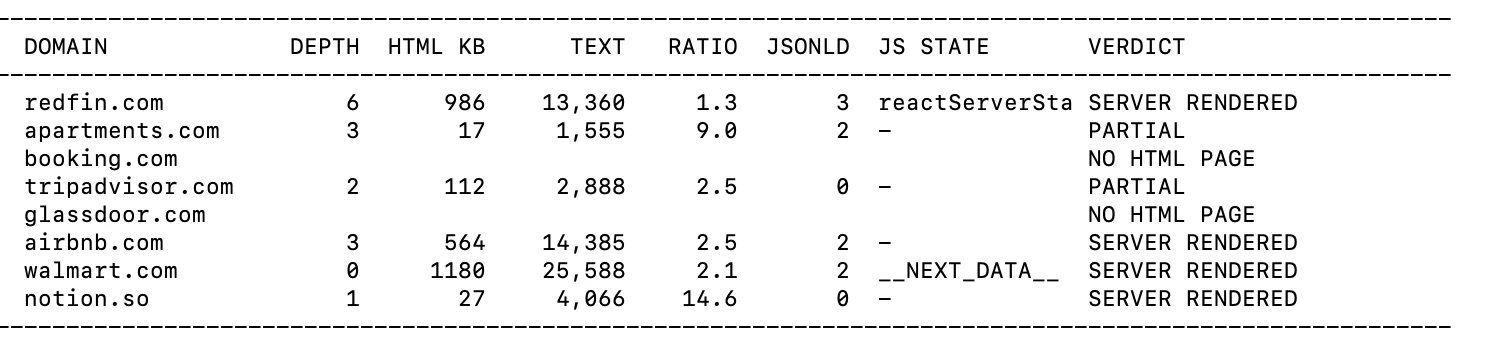
Abbiamo estratto una pagina archiviata da ciascuno di otto grandi siti e misurato quanto testo sopravviveva senza browser. Due di essi non avevano alcuna pagina HTML utilizzabile nell'archivio. Tra gli altri, la maggior parte era renderizzata lato server, tra cui Airbnb e Walmart. TripAdvisor era l'eccezione, restituendo una pagina da 18 KB che conteneva 282 caratteri di testo visibile.
Costi e licenza
I dati sono gratuito e il bucket di storage è aperto senza account. Ciò che paghi sono calcolo e banda, motivo per cui si consiglia di elaborare i dati nella stessa regione cloud in cui risiedono.
La licenza non è una licenza open data. Common Crawl concede una licenza limitata al servizio, dichiara di non poter concedere in licenza il contenuto delle pagine stesso e richiede agli utenti di indennizzarla contro le rivendicazioni derivanti dall'uso del contenuto “in connessione con intelligenza artificiale, machine learning o altre tecnologie simili”. La responsabilità totale è limitata a $100.1
Quale si adatta a quale compito
Questi prodotti non sono sostituti. La domanda non è quale sia il migliore, ma quale risponde alla domanda che hai.
- HTML grezzo su larga scala, inclusi i siti che bloccano i crawler. L'API Web Archive di Bright Data scrive una selezione filtrata nello storage che controlli e il suo archivio contiene pagine di siti che bloccano i crawler, che Common Crawl esclude.
- Nuove pagine non appena vengono scansionate. Bright Data Firehose trasmette pagine complete a S3, un webhook o uno stream. Ahrefs Firehose invia il testo modificato delle pagine che corrispondono alle tue regole, e il suo URL Watch ricontrolla le pagine che scegli secondo una pianificazione.
- Un corpus ampio senza costi, se hai capacità ingegneristica. Common Crawl ti dà scansioni complete in WARC, enumerabili con SQL, e non chiede nulla oltre alla tua capacità di calcolo. L'elaborazione spetta a te costruirla.
- Testi di notizie, blog e forum con entità e sentiment già estratti. Webz.io restituisce record elaborati invece di pagine, il che elimina il lavoro di estrazione ma elimina anche il markup. Il suo Firehose invia nuovi post ogni pochi minuti.
- Contesto della pagina al momento della query, per un agente o una pipeline RAG. Exa restituisce testo in cache in millisecondi e ripiega su un fetch live quando una pagina non è archiviata. Snapshot restituisce la versione di una pagina da una data passata negli ultimi cinque mesi.
 Aggiungi come fonte preferita
Come abbiamo testato le API di archiviazione web
Abbiamo lavorato dentro ciascun prodotto piuttosto che sulla base della documentazione. Ogni fornitore è stato utilizzato prima tramite la propria console o playground, poi tramite la sua API, in modo da vedere la richiesta generata dall'interfaccia e ciò che viene restituito prima che venga addebitato alcun importo.
Per ciascuno abbiamo costruito una query, l'abbiamo eseguita e letto la risposta grezza invece del riepilogo renderizzato. Quando il prodotto restituiva un conteggio, una stima dei costi o un oggetto di stato, abbiamo registrato direttamente quei campi. Quando offriva un campione o una consegna, l'abbiamo presa, spacchettato i file e aperti.
Piccoli script hanno gestito le parti che richiedevano ripetizione o misurazione dei tempi: estrarre un singolo record da un archivio multi-terabyte, decomprimere un pacchetto consegnato e cercare campi specifici nell'HTML grezzo, interrogare un indice colonnare con SQL e misurare quanto impiega una risposta in cache rispetto a una che deve essere scansionata. Questi script sono collegati accanto ai risultati che hanno prodotto.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Le migliori alternative a Common Crawl: Bright Data e Webz.io}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/common-crawl-alternatives}},
  note   = {AIMultiple. Consultato il 20 novembre 2026}
}Risultati e timestamp di 18 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 2 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Collegamenti di riferimento





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.