


Ottimizzazione dei costi di Kubernetes: 8 passaggi e 23 strumenti

I cluster Kubernetes possono sembrare del tutto sani mentre la bolletta sale. L'autoscaling è configurato, le dashboard sono verdi e la spesa aumenta comunque. In un sondaggio, il 42% dei 455 ingegneri di piattaforma ha indicato il costo come la sfida Kubernetes numero uno, mentre l'88% ha visto il costo totale di proprietà aumentare di anno in anno.1
Abbiamo raccolto 68 case study sull'ottimizzazione dei costi di Kubernetes e mappato ogni caso d'uso menzionato a ciascun fornitore che lo ha pubblicato:
Le celle più scure indicano più menzioni. Le celle vuote indicano che quello strumento non ha casi pubblicati per quel caso d'uso.
Continua a scorrere per una guida in 8 passaggi con esempi reali per ridurre la spesa dei cluster e il confronto dello strumento per l'ottimizzazione dei costi di Kubernetes.
1. Misura prima di cambiare qualsiasi cosa
Ogni numero nel resto di questa guida è un delta, e un delta ha bisogno di un punto di partenza. Senza una baseline rilevata prima della prima modifica, non c'è modo di sapere se il passaggio 1 ha funzionato, né di attribuire i risparmi del passaggio 3 al consolidamento piuttosto che al dimensionamento che lo ha preceduto. Questo conta più qui che nella maggior parte del lavoro di ingegneria, perché tutte e sei le azioni riducono la stessa bolletta e i loro risparmi non si sommano. Liberare capacità nel passaggio 1 non produce nulla in fattura finché il passaggio 3 non rimuove i nodi.
Misura quattro aspetti:
- Richieste rispetto a CPU e memoria effettivamente utilizzate, per workload. Il divario è il backlog del passaggio 1, ordinato per dimensione.
- Costo per namespace e per workload. Questo è ciò che rende le quote del passaggio 2 una negoziazione piuttosto che un'imposizione.
- Efficienza di bin-packing, allocabile rispetto a richiesto per nodo. Obiettivo del passaggio 3.
- Costo inattivo per ora del giorno e giorno della settimana nel non produttivo. Dimensiona il passaggio 5 prima di realizzarlo.
Misura per almeno un ciclo lavorativo completo. Sette giorni sono il minimo e trenta sono meglio. La finestra non è cautela procedurale. Il passaggio 1 imposta le richieste di memoria al massimo osservato, e un massimo osservato vale quanto la finestra che lo ha osservato. Un massimo rilevato nell'arco di 48 ore esclude un job batch settimanale e produce un OOMKill la domenica successiva.
Strumenti
- Allocazione dei costi: OpenCost, il progetto CNCF alla base del modello di allocazione, è la base gratuito. Il livello gratuito di Kubecost racchiude lo stesso motore in una UI fino a 250 core.
- Utilizzo: Prometheus con kube-state-metrics è il substrato. Robusta KRR lo legge direttamente senza installare nulla nel cluster.
- Spesa più ampia: Dove Kubernetes è una parte di una bolletta che anche la finanza deve spiegare, CloudZero, Vantage e Finout si collocano sopra questo livello anziché sostituirlo.
Entrambi gli strumenti di costo attribuiscono i costi in base alle label, quindi l'etichettatura viene prima. La spesa non etichettata è il motivo più comune per cui una baseline si rivela inutile tre settimane dopo.
Ogni azione qui sotto indica la raccomandazione, il metodo, la configurazione e un'azienda che ha compiuto quel passo. Ogni case study e ogni statistica è accompagnata da un link alla fonte.
2. Imposta le quote dei namespace come guardrail
I risparmi decadono man mano che i team distribuiscono nuovi workload senza richieste specificate. Un LimitRange fornisce richieste predefinite ai container che le omettono, e un ResourceQuota limita quanto un namespace può consumare complessivamente.
Distribuisci il LimitRange prima del ResourceQuota. Una volta che una quota vincola una risorsa, qualsiasi pod senza una richiesta per quella risorsa viene rifiutato all'ammissione, quindi l'ordine inverso interrompe i deployment.2
Ogni load balancer viene fatturato separatamente dal fornitore cloud, e i volumi orfani continuano a essere fatturati dopo che i loro pod sono spariti.
2. Dimensiona correttamente le richieste di CPU e memoria
Le richieste determinano il numero di nodi, e il numero di nodi determina la bolletta. La maggior parte dei cluster gira molto al di sotto della capacità per cui paga, perché le richieste sono state stimate una volta e mai più riviste. Un'analisi di 23.000 cluster di produzione su AWS, Azure e Google Cloud ha rilevato un utilizzo medio della CPU del 8%, della memoria del 20% e della GPU del 5%. 3
Imposta le richieste di CPU vicino al percentile 95 dell'uso osservato. Imposta le richieste di memoria al massimo osservato anziché a un percentile e imposta il limite di memoria uguale alla richiesta. Un percentile lascia il container a corto di risorse durante il traffico rimanente e, poiché il limite corrisponde alla richiesta, quella carenza si presenta come OOMKill anziché come rallentamento.
Ometti il limite della CPU. Il throttling della CPU degrada la latenza senza terminare il pod, e la richiesta riserva ciò di cui il workload ha bisogno.
Il Vertical Pod Autoscaler in modalità solo raccomandazione produce queste cifre senza rischi per la produzione.
Leggi le raccomandazioni con kubectl describe vpa payments-api e confronta il valore target con la richiesta attuale.
Caso di studio reale: Tryg Insurance
Tryg Insurance è la più grande compagnia di assicurazioni generali nella regione nordica e gestisce Kubernetes su Oracle Cloud Infrastructure. Il suo team di ingegneria ha combinato l'Horizontal Pod Autoscaler e il Vertical Pod Autoscaler per ridimensionare dinamicamente i workload mantenendo i livelli di servizio, e ha ridotto i costi cloud di Kubernetes del 50% utilizzando solo autoscaler open source, senza alcuna piattaforma commerciale di ottimizzazione.4
4. Consolida i nodi con Karpenter e scala a zero i workload inattivi
Il corretto dimensionamento libera capacità, ma quella capacità si trova su nodi che continuano a funzionare finché qualcosa non li rimuove. Karpenter esegue il provisioning delle istanze just-in-time e ricompatta i workload su un numero minore di nodi. KEDA scala a zero repliche i workload guidati da code, cosa che un Horizontal Pod Autoscaler standard non può fare.
Imposta il criterio di consolidamento su WhenEmptyOrUnderutilized. L'alternativa, WhenEmpty, limita l'interruzione ai nodi che non ospitano alcun pod di workload, e questi si verificano raramente senza intervento. 5
Un elenco ristretto di tipi di istanza vanifica questo, perché Karpenter non riesce a trovare opzioni economiche atipiche e la resilienza allo spot diminuisce. Dovresti lasciargli scegliere tra intere famiglie di istanze.
Caso di studio reale: Adidas
Adidas gestisce più cluster Kubernetes su AWS EKS. Il suo team di platform engineering ha adottato Karpenter per il provisioning dei nodi, ha aggiunto KEDA per lo scaling guidato dagli eventi, ha creato automaticamente oggetti Vertical Pod Autoscaler tramite policy Kyverno e ha utilizzato kube-downscaler per gli ambienti inattivi. Hanno ridotto il costo di gestione dei cluster Kubernetes su AWS fino al 50%, utilizzando uno stack interamente open source.6
5. Prepara adeguatamente prima di spostare i workload su spot
Le istanze spot offrono lo sconto più elevato disponibile e l'applicabilità più limitata. Niente dovrebbe essere spostato su spot finché PodDisruptionBudgets, diversificazione delle istanze, topology spread e gestione della terminazione non sono tutti in atto.
Un PodDisruptionBudget che non lascia margine blocca tutte le interruzioni volontarie, incluso il consolidamento di Karpenter, quindi i valori devono avere margine. 7
Caso di studio reale: Delivery Hero
Delivery Hero gestisce 390 applicazioni in 43 paesi, con circa il 90% dei workload in esecuzione su AWS EKS. Il suo team è migrato alle istanze Spot nell'arco di circa sei mesi, integrando nel processo la gestione della terminazione e un descheduler anziché cambiare direttamente il tipo di capacità.
- I costi infrastrutturali sono diminuiti di circa il 70%
- Gli sconti spot hanno raggiunto fino al 90% rispetto ai prezzi on-demand
- La piattaforma assorbe picchi di traffico pari a 4-5 volte il volume normale.8
6. Spegni gli ambienti non produttivi secondo una pianificazione
Gli ambienti di sviluppo e staging hanno poco o nessun carico di notte e nei fine settimana. Lo spegnimento programmato è tecnicamente semplice e non contestato a livello politico, il che lo rende il risparmio più rapido da realizzare e una prima azione utile dove i cambiamenti più difficili avranno bisogno di supporto in seguito.
Applica la pianificazione per impostazione predefinita a tutti i namespace non produttivi e richiedi ai team di disattivarla esplicitamente. Una policy che richiede un'azione per aderire raggiunge meno team di una che richiede un'azione per uscire.
Il risparmio arriva in fattura se il consolidamento dei nodi è attivo, poiché i deployment scalati in basso lasciano dietro di sé nodi vuoti.
Caso di studio reale: Bud Financial
Bud Financial arricchisce i dati sulle transazioni finanziarie per il settore dei servizi finanziari e gestisce circa 25 cluster su Google Kubernetes Engine. Il suo team ha utilizzato pause e resume programmate per ridurre i nodi dei cluster di notte e nei fine settimana, insieme al ribilanciamento quotidiano.
- I costi sono diminuiti del 47% solo grazie alla modifica della pianificazione
- La pianificazione ha eliminato 80 ore di funzionamento dei cluster a settimana
- L'utilizzo delle risorse è salito sopra il 90%.9
7. Migra i workload compatibili ad ARM
Le istanze basate su ARM cambiano il prezzo unitario anziché competere per la stessa capacità inattiva delle azioni precedenti, quindi questi risparmi si sommano davvero agli altri. Gli ostacoli saranno le dipendenze senza build ARM64.
Gli utenti dovrebbero valutare questa migrazione per singolo workload piuttosto che per l'intera infrastruttura e creare immagini multi-architettura prima di pianificare qualsiasi cosa.
Caso di studio reale: Pinterest
Pinterest ha migrato il proprio workload di web API sulle istanze AWS Graviton in esecuzione su ARM64, motivata sia dai costi sia dalla riduzione delle emissioni di carbonio.
- I costi sono diminuiti del 47%
- Il consumo di calcolo è diminuito del 38%
- Le emissioni di carbonio sono diminuite del 62%.10
8. Quando il tuning si esaurisce, cambia architettura
Le sei azioni precedenti ottimizzano i workload all'interno dei cluster esistenti. Una volta esaurite, ulteriori guadagni richiedono un cambiamento architetturale anziché ulteriore tuning.
Due risultati pubblicati segnano il limite pratico. InCred Finance ha ridotto la spesa del 30% su cluster che il suo team considerava ottimizzati11, e Yotpo ha ottenuto dal 30–40% eseguendo l'80% dei workload su istanze spot12. Oltre questa fascia, lo spreco rimanente non si trova più nei cluster ma nel numero di cluster. Ognuno comporta una control plane tariffa e forma un'isola di pianificazione che il bin-packing non può attraversare.
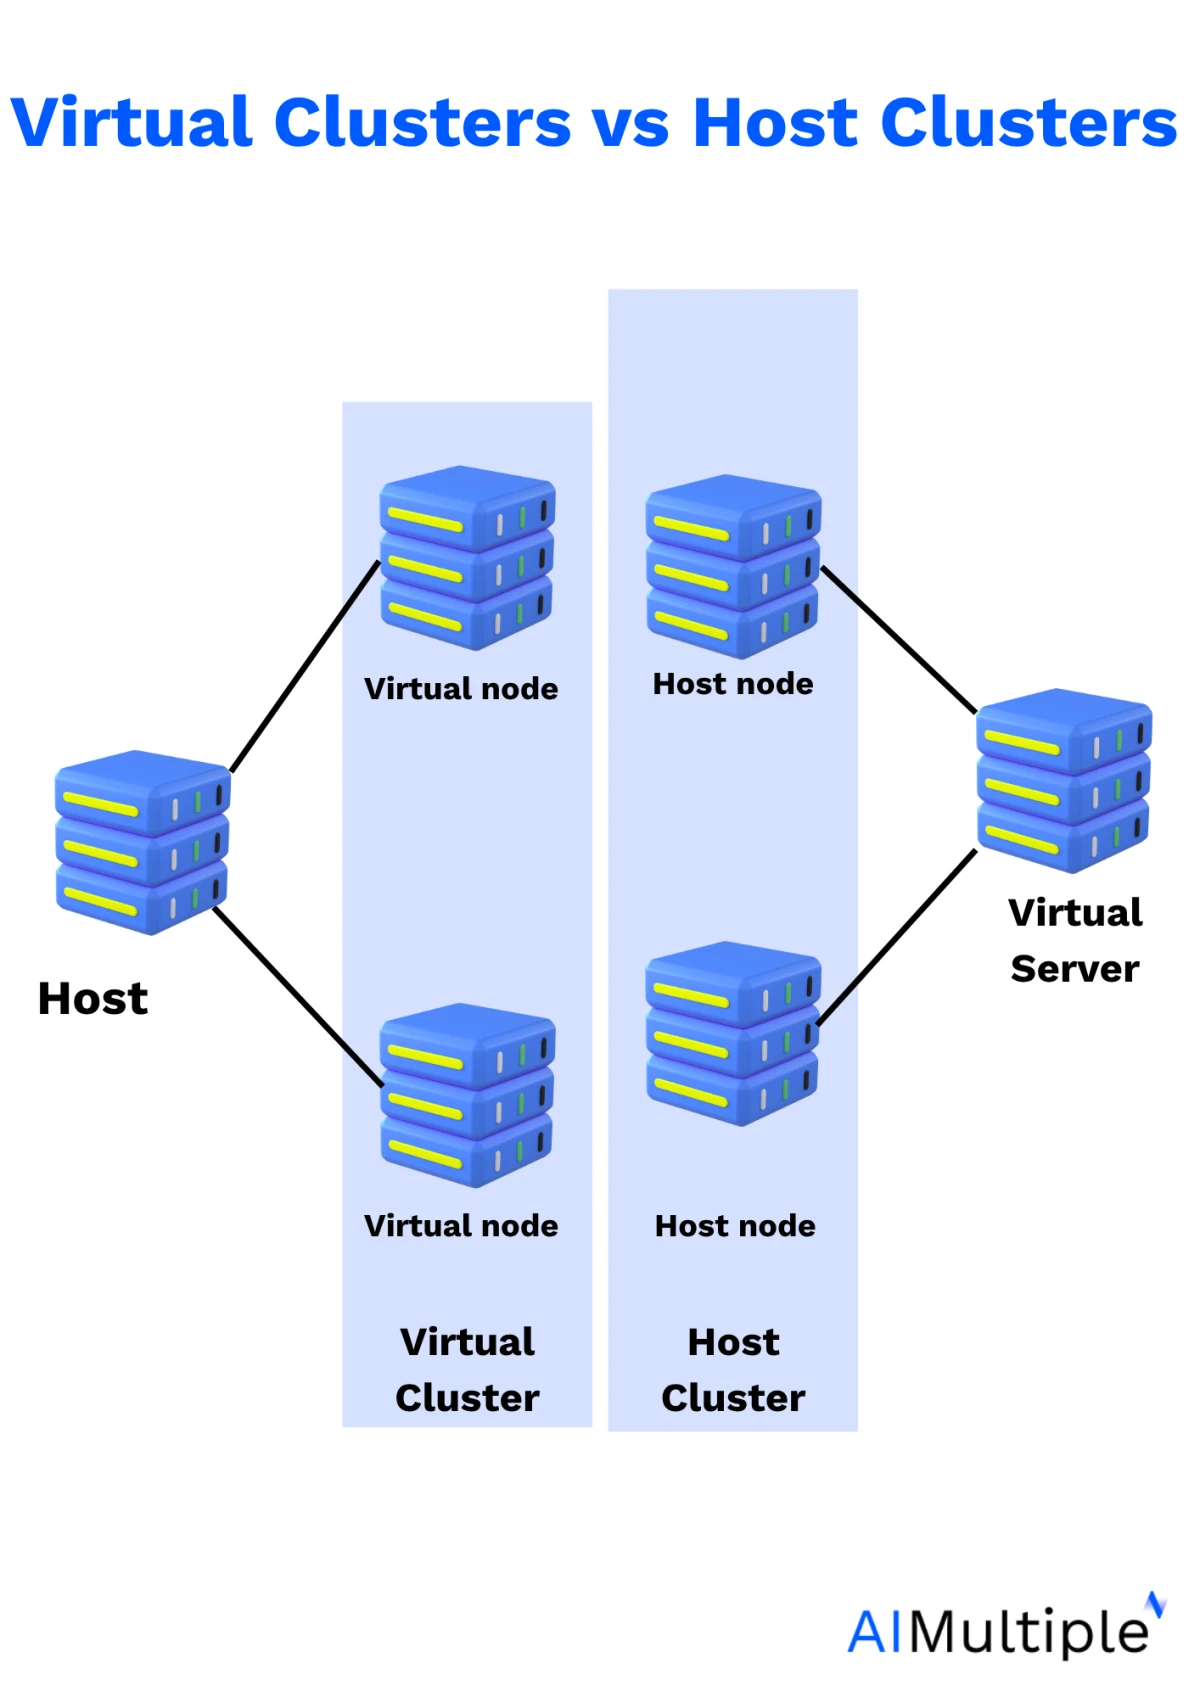
Il multi-tenancy elimina entrambi i costi. Invece di dedicare un cluster a ciascun cliente, team o ambiente, i cluster virtuali girano su infrastruttura fisica condivisa. Ogni tenant riceve il proprio API server e un control plane virtuale mentre i nodi sono messi in comune. Questo elimina il costo del control plane per singolo cluster e consente il bin-packing nel pool di nodi condiviso anziché all'interno di infrastrutture isolate.
yaml
bash
Sono disponibili due meccanismi. I namespace sono sempre più economici, quindi la scelta si basa sulla separazione richiesta dai tenant, non sul costo.
- I namespace partizionano un singolo cluster e non aggiungono alcun control plane proprio. Sono sufficienti quando i tenant si fidano l'uno dell'altro e possono condividere un unico API server e un unico set di CRD.
- I cluster virtuali danno a ogni tenant il proprio API server, in esecuzione come workload sull'host. Quel costo è giustificato in due casi: tenant che hanno bisogno di risorse cluster-scoped proprie, e requisiti di isolamento che un API server condiviso non può soddisfare.
Caso di studio reale: Atlan
Atlan è un'azienda di data catalog che ospita la piattaforma per circa il 95% dei suoi clienti, molti nei settori healthcare e finance dove l'isolamento dei dati è contrattuale. Gestiva un cluster EKS completo per cliente e ha superato i 100 cluster, un'infrastruttura costosa da mantenere attiva 24 ore su 24 e difficile da gestire. Dal Q1 2022 ha valutato opzioni di multi-tenancy e ha ricostruito su vCluster, offrendo a ogni cliente un cluster virtuale anziché fisico.
- I cluster EKS fisici sono scesi da più di 100 a 20, continuando a servire oltre 100+ clienti
- La spesa Kubernetes è diminuita di 600.000 dollari.13
 Aggiungi come fonte preferita
Ordine di esecuzione
Gli impegni vanno per ultimi nonostante siano l'azione più semplice. Acquistarli prima del corretto dimensionamento blocca da uno a tre anni lo spreco che il dimensionamento stava per eliminare. È l'errore di sequenza più costoso disponibile, ed è comune perché richiede un acquisto anziché lavoro di ingegneria.
L'azione 7 è una diramazione, non un passaggio. Intraprendila una volta completate le prime sei e se il risultato è ancora insufficiente, poiché cambia quanti cluster girano anziché quanto efficientemente ciascuno gira.
Strumenti per l'ottimizzazione dei costi di Kubernetes
Abbiamo tracciato gli strumenti con tre o più case study pubblicati, che coprono 47 dei 68 case study nel dataset:
- Orizzontale: quanti case study ha ciascuno strumento, contati una volta ciascuno.
- Verticale: quante categorie distinte di casi d'uso coprono quei casi, su dieci. Uno strumento conta una volta per categoria, non importa quante volte vi compare, quindi le 12 menzioni separate di rightsizing di CAST IA contribuiscono con 1 al suo punteggio di 10.
- Dimensione della bolla: in quanti degli otto stadi della strategia compare lo strumento.
Framework open source
I framework open source possono essere distribuiti per gli stadi da 0 a 6. Gli utenti si fanno carico degli aggiornamenti, del turnover delle versioni, dei costi di retention di Prometheus e delle decisioni che un recommender commerciale prenderebbe al posto loro.
Ognuno di questi copre un ambito diverso, ed è per questo che spesso ne girano più di uno contemporaneamente.
- Robusta KRR o VPA in
updateMode: "Off"produce il backlog del passaggio 1. Non scrive nulla. - Karpenter gestisce i nodi: provisioning, consolidamento, selezione delle istanze, diversificazione spot, architettura. Copre i passaggi 3, 4 e 6.
- KEDA gestisce il numero di repliche, incluso lo scale to zero, cosa che HPA da solo non può fare.
- py-kube-downscaler o kube-green gestisce la pianificazione non produttiva. Il risparmio più economico dell'elenco.
- OpenCost misura in modo continuativo e non partecipa a nulla.
Piattaforme commerciali
Ogni strumento commerciale assume una di tre posizioni sul livello dei nodi. È quella la decisione, e conta più del prezzo o del numero di funzionalità, perché il manifest NodePool del passaggio 3 o sopravvive o non sopravvive.
- Lascialo stare: StormForge, PerfectScale, Sedai e Kubex ridimensionano i workload. Hanno bisogno di Karpenter o Cluster Autoscaler sotto e non lo toccano mai. L'aggiunta più sicura a una configurazione esistente.
- Lavoraci insieme: ScaleOps aggiunge bin packing sopra Karpenter. nOps ottimizza un Cluster Autoscaler o Karpenter esistente anziché sostituirlo con il proprio. Maggiore copertura, provisioner ancora tuo.
- Sostituiscilo: CAST IA e Spot Ocean installano il proprio provisioner e scartano il manifest. Copertura più ampia, minore controllo.
- Gli strumenti di visibilità restano fuori: OpenCost, Kubecost, CloudZero, Vantage e Finout sono in sola lettura, quindi non entrano in conflitto con nulla e si sommano liberamente. Eseguine uno indipendentemente da cos'altro venga adottato.
Come combinare questi strumenti
La fattura si basa sui nodi in esecuzione, non sulle richieste dichiarate. Il corretto dimensionamento riduce le richieste, liberando spazio sui nodi esistenti ma senza rimuoverne nessuno, quindi la bolletta resta invariata finché uno strumento per i nodi non consolida via quello spazio. Gli strumenti per i nodi da soli falliscono per la ragione opposta: impacchettano qualsiasi richiesta ricevano, quindi le richieste sovradimensionate vengono impacchettate ancora più strettamente.
Due modi per coprire entrambi i livelli:
- Due strumenti: VPA, StormForge o PerfectScale per le richieste, più Karpenter per i nodi. Più economico, e il livello dei nodi resta sotto controllo diretto.
- Una piattaforma: CAST IA, Zesty o Spot Ocean fanno entrambe le cose in un unico prodotto. Più costosi, e il loro provisioner sostituisce Karpenter.
Cinque combinazioni di strumenti che rompono le cose:
- Due rightsizer con mutazione su uno stesso deployment: VPA in
Autoinsieme a StormForge, ScaleOps, PerfectScale o Zesty significa due controller che scrivono numeri diversi nello stesso campo. Un solo mutating admission controller per workload. - Karpenter e Cluster Autoscaler su un unico gruppo di nodi: Entrambi fanno provisioning per gli stessi pod non schedulabili, quindi il cluster finisce con circa il doppio dei nodi necessari.
- VPA e HPA sulla stessa metrica: L'utilizzo sale, VPA aumenta la richiesta, l'utilizzo misurato scende perché è utilizzo diviso richiesta, HPA rimuove repliche, il carico per pod sale, ripeti. Sicuro quando HPA scala su qualcosa che VPA non tocca, come la profondità della coda tramite KEDA.
- Due strumenti di commitment su un unico account pagante: Entrambi acquistano in base alla stessa spesa non coperta, bloccando un sovra-impegno da uno a tre anni.
- Due piattaforme complete: CAST IA, Zesty e Spot Ocean installano ciascuna il proprio provisioner e ciascuna si aspetta di possederlo.
Esamina tutti i case study che abbiamo raccolto:
Approfondimenti sui costi cloud
Leggi di più per padroneggiare il posizionamento dei pod e ridurre la spesa per il calcolo cloud:
- Confronta i migliori strumenti di orchestrazione dei container
- Confronta oltre 20 orchestratori cloud
- I migliori scheduler di job per cloud ibrido
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{Ottimizzazione dei costi di Kubernetes: 8 passaggi e 23 strumenti}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/kubernetes-cost-optimization}},
  note   = {AIMultiple. Consultato il 15 ottobre 2026}
}Risultati e timestamp di 249 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 6 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Collegamenti di riferimento
Prossimo da leggere
I 15 migliori strumenti di ottimizzazione per i motori di risposta

Ottimizzazione per i motori di risposta (AEO): consigli e best practice
Migliori 10 cloud GPU serverless e 14 GPU convenienti


Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.