


Yapay Zeka Halüsinasyon Tespit Araçları: W&B Weave ve Comet

Üç halüsinasyon tespit aracını benchmark ettik: W&B Weave HallucinationFree Scorer (CoreWeave Forge'un bir parçası, eski adıyla Weights & Biases), Arize Phoenix HallucinationEvaluator ve Comet Opik Hallucination Metric; 100 test senaryosu üzerinde.
Her araç doğruluk, kesinlik, duyarlılık ve gecikme süresi açısından değerlendirildi.
Yapay zeka halüsinasyon tespit araçları benchmark
Kaynak bağlamlarına göre olgusal soru-cevap senaryolarından 100 yanıtı test ettik (50 doğru, 50 halüsinasyonlu).
Doğruluk ve gecikme süresi karşılaştırması
Test süreciyle ilgili daha fazla ayrıntı için benchmark metodolojisi. bölümüne bakın.
W&B Weave ve Arize Phoenix sırasıyla %91 ve %90 doğrulukla neredeyse aynı performansı gösterdi. Her iki araç da dataset boyunca güvenilir performans sergiledi. Comet Opik %72 doğrulukla geride kaldı; 100 testin yalnızca 72'sini doğru sınıflandırdı; bu, muhafazakâr yaklaşımından kaynaklanan önemli bir farktı.
Hız açısından Arize Phoenix test başına 2 saniye ile kazanan oldu ve bu da onu gerçek zamanlı uygulamalar için uygun hale getiriyor. W&B Weave testleri 4 saniyede işledi; bu, çoğu üretim kullanım senaryosu için makul bir süredir. Comet Opik test başına 8,5 saniye ile belirgin şekilde daha yavaştı; bu da gecikmeye duyarlı uygulamalarda kullanıcı deneyimini olumsuz etkileyebilir.
F1 skoru, kesinlik ve duyarlılık
F1 skorları (kesinlik ve duyarlılığın harmonik ortalaması) bu örüntüleri doğruladı: W&B Weave %90,5 ve Phoenix %89,4 ile güçlü ve dengeli bir performans elde etti. Karşılaştırıldığında, Opik'in %61,1 değeri, mükemmel kesinlik ile zayıf duyarlılık arasındaki ödünleşimi yansıttı. Opik'in sıfır yanlış pozitifi, 28 yanlış negatif pahasına geldi; bu da onu yalnızca yanlış alarmların kaçırılan tespitlerden daha maliyetli olduğu senaryolar için uygun hale getiriyor.
Duyarlılık (gerçek halüsinasyonları yakalama becerisi) belirgin stratejiler ortaya koydu. W&B Weave %86 duyarlılıkla öne çıktı; 50 halüsinasyonun 43'ünü yakaladı ve yalnızca 7'sini kaçırdı. Phoenix %84 ile yakından takip etti; 42 halüsinasyon tespit etti ve 8'ini kaçırdı. Comet Opik'in duyarlılığı %44 ile önemli ölçüde daha düşüktü; yalnızca 22 halüsinasyon yakaladı ve 28 halüsinasyonu kaçırdı; gerçek halüsinasyonların yarısından fazlası tespit edilemedi.
Kesinlik (uyarı güvenilirliği) önemli farklılıklar gösterdi. Comet Opik, sıfır yanlış pozitifle mükemmel %100 kesinlik elde etti; bir şeyi halüsinasyon olarak işaretlediğinde her zaman doğruydu. Hem Phoenix (%95,5) hem de Weave (%95,6) neredeyse aynı kesinliği gösterdi; her biri 50 meşru yanıt içinde yalnızca 2 yanlış pozitif üretti; bu da aşırı muhafazakâr olmadan güçlü bir güvenilirlik sergiledi.
Performans farklılıklarını etkileyebilecek faktörler
Gözlemlenen performans farklılıkları muhtemelen tasarım felsefesinden, eşik seçiminden ve dayanaklandırmanın yorumlanmasından kaynaklanıyor.
Tespit stratejisi ve optimizasyon hedeflerindeki farklılıklar
- Araçlar aynı hedef yerine farklı hata ödünleşimleri için optimize edilmiş görünüyor.
- W&B Weave ve Arize Phoenix, yüksek kesinliği korurken çoğu halüsinasyonu yakalamayı sürdürerek dengeli performansı hedefliyor.
- Comet Opik, birçok halüsinasyon gözden kaçsa bile sıfır yanlış pozitife öncelik veren son derece muhafazakâr bir strateji benimsiyor.
- Bu stratejik tercih, Opik'in mükemmel kesinliğini ve önemli ölçüde düşük duyarlılığını doğrudan açıklıyor.
Araç tasarımına gömülü kesinlik–duyarlılık ödünleşimleri
- Comet Opik'in sıfır yanlış pozitifi, yalnızca güven çok yüksek olduğunda halüsinasyonları işaretleyen katı bir karar eşiğine işaret ediyor.
- W&B Weave ve Phoenix daha az kısıtlayıcı eşikler kullanıyor; çok daha yüksek duyarlılık karşılığında bazı yanlış pozitiflere izin veriyor.
- Bu eşik farklılıkları şunlara yol açabilir:
- Weave ve Phoenix genelinde benzer kesinlik
- Opik ile diğer iki araç arasında büyük duyarlılık farkları
- F1 skoru ve genel doğrulukta karşılık gelen farklılıklar
LLM-as-a-judge uygulamasındaki farklılıklar
- Her üç araç da LLM-as-a-judge yaklaşımını kullansa da uygulamaları farklılık gösteriyor.
- W&B Weave, ince ve desteklenmeyen iddialara duyarlılığı artırabilecek düşünce zinciri akıl yürütmesine vurgu yapıyor.
- Arize Phoenix, daha incelikli yargıları destekleyen güven skorlu etiket tabanlı çıktılar içeriyor.
- Comet Opik, yanlış alarmları azaltan ancak sınırdaki halüsinasyonlara duyarlılığı sınırlayan yüksek güvenli ikili kararlara odaklanıyor.
Değerlendirme derinliğinden kaynaklanan gecikme farklılıkları
- Arize Phoenix'in düşük gecikmesi, gerçek zamanlı kullanım için uygun, daha hafif veya daha akıcı bir değerlendirme pipeline'ına işaret ediyor.
- W&B Weave'in orta düzey gecikmesi, daha zengin akıl yürütme ve izleme loglamasıyla tutarlıdır.
- Comet Opik'in daha yüksek gecikmesi muhtemelen daha kapsamlı iç akıl yürütme veya doğrulama adımlarını yansıtıyor ve muhafazakâr tasarımını güçlendiriyor.
Yapay zeka halüsinasyon tespit araçları
W&B Weave'in HallucinationFree Scorer'ı
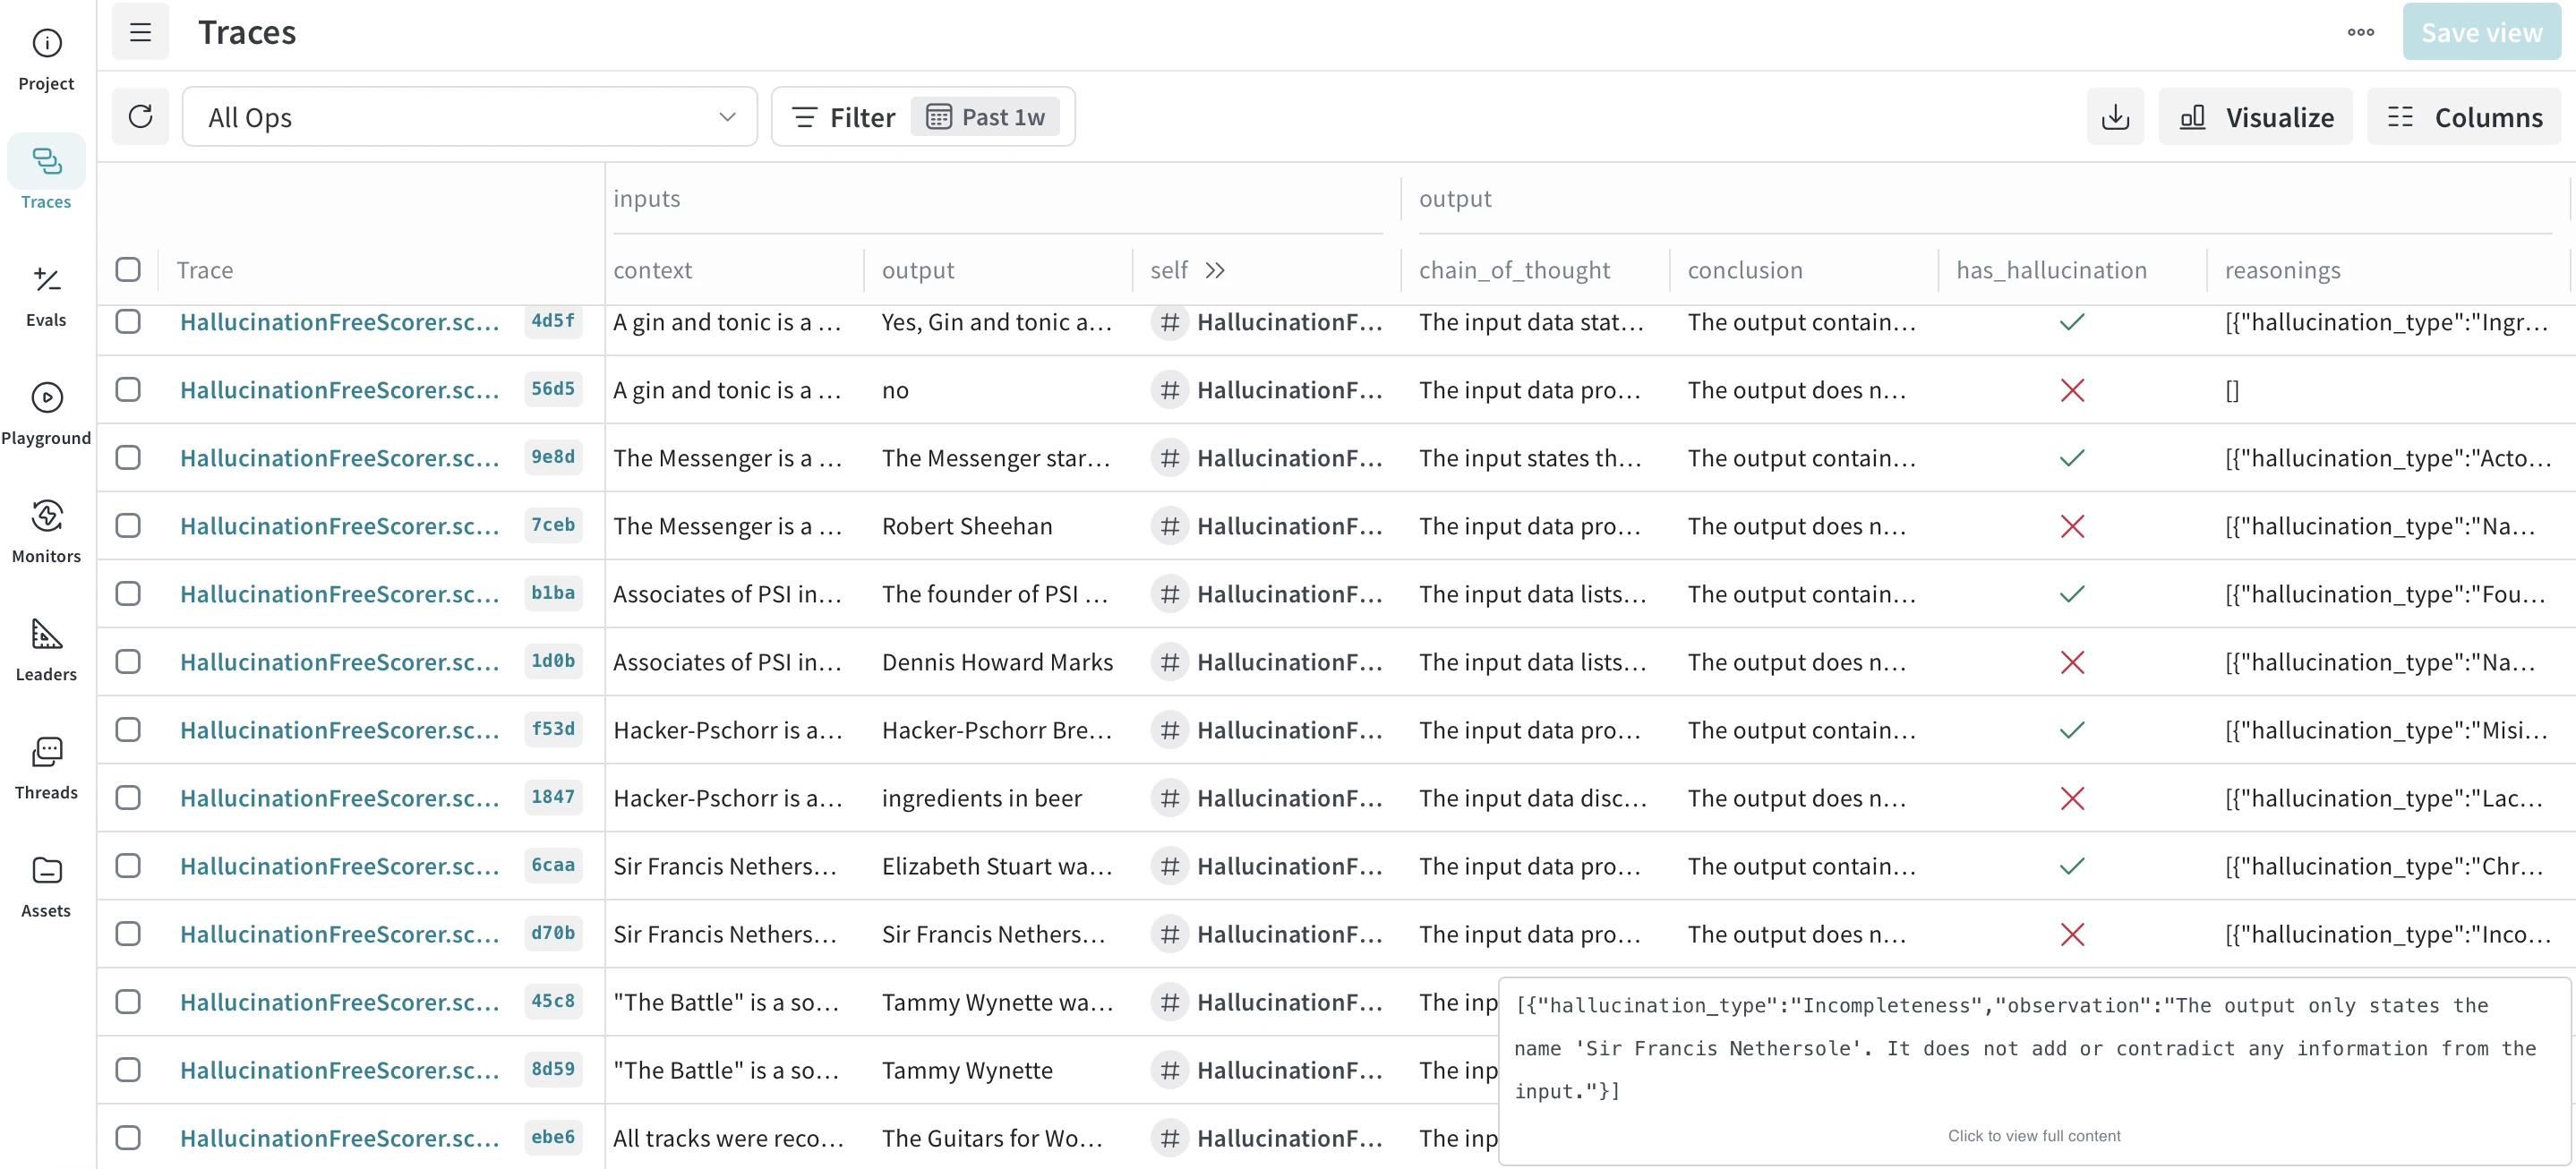
Şekil 1: W&B Weave'in izleme paneli.
CoreWeave Forge, kaynak bağlamda bulunmayan iddialar içeren LLM çıktılarını işaretleyen bir HallucinationFree Scorer ile birlikte gelir. Her yanıt üzerinde bir LLM yargıcı çalıştırır ve arkasındaki gerekçeyle birlikte dayanaklı/dayanaksız şeklinde bir karar döndürür.
Scorer iki girdi alır: bağlam (kaynak materyal) ve çıktı (LLM tarafından üretilen yanıt). Ardından çıktının bağlamda bulunmayan bilgi içerip içermediğini analiz etmek için bir dil modeli kullanır. Sonuç, kararı açıklayan bir boolean has_hallucination bayrağı ve gerekçe içerir.
Temel özellikler:
- Düşünce zinciri akıl yürütmesi: Her değerlendirme, çıktının neden halüsinasyon olarak işaretlendiğini veya işaretlenmediğini açıklayan bir gerekçe içerir.
- İkili sınıflandırma: Destekleyici kanıtlarla birlikte net doğru/yanlış kararları döndürür.
- Weave izleme ile entegrasyon: Sonuçlar görselleştirme için otomatik olarak Weave panosuna kaydedilir.
- Özelleştirilebilir model: OpenAI, Anthropic ve diğer sağlayıcılar dahil olmak üzere farklı LLM yargıçlarını destekler.
Arize Phoenix'in HallucinationEvaluator'ı
Arize Phoenix, referans materyalinden sapan yanıtları işaretleyen bir HallucinationEvaluator ile birlikte gelir. Her çıktı için bir LLM yargıcı, cevabın sağlanan bağlamda dayanaklı olup olmadığına karar verir ve kararına bir güven skoru ekler.
Değerlendirici üç girdi alır: kullanıcı sorgusu (girdi), referans metin (bağlam) ve modelin yanıtı (çıktı). Yanıtın bağlamdan türetilemeyecek bilgi içerip içermediğini analiz eder; açıklama ve güven skoruyla birlikte etiketli bir sonuç (“olgusal” veya “halüsinasyonlu”) döndürür.
Temel özellikler:
- Dengeli performans: Hem kesinlik hem de duyarlılık metriklerinde sonuçlar verir
- Etiket tabanlı çıktı: Yalnızca sayısal skorlar yerine kategorik etiketler (“olgusal” veya “halüsinasyonlu”) döndürür
- Ayrıntılı açıklamalar: Her değerlendirme kararı için gerekçe sağlar
Comet Opik'in Hallucination Metric'i
Comet Opik'in Hallucination Metric'i, her LLM yanıtını kaynak bağlamına göre puanlar ve çıktının o bağlama sadık olup olmadığına ilişkin ikili bir yargı döndürür. Kontrol, yalnızca desteklenmeyen iddiaların yüksek güvenli durumlarını işaretlemek üzere ayarlanmış bir LLM yargıcı üzerinden çalışır.
Metrik üç girdi kabul eder: kullanıcı sorgusu (girdi), kaynak materyal (bağlam) ve modelin yanıtı (çıktı). Çıktının bağlam tarafından desteklenmeyen iddialar içerip içermediğini değerlendirir.
Sonuç, ikili bir skor (0 halüsinasyon yok, 1 halüsinasyon tespit edildi) ve değerlendirmeyi açıklayan ayrıntılı bir gerekçe içerir.
Temel özellikler:
- Ayrıntılı açıklamalar: Her değerlendirme, içeriğin neden işaretlendiği veya onaylandığı hakkında kapsamlı gerekçe sağlar
- Üç girdili analiz: Değerlendirme için sorguyu, bağlamı ve yanıtı birlikte dikkate alır
- Deney izleme: Sonuçlar otomatik olarak Opik'in deney izleme sistemine kaydedilir
- Muhafazakâr yaklaşım: Yalnızca yüksek güvenli halüsinasyonları işaretleyerek yanlış pozitifleri en aza indirmek üzere tasarlanmıştır
Galileo Luna-2
Galileo Luna-2, Galileo'nun daha geniş yapay zeka gözlemlenebilirlik platformuna yerleştirilmiş bir halüsinasyon tespiti ve çalışma zamanı koruma katmanıdır. 1
Sistem, üretim inference yollarında satır içi olarak çalışacak şekilde tasarlanmıştır; dayanaksız içeriği kullanıcıya ulaşmadan önce engeller; Galileo'nun otomatik hata analizi katmanı Signals ise manuel log incelemesi olmadan üretim hatalarının kök nedenlerini ortaya çıkarır.
Temel özellikler:
Çok yöntemli tespit: Tek bir yargılama stratejisine bağlı kalmak yerine embedding benzerliği, Chain-of-Thought analizi ve G-Eval doğruluk puanlamasını birleştirir.
Çalışma zamanı korumaları: Luna-2, dayanaksız çıktıları yalnızca olaydan sonra işaretlemekle kalmaz, inference yolunda satır içi olarak engelleyebilir veya yeniden yazabilir.
Uçtan uca gözlemlenebilirlik: Çok adımlı ajan iş akışları boyunca girdileri, çıktıları ve iç akıl yürütme izlerini yakalar; Signals kök neden analizini otomatikleştirir.
DeepEval
DeepEval, Confident AI'dan açık kaynaklı bir LLM değerlendirme framework'üdür; Pytest gibi hissettirecek ancak LLM uygulamaları için tasarlanmıştır. HallucinationMetric'i, modelin çıktısının sağlanan bağlamla olgusal olarak tutarlı olup olmadığına karar vermek için bir LLM-as-a-judge kullanır ve framework herhangi bir CI/CD pipeline'ında çalışacak şekilde geliştirilmiştir.23
Metrik üç zorunlu girdi alır: kullanıcı sorgusu (input), model yanıtı (actual_output) ve referans materyal (context). Her çıktıyı Halüsinasyon = (Çelişen Bağlam Sayısı) / (Toplam Bağlam Sayısı) formülüyle puanlar; düşük skorlar daha iyi dayanaklanmayı gösterir. Bir çıktı, skoru yapılandırılan eşiğin altında veya eşiğe eşit olduğunda geçer.
Temel özellikler:
- Tanıdık test iş akışı: Halüsinasyon kontrolleri normal birim testleri gibi yazılır ve çalıştırılır; böylece hâlihazırda Pytest kullanan ekiplerin yeni bir araç öğrenmesi gerekmez.
- Ayarlanabilir sıkılık: Ekipler geçme eşiğini gevşetebilir veya sıkılaştırabilir ya da yüksek riskli içerikler için katı geçer/kalır moduna geçebilir.
- Her sonuç için açıklamalar: Her karar bir gerekçeyle birlikte gelir; böylece bir çıktının neden işaretlendiği açık olur.
Yapay zeka halüsinasyonu nedir?
Yapay zeka halüsinasyonları, tutarlı görünen ancak olgusal olmayan çıktılardır. Model, kaynak bağlam veya eğitim verileri bunları desteklemediğinde bile bu iddiaları kendinden emin bir şekilde üretir. Konuyla ilgili bir araştırma bunu, modellerin sağlanan bağlamdaki doğrulanabilir kanıtlar yerine dilsel önceliklere yaslanmasına bağlar.4 Bu sorun, sağlık hizmetleri, hukuk hizmetleri, kurumsal arama ve müşteri destek gibi yüksek riskli alanlarda ortaya çıkar; bu nedenle dayanaklı çıktı tespiti, LLM dağıtımının standart bir parçası haline gelmiştir.
Halüsinasyonların kaynakları ve sınıflandırması
Halüsinasyonlar iki geniş kaynaktan doğar. Model içi faktörler arasında istatistiksel örüntülere aşırı güven, eğitim verilerindeki boşluklar ve dizi üretiminin olasılıksal doğası yer alır; halüsinasyon tespiti ve azaltma üzerine bir analiz, LLM'lerin genellikle doğrulanabilir kanıtları almak yerine olası devamları çıkarsadığını ve bunun da kendinden emin ancak yanlış çıktı ürettiğini belirtir.5
Bağlamsal faktörler, RAG sistemlerinde geri getirme hatalarını, belirsiz prompt'ları, eksik dayanaklandırmayı ve çok modlu model'lerde nesne karışıklıklarını veya uydurulmuş sahne ayrıntılarını kapsar.
Ajan tabanlı iş akışlarında halüsinasyon tespiti
Çok adımlı ajanlar, tek turlu LLM'lerin yol açmadığı halüsinasyon riskleri doğurur: erken bir adımda uydurulan bir iddia, daha sonraki araç çağrılarına, geri getirmelere ve nihai çıktılara yayılır.
Ajan tabanlı halüsinasyon tespitindeki temel zorluklar:
- Hata yayılımı: Planlama aşamasında uydurulan bir olgu, araç seçimini, veri alımını ve nihai yanıtları etkileyebilir
- Araç çağrısı halüsinasyonları: Ajanlar araçları yanlış parametrelerle çağırabilir veya araç çıktılarını yanlış yorumlayabilir
- Durum bozulması: Ajan belleğinde saklanan halüsinasyonlu bilgiler gelecekteki akıl yürütme adımlarını etkiler
- Atıf karmaşıklığı: Halüsinasyonun hangi adımda ortaya çıktığını belirlemek uçtan uca izleme gerektirir
Ajan tabanlı sistemler için tespit yaklaşımları:
- Adım düzeyinde doğrulama: Ajan bir sonraki eyleme geçmeden önce her ara çıktının doğrulanması
- Araç çıktısı doğrulaması: Araç yanıtlarının beklenen formatlarla ve bilinen kısıtlarla çapraz kontrol edilmesi
- Yörünge analizi: Akıl yürütmenin dayanaklı bilgiden nerede saptığını belirlemek için ajan kararlarının tam dizisinin incelenmesi
- Adımlar arası tutarlılık kontrolleri: Çelişkileri tespit etmek için farklı aşamalarda yapılan iddiaların karşılaştırılması
W&B Weave'in HallucinationFree Scorer'ı ve Arize Phoenix'in HallucinationEvaluator'ı her ajan adımında uygulanabilir; entegre panoları ise kök neden analizi için tam yürütme izini görüntüler.
 Tercih edilen kaynak olarak ekle
Gerçek zamanlı halüsinasyon önleme
Üretim sonrası tespit sorunları ortaya çıkarır ancak kötü çıktıların kullanıcılara ulaşmasını durdurmaz. Gerçek zamanlı önleme, kontrolü yanıt iletilmeden önce satır içi olarak çalıştırır.
Önleme mekanizmaları:
- Çıktı korumaları: Üretilen içeriği kullanıcıya döndürmeden önce olgusallık kriterlerine göre analiz eden filtreler.
- Güven eşikleri: Modelin iç güveni kabul edilebilir düzeylerin altına düştüğünde yanıtları engelleme veya işaretleme.
- Geri getirme doğrulama kapıları: Yanıt sonlandırılmadan önce üretilen iddiaların getirilen belgeler tarafından desteklendiğinin doğrulanması.
- Yedek stratejiler: Halüsinasyon riski yüksek olduğunda güvenli bir varsayılan yanıt döndürme veya inceleme kuyruklarına yönlendirme.
Gerçek zamanlı önleme için araç yetenekleri:
- W&B Weave, halüsinasyon puanlamasını üretim pipeline'larına entegre ederek yanıtlar sunulmadan önce otomatik kontroller sağlar.
- Arize Phoenix, yüksek riskli çıktıları anında inceleme için işaretleyen uyarı yetenekleriyle gerçek zamanlı izleme sağlar.
- Comet Opik, ekiplerin halüsinasyon eşiklerini aşan yanıtları engelleyen kalite kapıları belirlemesine olanak tanıyan otomatik değerlendirmeli deney izleme sunar.
Halüsinasyon tespitine yaklaşımlar
Üç yaklaşım Weave, Phoenix ve Opik'in çalışma şekliyle doğrudan ilgilidir:
1. Tutarlılık tabanlı yöntemler
Tutarlılık tabanlı yöntemler, bir cevabı semantik benzerlik, n-gram örtüşmesi veya soru-cevap doğrulaması kullanarak birkaç alternatif üretimle karşılaştırarak değerlendirir. Yanıtlar birbiriyle çeliştiğinde veya mantıksal tutarsızlıklar içerdiğinde halüsinasyon olasılığı artar. İlgili bir teknik olan semantik entropi, yanıtları ifadeye göre değil anlama göre kümeler ve kavramsal istikrarsızlığı halüsinasyon sinyali olarak kullanır.
2. Olasılık ve güven tabanlı tespit
Token düzeyindeki olasılıklar, entropi değerleri, kalibrasyon eğrileri ve marj tabanlı güven tahminleri, modelin kendi çıktısı hakkındaki iç inancını ortaya çıkarır. Düşük güvenli bölümler genellikle daha yüksek halüsinasyon oranlarıyla ilişkilidir. Ham entropi değişken ifadeler nedeniyle yanıltıcı olabilir; ancak güven sinyalleri tutarlılık tabanlı göstergelerle birleştirildiğinde faydalı kalır. Arize Phoenix, etiketinin yanında bir güven skoru sunar; bu da bu kategoriye uyar.
3. Referans veya bağlam tabanlı tespit
Referans tabanlı değerlendirme, modelin çıktısını sağlanan bağlam veya harici kaynaklarla karşılaştırır ve RAG kalite kontrollerinin arkasındaki temel mekanizmadır. Tipik teknikler arasında, getirilen belgelerin cevabı destekleyip desteklemediğini kontrol eden entailment modelleri, kanıt desteğini doğrulayan hizalama ve dayanaklandırma yöntemleri ve iddiaların destekleyici metinle eşleşip eşleşmediğini ölçen olgusallık metrikleri bulunur. Benchmark edilen üç araç da öncelikle bu modda çalışır: bir bağlam girdisi alır ve çıktının bu bağlam içinde kalıp kalmadığını yargılarlar.
Yapay zeka halüsinasyon tespit teknikleri ve algoritmaları
Tespit yöntemleri üç ayrıntı düzeyinde çalışır:
- Token düzeyi: Bir çıktının içindeki şüpheli bölümleri işaretler. İnsan tarafından etiketlenmiş halüsinasyon dataset'lerini, bağlam verildiğinde önceki ve sonraki token olasılıkları arasındaki farkı veya dizi etiketleme sınıflandırıcılarını kullanır.
- Cümle düzeyi: Tüm ifadeleri yargılar. Örnekleme tabanlı öz tutarlılık kontrolleri birden çok üretimi istikrarsızlık açısından karşılaştırır; semantik entropi, etiketler olmadan kavramsal belirsizliği işaretler; entailment sınıflandırıcıları desteklenmeyen veya çelişkili iddiaları yakalar.
- İş akışı düzeyi: Kaynak grafikleri, adım düzeyinde entailment kontrolleri, ara akıl yürütme doğrulaması ve çok atlamalı görevler için bağımlılık izleme kullanarak çok adımlı pipeline'ları izler.
Benchmark ettiğimiz üç araç öncelikle cümle düzeyinde çalışır; Weave ve Phoenix, izleme panoları aracılığıyla iş akışı düzeyinde kullanıma da uzanır.
Endüstriyel örüntüler ve en iyi uygulamalar
Üretim ekipleri nadiren tek bir yönteme güvenir. Yaygın örüntüler şunlardır:
- Katmanlı tespit: Tutarlılık kontrolleri, olasılık puanlaması ve entailment doğrulaması aynı pipeline içinde çalışır.
- Gerçek zamanlı izleme: Panolar zaman içindeki sapmayı ve güven değişimlerini izler.
- Prompt ayarlama: Prompt'lar, dayanaksız çıktılara yol açan belirsizliği azaltmak için iyileştirilir.
- Uzman incelemesi: Hataların gerçek maliyet taşıdığı hukuki, tıbbi veya finansal içerikler için ayrılmıştır.
- CI/CD entegrasyonu: Otomatik kalite kontrolleri dağıtımdan önce çalışır; böylece regresyonlar erken ortaya çıkar.
- Ajan izleme: Eklentiler, anormallikleri ortaya çıkar çıkmaz yakalamak için araç çağrılarını ve ara akıl yürütme adımlarını gözlemler.
Yapay zeka halüsinasyon tespit araçları benchmark metodolojisi
Benchmark, olgusal soru-cevap senaryolarından alınan 50 bilgi öğesinden oluşan kontrollü bir dataset kullandı. Her öğe bir kaynak bağlam, bir soru, bu bağlama dayanan doğru bir yanıt ve uydurma bilgi içeren halüsinasyonlu bir yanıt içeriyordu. Örneğin bir test, The Oberoi Group'un genel merkezinin konumunu sordu; doğru yanıt “Delhi”, halüsinasyonlu yanıt “Mumbai” ile karşılaştırıldı.
Her bilgi öğesi iki test senaryosu üretti: biri doğru yanıtı kullandı (beklenen: halüsinasyon yok), diğeri halüsinasyonlu yanıtı kullandı (beklenen: halüsinasyon tespit edildi). Bu, toplam 100 test senaryosuna denk gelen dengeli bir 50/50 bölünme oluşturdu. Üç aracın tümü aynı test senaryolarını sırayla işledi; her biri aynı girdileri (bağlam, soru ve çıktı) aldı.
Adil bir karşılaştırma sağlamak için her test senaryosunun gecikmesini ayrı ayrı ölçtük; sonuçları çarpıtabilecek paralel işleme veya toplu değerlendirme tuzaklarından kaçındık. Doğru pozitifleri, yanlış pozitifleri, doğru negatifleri ve yanlış negatifleri hesaplamada doğruluğu sağlamak için ground truth etiketleri manuel olarak doğrulandı.
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{Yapay Zeka Halüsinasyon Tespit Araçları: W&B Weave ve Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Erişim tarihi: 18 Haziran 2026}
}12 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 4 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
3 güncellemeKıyaslanan halüsinasyon tespit araçlarının yanına yeni araç bölümleri olarak Galileo Luna-2 ve DeepEval eklendi.
“Hallucination detection in agentic workflows” başlığı, “What is AI hallucination?” bölümüne eklendi.
Referans Linkleri
Daha önce proje yönetimi ve danışmanlık firmalarında işe alım uzmanı olarak çalıştı. Sıla, Sosyal Psikoloji alanında yüksek lisans derecesine ve Uluslararası İlişkiler alanında lisans derecesine sahiptir.







Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.