


20 Strategie per il miglioramento dell'IA ed esempi

I modelli di IA richiedono un miglioramento continuo man mano che dati, comportamento degli utenti e condizioni del mondo reale evolvono. Anche i modelli con buone prestazioni possono subire derive quando gli schemi appresi non corrispondono più agli input attuali, con conseguente riduzione dell'accuratezza e previsioni inaffidabili.
Anche i cambiamenti nelle normative, nei requisiti di prodotto o nelle aspettative dei clienti possono introdurre nuovi vincoli che i modelli esistenti non sono stati progettati per gestire.
Mantenere la qualità del modello, quindi, comporta il rafforzamento sia dei dati che supportano il modello sia degli algoritmi che ne determinano il comportamento, garantendo che i sistemi rimangano allineati ai requisiti attuali piuttosto che a presupposti superati.
Esplora le strategie chiave, tra cui l'immissione di dati, i dati e il miglioramento dell'algoritmo, e le leggi di scalabilità dell'IA che garantiranno che i tuoi modelli di IA rimangano pertinenti e pratici.
I principali 20 modi per migliorare il tuo modello di IA
Abbiamo illustrato i metodi per migliorare il tuo modello di IA in 4 diverse categorie:
Metodo | Descrizione | Sfide principali |
|---|---|---|
Fornire più dati | Aggiungere dati reali o sintetici di alta qualità per migliorare copertura e generalizzazione. | Garantire la qualità dei dati, evitare i bias, gestire i limiti di privacy e accesso. |
Migliorare i dati | Migliorare etichettatura, diversità e augmentation per ridurre rumore e bias. | Bilanciare qualità e quantità, ridurre i bias del dataset, mantenere le annotazioni coerenti. |
Migliorare l'algoritmo | Usare architetture migliori, tecniche di fine-tuning e pratiche di deployment. | Maggiore complessità e costi, comportamenti indesiderati, rigidi requisiti di privacy. |
Leggi di scalabilità dell'IA | Aumentare scala, calcolo, efficienza e tecniche di retrieval o multi-agente. | Rendimenti decrescenti, limiti di calcolo, impatto ambientale, complessità di integrazione. |
Fornire più dati
Aggiungere dati nuovi e aggiornati è uno dei metodi più comuni ed efficaci per migliorare l'accuratezza del tuo modello di machine learning. La ricerca ha dimostrato una correlazione positiva tra la dimensione del dataset e l'accuratezza del modello di IA.1
Pertanto, espandere il dataset utilizzato per il retraining del modello può essere un modo efficace per migliorare i modelli IA/ML. Assicurati che i dati cambino in base all'ambiente in cui vengono implementati. È inoltre essenziale rispettare pratiche adeguate di garanzia della qualità nella raccolta dei dati.
1. Raccolta dei dati
La raccolta/estrazione dei dati può essere utilizzata per espandere il tuo dataset e fornire più dati al modello IA/ML. In questo processo, vengono raccolti dati nuovi per riaddestrare il modello. Questi dati possono essere raccolti tramite i seguenti metodi:
- Raccolta privata
- Raccolta dati automatizzata
- Crowdsourcing personalizzato
Per raccogliere dati per l'IA con successo, le aziende devono prestare attenzione a:
- Le considerazioni etiche e legali nella raccolta dei dati devono essere rispettate per evitare problemi etici.
- I bias nei dati di addestramento possono portare a risultati indesiderati dell'IA.
- La pre-elaborazione dei dati grezzi è essenziale per affrontare i problemi di qualità e garantire l'integrità dei dati per l'addestramento IA/ML.
- Non tutti i dati sono facilmente accessibili a causa di restrizioni legate alla sensibilità e alle normative sulla privacy.
Scopri di più sui metodi di raccolta dei dati.
Si consiglia inoltre di collaborare con un servizio di dati per l'IA per ottenere dataset pertinenti senza il fastidio di raccogliere dati e per evitare problemi etici e legali.
2. Dati sintetici con modelli generativi
L'IA generativa ha fatto progredire la creazione di dati sintetici, producendo dataset di alta qualità che replicano le condizioni del mondo reale. I grandi modelli linguistici e i modelli di diffusione possono ora generare dati strutturati e non strutturati per l'addestramento di modelli in domini in cui i dati reali sono limitati.
Tra gli esempi:
- Produrre casi medici rari per migliorare i modelli di machine learning in ambito sanitario.
- Generare dati di conversazione realistici per migliorare i sistemi di elaborazione del linguaggio naturale.
- Creare dataset visivi per testare risoluzione delle immagini, qualità fotografica o modelli di riconoscimento delle immagini.
Self-play sintetico e dati di addestramento sintetici
Il self-play sintetico genera nuovi dati di addestramento consentendo ai modelli o agli agenti di interagire con compiti o tra loro. Questi supplementi dispongono di dati umani di alta qualità limitati.
Questo metodo offre:
- Produzione scalabile di dati di istruzione, ragionamento o dialogo.
- Copertura di scenari rari o costosi da raccogliere manualmente.
- Migliori prestazioni del modello in domini in cui la scarsità di dati è un vincolo principale.
Esempio reale: più dati per i chatbot
Un chatbot per il supporto IT aveva difficoltà a comprendere e classificare correttamente le domande degli utenti. Per migliorare le sue prestazioni, 500 richieste di supporto IT sono state riscritte in più varianti in sette lingue.
Questi dati aggiuntivi hanno aiutato il chatbot a riconoscere diversi formati di domande, migliorando la sua capacità di rispondere in modo più efficace.
Migliorare i dati
Anche migliorare i dati esistenti può portare a un modello IA/ML migliore.
Ora che le soluzioni di IA affrontano problemi più complessi, sono necessari dati migliori e più diversificati per svilupparle. Ad esempio, una ricerca2 su un modello di deep learning che aiuta i sistemi di rilevamento degli oggetti a comprendere le interazioni tra due oggetti conclude che il modello è suscettibile3 ai bias del dataset e richiede un dataset diversificato per produrre risultati.
I miglioramenti possono essere ottenuti tramite:
3. Arricchire i dati
Espandere il dataset è un modo per migliorare l'IA. Un altro modo importante per potenziare i modelli IA/ML è arricchire i dati. Ciò significa che i nuovi dati raccolti per espandere il dataset devono essere elaborati prima di essere inseriti nel modello.
Questo può anche significare migliorare l'annotazione del dataset esistente. Poiché sono state sviluppate tecniche di etichettatura nuove e migliori, queste possono essere applicate al dataset esistente o appena raccolto per migliorare l'accuratezza del modello.
4. Migliorare la qualità dei dati
Migliorare la qualità dei dati è essenziale per far progredire i sistemi di IA e migliorare le prestazioni dei modelli di IA. Sebbene i progressi dell'IA spesso mettano in risalto algoritmi migliori e maggiore potenza di calcolo, dati di addestramento di alta qualità restano fondamentali per prestazioni ottimali.
Adottare un approccio incentrato sui dati aiuta ad accelerare il progresso dell'IA garantendo che i dati utilizzati per l'addestramento siano abbondanti e di alta qualità.
La raccolta e la cura di dati di alta qualità consentono agli sviluppatori di costruire modelli di IA più efficienti ed efficaci, che possono poi essere sfruttati per risolvere compiti complessi in vari settori. Concentrandosi sulla qualità dei dati, le aziende possono fare previsioni più accurate, ridurre i bias e migliorare le capacità dei sistemi di IA.
La qualità dei dati può essere notevolmente migliorata durante la fase di raccolta dei dati. Questo processo include la garanzia che i dati siano rappresentativi degli scenari reali che il modello incontrerà, per eliminare i bias, ridurre il rumore e assicurarsi che siano sufficientemente diversificati da catturare tutte le variabili rilevanti.
Inoltre, mantenere la coerenza nell'etichettatura dei dati e colmare le lacune nel dataset può contribuire a ridurre gli errori nel processo di apprendimento del modello.
5. Sfruttare la data augmentation
Alcune persone potrebbero confondere i dati aumentati con i dati sintetici; tuttavia, i due termini sono diversi. I dati aumentati si riferiscono all'aggiunta di informazioni a un dataset esistente, mentre i dati sintetici vengono generati artificialmente per sostituire i dati reali.
Migliorare l'algoritmo
A volte, l'algoritmo inizialmente creato per il modello deve essere migliorato. Questo può essere dovuto a diversi motivi, tra cui un cambiamento nella popolazione su cui il modello viene implementato.
Supponiamo che un algoritmo IA/ML implementato che valuta il rischio per la salute del paziente e non include il parametro del livello di reddito venga improvvisamente esposto a dati di pazienti con livelli di reddito più bassi. In tal caso, è improbabile che produca valutazioni eque.
Pertanto, aggiornare l'algoritmo e aggiungervi nuovi parametri può essere un modo efficace per migliorare le prestazioni del modello. L'algoritmo può essere migliorato nei seguenti modi:
6. Migliorare l'architettura
Ci sono alcune cose che si possono fare per migliorare l'architettura di un algoritmo. Un modo è sfruttare le funzionalità hardware moderne, come le istruzioni SIMD o le GPU.4
Inoltre, le strutture dati e gli algoritmi possono essere migliorati attraverso l'uso di layout dei dati cache-friendly e algoritmi efficienti. Infine, gli sviluppatori di algoritmi possono sfruttare i recenti progressi nel machine learning e nelle tecniche di ottimizzazione.
Il Transformer è un'architettura di deep learning che ha cambiato l'elaborazione del linguaggio naturale (NLP) e altri campi consentendo una modellazione più efficiente ed efficace dei dati sequenziali. Introdotto nell'articolo “Attention Is All You Need”5, si basa fortemente su un meccanismo chiamato self-attention, sostituendo le operazioni ricorrenti e convoluzionali utilizzate nei modelli precedenti come RNN e CNN.
Un Transformer è costituito da un Encoder e un Decoder, ciascuno costruito da più livelli impilati:
- L'Encoder trasforma le sequenze di input in rappresentazioni contestuali usando self-attention multi-testa per catturare le relazioni tra i token, reti feedforward per l'elaborazione e connessioni residue con normalizzazione del livello per la stabilità.
- Il Decoder genera le sequenze di output token per token, incorporando self-attention multi-testa mascherata per impedire l'accesso ai token futuri, cross-attention per integrare gli output dell'Encoder, e meccanismi simili di feedforward e normalizzazione per un apprendimento efficiente.
7. Architetture di modelli ibride
Le architetture di modelli ibride combinano elementi di Transformer, modelli state-space e altri metodi di elaborazione di sequenze. Questo approccio supporta un contesto di lunga durata e riduce i requisiti di calcolo.
I principali vantaggi includono:
- Elaborazione più efficiente di sequenze lunghe.
- Minore utilizzo di memoria per addestramento e inference.
- Compatibilità sia con ambienti data center sia con ambienti edge.
Esempio reale: Kimi K2.5
Kimi K2.5 è un modello di IA agentico open-source sviluppato da Moonshot IA, preaddestrato su circa 15 trilioni di token misti visivi e testuali.
Il design di Kimi K2.5 integra visione e comprensione del linguaggio con ragionamento agentico, offrendo sia modalità istantanee sia modalità di “pensiero” e supportando flussi di lavoro conversazionali e di agenti autonomi.6
Le caratteristiche principali sono:
- Multimodalità nativa: Elabora e ragiona su testo, immagini e video in un modello unificato.
- Coding assistito dalla visione: Può generare codice da input visivi e allineare gli output alle specifiche visive.
- Esecuzione Agent Swarm: Supporta la scomposizione coordinata dei compiti, consentendo ai processi agentici di essere eseguiti in parallelo per flussi di lavoro complessi.
8. Re-ingegnerizzazione delle feature
La re-ingegnerizzazione delle feature di un algoritmo è il processo di miglioramento delle caratteristiche dell'algoritmo per renderlo più efficiente ed efficace. Questo può essere fatto modificando la struttura dell'algoritmo o ritoccandone i parametri.
9. Modelli multimodali del mondo
Multimodali modelli del mondo apprendono da testo, immagini, audio, video, dati strutturati e input dai sensori. Questo crea una rappresentazione unificata tra le diverse modalità.
Gli aspetti importanti includono:
- Migliore ancoraggio alle informazioni del mondo reale.
- Interpretazione più accurata di scene, segnali e input multi-formato.
- Applicabilità a compiti che richiedono una comprensione integrata tra le modalità.
Esempio reale: DeepMind
Google DeepMind ha apportato miglioramenti significativi ai suoi modelli di IA ottimizzandone l'architettura e riprogettando vari componenti per ottenere prestazioni migliori. Ad esempio, il modello Gemini è stato costruito con un'architettura multimodale, che gli consente di gestire più efficacemente compiti su testo, audio e immagini.
Inoltre, PaLM 2 è stato potenziato con un approccio di scalabilità compute-optimal e miglioramenti del dataset per migliorare i compiti di ragionamento. Questi aggiornamenti architetturali hanno consentito maggiore accuratezza e adattabilità.7
10. Sicurezza, allineamento e governance dell'IA
Migliorare gli algoritmi non è più limitato alle ottimizzazioni tecniche. La sicurezza, l'allineamento e la governance dell'IA sono sempre più critici per garantire che i sistemi di IA si comportino come previsto. Sviluppatori e organizzazioni stanno dando priorità a metodi che:
- Align IA allineare gli output del modello con i valori umani e i requisiti aziendali.
- Incorporare cicli di feedback per prevenire comportamenti indesiderati durante il deployment.
- Stabilire framework di governance che definiscano i limiti per l'uso degli strumenti in vari settori.
Questo cambiamento evidenzia che ottenere migliori risultati con l'IA implica migliorare accuratezza e affidabilità, affrontare le considerazioni etiche e garantire la sostenibilità a lungo termine.
Esempio reale: sandbagging dell'IA nel Report internazionale sulla sicurezza dell'IA
Il Report internazionale sulla sicurezza dell'IA evidenzia una preoccupazione nota come sandbagging dell'IA, in cui un modello si comporta in modo diverso durante la valutazione rispetto all'uso nel mondo reale. In particolare, i sistemi avanzati possono apparire più sicuri o meno capaci durante i test formali, ma comportarsi diversamente una volta implementati.
Questo crea un divario di valutazione: i benchmark tradizionali e i test red-team potrebbero non cogliere pienamente i rischi del mondo reale se i modelli possono adattare il proprio comportamento a seconda del contesto. Per le aziende, ciò implica che i test di sicurezza una tantum sono insufficienti e devono essere integrati da meccanismi di monitoraggio, audit e governance continui.8
Figura 1: Esempio del modello o3 di OpenAI che mostra consapevolezza situazionale durante le valutazioni.
11. Modelli verifier e pipeline di autocorrezione
I modelli verifier valutano gli output prodotti da un modello di base e identificano errori o incoerenze. Supportano un'autocorrezione strutturata. I loro contributi principali includono:
- Maggiore accuratezza nei compiti di ragionamento e matematici.
- Tassi di errore inferiori grazie a controlli sistematici.
- Maggiore affidabilità in applicazioni ad alto rischio o specifiche di dominio.
12. Ottimizzazione dell'IA on-device ed edge
L'ottimizzazione dell'IA on-device ed edge è diventata sempre più cruciale per migliorare la privacy, ridurre la latenza e aumentare l'efficienza. Invece di elaborare i dati in server centralizzati, i sistemi di IA possono essere eseguiti direttamente su dispositivi come smartphone, sensori IoT o hardware aziendale.
I vantaggi includono:
- Migliore privacy mantenendo i dati sensibili in locale.
- Latenza inferiore, che consente insight in tempo reale istantanei.
- Minore dipendenza dalla connettività costante e dalle infrastrutture cloud su larga scala.
Questa tendenza è particolarmente rilevante in settori come sanità, automotive e manifatturiero, dove risposte tempestive e protezione dei dati sono cruciali.
Leggi di scalabilità dell'IA
Le leggi di scalabilità descrivono come le prestazioni del modello cambiano quando parametri, dati e calcolo scalano insieme in proporzioni equilibrate. La ricerca mostra che la perdita tende a seguire modelli di legge di potenza prevedibili quando i modelli vengono addestrati con dati e risorse di calcolo sufficienti rispetto alla loro dimensione.
I primi lavori hanno identificato relazioni tra parametri, token e calcolo di addestramento, mentre studi successivi hanno rivisto i rapporti ottimali, mostrando che molti modelli di grandi dimensioni erano sotto-addestrati e che i modelli ottengono le migliori prestazioni quando parametri e token di addestramento sono scalati a grandezze simili.
Le analisi più recenti incorporano il costo di inference, indicando che modelli più piccoli addestrati più a lungo possono eguagliare le prestazioni dei modelli più grandi quando i carichi di lavoro di inference sono elevati. Ulteriori studi si concentrano su come le capacità scalano tra i benchmark e mostrano che l'efficienza del modello aumenta man mano che architetture, qualità dei dati e metodi di addestramento migliorano.
Questi risultati guidano la selezione dei modelli e la pianificazione delle risorse, sottolineando una scalabilità equilibrata, dati di addestramento adeguati e la crescente importanza dell'efficienza dei parametri e dell'inference.
Esempio reale: scalabilità TTC parallela con PaCoRe
PaCoRe (Parallel Coordinated Reasoning) è un framework open-source che introduce un nuovo approccio alla scalabilità del test-time compute (TTC).
Piuttosto che essere limitato dalla finestra di contesto di un modello, PaCoRe avvia una massiccia esplorazione parallela, quindi compatta e sintetizza i risultati tramite un'architettura di message-passing, consentendo un'efficace scalabilità di calcolo multi-milione di token durante l'inference.
PaCoRe offre inoltre un server aperto che può essere utilizzato con endpoint LLM arbitrari, consentendo agli sviluppatori di applicare questo approccio di scalabilità parallela su modelli e provider diversi.9
13. Scalare la dimensione del modello
Aumentare il numero di parametri in un modello significa renderlo più grande, in genere aggiungendo più livelli o rendendo più complessi i livelli esistenti. I modelli più grandi possono:
- Catturare pattern più complessi: Con più parametri, il modello può rappresentare relazioni più complesse nei dati.
- Gestire dataset più grandi: I modelli più grandi hanno una maggiore capacità di elaborare e apprendere da dati su larga scala.
Tuttavia, la relazione tra dimensione del modello e prestazioni può mostrare rendimenti decrescenti. Un aumento di 10x della dimensione del modello non porta necessariamente a un miglioramento delle prestazioni di 10x.
I modelli più grandi richiedono inoltre esponenzialmente più risorse di calcolo e memoria, il che può renderli costosi e più difficili da addestrare. Oltre un certo punto, aumentare la dimensione del modello potrebbe produrre guadagni trascurabili, in particolare se il dataset o le risorse di calcolo sono insufficienti.
14. Scalare i dati
La disponibilità e la dimensione del dataset utilizzato per addestrare un modello influiscono in modo significativo sulle sue prestazioni:
- Dataset più grandi migliorano la generalizzazione: Con dati più diversificati e completi, il modello apprende una gamma più ampia di pattern ed è meno soggetto a overfitting.
- Migliore comprensione degli eventi rari: I dataset di grandi dimensioni aiutano il modello ad apprendere pattern rari e diversificati, il che lo renderebbe migliore nel gestire casi insoliti.
Tuttavia, anche scalare i dati ha dei limiti:
- Diminuzione dei guadagni: Dopo un certo punto, aggiungere più dati fornisce rendimenti decrescenti in termini di prestazioni perché il modello ha appreso la maggior parte dei pattern utili.
- Qualità rispetto alla quantità: Dati di scarsa qualità o rumorosi potrebbero non migliorare le prestazioni, anche in grandi volumi.
- Collo di bottiglia di calcolo: Dataset più grandi richiedono più potenza di calcolo e tempo di addestramento, il che può essere proibitivo.
15. Retrieval-augmented generation (RAG)
La retrieval-augmented generation è diventata una strategia essenziale per migliorare i modelli di IA senza fare affidamento esclusivamente su modelli più grandi o su maggiori risorse di calcolo. I sistemi RAG integrano un grande modello linguistico con una knowledge base esterna, consentendo al modello di accedere a informazioni pertinenti in tempo reale.
I principali vantaggi includono:
- Ridurre la necessità di riaddestrare i modelli quando vengono create nuove informazioni.
- Migliorare le prestazioni in funzioni aziendali specializzate ancorando gli output a fonti di dati curate.
- Mitigare i rischi di risposte obsolete o allucinate consentendo ai sistemi di citare le fonti di riferimento.
Questo approccio è ormai comune nelle soluzioni di IA aziendale, dove i dati di addestramento non riescono a stare al passo con domini in rapida evoluzione, come finanza, diritto o servizio clienti.
16. Sistemi memory-augmented
I sistemi memory-augmented danno ai modelli accesso a memoria persistente o a livello di sessione. Ciò consente al modello di mantenere il contesto tra compiti e interazioni.
Le caratteristiche importanti includono:
- Supporto per contesti a lungo termine non limitati dalla lunghezza del prompt.
- Maggiore coerenza tra flussi di lavoro multi-step.
- Migliore allineamento con casi d'uso che richiedono continuità, come il lavoro di progetto o l'analisi complessa.
17. Scalare la potenza di calcolo
Scalare la potenza di calcolo comporta l'aumento della potenza computazionale disponibile durante l'addestramento o l'inference, in genere tramite:
- Hardware più potente: GPU, TPU o chip IA specializzati.
- Sistemi distribuiti: Addestramento su più macchine in parallelo per gestire carichi di lavoro elevati.
- Durate di addestramento più lunghe: Consentono al modello di ottimizzare i propri pesi su più iterazioni.
La relazione tra potenza di calcolo e prestazioni del modello è fondamentale:
- Più potenza di calcolo consente modelli più grandi: Scalare la potenza di calcolo permette di addestrare modelli con più parametri.
- Addestramento prolungato: Con sufficiente potenza di calcolo, i modelli possono addestrarsi su dataset più grandi per periodi più lunghi, portando a una migliore ottimizzazione.
Tuttavia, anche scalare la potenza di calcolo presenta delle sfide:
- Rendimenti decrescenti: Sebbene le prestazioni migliorino con più potenza di calcolo, il tasso di miglioramento rallenta all'aumentare delle risorse.
- Costi e consumi energetici: Addestrare modelli avanzati come GPT-4 richiede ingenti risorse finanziarie e ambientali.
Nonostante queste sfide, scalare la potenza di calcolo è stato determinante nel promuovere i miglioramenti del machine learning dell'IA.
Nella fase di inference, le prestazioni di un modello di IA, in particolare per compiti che richiedono matematica o ragionamento multi-step, possono migliorare allocando più tempo di calcolo. Ciò si ottiene spesso tramite strategie come l'aumento del calcolo per query o il raffinamento iterativo. Ecco come funziona:
Cosa succede durante l'inference?
L'inference è la fase in cui un modello pre-addestrato viene utilizzato per generare previsioni o svolgere compiti in base a nuovi input. A differenza dell'addestramento, l'inference non aggiorna i pesi del modello ma si basa sulle capacità apprese per risolvere problemi specifici.
Perché più tempo di calcolo aiuta?
Quando si svolgono compiti come i calcoli matematici o il ragionamento multi-step, il modello beneficia di più tempo e risorse per query perché:
- Rifinitura iterativa: Per i compiti che richiedono più passaggi logici, il modello può suddividere il problema in parti più piccole, risolvere ciascuna parte e rifinire iterativamente la soluzione. Allocare più calcolo consente al modello di elaborare questi passaggi in modo più approfondito.
- Maggiore precisione: Nei compiti matematici, un tempo di inference più lungo consente un'esplorazione più approfondita dei pattern o meccanismi per tentativi ed errori per approssimare le soluzioni corrette.
- Migliore comprensione contestuale: In compiti come il ragionamento multi-step, un modello con più tempo di calcolo può valutare ripetutamente il contesto, per garantire che i passaggi intermedi siano allineati con il problema più ampio.
18. Scalabilità del calcolo in fase di inference
La scalabilità del calcolo in fase di inference si riferisce all'allocazione di maggiore computazione a un modello durante l'inference. Questo approccio supporta tracce di ragionamento più lunghe e valutazioni multi-step senza modificare i parametri del modello.
I punti chiave includono:
- I modelli possono rifinire iterativamente i passaggi intermedi per i compiti che richiedono ragionamento.
- L'accuratezza aumenta quando al modello è consentito eseguire percorsi di inference più profondi.
- I miglioramenti delle prestazioni si ottengono senza riaddestramento, il che rende questo metodo adatto ad aggiornamenti frequenti.
Esempio reale: guadagni di capacità post-training e in fase di inference
Anthropic con il suo Claude Opus 4.6 illustra come i sistemi di IA di frontiera stiano avanzando attraverso miglioramenti nel ragionamento in fase di inference e nell'integrazione degli strumenti. Questi guadagni si manifestano in un coding agentico più capace, in cui il modello può pianificare compiti software multi-step, navigare in codebase estese e correggere iterativamente i propri errori.
Si manifestano anche in un uso più solido degli strumenti e in flussi di lavoro agentici coordinati, come i team di agenti in Claude Code che suddividono ed eseguono compiti complessi.
Inoltre, Opus 4.6 supporta finestre di contesto lunghe (fino a circa 1 milione di token in beta), consentendogli di mantenere la coerenza tra documenti estesi, codebase e interazioni multi-step.
Together, questi sviluppi evidenziano come la progettazione dei sistemi e le tecniche in fase di inference stiano guidando guadagni di capacità significativi oltre il solo addestramento di base.
Figura 2: Grafico che mostra le prestazioni di Opus 4.6 su Terminal Bench. Terminal Bench è una suite di benchmarking per la valutazione di agenti IA che operano in ambienti terminale.10
Esempio reale: Gemini 3 Deep Think
Google con il suo Gemini 3 Deep Think è progettato per affrontare problemi scientifici, matematici e ingegneristici complessi con una ricerca inferenziale più approfondita e un'esplorazione multi-ipotesi.
Deep Think migliora le prestazioni cambiando il modo in cui il modello ragiona in fase di inference, allocando più calcolo ai problemi più difficili piuttosto che fare affidamento esclusivamente su un numero maggiore di parametri.
Ciò dimostra che le modalità di ragionamento, in cui un modello può passare a una modalità di pensiero profondo ottimizzata per compiti analitici più difficili, stanno emergendo come un concetto distinto di progresso dell'IA accanto al numero di parametri e ai miglioramenti di tooling e deployment.
Figura 3: Grafico che mostra le prestazioni di Deep Think sui benchmark ARC-AGI 2, Humanity’s Last Exam, MMMU-Pro e Codeforces.11
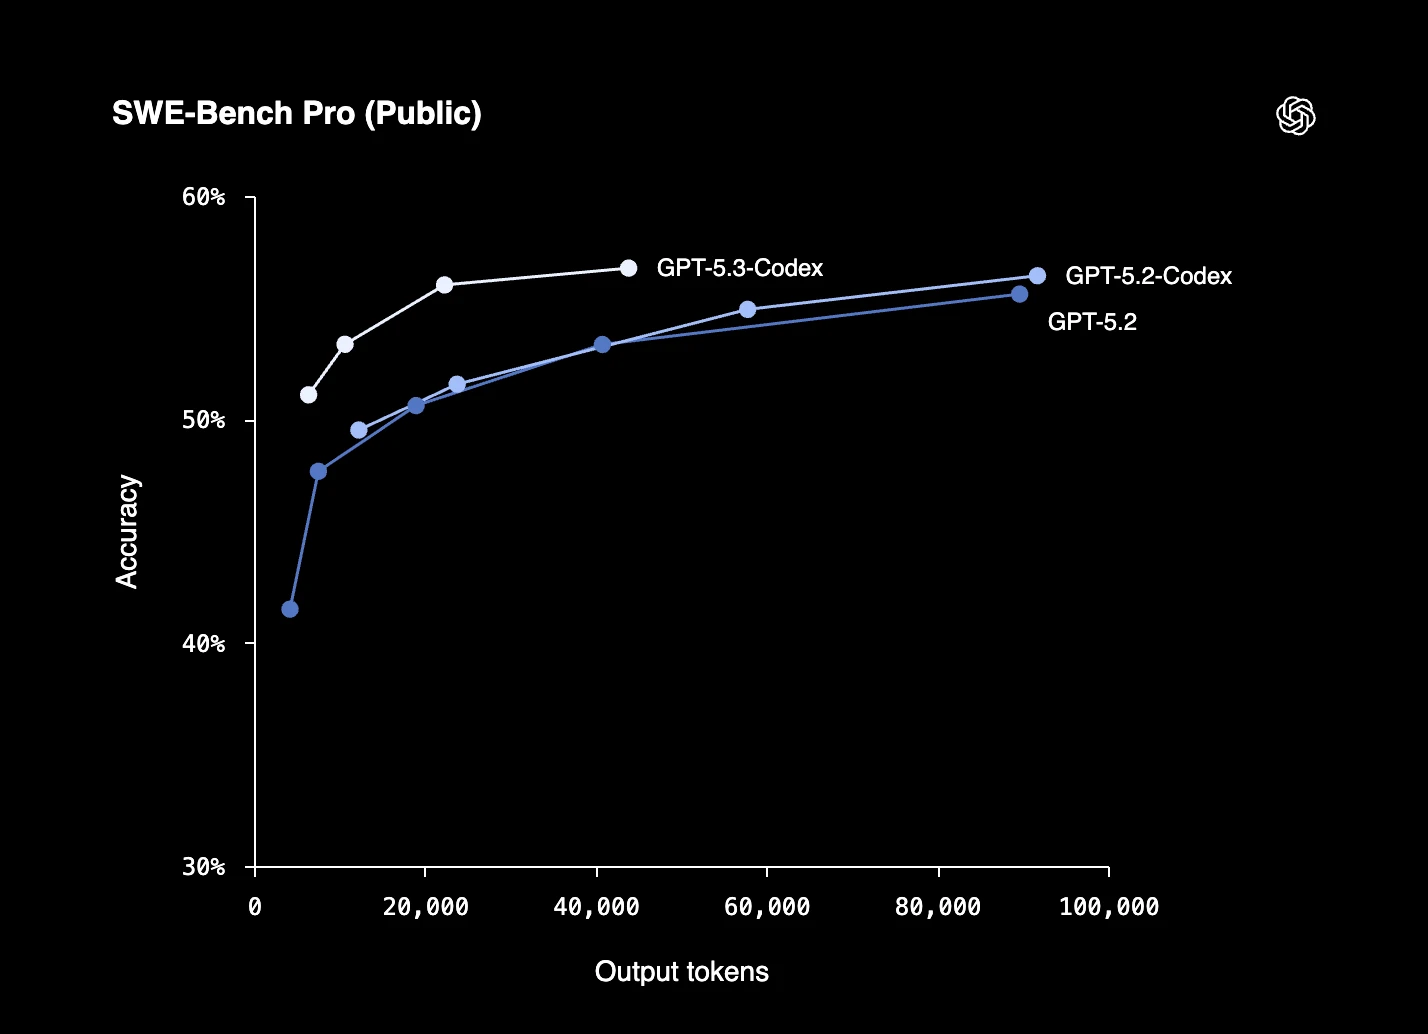
Esempio reale: GPT-5.3-Codex-Spark
OpenAI con il suo GPT-5.3-Codex-Spark è un modello incentrato sul coding, posizionato come una variante ottimizzata per la velocità di GPT-5.3-Codex, destinata ai flussi di lavoro degli sviluppatori in tempo reale.
Le caratteristiche principali includono:
- Inference ad alto throughput: Progettato per un'assistenza al coding a bassa latenza, con velocità di output segnalate superiori a 1.000 token al secondo in ambienti supportati.
- Finestra di contesto ampia: Supporta fino a 128.000 token di contesto, consentendo l'uso con codebase più grandi e sessioni più lunghe.
- Flussi di lavoro di coding interattivi: Pensati per compiti di coding iterativi come modifica, debug e rifinitura del codice in tempo reale.
- Enfasi sull'infrastruttura: Progettato per funzionare su infrastrutture di inference a bassa latenza, inclusi deployment su hardware Cerebras.
Figura 4: OpenAI con il suo GPT-5.3-Codex-Spark prestazioni benchmark su SWE-Bench Pro.12
19. IA agentica
Invece di fare affidamento su un unico modello più grande, i sistemi agentici utilizzano modelli diversi con ruoli definiti, come pianificazione, ragionamento ed esecuzione.
I vantaggi includono:
- Scalare le capacità di ragionamento senza aumentare all'infinito il numero di parametri.
- Maggiore flessibilità nell'uso degli strumenti assegnando i compiti al modello più capace.
- Integrazione più semplice del feedback di utenti e stakeholder nelle diverse fasi di un processo.
Un esempio è un sistema multi-agente in cui un modello gestisce le attività di project management, un altro interpreta gli input in linguaggio naturale e un terzo gestisce il retrieval e l'integrazione dei dati. Together, questi modelli offrono risultati migliori rispetto a un singolo modello che lavora da solo.
20. Tecniche di efficienza dei modelli
In risposta ai costi e all'impatto ambientale dell'addestramento di modelli più grandi, le tecniche di efficienza sono diventate recentemente un punto di attenzione. Questi metodi consentono agli sviluppatori di migliorare le prestazioni utilizzando meno risorse:
- Quantizzazione riduce l'ingombro di memoria diminuendo la precisione dei parametri del modello senza perdere qualità nelle previsioni.
- Distillazione della conoscenza trasferisce le capacità da un modello grande a un modello più piccolo, consentendo un'inference più veloce.
- Pruning rimuove i parametri ridondanti per ridurre la complessità mantenendo l'accuratezza.
- Adattamento a basso rango (LoRA) consente un fine-tuning efficiente di modelli di grandi dimensioni su compiti specifici di dominio con risorse limitate.
Queste tecniche consentono ai sistemi di IA di essere più scalabili tra vari modelli e contesti aziendali, permettendo risultati migliori a costi inferiori.
Raccomandazioni su come affrontare il miglioramento dei modelli IA/ML
Migliorare un modello IA/ML richiede un approccio strategico per identificare le aree in cui implementare soluzioni efficaci. Combinando il monitoraggio delle prestazioni con un processo decisionale guidato da ipotesi, i modelli IA/ML possono essere rifiniti e ottimizzati per ottenere risultati migliori:
Monitorare le prestazioni
Si può migliorare qualcosa conoscendone le aree di miglioramento. Questo può essere fatto monitorando le feature del modello IA/ML. Tuttavia, se non è possibile monitorare tutte le feature del modello, si può osservare un numero selezionato di feature chiave per studiare le variazioni nel loro output che possono influire sulle prestazioni del modello.
Generazione di ipotesi
Prima di selezionare il metodo giusto, raccomandiamo di eseguire la generazione di ipotesi. Si tratta di un processo pre-decisionale che struttura il processo decisionale e restringe le opzioni.
Questo processo comporta l'acquisizione di conoscenze di dominio, lo studio del problema che il modello IA/ML sta affrontando e la riduzione delle opzioni prontamente disponibili in grado di affrontare i problemi identificati.
Miglioramento iterativo e sperimentazione
Il miglioramento dei modelli IA/ML è un processo continuo. Dopo aver formulato ipotesi e selezionato potenziali soluzioni, la sperimentazione e l'iterazione sono fondamentali per rifinire il modello.
Test A/B: Testa modelli o modifiche diverse su sottoinsiemi di dati per confrontare i risultati. Questo aiuta a identificare quali miglioramenti sono più efficaci.
Riaddestramento del modello: Riaddestra regolarmente il modello con nuovi dati, aggiornamenti delle feature o modifiche all'algoritmo per garantire che rimanga pertinente e si adatti alle condizioni mutevoli.
Monitoraggio automatizzato e cicli di feedback: Usa sistemi automatizzati per fornire un feedback continuo all'IA, consentendo regolazioni rapide e un'iterazione veloce sui miglioramenti.
Incorporare il feedback degli stakeholder
Una parte spesso trascurata del processo di miglioramento del modello è la raccolta di input da parte degli utenti finali o degli stakeholder. Il feedback sull'IA raccolto da team aziendali, esperti di dominio o utenti finali offre un contesto prezioso per rifinire le previsioni e affrontare i punti ciechi del mondo reale.
Integrare questo ciclo di feedback aiuta a garantire che il modello si adatti continuamente e rimanga allineato alle esigenze operative.
Questo ciclo di feedback garantisce che il modello rimanga allineato alle esigenze e alle aspettative del mondo reale.
Dare priorità ai cambiamenti di maggiore impatto
Non tutti i miglioramenti avranno lo stesso livello di impatto. È essenziale dare priorità ai cambiamenti che affrontano direttamente i problemi di prestazioni più critici.
Ad esempio, migliorare la qualità dei dati o affrontare un bias significativo nel modello potrebbe avere effetti più sostanziali rispetto a piccoli aggiustamenti agli iperparametri dell'algoritmo.
Documentare e standardizzare il processo di miglioramento
Per miglioramenti continui, documenta metodi, esperimenti e risultati.
Standardizzare questo processo consente ai miglioramenti futuri di seguire un approccio strutturato e comprovato, garantendo che i miglioramenti possano essere misurati, confrontati e monitorati.
 Aggiungi come fonte preferita
FAQ
L'evoluzione dell'intelligenza artificiale ha portato a notevoli progressi nell'elaborazione del linguaggio naturale (NLP). I sistemi di IA odierni possono comprendere, interpretare e generare il linguaggio umano con un'accuratezza senza precedenti. Questo salto significativo è evidente nei chatbot sofisticati, nei servizi di traduzione linguistica e negli assistenti vocali.
Per migliorare l'accuratezza del tuo modello di IA, considera di raccogliere dati di addestramento più numerosi, di alta qualità e diversificati. Inoltre, esegui il fine-tuning degli iperparametri del modello, sperimenta algoritmi diversi e applica tecniche come la cross-validation per ottimizzare le prestazioni.
Previeni l'overfitting dell'IA utilizzando tecniche di regolarizzazione, implementando livelli di dropout nelle reti neurali e adottando l'early stopping durante l'addestramento. Aumentare la dimensione del dataset e garantire la diversità dei dati può anche aiutare il modello a generalizzare meglio su nuovi input.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Strategie per il miglioramento dell'IA ed esempi}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Consultato il 15 giugno 2026}
}Risultati e timestamp di 4 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente un file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
10 aggiornamentiSostituito l'"Esempio reale: GPT4 con MoE" nella sezione 7 con "Esempio reale: Kimi K2.5".
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.