


AI Veri Kalitesi: Zorluklar ve En İyi Uygulamalar

Kötü veri kalitesi, yapay zeka ve ML projelerinin başarılı bir şekilde devreye alınmasını geciktirir. 1 En gelişmiş yapay zeka algoritmaları bile temel veriler düşük kaliteli olduğunda hatalı sonuçlar üretebilir.
Yapay zekada veri kalitesinin önemini, kuruluşların karşılaştığı zorlukları ve yüksek kaliteli veri sağlamaya yönelik en iyi uygulamaları keşfedin:
Yapay zekada veri kalitesinin önemi nedir?
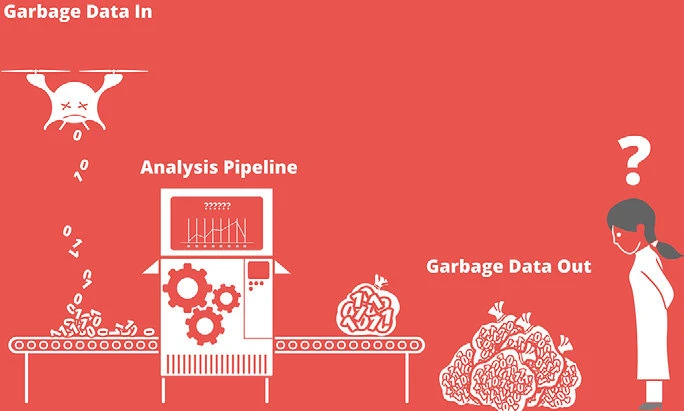
Veri kalitesi, yapay zeka model'lerinin performansını, doğruluğunu ve güvenilirliğini doğrudan etkilediği için yapay zeka açısından temel öneme sahiptir. Yüksek kaliteli veriler, model'lerin daha iyi tahminler yapmasını ve daha güvenilir sonuçlar üretmesini sağlar. Yapay zekadaki düşük veri kalitesinin etkisi Şekil 1'de gösterilmektedir.
Şekil 1: Düşük kaliteli veri ve analitiğin etkisi
Kaynak: SnapLogic2
Veri yanlılıklarının ele alınması, veri kalitesinin sağlanması açısından çok önemlidir. Bu, yapay zeka tarafından üretilen çıktılarda önyargıların sürdürülmesini ve güçlendirilmesini önler ve belirli gruplara veya bireylere yönelik adil olmayan muamelenin en aza indirilmesine yardımcı olur.
Ayrıca, çeşitli ve temsil gücü yüksek bir dataset, bir AI modelinin farklı durumlar ve girdiler genelinde iyi genelleme yapma yeteneğini artırır; çeşitli bağlamlar ve kullanıcı grupları arasında performansını ve uygunluğunu güvence altına alır.
Stanford University'de AI Profesörü ve DeepLearning.AI'nin kurucusu Andrew Ng'in belirttiği gibi, “İşimizin yüzde 80'i veri hazırlama ise, veri kalitesini sağlamak bir makine öğrenimi ekibi için en kritik görevdir.”
Veri kalitesi için 'çöp girerse çöp çıkar' sorunundan kaçınmak neden kritik öneme sahiptir?
“Çöp girerse, çöp çıkar” (GIGO), veri kalitesinde girdi kalitesinin önemini vurgulayan basit ama etkili bir ilkedir. Bir AI modeli veya algoritması gibi bir sisteme gelen girdi verileri düşük kaliteli, hatalı veya ilgisizse, sistemin çıktısı da düşük kaliteli, hatalı veya ilgisiz olur.
Şekil 2: Veri kalitesi ve standartlar: “çöp giren” veri, “çöp çıkan” sonuçlar.
Kaynak: Shakoor vd. 3
Bu kavram, AI bağlamında özellikle önemlidir çünkü makine öğrenimi ve derin öğrenme model'leri de dahil olmak üzere AI model'leri, eğitim ve doğrulama için kullanılan verilere büyük ölçüde bağımlıdır. Eğitim verileri yanlı, eksik veya hata içeriyorsa, AI modeli büyük olasılıkla güvenilmez veya yanlı sonuçlar üretecektir.
GIGO sorununu önlemek için, AI sistemlerinde kullanılan verilerin doğru, temsil gücü yüksek ve yüksek kaliteli olmasını sağlamak çok önemlidir. Bu genellikle veri temizliği, ön işleme ve artırma ile AI model performansını değerlendirmek için sağlam değerlendirme metriklerinin kullanımını içerir.
AI alanında kaliteli verinin temel bileşenleri nelerdir?
Doğruluk: Doğru veriler, AI algoritmalarının doğru ve güvenilir sonuçlar üretmesini sağlamak için çok önemlidir. Veri girişindeki hatalar, kuruluşlara ve bireylere potansiyel olarak zarar veren yanlış kararlara veya hatalı içgörülere yol açabilir.
Tutarlılık: Verilerin standart bir biçim ve yapı izlemesini sağlar; bu da verimli işleme ve analizi kolaylaştırır. Tutarsız veriler kafa karışıklığına ve yanlış yorumlamaya yol açarak AI sistemlerinin performansını olumsuz etkileyebilir.
Bütünlük: Eksik veri setleri, AI algoritmalarının temel kalıpları ve ilişkileri kaçırmasına neden olarak eksik veya yanlı sonuçlara yol açabilir. Veri bütünlüğünün sağlanması, AI model'lerinin doğru ve kapsamlı şekilde eğitilmesi için hayati öneme sahiptir.
Güncellik: Veri tazeliği, AI performansında önemli bir rol oynar. Güncel olmayan veriler mevcut ortamı veya eğilimleri yansıtmayabilir ve ilgisiz ya da yanıltıcı çıktılara yol açabilir.
Uygunluk: İlgili veriler, eldeki soruna doğrudan katkıda bulunur ve AI sistemlerinin en önemli değişkenlere ve ilişkilere odaklanmasına yardımcı olur. İlgisiz veriler model'leri karmaşıklaştırabilir ve verimsizliklere yol açabilir.
AI alanında veri kalitesini sağlamanın zorlukları nelerdir?
1-Veri toplama
Yapay zekadaki gelişmeler finans, sağlık hizmetleri, üretim ve eğlence gibi sektörlere fayda sağlarken, kuruluşlar kaliteyi koruyarak çeşitli kaynaklardan veri toplama zorluğu ile karşı karşıya kalır. Birçok kuruluş, tüm veri noktalarının aynı standartları izlemesini sağlamak ve süreci otomatikleştirmek için web kazıyıcılarına yönelir.
2-Veri etiketleme
AI algoritmaları eğitim için etiketlenmiş verilere bağımlıdır, ancak manuel etiketleme hem zaman alıcıdır hem de hataya açıktır. Gerçek dünya koşullarını yansıtan doğru etiketler elde etmek çoğu zaman zordur.
3-Veri depolama ve güvenlik
Veri kalitesini sağlamak, verileri yetkisiz erişimden ve olası bozulmalardan korumayı gerektirir. Kuruluşların güvenli ve güvenilir veri depolamasına sahip olması çok önemlidir, ancak bu zor olabilir.
4-Veri yönetişimi
Kuruluşlar genellikle veri kalitesi sorunlarını etkili şekilde ele alan veri yönetişimi framework'lerini uygulamakta zorlanır. Uygun veri yönetişiminin eksikliği, silolanmış verilere, tutarsızlığa ve hatalara yol açabilir.
5- Veri zehirleme
Veri zehirleme, saldırganların dataset içine kötü amaçlı veya yanıltıcı bilgiler eklediği, AI sistemlerine yönelik hedefli bir saldırıdır. Bu zehirlenmiş veriler model'in eğitimini bozarak güvenilmez ve hatta zararlı sonuçlara yol açabilir. Bu riski azaltmak için düzenli denetimler ve anomali tespiti yoluyla veri bütünlüğünü korumak çok önemlidir.
6-Sentetik veri geri bildirim döngüleri
AI tarafından üretilen verileri AI model'lerine geri beslemek, model kalitesini düşüren geri bildirim döngüleri yaratabilir. Örneğin sentetik veriler tekrar kullanıldığında model, gerçek dünya koşullarından uzaklaşan ve fazla yapay olan kalıplar öğrenebilir. Bu, model'lerin gerçek veriler üzerinde kötü performans göstermesine ve önyargıları veya hataları potansiyel olarak güçlendirmesine neden olabilir. Model sağlamlığını korumak için sentetik ve gerçek verileri dengelemek esastır.
Gerçek dünya vaka çalışmaları
Vaka Çalışması 1: Mayo Clinic – AI öncesinde veri yönetimi
Üç kampüste yaklaşık 76.000 çalışanı bulunan Mayo Clinic, veri hazırlığını her AI projesinin ilk adımı olarak ele alır.4
Zorluk: Veri sorumluluğu birçok klinik ve iş birimine dağılmıştır. Baş veri ve analitik sorumlusu Ajai Sehgal, verilerin yönetiminden kimse sorumlu olmadığında veri sorunlarının ortaya çıktığını ve sağlık hizmetlerinde AI, düşük kaliteli çıktıları göze alamaz.
Çözüm: Mayo, verileri en iyi bilen klinik ve iş ekiplerini analize hazır hale getirmekten sorumlu veri yöneticileri yaptı. Merkezi bir ekip, her veri öğesini ilgili meta verilerine ve klinik kurallarına bağlayan bir veri kütüphanesi tutar. Örneğin Mayo'nun cerrahi uygulaması, AI çalışmalarına verilerini hazır hale getirerek başlıyor ve kendi kendini finanse eden bir veri ve analitik ekibi önerdi.
Vaka Çalışması 2: JPMorgan Chase – Doğrulanmış dahili verilerle dolandırıcılık tespiti
JPMorgan Chase, kurumsal e-posta ele geçirme gibi dolandırıcılıkları tespit etmek için büyük dil model'lerini kullanır.5
Zorluk: Bankanın dolandırıcılık tespiti, yaptırım taraması ve müşteri tanıma kontrollerini yürüten Ryan Schmiedl, 2023'te ChatGPT gibi internet genelindeki verilerle eğitilen model'lerin doğrulanmamış iddiaları gerçekmiş gibi sunabileceği konusunda uyardı.
Çözüm: Banka, LLM'lerini yalnızca kendi ekosisteminden gelen verilerle eğitir ve öncelikle bu verilerin denetlendiğinden ve doğrulandığından emin olur. Ayrıca yapılandırılmamış verilerden şirket ve kişi adlarını extract etmek ve dolandırıcılık riskine karşı taramak için AI kullanır.
Vaka Çalışması 3: Walmart – Ürün kataloğu verilerini LLM'lerle temizleme
Walmart, arama ve ürün sayfalarının arkasındaki ürün kataloğu verilerini iyileştirmek için üretken yapay zeka kullandı.6
Zorluk: Walmart'ın ölçeğinde katalog verilerini eksiksiz ve doğru tutmak yoğun emek gerektirir. CEO Doug McMillon, üretken yapay zeka olmadan bu işin “mevcut çalışan sayısının yaklaşık 100 katını” gerektireceğini söyledi.
Çözüm: McMillon, şirketin 15 Ağustos 2024 tarihli kazanç görüşmesinde Walmart'ın 850 milyondan fazla katalog verisi öğesini oluşturmak veya iyileştirmek için birden fazla büyük dil modeli kullandığını söyledi. Walmart U.S. CEO'su John Furner, iyileştirilen verilerin şirketin kataloğu müşterilerin aradıklarıyla eşleştirmesine yardımcı olduğunu belirtti.
AI alanında veri kalitesini sağlamaya yönelik en iyi uygulamalar
1-Veri yönetişimi politikalarını uygulayın
Bir veri yönetişimi framework'ü, veri kalitesi standartlarını, süreçlerini ve rollerini tanımlamalıdır. Bu, bir veri kalitesi kültürü oluşturmaya yardımcı olur ve veri yönetimi uygulamalarının kurumsal hedeflerle uyumlu olmasını sağlar.
Gerçek hayattan örnek: Airbnb
Airbnb, Airbnb'nin özel verilerini ve araçlarını entegre eden özelleştirilmiş kurslar sunarak iş gücü genelinde veri okuryazarlığını artırmak için “Data University” programını başlattı. 2016'nın 3. çeyreğinde başladığından bu yana Data University, Airbnb'nin dahili veri bilimi araçlarıyla etkileşimi artırdı ve haftalık aktif kullanıcıları %30'dan %45'a çıkardı.
500'den fazla çalışanın katılımıyla bu girişim, veri yönetişimi çalışmalarını kurumsal hedeflerle uyumlu hale getirmenin önemini vurgular; şirket genelinde bir veri kalitesi ve bilinçli karar alma kültürünü teşvik eder. Program, özelleştirilmiş veri yönetişimi framework'lerinin veri yetkinliğini nasıl artırabileceğini ve iş hedefleriyle uyumu nasıl güçlendirebileceğini örneklemektedir.
2-Veri kalitesi araçlarını kullanın
Veri kalitesi araçları; veri temizleme, doğrulama ve izleme süreçlerini otomatikleştirerek AI model'lerinin yüksek kaliteli verilere tutarlı şekilde erişmesini sağlayabilir.
Gerçek hayattan örnek: General Electric
Veri kalitesi araçlarının kullanımına ilişkin güncel bir gerçek hayat örneği, General Electric'in (GE) özellikle endüstriyel veri analitiği için Predix platformu kapsamında veri yönetişimi ve kalite yönetimi stratejisini uygulamasıdır. GE, dijital dönüşümünü ve AI girişimlerini desteklemek için endüstriyel IoT ekosistemi genelinde yüksek veri standartlarını korumak amacıyla sağlam bir veri kalitesi araç setine yatırım yaptı.
GE, türbinler ve jet motorları gibi endüstriyel ekipmanlarının ürettiği büyük hacimli verileri yönetmek için veri temizleme, doğrulama ve sürekli izlemeye yönelik otomatik araçlar kullandı. Bu araçlar, GE'nin AI model'lerini besleyen verilerin doğru, tutarlı ve güvenilir olmasını sağlamaya yardımcı oldu; manuel müdahale ihtiyacını azalttı ve gerçek zamanlı veri odaklı içgörüleri mümkün kıldı.
Veri kalitesi çözümleri örnekleri
Pandada AI, 2026'nın başlarında piyasaya sürülen, otomatik veri temizleme ve analiz için yapay zeka destekli bir platformdur. Veri dosyalarını (CSV'ler, Excel elektronik tabloları, PDF'ler ve hatta görüntüler) içe aktarabilir ve yapılandırılmış, paylaşılabilir analitik raporları ve sunumları oluşturabilir.7 Platform; veri sorunlarını otomatik olarak düzelten akıllı veri temizleme özellikleri (yinelenenleri kaldırma, biçim standardizasyonu, eksik değer tespiti) içerir ve manuel veri hazırlama işini azaltır.8
Sieve, Y Combinator Spring 2025 döneminden bir girişimin veri temizleme platformudur ve AI destekli işlemeyi isteğe bağlı insan incelemesiyle birleştirir.9 Otomatik veri temizliği için bir API ve bir Excel eklentisi sunar; işaretlenen sorunları doğrulama için otomatik olarak insan operatörlere yönlendirir.9
3-Bir veri kalitesi ekibi oluşturun
Veri kalitesinden sorumlu özel bir ekip oluşturmak, veriyle ilgili süreçlerin sürekli izlenmesini ve iyileştirilmesini sağlayacaktır. Ekip ayrıca diğer çalışanları veri kalitesinin önemi konusunda eğitebilir ve yetiştirebilir.
4-Veri sağlayıcılarla iş birliği yapın
Veri sağlayıcılarla güçlü ilişkiler kurmak ve onların veri kalitesine bağlılığını sağlamak, düşük kaliteli veri alma riskini en aza indirebilir.
5-Veri kalitesi metriklerini sürekli izleyin
Veri kalitesi metriklerini düzenli olarak ölçmek ve izlemek, kuruluşların potansiyel sorunları AI performansını etkilemeden önce belirlemesine ve ele almasına yardımcı olabilir.
 Tercih edilen kaynak olarak ekle
AI Verisi Nedir?
AI verisi, genel olarak yapay zeka sistemlerinin geliştirilmesinde veya işletilmesinde kullanılan her türlü veriyi ifade eder. Dolayısıyla bu kapsam, model'leri eğitmek için kullanılan dataset'ler, tahminler için kullanılan gerçek zamanlı girdi verileri ve gerçek dünya örneklerini artırmak için üretilen sentetik veriler gibi öğeleri içerir ancak bunlarla sınırlı değildir. Resmi bir teknik terim olmasa da “AI verisi” genellikle makine öğrenimi ve derin öğrenme sistemlerini çalıştıran bilgiyi tanımlamak için kullanılır.
SSS'ler
Gartner araştırmasına göre, düşük veri kalitesi kuruluşlara yılda ortalama 12.9 milyon dolara mal olur. Ancak gerçek maliyet doğrudan finansal etkinin ötesine uzanır. Düşük veri kalitesi, başarısız AI projelerine yol açar; sektör raporları, AI ve ML projelerinin %85'e kadarının, genellikle veri kalitesi sorunları nedeniyle başlangıçtaki vaatlerini yerine getiremediğini öne sürüyor. Ek maliyetler arasında, veri bilimcilerin zamanlarının 60-%80'ini model geliştirme yerine veri temizliğine harcaması nedeniyle boşa geçen zaman; hatalı tahminlerden ve kötü müşteri deneyimlerinden kaynaklanan kayıp gelir fırsatları ve özellikle veri kalitesi hatalarının önemli para cezalarına yol açabileceği düzenlemeye tabi sektörlerde uyum riskleri yer alır.
Sektör kaynaklarından yapılan araştırmalar, AI projesi başarısızlıklarının 70-%85'inin veriyle ilgili sorunlardan kaynaklandığını ve başlıca suçlunun veri kalitesi olduğunu göstermektedir. VentureBeat'in AI uygulamaları analizi, veri bilimi projelerinin %87'inin yetersiz veya düşük kaliteli veriler başlıca neden olmak üzere hiçbir zaman üretime geçmediğini ortaya koydu. Dimensional Research tarafından yapılan bir anket, kuruluşların %96'sının AI model'lerini eğitirken veri kalitesi sorunlarıyla karşılaştığını ortaya koydu. Bu başarısızlıklar; testte iyi performans gösteren ancak veri sapması nedeniyle üretimde başarısız olan model'ler, temsil gücü olmayan eğitim verilerinden kaynaklanan yanlı sonuçlar ve veri pipeline'larının üretim hacimlerinde kaliteyi koruyamaması nedeniyle ölçeklenememe gibi çeşitli şekillerde kendini gösterir.
Birbiriyle yakından ilişkili olsalar da veri kalitesi ve veri yönetişimi farklı amaçlara hizmet eder. Veri kalitesi, verinin kendisinin özelliklerini ifade eder ve verinin doğru, eksiksiz, tutarlı, güncel ve ilgili olup olmadığına odaklanır. Verinin amaçlanan kullanım için durumu ve kullanılabilirliği ile ilgilidir. Veri kalitesi genellikle hata oranları, bütünlük yüzdeleri ve yinelenen kayıt sayıları gibi metriklerle ölçülür.
Öte yandan veri yönetişimi; kuruluş genelinde doğru veri yönetimini sağlayan politikalar, prosedürler, roller ve sorumluluklar framework'üdür. Yönetişim; verinin kime ait olduğunu, ona kimin erişebileceğini, nasıl kullanılması gerektiğini, hangi standartları karşılaması gerektiğini ve kalitenin nasıl korunacağını tanımlar.
Veri yönetişimini kurumsal yapı ve kural kitabı olarak, veri kalitesini ise ulaşmaya çalıştığınız sonuç olarak düşünün. İyi yönetişim iyi kaliteyi mümkün kılar, ancak AI girişimlerinde başarılı olmak için her ikisine de ihtiyacınız vardır. Yönetişim, veri kalitesinin tek seferlik bir temizlik değil, sürekli bir uygulama olmasını sağlayan sürdürülebilir yapıyı sunar.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{AI Veri Kalitesi: Zorluklar ve En İyi Uygulamalar}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Erişim tarihi: 23 Ekim 2026}
}
Değişiklik günlüğü
6 güncellemePandada AI ve Sieve, "Veri kalitesi çözümleri örnekleri" bölümüne eklendi.
FAQs bölümü eklendi.
Referans Linkleri





Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.