


LLM Router Karşılaştırması: 523 Ajan Veritabanı Görevinde 8 Router

8 LLM router'ı 523 ajan veritabanı görevinde test ettik ve her birini doğruluk ve maliyet açısından tekli modellerle karşılaştırdık.
Ajan router kıyaslama sonuçları
| Name | Series | $ per 1,000 questions, router fees included (log scale) | Score (%) | Score | Cost | Pool | Label |
|---|---|---|---|---|---|---|---|
| Fireworks Nexus Auto | Fireworks Nexus Auto | 1.93 | 35.95 | 35.9% | 1.9 | Router's own, open models | Fireworks Nexus Auto |
| Not Diamond | Not Diamond | 50.52 | 50.86 | 50.9% | 50.5 | 19 models | Not Diamond |
| NVIDIA Switchyard (Sol + Luna) | NVIDIA Switchyard (Sol + Luna) | 16.6 | 56.21 | 56.2% | 16.6 | GPT-6.1 Sol + GPT-6 Luna | NVIDIA Switchyard (Sol + Luna) |
| OpenRouter Auto | OpenRouter Auto | 1.97 | 28.68 | 28.7% | 2.0 | Router's own | OpenRouter Auto |
| OpenRouter Auto Code | OpenRouter Auto Code | 24.62 | 52.77 | 52.8% | 24.6 | Router's own | OpenRouter Auto Code |
| Sakana Fugu Max | Sakana Fugu Max | 29.96 | 27.34 | 27.3% | 30.0 | Router's own | Sakana Fugu Max |
| TypeSafe Jev | TypeSafe Jev | 2.09 | 29.45 | 29.4% | 2.1 | Router's own | TypeSafe Jev |
| Unbiased Pareto 26.10 | Unbiased Pareto 26.10 | 13.18 | 44.17 | 44.2% | 13.2 | Router's own | Unbiased Pareto 26.10 |
| Claude Fable 5 | Anthropic | 150.34 | 60.04 | 60.0% | 150.3 | single model | Claude Fable 5 |
| Claude Fable 5.1 | Anthropic | 718.96 | 62.91 | 62.9% | 719.0 | single model | Claude Fable 5.1 |
| Claude Fable 5.2 | Anthropic | 109.43 | 85.28 | 85.3% | 109.4 | single model | Claude Fable 5.2 |
| Claude Haiku 5.5 | Anthropic | 1.92 | 26.2 | 26.2% | 1.9 | single model | Claude Haiku 5.5 |
| Claude Opus 4.8 | Anthropic | 148.83 | 50.67 | 50.7% | 148.8 | single model | Claude Opus 4.8 |
| Claude Opus 5 | Anthropic | 77.8 | 60.99 | 61.0% | 77.8 | single model | Claude Opus 5 |
| Claude Opus 5.5 | Anthropic | 236.55 | 84.89 | 84.9% | 236.5 | single model | Claude Opus 5.5 |
| Claude Sonnet 5 | Anthropic | 76.64 | 34.42 | 34.4% | 76.6 | single model | Claude Sonnet 5 |
| Claude Sonnet 5.5 | Anthropic | 53.81 | 70.36 | 70.4% | 53.8 | single model | Claude Sonnet 5.5 |
| Command A Plus | Cohere | 9.19 | 30.21 | 30.2% | 9.2 | single model | Command A Plus |
| DeepSeek V4 Flash | DeepSeek | 2.91 | 30.4 | 30.4% | 2.9 | single model | DeepSeek V4 Flash |
| DeepSeek V4 Flash 0731 | DeepSeek | 1.66 | 33.84 | 33.8% | 1.7 | single model | DeepSeek V4 Flash 0731 |
| DeepSeek V4 Pro | DeepSeek | 11.28 | 35.37 | 35.4% | 11.3 | single model | DeepSeek V4 Pro |
| DeepSeek V4 Pro 0813 | DeepSeek | 13.95 | 40.92 | 40.9% | 13.9 | single model | DeepSeek V4 Pro 0813 |
| DeepSeek V4.1 Flash | DeepSeek | 4.25 | 30.78 | 30.8% | 4.2 | single model | DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash 1017 | DeepSeek | 2.05 | 20.65 | 20.7% | 2.0 | single model | DeepSeek V4.1 Flash 1017 |
| Gemini 3 Flash Preview | 9.37 | 59.66 | 59.7% | 9.4 | single model | Gemini 3 Flash Preview | |
| Gemini 3.1 Flash Lite | 6.95 | 42.07 | 42.1% | 6.9 | single model | Gemini 3.1 Flash Lite | |
| Gemini 3.1 Pro Preview | 90.04 | 60.42 | 60.4% | 90.0 | single model | Gemini 3.1 Pro Preview | |
| Gemini 3.5 Flash Lite | 8.52 | 48.76 | 48.8% | 8.5 | single model | Gemini 3.5 Flash Lite | |
| Gemini 3.6 Flash | 27.38 | 58.89 | 58.9% | 27.4 | single model | Gemini 3.6 Flash | |
| Gemini 3.7 Flash | 25.08 | 69.41 | 69.4% | 25.1 | single model | Gemini 3.7 Flash | |
| Gemini 3.8 Flash | 32.67 | 65.39 | 65.4% | 32.7 | single model | Gemini 3.8 Flash | |
| Gemini 4 Argon | 48.44 | 77.82 | 77.8% | 48.4 | single model | Gemini 4 Argon | |
| Gemini 4 Carbon | 75.67 | 77.25 | 77.2% | 75.7 | single model | Gemini 4 Carbon | |
| GLM 4.7 | Zhipu AI | 10.84 | 25.05 | 25.0% | 10.8 | single model | GLM 4.7 |
| GLM 5.1 | Zhipu AI | 12.8 | 38.43 | 38.4% | 12.8 | single model | GLM 5.1 |
| GLM 5.2 | Zhipu AI | 6.71 | 39.2 | 39.2% | 6.7 | single model | GLM 5.2 |
| GLM 5.3 | Zhipu AI | 24.27 | 38.62 | 38.6% | 24.3 | single model | GLM 5.3 |
| GLM 5.3 Flash | Zhipu AI | 4.22 | 36.14 | 36.1% | 4.2 | single model | GLM 5.3 Flash |
| GLM 5.3 Prime | Zhipu AI | 69.86 | 35.18 | 35.2% | 69.9 | single model | GLM 5.3 Prime |
| GPT-5.2 | OpenAI | 29.97 | 31.93 | 31.9% | 30.0 | single model | GPT-5.2 |
| GPT-5.4 Mini | OpenAI | 7.03 | 24.28 | 24.3% | 7.0 | single model | GPT-5.4 Mini |
| GPT-5.4 Nano | OpenAI | 2.85 | 21.03 | 21.0% | 2.8 | single model | GPT-5.4 Nano |
| GPT-5.5 | OpenAI | 75.52 | 44.93 | 44.9% | 75.5 | single model | GPT-5.5 |
| GPT-5.6 Luna | OpenAI | 13.87 | 33.46 | 33.5% | 13.9 | single model | GPT-5.6 Luna |
| GPT-5.6 Sol | OpenAI | 60.83 | 49.9 | 49.9% | 60.8 | single model | GPT-5.6 Sol |
| GPT-5.6 Terra | OpenAI | 30.71 | 39.39 | 39.4% | 30.7 | single model | GPT-5.6 Terra |
| GPT-6 Luna | OpenAI | 1.34 | 38.81 | 38.8% | 1.3 | single model | GPT-6 Luna |
| GPT-6 Luna Pro | OpenAI | 3.91 | 38.24 | 38.2% | 3.9 | single model | GPT-6 Luna Pro |
| GPT-6 Sol | OpenAI | 21.83 | 50.48 | 50.5% | 21.8 | single model | GPT-6 Sol |
| GPT-6 Sol Pro | OpenAI | 59.11 | 50.67 | 50.7% | 59.1 | single model | GPT-6 Sol Pro |
| GPT-6.1 Sol (reference) | OpenAI | 15.45 | 61.19 | 61.2% | 15.4 | single model, run with the routers | GPT-6.1 Sol (reference) |
| GPT-6.1 Sol (text-to-SQL) | OpenAI | 15.91 | 61.38 | 61.4% | 15.9 | single model | GPT-6.1 Sol (text-to-SQL) |
| GPT-6.1 Sol Pro | OpenAI | 44.12 | 59.85 | 59.8% | 44.1 | single model | GPT-6.1 Sol Pro |
| GPT-6.1 Terra | OpenAI | 8.76 | 53.54 | 53.5% | 8.8 | single model | GPT-6.1 Terra |
| GPT-OSS 120B | OpenAI | 0.597 | 19.89 | 19.9% | 0.6 | single model | GPT-OSS 120B |
| Grok 4.3 | xAI | 16.13 | 41.68 | 41.7% | 16.1 | single model | Grok 4.3 |
| Grok 4.5 | xAI | 26.24 | 48.57 | 48.6% | 26.2 | single model | Grok 4.5 |
| Grok 4.6 | xAI | 41.78 | 58.32 | 58.3% | 41.8 | single model | Grok 4.6 |
| Grok 4.7 | xAI | 37.1 | 48.37 | 48.4% | 37.1 | single model | Grok 4.7 |
| HY4 Preview | Tencent | 12.78 | 45.12 | 45.1% | 12.8 | single model | HY4 Preview |
| Kimi K2.6 | Moonshot AI | 19.13 | 43.79 | 43.8% | 19.1 | single model | Kimi K2.6 |
| Kimi K3 | Moonshot AI | 48.24 | 45.32 | 45.3% | 48.2 | single model | Kimi K3 |
| Kimi K3.1 Pro | Moonshot AI | 32 | 49.14 | 49.1% | 32.0 | single model | Kimi K3.1 Pro |
| Llama 4 Maverick | Meta | 6.1 | 28.11 | 28.1% | 6.1 | single model | Llama 4 Maverick |
| MiMo V2.6 Pro | Xiaomi | 4.93 | 38.81 | 38.8% | 4.9 | single model | MiMo V2.6 Pro |
| MiniMax M2.5 | MiniMax | 3.45 | 29.45 | 29.4% | 3.5 | single model | MiniMax M2.5 |
| MiniMax M3 | MiniMax | 4.85 | 34.03 | 34.0% | 4.9 | single model | MiniMax M3 |
| MiniMax M3.1 Flash | MiniMax | 2.71 | 33.84 | 33.8% | 2.7 | single model | MiniMax M3.1 Flash |
| Mistral Large 4.0 | Mistral AI | 18.65 | 26.77 | 26.8% | 18.7 | single model | Mistral Large 4.0 |
| Mistral Small 2603 | Mistral AI | 1.74 | 23.33 | 23.3% | 1.7 | single model | Mistral Small 2603 |
| Muse Ember | Meta | 2.99 | 37.48 | 37.5% | 3.0 | single model | Muse Ember |
| Muse Glimmer 30B | Meta | 6.4 | 31.17 | 31.2% | 6.4 | single model | Muse Glimmer 30B |
| Muse Spark 1.1 | Meta | 27.77 | 39.01 | 39.0% | 27.8 | single model | Muse Spark 1.1 |
| Muse Spark 1.2 | Meta | 39.56 | 45.89 | 45.9% | 39.6 | single model | Muse Spark 1.2 |
| Muse Spark 1.3 | Meta | 38.67 | 43.98 | 44.0% | 38.7 | single model | Muse Spark 1.3 |
| Muse Spark Open | Meta | 27.1 | 41.87 | 41.9% | 27.1 | single model | Muse Spark Open |
| Muse Wonder | Meta | 94.28 | 54.49 | 54.5% | 94.3 | single model | Muse Wonder |
| Nemotron 3 Ultra 550B A55B | NVIDIA | 25.28 | 31.93 | 31.9% | 25.3 | single model | Nemotron 3 Ultra 550B A55B |
| Qwen3.5 27B | Alibaba | 12.49 | 37.28 | 37.3% | 12.5 | single model | Qwen3.5 27B |
| Qwen3.6 27B | Alibaba | 19.48 | 47.8 | 47.8% | 19.5 | single model | Qwen3.6 27B |
| Qwen3.6 Flash | Alibaba | 8.69 | 34.23 | 34.2% | 8.7 | single model | Qwen3.6 Flash |
| Qwen3.7 Plus | Alibaba | 8.88 | 39.77 | 39.8% | 8.9 | single model | Qwen3.7 Plus |
| Qwen3.8 2.4T A95B | Alibaba | 32.28 | 48.76 | 48.8% | 32.3 | single model | Qwen3.8 2.4T A95B |
| Qwen3.8 27B | Alibaba | 14.25 | 43.4 | 43.4% | 14.2 | single model | Qwen3.8 27B |
| Qwen3.8 Flash | Alibaba | 2.5 | 41.68 | 41.7% | 2.5 | single model | Qwen3.8 Flash |
| Qwen3.8 Max | Alibaba | 30.54 | 46.27 | 46.3% | 30.5 | single model | Qwen3.8 Max |
| Qwen3.8 Max 0902 | Alibaba | 31.52 | 36.33 | 36.3% | 31.5 | single model | Qwen3.8 Max 0902 |
| Qwen3.8 Max Prime | Alibaba | 62.91 | 34.99 | 35.0% | 62.9 | single model | Qwen3.8 Max Prime |
| Solar Pro4 | Upstage | 2.14 | 23.33 | 23.3% | 2.1 | single model | Solar Pro4 |
| Tencent HY3 | Tencent | 2.05 | 43.21 | 43.2% | 2.1 | single model | Tencent HY3 |
8 router'ın her biri için, çalıştırdığımız en az bir tekli model aynı veya daha yüksek puan aldı ve soru başına aynı veya daha az maliyete sahipti. Grafikte yeşil alan, GPT-6.1 Sol'dan daha düşük maliyetli ve %50 üzerinde puan alan sonuçları gösterir.
Her soru için ajan önce 11 veritabanından birini seçer ve ardından ona karşı SQL sorguları yazar. Soru başına en fazla 10 kez bir model çağırabilir ve router her çağrı için modeli seçer. Havuz, bir router'ın seçebileceği modeller kümesidir.
Router bazında puanlar
| Label | Label short | CI low | CI high | Score (%) |
|---|---|---|---|---|
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 57.17 | 65.39 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 51.82 | 60.42 | 56.21 |
| OpenRouter Auto Code | Auto Code | 48.37 | 56.98 | 52.77 |
| Not Diamond (19 models) | Not Diamond | 46.46 | 55.07 | 50.86 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 39.96 | 48.37 | 44.17 |
| Fireworks Nexus Auto | Nexus Auto | 31.74 | 40.15 | 35.95 |
| TypeSafe Jev | TypeSafe Jev | 25.62 | 33.27 | 29.45 |
| OpenRouter Auto | OpenRouter Auto | 24.86 | 32.7 | 28.68 |
| Sakana Fugu Max | Fugu Max | 23.52 | 31.36 | 27.34 |
8 router'ın tümü GPT-6.1 Sol'dan açıkça daha düşük puan aldı. Switchyard en yakına geldi; 5.0 puan aşağıda. %95 güven aralığı Sol'inkiyle örtüşüyor, ancak aynı sorular üzerindeki test ikisini ayırıyor (bkz. İstatistikler).
Her router en çok kullandığı modele karşı
| Label | Label short | Router score | Alone score | Main model name | Main model short | Main model share | Router | Most used model |
|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 28.7% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 99% | 28.68 | 26.2 |
| TypeSafe Jev | TypeSafe Jev | 29.4% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 98% | 29.45 | 26.2 |
| Fireworks Nexus Auto | Nexus Auto | 35.9% | 36.1% | GLM 5.3 Flash | GLM 5.3 Flash | 99% | 35.95 | 36.14 |
| Not Diamond (19 models) | Not Diamond | 50.9% | 49.9% | GPT-5.6 Sol | GPT-5.6 Sol | 100% | 50.86 | 49.9 |
| OpenRouter Auto Code | Auto Code | 52.8% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 71% | 52.77 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 56.2% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 75% | 56.21 | 61.19 |
Modelinin adını veren altı router'dan dördü, en çok kullandıkları modelin 3.3 puan yakınında puan aldı. Switchyard çağrılarını GPT-6.1 Sol ile GPT-6 Luna arasında, Otomatik Code ise GPT-6.1 Sol ile GLM 5.3 arasında böldü. Sol'un 5.0 ve 8.4 puan altında puan aldılar.
Router'lar tek bir havuzu paylaşmadı; bu nedenle bu farklar hem router'ı hem de seçebileceği modelleri yansıtır. Ortak havuz bölümü, üç router'ı aynı iki model üzerinde karşılaştırır. Switchyard ve Not Diamond için havuzları biz belirledik (bkz. Router'lar ve havuzlar).
Soru başına süre
| Label | Label short | Sec label | Seconds |
|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 8.8 s | 8.8 |
| TypeSafe Jev | TypeSafe Jev | 9.0 s | 8.96 |
| OpenRouter Auto Code | Auto Code | 10.4 s | 10.42 |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 10.7 s | 10.69 |
| Fireworks Nexus Auto | Nexus Auto | 10.8 s | 10.81 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 12.7 s | 12.68 |
| Sakana Fugu Max | Fugu Max | 13.3 s | 13.28 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 15.4 s | 15.44 |
| Not Diamond (19 models) | Not Diamond | 17.3 s | 17.28 |
19 modelli Not Diamond ve Switchyard en yavaş router'lardı. Medyanda soru başına 17.3 ve 15,4 saniye sürdüler. GPT-6.1 Sol 10,7 saniye sürdü. OpenRouter Otomatik ve Jev, 8.8 ve 9,0 saniye ile en hızlıydı. Her ikisi de neredeyse tüm çağrıları Claude Haiku 5.5'e gönderdi.
Otomatik Code'un GPT-6.1 Sol çağrıları öncelikli katmanda çalıştı. Router olmadan GPT-6.1 Sol için 1,8 saniyeye karşılık medyanda 1,5 saniyede ürettiler. Otomatik Code üzerinden yönlendirme, çağrı başına yaklaşık 0,2 saniye ekledi. Soru başına ikisi de yaklaşık aynı süreyi aldı; medyanda 10.4 ve 10,7 saniye.
Router maliyetleri ve ücretleri
| Label | Label short | Total | Per correct | Billed | Computed from list prices |
|---|---|---|---|---|---|
| Fireworks Nexus Auto | Nexus Auto | $1.9 | $5.4 | — | 1.93 |
| OpenRouter Auto | OpenRouter Auto | $2.0 | $6.9 | 1.97 | — |
| TypeSafe Jev | TypeSafe Jev | $2.1 | $7.1 | 2.09 | — |
| Unbiased Pareto 26.10 | Unbiased Pareto | $13.2 | $29.8 | 13.18 | — |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | $15.4 | $25.2 | 15.45 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | $16.6 | $29.5 | 16.6 | — |
| OpenRouter Auto Code | Auto Code | $24.6 | $46.6 | 24.62 | — |
| Sakana Fugu Max | Fugu Max | $30.0 | $109.6 | 29.96 | — |
| Not Diamond (19 models) | Not Diamond | $50.5 | $99.3 | 43.76 | 6.76 |
Bir router'ın maliyeti model faturası artı varsa değerlendirici veya seçim ücretidir. Bir deneme başarısız olur ve soru yeniden çalışırsa yalnızca son denemeyi sayarız. Grafikte çizgili kısımlar fiyat listelerinden hesaplanmıştır, geri kalanı faturalardan gelir.
Doğru yanıt başına en düşük maliyeti Fireworks Nexus Otomatik gösterdi; liste fiyatlarıyla 1.000 doğru yanıt başına 5,4 $ oldu. Faturalanan maliyete sahip router'lar arasında en düşük maliyet OpenRouter Otomatik'da 6,9 $ oldu.
Bazı router'lar en çok kullandıkları modelden daha pahalıya mal oldu. Ek maliyet Switchyard'ın değerlendiricisinden, Not Diamond'ın seçim ücretinden ve Otomatik Code'un GPT-6.1 Sol çağrılarındaki öncelikli katmandan kaynaklandı. Her durumda router, en çok kullandığı modelden açıkça daha yüksek puan almadı.
Tekli modellere karşı maliyet
Dört router, GPT-6.1 Sol'dan daha pahalıya mal oldu. 1.000 soru başına 15,4 $ karşılığında %61,2 puan alan Sol'dan dördü de daha düşük puan aldı:
- 19 modelli Not Diamond: 50,5 $ karşılığında %50,9. Bunun çoğu GPT-5.6 Sol çağrılarıydı ve seçim ücreti 6,8 $ ekledi (bkz. Ücretler ve fiyat katmanları).
- Sakana Fugu Max: 30,0 $ karşılığında %27,3, 8 router arasındaki en düşük puan. Modelini adlandırmaz. Soru başına 6.8 model çağrısı yaptı; GPT-6.1 Sol için bu 5.5'tir. Ortalama çağrı maliyeti bir GPT-6.1 Sol çağrısının yaklaşık 1.6 katıydı.
- OpenRouter Otomatik Code: 24,6 $ karşılığında %52,8. Çağrıların %71'ini GPT-6.1 Sol'a gönderdi ve bunların neredeyse tamamı OpenAI'ın öncelikli katmanında çalıştı (bkz. Ücretler ve fiyat katmanları).
- NVIDIA Switchyard: 16,6 $ karşılığında %56,2. GPT-6.1 Sol ve GPT-6 Luna'ya yaptığı çağrılar 13,7 $ tuttu; bu, Sol'un 15,4 $'ından azdı. Değerlendirici modeli 2,9 $ ekledi (bkz. Ücretler ve fiyat katmanları).
En ucuz üç router'dan hiçbiri, 1.000 soru başına 1,3 $ karşılığında %38,8 puan alan GPT-6 Luna'dan daha yüksek puan almadı. OpenRouter Otomatik ve TypeSafe Jev yaklaşık 10 puan daha düşük, sırasıyla 2,0 $ ve 2,1 $ karşılığında %28,7 ve %29,4 puan aldı. Fireworks Nexus Otomatik 1,9 $ karşılığında %35,9 puan aldı ve Luna'dan belirgin bir farkı yoktu.
Ücretler ve fiyat katmanları
- Her çağrı için model seçmek üzere Switchyard önce o ana kadarki araç sonuçlarını kontrol eder. Hatalar ve tekrarlanan başarısızlıklar daha güçlü modele işaret eder. Bir sorunun ilk çağrısında olduğu gibi araç sonuçları seçimi netleştirmediğinde, küçük bir değerlendirici model olan Gemini 3.5 Flash Lite soruyu okur ve modeli seçer.1 Her değerlendirici çağrısı normal bir model çağrısı olarak faturalandırılır. Ortak havuzda değerlendirici, 1.000 soru başına 3,2 $ ekledi.
- Not Diamond her model seçimi için ücret alır. Her seçimi, fiyat listesindeki fiyat olan 0,001 $ üzerinden saydık.2 Ortak havuzda ücret, 1.000 soru başına 6,3 $ oldu; bu, Not Diamond'ın 15,8 $'lık toplamının %40'ıdır.
- Otomatik Code, neredeyse tüm GPT-6.1 Sol çağrılarında OpenAI'ın öncelikli katmanını aldı. Çağrı başına GPT-6.1 Sol'un fiyatının 2.04 katını ödedi. OpenRouter, kapalı bir modelin öncelikli katmanının yalnızca bir istek bunu istediğinde veya sağlayıcıyı sabitlediğinde hizmet verdiğini söylüyor,3 ancak isteklerimiz bunların hiçbirini yapmadı. Bu katman olmasaydı, Otomatik Code 1.000 soru başına 24,6 $ yerine yaklaşık 13 $'a mal olurdu.
19 model ile Not Diamond'ın GPT-5.6 Sol çağrıları 1.000 soru başına 43,8 $ tuttu; buna karşılık metinden-SQL'e kıyaslama testimizde GPT-5.6 Sol 60,8 $ tuttu. Bu farkı bir önbellek indirimi açıklayabilir. Not Diamond, girdi token'larının %69,5'inde önbellekli fiyat üzerinden işlem gördü. Metinden-SQL'e çalışmamız önbellek kullanımını kaydetmediğinden bunu doğrulayamıyoruz.
Model seçimi ve geçiş
| Label | Label short | Claude Haiku 5.5 | DeepSeek V4.1 Flash | GLM 5.3 | GLM 5.3 Flash | GPT-5.6 Sol | GPT-6 Luna | GPT-6.1 Sol | Other |
|---|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 98.63 | 1.37 | — | — | — | — | — | — |
| TypeSafe Jev | TypeSafe Jev | 98.29 | 1.03 | 0.3206 | — | — | — | 0.1425 | 0.2138 |
| Fireworks Nexus Auto | Nexus Auto | — | — | 1.15 | 98.85 | — | — | — | — |
| Not Diamond (19 models) | Not Diamond, 19 models | — | — | — | — | 100 | — | — | — |
| OpenRouter Auto Code | Auto Code | — | — | 29.43 | — | — | — | 70.57 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard, Sol + Luna | — | — | — | — | — | 25.02 | 74.98 | — |
Modeli adlandıran ve varsayılan ayarlarda çalışan 9 router çalışmasından beşi, çağrılarının en az %98'ini tek bir modele gönderdi. Bunlar kendi havuzunda OpenRouter Otomatik, Jev, Nexus Otomatik ve her iki havuzda Not Diamond'dı.
Not Diamond'ın 19 modellik listesinde, 1.000 soru başına 9,4 $ karşılığında %59,7 puan alan Gemini 3 Flash Preview da vardı. Not Diamond'ın seçimlerinin hiçbiri Gemini 3 Flash Preview'e gitmedi. Her çağrı, %49,9 puan alan GPT-5.6 Sol'a gitti.
Soru içinde model geçişi
Varsayılan ayarlarda yalnızca Switchyard, soruların %5'inden fazlasında model değiştirdi. GPT-6.1 Sol ve GPT-6 Luna ile 523 sorunun 308'inde, ortak havuzda ise 35 soruda bunu yaptı.
Her soru, her çağrıda aynı oturum anahtarıyla tek bir router oturumu olarak çalıştı. OpenRouter'ın Switchyard belgeleri ve Pareto belgeleri, ajanlar için bunu önerir. Oturum anahtarı, bir router'ın model değiştirmesini engellemez. Router'ların çoğu her çağrı için model seçebilir. OpenRouter'ın Otomatik belgeleri, yeni modelin prompt önbelleğini yeniden oluşturması gerektiği için geçişin daha maliyetli olduğunu söyler. Bu nedenle Otomatik yalnızca buna değdiğinde geçiş yapar. Fireworks'ün Nexus Otomatik belgeleri, her yeni kullanıcı mesajı için bir model seçtiğini ve o mesajın araç çağrıları için onu koruduğunu söyler. Ajanımız, soruyu içeren bir kullanıcı mesajı ve nihai yanıtı isteyen ikinci bir mesaj gönderir. Nexus Otomatik'nun 9 geçişinin tümü bu ikinci mesajda gerçekleşti.
Rastgele karışım karşılaştırması
Her iki havuzdaki Switchyard'ı ve Otomatik Code'u rastgele bir karışımla karşılaştırdık. Rastgele karışım, her soruyu router'ın çağrı paylarında rastgele seçilen tek bir modelle yanıtlar. Beklenen puanı, tekli model çalışmalarımızdan gelir.
Sol ve Luna ile Switchyard %56,2 puan aldı; rastgele karışımı %55,7 puan aldı. Ortak havuzdaki Switchyard, %52,4'e karşılık %55,1 puan aldı. Otomatik Code, %54,7'ye karşılık %52,8 puan aldı. Üç router'dan hiçbiri rastgele karışımından açıkça daha iyi veya daha kötü yapmadı.
Tek havuzlu üç router
| Label | Label short | Cost label | Same two models, three routers |
|---|---|---|---|
| Not Diamond, cost setting | Not Diamond, cost | $12.8 | 59.66 |
| Gemini 3 Flash Preview (no router) | Gemini (no router) | $9.4 | 59.66 |
| Not Diamond, default setting | Not Diamond, default | $15.8 | 59.27 |
| NVIDIA Switchyard | Switchyard | $11.2 | 55.07 |
| OpenRouter Auto | OpenRouter Auto | $3.4 | 32.89 |
| DeepSeek V4 Flash (no router) | DeepSeek (no router) | $2.9 | 30.4 |
Modelleri yönlendirmeden ayırmak için üç router'a aynı iki modeli verdik. Gemini 3 Flash Preview güçlü olan, DeepSeek V4 Flash ise ucuz olan modeldir.
Ortak havuz sonuçları
Varsayılan ayarlarda hiçbir router, en çok kullandığı modelden açıkça farklı bir sonuç göstermedi ve hiçbiri Gemini 3 Flash Preview'in üzerinde puan almadı.
Not Diamond, GPT-6.1 Sol'dan 1.9 puan, Switchyard ise 6.1 puan daha düşük puan aldı. Testimiz bu farkları doğrulamadı.
- Varsayılan ayarında Not Diamond, çağrıların %100'ini Gemini 3 Flash Preview'e gönderdi. Gemini 3 Flash Preview'in %59,7'sine karşılık %59,3 puan aldı. 1.000 soru başına 9,4 $'a karşılık 15,8 $'a mal oldu.
- Maliyet ayarıyla Not Diamond, çağrıların %62'ini DeepSeek V4 Flash'a gönderdi. Yine de her nihai yanıtı Gemini 3 Flash Preview ile verdi. Gemini 3 Flash Preview ile aynı olan %59,7 puan aldı; 9,4 $'a karşılık 12,8 $ maliyetle. Seçim ücreti olan 7,5 $, model çağrılarının maliyetinden daha fazlaydı.
- Switchyard, çağrıların %75'ini Gemini 3 Flash Preview'e gönderdi ve Not Diamond'dan açıkça farklı olmadan %55,1 puan aldı.
- Otomatik, çağrıların %97'ini DeepSeek V4 Flash'a gönderdi ve DeepSeek V4 Flash'ın %30,4'ine yakın olan %32,9 puan aldı.
Model uyumu ve çağrı sınırı
Bu havuzda herhangi bir router'ın modele soruya uygun olarak seçtiğine dair net bir işaret bulamadık. Gemini 3 Flash Preview'in çözdüğü, DeepSeek V4 Flash'ın ise kaçırdığı 170 soru ve bunun tersinin geçerli olduğu 17 soru var. Her router, her iki kümede de DeepSeek V4 Flash'a çağrılarının benzer bir payını gönderdi; en fazla 10 puan farkla. 17 soruluk küme, küçük bir farkı göstermek için çok küçüktür.
Otomatik, 10 çağrı sınırına en sık ulaştı; soruların %37,3'inde buna karşılık Switchyard için %18,9 ve Not Diamond için %16,8.
OpenRouter Otomatik ayrıca bu havuzda en uzun süreyi aldı; medyanda soru başına 17,5 saniye. Not Diamond aynı iki model üzerinde 9,0 saniye sürdü.
Kısaca her router
Not Diamond
Not Diamond'ın varsayılan router'ı önceden eğitilmiş olarak gelir; bu nedenle kullanmadan önce eğitmeniz gerekmez. Kendi verilerinizle özel bir router da eğitebilirsiniz.4 Not Diamond modeli çağırmaz. Seçtiği modelin adını döndürür ve ardından kendi kodunuz o modeli çağırır. Diğer router'lar çağrıyı kendileri yapar. Varsayılan olarak Not Diamond kaliteye göre seçim yapar. Her istekteki bir denge ayarı, bunun yerine maliyet veya gecikmeyi tercih etmesini sağlayabilir.5 Varsayılan router'ı kullandık ve maliyet ayarını yalnızca ortak havuzda bir kez çalıştırdık.
NVIDIA Switchyard
Switchyard, OpenRouter üzerinde çalışır. En fazla üç model listelersiniz ve o, bunların en ucuzu ile en pahalısı arasında seçim yapar. Kendi adına yönlendirme ücreti eklemez.1
OpenRouter Otomatik
OpenRouter Otomatik, her istek için bir model ve bir muhakeme çabası seçer ve ücret eklemez.6 `allowed_models` içindeki bir liste sabit bir sınırdır ve düşük, orta veya yüksek maliyet katmanı politikayı belirler. Belgeler, varsayılanın eski Otomatik'dan daha pahalı olduğunu ve maliyetleri ona yakın tutmak için düşük katmanı önerdiğini söyler. Testimizde düşük katman, %28,7 varsayılana karşılık %28,3 puan aldı; aynı 1.000 soru başına 2,0 $ maliyetle ve açıkça bir fark olmadan.
OpenRouter Otomatik Code
Otomatik Code, Otomatik ile aynı motorda çalışır; kodlama ajanları için ayarlanmış bir politikaya sahiptir ve ücret eklemez.7 Prompt önbelleğini korumak için model değiştirmektense muhakeme çabasını değiştirmeyi tercih eder. `allowed_models`'i sabit bir sınır olarak ele alır. Ortak havuzu verdiğimizde, her istek ölçülen hiçbir modelin isteği karşılamadığını söyleyen bir hatayla başarısız oldu.
TypeSafe Jev
Jev, her istek için bir model ve bir muhakeme çabası seçer; her istek, gittiği modelin fiyatı üzerinden faturalandırılır.8 Model listesi yalnızca bir tercihtir ve yalnızca `excluded_models` bir modeli engeller.9 Puanı, OpenRouter Otomatik'dan açıkça bir fark göstermedi. 14 Kasım 2026 itibarıyla, OpenRouter'ın router kıyaslama sayfası Otomatik'nun artık Jev tarafından desteklendiğini söylüyor.10
Fireworks Nexus Otomatik
Nexus Otomatik, Fireworks router'ıdır ve otomatik model kimliği ile çağrılır. Model listesi almaz. Bir Fireworks anahtarıyla, Fireworks açık modelleri arasından seçim yapar.11
Unbiased Pareto 26.10
OpenRouter, Unbiased Pareto 26.10'u milyon girdi token'ı başına 0,80 $ ve milyon çıktı token'ı başına 3,20 $ olarak listeler.12 Model listesi almaz ve sayfa, nasıl model seçtiğini veya hangi modelleri kullandığını söylemez. Yanıtları yalnızca router'ı adlandırır. 1.000 soru başına 13,2 $ karşılığında %44,2 puan aldı; bu, Gemini 3 Flash Preview'den daha düşük ve daha pahalıdır.
Sakana Fugu Max
Sakana, Fugu Max'in en büyük model havuzunu çalıştırdığını söylüyor. Havuz sabittir ve Sakana tüm üyelerini listelemez. Milyon girdi token'ı başına 2 $ ve milyon çıktı token'ı başına 6 $, ayrıca her dahili web aracı çağrısı için 0,007 $ maliyeti vardır.13
Ajan router kıyaslama yöntemi
Her router aynı ajanı, prompt'u, araçları ve soru sırasını aldı. Yerel bir proxy, her çağrının modelini, token'larını, maliyetini ve süresini kaydetti.
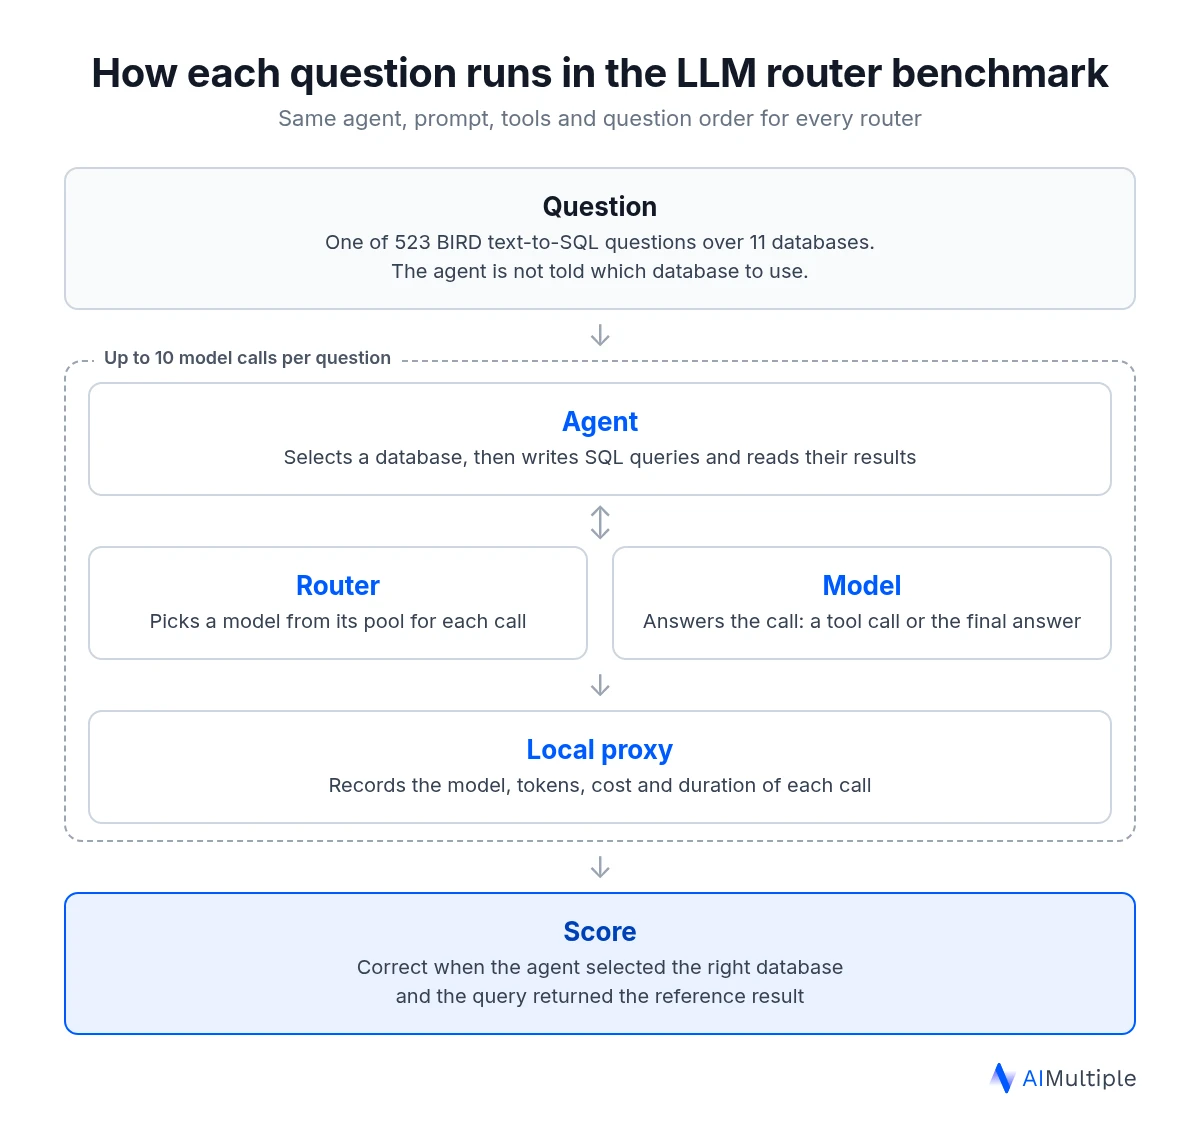
metinden-SQL'e kıyaslama testimizden 523 soru kullandık; bu test, herkese açık bir metinden-SQL'e veri kümesi olan BIRD'e dayanır. Ajana 11 veritabanından hangisini kullanacağı söylenmez ve veritabanı adları takma adlarla değiştirilir. Ajan doğru veritabanını seçtiğinde ve sorgusu referans sonucu döndürdüğünde bir soru doğru sayılır. Bir hata başarısızlık sayılır. Her istek en fazla 600 saniye sürebilir.
Altı router'ı OpenRouter üzerinden openrouter/otomatik, openrouter/otomatik-code, typesafe/jev-router, nvidia/switchyard, unbiased/pareto-26.10 ve sakana/fugu-max kimlikleriyle çağırdık. Not Diamond, modelSelect API'si üzerinden çalıştı ve seçtiği her modeli OpenRouter üzerinden çağırdık. Fireworks Nexus Otomatik, Fireworks API'si üzerinden çalıştı. Ayrıca GPT-6.1 Sol'u aynı kurulumda router olmadan çalıştırdık. Diğer tekli model puanları, aynı 523 soru üzerindeki metinden-SQL'e kıyaslama testimizden gelir.
Süre, tüm ajan adımları boyunca bizim tarafımızda ölçülen, soru başına medyan saniyedir. Her router ve havuz, 13 ile 16 Kasım 2026 arasında bir kez çalıştı. Her soru hatasız tamamlandı.
Router'lar ve havuzlar
Çalıştırma sırasında herkese açık bir API'ye sahip olan ve araç çağrılarını kabul eden router'ları dahil ettik. OpenRouter Otomatik ve Otomatik Code, OpenRouter'ın Otomatik'yu yeniden inşa edip Otomatik Code'u başlattığı 6 Kasım 2026'dan sonra çalıştı.14
Altı router, satıcı varsayılanlarıyla kendi havuzlarında çalıştı. Switchyard ve Not Diamond için havuzu biz belirledik. Model listesi olmadan Switchyard, son yedi günde OpenRouter'da en yüksek harcamaya sahip 20 modelden ikisini alır; bu nedenle çift zamanla değişir. Çifti sabit tutmak için ona GPT-6.1 Sol ve GPT-6 Luna'yı verdik. Not Diamond bir model listesi gerektirir. Ona, desteklediği ve metinden-SQL'e kıyaslama testimizde de test ettiğimiz 19 modeli verdik.
Aynı modeller üzerinde yönlendirmeyi karşılaştırmak için Not Diamond, NVIDIA Switchyard ve OpenRouter Otomatik'yu ortak bir havuzda çalıştırdık. Bu çalıştırmalar sıralanmamıştır.
Bir router, yalnızca verdiğimiz model listesine sadık kaldığında katılabilirdi. Not Diamond, yukarıda Switchyard'ın kullandığı GPT-6.1 Sol veya GPT-6 Luna çiftini desteklemez. Bu nedenle, desteklediği güçlü ve ucuz bir model çifti olan Gemini 3 Flash Preview ile DeepSeek V4 Flash'ı seçtik.15 Switchyard ve OpenRouter Otomatik aynı listeyi aldı. Diğer beş router bu listeye bağlı tutulamadı (bkz. Kısaca her router).
OpenRouter Pareto Code'u da test ettik ancak sıralamaya katmadık. Kullanıcı üç katmandan birini seçer. Bir katman içinde, çağrıları mevcut en ucuz modele gönderir ve seçimini her tura uyarlamaz.
13 Kasım'da Pareto Code'un varsayılan katmanı tek bir model içeriyordu: Claude Fable 5.2. Seçtiğimiz Orta katmanda, Pareto Code tüm 3.083 çağrıyı Kimi K3'e gönderdi ve 1.000 soru başına 28,4 $ karşılığında %43,0 puan aldı.
İstatistikler
Puan grafiğindeki parantezler, 523 soru üzerinde bootstrap ile hesaplanmış bir %95 güven aralığını gösterir. Bu, bir puanın hangi soruların seçildiğine ne kadar bağlı olduğunu gösterir.
Aynı sorular üzerindeki iki sonucu karşılaştırmak için kesin McNemar testi kullandık. Bu test yalnızca bir sonucun doğru, diğerinin yanlış yaptığı soruları sayar. Birçok karşılaştırma yaptığımız için sonuçları %5 düzeyinde Holm yöntemiyle düzelttik. Test iki sonucu ayırmadığında, açıkça bir fark olmadığını söyleriz.
Örneğin, ortak havuzdaki Switchyard, GPT-6.1 Sol'dan 6.1 puan daha düşüktü ve açıkça bir fark yoktu. Sol ve Luna ile 5.0 puan daha düşüktü ve bu fark açıktı. Ortak havuzda Switchyard ve Sol, birinin doğru diğerinin yanlış olduğu 146 soruda ayrıştı. Sol ve Luna ile yalnızca 44 soruda ayrıştılar. Daha fazla soru ayrıştığında, bir farkı açıkça adlandırmadan önce farkın daha büyük olması gerekir.
GPT-6.1 Sol ile yapılan router karşılaştırmaları, router'larla aynı kurulumdan geçen %61,2 çalışmasını kullanır. Rastgele karışımlar ve diğer tekli model karşılaştırmaları, metinden-SQL'e kıyaslama testimizden Sol'un %61,4 çalışmasını kullanır. İlk grafikte GPT-6.1 Sol (metinden-SQL'e) olarak etiketlenmiştir. İki çalıştırma arasında açıkça bir fark yoktur.
Sınırlamalar
- Her router ve havuz için bir çalıştırma. GPT-6.1 Sol'un iki çalıştırmasında, 33 soru birinde doğru, diğerinde yanlıştı.
- Soru başına en fazla 10 model çağrısı içeren tek bir görev türü. Daha uzun ajan görevleri farklı sonuçlar verebilir.
- Model seçimleri tarihle değişir. Çalıştırmaları başladıktan dört gün sonra, 17 Kasım'da OpenRouter Otomatik, Otomatik Code ve Jev üzerinde 17 soruyu yeniden çalıştırdık. Router'lar, bu çalıştırmalarda görmediğimiz iki model seçti. Otomatik Code çağrılarının %63'ini bunlardan birine gönderdi.
- 10 çağrı sınırı, soruların %16,1'inde Sakana Fugu Max'i vurdu. Bunların tümünü doğru yanıtlamış olsaydı bile yine de GPT-6.1 Sol'un altında puan alırdı.
- Belirlediğimiz üç havuz dışındaki havuzlar farklı sonuçlar verebilir.
- Not Diamond'ın seçim ücreti, eski fiyatlandırma sayfasındaki oran olan seçim başına 0,001 $ kullanır. Güncel sayfası bunun yerine yönlendirilen milyon token başına 0,05 $ ücretlendirir.
- Sorular BIRD'ün herkese açık kümelerinden gelir; bu nedenle modeller bunları eğitimde görmüş olabilir.
 Tercih edilen kaynak olarak ekle
SSS'ler
Bir LLM router'ı, bir uygulama ile bir dizi model arasında yer alır ve her istek için bir model seçer. Amaç, kolay işleri ucuz bir modele, zor işleri güçlü bir modele göndermektir. Bir ajanda, bir soru birkaç çağrı gerektirir; bu nedenle bir router her çağrı için başka bir model seçebilir.
8 router arasında en yüksek puanı NVIDIA Switchyard aldı: %56,2. OpenRouter Otomatik Code %52,8, 19 modelli Not Diamond ise %50,9 puan aldı. Switchyard ile Otomatik Code arasında veya Otomatik Code ile Not Diamond arasında açıkça bir fark yoktur.
Ortak havuzda Not Diamond, varsayılan ayarında herhangi bir router'ın en yüksek puanı olan %59,3 puan aldı. Switchyard, bu havuzda %55,1 puan aldı ve Not Diamond'dan açıkça farklı değildi.
Bu testte hayır. 8 router'ın her biri GPT-6.1 Sol'dan açıkça daha düşük puan aldı.
Ortak havuzda Not Diamond, GPT-6.1 Sol'dan 1.9 puan, Switchyard ise 6.1 puan daha düşüktü. Testimiz bu farkları doğrulamadı.
Fireworks Nexus Otomatik, liste fiyatlarından hesaplanan en düşük maliyete sahipti: 1.000 soru başına 1,9 $. OpenRouter Otomatik 2,0 $ ve TypeSafe Jev 2,1 $ maliyete sahipti. Her biri neredeyse tüm çağrıları tek bir ucuz modele gönderdi: OpenRouter Otomatik ve TypeSafe Jev için Claude Haiku 5.5, Nexus Otomatik için GLM 5.3 Flash.
Not Diamond, ortak havuzda %59,3, 19 modelle ise %50,9 puan aldı. OpenRouter Otomatik, ortak havuzda %32,9, kendi havuzunda ise %28,7 puan aldı. Switchyard, GPT-6.1 Sol ve GPT-6 Luna ile %56,2, ortak havuzda ise %55,1 puan aldı; bu, açıkça fark olmayan 1.1 puanlık bir farktır.
İleri okuma
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{yila2026,
  author = {Yıla, Berkay},
  title  = {{LLM Router Karşılaştırması: 523 Ajan Veritabanı Görevinde 8 Router}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/llm-router}},
  note   = {AIMultiple. Erişim tarihi: 18 Kasım 2026}
}135 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 7 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Referans Linkleri





Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.