


OCR-Benchmark: Textextraktion / Erfassungsgenauigkeit
| Name | Category | Value |
|---|---|---|
| Nanonets-OCR2-3B | Average | 0.52 |
| PaddleOCR-VL | Average | 0.79 |
| Deepseek-OCR | Average | 0.81 |
| Mistral-OCR-2 | Average | 0.83 |
| Mistral-OCR-3 | Average | 0.85 |
| Claude-Sonnet-4.5 | Average | 0.86 |
| Moondream-OCR | Average | 0.87 |
| Amazon-Textract | Average | 0.87 |
| Dots-OCR | Average | 0.89 |
| Google-Vision | Average | 0.89 |
| Gemini-3-Pro | Average | 0.89 |
| GPT-5 | Average | 0.89 |
| Azure | Average | 0.9 |
| OlmOCR-2-7B | Average | 0.9 |
| Gemini-2.5-Pro | Average | 0.91 |
| Nanonets-OCR2-3B | Handwriting | 0.46 |
| Deepseek-OCR | Handwriting | 0.75 |
| Amazon-Textract | Handwriting | 0.81 |
| Claude-Sonnet-4.5 | Handwriting | 0.82 |
| Mistral-OCR-2 | Handwriting | 0.83 |
| Google-Vision | Handwriting | 0.86 |
| Gemini-3-Pro | Handwriting | 0.87 |
| PaddleOCR-VL | Handwriting | 0.87 |
| Dots-OCR | Handwriting | 0.89 |
| Azure | Handwriting | 0.89 |
| Mistral-OCR-3 | Handwriting | 0.9 |
| Moondream-OCR | Handwriting | 0.91 |
| Gemini-2.5-Pro | Handwriting | 0.93 |
| OlmOCR-2-7B | Handwriting | 0.94 |
| GPT-5 | Handwriting | 0.95 |
| Nanonets-OCR2-3B | Printed Media | 0.54 |
| PaddleOCR-VL | Printed Media | 0.63 |
| GPT-5 | Printed Media | 0.77 |
| Deepseek-OCR | Printed Media | 0.81 |
| OlmOCR-2-7B | Printed Media | 0.81 |
| Mistral-OCR-3 | Printed Media | 0.81 |
| Mistral-OCR-2 | Printed Media | 0.82 |
| Moondream-OCR | Printed Media | 0.82 |
| Amazon-Textract | Printed Media | 0.84 |
| Gemini-3-Pro | Printed Media | 0.84 |
| Dots-OCR | Printed Media | 0.84 |
| Azure | Printed Media | 0.84 |
| Claude-Sonnet-4.5 | Printed Media | 0.85 |
| Google-Vision | Printed Media | 0.85 |
| Gemini-2.5-Pro | Printed Media | 0.85 |
| Nanonets-OCR2-3B | Printed Text | 0.55 |
| Mistral-OCR-2 | Printed Text | 0.85 |
| Mistral-OCR-3 | Printed Text | 0.85 |
| Deepseek-OCR | Printed Text | 0.86 |
| PaddleOCR-VL | Printed Text | 0.87 |
| Moondream-OCR | Printed Text | 0.89 |
| Claude-Sonnet-4.5 | Printed Text | 0.92 |
| Dots-OCR | Printed Text | 0.94 |
| OlmOCR-2-7B | Printed Text | 0.94 |
| Amazon-Textract | Printed Text | 0.95 |
| Google-Vision | Printed Text | 0.95 |
| Gemini-3-Pro | Printed Text | 0.95 |
| Gemini-2.5-Pro | Printed Text | 0.95 |
| GPT-5 | Printed Text | 0.95 |
| Azure | Printed Text | 0.96 |
Die Genauigkeit von OCR ist für viele Dokumentverarbeitungsaufgaben entscheidend, und multimodale SOTA-LLMs bieten inzwischen eine Alternative zu OCR. Wir haben führende OCR-Dienste im DeltOCR Bench getestet, um ihre Genauigkeit bei verschiedenen Dokumenttypen zu ermitteln:
- Handschrift: GPT-5 (95 %) sticht als stärkster Performer hervor, dicht gefolgt von olmOCR-2-7B (94 %) und Gemini 2.5 Pro (93 %).
- Gedruckte Medien: Gemini 2.5 Pro, Google Vision und Claude Sonnet 4.5 führen diese Kategorie mit der höchsten Punktzahl (85 %) an
- Gedruckter Text: Microsoft Azure Document Intelligence API führt mit einem Wert von 96 %.
OCR-Benchmark: DeltOCR Bench
Die vollständigen Namen der oben genannten Produkte und ihrer Versionen mit Stand November 2025 sind unten aufgeführt. Unsere Studie umfasst sowohl leicht zugängliche API-Dienste als auch Lösungen, die eine On-Premises-Infrastruktur erfordern, und vergleicht wichtige Modelle am Markt in einer umfassenden Testumgebung.
- Handschrift:
- Genauigkeitsbereich: Eine breite Spanne von 46 % bis 95 %.
- Highlights: GPT-5 (95 %), olmOCR-2-7B (94 %) und Gemini 2.5 Pro (93 %) erzielen die höchste Leistung. Diese hohen Punktzahlen zeigen das außergewöhnliche Genauigkeitspotenzial multimodaler LLMs wie GPT-5 und Gemini 2.5 Pro in diesem Bereich.
- Empfehlung: Für die Erkennung hochkomplexer Handschriften werden die führenden LLM-Lösungen wie GPT-5 oder Gemini 2.5 Pro aufgrund ihrer API-Zugänglichkeit und einfachen Integration empfohlen.
- Gedruckte Medien:
- Genauigkeitsbereich: Eine Spanne von 54 % bis 85 %.
- Highlights: Lösungen wie Gemini 2.5 Pro, Google Vision und Claude Sonnet 4.5 teilen sich die höchste Punktzahl (85 %). Diese Kategorie ist äußerst wettbewerbsintensiv zwischen LLMs und traditionellen cloudbasierten OCR-Diensten (Azure, Dots OCR, Amazon Textract). GPT-5 hinkt in dieser Kategorie (77 %) anderen führenden LLMs hinterher.
- Empfehlung: Für Dokumente mit komplexen visuellen Layouts (mehrere Schriftarten, niedrige Auflösung usw.) werden LLMs wie Gemini 2.5 Pro oder cloudbasierte Dienste wie Google Vision oder Microsoft Azure Document Intelligence API empfohlen.
- Gedruckter Text:
- Genauigkeitsbereich: Eine hohe Spanne von 55 % bis 96 %, wobei die meisten führenden Lösungen Punktzahlen von 94 % und mehr erreichten.
- Highlights: Microsoft Azure Document Intelligence API (96 %) übernimmt die Führung, dicht gefolgt von Lösungen wie GPT-5, Gemini 2.5 Pro, Gemini 3 Pro Preview, Google Vision und Amazon Textract, die alle 95 % erreichen. Diese Kategorie ist ein Bereich, in dem alle SOTA-Lösungen extrem hohe Genauigkeitswerte erzielen.
- Empfehlung: Für einfache gedruckte Texte mit hohen Genauigkeitsanforderungen können etablierte Cloud-Lösungen wie Microsoft Azure Document Intelligence API oder Google Vision oder punktstarke LLMs (Gemini/GPT-5) bedenkenlos eingesetzt werden.
API-Lösungen
Die folgenden Modelle wurden aufgrund ihrer einfachen Zugänglichkeit und Leistung in unsere Benchmarking-Liste aufgenommen.
- Claude Sonnet 4.5
- OpenAI GPT-5
- Gemini 2.5 Pro
- Gemini 3 Pro Preview
- Amazon Textract API
- Google Cloud Vision API
- Microsoft Azure Document Intelligence API
- Moondream OCR
- Mistral OCR 3
- Mistral OCR 2
Microsoft Azure Document Intelligence API ist Teil der Azure Cognitive Services-Familie.
Lokal bereitgestellte Modelle
Das Testen dieser Modelle ist aufgrund von Installation, Abhängigkeitsverwaltung und Hardware-Anforderungen schwieriger als bei API-Lösungen. Alle lokalen Tests wurden in einer dedizierten Serverumgebung durchgeführt.
- olmOCR-2-7B
- PaddleOCR-VL
- Nanonets-OCR2-3B
- Deepseek-OCR
- Dots-OCR
Wir haben die Genauigkeit der Ergebnisse als Kosinus-Ähnlichkeitswert für gedruckten Text, gedruckte Medien und Handschrift berechnet. Jeder im Diagramm sichtbare Wert stellt die Leistung des entsprechenden Modells in dieser Kategorie dar.
Während unserer Tests haben wir beobachtet, dass das Modell Nanonets-OCR2-3B im Benchmark die schwächste Leistung erbrachte und die niedrigsten Punktzahlen erzielte. Generell stellten wir fest, dass einige Modelle insbesondere mit kursiver Handschrift und unübersichtlichen Textlayouts (gemischte Zeilenreihenfolge, uneinheitliche Großschreibung) Probleme hatten. Ähnliche Leistungsprobleme traten auch in der Kategorie gedruckte Medien auf, insbesondere bei Bildern mit niedriger Auflösung und solchen, die mehrere Schriftarten enthalten.
Dataset
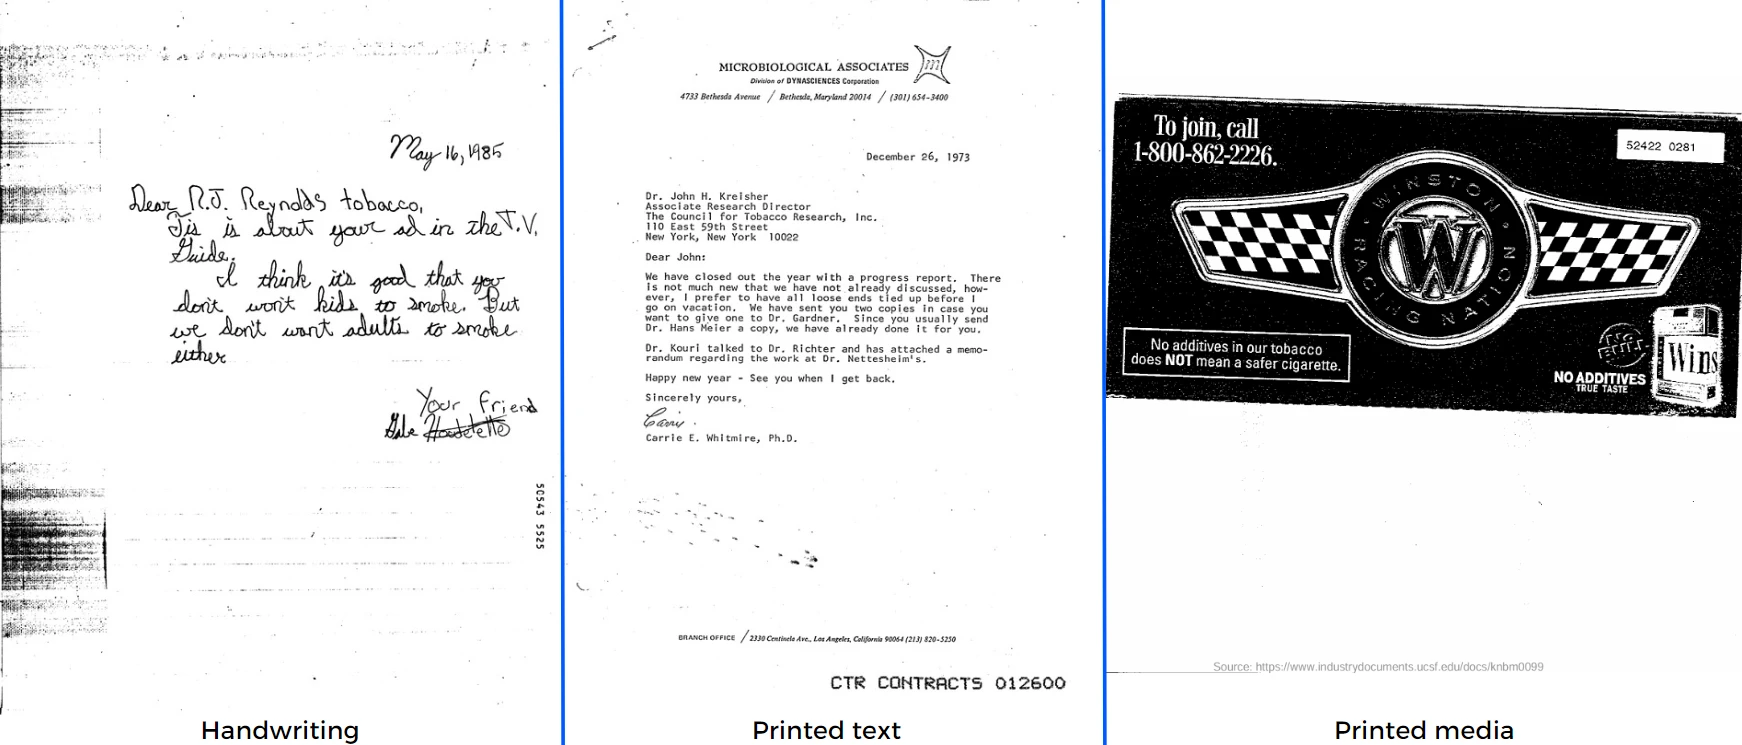
In diesem Benchmark verwendeten wir insgesamt 300 Dokumente, mit 100 Dokumenten pro Kategorie über 3 Kategorien hinweg:
Gedruckter Text umfasst Briefe, Website-Screenshots, E-Mails, Berichte usw.
Gedruckte Medien umfassen Poster, Buchumschläge, Werbung usw. Wir wollten den Erfolg der OCR-Tools bei unterschiedlichen Textschriften und -platzierungen untersuchen.
Files in diesen 2 Kategorien stammten aus der Industry Documents Library (IDL).1
Handschrift: In der Kategorie Handschrift haben wir, da einige IDL-Dokumente nicht leicht lesbar waren, Dokumente erstellt, die den IDL-Dokumenten ähneln. Wir haben manuell Proben von für Menschen lesbarer Handschrift vorbereitet. Alle Proben waren in kursiver Handschrift verfasst.
Methodik des DeltOCR Bench
Dieser Benchmark konzentriert sich auf die Textextraktionsgenauigkeit der Produkte.
Die Vorverarbeitung wird nur für die Kategorie Handschrift durchgeführt. Wir haben Bilder von handschriftlichen Dokumenten mit unseren Smartphones aufgenommen und eine mobile Scanner-App verwendet:
- Die Bilder wurden in Schwarzweiß umgewandelt
- Der Kontrast wurde erhöht und der Hintergrund entfernt.
OCR: Wir haben alle Produkte auf demselben Dataset ausgeführt und Textausgaben als Rohtextdateien (.txt) erzeugt. Anschließend haben wir die Ground Truth manuell erstellt, die den korrekten Text in all diesen Dateien enthält. Die Ground Truth wurde zweimal von Menschen überprüft.
Vergleich: Wir haben die Genauigkeit der OCR-Lösungen gemessen, indem wir ihre Ausgaben mit den Originaltexten verglichen haben. Zu diesem Zweck verwendeten wir das Sentence-BERT (SBERT)-Framework, um Kosinus-Ähnlichkeitswerte zu berechnen. Im Benchmark verwendeten wir das leistungsstarke mehrsprachige Paraphrasenmodell MiniLM-L12-v2, um den Ähnlichkeitswert zwischen der Ausgabe jedes Produkts und den Ground-Truth-Texten zu berechnen. Dieser Wert repräsentiert das Niveau der Textgenauigkeit.
Die Ähnlichkeitsfunktion verwendet eine Kosinus-Distanzmetrik, um die Ähnlichkeit zwischen zwei Texten zu berechnen. Wir haben für diesen Benchmark keine Levenshtein-Distanz verwendet, da verschiedene Produkte Texte in unterschiedlicher Reihenfolge ausgeben.2
Während die Levenshtein-Distanz diese Unterschiede berücksichtigt, suchen wir nur danach, wie genau der Text erkannt wird, nicht aber, wo er sich befindet. Die Kosinus-Distanz verursacht für solche Fälle vernachlässigbare Abzüge, daher haben wir uns entschieden, sie in diesem Benchmark zu verwenden.
Produktauswahl
Es gibt viele OCR-Produkte auf dem Markt. Wir müssen uns auf diejenigen konzentrieren, die Rohtextergebnisse ausgeben können. Die Produkte für diesen Benchmark wurden auf der Grundlage folgender Kriterien ausgewählt:
- Fähigkeit, Text zu extracten. Wir haben in diesen Vergleich keine Lösungen aufgenommen, die nur maschinenlesbare (d. h. strukturierte) Daten extracten.
- Ihre Beliebtheit auf dem Markt
Dies ist keine umfassende Marktübersicht, und wir haben möglicherweise einige Produkte mit erheblichen Fähigkeiten ausgeschlossen. Wenn das der Fall ist, hinterlassen Sie bitte einen Kommentar, und wir erweitern den Benchmark gerne.
Einschränkungen
Erweiterte Fähigkeiten wie Textlokalisierung, Schlüssel-Wert-Paarung und Dokumentenklassifizierung wurden in diesem Benchmark nicht bewertet.
Der Stichprobenumfang wird in der nächsten Iteration erhöht. Wenn Sie OCR für Handschrift suchen, lesen Sie unseren Handschrift-OCR-Benchmark mit 50 Proben.
FAQs
Optische Zeichenerkennung (OCR) ist ein Bereich des maschinellen Lernens, der sich auf die Unterscheidung von Zeichen in Bildern wie gescannten Dokumenten, gedruckten Büchern oder Fotos spezialisiert hat. Obwohl es sich um eine ausgereifte Technologie handelt, gibt es noch keine OCR-Produkte, die alle Arten von Text mit 100 % Genauigkeit erkennen können. Unter den Produkten, die wir getestet haben, konnten nur wenige Produkte erfolgreiche Ergebnisse aus unserem Testset liefern.
OCR-Tools werden von Unternehmen verwendet, um Texte und ihre Positionen in Bildern zu identifizieren, Geschäftsdokumente nach Themen zu klassifizieren oder Schlüssel-Wert-Paarungen innerhalb von Dokumenten durchzuführen. Basierend auf OCR-Ergebnissen erstellen andere Technologieunternehmen Anwendungen wie Dokumentenautomatisierung. Für all diese Geschäftsfälle ist eine genaue Texterkennung für ein OCR-Produkt entscheidend.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{alper2026,
  author = {Alper, Şevval},
  title  = {{OCR-Benchmark: Textextraktion / Erfassungsgenauigkeit}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/ocr-accuracy}},
  note   = {AIMultiple. Abgerufen am 29. Juli 2026}
}Ergebnisse und Zeitstempel von 60 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 4 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
9 AktualisierungenAzure Cognitive Service wurde im Abschnitt „Highlights“ durch Microsoft Azure Document Intelligence API ersetzt.
Referenzlinks
Şevval konzentriert sich auf KI-Programmierwerkzeuge, KI-Agenten und Quantentechnologien.




Kommentare 8
Teilen Sie Ihre Gedanken
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.
Did you ever think of oncluding multimodal llms in your comparison, like gpt4o, llama 3.2. gemini, claude etc.?
Hi Serhat and thank you for your comment, Yes, we added those for which we have API access like Claude and GPT-4o.
Just stumbled on this milestone assessment update. Could you kindly elaborate further on the three revised datasets: Thanks for this work. Character Sets When someone refers to 'handriting', that can mean many things: 'handwriting style' typefaces (per Docusign, etc.), and hand-printed (block printing and mixed-case printing) as often found in combs and box delineators, and finally, cursive or longhand writing (exclusive of signatures). Character Context Structured content, semi-structured content, and unstructured content. Image Qualities (bitonal, greyscale, full colour, spatial dpi, from a scanner/cell-phone/native rendering, image 'enhancements' prior to OCR (thickening, local gamma, background dropout, sharpening, smoothing, noise removal, etc.) These can have significant impacts, and some don't realize the importance of including these benchmark differentiators.
Hi there, thank you for the detailed comment, we are updating the article to include these details.
Hello, great work! Just curious, did you use a trained Tesseract when making these testing?
Hi, Webster. Glad you enjoyed the article. The tools we tested were: ABBYY FineReader 15 Amazon Textract Google Cloud Platform Vision API Microsoft Azure Computer Vision API Tesseract OCR Engine Hope this answers your question.
The graph images are not working for me at the moment. Otherwise great
Thank you Bobby! We have a glitch in the CMS and we are fixing it. Apologies for the issue, it should be fixed next week.
Thanks for sharing, can you add a free OCR for everyone to use? https://www.geekersoft.com/ocr-online.html
Hi Samsun, unfortunately, we don't share all OCR providers on this page, there are thousands of them. We tried to put together the largest ones in terms of market presence. If you have evidence that your solution is one of the top 10 globally, please share it with us at info@aimultiple.com so we can consider it.
What version of Tesseract did you test with? They recently released v5.
Hi Scott, we did the benchmarking before Tesseract 5. We will redo it soon and include the versions in the methodology section as well.
This is very informative, nice work. I assume your tests used documents/images in English? I've been experimenting with OCR tools on other languages and finding relatively poor accuracy.
Exactly, all text were in English. I hear similar things about OCR on non-Latin characters. We have an Arabic speaker in the team who claims that accuracy in Arabic is much lower compared to English. We can do a benchmark on non-Latin characters if there is demand for it.
interesting post!!! do you have any suggestion about improving accuracy on scanned image ? i'm using tesseract right now. anyway , great work!
Thank you for the comment. There are pre-processing approaches that can be implemented to improve image quality. But such approaches may already be used in Tesseract. A detailed research into Tesseract image processing would be helpful in your case.