


I migliori strumenti IA di web scraping messi a confronto

I siti cambiano layout e i campi che ti servono da una pagina variano nel tempo. Questi cambiamenti rompono gli scraper codificati manualmente. Gli scraper IA possono essere aggiornati con semplici prompt e alcuni possono riparare uno scraper salvato quando il sito cambia.
Abbiamo confrontato i migliori strumenti di web scraping IA sui primi 10 domini e-commerce per valutarne le prestazioni e abbiamo anche confrontato il modo in cui ciascuno sfrutta l'IA.
La classifica si basa sul tasso di successo per i fornitori sottoposti a benchmark e sulla copertura delle funzionalità per gli altri.
Benchmark degli strumenti IA di web scraping
Ogni fornitore adotta un approccio diverso all'IA e il nostro obiettivo era confrontare questi approcci e i compromessi che comportano. Per maggiori dettagli sul processo di test, consulta la sezione metodologia del benchmark.
I dati su prezzi e valute sono stati estratti dai primi 10 siti di e-commerce al mondo.
Risultati principali sugli strumenti IA di web scraping dal benchmark
- I fallimenti si presentano come dati. Quando uno strumento non riesce a leggere un prezzo, spesso perché la pagina ha incontrato un muro anti-bot, la risposta può tornare come 0 invece che come errore. Un valore null può essere ritentato o saltato; uno 0 passa la validazione inosservato. Per esempio, Apify e Oxylabs hanno restituito null in questi casi e la documentazione di Firecrawl consiglia di aggiungere “Restituisci null se non trovato nella pagina” a ogni campo dello schema, così il modello non ipotizza un valore.
- Campi extra arrivano senza invito. Chiedi prezzo e valuta e potresti ricevere anche brand, descrizione o URL delle immagini. Uno schema limita la risposta ai campi che indichi. Per esempio, Bright Data ti consente di bloccare lo schema di output in fase di creazione, così la stessa struttura torna a ogni chiamata.
- Viene estratto l'elemento sbagliato. Prezzo scontato rispetto a quello originale, prezzo con o senza tasse, varianti regionali: lo strumento potrebbe prendere il numero che non volevi.
- I numeri slittano. Gli strumenti da prompt a JSON possono aggiungere decimali, troncare valori o restituire approssimazioni convertite in valuta che non compaiono da nessuna parte nella pagina.
- La localizzazione cambia la risposta. Alcuni siti applicano prezzi in base al geo-IP, quindi un fornitore su proxy statunitensi vede un numero diverso da quello che vede un utente europeo.
Lo schema e la regione dei proxy sono i parametri che ti permettono di individuare la maggior parte di questi problemi prima che raggiungano i tuoi dati.
Prezzi degli strumenti IA di web scraping
Kadoa non pubblica tariffe, offrendo un piano Flex basato sul consumo e un piano Enterprise con vendita diretta.
Confronto degli strumenti IA di web scraping
Tempo per il primo scraper: Per gli strumenti che creano uno scraper che poi chiami tramite ID, quanto richiede la configurazione. “Singola chiamata HTTP” significa che non esiste alcun passaggio di creazione.
Schema di output definito dall'utente: Indica se puoi impostare i campi di output e i relativi tipi prima dell'esecuzione dello scraping, invece di descriverli in un prompt e lasciare che l'LLM decida la struttura a runtime.
Endpoint crea una volta, chiama molte volte: Indica se lo scraper viene creato una sola volta, archiviato lato fornitore e poi chiamato semplicemente con un URL. Qui l'LLM (o, per gli strumenti basati su registrazione, il tuo click-through) viene eseguito al momento della creazione e il suo output viene congelato in uno scraper che possiedi e che puoi modificare sul posto, ovvero ciò a cui si collegano pianificazioni, webhook e integrazioni. Dove questo manca, l'estrazione viene ricalcolata a ogni chiamata e l'intera definizione viaggia con ogni richiesta.
Scraper salvato auto-riparante: Indica se uno scraper salvato viene riparato quando il sito di destinazione cambia, senza ricostruirlo da zero. La correzione si applica allo stesso scraper archiviato con il suo identificatore esistente, così trigger, pianificazioni e integrazioni continuano a funzionare.
* Kadoa archivia lo scraper e lo chiama tramite ID, ma gli URL di destinazione vengono vincolati quando si crea il flusso di lavoro. Puntarlo a un nuovo URL richiede un aggiornamento separato dei metadati prima dell'esecuzione.
Gli strumenti che eseguono un LLM sulla pagina a ogni chiamata non vengono conteggiati qui: non esiste una logica di estrazione persistente da riparare, il che li rende tolleranti ai cambiamenti di layout, ma significa anche che non c'è alcun artefatto da ispezionare, versionare o approvare. Né lo sono le cache interne prive di un identificatore a cui puoi puntare, poiché anche in questo caso non c'è nulla da ispezionare, versionare o approvare.
Oltre a problemi come il continuo cambiamento delle pagine, nelle pipeline agentiche spesso serve una semplice API che puoi chiamare: fornisci un URL e ricevi dati strutturati. Ma non sempre trovi una API scraper già pronta per ogni dominio di cui hai bisogno regolarmente; e quando la trovi, i campi che vuoi potrebbero non esserci, oppure devi personalizzare lo schema in base alle tue esigenze. Esistono diversi approcci per affrontare questi problemi.
Piattaforme IA di web scraping crea una volta, chiama molte volte
Se crei il tuo scraper, devi scrivere il crawler, configurare i proxy, eseguire browser headless e gestire code, tentativi e anti-bot da solo.
L'IA è entrata nello scraping per ridurre il lavoro manuale e semplificare la configurazione. È coinvolta nella maggior parte di questi strumenti, ma ogni fornitore la utilizza in modo diverso e risponde a esigenze differenti.
Bright Data Scraper Studio offre un approccio in due fasi: crei lo scraper per qualsiasi URL con un prompt e poi lo chiami come una API stabile. Lo configuri una volta e da allora in poi ti basta passare gli URL.
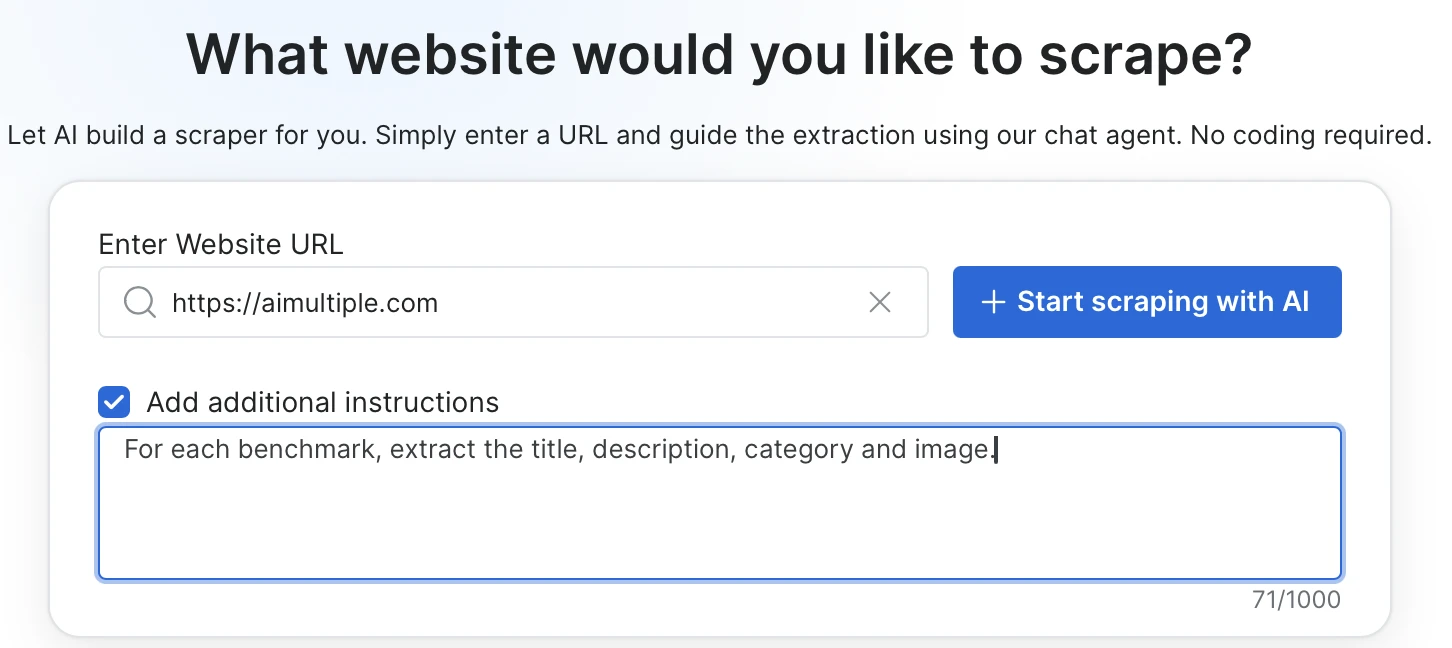
Descrivi in linguaggio naturale i campi che vuoi estrarre e puoi opzionalmente aggiungere selettori CSS, azioni richieste sulla pagina o comportamento di caricamento della pagina.
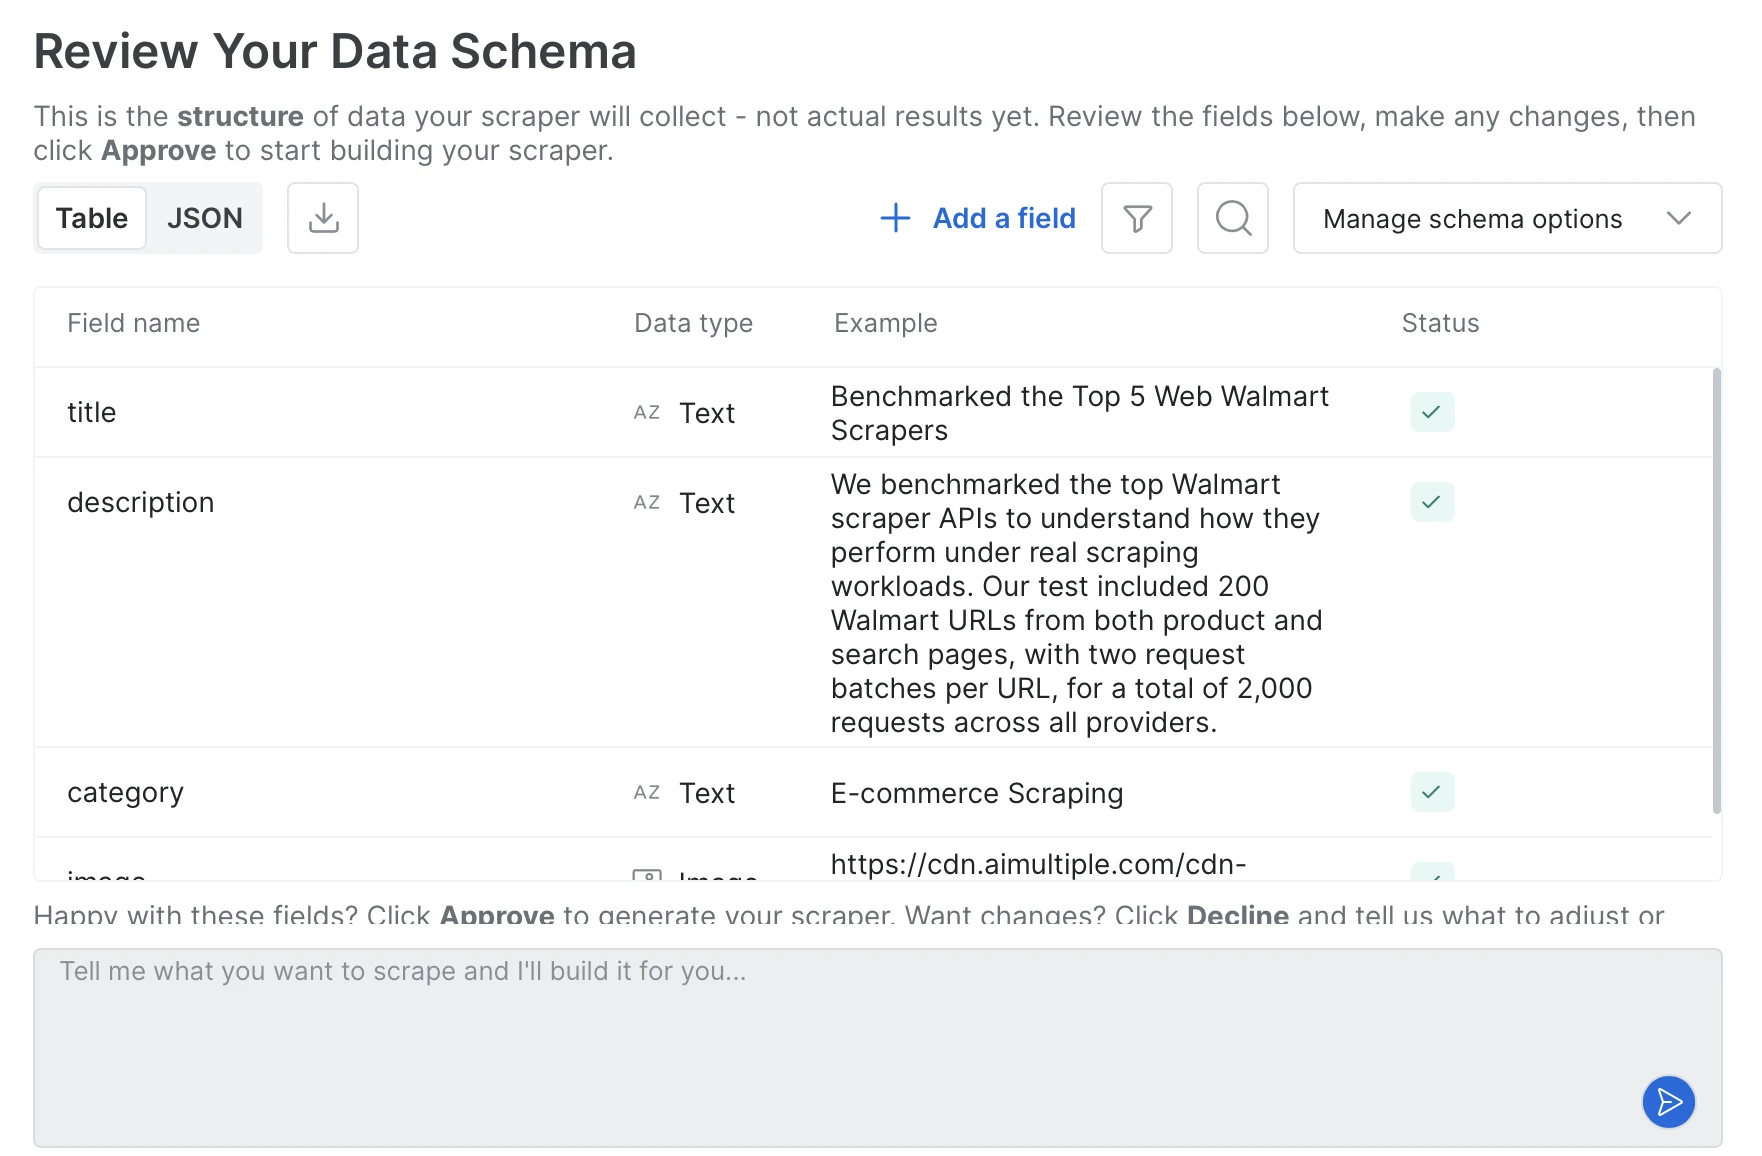
L'agente genera lo schema di output dal prompt; lo approvi aggiungendo o rimuovendo campi o modificando i tipi, e poi viene scritto il codice dello scraper.
- Endpoint crea una volta, chiama molte volte: Una volta approvato lo schema, lo scraper viene registrato come endpoint di lunga durata con un identificatore fisso. Ogni chiamata raggiunge lo stesso endpoint con un semplice URL e lo schema di output rimane identico a ogni chiamata. Nei nostri test, la creazione di uno scraper dedicato ha richiesto in media circa 10 minuti.
- Due metodi di creazione: Puoi chattare con l'agente nel browser oppure usare la CLI di Bright Data per creare lo scraper dal terminale con un solo comando che accetta un URL e un prompt. Entrambi producono lo stesso scraper.
- Flusso di lavoro con coding agent: I comandi da terminale girano invariati in Claude Code, Cursor e Codex, così l'agente può creare, eseguire o auto-riparare uno scraper senza uscire dall'editor. Puoi anche fissare l'identificatore dello scraper nel file delle regole dell'agente, così le sessioni future lo riutilizzano. I risultati possono essere consegnati tramite API, SDK, CLI, webhook o direttamente nello storage cloud su S3, GCS, Azure o OSS.
- Combinazione con scraper già pronti: Bright Data mantiene una libreria di scraper pronti per siti popolari come Amazon, LinkedIn e Zillow.
- Scraper salvato auto-riparante: Quando il sito cambia e lo scraper si rompe, descrivi in linguaggio naturale cosa si è rotto; l'IA produce una correzione e la mostra con un output di esempio, e nulla viene pubblicato finché non approvi. Poiché l'identificatore dello scraper non cambia, ogni trigger, pianificazione e integrazione collegata continua a funzionare.
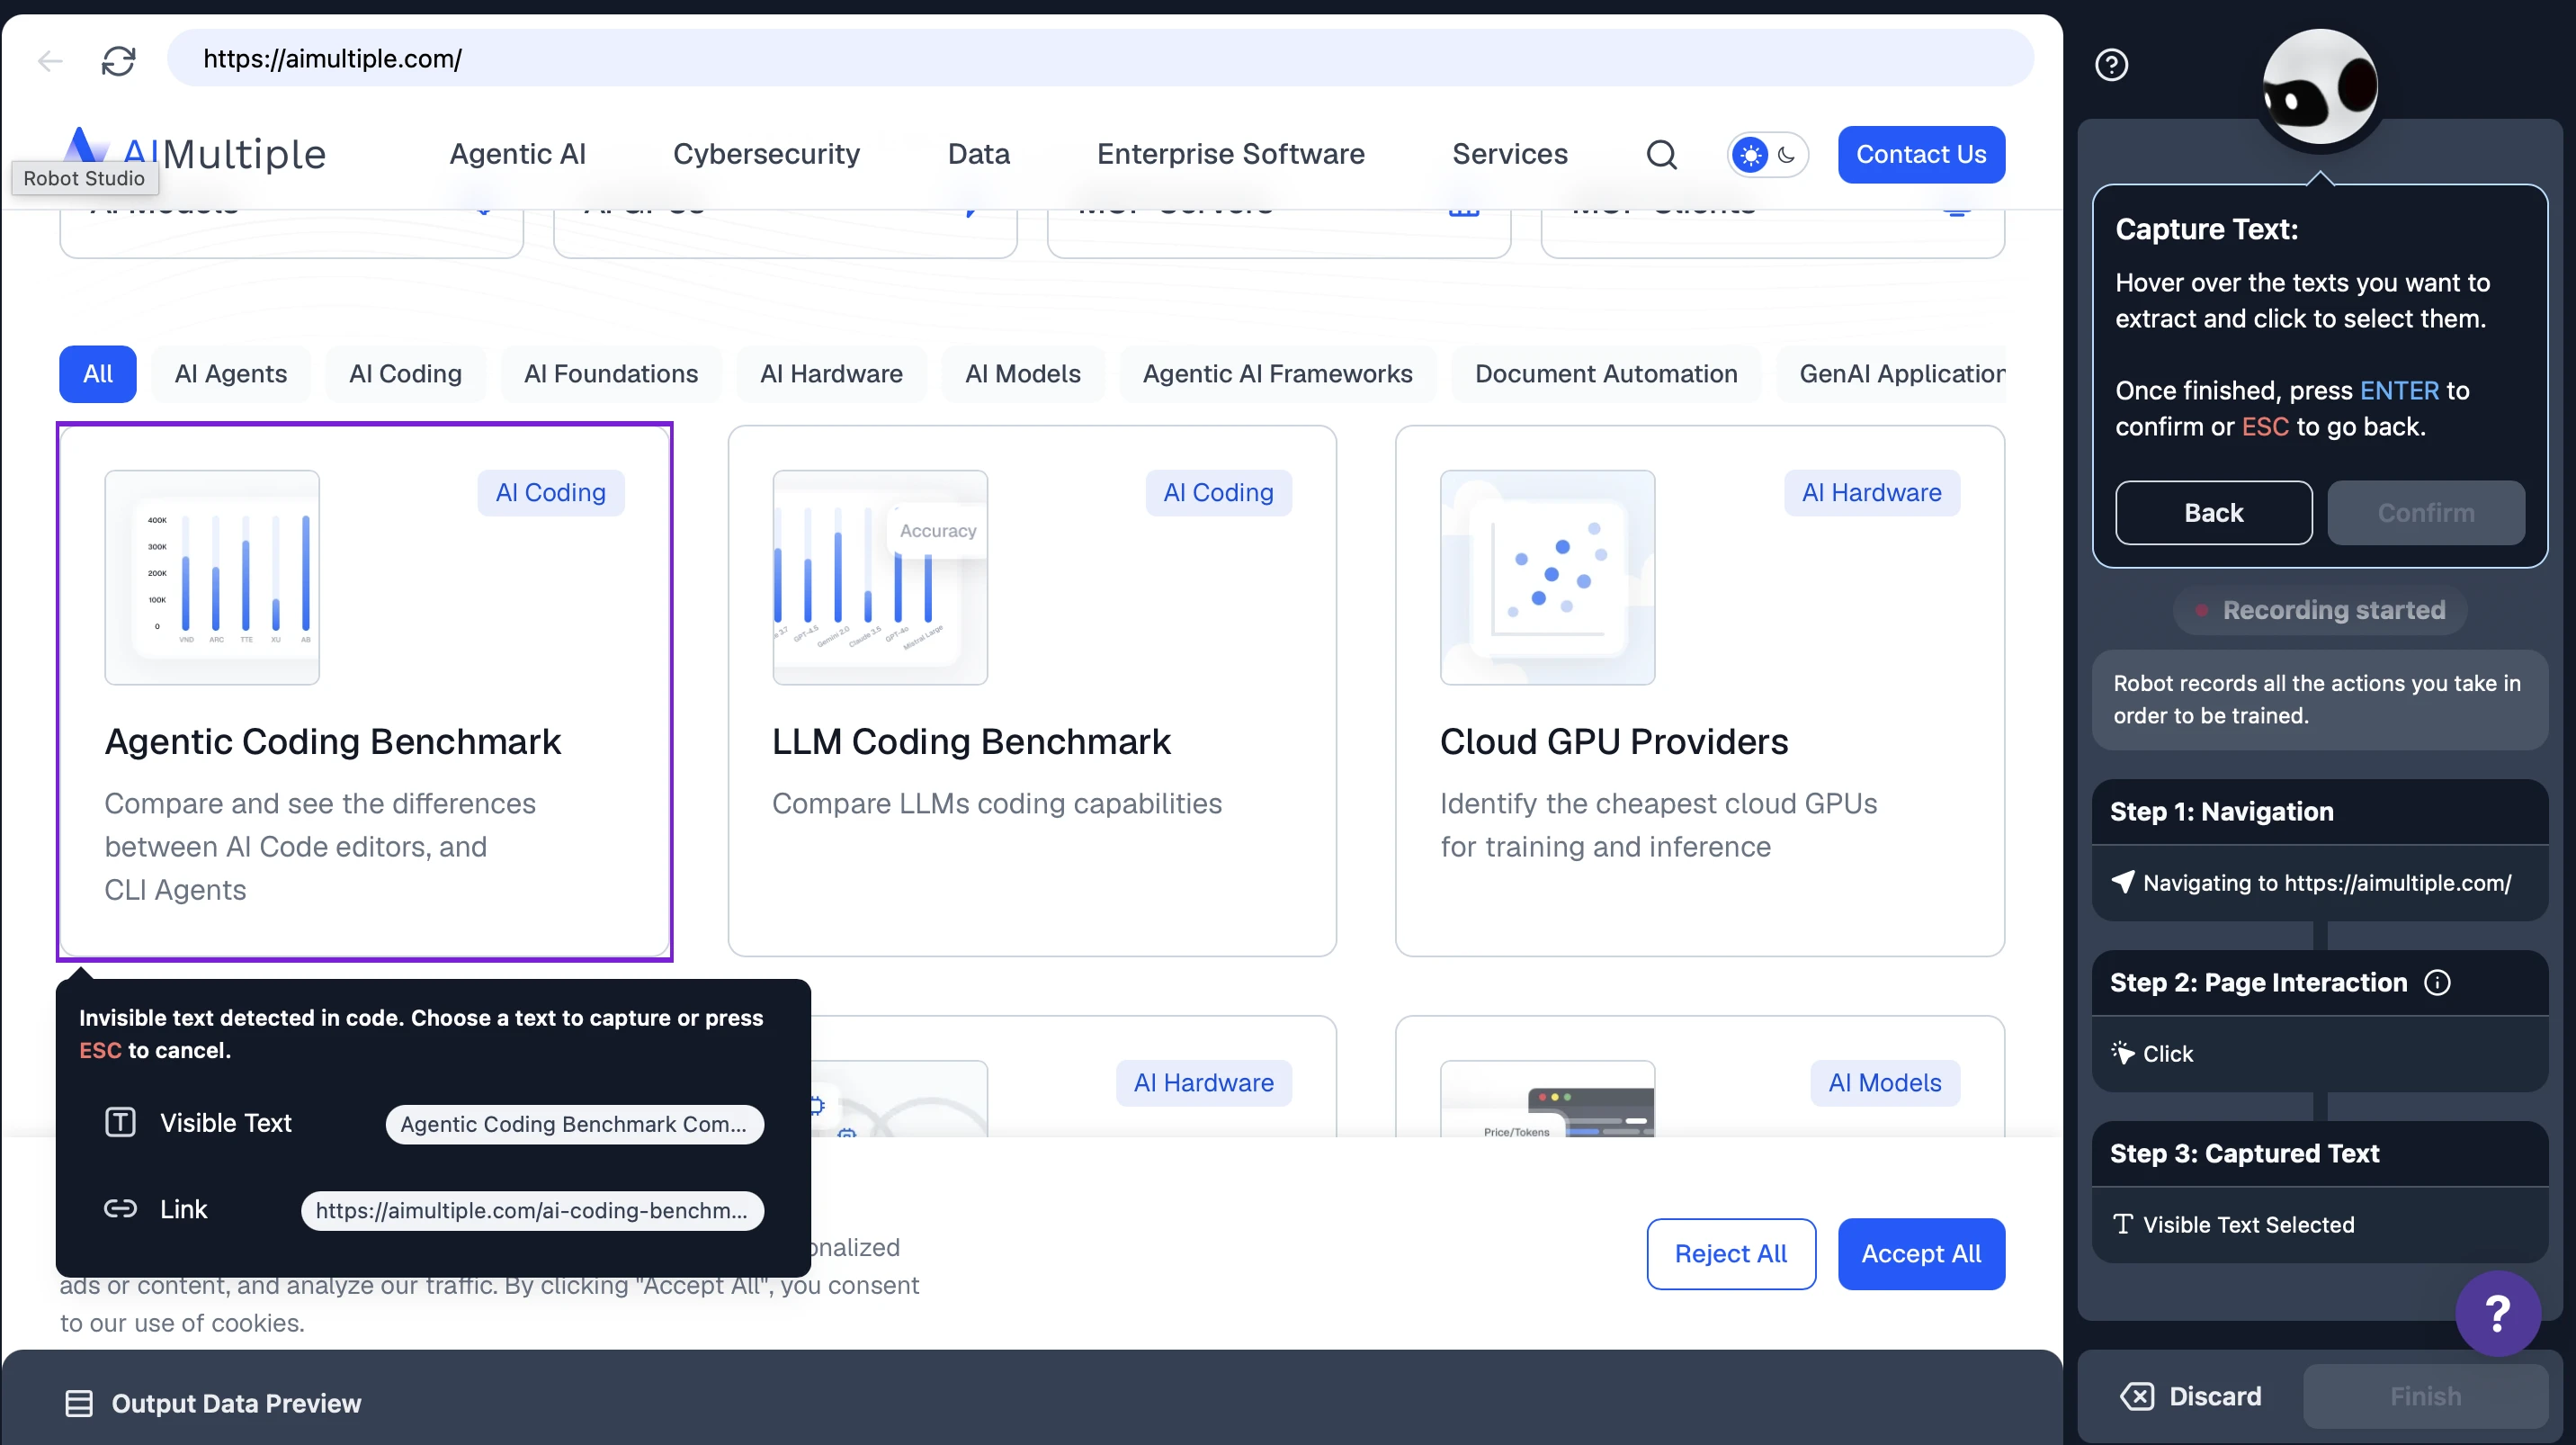
Con Browse IA crei ancora lo scraper da solo, ma la configurazione è visiva: vai alla pagina di destinazione e fai clic per contrassegnare i campi da acquisire, e il robot salva i passaggi di navigazione e i campi selezionati come registrazione. Quella registrazione viene poi eseguita ripetutamente; quando la pagina cambia, il robot si adatta da solo nella maggior parte dei casi e viene riaddestrato quando non riesce.
- Configurazione visiva con Robot Studio: Gli scraper vengono creati con un flusso clic → acquisisci campo → salva.
- Monitoraggio e avvisi integrati: Pianificazioni orarie, giornaliere o settimanali + rilevamento dei cambiamenti + avvisi email/webhook nello stesso prodotto.
- Lo schema si forma dai campi acquisiti: Per ogni campo viene aggiunto un passaggio di acquisizione separato; nessun passaggio da prompt a schema.
- Adattamento automatico: Il motore di Browse IA adatta il codice di scraping quando un sito cambia e la maggior parte dei robot continua a funzionare senza interventi. Quando l'adattamento non basta, riaddestri il robot, preservando cronologia, esecuzioni e flussi di lavoro.
Anche Kadoa crea lo scraper da un prompt, ma vincola gli URL di destinazione quando viene creato il flusso di lavoro invece di accettarli a ogni chiamata. Ciò che archivia è codice generato anziché un prompt, quindi c'è un artefatto concreto da monitorare e riparare.
- Endpoint crea una volta, chiama molte volte: Un flusso di lavoro salvato riceve un ID persistente e viene chiamato con
PUT /v4/workflows/{id}/run. La richiesta trasporta solo variabili e un limite di righe; lo schema e il codice di estrazione restano lato Kadoa. Puntare lo stesso flusso di lavoro a un URL diverso richiede prima l'aggiornamento dei metadati, quindi non è una singola chiamata con un URL all'interno. - Da prompt a schema tipizzato: Descrivi i dati nel prompt di configurazione e Kadoa propone uno schema che puoi modificare in una vista visiva o JSON. I campi hanno tipi come STRING, NUMBER, MONEY, DATE e LINK e possono essere contrassegnati come chiavi.
- Scraper salvato auto-riparante: La riparazione viene attivata da un'esecuzione non riuscita anziché da una pianificazione. Kadoa rigenera il codice di estrazione e lo convalida rispetto ai dati estratti in precedenza, con lo stesso ID del flusso di lavoro, così pianificazioni e integrazioni continuano a funzionare. Non c'è alcun passaggio di approvazione prima che la correzione vada in produzione. Quando il ripristino automatico fallisce, viene aperto un ticket per il team operativo di Kadoa.
- Flusso di lavoro con coding agent: Un server MCP ospitato con oltre 40 strumenti, più SDK Node e Python proprietari e una CLI (
kadoa create,kadoa run,kadoa export). - Consegna: API, SDK, CLI, MCP e Google Sheets per il pull; S3, GCS, Blob di Azure, webhook, WebSocket, email e Slack per il push; Snowflake e Databricks per la condivisione. I connettori di archiviazione cloud vengono configurati tramite supporto, non in autonomia.
API di estrazione IA one-shot
Oxylabs IA Studio è una suite di cinque applicazioni IA distinte sotto un unico SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch e AiMap. Nulla viene persistito lato server; ogni chiamata di scraping esegue una nuova acquisizione più l'estrazione tramite LLM.
- Flusso di AiScraper: generate_schema(prompt=…) chiama facoltativamente l'LLM per produrre uno schema JSON, poi scrape(url, schema) recupera la pagina ed esegue l'estrazione tramite LLM. Puoi conservare e riutilizzare lo schema dalla tua parte, ma il server non registra uno scraper di lunga durata.
- Cinque applicazioni, un unico SDK: AiScraper per l'estrazione strutturata da singolo URL, AiCrawler per l'attraversamento del sito guidato da prompt, BrowserAgent per le azioni sulla pagina, AiSearch per la ricerca in linguaggio naturale più estrazione e AiMap per mappe URL filtrate di un sito.
- Formati di output: markdown (predefinito), json, csv, toon (un formato ottimizzato per i token), screenshot e html (solo agente browser).
- Schemi scritti a mano:
generate_schemaè facoltativo. Il parametroschemaaccetta qualsiasi schema JSON che scrivi, e gli stessi esempi di Oxylabs passano un modello Pydantic scritto a mano. Uno schema è obbligatorio per l'output JSON, CSV e TOON. - Parametri degni di nota: render_javascript=”auto” consente al servizio di decidere se è necessario il rendering JS, geo_location accetta un codice paese ISO o un nome per la posizione del proxy e max_credits imposta un limite di spesa per richiesta.
Apify offre un ecosistema aperto per sviluppatori in cui gli “Actor”, programmi eseguibili di scraping e automazione, vengono creati ed eseguiti sulla sua piattaforma. Puoi scrivere il tuo Actor da zero, partire da un modello pronto o usare Actor pubblicati da altri nello Store di Apify.
- Actor di estrazione IA: Apify dispone anche di un Actor pronto all'uso, apify/ai-web-scraper, che accetta un prompt in linguaggio naturale e restituisce JSON strutturato da qualsiasi URL. Reinserisci il prompt a ogni esecuzione e l'output JSON non è garantito rimanere coerente tra le chiamate, un comportamento comune per gli strumenti guidati da prompt.
- Solo prompt: L'input dell'Actor ha cinque campi:
startUrls,extractionMode,prompt,maxPagesToVisitemaxCrawlDepth. Non esiste un parametro per uno schema di output definito dall'utente. - Crea il tuo actor: Se non esiste uno scraper pronto per il sito di destinazione o se nessuno di essi estrae i campi dati che vuoi, scrivi il tuo Actor e decidi quali campi estrarre, dove si trovano nella pagina e come gestire il resto. Quanto tempo richiede dipende dalle tue competenze di programmazione e dalla complessità del sito. Se preferisci non realizzarlo da solo, puoi anche ricevere aiuto dai servizi professionali di Apify.
- Combinazione con scraper già pronti: Un marketplace in cui gli sviluppatori pubblicano i propri Actor. Gli scraper per i siti popolari sono per lo più pubblicati e mantenuti da terze parti.
- Servizi della piattaforma: Gli Actor includono pianificazione, monitoraggio, archiviazione di dataset, pool di proxy e accesso API pronti all'uso.
- Accesso agli agent, non creazione da parte degli agent: Il server MCP di Apify consente a un coding agent di cercare ed eseguire Actor, ma non esiste un flusso integrato per creare o mantenere un Actor dall'interno dell'agente.
- Proprietà della manutenzione: Se hai creato tu l'Actor, lo ripari quando il sito cambia. Se ne usi uno dallo Store, aspetti che il proprietario dell'Actor rilasci la correzione secondo i suoi tempi.
Firecrawl trasforma un URL più un prompt o uno schema JSON in JSON in un'unica chiamata sincrona. Ogni richiesta esegue la pipeline di estrazione nel momento in cui viene effettuata la chiamata.
- Prompt o schema: Uno schema fissa i nomi e i tipi dei campi prima della chiamata, così la risposta contiene solo i campi che hai indicato. Un prompt lascia la struttura al modello, è più rapido da scrivere ma può variare tra le chiamate.
- Formati per tipo di pagina:
product,menu,branding,audioevideorestituiscono una struttura fissa definita da Firecrawl.productcopre titolo, prezzo, disponibilità, varianti e prezzo di vendita. Non accettano parametri e vengono eseguiti senza un LLM. deterministicJson: Accetta uno schema e memorizza nella cache un estrattore generato per ciascun sito, così le estrazioni ripetute saltano l'LLM. Non può essere combinato con il formatojson.- Esecuzione per singola richiesta: Ogni chiamata porta con sé il proprio prompt o schema e viene eseguita al momento della richiesta, così l'output riflette la pagina come appare in quel momento e non c'è nulla da registrare in anticipo.
- Supporto per coding agent: Server MCP ufficiale e CLI, con guide rapide per Claude Code, Cursor, Codex CLI e Gemini CLI, oltre a un plugin ufficiale per Claude.
- Agent: Firecrawl offre anche un prodotto Agent in cui l'URL è facoltativo. Descrivi ciò che vuoi e l'agente naviga nel web per trovarlo.
ScrapingBee utilizza lo stesso modello a chiamata singola e senza stato di Firecrawl. La differenza sta nel modo in cui descrivi ciò che vuoi.
- Tre modalità di estrazione: ai_query per un singolo campo in linguaggio naturale (restituisce una stringa), ai_extract_rules per uno schema JSON in cui ogni campo ha una propria descrizione e una forma avanzata dello stesso con tipi, enum e output annidato.
- ai_selector: Passa un selettore CSS per concentrare l'LLM su una parte specifica della pagina. Più veloce e preciso che lasciargli leggere l'intero DOM.
- Scraping classico nella stessa chiamata: render_js per siti con molto JS, screenshot, extract_rules per l'estrazione CSS/XPath senza IA e json_response per ottenere HTML, cookie, XHR e iframe in un'unica risposta.
Come scegliere lo strumento giusto per la tua pipeline?
In pratica, lo strumento giusto dipende meno dagli elenchi di funzionalità e più da ciò che la tua pipeline fa con i dati nel tempo. Vale la pena tenere a mente alcuni schemi:
Scraping occasionale o una tantum
Se ti servono dati da un URL una sola volta e per te va bene descriverli o passare uno schema ogni volta, le API di estrazione IA one-shot sono la strada più rapida. Nessuno scraper da creare, nessuno schema da registrare.
Scraping ripetuto in una pipeline
Se esegui lo stesso scraper più e più volte e hai bisogno di un endpoint stabile che restituisca lo stesso schema ogni volta, oppure se devi personalizzare i campi dati per gli URL che vuoi, una piattaforma crea una volta, chiama molte volte è più adatta. La tua pipeline si limita a passare gli URL e la struttura dell'output rimane prevedibile.
Quanto tempo richiede
Il tempo di creazione varia in base all'approccio. Scrivere uno scraper o un actor da zero richiede in genere da giorni a settimane, perché crawler, configurazione dei proxy e tentativi sono a tuo carico. Le piattaforme basate su prompt generano schema e codice in pochi minuti. Anche gli strumenti basati su registrazione richiedono pochi minuti, con configurazione punta e clicca invece di un prompt. Le API di estrazione IA one-shot saltano la fase di creazione; la prima risposta arriva in una singola chiamata HTTP.
Sito già coperto da uno scraper pronto
Usare uno scraper pronto per siti popolari è di solito più veloce che crearne uno proprio, ma chi lo mantiene funzionante dipende dalla sua provenienza. Una libreria mantenuta dal fornitore viene aggiornata dal fornitore quando il sito cambia.
Sito non coperto da nulla di pronto
A quel punto la domanda diventa chi sistema le cose quando i layout cambiano. Creare da solo significa che la manutenzione spetta a te. Uno strumento basato su registrazione richiede di riaddestrare il robot quando qualcosa si rompe. L'auto-riparazione IA sul codice che possiedi si colloca a metà strada: la correzione viene proposta sul codice esistente e tu la approvi prima che vada in produzione.
Creazione con coding agent
Se il tuo flusso di lavoro passa attraverso Claude Code, Cursor o Codex, è importante se lo strumento espone una CLI o un'integrazione MCP che l'agente può pilotare end-to-end, oppure se l'agente può solo chiamare una semplice HTTP API.
 Aggiungi come fonte preferita
Metodologia del benchmark degli strumenti IA di web scraping
Per costruire il dataset, abbiamo selezionato i primi 10 siti di moda e abbigliamento al mondo da Semrush. Per ogni sito è stata scelta una singola pagina prodotto e la verità di riferimento (prezzo e valuta) è stata registrata manualmente visitando direttamente la pagina.
Sono stati testati cinque strumenti di scraping IA: l'API Scrape di Firecrawl, Scraper Studio di Bright Data, IA Extract di ScrapingBee, l'actor IA Web Scraper di Apify e IA Scraper di Oxylabs IA Studio. Ogni fornitore ha ricevuto lo stesso prompt di una sola frase: “Estrai il prezzo e la valuta del prodotto e restituisci json.”
Ogni URL è stato inviato una sola volta a ciascun fornitore. Non ci sono stati tentativi, fallback, applicazione dello schema o passaggi di post-elaborazione. La risposta grezza è stata archiviata così com'era, esattamente come restituita dal fornitore.
Per la validazione, l'output JSON grezzo è stato analizzato con un'espressione regolare per trovare il prezzo e la valuta attesi. Il confronto dei prezzi tollera variazioni di formattazione comuni come 26.49 e 26,49, 2.140 e 2140, e piccole differenze di precisione decimale. Il confronto della valuta accetta sia il codice ISO (USD) sia il simbolo ($).
Sono state monitorate due metriche. Il tasso di successo viene calcolato per URL come controllo binario sull'effettiva corretta restituzione del prezzo e un altro per la valuta; i due vengono poi mediati per produrre un unico punteggio di successo per ciascun URL, e i punteggi vengono mediati su tutti e dieci gli URL per ogni fornitore. Il tempo di completamento end-to-end è la durata reale dalla richiesta alla risposta, media sui dieci URL. Per Bright Data, la creazione una tantum del collector è esclusa.
Come abbiamo selezionato questi strumenti
Abbiamo incluso strumenti che usano l'IA, come LLM, NLP o modelli di visione, per interpretare la struttura delle pagine senza regole cablate o per estrarre dati da un prompt. Abbiamo escluso librerie generiche senza IA integrata, come Scrapy e Playwright, anche se entrambe sono ampiamente utilizzate per lo scraping.
Nelle sezioni precedenti, gli strumenti sono raggruppati in base al loro funzionamento piuttosto che ai loro utilizzatori. La linea di demarcazione è dove gira il modello: le piattaforme crea una volta risolvono la struttura della pagina una sola volta e archiviano il risultato come scraper da chiamare tramite ID, mentre le API one-shot la risolvono di nuovo a ogni richiesta. Questa distinzione incide su costi, coerenza dell'output e responsabilità delle correzioni quando un sito cambia, quindi separa gli strumenti in modo più utile rispetto a una divisione no-code contro sviluppatori.
FAQ
Sì. Le librerie open source come Crawl4AI, Skyvern e Browser Use sono gratuito da self-hostare, e la maggior parte degli strumenti commerciali, tra cui Browse IA, Firecrawl e Thunderbit, offrono un piano gratuito con limiti di utilizzo.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{I migliori strumenti IA di web scraping messi a confronto}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Consultato il 25 agosto 2026}
}Risultati e timestamp di 56 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 2 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
5 aggiornamentiAggiunta una sezione di benchmark che confronta gli strumenti di web scraping AI sui principali siti e-commerce.
Sostituito l'elenco degli strumenti con voci dedicate a Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern e altri, e aggiunta una sezione FAQ.
Sostituita l'introduzione agli strumenti di web scraping AI con una descrizione degli agenti AI autonomi, dello scraping basato sulla visione (VLM) e degli scraper auto-riparanti.
Prossimo da leggere
Modelli Quantitativi Su Larga Scala: Applicazioni e Sfide

Agentic Mesh: il futuro della collaborazione IA scalabile


Time Series Foundation Models: Casi d'uso e vantaggi





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.