


AIM-Decision: Jev gegen Clef gegen LLMs
Entscheidungsmodelle, auch System-One-Modelle genannt,1 bewerten eine feste Optionsmenge, statt Text Token für Token zu generieren. Wir testeten 59 Entscheidungsmodelle anhand von 1.655 Klassifikationsfragen, etwa der Bewertung einer Sicherheitslücke oder eines Produktrückrufs, und ließen 46 davon auf 50 Browser-Aufgaben laufen. Siehe AIM System One Index für kombinierte Ergebnisse.
Ergebnisse des Klassifikations-Benchmarks
- decider-12b erzielte 46.4 bei Sicherheitslücken und 62.4 bei Rückrufen, zu $0,06 pro 1.000 Entscheidungen. Kein Entscheidungsmodell erzielte bei einer der beiden Aufgaben signifikant mehr.
- Jev 1.13 kostete $0,039 pro 1.000 Entscheidungen und erzielte 47.9, etwa einen Punkt unter Kev-9B und Nimble 9B, die etwa 7- bzw. 9-mal teurer waren.
- pplx-decider-v1.1-27b und Mercury Decide erzielten 48.7 und 48.1, über Jevs 47.9, zu etwa einem Drittel der Kosten.
- Eikos-27B mit 27 Milliarden Parametern kostete $0,073 pro 1.000 Entscheidungen. Tev1 4B mit 4 Milliarden kostete $0.34.
- Strands Decider 2B erzielte 62.6 bei Rückrufen, den höchsten Wert aller Modelle, und 33.9 bei Sicherheitslücken, wo zufällige Antworten im Schnitt 25 ergeben.
- GLiDE erzielte 46.5 bei Sicherheitslücken gegenüber decider-12bs 46.4, benötigte aber 15,7 Sekunden pro Entscheidung gegenüber 0.13 und kostete $0,48 pro 1.000 Entscheidungen. GLiDE v2 erreichte im Schnitt 49.0 über die beiden Aufgaben bei 0,47 Sekunden und $0.10. Clef erreichte im Schnitt 51.0 zu $0,17 über Cloudflares API.
Erfolgsraten der Browser-Automatisierung
Ein Versuch pro Aufgabe; die LLMs liefen mit der Einstellung ihrer API für niedrigen Reasoning-Aufwand.
- Solar Decide, Solar Decide Flash und beide Versionen von Nimble 9B, Tev1 4B und Tev1 0.8B sind nicht gewertet, weil sie höchstens 26 Optionen pro Frage akzeptieren und 17 der 50 Aufgaben auf einer Seite mit mehr Optionen starten. Laya und Strands Decider 2B sind ebenfalls nicht dabei, da ihre Eingabelimits Anfragen ablehnten, die anderen Modelle vollständig erhielten.
- SubQ Snap schloss 41 Aufgaben ab, zwei weniger als Gemini 3.8 Flash und sechs weniger als GPT-6 Astra. Es kostete geschätzt $0,001 pro abgeschlossene Aufgabe, gegenüber $0,025 für Gemini und $0,226 für Astra.
- Entscheidungsmodelle schlossen zusammen 49 der 50 Aufgaben ab, einschließlich aller drei, an denen Astra scheiterte.
- decider-12b, Erster bei der Klassifikation, schloss 16 Browser-Aufgaben ab; Kev-27B, das bei der Klassifikation unter Jev lag, schloss 40 ab. JEV-27B-VL, laut Model-Card aus Jev 1.13 destilliert,2 erzielte 45.8 gegenüber Jevs 47.9 und schloss 24 Browser-Aufgaben ab gegenüber Jevs 18.
Siehe 10 Beispielaufgaben und die Ergebnisse jedes Modells auf Hugging Face sowie die Durchführung des Benchmarks unter Methodik.
Entscheidungsmodelle vs LLMs bei Browser-Aufgaben
Die meisten LLMs schreiben ihre Antwort Token für Token, und jeder Token kostet Rechenleistung und Zeit. Bei den meisten Browser-Schritten wählt der Agent nur eine Operation und ein Bedienelement auf der Seite aus.
Ein Entscheidungsmodell liest die Seite und die Optionen, bewertet jede Option und gibt die wahrscheinlichste zurück. Es liefert eine Wahrscheinlichkeit für jede Option statt generierten Textes, sodass ein Schritt keine lange Ausgabe benötigt. Wenn Entscheidungsmodelle genau genug werden, könnte dieselbe Automatisierung viel schneller und zu einem Bruchteil der LLM-Kosten laufen.
Die Entscheidungsmodelle, so wie wir sie bereitgestellt haben, geben Optionsbewertungen und keinen Text zurück, daher schreibt ein separates Textmodell, Mercury 2.5,3 die Werte, die in Formularfelder eingegeben werden. Wir nennen es den Texthelfer, und es stand jedem Modell zur Verfügung.
Wir ließen jedes Modell auf der quelloffenen jev-ultrafast-Laufzeit von browser-use laufen,4 die für Jev 1.13 von TypeSafe entwickelt wurde.5 GPT-6 Astra dient als High-End-LLM-Referenz und Gemini 3.8 Flash als kostengünstige Referenz. Alle Modelle sind unter Methodik aufgeführt.
Fünf Modelle bei derselben Aufgabe
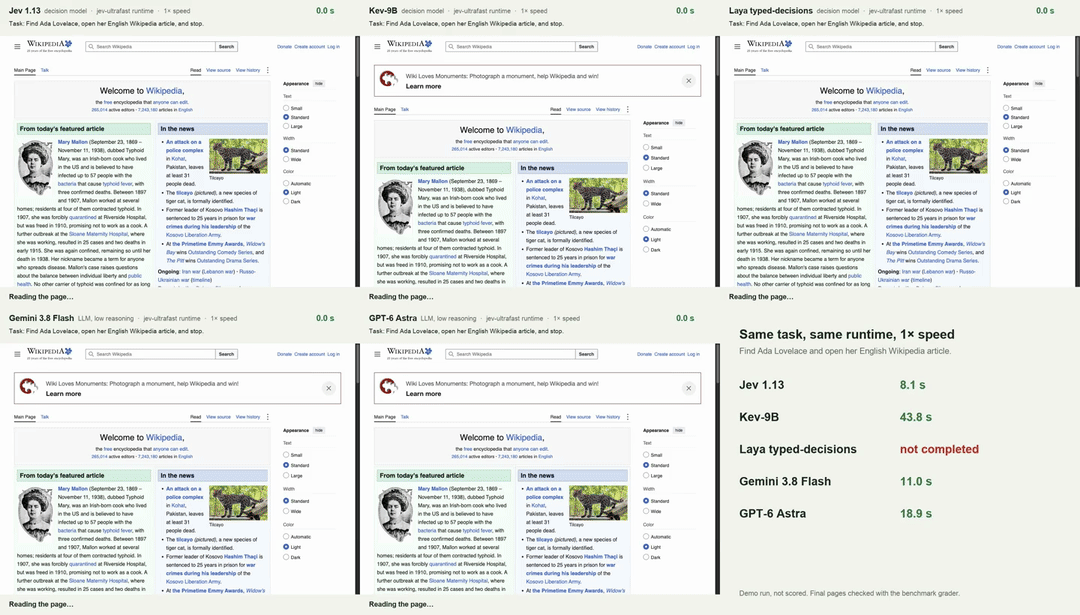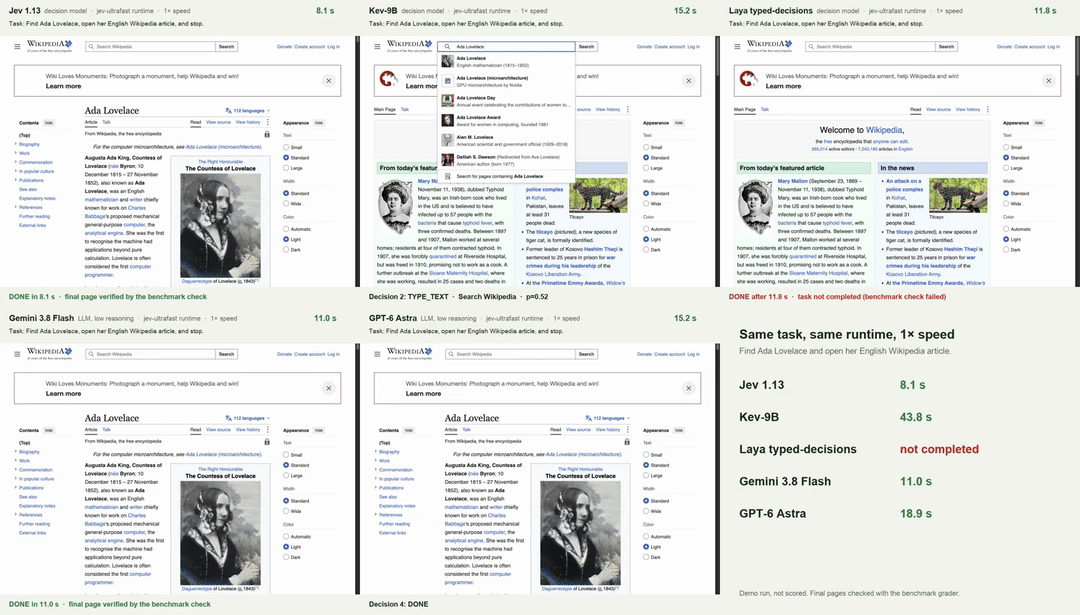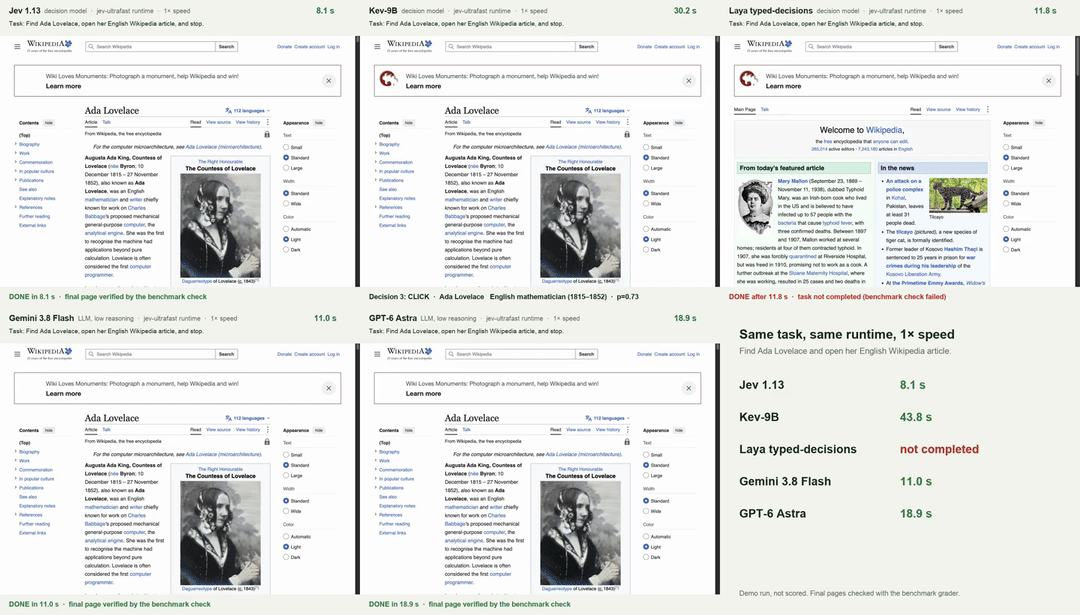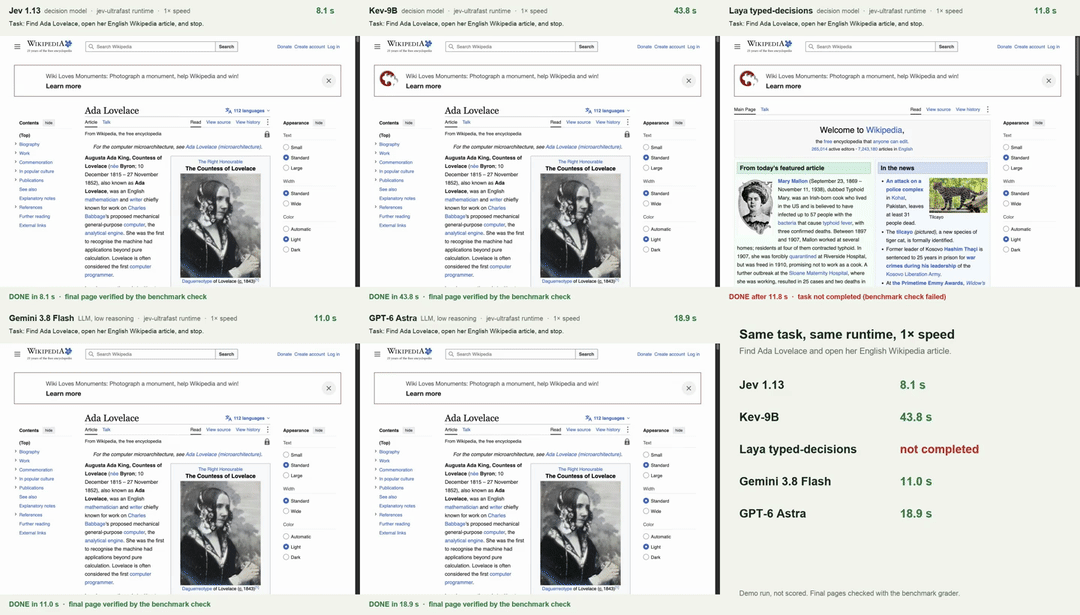
Auf Wikipedia tippte jedes Modell außer Laya in das Suchfeld, der Texthelfer schrieb „Ada Lovelace“, und das Modell wählte den richtigen Vorschlag. Jev erreichte den Artikel in 8,1 Sekunden, Gemini in 11.0, Astra in 18.9 und Kev-9B in 43.8. Laya erklärte die Aufgabe auf der Hauptseite für erledigt, ohne eine Aktion auszuführen.
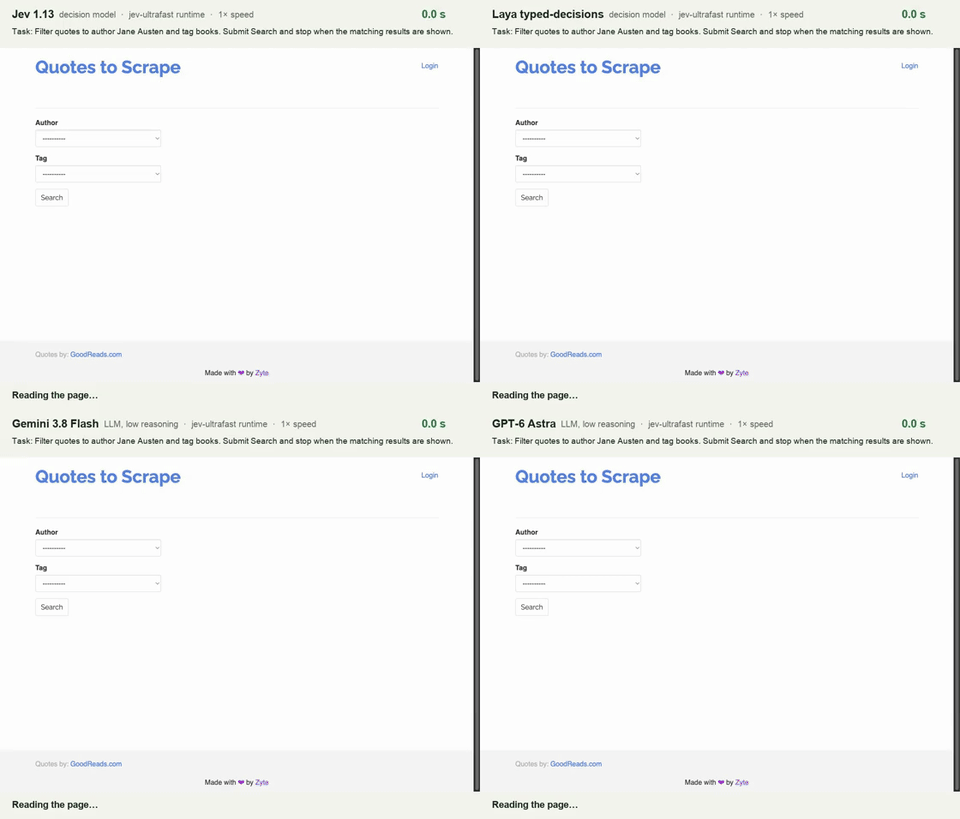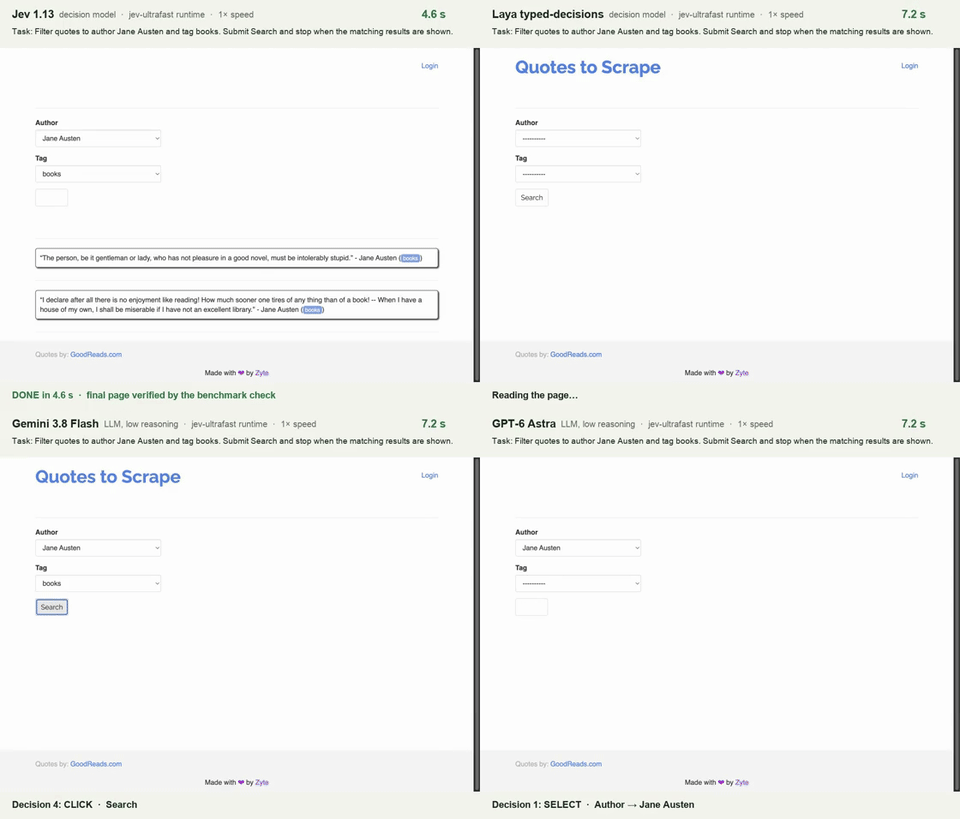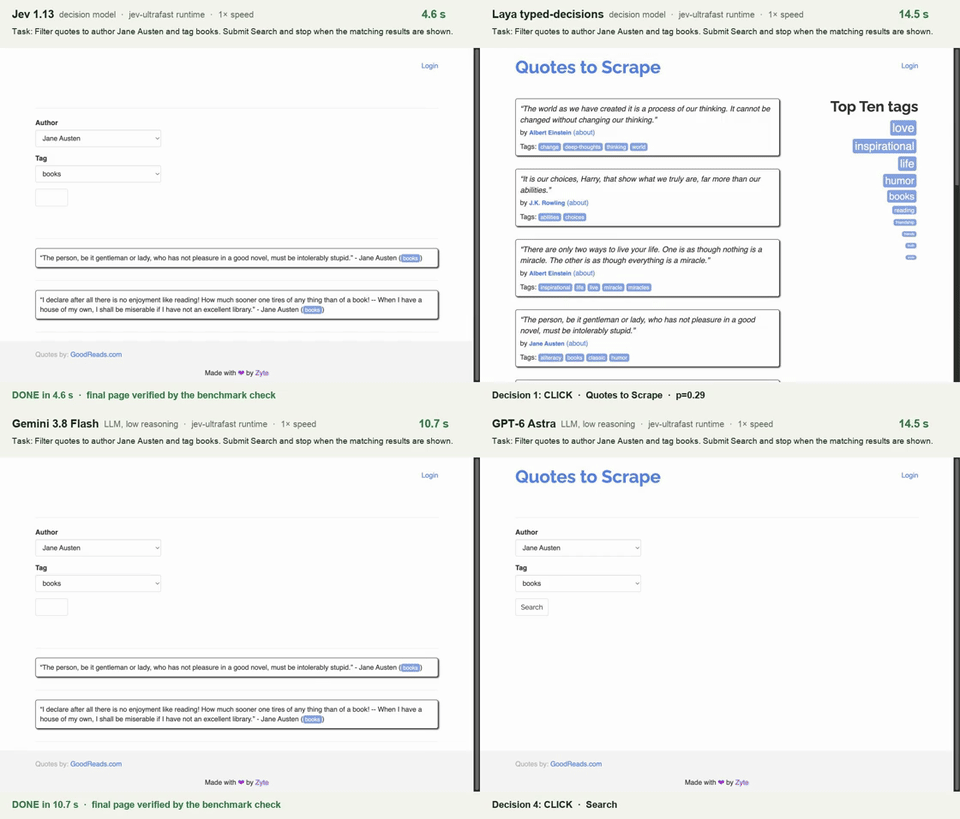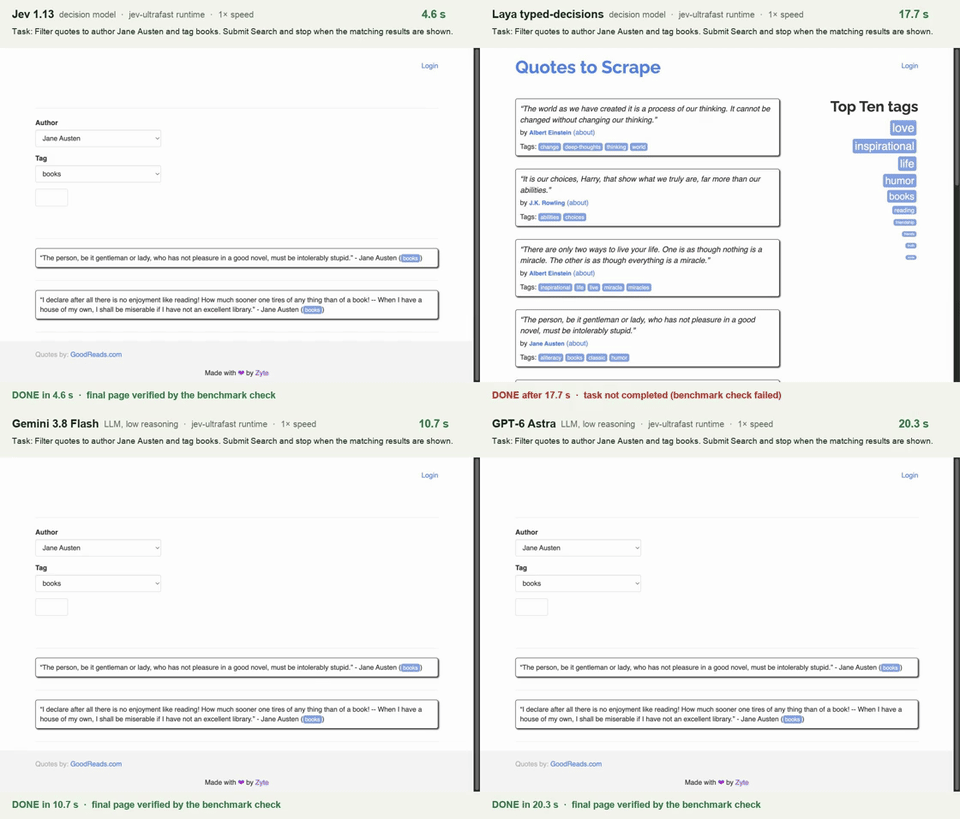
Die Filteraufgabe erfordert zwei Dropdowns und einen Suchbutton. Jev, Gemini und Astra führten dieselben vier Schritte aus und beendeten die Aufgabe in 4.6, 10.7 und 20,3 Sekunden. Laya klickte auf das Site-Logo und erklärte die Aufgabe für erledigt. Kev-9B scheiterte bei dieser Aufgabe im Benchmark, und in der Demo klickte es nach 11 Minuten immer noch, daher ist es in diesem Clip ausgelassen.
Die Bildunterschriften zeigen die gewählte Operation und das Ziel jedes Modells und bei Entscheidungsmodellen die Wahrscheinlichkeit dieser Operation. Die Clips stammen aus einem separaten Demo-Lauf mit 1-facher Geschwindigkeit, nicht aus dem gewerteten Benchmark, und jede Zielseite wurde mit dem Grader des Benchmarks geprüft.
Wie Modelle scheiterten
Jev und Kev-9B schlossen zusammen 26 unterschiedliche Aufgaben ab. Beide schlossen die beiden Wikipedia-Aufgaben und die Web-Scraper-Dropdown-Aufgabe ab, ebenso wie beide LLMs. Bei Books to Scrape, wo jede Aufgabe von einer Kategorieliste zu einer Produktseite führt, schloss Jev eine der sechs und Kev-9B drei ab. Kev-27B, Eikos-27B und AutoJev-27B schlossen alle sechs ab.
- Jev erklärte die Aufgabe in 24 seiner 32 Fehlschläge für blockiert, 16 Mal, bevor es eine Aktion ausführte.
- Kev-9B benötigte im Median 9.5 Aktionen bei fehlgeschlagenen Aufgaben, gegenüber 3 bei abgeschlossenen Aufgaben. Zehn Versuche erreichten das Aktions- oder Entscheidungsaufruflimit, und fünf weitere wurden gestoppt, nachdem drei aufeinanderfolgende Aktionen die Seite unverändert ließen.
- Kev-4B, vom Entwickler von Kev-9B, erklärte die Aufgabe bei seiner ersten Entscheidung in 29 der 50 Aufgaben für blockiert.
- Kev-27B, Eikos-27B und GLiDE scheiterten alle an sieben gemeinsamen Aufgaben. Sie erklärten vier davon für blockiert, zwei ScrapeMe-Produktabfragen und zwei Web-Scraper-Aufgaben, und keines der drei schloss die Checkbox- oder die Rechner-Formularaufgabe ab.
- GPT-6 Astra scheiterte bei 3 Aufgaben. Es markierte eine ScrapeMe-Kategorieaufgabe als blockiert, tippte weiter in dasselbe Rechnerfeld, bis es gestoppt wurde, und bei der Formularaufgabe T02 lieferte der Texthelfer keinen gültigen Wert, nachdem Astra das Formular ausgefüllt und abgeschickt hatte.
- Gemini 3.8 Flash scheiterte bei 7, darunter dasselbe T02-Ende. Drei Fehlschläge erreichten die richtige Seite, schlossen aber nicht ab, zwei wurden von unserer Kostensicherung gestoppt, als OpenRouter keine Gebühr meldete, und einer erreichte das Aktionslimit.
Warum einige Modelle 0/50 erzielten
GLiNER2.5-Decide
GLiNER2.5-Decide von Fastino6 erklärte alle 50 Aufgaben zu früh für erledigt, 49 davon bei seiner ersten Entscheidung. Bei den 37 Aufgaben, die eine Startseite mit einer anderen Aufgabe teilen, unterschieden sich seine Operationswahrscheinlichkeiten zwischen den Zielen um nicht mehr als 6 Punkte.
Fastino beschreibt GLiNER2.5-Decide als Klassifikator für Entscheidungen wie Ticket-Routing, Absicht, Dringlichkeit und ob ein Agent fertig ist, und gibt an, dass das Modell nicht logisch schlussfolgert. Das Modell ist für Eingaben von bis zu 512 Tokens ausgelegt, akzeptiert aber längere. Unsere Erstschritt-Anfragen hatten einen Median von 1.915 Tokens.
CLM-v0.1-8B
CLM-v0.1-8B von Contrastive-LM7 wählte bei 2.199 seiner 2.288 Operationsentscheidungen „wait“, sodass 36 Versuche keine Aktionen mehr übrig hatten. Auf denselben Startseiten unterschieden sich seine Wahrscheinlichkeiten zwischen den Zielen um höchstens 13 Punkte.
Contrastive-LM gibt an, dass CLM-v0.1-8B ohne Fine-Tuning bei Computer-Use-, Gaming- und Tool-Calling-Aufgaben mit Jev gleichzieht und das Anfrageformat von Jev unverändert akzeptiert.8 Wir sendeten Anfragen in diesem Format.
Geschwindigkeit und Erfolg
Kev-27B, Eikos-27B und AutoJev-27B schlossen 68 % bis 80 % der Aufgaben mit einem Median von etwa 7 Sekunden pro Versuch ab, schneller als Gemini mit 12,7 Sekunden und Astra mit 17.4. SubQ Snap, pplx-decider-v1.1-27b und Mercury Decide schlossen 72 % bis 82 % in 5.3 bis 6,3 Sekunden ab.
decider-4b, decider-12b und Jev benötigten 2.5 bis 4,2 Sekunden pro Versuch und erklärten 19 bis 24 Aufgaben für blockiert.
GLiDE schloss 76 % bei einem Median von 46,8 Sekunden pro Versuch ab, und 3 seiner Versuche erreichten das 900-Sekunden-Limit. NeoHorse-Jev-4B war mit 78,6 Sekunden das langsamste, bei 15 abgeschlossenen Aufgaben. GLiDE v2 schloss 72 % bei einem Median von 6,0 Sekunden ab.
GLiNER2.5-Decide (0,2 Sekunden) erklärte 49 von 50 Aufgaben bei seiner ersten Entscheidung für erledigt, und Kev-4B erklärte 29 Aufgaben bei seiner ersten für blockiert.
Kev-9B benötigte im Median 38,3 Sekunden pro Versuch, fünfmal so lange wie Kev-27B. Jede Entscheidung von Kev-9B benötigte im Median 3,7 Sekunden Serverzeit, gegenüber etwa 1 Sekunde für einen vollständigen Jev-API-Aufruf. Der Anfrage-Overhead fügte etwa eine halbe Sekunde hinzu.
Kev-9B traf im Schnitt 26 Entscheidungen pro Versuch, gegenüber etwa 4 bei Jev, und 90 % davon entfielen auf fehlgeschlagene Versuche.
Kosten
Kosten der Browser-Automatisierung
† Schätzung: A100-Kosten pro Input-Token, gemessen an den eigenen Browser-Anfragen des Modells bei voller GPU, multipliziert mit seinen Browser-Input-Tokens, plus den Gebühren des Texthelfers. Methode unter Methodik.
‡ Der höhere Wert addiert 17 Anfragen, die ohne gemeldete Tokens fehlschlugen, mit jeweils 120.000 Input-Tokens gezählt; Fastino stellt sie möglicherweise nicht in Rechnung.
Astra, Gemini und Jev verwendeten jeweils 3.150 bis 3.470 Input-Tokens pro Entscheidung. Astras Input-Preis ist etwa 240-mal so hoch wie der von Jev.910
Bei niedrigem Reasoning erzeugte Astra über 307 Entscheidungen hinweg 6.599 Output-Tokens, gegenüber 968.376 Input-Tokens. Jevs Output-Preis ist $0.
Zu Jevs Input-Preis hätten Astras 968.376 Entscheidungs-Input-Tokens etwa $0,04 statt $9,68 gekostet. Kev-27B kam bis auf sieben Aufgaben an Astra heran, für geschätzte $0,24 über die 50 Aufgaben, gegenüber Astras $10,63.
Auf Basis dieser Schätzungen kostete jedes Entscheidungsmodell in der Tabelle, das eine Aufgabe abschloss, außer Celeris 1.1 Decision, Kev-4B, Kev-9B und NeoHorse-Jev-4B, weniger pro abgeschlossene Aufgabe als Gemini. Neun Modelle kosteten pro abgeschlossener Aufgabe weniger als Jev 1.13: Mercury Decide, Decider V1.2, pplx-decider-v1.1-27b, Span-02, Drex v1.5, SubQ Snap, H2O-Lightning-4B, Jev 1.14 und Drex v2.0. Mercury Decide kostet weniger als ein Drittel von Jev.
- Kev-9B kostete pro abgeschlossener Aufgabe etwa das 5-Fache von Gemini und das 84-Fache von Jev. Die geschätzten A100-Kosten lagen bei etwa $0,80 pro Million Input-Tokens, das 19-Fache des Jev-API-Preises, und es traf 1.321 Entscheidungen gegenüber 185 bei Jev.
- Die geschätzten GPU-Kosten pro Token von Kev-4B lagen bei etwa dem 12,1-Fachen seines OpenRouter-Preises.
Die A100-Zeit, die wir für den Kev-9B-Lauf gemietet haben, 3,32 Stunden inklusive Setup und Leerlauf, kostete etwa $5,31. Eine Jev-Gebühr und zwei Gemini-Gebühren wurden nicht erfasst und fehlen in der Tabelle.
Kosten der Klassifikation
Gehostete Modelle sind zu ihren API-Listenpreisen berechnet, mit Ausnahme der Modelle auf OpenRouter, die zu den von OpenRouter berechneten Gebühren angesetzt sind. Mercury Decide lief auf OpenRouters free-Route und wird zum Listenpreis seiner kostenpflichtigen Route berechnet. Selbst gehostete Modelle werden pro 1.000 Entscheidungen zum höchsten Durchsatz berechnet, den wir auf einer gemieteten A100 bei voller GPU gemessen haben.
Bei unserem Satz von $1,673 pro Stunde kostet eine gemietete A100 etwa $40 pro Tag, ob ausgelastet oder im Leerlauf. Zu dem erfassten Satz kauft $40 etwa eine Million Jev-Entscheidungen.
 Als bevorzugte Quelle hinzufügen
Training von Entscheidungsmodellen
Wir haben Kev-9B und Laya auf Entscheidungen fine-tuned, die GLM-5.3-Flash, das Labeling-Modell, bei Browser-Aufgaben von acht Websites außerhalb des Benchmarks getroffen hat. Dann ließen wir die 50 Aufgaben erneut laufen. Jedes fine-tuned Modell wird mit seiner Standardversion verglichen, die am selben Tag auf derselben Hardware lief.
Der fine-tuned Kev und beide Laya-Versionen sind auf Hugging Face.
p stammt aus einem gepaarten Test auf denselben 50 Aufgaben (exakter McNemar), und p unter 0,05 gilt als signifikant. Standard-Kev schloss in diesem Vergleich 21 Aufgaben ab, eine mehr als in den obigen Ergebnissen. Einer der 12 Gewinne von Kev, C02, war im Standardlauf ein Browser-Timeout und kein Modellfehler. Ohne diesen gewann Kev 11 Aufgaben und verlor 1 (p = 0.006).
- Der fine-tuned Kev gewann auf sechs der neun Websites Aufgaben hinzu, jeweils drei auf Quotes to Scrape und Scrape This Site. Seine Ergebnisse auf Web Scraper, Wikipedia und den TestPages-Formularen änderten sich nicht.
- Der fine-tuned Kev beendete 5 Versuche blockiert gegenüber 12 und erreichte das Aktionslimit 6-mal gegenüber 11. Er erklärte eine unerledigte Aufgabe 7-mal für erledigt, gegenüber 4.
- Bei 41 Aufgaben von den Trainings-Websites, die nicht im Training enthalten waren, schloss Kev 21 ab, gegenüber 13 zuvor. Bei 101 Einzelentscheidungen aus 19 dieser Aufgaben wählte er die Operation des Labeling-Modells in 94 % der Fälle, gegenüber 62 % zuvor.
- Layas erster Fine-Tune wählte die Operation des Labeling-Modells bei 75 % der 88 Entscheidungen, die es lesen konnte, gegenüber 19 % beim Standard-Laya. Es erklärte eine Aufgabe auf einer Seite, die noch eine Aktion erforderte, 2-mal statt 53-mal für erledigt.
- Im Benchmark erklärte Layas erster Fine-Tune eine unerledigte Aufgabe 36-mal für erledigt, einmal bevor er eine Aktion ausführte. Standard-Laya tat dies 32-mal, 17 davon vor einer Aktion.
Anwendungsfälle für Entscheidungsmodelle
- Prüfen des Fertig-Signals eines Agenten. Auf der letzten Seite, die ein Browser-Agent sah, bevor er eine Aufgabe für erledigt erklärte, erzielten 41 der 59 Entscheidungsmodelle über 90 Punkte bei der Unterscheidung von erledigt und nicht erledigt, und AutoJev-27B, Clef, d1-ultra, Decision-2.0-Vega-27B und Kev-27B erzielten 99,5. Wir haben keine Prüfungen auf Seiten früher in einem Lauf getestet.
- Triage mit festen Labels, etwa die Bewertung von Sicherheitshinweisen oder Rückrufen. decider-12b lag 21 Punkte über dem Zufallsniveau bei Schweregrad und 29 bei Rückrufen. Bei Paper-Themen erzielte ein auf 28.595 gelabelten Papers trainierter Keyword-Klassifikator 70,4, und kein Entscheidungsmodell war signifikant besser; dieselbe Art von Klassifikator lag bei Schweregrad und Rückrufen nahe dem Zufall.
- Auswahl jeder Aktion in der Browser-Automatisierung. SubQ Snap schloss 41 von 50 Aufgaben ab, gegenüber 43 bzw. 47 bei den beiden LLMs. Das Fine-Tuning von Kev-9B auf 606 Entscheidungen von anderen Websites steigerte es von 21 auf 32.
Bei den beiden Hauptklassifikationsaufgaben kosteten lokale Entscheidungsmodelle geschätzt $0,007 bis $0,57 pro 1.000 Entscheidungen auf einer gemieteten GPU, und alle außer NeoHorse-Jev-4B und Shisa DE-2 lagen im Schnitt unter einer Sekunde pro Entscheidung. Bei den Browser-Aufgaben lag Jevs Input-Preis bei etwa 1/240 des Preises von GPT-6 Astra.
Jede Antwort enthält außerdem eine Wahrscheinlichkeit pro Option, mit der eine Anwendung unsichere Fälle an ein LLM übergeben könnte. Wir haben nicht getestet, wie gut diese Wahrscheinlichkeiten mit der tatsächlichen Genauigkeit übereinstimmen.
36 der 59 Modelle liefen auf einer einzelnen gemieteten GPU; die anderen 23 sind gehostete APIs.
Methodik
Benchmark für Browser-Automatisierung
Alle Modelle verwendeten dieselbe jev-ultrafast-Browser-Laufzeit. Bei jedem Schritt wandelte sie die aktuelle Seite in Seitentext plus eine nummerierte Liste sichtbarer Bedienelemente um. Das Modell wählte eine Operation wie Klicken, Eintippen, Auswählen, Erledigt oder Blockiert sowie ein Ziel aus dieser Liste. Die Laufzeit führte die Aktion aus und las die Seite erneut.
Die Entscheidungsmodelle ordnen die bereitgestellten Optionen und geben keinen Text zurück. Wenn ein Modell Eintippen wählte, schrieb der Texthelfer den Wert in das Formularfeld. Jeder Versuch begann in einer frischen Browser-Sitzung.
Jedes Modell wurde über eine API erreicht. Kev-9B und Laya liefen mit dem Browser auf einem Mac, in Chrome 153 bis 30. September und Chrome 154 ab 2. Oktober. Die anderen selbst gehosteten Modelle liefen mit Chrome auf Linux auf ihren gemieteten GPUs.
Keine Anfrage wurde gekürzt, um sie an ein Modell anzupassen. Solar Decide, Solar Decide Flash und Ollama akzeptieren 2 bis 26 Optionen pro Frage. Eine Anfrage außerhalb dieser Limits beendete den Versuch, ebenso wie übergroße Anfragen bei Laya. Ollama akzeptiert Optionsbeschreibungen nur als Text, daher wurden strukturierte Optionen als kompakter JSON-Text gesendet. Tev1 wird mit einem Kontext von 2.050 Tokens ausgeliefert; wir erhöhten ihn auf 8.194, Nimbles eigene Einstellung, damit Seiten nicht abgeschnitten wurden.
Classify-1 lehnt die strukturierten Anweisungen, Optionsbeschreibungen und den Seitenzustand ab, die anderen Modelle erhalten; daher sendeten wir sie in beiden Benchmarks als kompakten JSON-Text.
Strands Decider 2B liest höchstens 4.096 Tokens und verweigerte längere Seiten, was 11 Versuche beendete.
Cloudflares Dienst liest für Clef und Clef-Flash nur die ersten 2.048 Tokens des Seitentexts. Wir sendeten keine längeren Seiten, was je Modell einen Versuch beendete.
Für 21 Modelle, darunter Clef, decider und Eikos, wurde eine Frage mit einer Option, etwa das einzige Textfeld einer Seite, mit dieser Option doppelt gesendet, und die Antwort wurde zurück auf diese Option gemappt. Ihre Dienste verweigern Fragen mit nur einer Option.
Wir ließen Kev-9B mit dem Referenzcode des Herstellers in voller 32-Bit-Präzision laufen. Wir installierten keine optionalen Kernel-Pakete, die sein Basismodell beschleunigen, sodass das Modell auf langsamere Referenz-Kernel zurückfiel. Wir testeten kein schnelleres GPU-Setup.
CLMs eigener Code wandelt jede Anfrage in Text um. GLiNER erhielt denselben Text, mit Ziel und Regeln jeder Frage als prompt. Kev-4B wird auch auf OpenRouter von SiliconFlow mit 8-Bit-Präzision bereitgestellt.11 Über diesen Weg vom Mac aus ausgeführt, schloss Kev-4B am 29 September 8 Aufgaben ab.
GPT-6 Luna Decisions wird auch auf OpenRouter bereitgestellt, das einen Fehler für die gesamte Anfrage zurückgibt, wenn das Modell eine Frage verweigert; OpenAIs eigene API beantwortet die anderen Fragen.12 Über OpenRouter schloss Luna 1 Aufgabe ab, daher verwenden die obigen Ergebnisse OpenAIs API.
Für Celeris 1.1 Decision verwendeten 4 der 50 Browser-Aufgaben Mercury 3 als Texthelfer anstelle von Mercury 2.5. Celeris scheiterte an allen vier mit beiden Helfern.
Browser-Modelle
Low Reasoning ist eine anbieterdefinierte Einstellung für den Denkaufwand. Astras 307 Entscheidungen umfassten 791 gemeldete Reasoning-Tokens. Kev-9B13 und Kev-4B14 stammen vom selben Entwickler, und Nimble 9B stammt von Bespoke Labs.15 GLiDE stammt von Fastino, dem Entwickler von GLiNER2.5-Decide,16 und Clef sowie Clef-Flash von Cloudflare.17
MATILDA JEV v1.5s Model-Card gibt an, dass früheres Training in seinem Stammbaum benchmarkbezogenes Material verwendet hat.18
Dataset
Die 50 Aufgaben umfassen neun Websites: acht Übungsseiten, die für Scraping und Tests gebaut wurden, plus Wikipedia. Die Aufgaben umfassen Katalognavigation, Suche, Sortierung, Pagination, Produktoptionen, Formulare und Artikelsuchen. Jede Aufgabe beginnt mit einer festen URL und beschreibt den Endzustand in einem Satz, zum Beispiel: „Wechsle zu Science Fiction, finde Dune (Dune #1), öffne die Produktdetails und stoppe.“
Bevor die Modelle liefen, schloss ein skriptgesteuerter Lauf alle 50 Aufgaben nur mit den unterstützten Aktionen der Laufzeit ab. Jede Aufgabe ist ohne Passwörter, CAPTCHAs oder die Enter-Taste lösbar.
Beispielaufgaben
Zehn der 50 Aufgaben sind auf Hugging Face mit Anweisungen, Start-URL, Bestehenskriterien und den Ergebnissen jedes Modells veröffentlicht. Die übrigen 40 werden für spätere Läufe zurückgehalten.
Evaluierung
Eine Aufgabe galt als bestanden, wenn das Modell sie innerhalb der Limits für erledigt erklärte und eine separate Prüfung der Zielseite jede Bedingung bestätigte: eine akzeptierte End-URL, die auf der Seite sichtbaren Fakten der Aufgabe, mehr als 100 Zeichen Seitentext und eine vollständig geladene Seite.
Jeder Versuch hatte 900 Sekunden, 60 Browser-Aktionen und 120 Entscheidungsaufrufe. API-Fehler zählten als Fehlschläge. Die Zeit läuft vom ersten Laden der Seite bis zur Endprüfung.
Die Prüfung liest die Zielseite, nachdem sie fertig geladen ist.
Kostenberechnung
Die API-Kosten umfassen die Entscheidungsaufrufe und den Texthelfer, für alle 50 Versuche pro Modell. OpenRouter meldete die Gebühren für GPT-6 Astra, Gemini und Mercury 2.5. Jevs Kosten sind die gemeldeten Tokens zum Listenpreis vom 22. September 2026: $0,042 pro Million Input-Tokens und keine Gebühr für Output.5 GLiDE, Clef und Clef-Flash werden ebenfalls zu ihren Listenpreisen berechnet.
GLiDE v2, GPT-6 Luna Decisions, SubQ Snap und Celeris 1.1 Decision werden zu ihren Listenpreisen berechnet, und die übrigen Entscheidungsmodelle auf OpenRouter zu den von OpenRouter gemeldeten Gebühren. Mercury Decide, das auf der free-Route läuft, wird zum Listenpreis seiner paid Route berechnet.
Selbst gehostete Browser-Läufe verwendeten eine A100, A6000, RTX 4090 oder einen Mac. Wir berechnen alle auf einer gemieteten A100 zu $1,673 pro Stunde. Wir sendeten die eigenen Browser-Anfragen jedes Modells erneut an das Modell, bei voller GPU. Die Kosten eines Modells in der Tabelle sind seine Kosten pro Input-Token beim höchsten Durchsatz, multipliziert mit seinen Browser-Input-Tokens, plus den Gebühren des Texthelfers.
Beide Workloads bestehen fast vollständig aus Input, da diese Modelle Optionsbewertungen oder nur wenige Tokens zurückgeben.
Fine-Tuning
Die 327 Aufgaben, 286 für das Training und 41 zurückgehalten, stammen von acht Websites, die nicht im Benchmark enthalten sind, darunter Demo Web Shop, Automation Exercise und Project Gutenberg. Jede Aufgabe wurde im Browser geprüft: Ihre Startseite fällt beim Grader durch, und wo die Aufgabe auf einer anderen URL endet, besteht diese Seite.
GLM-5.3-Flash, ein Modell mit offenen Gewichten unter der MIT-Lizenz,19 versuchte 300 der Aufgaben auf der Benchmark-Laufzeit bei niedrigem Reasoning. Anbieterfehler hielten es von den anderen 27 ab. Wir verwendeten dafür weder GPT-6 Astra noch Gemini, da die Nutzungsbedingungen von OpenAI und Google die Verwendung ihrer Ausgaben zum Bau konkurrierender Modelle untersagen.2021
Die 184 erfolgreichen Trainingsläufe lieferten 606 Entscheidungsdatensätze. Ein Lauf galt als erfolgreich, wenn der Grader ihn bestand oder wenn er über die Site-Suche die richtige Produktseite erreichte und nur an der URL-Prüfung scheiterte, wie es bei 11 Läufen über alle Aufgaben hinweg der Fall war.
Der Einzelentscheidungstest spielt 103 aufgezeichnete Entscheidungen aus 19 zurückgehaltenen Aufgaben ab und zählt, wie oft ein Modell die Operation des Labeling-Modells wählt. Kev konnte 101 davon lesen. Laya konnte 88 lesen, wenn nur die pro Schritt benötigten Fragen gesendet wurden, und 34 bei der vollständigen Anfrage, die der Benchmark sendet. Bei diesen 34 stimmte Standard-Laya in 29 % der Fälle zu, der erste Fine-Tune in 71 % und der zweite in 41 %.
Beide Modelle starteten von den Standardgewichten, die wir benchmarkten, und verwendeten die Trainingsrezepte ihrer Hersteller mit den Input-Limits des Benchmarks. Kev trainierte außerdem zwei Epochen statt einer, ohne die Replay-Datensätze des Herstellers. Jeder Trainingslauf dauerte unter 20 Minuten auf einer H100-GPU.
Layas erster Fine-Tune verwendete dieselben 606 Datensätze und übersprang alle, die zu lang für Laya waren. Der zweite behielt nur die 292, die in die vollständige Anfrage des Benchmarks passten, und ergänzte 102 aus Layas eigenen Läufen, bei denen GLM-5.3-Flash übernahm, nachdem Laya eine Aufgabe für erledigt oder blockiert erklärt hatte (73) oder sein 10-Aktionsbudget aufgebraucht hatte (29). Kev hatte keine zweite Runde.
Das Kev-Paar und Layas erstes Paar liefen auf einer gemieteten H100 in Frankreich, mit Chrome auf Linux. Layas zweites Paar lief auf dem Mac aus dem Hauptbenchmark. Jedes Paar verwendete die 50 Aufgaben, Laufzeit, Limits und Grader des Hauptbenchmarks, mit einem Versuch pro Aufgabe.
Klassifikations-Benchmark
Jedes Item ist eine Entscheidung mit einer festen Optionsmenge. Die Items stammen aus Datensätzen, die von Juli bis September 2026 veröffentlicht wurden, sowie aus unveröffentlichten Snapshots von Zielseiten unserer eigenen Browser-Läufe. Viele der Modelle wurden nach Veröffentlichung dieser Datensätze veröffentlicht, daher könnte ein Modell ein Item und seine aufgezeichnete Antwort im Training gesehen haben. Wir können nicht prüfen, worauf jedes Modell trainiert wurde.
Die ersten drei Aufgaben verlangen von einem Modell, eine von einer Institution erfasste Entscheidung allein aus dem Text zu reproduzieren. GitHub und die FDA haben möglicherweise Hinweise verwendet, die der Text nicht enthält. GitHubs Schweregradstufen entsprechen den vier Bewertungen über None im CVSS, dem Standard-Scoring-System für Schwachstellen.22
Jedes Modell erhielt dieselben Anweisungen und Optionsdefinitionen für eine Aufgabe: die Klassendefinitionen der FDA, GitHubs Schweregradbänder, arXiv’ Kategoriebeschreibungen. Die Optionsreihenfolge wurde pro Item gemischt und war für jedes Modell gleich. Schweregrad von Sicherheitslücken und Gefahrenstufe bei Rückrufen sind die Hauptaufgaben, die vor jedem Lauf festgelegt wurden; Paper-Themen und die Prüfung „Aufgabe erledigt“ sind ergänzend.
Der Score ist die balancierte Genauigkeit: die Erfolgsrate innerhalb jeder möglichen Antwort, gemittelt über die Antworten.
Ein Modell, das immer die häufigste Antwort gibt, erzielt 25 beim Schweregrad, 33 bei Rückrufen und 5 bei Paper-Themen. Der Chart-Score ist der Durchschnitt der beiden Hauptaufgaben, wobei diese Antwort etwa 29 ergibt. Die Intervalle sind 95 %-Bootstrap-Intervalle, die zusammenhängende Items gemeinsam resampeln: Hinweise für dasselbe Paket, Rückrufe aus demselben Rückrufereignis, Seiten aus derselben Browser-Aufgabe.
Um zu testen, ob ein Modell signifikant besser als decider-12b abschnitt, zogen wir 1.000 solcher Resamples, für jedes Modell dieselben, und nahmen das 95 %-Intervall der Differenz jedes Modells bei jeder Hauptaufgabe; ein Modell gilt nur dann als besser, wenn dieses Intervall über null liegt, ohne Anpassung für multiple Vergleiche. Jedes Modell wurde auf Paper-Themen auf dieselbe Weise mit dem Keyword-Klassifikator verglichen.
Zwei LLMs, Qwen 3.8 Max und Claude Opus 5.5, labelten eine Stichprobe von 350 Testitems, 100 pro Aufgabe und 50 Browserseiten, ohne die aufgezeichnete Antwort zu sehen.
Sie stimmten bei 62 von 100 Hinweisen, 69 von 100 Rückrufen, 84 von 100 Papers und 49 von 50 Browserseiten miteinander überein. Wo sie bei Hinweisen und Rückrufen von der Aufzeichnung abwichen, lagen sie meist eine Stufe daneben, in Richtung der mittleren Stufen. Sie stimmten bei 55 und 56 von 100 Hinweisen mit GitHubs Schweregrad überein.
Beide Juroren gaben bei 54 Items dieselbe Antwort, die von der Aufzeichnung abwich. Wir prüften die 53 GitHub-, FDA- und arXiv-Datensätze gegen die Live-Quelle, und alle stimmten überein, sodass sich kein Label änderte.
Die eine Browserseite wurde als erledigt gelabelt, weil der Grader mindestens 40 Bewertungen auf der ganzen Seite zählte, während der Schnappschuss, den die Modelle sehen, etwa neun zeigt. Wir entfernten sie und die 48 anderen Items der Prüfung „Aufgabe erledigt“, deren Antwort vom Zählen von 10 oder mehr Items abhing; das lässt 155 übrig.
Lokale Kosten gelten für die Einstellung, die wir auf dieser GPU getestet haben; eine andere Servereinstellung oder GPU würde sie ändern. Als wir die ersten Ollama-Versionen von Nimble 9B und den Tev1-Modellen für die Kostenmessung ausführten, wich Tev1 0.8B bei 1,2 % der Fragen von seinem gewerteten Lauf ab, und Nimble 9B und Tev1 4B bei unter 1 %.
Bei der gewählten Einstellung stimmten die anderen selbst gehosteten Modelle mit mindestens 98 % ihrer gewerteten Antworten überein, außer Shisa DE-1 und Shisa DE-2. Sie variieren von Lauf zu Lauf selbst bei einer Anfrage nach der anderen, daher lag ihre Schwelle bei ihrer eigenen Einzelanfrage-Übereinstimmung minus 2 Prozentpunkten; sie stimmten mit 97,6 % und 96,4 % überein. Bei ihren eigenen Browser-Anfragen stimmten CLM-v0.1-8B, Shisa DE-2 und GEV-26B-Decide unter derselben Regel mit 90,7 %, 77,9 % und 83,1 % überein.
Ausnahmen vom Ausführen jedes Modells wie veröffentlicht:
- Laya Typed-Decisions lief mit einem 8.192-Token-Kontext statt seiner veröffentlichten 1.024, und Tev1 mit 8.194 statt 2.050, wie in unseren Browser-Läufen.
- Wo Layas eigener Code eine lange Option oder Eingabe abgeschnitten hätte, lehnte unser Connector die Anfrage stattdessen ab, und eine Ablehnung zählt als falsche Antwort. Jede Paper-Thema-Anfrage wurde abgelehnt, weil die Themenbeschreibungen länger sind als die 48 Tokens, die Laya pro Option liest.
- Der Encoder-Kontext von CLM wurde von 2.048 auf 16.384 Tokens erhöht; GLiNER lief über seine dokumentierte Eingabe von 512 Tokens hinaus. Shisa DE-1 verwendete einen 32.768-Token-Kontext, um in den GPU-Speicher zu passen.
- d3, d3-flash, d3-mini, Decision-2.0-Vega-27B, Decision-1.0-Lux-9B und MATILDA JEV v1.5 liefen auf einer NVIDIA A100, die ihre Hersteller nicht validiert haben; die drei d3 und Decision-2.0-Vega-27B liefen ohne ihre nur für AMD verfügbaren Fast Paths. JEV-27B-VL und GEV-26B-Decide liefen auf vLLM 0.29.0; ihre Model-Cards nennen einen unveröffentlichten vLLM-Build.
- NeoHorse-Jev-4B lief über den vLLM-Adapter seines Herstellers, da sein eigener Server Seitentext über 2.048 Tokens standardmäßig ablehnt.
- APUS Reflex 35B-A3B akzeptiert 2 bis 16 Optionen pro Frage, daher lehnte es alle 500 Paper-Thema-Fragen (20 Optionen) ab, die als falsche Antworten zählen, und es führte die Browser-Aufgaben nicht aus.
- Together AI hatte bis zum 30. September 2026 keine Lizenz für die Tev1-Gewichte veröffentlicht.
- Cloudflares Dienst liest für Clef und Clef-Flash nur die ersten 2.048 Tokens des Itemtexts, obwohl die Modelle 65.536 akzeptieren. Die 12 längeren Items, 9 zum Schweregrad und 3 zu Rückrufen, zählen als falsche Antworten.
Einschränkungen
Jedes Modell versuchte jede Browser-Aufgabe einmal, daher zeigt ein Abstand von wenigen Aufgaben zwischen zwei Modellen nicht, welches besser ist.
Die 50 Aufgaben stammen von neun Websites, und Aufgaben auf derselben Website teilen sich Seitenlayouts. Die Modelle liefen auf Live-Websites, die sich zwischen den Läufen ändern können.
Das Schrittformat, eine Operationsliste plus Ziellisten, wurde zuerst für Jev gebaut. Jedes Modell erhielt dasselbe Format. Wir haben nicht getestet, ob ein anderes Format die Ergebnisse ändern würde. Laya lief mit Eingabelimits über seinen veröffentlichten Einstellungen, damit lange Seiten nicht abgeschnitten wurden.
Im Klassifikations-Benchmark beantwortete jedes Modell jedes Item einmal. Die GitHub- und FDA-Antworten sind die erfassten Entscheidungen dieser Institutionen, die auf Hinweisen beruhen können, die der Hinweis- oder Rückruftext nicht enthält.
Zitieren Sie diesen Benchmark
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{AIM-Decision: Jev gegen Clef gegen LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/decision-models}},
  note   = {AIMultiple. Abgerufen am 21. Oktober 2026}
}Ergebnisse und Zeitstempel von 392 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 10 CSV-Dateien und eine README enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.