


Beste Common Crawl-Alternativen: Bright Data & Webz.io

Common Crawl veröffentlicht monatlich einen kostenlos Crawl von Seiten, die Sie selbst herunterladen und filtern. Wir haben fünf Alternativen getestet, die bereits gesammelte Seiten verkaufen, und verglichen, was jeder Anbieter speichert und liefert.
Funktionsvergleich der Common Crawl-Alternativen
- Massenlieferung in Ihren eigenen Speicher: der Anbieter schreibt die von Ihnen ausgewählten Daten in Ihren S3-, Google Cloud- oder Azure-Bucket oder an Ihren Webhook. Der öffentliche Bucket von Common Crawl, den Sie selbst herunterladen, zählt nicht.
- Meldet, wie viele Daten zu einer Domain gespeichert sind: Sie sehen, wie viele Seiten für eine Domain gespeichert sind, bevor Sie herunterladen.
- Live-Scraping beim selben Anbieter verfügbar: dasselbe Unternehmen verkauft auch ein Live-Abrufen jeder URL für Seiten, die das Archiv nicht hat.
- Kontinuierlicher Push-Feed neuer Seiten: Neue Seiten oder Posts kommen eigenständig an, sobald sie gecrawlt werden. Geplante Suchen wie Exa Monitors zählen nicht.
- Filter nach Veröffentlichungsdatum: Der Datumsfilter bezieht sich auf den Veröffentlichungszeitpunkt des Inhalts, nicht auf den Crawlzeitpunkt.
- Linkgraph-Daten: Daten darüber, welche Websites und Seiten aufeinander verweisen.
Preis & free-Guthaben
Bright Data erlaubt 100 kostenlos Archivsuchen pro Tag, und jede zeigt die Lieferkosten an, bevor Sie zahlen. Die monatlichen free-Guthaben decken Web Archive und Data Firehose nicht ab, und Data Firehose wird über den Vertrieb eingerichtet.
Der Preis von Webz.io ist der Kartenpreis für eine Archive-Bestellung; Guthabenpakete und ältere Dumps werden vom Vertrieb bepreist.
Exa berechnet auch die Suche, und zwar mit $7 pro 1.000 Anfragen. Das Auffinden von 1.000 Seiten bei 10 Ergebnissen pro Suche kostet also zusätzlich etwa $0,70.
Ahrefs Firehose berechnet nur neue, deduplizierte Treffer, und die kostenpflichtigen Tarife kosten $39 bis $299 pro Monat.
Die Abrechnungsregeln unterscheiden sich zwischen den Produkten desselben Anbieters. Prüfen Sie daher die Dokumentation des Produkts, das Sie verwenden möchten.
Web-Archivierungs-APIs
Bright Data Web Archive API verkauft Seiten, die Bright Data’s Unlocker- und SERP-APIs bereits für Kunden gesammelt haben. Unlocker löst CAPTCHAs und behandelt Anti-Bot-Systeme wie Cloudflare, Akamai und DataDome, sodass das Archiv Seiten von Websites enthält, die Crawler blockieren. Der Crawler von Common Crawl folgt robots.txt und lässt diese Websites aus.
Der Pool folgt dem, was Kunden scrapen, und nicht einem Crawl-Zeitplan. Er umfasste mehr als 115 PB über etwa 800 Milliarden Seiten aus rund 380 Millionen Domains und fügt täglich etwa 1.6 Milliarden Seiten hinzu. Data Firehose sendet dieselbe Art von Seiten, sobald sie gesammelt werden, sodass der Kunde nicht danach suchen muss.
- Seiten, die älter als 24 Stunden sind, werden zuerst aus S3 Glacier Deep Archive wiederhergestellt, sodass ihre Lieferung bis zu 72 Stunden dauern kann.
- Jede Suche benötigt einen Zeitraum, und eine Suche, die länger als 30 Sekunden läuft, gibt eine Such-ID zum Abrufen zurück statt Ergebnisse.
- Ein Metadaten-Export gibt die URLs und Metadaten einer Suche als gzip-komprimierte CSV ohne Seiteninhalt zurück.
Data Firehose
Bright Data richtet jeden Firehose-Feed gemeinsam mit dem Kunden ein, bevor der erste Datensatz ankommt: Zieldomains, Kategorien, Sprachen und Länder sowie ob Recrawls derselben URL gespeichert werden. Recrawls sind wichtig für das Preis-Monitoring, bei dem jede neue Kopie einer Produktseite einen neuen Preis enthalten kann, während ein Produktkatalog nur eine Kopie pro Seite benötigt.
Die Seiten kommen dann als rohes HTML, geparste Ausgabe, Bilder oder Video über Amazon S3, einen Webhook oder einen Stream an, einzeln oder in Batches nach Zeit oder Größe. Es werden nur Seiten geliefert, die HTTP 200 zurückgegeben haben, und Pausieren, Filteränderungen und Volumen laufen über eine API.
Web Archive API
Wir haben die Web Archive API praktisch genutzt. Eine Suche filtert den Pool nach Zeitraum, Domain, URL-Muster, Kategorie, Sprache und Land und liefert die Datensatzanzahl und die Lieferkosten, bevor etwas geliefert wird. Ein Dump schreibt die passenden Seiten dann in Amazon S3, Azure Blob Storage, Google Cloud Storage oder einen Webhook.
Wir durchsuchten das Archiv nach zillow.com und redfin.com, nahmen eine Beispiel-Lieferung über einen Webhook entgegen und öffneten die Dateien.
Filter
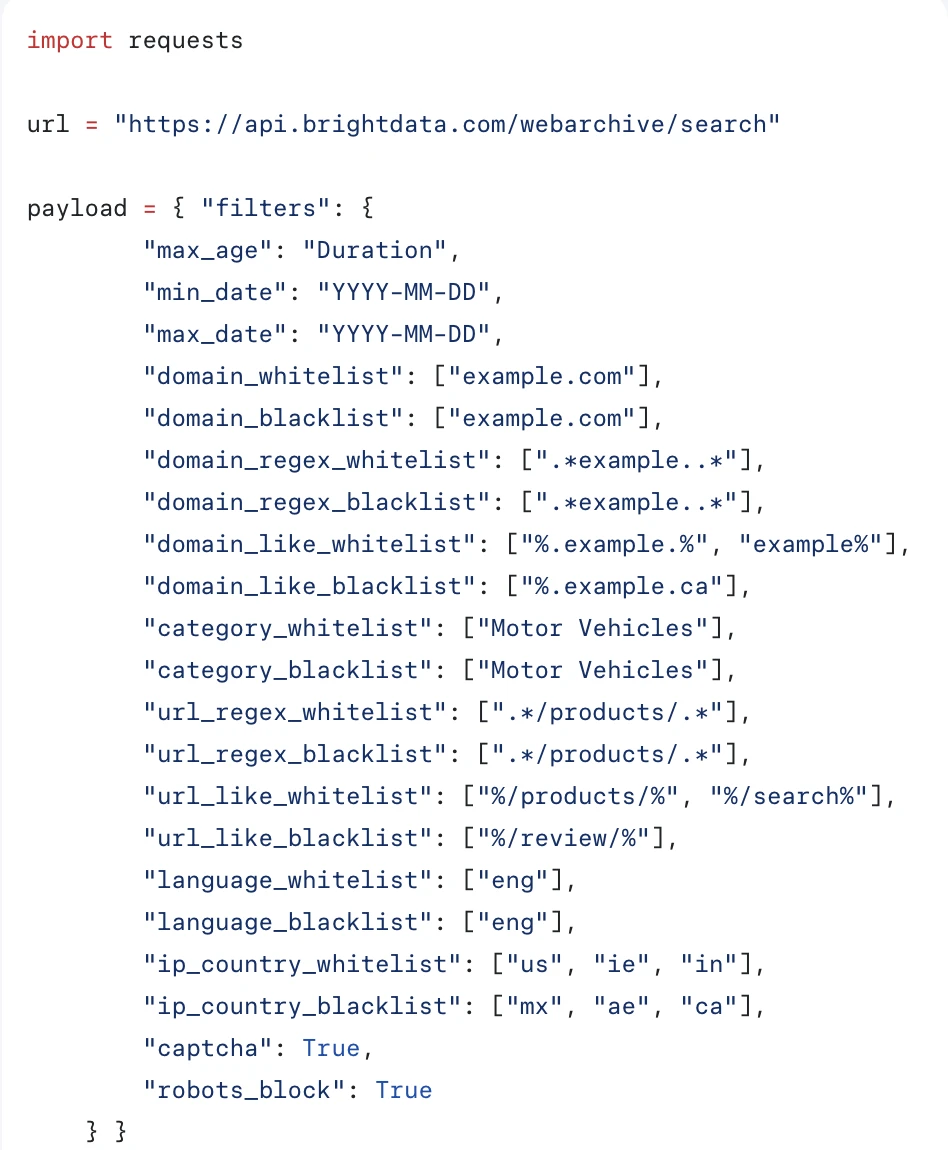
Alles läuft über ein filters-Objekt mit 20 Feldern: Zeitraum, Domain, URL-Muster, Kategorie, Sprache, Land und Sammlungsergebnis. Die Zeit ist Pflicht, und die Kategorie ist eine geschlossene Liste von 30 Werten, sodass Seiten bereits beim Eingang klassifiziert werden.
Zwei Felder beschreiben, wie die Seite gesammelt wurde, und nicht, was sie enthält. ip_country filtert nach dem Land der Exit-IP, die Seite gesammelt hat, was bestätigt, dass das Archiv ein Nebenprodukt des proxy-Netzwerks ist. captcha und robots_block geben nur Datensätze zurück, bei denen ein CAPTCHA ausgelöst wurde oder eine Robots-Regel angewendet wurde, sodass blockierte Versuche gespeichert statt verworfen werden.
Suche und Kosten
Das Suchen ist kostenlos, bis zu 100 Abfragen pro Tag, und die Antwort enthält alles, was Sie brauchen, um einen Auftrag vor der Bezahlung zu bemessen: die Anzahl der übereinstimmenden Datensätze, die geschätzten Lieferkosten und eine Aufschlüsselung, wie viele Seiten sich in der 24-Stunden-Cache-Stufe im Vergleich zur Archiv-Stufe befinden.
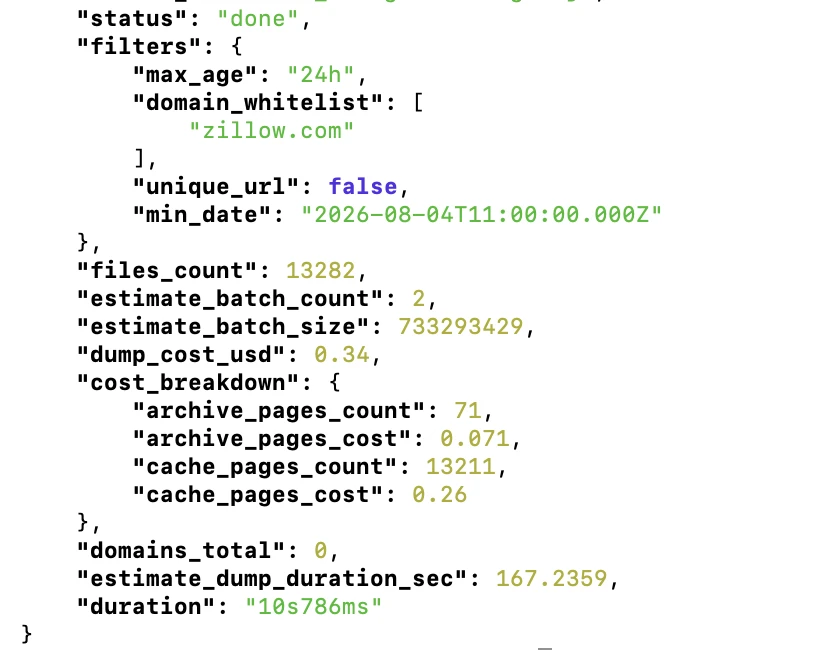
- Abdeckung von Websites, die Crawler blockieren: Common Crawl enthält über einen gesamten monatlichen Crawl hinweg null Seiten für zillow.com. Bright Data lieferte 13.282 Datensätze für ein einzelnes 24-Stunden-Fenster.
- Die Abfragegeschwindigkeit skaliert mit dem Fenster: Eine 240-Tage-Abfrage zu redfin.com lieferte 59.831 Datensätze in 1 Minute 53 Sekunden. Die 24-Stunden-Abfrage für zillow.com wurde in 10,8 Sekunden beantwortet.
- Zwei Speicherstufen: Daten der letzten 24 Stunden kosten $0,20 pro 1.000 Seiten. Alles Ältere wandert zu S3 Glacier Deep Archive zu $1 pro 1.000. Die Lieferzeit folgt dem: Unser 24-Stunden-Auftrag kam in etwa 30 Sekunden an, während der 240-Tage-Auftrag zig Minuten lang in
restoring_archive_datablieb. - Lieferung in Ihren eigenen Speicher: Amazon S3, Azure Blob Storage, Google Cloud Storage oder Webhook. Wir haben den Webhook-Weg getestet; zehn Seiten kamen als ein einziges tar mit jeweils einer
.html.gzund einer.meta.jsonpro Seite an. - Stichprobe vor der Verpflichtung:
max_entriesbegrenzt, wie viele Dateien eine Lieferung enthält, sodass eine Abfrage mit 59.831 Datensätzen mit zehn Seiten für einen Bruchteil eines Cents getestet werden kann.
Erhalten Sie 100 kostenlos Archivsuchen/Tag mit Bright Data
Kostenlosen Zugang erhaltenWas tatsächlich in den Dateien steckt
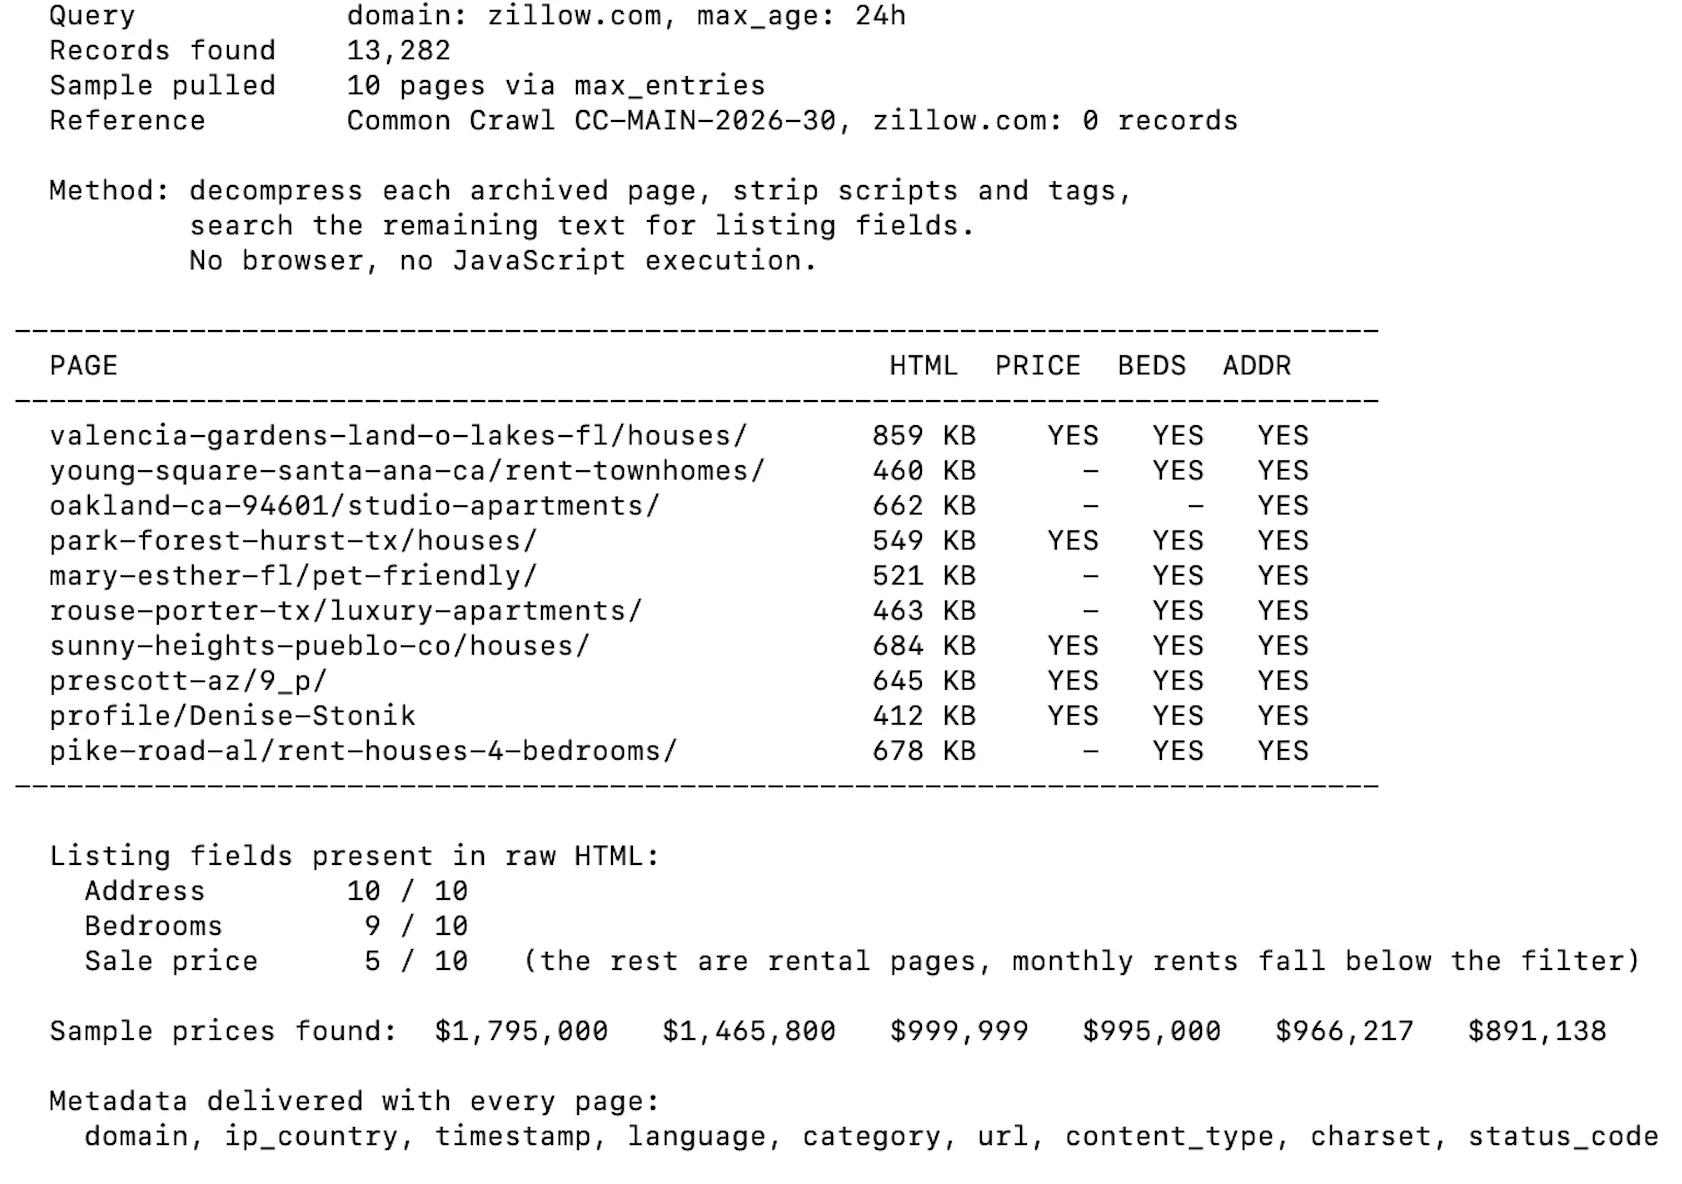
Jede Seite kommt so an, wie der Server sie gesendet hat, mit neun Metadatenfeldern: domain, url, timestamp, language, category, ip_country, content_type, charset und status_code. Um zu prüfen, ob dieses rohe HTML ohne Browser nutzbar ist, öffneten wir zehn archivierte Zillow-Seiten, entfernten Skripte und Tags und durchsuchten den verbleibenden Text nach Listing-Feldern.
Webz.io sammelt Posts von Nachrichtenseiten, Blogs, Foren und Bewertungsseiten und gibt jeden als strukturierten JSON-Datensatz zurück, während Common Crawl die rohe Seite behält. Der Firehose sendet neue Posts für Filter, die pro Kunde eingerichtet sind, während das Archive und Bulk-Dumps vergangene Jahre abdecken.
- Das Self-Serve Archive reicht fünf Jahre zurück. Bulk-Dumps ganzer, ungefilterter Monate reichen für News bis 2008 und für Blogs und Foren bis Dezember 2014 zurück und werden auf Anfrage aus AWS Glacier bereitgestellt.
- Entitäten enthalten ihr eigenes Sentiment auf Englisch, Deutsch, Spanisch und Italienisch, und Anreicherungsfelder erscheinen nur in Daten ab etwa 2015.
- Eine Archive-Bestellung muss mindestens 10 Posts in den letzten 30 Tagen finden und liefert nur NDJSON. Files werden bei 500 MB geteilt, und der Download-Link bleibt sieben Tage gültig.
- Die News-API reicht für Nachrichten etwa ein Jahr zurück, während Blog- und Forenposts etwa 31 Tage lang durchsuchbar bleiben.
- Ein Feld `ai_allow` zeigt, ob Webz.io eine Einschränkung auf Quellenebene für das KI-Training gefunden hat, und Abfragen können danach filtern.
Der Abfrage-Builder
Abfragen kombinieren einen booleschen Ausdruck über den Text mit Bedingungen auf Feldebene, verknüpft mit AND. Jede Bedingung wird aus einer Eigenschaft, einem Operator und einem Wert erstellt.
Ein Detail sollten Sie vor der Verwendung kennen: Der mit Equals bezeichnete Operator erfordert keine exakte Übereinstimmung. Wir gaben redfin für das Feld „Seitentitel“ ein, und es traf eine Website mit dem Titel „Redfin Real Estate News“.
Was zurückkommt
Jedes Ergebnis enthält den vollständigen Text zusammen mit entities, sentiment, social, categories, language, domain_rank, country und einem syndication-Objekt, das festhält, ob dieselbe Geschichte anderswo erschienen ist. Es gibt kein Roh-HTML-Feld. Die Produktseite beschreibt das, was Sie erhalten, als „den vollständigen Text jedes Artikels, Posts, Threads oder jeder Rezension“, und die Lieferung erfolgt „über die API oder durch eine selbst ausgeführte Abfrage“.
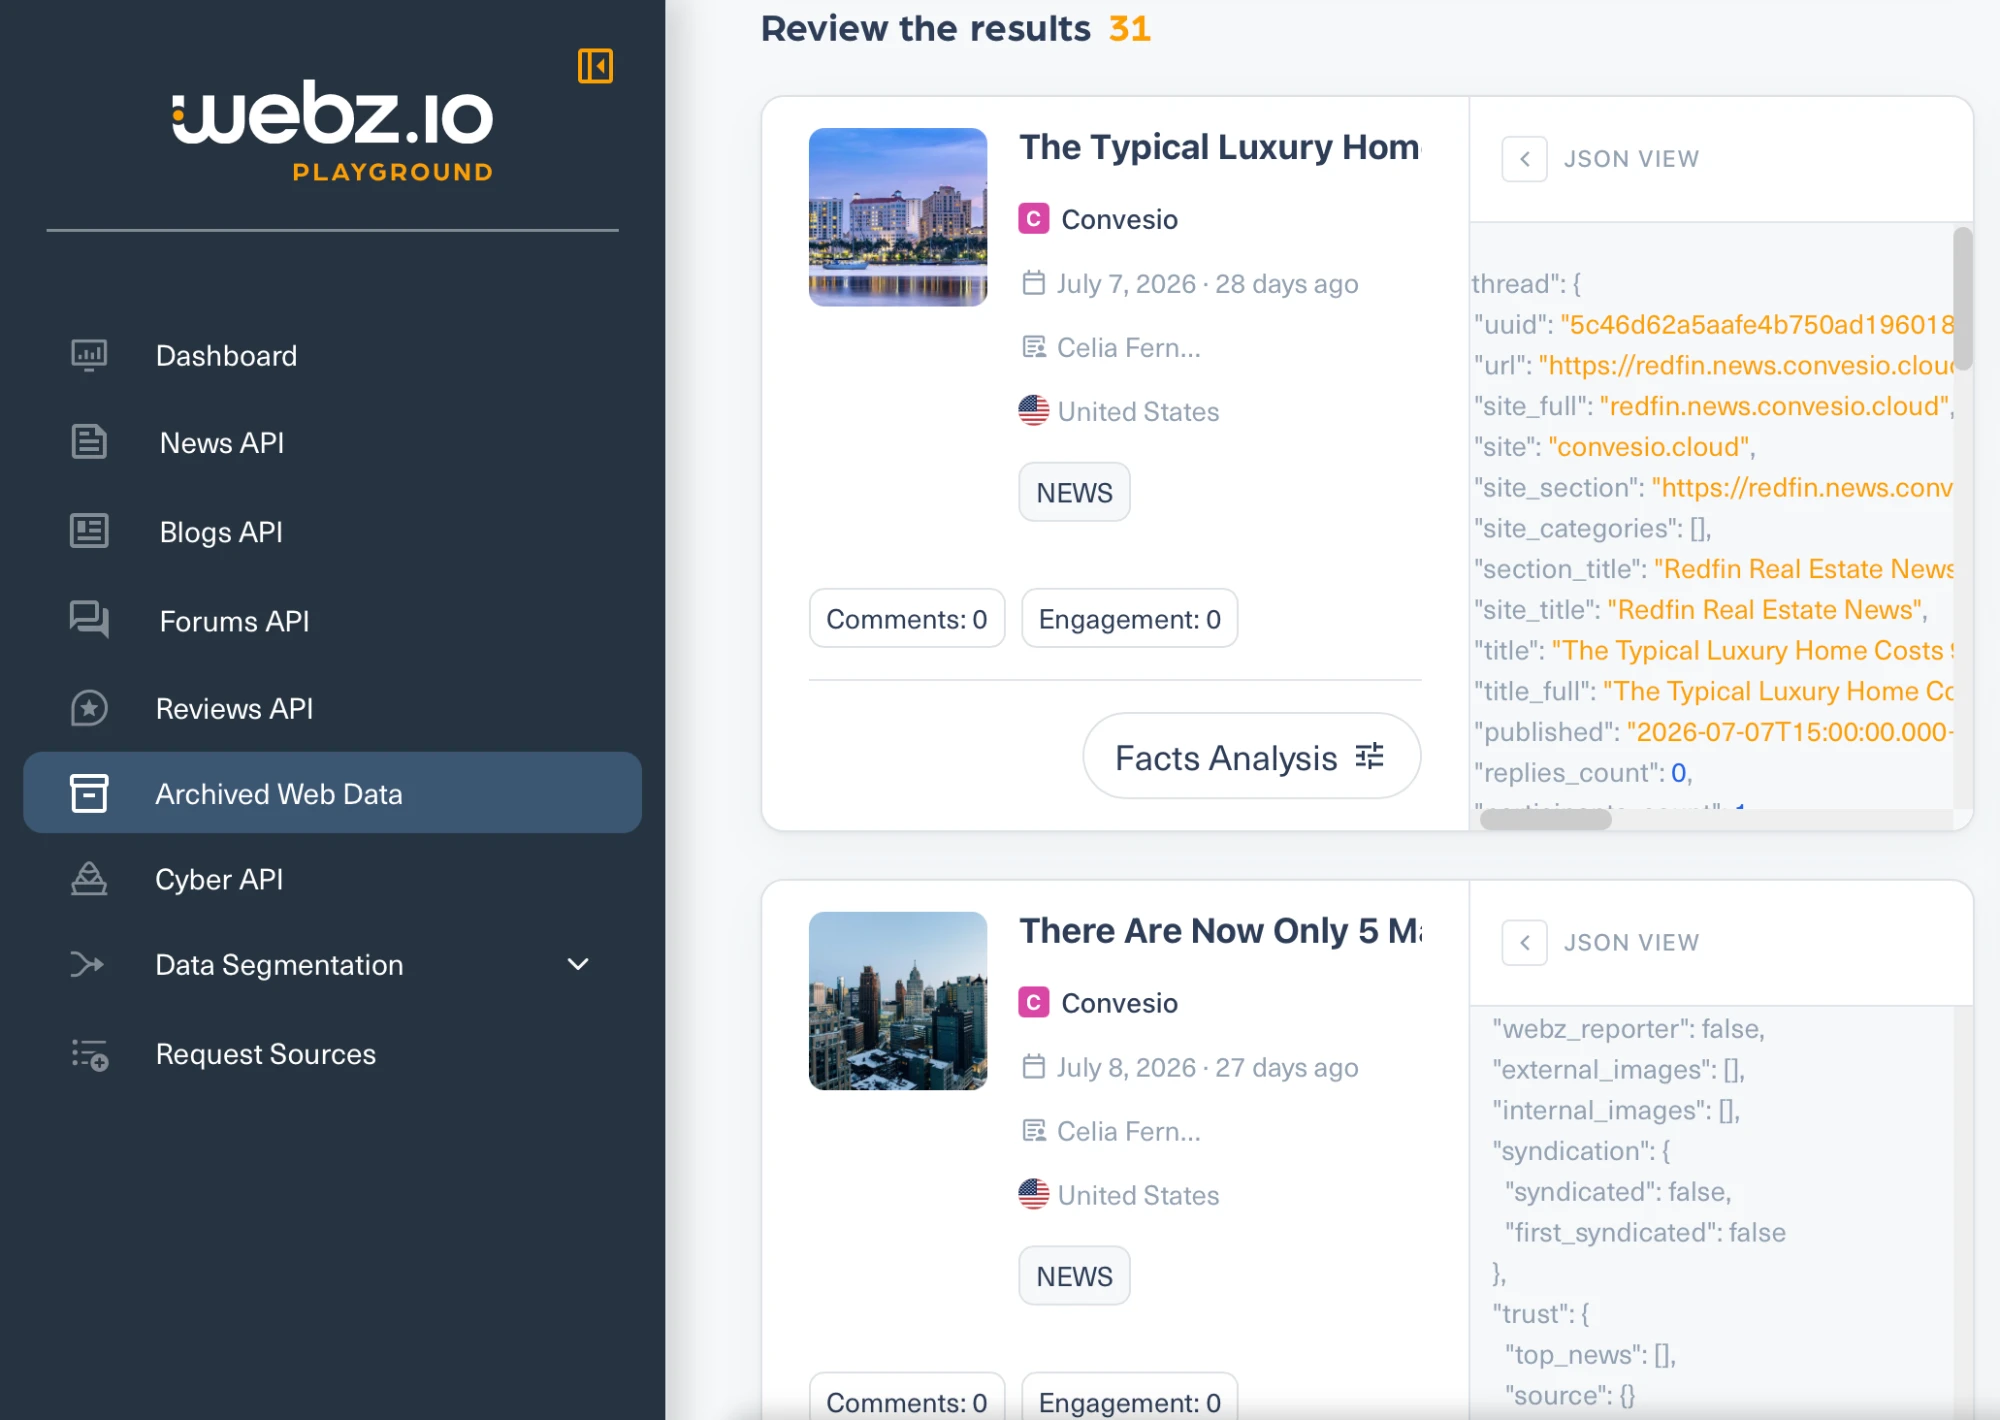
- Das Archiv enthält Publisher, keine Listing-Websites. Die Suche nach Redfin lieferte Redfins Unternehmens-News-Blog, gehostet auf
convesio.cloud, und nicht Seiten von redfin.com. Die direkte Abfrage des Website-Domain-Felds nachredfin.comlieferte nichts, währendconvesio.cloudundyahoo.comErgebnisse lieferten. Die leere Antwort spiegelt also die Abdeckung wider und nicht eine fehlerhafte Abfrage. - Die Massensammlung ist vertraglich eingeschränkt. Die Nutzungsbedingungen verbieten einen pauschalen Sternchen-Filter und vertikale Filter wie
site_type:newsoderlanguage:english, die genau die Abfrageformen sind, die ein Korpus-Käufer verwenden würde. Die Oberfläche selbst schlägt vor,site_type:newshinzuzufügen, um eine Suche einzugrenzen.
Exa hat einen eigenen Web-Index aufgebaut und verkauft die Suche darüber. Exa gibt an, dass sein Index über 2 Billionen URLs verfolgt und 100 Milliarden Seiten bereitstellt.
Für diesen Vergleich ist der relevante Teil nicht der Search-Endpoint, sondern /contents, das den Text einer Seite aus dem Cache von Exa zurückgibt, statt ihn live zu laden.
Cache- oder Live-Optionen
Ein einziger Parameter steuert das. maxAgeHours mit 24 bedeutet: Verwende die zwischengespeicherte Kopie, wenn sie weniger als einen Tag alt ist, andernfalls crawl. Bei 0 wird immer gecrawlt. Bei -1 wird nie gecrawlt und nur zurückgegeben, was bereits gespeichert ist. Der maximal akzeptierte Wert beträgt 720 Stunden, daher kann der Parameter nichts referenzieren, das älter als 30 Tage ist.
Wir führten zwei Anfragen mit einer Altersgrenze aus, die so gesetzt war, dass Exa niemals crawl und nur zurückgibt, was bereits gespeichert ist. Die erste fragte nach einer Redfin-Stadtseite.
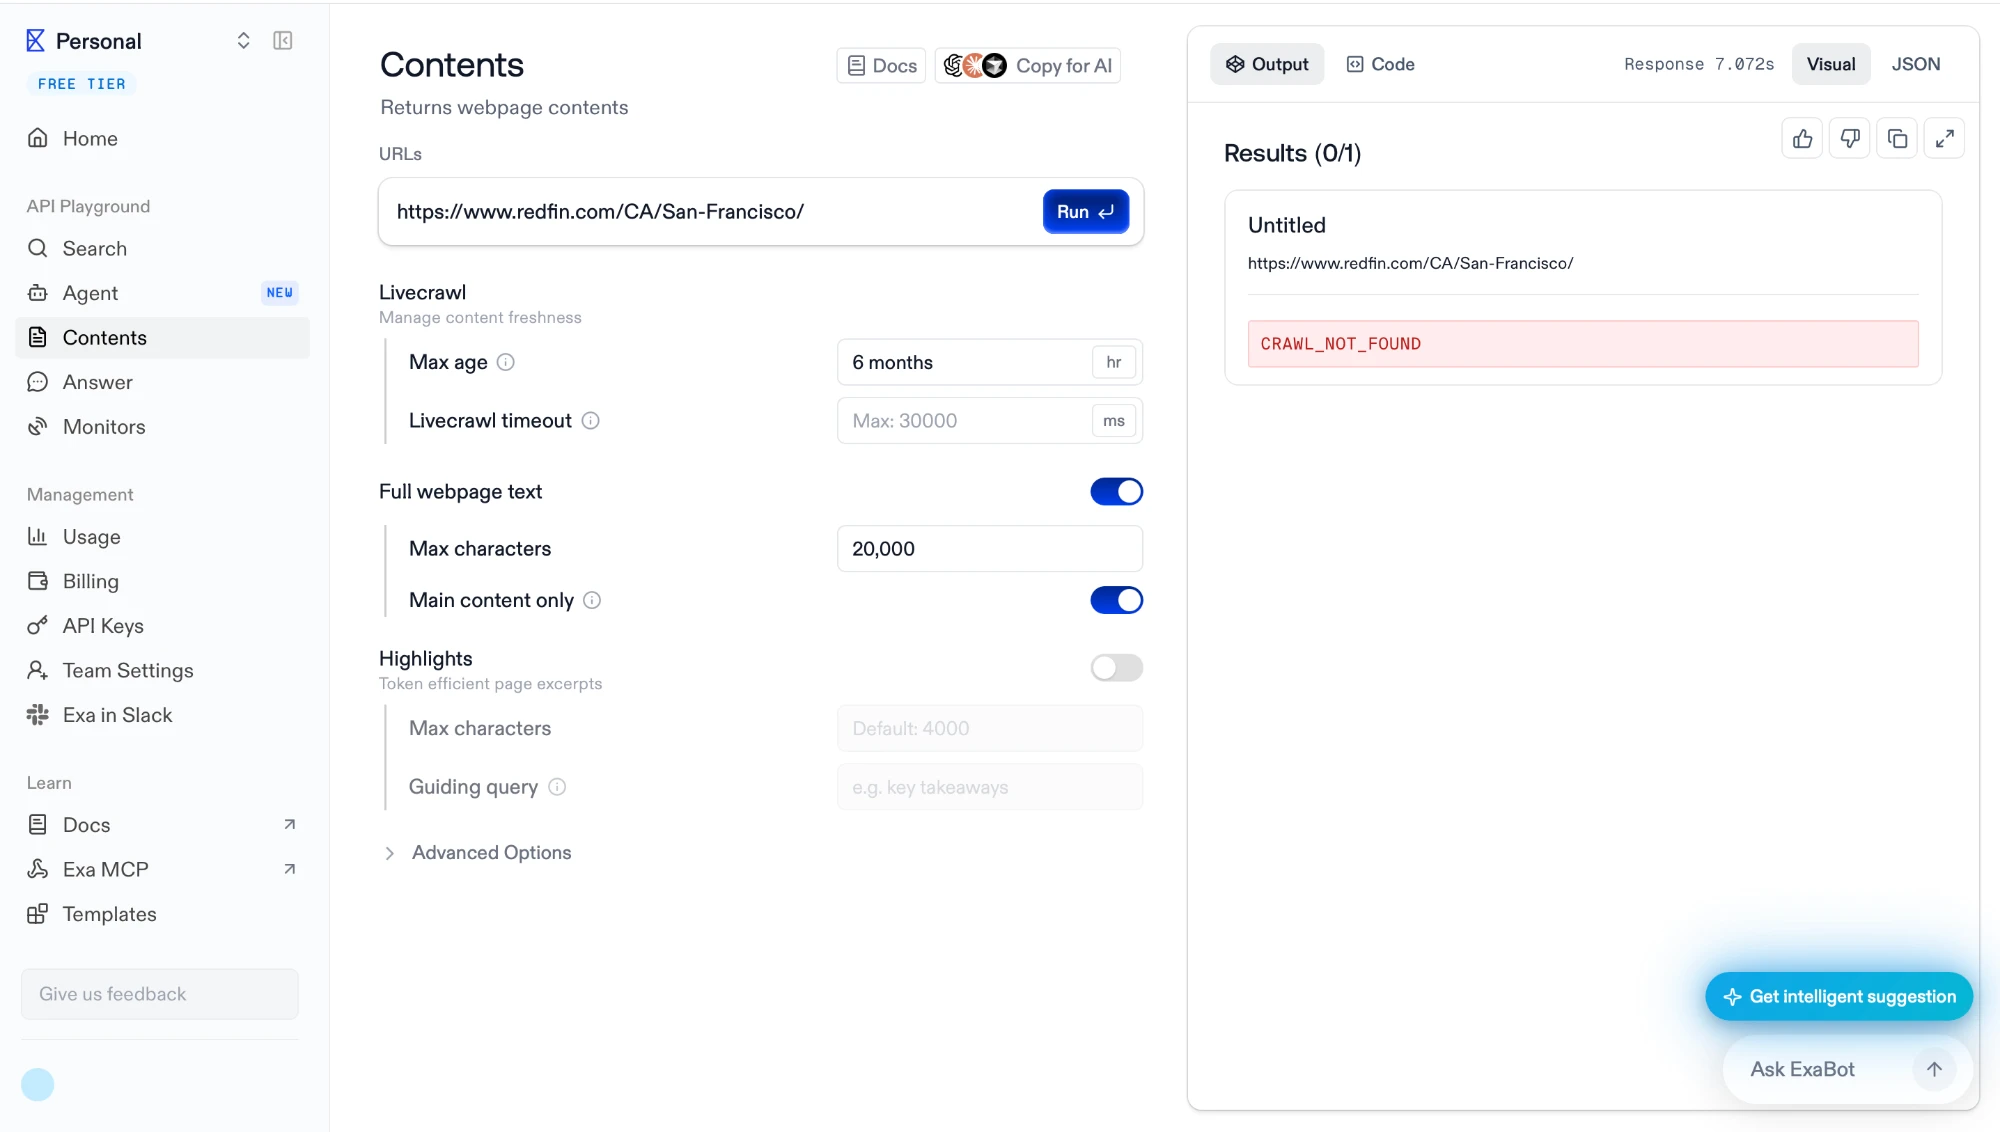
Es gab CRAWL_NOT_FOUND nach 7,07 Sekunden zurück. Die zweite fragte nach der Redfin-Startseite.
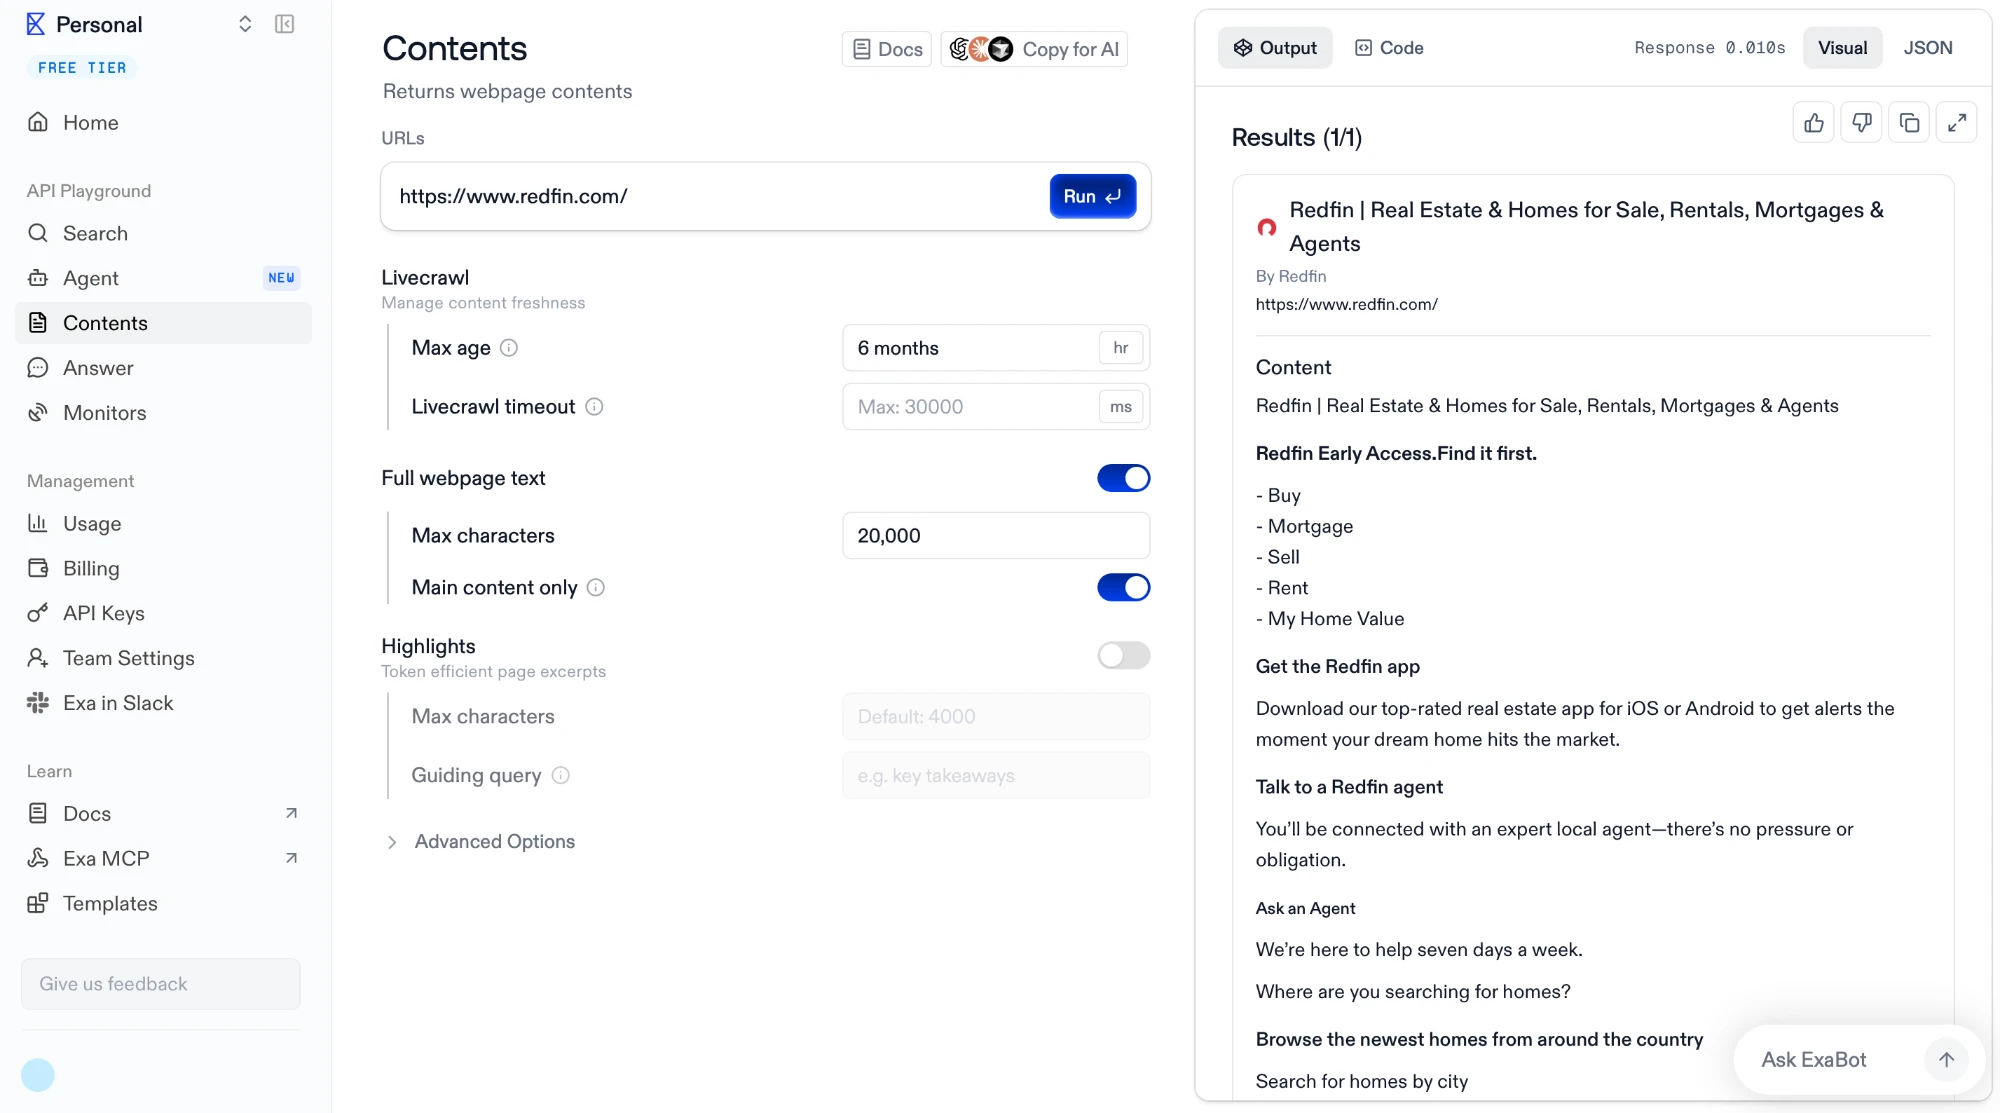
Es gab den vollständigen Seiteninhalt in 0.010 Sekunden zurück. Zehn Millisekunden sind kürzer als ein Netzwerk-Roundtrip, daher kam diese Antwort aus dem Speicher und nicht von einem Abruf. Der Cache ist real, und der siebensekündige Fehlschlag war Exa, das suchte und nicht fand.
Zwei weitere Standardeinstellungen sind im selben Bildschirm sichtbar. Der Inhalt ist auf 20.000 Zeichen begrenzt, und „nur Hauptinhalt“ ist aktiviert, sodass Navigation und Standardtext von Exas eigener Logik entfernt werden und nicht von Ihrer.
Die Abdeckung ist auf Seitenebene lückenhaft
Die Startseite war im Cache; die Stadtseite für San Francisco nicht. Die Suche nach der Domain zeigt, warum das keine einfache Anwesenheit-oder-Abwesenheit-Frage ist.
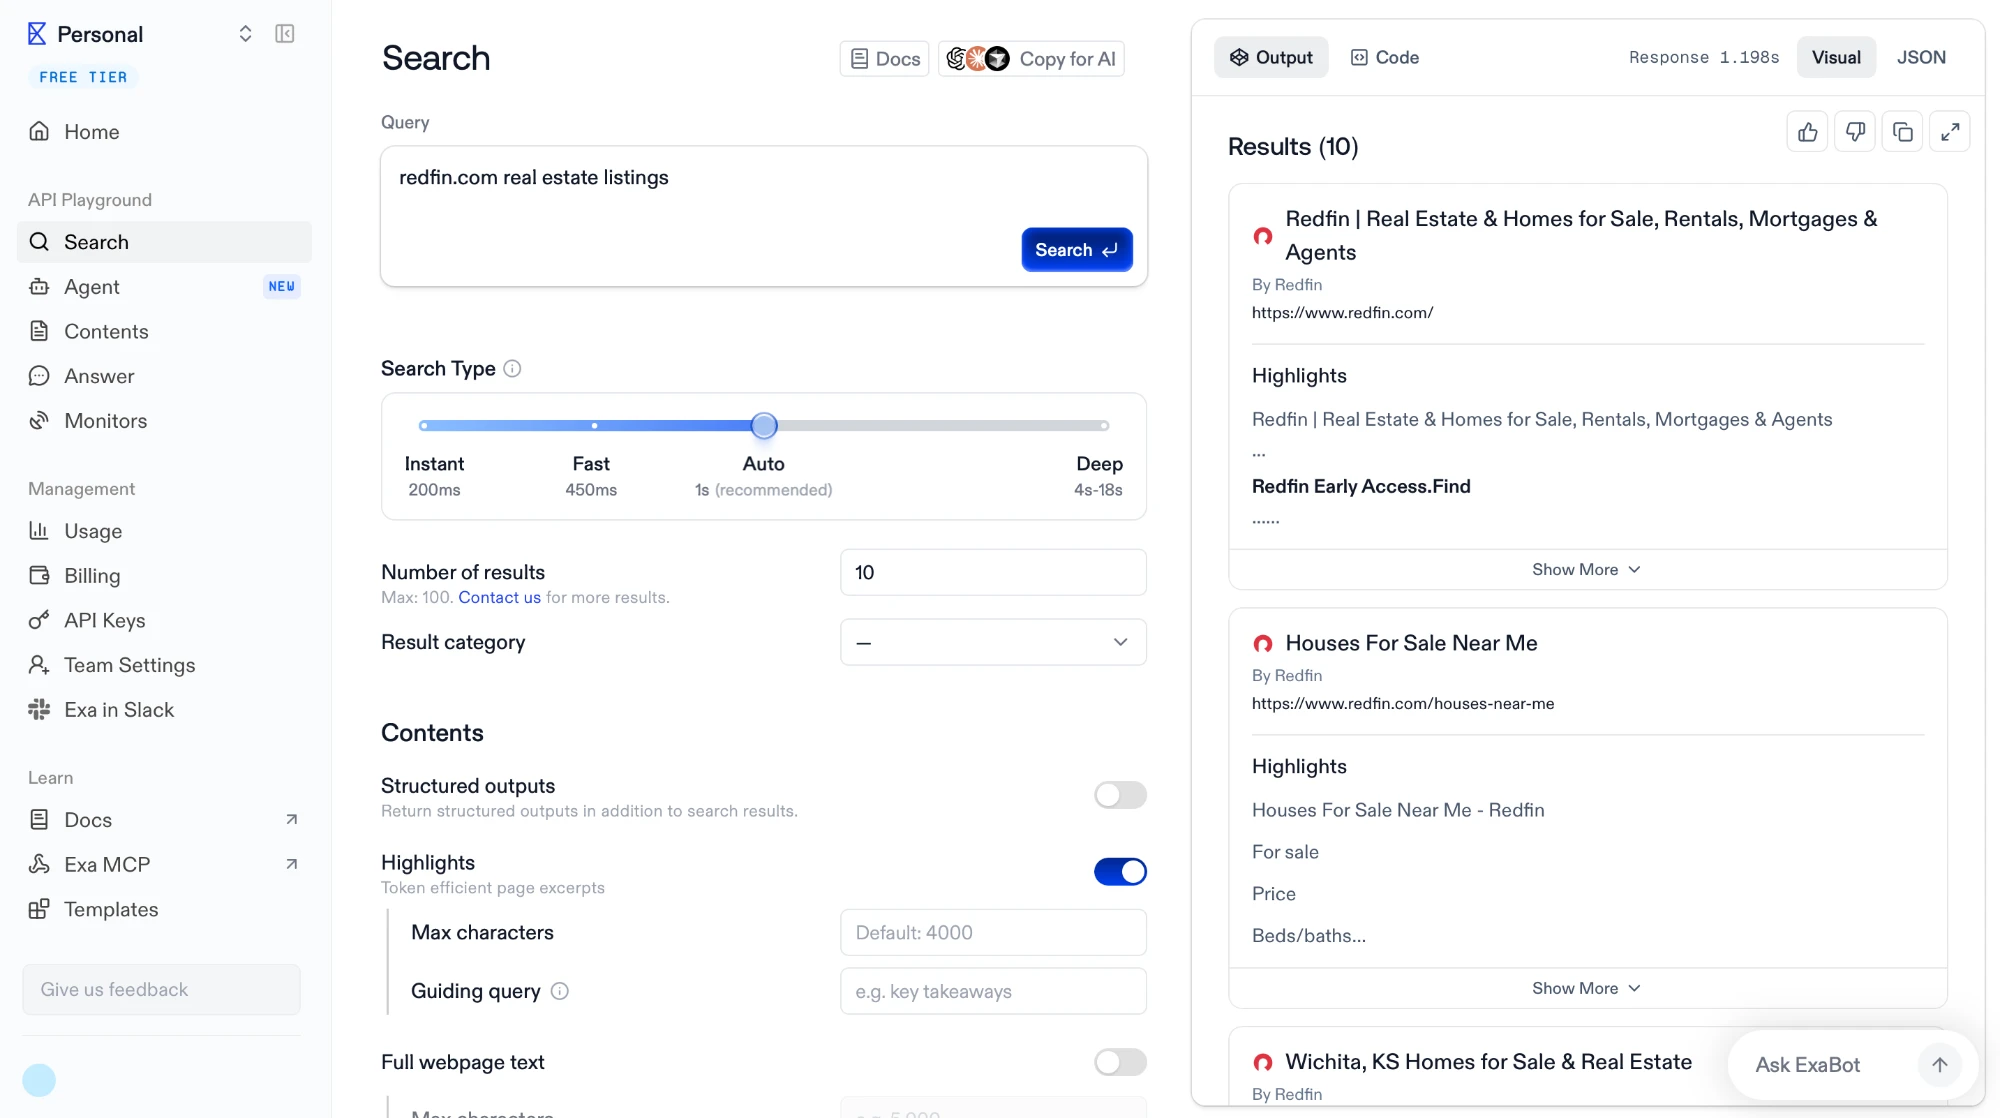
Die Abfrage lieferte die Redfin-Startseite, eine „Houses For Sale Near Me“-Seite und eine Stadtseite für Wichita, sodass tiefe Seiten im Index durchaus existieren. Die Abdeckung ist über eine Domain verstreut und nicht vollständig oder leer.
Einschränkungen
Derselbe Bildschirm enthält den Satz, der Exa in diesem Vergleich von den Archiven unterscheidet: „Anzahl der Ergebnisse: 10. Max.: 100. Kontaktieren Sie uns für weitere Ergebnisse.“
Es gibt keine Gesamtzahl. Common Crawl beantwortete diese Frage mit einer SQL-Abfrage, und Bright Data beantwortete sie mit einem files_count-Feld.
Kein Bulk-Export, keine Lieferung in den eigenen Speicher, kein Firehose. Der Enterprise-Tarif erwähnt benutzerdefinierte Indizes, die über die API bereitgestellt werden, statt dass Daten übergeben werden.
Ahrefs Firehose streamt die Seiten, die AhrefsBot crawlt und die den Regeln eines Kunden entsprechen, aber jedes Ereignis enthält den geänderten Text einer Seite, während Common Crawl die ganze Seite speichert. Regeln verwenden Lucene-Syntax und werden auf den Text angewendet, der seit dem letzten Crawl hinzugefügt oder entfernt wurde.
- Ein Ereignis enthält die URL, den Titel, den Veröffentlichungszeitpunkt und die eingefügten und entfernten Textabschnitte mit etwas umgebendem Kontext. Ereignisse kommen über Server-Sent Events an, bleiben etwa 24 Stunden gepuffert, und ein Client setzt mit der letzten Ereignis-ID fort.
- URL Watch crawlt eine ausgewählte Liste von URLs nach Zeitplan erneut und speichert den Diff jedes Crawls sowie einen gerenderten Schnappschuss.
- Smart Digest, in der Beta, lässt einen Agenten die Treffer eines Taps nach Zeitplan von stündlich bis wöchentlich lesen und einen Bericht über die Änderungen per E-Mail senden.
- Backlink- und Referring-Domain-Daten stammen aus dem Ahrefs API Site Explorer, einem von Firehose getrennten Produkt.
Erstellen der Regel
Wir haben Firehose so eingerichtet, dass es neu auf OpenRouter gelistete Modelle und Modellankündigungen von KI-Laboren mit einem Tap und zwei Regeln verfolgt. Eine Regel kann mit einer Beschreibung in einfacher Sprache, einem visuellen Builder oder einer direkt eingegebenen Lucene-Abfrage beginnen. Die erste Regel, domain:openrouter.ai, erfasst neue Modellseiten auf OpenRouter. Wir haben demselben Tap eine zweite Regel für die Websites von OpenAI (openai.com), Anthropic (anthropic.com), Google (blog.google und deepmind.google), Mistral (mistral.ai), xAI (x.ai) und Meta (ai.meta.com) hinzugefügt. Sie erfasst Seiten auf diesen Websites, deren Titel „introducing“, „model“ oder „launch“ enthalten.
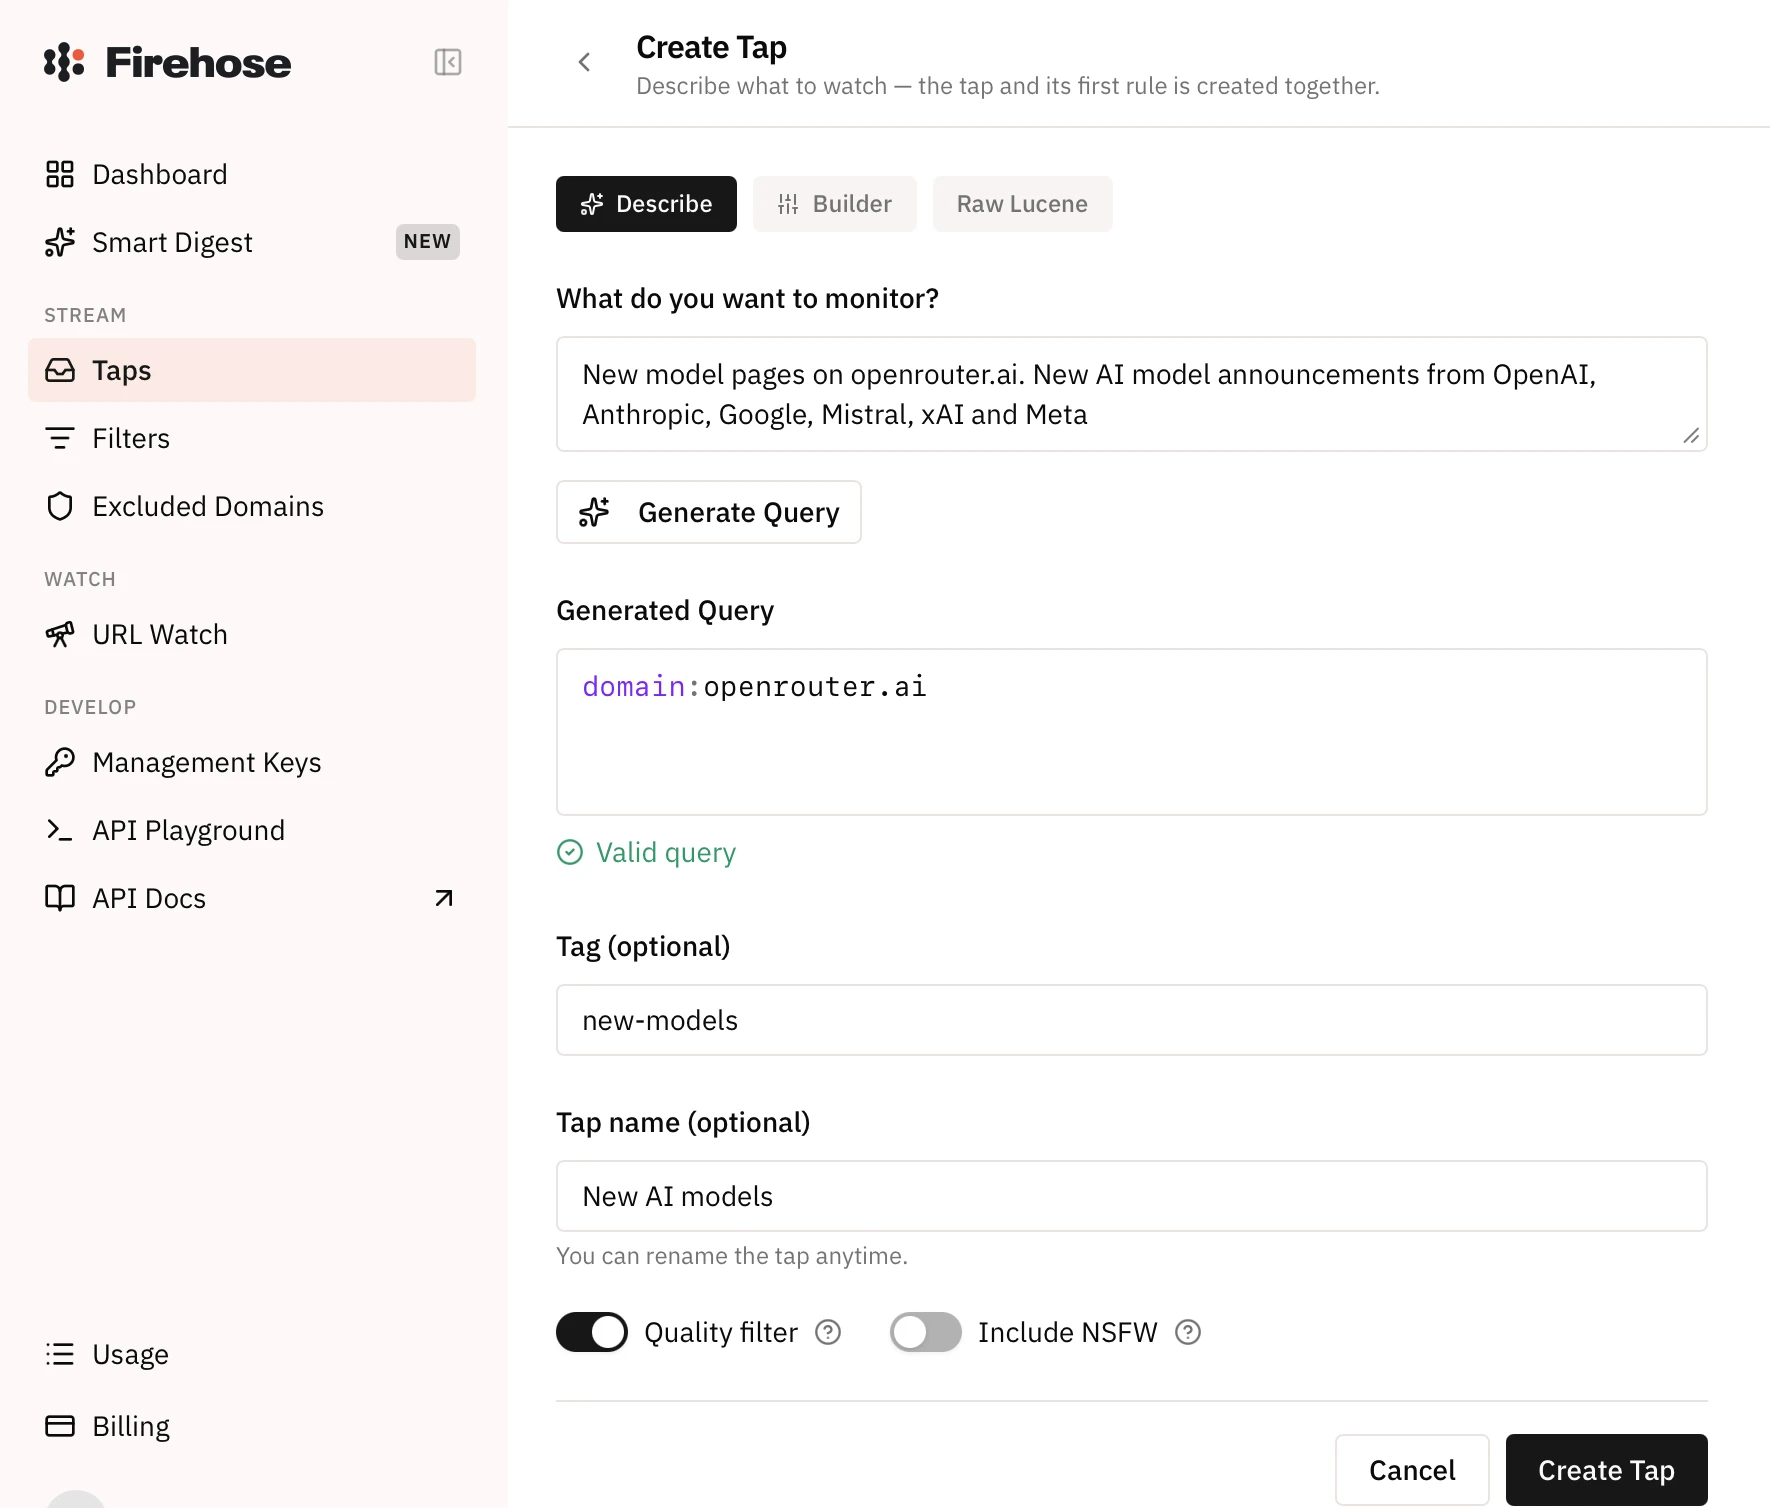
Die Vorschau erklärt die Regel in einfachen Worten („Domain is openrouter.ai“), statt Beispielseiten aufzulisten, sodass die Reichweite einer Regel erst sichtbar wird, nachdem Treffer eingehen. Eine neue Regel erfasst Seiten, die nach ihrer Aktivierung gecrawlt wurden, und durchsucht keine vergangenen Crawls. Der Qualitätsfilter ist standardmäßig aktiviert und lässt nur Seiten durch, die in den letzten 7 Tagen veröffentlicht wurden, und schließt Paginierung, Tag-Seiten und Query-String-URLs aus.
Was ein Treffer enthält
Innerhalb von etwa 90 Minuten nach dem Livegang des Taps gab es 10 Treffer zurück, alle aus der OpenRouter-Regel. Es handelte sich um die deutschen, spanischen, französischen und englischen Seiten von drei Modellen, die OpenRouter an diesem Morgen in seinen Katalog aufgenommen hatte: Gemini 2.5 Pro TTS, Gemini 2.5 Flash TTS und Pixtral Large 2502.
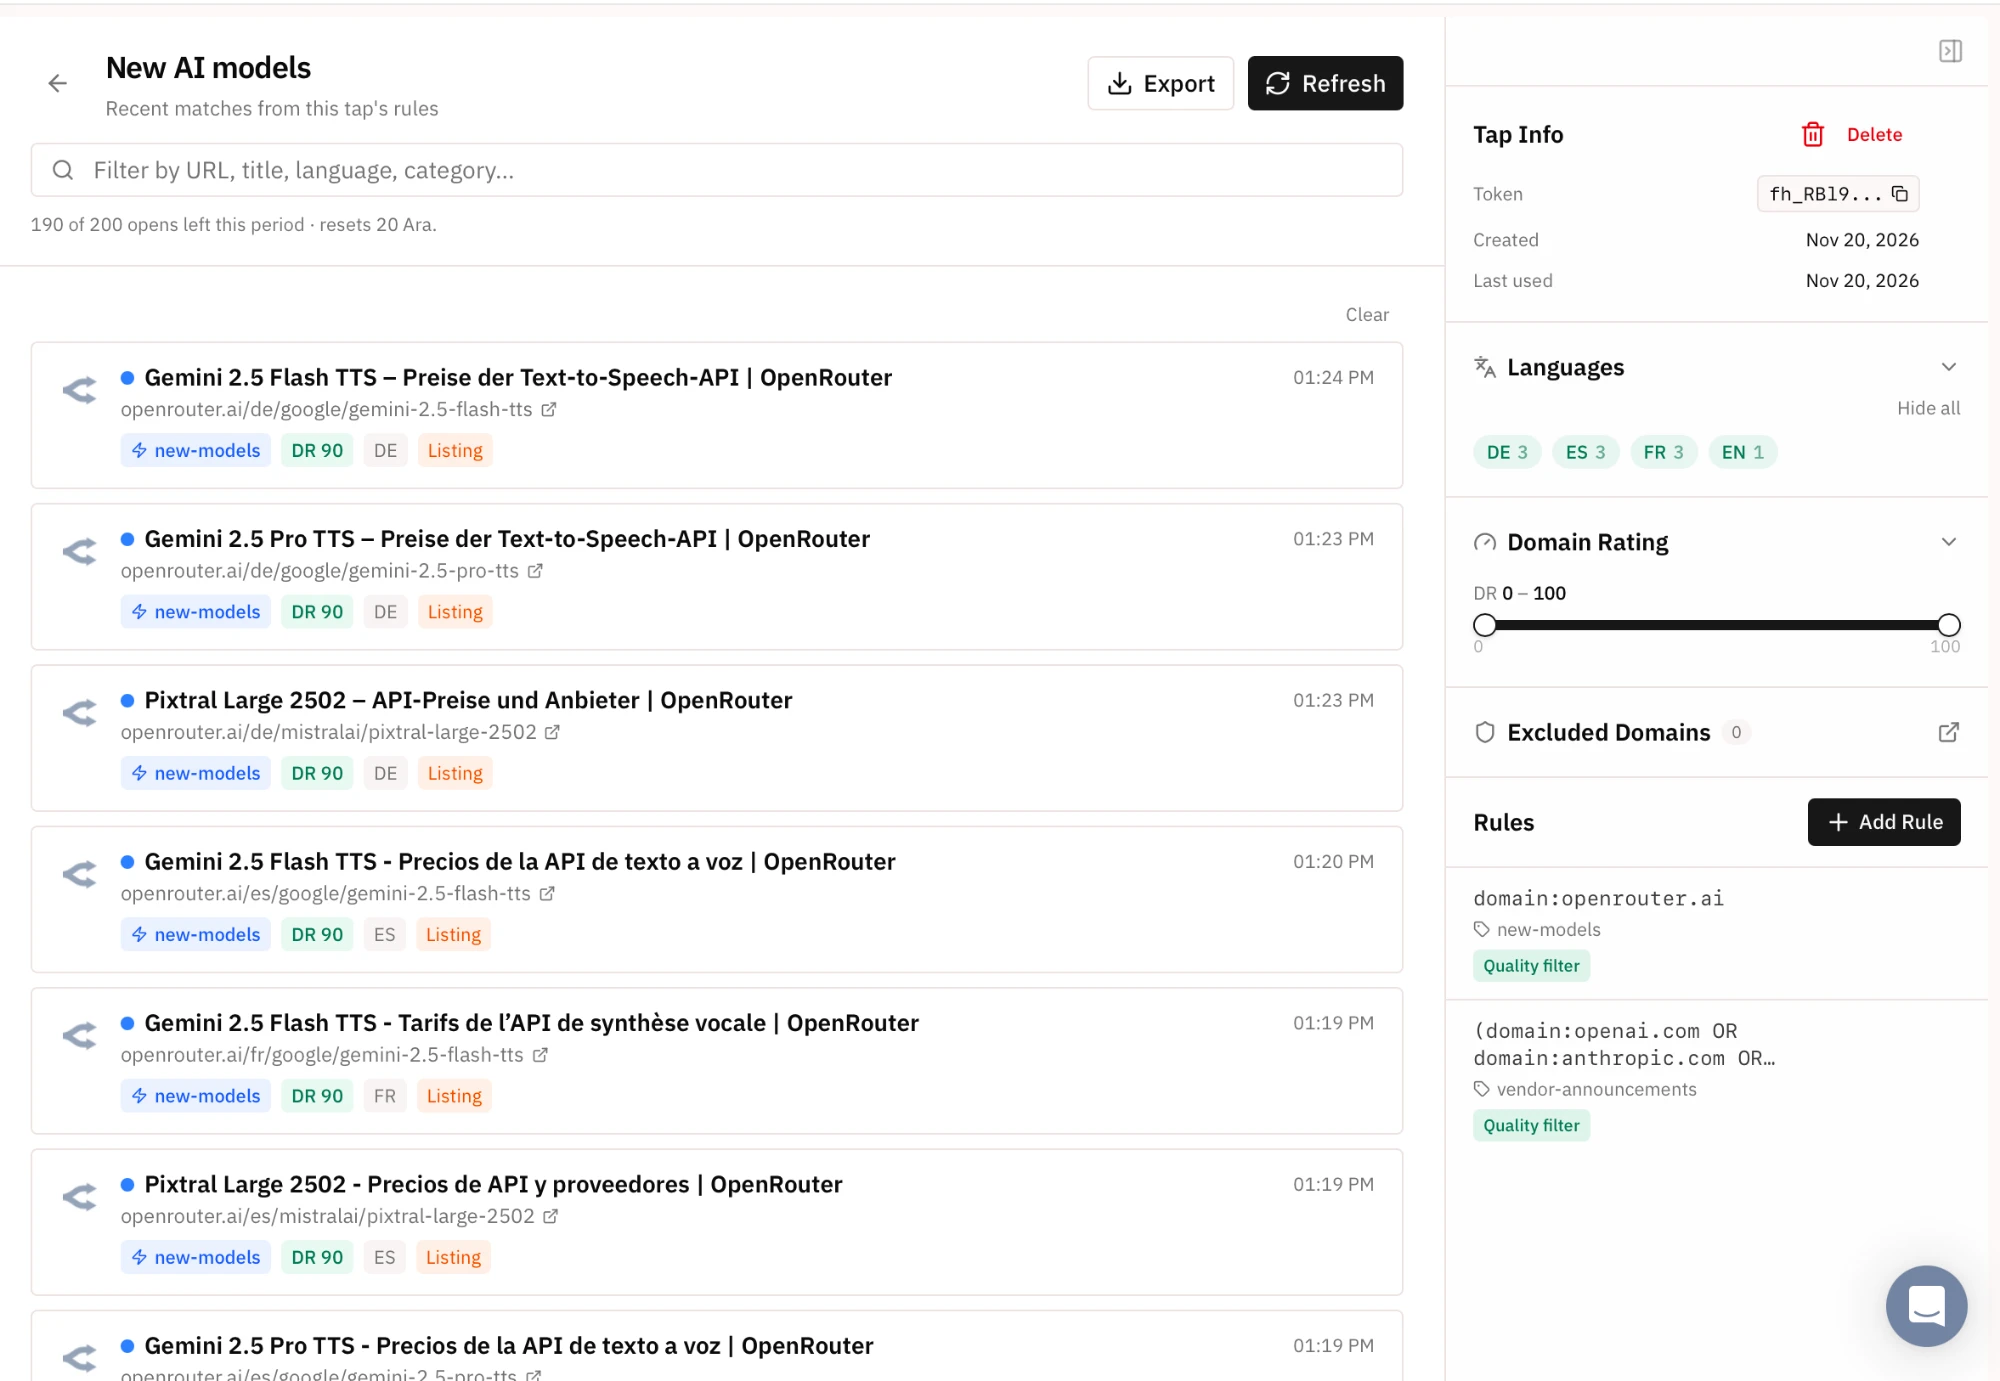
Firehose markiert eine Seite, die für seinen Crawler neu ist, und nicht ein Produkt, das neu ist. Daher bringen Katalogseiten wie OpenRouter ältere Modelle in einen Release-Tracking-Feed.
URL Watch
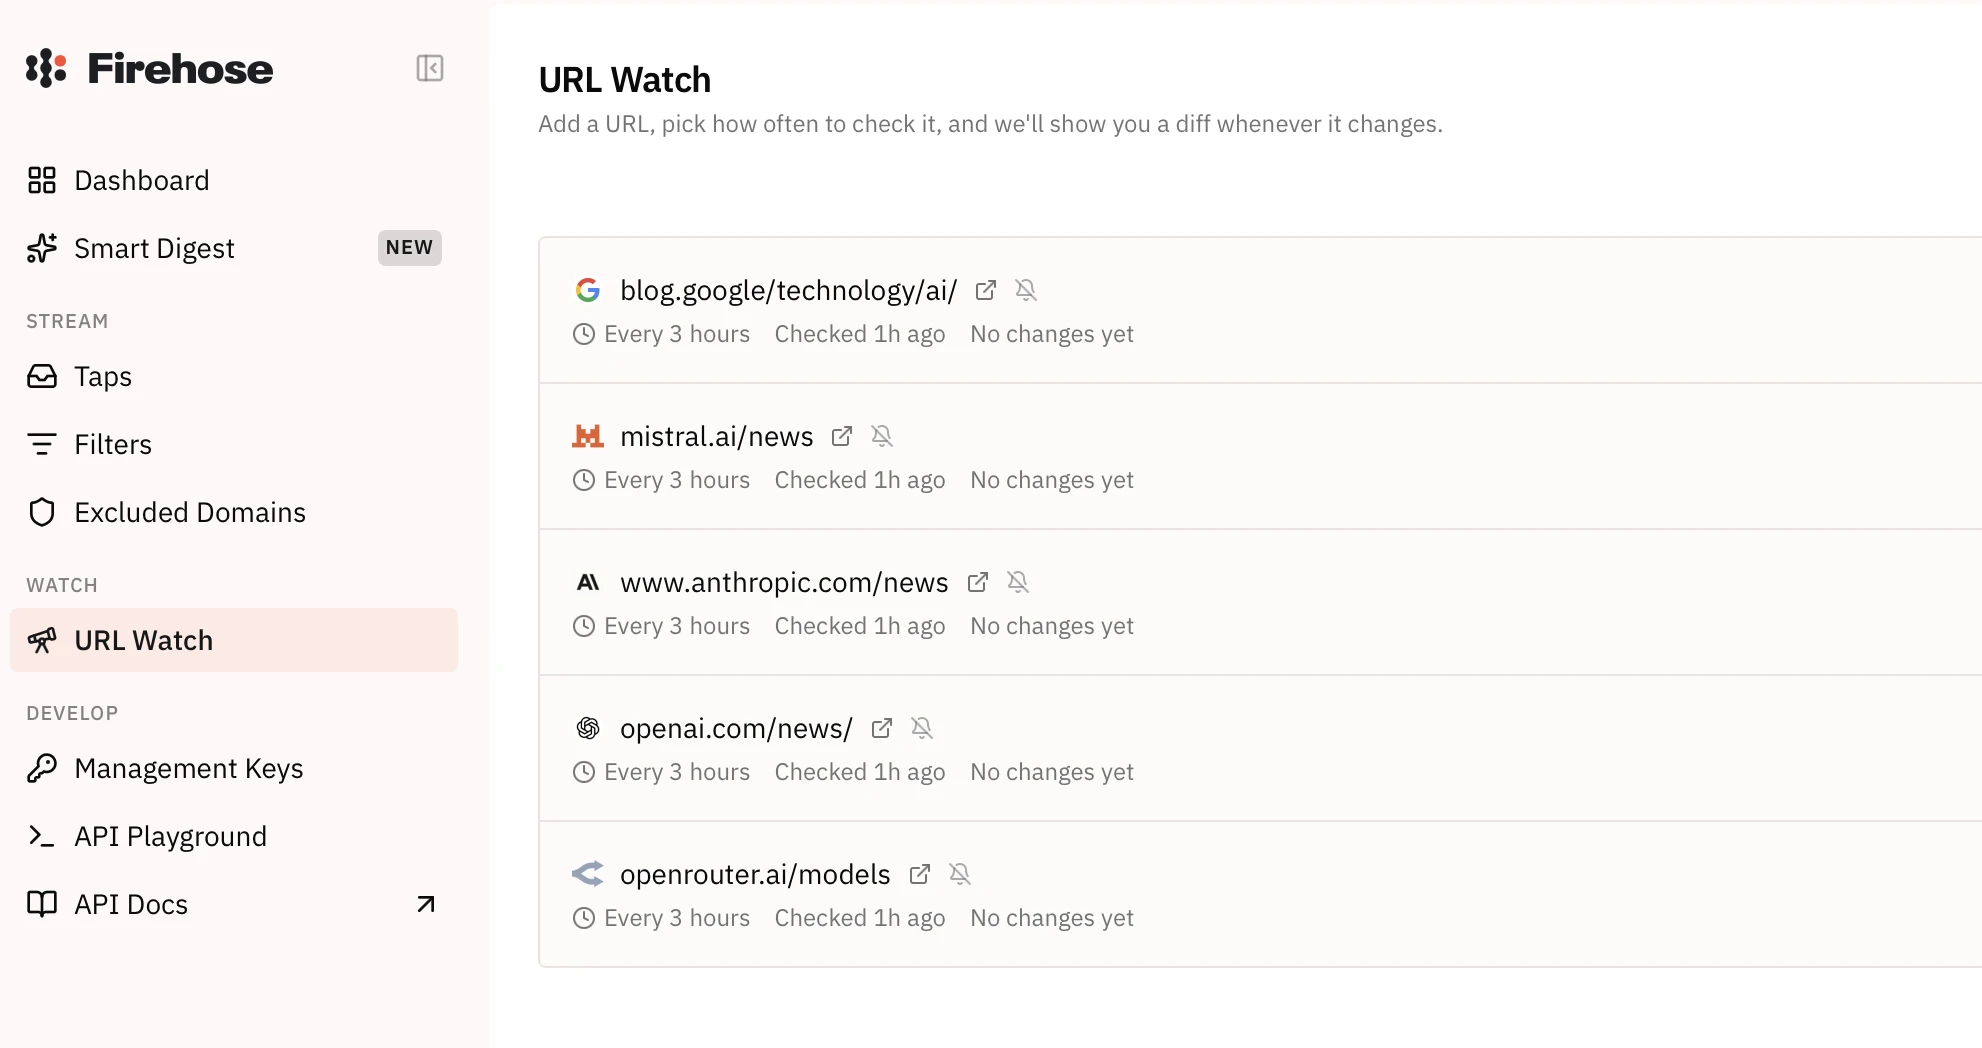
URL Watch funktioniert umgekehrt: Statt darauf zu warten, dass der Crawler eine Seite erreicht, prüft Firehose die vom Kunden ausgewählten Seiten nach einem festen Zeitplan erneut und zeigt einen Diff an, wenn sich eine ändert. Wir beobachteten die Modellliste von OpenRouter sowie die News-Seiten von OpenAI, Anthropic, Mistral und Google, jeweils alle 3 Stunden.
Wie Common Crawl funktioniert
Common Crawl ist eine gemeinnützige Organisation, die etwa einmal im Monat einen Crawl des offenen Webs veröffentlicht und ihn verschenkt. Es gibt kein Konto, keinen Schlüssel und kein Kontingent. Der Deal ist, dass Sie Dateien statt eines Dienstes erhalten: Ihnen wird nichts geliefert, und alles, was über die Suche nach einer einzelnen Seite hinausgeht, bedeutet eigene Verarbeitung.
Auswahl eines Formats
Jeder Crawl erscheint in mehreren Formaten. Rohe HTTP-Antworten enthalten das ursprüngliche HTML. Ein Metadaten-extract enthält Links, Titel und Header als JSON. Eine Klartextversion enthält den Artikeltext ohne Markup. Zwei kleinere Sets decken robots.txt-Dateien und Nicht-200-Antworten ab.
Die Wahl ist wichtig, weil sie unumkehrbar ist. Klartext ist viel kleiner und schneller zu verarbeiten, aber Tags, Attribute und eingebettetes JSON-LD fehlen darin, sodass die strukturierte Extraktion vom Roh-Set ausgehen muss.
Es gibt keine gefilterte Lieferung. Sie wählen ein Format, laden herunter, was Sie brauchen, und verarbeiten es selbst.
Finden einer Seite
Es gibt zwei Mechanismen, die unterschiedliche Fragen beantworten. Der CDX-Server übernimmt Einzel-URL-Suchen über ein Webformular oder eine API. Der als Parquet veröffentlichte spaltenorientierte Index übernimmt Massenabfragen über SQL.
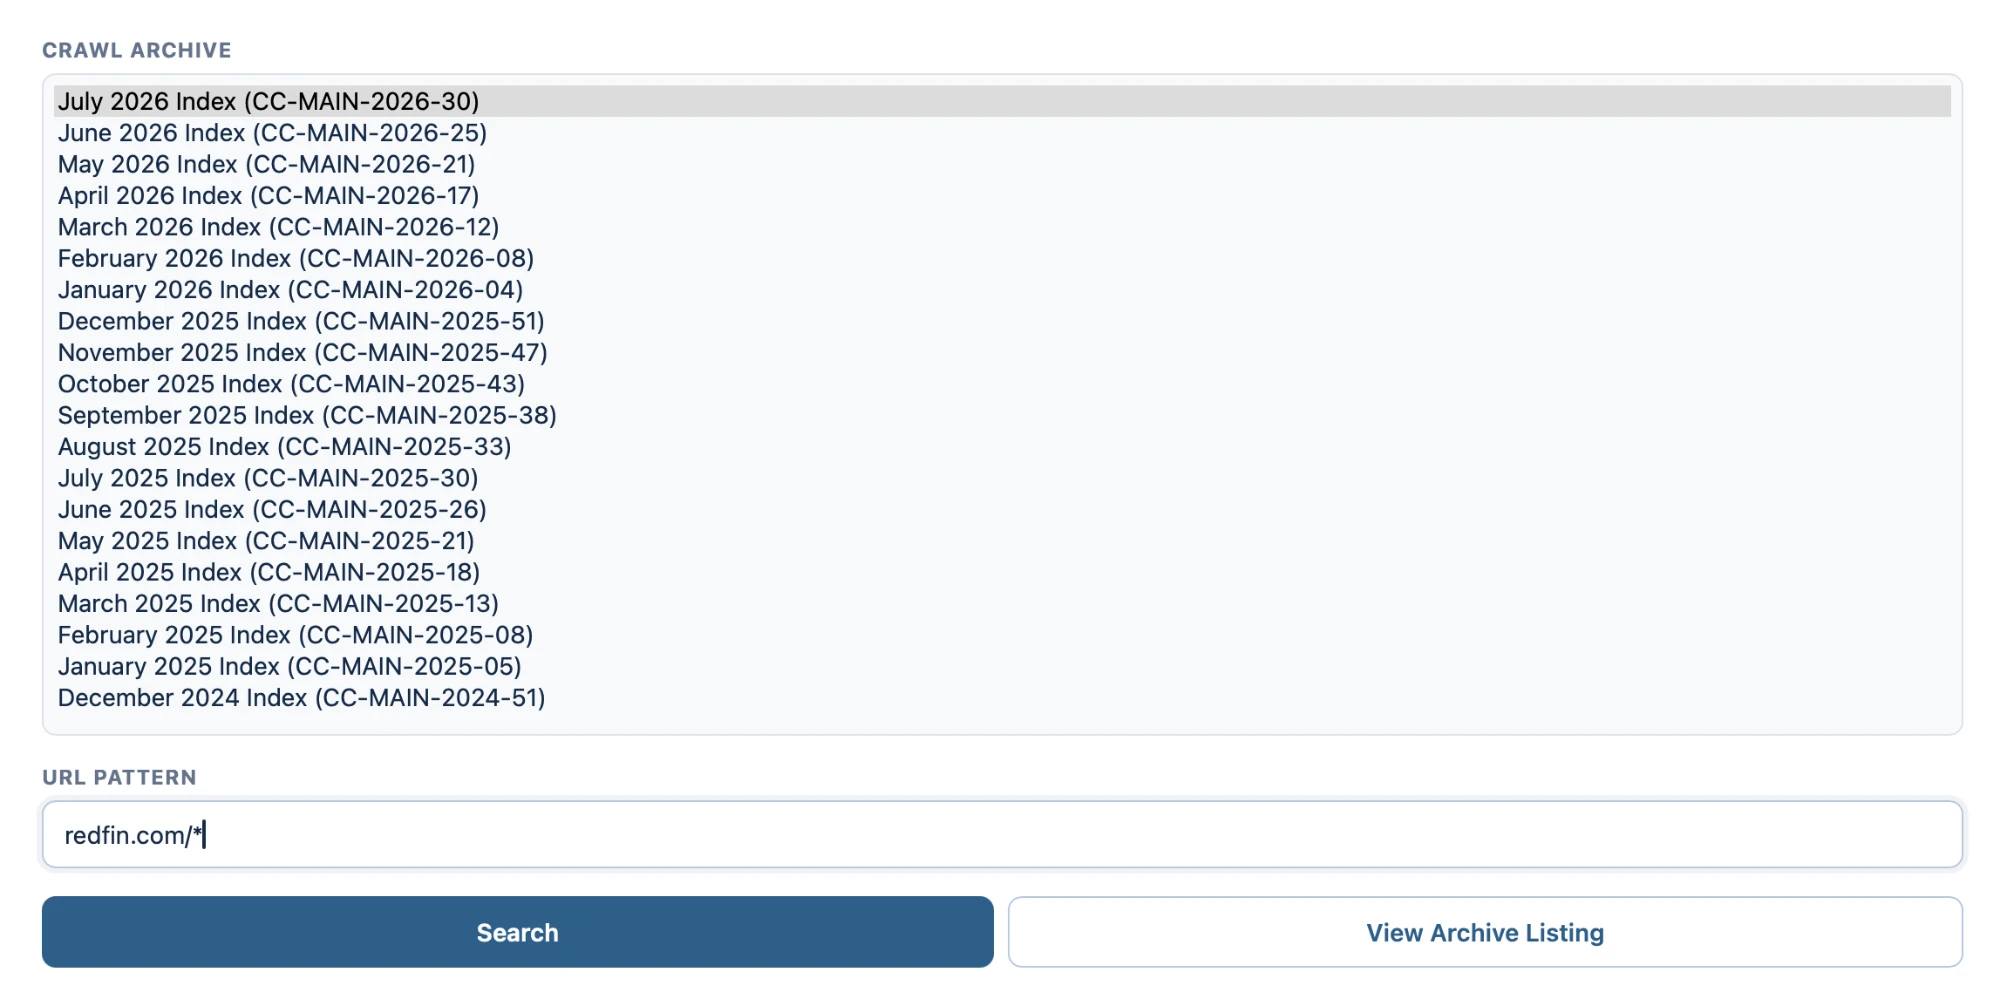
Die CDX-Oberfläche verlangt zwei Dinge: welchen monatlichen Crawl Sie durchsuchen möchten, aus einer bis 2008 zurückreichenden Liste, und ein URL-Muster.
Die Ergebnisse kommen als JSON zurück, eine Zeile pro Erfassung. Drei Felder sind wichtiger als die übrigen: der WARC-Dateiname, ein Byte-Offset und eine Datensatzlänge.
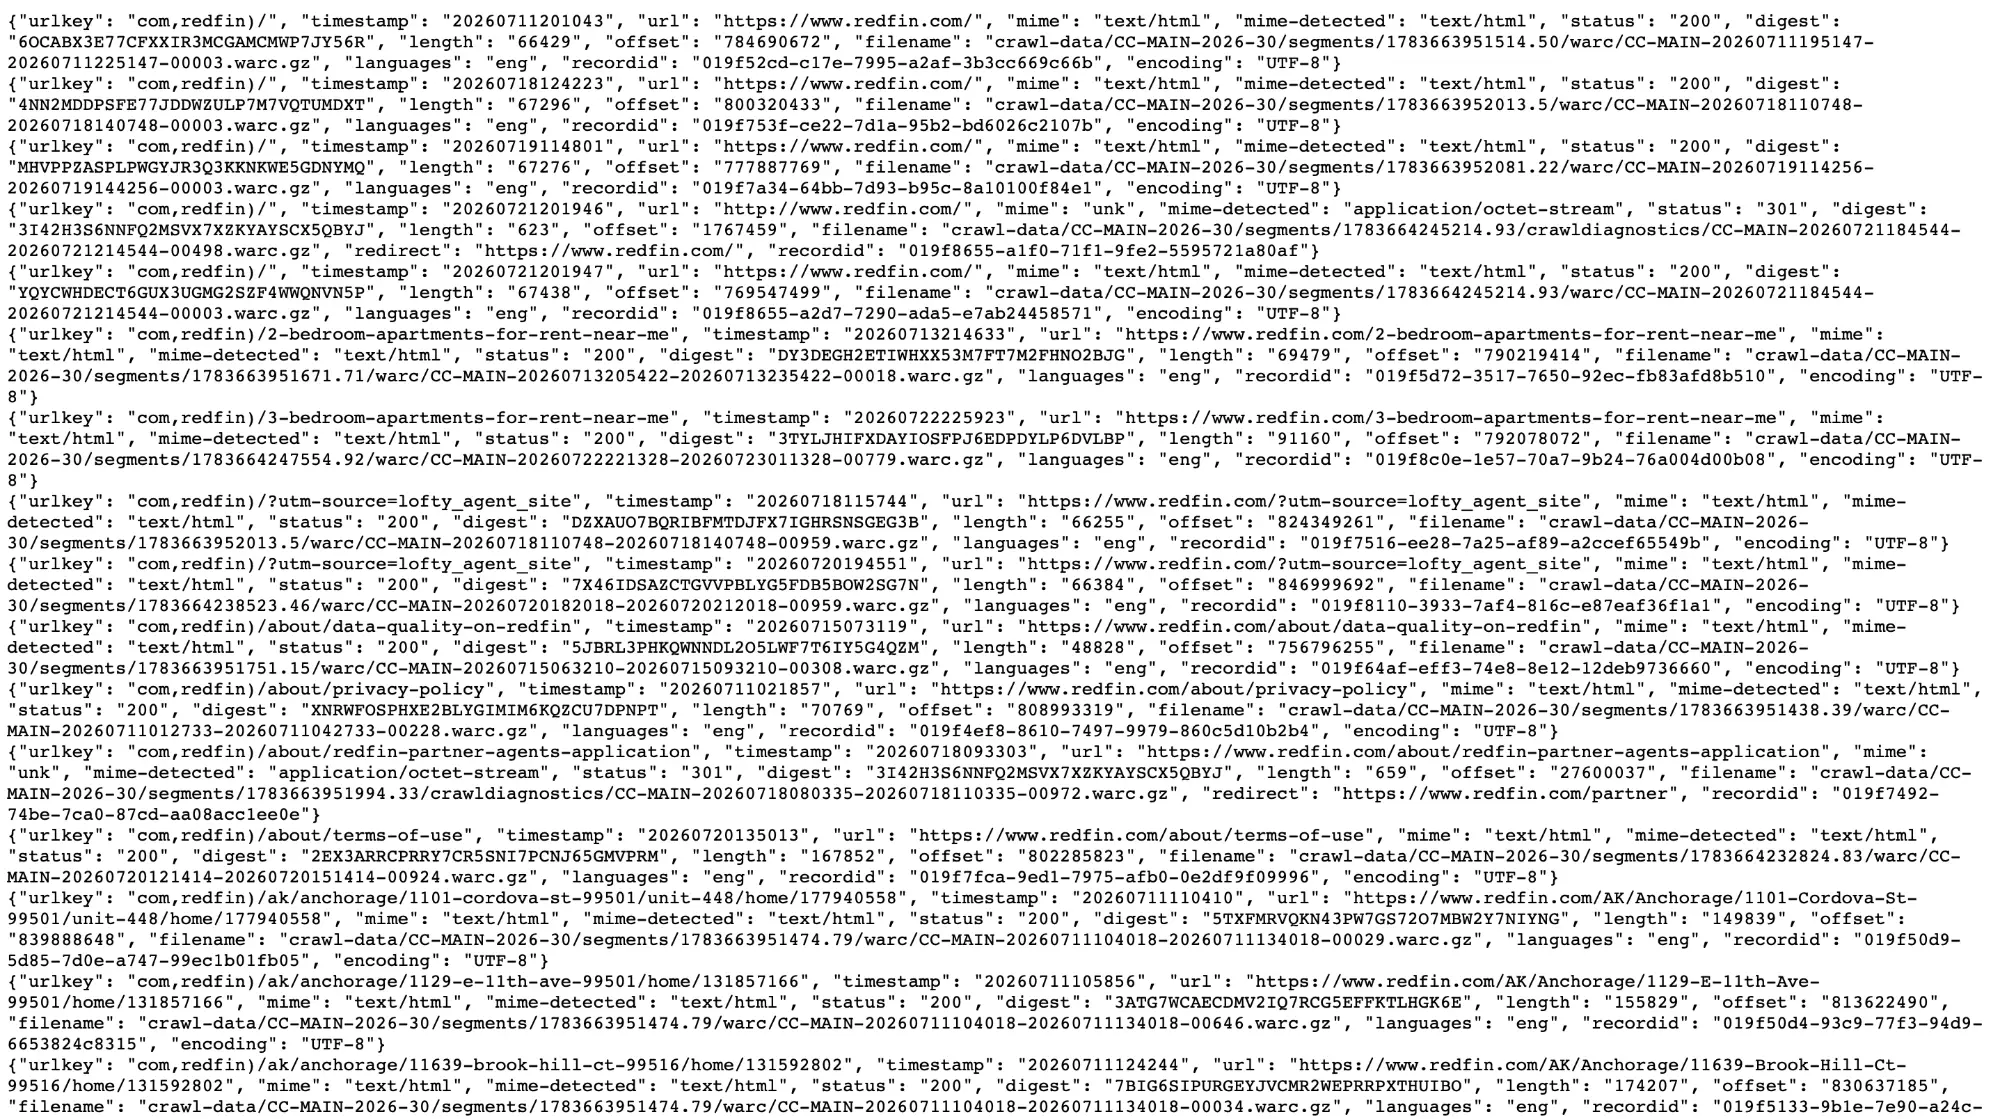
Im Output sind zwei Dinge sichtbar. Dieselbe URL erscheint mehrmals mit unterschiedlichen Zeitstempeln, sodass ein einzelner monatlicher Crawl keine einzelne Momentaufnahme ist. Fehlgeschlagene Antworten werden separat gespeichert, mit Weiterleitungen und Fehlern in einem crawldiagnostics-Ordner und nicht neben erfolgreichen Abrufen.
Eine Seite abrufen, ohne die Datei herunterzuladen, in der sie liegt
Mit Dateiname, Offset und Länge können Sie einen einzelnen Datensatz mit einem HTTP-Range-Header anfordern. Wir haben dies auf einer Redfin-Listing-Seite getestet.
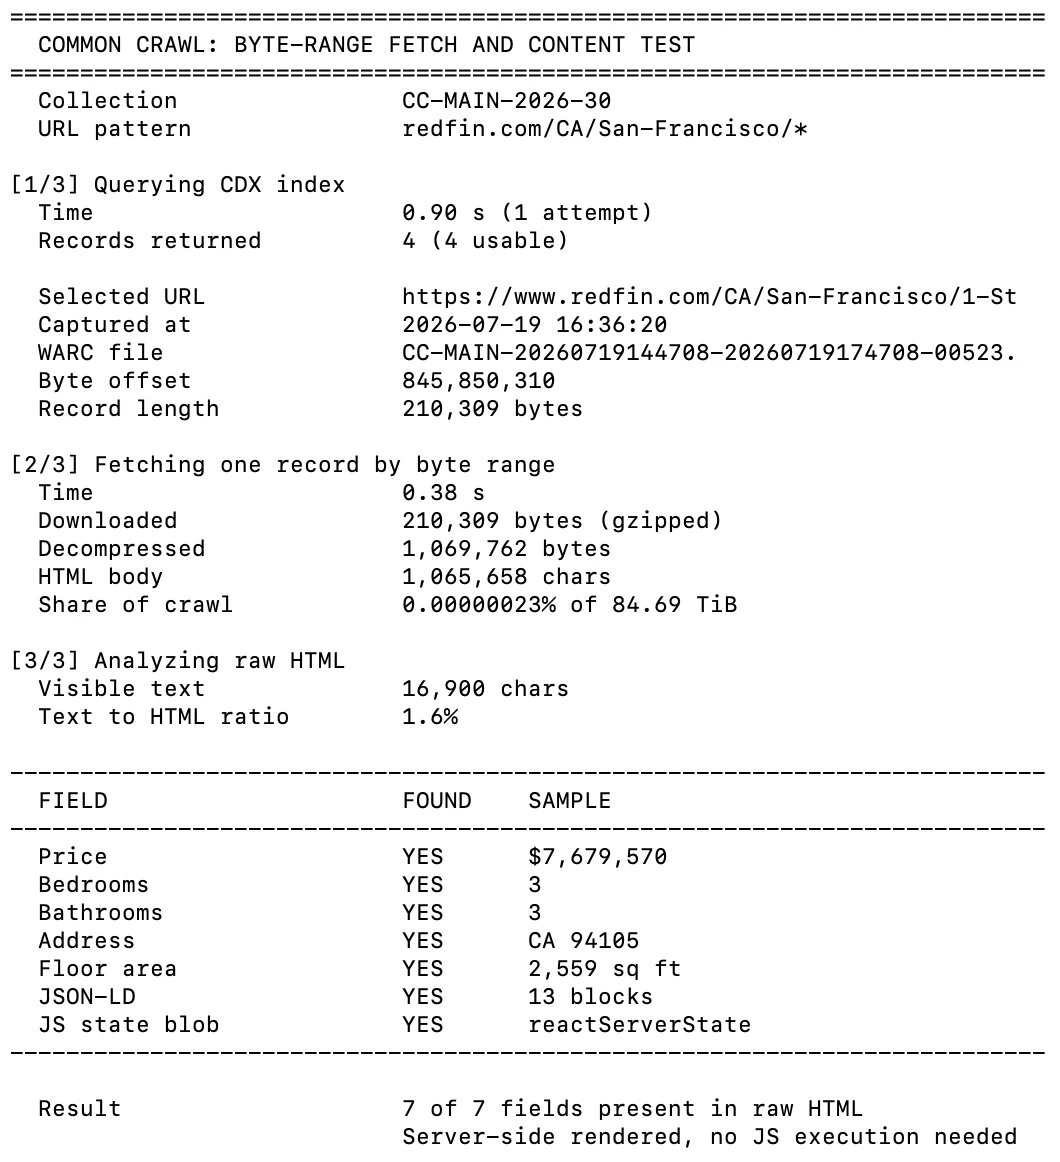
Die CDX-Suche lieferte in unter einer Sekunde ein Ergebnis, und der Byte-Range-Abruf dauerte 0,38 Sekunden für 210 KB. Alle sieben Listing-Felder, nach denen wir gesucht haben, einschließlich Preis, Schlafzimmer und Adresse, waren im rohen HTML vorhanden, ohne dass JavaScript ausgeführt wurde.
Massenfilterung mit SQL
Für alles, das größer als eine einzelne URL ist, ist der spaltenorientierte Index der richtige Weg. Er ist Parquet, über HTTPS abfragbar und stellt 33 Spalten zu URL, Host, TLD, Sprache, MIME-Typ, Abrufstatus und Zeitstempel bereit.
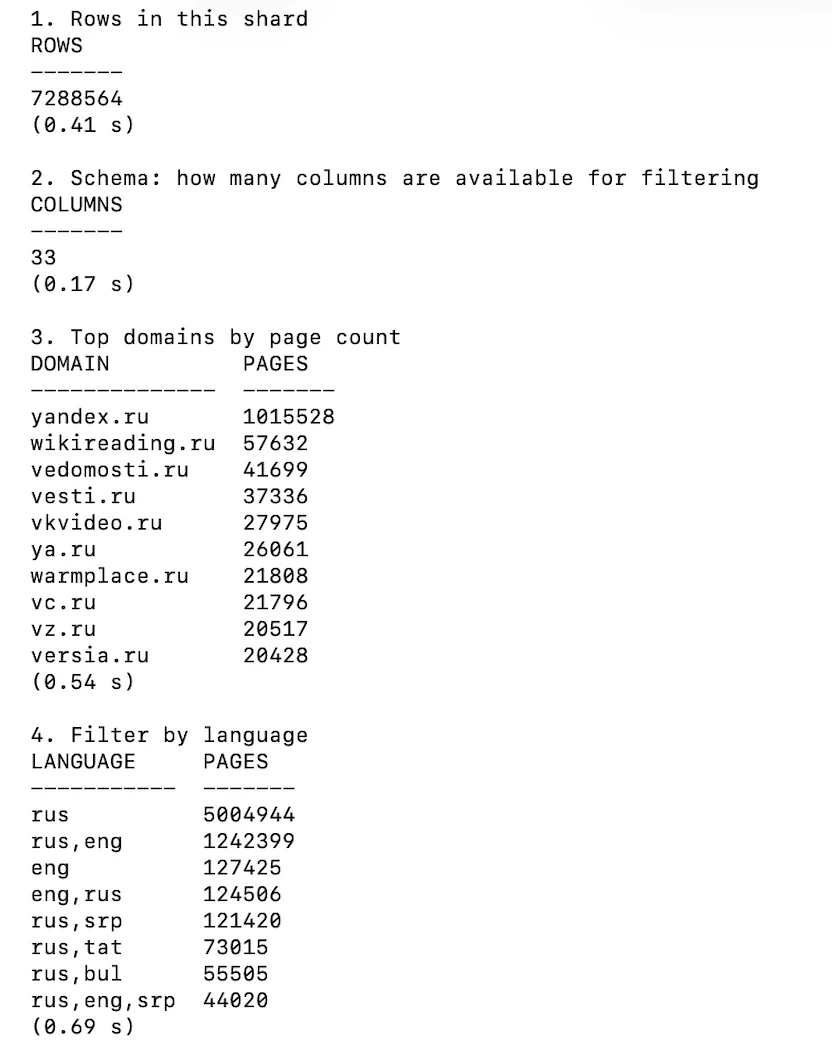
Abfragen gegen einen einzelnen Shard mit 7.29 Millionen Zeilen wurden jeweils in deutlich unter einer Sekunde beantwortet, ohne dass etwas auf die Festplatte geschrieben wurde. Ein Detail, das Sie vor der Nutzung kennen sollten: Die Shards sind nach einem umgekehrten Hostnamen verschlüsselt, sodass jede Datei einen engen alphabetischen Ausschnitt enthält und keine Zufallsstichprobe. Die Abfrage eines beliebigen Shards nach einer bestimmten Domain liefert normalerweise nichts.
Wie viel es für eine bestimmte Domain enthält
Wir haben den Index für zwei Domains abgefragt, redfin.com und zillow.com, jeweils den Shard gefunden, der sie abdeckt, und seine Zeilen gezählt.
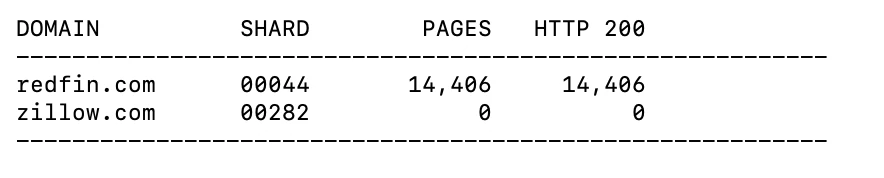
redfin.com lieferte 14.406 Seiten, alle mit HTTP 200. zillow.com lieferte keine. Das ist keine partielle Abdeckung oder ein fehlgeschlagener Abruf; die Domain befindet sich nicht im Index. Common Crawl respektiert robots.txt, sodass eine Website, die ihren Crawler aussperrt, fehlt, statt dünn vertreten zu sein.
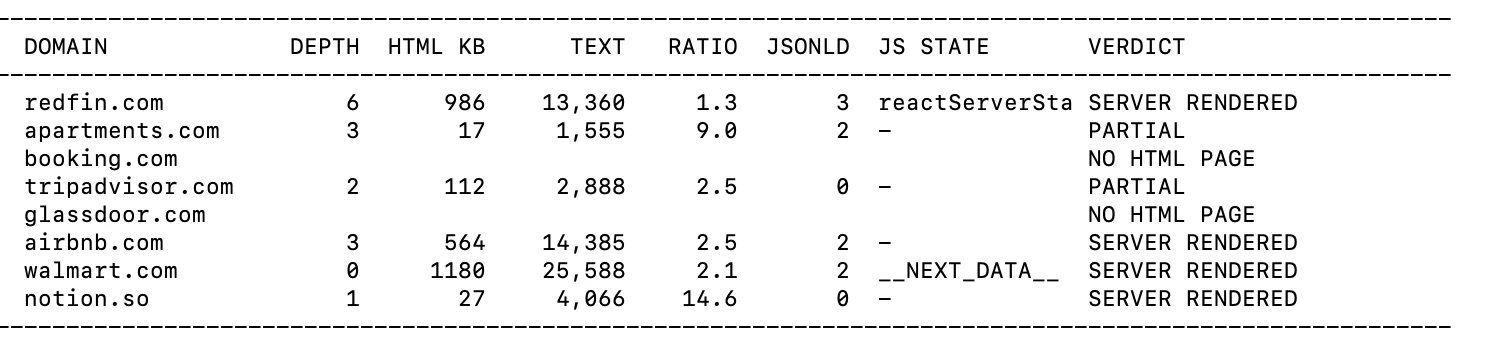
Wir haben von jeder von acht großen Websites eine archivierte Seite abgerufen und gemessen, wie viel Text ohne Browser übrig blieb. Zwei von ihnen hatten überhaupt keine nutzbare HTML-Seite im Archiv. Bei den übrigen wurden die meisten serverseitig gerendert, darunter Airbnb und Walmart. TripAdvisor war die Ausnahme und lieferte eine 18 KB große Seite, die 282 Zeichen sichtbaren Text enthielt.
Kosten und Lizenz
Die Daten sind kostenlos, und der Speicher-Bucket ist ohne Konto offen. Was Sie zahlen, ist Compute und Bandbreite, weshalb die Verarbeitung in derselben Cloud-Region wie die Daten empfohlen wird.
Die Lizenz ist keine Open-Data-Lizenz. Common Crawl gewährt eine eingeschränkte Lizenz an dem Dienst, gibt an, dass es den Seiteninhalt selbst nicht lizenzieren kann, und verlangt von den Nutzern die Freistellung von Ansprüchen, die aus der Nutzung des Inhalts „im Zusammenhang mit künstlicher Intelligenz, maschinellem Lernen oder anderen ähnlichen Technologien“ entstehen. Die Gesamthaftung ist auf $100 begrenzt.1
Welches passt zu welcher Aufgabe
Diese Produkte sind keine Substitute. Die Frage ist nicht, welches am besten ist, sondern welches die Frage beantwortet, die Sie haben.
- Rohes HTML in großem Maßstab, einschließlich Websites, die Crawler blockieren. Bright Data’s Web Archive API schreibt eine gefilterte Auswahl in Speicher, den Sie kontrollieren, und ihr Archiv enthält Seiten von Websites, die Crawler blockieren, die Common Crawl auslässt.
- Neue Seiten, sobald sie gecrawlt wurden. Bright Data Firehose streamt vollständige Seiten an S3, einen Webhook oder einen Stream. Ahrefs Firehose sendet den geänderten Text von Seiten, die Ihren Regeln entsprechen, und URL Watch prüft die von Ihnen gewählten Seiten nach Zeitplan erneut.
- Ein breites Korpus ohne Kosten, wenn Sie eigene Engineering-Kapazität haben. Common Crawl gibt Ihnen vollständige Crawls als WARC, abfragbar mit SQL, und verlangt nichts außer Ihrer eigenen Rechenleistung. Die Verarbeitung müssen Sie selbst aufbauen.
- News-, Blog- und Forentext mit bereits extrahierten Entitäten und Sentiment. Webz.io gibt verarbeitete Datensätze statt Seiten zurück, was die Extraktionsarbeit überflüssig macht, aber auch das Markup entfernt. Sein Firehose sendet alle paar Minuten neue Posts.
- Seitenkontext zur Abfragezeit, für einen Agenten oder eine RAG-Pipeline. Exa gibt zwischengespeicherten Text in Millisekunden zurück und greift auf einen Live-Abruf zurück, wenn eine Seite nicht gespeichert ist. Snapshot gibt die Version einer Seite von einem vergangenen Datum innerhalb der letzten fünf Monate zurück.
 Als bevorzugte Quelle hinzufügen
Wie wir Web-Archiv-APIs getestet haben
Wir haben in jedem Produkt selbst gearbeitet und nicht nur mit der Dokumentation. Jeder Anbieter wurde zuerst über seine eigene Konsole oder Spielwiese und dann über seine API bedient, sodass wir sehen konnten, welche Anfrage die Oberfläche erzeugt und was zurückkommt, bevor etwas berechnet wird.
Für jedes Produkt haben wir eine Abfrage erstellt, ausgeführt und die rohe Antwort statt der gerenderten Zusammenfassung gelesen. Wenn das Produkt eine Anzahl, eine Kostenschätzung oder ein Statusobjekt zurückgab, haben wir diese Felder direkt protokolliert. Wenn es eine Stichprobe oder eine Lieferung anbot, nahmen wir sie an, entpackten die Dateien und öffneten sie.
Kleine Skripte übernahmen die Teile, die Wiederholung oder Zeitmessung erforderten: das Abrufen eines einzelnen Datensatzes aus einem Multi-Terabyte-Archiv, das Entpacken eines gelieferten Pakets und das Durchsuchen des rohen HTML nach bestimmten Feldern, das Abfragen eines spaltenorientierten Indexes mit SQL sowie das Messen, wie lange eine zwischengespeicherte Antwort im Vergleich zu einer erst zu crawlenden Seite dauert. Diese Skripte sind neben den Ergebnissen verlinkt, die sie erzeugt haben.
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Beste Common Crawl-Alternativen: Bright Data & Webz.io}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/common-crawl-alternatives}},
  note   = {AIMultiple. Abgerufen am 20. November 2026}
}Ergebnisse und Zeitstempel von 18 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 2 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.