


LLM-Router-Benchmark: 8 Router bei 523 agentischen Datenbankaufgaben

Wir haben 8 LLM-Router bei 523 agentischen Datenbankaufgaben getestet und jeden mit einzelnen Modellen hinsichtlich Genauigkeit und Kosten verglichen.
Ergebnisse des agentischen Router-Benchmarks
| Name | Series | $ per 1,000 questions, router fees included (log scale) | Score (%) | Score | Cost | Pool | Label |
|---|---|---|---|---|---|---|---|
| Fireworks Nexus Auto | Fireworks Nexus Auto | 1.93 | 35.95 | 35.9% | 1.9 | Router's own, open models | Fireworks Nexus Auto |
| Not Diamond | Not Diamond | 50.52 | 50.86 | 50.9% | 50.5 | 19 models | Not Diamond |
| NVIDIA Switchyard (Sol + Luna) | NVIDIA Switchyard (Sol + Luna) | 16.6 | 56.21 | 56.2% | 16.6 | GPT-6.1 Sol + GPT-6 Luna | NVIDIA Switchyard (Sol + Luna) |
| OpenRouter Auto | OpenRouter Auto | 1.97 | 28.68 | 28.7% | 2.0 | Router's own | OpenRouter Auto |
| OpenRouter Auto Code | OpenRouter Auto Code | 24.62 | 52.77 | 52.8% | 24.6 | Router's own | OpenRouter Auto Code |
| Sakana Fugu Max | Sakana Fugu Max | 29.96 | 27.34 | 27.3% | 30.0 | Router's own | Sakana Fugu Max |
| TypeSafe Jev | TypeSafe Jev | 2.09 | 29.45 | 29.4% | 2.1 | Router's own | TypeSafe Jev |
| Unbiased Pareto 26.10 | Unbiased Pareto 26.10 | 13.18 | 44.17 | 44.2% | 13.2 | Router's own | Unbiased Pareto 26.10 |
| Claude Fable 5 | Anthropic | 150.34 | 60.04 | 60.0% | 150.3 | single model | Claude Fable 5 |
| Claude Fable 5.1 | Anthropic | 718.96 | 62.91 | 62.9% | 719.0 | single model | Claude Fable 5.1 |
| Claude Fable 5.2 | Anthropic | 109.43 | 85.28 | 85.3% | 109.4 | single model | Claude Fable 5.2 |
| Claude Haiku 5.5 | Anthropic | 1.92 | 26.2 | 26.2% | 1.9 | single model | Claude Haiku 5.5 |
| Claude Opus 4.8 | Anthropic | 148.83 | 50.67 | 50.7% | 148.8 | single model | Claude Opus 4.8 |
| Claude Opus 5 | Anthropic | 77.8 | 60.99 | 61.0% | 77.8 | single model | Claude Opus 5 |
| Claude Opus 5.5 | Anthropic | 236.55 | 84.89 | 84.9% | 236.5 | single model | Claude Opus 5.5 |
| Claude Sonnet 5 | Anthropic | 76.64 | 34.42 | 34.4% | 76.6 | single model | Claude Sonnet 5 |
| Claude Sonnet 5.5 | Anthropic | 53.81 | 70.36 | 70.4% | 53.8 | single model | Claude Sonnet 5.5 |
| Command A Plus | Cohere | 9.19 | 30.21 | 30.2% | 9.2 | single model | Command A Plus |
| DeepSeek V4 Flash | DeepSeek | 2.91 | 30.4 | 30.4% | 2.9 | single model | DeepSeek V4 Flash |
| DeepSeek V4 Flash 0731 | DeepSeek | 1.66 | 33.84 | 33.8% | 1.7 | single model | DeepSeek V4 Flash 0731 |
| DeepSeek V4 Pro | DeepSeek | 11.28 | 35.37 | 35.4% | 11.3 | single model | DeepSeek V4 Pro |
| DeepSeek V4 Pro 0813 | DeepSeek | 13.95 | 40.92 | 40.9% | 13.9 | single model | DeepSeek V4 Pro 0813 |
| DeepSeek V4.1 Flash | DeepSeek | 4.25 | 30.78 | 30.8% | 4.2 | single model | DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash 1017 | DeepSeek | 2.05 | 20.65 | 20.7% | 2.0 | single model | DeepSeek V4.1 Flash 1017 |
| Gemini 3 Flash Preview | 9.37 | 59.66 | 59.7% | 9.4 | single model | Gemini 3 Flash Preview | |
| Gemini 3.1 Flash Lite | 6.95 | 42.07 | 42.1% | 6.9 | single model | Gemini 3.1 Flash Lite | |
| Gemini 3.1 Pro Preview | 90.04 | 60.42 | 60.4% | 90.0 | single model | Gemini 3.1 Pro Preview | |
| Gemini 3.5 Flash Lite | 8.52 | 48.76 | 48.8% | 8.5 | single model | Gemini 3.5 Flash Lite | |
| Gemini 3.6 Flash | 27.38 | 58.89 | 58.9% | 27.4 | single model | Gemini 3.6 Flash | |
| Gemini 3.7 Flash | 25.08 | 69.41 | 69.4% | 25.1 | single model | Gemini 3.7 Flash | |
| Gemini 3.8 Flash | 32.67 | 65.39 | 65.4% | 32.7 | single model | Gemini 3.8 Flash | |
| Gemini 4 Argon | 48.44 | 77.82 | 77.8% | 48.4 | single model | Gemini 4 Argon | |
| Gemini 4 Carbon | 75.67 | 77.25 | 77.2% | 75.7 | single model | Gemini 4 Carbon | |
| GLM 4.7 | Zhipu AI | 10.84 | 25.05 | 25.0% | 10.8 | single model | GLM 4.7 |
| GLM 5.1 | Zhipu AI | 12.8 | 38.43 | 38.4% | 12.8 | single model | GLM 5.1 |
| GLM 5.2 | Zhipu AI | 6.71 | 39.2 | 39.2% | 6.7 | single model | GLM 5.2 |
| GLM 5.3 | Zhipu AI | 24.27 | 38.62 | 38.6% | 24.3 | single model | GLM 5.3 |
| GLM 5.3 Flash | Zhipu AI | 4.22 | 36.14 | 36.1% | 4.2 | single model | GLM 5.3 Flash |
| GLM 5.3 Prime | Zhipu AI | 69.86 | 35.18 | 35.2% | 69.9 | single model | GLM 5.3 Prime |
| GPT-5.2 | OpenAI | 29.97 | 31.93 | 31.9% | 30.0 | single model | GPT-5.2 |
| GPT-5.4 Mini | OpenAI | 7.03 | 24.28 | 24.3% | 7.0 | single model | GPT-5.4 Mini |
| GPT-5.4 Nano | OpenAI | 2.85 | 21.03 | 21.0% | 2.8 | single model | GPT-5.4 Nano |
| GPT-5.5 | OpenAI | 75.52 | 44.93 | 44.9% | 75.5 | single model | GPT-5.5 |
| GPT-5.6 Luna | OpenAI | 13.87 | 33.46 | 33.5% | 13.9 | single model | GPT-5.6 Luna |
| GPT-5.6 Sol | OpenAI | 60.83 | 49.9 | 49.9% | 60.8 | single model | GPT-5.6 Sol |
| GPT-5.6 Terra | OpenAI | 30.71 | 39.39 | 39.4% | 30.7 | single model | GPT-5.6 Terra |
| GPT-6 Luna | OpenAI | 1.34 | 38.81 | 38.8% | 1.3 | single model | GPT-6 Luna |
| GPT-6 Luna Pro | OpenAI | 3.91 | 38.24 | 38.2% | 3.9 | single model | GPT-6 Luna Pro |
| GPT-6 Sol | OpenAI | 21.83 | 50.48 | 50.5% | 21.8 | single model | GPT-6 Sol |
| GPT-6 Sol Pro | OpenAI | 59.11 | 50.67 | 50.7% | 59.1 | single model | GPT-6 Sol Pro |
| GPT-6.1 Sol (reference) | OpenAI | 15.45 | 61.19 | 61.2% | 15.4 | single model, run with the routers | GPT-6.1 Sol (reference) |
| GPT-6.1 Sol (text-to-SQL) | OpenAI | 15.91 | 61.38 | 61.4% | 15.9 | single model | GPT-6.1 Sol (text-to-SQL) |
| GPT-6.1 Sol Pro | OpenAI | 44.12 | 59.85 | 59.8% | 44.1 | single model | GPT-6.1 Sol Pro |
| GPT-6.1 Terra | OpenAI | 8.76 | 53.54 | 53.5% | 8.8 | single model | GPT-6.1 Terra |
| GPT-OSS 120B | OpenAI | 0.597 | 19.89 | 19.9% | 0.6 | single model | GPT-OSS 120B |
| Grok 4.3 | xAI | 16.13 | 41.68 | 41.7% | 16.1 | single model | Grok 4.3 |
| Grok 4.5 | xAI | 26.24 | 48.57 | 48.6% | 26.2 | single model | Grok 4.5 |
| Grok 4.6 | xAI | 41.78 | 58.32 | 58.3% | 41.8 | single model | Grok 4.6 |
| Grok 4.7 | xAI | 37.1 | 48.37 | 48.4% | 37.1 | single model | Grok 4.7 |
| HY4 Preview | Tencent | 12.78 | 45.12 | 45.1% | 12.8 | single model | HY4 Preview |
| Kimi K2.6 | Moonshot AI | 19.13 | 43.79 | 43.8% | 19.1 | single model | Kimi K2.6 |
| Kimi K3 | Moonshot AI | 48.24 | 45.32 | 45.3% | 48.2 | single model | Kimi K3 |
| Kimi K3.1 Pro | Moonshot AI | 32 | 49.14 | 49.1% | 32.0 | single model | Kimi K3.1 Pro |
| Llama 4 Maverick | Meta | 6.1 | 28.11 | 28.1% | 6.1 | single model | Llama 4 Maverick |
| MiMo V2.6 Pro | Xiaomi | 4.93 | 38.81 | 38.8% | 4.9 | single model | MiMo V2.6 Pro |
| MiniMax M2.5 | MiniMax | 3.45 | 29.45 | 29.4% | 3.5 | single model | MiniMax M2.5 |
| MiniMax M3 | MiniMax | 4.85 | 34.03 | 34.0% | 4.9 | single model | MiniMax M3 |
| MiniMax M3.1 Flash | MiniMax | 2.71 | 33.84 | 33.8% | 2.7 | single model | MiniMax M3.1 Flash |
| Mistral Large 4.0 | Mistral AI | 18.65 | 26.77 | 26.8% | 18.7 | single model | Mistral Large 4.0 |
| Mistral Small 2603 | Mistral AI | 1.74 | 23.33 | 23.3% | 1.7 | single model | Mistral Small 2603 |
| Muse Ember | Meta | 2.99 | 37.48 | 37.5% | 3.0 | single model | Muse Ember |
| Muse Glimmer 30B | Meta | 6.4 | 31.17 | 31.2% | 6.4 | single model | Muse Glimmer 30B |
| Muse Spark 1.1 | Meta | 27.77 | 39.01 | 39.0% | 27.8 | single model | Muse Spark 1.1 |
| Muse Spark 1.2 | Meta | 39.56 | 45.89 | 45.9% | 39.6 | single model | Muse Spark 1.2 |
| Muse Spark 1.3 | Meta | 38.67 | 43.98 | 44.0% | 38.7 | single model | Muse Spark 1.3 |
| Muse Spark Open | Meta | 27.1 | 41.87 | 41.9% | 27.1 | single model | Muse Spark Open |
| Muse Wonder | Meta | 94.28 | 54.49 | 54.5% | 94.3 | single model | Muse Wonder |
| Nemotron 3 Ultra 550B A55B | NVIDIA | 25.28 | 31.93 | 31.9% | 25.3 | single model | Nemotron 3 Ultra 550B A55B |
| Qwen3.5 27B | Alibaba | 12.49 | 37.28 | 37.3% | 12.5 | single model | Qwen3.5 27B |
| Qwen3.6 27B | Alibaba | 19.48 | 47.8 | 47.8% | 19.5 | single model | Qwen3.6 27B |
| Qwen3.6 Flash | Alibaba | 8.69 | 34.23 | 34.2% | 8.7 | single model | Qwen3.6 Flash |
| Qwen3.7 Plus | Alibaba | 8.88 | 39.77 | 39.8% | 8.9 | single model | Qwen3.7 Plus |
| Qwen3.8 2.4T A95B | Alibaba | 32.28 | 48.76 | 48.8% | 32.3 | single model | Qwen3.8 2.4T A95B |
| Qwen3.8 27B | Alibaba | 14.25 | 43.4 | 43.4% | 14.2 | single model | Qwen3.8 27B |
| Qwen3.8 Flash | Alibaba | 2.5 | 41.68 | 41.7% | 2.5 | single model | Qwen3.8 Flash |
| Qwen3.8 Max | Alibaba | 30.54 | 46.27 | 46.3% | 30.5 | single model | Qwen3.8 Max |
| Qwen3.8 Max 0902 | Alibaba | 31.52 | 36.33 | 36.3% | 31.5 | single model | Qwen3.8 Max 0902 |
| Qwen3.8 Max Prime | Alibaba | 62.91 | 34.99 | 35.0% | 62.9 | single model | Qwen3.8 Max Prime |
| Solar Pro4 | Upstage | 2.14 | 23.33 | 23.3% | 2.1 | single model | Solar Pro4 |
| Tencent HY3 | Tencent | 2.05 | 43.21 | 43.2% | 2.1 | single model | Tencent HY3 |
Für jeden der 8 Router erzielte mindestens ein von uns ausgeführtes einzelnes Modell eine gleich hohe oder höhere Punktzahl und kostete pro Frage gleich viel oder weniger. Im Diagramm markiert der grüne Bereich Ergebnisse, die weniger als GPT-6.1 Sol kosten und über 50 % liegen.
Für jede Frage wählt der Agent zuerst eine von 11 Datenbanken aus und schreibt dann SQL-Abfragen dagegen. Er kann ein Modell bis zu 10 Mal pro Frage aufrufen, und der Router wählt das Modell für jeden Aufruf. Ein Pool ist die Menge von Modellen, aus denen ein Router wählen kann.
Punktzahlen nach Router
| Label | Label short | CI low | CI high | Score (%) |
|---|---|---|---|---|
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 57.17 | 65.39 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 51.82 | 60.42 | 56.21 |
| OpenRouter Auto Code | Auto Code | 48.37 | 56.98 | 52.77 |
| Not Diamond (19 models) | Not Diamond | 46.46 | 55.07 | 50.86 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 39.96 | 48.37 | 44.17 |
| Fireworks Nexus Auto | Nexus Auto | 31.74 | 40.15 | 35.95 |
| TypeSafe Jev | TypeSafe Jev | 25.62 | 33.27 | 29.45 |
| OpenRouter Auto | OpenRouter Auto | 24.86 | 32.7 | 28.68 |
| Sakana Fugu Max | Fugu Max | 23.52 | 31.36 | 27.34 |
Alle 8 Router schnitten deutlich schlechter ab als GPT-6.1 Sol. Switchyard kam am nächsten, 5.0 Punkte darunter. Sein 95 %-Intervall überschneidet sich mit dem von Sol, aber der Test bei denselben Fragen trennt die beiden (siehe Statistik).
Jeder Router im Vergleich zu seinem meistgenutzten Modell
| Label | Label short | Router score | Alone score | Main model name | Main model short | Main model share | Router | Most used model |
|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 28.7% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 99% | 28.68 | 26.2 |
| TypeSafe Jev | TypeSafe Jev | 29.4% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 98% | 29.45 | 26.2 |
| Fireworks Nexus Auto | Nexus Auto | 35.9% | 36.1% | GLM 5.3 Flash | GLM 5.3 Flash | 99% | 35.95 | 36.14 |
| Not Diamond (19 models) | Not Diamond | 50.9% | 49.9% | GPT-5.6 Sol | GPT-5.6 Sol | 100% | 50.86 | 49.9 |
| OpenRouter Auto Code | Auto Code | 52.8% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 71% | 52.77 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 56.2% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 75% | 56.21 | 61.19 |
Von den sechs Routern, die ihr Modell benennen, lagen vier innerhalb von 3.3 Punkten ihres meistgenutzten Modells. Switchyard teilte seine Aufrufe zwischen GPT-6.1 Sol und GPT-6 Luna auf, und Automatisch Code zwischen GPT-6.1 Sol und GLM 5.3. Sie lagen 5.0 und 8.4 Punkte unter Sol.
Die Router hatten keinen gemeinsamen Pool, daher spiegeln diese Abstände sowohl den Router als auch die Modelle wider, aus denen er wählen konnte. Der Abschnitt Gemeinsamer Pool vergleicht drei Router mit denselben zwei Modellen. Wir haben die Pools für Switchyard und Not Diamond festgelegt (siehe Router und Pools).
Zeit pro Frage
| Label | Label short | Sec label | Seconds |
|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 8.8 s | 8.8 |
| TypeSafe Jev | TypeSafe Jev | 9.0 s | 8.96 |
| OpenRouter Auto Code | Auto Code | 10.4 s | 10.42 |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 10.7 s | 10.69 |
| Fireworks Nexus Auto | Nexus Auto | 10.8 s | 10.81 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 12.7 s | 12.68 |
| Sakana Fugu Max | Fugu Max | 13.3 s | 13.28 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 15.4 s | 15.44 |
| Not Diamond (19 models) | Not Diamond | 17.3 s | 17.28 |
Not Diamond mit 19 Modellen und Switchyard waren die langsamsten Router. Sie benötigten im Median 17.3 bzw. 15,4 Sekunden pro Frage. GPT-6.1 Sol benötigte 10,7 Sekunden. OpenRouter Automatisch und Jev waren mit 8.8 und 9,0 Sekunden am schnellsten. Beide schickten fast jeden Aufruf an Claude Haiku 5.5.
Bei Automatisch Code liefen die GPT-6.1 Sol-Aufrufe auf der Prioritätsstufe. Sie wurden im Median in 1,5 Sekunden generiert, gegenüber 1,8 Sekunden für GPT-6.1 Sol ohne Router. Das Routing über Automatisch Code fügte etwa 0,2 Sekunden pro Aufruf hinzu. Pro Frage benötigten die beiden etwa gleich lange, 10.4 und 10,7 Sekunden im Median.
Kosten und Gebühren der Router
| Label | Label short | Total | Per correct | Billed | Computed from list prices |
|---|---|---|---|---|---|
| Fireworks Nexus Auto | Nexus Auto | $1.9 | $5.4 | — | 1.93 |
| OpenRouter Auto | OpenRouter Auto | $2.0 | $6.9 | 1.97 | — |
| TypeSafe Jev | TypeSafe Jev | $2.1 | $7.1 | 2.09 | — |
| Unbiased Pareto 26.10 | Unbiased Pareto | $13.2 | $29.8 | 13.18 | — |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | $15.4 | $25.2 | 15.45 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | $16.6 | $29.5 | 16.6 | — |
| OpenRouter Auto Code | Auto Code | $24.6 | $46.6 | 24.62 | — |
| Sakana Fugu Max | Fugu Max | $30.0 | $109.6 | 29.96 | — |
| Not Diamond (19 models) | Not Diamond | $50.5 | $99.3 | 43.76 | 6.76 |
Die Kosten eines Routers sind die Modellrechnung plus eventuelle Judge- oder Auswahlgebühren. Wenn ein Versuch fehlschlug und die Frage erneut ausgeführt wurde, zählen wir nur den letzten Versuch. Im Diagramm sind gestreifte Teile aus Preislisten berechnet, der Rest stammt aus Rechnungen.
Fireworks Nexus Automatisch kostete am wenigsten pro richtiger Antwort, 5,4 $ pro 1.000 richtige Antworten zu Listenpreisen. Unter Routern mit abgerechneten Kosten kostete OpenRouter Automatisch mit 6,9 $ am wenigsten.
Einige Router kosteten mehr als ihr meistgenutztes Modell. Die Mehrkosten stammten vom Judge von Switchyard, von der Auswahlgebühr von Not Diamond und von der Prioritätsstufe von Automatisch Code für dessen GPT-6.1 Sol-Aufrufe. In jedem Fall schnitt der Router nicht klar besser ab als sein meistgenutztes Modell.
Kosten im Vergleich zu einzelnen Modellen
Vier Router kosteten mehr als GPT-6.1 Sol, das 61,2 % für 15,4 $ pro 1.000 Fragen erzielte. Alle vier schnitten schlechter ab:
- Not Diamond mit 19 Modellen: 50,9 % für 50,5 $. Der größte Teil davon entfiel auf seine GPT-5.6 Sol-Aufrufe, und seine Auswahlgebühr fügte 6,8 $ hinzu (siehe Gebühren und Preisstufen).
- Sakana Fugu Max: 27,3 %, die niedrigste Punktzahl der 8 Router, für 30,0 $. Es benennt sein Modell nicht. Es führte 6.8 Modellaufrufe pro Frage aus, gegenüber 5.5 bei GPT-6.1 Sol. Sein durchschnittlicher Aufruf kostete etwa das 1.6-Fache eines GPT-6.1 Sol-Aufrufs.
- OpenRouter Automatisch Code: 52,8 % für 24,6 $. Es schickte 71 % der Aufrufe an GPT-6.1 Sol, und fast alle davon liefen auf der Prioritätsstufe von OpenAI (siehe Gebühren und Preisstufen).
- NVIDIA Switchyard: 56,2 % für 16,6 $. Seine Aufrufe an GPT-6.1 Sol und GPT-6 Luna kosteten 13,7 $, weniger als Sols 15,4 $. Sein Judge-Modell fügte 2,9 $ hinzu (siehe Gebühren und Preisstufen).
Keiner der drei günstigsten Router schnitt besser ab als GPT-6 Luna, das 38,8 % für 1,3 $ pro 1.000 Fragen erzielte. OpenRouter Automatisch und TypeSafe Jev lagen etwa 10 Punkte darunter, 28,7 % und 29,4 %, für 2,0 $ und 2,1 $. Fireworks Nexus Automatisch erzielte 35,9 % für 1,9 $, ohne klaren Unterschied zu Luna.
Gebühren und Preisstufen
- Um für jeden Aufruf ein Modell zu wählen, prüft Switchyard zuerst die bisherigen Tool-Ergebnisse. Fehler und wiederholte Misserfolge deuten auf das stärkere Modell hin. Wenn die Tool-Ergebnisse die Wahl nicht klären, wie beim ersten Aufruf einer Frage, liest ein kleines Judge-Modell, Gemini 3.5 Flash Lite, die Frage und wählt das Modell.1 Jeder Judge-Aufruf wird als normaler Modellaufruf abgerechnet. Auf dem gemeinsam genutzten Pool fügte der Judge 3,2 $ pro 1.000 Fragen hinzu.
- Not Diamond berechnet eine Gebühr für jede Modellwahl. Wir haben jede Wahl mit 0,001 $ gezählt, dem Preis auf seiner Preisliste.2 Auf dem gemeinsam genutzten Pool belief sich die Gebühr auf 6,3 $ pro 1.000 Fragen, 40 % der Gesamtsumme von 15,8 $ bei Not Diamond.
- Automatisch Code bekam die Prioritätsstufe von OpenAI auf fast allen seinen GPT-6.1 Sol-Aufrufen. Es zahlte das 2.04-Fache des Preises pro Aufruf von GPT-6.1 Sol. OpenRouter sagt, dass die Prioritätsstufe eines geschlossenen Modells nur dann greift, wenn eine Anfrage dies verlangt oder den Anbieter festlegt,3 aber unsere Anfragen taten beides nicht. Ohne die Stufe hätte Automatisch Code etwa 13 $ pro 1.000 Fragen gekostet statt 24,6 $.
Mit 19 Modellen kosteten die GPT-5.6 Sol-Aufrufe von Not Diamond 43,8 $ pro 1.000 Fragen, gegenüber 60,8 $ für GPT-5.6 Sol in unserem Text-zu-SQL-Benchmark. Ein Cache-Rabatt könnte den Unterschied erklären. Not Diamond erhielt den Cache-Preis bei 69,5 % seiner Eingabe-Tokens. Unser Text-zu-SQL-Lauf hat die Cache-Nutzung nicht aufgezeichnet, daher können wir dies nicht bestätigen.
Modellwahl und Modellwechsel
| Label | Label short | Claude Haiku 5.5 | DeepSeek V4.1 Flash | GLM 5.3 | GLM 5.3 Flash | GPT-5.6 Sol | GPT-6 Luna | GPT-6.1 Sol | Other |
|---|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 98.63 | 1.37 | — | — | — | — | — | — |
| TypeSafe Jev | TypeSafe Jev | 98.29 | 1.03 | 0.3206 | — | — | — | 0.1425 | 0.2138 |
| Fireworks Nexus Auto | Nexus Auto | — | — | 1.15 | 98.85 | — | — | — | — |
| Not Diamond (19 models) | Not Diamond, 19 models | — | — | — | — | 100 | — | — | — |
| OpenRouter Auto Code | Auto Code | — | — | 29.43 | — | — | — | 70.57 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard, Sol + Luna | — | — | — | — | — | 25.02 | 74.98 | — |
Von den 9 Router-Läufen mit Standardeinstellungen, die das Modell benennen, schickten fünf mindestens 98 % ihrer Aufrufe an ein einziges Modell. Dies waren OpenRouter Automatisch mit seinem eigenen Pool, Jev, Nexus Automatisch und Not Diamond auf beiden Pools.
Die Liste der 19 Modelle von Not Diamond enthielt auch Gemini 3 Flash Preview, das 59,7 % für 9,4 $ pro 1.000 Fragen erzielte. Keine der Auswahlen von Not Diamond ging an Gemini 3 Flash Preview. Jeder Aufruf ging an GPT-5.6 Sol, das 49,9 % erzielte.
Modellwechsel innerhalb einer Frage
Bei Standardeinstellungen wechselte nur Switchyard innerhalb von mehr als 5 % der Fragen das Modell. Dies tat es in 308 von 523 Fragen mit GPT-6.1 Sol und GPT-6 Luna sowie in 35 Fragen im gemeinsamen Pool.
Jede Frage lief als eine Router-Sitzung, mit demselben Sitzungsschlüssel bei jedem Aufruf. Die OpenRouter-Dokumentation zu Switchyard und Pareto empfiehlt dies für Agenten. Ein Sitzungsschlüssel hindert einen Router nicht daran, Modelle zu wechseln. Die meisten Router können für jeden Aufruf ein Modell wählen. Die OpenRouter-Dokumentation zu Automatisch sagt, dass ein Wechsel mehr kostet, weil das neue Modell den Prompt-Cache neu aufbauen muss. Daher wechselt Automatisch nur, wenn es sich lohnt. Die Fireworks-Dokumentation zu Nexus Automatisch sagt, dass es für jede neue Benutzernachricht ein Modell wählt und es für die Tool-Aufrufe dieser Nachricht beibehält. Unser Agent sendet eine Benutzernachricht mit der Frage und eine zweite, die nach der endgültigen Antwort fragt. Alle 9 Nexus-Automatisch-Wechsel erfolgten bei dieser zweiten Nachricht.
Vergleich mit zufälliger Mischung
Wir haben Switchyard in beiden Pools und Automatisch Code mit einer zufälligen Mischung verglichen. Die zufällige Mischung beantwortet jede Frage mit einem Modell, das zufällig gemäß den Aufrufanteilen des Routers ausgewählt wird. Ihre erwartete Punktzahl stammt aus unseren Einzelmodell-Läufen.
Switchyard mit Sol und Luna erzielte 56,2 %, gegenüber 55,7 % für seine zufällige Mischung. Switchyard im gemeinsamen Pool erzielte 55,1 % gegenüber 52,4 %. Automatisch Code erzielte 52,8 % gegenüber 54,7 %. Keiner der drei Router schnitt klar besser oder schlechter ab als seine zufällige Mischung.
Drei Router mit einem Pool
| Label | Label short | Cost label | Same two models, three routers |
|---|---|---|---|
| Not Diamond, cost setting | Not Diamond, cost | $12.8 | 59.66 |
| Gemini 3 Flash Preview (no router) | Gemini (no router) | $9.4 | 59.66 |
| Not Diamond, default setting | Not Diamond, default | $15.8 | 59.27 |
| NVIDIA Switchyard | Switchyard | $11.2 | 55.07 |
| OpenRouter Auto | OpenRouter Auto | $3.4 | 32.89 |
| DeepSeek V4 Flash (no router) | DeepSeek (no router) | $2.9 | 30.4 |
Um die Modelle vom Routing zu trennen, gaben wir drei Routern dieselben zwei Modelle. Gemini 3 Flash Preview ist das starke, und DeepSeek V4 Flash ist das günstige.
Ergebnisse im gemeinsamen Pool
Bei Standardeinstellungen zeigte kein Router einen klaren Unterschied zu seinem meistgenutzten Modell, und keiner erzielte mehr als Gemini 3 Flash Preview.
Not Diamond lag 1.9 Punkte unter GPT-6.1 Sol und Switchyard 6.1 Punkte darunter. Unser Test hat diese Abstände nicht bestätigt.
- Bei seiner Standardeinstellung schickte Not Diamond 100 % der Aufrufe an Gemini 3 Flash Preview. Es erzielte 59,3 % gegenüber 59,7 % für Gemini 3 Flash Preview. Es kostete 15,8 $ pro 1.000 Fragen gegenüber 9,4 $.
- Mit seiner Kosteneinstellung schickte Not Diamond 62 % der Aufrufe an DeepSeek V4 Flash. Es gab weiterhin jede endgültige Antwort mit Gemini 3 Flash Preview. Es erzielte 59,7 %, genauso wie Gemini 3 Flash Preview, für 12,8 $ gegenüber 9,4 $. Seine Auswahlgebühr, 7,5 $, war höher als die Kosten seiner Modellaufrufe.
- Switchyard schickte 75 % der Aufrufe an Gemini 3 Flash Preview und erzielte 55,1 %, ohne klaren Unterschied zu Not Diamond.
- Automatisch schickte 97 % der Aufrufe an DeepSeek V4 Flash und erzielte 32,9 %, nahe an den 30,4 % von DeepSeek V4 Flash.
Modelleignung und Aufruflimit
Wir fanden kein klares Anzeichen dafür, dass ein Router in diesem Pool das zur Frage passende Modell wählte. Es gibt 170 Fragen, die Gemini 3 Flash Preview löst und DeepSeek V4 Flash verfehlt, und 17, bei denen es umgekehrt ist. Jeder Router schickte in beiden Gruppen einen ähnlichen Anteil seiner Aufrufe an DeepSeek V4 Flash, höchstens 10 Punkte auseinander. Die Gruppe von 17 ist zu klein, um einen kleinen Unterschied zu zeigen.
Automatisch erreichte das Limit von 10 Aufrufen am häufigsten, bei 37,3 % der Fragen, gegenüber 18,9 % bei Switchyard und 16,8 % bei Not Diamond.
OpenRouter Automatisch brauchte in diesem Pool außerdem am längsten, 17,5 Sekunden pro Frage im Median. Not Diamond benötigte 9,0 Sekunden mit denselben zwei Modellen.
Jeder Router im Kurzporträt
Not Diamond
Der Standard-Router von Not Diamond wird vortrainiert geliefert, Sie müssen ihn also vor der Verwendung nicht trainieren. Sie können auch einen benutzerdefinierten Router mit Ihren eigenen Daten trainieren.4 Not Diamond ruft das Modell nicht auf. Es gibt den Namen des gewählten Modells zurück, und Ihr eigener Code ruft dieses Modell dann auf. Die anderen Router führen den Aufruf selbst aus. Standardmäßig wählt Not Diamond nach Qualität. Eine Trade-off-Einstellung bei jeder Anfrage kann stattdessen Kosten oder Latenz bevorzugen.5 Wir verwendeten den Standard-Router und führten seine Kosteneinstellung einmal im gemeinsamen Pool aus.
NVIDIA Switchyard
Switchyard läuft auf OpenRouter. Sie listen bis zu drei Modelle auf, und es wählt zwischen dem günstigsten und dem teuersten davon. Es fügt keine eigene Routing-Gebühr hinzu.1
OpenRouter Automatisch
OpenRouter Automatisch wählt für jede Anfrage ein Modell und einen Reasoning-Aufwand und erhebt keine Gebühr.6 Eine Liste in `allowed_models` ist ein hartes Limit, und eine Kostenstufe von niedrig, mittel oder hoch legt die Richtlinie fest. Die Dokumentation besagt, dass der Standard mehr kostet als das alte Automatisch, und empfiehlt die niedrige Stufe, um die Kosten näher daran zu halten. In unserem Test erzielte die niedrige Stufe 28,3 % gegenüber 28,7 % beim Standard, bei denselben 2,0 $ pro 1.000 Fragen, ohne klaren Unterschied.
OpenRouter Automatisch Code
Automatisch Code läuft auf derselben Engine wie Automatisch, mit einer für Coding-Agenten abgestimmten Richtlinie, und erhebt keine Gebühr.7 Es zieht es vor, den Reasoning-Aufwand zu ändern statt die Modelle zu wechseln, um den Prompt-Cache zu erhalten. Es behandelt `allowed_models` als hartes Limit. Als wir ihm den gemeinsamen Pool gaben, schlug jede Anfrage mit einem Fehler fehl, der besagte, dass kein gemessenes Modell die Anfrage erfüllte.
TypeSafe Jev
Jev wählt für jede Anfrage ein Modell und einen Reasoning-Aufwand, und jede Anfrage wird zum Preis des Modells abgerechnet, an das sie geht.8 Eine Modellliste ist nur eine Präferenz, und nur `excluded_models` blockiert ein Modell.9 Seine Punktzahl zeigte keinen klaren Unterschied zu OpenRouter Automatisch. Stand 14. November 2026 besagt die Router-Benchmark-Seite von OpenRouter, dass Automatisch nun von Jev betrieben wird.10
Fireworks Nexus Automatisch
Nexus Automatisch ist ein Fireworks-Router, der mit der Modell-ID automatisch aufgerufen wird. Es benötigt keine Modellliste. Mit einem Fireworks-Schlüssel wählt es zwischen offenen Fireworks-Modellen.11
Unbiased Pareto 26.10
OpenRouter führt Unbiased Pareto 26.10 mit 0,80 $ pro Million Eingabe-Tokens und 3,20 $ pro Million Ausgabe-Tokens.12 Es benötigt keine Modellliste, und die Seite sagt nicht, wie es ein Modell auswählt oder welche Modelle es verwendet. Seine Antworten nennen nur den Router. Es erzielte 44,2 % für 13,2 $ pro 1.000 Fragen, niedriger und teurer als Gemini 3 Flash Preview.
Sakana Fugu Max
Sakana sagt, Fugu Max führe seinen größten Pool von Modellen aus. Der Pool ist festgelegt, und Sakana listet nicht alle seine Mitglieder auf. Es kostet 2 $ pro Million Eingabe-Tokens und 6 $ pro Million Ausgabe-Tokens sowie 0,007 $ für jeden internen Web-Tool-Aufruf.13
Methodik des agentischen Router-Benchmarks
Jeder Router erhielt denselben Agenten, Prompt, dieselben Tools und dieselbe Fragenreihenfolge. Ein lokaler Proxy zeichnete Modell, Tokens, Kosten und Dauer jedes Aufrufs auf.
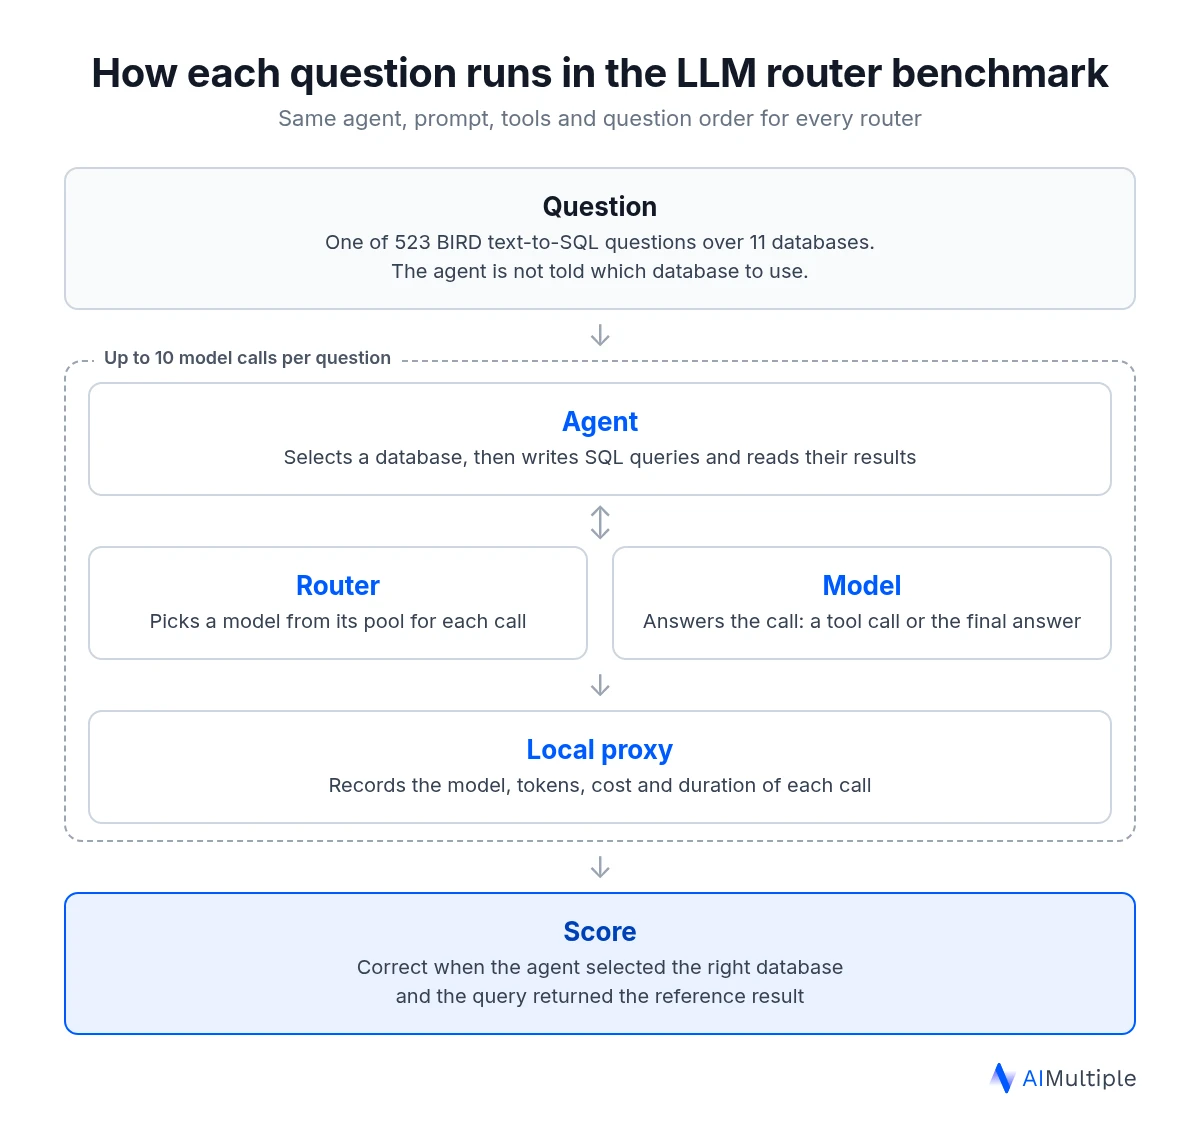
Wir verwendeten 523 Fragen aus unserem Text-zu-SQL-Benchmark, der auf BIRD basiert, einem öffentlichen Text-zu-SQL-Datensatz. Dem Agenten wird nicht mitgeteilt, welche der 11 Datenbanken er verwenden soll, und Datenbanknamen werden durch Aliasse ersetzt. Eine Frage gilt als richtig, wenn der Agent die richtige Datenbank wählt und seine Abfrage das Referenzergebnis zurückgibt. Ein Fehler gilt als Misserfolg. Jede Anfrage kann bis zu 600 Sekunden dauern.
Wir riefen sechs Router über OpenRouter mit den IDs openrouter/automatisch, openrouter/automatisch-code, typesafe/jev-router, nvidia/switchyard, unbiased/pareto-26.10 und sakana/fugu-max auf. Not Diamond lief über seine modelSelect-API, und wir riefen jedes von ihm gewählte Modell über OpenRouter auf. Fireworks Nexus Automatisch lief über die Fireworks-API. Außerdem führten wir GPT-6.1 Sol ohne Router durch denselben Aufbau aus. Die übrigen Punktzahlen einzelner Modelle stammen aus unserem Text-zu-SQL-Benchmark mit denselben 523 Fragen.
Die Zeit ist der Median der Sekunden pro Frage, gemessen auf unserer Seite über alle Agentenschritte. Jeder Router und Pool lief einmal, vom 13 bis zum 16. November 2026. Jede Frage wurde ohne Fehler abgeschlossen.
Router und Pools
Wir berücksichtigten Router, die zum Zeitpunkt des Laufs eine öffentliche API hatten und Tool-Aufrufe akzeptierten. OpenRouter Automatisch und Automatisch Code liefen nach dem 6. November 2026, als OpenRouter Automatisch überarbeitete und Automatisch Code einführte.14
Sechs Router liefen mit ihrem eigenen Pool und den Voreinstellungen des Anbieters. Wir legten den Pool für Switchyard und Not Diamond fest. Ohne Modellliste nimmt Switchyard zwei der 20 Modelle mit den höchsten Ausgaben auf OpenRouter in den vergangenen sieben Tagen, sodass sich das Paar im Laufe der Zeit ändert. Um das Paar fest zu halten, gaben wir ihm GPT-6.1 Sol und GPT-6 Luna. Not Diamond benötigt eine Modellliste. Wir gaben ihm 19 Modelle, die es unterstützt und die wir auch in unserem Text-zu-SQL-Benchmark getestet haben.
Um das Routing mit denselben Modellen zu vergleichen, führten wir Not Diamond, NVIDIA Switchyard und OpenRouter Automatisch mit einem gemeinsamen Pool aus. Diese Läufe werden nicht in eine Rangfolge eingeordnet.
Ein Router konnte nur teilnehmen, wenn er sich an eine von uns vorgegebene Modellliste hielt. Not Diamond unterstützt weder GPT-6.1 Sol noch GPT-6 Luna, das Paar, das Switchyard oben verwendete. Also wählten wir Gemini 3 Flash Preview und DeepSeek V4 Flash, ein starkes und ein günstiges Modell, das es unterstützt.15 Switchyard und OpenRouter Automatisch übernahmen dieselbe Liste. Die anderen fünf Router konnten nicht auf diese Liste festgelegt werden (siehe Jeder Router im Kurzporträt).
Wir testeten auch OpenRouter Pareto Code, stuften ihn aber nicht ein. Der Nutzer wählt eine von drei Stufen. Innerhalb einer Stufe sendet es Aufrufe an das günstigste verfügbare Modell und passt seine Wahl nicht an jede Runde an.
Am 13. November enthielt die Standardstufe von Pareto Code ein Modell, Claude Fable 5.2. In der von uns gewählten mittleren Stufe schickte Pareto Code alle 3.083 Aufrufe an Kimi K3 und erzielte 43,0 % für 28,4 $ pro 1.000 Fragen.
Statistik
Die Klammern im Punktediagramm zeigen ein 95 %-Konfidenzintervall, berechnet mit einem Bootstrap über die 523 Fragen. Es zeigt, wie stark eine Punktzahl davon abhängt, welche Fragen ausgewählt wurden.
Um zwei Ergebnisse bei denselben Fragen zu vergleichen, verwendeten wir einen exakten McNemar-Test. Er zählt nur die Fragen, die ein Ergebnis richtig und das andere falsch hatte. Da wir viele Vergleiche anstellten, korrigierten wir die Ergebnisse mit der Holm-Methode auf einem 5 %-Niveau. Wenn der Test zwei Ergebnisse nicht trennt, sagen wir, dass kein klarer Unterschied besteht.
Zum Beispiel lag Switchyard im gemeinsamen Pool 6.1 Punkte unter GPT-6.1 Sol, ohne klaren Unterschied. Mit Sol und Luna lag es 5.0 Punkte darunter, und dieser Abstand ist klar. Im gemeinsamen Pool unterschieden sich Switchyard und Sol bei 146 Fragen, bei denen eine richtig und die andere falsch war. Mit Sol und Luna unterschieden sie sich nur bei 44. Je mehr Fragen sich unterscheiden, desto größer muss ein Abstand sein, bevor wir ihn als klar bezeichnen.
Vergleiche der Router mit GPT-6.1 Sol verwenden dessen Lauf mit 61,2 % durch denselben Aufbau wie die Router. Die zufälligen Mischungen und andere Vergleiche mit einzelnen Modellen verwenden Sols Lauf mit 61,4 % aus unserem Text-zu-SQL-Benchmark. Im ersten Diagramm ist er als GPT-6.1 Sol (Text-zu-SQL) beschriftet. Es gibt keinen klaren Unterschied zwischen den beiden Läufen.
Einschränkungen
- Ein Lauf pro Router und Pool. In den beiden Läufen von GPT-6.1 Sol waren 33 Fragen in einem Lauf richtig und im anderen falsch.
- Ein Aufgabentyp, mit bis zu 10 Modellaufrufen pro Frage. Längere Agentenaufgaben können zu anderen Ergebnissen führen.
- Modellentscheidungen ändern sich mit dem Datum. Wir wiederholten 17 Fragen bei OpenRouter Automatisch, Automatisch Code und Jev am 17. November, vier Tage nach Beginn ihrer Läufe. Die Router wählten zwei Modelle, die wir in diesen Läufen nicht gesehen hatten. Automatisch Code schickte 63 % seiner Aufrufe an eines davon.
- Das Limit von 10 Aufrufen traf Sakana Fugu Max bei 16,1 % der Fragen. Selbst wenn es all diese richtig beantwortet hätte, würde es immer noch unter GPT-6.1 Sol abschneiden.
- Andere Pools als die drei von uns festgelegten können zu anderen Ergebnissen führen.
- Die Auswahlgebühr von Not Diamond verwendet 0,001 $ pro Auswahl, den Satz auf seiner älteren Preisseite. Seine aktuelle Seite berechnet stattdessen 0,05 $ pro Million gerouteter Tokens.
- Die Fragen stammen aus den öffentlichen Sets von BIRD, sodass Modelle sie möglicherweise im Training gesehen haben.
 Als bevorzugte Quelle hinzufügen
FAQs
Ein LLM-Router sitzt zwischen einer Anwendung und einer Reihe von Modellen und wählt für jede Anfrage ein Modell aus. Ziel ist es, einfache Arbeit an ein günstiges Modell und schwere Arbeit an ein starkes Modell zu senden. Bei einem Agenten umfasst eine Frage mehrere Aufrufe, daher kann ein Router für jeden Aufruf ein anderes Modell wählen.
Von den 8 Routern schnitt NVIDIA Switchyard mit 56,2 % am besten ab. OpenRouter Automatisch Code erzielte 52,8 % und Not Diamond mit 19 Modellen erzielte 50,9 %. Es gibt keinen klaren Unterschied zwischen Switchyard und Automatisch Code oder zwischen Automatisch Code und Not Diamond.
Im gemeinsamen Pool erzielte Not Diamond 59,3 %, die höchste Punktzahl aller Router bei seiner Standardeinstellung. Switchyard erzielte in diesem Pool 55,1 %, ohne klaren Unterschied zu Not Diamond.
In diesem Test nicht. Jeder der 8 Router schnitt klar schlechter ab als GPT-6.1 Sol.
Im gemeinsamen Pool lag Not Diamond 1.9 Punkte unter GPT-6.1 Sol und Switchyard 6.1 Punkte darunter. Unser Test hat diese Abstände nicht bestätigt.
Fireworks Nexus Automatisch hatte die niedrigsten Kosten, 1,9 $ pro 1.000 Fragen, berechnet aus Listenpreisen. OpenRouter Automatisch kostete 2,0 $ und TypeSafe Jev 2,1 $. Jeder schickte fast jeden Aufruf an ein günstiges Modell: Claude Haiku 5.5 für OpenRouter Automatisch und TypeSafe Jev sowie GLM 5.3 Flash für Nexus Automatisch.
Not Diamond erzielte im gemeinsamen Pool 59,3 % und mit 19 Modellen 50,9 %. OpenRouter Automatisch erzielte im gemeinsamen Pool 32,9 % und mit seinem eigenen Pool 28,7 %. Switchyard erzielte mit GPT-6.1 Sol und GPT-6 Luna 56,2 % und im gemeinsamen Pool 55,1 %, ein Abstand von 1.1 Punkten ohne klaren Unterschied.
Weiterführende Informationen
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{yila2026,
  author = {Yıla, Berkay},
  title  = {{LLM-Router-Benchmark: 8 Router bei 523 agentischen Datenbankaufgaben}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/llm-router}},
  note   = {AIMultiple. Abgerufen am 18. November 2026}
}Ergebnisse und Zeitstempel von 135 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 7 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Referenzlinks





Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.