


En İyi Yapay Zeka Web Kazıma Araçları Kıyaslandı

Siteler düzenlerini değiştirir ve bir sayfadan ihtiyaç duyduğunuz alanlar zamanla kayar. Bu değişiklikler elle kodlanmış kazıyıcıları bozar. Yapay zeka kazıyıcıları basit prompt'larla güncellenebilir ve bazıları site değiştiğinde kayıtlı bir kazıyıcıyı onarabilir.
En iyi yapay zeka web kazıma araçlarını, en iyi 10 e-ticaret alan adında performanslarını görmek için kıyasladık ve ayrıca her birinin yapay zekadan nasıl yararlandığını karşılaştırdık.
Sıralama, kıyaslanan sağlayıcılar için başarı oranına, geri kalanlar için ise özellik kapsamına göredir.
Yapay zeka web kazıma araçları kıyaslaması
Her sağlayıcı yapay zekaya farklı bir yaklaşım benimsiyor ve amacımız bu yaklaşımları ve beraberinde getirdikleri ödünleşimleri karşılaştırmaktı. Test süreci hakkında daha fazla ayrıntı için kıyaslama metodolojisi bölümüne bakın.
Fiyat ve para birimi verileri dünya genelindeki en iyi 10 e-ticaret sitesinden çıkarıldı.
Kıyaslamadan yapay zeka web kazıma araçları hakkında önemli bulgular
- Hatalar veri gibi görünerek geri döner. Bir araç fiyatı okuyamadığında, genellikle sayfa bir anti-bot duvarına takıldığı için, yanıt hata yerine 0 olarak dönebilir. Null yeniden denenebilir veya atlanabilir; 0 ise doğrulamadan fark edilmeden geçer. Örneğin, Apify ve Oxylabs bu durumlarda null döndürdü ve Firecrawl dokümantasyonu, modelin bir değer tahmin etmemesi için şemadaki her alana “Sayfada bulunamazsa null döndür” eklenmesini öneriyor.
- Ekstra alanlar davetsiz gelir. Fiyat ve para birimini isteyin; ayrıca marka, açıklama veya görsel URL'leri de alabilirsiniz. Bir şema, yanıtı adlandırdığınız alanlarla sınırlar. Örneğin, Bright Data çıktı şemasını derleme sırasında kilitlemenize olanak tanır, böylece her çağrıda aynı şekil geri döner.
- Yanlış öğe çekilir. İndirimli fiyata karşı orijinal fiyat, vergiliye karşı vergisiz, bölgesel geçişler: araç istemediğiniz sayıyı alabilir.
- Sayılar kayar. Prompt'tan JSON'a araçlar ondalıklar ekleyebilir, değerleri kısaltabilir veya sayfada hiç görünmeyen para birimi dönüştürülmüş yaklaşık değerler döndürebilir.
- Yerel ayar yanıtı değiştirir. Bazı siteler coğrafi IP'ye göre fiyatlandırır; bu nedenle ABD proxy'lerindeki bir sağlayıcı bir sayı görürken Avrupalı bir kullanıcı başka bir sayı görür.
Şema ve proxy bölgesi, bunların çoğunu verilerinize ulaşmadan önce yakalamanızı sağlayan parametrelerdir.
Yapay zeka web kazıma araçları fiyatlandırması
Kadoa hiçbir tarife yayınlamaz; kullanıma dayalı Flex katmanı ve satışla iletişime geçilen Enterprise katmanı sunar.
Yapay zeka web kazıma araçları karşılaştırması
İlk kazıyıcıya kadar geçen süre: Daha sonra ID ile çağırdığınız bir kazıyıcı oluşturan araçlar için kurulumun ne kadar sürdüğü. “Tek HTTP çağrısı”, hiçbir derleme adımı olmadığı anlamına gelir.
Kullanıcı tanımlı çıktı şeması: Kazıma çalışmadan önce çıktı alanlarını ve türlerini kendiniz belirleyip belirleyemeyeceğiniz; bunları bir prompt'ta tanımlayıp yapıyı çalışma zamanında LLM'e bırakmak yerine.
Bir kez oluştur, çok kez çağır endpoint: Kazıyıcının bir kez oluşturulup, sağlayıcı tarafında saklanıp, ardından yalnızca bir URL ile çağrılıp çağrılmadığı. Burada LLM (veya kayıt tabanlı araçlar için tıklama akışınız) derleme sırasında çalışır ve çıktısı, sizin sahip olduğunuz ve yerinde değiştirebileceğiniz bir kazıyıcıda dondurulur; planlamaların, webhook'ların ve entegrasyonların bağlandığı şey budur. Bunun eksik olduğu durumda, çıkarım her çağrıda yeniden yapılır ve tam tanım her istekle birlikte taşınır.
Kendi kendini onaran kayıtlı kazıyıcı: Kayıtlı bir kazıyıcının, hedef site değiştiğinde sıfırdan yeniden oluşturulmadan onarılıp onarılmadığı. Düzeltme, aynı saklanan kazıyıcıya mevcut tanımlayıcısı altında uygulanır; böylece tetikleyiciler, planlamalar ve entegrasyonlar çalışmaya devam eder.
* Kadoa kazıyıcıyı saklar ve ID ile çağırır, ancak hedef URL'ler iş akışı oluşturulduğunda bağlanır. Yeni bir URL'ye yönlendirmek, çalıştırmadan önce ayrı bir meta veri güncellemesi gerektirir.
Her çağrıda sayfa üzerinde bir LLM çalıştıran araçlar burada sayılmaz: onarılacak kalıcı bir çıkarım mantığı yoktur; bu, onları yerleşim değişikliklerine toleranslı kılar ancak inceleyecek, sürümleyecek veya onaylayacak bir yapıt olmadığı anlamına da gelir. İşaret edebileceğiniz bir tanımlayıcısı olmayan dahili önbellekler de sayılmaz, çünkü yine inceleyecek, sürümleyecek veya onaylayacak bir şey yoktur.
Sayfaların sürekli değişmesi gibi konuların ötesinde, agentic pipeline'larda genellikle çağırabileceğiniz basit bir API'ye ihtiyaç duyarsınız: bir URL verin, yapılandırılmış veriyi geri alın. Ancak düzenli olarak kazımanız gereken her alan adı için hazır bir kazıyıcı API'si her zaman bulamazsınız; bulduğunuzda da istediğiniz alanlar orada olmayabilir veya şemayı kendi ihtiyaçlarınıza göre özelleştirmeniz gerekebilir. Bu sorunları ele alan farklı yaklaşımlar vardır.
Bir kez oluştur, çok kez çağır yapay zeka web kazıma platformları
Kendi kazıyıcınızı oluşturursanız, crawler'ı yazmanız, proxy'leri bağlamanız, başsız tarayıcıları çalıştırmanız ve kuyrukları, yeniden denemeleri ve anti-botu kendi başınıza yönetmeniz gerekir.
Yapay zeka, bu manuel işi azaltmak ve kurulumu basitleştirmek için kazımaya girdi. Bu araçların çoğunda yer alır, ancak her sağlayıcı onu farklı kullanır ve farklı bir ihtiyaç kümesine yanıt verir.
Bright Data Scraper Studio, herhangi bir URL için kazıyıcıyı bir prompt ile oluşturduğunuz ve ardından onu kararlı bir API olarak çağırdığınız iki aşamalı bir yaklaşım sunar. Bir kez kurarsınız ve o andan itibaren yalnızca URL'leri iletirsiniz.
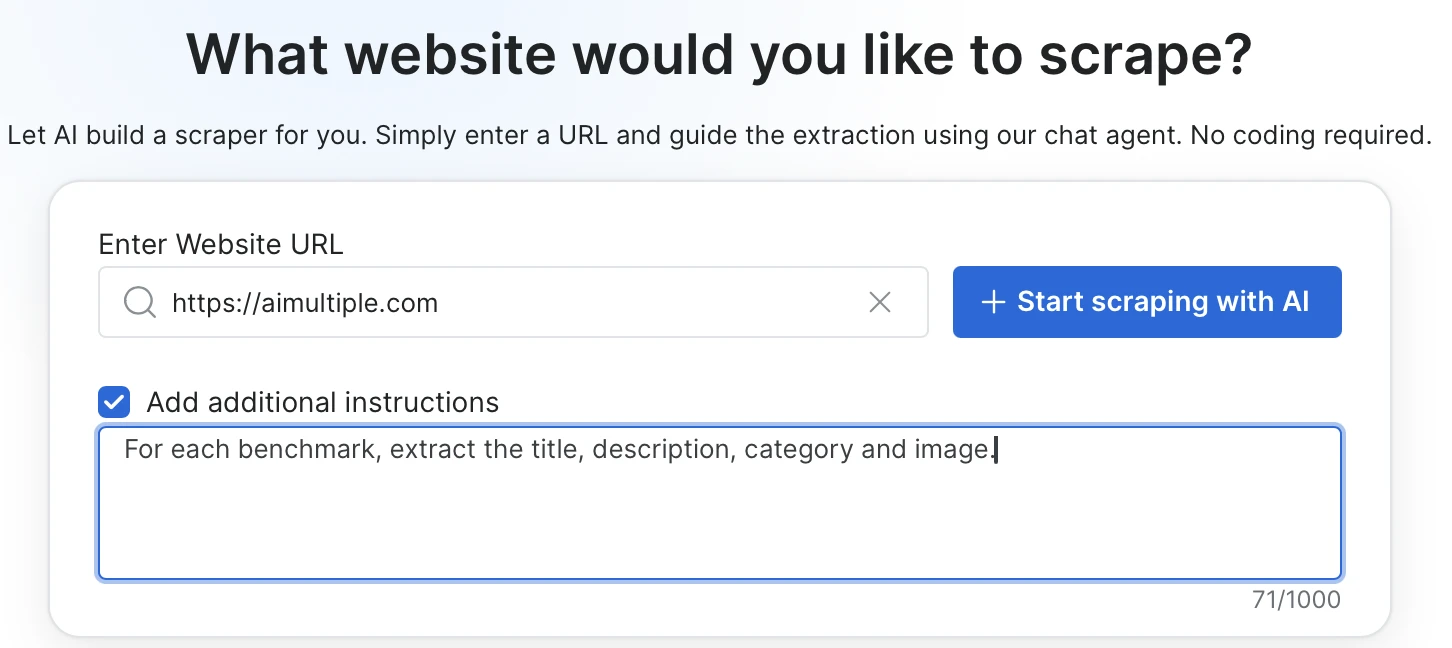
Çıkarmak istediğiniz alanları sade bir dille tanımlarsınız ve isteğe bağlı olarak CSS seçicileri, gerekli sayfa içi eylemler veya sayfa yükleme davranışı ekleyebilirsiniz.
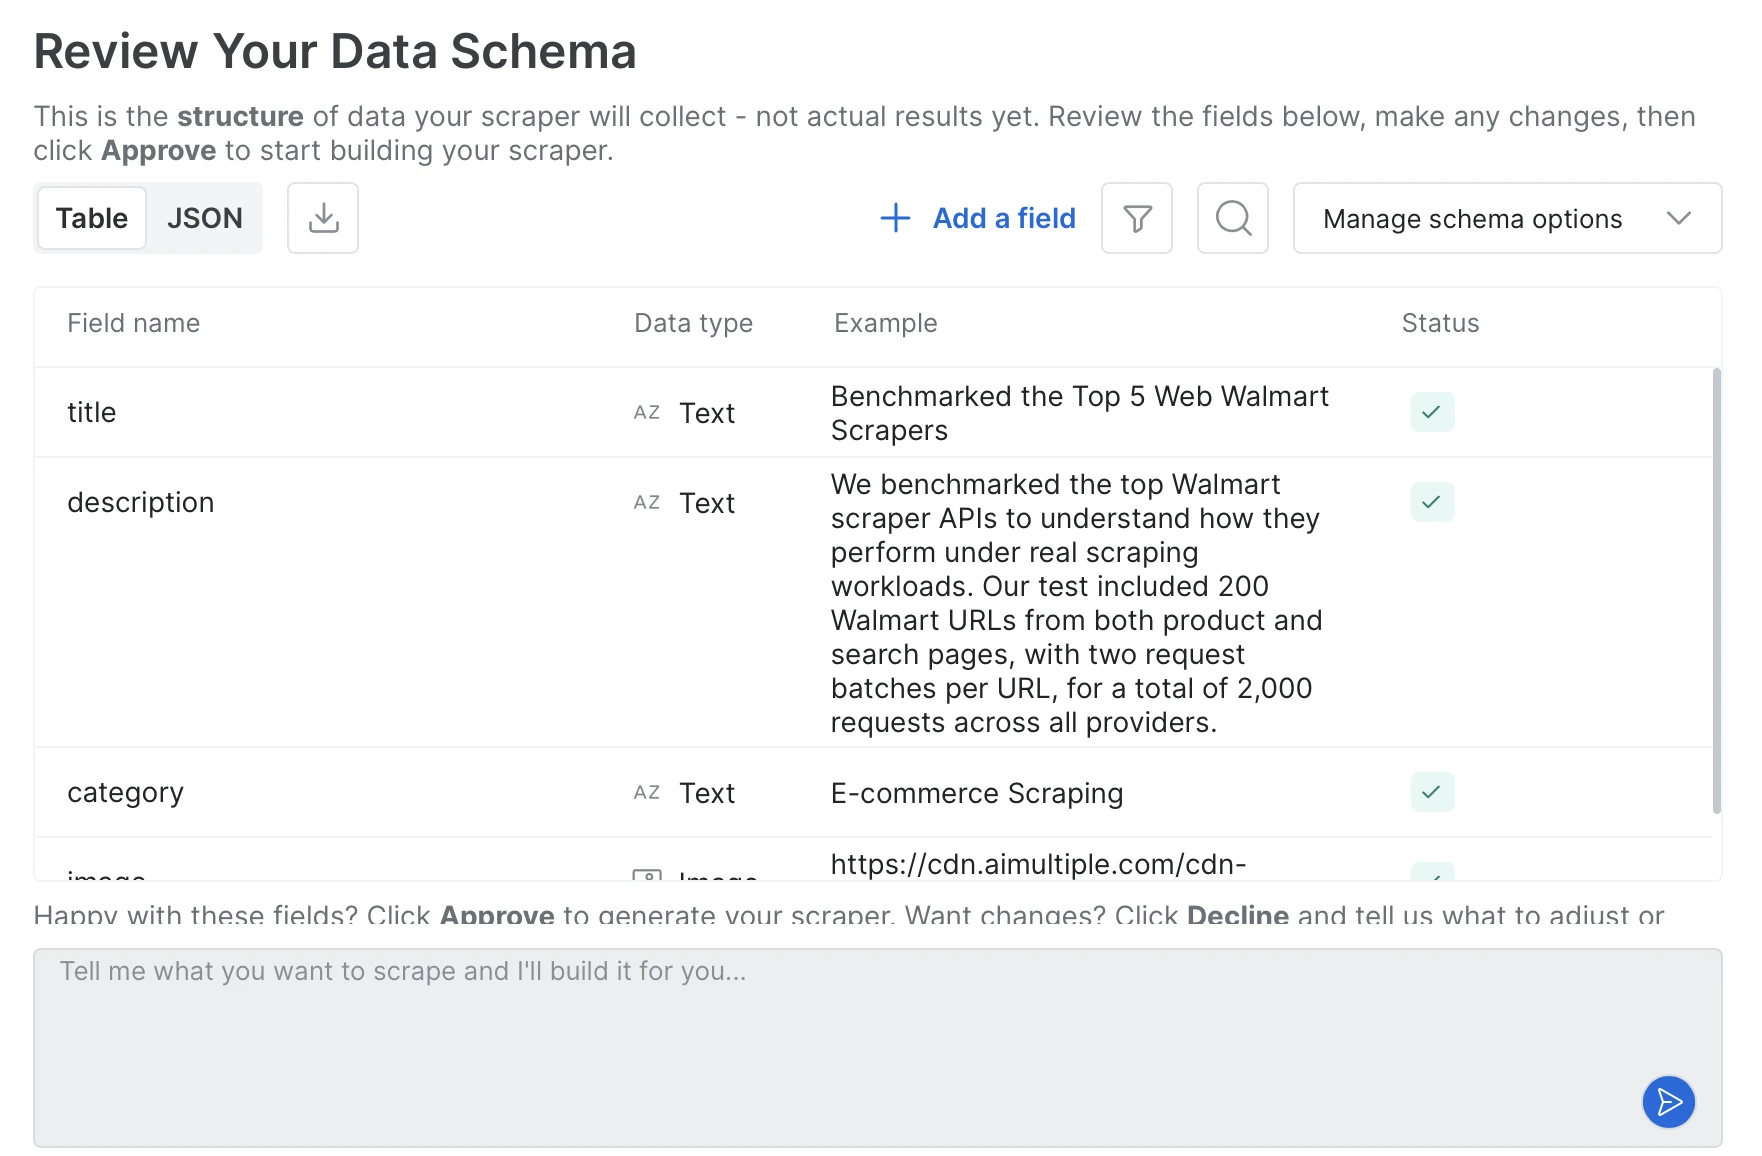
Ajan, prompt'tan çıktı şemasını oluşturur; alan ekleyerek veya çıkararak ya da türleri değiştirerek onaylarsınız ve ardından kazıyıcı kodu yazılır.
- Bir kez oluştur, çok kez çağır endpoint: Şemayı onayladığınızda, kazıyıcı sabit bir tanımlayıcıyla uzun ömürlü bir endpoint olarak kaydedilir. Her çağrı aynı endpoint'e yalnızca bir URL ile ulaşır ve çıktı şeması çağrılar arasında aynı kalır. Testlerimizde özel bir kazıyıcı oluşturmak ortalama 10 dakika civarında sürdü.
- İki oluşturma yöntemi: Tarayıcıda Ajan ile sohbet edebilir veya terminalinizden bir URL ve bir prompt alan tek bir komutla kazıyıcıyı oluşturmak için Bright Data CLI'sini kullanabilirsiniz. Her ikisi de aynı kazıyıcıyı üretir.
- Kodlama ajanı iş akışı: Terminal komutları Claude Code, Cursor ve Codex içinde değişiklik yapılmadan çalışır; böylece ajan düzenleyiciden ayrılmadan kazıyıcıyı oluşturabilir, çalıştırabilir veya kendi kendine onarabilir. Ayrıca kazıyıcının tanımlayıcısını ajanın kurallar dosyasına sabitleyebilirsiniz, böylece gelecekteki oturumlar onu yeniden kullanır. Sonuçlar API, SDK, CLI, webhook'lar aracılığıyla veya doğrudan S3, GCS, Azure veya OSS üzerindeki bulut depolamaya iletilebilir.
- Önceden oluşturulmuş kazıyıcılarla birlikte: Bright Data, Amazon, LinkedIn ve Zillow gibi popüler siteler için hazır kazıyıcılardan oluşan bir kitaplık sağlar.
- Kendi kendini onaran kayıtlı kazıyıcı: Site değiştiğinde ve kazıyıcı bozulduğunda, bozulan şeyi sade bir dille açıklarsınız; yapay zeka bir düzeltme üretir ve örnek çıktıyla gösterir; siz onaylayana kadar hiçbir şey yayına girmez. Kazıyıcının tanımlayıcısı değişmediği için ona bağlı her tetikleyici, planlama ve entegrasyon çalışmaya devam eder.
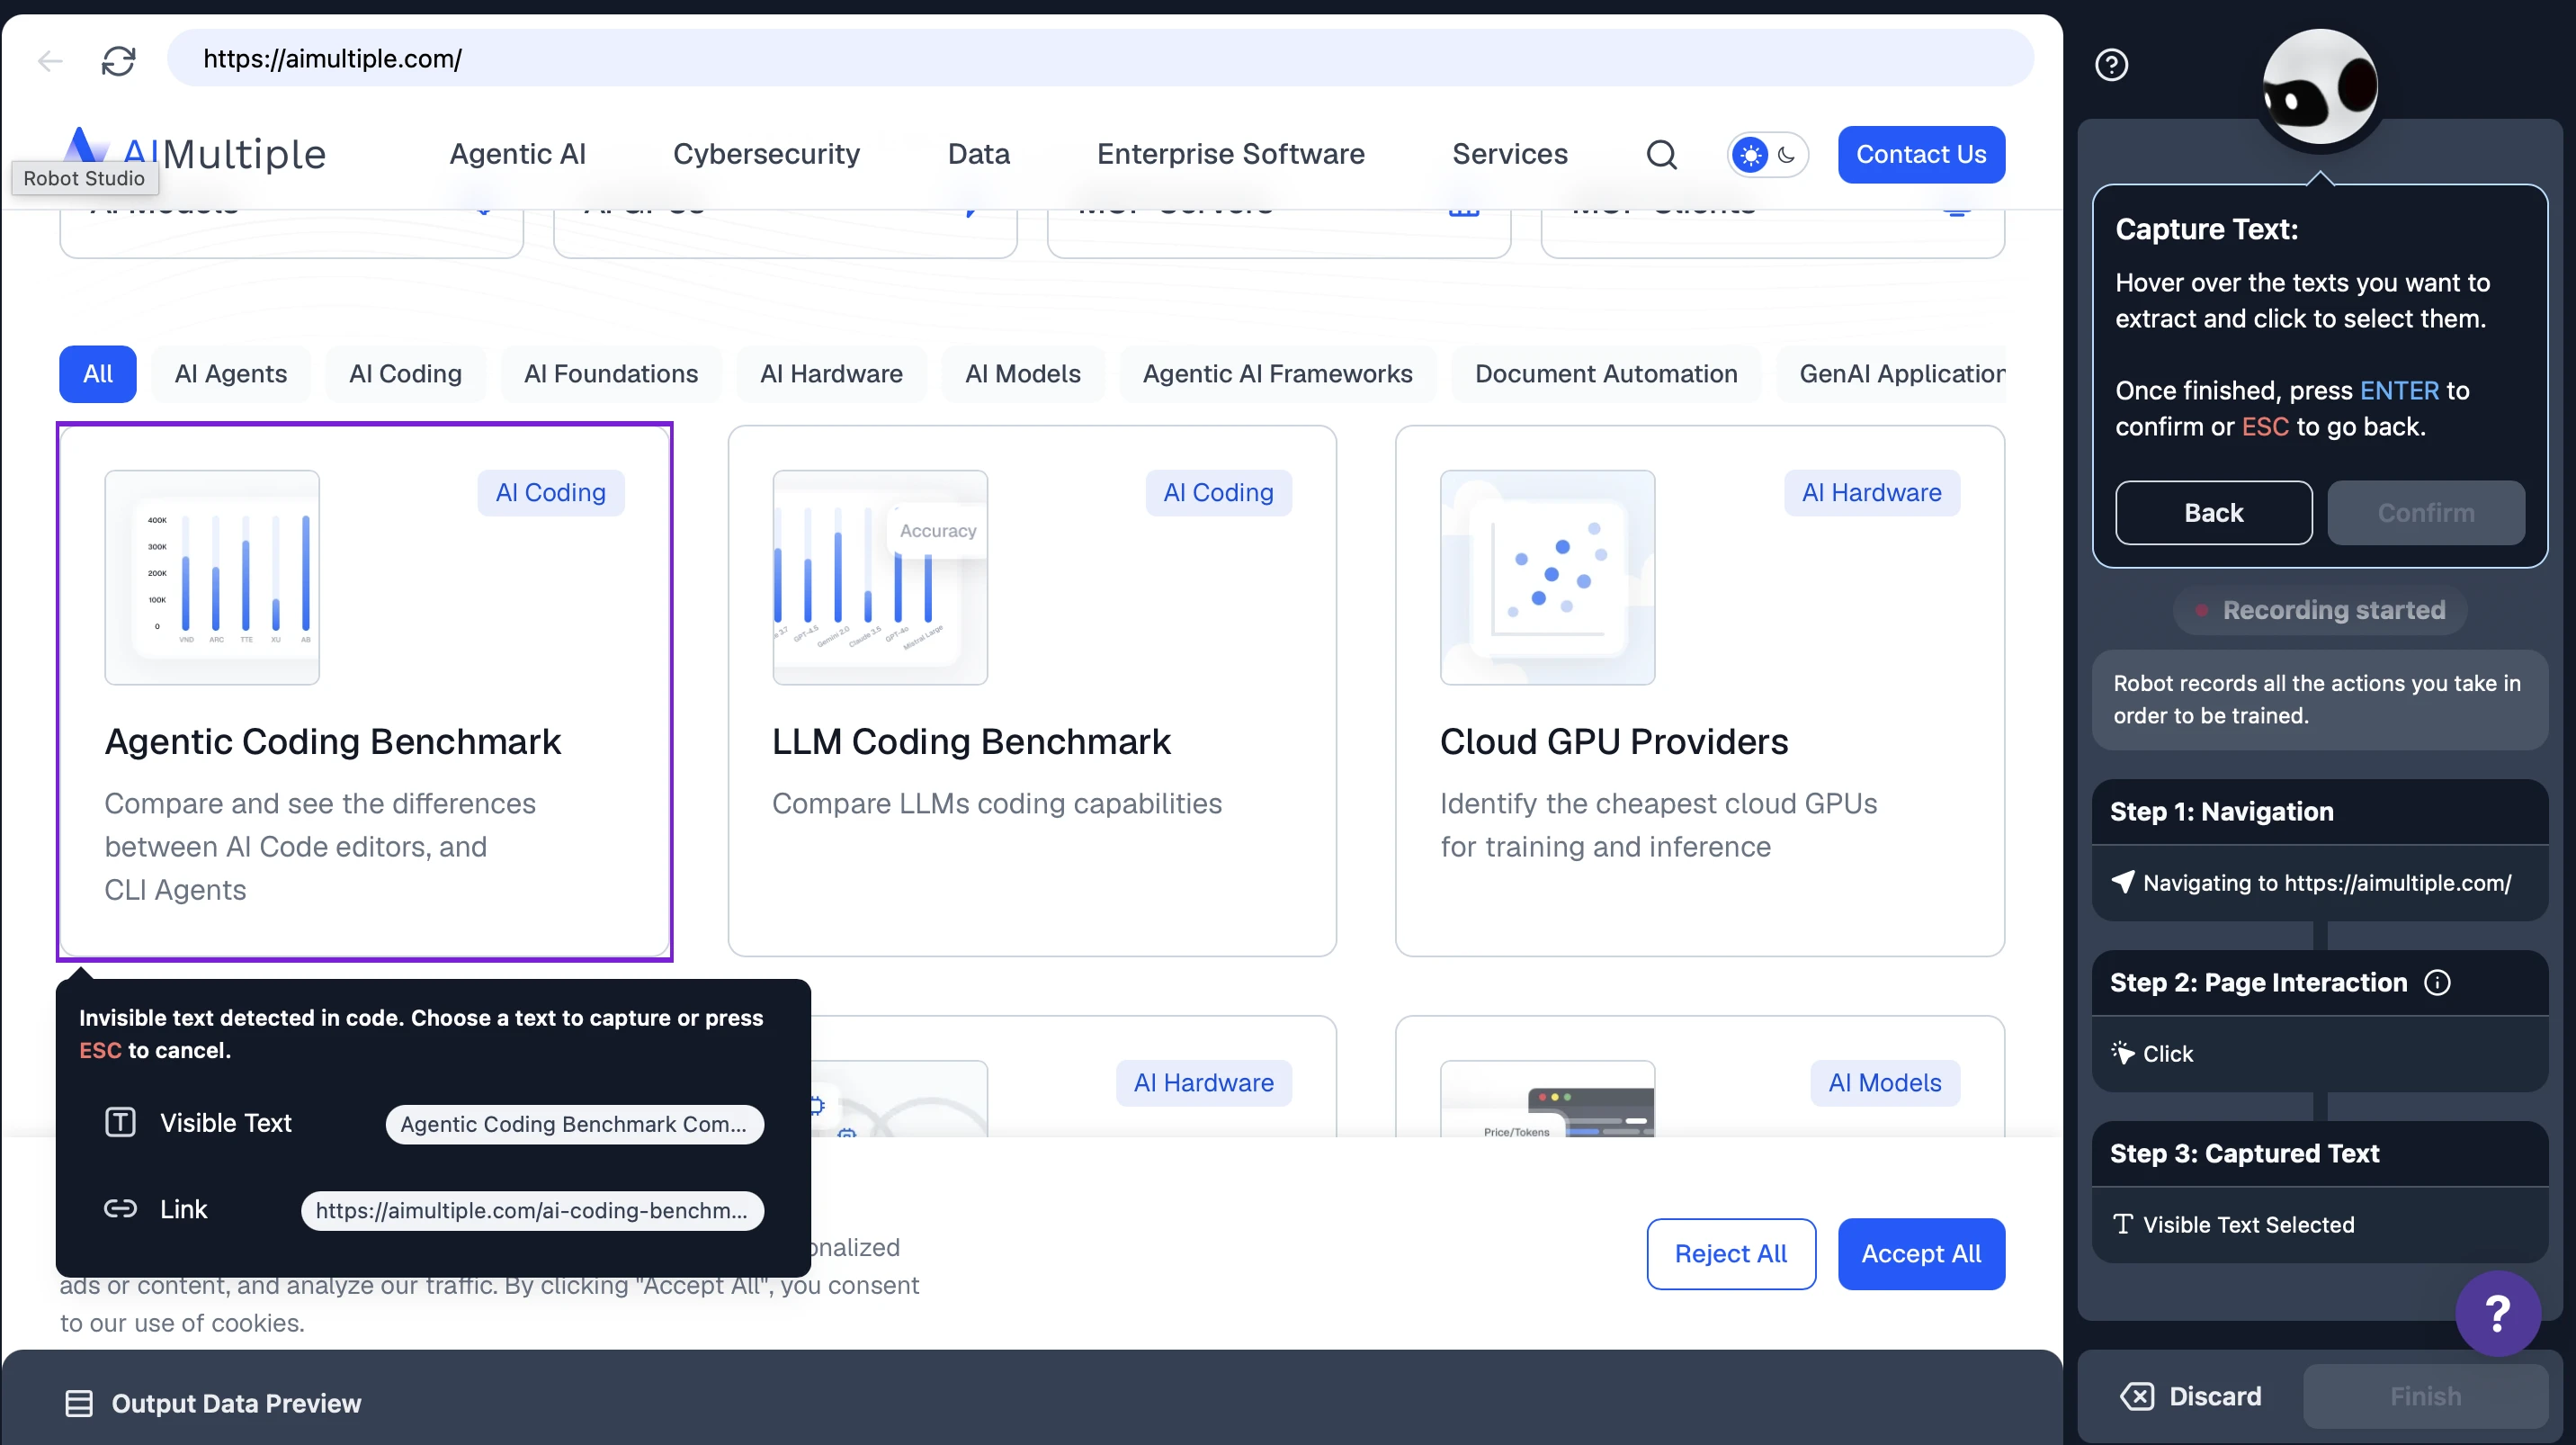
Browse AI'de kazıyıcıyı yine kendiniz oluşturursunuz, ancak kurulum görseldir: hedef sayfaya gider ve hangi alanların yakalanması gerektiğini işaretlemek için tıklarsınız; robot, gezinme adımlarını ve seçilen alanları bir kayıt olarak kaydeder. Bu kayıt daha sonra tekrar çalışır; sayfa değiştiğinde robot çoğu durumda kendi kendine uyum sağlar, sağlayamadığında yeniden eğitilir.
- Robot Studio ile görsel kurulum: Kazıyıcılar tıkla → alanı yakala → kaydet akışıyla oluşturulur.
- Yerleşik izleme ve uyarı: Saatlik, günlük veya haftalık planlamalar + değişiklik algılama + aynı üründe e-posta/webhook uyarıları.
- Şema yakalanan alanlardan oluşturulur: Her alan için ayrı bir yakalama adımı eklenir; prompt'tan şemaya yoktur.
- Otomatik uyarlama: Browse AI'nin motoru, bir site değiştiğinde kazıma kodunu uyarlar ve çoğu robot müdahale olmadan çalışmaya devam eder. Uyarlama yeterli olmadığında robotu yeniden eğitirsiniz; bu, geçmişini, çalıştırmalarını ve iş akışlarını korur.
Kadoa da kazıyıcıyı bir prompt'tan oluşturur, ancak hedef URL'leri çağrı başına kabul etmek yerine iş akışı oluşturulduğunda bağlar. Sakladığı şey bir prompt'tan ziyade üretilmiş koddur; bu nedenle izlenecek ve onarılacak somut bir yapıt vardır.
- Bir kez oluştur, çok kez çağır endpoint: Kayıtlı bir iş akışı kalıcı bir ID alır ve
PUT /v4/workflows/{id}/runile çağrılır. İstek yalnızca değişkenleri ve bir satır sınırını taşır; şema ve çıkarım kodu Kadoa tarafında kalır. Aynı iş akışını farklı bir URL'ye yönlendirmek önce meta verilerini güncellemeyi gerektirir; bu nedenle içinde URL olan tek bir çağrı değildir. - Prompt'tan tipli şemaya: Veriyi kurulum prompt'unda tanımlarsınız ve Kadoa, görsel veya JSON görünümünde düzenleyebileceğiniz bir şema önerir. Alanlar STRING, NUMBER, MONEY, DATE ve LINK gibi türler taşır ve anahtar olarak işaretlenebilir.
- Kendi kendini onaran kayıtlı kazıyıcı: Onarım, bir planlama yerine başarısız bir çalıştırma ile tetiklenir. Kadoa çıkarım kodunu yeniden üretir ve aynı iş akışı ID'si altında daha önce çıkarılan verilere göre doğrular; böylece planlamalar ve entegrasyonlar çalışmaya devam eder. Düzeltme yayına girmeden önce bir onay adımı yoktur. Otomatik kurtarma başarısız olduğunda Kadoa'nın operasyon ekibine bir talep iletilir.
- Kodlama ajanı iş akışı: 40+ araçlı barındırılan bir MCP sunucusu; ayrıca birinci taraf Node ve Python SDK'ları ve bir CLI (
kadoa create,kadoa run,kadoa export). - Teslimat: Çekme için API, SDK, CLI, MCP ve Google Sheets; itme için S3, GCS, Azure Blob, webhook'lar, WebSocket'ler, e-posta ve Slack; paylaşım için Snowflake ve Databricks. Bulut depolama bağlayıcıları kendi kendine hizmet yerine destek aracılığıyla kurulur.
Tek seferlik yapay zeka çıkarım API'leri
Oxylabs AI Studio, tek bir SDK (pip install oxylabs-ai-studio) altında beş ayrı yapay zeka uygulamasından oluşan bir pakettir: AiScraper, AiCrawler, BrowserAgent, AiSearch ve AiMap. Sunucu tarafında hiçbir şey kalıcı değildir; her kazıma çağrısı yeni bir getirme artı LLM çıkarımı çalıştırır.
- AiScraper akışı: generate_schema(prompt=…) isteğe bağlı olarak bir LLM'i çağırır ve bir JSON şeması üretir; ardından scrape(url, schema) sayfayı getirir ve LLM çıkarımı çalıştırır. Şemayı kendi tarafınızda tutabilir ve yeniden kullanabilirsiniz, ancak sunucu uzun ömürlü bir kazıyıcı kaydetmez.
- Beş uygulama, tek SDK: Tek URL'li yapılandırılmış çıkarım için AiScraper, prompt güdümlü site taraması için AiCrawler, sayfa içi eylemler için BrowserAgent, doğal dille arama artı çıkarım için AiSearch ve bir sitenin filtrelenmiş URL haritaları için AiMap.
- Çıktı biçimleri: markdown (varsayılan), json, csv, toon (token için optimize edilmiş bir biçim), screenshot ve html (yalnızca tarayıcı ajanı).
- Elle yazılmış şemalar:
generate_schemaisteğe bağlıdır.schemaparametresi yazdığınız herhangi bir JSON Şemasını alır ve Oxylabs'in kendi örnekleri elle yazılmış bir Pydantic modelini geçer. JSON, CSV ve TOON çıktısı için bir şema zorunludur. - Öne çıkan parametreler: render_javascript=”otomatik” hizmetin JS render'ının gerekip gerekmediğine karar vermesini sağlar; geo_location, proxy konumu için bir ISO ülke kodu veya adı alır ve max_credits istek başına bir harcama sınırı belirler.
Apify, çalıştırılabilir kazıma ve otomasyon programları olan “Actor”ların platformunda oluşturulup çalıştırıldığı açık bir geliştirici ekosistemi sunar. Kendi Actor'ınızı sıfırdan yazabilir, hazır bir şablondan başlayabilir veya başkalarının Apify Store'da yayınladığı Actor'ları kullanabilirsiniz.
- Yapay zeka çıkarım actor'ı: Apify ayrıca doğal dilli bir prompt alan ve herhangi bir URL'den yapılandırılmış JSON döndüren hazır bir apify/ai-web-scraper Actor'ına sahiptir. Prompt'u her çalıştırmada yeniden girersiniz ve JSON çıktısının çağrılar arasında tutarlı kalması garanti edilmez; bu, prompt güdümlü araçlar için yaygın bir davranıştır.
- Yalnızca prompt: Actor'ın girdisi beş alandan oluşur:
startUrls,extractionMode,prompt,maxPagesToVisitvemaxCrawlDepth. Kullanıcı tanımlı bir çıktı şeması için parametre yoktur. - Kendi actor'ınızı oluşturun: Hedef siteniz için hazır bir kazıyıcı yoksa veya hiçbiri istediğiniz veri alanlarını kazımıyorsa, kendi Actor'ınızı yazar ve hangi alanların çıkarılacağına, bunların sayfada nerede bulunduğuna ve geri kalanının nasıl ele alınacağına siz karar verirsiniz. Bunun ne kadar süreceği kodlama becerilerinize ve sitenin karmaşıklığına bağlıdır. Kendi başınıza oluşturmak istemezseniz Apify profesyonel hizmetlerinden de yardım alabilirsiniz.
- Önceden oluşturulmuş kazıyıcılarla birlikte: Geliştiricilerin kendi Actor'larını yayınladığı bir pazar yeri. Popüler siteler için kazıyıcılar çoğunlukla üçüncü taraflarca yayınlanır ve bakımı yapılır.
- Platform hizmetleri: Actor'lar kullanıma hazır planlama, izleme, dataset depolama, proxy havuzu ve API erişimiyle birlikte gelir.
- Ajan erişimi, ajan yazarlığı değil: Apify'nin MCP sunucusu bir kodlama ajanının Actor'ları aramasına ve çalıştırmasına olanak tanır, ancak ajanın içinden bir Actor oluşturmak veya bakımını yapmak için yerleşik bir akış yoktur.
- Bakım sorumluluğu: Actor'ı kendiniz oluşturduysanız, site değiştiğinde onu siz düzeltirsiniz. Store'dan bir tane kullanıyorsanız, düzeltmenin Actor sahibinin zaman planına göre yayınlanmasını beklersiniz.
Firecrawl, bir URL artı bir prompt'u veya bir JSON şemasını tek bir senkron çağrıda JSON'a dönüştürür. Her istek, çağrının yapıldığı anda çıkarım pipeline'ını çalıştırır.
- Prompt veya şema: Bir şema, çağrıdan önce alan adlarını ve türlerini sabitler; böylece yanıt yalnızca adlandırdığınız alanları içerir. Bir prompt yapıyı modele bırakır; yazması daha hızlıdır ancak çağrılar arasında değişebilir.
- Sayfa tipi biçimleri:
product,menu,branding,audiovevideo, Firecrawl tarafından belirlenen sabit bir yapı döndürür.productbaşlık, fiyat, stok durumu, varyantlar ve indirimli fiyatı kapsar. Parametre almazlar ve bir LLM olmadan çalışırlar. deterministicJson: Bir şema alır ve site başına üretilen bir çıkarıcıyı önbelleğe alır; böylece tekrarlanan kazımalar LLM'i atlar.jsonbiçimiyle birleştirilemez.- İstek başına yürütme: Her çağrı kendi prompt'unu veya şemasını taşır ve istek sırasında çalışır; bu nedenle çıktı, sayfanın o andaki görünümünü yansıtır ve önceden kaydedilecek hiçbir şey yoktur.
- Kodlama ajanı desteği: Resmi MCP sunucusu ve CLI; Claude Code, Cursor, Codex CLI ve Gemini CLI için hızlı başlangıçlar ve ayrıca resmi bir Claude eklentisi.
- Ajan: Firecrawl ayrıca URL'nin isteğe bağlı olduğu bir Agent ürünü sunar. Ne istediğinizi açıklarsınız ve ajan onu bulmak için web'de gezinir.
ScrapingBee, Firecrawl ile aynı tek çağrılı, durumsuz modeli kullanır. Fark, ne istediğinizi nasıl tanımladığınızda yatar.
- Üç çıkarım modu: Doğal dilde tek bir alan için ai_query (bir string döndürür), her alanın kendi açıklamasına sahip olduğu bir JSON şeması için ai_extract_rules ve türler, enum'lar ve iç içe çıktı içeren gelişmiş bir biçim.
- ai_selector: LLM'i sayfanın belirli bir bölümüne odaklamak için bir CSS seçici geçirin. Tam DOM'u okumasına izin vermekten daha hızlı ve daha doğrudur.
- Aynı çağrıda klasik kazıma: JS yoğun siteler için render_js, screenshot, yapay zeka olmadan CSS/XPath çıkarımı için extract_rules ve tek bir zarf içinde HTML, cookies, XHR'ler ve iframe'ler almak için json_response.
Pipeline'ınız için doğru araç nasıl seçilir?
Pratikte doğru araç, özellik listelerinden çok pipeline'ınızın zaman içinde verilerle ne yaptığına bağlıdır. Akılda tutulmaya değer birkaç örüntü vardır:
Tek seferlik veya ara sıra kazıma
Bir URL'den yalnızca bir kez veriye ihtiyacınız varsa ve her seferinde onu tanımlamak veya bir şema geçmek size uygunsa, tek seferlik yapay zeka çıkarım API'leri en hızlı yoldur. Oluşturulacak kazıyıcı yok, kaydedilecek şema yok.
Pipeline içinde tekrarlanan kazıma
Aynı kazıyıcıyı tekrar çalıştırıyorsanız ve her seferinde aynı şemayı döndüren kararlı bir endpoint'e ihtiyacınız varsa veya istediğiniz URL'ler için veri alanlarını özelleştirmeniz gerekiyorsa, bir kez oluştur, çok kez çağır platformu daha uygundur. Pipeline'ınız yalnızca URL'leri iletir ve çıktı şekli öngörülebilir kalır.
Oraya ulaşmak ne kadar sürer
Oluşturma süresi yaklaşıma göre değişir. Sıfırdan bir kazıyıcı veya actor yazmak, crawler, proxy bağlantısı ve yeniden denemeler size ait olduğu için genellikle günler ila haftalar sürer. Prompt tabanlı platformlar şemayı ve kodu dakikalar içinde üretir. Kayıt tabanlı araçlar da prompt yerine işaretle ve tıkla kurulumuyla dakikalar içinde sonuç verir. Tek seferlik yapay zeka çıkarım API'leri derleme adımını atlar; ilk yanıt tek bir HTTP çağrısında geri döner.
Site zaten hazır bir kazıyıcı tarafından kapsanıyor
Popüler siteler için hazır bir kazıyıcı kullanmak genellikle kendi kazıyıcınızı oluşturmaktan daha hızlıdır, ancak onu kimin çalışır durumda tuttuğu nereden geldiğine bağlıdır. Sağlayıcı bakımındaki bir kitaplık, site değiştiğinde sağlayıcı tarafından güncellenir.
Hazır hiçbir şey tarafından kapsanmayan site
O zaman soru, yerleşimler değiştiğinde işleri kimin düzelteceği hâline gelir. Kendiniz oluşturmak, bakımın size ait olduğu anlamına gelir. Kayıt tabanlı bir araç, işler bozulduğunda robotun yeniden eğitilmesi anlamına gelir. Sahip olduğunuz kod üzerinde yapay zeka kendi kendini onarma bunların arasındadır: düzeltme mevcut kodunuz üzerinde önerilir ve yayına girmeden önce onaylarsınız.
Kodlama ajanlarıyla oluşturma
İş akışınız Claude Code, Cursor veya Codex üzerinden yürüyorsa, aracın, ajanın uçtan uca yönetebileceği bir CLI veya MCP entegrasyonu sunup sunmadığı ya da ajanın yalnızca düz bir HTTP API'sini çağırıp çağıramayacağı önemlidir.
 Tercih edilen kaynak olarak ekle
Yapay zeka web kazıma kıyaslama metodolojisi
Dataset'i oluşturmak için Semrush'tan dünya genelindeki en iyi 10 moda ve giyim sitesini seçtik. Her site için tek bir ürün sayfası seçildi ve temel doğruluk verisi (fiyat ve para birimi) sayfa doğrudan ziyaret edilerek manuel olarak kaydedildi.
Beş yapay zeka kazıma aracı test edildi: Firecrawl Scrape API'si, Bright Data Scraper Studio, ScrapingBee AI Extract, Apify AI Web Scraper actor'ı ve Oxylabs AI Studio'nun AI Scraper'ı. Her sağlayıcı aynı tek cümlelik prompt'u aldı: “Ürünün fiyatını ve para birimini çıkar ve json döndür.”
Her URL her sağlayıcıya bir kez gönderildi. Yeniden deneme, yedek, şema zorunluluğu veya son işlem adımı yoktu. Ham yanıt, sağlayıcının döndürdüğü haliyle aynen saklandı.
Doğrulama için ham JSON çıktısı, beklenen fiyat ve para birimi için düzenli ifadeyle tarandı. Fiyat eşleştirme, 26.49 ile 26,49, 2.140 ile 2140 ve küçük ondalık hassasiyet farkları gibi yaygın biçimlendirme farklılıklarını tolere eder. Para birimi eşleştirme, ISO kodunu (USD) veya simgeyi ($) kabul eder.
İki metrik izlendi. Başarı oranı, her URL için fiyatın doğru döndürülüp döndürülmediğine ve para birimi için birer ikili kontrol olarak hesaplanır; ikisi daha sonra her URL için tek bir başarı puanı üretmek üzere ortalanır ve puanlar her sağlayıcı için on URL'nin tamamında ortalanır. Uçtan uca tamamlanma süresi, istekten yanıta kadar geçen duvar saati süresidir ve on URL üzerinden ortalanır. Bright Data için tek seferlik collector derlemesi hariç tutulur.
Bu araçları nasıl seçtik
Sayfa yapısını sabit kodlanmış kurallar olmadan yorumlamak veya bir prompt'tan veri çıkarmak için LLM'ler, NLP veya görüntü modelleri gibi yapay zeka kullanan araçları dahil ettik. Scrapy ve Playwright gibi yerleşik yapay zekası olmayan genel amaçlı kitaplıkları, her ikisi de kazıma için yaygın olarak kullanılsa da hariç tuttuk.
Yukarıdaki bölümlerde araçlar, kimin kullandığına göre değil, nasıl çalıştıklarına göre gruplandırılmıştır. Ayrım çizgisi modelin çalıştığı yerdir: bir kez oluştur platformları sayfa yapısını bir kez çözer ve sonucu ID ile çağırdığınız bir kazıyıcı olarak saklar; tek seferlik API'ler ise bunu her istekte yeniden çözer. Bu ayrım maliyeti, çıktı tutarlılığını ve site değiştiğinde işleri kimin düzelteceğini belirler; bu nedenle araçları kodsuz ve geliştirici ayrımından daha kullanışlı biçimde ayırır.
SSS'ler
Evet. Crawl4AI, Skyvern ve Browser Use gibi açık kaynaklı kütüphaneler kendi kendine barındırma için ücretsiz'dir ve Browse AI, Firecrawl ve Thunderbit dahil çoğu ticari araç, kullanım limitleri olan bir ücretsiz katmanı sunar.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{En İyi Yapay Zeka Web Kazıma Araçları Kıyaslandı}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Erişim tarihi: 25 Ağustos 2026}
}56 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 2 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
5 güncellemeEklendi: en iyi e-ticaret sitelerinde AI web kazıma araçlarını karşılaştıran bir kıyaslama bölümü.
Araç listesi Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern ve diğerlerinin adlandırılmış girdileriyle değiştirildi ve bir SSS bölümü eklendi.
Yapay zeka web kazıma araçlarına girişi, Otonom Yapay Zeka Ajanları, Vizyon Tabanlı Kazıma (VLM) ve Kendi Kendini Onaran kazıyıcıların açıklamasıyla değiştirdi.








Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.