


AIM-Decision: Jev vs Clef vs LLM'ler
Karar modelleri, System One modelleri olarak da adlandırılır,1 token metin üretmek yerine sabit bir seçenek kümesini puanlar. 59 karar modelini 1.655 sınıflandırma sorusunda, örneğin bir güvenlik açığını veya ürün geri çağırmasını derecelendirme gibi, test ettik ve bunlardan 46 tanesini 50 tarayıcı görevi üzerinde çalıştırdık. Birleşik sonuçlar için AIM System One Index'e bakın.
Sınıflandırma kıyaslama sonuçları
- decider-12b güvenlik açıklarında 46.4 ve geri çağırmalarda 62.4 puan aldı, $0,06 / 1.000 karar başına maliyetle. Hiçbir karar modeli iki görevde de anlamlı derecede daha yüksek puan almadı.
- Jev 1.13 $0,039 / 1.000 karar başına maliyete sahipti ve 47.9 puan aldı; bu, yaklaşık 7 ve 9 kat daha pahalı olan Kev-9B ve Nimble 9B'den yaklaşık bir puan düşüktü.
- pplx-decider-v1.1-27b ve Mercury Decide sırasıyla 48.7 ve 48.1 puan aldı, Jev'in 47.9 puanının üstünde, maliyetinin yaklaşık üçte biri kadardı.
- Eikos-27B, 27 milyar parametreli, $0,073 / 1.000 karar başına maliyete sahipti. 4 milyar parametreli Tev1 4B ise $0,34 maliyete sahipti.
- Strands Decider 2B geri çağırmalarda 62.6 puan aldı (tüm modeller arasında en yüksek) ve güvenlik açıklarında 33.9 puan aldı; rastgele yanıtların ortalaması 25'tir.
- GLiDE güvenlik açıklarında 46.5 puan alarak decider-12b'nin 46.4 puanına karşı, ancak karar başına 15,7 saniye sürdü (0.13'e karşılık) ve $0,48 / 1.000 karar başına maliyete sahipti. GLiDE v2 iki görevde ortalama 49.0 puan aldı, 0,47 saniye ve $0,10 maliyetle. Clef 51.0 puan aldı $0,17 maliyetle Cloudflare'ın API'si üzerinden.
Tarayıcı otomasyonu başarı oranları
Görev başına bir deneme; LLM'ler düşük akıl yürütme çabası ayarında API'lerinde çalıştı.
- Solar Decide, Solar Decide Flash ve Nimble 9B ile Tev1 4B ve Tev1 0.8B'nin her iki sürümü sıralanmadı çünkü soru başına en fazla 26 seçenek kabul ediyorlar ve 50 görevden 17'si daha fazla seçenekli bir sayfada açılıyor. Laya ve Strands Decider 2B de kapsam dışı çünkü girdi sınırları, diğer modellerin tam olarak aldığı istekleri reddetti.
- SubQ Snap 41 görev tamamladı; bu, Gemini 3.8 Flash'tan iki eksik ve GPT-6 Astra'dan altı eksiktir. Tamamlanan görev başına tahmini $0,001 maliyeti vardı; Gemini için $0,025 ve Astra için $0,226 idi.
- Karar modelleri birlikte 50 görevden 49'unu tamamladı; Astra'nın başarısız olduğu üç görev dahil.
- Sınıflandırmada birinci olan decider-12b, 16 tarayıcı görevini tamamladı; sınıflandırmada Jev'den düşük puan alan Kev-27B ise 40 görev tamamladı. Model kartına göre Jev 1.13'ten damıtılan JEV-27B-VL,2 Jev'in 47.9 puanına karşılık 45.8 puan aldı ve Jev'in 18 görevine karşılık 24 tarayıcı görevini tamamladı.
10 örnek görevi ve her modelin sonucunu Hugging Face üzerinde ve kıyaslamayı nasıl çalıştırdığımızı metodoloji altında görebilirsiniz.
Tarayıcı görevlerinde karar modelleri vs LLM'ler
Çoğu LLM yanıtını her seferinde bir token olarak yazar ve her token hesaplama ve zaman maliyeti getirir. Çoğu tarayıcı adımında ajan yalnızca bir işlem ve sayfadaki bir kontrol seçer.
Karar modeli sayfayı ve seçenekleri okur, her seçeneği puanlar ve en olası olanı döndürür. Üretilen metin yerine her seçenek için bir olasılık döndürür, bu nedenle bir adım uzun çıktı gerektirmez. Karar modelleri yeterince doğru olursa, aynı otomasyon çok daha hızlı ve LLM maliyetinin çok küçük bir kısmına çalışabilir.
Karar modelleri, bizim sunuşumuzda, seçenek puanları döndürür ve metin döndürmez; bu nedenle ayrı bir metin modeli, Mercury 2.5,3 form alanlarına yazılan değerleri yazar. Buna metin yardımcısı diyoruz ve her model için kullanılabilirdi.
Her modeli browser-use'un açık kaynaklı jev-ultrafast çalışma zamanında çalıştırdık,4 bu çalışma zamanı TypeSafe tarafından Jev 1.13 için geliştirilmişti.5 GPT-6 Astra üst düzey bir LLM referansı, Gemini 3.8 Flash ise düşük maliyetli bir referans olarak görev yapar. Tüm modeller metodoloji altında listelenmiştir.
Aynı görevde beş model
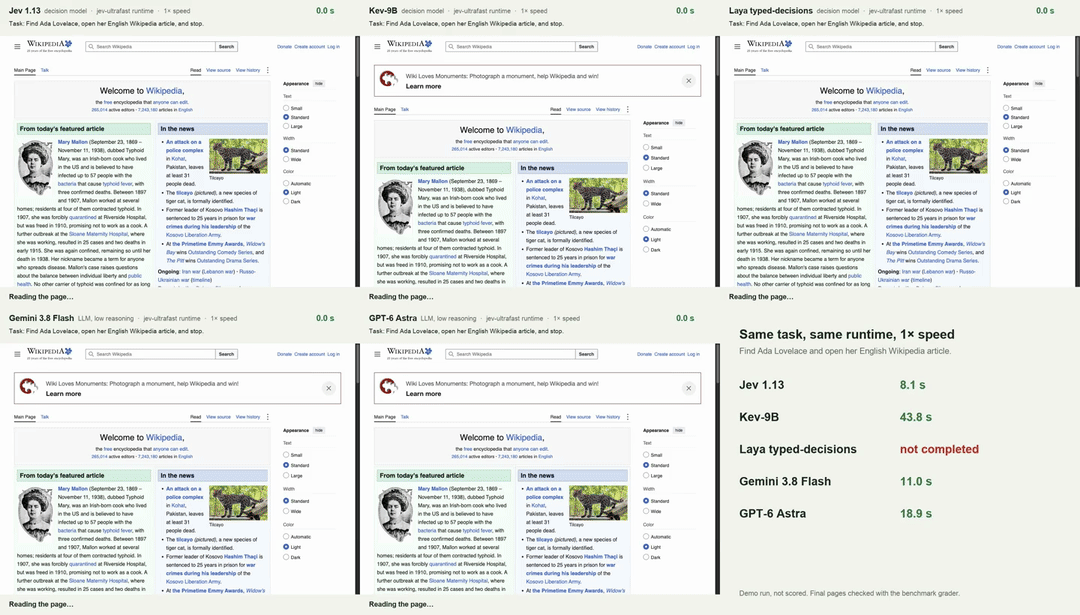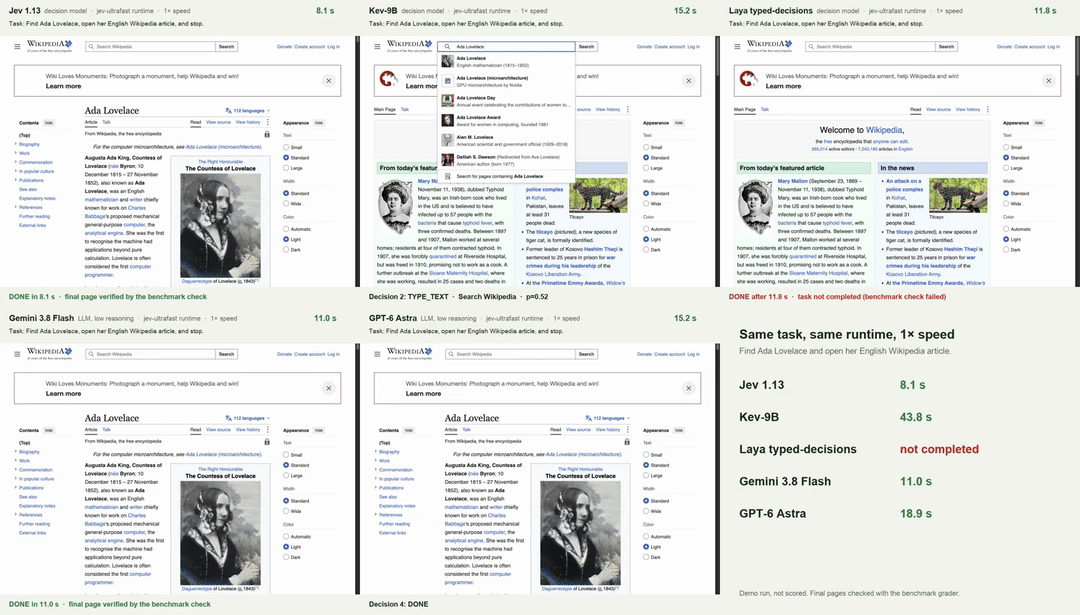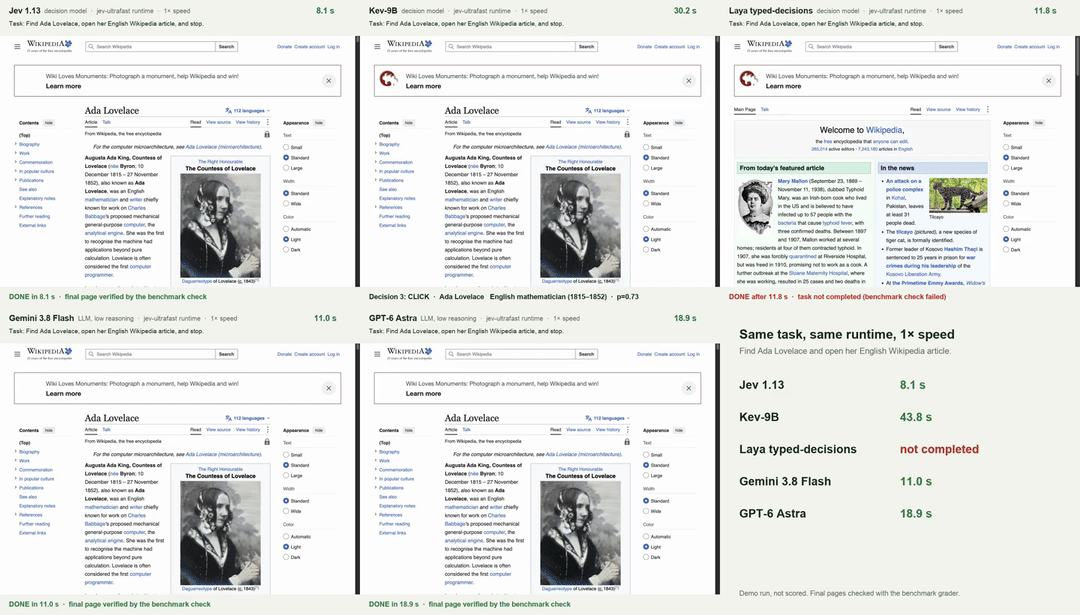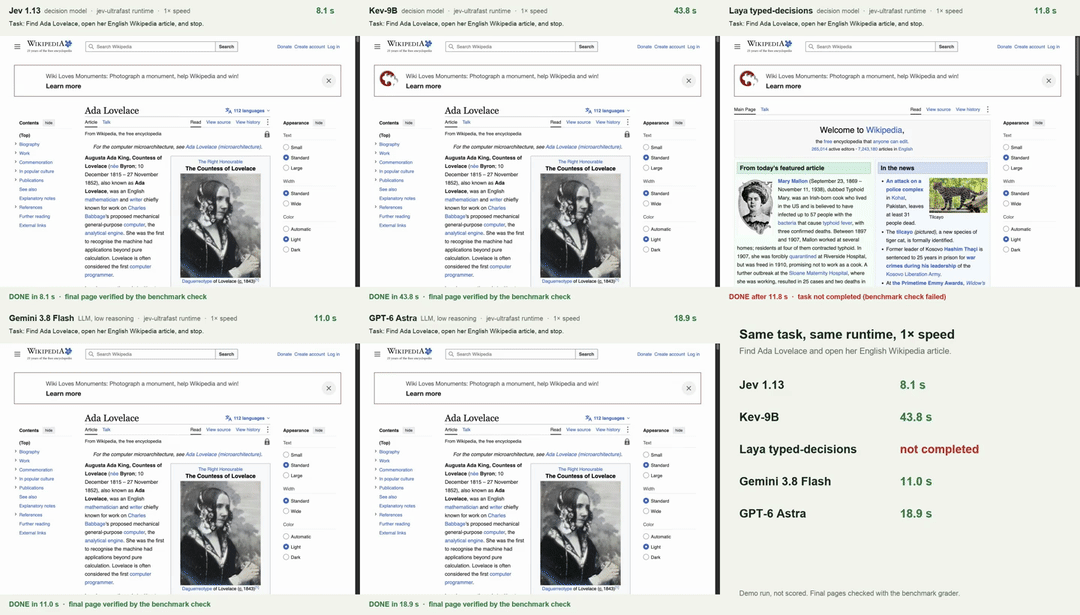
Wikipedia'da, Laya hariç her model arama kutusuna yazdı; metin yardımcısı “Ada Lovelace” yazdı ve model doğru öneriyi seçti. Jev makaleye 8,1 saniyede ulaştı, Gemini 11,0 saniyede, Astra 18,9 saniyede ve Kev-9B 43,8 saniyede ulaştı. Laya, hiçbir işlem yapmadan ana sayfada görevi bitmiş ilan etti.
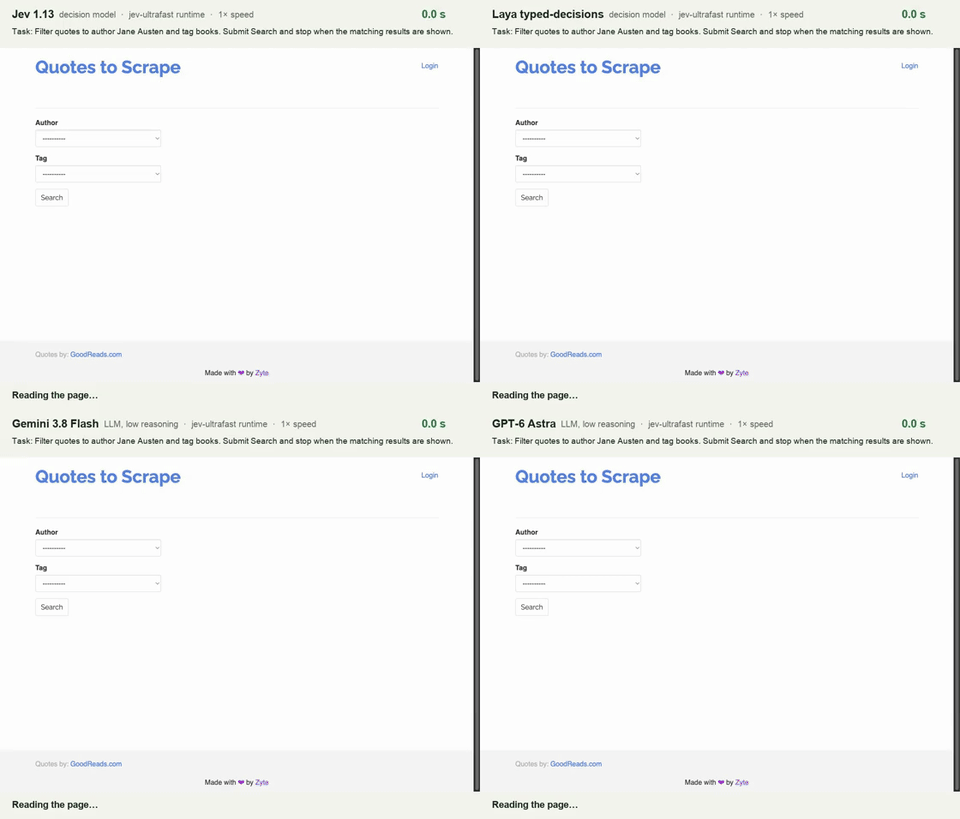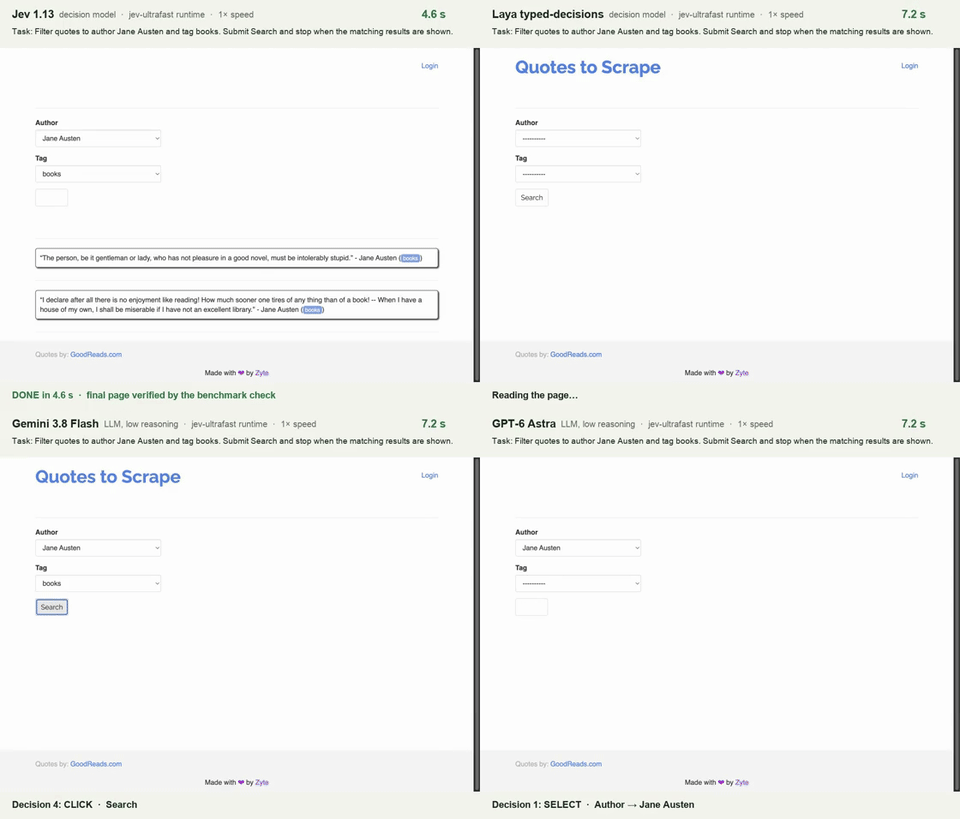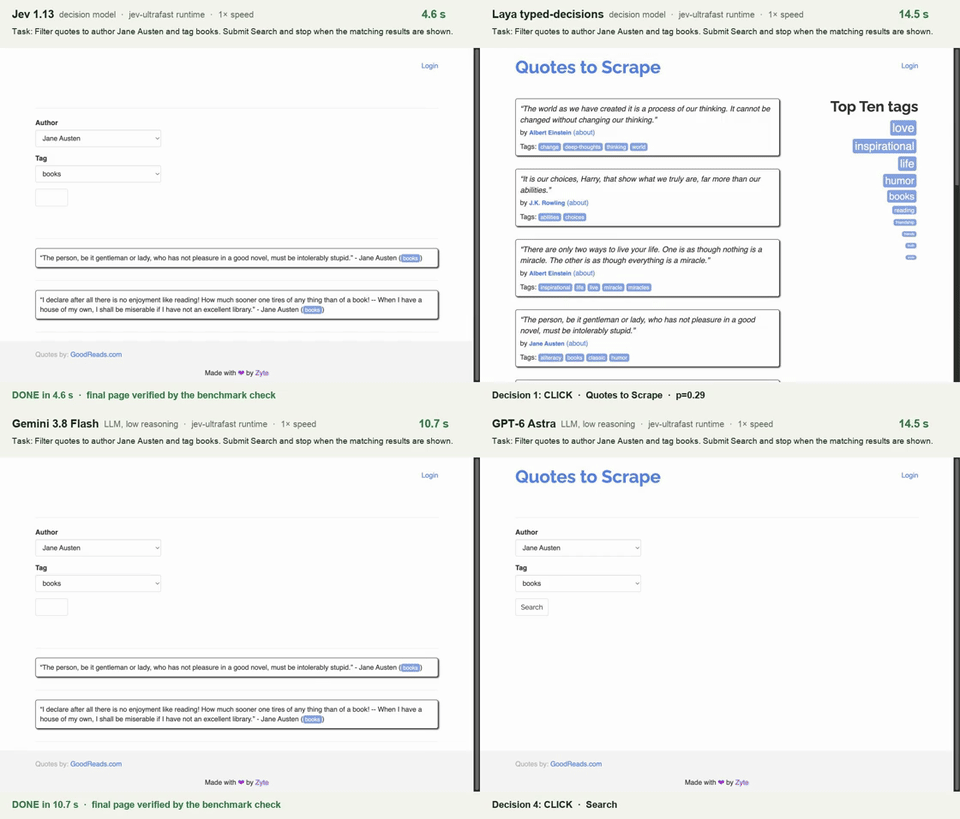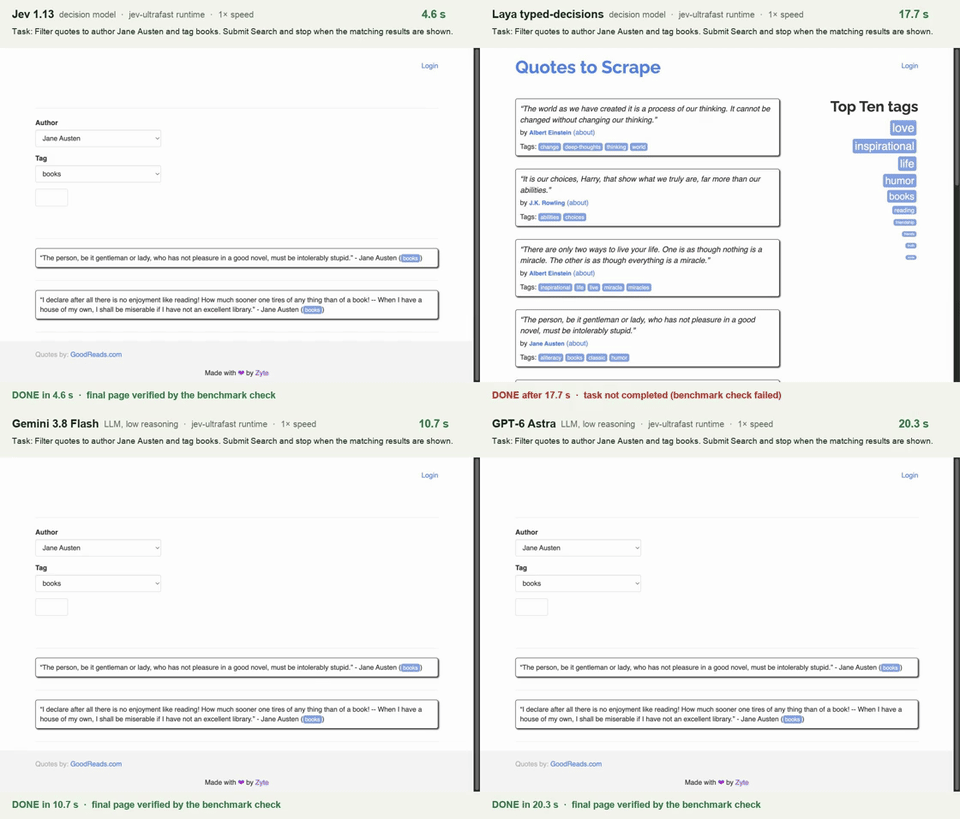
Filtre görevi iki açılır liste ve bir arama düğmesi gerektiriyor. Jev, Gemini ve Astra aynı dört adımı atıp 4.6, 10.7 ve 20,3 saniyede bitirdi. Laya site logosuna tıklayıp görevi bitmiş ilan etti. Kev-9B kıyaslamada bu görevde başarısız oldu ve demoda 11 dakika sonra hâlâ tıklıyordu, bu yüzden bu klipten çıkarıldı.
Altyazılar her modelin seçtiği işlemi ve hedefi, karar modelleri için ise o işlemin olasılığını gösterir. Klipler, puanlanan kıyaslamadan değil, 1× hızdaki ayrı bir demo çalışmasından gelir ve her son sayfa kıyaslamanın değerlendiricisi ile kontrol edilmiştir.
Modeller nasıl başarısız oldu
Jev ve Kev-9B birlikte 26 farklı görev tamamladı. Her ikisi de iki Wikipedia görevini ve Web Scraper açılır liste görevini tamamladı; aynı şeyi iki LLM da yaptı. Her görevin bir kategori listesinden ürün sayfasına ilerlediği Books to Scrape'te Jev altı görevden birini, Kev-9B üçünü tamamladı. Kev-27B, Eikos-27B ve AutoJev-27B altı görevin tamamını tamamladı.
- Jev 32 başarısızlığının 24'ünde görevi engellenmiş ilan etti; 16'sında herhangi bir işlem yapmadan önce.
- Kev-9B başarısız görevlerde medyan 9.5 işlem yaptı; tamamladığı görevlerde 3 işlem yaptı. On deneme işlem veya karar çağrısı sınırına ulaştı ve beş deneme daha, art arda üç işlem sayfayı değiştirmeden bırakınca durduruldu.
- Kev-9B'nin geliştiricisinden Kev-4B, 50 görevin 29'unda ilk kararında görevi engellenmiş ilan etti.
- Kev-27B, Eikos-27B ve GLiDE ortak yedi görevde başarısız oldu. Bunlardan dördünü engellenmiş ilan ettiler; iki ScrapeMe ürün araması ve iki Web Scraper görevi; üçü de onay kutusunu veya hesap makinesi formunu bitiremedi.
- GPT-6 Astra 3 görevde başarısız oldu. Bir ScrapeMe kategori görevini engellenmiş işaretledi, durdurulana kadar aynı hesap makinesi alanına yazmaya devam etti ve T02 form görevinde Astra formu doldurup gönderdikten sonra metin yardımcısı geçerli bir değer döndürmedi.
- Gemini 3.8 Flash aynı T02 sonu dahil 7 görevde başarısız oldu. Üç başarısızlık doğru sayfaya ulaştı ama bitirmedi; ikisi OpenRouter ücret bildirmediğinde maliyet korumamız tarafından durduruldu; biri eylem sınırına takıldı.
Neden bazı modeller 0/50 puan aldı
GLiNER2.5-Decide
Fastino'dan GLiNER2.5-Decide6 tüm 50 görevi çok erken bitmiş ilan etti; bunların 49'u ilk kararında. Başka bir görevle aynı başlangıç sayfasını paylaşan 37 görevde, işlem olasılıkları hedefler arasında en fazla 6 puan farklılık gösterdi.
Fastino GLiNER2.5-Decide'i bilet yönlendirme, niyet, aciliyet ve bir ajanın bitirip bitirmediği gibi kararlar için bir sınıflandırıcı olarak tanımlıyor ve modelin akıl yürütmediğini belirtiyor. Model, 512 token'a kadar girdiler için tasarlanmış ama daha uzun girdileri de kabul ediyor. İlk adım isteklerimizin medyanı 1.915 token'dı.
CLM-v0.1-8B
Contrastive-LM'den CLM-v0.1-8B7 2.288 işlem kararının 2.199'unda beklemeyi seçti, bu yüzden 36 deneme işlem sınırını doldurdu. Aynı başlangıç sayfalarında olasılıkları hedefler arasında en fazla 13 puan farklılık gösterdi.
Contrastive-LM CLM-v0.1-8B'nin, fine-tuning olmaksızın bilgisayar kullanımı, oyun ve araç çağırma görevlerinde Jev ile aynı düzeyde performans sergilediğini ve Jev'in istek biçimini değiştirmeden kabul ettiğini belirtiyor.8 O biçimde istekler gönderdik.
Hız ve başarı
Kev-27B, Eikos-27B ve AutoJev-27B görevlerin %68'i ila %80'ini deneme başına medyan yaklaşık 7 saniyede tamamladı; bu, Gemini'nin 12,7 saniyesinden ve Astra'nın 17,4 saniyesinden daha hızlıdır. SubQ Snap, pplx-decider-v1.1-27b ve Mercury Decide görevlerin %72'si ila %82'sini 5.3 ila 6,3 saniyede tamamladı.
decider-4b, decider-12b ve Jev deneme başına 2.5 ila 4,2 saniye sürdü ve 19 ila 24 görevi engellenmiş ilan etti.
GLiDE görevlerin %76'sını deneme başına medyan 46,8 saniyede tamamladı ve denemelerinden 3'ü 900 saniye sınırına takıldı. NeoHorse-Jev-4B 78,6 saniye ile en yavaşıydı ve 15 görev tamamladı. GLiDE v2 görevlerin %72'sini medyan 6,0 saniyede tamamladı.
GLiNER2.5-Decide (0,2 saniye) 50 görevden 49'unu ilk kararında bitmiş ilan etti ve Kev-4B 29 görevi ilk kararında engellenmiş ilan etti.
Kev-9B deneme başına medyan 38,3 saniye sürdü; bu Kev-27B'nin beş katıdır. Her Kev-9B kararı medyan 3,7 saniye sunucu süresi aldı; buna karşılık tam bir Jev API çağrısı yaklaşık 1 saniye sürdü. İstek yükü yaklaşık yarım saniye ekledi.
Kev-9B deneme başına ortalama 26 karar verdi; Jev için bu sayı yaklaşık 4'tür ve bunların %90'ı başarısız denemelerde geldi.
Maliyet
Tarayıcı otomasyonu maliyeti
† Tahmin: A100 girdi token'ı başına maliyet, modelin kendi tarayıcı isteklerinde GPU dolu iken ölçüldü, çarpı tarayıcı girdi token'ları artı metin yardımcısının ücretleri. Yöntem metodoloji altında.
‡ Daha yüksek rakam, token bildirmeden başarısız olan 17 isteği ekler; her biri 120.000 girdi token'ı olarak sayılır; Fastino bunları faturalamayabilir.
Astra, Gemini ve Jev her biri karar başına 3.150 ila 3.470 girdi token'ı kullandı. Astra'nın girdi fiyatı Jev'inkinin yaklaşık 240 katıdır.910
Düşük akıl yürütmede Astra 307 kararda 6.599 çıktı token'ı üretti; buna karşılık 968.376 girdi token'ı. Jev'in çıktı fiyatı $0'dır.
Jev'in girdi fiyatında Astra'nın 968.376 karar girdi token'ı $9,68 yerine yaklaşık $0,04 tutardı. Kev-27B Astra'dan yedi görev geride kalarak 50 görev boyunca tahmini $0,24 maliyete ulaştı; Astra'nın maliyeti $10,63 idi.
Bu tahminlere göre, tabloda bir görev tamamlayan her karar modeli, Celeris 1.1 Decision, Kev-4B, Kev-9B ve NeoHorse-Jev-4B hariç, tamamlanan görev başına Gemini'den daha düşük maliyete sahipti. Dokuz model tamamlanan görev başına Jev 1.13'ten daha düşük maliyete sahipti: Mercury Decide, Decider V1.2, pplx-decider-v1.1-27b, Span-02, Drex v1.5, SubQ Snap, H2O-Lightning-4B, Jev 1.14 ve Drex v2.0. Mercury Decide Jev'in maliyetinin üçte birinden azına mal oluyor.
- Kev-9B tamamlanan görev başına Gemini'nin yaklaşık 5 katı ve Jev'in 84 katı maliyete sahipti. Tahmini A100 maliyeti milyon girdi token'ı başına yaklaşık $0,80 idi; bu Jev'in API fiyatının 19 katıdır ve Jev'in 185 kararına karşılık 1.321 karar verdi.
- Kev-4B'nin tahmini GPU token maliyeti, OpenRouter fiyatının yaklaşık 12.1 katıydı.
Kev-9B çalışması için kiraladığımız A100 süresi, kurulum ve boşta kalma dahil 3.32 saat, yaklaşık $5,31 tuttu. Bir Jev ücreti ve iki Gemini ücreti kaydedilmedi ve tabloda eksik.
Sınıflandırma maliyeti
Hosted modeller API liste fiyatlarıyla fiyatlandırılır; OpenRouter üzerindeki modeller ise OpenRouter tarafından faturalanan ücretlerle fiyatlandırılır. Mercury Decide, OpenRouter'ın ücretsiz rotasında çalıştı ve ücretli rotasının liste fiyatıyla fiyatlandırıldı. Kendi sunucumuzda barındırılan modeller, kiralık bir A100 üzerinde GPU dolu iken ölçtüğümüz en yüksek verimde 1.000 karar başına fiyatlandırıldı.
Saatte $1,673 oranımızda, kiralık bir A100 yoğun veya boş olsun günde yaklaşık $40 tutar. Kaydettiğimiz oranda $40 yaklaşık bir milyon Jev kararı alır.
 Tercih edilen kaynak olarak ekle
Karar modellerini eğitme
Etiketleme modeli olan GLM-5.3-Flash'ın kıyaslama dışındaki sekiz web sitesindeki tarayıcı görevlerinde verdiği kararlar üzerinde Kev-9B ve Laya'yı fine-tune ettik. Ardından 50 görevi tekrar çalıştırdık. Her fine-tune edilmiş model, aynı gün ve donanımda çalıştırılan stok sürümüyle karşılaştırıldı.
Fine-tune edilmiş Kev ve her iki Laya sürümü Hugging Face üzerindedir.
p, aynı 50 görev üzerinde eşleştirilmiş bir testten (kesin McNemar) gelir ve p değeri 0.05'in altında olan anlamlı sayılır. Bu karşılaştırmada stok Kev 21 görev tamamladı; yukarıdaki sonuçlardan bir görev fazla. Kev'in 12 kazancından biri olan C02, stok çalışmasında model hatası değil tarayıcı zaman aşımıydı. Onsuz Kev 11 görev kazandı ve 1 kaybetti (p = 0.006).
- Fine-tune edilmiş Kev dokuz web sitesinin altısında görevler kazandı; Quotes to Scrape ve Scrape This Site'de her birinde üçer görev. Web Scraper, Wikipedia ve TestPages formlarında sonuçları değişmedi.
- Fine-tune edilmiş Kev 5 denemeyi engellenmiş bitirdi (stokta 12) ve eylem sınırına 6 kez takıldı (stokta 11). Bitmemiş bir görevi 7 kez bitmiş ilan etti; stokta bu 4 idi.
- Eğitim sitelerinden eğitim dışı tutulan 41 görevde Kev 13'e karşılık 21 görev tamamladı. Bu görevlerin 19'undan alınan 101 tek kararda, etiketleme modelinin işlemini %94 oranında seçti; önceki oran %62 idi.
- Laya'nın ilk fine-tune'u okuyabildiği 88 kararın %75'inde etiketleme modelinin işlemini seçti; stok Laya için bu oran %19'du. Hâlâ işlem gerektiren bir sayfada görevi bitmiş ilan etme sayısı 53 yerine 2 oldu.
- Kıyaslamada Laya'nın ilk fine-tune'u bitmemiş bir görevi 36 kez bitmiş ilan etti; bunlardan biri herhangi bir işlem yapmadan önce. Stok Laya 32 kez yaptı; bunların 17'si işlem yapmadan önce oldu.
Karar modeli kullanım örnekleri
- Bir ajanın bitiş sinyalini kontrol etme. Bir tarayıcı ajanı görevi bitmiş ilan etmeden önce gördüğü son sayfada, 59 karar modelinden 41'i bitmiş ile bitmemişi ayırt etmede 90 üzeri puan aldı; AutoJev-27B, Clef, d1-ultra, Decision-2.0-Vega-27B ve Kev-27B 99.5 puan aldı. Bir çalışmanın daha erken sayfalarındaki kontrolleri test etmedik.
- Sabit etiketlerle triaj, örneğin güvenlik danışmanlıklarını veya geri çağırmaları derecelendirme. decider-12b ciddiyet üzerinde şans düzeyinin 21 puan üzerinde ve geri çağırmalarda 29 puan üzerinde puan aldı. Kâğıt konularında, 28.595 etiketli makale üzerinde eğitilmiş bir anahtar kelime sınıflandırıcı 70.4 puan aldı ve hiçbir karar modeli anlamlı derecede daha yüksek puan almadı; aynı tür sınıflandırıcı ciddiyet ve geri çağırmalarda şans düzeyine yakın puan aldı.
- Tarayıcı otomasyonunda her eylemi seçme. SubQ Snap 50 görevden 41'ini tamamladı; iki LLM için bu sayı 43 ve 47 idi. Kev-9B'yi diğer web sitelerinden 606 karar üzerinde fine-tune etmek onu 21'den 32'ye çıkardı.
İki ana sınıflandırma görevinde, yerel karar modelleri kiralık bir GPU üzerinde 1.000 karar başına tahmini $0,007 ila $0,57 arasında maliyete sahipti ve NeoHorse-Jev-4B ile Shisa DE-2 hariç tümü karar başına bir saniyenin altında ortalamaya sahipti. Tarayıcı görevlerinde Jev'in girdi fiyatı GPT-6 Astra'nınkinin yaklaşık 1/240'ıydı.
Her yanıt ayrıca seçenek başına bir olasılıkla gelir; bir uygulama belirsiz durumları bir LLM'ye devretmek için bunu kullanabilir. Bu olasılıkların gerçek doğrulukla ne kadar eşleştiğini test etmedik.
59 modelden 36'sı tek kiralık bir GPU üzerinde çalıştı; diğer 23'ü barındırılan API'lerdir.
Metodoloji
Tarayıcı otomasyonu kıyaslaması
Tüm modeller aynı jev-ultrafast tarayıcı çalışma zamanını kullandı. Her adımda, mevcut sayfayı sayfa metnine ve görünür kontrollerin numaralı bir listesine dönüştürdü. Model, tıklama, yazma, seçme, bitirme veya engellenmiş gibi bir işlem ve bu listeden bir hedef seçti. Çalışma zamanı eylemi gerçekleştirdi ve sayfayı yeniden okudu.
Karar modelleri sağlanan seçenekleri sıralar ve metin döndürmez. Herhangi bir model yazmayı seçtiğinde, metin yardımcısı değeri form alanına yazdı. Her deneme temiz bir tarayıcı oturumunda başladı.
Her model bir API üzerinden erişildi; Kev-9B ve Laya tek bir Mac'te Chrome 153'te 30 Eylül'e kadar ve Chrome 154'te 2 Ekim'den itibaren tarayıcıyla çalıştı. Diğer kendi sunucumuzda barındırılan modeller kiralık GPU'da Linux'ta Chrome ile çalıştı.
Hiçbir istek bir modele uyacak şekilde kısaltılmadı. Solar Decide, Solar Decide Flash ve Ollama soru başına 2 ila 26 seçenek kabul eder. Bu sınırlar dışındaki bir istek denemeyi sonlandırdı; tıpkı Laya için aşırı büyük isteklerin yaptığı gibi. Ollama seçenek açıklamalarını yalnızca metin olarak kabul eder, bu nedenle yapılandırılmış seçenekler kompakt JSON metni olarak gönderildi. Tev1 2.050 token bağlamla gelir; sayfalar kesilmesin diye onu Nimble'ın kendi ayarı olan 8.194'e yükselttik.
Classify-1 diğer modellerin aldığı yapılandırılmış talimatları, seçenek açıklamalarını ve sayfa durumunu reddeder; bu nedenle her iki kıyaslamada bunları kompakt JSON metni olarak gönderdik.
Strands Decider 2B en fazla 4.096 token okur ve daha uzun sayfaları reddetti; bu 11 denemeyi sonlandırdı.
Cloudflare'ın hizmeti Clef ve Clef-Flash için sayfa metninin yalnızca ilk 2.048 token'ını okur. Daha uzun sayfalar göndermedik; bu, her model için bir denemeyi sonlandırdı.
21 model için, aralarında Clef, decider ve Eikos bulunur, tek seçenekli bir soru — örneğin bir sayfanın tek metin alanı — o seçenekle iki kez gönderildi ve yanıt ona geri eşlendi. Hizmetleri tek seçenekli soruları reddeder.
Kev-9B'yi üreticinin referans koduyla tam 32 bit hassasiyette çalıştırdık. Temel modelini hızlandıran isteğe bağlı çekirdek paketlerini kurmadık; bu nedenle model daha yavaş referans çekirdeklere geri döndü. Daha hızlı bir GPU kurulumunu test etmedik.
CLM'nin kendi kodu her isteği metne dönüştürür. GLiNER aynı metni aldı; her sorunun hedefi ve kuralları onun prompt'u olarak verildi. Kev-4B ayrıca OpenRouter üzerinde SiliconFlow tarafından 8-bit hassasiyette sunulur.11 29 Eylül'de Mac'ten bu yolla çalıştırıldığında Kev-4B 8 görev tamamladı.
GPT-6 Luna Decisions ayrıca OpenRouter üzerinde sunulur; model bir soruyu reddettiğinde OpenRouter tüm istek için hata döndürür; OpenAI'nin kendi API'si diğer soruları yanıtlar.12 OpenRouter üzerinden Luna 1 görev tamamladı; bu nedenle yukarıdaki sonuçlar OpenAI'nin API'sini kullanır.
Celeris 1.1 Decision için 50 tarayıcı görevinden 4'ünde metin yardımcısı olarak Mercury 2.5 yerine Mercury 3 kullanıldı. Celeris dört görevi de iki yardımcıyla da başarısız oldu.
Tarayıcı modelleri
Düşük akıl yürütme, sağlayıcı tanımlı bir çaba ayarıdır. Astra'nın 307 kararı 791 bildirilen akıl yürütme token'ı içeriyordu. Kev-9B13 ve Kev-4B14 aynı geliştiriciden gelir ve Nimble 9B Bespoke Labs'tandır.15 GLiDE, GLiNER2.5-Decide'in geliştiricisi Fastino'dan gelir16 ve Clef ile Clef-Flash Cloudflare'dandır.17
MATILDA JEV v1.5'in model kartı, soyundaki daha önceki eğitimde kıyaslama ile ilgili materyal kullanıldığını söylüyor.18
Veri kümesi
50 görev dokuz web sitesini kapsar: kazıma ve test için oluşturulmuş sekiz pratik site artı Wikipedia. Görevler katalog gezinmesi, arama, sıralama, sayfalama, ürün seçenekleri, formlar ve makale aramalarını içerir. Her görev sabit bir olmadan sabit bir URL'den başlar ve bitiş durumunu tek bir cümleyle belirtir; örneğin “Bilim Kurgu'ya geç, Dune (Dune #1)'i bul, ürün detaylarını aç ve dur.”
Modeller çalışmadan önce, komut dosyalı bir çalışma yalnızca çalışma zamanının desteklenen eylemlerini kullanarak tüm 50 görevi tamamladı. Her görev parolalar, CAPTCHA'lar veya Enter tuşu olmadan çözülebilir.
Örnek görevler
50 görevden on tanesi talimatlar, başlangıç URL'si, geçiş koşulları ve her modelin sonucuyla birlikte Hugging Face üzerinde yayınlandı. Diğer 40 görev sonraki çalışmalar için saklandı.
Değerlendirme
Bir görev, model onu sınırlar içinde bitmiş ilan ettiğinde ve son sayfanın ayrı bir kontrolü her koşulu doğruladığında geçti: kabul edilen bir son URL, görevin olguları sayfada görünür, 100 karakterden fazla sayfa metni ve tamamen yüklenmiş bir sayfa.
Her deneme 900 saniye, 60 tarayıcı eylemi ve 120 karar çağrısıyla sınırlıydı. API hataları başarısızlık sayıldı. Süre, ilk yüklenen sayfadan son kontrole kadar ölçüldü.
Kontrol, son sayfayı yüklenmesi bittikten sonra okur.
Maliyet hesaplama
API maliyeti, model başına tüm 50 deneme için karar çağrılarını ve metin yardımcısını kapsar. OpenRouter GPT-6 Astra, Gemini ve Mercury 2.5 için ücretleri bildirdi. Jev'in maliyeti 22 Eylül 2026'daki liste fiyatından bildirilen token'larıdır: milyon girdi token'ı başına $0,042 ve çıktı için ücret yok.5 GLiDE, Clef ve Clef-Flash de liste fiyatlarıyla fiyatlandırıldı.
GLiDE v2, GPT-6 Luna Decisions, SubQ Snap ve Celeris 1.1 Decision liste fiyatlarıyla, OpenRouter üzerindeki diğer karar modelleri ise OpenRouter tarafından bildirilen ücretlerle fiyatlandırıldı. Ücretsiz rotada çalıştırılan Mercury Decide, ücretli rotasının liste fiyatıyla fiyatlandırıldı.
Kendi sunucumuzda barındırılan tarayıcı çalışmaları A100, A6000, RTX 4090 veya bir Mac kullandı. Hepsini saatte $1,673'ten kiralık tek bir A100 üzerinde fiyatlandırıyoruz. Her modelin kendi tarayıcı isteklerini GPU dolu iken modele tekrar gönderdik. Tablodaki bir modelin maliyeti, en yüksek verimde girdi token'ı başına maliyeti çarpı tarayıcı girdi token'ları artı metin yardımcısının ücretleridir.
Her iki iş yükü de neredeyse tamamen girdiden oluşur; çünkü bu modeller seçenek puanları veya birkaç token döndürür.
Fine-tuning
327 görev — 286'sı eğitim ve 41'i ayrılmış — Demo Web Shop, Automation Exercise ve Project Gutenberg dahil kıyaslamada olmayan sekiz web sitesinden gelir. Her görev bir tarayıcıda kontrol edildi: başlangıç sayfası değerlendiriciyi geçemez ve görevin farklı bir URL'de bittiği yerde o sayfa geçer.
MIT lisanslı açık ağırlıklı bir model olan GLM-5.3-Flash,19 düşük akıl yürütmede kıyaslama çalışma zamanında görevlerin 300'ünü denedi. Sağlayıcı hataları onu diğer 27 görevden alıkoydu. Bunun için GPT-6 Astra veya Gemini kullanmadık; çünkü OpenAI'nin ve Google'ın koşulları, çıktılarını rekabet eden modeller oluşturmak için kullanmayı yasaklar.2021
184 başarılı eğitim çalışması 606 karar kaydı verdi. Bir çalışma, değerlendirici onu geçtiğinde veya site araması yoluyla doğru ürün sayfasına ulaşıp yalnızca tam URL kontrolünde başarısız olduğunda başarılı sayıldı; tüm görevlerde 11 çalışmanın yaptığı gibi.
Tek karar testi, 19 ayrılmış görevden kaydedilen 103 kararı yeniden oynatır ve bir modelin etiketleme modelinin işlemini ne sıklıkla seçtiğini sayar. Kev bunlardan 101'ini okuyabildi. Laya, her adımın ihtiyaç duyduğu sorularla gönderildiğinde 88'ini okuyabildi; kıyaslamanın gönderdiği tam istekte 34'ünü. Bu 34 kararda stok Laya %29 oranında anlaştı, ilk fine-tune %71 ve ikinci fine-tune %41 oranında anlaştı.
Her iki model de kıyasladığımız stok ağırlıklardan başladı ve üreticilerinin eğitim tariflerini kıyaslamanın girdi sınırlarıyla kullandı. Kev ayrıca üreticinin tekrar kayıtları olmadan bir yerine iki epoch eğitildi. Her eğitim çalışması bir H100 GPU'da 20 dakikanın altında sürdü.
Laya'nın ilk fine-tune'u aynı 606 kaydı kullandı; Laya için çok uzun olanları atladı. İkincisi, kıyaslamanın gönderdiği tam isteğe uyan 292 kaydı tuttu ve Laya'nın kendi çalışmalarından 102 kayıt ekledi; burada GLM-5.3-Flash, Laya bir görevi bitmiş veya engellenmiş ilan ettikten sonra (73) veya 10 eylem bütçesini tükettikten sonra (29) devraldı. Kev'in ikinci turu yoktu.
Kev çifti ve Laya'nın ilk çifti Fransa'da kiralık bir H100 üzerinde Chrome ile Linux'ta çalıştı. Laya'nın ikinci çifti ana kıyaslamadaki Mac'te çalıştı. Her çift ana kıyaslamanın 50 görevini, çalışma zamanını, sınırlarını ve değerlendiricisini, görev başına bir deneme ile kullandı.
Sınıflandırma kıyaslaması
Her öğe, sabit bir seçenek kümesine sahip bir karardır. Öğeler, Temmuz-Eylül 2026 arasında yayınlanan kayıtlardan ve kendi tarayıcı çalışmalarımızdaki son sayfaların yayınlanmamış anlık görüntülerinden gelir. Modellerin çoğu bu kayıtlar kamuya açıldıktan sonra yayınlandı; bu nedenle bir model, bir öğeyi ve onun kayıtlı yanıtını eğitimde görmüş olabilir. Her modelin ne üzerinde eğitildiğini kontrol edemeyiz.
İlk üç görev, bir modelin bir kurumun kaydettiği bir kararı yalnızca metinden yeniden üretmesini ister. GitHub ve FDA metnin içermediği kanıtlar kullanmış olabilir. GitHub'ın ciddiyet seviyeleri, standart güvenlik açığı puanlama sistemi CVSS'teki None üzerindeki dört derecelendirmeyle eşleşir.22
Her model bir görev için aynı talimatları ve seçenek tanımlarını aldı: FDA'nın sınıf tanımları, GitHub'ın ciddiyet bantları, arXiv'in kategori açıklamaları. Seçenek sırası her öğe için karıştırıldı ve her model için aynıydı. Güvenlik açığı ciddiyeti ve geri çağırma tehlike düzeyi ana görevlerdir; herhangi bir çalıştırmadan önce sabitlendi. Makale konuları ve görev bitiş kontrolü tamamlayıcıdır.
Puan dengeli doğruluktur: her olası yanıt içindeki başarı oranı, yanıtlar üzerinden ortalanır.
Her zaman en yaygın yanıtı veren bir model ciddiyette 25, geri çağırmada 33 ve makale konularında 5 puan alır. Grafik puanı, iki ana görevin ortalamasıdır; bu yanıt yaklaşık 29 puan alır. Aralıklar, ilgili öğeleri birlikte yeniden örnekleyen %95 bootstrap aralıklarıdır: aynı paket için danışmanlıklar, aynı geri çağırma olayından geri çağırmalar, aynı tarayıcı görevinden sayfalar.
Herhangi bir modelin decider-12b'den anlamlı derecede daha yüksek puan alıp almadığını test etmek için, bu tür 1.000 yeniden örnekleme çektik; her model için aynıydı ve her modelin her ana görevdeki farkının %95 aralığını aldık. Bir model yalnızca bu aralık sıfırın üzerindeyse daha yüksek sayılır; çoklu karşılaştırmalar için düzeltme yok. Her model makale konularında anahtar kelime sınıflandırıcıyla aynı şekilde karşılaştırıldı.
İki LLM, Qwen 3.8 Max ve Claude Opus 5.5, kayıtlı yanıtı görmeden 350 test öğesinden bir örneği etiketledi: görev başına 100 ve 50 tarayıcı sayfası.
100 danışmanlığın 62'sinde, 100 geri çağırmanın 69'unda, 100 makalenin 84'ünde ve 50 tarayıcı sayfasının 49'unda birbirleriyle anlaştılar. Danışmanlıklar ve geri çağırmalarda kayıtla anlaşmadıkları yerlerde çoğunlukla bir düzey kaymışlardı, orta düzeylere doğru. 100 danışmanlığın 55 ve 56'sında GitHub'ın ciddiyetiyle eşleştiler.
Her iki yargıç kayıttan farklı aynı yanıtı 54 öğede verdi. 53 GitHub, FDA ve arXiv kaydını canlı kaynağa karşı kontrol ettik ve hepsi eşleşti; bu nedenle hiçbir etiket değişmedi.
Bir tarayıcı sayfası bitmiş olarak etiketlenmişti çünkü değerlendirici tam sayfada en az 40 yorum saymıştı; oysa modellerin gördüğü anlık görüntü yaklaşık dokuz gösteriyor. Onu ve yanıtı 10 veya daha fazla öğe saymaya dayanan diğer 48 görev bitiş öğesini çıkardık; 155 kalıyor.
Yerel maliyetler o GPU üzerinde test ettiğimiz ayar için geçerlidir; başka bir sunucu ayarı veya GPU bunları değiştirir. Maliyet için Nimble 9B ve Tev1 modellerinin ilk Ollama sürümlerini ölçtüğümüzde, Tev1 0.8B puanlanan çalışmasından soruların %1.2'sinde farklıydı; Nimble 9B ve Tev1 4B ise %1'in altında farklıydı.
Seçilen ayarda diğer kendi sunucumuzda barındırılan modeller puanlanan yanıtlarının en az %98'iyle eşleşti; Shisa DE-1 ve Shisa DE-2 hariç. Onlar tek istekte bile çalıştırmadan çalıştırmaya değişir, bu nedenle eşikleri kendi tek-tek uyumları eksi 2 yüzde puanıdır; %97.6 ve %96.4 ile eşleştiler. Kendi tarayıcı isteklerinde CLM-v0.1-8B, Shisa DE-2 ve GEV-26B-Decide aynı kural altında %90.7, %77.9 ve %83.1 ile eşleşti.
Her modeli yayınlandığı gibi çalıştırmanın istisnaları:
- Laya Typed-Decisions yayınlanan 1.024 token bağlamı yerine 8.192 token bağlamla çalıştı; Tev1 ise tarayıcı çalışmalarımızdaki gibi 2.050 yerine 8.194 ile.
- Laya'nın kendi kodu uzun bir seçeneği veya girdiyi keseceği yerde, bağlayıcımız isteği bunun yerine reddetti ve bir ret yanlış yanıt sayılır. Her makale konusu isteği, konu açıklamaları Laya'nın seçenek başına okuduğu 48 token'dan uzun olduğu için reddedildi.
- CLM'nin kodlayıcı bağlamı 2.048'den 16.384 token'a yükseltildi; GLiNER, belgelenen 512 token girdisinin ötesinde çalıştı. Shisa DE-1 GPU belleğine sığdırmak için 32.768 token bağlam kullandı.
- d3, d3-flash, d3-mini, Decision-2.0-Vega-27B, Decision-1.0-Lux-9B ve MATILDA JEV v1.5 üreticilerinin doğrulamadığı bir NVIDIA A100 üzerinde çalıştı; üç d3 ve Decision-2.0-Vega-27B, AMD özel hızlı yolları olmadan çalıştı. JEV-27B-VL ve GEV-26B-Decide vLLM 0.29.0 üzerinde çalıştı; model kartları yayınlanmamış bir vLLM derlemesini adlandırıyor.
- NeoHorse-Jev-4B, kendi sunucusu varsayılan olarak 2.048 token üzeri sayfa metnini reddettiği için üreticisinin vLLM adaptörü üzerinden çalıştı.
- APUS Reflex 35B-A3B soru başına 2 ila 16 seçenek kabul eder; bu nedenle 500 makale konusu sorusunun tamamını reddetti (20 seçenek) ve bunlar yanlış yanıt sayılır; tarayıcı görevlerini çalıştırmadı.
- Together AI 30 Eylül 2026'ya kadar Tev1 ağırlıkları için bir lisans yayınlamamıştı.
- Cloudflare'ın hizmeti, Clef ve Clef-Flash için öğe metninin yalnızca ilk 2.048 token'ını okur; ancak modeller 65.536 kabul eder. 9'u ciddiyet ve 3'ü geri çağırma olmak üzere 12 uzun öğe yanlış yanıt sayılır.
Sınırlamalar
Her model her tarayıcı görevini bir kez denedi; bu nedenle iki model arasındaki birkaç görevlik fark hangisinin daha iyi olduğunu göstermez.
50 görev dokuz web sitesinden gelir ve aynı sitedeki görevler sayfa düzenlerini paylaşır. Modeller canlı web sitelerinde çalıştı; bu siteler çalışmalar arasında değişebilir.
Adım biçimi, bir işlem listesi artı hedef listeleri, ilk olarak Jev için geliştirildi. Her model aynı biçimi aldı. Başka bir biçimin sonuçları değiştirip değiştirmeyeceğini test etmedik. Laya, uzun sayfalar kesilmesin diye yayınlanan ayarlarının üzerinde girdi sınırlarıyla çalıştı.
Sınıflandırma kıyaslamasında her model her öğeyi bir kez yanıtladı. GitHub ve FDA yanıtları bu kurumların kayıtlı kararlarıdır; bunlar bildirim veya geri çağırma metninin içermediği kanıtlara dayanabilir.
Bu benchmarkı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{AIM-Decision: Jev vs Clef vs LLM'ler}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/decision-models}},
  note   = {AIMultiple. Erişim tarihi: 21 Ekim 2026}
}389 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 10 CSV dosyası ve bir README içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Referans Linkleri






Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.