


Kubernetes-Kostenoptimierung: 8 Schritte & 23 Tools

Kubernetes-Cluster können völlig gesund aussehen, während die Rechnung steigt. Autoscaling ist konfiguriert, Dashboards sind grün, und die Ausgaben steigen trotzdem. In einer Umfrage nannten 42 % von 455 Plattformingenieuren Kosten als ihre größte Kubernetes-Herausforderung, während 88 % einen jährlichen Anstieg der Gesamtbetriebskosten verzeichneten.1
Wir haben 68 Fallstudien zur Kubernetes-Kostenoptimierung gesammelt und jeden erwähnten Anwendungsfall dem jeweiligen Anbieter zugeordnet, der ihn veröffentlicht hat:
Dunklere Zellen bedeuten mehr Erwähnungen. Leere Zellen bedeuten, dass dieses Tool keinen veröffentlichten Fall für diesen Anwendungsfall hat.
Scrollen Sie weiter zu einem 8-Schritte-Leitfaden mit Praxisbeispielen zur Senkung der Clusterausgaben und dem Vergleich des Kubernetes-Kostenoptimierungstools.
1. Messen, bevor Sie etwas ändern
Jede Zahl im Rest dieses Leitfadens ist ein Delta, und ein Delta braucht einen Ausgangspunkt. Ohne eine Baseline, die vor der ersten Änderung erfasst wurde, lässt sich nicht feststellen, ob Schritt 1 funktioniert hat, und auch nicht, ob die Einsparungen aus Schritt 3 auf die Konsolidierung zurückzuführen sind und nicht auf das vorangegangene Rightsizing. Das ist hier wichtiger als bei den meisten Engineering-Arbeiten, da alle sechs Maßnahmen dieselbe Rechnung senken und ihre Einsparungen sich nicht addieren. Kapazität, die in Schritt 1 freigesetzt wird, schlägt sich erst auf der Rechnung nieder, wenn Schritt 3 die Nodes entfernt.
Messen Sie vier Dinge:
- Angeforderte im Vergleich zu tatsächlich genutzter CPU und Arbeitsspeicher, pro Workload. Diese Lücke ist Ihr Schritt-1-Backlog, sortiert nach Größe.
- Kosten pro Namespace und pro Workload. Dadurch werden die Quotas aus Schritt 2 zu einer Verhandlung statt einer Auflage.
- Bin-Packing-Effizienz, zuweisbar gegenüber angefordert pro Node. Das Ziel von Schritt 3.
- Leerlaufkosten nach Tageszeit und Wochentag in der Nicht-Produktion. Das dimensioniert Schritt 5, bevor Sie ihn aufbauen.
Messen Sie über mindestens einen vollständigen Geschäftszyklus hinweg. Sieben Tage sind das Minimum, dreißig sind besser. Das Zeitfenster ist keine prozedurale Vorsicht. Schritt 1 legt Speicheranforderungen auf das beobachtete Maximum fest, und ein beobachtetes Maximum ist nur so gut wie das Fenster, das es beobachtet hat. Ein Maximum, das über 48 Stunden erfasst wurde, verpasst einen wöchentlichen Batch-Job und erzeugt am folgenden Sonntag einen OOMKill.
Tooling
- Kostenallokation: OpenCost, das CNCF-Projekt hinter dem Zuteilungsmodell, ist die kostenlose Basis. Die kostenlose Stufe von Kubecost verpackt dieselbe Engine in einer UI für bis zu 250 Kerne.
- Auslastung: Prometheus mit kube-state-metrics ist die Grundlage. Robusta KRR liest sie direkt aus, ohne etwas im Cluster zu installieren.
- Übergreifende Ausgaben: Wenn Kubernetes nur ein Teil einer Rechnung ist, die auch die Finanzabteilung erklären muss, setzen CloudZero, Vantage und Finout oberhalb dieser Ebene an, statt sie zu ersetzen.
Beide Kostentools ordnen Kosten anhand von Labels zu, daher kommt das Labeling zuerst. Nicht gelabelte Ausgaben sind der häufigste Grund dafür, dass sich eine Baseline drei Wochen später als nutzlos erweist.
Jede Maßnahme unten nennt die Empfehlung, die Methode, die Konfiguration und ein Unternehmen, das diesen Schritt umgesetzt hat. Jede Fallstudie und jede Statistik enthält einen Quellenlink.
2. Namespace-Quotas als Leitplanken festlegen
Einsparungen schwinden, wenn Teams neue Workloads ohne spezifizierte Requests bereitstellen. Eine LimitRange liefert Standard-Requests für Container, die sie auslassen, und eine ResourceQuota begrenzt, was ein Namespace insgesamt verbrauchen darf.
Stellen Sie die LimitRange vor der ResourceQuota bereit. Sobald eine Quota eine Ressource einschränkt, wird jeder Pod ohne Request für diese Ressource bei der Aufnahme abgelehnt; die umgekehrte Reihenfolge zerstört daher Deployments.2
Jeder Load Balancer wird separat vom Cloud-Anbieter abgerechnet, und verwaiste Volumes werden auch dann noch abgerechnet, wenn ihre Pods bereits weg sind.
2. CPU- und Speicher-Requests richtig dimensionieren
Requests bestimmen die Node-Anzahl, und die Node-Anzahl bestimmt die Rechnung. Die meisten Cluster laufen weit unter der Kapazität, für die sie bezahlen, weil Requests einmal geschätzt und nie wieder überprüft wurden. Eine Analyse von 23.000 Produktionsclustern in AWS, Azure und Google Cloud ergab eine durchschnittliche CPU-Auslastung von 8 %, Speicher bei 20 % und GPU bei 5 %. 3
Setzen Sie CPU-Requests nahe dem 95th Perzentil der beobachteten Nutzung. Setzen Sie Speicher-Requests auf das beobachtete Maximum statt auf ein Perzentil und setzen Sie das Speicherlimit gleich dem Request. Ein Perzentil lässt den Container während des restlichen Traffics zu knapp ausgestattet sein, und weil das Limit dem Request entspricht, kommt diese Unterdeckung als OOMKill statt als Verlangsamung an.
Lassen Sie das CPU-Limit weg. CPU-Throttling verschlechtert die Latenz, ohne den Pod zu beenden, und der Request reserviert, was der Workload benötigt.
Der Vertical Pod Autoscaler im reinen Empfehlungsmodus erzeugt diese Werte ohne Produktionsrisiko.
Lesen Sie die Empfehlungen mit kubectl describe vpa payments-api und vergleichen Sie den Zielwert mit dem aktuellen Request.
Praxisbeispiel: Tryg Insurance
Tryg Insurance ist der größte Schadenversicherer im nordischen Raum und betreibt Kubernetes auf Oracle Cloud Infrastructure. Das Engineering-Team kombinierte den Horizontal Pod Autoscaler und den Vertical Pod Autoscaler, um Workloads dynamisch richtig zu dimensionieren und gleichzeitig das Serviceniveau zu halten, und senkte die Kubernetes-Cloudkosten mit ausschließlich Open-Source-Autoscalern um 50 %, ohne kommerzielle Optimierungsplattform.4
4. Nodes mit Karpenter konsolidieren und ungenutzte Workloads auf null skalieren
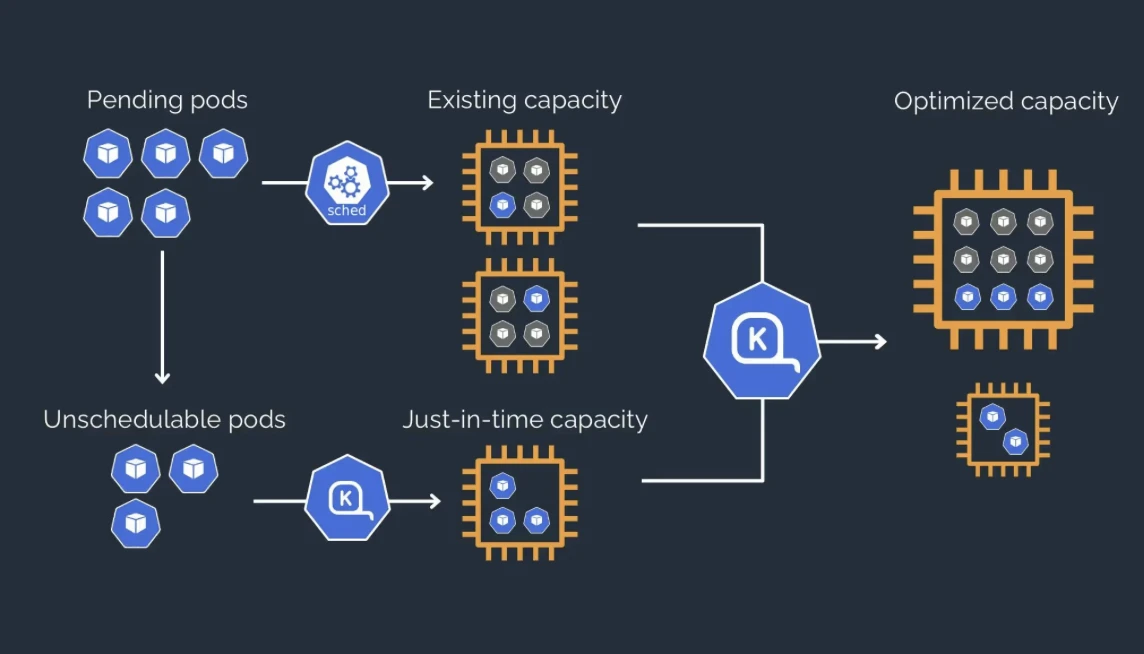
Rightsizing setzt Kapazität frei, aber diese Kapazität liegt auf Nodes, die weiterlaufen, bis etwas sie entfernt. Karpenter stellt Instanzen rechtzeitig bereit und packt Workloads auf weniger Nodes um. KEDA skaliert warteschlangengesteuerte Workloads auf null Replicas herunter, was ein Standard Horizontal Pod Autoscaler nicht kann.
Setzen Sie die Konsolidierungsrichtlinie auf WhenEmptyOrUnderutilized. Die Alternative WhenEmpty beschränkt Störungen auf Nodes, die überhaupt keine Workload-Pods halten, und solche treten ohne Eingriff selten auf. 5
Eine enge Instanzliste macht dies zunichte, weil Karpenter keine günstigen Ausreißer finden kann und Ihre Spot-Resilienz sinkt. Sie sollten es über ganze Instanzfamilien hinweg wählen lassen.
Praxisbeispiel: Adidas
Adidas betreibt mehrere Kubernetes-Cluster auf AWS EKS. Das Plattform-Engineering-Team führte Karpenter für die Node-Bereitstellung ein, ergänzte KEDA für ereignisgesteuerte Skalierung, erstellte Vertical Pod Autoscaler-Objekte automatisch-erstellt über Kyverno-Policies und nutzte kube-downscaler für ungenutzte Umgebungen. Sie senkten die Kosten für den Betrieb ihrer Kubernetes-Cluster auf AWS um bis zu 50 %, mit einem vollständig Open-Source-Stack.6
5. Vor der Verlagerung von Workloads zu Spot richtig vorbereiten
Spot-Instanzen bieten den größten verfügbaren Rabatt und die engste Anwendbarkeit. Nichts sollte zu Spot wechseln, bis PodDisruptionBudgets, Instanzdiversifizierung, Topologieverteilung und Termination Handling eingerichtet sind.
Ein PodDisruptionBudget, das keinen Spielraum lässt, blockiert alle freiwilligen Störungen, einschließlich der Karpenter-Konsolidierung; daher benötigen die Werte Puffer. 7
Praxisbeispiel: Delivery Hero
Delivery Hero betreibt 390 Anwendungen in 43 Ländern, wobei etwa 90 % der Workloads auf AWS EKS laufen. Das Team migrierte über ungefähr sechs Monate zu Spot-Instanzen und baute dabei Termination Handling und einen Descheduler in den Prozess ein, statt die Kapazitätstypen direkt umzustellen.
- Die Infrastrukturkosten sanken um rund 70 %
- Die Spot-Rabatte erreichten bis zu 90 % gegenüber On-Demand-Preisen
- Die Plattform absorbiert Traffic-Spitzen vom 4- bis 5-Fachen des normalen Volumens.8
6. Nicht-Produktion nach Zeitplan herunterfahren
Entwicklungs- und Staging-Umgebungen tragen nachts und an Wochenenden wenig oder gar keine Last. Ein geplantes Herunterfahren ist technisch einfach und politisch unumstritten, was es zur schnellsten umsetzbaren Einsparung und zu einer nützlichen ersten Maßnahme macht, wenn härtere Änderungen später Unterstützung benötigen.
Wenden Sie den Zeitplan standardmäßig auf alle Nicht-Produktions-Namespaces an und verlangen Sie von Teams eine ausdrückliche Abmeldung. Eine Richtlinie, die eine Aktion zum Beitreten erfordert, erreicht weniger Teams als eine, die eine Aktion zum Verlassen erfordert.
Die Einsparung kommt auf der Rechnung an, wenn die Node-Konsolidierung läuft, da herunterskalierte Deployments leere Nodes hinterlassen.
Praxisbeispiel: Bud Financial
Bud Financial reichert Finanztransaktionsdaten für den Finanzdienstleistungssektor an und betreibt rund 25 Cluster auf Google Kubernetes Engine. Das Team nutzte geplantes Pausieren und Fortsetzen, um Cluster-Nodes nachts und an Wochenenden zu verkleinern, zusammen mit täglichem Rebalancing.
- Die Kosten sanken allein durch die Zeitplanänderung um 47 %
- Der Zeitplan entfernte 80 Stunden Clusterbetrieb pro Woche
- Die Ressourcenauslastung stieg auf über 90 %.9
7. Kompatible Workloads zu ARM migrieren
ARM-basierte Instanzen ändern den Stückpreis, statt wie die obigen Maßnahmen um dieselbe ungenutzte Kapazität zu konkurrieren; daher addieren sich diese Einsparungen wirklich zu den übrigen. Die Blockierer werden Abhängigkeiten ohne ARM64-Builds sein.
Anwender sollten dies pro Workload statt über die gesamte Umgebung planen und Multi-Architektur-Images erstellen, bevor sie etwas einplanen.
Praxisbeispiel: Pinterest
Pinterest migrierte seinen Web-API-Workload zu AWS-Graviton-Instanzen auf ARM64, motiviert durch Kosten- und CO₂-Reduktion.
- Die Kosten sanken um 47 %
- Der Compute-Verbrauch sank um 38 %
- Die CO₂-Emissionen sanken um 62 %.10
8. Wenn das Tuning an Grenzen stößt, ändern Sie die Architektur
Die sechs obigen Maßnahmen optimieren Workloads innerhalb bestehender Cluster. Sobald sie ausgeschöpft sind, erfordern weitere Gewinne eher architektonische Änderungen als weiteres Tuning.
Zwei veröffentlichte Ergebnisse markieren die praktische Grenze. InCred Finance senkte die Ausgaben für Cluster, die sein Team als optimiert betrachtete, um 30 %11, und Yotpo erreichte 30–40 %, während 80 % der Workloads auf Spot-Instanzen liefen12. Jenseits dieses Bereichs liegt die verbleibende Verschwendung nicht mehr in den Clustern, sondern in der Anzahl der Cluster. Jeder einzelne verursacht Control Plane Kosten und bildet eine Scheduling-Insel, die Bin-Packing nicht überqueren kann.
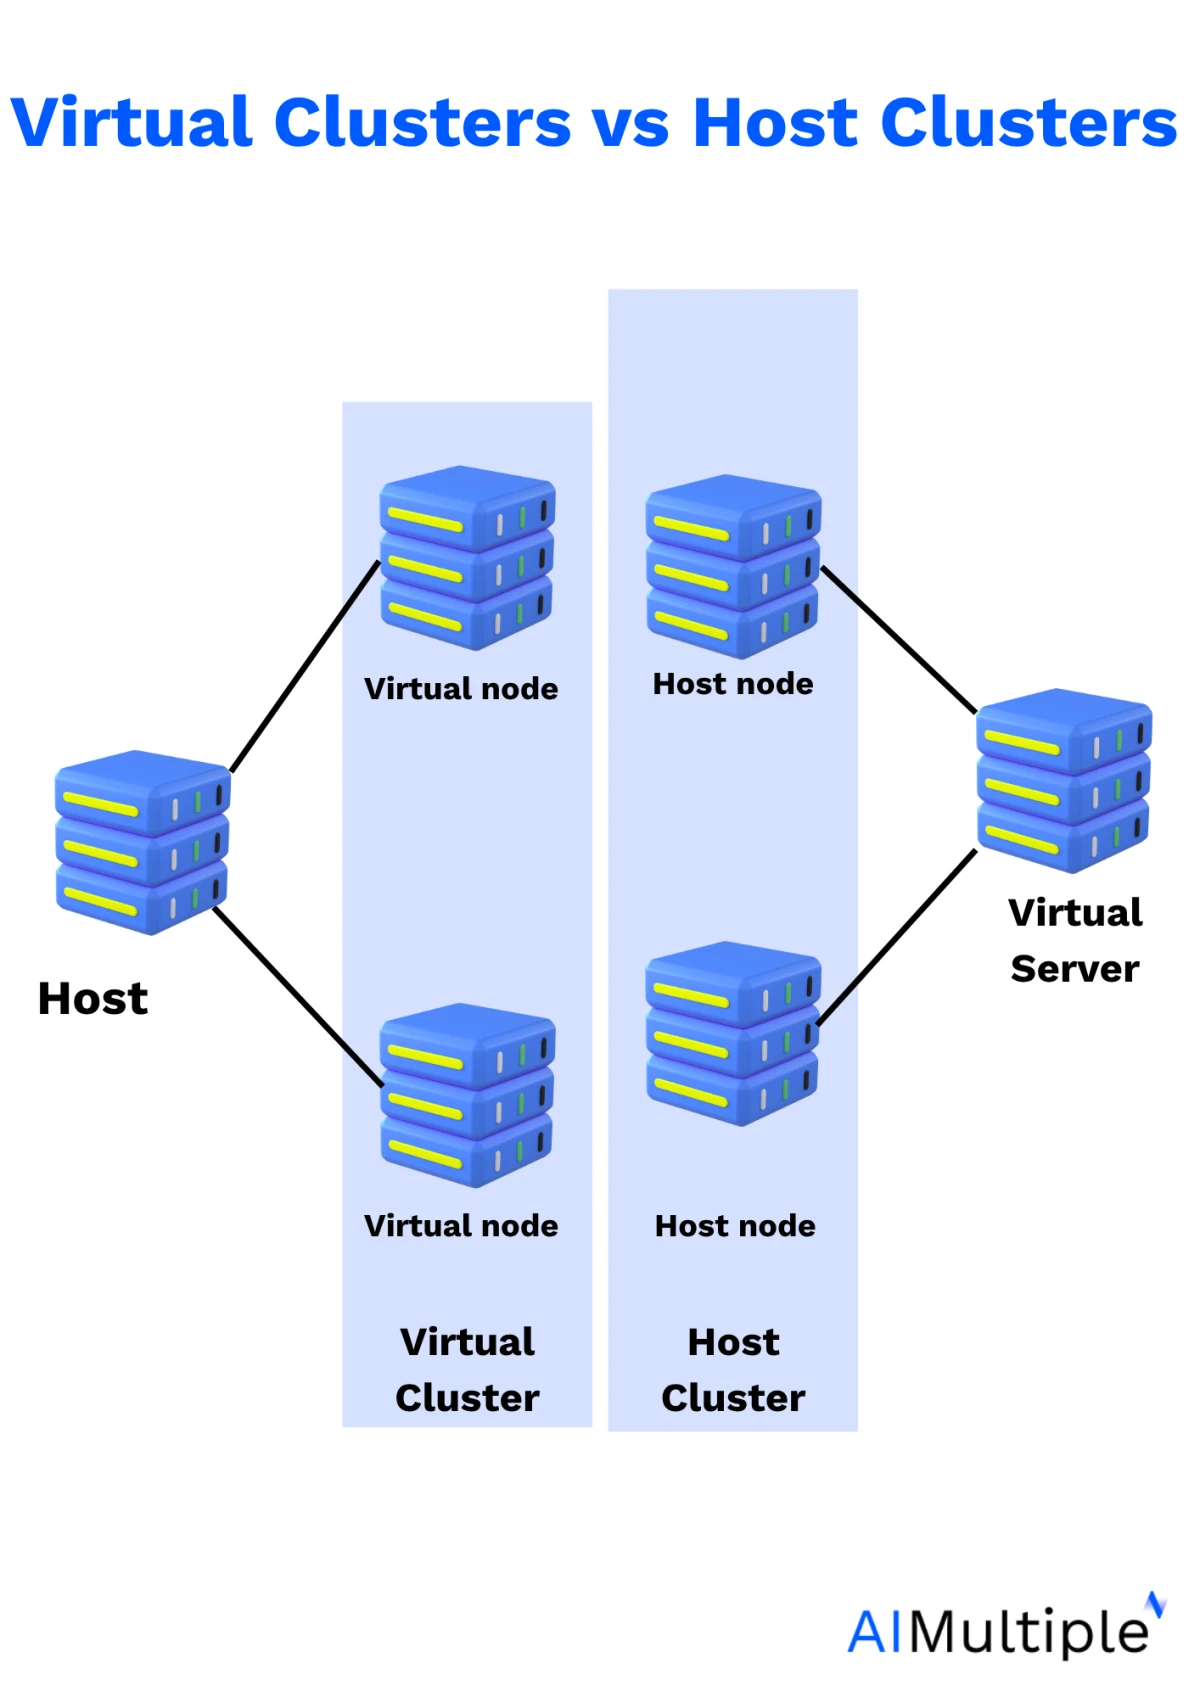
Mandantenfähigkeit beseitigt beide Kosten. Statt jedem Kunden, Team oder jeder Umgebung einen eigenen Cluster zu widmen, laufen virtuelle Cluster auf gemeinsam genutzter physischer Infrastruktur. Jeder Mandant erhält einen eigenen API-Server und eine virtuelle Control Plane, während die Nodes gepoolt werden. Dadurch entfallen die Control-Plane-Kosten pro Cluster, und Bin-Packing wird über den gemeinsamen Node-Pool hinweg statt innerhalb isolierter Bereiche möglich.
yaml
bash
Zwei Mechanismen stehen zur Verfügung. Namespaces sind immer günstiger; daher richtet sich die Wahl nach der von den Mandanten benötigten Trennung und nicht nach den Kosten.
- Namespaces partitionieren einen einzelnen Cluster und fügen keine eigene Control Plane hinzu. Sie genügen, wenn sich die Mandanten gegenseitig vertrauen und einen API-Server sowie einen Satz CRDs gemeinsam nutzen können.
- Virtuelle Cluster geben jedem Mandanten einen eigenen API-Server, der als Workload auf dem Host läuft. Diese Kosten sind in zwei Fällen gerechtfertigt: bei Mandanten, die eigene clusterweite Ressourcen benötigen, und bei Isolationsanforderungen, die ein gemeinsam genutzter API-Server nicht erfüllen kann.
Praxisbeispiel: Atlan
Atlan ist ein Datenkatalog-Unternehmen, das die Plattform für rund 95 % seiner Kunden hostet, viele davon im Gesundheitswesen und Finanzwesen, wo die Datenisolation vertraglich vorgeschrieben ist. Es betrieb einen vollständigen EKS-Cluster pro Kunde und überschritt 100 Cluster – ein Bestand, der rund um die Uhr teuer im Betrieb und schwer zu warten war. Ab Q1 2022 evaluierte es Mandantenfähigkeitsoptionen und baute die Plattform auf vCluster neu auf, wodurch jeder Kunde einen virtuellen statt eines physischen Clusters erhielt.
- Die physischen EKS-Cluster sanken von mehr als 100 auf 20, während weiterhin 100+ Kunden bedient werden
- Die Kubernetes-Ausgaben sanken um 600.000 $.13
 Als bevorzugte Quelle hinzufügen
Reihenfolge der Umsetzung
Commitments stehen trotz der einfachsten Maßnahme an letzter Stelle. Sie vor dem Rightsizing zu kaufen, schreibt ein bis drei Jahre der Verschwendung fest, die das Rightsizing gerade beseitigen wollte. Das ist der teuerste verfügbare Reihenfolgefehler und kommt häufig vor, weil er einen Einkauf statt Engineering-Arbeit erfordert.
Maßnahme 7 ist eine Abzweigung, kein Schritt. Führen Sie erst durch, wenn die ersten sechs abgeschlossen sind und das Ergebnis noch zu gering ist, denn sie ändert, wie viele Cluster laufen, statt wie effizient jeder einzelne läuft.
Kubernetes-Kostenoptimierungstools
Wir haben Tools mit drei oder mehr veröffentlichten Fallstudien abgebildet, die 47 der 68 Fallstudien im Datensatz abdecken:
- Horizontal: wie viele Fallstudien jedes Tool hat, jeweils einmal gezählt.
- Vertikal: wie viele unterschiedliche Anwendungsfallkategorien diese Fälle abdecken, von zehn. Ein Tool zählt pro Kategorie nur einmal, unabhängig davon, wie oft es dort vorkommt; daher tragen die CAST KI 12 einzelnen Rightsizing-Erwähnungen 1 zu seinem Wert von 10 bei.
- Blasengröße: in wie vielen der acht Strategiephasen das Tool vorkommt.
Open-Source-Frameworks
Open-Source-Frameworks können für die Phasen 0 bis 6 eingesetzt werden. Anwender tragen die Upgrades, die Versionswechsel, die Prometheus-Aufbewahrungskosten und die Ermessensentscheidungen, die ein kommerzieller Empfehlungsdienst für sie treffen würde.
Jedes dieser Tools deckt einen anderen Bereich ab, weshalb mehrere gleichzeitig laufen.
- Robusta KRR oder VPA in
updateMode: "Off"erzeugt den Schritt-1-Backlog. Schreibt nichts. - Karpenter steuert die Nodes: Bereitstellung, Konsolidierung, Instanzauswahl, Spot-Diversifizierung, Architektur. Trägt die Schritte 3, 4 und 6.
- KEDA steuert die Replica-Anzahl, einschließlich Skalierung auf null, was HPA allein nicht kann.
- py-kube-downscaler oder kube-green steuert den Nicht-Produktionszeitplan. Günstigste Einsparung auf der Liste.
- OpenCost misst durchgängig und beteiligt sich an nichts.
Kommerzielle Plattformen
Jedes kommerzielle Tool nimmt eine von drei Positionen auf der Node-Ebene ein. Das ist die Entscheidung, und sie zählt mehr als Preis oder Funktionsumfang, denn das NodePool-Manifest aus Schritt 3 bleibt entweder bestehen oder nicht.
- In Ruhe lassen: StormForge, PerfectScale, Sedai und Kubex dimensionieren Workloads. Sie benötigen darunter Karpenter oder Cluster Autoscaler und fassen diese nie an. Die sicherste Ergänzung für ein bestehendes Setup.
- Damit arbeiten: ScaleOps ergänzt Bin-Packing auf Karpenter. nOps stimmt einen vorhandenen Cluster Autoscaler oder Karpenter ab, statt einen eigenen einzusetzen. Mehr Abdeckung, der Provisioner bleibt Ihrer.
- Ersetzen: CAST KI und Spot Ocean installieren ihren eigenen Provisioner und verwerfen das Manifest. Größte Abdeckung, geringste Kontrolle.
- Sichtbarkeits-Tools sitzen außen: OpenCost, Kubecost, CloudZero, Vantage und Finout sind rein lesend, daher kollidieren sie mit nichts und lassen sich frei kombinieren. Betreiben Sie eines, unabhängig davon, was sonst eingesetzt wird.
Wie man diese Tools kombiniert
Die Rechnung basiert auf laufenden Nodes, nicht auf deklarierten Requests. Rightsizing senkt die Requests, wodurch Platz auf vorhandenen Nodes freigesetzt wird, ohne sie zu entfernen; daher bleibt die Rechnung unverändert, bis ein Node-Tool diesen Platz konsolidiert. Node-Tools allein scheitern aus dem spiegelbildlichen Grund: Sie packen, welche Requests sie erhalten, sodass überhöhte Requests noch enger gepackt werden.
Zwei Möglichkeiten, beide Ebenen abzudecken:
- Zwei Tools: VPA, StormForge oder PerfectScale für Requests plus Karpenter für Nodes. Günstiger, und die Node-Ebene bleibt unter direkter Kontrolle.
- Eine Plattform: CAST KI, Zesty oder Spot Ocean erledigen beides in einem einzigen Produkt. Teurer, und ihr Provisioner ersetzt Karpenter.
Fünf Tool-Kombinationen, die Dinge kaputt machen:
- Zwei mutierende Rightsizer auf einem Deployment: VPA in
Autoneben StormForge, ScaleOps, PerfectScale oder Zesty bedeutet zwei Controller, die unterschiedliche Werte in dasselbe Feld schreiben. Nur ein mutierender Admission Controller pro Workload. - Karpenter und Cluster Autoscaler in einer Node-Group: Beide provisionieren gegen dieselben nicht planbaren Pods, sodass der Cluster am Ende ungefähr doppelt so viele Nodes hat wie nötig.
- VPA und HPA auf derselben Metrik: Die Nutzung steigt, VPA erhöht den Request, die gemessene Auslastung sinkt, weil sie Nutzung durch Request ist, HPA entfernt Replicas, die Last pro Pod steigt, Wiederholung. Sicher, wenn HPA auf etwas skaliert, das VPA nicht betrifft, etwa Warteschlangentiefe über KEDA.
- Zwei Commitment-Tools auf einem Zahlerkonto: Beide kaufen gegen dieselben ungedeckten Ausgaben und legen eine Überbelegung für ein bis drei Jahre fest.
- Zwei vollständige Plattformen: CAST KI, Zesty und Spot Ocean installieren jeweils ihren eigenen Provisioner und erwarten jeweils, ihn zu besitzen.
Alle von uns gesammelten Fallstudien ansehen:
Weiterführende Informationen zu Cloud-Kosten
Lesen Sie mehr, um Pod-Platzierung zu beherrschen und Ihre Cloud-Compute-Ausgaben zu senken:
- Vergleichen Sie die besten Container-Orchestrierungstools
- Vergleichen Sie 20+ Cloud-Orchestratoren
- Top-Hybrid-Cloud-Job-Scheduler
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{Kubernetes-Kostenoptimierung: 8 Schritte & 23 Tools}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/kubernetes-cost-optimization}},
  note   = {AIMultiple. Abgerufen am 15. Oktober 2026}
}Ergebnisse und Zeitstempel von 249 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 6 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Referenzlinks



Seien Sie der Erste, der kommentiert
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.