


Archivo web APIs: 4 proveedores principales probados y comparados

Un archivo web conserva páginas que se recopilaron antes de que usted las solicitara, de modo que puede extraerlas sin rastrear los sitios usted mismo. Lo que cada proveedor almacena y cuánto de ello entregará varía mucho.
Probamos 4 de ellos con consultas de ejemplo para ver cómo funcionan y qué devuelven.
Comparación de características de las APIs de archivo web
- Disponibilidad de HTML sin procesar: el marcado de la página tal como lo envió el servidor. Los términos de Webz.io mencionan “las páginas HTML completas”, pero el archivo devuelve un campo
texty no otorga derechos sobre los archivos sin procesar. - Entrega masiva a su propio almacenamiento: una selección filtrada escrita en un destino que usted controla. El corpus de Common Crawl se encuentra en S3 público para que usted lo descargue; no se envía nada a ninguna parte. Webz.io entrega solo a través de su API.
- Scraping en vivo del mismo proveedor: cubre la familia de productos, no solo el endpoint del archivo, por lo que responde si un proveedor puede cubrir tanto páginas archivadas como nunca archivadas. Exa es el único donde el fallback está dentro de la misma llamada.
Precio y créditos gratis
Bright Data cobra $0,2 por 1.000 páginas por los datos de las últimas 24 horas y $1 por 1.000 por cualquier cosa más antigua. Exa cobra $7 por 1.000 búsquedas además del precio por página, por lo que localizar 1.000 páginas antes de recuperarlas añade aproximadamente $0,70, lo que hace que las dos cifras idénticas de $1 se comporten de manera distinta en la práctica.
Los créditos gratuitos cubren la entrega de datos: las consultas son gratis en los cuatro, por lo que la diferencia es si los créditos gratis también pagan por extraer los datos. Bright Data permite 100 búsquedas de archivo al día sin coste, cada una devuelve el recuento de registros coincidentes y el precio de entrega antes de que se cobre nada, de modo que un trabajo puede dimensionarse de forma gratis. Webz.io funciona de la misma manera, con una muestra gratis y una estimación de costes, pero una descarga masiva requiere créditos prepagados comprados por separado. Common Crawl y Exa permiten que los créditos gratis paguen por la recuperación real.
APIs de archivado web
Bright Data Web Archive API vende acceso a páginas que su infraestructura ya ha recopilado a través del Unlocker y las SERP APIs. En lugar de ejecutar un crawler, describes lo que quieres con filtros, revisas una estimación de costes y haces que las páginas coincidentes se entreguen a tu propio almacenamiento.
Filtros
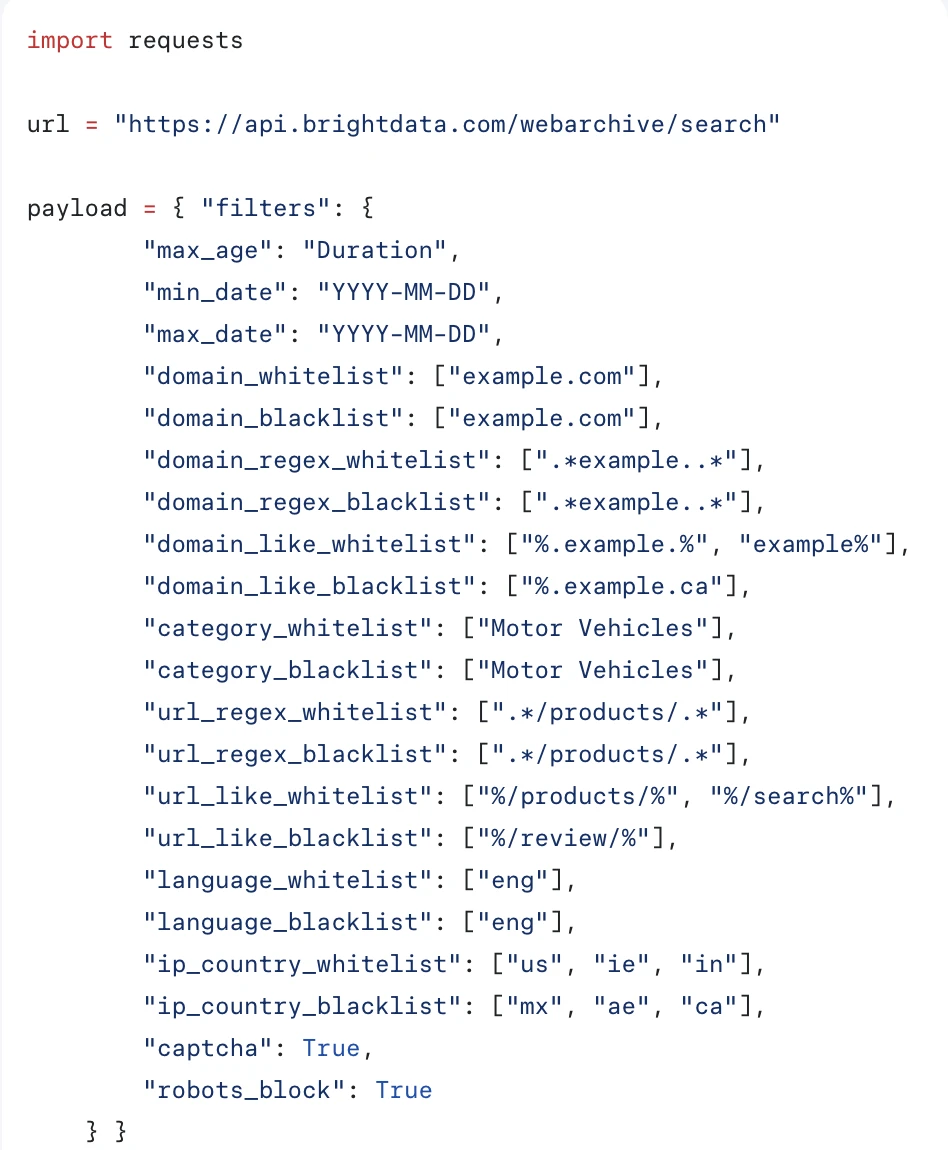
Todo se ejecuta a través de un objeto filters con 20 campos: rango temporal, dominio, patrón de URL, categoría, idioma, país y resultado de recopilación. El tiempo es obligatorio y la categoría es una lista cerrada de 30 valores, por lo que las páginas se clasifican al entrar.
Dos campos describen cómo se recopiló la página en lugar de lo que contiene. ip_country filtra por el país de la IP de salida que recopiló la página, lo que confirma que el archivo es un subproducto de la red proxy. captcha y robots_block devuelven solo registros donde se activó un CAPTCHA o se aplicó una regla de robots, de modo que los intentos bloqueados se almacenan en lugar de descartarse.
Búsqueda y coste
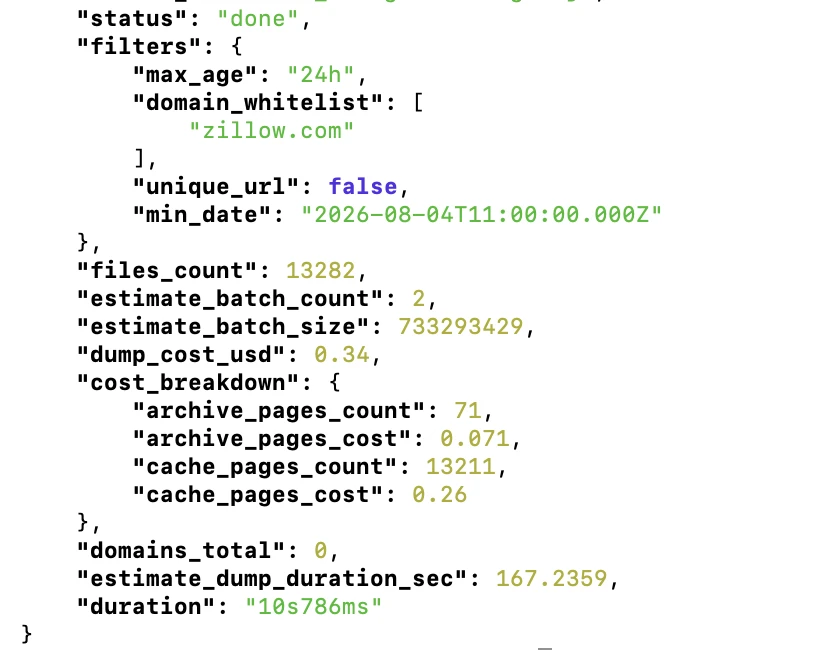
La búsqueda es gratis, hasta 100 consultas por día, y la respuesta incluye todo lo necesario para dimensionar un trabajo antes de pagar: el recuento de registros coincidentes, el coste de entrega estimado y un desglose que muestra cuántas páginas se encuentran en el nivel de caché de 24 horas frente al nivel de archivo.
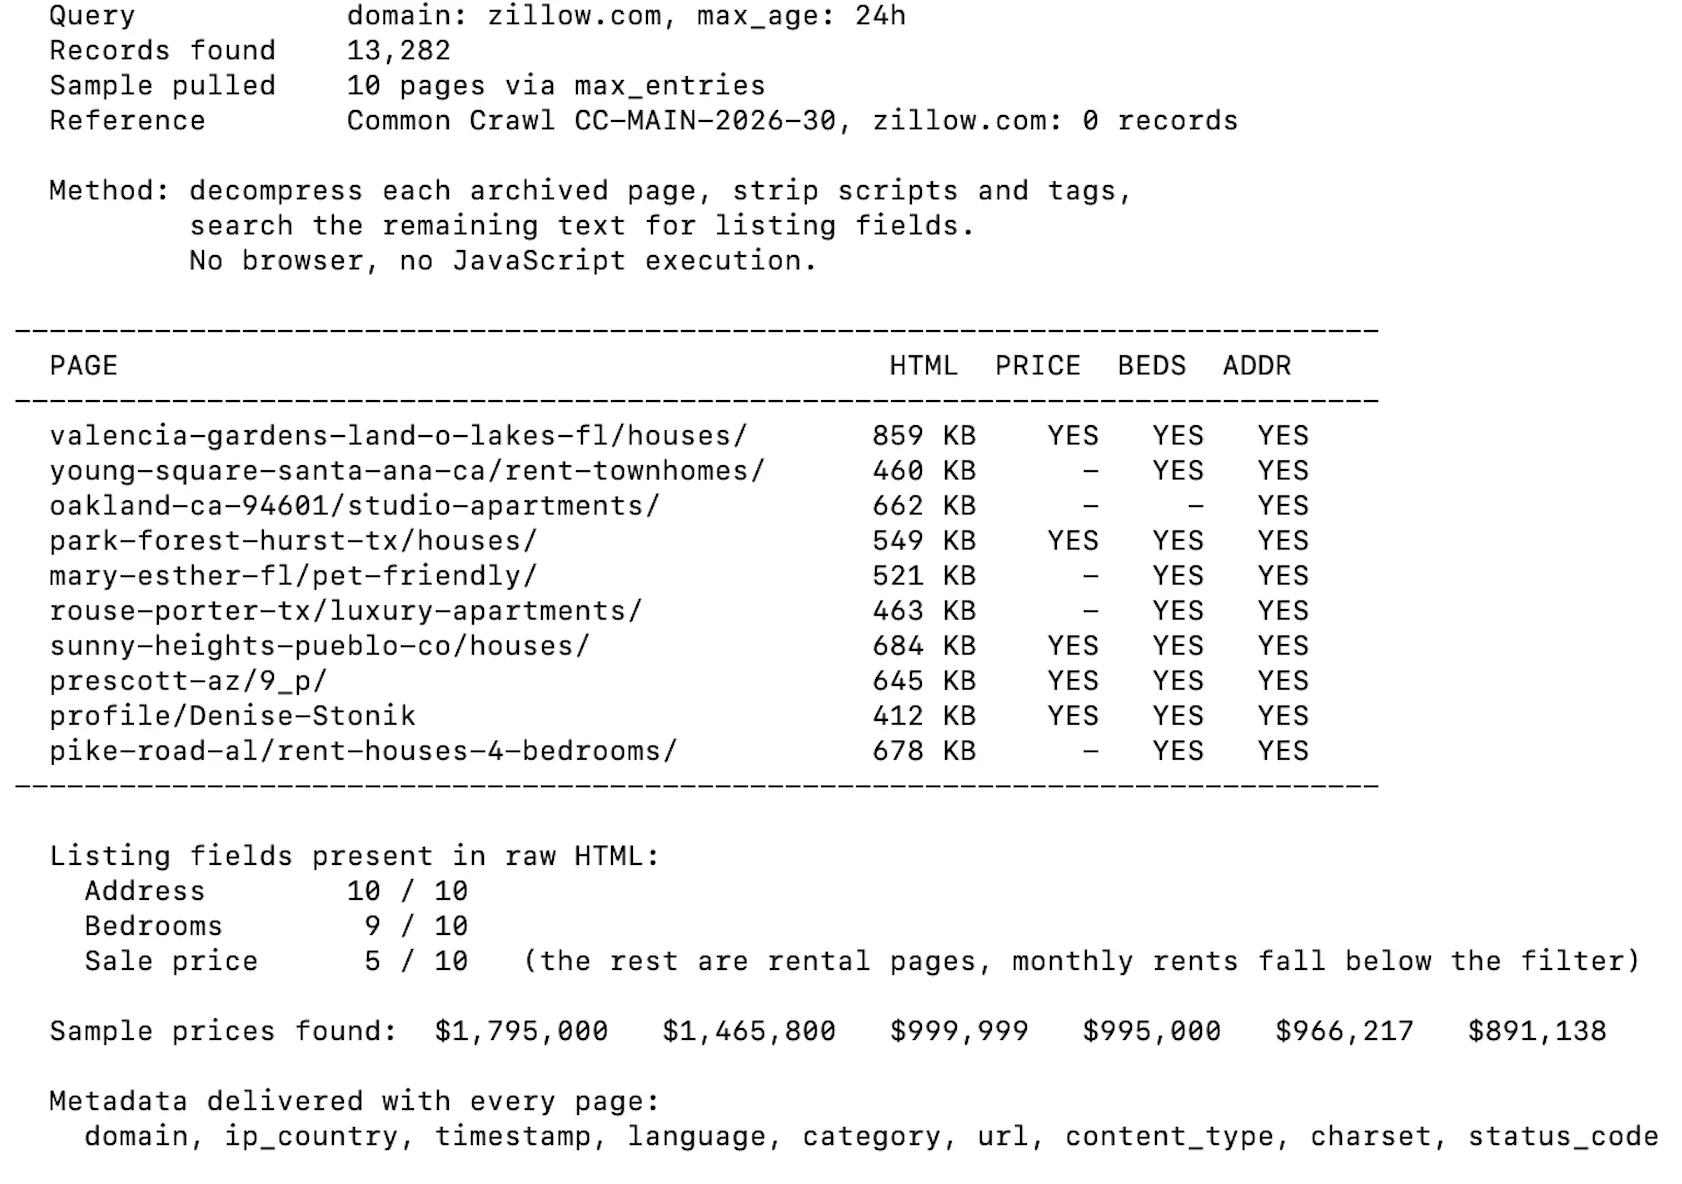
- Cobertura de sitios que bloquean rastreadores: Common Crawl no tiene páginas de zillow.com en un rastreo mensual completo. Bright Data devolvió 13.282 registros para una única ventana de 24 horas.
- La velocidad de consulta aumenta con la ventana: una consulta de 240 días sobre redfin.com devolvió 59.831 registros en 1 minuto 53 segundos. La consulta de zillow.com de 24 horas se completó en 10,8 segundos.
- Dos niveles de almacenamiento: los datos de las últimas 24 horas cuestan $0,2 por 1.000 páginas. Todo lo más antiguo se mueve a S3 Glacier Deep Archive a $1 por 1.000. El tiempo de entrega acompaña: nuestro trabajo de 24 horas llegó en unos 30 segundos, mientras que el trabajo de 240 días permaneció en
restoring_archive_datadurante decenas de minutos. - Entrega a su propio almacenamiento: Amazon S3, Azure Blob Storage, Google Cloud Storage o webhook. Probamos la vía del webhook; diez páginas llegaron como un único tar con un
.html.gzy un.meta.jsonpor página. - Muestra antes de comprometerse:
max_entrieslimita cuántos archivos incluye una entrega, por lo que una consulta de 59.831 registros se puede muestrear con diez páginas por una fracción de centavo.
Obtén 100 búsquedas de archivo gratis al día con Bright Data
Obtén acceso gratuitoQué contiene realmente los archivos
Cada página llega tal como la envió el servidor, con nueve campos de metadatos: domain, url, timestamp, language, category, ip_country, content_type, charset y status_code. Para comprobar si ese HTML sin procesar es utilizable sin un navegador, abrimos diez páginas archivadas de Zillow, eliminamos scripts y etiquetas, y buscamos campos de anuncios en el texto restante.
Common Crawl es una organización sin ánimo de lucro que publica un rastreo de la web abierta aproximadamente una vez al mes y lo regala. No hay cuenta, ni clave, ni cuota. La contrapartida es que obtienes archivos en lugar de un servicio: no se te entrega nada y cualquier cosa más allá de la consulta de una sola página implica ejecutar tu propio procesamiento.
Elegir un formato
Cada rastreo viene en varios formatos. Las respuestas HTTP sin procesar contienen el HTML original. Un extract de metadatos contiene enlaces, títulos y cabeceras en JSON. Una versión de texto plano contiene el texto del artículo sin marcado. Dos conjuntos más pequeños cubren los archivos robots.txt y las respuestas que no son 200.
La elección importa porque es unidireccional. El texto plano es mucho más pequeño y rápido de procesar, pero las etiquetas, los atributos y el JSON-LD incrustado desaparecen de él, por lo que la extracción estructurada debe partir del conjunto sin procesar.
No hay entrega filtrada. Eliges un formato, descargas lo que necesitas y lo procesas tú mismo.
Encontrar una página
Existen dos mecanismos y responden a preguntas diferentes. El servidor CDX gestiona consultas de una sola URL mediante un formulario web o una API. El índice columnar, publicado como Parquet, gestiona preguntas masivas mediante SQL.
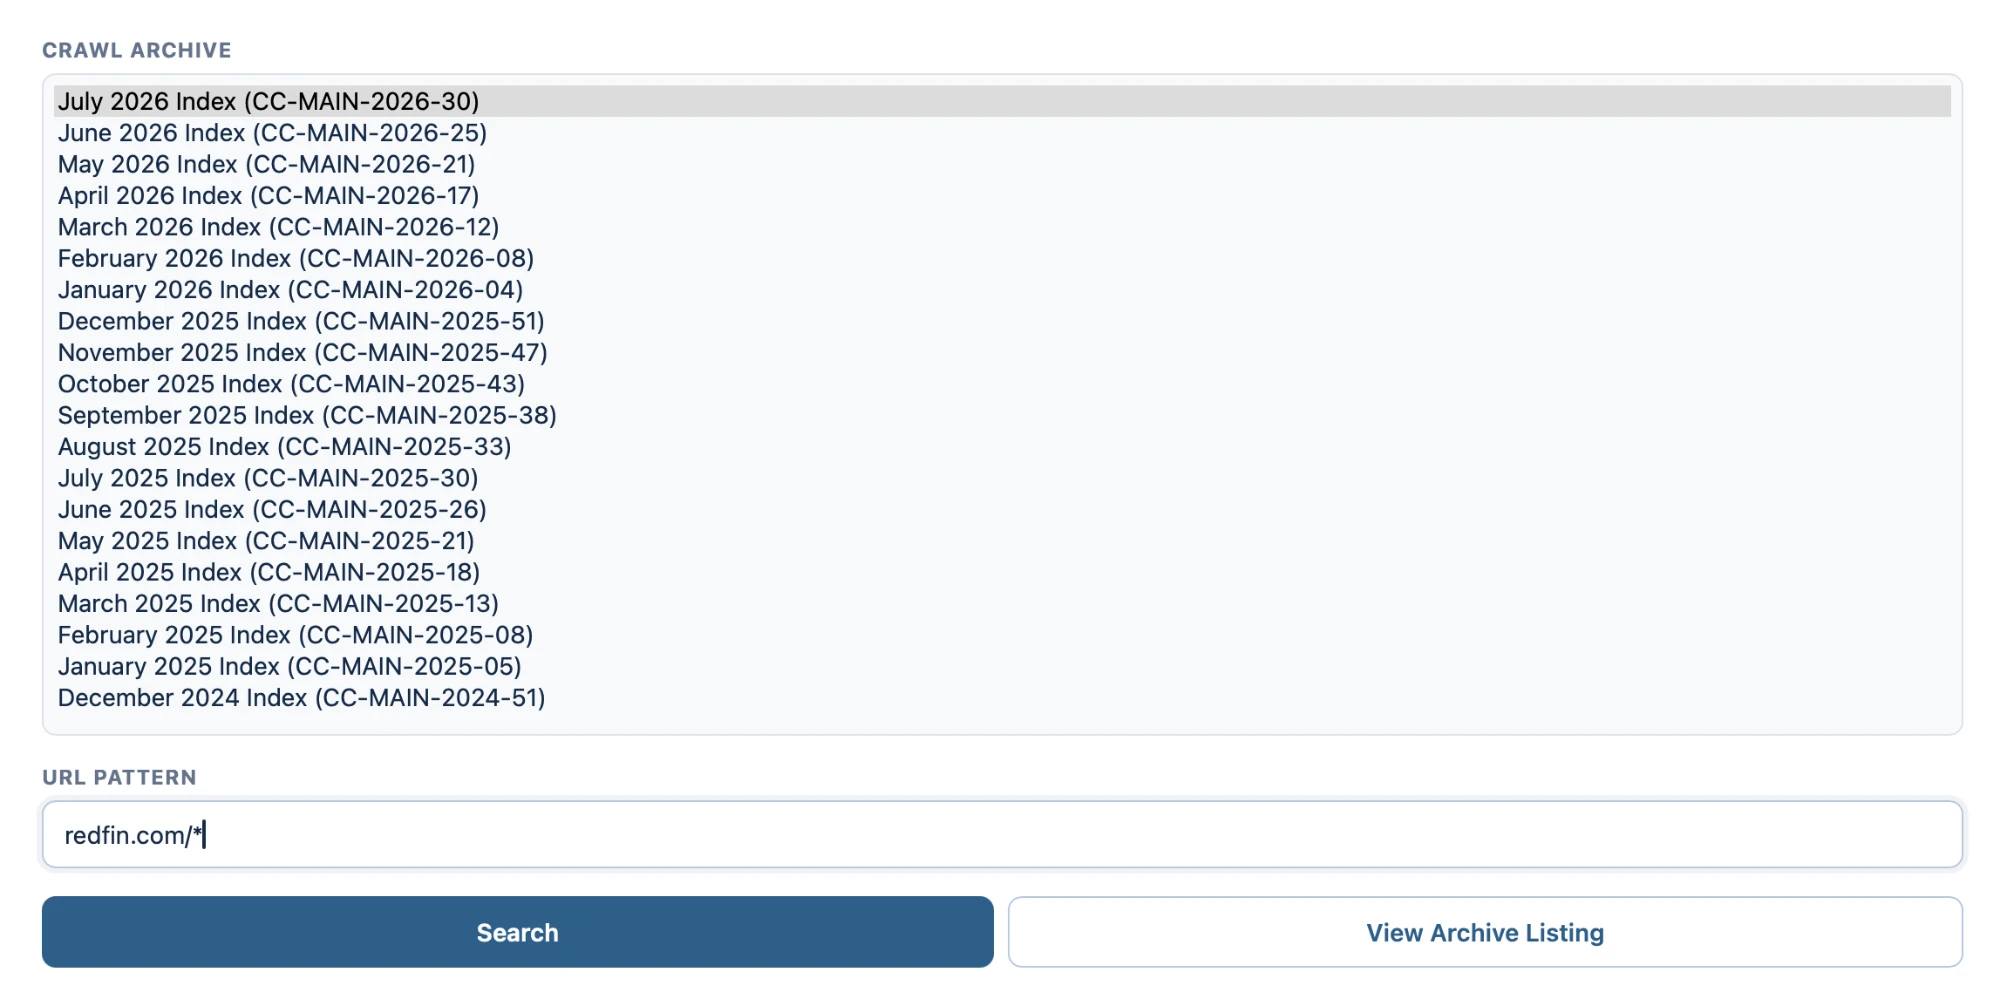
La interfaz CDX pide dos cosas: qué rastreo mensual buscar, de una lista que se remonta a 2008, y un patrón de URL.
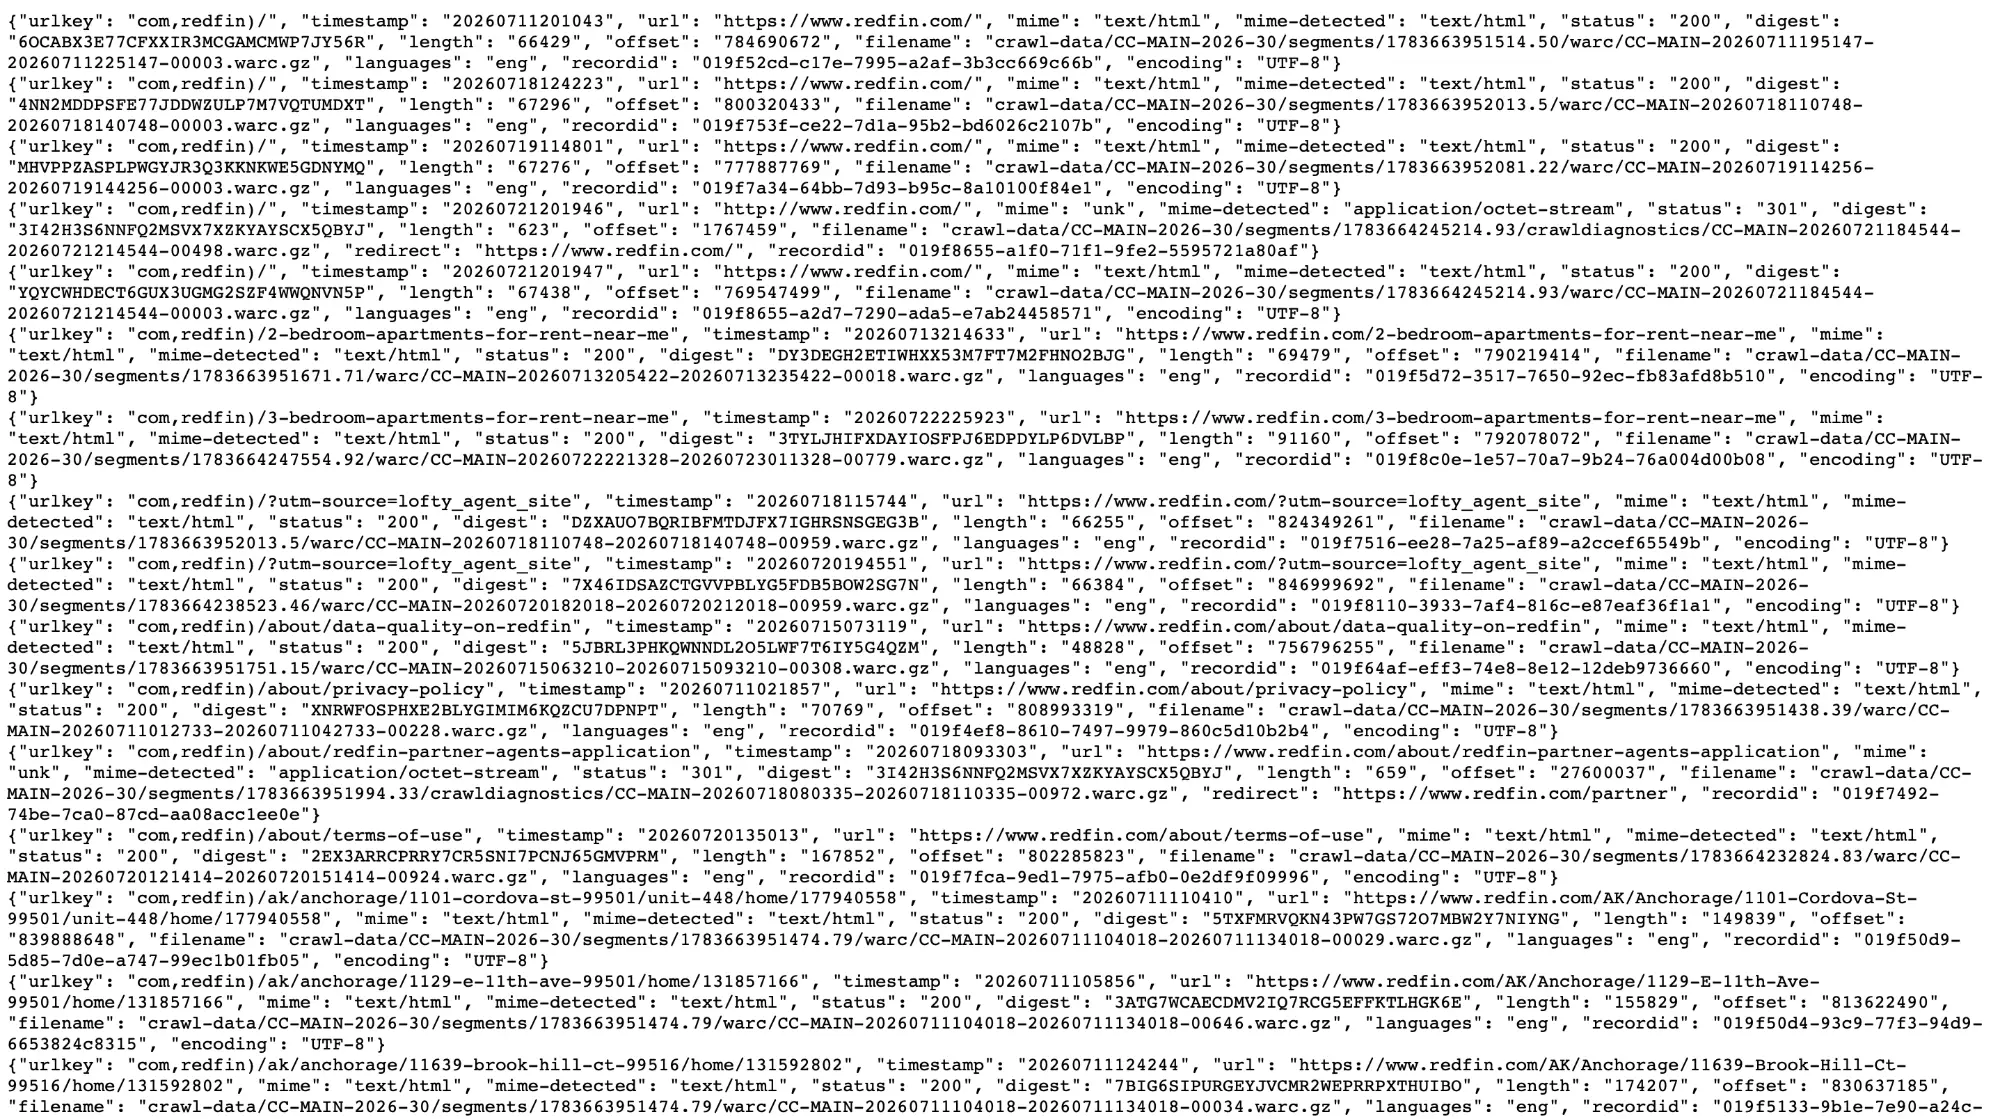
Los resultados se devuelven como JSON, una línea por captura. Tres campos importan más que el resto: el nombre de archivo WARC, un desplazamiento de bytes y la longitud del registro.
Dos cosas son visibles en la salida. La misma URL aparece varias veces con marcas de tiempo diferentes, por lo que un único rastreo mensual no es una única instantánea. Y las respuestas fallidas se almacenan por separado, con redirecciones y errores en una carpeta crawldiagnostics en lugar de junto a las descargas exitosas.
Extraer una página sin descargar el archivo que la contiene
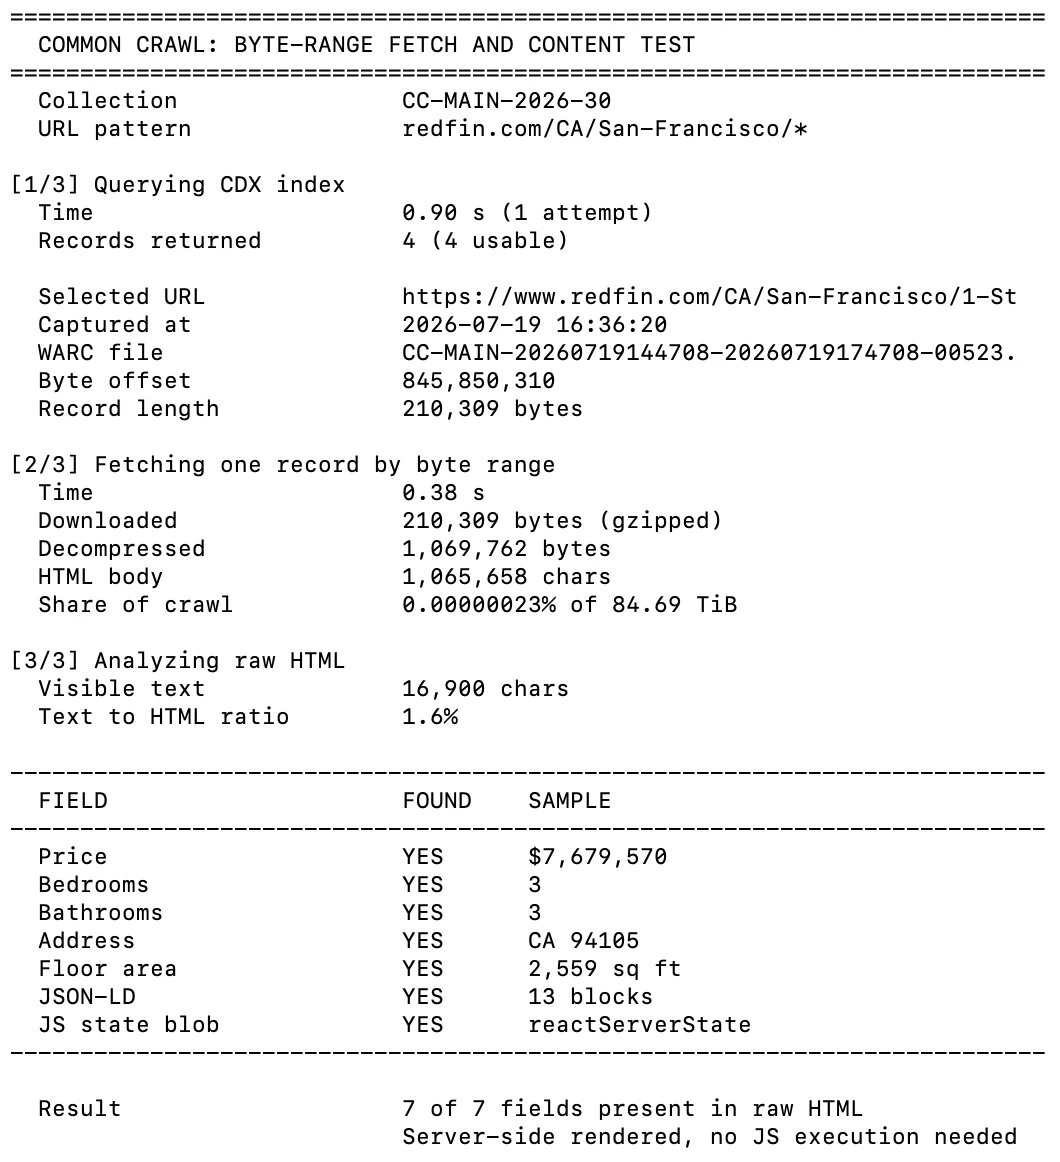
El nombre de archivo, el desplazamiento y la longitud permiten solicitar un único registro con una cabecera HTTP Range. Probamos esto en una página de anuncios de Redfin.
La consulta CDX se completó en menos de un segundo y la descarga por rango de bytes tardó 0,38 segundos para 210 KB. Los siete campos de anuncio que buscamos, incluidos el precio, los dormitorios y la dirección, estaban presentes en el HTML sin procesar sin ejecutar JavaScript.
Filtrado masivo con SQL
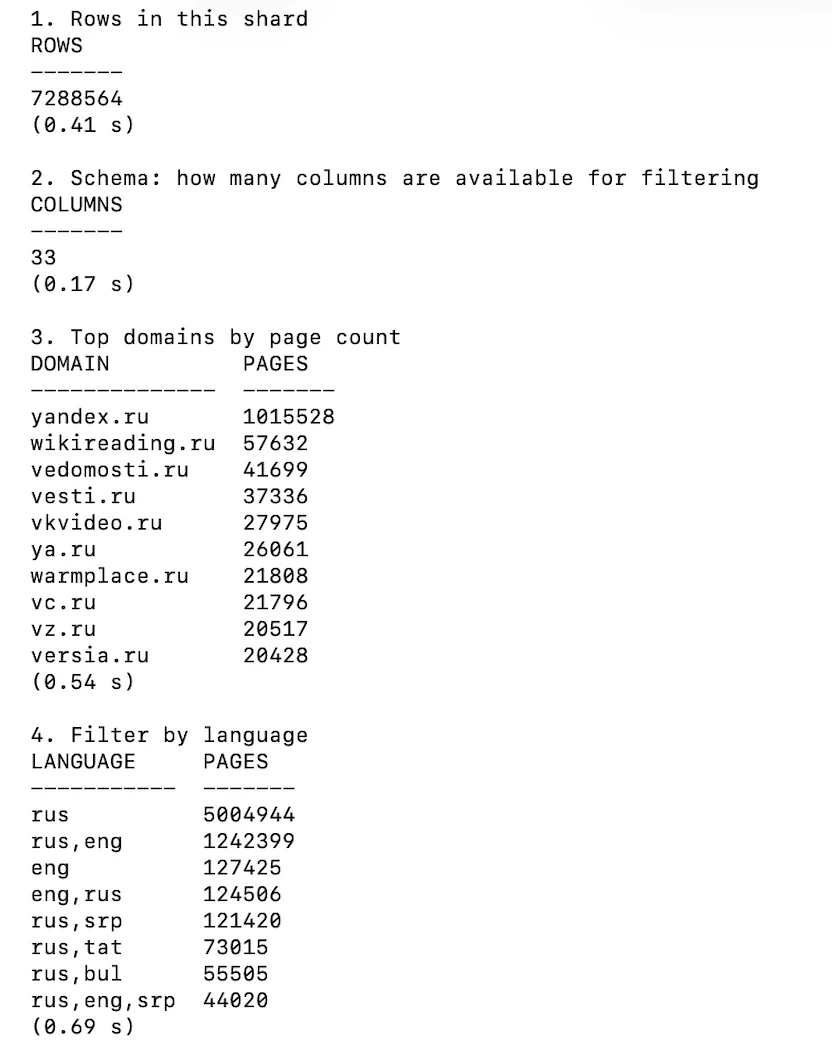
Para cualquier cosa mayor que una única URL, el índice columnar es la vía. Es Parquet, se puede consultar por HTTPS y expone 33 columnas que cubren URL, host, TLD, idioma, tipo MIME, estado de descarga y marca de tiempo.
Las consultas contra un único fragmento de 7.29 millones de filas se completaron en bastante menos de un segundo cada una, sin escribir nada en disco. Un detalle que hay que conocer antes de usarlo: los fragmentos están indexados por un nombre de host invertido, por lo que cada archivo contiene una franja alfabética estrecha en lugar de una muestra aleatoria. Consultar un fragmento arbitrario para un dominio específico normalmente no devolverá nada.
Cuánto almacena para un dominio dado
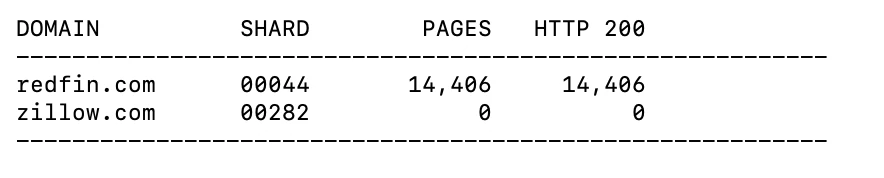
Consultamos el índice para dos dominios, redfin.com y zillow.com, localizamos el fragmento que cubre cada uno y contamos sus filas.
redfin.com devolvió 14.406 páginas, todas ellas HTTP 200. zillow.com no devolvió ninguna. Esto no es una cobertura parcial ni una descarga fallida; el dominio no está en el índice. Common Crawl respeta robots.txt, por lo que un sitio que prohíbe su rastreador está ausente en lugar de escasamente representado.
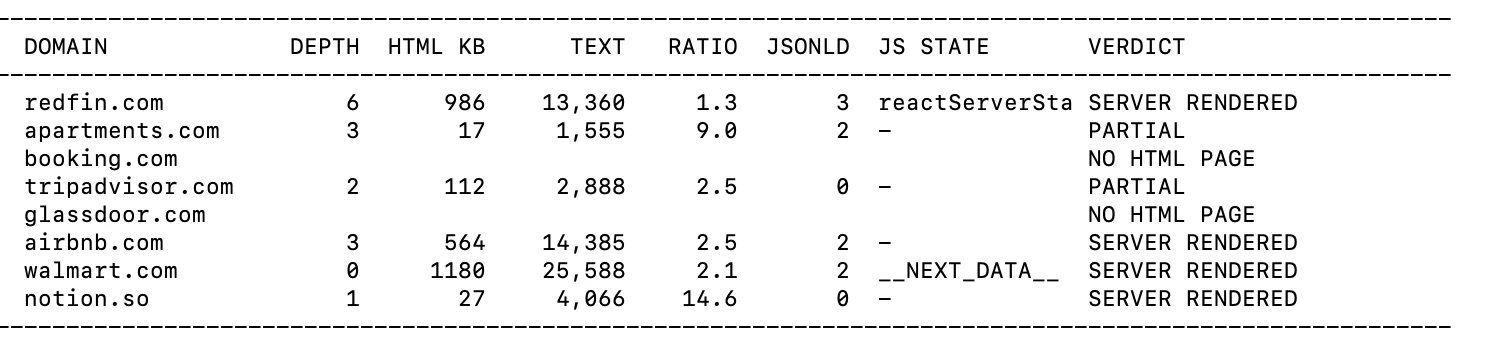
Extraemos una página archivada de cada uno de ocho sitios grandes y medimos cuánto texto sobrevivía sin un navegador. Dos de ellos no tenían ninguna página HTML utilizable en el archivo. Entre el resto, la mayoría estaban renderizadas en el servidor, incluidas Airbnb y Walmart. TripAdvisor fue la excepción, devolviendo una página de 18 KB que contenía 282 caracteres de texto visible.
Coste y licencia
Los datos son gratis y el bucket de almacenamiento está abierto sin necesidad de cuenta. Lo que pagas es cómputo y ancho de banda, por lo que se recomienda procesar en la misma región de nube que los datos.
La licencia no es una licencia de datos abiertos. Common Crawl otorga una licencia limitada al servicio, afirma que no puede licenciar el contenido de las páginas en sí y exige a los usuarios que lo indemnicen frente a reclamaciones derivadas del uso del contenido “en relación con inteligencia artificial, aprendizaje automático u otras tecnologías similares”. La responsabilidad total se limita a $100.1
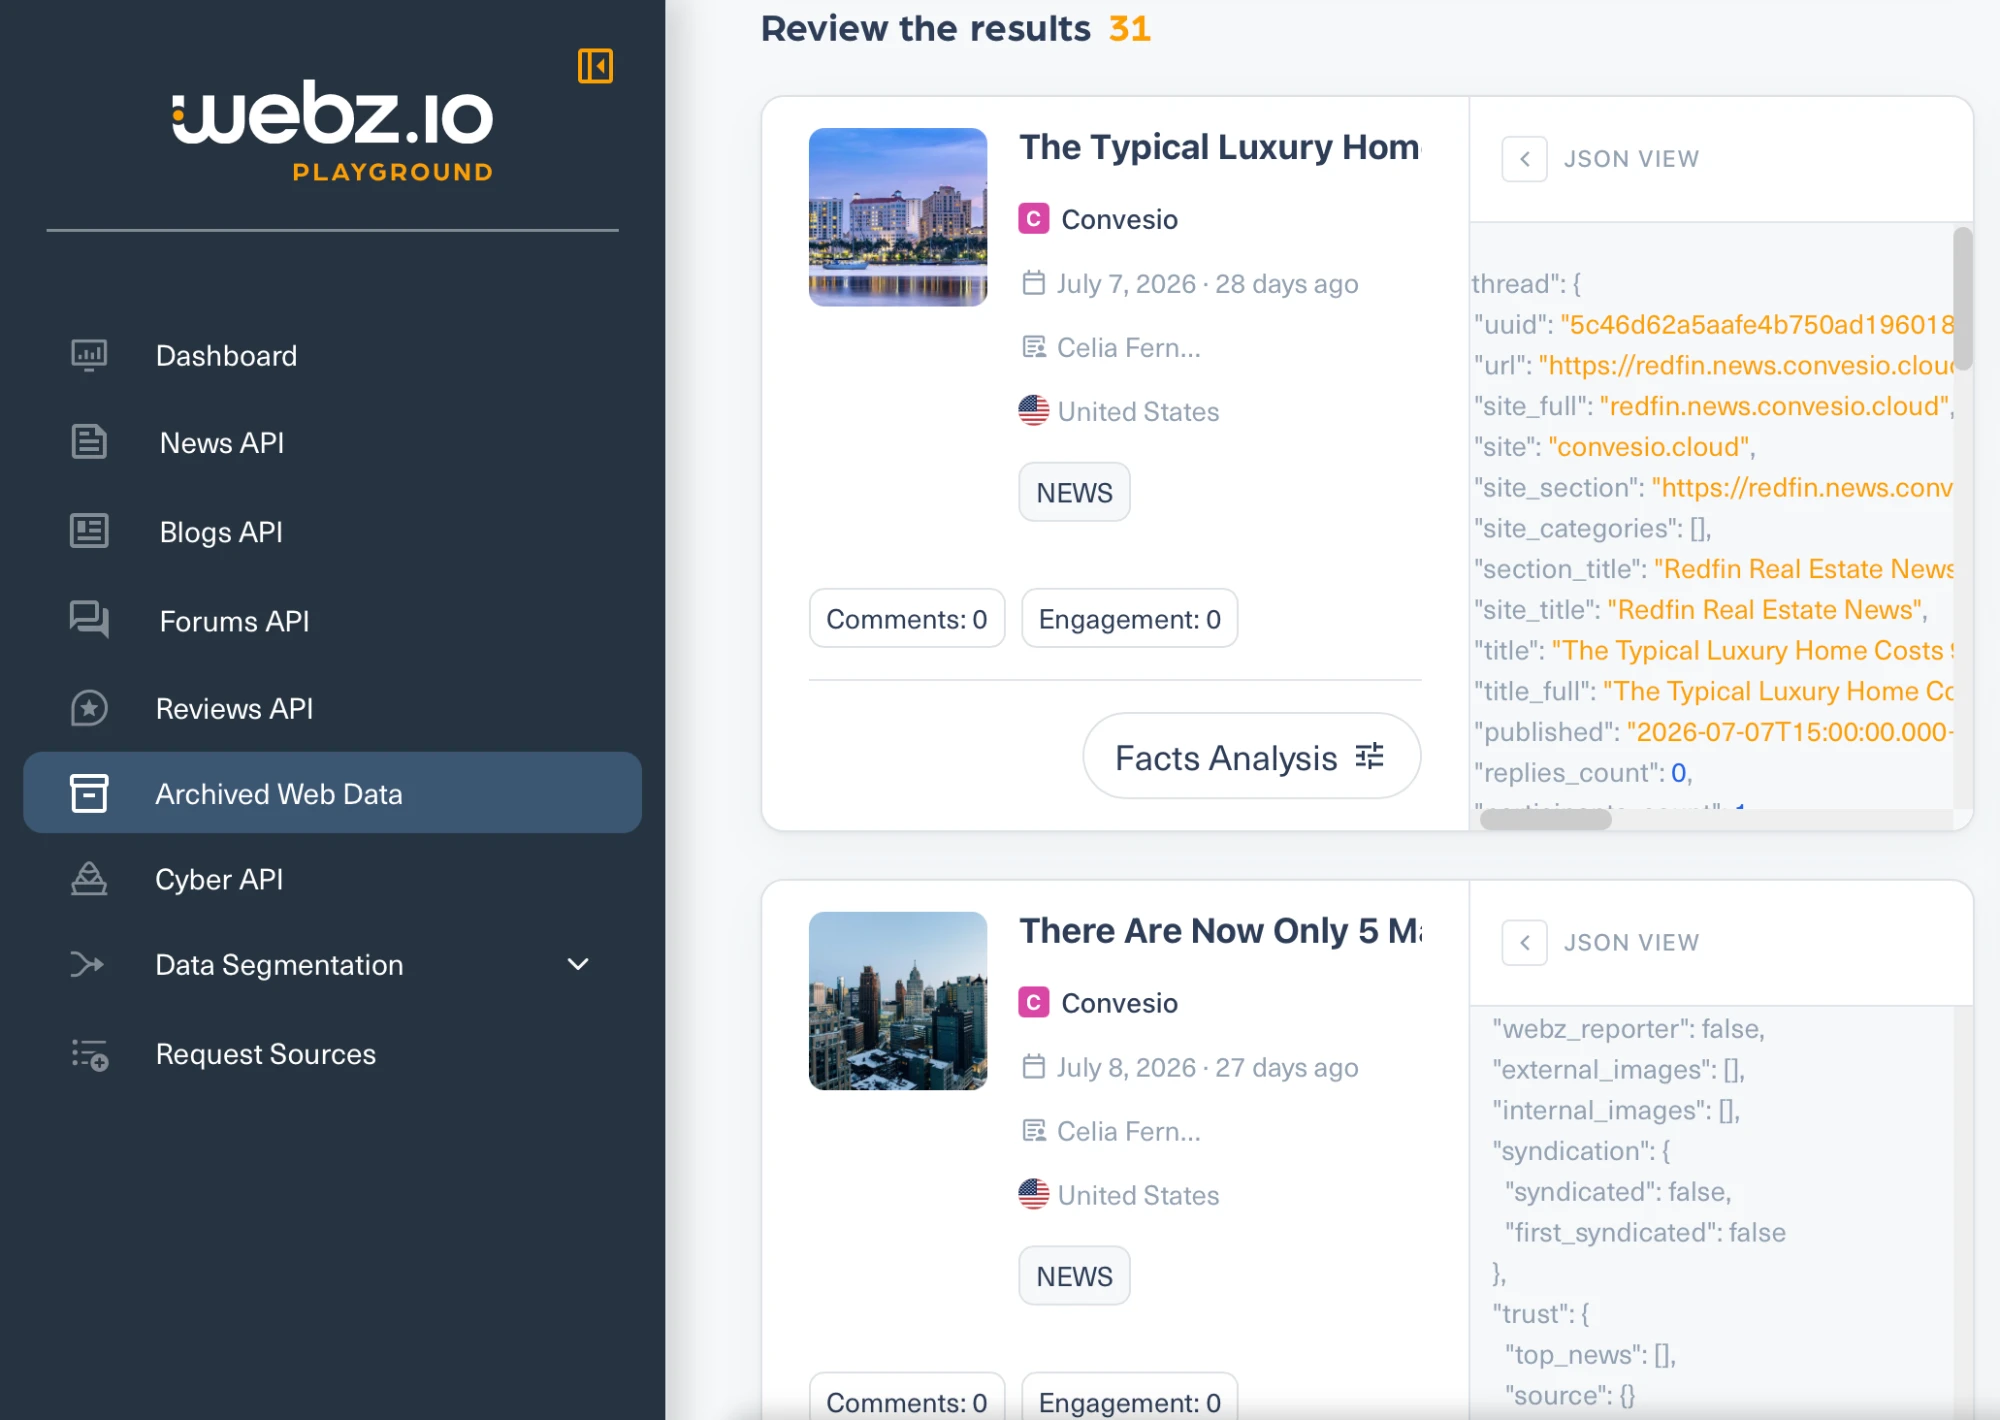
Webz.io vende acceso a un archivo de artículos de noticias, publicaciones de blog, hilos de foros y reseñas. Las noticias se remontan a 2008 y los blogs e hilos de foros a diciembre de 2014, pero el archivo de autoservicio cubre solo los últimos cinco años; los datos más antiguos se entregan como volcados masivos bajo petición. 2 Lo que devuelve no es la página, sino un registro procesado: el texto del artículo más entidades extraídas, puntuaciones de sentimiento, recuentos de interacción social y metadatos del sitio. Todo lo que tiene más de unos 30 días se aloja en el producto de archivo; el material más reciente lo sirven las APIs de News, Blogs y Forums.
El constructor de consultas
Las consultas combinan una expresión booleana sobre el texto con condiciones a nivel de campo, unidas por AND. Cada condición se construye a partir de una propiedad, un operador y un valor.
Un detalle que conviene conocer antes de usarlo: el operador etiquetado Equals no requiere una coincidencia exacta. Introdujimos redfin en el campo de título del sitio y coincidió con un sitio cuyo título es “Redfin Real Estate News”.
Qué se devuelve
Cada resultado incluye el texto completo junto con entities, sentiment, social, categories, language, domain_rank, country y un objeto syndication que registra si la misma historia apareció en otros lugares. No hay ningún campo de HTML sin procesar. La página del producto describe lo que obtienes como “el texto completo de cada artículo, publicación, hilo o reseña”, y la entrega es “a través de la API o ejecutando una consulta uno mismo”.
- El archivo contiene editores, no sitios de anuncios. Buscar Redfin devolvió el blog corporativo de noticias de Redfin, alojado en
convesio.cloud, en lugar de páginas de redfin.com. Consultar directamente el campo de dominio del sitio pararedfin.comno devolvió nada, mientras queconvesio.cloudyyahoo.comdevolvieron resultados, por lo que la respuesta vacía refleja cobertura y no una consulta rota. - La recopilación masiva está restringida por contrato. Los términos del servicio prohíben un filtro comodín de asterisco y filtros verticales como
site_type:newsolanguage:english, que son exactamente las formas de consulta que usaría un comprador de corpus. La propia interfaz sugiere añadirsite_type:newspara acotar una búsqueda.
Exa creó su propio índice web y vende búsquedas sobre él. La compañía informa de más de 500 mil millones de URL. Exa informa de que su índice rastrea más de 2 billones de URL y sirve 100 mil millones de páginas.3
Para esta comparación, la parte relevante no es el endpoint de búsqueda, sino /contents, que devuelve el texto de una página desde la caché de Exa en lugar de obtenerla en vivo.
Opciones de caché o en vivo
Un único parámetro lo controla. maxAgeHours con el valor 24 significa usar la copia en caché si tiene menos de un día; de lo contrario, rastrear. Con 0 siempre rastrea. Con -1 nunca rastrea, devolviendo solo lo que ya está almacenado. El valor máximo aceptado es 720 horas, por lo que el parámetro no puede referenciar nada más antiguo de 30 días.
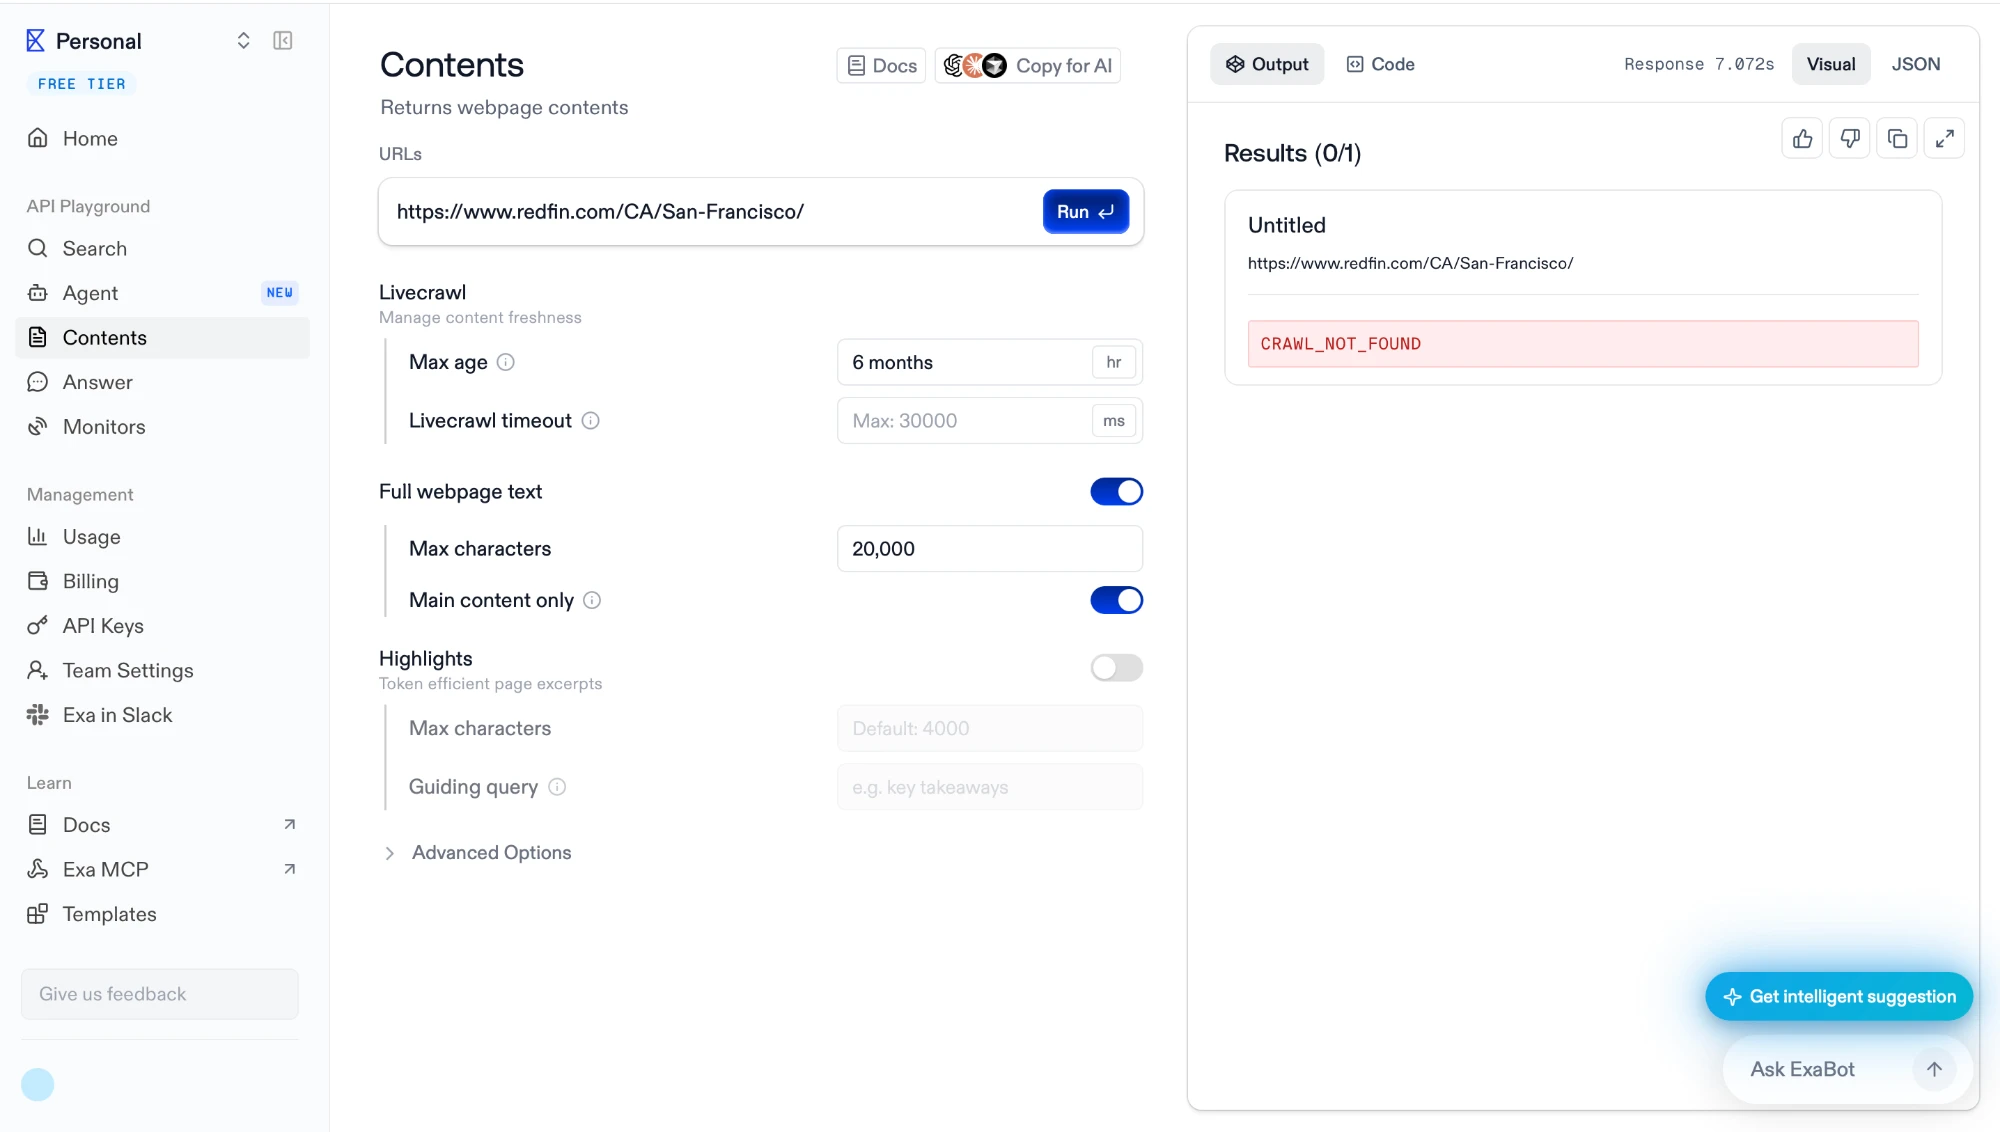
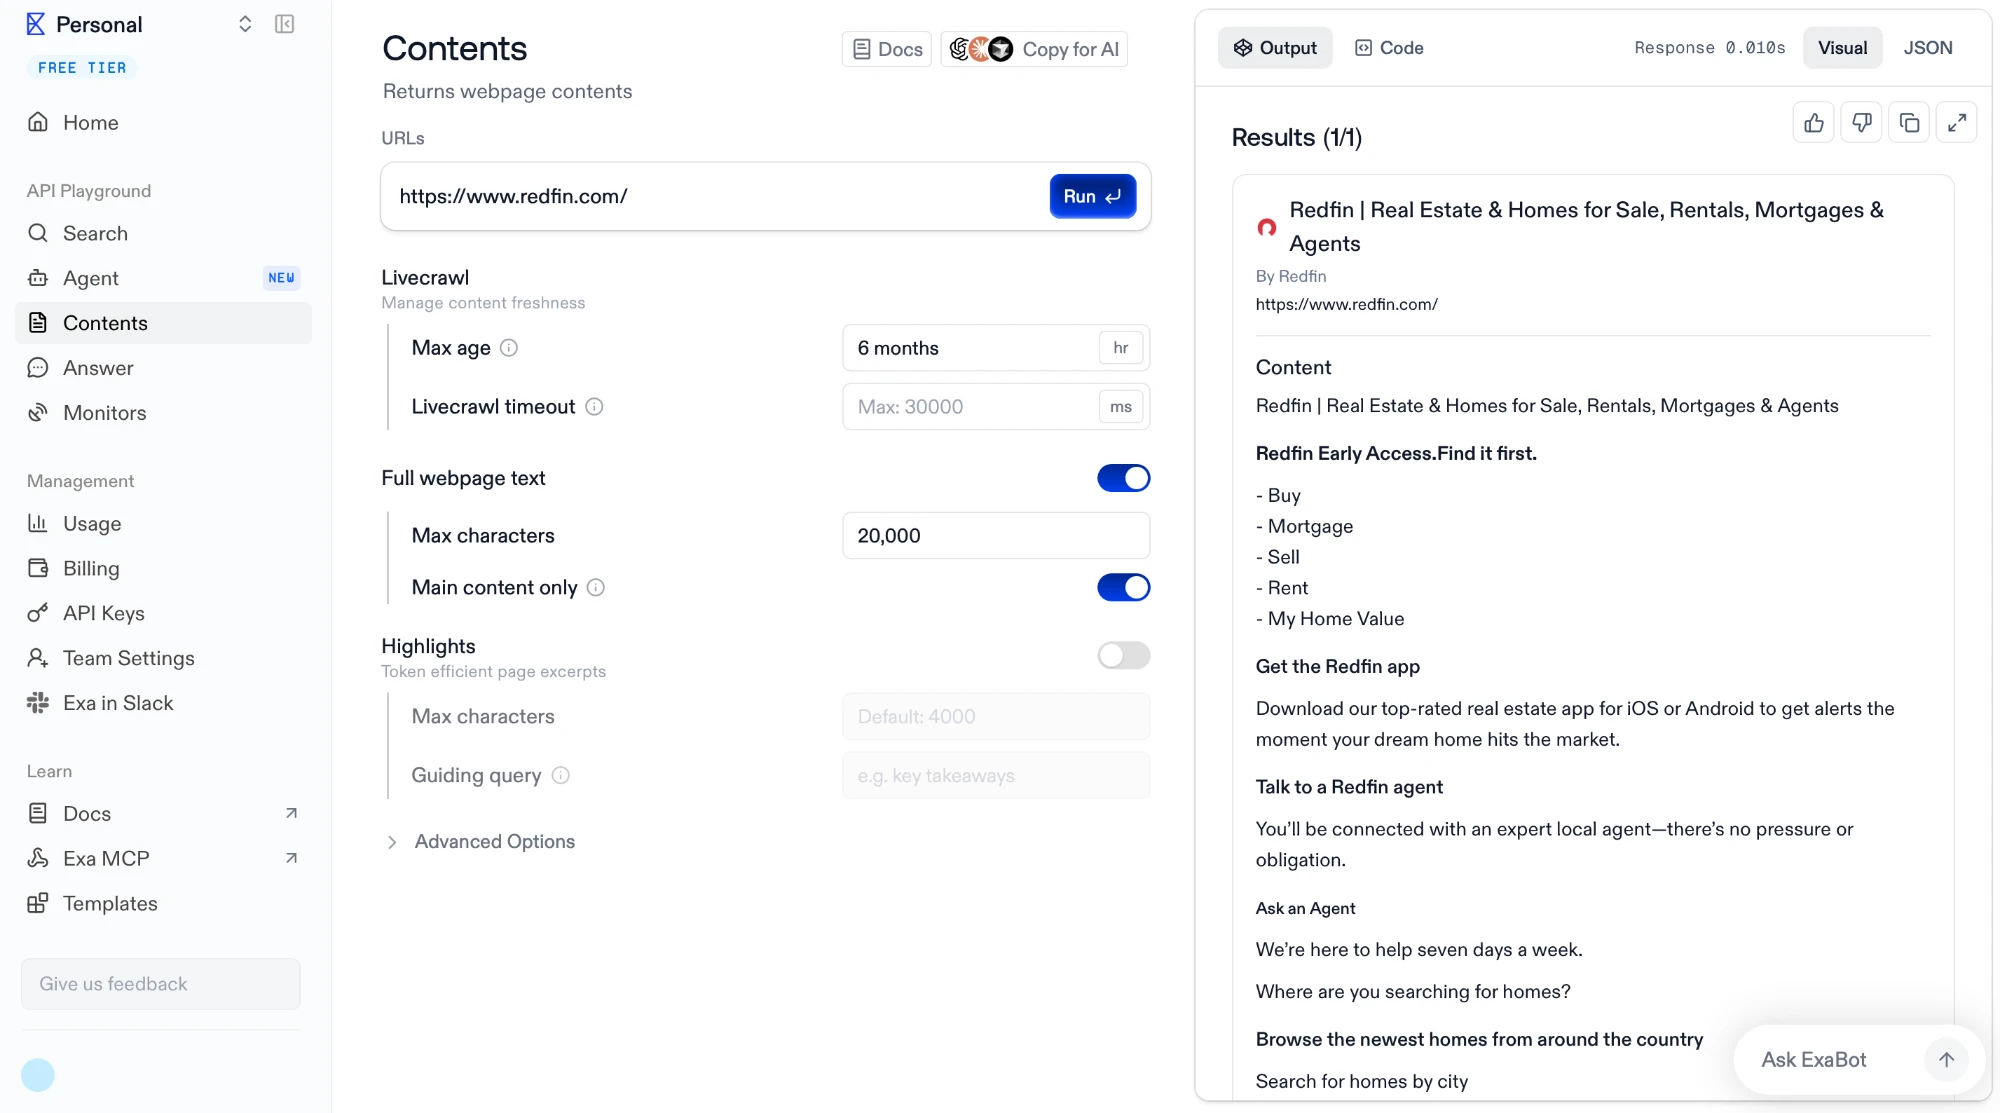
Ejecutamos dos solicitudes con el límite de antigüedad fijado en seis meses. La primera pedía una página de ciudad de Redfin.
Devolvió CRAWL_NOT_FOUND después de 7,07 segundos. La segunda pedía la página de inicio de Redfin.
Devolvió el contenido completo de la página en 0.010 segundos. Diez milisegundos es menos que un viaje de ida y vuelta por la red, por lo que esa respuesta procedía del almacenamiento, no de una descarga. La caché es real, y el fallo de siete segundos fue Exa buscando y no encontrando.
Otras dos opciones por defecto son visibles en la misma pantalla. El contenido se limita a 20.000 caracteres y la opción “solo contenido principal” está activada, por lo que la navegación y el texto repetitivo son eliminados por la lógica propia de Exa en lugar de la tuya.
La cobertura es irregular a nivel de página
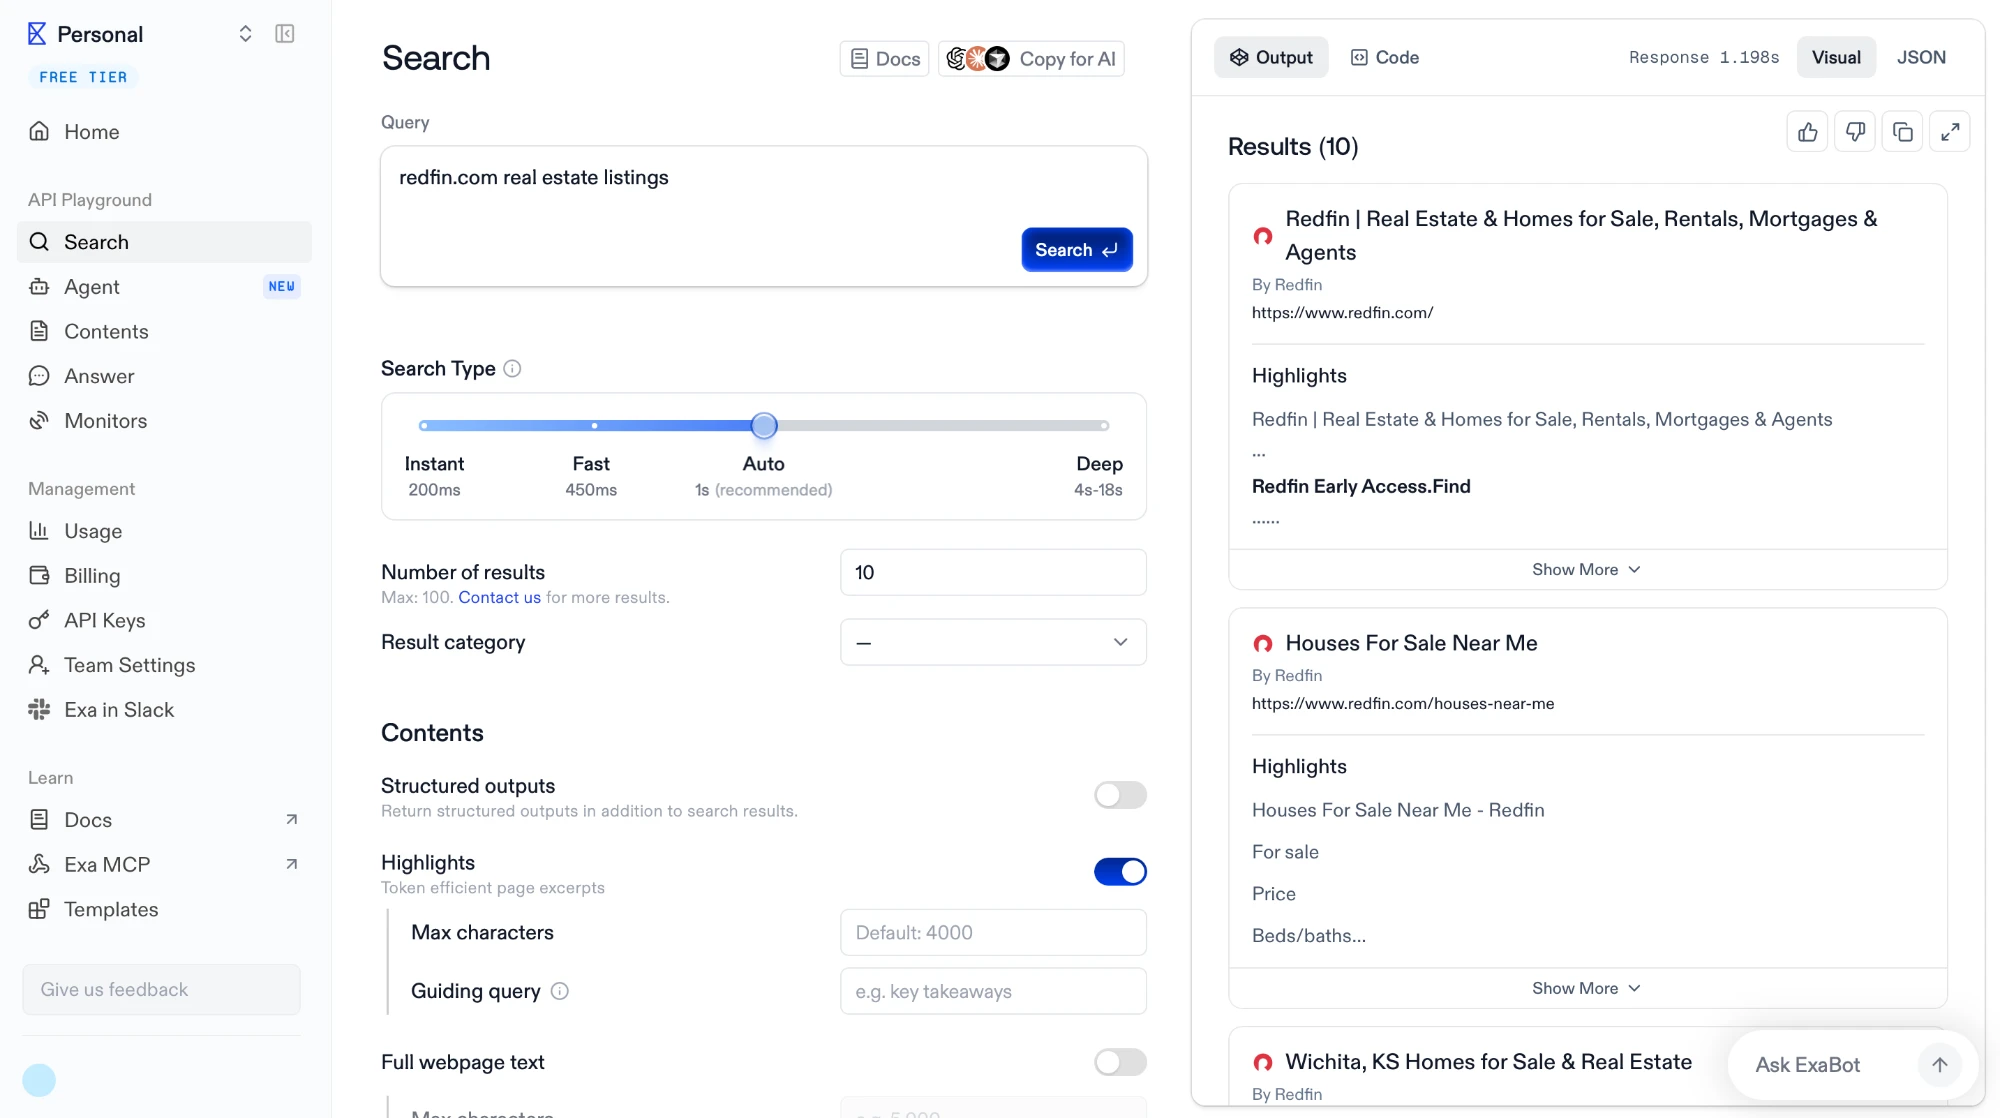
La página de inicio estaba en caché; la página de la ciudad de San Francisco no lo estaba. Buscar el dominio muestra por qué no es una simple cuestión de presencia o ausencia.
La consulta devolvió la página de inicio de Redfin, una página “Houses For Sale Near Me” y una página de la ciudad de Wichita, por lo que las páginas profundas existen en el índice. La cobertura está dispersa en un dominio en lugar de completa o vacía.
Limitaciones
La misma pantalla contiene la frase que separa a Exa de los archivos en esta comparación: “Número de resultados: 10. Máximo: 100. Contáctenos para obtener más resultados.”
No hay un recuento total. Common Crawl respondió a esa pregunta con una consulta SQL y Bright Data la respondió con un campo files_count.
No hay exportación masiva, ni entrega a su propio almacenamiento, ni firehose. El plan Enterprise menciona índices personalizados, que son índices a medida servidos a través de la API en lugar de datos entregados.
Cuál encaja con cada trabajo
Estos cuatro productos no son sustitutos. La cuestión no es cuál es el mejor, sino cuál responde a la pregunta que usted tiene.
- HTML sin procesar a escala, incluidos los sitios que bloquean rastreadores. Bright Data es el único que escribe una selección filtrada en un almacenamiento que usted controla y el único que tiene páginas de dominios que prohíben los rastreadores.
- Un corpus amplio sin coste, si usted tiene capacidad de ingeniería. Common Crawl le ofrece rastreos completos en WARC, enumerables con SQL, y no pide nada más allá de su propio cómputo. El procesamiento es suyo de construir.
- Texto de noticias, blogs y foros con entidades y sentimiento ya extraídos. Webz.io devuelve registros procesados en lugar de páginas, lo que elimina el trabajo de extracción pero también elimina el marcado.
- Contexto de página en el momento de la consulta, para un agente o un pipeline de RAG. Exa devuelve texto en caché en milisegundos y recurre a una descarga en vivo cuando una página no está almacenada, dentro de la misma llamada.
 Añadir como fuente preferida
Cómo probamos las APIs de archivo web
Trabajamos dentro de cada producto en lugar de a partir de su documentación. Primero manejamos cada proveedor a través de su propia consola o playground y luego a través de su API, de modo que pudiéramos ver la solicitud que genera la interfaz y lo que devuelve antes de que se cobre nada.
Para cada uno construimos una consulta, la ejecutamos y leímos la respuesta sin procesar en lugar del resumen renderizado. Cuando el producto devolvía un recuento, una estimación de costes o un objeto de estado, registrábamos esos campos directamente. Cuando ofrecía una muestra o una entrega, la tomábamos, desempaquetábamos los archivos y los abríamos.
Pequeños scripts se encargaron de las partes que requerían repetición o medición de tiempos: extraer un único registro de un archivo de varios terabytes, descomprimir un paquete entregado y buscar campos específicos en el HTML sin procesar, consultar un índice columnar con SQL y medir cuánto tarda una respuesta en caché frente a una que debe rastrearse. Esos scripts están enlazados junto a los resultados que produjeron.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Archivo web APIs: 4 proveedores principales probados y comparados}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/web-archive-api}},
  note   = {AIMultiple. Recuperado el 11 de agosto de 2026}
}Resultados y marcas de tiempo de 15 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 2 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia






Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.