


LLM Benchmark de enrutadores: 8 enrutadores en 523 tareas de base de datos con agentes

Probamos 8 LLM enrutadores en 523 tareas de base de datos con agentes y comparamos cada uno con modelos individuales en precisión y coste.
Resultados del benchmark de enrutadores con agentes
| Name | Series | $ per 1,000 questions, router fees included (log scale) | Score (%) | Score | Cost | Pool | Label |
|---|---|---|---|---|---|---|---|
| Fireworks Nexus Auto | Fireworks Nexus Auto | 1.93 | 35.95 | 35.9% | 1.9 | Router's own, open models | Fireworks Nexus Auto |
| Not Diamond | Not Diamond | 50.52 | 50.86 | 50.9% | 50.5 | 19 models | Not Diamond |
| NVIDIA Switchyard (Sol + Luna) | NVIDIA Switchyard (Sol + Luna) | 16.6 | 56.21 | 56.2% | 16.6 | GPT-6.1 Sol + GPT-6 Luna | NVIDIA Switchyard (Sol + Luna) |
| OpenRouter Auto | OpenRouter Auto | 1.97 | 28.68 | 28.7% | 2.0 | Router's own | OpenRouter Auto |
| OpenRouter Auto Code | OpenRouter Auto Code | 24.62 | 52.77 | 52.8% | 24.6 | Router's own | OpenRouter Auto Code |
| Sakana Fugu Max | Sakana Fugu Max | 29.96 | 27.34 | 27.3% | 30.0 | Router's own | Sakana Fugu Max |
| TypeSafe Jev | TypeSafe Jev | 2.09 | 29.45 | 29.4% | 2.1 | Router's own | TypeSafe Jev |
| Unbiased Pareto 26.10 | Unbiased Pareto 26.10 | 13.18 | 44.17 | 44.2% | 13.2 | Router's own | Unbiased Pareto 26.10 |
| Claude Fable 5 | Anthropic | 150.34 | 60.04 | 60.0% | 150.3 | single model | Claude Fable 5 |
| Claude Fable 5.1 | Anthropic | 718.96 | 62.91 | 62.9% | 719.0 | single model | Claude Fable 5.1 |
| Claude Fable 5.2 | Anthropic | 109.43 | 85.28 | 85.3% | 109.4 | single model | Claude Fable 5.2 |
| Claude Haiku 5.5 | Anthropic | 1.92 | 26.2 | 26.2% | 1.9 | single model | Claude Haiku 5.5 |
| Claude Opus 4.8 | Anthropic | 148.83 | 50.67 | 50.7% | 148.8 | single model | Claude Opus 4.8 |
| Claude Opus 5 | Anthropic | 77.8 | 60.99 | 61.0% | 77.8 | single model | Claude Opus 5 |
| Claude Opus 5.5 | Anthropic | 236.55 | 84.89 | 84.9% | 236.5 | single model | Claude Opus 5.5 |
| Claude Sonnet 5 | Anthropic | 76.64 | 34.42 | 34.4% | 76.6 | single model | Claude Sonnet 5 |
| Claude Sonnet 5.5 | Anthropic | 53.81 | 70.36 | 70.4% | 53.8 | single model | Claude Sonnet 5.5 |
| Command A Plus | Cohere | 9.19 | 30.21 | 30.2% | 9.2 | single model | Command A Plus |
| DeepSeek V4 Flash | DeepSeek | 2.91 | 30.4 | 30.4% | 2.9 | single model | DeepSeek V4 Flash |
| DeepSeek V4 Flash 0731 | DeepSeek | 1.66 | 33.84 | 33.8% | 1.7 | single model | DeepSeek V4 Flash 0731 |
| DeepSeek V4 Pro | DeepSeek | 11.28 | 35.37 | 35.4% | 11.3 | single model | DeepSeek V4 Pro |
| DeepSeek V4 Pro 0813 | DeepSeek | 13.95 | 40.92 | 40.9% | 13.9 | single model | DeepSeek V4 Pro 0813 |
| DeepSeek V4.1 Flash | DeepSeek | 4.25 | 30.78 | 30.8% | 4.2 | single model | DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash 1017 | DeepSeek | 2.05 | 20.65 | 20.7% | 2.0 | single model | DeepSeek V4.1 Flash 1017 |
| Gemini 3 Flash Preview | 9.37 | 59.66 | 59.7% | 9.4 | single model | Gemini 3 Flash Preview | |
| Gemini 3.1 Flash Lite | 6.95 | 42.07 | 42.1% | 6.9 | single model | Gemini 3.1 Flash Lite | |
| Gemini 3.1 Pro Preview | 90.04 | 60.42 | 60.4% | 90.0 | single model | Gemini 3.1 Pro Preview | |
| Gemini 3.5 Flash Lite | 8.52 | 48.76 | 48.8% | 8.5 | single model | Gemini 3.5 Flash Lite | |
| Gemini 3.6 Flash | 27.38 | 58.89 | 58.9% | 27.4 | single model | Gemini 3.6 Flash | |
| Gemini 3.7 Flash | 25.08 | 69.41 | 69.4% | 25.1 | single model | Gemini 3.7 Flash | |
| Gemini 3.8 Flash | 32.67 | 65.39 | 65.4% | 32.7 | single model | Gemini 3.8 Flash | |
| Gemini 4 Argon | 48.44 | 77.82 | 77.8% | 48.4 | single model | Gemini 4 Argon | |
| Gemini 4 Carbon | 75.67 | 77.25 | 77.2% | 75.7 | single model | Gemini 4 Carbon | |
| GLM 4.7 | Zhipu AI | 10.84 | 25.05 | 25.0% | 10.8 | single model | GLM 4.7 |
| GLM 5.1 | Zhipu AI | 12.8 | 38.43 | 38.4% | 12.8 | single model | GLM 5.1 |
| GLM 5.2 | Zhipu AI | 6.71 | 39.2 | 39.2% | 6.7 | single model | GLM 5.2 |
| GLM 5.3 | Zhipu AI | 24.27 | 38.62 | 38.6% | 24.3 | single model | GLM 5.3 |
| GLM 5.3 Flash | Zhipu AI | 4.22 | 36.14 | 36.1% | 4.2 | single model | GLM 5.3 Flash |
| GLM 5.3 Prime | Zhipu AI | 69.86 | 35.18 | 35.2% | 69.9 | single model | GLM 5.3 Prime |
| GPT-5.2 | OpenAI | 29.97 | 31.93 | 31.9% | 30.0 | single model | GPT-5.2 |
| GPT-5.4 Mini | OpenAI | 7.03 | 24.28 | 24.3% | 7.0 | single model | GPT-5.4 Mini |
| GPT-5.4 Nano | OpenAI | 2.85 | 21.03 | 21.0% | 2.8 | single model | GPT-5.4 Nano |
| GPT-5.5 | OpenAI | 75.52 | 44.93 | 44.9% | 75.5 | single model | GPT-5.5 |
| GPT-5.6 Luna | OpenAI | 13.87 | 33.46 | 33.5% | 13.9 | single model | GPT-5.6 Luna |
| GPT-5.6 Sol | OpenAI | 60.83 | 49.9 | 49.9% | 60.8 | single model | GPT-5.6 Sol |
| GPT-5.6 Terra | OpenAI | 30.71 | 39.39 | 39.4% | 30.7 | single model | GPT-5.6 Terra |
| GPT-6 Luna | OpenAI | 1.34 | 38.81 | 38.8% | 1.3 | single model | GPT-6 Luna |
| GPT-6 Luna Pro | OpenAI | 3.91 | 38.24 | 38.2% | 3.9 | single model | GPT-6 Luna Pro |
| GPT-6 Sol | OpenAI | 21.83 | 50.48 | 50.5% | 21.8 | single model | GPT-6 Sol |
| GPT-6 Sol Pro | OpenAI | 59.11 | 50.67 | 50.7% | 59.1 | single model | GPT-6 Sol Pro |
| GPT-6.1 Sol (reference) | OpenAI | 15.45 | 61.19 | 61.2% | 15.4 | single model, run with the routers | GPT-6.1 Sol (reference) |
| GPT-6.1 Sol (text-to-SQL) | OpenAI | 15.91 | 61.38 | 61.4% | 15.9 | single model | GPT-6.1 Sol (text-to-SQL) |
| GPT-6.1 Sol Pro | OpenAI | 44.12 | 59.85 | 59.8% | 44.1 | single model | GPT-6.1 Sol Pro |
| GPT-6.1 Terra | OpenAI | 8.76 | 53.54 | 53.5% | 8.8 | single model | GPT-6.1 Terra |
| GPT-OSS 120B | OpenAI | 0.597 | 19.89 | 19.9% | 0.6 | single model | GPT-OSS 120B |
| Grok 4.3 | xAI | 16.13 | 41.68 | 41.7% | 16.1 | single model | Grok 4.3 |
| Grok 4.5 | xAI | 26.24 | 48.57 | 48.6% | 26.2 | single model | Grok 4.5 |
| Grok 4.6 | xAI | 41.78 | 58.32 | 58.3% | 41.8 | single model | Grok 4.6 |
| Grok 4.7 | xAI | 37.1 | 48.37 | 48.4% | 37.1 | single model | Grok 4.7 |
| HY4 Preview | Tencent | 12.78 | 45.12 | 45.1% | 12.8 | single model | HY4 Preview |
| Kimi K2.6 | Moonshot AI | 19.13 | 43.79 | 43.8% | 19.1 | single model | Kimi K2.6 |
| Kimi K3 | Moonshot AI | 48.24 | 45.32 | 45.3% | 48.2 | single model | Kimi K3 |
| Kimi K3.1 Pro | Moonshot AI | 32 | 49.14 | 49.1% | 32.0 | single model | Kimi K3.1 Pro |
| Llama 4 Maverick | Meta | 6.1 | 28.11 | 28.1% | 6.1 | single model | Llama 4 Maverick |
| MiMo V2.6 Pro | Xiaomi | 4.93 | 38.81 | 38.8% | 4.9 | single model | MiMo V2.6 Pro |
| MiniMax M2.5 | MiniMax | 3.45 | 29.45 | 29.4% | 3.5 | single model | MiniMax M2.5 |
| MiniMax M3 | MiniMax | 4.85 | 34.03 | 34.0% | 4.9 | single model | MiniMax M3 |
| MiniMax M3.1 Flash | MiniMax | 2.71 | 33.84 | 33.8% | 2.7 | single model | MiniMax M3.1 Flash |
| Mistral Large 4.0 | Mistral AI | 18.65 | 26.77 | 26.8% | 18.7 | single model | Mistral Large 4.0 |
| Mistral Small 2603 | Mistral AI | 1.74 | 23.33 | 23.3% | 1.7 | single model | Mistral Small 2603 |
| Muse Ember | Meta | 2.99 | 37.48 | 37.5% | 3.0 | single model | Muse Ember |
| Muse Glimmer 30B | Meta | 6.4 | 31.17 | 31.2% | 6.4 | single model | Muse Glimmer 30B |
| Muse Spark 1.1 | Meta | 27.77 | 39.01 | 39.0% | 27.8 | single model | Muse Spark 1.1 |
| Muse Spark 1.2 | Meta | 39.56 | 45.89 | 45.9% | 39.6 | single model | Muse Spark 1.2 |
| Muse Spark 1.3 | Meta | 38.67 | 43.98 | 44.0% | 38.7 | single model | Muse Spark 1.3 |
| Muse Spark Open | Meta | 27.1 | 41.87 | 41.9% | 27.1 | single model | Muse Spark Open |
| Muse Wonder | Meta | 94.28 | 54.49 | 54.5% | 94.3 | single model | Muse Wonder |
| Nemotron 3 Ultra 550B A55B | NVIDIA | 25.28 | 31.93 | 31.9% | 25.3 | single model | Nemotron 3 Ultra 550B A55B |
| Qwen3.5 27B | Alibaba | 12.49 | 37.28 | 37.3% | 12.5 | single model | Qwen3.5 27B |
| Qwen3.6 27B | Alibaba | 19.48 | 47.8 | 47.8% | 19.5 | single model | Qwen3.6 27B |
| Qwen3.6 Flash | Alibaba | 8.69 | 34.23 | 34.2% | 8.7 | single model | Qwen3.6 Flash |
| Qwen3.7 Plus | Alibaba | 8.88 | 39.77 | 39.8% | 8.9 | single model | Qwen3.7 Plus |
| Qwen3.8 2.4T A95B | Alibaba | 32.28 | 48.76 | 48.8% | 32.3 | single model | Qwen3.8 2.4T A95B |
| Qwen3.8 27B | Alibaba | 14.25 | 43.4 | 43.4% | 14.2 | single model | Qwen3.8 27B |
| Qwen3.8 Flash | Alibaba | 2.5 | 41.68 | 41.7% | 2.5 | single model | Qwen3.8 Flash |
| Qwen3.8 Max | Alibaba | 30.54 | 46.27 | 46.3% | 30.5 | single model | Qwen3.8 Max |
| Qwen3.8 Max 0902 | Alibaba | 31.52 | 36.33 | 36.3% | 31.5 | single model | Qwen3.8 Max 0902 |
| Qwen3.8 Max Prime | Alibaba | 62.91 | 34.99 | 35.0% | 62.9 | single model | Qwen3.8 Max Prime |
| Solar Pro4 | Upstage | 2.14 | 23.33 | 23.3% | 2.1 | single model | Solar Pro4 |
| Tencent HY3 | Tencent | 2.05 | 43.21 | 43.2% | 2.1 | single model | Tencent HY3 |
Para cada uno de los 8 enrutadores, al menos un modelo individual que ejecutamos obtuvo una puntuación igual o superior y costó lo mismo o menos por pregunta. En el gráfico, el área verde marca los resultados que costaron menos que GPT-6.1 Sol y obtuvieron una puntuación superior al 50 %.
Para cada pregunta, el agente primero elige una de las 11 bases de datos y luego escribe consultas SQL contra ella. Puede llamar a un modelo hasta 10 veces por pregunta, y el enrutador elige el modelo para cada llamada. Un conjunto es el conjunto de modelos entre los que un enrutador puede elegir.
Puntuaciones por enrutador
| Label | Label short | CI low | CI high | Score (%) |
|---|---|---|---|---|
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 57.17 | 65.39 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 51.82 | 60.42 | 56.21 |
| OpenRouter Auto Code | Auto Code | 48.37 | 56.98 | 52.77 |
| Not Diamond (19 models) | Not Diamond | 46.46 | 55.07 | 50.86 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 39.96 | 48.37 | 44.17 |
| Fireworks Nexus Auto | Nexus Auto | 31.74 | 40.15 | 35.95 |
| TypeSafe Jev | TypeSafe Jev | 25.62 | 33.27 | 29.45 |
| OpenRouter Auto | OpenRouter Auto | 24.86 | 32.7 | 28.68 |
| Sakana Fugu Max | Fugu Max | 23.52 | 31.36 | 27.34 |
Los 8 enrutadores obtuvieron una puntuación claramente inferior a GPT-6.1 Sol. Switchyard quedó más cerca, 5.0 puntos por debajo. Su intervalo del 95 % se solapa con el de Sol, pero la prueba sobre las mismas preguntas separa a los dos (véase Estadísticas).
Cada enrutador frente a su modelo más utilizado
| Label | Label short | Router score | Alone score | Main model name | Main model short | Main model share | Router | Most used model |
|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 28.7% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 99% | 28.68 | 26.2 |
| TypeSafe Jev | TypeSafe Jev | 29.4% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 98% | 29.45 | 26.2 |
| Fireworks Nexus Auto | Nexus Auto | 35.9% | 36.1% | GLM 5.3 Flash | GLM 5.3 Flash | 99% | 35.95 | 36.14 |
| Not Diamond (19 models) | Not Diamond | 50.9% | 49.9% | GPT-5.6 Sol | GPT-5.6 Sol | 100% | 50.86 | 49.9 |
| OpenRouter Auto Code | Auto Code | 52.8% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 71% | 52.77 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 56.2% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 75% | 56.21 | 61.19 |
De los seis enrutadores que indican su modelo, cuatro obtuvieron una puntuación dentro de 3.3 puntos de su modelo más utilizado. Switchyard repartió sus llamadas entre GPT-6.1 Sol y GPT-6 Luna, y Auto Code entre GPT-6.1 Sol y GLM 5.3. Obtuvieron 5.0 y 8.4 puntos por debajo de Sol.
Los enrutadores no compartían un mismo conjunto, por lo que estas diferencias reflejan tanto al enrutador como a los modelos que podía elegir. La sección del conjunto compartido compara tres enrutadores con los mismos dos modelos. Nosotros establecimos los conjuntos para Switchyard y Not Diamond (véase Enrutadores y conjuntos).
Tiempo por pregunta
| Label | Label short | Sec label | Seconds |
|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 8.8 s | 8.8 |
| TypeSafe Jev | TypeSafe Jev | 9.0 s | 8.96 |
| OpenRouter Auto Code | Auto Code | 10.4 s | 10.42 |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 10.7 s | 10.69 |
| Fireworks Nexus Auto | Nexus Auto | 10.8 s | 10.81 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 12.7 s | 12.68 |
| Sakana Fugu Max | Fugu Max | 13.3 s | 13.28 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 15.4 s | 15.44 |
| Not Diamond (19 models) | Not Diamond | 17.3 s | 17.28 |
Not Diamond con 19 modelos y Switchyard fueron los enrutadores más lentos. Tardaron 17.3 y 15,4 segundos por pregunta en la mediana. GPT-6.1 Sol tardó 10,7 segundos. OpenRouter Auto y Jev fueron los más rápidos, con 8.8 y 9,0 segundos. Ambos enviaron casi todas las llamadas a Claude Haiku 5.5.
Las llamadas de Auto Code a GPT-6.1 Sol se ejecutaron en el nivel prioritario. Generaron en 1,5 segundos en la mediana, frente a 1,8 segundos para GPT-6.1 Sol sin un enrutador. El enrutamiento a través de Auto Code añadió unos 0,2 segundos por llamada. Por pregunta, los dos tardaron aproximadamente lo mismo, 10.4 y 10,7 segundos en la mediana.
Costes y tarifas de los enrutadores
| Label | Label short | Total | Per correct | Billed | Computed from list prices |
|---|---|---|---|---|---|
| Fireworks Nexus Auto | Nexus Auto | $1.9 | $5.4 | — | 1.93 |
| OpenRouter Auto | OpenRouter Auto | $2.0 | $6.9 | 1.97 | — |
| TypeSafe Jev | TypeSafe Jev | $2.1 | $7.1 | 2.09 | — |
| Unbiased Pareto 26.10 | Unbiased Pareto | $13.2 | $29.8 | 13.18 | — |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | $15.4 | $25.2 | 15.45 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | $16.6 | $29.5 | 16.6 | — |
| OpenRouter Auto Code | Auto Code | $24.6 | $46.6 | 24.62 | — |
| Sakana Fugu Max | Fugu Max | $30.0 | $109.6 | 29.96 | — |
| Not Diamond (19 models) | Not Diamond | $50.5 | $99.3 | 43.76 | 6.76 |
El coste de un enrutador es la factura del modelo más cualquier comisión de juez o de selección. Si un intento falló y la pregunta se ejecutó de nuevo, contamos solo el intento final. En el gráfico, las partes rayadas se calculan a partir de listas de precios y el resto procede de facturas.
Fireworks Nexus Auto costó lo mínimo por respuesta correcta, $5,4 por 1.000 respuestas correctas a precios de lista. Entre los enrutadores con coste facturado, OpenRouter Auto costó lo mínimo, $6.9.
Algunos enrutadores costaron más que su modelo más utilizado. El coste adicional provino del juez de Switchyard, de la comisión de selección de Not Diamond y del nivel prioritario en las llamadas de Auto Code a GPT-6.1 Sol. En cada caso, el enrutador no obtuvo una puntuación claramente superior a la de su modelo más utilizado.
Coste frente a modelos individuales
Cuatro enrutadores costaron más que GPT-6.1 Sol, que obtuvo una puntuación del 61,2 % por $15,4 por 1.000 preguntas. Los cuatro obtuvieron una puntuación inferior:
- Not Diamond con 19 modelos: 50,9 % por $50.5. La mayor parte correspondió a sus llamadas a GPT-5.6 Sol, y su comisión de selección añadió $6,8 (véase Tarifas y niveles de precios).
- Sakana Fugu Max: 27,3 %, la puntuación más baja de los 8 enrutadores, por $30.0. No indica su modelo. Realizó 6.8 llamadas de modelo por pregunta, frente a 5.5 para GPT-6.1 Sol. Su llamada media costó unas 1.6 veces una llamada a GPT-6.1 Sol.
- OpenRouter Auto Code: 52,8 % por $24.6. Envió el 71 % de las llamadas a GPT-6.1 Sol, y casi todas se ejecutaron en el nivel prioritario de OpenAI (véase Tarifas y niveles de precios).
- NVIDIA Switchyard: 56,2 % por $16.6. Sus llamadas a GPT-6.1 Sol y GPT-6 Luna costaron $13,7, menos que los $15,4 de Sol. Su modelo juez añadió $2,9 (véase Tarifas y niveles de precios).
Ninguno de los tres enrutadores más baratos obtuvo una puntuación superior a GPT-6 Luna, que obtuvo un 38,8 % por $1,3 por 1.000 preguntas. OpenRouter Auto y TypeSafe Jev obtuvieron unos 10 puntos menos, 28,7 % y 29,4 %, por $2,0 y $2.1. Fireworks Nexus Auto obtuvo un 35,9 % por $1,9, sin una diferencia clara con Luna.
Tarifas y niveles de precios
- Para elegir un modelo en cada llamada, Switchyard primero comprueba los resultados de las herramientas hasta el momento. Los errores y los fallos repetidos apuntan al modelo más potente. Cuando los resultados de las herramientas no deciden la elección, como en la primera llamada de una pregunta, un pequeño modelo juez, Gemini 3.5 Flash Lite, lee la pregunta y elige el modelo.1 Cada llamada al juez se factura como una llamada de modelo normal. En el conjunto compartido, el juez añadió $3,2 por 1.000 preguntas.
- Not Diamond cobra una comisión por cada selección de modelo. Contamos cada selección a $0,001, el precio de su lista de precios.2 En el conjunto compartido, la comisión ascendió a $6,3 por 1.000 preguntas, el 40 % del total de $15,8 de Not Diamond.
- Auto Code obtuvo el nivel prioritario de OpenAI en casi todas sus llamadas a GPT-6.1 Sol. Pagó 2.04 veces el precio por llamada de GPT-6.1 Sol. OpenRouter indica que el nivel prioritario de un modelo cerrado solo se utiliza cuando una solicitud lo pide o fija el proveedor,3 pero nuestras solicitudes no hicieron ninguna de las dos cosas. Sin el nivel, Auto Code habría costado unos $13 por 1.000 preguntas en lugar de $24.6.
Con 19 modelos, las llamadas de Not Diamond a GPT-5.6 Sol costaron $43,8 por 1.000 preguntas, frente a $60,8 para GPT-5.6 Sol en nuestro benchmark de texto a SQL. Un descuento por caché puede explicar la diferencia. Not Diamond obtuvo el precio en caché en el 69,5 % de sus tokens de entrada. Nuestra ejecución de texto a SQL no registró el uso de caché, por lo que no podemos confirmarlo.
Elección y cambio de modelo
| Label | Label short | Claude Haiku 5.5 | DeepSeek V4.1 Flash | GLM 5.3 | GLM 5.3 Flash | GPT-5.6 Sol | GPT-6 Luna | GPT-6.1 Sol | Other |
|---|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 98.63 | 1.37 | — | — | — | — | — | — |
| TypeSafe Jev | TypeSafe Jev | 98.29 | 1.03 | 0.3206 | — | — | — | 0.1425 | 0.2138 |
| Fireworks Nexus Auto | Nexus Auto | — | — | 1.15 | 98.85 | — | — | — | — |
| Not Diamond (19 models) | Not Diamond, 19 models | — | — | — | — | 100 | — | — | — |
| OpenRouter Auto Code | Auto Code | — | — | 29.43 | — | — | — | 70.57 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard, Sol + Luna | — | — | — | — | — | 25.02 | 74.98 | — |
De las 9 ejecuciones de enrutadores con configuración predeterminada que indican el modelo, cinco enviaron al menos el 98 % de sus llamadas a un solo modelo. Fueron OpenRouter Auto en su propio conjunto, Jev, Nexus Auto y Not Diamond en ambos conjuntos.
La lista de 19 modelos de Not Diamond también incluía Gemini 3 Flash Preview, que obtuvo un 59,7 % por $9,4 por 1.000 preguntas. Ninguna de las selecciones de Not Diamond fue a Gemini 3 Flash Preview. Todas las llamadas fueron a GPT-5.6 Sol, que obtuvo un 49,9 %.
Cambio dentro de una pregunta
Con la configuración predeterminada, solo Switchyard cambió de modelo en más del 5 % de las preguntas. Lo hizo en 308 de 523 preguntas con GPT-6.1 Sol y GPT-6 Luna, y en 35 en el conjunto compartido.
Cada pregunta se ejecutó como una sesión de enrutador, con la misma clave de sesión en cada llamada. Los documentos de Switchyard de OpenRouter y los documentos de Pareto recomiendan esto para agentes. Una clave de sesión no impide que un enrutador cambie de modelo. La mayoría de los enrutadores pueden elegir un modelo para cada llamada. Los documentos de Auto de OpenRouter dicen que un cambio cuesta más, porque el nuevo modelo debe reconstruir la caché del prompt. Por eso Auto cambia solo cuando merece la pena. Los documentos de Nexus Auto de Fireworks dicen que elige un modelo para cada nuevo mensaje del usuario y lo mantiene para las llamadas a herramientas de ese mensaje. Nuestro agente envía un mensaje de usuario con la pregunta y un segundo que pide la respuesta final. Los 9 cambios de Nexus Auto se produjeron en ese segundo mensaje.
Comparación con mezcla aleatoria
Comparamos Switchyard en ambos conjuntos y Auto Code con una mezcla aleatoria. La mezcla aleatoria responde cada pregunta con un modelo, elegido al azar según las proporciones de llamadas del enrutador. Su puntuación esperada procede de nuestras ejecuciones de modelos individuales.
Switchyard con Sol y Luna obtuvo un 56,2 %, frente al 55,7 % de su mezcla aleatoria. Switchyard en el conjunto compartido obtuvo un 55,1 % frente a 52,4 %. Auto Code obtuvo un 52,8 % frente a 54,7 %. Ninguno de los tres enrutadores lo hizo claramente mejor o peor que su mezcla aleatoria.
Tres enrutadores con un mismo conjunto
| Label | Label short | Cost label | Same two models, three routers |
|---|---|---|---|
| Not Diamond, cost setting | Not Diamond, cost | $12.8 | 59.66 |
| Gemini 3 Flash Preview (no router) | Gemini (no router) | $9.4 | 59.66 |
| Not Diamond, default setting | Not Diamond, default | $15.8 | 59.27 |
| NVIDIA Switchyard | Switchyard | $11.2 | 55.07 |
| OpenRouter Auto | OpenRouter Auto | $3.4 | 32.89 |
| DeepSeek V4 Flash (no router) | DeepSeek (no router) | $2.9 | 30.4 |
Para separar los modelos del enrutamiento, dimos a tres enrutadores los mismos dos modelos. Gemini 3 Flash Preview es el potente, y DeepSeek V4 Flash es el barato.
Resultados del conjunto compartido
Con la configuración predeterminada, ningún enrutador mostró una diferencia clara respecto a su modelo más utilizado, y ninguno obtuvo una puntuación superior a Gemini 3 Flash Preview.
Not Diamond obtuvo 1.9 puntos por debajo de GPT-6.1 Sol, y Switchyard 6.1 puntos por debajo. Nuestra prueba no confirmó estas diferencias.
- Con su configuración predeterminada, Not Diamond envió el 100 % de las llamadas a Gemini 3 Flash Preview. Obtuvo un 59,3 % frente al 59,7 % de Gemini 3 Flash Preview. Costó $15,8 por 1.000 preguntas frente a $9.4.
- Con su configuración de coste, Not Diamond envió el 62 % de las llamadas a DeepSeek V4 Flash. Aun así, dio cada respuesta final con Gemini 3 Flash Preview. Obtuvo un 59,7 %, igual que Gemini 3 Flash Preview, por $12,8 frente a $9.4. Su comisión de selección, $7,5, fue mayor que el coste de sus llamadas de modelo.
- Switchyard envió el 75 % de las llamadas a Gemini 3 Flash Preview y obtuvo un 55,1 %, sin una diferencia clara con Not Diamond.
- Auto envió el 97 % de las llamadas a DeepSeek V4 Flash y obtuvo un 32,9 %, cerca del 30,4 % de DeepSeek V4 Flash.
Adecuación del modelo y límite de llamadas
No encontramos ninguna señal clara de que algún enrutador eligiera el modelo para adaptarse a la pregunta en este conjunto. Hay 170 preguntas que Gemini 3 Flash Preview resuelve y DeepSeek V4 Flash falla, y 17 donde ocurre lo contrario. Cada enrutador envió una proporción similar de sus llamadas a DeepSeek V4 Flash en ambos conjuntos, con una diferencia máxima de 10 puntos. El conjunto de 17 es demasiado pequeño para mostrar una diferencia pequeña.
Auto alcanzó el límite de 10 llamadas con mayor frecuencia, en el 37,3 % de las preguntas, frente al 18,9 % de Switchyard y el 16,8 % de Not Diamond.
OpenRouter Auto también fue el que más tardó en este conjunto, 17,5 segundos por pregunta en la mediana. Not Diamond tardó 9,0 segundos con los mismos dos modelos.
Cada enrutador en resumen
Not Diamond
El enrutador predeterminado de Not Diamond viene preentrenado, por lo que no hay que entrenarlo antes de usarlo. También se puede entrenar un enrutador personalizado con tus propios datos.4 Not Diamond no llama al modelo. Devuelve el nombre del modelo que elige, y tu propio código llama después a ese modelo. Los demás enrutadores realizan la llamada ellos mismos. De forma predeterminada, Not Diamond elige por calidad. Una configuración de compensación en cada solicitud puede hacer que prefiera el coste o la latencia en su lugar.5 Usamos el enrutador predeterminado y ejecutamos su configuración de coste una vez, en el conjunto compartido.
NVIDIA Switchyard
Switchyard se ejecuta en OpenRouter. Indicas hasta tres modelos, y elige entre el más barato y el más caro de ellos. No añade ninguna comisión de enrutamiento propia.1
OpenRouter Auto
OpenRouter Auto elige un modelo y un nivel de razonamiento para cada solicitud y no añade ninguna comisión.6 Una lista en `allowed_models` es un límite estricto, y un nivel de coste bajo, medio o alto define la política. La documentación dice que la opción predeterminada cuesta más que el Auto antiguo y sugiere el nivel bajo para mantener los costes más cercanos a él. En nuestra prueba, el nivel bajo obtuvo un 28,3 % frente al 28,7 % de la opción predeterminada, al mismo coste de $2,0 por 1.000 preguntas, sin una diferencia clara.
OpenRouter Auto Code
Auto Code se ejecuta en el mismo motor que Auto, con una política ajustada para agentes de programación, y no añade ninguna comisión.7 Prefiere cambiar el nivel de razonamiento antes que cambiar de modelo, para mantener la caché del prompt. Trata `allowed_models` como un límite estricto. Cuando le dimos el conjunto compartido, todas las solicitudes fallaron con un error que decía que ningún modelo medido cumplía la solicitud.
TypeSafe Jev
Jev elige un modelo y un nivel de razonamiento para cada solicitud, y cada solicitud se factura al precio del modelo al que va.8 Una lista de modelos es solo una preferencia, y solo `excluded_models` bloquea un modelo.9 Su puntuación no mostró una diferencia clara con OpenRouter Auto. A fecha de 14 de noviembre de 2026, la página de benchmark de enrutadores de OpenRouter dice que Auto ahora funciona con Jev.10
Fireworks Nexus Auto
Nexus Auto es un enrutador de Fireworks, llamado con el id de modelo auto. No admite una lista de modelos. Con una clave de Fireworks, elige entre los modelos abiertos de Fireworks.11
Unbiased Pareto 26.10
OpenRouter lista Unbiased Pareto 26.10 a $0,80 por millón de tokens de entrada y $3,20 por millón de tokens de salida.12 No admite una lista de modelos, y la página no dice cómo elige un modelo ni qué modelos utiliza. Sus respuestas solo nombran al enrutador. Obtuvo un 44,2 % por $13,2 por 1.000 preguntas, más bajo y más caro que Gemini 3 Flash Preview.
Sakana Fugu Max
Sakana dice que Fugu Max ejecuta su mayor conjunto de modelos. El conjunto es fijo, y Sakana no enumera todos sus miembros. Cuesta $2 por millón de tokens de entrada y $6 por millón de tokens de salida, más $0,007 por cada llamada interna a herramientas web.13
Metodología del benchmark de enrutadores con agentes
Todos los enrutadores recibieron el mismo agente, prompt, herramientas y orden de preguntas. Un proxy local registró el modelo, los tokens, el coste y la duración de cada llamada.
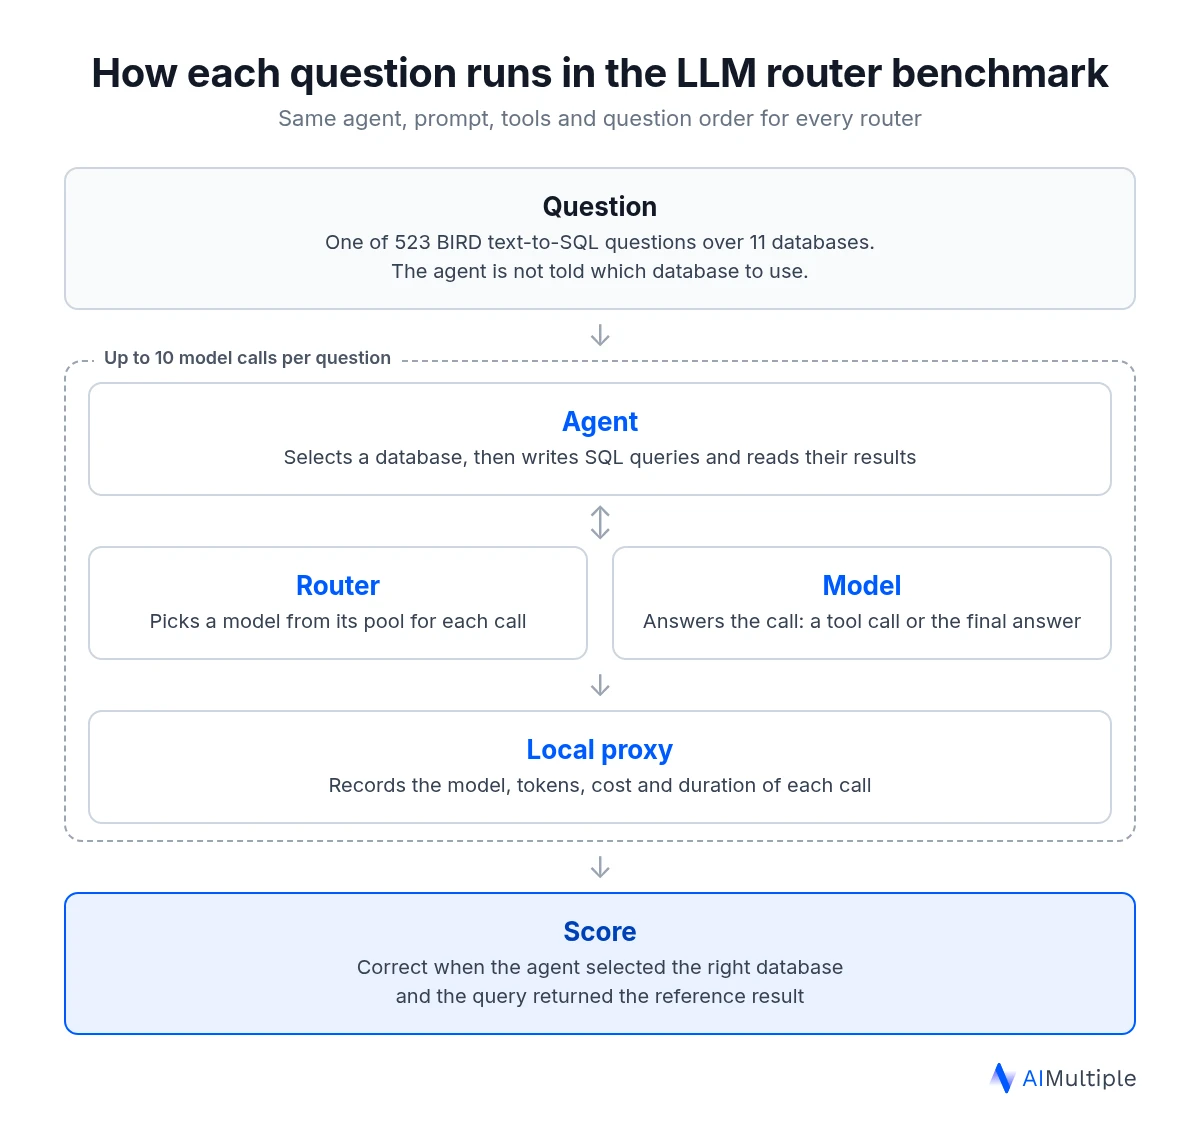
Usamos 523 preguntas de nuestro benchmark de texto a SQL, que se basa en BIRD, un conjunto de datos público de texto a SQL. Al agente no se le dice cuál de las 11 bases de datos debe usar, y los nombres de las bases de datos se sustituyen por alias. Una pregunta se considera correcta cuando el agente elige la base de datos correcta y su consulta devuelve el resultado de referencia. Un error cuenta como un fallo. Cada solicitud puede tardar hasta 600 segundos.
Llamamos a seis enrutadores a través de OpenRouter con los ids openrouter/auto, openrouter/auto-code, typesafe/jev-router, nvidia/switchyard, unbiased/pareto-26.10 y sakana/fugu-max. Not Diamond se ejecutó a través de su API modelSelect, y llamamos a cada modelo que eligió a través de OpenRouter. Fireworks Nexus Auto se ejecutó a través de la API de Fireworks. También ejecutamos GPT-6.1 Sol sin enrutador con la misma configuración. Las demás puntuaciones de modelos individuales proceden de nuestro benchmark de texto a SQL sobre las mismas 523 preguntas.
El tiempo es la mediana de segundos por pregunta, medido por nuestra parte a lo largo de todos los pasos del agente. Cada enrutador y conjunto se ejecutó una vez, del 13 al 16 de noviembre de 2026. Todas las preguntas terminaron sin errores.
Enrutadores y conjuntos
Incluimos enrutadores que tenían una API pública en el momento de la ejecución y aceptaban llamadas a herramientas. OpenRouter Auto y Auto Code se ejecutaron después del 6 de noviembre de 2026, cuando OpenRouter reconstruyó Auto y lanzó Auto Code.14
Seis enrutadores se ejecutaron con su propio conjunto y con los valores predeterminados del proveedor. Nosotros establecimos el conjunto para Switchyard y Not Diamond. Sin una lista de modelos, Switchyard toma dos de los 20 modelos con mayor gasto en OpenRouter durante los últimos siete días, por lo que la pareja cambia con el tiempo. Para mantener la pareja fija, le dimos GPT-6.1 Sol y GPT-6 Luna. Not Diamond requiere una lista de modelos. Le dimos 19 modelos que admite y que también probamos en nuestro benchmark de texto a SQL.
Para comparar el enrutamiento con los mismos modelos, ejecutamos Not Diamond, NVIDIA Switchyard y OpenRouter Auto en un conjunto compartido. Estas ejecuciones no están clasificadas.
Un enrutador solo podía participar si se ajustaba a la lista de modelos que le dimos. Not Diamond no admite GPT-6.1 Sol ni GPT-6 Luna, la pareja que Switchyard utilizó anteriormente. Así que elegimos Gemini 3 Flash Preview y DeepSeek V4 Flash, un modelo potente y uno barato que admite.15 Switchyard y OpenRouter Auto tomaron la misma lista. Los otros cinco enrutadores no pudieron mantenerse en esta lista (véase Cada enrutador en resumen).
También probamos OpenRouter Pareto Code, pero no lo clasificamos. El usuario elige uno de los tres niveles. Dentro de un nivel, envía las llamadas al modelo disponible más barato y no adapta su elección a cada turno.
El 13 de noviembre, el nivel predeterminado de Pareto Code incluía un modelo, Claude Fable 5.2. En el nivel medio que elegimos, Pareto Code envió las 3.083 llamadas a Kimi K3 y obtuvo un 43,0 % por $28,4 por 1.000 preguntas.
Estadísticas
Los corchetes del gráfico de puntuaciones muestran un intervalo de confianza del 95 %, calculado con bootstrap sobre las 523 preguntas. Muestra cuánto depende una puntuación de qué preguntas se eligieron.
Para comparar dos resultados en las mismas preguntas, utilizamos una prueba exacta de McNemar. Cuenta solo las preguntas que un resultado acertó y el otro falló. Como hicimos muchas comparaciones, ajustamos los resultados con el método de Holm a un nivel del 5 %. Cuando la prueba no separa dos resultados, decimos que no hay una diferencia clara.
Por ejemplo, Switchyard en el conjunto compartido quedó 6.1 puntos por debajo de GPT-6.1 Sol, sin una diferencia clara. Con Sol y Luna, quedó 5.0 puntos por debajo, y esa diferencia es clara. En el conjunto compartido, Switchyard y Sol discreparon en 146 preguntas, donde uno acertó y el otro falló. Con Sol y Luna, discreparon en solo 44. Cuando más preguntas discrepan, una diferencia debe ser mayor antes de llamarla clara.
Las comparaciones de enrutadores con GPT-6.1 Sol usan su ejecución del 61,2 % con la misma configuración que los enrutadores. Las mezclas aleatorias y otras comparaciones de modelos individuales usan la ejecución del 61,4 % de Sol de nuestro benchmark de texto a SQL. En el primer gráfico está etiquetado como GPT-6.1 Sol (texto a SQL). No hay una diferencia clara entre las dos ejecuciones.
Limitaciones
- Una ejecución por enrutador y conjunto. En las dos ejecuciones de GPT-6.1 Sol, 33 preguntas fueron correctas en una ejecución y erróneas en la otra.
- Un tipo de tarea, con hasta 10 llamadas de modelo por pregunta. Las tareas de agente más largas pueden dar otros resultados.
- Las elecciones de modelo cambian con la fecha. Volvimos a ejecutar 17 preguntas en OpenRouter Auto, Auto Code y Jev el 17 de noviembre, cuatro días después de que comenzaran sus ejecuciones. Los enrutadores eligieron dos modelos que no habíamos visto en esas ejecuciones. Auto Code envió el 63 % de sus llamadas a uno de ellos.
- El límite de 10 llamadas afectó a Sakana Fugu Max en el 16,1 % de las preguntas. Incluso si hubiera respondido correctamente todas esas, seguiría puntuando por debajo de GPT-6.1 Sol.
- Conjuntos distintos de los tres que establecimos pueden dar otros resultados.
- La comisión de selección de Not Diamond utiliza $0,001 por selección, la tarifa de su antigua página de precios. Su página actual cobra $0,05 por millón de tokens enrutados.
- Las preguntas proceden de los conjuntos públicos de BIRD, por lo que los modelos pueden haberlas visto durante el entrenamiento.
 Añadir como fuente preferida
Preguntas frecuentes
Un enrutador de LLM se sitúa entre una aplicación y un conjunto de modelos y elige un modelo para cada solicitud. El objetivo es enviar el trabajo fácil a un modelo barato y el trabajo difícil a uno potente. En un agente, una pregunta requiere varias llamadas, por lo que un enrutador puede elegir otro modelo para cada llamada.
De los 8 enrutadores, NVIDIA Switchyard obtuvo la puntuación más alta, 56,2 %. OpenRouter Auto Code obtuvo 52,8 % y Not Diamond con 19 modelos obtuvo 50,9 %. No hay una diferencia clara entre Switchyard y Auto Code, ni entre Auto Code y Not Diamond.
En el conjunto compartido, Not Diamond obtuvo 59,3 %, la puntuación más alta de cualquier enrutador con su configuración predeterminada. Switchyard obtuvo 55,1 % en ese conjunto, sin una diferencia clara con Not Diamond.
No en esta prueba. Cada uno de los 8 enrutadores obtuvo una puntuación claramente inferior a GPT-6.1 Sol.
En el conjunto compartido, Not Diamond quedó 1.9 puntos por debajo de GPT-6.1 Sol y Switchyard 6.1 puntos por debajo. Nuestra prueba no confirmó estas diferencias.
Fireworks Nexus Auto tuvo el coste más bajo, $1,9 por 1.000 preguntas, calculado a partir de los precios de lista. OpenRouter Auto costó $2,0 y TypeSafe Jev $2.1. Cada uno envió casi todas las llamadas a un modelo barato: Claude Haiku 5.5 para OpenRouter Auto y TypeSafe Jev, y GLM 5.3 Flash para Nexus Auto.
Not Diamond obtuvo 59,3 % en el conjunto compartido y 50,9 % con 19 modelos. OpenRouter Auto obtuvo 32,9 % en el conjunto compartido y 28,7 % en su propio conjunto. Switchyard obtuvo 56,2 % con GPT-6.1 Sol y GPT-6 Luna y 55,1 % en el conjunto compartido, una diferencia de 1.1 puntos sin una diferencia clara.
Lecturas adicionales
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{yila2026,
  author = {Yıla, Berkay},
  title  = {{LLM Benchmark de enrutadores: 8 enrutadores en 523 tareas de base de datos con agentes}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/llm-router}},
  note   = {AIMultiple. Recuperado el 18 de noviembre de 2026}
}Resultados y marcas de tiempo de 135 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 7 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.