


AIM-Decision: Jev versus Clef versus LLMs
Models de decisão, também chamados de System One models,1 pontuam um conjunto fixo de opções em vez de gerar texto token por token. Testamos 59 models de decisão em 1.655 perguntas de classificação, como classificar uma falha de segurança ou um recall de produto, e executamos 46 deles em 50 tarefas de navegador. Veja AIM System One Index para os resultados combinados.
Resultados do benchmark de classificação
- decider-12b marcou 46.4 em falhas de segurança e 62.4 em recalls, a $0,06 por 1.000 decisões. Nenhum model de decisão marcou significativamente mais em nenhuma das duas tarefas.
- Jev 1.13 custou $0,039 por 1.000 decisões e marcou 47.9, cerca de um ponto abaixo de Kev-9B e Nimble 9B, que custam cerca de 7 e 9 vezes mais.
- pplx-decider-v1.1-27b e Mercury Decide marcaram 48.7 e 48.1, acima dos 47.9 do Jev, por cerca de um terço do custo dele.
- Eikos-27B, com 27 bilhões de parâmetros, custou $0,073 por 1.000 decisões. Tev1 4B, com 4 bilhões, custou $0.34.
- Strands Decider 2B marcou 62.6 em recalls, o mais alto de qualquer model, e 33.9 em falhas de segurança, onde respostas aleatórias têm média de 25.
- GLiDE marcou 46.5 em falhas de segurança contra 46.4 do decider-12b, mas levou 15,7 segundos por decisão contra 0.13 e custou $0,48 por 1.000 decisões. GLiDE v2 teve média de 49.0 nas duas tarefas com 0,47 segundos e $0.10. Clef teve média de 51.0 a $0,17 via Cloudflare’s API.
Taxas de sucesso da automação de navegador
Uma tentativa por tarefa; os LLMs rodaram na configuração de baixo esforço de raciocínio da API deles.
- Solar Decide, Solar Decide Flash e ambas as versões de Nimble 9B, Tev1 4B e Tev1 0.8B não estão classificados porque aceitam no máximo 26 opções por pergunta, e 17 das 50 tarefas abrem em uma página com mais. Laya e Strands Decider 2B também estão fora, porque seus limites de entrada rejeitaram pedidos que os outros models receberam integralmente.
- SubQ Snap completou 41 tarefas, duas a menos que Gemini 3.8 Flash e seis a menos que GPT-6 Astra. Custou estimados $0,001 por tarefa concluída, contra $0,025 para Gemini e $0,226 para Astra.
- Models de decisão juntos completaram 49 das 50 tarefas, incluindo todas as três que Astra falhou.
- decider-12b, primeiro em classificação, completou 16 tarefas de navegador; Kev-27B, que marcou abaixo de Jev em classificação, completou 40. JEV-27B-VL, destilado de Jev 1.13 conforme seu model card,2 marcou 45.8 contra 47.9 do Jev e completou 24 tarefas de navegador contra 18 do Jev.
Veja 10 tarefas de exemplo e o resultado de cada model em Hugging Face, e como executamos o benchmark sob metodologia.
Models de decisão versus LLMs em tarefas de navegador
A maioria dos LLMs escreve sua resposta um token por vez, e cada token custa computação e tempo. Na maioria das etapas de navegador, o agente apenas escolhe uma operação e um controle na página.
Um model de decisão lê a página e as opções, pontua cada opção e retorna a mais provável. Ele retorna uma probabilidade para cada opção em vez de texto gerado, então uma etapa não precisa de saída longa. Se os models de decisão se tornarem precisos o suficiente, a mesma automação poderá rodar muito mais rápido e a uma fração do custo de LLM.
Os models de decisão, como os servimos, retornam pontuações de opções e nenhum texto, então um model de texto separado, Mercury 2.5,3 escreve os valores digitados nos campos de formulário. Chamamos isso de auxiliar de texto, e ele estava disponível para todos os models.
Executamos todos os models no runtime de código aberto jev-ultrafast do browser-use,4 que foi criado para Jev 1.13 da TypeSafe.5 GPT-6 Astra serve como referência de LLM high-end e Gemini 3.8 Flash como uma de baixo custo. Todos os models estão listados na metodologia.
Cinco models na mesma tarefa
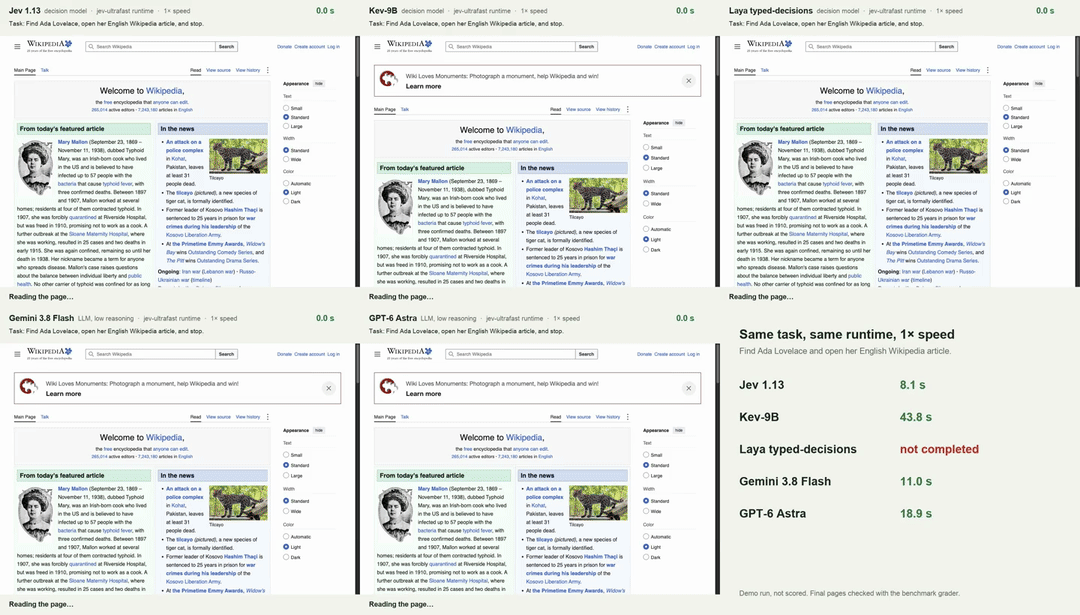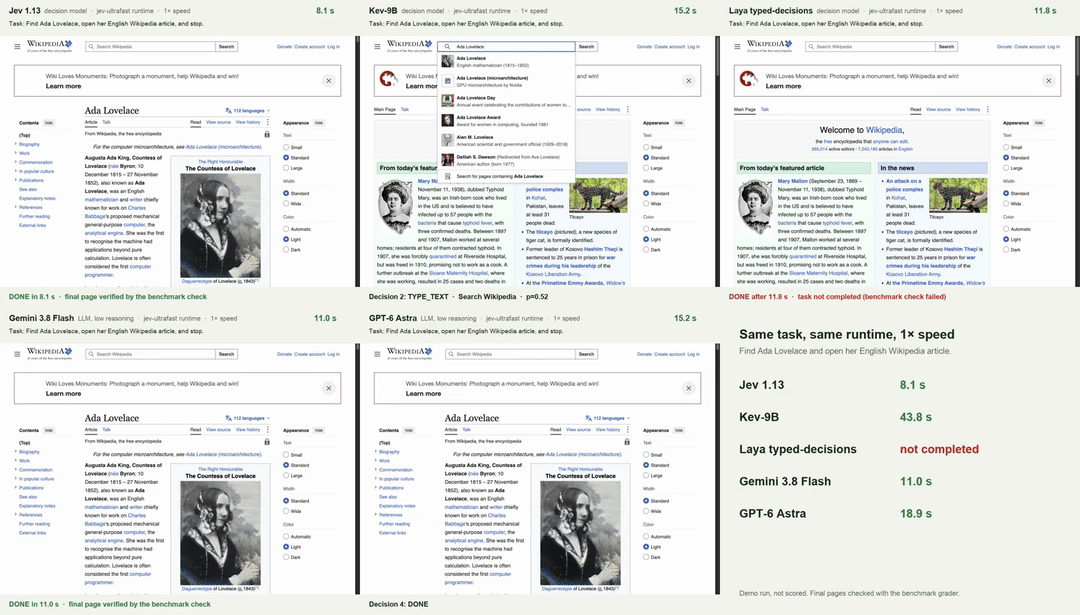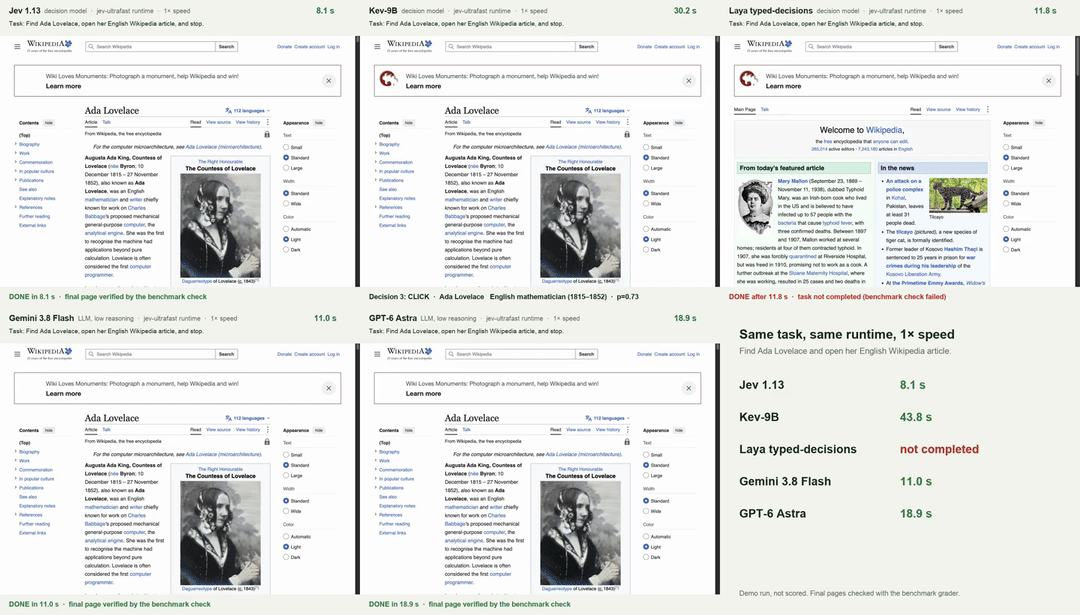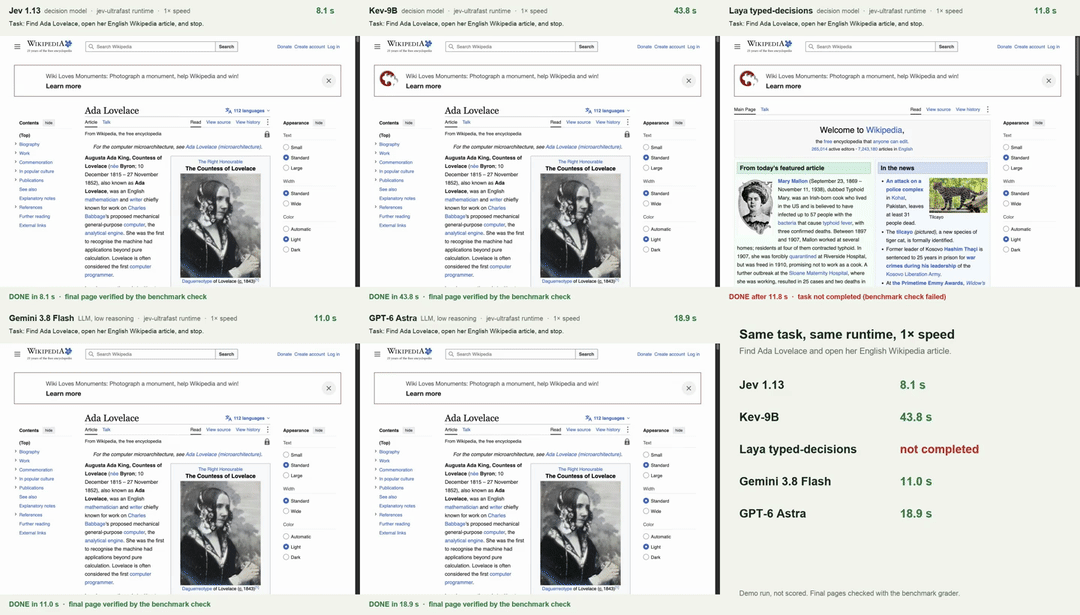
Na Wikipedia, todos os models exceto Laya digitaram na caixa de busca, o auxiliar de texto escreveu “Ada Lovelace”, e o model escolheu a sugestão certa. Jev chegou ao artigo em 8,1 segundos, Gemini em 11.0, Astra em 18.9 e Kev-9B em 43.8. Laya declarou a tarefa concluída na página principal sem executar nenhuma ação.
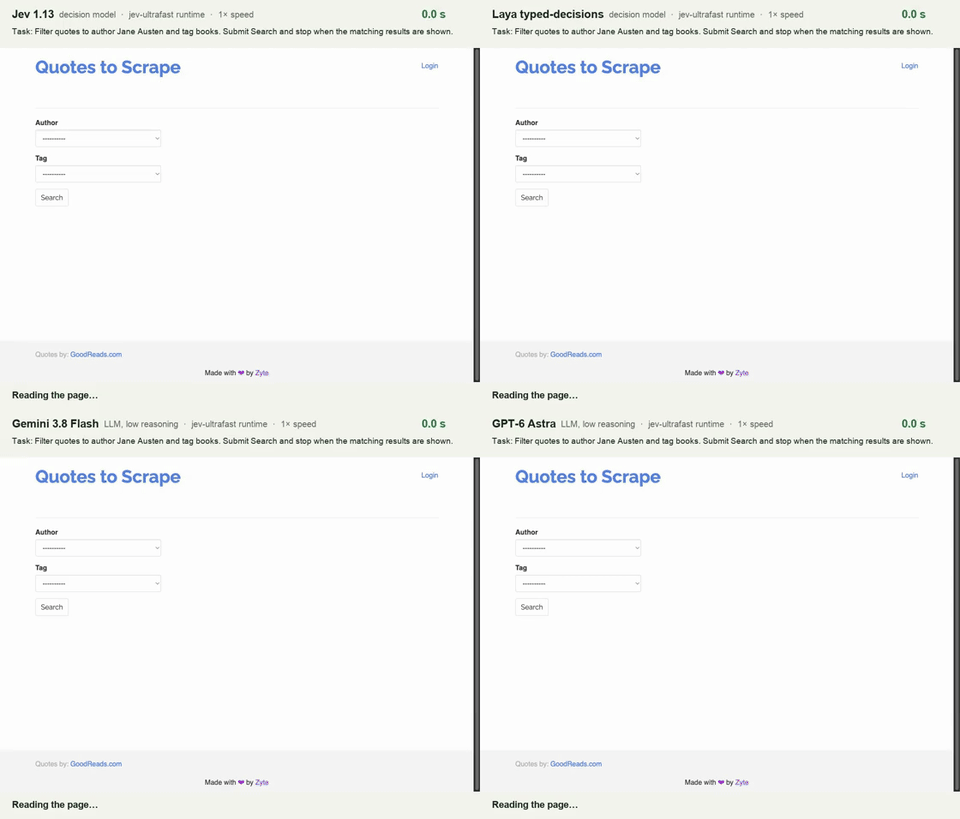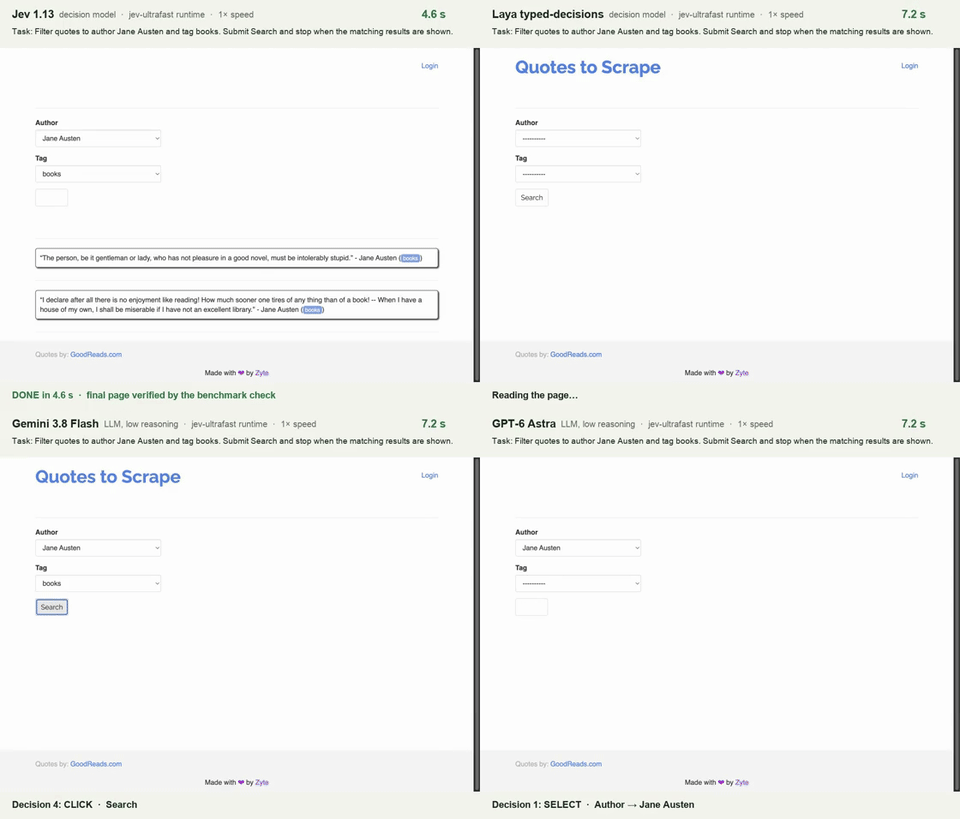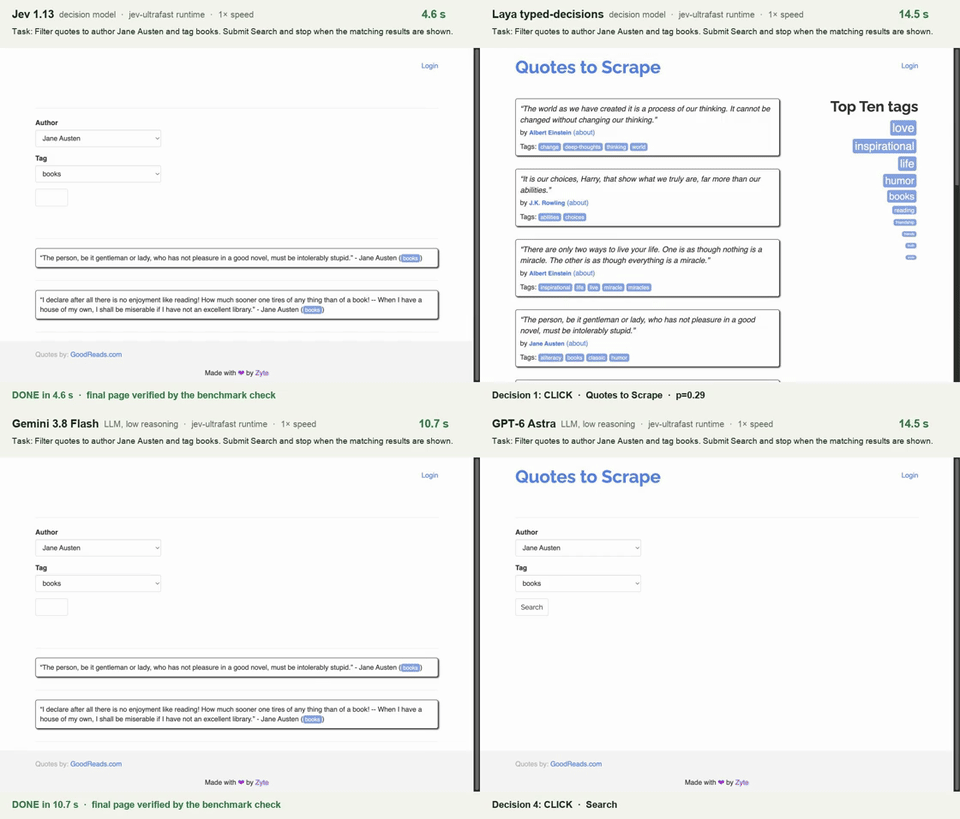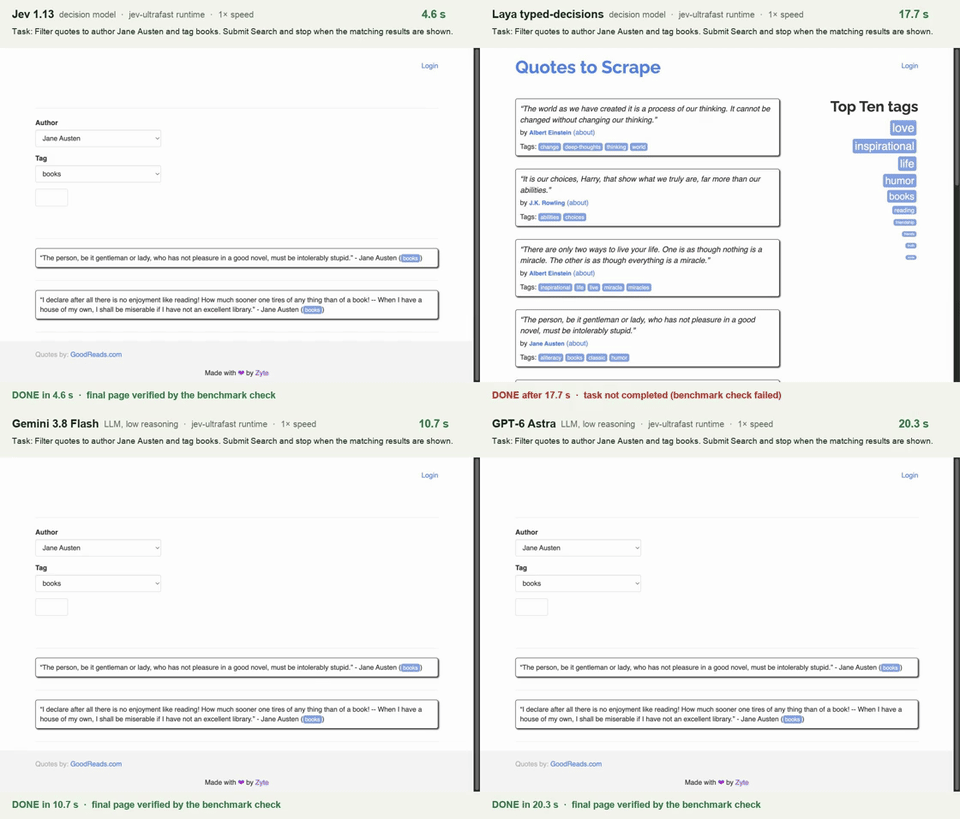
A tarefa de filtro precisa de dois dropdowns e um botão de busca. Jev, Gemini e Astra deram os mesmos quatro passos e terminaram em 4.6, 10.7 e 20,3 segundos. Laya clicou no logo do site e declarou a tarefa concluída. Kev-9B falhou nessa tarefa no benchmark, e na demo ainda estava clicando após 11 minutos, então ficou de fora deste clipe.
As legendas mostram a operação e o alvo escolhidos por cada model e, para models de decisão, a probabilidade dessa operação. Os clipes vêm de uma execução de demonstração separada em velocidade 1×, não do benchmark pontuado, e cada página final foi verificada com o avaliador do benchmark.
Como os models falharam
Jev e Kev-9B juntos completaram 26 tarefas distintas. Ambos completaram as duas tarefas da Wikipedia e a tarefa de dropdown do Web Scraper, assim como ambos os LLMs. Em Books to Scrape, onde cada tarefa vai de uma lista de categorias para uma página de produto, Jev completou uma das seis e Kev-9B completou três. Kev-27B, Eikos-27B e AutoJev-27B completaram todas as seis.
- Jev declarou a tarefa bloqueada em 24 de suas 32 falhas, 16 vezes antes de realizar qualquer ação.
- Kev-9B teve uma mediana de 9.5 ações em tarefas falhas, contra 3 em tarefas que completou. Dez tentativas atingiram o limite de ações ou de chamadas de decisão, e outras cinco foram interrompidas depois que três ações seguidas deixaram a página inalterada.
- Kev-4B, do desenvolvedor do Kev-9B, declarou a tarefa bloqueada em sua primeira decisão em 29 das 50 tarefas.
- Kev-27B, Eikos-27B e GLiDE falharam sete tarefas em comum. Declararam quatro delas bloqueadas, duas buscas de produtos ScrapeMe e duas tarefas Web Scraper, e nenhum dos três terminou o checkbox ou o formulário de calculadora.
- GPT-6 Astra falhou em 3 tarefas. Marcou uma tarefa de categoria ScrapeMe como bloqueada, continuou digitando no mesmo campo da calculadora até ser interrompido e, na tarefa de formulário T02, o auxiliar de texto não retornou nenhum valor válido depois que Astra preencheu e enviou o formulário.
- Gemini 3.8 Flash falhou em 7, incluindo o mesmo final T02. Três falhas chegaram à página correta, mas não terminaram, duas foram interrompidas pelo nosso limite de custo quando OpenRouter não informou uma taxa, e uma atingiu o limite de ações.
Por que alguns models marcaram 0/50
GLiNER2.5-Decide
GLiNER2.5-Decide da Fastino6 declarou todas as 50 tarefas concluídas cedo demais, 49 delas em sua primeira decisão. Nas 37 tarefas que compartilham uma página inicial com outra tarefa, suas probabilidades de operação não diferiram em mais de 6 pontos entre os objetivos.
Fastino descreve GLiNER2.5-Decide como um classificador para decisões como roteamento de tickets, intenção, urgência e se um agente terminou, e afirma que o model não raciocina. O model foi criado para entradas de até 512 tokens, mas aceita entradas mais longas. Nossas requisições da primeira etapa tinham uma mediana de 1.915 tokens.
CLM-v0.1-8B
CLM-v0.1-8B da Contrastive-LM7 escolheu esperar em 2.199 de suas 2.288 decisões de operação, então 36 tentativas ficaram sem ações. Nas mesmas páginas iniciais, suas probabilidades diferiram em no máximo 13 pontos entre os objetivos.
Contrastive-LM afirma que CLM-v0.1-8B, sem fine-tuning, tem desempenho equivalente ao Jev em tarefas de uso de computador, jogos e chamada de ferramentas, e que aceita o formato de solicitação do Jev sem alterações.8 Enviamos solicitações nesse formato.
Velocidade e sucesso
Kev-27B, Eikos-27B e AutoJev-27B completaram 68% a 80% das tarefas com uma mediana de cerca de 7 segundos por tentativa, mais rápido que Gemini a 12,7 segundos e Astra a 17.4. SubQ Snap, pplx-decider-v1.1-27b e Mercury Decide completaram 72% a 82% em 5.3 a 6,3 segundos.
decider-4b, decider-12b e Jev levaram 2.5 a 4,2 segundos por tentativa e declararam 19 a 24 tarefas bloqueadas.
GLiDE completou 76% com uma mediana de 46,8 segundos por tentativa, e 3 de suas tentativas atingiram o limite de 900 segundos. NeoHorse-Jev-4B foi o mais lento, a 78,6 segundos, com 15 tarefas concluídas. GLiDE v2 completou 72% com uma mediana de 6,0 segundos.
GLiNER2.5-Decide (0,2 segundos) declarou 49 das 50 tarefas concluídas em sua primeira decisão, e Kev-4B declarou 29 tarefas bloqueadas na primeira.
Kev-9B teve uma mediana de 38,3 segundos por tentativa, cinco vezes a de Kev-27B. Cada decisão do Kev-9B levou uma mediana de 3,7 segundos de tempo de servidor, contra cerca de 1 segundo para uma chamada completa da API do Jev. A sobrecarga da requisição adicionou cerca de meio segundo.
Kev-9B teve média de 26 decisões por tentativa, contra cerca de 4 para o Jev, e 90% delas ocorreram em tentativas que falharam.
Custo
Custo da automação de navegador
† Estimativa: custo de A100 por token de entrada, medido nas próprias requisições de navegador do model com a GPU cheia, vezes os tokens de entrada do navegador, mais as taxas do auxiliar de texto. Método sob metodologia.
‡ O valor mais alto adiciona 17 requisições que falharam sem informar tokens, contadas como 120.000 tokens de entrada cada; Fastino pode não cobrá-las.
Astra, Gemini e Jev usaram cada um de 3.150 a 3.470 tokens de entrada por decisão. O preço de entrada da Astra é cerca de 240 vezes o do Jev.910
Em baixo raciocínio, Astra produziu 6.599 tokens de saída em 307 decisões, contra 968.376 tokens de entrada. O preço de saída do Jev é $0.
Ao preço de entrada do Jev, os 968.376 tokens de entrada de decisão da Astra teriam custado cerca de $0,04 em vez de $9.68. Kev-27B ficou a sete tarefas da Astra por um valor estimado de $0,24 nas 50 tarefas, contra $10,63 da Astra.
Nessas estimativas, todos os models de decisão da tabela que concluíram uma tarefa, exceto Celeris 1.1 Decision, Kev-4B, Kev-9B e NeoHorse-Jev-4B, custaram menos por tarefa concluída do que Gemini. Nove models custaram menos que Jev 1.13 por tarefa concluída: Mercury Decide, Decider V1.2, pplx-decider-v1.1-27b, Span-02, Drex v1.5, SubQ Snap, H2O-Lightning-4B, Jev 1.14 e Drex v2.0. Mercury Decide custa menos de um terço do Jev.
- Kev-9B custou cerca de 5 vezes Gemini e 84 vezes Jev por tarefa concluída. Seu custo estimado de A100 foi cerca de $0,80 por milhão de tokens de entrada, 19 vezes o preço da API do Jev, e ele tomou 1.321 decisões contra 185 do Jev.
- O custo estimado do Kev-4B em GPU por token foi cerca de 12.1 vezes o preço do OpenRouter.
O tempo de A100 que alugamos para a execução do Kev-9B, 3.32 horas incluindo configuração e tempo ocioso, ficou em cerca de $5.31. Uma taxa do Jev e duas taxas do Gemini não foram registradas e estão faltando na tabela.
Custo de classificação
Os models hospedados são precificados pelos preços de tabela de sua API, exceto os models no OpenRouter, que são precificados pelas taxas cobradas pelo OpenRouter. Mercury Decide rodou na rota do OpenRouter gratuito e é precificado pelo preço de tabela de sua rota paga. Models auto-hospedados são precificados por 1.000 decisões na maior vazão que medimos em um A100 alugado com a GPU cheia.
À nossa taxa de $1,673 por hora, um A100 alugado custa cerca de $40 por dia, ocupado ou ocioso. À taxa que registramos, $40 compram cerca de um milhão de decisões do Jev.
 Adicionar como fonte preferencial
Treinamento de models de decisão
Fizemos fine-tuning de Kev-9B e Laya em decisões que o GLM-5.3-Flash, o model de rotulagem, tomou em tarefas de navegador de oito sites fora do benchmark. Depois executamos as 50 tarefas novamente. Cada model com fine-tuning é comparado com sua versão original, executado no mesmo dia e hardware.
O Kev com fine-tuning e ambas as versões do Laya estão em Hugging Face.
p vem de um teste pareado nas mesmas 50 tarefas (McNemar exato), e p abaixo de 0.05 conta como significativo. O Kev original completou 21 tarefas nesta comparação, uma a mais do que nos resultados acima. Um dos 12 ganhos do Kev, C02, foi um timeout de navegador na execução original, e não uma falha do model. Sem ele, o Kev ganhou 11 tarefas e perdeu 1 (p = 0.006).
- O Kev com fine-tuning ganhou tarefas em seis dos nove sites, três em cada um de Quotes to Scrape e Scrape This Site. Seus resultados em Web Scraper, Wikipedia e nos formulários TestPages não mudaram.
- O Kev com fine-tuning terminou 5 tentativas bloqueadas contra 12 e atingiu o limite de ações 6 vezes contra 11. Declarou uma tarefa inacabada como concluída 7 vezes, contra 4.
- Em 41 tarefas dos sites de treinamento que foram mantidas fora do treinamento, o Kev completou 21 contra 13 antes. Em 101 decisões isoladas de 19 dessas tarefas, ele escolheu a operação do model de rotulagem 94% das vezes, contra 62% antes.
- O primeiro fine-tuning do Laya escolheu a operação do model de rotulagem em 75% das 88 decisões que conseguiu ler, contra 19% para o Laya original. Ele declarou uma tarefa concluída em uma página que ainda precisava de uma ação 2 vezes em vez de 53.
- No benchmark, o primeiro fine-tuning do Laya declarou uma tarefa inacabada como concluída 36 vezes, uma vez antes de realizar qualquer ação. O Laya original fez isso 32 vezes, 17 delas antes de qualquer ação.
Casos de uso de models de decisão
- Verificar o sinal de conclusão de um agente. Na última página que um agente de navegador viu antes de declarar uma tarefa concluída, 41 dos 59 models de decisão marcaram acima de 90 ao distinguir concluído de não concluído, e AutoJev-27B, Clef, d1-ultra, Decision-2.0-Vega-27B e Kev-27B marcaram 99.5. Não testamos verificações em páginas anteriores em uma execução.
- Triagem com rótulos fixos, como classificar avisos de segurança ou recalls. decider-12b marcou 21 pontos acima do nível de acaso em gravidade e 29 em recalls. Em tópicos de artigos, um classificador por palavras-chave treinado em 28.595 artigos rotulados marcou 70.4, e nenhum model de decisão marcou significativamente mais; o mesmo tipo de classificador marcou quase aleatório em gravidade e recalls.
- Escolher cada ação na automação de navegador. SubQ Snap completou 41 de 50 tarefas, contra 43 e 47 para os dois LLMs. O fine-tuning de Kev-9B em 606 decisões de outros sites elevou-o de 21 para 32.
Nas duas tarefas principais de classificação, os models de decisão locais custaram estimados $0,007 a $0,57 por 1.000 decisões em uma GPU alugada, e todos exceto NeoHorse-Jev-4B e Shisa DE-2 tiveram média abaixo de um segundo por decisão. Nas tarefas de navegador, o preço de entrada do Jev foi cerca de 1/240 do GPT-6 Astra.
Cada resposta também vem com uma probabilidade por opção, que uma aplicação poderia usar para passar casos incertos para um LLM. Não testamos o quanto essas probabilidades correspondem à precisão real.
36 dos 59 models rodaram em uma única GPU alugada; os outros 23 são APIs hospedadas.
Metodologia
Benchmark de automação de navegador
Todos os models usaram o mesmo runtime de navegador jev-ultrafast. Em cada etapa, ele convertia a página atual em texto de página mais uma lista numerada de controles visíveis. O model escolhia uma operação, como clicar, digitar, selecionar, concluir ou bloquear, e um alvo dessa lista. O runtime executava a ação e relia a página.
Os models de decisão classificam as opções fornecidas e não retornam texto. Quando qualquer model escolhia digitar, o auxiliar de texto escrevia o valor no campo do formulário. Cada tentativa começava em uma nova sessão de navegador.
Todos os models foram acessados por uma API, Kev-9B e Laya rodaram com o navegador em um Mac, no Chrome 153 até 30 de setembro e Chrome 154 a partir de 2 de outubro. Os outros models auto-hospedados rodaram com Chrome no Linux em suas GPUs alugadas.
Nenhuma requisição foi encurtada para caber em um model. Solar Decide, Solar Decide Flash e Ollama aceitam de 2 a 26 opções por pergunta. Uma requisição fora desses limites encerrava a tentativa, assim como requisições grandes demais para Laya. Ollama aceita descrições de opções apenas como texto, então as opções estruturadas foram enviadas como texto JSON compacto. Tev1 vem com um contexto de 2.050 tokens; nós o aumentamos para 8.194, a configuração do próprio Nimble, para que as páginas não fossem cortadas.
Classify-1 rejeita as instruções estruturadas, descrições de opções e estado da página que os outros models recebem, por isso em ambos os benchmarks as enviamos como texto JSON compacto.
Strands Decider 2B lê no máximo 4.096 tokens e recusou páginas mais longas, o que encerrou 11 tentativas.
O serviço do Cloudflare lê apenas os primeiros 2.048 tokens do texto da página para Clef e Clef-Flash. Não enviamos páginas mais longas, o que encerrou uma tentativa para cada model.
Para 21 models, entre eles Clef, decider e Eikos, uma pergunta com uma opção, como o único campo de texto de uma página, foi enviada com essa opção duas vezes, e a resposta foi mapeada de volta para ela. Os serviços deles recusam perguntas com uma única opção.
Executamos Kev-9B com o código de referência do produtor em precisão total de 32 bits. Não instalamos pacotes de kernel opcionais que aceleram seu model base, então o model caiu para kernels de referência mais lentos. Não testamos uma configuração de GPU mais rápida.
O próprio código do CLM transforma cada requisição em texto. GLiNER recebeu o mesmo texto, com o objetivo e as regras de cada pergunta como seu prompt. Kev-4B também é servido no OpenRouter pela SiliconFlow com precisão de 8 bits.11 Executado por ele a partir do Mac em 29 de setembro, Kev-4B completou 8 tarefas.
GPT-6 Luna Decisions também é servido no OpenRouter, que retorna um erro para toda a requisição quando o model recusa uma pergunta; a própria OpenAI API responde às outras perguntas.12 Através do OpenRouter, Luna completou 1 tarefa, então os resultados acima usam a OpenAI API.
Para Celeris 1.1 Decision, 4 das 50 tarefas de navegador usaram Mercury 3 como auxiliar de texto em vez de Mercury 2.5. Celeris falhou nas quatro com qualquer um dos auxiliares.
Models de navegador
Raciocínio baixo é uma configuração de esforço definida pelo provedor. As 307 decisões de Astra incluíram 791 tokens de raciocínio relatados. Kev-9B13 e Kev-4B14 vêm do mesmo desenvolvedor, e Nimble 9B é da Bespoke Labs.15 GLiDE vem da Fastino, desenvolvedora do GLiNER2.5-Decide,16 e Clef e Clef-Flash da Cloudflare.17
O model card do MATILDA JEV v1.5 diz que treinamentos anteriores em sua linhagem usaram material relacionado a benchmark.18
Dataset
As 50 tarefas cobrem nove sites: oito sites de prática construídos para scraping e testes, mais a Wikipedia. As tarefas incluem navegação em catálogo, busca, ordenação, paginação, opções de produto, formulários e buscas de artigos. Cada tarefa começa a partir de uma URL fixa e declara o estado final em uma frase, por exemplo “Mude para Science Fiction, encontre Dune (Dune #1), abra os detalhes do produto e pare.”
Antes da execução dos models, uma execução roteirizada completou todas as 50 tarefas usando apenas as ações suportadas pelo runtime. Todas as tarefas são solucionáveis sem senhas, CAPTCHAs ou a tecla Enter.
Tarefas de exemplo
Dez das 50 tarefas estão publicadas no Hugging Face com as instruções, URL inicial, condições de aprovação e o resultado de cada model. As outras 40 ficam retidas para execuções posteriores.
Avaliação
Uma tarefa passava quando o model a declarava concluída dentro dos limites e uma verificação separada da página final confirmava todas as condições: uma URL final aceita, os fatos da tarefa visíveis na página, mais de 100 caracteres de texto da página e uma página totalmente carregada.
Cada tentativa teve 900 segundos, 60 ações de navegador e 120 chamadas de decisão. Erros de API contaram como falhas. A cronometragem vai da primeira página carregada até a verificação final.
A verificação lê a página final depois que ela termina de carregar.
Cálculo de custo
O custo de API cobre as chamadas de decisão e o auxiliar de texto, para todas as 50 tentativas por model. OpenRouter informou as taxas para GPT-6 Astra, Gemini e Mercury 2.5. O custo do Jev são seus tokens reportados ao preço de tabela em 22 de setembro de 2026: $0,042 por milhão de tokens de entrada e nenhuma cobrança pela saída.5 GLiDE, Clef e Clef-Flash também são precificados por seus preços de tabela.
GLiDE v2, GPT-6 Luna Decisions, SubQ Snap e Celeris 1.1 Decision são precificados por seus preços de tabela, e os outros models de decisão no OpenRouter pelas taxas informadas pelo OpenRouter. Mercury Decide, executado na rota gratuito, é precificado pelo preço de tabela de sua rota paga.
As execuções de navegador auto-hospedadas usaram uma A100, A6000, RTX 4090 ou um Mac. Nós precificamos todas elas em uma A100 alugada a $1,673 por hora. Enviamos as próprias requisições de navegador de cada model novamente a ela com a GPU cheia. O custo de um model na tabela é seu custo por token de entrada na maior vazão, vezes seus tokens de entrada de navegador, mais as taxas do auxiliar de texto.
Ambas as cargas de trabalho são quase totalmente de entrada, porque esses models retornam pontuações de opções ou poucos tokens.
Fine-tuning
As 327 tarefas, 286 para treinamento e 41 mantidas fora, vêm de oito sites que não estão no benchmark, incluindo Demo Web Shop, Automation Exercise e Project Gutenberg. Cada tarefa foi verificada em um navegador: sua página inicial falha no avaliador, e quando a tarefa termina em uma URL diferente, essa página passa.
GLM-5.3-Flash, um model de pesos abertos sob a licença MIT,19 tentou 300 das tarefas no runtime do benchmark com raciocínio baixo. Erros do provedor o impediram nas outras 27. Não usamos GPT-6 Astra nem Gemini para isso, porque os termos da OpenAI e do Google proíbem usar sua saída para construir models concorrentes.2021
As 184 execuções de treinamento bem-sucedidas geraram 606 registros de decisão. Uma execução contava como bem-sucedida quando o avaliador a aprovava, ou quando chegava à página de produto certa por meio de busca no site e falhava apenas na verificação de URL exata, como 11 execuções em todas as tarefas fizeram.
O teste de decisão única reproduz 103 decisões gravadas de 19 tarefas mantidas fora e conta com que frequência um model escolhe a operação do model de rotulagem. Kev conseguiu ler 101 delas. Laya conseguiu ler 88 quando enviadas apenas as perguntas que cada etapa precisa, e 34 na requisição completa que o benchmark envia. Nessas 34, o Laya original concordou 29% das vezes, o primeiro fine-tuning 71% e o segundo 41%.
Ambos os models começaram dos pesos originais que avaliamos e usaram as receitas de treinamento de seus produtores com os limites de entrada do benchmark. Kev também treinou por duas épocas em vez de uma, sem os registros de repetição do produtor. Cada execução de treinamento levou menos de 20 minutos em uma H100 GPU.
O primeiro fine-tuning do Laya usou os mesmos 606 registros, pulando os longos demais para o Laya. O segundo manteve apenas os 292 que cabem na requisição completa que o benchmark envia e adicionou 102 das próprias execuções do Laya, onde o GLM-5.3-Flash assumiu depois que Laya declarou uma tarefa concluída ou bloqueada (73) ou esgotou seu orçamento de 10 ações (29). Kev não teve uma segunda rodada.
O par do Kev e o primeiro par do Laya rodaram em um H100 alugado na França, com Chrome no Linux. O segundo par do Laya rodou no Mac do benchmark principal. Cada par usou as 50 tarefas, o runtime, os limites e o avaliador do benchmark principal, com uma tentativa por tarefa.
Benchmark de classificação
Cada item é uma decisão com um conjunto fixo de opções. Os itens vêm de registros publicados de julho a setembro de 2026 e de snapshots não publicados de páginas finais em nossas próprias execuções de navegador. Muitos dos models foram lançados depois que esses registros se tornaram públicos, então um model pode ter visto um item e sua resposta registrada no treinamento. Não podemos verificar em que cada model foi treinado.
As três primeiras tarefas pedem que um model reproduza uma decisão registrada por uma instituição, apenas a partir do texto. GitHub e a FDA podem ter usado evidências que o texto não contém. Os níveis de gravidade do GitHub correspondem às quatro classificações acima de None no CVSS, o sistema padrão de pontuação de vulnerabilidades.22
Todos os models receberam as mesmas instruções e definições de opções para uma tarefa: as definições de classe da FDA, as faixas de gravidade do GitHub, as descrições de categoria do arXiv. A ordem das opções foi embaralhada por item e foi a mesma para todos os models. A gravidade da falha de segurança e o nível de perigo de recall são as tarefas principais, definidas antes de qualquer execução; tópicos de artigos e a verificação de tarefa concluída são complementares.
A pontuação é a acurácia balanceada: a taxa de sucesso dentro de cada resposta possível, calculada pela média entre as respostas.
Um model que sempre dá a resposta mais comum marca 25 em gravidade, 33 em recall e 5 em tópicos de artigos. A pontuação do gráfico é a média das duas tarefas principais, onde essa resposta marca cerca de 29. Os intervalos são intervalos bootstrap de 95% que reamostram itens relacionados juntos: avisos do mesmo pacote, recalls do mesmo evento de recall, páginas da mesma tarefa de navegador.
Para testar se algum model marcou significativamente mais alto que decider-12b, sorteamos 1.000 dessas reamostragens, as mesmas para todos os models, e obtivemos o intervalo de 95% da diferença de cada model em cada tarefa principal; um model conta como mais alto apenas se esse intervalo ficar acima de zero, sem ajuste para comparações múltiplas. Cada model foi comparado com o classificador por palavras-chave em tópicos de artigos da mesma forma.
Dois LLMs, Qwen 3.8 Max e Claude Opus 5.5, rotularam uma amostra de 350 itens de teste, 100 por tarefa e 50 páginas de navegador, sem ver a resposta registrada.
Eles concordaram entre si em 62 de 100 avisos, 69 de 100 recalls, 84 de 100 artigos e 49 de 50 páginas de navegador. Quando discordaram do registro em avisos e recalls, ficaram principalmente um nível distantes, em direção aos níveis intermediários. Eles corresponderam à gravidade do GitHub em 55 e 56 de 100 avisos.
Ambos os juízes deram a mesma resposta, diferente do registro, em 54 itens. Verificamos os 53 registros do GitHub, FDA e arXiv contra a fonte ao vivo, e todos corresponderam, então nenhum rótulo mudou.
A única página de navegador foi rotulada como concluída porque o avaliador contou pelo menos 40 avaliações na página completa, enquanto o snapshot que os models veem mostra cerca de nove. Nós a removemos e os outros 48 itens de tarefa concluída cuja resposta dependia de contar 10 ou mais itens, o que deixa 155.
Os custos locais valem para a configuração que testamos naquela GPU; outra configuração de servidor ou GPU os alteraria. Quando medimos as primeiras versões Ollama do Nimble 9B e dos models Tev1 para custo, Tev1 0.8B diferiu de sua execução pontuada em 1,2% das perguntas, e Nimble 9B e Tev1 4B em menos de 1%.
Na configuração escolhida, os outros models auto-hospedados corresponderam a pelo menos 98% de suas respostas pontuadas, exceto Shisa DE-1 e Shisa DE-2. Eles variam de execução para execução mesmo uma requisição por vez, então o limiar deles foi a própria concordância um-a-um menos 2 pontos percentuais; corresponderam 97,6% e 96,4%. Em suas próprias requisições de navegador, CLM-v0.1-8B, Shisa DE-2 e GEV-26B-Decide corresponderam 90,7%, 77,9% e 83,1% sob a mesma regra.
Exceções à execução de cada model como lançado:
- Laya Typed-Decisions rodou com um contexto de 8.192 tokens em vez dos 1.024 lançados, e Tev1 com 8.194 em vez de 2.050, como em nossas execuções de navegador.
- Onde o próprio código do Laya cortaria uma opção ou entrada longa, nosso conector rejeitava a requisição, e uma rejeição conta como resposta errada. Todas as requisições de tópico de artigo foram rejeitadas porque as descrições de tópico são mais longas que os 48 tokens que Laya lê por opção.
- O contexto do encoder do CLM foi aumentado de 2.048 para 16.384 tokens; GLiNER rodou além de sua entrada documentada de 512 tokens. Shisa DE-1 usou um contexto de 32.768 tokens para caber na memória da GPU.
- d3, d3-flash, d3-mini, Decision-2.0-Vega-27B, Decision-1.0-Lux-9B e MATILDA JEV v1.5 rodaram em uma NVIDIA A100, que seus produtores não validaram; os três d3 e o Decision-2.0-Vega-27B rodaram sem seus caminhos rápidos exclusivos para AMD. JEV-27B-VL e GEV-26B-Decide rodaram no vLLM 0.29.0; seus model cards citam uma build vLLM não lançada.
- NeoHorse-Jev-4B rodou através do adaptador vLLM do produtor, porque seu próprio servidor recusa texto de página acima de 2.048 tokens por padrão.
- APUS Reflex 35B-A3B aceita de 2 a 16 opções por pergunta, então rejeitou todas as 500 perguntas de tópico de artigo (20 opções), que contam como respostas erradas, e não rodou as tarefas de navegador.
- Together AI não havia publicado licença para os pesos Tev1 até 30 de setembro de 2026.
- O serviço do Cloudflare lê apenas os primeiros 2.048 tokens do texto do item para Clef e Clef-Flash, embora os models aceitem 65.536. Os 12 itens mais longos, 9 em gravidade e 3 em recalls, contam como respostas erradas.
Limitações
Cada model tentou cada tarefa de navegador uma vez, então uma diferença de algumas tarefas entre dois models não mostra qual é melhor.
As 50 tarefas vêm de nove sites, e tarefas no mesmo site compartilham layouts de página. Os models rodaram em sites ao vivo, que podem mudar entre execuções.
O formato de etapa, uma lista de operações mais listas de alvos, foi criado primeiro para o Jev. Todos os models receberam o mesmo formato. Não testamos se outro formato mudaria os resultados. Laya rodou com limites de entrada acima das configurações lançadas para que páginas longas não fossem cortadas.
No benchmark de classificação, cada model respondeu cada item uma vez. As respostas do GitHub e da FDA são as decisões registradas dessas instituições, que podem se basear em evidências que o aviso ou o texto do recall não contém.
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{AIM-Decision: Jev versus Clef versus LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/decision-models}},
  note   = {AIMultiple. Acessado em 21 outubro 2026}
}Resultados e carimbos de data/hora de 392 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 10 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Links de referência




Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.