


LLM Roteador Benchmark: 8 roteadores em 523 tarefas de banco de dados agênticas

Testamos 8 LLM roteadores em 523 tarefas de banco de dados agênticas e comparamos cada um com models individuais em precisão e custo.
Resultados do benchmark de roteadores agênticos
| Name | Series | $ per 1,000 questions, router fees included (log scale) | Score (%) | Score | Cost | Pool | Label |
|---|---|---|---|---|---|---|---|
| Fireworks Nexus Auto | Fireworks Nexus Auto | 1.93 | 35.95 | 35.9% | 1.9 | Router's own, open models | Fireworks Nexus Auto |
| Not Diamond | Not Diamond | 50.52 | 50.86 | 50.9% | 50.5 | 19 models | Not Diamond |
| NVIDIA Switchyard (Sol + Luna) | NVIDIA Switchyard (Sol + Luna) | 16.6 | 56.21 | 56.2% | 16.6 | GPT-6.1 Sol + GPT-6 Luna | NVIDIA Switchyard (Sol + Luna) |
| OpenRouter Auto | OpenRouter Auto | 1.97 | 28.68 | 28.7% | 2.0 | Router's own | OpenRouter Auto |
| OpenRouter Auto Code | OpenRouter Auto Code | 24.62 | 52.77 | 52.8% | 24.6 | Router's own | OpenRouter Auto Code |
| Sakana Fugu Max | Sakana Fugu Max | 29.96 | 27.34 | 27.3% | 30.0 | Router's own | Sakana Fugu Max |
| TypeSafe Jev | TypeSafe Jev | 2.09 | 29.45 | 29.4% | 2.1 | Router's own | TypeSafe Jev |
| Unbiased Pareto 26.10 | Unbiased Pareto 26.10 | 13.18 | 44.17 | 44.2% | 13.2 | Router's own | Unbiased Pareto 26.10 |
| Claude Fable 5 | Anthropic | 150.34 | 60.04 | 60.0% | 150.3 | single model | Claude Fable 5 |
| Claude Fable 5.1 | Anthropic | 718.96 | 62.91 | 62.9% | 719.0 | single model | Claude Fable 5.1 |
| Claude Fable 5.2 | Anthropic | 109.43 | 85.28 | 85.3% | 109.4 | single model | Claude Fable 5.2 |
| Claude Haiku 5.5 | Anthropic | 1.92 | 26.2 | 26.2% | 1.9 | single model | Claude Haiku 5.5 |
| Claude Opus 4.8 | Anthropic | 148.83 | 50.67 | 50.7% | 148.8 | single model | Claude Opus 4.8 |
| Claude Opus 5 | Anthropic | 77.8 | 60.99 | 61.0% | 77.8 | single model | Claude Opus 5 |
| Claude Opus 5.5 | Anthropic | 236.55 | 84.89 | 84.9% | 236.5 | single model | Claude Opus 5.5 |
| Claude Sonnet 5 | Anthropic | 76.64 | 34.42 | 34.4% | 76.6 | single model | Claude Sonnet 5 |
| Claude Sonnet 5.5 | Anthropic | 53.81 | 70.36 | 70.4% | 53.8 | single model | Claude Sonnet 5.5 |
| Command A Plus | Cohere | 9.19 | 30.21 | 30.2% | 9.2 | single model | Command A Plus |
| DeepSeek V4 Flash | DeepSeek | 2.91 | 30.4 | 30.4% | 2.9 | single model | DeepSeek V4 Flash |
| DeepSeek V4 Flash 0731 | DeepSeek | 1.66 | 33.84 | 33.8% | 1.7 | single model | DeepSeek V4 Flash 0731 |
| DeepSeek V4 Pro | DeepSeek | 11.28 | 35.37 | 35.4% | 11.3 | single model | DeepSeek V4 Pro |
| DeepSeek V4 Pro 0813 | DeepSeek | 13.95 | 40.92 | 40.9% | 13.9 | single model | DeepSeek V4 Pro 0813 |
| DeepSeek V4.1 Flash | DeepSeek | 4.25 | 30.78 | 30.8% | 4.2 | single model | DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash 1017 | DeepSeek | 2.05 | 20.65 | 20.7% | 2.0 | single model | DeepSeek V4.1 Flash 1017 |
| Gemini 3 Flash Preview | 9.37 | 59.66 | 59.7% | 9.4 | single model | Gemini 3 Flash Preview | |
| Gemini 3.1 Flash Lite | 6.95 | 42.07 | 42.1% | 6.9 | single model | Gemini 3.1 Flash Lite | |
| Gemini 3.1 Pro Preview | 90.04 | 60.42 | 60.4% | 90.0 | single model | Gemini 3.1 Pro Preview | |
| Gemini 3.5 Flash Lite | 8.52 | 48.76 | 48.8% | 8.5 | single model | Gemini 3.5 Flash Lite | |
| Gemini 3.6 Flash | 27.38 | 58.89 | 58.9% | 27.4 | single model | Gemini 3.6 Flash | |
| Gemini 3.7 Flash | 25.08 | 69.41 | 69.4% | 25.1 | single model | Gemini 3.7 Flash | |
| Gemini 3.8 Flash | 32.67 | 65.39 | 65.4% | 32.7 | single model | Gemini 3.8 Flash | |
| Gemini 4 Argon | 48.44 | 77.82 | 77.8% | 48.4 | single model | Gemini 4 Argon | |
| Gemini 4 Carbon | 75.67 | 77.25 | 77.2% | 75.7 | single model | Gemini 4 Carbon | |
| GLM 4.7 | Zhipu AI | 10.84 | 25.05 | 25.0% | 10.8 | single model | GLM 4.7 |
| GLM 5.1 | Zhipu AI | 12.8 | 38.43 | 38.4% | 12.8 | single model | GLM 5.1 |
| GLM 5.2 | Zhipu AI | 6.71 | 39.2 | 39.2% | 6.7 | single model | GLM 5.2 |
| GLM 5.3 | Zhipu AI | 24.27 | 38.62 | 38.6% | 24.3 | single model | GLM 5.3 |
| GLM 5.3 Flash | Zhipu AI | 4.22 | 36.14 | 36.1% | 4.2 | single model | GLM 5.3 Flash |
| GLM 5.3 Prime | Zhipu AI | 69.86 | 35.18 | 35.2% | 69.9 | single model | GLM 5.3 Prime |
| GPT-5.2 | OpenAI | 29.97 | 31.93 | 31.9% | 30.0 | single model | GPT-5.2 |
| GPT-5.4 Mini | OpenAI | 7.03 | 24.28 | 24.3% | 7.0 | single model | GPT-5.4 Mini |
| GPT-5.4 Nano | OpenAI | 2.85 | 21.03 | 21.0% | 2.8 | single model | GPT-5.4 Nano |
| GPT-5.5 | OpenAI | 75.52 | 44.93 | 44.9% | 75.5 | single model | GPT-5.5 |
| GPT-5.6 Luna | OpenAI | 13.87 | 33.46 | 33.5% | 13.9 | single model | GPT-5.6 Luna |
| GPT-5.6 Sol | OpenAI | 60.83 | 49.9 | 49.9% | 60.8 | single model | GPT-5.6 Sol |
| GPT-5.6 Terra | OpenAI | 30.71 | 39.39 | 39.4% | 30.7 | single model | GPT-5.6 Terra |
| GPT-6 Luna | OpenAI | 1.34 | 38.81 | 38.8% | 1.3 | single model | GPT-6 Luna |
| GPT-6 Luna Pro | OpenAI | 3.91 | 38.24 | 38.2% | 3.9 | single model | GPT-6 Luna Pro |
| GPT-6 Sol | OpenAI | 21.83 | 50.48 | 50.5% | 21.8 | single model | GPT-6 Sol |
| GPT-6 Sol Pro | OpenAI | 59.11 | 50.67 | 50.7% | 59.1 | single model | GPT-6 Sol Pro |
| GPT-6.1 Sol (reference) | OpenAI | 15.45 | 61.19 | 61.2% | 15.4 | single model, run with the routers | GPT-6.1 Sol (reference) |
| GPT-6.1 Sol (text-to-SQL) | OpenAI | 15.91 | 61.38 | 61.4% | 15.9 | single model | GPT-6.1 Sol (text-to-SQL) |
| GPT-6.1 Sol Pro | OpenAI | 44.12 | 59.85 | 59.8% | 44.1 | single model | GPT-6.1 Sol Pro |
| GPT-6.1 Terra | OpenAI | 8.76 | 53.54 | 53.5% | 8.8 | single model | GPT-6.1 Terra |
| GPT-OSS 120B | OpenAI | 0.597 | 19.89 | 19.9% | 0.6 | single model | GPT-OSS 120B |
| Grok 4.3 | xAI | 16.13 | 41.68 | 41.7% | 16.1 | single model | Grok 4.3 |
| Grok 4.5 | xAI | 26.24 | 48.57 | 48.6% | 26.2 | single model | Grok 4.5 |
| Grok 4.6 | xAI | 41.78 | 58.32 | 58.3% | 41.8 | single model | Grok 4.6 |
| Grok 4.7 | xAI | 37.1 | 48.37 | 48.4% | 37.1 | single model | Grok 4.7 |
| HY4 Preview | Tencent | 12.78 | 45.12 | 45.1% | 12.8 | single model | HY4 Preview |
| Kimi K2.6 | Moonshot AI | 19.13 | 43.79 | 43.8% | 19.1 | single model | Kimi K2.6 |
| Kimi K3 | Moonshot AI | 48.24 | 45.32 | 45.3% | 48.2 | single model | Kimi K3 |
| Kimi K3.1 Pro | Moonshot AI | 32 | 49.14 | 49.1% | 32.0 | single model | Kimi K3.1 Pro |
| Llama 4 Maverick | Meta | 6.1 | 28.11 | 28.1% | 6.1 | single model | Llama 4 Maverick |
| MiMo V2.6 Pro | Xiaomi | 4.93 | 38.81 | 38.8% | 4.9 | single model | MiMo V2.6 Pro |
| MiniMax M2.5 | MiniMax | 3.45 | 29.45 | 29.4% | 3.5 | single model | MiniMax M2.5 |
| MiniMax M3 | MiniMax | 4.85 | 34.03 | 34.0% | 4.9 | single model | MiniMax M3 |
| MiniMax M3.1 Flash | MiniMax | 2.71 | 33.84 | 33.8% | 2.7 | single model | MiniMax M3.1 Flash |
| Mistral Large 4.0 | Mistral AI | 18.65 | 26.77 | 26.8% | 18.7 | single model | Mistral Large 4.0 |
| Mistral Small 2603 | Mistral AI | 1.74 | 23.33 | 23.3% | 1.7 | single model | Mistral Small 2603 |
| Muse Ember | Meta | 2.99 | 37.48 | 37.5% | 3.0 | single model | Muse Ember |
| Muse Glimmer 30B | Meta | 6.4 | 31.17 | 31.2% | 6.4 | single model | Muse Glimmer 30B |
| Muse Spark 1.1 | Meta | 27.77 | 39.01 | 39.0% | 27.8 | single model | Muse Spark 1.1 |
| Muse Spark 1.2 | Meta | 39.56 | 45.89 | 45.9% | 39.6 | single model | Muse Spark 1.2 |
| Muse Spark 1.3 | Meta | 38.67 | 43.98 | 44.0% | 38.7 | single model | Muse Spark 1.3 |
| Muse Spark Open | Meta | 27.1 | 41.87 | 41.9% | 27.1 | single model | Muse Spark Open |
| Muse Wonder | Meta | 94.28 | 54.49 | 54.5% | 94.3 | single model | Muse Wonder |
| Nemotron 3 Ultra 550B A55B | NVIDIA | 25.28 | 31.93 | 31.9% | 25.3 | single model | Nemotron 3 Ultra 550B A55B |
| Qwen3.5 27B | Alibaba | 12.49 | 37.28 | 37.3% | 12.5 | single model | Qwen3.5 27B |
| Qwen3.6 27B | Alibaba | 19.48 | 47.8 | 47.8% | 19.5 | single model | Qwen3.6 27B |
| Qwen3.6 Flash | Alibaba | 8.69 | 34.23 | 34.2% | 8.7 | single model | Qwen3.6 Flash |
| Qwen3.7 Plus | Alibaba | 8.88 | 39.77 | 39.8% | 8.9 | single model | Qwen3.7 Plus |
| Qwen3.8 2.4T A95B | Alibaba | 32.28 | 48.76 | 48.8% | 32.3 | single model | Qwen3.8 2.4T A95B |
| Qwen3.8 27B | Alibaba | 14.25 | 43.4 | 43.4% | 14.2 | single model | Qwen3.8 27B |
| Qwen3.8 Flash | Alibaba | 2.5 | 41.68 | 41.7% | 2.5 | single model | Qwen3.8 Flash |
| Qwen3.8 Max | Alibaba | 30.54 | 46.27 | 46.3% | 30.5 | single model | Qwen3.8 Max |
| Qwen3.8 Max 0902 | Alibaba | 31.52 | 36.33 | 36.3% | 31.5 | single model | Qwen3.8 Max 0902 |
| Qwen3.8 Max Prime | Alibaba | 62.91 | 34.99 | 35.0% | 62.9 | single model | Qwen3.8 Max Prime |
| Solar Pro4 | Upstage | 2.14 | 23.33 | 23.3% | 2.1 | single model | Solar Pro4 |
| Tencent HY3 | Tencent | 2.05 | 43.21 | 43.2% | 2.1 | single model | Tencent HY3 |
Para cada um dos 8 roteadores, pelo menos um model individual que executamos pontuou tão alto ou mais alto e custou o mesmo ou menos por pergunta. No gráfico, a área verde marca resultados que custaram menos que GPT-6.1 Sol e pontuaram acima de 50%.
Para cada pergunta, o agente primeiro escolhe um dos 11 bancos de dados e depois escreve consultas SQL contra ele. Ele pode chamar um model até 10 vezes por pergunta, e o roteador escolhe o model para cada chamada. Um pool é o conjunto de models do qual um roteador pode escolher.
Pontuações por roteador
| Label | Label short | CI low | CI high | Score (%) |
|---|---|---|---|---|
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 57.17 | 65.39 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 51.82 | 60.42 | 56.21 |
| OpenRouter Auto Code | Auto Code | 48.37 | 56.98 | 52.77 |
| Not Diamond (19 models) | Not Diamond | 46.46 | 55.07 | 50.86 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 39.96 | 48.37 | 44.17 |
| Fireworks Nexus Auto | Nexus Auto | 31.74 | 40.15 | 35.95 |
| TypeSafe Jev | TypeSafe Jev | 25.62 | 33.27 | 29.45 |
| OpenRouter Auto | OpenRouter Auto | 24.86 | 32.7 | 28.68 |
| Sakana Fugu Max | Fugu Max | 23.52 | 31.36 | 27.34 |
Todos os 8 roteadores pontuaram claramente abaixo do GPT-6.1 Sol. O Switchyard chegou mais perto, 5.0 pontos abaixo. Seu intervalo de 95% se sobrepõe ao do Sol, mas o teste nas mesmas perguntas separa os dois (ver Estatísticas).
Cada roteador contra seu model mais usado
| Label | Label short | Router score | Alone score | Main model name | Main model short | Main model share | Router | Most used model |
|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 28.7% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 99% | 28.68 | 26.2 |
| TypeSafe Jev | TypeSafe Jev | 29.4% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 98% | 29.45 | 26.2 |
| Fireworks Nexus Auto | Nexus Auto | 35.9% | 36.1% | GLM 5.3 Flash | GLM 5.3 Flash | 99% | 35.95 | 36.14 |
| Not Diamond (19 models) | Not Diamond | 50.9% | 49.9% | GPT-5.6 Sol | GPT-5.6 Sol | 100% | 50.86 | 49.9 |
| OpenRouter Auto Code | Auto Code | 52.8% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 71% | 52.77 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 56.2% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 75% | 56.21 | 61.19 |
Dos seis roteadores que nomeiam seu model, quatro pontuaram dentro de 3.3 pontos de seu model mais usado. O Switchyard dividiu suas chamadas entre GPT-6.1 Sol e GPT-6 Luna, e o Auto Code entre GPT-6.1 Sol e GLM 5.3. Eles pontuaram 5.0 e 8.4 pontos abaixo do Sol.
Os roteadores não compartilharam um pool, então essas lacunas refletem tanto o roteador quanto os models que ele podia escolher. A seção de pool compartilhado compara três roteadores com os mesmos dois models. Definimos os pools para Switchyard e Not Diamond (ver Roteadores e pools).
Tempo por pergunta
| Label | Label short | Sec label | Seconds |
|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 8.8 s | 8.8 |
| TypeSafe Jev | TypeSafe Jev | 9.0 s | 8.96 |
| OpenRouter Auto Code | Auto Code | 10.4 s | 10.42 |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 10.7 s | 10.69 |
| Fireworks Nexus Auto | Nexus Auto | 10.8 s | 10.81 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 12.7 s | 12.68 |
| Sakana Fugu Max | Fugu Max | 13.3 s | 13.28 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 15.4 s | 15.44 |
| Not Diamond (19 models) | Not Diamond | 17.3 s | 17.28 |
Not Diamond com 19 models e o Switchyard foram os roteadores mais lentos. Eles levaram 17.3 e 15,4 segundos por pergunta na mediana. O GPT-6.1 Sol levou 10,7 segundos. O OpenRouter Auto e Jev foram os mais rápidos, com 8.8 e 9,0 segundos. Ambos enviaram quase todas as chamadas para Claude Haiku 5.5.
As chamadas do Auto Code para o GPT-6.1 Sol rodaram no nível de prioridade. Elas geraram em 1,5 segundos na mediana, contra 1,8 segundos para o GPT-6.1 Sol sem roteador. O roteamento através do Auto Code adicionou cerca de 0,2 segundos por chamada. Por pergunta, os dois levaram quase o mesmo tempo, 10.4 e 10,7 segundos na mediana.
Custos e taxas dos roteadores
| Label | Label short | Total | Per correct | Billed | Computed from list prices |
|---|---|---|---|---|---|
| Fireworks Nexus Auto | Nexus Auto | $1.9 | $5.4 | — | 1.93 |
| OpenRouter Auto | OpenRouter Auto | $2.0 | $6.9 | 1.97 | — |
| TypeSafe Jev | TypeSafe Jev | $2.1 | $7.1 | 2.09 | — |
| Unbiased Pareto 26.10 | Unbiased Pareto | $13.2 | $29.8 | 13.18 | — |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | $15.4 | $25.2 | 15.45 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | $16.6 | $29.5 | 16.6 | — |
| OpenRouter Auto Code | Auto Code | $24.6 | $46.6 | 24.62 | — |
| Sakana Fugu Max | Fugu Max | $30.0 | $109.6 | 29.96 | — |
| Not Diamond (19 models) | Not Diamond | $50.5 | $99.3 | 43.76 | 6.76 |
O custo de um roteador é a fatura do model mais qualquer taxa de juiz ou de seleção. Se uma tentativa falhou e a pergunta foi executada novamente, contamos apenas a tentativa final. No gráfico, as partes listradas são calculadas a partir das tabelas de preços e o restante vem das faturas.
O Fireworks Nexus Auto custou menos por resposta correta, $5,4 por 1.000 respostas corretas a preços de tabela. Entre os roteadores com custo faturado, o OpenRouter Auto custou menos, $6.9.
Alguns roteadores custaram mais do que seu model mais usado. O custo extra veio do juiz do Switchyard, da taxa de seleção da Not Diamond e do nível de prioridade nas chamadas do Auto Code para o GPT-6.1 Sol. Em cada caso, o roteador não pontuou claramente acima de seu model mais usado.
Custo contra models individuais
Quatro roteadores custaram mais do que o GPT-6.1 Sol, que pontuou 61,2% por $15,4 por 1.000 perguntas. Todos os quatro pontuaram menos:
- Not Diamond com 19 models: 50,9% por $50.5. A maior parte disso veio de suas chamadas ao GPT-5.6 Sol, e sua taxa de seleção adicionou $6,8 (ver Taxas e níveis de preço).
- Sakana Fugu Max: 27,3%, a menor pontuação dos 8 roteadores, por $30.0. Ele não nomeia seu model. Fez 6.8 chamadas de model por pergunta, contra 5.5 do GPT-6.1 Sol. Sua chamada média custou cerca de 1.6 vezes uma chamada do GPT-6.1 Sol.
- OpenRouter Auto Code: 52,8% por $24.6. Enviou 71% das chamadas para o GPT-6.1 Sol, e quase todas elas rodaram no nível de prioridade da OpenAI (ver Taxas e níveis de preço).
- NVIDIA Switchyard: 56,2% por $16.6. Suas chamadas para GPT-6.1 Sol e GPT-6 Luna custaram $13,7, menos do que os $15,4 do Sol. Seu model de juiz adicionou $2,9 (ver Taxas e níveis de preço).
Nenhum dos três roteadores mais baratos pontuou acima do GPT-6 Luna, que pontuou 38,8% por $1,3 a cada 1.000 perguntas. O OpenRouter Auto e o TypeSafe Jev pontuaram cerca de 10 pontos a menos, 28,7% e 29,4%, por $2,0 e $2.1. O Fireworks Nexus Auto pontuou 35,9% por $1,9, sem diferença clara em relação ao Luna.
Taxas e níveis de preço
- Para escolher um model para cada chamada, o Switchyard primeiro verifica os resultados das ferramentas até aquele momento. Erros e falhas repetidas apontam para o model mais forte. Quando os resultados das ferramentas não definem a escolha, como na primeira chamada de uma pergunta, um pequeno model de juiz, Gemini 3.5 Flash Lite, lê a pergunta e escolhe o model.1 Cada chamada do juiz é faturada como uma chamada normal de model. No pool compartilhado, o juiz adicionou $3,2 por 1.000 perguntas.
- A Not Diamond cobra uma taxa por cada escolha de model. Contamos cada escolha a $0,001, o preço em sua lista de preços.2 No pool compartilhado, a taxa chegou a $6,3 por 1.000 perguntas, 40% do total de $15,8 da Not Diamond.
- Auto Code obteve o nível de prioridade da OpenAI em quase todas as suas chamadas ao GPT-6.1 Sol. Pagou 2.04 vezes o preço por chamada do GPT-6.1 Sol. A OpenRouter diz que o nível de prioridade de um model fechado serve apenas quando uma solicitação o pede ou fixa o provedor,3 mas nossas solicitações não fizeram nenhum dos dois. Sem o nível, o Auto Code teria custado cerca de $13 por 1.000 perguntas em vez de $24.6.
Com 19 models, as chamadas da Not Diamond para o GPT-5.6 Sol custaram $43,8 por 1.000 perguntas, contra $60,8 para o GPT-5.6 Sol em nosso benchmark de texto para SQL. Um desconto de cache pode explicar a lacuna. A Not Diamond obteve o preço em cache em 69,5% de seus tokens de entrada. Nossa execução de texto para SQL não registrou o uso de cache, então não podemos confirmar isso.
Escolha e troca de model
| Label | Label short | Claude Haiku 5.5 | DeepSeek V4.1 Flash | GLM 5.3 | GLM 5.3 Flash | GPT-5.6 Sol | GPT-6 Luna | GPT-6.1 Sol | Other |
|---|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 98.63 | 1.37 | — | — | — | — | — | — |
| TypeSafe Jev | TypeSafe Jev | 98.29 | 1.03 | 0.3206 | — | — | — | 0.1425 | 0.2138 |
| Fireworks Nexus Auto | Nexus Auto | — | — | 1.15 | 98.85 | — | — | — | — |
| Not Diamond (19 models) | Not Diamond, 19 models | — | — | — | — | 100 | — | — | — |
| OpenRouter Auto Code | Auto Code | — | — | 29.43 | — | — | — | 70.57 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard, Sol + Luna | — | — | — | — | — | 25.02 | 74.98 | — |
Das 9 execuções de roteador nas configurações padrão que nomeiam o model, cinco enviaram pelo menos 98% de suas chamadas para um único model. Foram eles OpenRouter Auto em seu próprio pool, Jev, Nexus Auto e Not Diamond em ambos os pools.
A lista de 19 models da Not Diamond também incluía Gemini 3 Flash Preview, que pontuou 59,7% por $9,4 a cada 1.000 perguntas. Nenhuma das escolhas da Not Diamond foi para o Gemini 3 Flash Preview. Todas as chamadas foram para o GPT-5.6 Sol, que pontuou 49,9%.
Troca dentro de uma pergunta
Nas configurações padrão, apenas o Switchyard trocou de models dentro de mais de 5% das perguntas. Ele fez isso em 308 de 523 perguntas com GPT-6.1 Sol e GPT-6 Luna, e em 35 no pool compartilhado.
Cada pergunta foi executada como uma sessão de roteador, com a mesma chave de sessão em cada chamada. Os docs do OpenRouter no Switchyard docs e no Pareto docs recomendam isso para agentes. Uma chave de sessão não impede um roteador de trocar de models. A maioria dos roteadores pode escolher um model para cada chamada. Os docs do OpenRouter no Auto docs dizem que uma troca custa mais, porque o novo model precisa reconstruir o prompt cache. Portanto, o Auto troca apenas quando vale a pena. Os docs da Fireworks no Nexus Auto docs dizem que ele escolhe um model para cada nova mensagem do usuário e o mantém para as chamadas de ferramentas dessa mensagem. Nosso agente envia uma mensagem de usuário com a pergunta e uma segunda que solicita a resposta final. Todas as 9 trocas do Nexus Auto vieram nessa segunda mensagem.
Comparação com mistura aleatória
Comparamos o Switchyard em ambos os pools e o Auto Code com uma mistura aleatória. A mistura aleatória responde a cada pergunta com um model, escolhido aleatoriamente nas proporções de chamadas do roteador. Sua pontuação esperada vem de nossas execuções de model individual.
O Switchyard com Sol e Luna pontuou 56,2%, contra 55,7% de sua mistura aleatória. O Switchyard no pool compartilhado pontuou 55,1% contra 52,4%. O Auto Code pontuou 52,8% contra 54,7%. Nenhum dos três roteadores se saiu claramente melhor ou pior do que sua mistura aleatória.
Três roteadores com um pool
| Label | Label short | Cost label | Same two models, three routers |
|---|---|---|---|
| Not Diamond, cost setting | Not Diamond, cost | $12.8 | 59.66 |
| Gemini 3 Flash Preview (no router) | Gemini (no router) | $9.4 | 59.66 |
| Not Diamond, default setting | Not Diamond, default | $15.8 | 59.27 |
| NVIDIA Switchyard | Switchyard | $11.2 | 55.07 |
| OpenRouter Auto | OpenRouter Auto | $3.4 | 32.89 |
| DeepSeek V4 Flash (no router) | DeepSeek (no router) | $2.9 | 30.4 |
Para separar os models do roteamento, demos a três roteadores os mesmos dois models. O Gemini 3 Flash Preview é o forte, e o DeepSeek V4 Flash é o barato.
Resultados do pool compartilhado
Nas configurações padrão, nenhum roteador mostrou diferença clara em relação ao seu model mais usado, e nenhum pontuou acima do Gemini 3 Flash Preview.
A Not Diamond pontuou 1.9 pontos abaixo do GPT-6.1 Sol, e o Switchyard 6.1 pontos abaixo. Nosso teste não confirmou essas lacunas.
- Na configuração padrão, a Not Diamond enviou 100% das chamadas para o Gemini 3 Flash Preview. Pontuou 59,3% contra 59,7% do Gemini 3 Flash Preview. Custou $15,8 por 1.000 perguntas contra $9.4.
- Com a configuração de custo, a Not Diamond enviou 62% das chamadas para o DeepSeek V4 Flash. Ainda assim deu cada resposta final com o Gemini 3 Flash Preview. Pontuou 59,7%, o mesmo que o Gemini 3 Flash Preview, por $12,8 contra $9.4. Sua taxa de seleção, $7,5, foi mais do que o custo de suas chamadas de model.
- O Switchyard enviou 75% das chamadas para o Gemini 3 Flash Preview e pontuou 55,1%, sem diferença clara em relação à Not Diamond.
- O Auto enviou 97% das chamadas para o DeepSeek V4 Flash e pontuou 32,9%, próximo dos 30,4% do DeepSeek V4 Flash.
Adequação do model e limite de chamadas
Não encontramos nenhum sinal claro de que algum roteador tenha escolhido o model adequado à pergunta neste pool. Há 170 perguntas que o Gemini 3 Flash Preview resolve e o DeepSeek V4 Flash erra, e 17 em que ocorre o inverso. Cada roteador enviou uma proporção semelhante de suas chamadas para o DeepSeek V4 Flash em ambos os conjuntos, com no máximo 10 pontos de diferença. O conjunto de 17 é pequeno demais para mostrar uma diferença pequena.
O Auto atingiu o limite de 10 chamadas com mais frequência, em 37,3% das perguntas, contra 18,9% do Switchyard e 16,8% da Not Diamond.
O OpenRouter Auto também levou mais tempo neste pool, 17,5 segundos por pergunta na mediana. A Not Diamond levou 9,0 segundos com os mesmos dois models.
Cada roteador em resumo
Not Diamond
O roteador padrão da Not Diamond vem pré-treinado, então você não precisa treiná-lo antes de usar. Você também pode treinar um roteador personalizado com seus próprios dados.4 A Not Diamond não chama o model. Ela retorna o nome do model que escolhe, e seu próprio código então chama esse model. Os outros roteadores fazem a chamada por si mesmos. Por padrão, a Not Diamond escolhe pela qualidade. Uma configuração de compensação em cada solicitação pode fazê-la priorizar custo ou latência.5 Usamos o roteador padrão e executamos sua configuração de custo uma vez, no pool compartilhado.
NVIDIA Switchyard
O Switchyard roda na OpenRouter. Você lista até três models, e ele escolhe entre o mais barato e o mais caro deles. Ele não adiciona nenhuma taxa de roteamento própria.1
OpenRouter Auto
O OpenRouter Auto escolhe um model e um esforço de raciocínio para cada solicitação e não adiciona taxa.6 Uma lista em `allowed_models` é um limite rígido, e uma faixa de custo baixa, média ou alta define a política. Os docs dizem que o padrão custa mais do que o Auto antigo e sugerem a faixa baixa para manter os custos mais próximos dele. Em nosso teste, a faixa baixa pontuou 28,3% contra 28,7% do padrão, com os mesmos $2,0 por 1.000 perguntas, sem diferença clara.
OpenRouter Auto Code
O Auto Code roda no mesmo mecanismo do Auto, com uma política ajustada para agentes de codificação, e não adiciona taxa.7 Ele prefere mudar o esforço de raciocínio em vez de trocar de models, para manter o prompt cache. Trata `allowed_models` como um limite rígido. Quando demos a ele o pool compartilhado, todas as solicitações falharam com um erro que dizia que nenhum model medido atendeu à solicitação.
TypeSafe Jev
O Jev escolhe um model e um esforço de raciocínio para cada solicitação, e cada solicitação é faturada pelo preço do model para o qual vai.8 Uma lista de models é apenas uma preferência, e somente `excluded_models` bloqueia um model.9 Sua pontuação não mostrou diferença clara em relação ao OpenRouter Auto. Em 14 de novembro de 2026, a página de benchmark de roteadores da OpenRouter diz que o Auto agora é alimentado pelo Jev.10
Fireworks Nexus Auto
O Nexus Auto é um roteador da Fireworks, chamado com o id de model auto. Ele não aceita lista de models. Com uma chave da Fireworks, ele escolhe entre os models abertos da Fireworks.11
Unbiased Pareto 26.10
A OpenRouter lista o Unbiased Pareto 26.10 a $0,80 por milhão de tokens de entrada e $3,20 por milhão de tokens de saída.12 Ele não aceita lista de models, e a página não diz como escolhe um model nem quais models usa. Suas respostas nomeiam apenas o roteador. Pontuou 44,2% por $13,2 a cada 1.000 perguntas, abaixo e mais caro do que o Gemini 3 Flash Preview.
Sakana Fugu Max
A Sakana diz que o Fugu Max roda seu maior pool de models. O pool é fixo, e a Sakana não lista todos os seus membros. Ele custa $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída, mais $0,007 para cada chamada interna de ferramenta web.13
Metodologia do benchmark de roteadores agênticos
Todos os roteadores receberam o mesmo agente, prompt, ferramentas e ordem de perguntas. Um proxy local registrou o model, tokens, custo e duração de cada chamada.
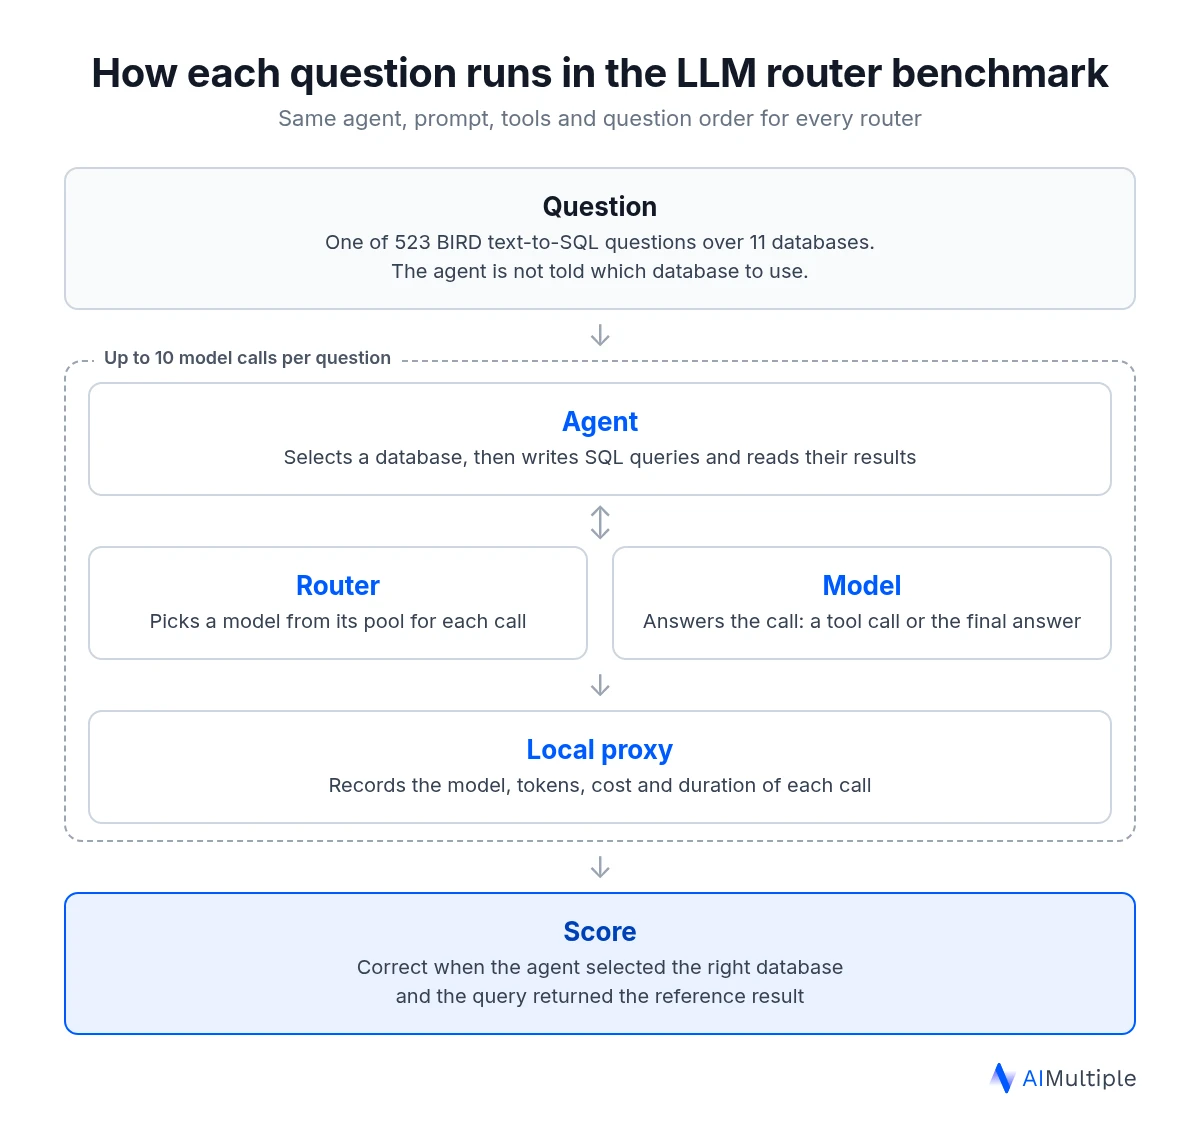
Usamos 523 perguntas do nosso benchmark de texto para SQL, que se baseia no BIRD, um dataset público de texto para SQL. O agente não é informado sobre qual dos 11 bancos de dados usar, e os nomes dos bancos de dados são substituídos por aliases. Uma pergunta conta como correta quando o agente escolhe o banco de dados certo e sua consulta retorna o resultado de referência. Um erro conta como falha. Cada solicitação pode levar até 600 segundos.
Chamamos seis roteadores através da OpenRouter com os ids openrouter/auto, openrouter/auto-code, typesafe/jev-router, nvidia/switchyard, unbiased/pareto-26.10 e sakana/fugu-max. A Not Diamond rodou através de sua modelSelect API, e chamamos cada model escolhido por ela através da OpenRouter. O Fireworks Nexus Auto rodou através da Fireworks API. Também executamos o GPT-6.1 Sol sem roteador na mesma configuração. As outras pontuações de model individual vêm do nosso benchmark de texto para SQL nas mesmas 523 perguntas.
O tempo é a mediana de segundos por pergunta, medida do nosso lado ao longo de todas as etapas do agente. Cada roteador e pool rodou uma vez, de 13 a 16 de novembro de 2026. Todas as perguntas terminaram sem erro.
Roteadores e pools
Incluímos roteadores que tinham uma API pública no momento da execução e aceitavam chamadas de ferramentas. O OpenRouter Auto e o Auto Code rodaram após 6 de novembro de 2026, quando a OpenRouter reconstruiu o Auto e lançou o Auto Code.14
Seis roteadores rodaram em seu próprio pool com os padrões do fornecedor. Definimos o pool para o Switchyard e para a Not Diamond. Sem uma lista de models, o Switchyard escolhe dois dos 20 models com maior gasto na OpenRouter nos últimos sete dias, então o par muda com o tempo. Para manter o par fixo, demos a ele o GPT-6.1 Sol e o GPT-6 Luna. A Not Diamond exige uma lista de models. Demos a ela 19 models que ela suporta e que também testamos em nosso benchmark de texto para SQL.
Para comparar o roteamento com os mesmos models, executamos Not Diamond, NVIDIA Switchyard e OpenRouter Auto em um pool compartilhado. Essas execuções não são classificadas.
Um roteador só poderia participar se mantivesse uma lista de models que demos a ele. A Not Diamond não suporta o GPT-6.1 Sol nem o GPT-6 Luna, o par que o Switchyard usou acima. Então escolhemos o Gemini 3 Flash Preview e o DeepSeek V4 Flash, um model forte e um barato compatíveis com ela.15 O Switchyard e o OpenRouter Auto usaram a mesma lista. Os outros cinco roteadores não puderam ser restringidos a essa lista (ver Cada roteador em resumo).
Também testamos o OpenRouter Pareto Code, mas não o classificamos. O usuário escolhe uma das três faixas. Dentro de uma faixa, ele envia chamadas para o model disponível mais barato e não adapta sua escolha a cada turno.
Em 13 de novembro, a faixa padrão do Pareto Code continha um model, o Claude Fable 5.2. Na faixa Medium que escolhemos, o Pareto Code enviou todas as 3.083 chamadas para o Kimi K3 e pontuou 43,0% por $28,4 a cada 1.000 perguntas.
Estatísticas
Os colchetes no gráfico de pontuações mostram um intervalo de confiança de 95%, calculado com um bootstrap sobre as 523 perguntas. Ele mostra o quanto uma pontuação depende de quais perguntas foram escolhidas.
Para comparar dois resultados nas mesmas perguntas, usamos um teste exato de McNemar. Ele conta apenas as perguntas que um resultado acertou e o outro errou. Como fizemos muitas comparações, ajustamos os resultados com o método de Holm a um nível de 5%. Quando o teste não separa dois resultados, dizemos que não há diferença clara.
Por exemplo, o Switchyard no pool compartilhado ficou 6.1 pontos abaixo do GPT-6.1 Sol, sem diferença clara. Com Sol e Luna, ficou 5.0 pontos abaixo, e essa lacuna é clara. No pool compartilhado, o Switchyard e o Sol divergiram em 146 perguntas, nas quais um acertou e o outro errou. Com Sol e Luna, divergiram em apenas 44. Quando mais perguntas divergem, uma lacuna precisa ser maior antes de a chamarmos de clara.
As comparações de roteadores com o GPT-6.1 Sol usam sua execução de 61,2% na mesma configuração dos roteadores. As misturas aleatórias e outras comparações de model individual usam a execução de 61,4% do Sol do nosso benchmark de texto para SQL. No primeiro gráfico, ela é rotulada como GPT-6.1 Sol (texto para SQL). Não há diferença clara entre as duas execuções.
Limitações
- Uma execução por roteador e pool. Nas duas execuções do GPT-6.1 Sol, 33 perguntas estavam certas em uma execução e erradas na outra.
- Um tipo de tarefa, com até 10 chamadas de model por pergunta. Tarefas de agente mais longas podem dar outros resultados.
- As escolhas de models mudam com a data. Reexecutamos 17 perguntas no OpenRouter Auto, no Auto Code e no Jev em 17 de novembro, quatro dias após o início de suas execuções. Os roteadores escolheram dois models que não tínhamos visto nessas execuções. O Auto Code enviou 63% de suas chamadas para um deles.
- O limite de 10 chamadas atingiu o Sakana Fugu Max em 16,1% das perguntas. Mesmo que tivesse respondido todas elas corretamente, ainda pontuaria abaixo do GPT-6.1 Sol.
- Pools diferentes dos três que definimos podem dar outros resultados.
- A taxa de seleção da Not Diamond usa $0,001 por escolha, a tarifa em sua página de preços antiga. Sua página atual cobra $0,05 por milhão de tokens roteados.
- As perguntas vêm dos conjuntos públicos do BIRD, então os models podem tê-las visto no treinamento.
 Adicionar como fonte preferencial
Perguntas frequentes
Um roteador LLM fica entre uma aplicação e um conjunto de models e escolhe um model para cada solicitação. O objetivo é enviar o trabalho fácil para um model barato e o trabalho difícil para um forte. Em um agente, uma pergunta envolve várias chamadas, então um roteador pode escolher outro model para cada chamada.
Dos 8 roteadores, o NVIDIA Switchyard pontuou mais alto, 56,2%. O OpenRouter Auto Code pontuou 52,8% e a Not Diamond com 19 models pontuou 50,9%. Não há diferença clara entre o Switchyard e o Auto Code, nem entre o Auto Code e a Not Diamond.
No pool compartilhado, a Not Diamond pontuou 59,3%, a maior pontuação de qualquer roteador em sua configuração padrão. O Switchyard pontuou 55,1% nesse pool, sem diferença clara em relação à Not Diamond.
Não neste teste. Cada um dos 8 roteadores pontuou claramente abaixo do GPT-6.1 Sol.
No pool compartilhado, a Not Diamond ficou 1.9 pontos abaixo do GPT-6.1 Sol e o Switchyard 6.1 pontos abaixo. Nosso teste não confirmou essas lacunas.
O Fireworks Nexus Auto teve o menor custo, $1,9 por 1.000 perguntas, calculado a partir das tabelas de preços. O OpenRouter Auto custou $2,0 e o TypeSafe Jev $2.1. Cada um enviou quase todas as chamadas para um model barato: Claude Haiku 5.5 para o OpenRouter Auto e o TypeSafe Jev, e GLM 5.3 Flash para o Nexus Auto.
A Not Diamond pontuou 59,3% no pool compartilhado e 50,9% com 19 models. O OpenRouter Auto pontuou 32,9% no pool compartilhado e 28,7% em seu próprio pool. O Switchyard pontuou 56,2% com GPT-6.1 Sol e GPT-6 Luna e 55,1% no pool compartilhado, uma lacuna de 1.1 pontos sem diferença clara.
Leitura adicional
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{yila2026,
  author = {Yıla, Berkay},
  title  = {{LLM Roteador Benchmark: 8 roteadores em 523 tarefas de banco de dados agênticas}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/llm-router}},
  note   = {AIMultiple. Acessado em 18 novembro 2026}
}Resultados e carimbos de data/hora de 135 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 7 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Links de referência





Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.