


Web Arşivi API'ler: 4 Önde Gelen Sağlayıcı Test Edildi ve Karşılaştırıldı

Bir web arşivi, siz daha istemeden önce toplanmış sayfaları tutar; böylece siteleri kendiniz taramadan bu sayfaları çekebilirsiniz. Her sağlayıcının ne depoladığı ve bunun ne kadarını vereceği büyük ölçüdeğişir.
Nasıl çalıştıklarını ve ne döndürdüklerini görmek için 4'ünü örnek sorgularla test ettik.
Web arşivi API'ler özellik karşılaştırması
- Ham HTML mevcut: sayfa işaretlemesi sunucunun gönderdiği haliyle. Webz.io'nun şartları “tam HTML sayfalarından” söz eder, ancak arşiv bir
textalanı döndürür ve ham dosyalar üzerinde hiçbir hak vermez. - Kendi depolama alanınıza toplu teslimat: kontrol ettiğiniz bir hedefe yazılan filtrelenmiş bir seçim. Common Crawl'ın derlemi indirmeniz için genel S3 üzerinde durur; hiçbir şey hiçbir yere gönderilmez. Webz.io yalnızca kendi API'si aracılığıyla teslimat yapar.
- Canlı scraping aynı sağlayıcıdan: yalnızca arşiv endpoint'ini değil ürün ailesini kapsar; böylece tek bir tedarikçinin hem arşivlenmiş hem de hiç arşivlenmemiş sayfaları karşılayıp karşılayamayacağını yanıtlar. Exa, fallback'in aynı çağrının içinde olduğu tek seçenektir.
Fiyat ve ücretsiz krediler
Bright Data, son 24 saate ait veriler için 1.000 sayfa başına $0,2 ve daha eski her şey için 1.000 sayfa başına $1 ücret alır. Exa, sayfa fiyatına ek olarak 1.000 arama başına $7 ücret alır; bu nedenle sayfaları getirmeden önce 1.000 sayfayı bulmak kabaca $0,70 ekler ve bu da aynı görünen iki $1 rakamının pratikte farklı davranmasına neden olur.
Ücretsiz krediler veri teslimatını karşılar: dördünde de sorgulama ücretsiz'dir; fark, ücretsiz kredilerin veriyi dışarı almak için de ödeme yapıp yapmadığıdır. Bright Data günde 100 arşiv aramasına ücretsiz izin verir; her biri, herhangi bir ücret alınmadan önce eşleşen kayıt sayısını ve teslimat fiyatını döndürür, böylece bir iş ücretsiz olarak boyutlandırılabilir. Webz.io aynı şekilde çalışır; ücretsiz bir örnek ve maliyet tahmini sunar, ancak bir döküm ayrıca satın alınmış ön ödemeli kredi gerektirir. Common Crawl ve Exa, ücretsiz kredilerin gerçek alım için ödeme yapmasına izin verir.
Web arşivleme API'leri
Bright Data Web Archive API, altyapısının Unlocker ve SERP API'leri aracılığıyla zaten topladığı sayfalara erişim satar. Bir tarayıcı çalıştırmak yerine, filtrelerle ne istediğinizi tanımlar, maliyet tahminini gözden geçirir ve eşleşen sayfaların kendi depolama alanınıza teslim edilmesini sağlarsınız.
Filtreler
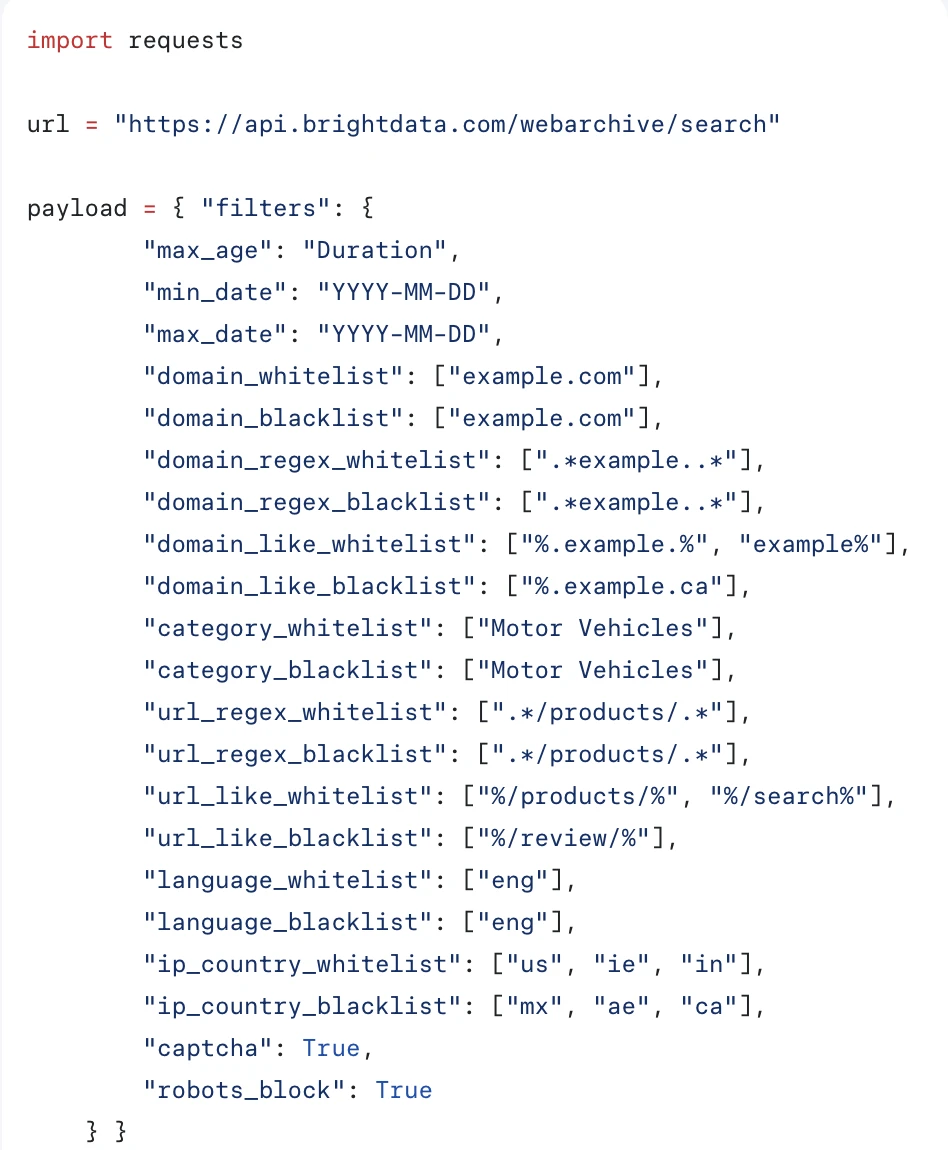
Her şey 20 alanlı tek bir filters nesnesi üzerinden yürür: zaman aralığı, alan adı, URL deseni, kategori, dil, ülke ve toplama sonucu. Zaman zorunludur ve kategori 30 değerlik kapalı bir listedir; bu nedenle sayfalar içeri girerken sınıflandırılır.
İki alan, sayfanın ne içerdiğinden çok nasıl toplandığını tanımlar. ip_country, sayfayı toplayan çıkış IP'sinin ülkesine göre filtreler ve arşivin proxy ağının bir yan ürünü olduğunu doğrular. captcha ve robots_block yalnızca bir CAPTCHA'nın tetiklendiği veya bir robots kuralının uygulandığı kayıtları döndürür; böylece engellenen girişimler atılmak yerine depolanır.
Arama ve maliyet
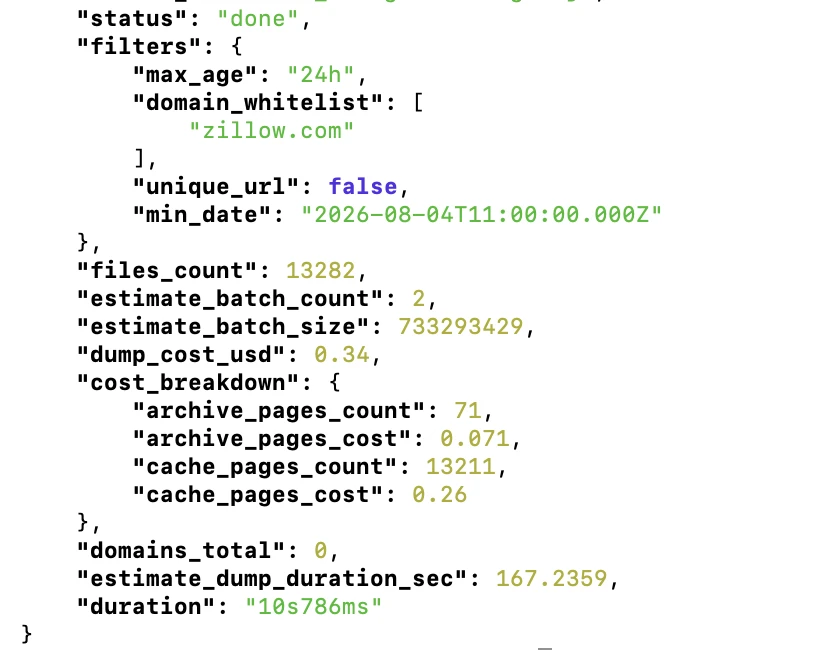
Arama ücretsiz'dir, günde 100 sorguya kadar çıkar ve yanıt, ödeme yapmadan önce bir işi boyutlandırmak için gereken her şeyi taşır: eşleşen kayıt sayısı, tahmini teslimat maliyeti ve kaç sayfanın 24 saatlik önbellek katmanında, kaçının arşiv katmanında olduğunu gösteren bir dağılım.
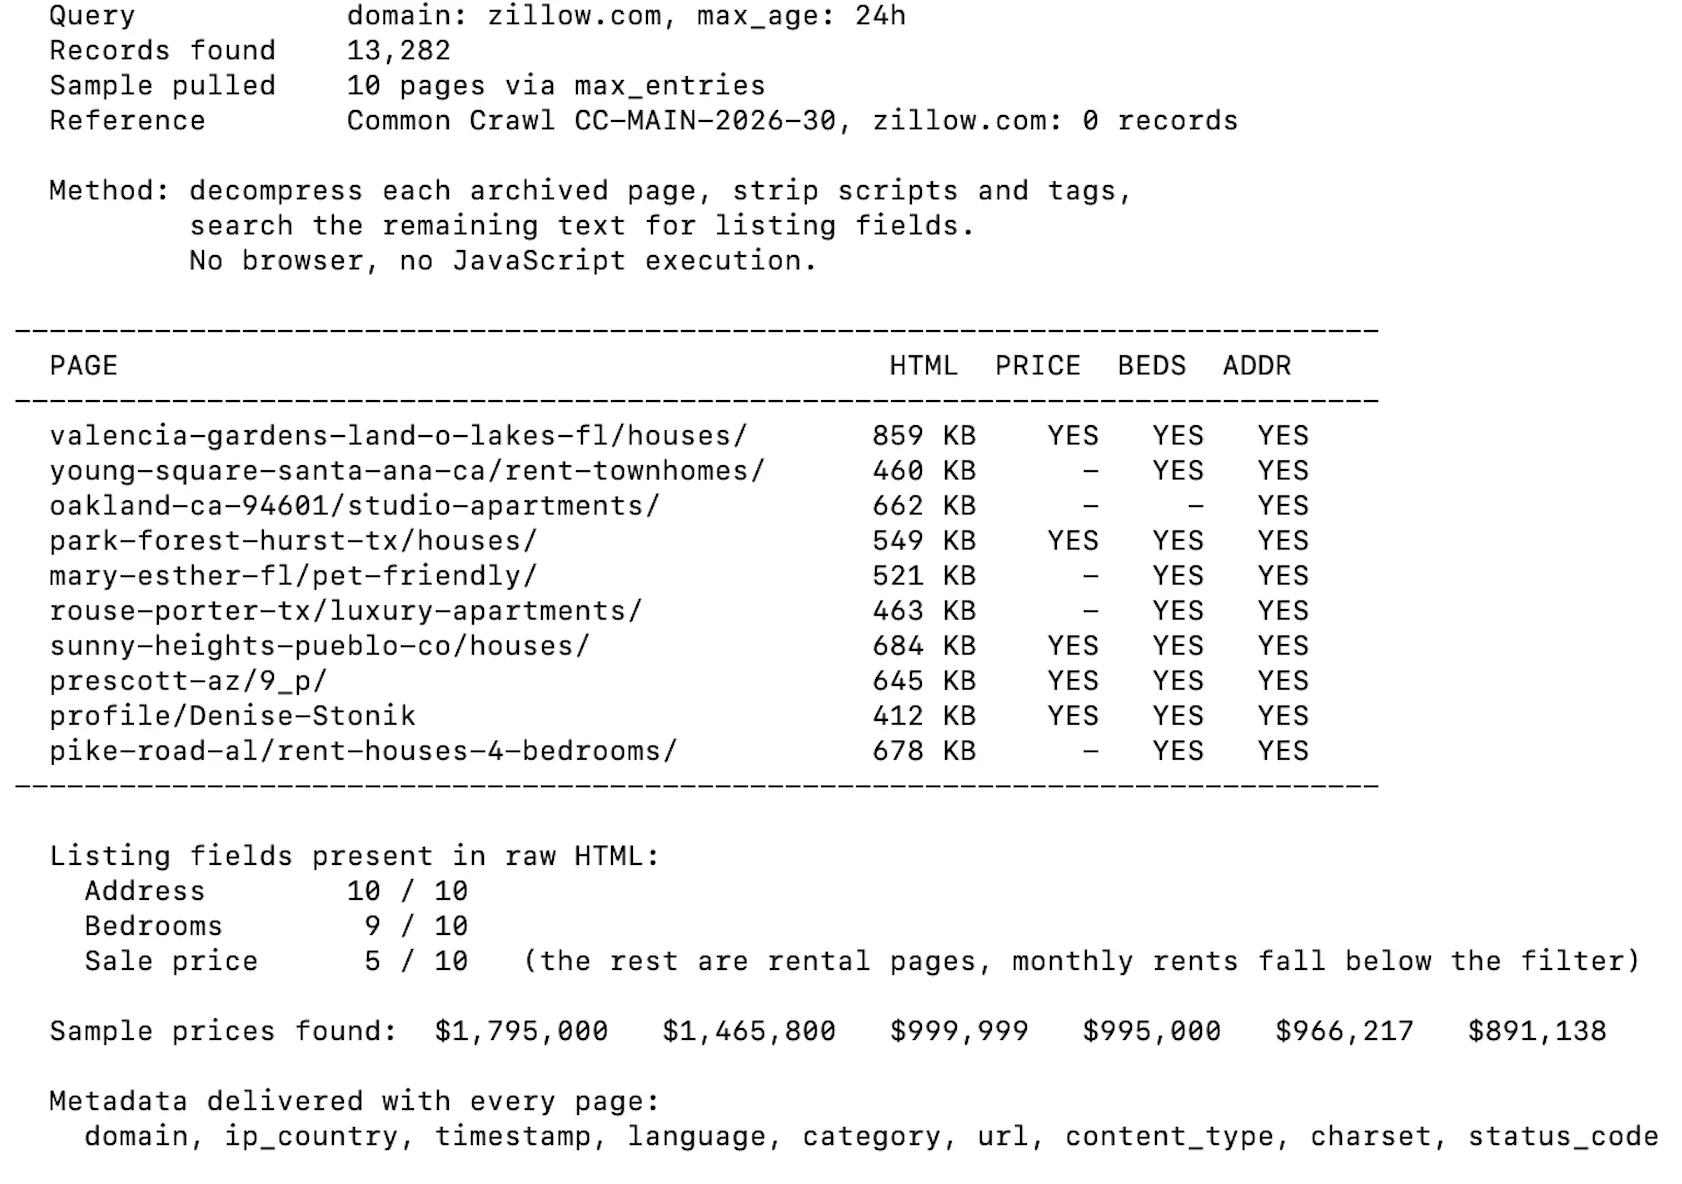
- Tarayıcıları engelleyen sitelerin kapsamı: Common Crawl, aylık taramanın tamamında zillow.com için sıfır sayfa tutar. Bright Data, tek bir 24 saatlik pencere için 13.282 kayıt döndürdü.
- Sorgu hızı pencereyle ölçeklenir: redfin.com üzerindeki 240 günlük sorgu, 1 dakika 53 saniyede 59.831 kayıt döndürdü. 24 saatlik zillow.com sorgusu 10,8 saniyede döndü.
- İki depolama katmanı: Son 24 saate ait veriler 1.000 sayfa başına $0,2 tutar. Daha eski her şey, 1.000 sayfa başına $1 karşılığında S3 Glacier Deep Archive'a taşınır. Teslimat süresi de bunu izler: 24 saatlik işimiz yaklaşık 30 saniyede ulaştı; 240 günlük iş ise onlarca dakika boyunca
restoring_archive_dataiçinde kaldı. - Kendi depolama alanınıza teslimat: Amazon S3, Azure Blob Storage, Google Cloud Storage veya webhook. Webhook yolunu test ettik; on sayfa, sayfa başına bir
.html.gzve bir.meta.jsoniçeren tek bir tar olarak ulaştı. - Taahhüt vermeden önce örnek alın:
max_entries, bir teslimatın kaç dosya içereceğini sınırlar; böylece 59.831 kayıtlık bir sorgu, bir sentin kesri karşılığında on sayfayla örneklenebilir.
Günde 100 ücretsiz arşiv aramasını Bright Data ile edinin
Ücretsiz Erişim Elde EtDosyalarda gerçekte ne var
Her sayfa, sunucunun gönderdiği haliyle ve dokuz metadata alanıyla gelir: domain, url, timestamp, language, category, ip_country, content_type, charset ve status_code. Bu ham HTML'in bir tarayıcı olmadan kullanılabilir olup olmadığını kontrol etmek için on arşivlenmiş Zillow sayfasını açtık, script'leri ve etiketleri çıkardık ve kalan metinde ilan alanlarını aradık.
Common Crawl, açık web'in taramasını yaklaşık ayda bir yayınlayan ve bunu ücretsiz veren kâr amacı gütmeyen bir kuruluştur. Hesap, anahtar ve kota yoktur. Karşılığında bir hizmet değil, dosyalar alırsınız: size hiçbir şey teslim edilmez ve tek sayfa aramasının ötesindeki her şey kendi işlemenizi çalıştırmayı gerektirir.
Format seçme
Her tarama birkaç formatta gelir. Ham HTTP yanıtları orijinal HTML'i taşır. Bir metadata extract'i bağlantıları, başlıkları ve header'ları JSON olarak taşır. Düz metin sürümü, işaretleme kaldırılmış olarak makale metnini taşır. İki küçük set, robots.txt dosyalarını ve 200 olmayan yanıtları kapsar.
Seçim önemlidir çünkü tek yönlüdür. Düz metin çok daha küçüktür ve çalışması daha hızlıdır, ancak etiketler, nitelikler ve gömülü JSON-LD ondan çıkarılmıştır; bu nedenle yapılandırılmış çıkarım ham setten başlamalıdır.
Filtrelenmiş teslimat yoktur. Bir format seçer, ihtiyacınız olanı indirir ve kendiniz işlersiniz.
Sayfa bulma
İki mekanizma vardır ve farklı soruları yanıtlarlar. CDX sunucusu, bir web formu veya bir API aracılığıyla tek URL'li aramaları yönetir. Parquet olarak yayınlanan sütunlu dizin, toplu soruları SQL aracılığıyla yönetir.
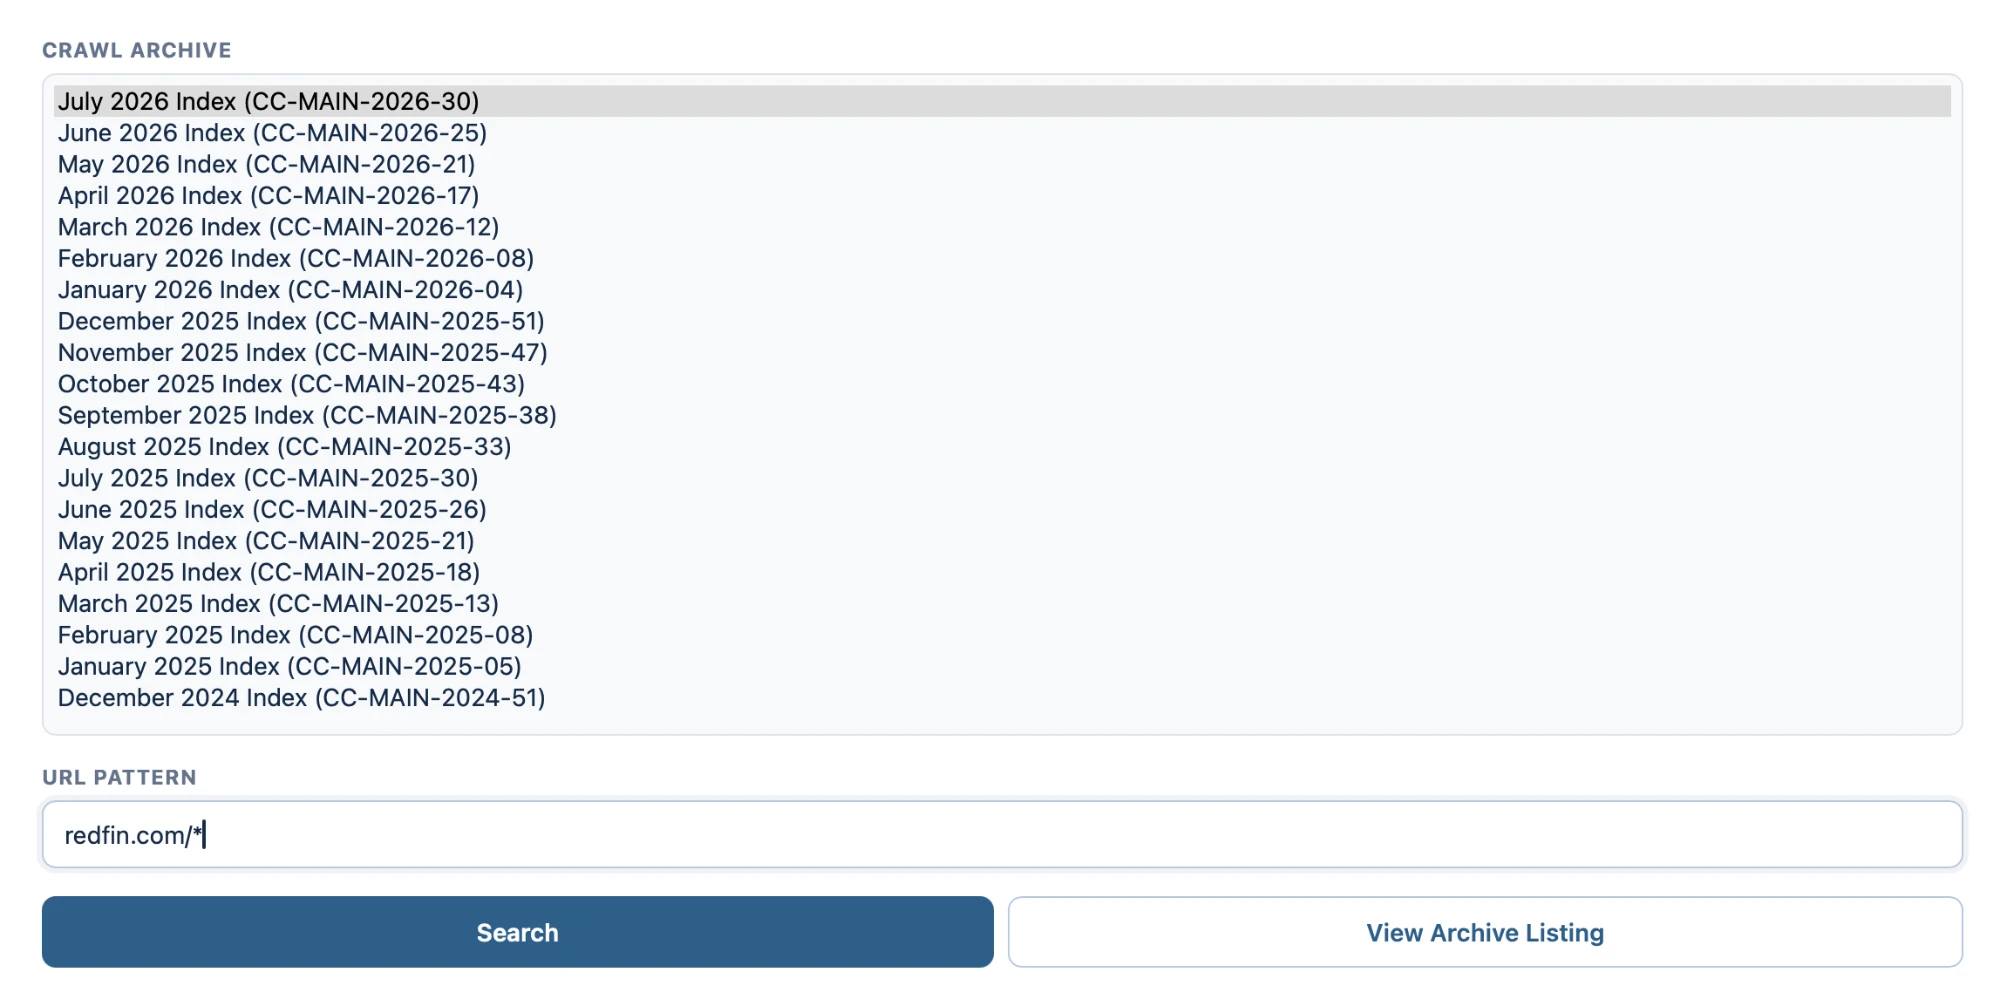
CDX arayüzü iki şey ister: 2008'e kadar uzanan bir listeden hangi aylık taramanın aranacağı ve bir URL deseni.
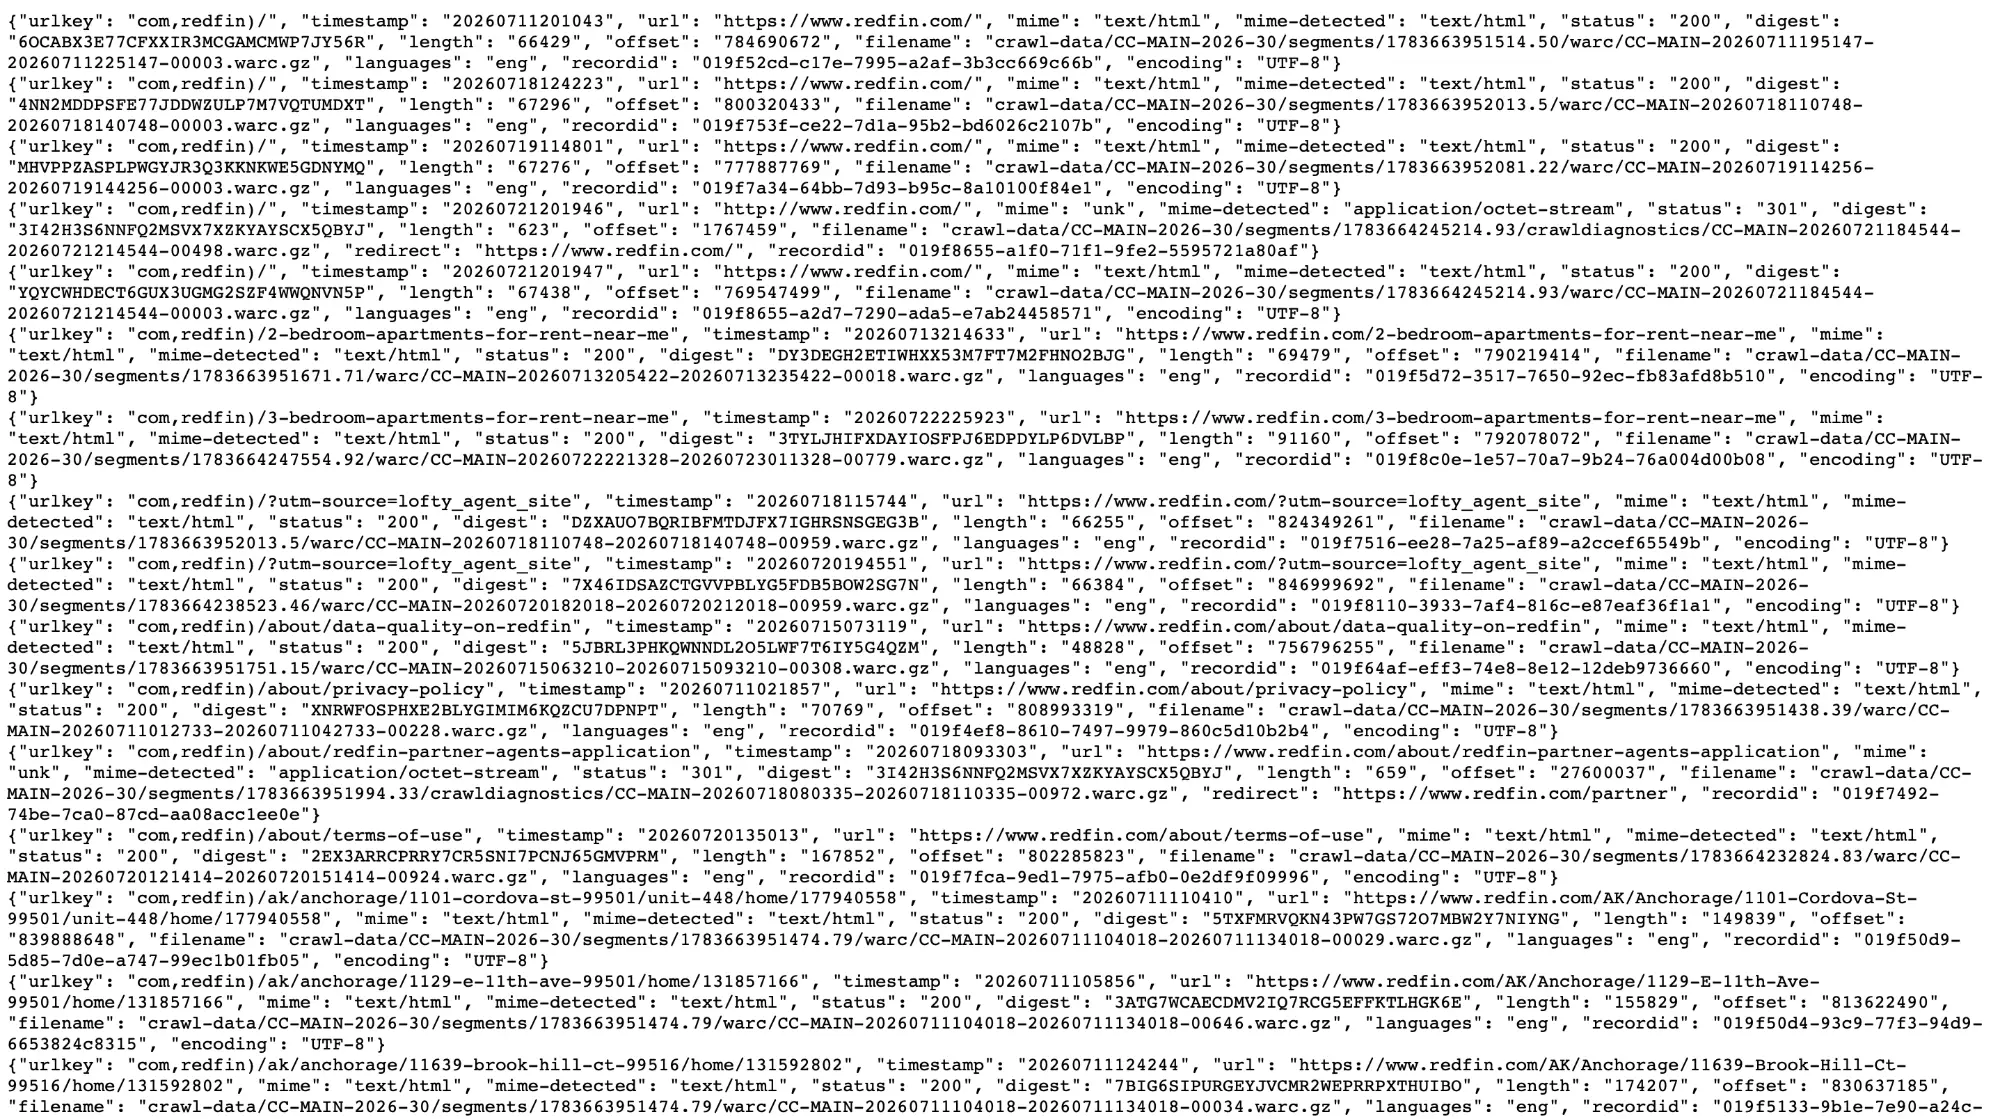
Sonuçlar JSON olarak döner; her yakalama için bir satır. Üç alan diğerlerinden daha önemlidir: WARC dosya adı, bir byte offset'i ve bir kayıt uzunluğu.
Çıktıda iki şey görülür. Aynı URL farklı zaman damgalarıyla birkaç kez görünür; bu nedenle tek bir aylık tarama tek bir anlık görüntü değildir. Başarısız yanıtlar ayrı olarak depolanır; yönlendirmeler ve hatalar başarılı getirmelerin yanında değil, bir crawldiagnostics klasöründe tutulur.
Bir sayfayı, içinde bulunduğu dosyayı indirmeden çekme
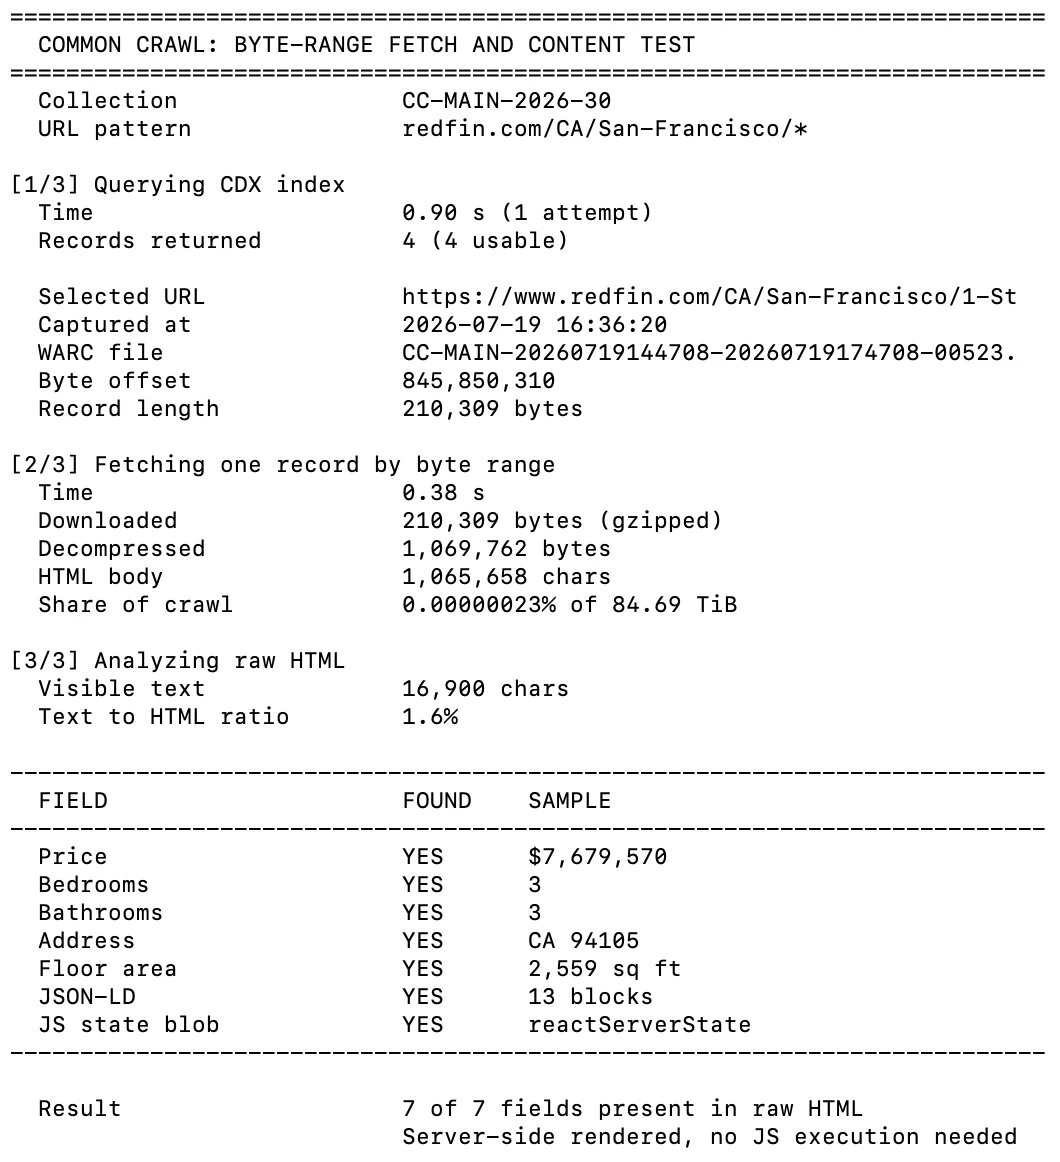
Dosya adı, offset ve uzunluk, bir HTTP Range header'ı ile tek bir kayıt istemenizi sağlar. Bunu bir Redfin ilan sayfasında test ettik.
CDX araması bir saniyenin altında döndü ve byte-range getirmesi 0,38 saniyede 210 KB getirdi. Aradığımız yedi ilan alanının tamamı (fiyat, yatak odası ve adres dahil) ham HTML'de mevcuttu ve hiçbir JavaScript çalıştırılmadı.
SQL ile toplu filtreleme
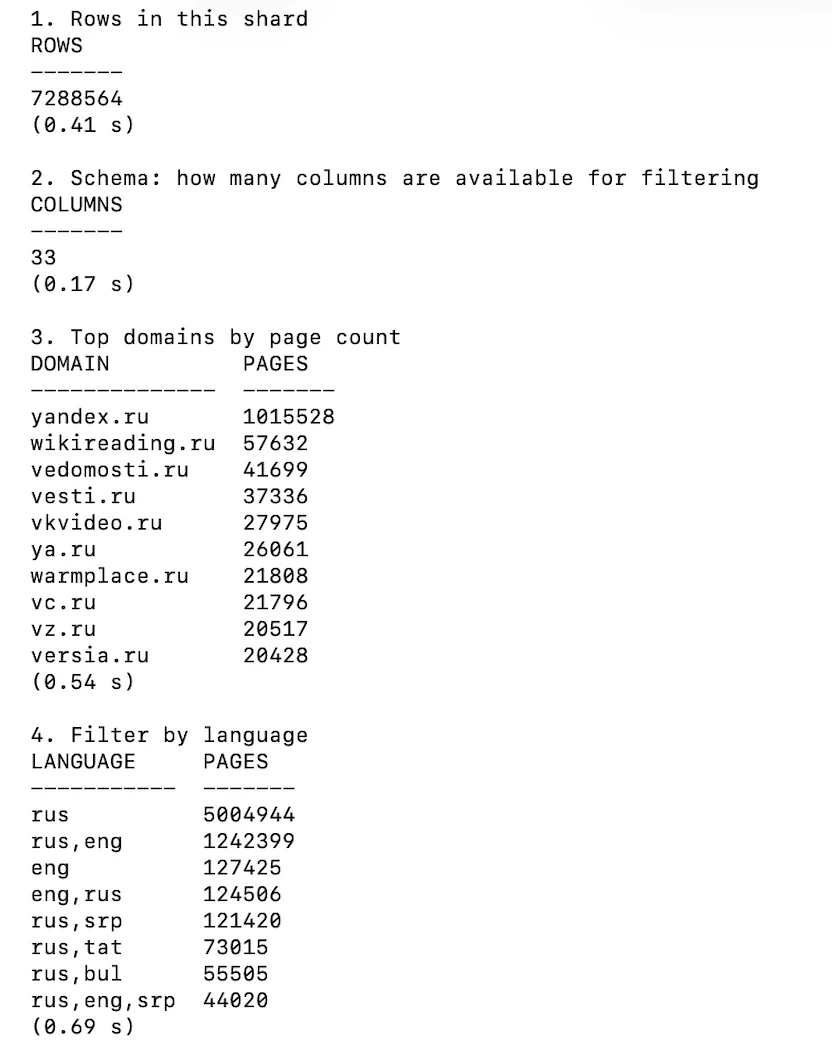
Tek bir URL'den daha büyük her şey için yol sütunlu dizinden geçer. Parquet'tir, HTTPS üzerinden sorgulanabilir ve URL, host, TLD, dil, MIME türü, fetch durumu ve timestamp'i kapsayan 33 sütun sunar.
7.29 milyon satırlık tek bir shard'a karşı sorgular her biri bir saniyenin oldukça altında döndü ve diske hiçbir şey yazılmadı. Kullanmadan önce bilinmesi gereken bir ayrıntı: shard'lar ters çevrilmiş bir host adıyla anahtarlanmıştır; bu nedenle her dosya rastgele bir örneklem değil, dar bir alfabetik dilim tutar. Belirli bir alan adı için rastgele bir shard'ı sorgulamak genellikle hiçbir şey döndürmez.
Belirli bir alan adı için ne kadar tuttuğu
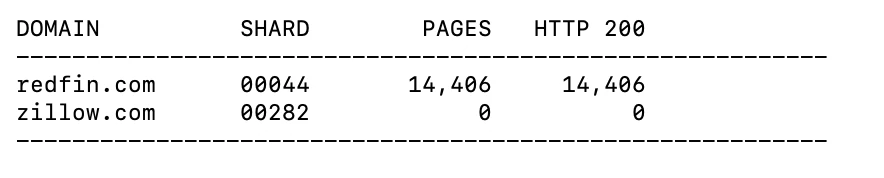
İki alan adı için dizini sorguladık: redfin.com ve zillow.com; her birini kapsayan shard'ı bulup satırlarını saydık.
redfin.com 14.406 sayfa döndürdü; bunların tamamı HTTP 200 idi. zillow.com hiç sonuç döndürmedi. Bu kısmi kapsama veya başarısız bir fetch değildir; alan adı dizinde yoktur. Common Crawl robots.txt dosyasına uyar; bu nedenle tarayıcısını yasaklayan bir site ince temsil edilmekten ziyade dizinde hiç yer almaz.
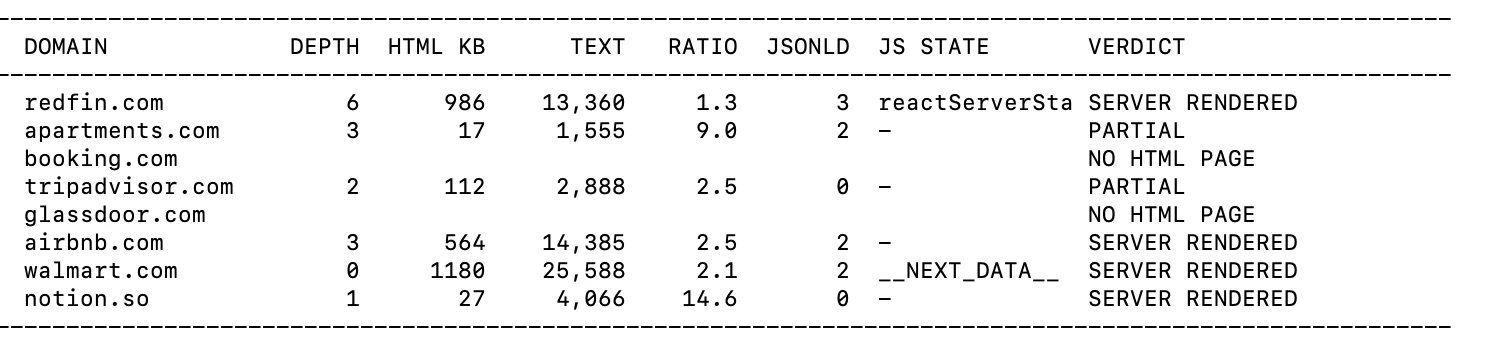
Sekiz büyük sitenin her birinden arşivlenmiş bir sayfa çektik ve tarayıcı olmadan ne kadar metnin korunduğunu ölçtük. Bunlardan ikisinin arşivde hiç kullanılabilir HTML sayfası yoktu. Geri kalanların çoğu sunucu taraflı oluşturulmuştu; Airbnb ve Walmart. TripAdvisor istisnaydı; 18 KB'lik bir sayfa döndürdü ve bu sayfa 282 karakter görünür metin içeriyordu.
Maliyet ve lisans
Veri ücretsiz'dir ve depolama bucket'ı hesapsız açıktır. Ödediğiniz şey compute ve bant genişliğidir; bu nedenle işlemenin veriyle aynı bulut bölgesinde yapılması önerilir.
Lisans açık bir veri lisansı değildir. Common Crawl hizmete sınırlı bir lisans verir, sayfa içeriğinin kendisini lisanslayamayacağını belirtir ve kullanıcıların içeriği “yapay zekâ, makine öğrenimi veya benzer teknolojilerle bağlantılı olarak” kullanmasından doğan taleplere karşı kendisini tazmin etmesini şart koşar. Toplam sorumluluk $100 ile sınırlıdır.1
Webz.io haber makaleleri, blog yazıları, forum başlıkları ve incelemelerden oluşan bir arşive erişim satar. Haberler 2008'e, bloglar ve forum başlıkları Aralık 2014'e kadar uzanır; ancak self-servis arşiv yalnızca son beş yılı kapsar; daha eski veriler talep üzerine toplu dökümler halinde gelir. 2 Döndürdüğü şey sayfa değil, işlenmiş bir kayıttır: makale metni artı çıkarılan varlıklar, duygu skorları, sosyal etkileşim sayıları ve site metadata'sı. Yaklaşık 30 günden daha eski her şey arşiv ürününde bulunur; daha yeni materyal News, Blogs ve Forums API'leri tarafından sunulur.
Sorgu oluşturucu
Sorgular, metin üzerindeki bir Boolean ifadesini alan düzeyindeki koşullarla birleştirir ve AND ile bağlanır. Her koşul bir özellik, bir operatör ve bir değerden oluşur.
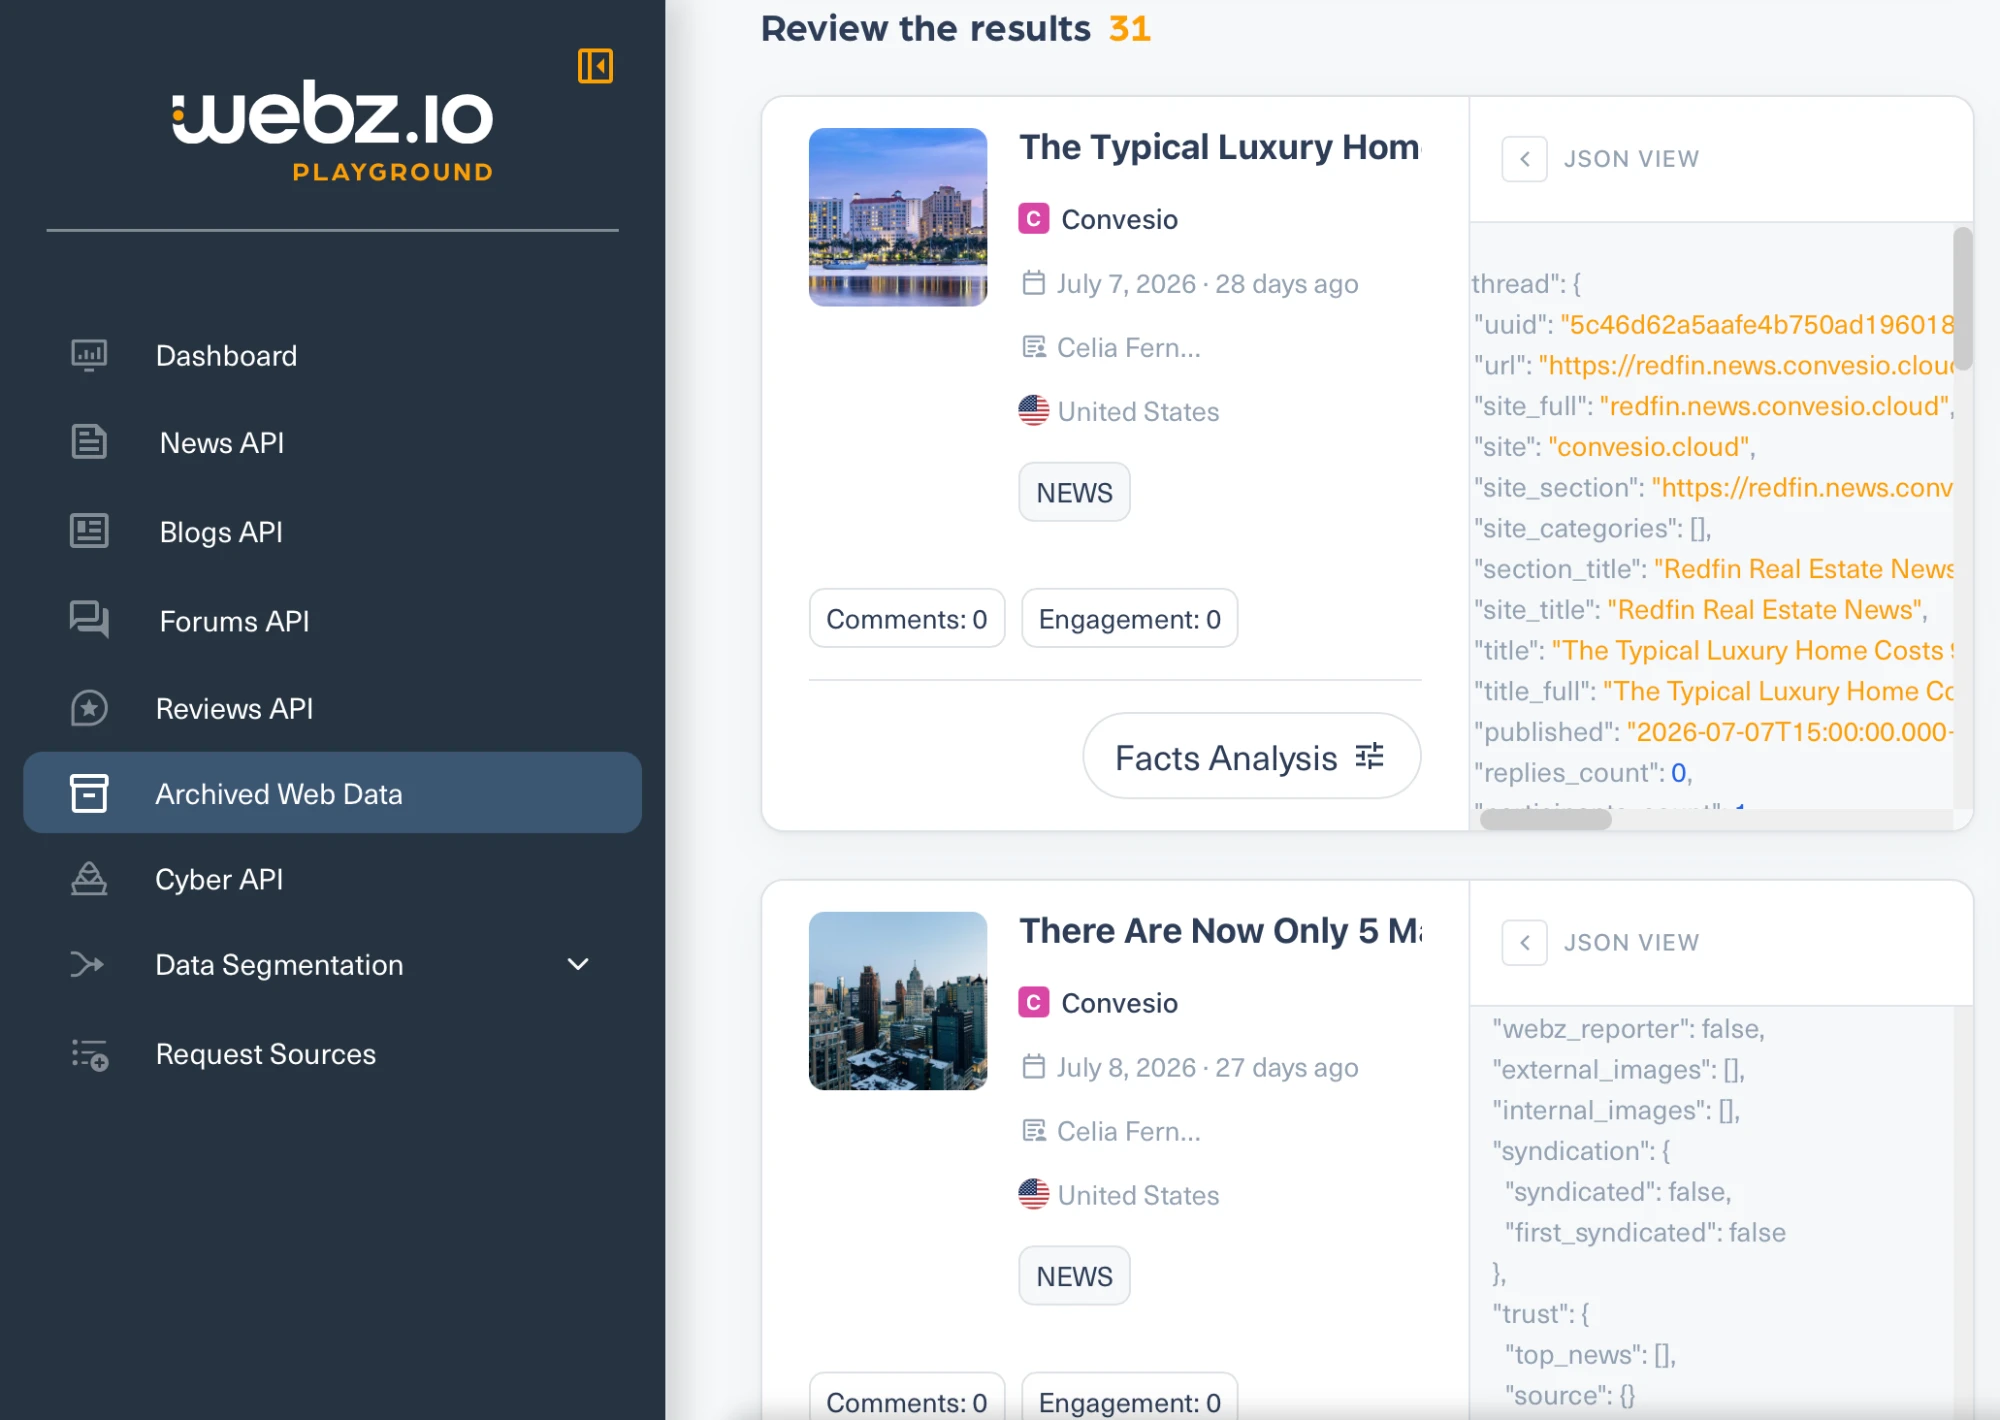
Kullanmadan önce bilinmeye değer bir ayrıntı: Equals etiketli operatör tam eşleşme gerektirmez. Site başlığı alanına karşı redfin girdik ve başlığı “Redfin Real Estate News” olan bir siteyle eşleşti.
Ne döner
Her sonuç, tam metnin yanı sıra entities, sentiment, social, categories, language, domain_rank, country ve aynı hikayenin başka yerde görünüp görünmediğini kaydeden bir syndication nesnesi taşır. Ham HTML alanı yoktur. Ürün sayfası, elde ettiğiniz şeyi “her makale, gönderi, başlık veya incelemenin tam metni” olarak tanımlar ve teslimat “API aracılığıyla veya kendiniz bir sorgu çalıştırarak” yapılır.
- Arşiv yayıncıları tutar, ilan sitelerini değil. Redfin'i aramak, redfin.com'dan sayfalar yerine
convesio.cloudüzerinde barındırılan Redfin kurumsal haber blogunu döndürdü. Site alan adı alanını doğrudanredfin.comiçin sorgulamak hiçbir şey döndürmedi;convesio.cloudveyahoo.comsonuç döndürdü; bu nedenle boş yanıt bozuk bir sorguyu değil, kapsamı yansıtır. - Toplu toplama sözleşmeyle kısıtlıdır. Hizmet şartları, catch-all yıldız filtresini ve
site_type:newsveyalanguage:englishgibi dikey filtreleri yasaklar; bunlar tam olarak bir derlem alıcısının kullanacağı sorgu şekilleridir. Arayüzün kendisi, aramayı daraltmak içinsite_type:newseklemeyi önerir.
Exa kendi web dizinini oluşturdu ve bunun üzerinden arama satıyor. Şirket 500 milyardan fazla URL bildiriyor. Exa, dizininin 2 trilyondan fazla URL izlediğini ve 100 milyar sayfa sunduğunu bildiriyor.3
Bu karşılaştırma için ilgili kısım arama endpoint'i değil, /contents; bu, bir sayfanın metnini canlı olarak getirmek yerine Exa'nın önbelleğinden döndürür.
Önbellek veya canlı seçenekleri
Tek bir parametre bunu kontrol eder. maxAgeHours 24 olarak ayarlandığında, önbellekteki kopya bir günden daha eski değilse onu kullan, aksi takdirde tara anlamına gelir. 0 olarak ayarlandığında her zaman tarar. -1 olarak ayarlandığında asla taramaz, yalnızca zaten depolanmış olanı döndürür. Kabul edilen maksimum değer 720 saattir; bu nedenle parametre 30 günden daha eski hiçbir şeye referans veremez.
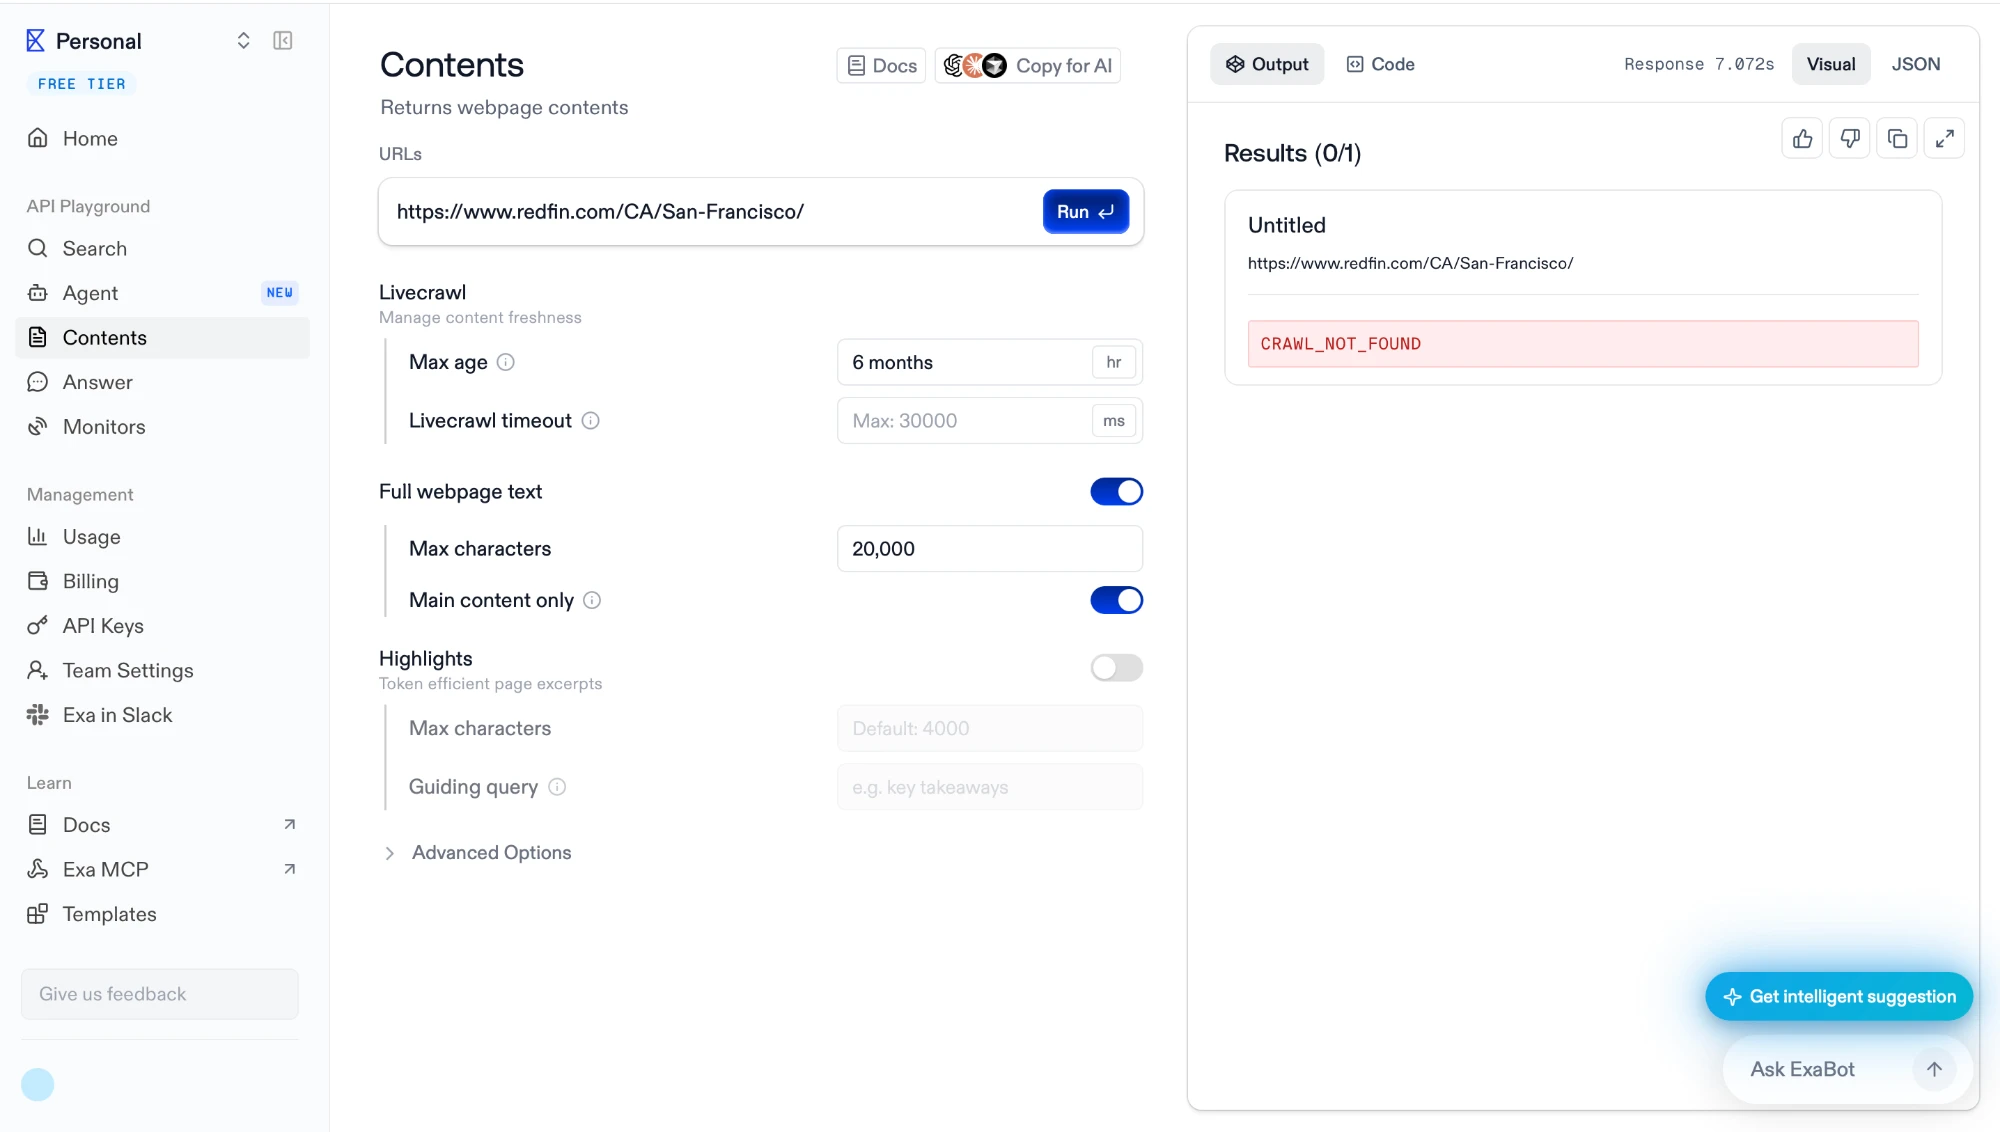
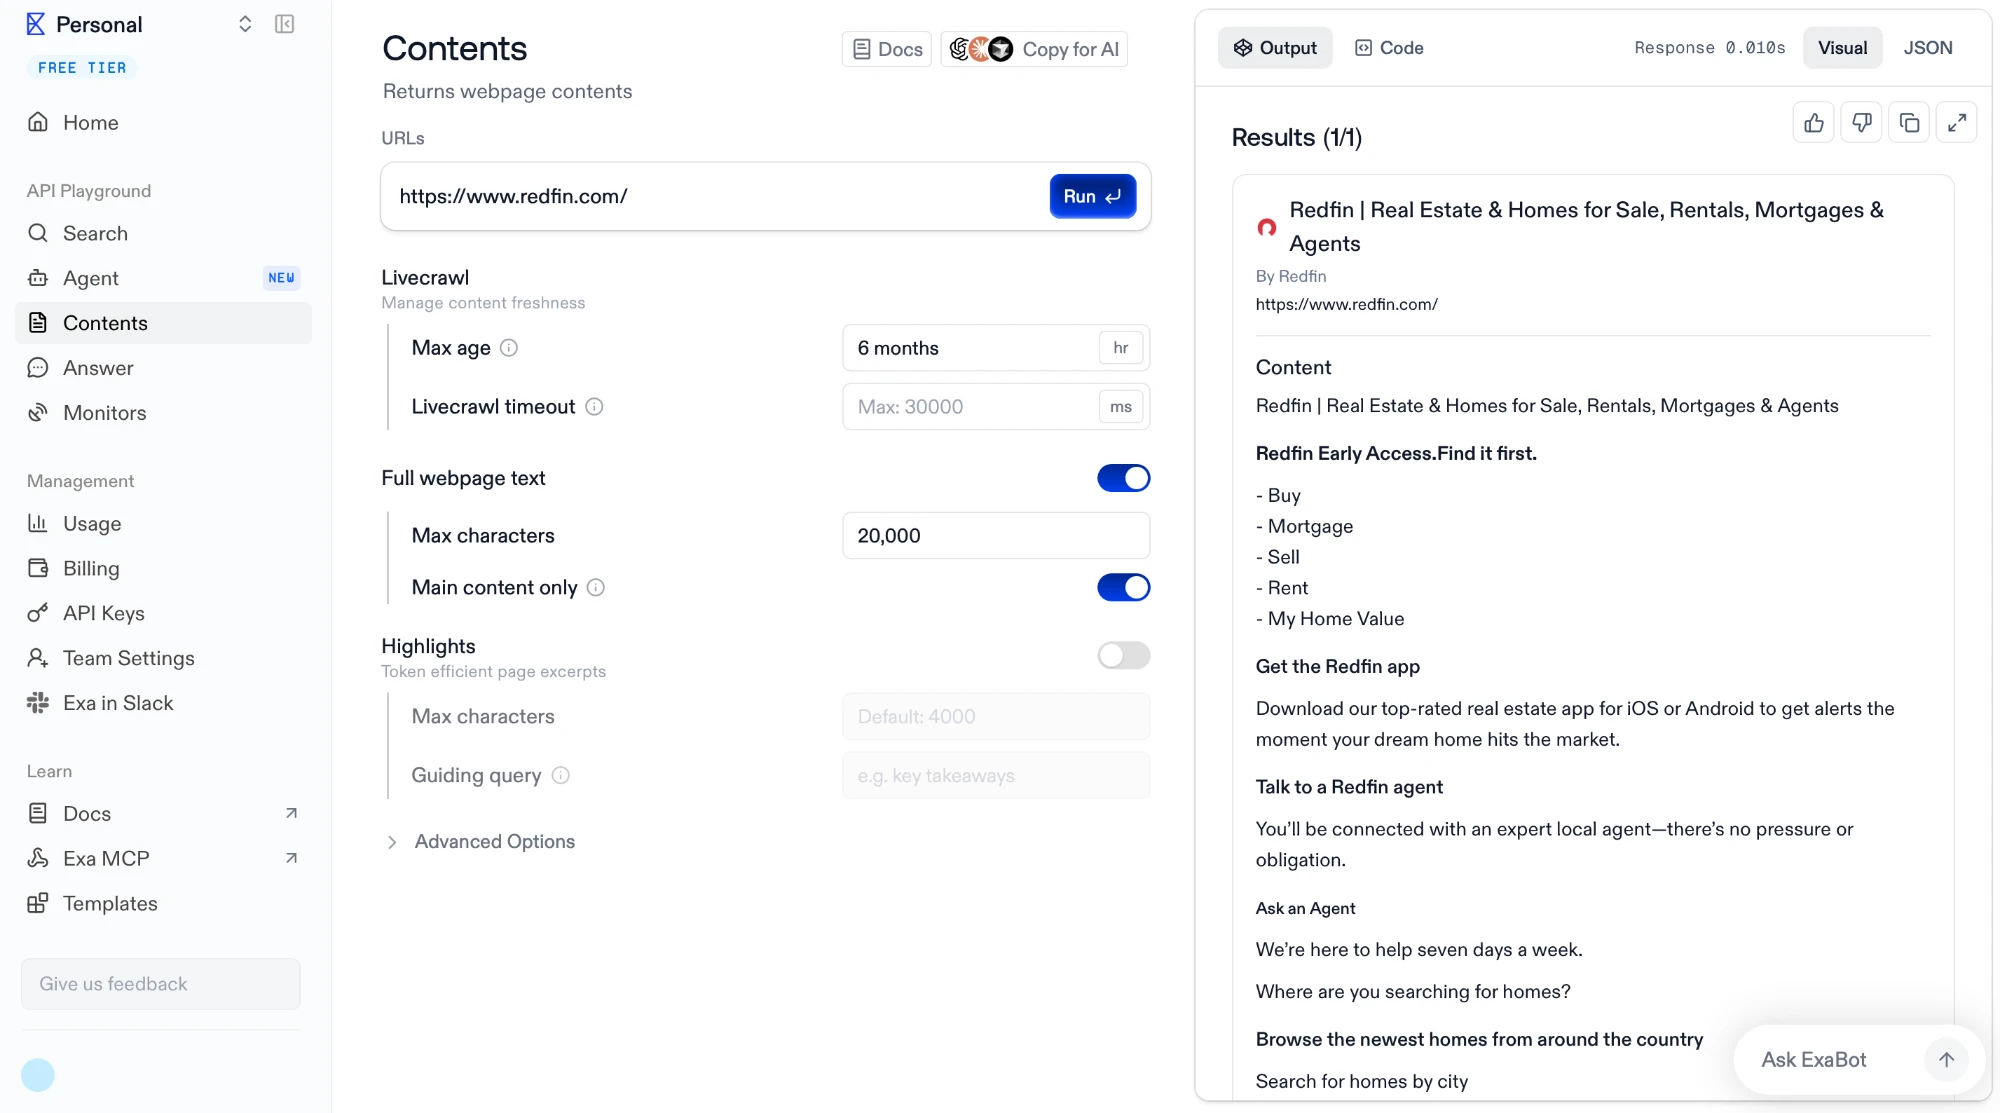
Yaş sınırı altı ay olarak ayarlanmış şekilde iki istek çalıştırdık. İlki bir Redfin şehir sayfasını istedi.
CRAWL_NOT_FOUND sonucunu 7,07 saniye sonra döndürdü. İkincisi Redfin ana sayfasını istedi.
Tam sayfa içeriğini 0.010 saniyede döndürdü. On milisaniye bir ağ gidiş-dönüşünden daha kısadır; bu nedenle bu yanıt bir fetch'ten değil, depolamadan geldi. Önbellek gerçektir ve yedi saniyelik başarısızlık Exa'nın arayıp bulamamasıydı.
Aynı ekranda iki başka varsayılan daha görülüyor. İçerik 20.000 karakterle sınırlandırılmış ve “yalnızca ana içerik” açık; bu nedenle navigasyon ve şablon metinler sizin değil, Exa'nın kendi mantığıyla kaldırılıyor.
Kapsam sayfa düzeyinde düzensizdir
Ana sayfa önbelleğe alınmıştı; San Francisco şehir sayfası alınmamıştı. Alan adını aramak, bunun neden basit bir var-yok sorusu olmadığını gösterir.
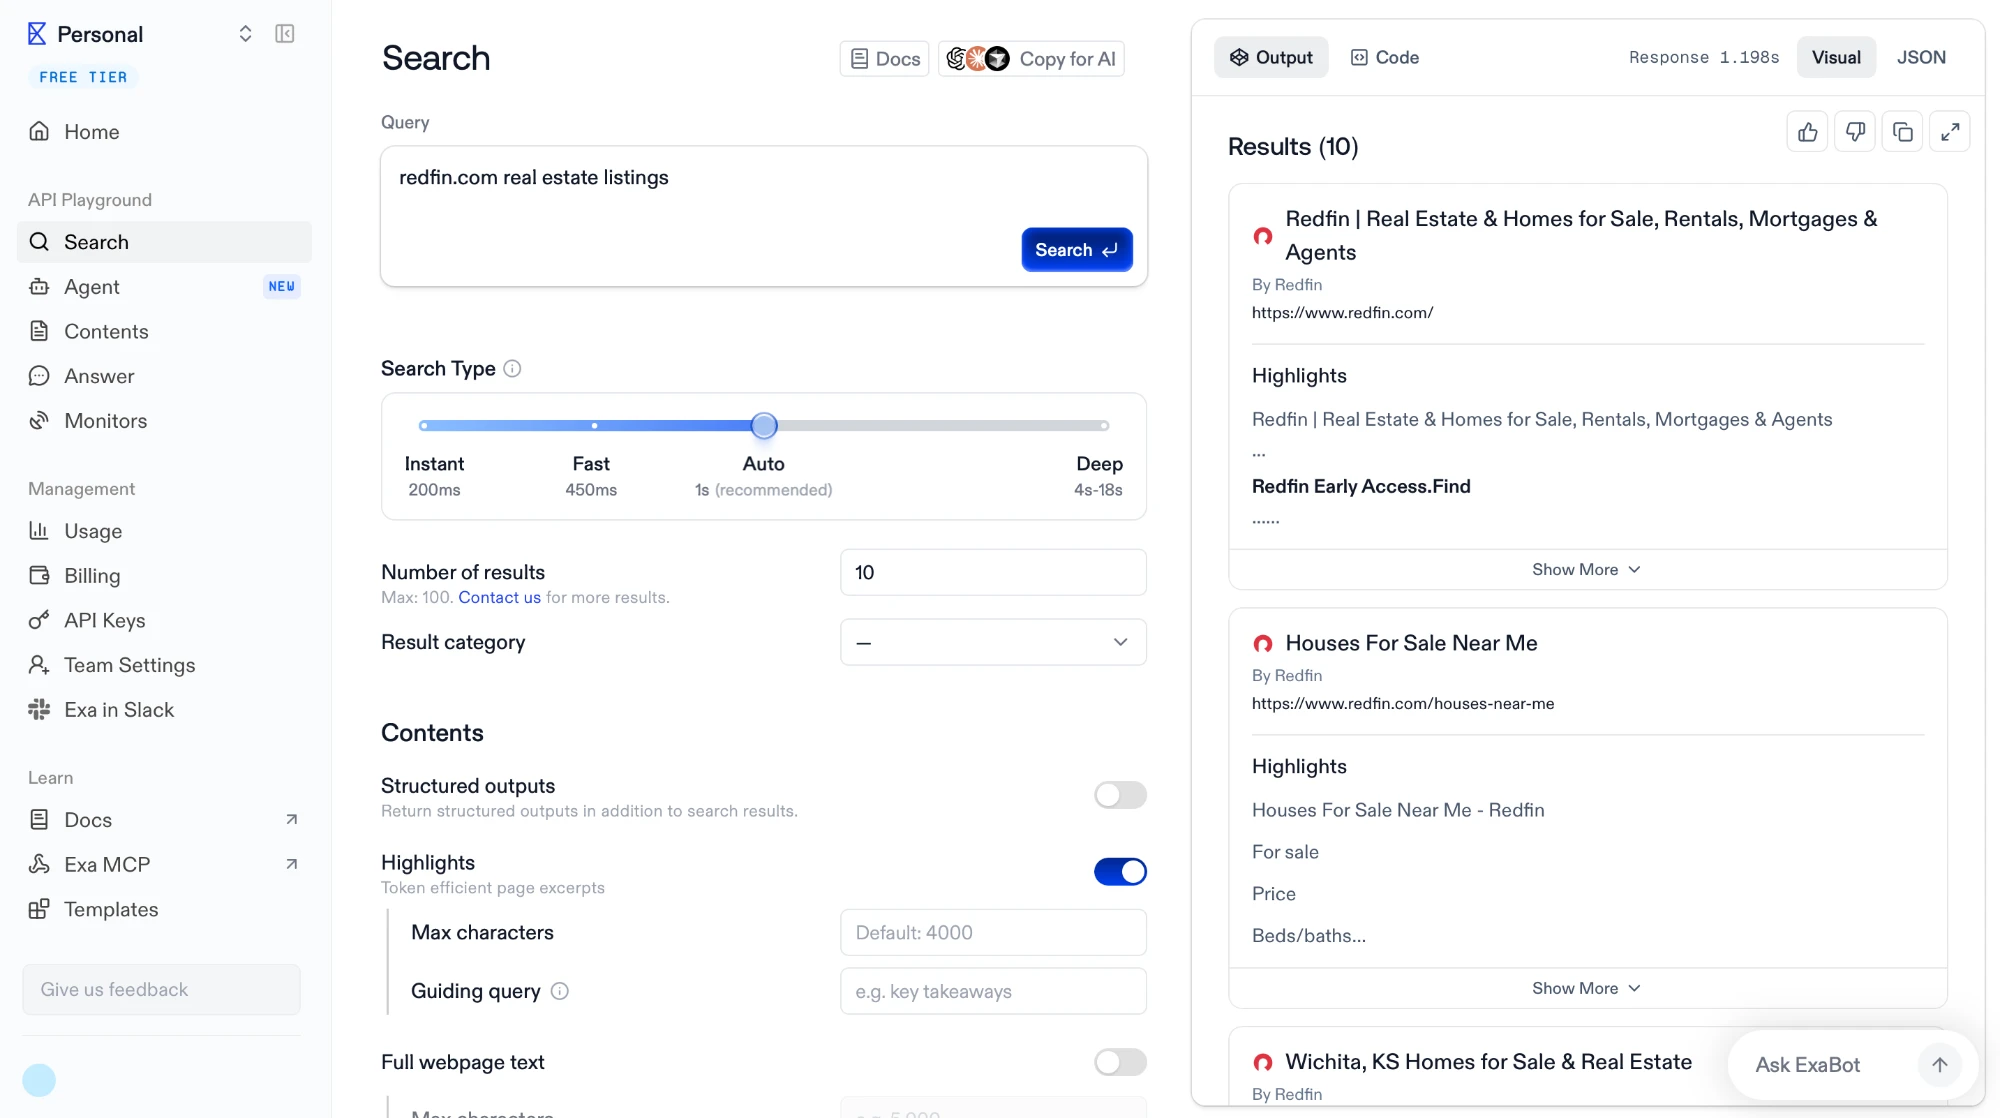
Sorgu, Redfin ana sayfasını, bir “Yakınımdaki Satılık Evler” sayfasını ve bir Wichita şehir sayfasını döndürdü; yani derin sayfalar dizinde gerçekten mevcut. Kapsam, bir alan adı genelinde eksiksiz veya boş olmak yerine dağınıktır.
Sınırlamalar
Aynı ekran, bu karşılaştırmada Exa'yı arşivlerden ayıran cümleyi taşır: “Sonuç sayısı: 10. Maks: 100. Daha fazla sonuç için bizimle iletişime geçin.”
Toplam sayı yoktur. Common Crawl bu soruyu bir SQL sorgusuyla yanıtladı ve Bright Data bunu bir files_count alanıyla yanıtladı.
Toplu dışa aktarma yok, kendi depolama alanınıza teslimat yok, firehose yok. Enterprise katmanı, veri teslim etmek yerine API aracılığıyla sunulan özel olarak uyarlanmış dizinler olan custom index'lerden söz eder.
Hangisi hangi işe uygun
Bu dört ürün birbirinin yerine geçmez. Soru hangisinin en iyi olduğu değil, hangisinin sizin sorunuzu yanıtladığıdır.
- Tarayıcıları engelleyen siteler dahil, ölçekli ham HTML. Bright Data, buradakiler arasında kontrol ettiğiniz depoya filtrelenmiş bir seçim yazan tek sağlayıcıdır ve tarayıcıları yasaklayan alan adlarından sayfa barındıran tek sağlayıcıdır.
- Mühendislik kapasiteniz varsa, maliyetsiz geniş bir derlem. Common Crawl, SQL ile sıralanabilen WARC formatında eksiksiz taramalar verir ve kendi compute gücünüzden başka hiçbir şey istemez. İşleme sizin inşa edeceğiniz şeydir.
- Varlıkları ve duygusu zaten çıkarılmış haber, blog ve forum metni. Webz.io sayfalar yerine işlenmiş kayıtlar döndürür; bu, çıkarma işini ortadan kaldırır ama işaretlemeyi de kaldırır.
- Sorgu anında, bir ajan veya RAG pipeline'ı için sayfa bağlamı. Exa, önbelleğe alınmış metni milisaniyeler içinde döndürür ve bir sayfa depolanmadığında aynı çağrının içinde canlı bir fetch'e geri döner.
 Tercih edilen kaynak olarak ekle
Web arşivi API'lerini nasıl test ettik
Her ürünün içinde, belgelerinden yola çıkmak yerine çalıştık. Her sağlayıcı önce kendi konsolu veya playground'ı üzerinden, ardından API'si üzerinden yönlendirildi; böylece arayüzün ürettiği isteği ve herhangi bir ücret alınmadan önce neyin geri geldiğini görebildik.
Her biri için bir sorgu oluşturduk, çalıştırdık ve oluşturulmuş özet yerine ham yanıtı okuduk. Ürün bir sayım, maliyet tahmini veya durum nesnesi döndürdüğünde bu alanları doğrudan kaydettik. Örnek veya teslimat sunduğunda onu aldık, paketi açtık ve dosyaları açtık.
Tekrar veya zamanlama gerektiren kısımları küçük script'ler üstlendi: çok terabaytlık bir arşivden tek bir kaydı getirmek, teslim edilen bir paketi açmak ve belirli alanlar için ham HTML'i aramak, SQL ile sütunlu bir dizini sorgulamak ve önbelleğe alınmış bir yanıtın taranması gereken bir yanıta kıyasla ne kadar sürdüğünü ölçmek. Bu script'ler, ürettikleri sonuçların yanında bağlantılıdır.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Web Arşivi API'ler: 4 Önde Gelen Sağlayıcı Test Edildi ve Karşılaştırıldı}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/web-archive-api}},
  note   = {AIMultiple. Erişim tarihi: 11 Ağustos 2026}
}15 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, 2 CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Referans Linkleri






Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.