


AIM-Decision: Jev frente a Clef frente a LLMs
Los modelos de decisión, también llamados modelos System One,1 puntúan un conjunto fijo de opciones en lugar de generar texto token a token. Probamos 59 modelos de decisión en 1.655 preguntas de clasificación, como calificar una falla de seguridad o un retiro de producto, y ejecutamos 46 de ellos en 50 tareas de navegador. Consulte AIM System One Index para obtener los resultados combinados.
Resultados del benchmark de clasificación
- decider-12b obtuvo 46.4 en fallos de seguridad y 62.4 en retiros, a $0,06 por cada 1.000 decisiones. Ningún modelo de decisión obtuvo resultados significativamente más altos en ninguna de las dos tareas.
- Jev 1.13 costó $0,039 por cada 1.000 decisiones y obtuvo 47.9, aproximadamente un punto por debajo de Kev-9B y Nimble 9B, que cuestan unas 7 y 9 veces más.
- pplx-decider-v1.1-27b y Mercury Decide obtuvieron 48.7 y 48.1, por encima del 47.9 de Jev, a aproximadamente un tercio de su coste.
- Eikos-27B, con 27 mil millones de parámetros, costó $0,073 por cada 1.000 decisiones. Tev1 4B, con 4 mil millones, costó $0.34.
- Strands Decider 2B obtuvo 62.6 en retiros, la puntuación más alta de todos los modelos, y 33.9 en fallos de seguridad, donde las respuestas aleatorias promedian 25.
- GLiDE obtuvo 46.5 en fallos de seguridad frente al 46.4 de decider-12b, pero tardó 15,7 segundos por decisión frente a 0.13 y costó $0,48 por cada 1.000 decisiones. GLiDE v2 promedió 49.0 en las dos tareas con 0,47 segundos y $0.10. Clef promedió 51.0 a $0,17 a través de Cloudflare y su API.
Tasas de éxito de la automatización del navegador
Un intento por tarea; los LLMs se ejecutaron con el ajuste de bajo esfuerzo de razonamiento de su API.
- Solar Decide, Solar Decide Flash y ambas versiones de Nimble 9B, Tev1 4B y Tev1 0.8B no están clasificados porque aceptan como máximo 26 opciones por pregunta, y 17 de las 50 tareas abren en una página con más. Laya y Strands Decider 2B también quedan fuera, porque sus límites de entrada rechazaron solicitudes que los demás modelos recibieron completas.
- SubQ Snap completó 41 tareas, dos menos que Gemini 3.8 Flash y seis menos que GPT-6 Astra. Costó un estimado de $0,001 por tarea completada, frente a $0,025 para Gemini y $0,226 para Astra.
- Los modelos de decisión en conjunto completaron 49 de las 50 tareas, incluidas las tres en las que Astra falló.
- decider-12b, primero en clasificación, completó 16 tareas de navegador; Kev-27B, que obtuvo una puntuación inferior a Jev en clasificación, completó 40. JEV-27B-VL, destilado de Jev 1.13 según su ficha de modelo,2 obtuvo 45.8 frente al 47.9 de Jev y completó 24 tareas de navegador frente a las 18 de Jev.
Consulte 10 tareas de ejemplo y el resultado de cada modelo en Hugging Face, y cómo ejecutamos el benchmark en metodología.
Modelos de decisión frente a LLMs en tareas de navegador
La mayoría de los LLMs escriben su respuesta token a token, y cada token cuesta cómputo y tiempo. En la mayoría de los pasos del navegador, el agente solo elige una operación y un control en la página.
Un modelo de decisión lee la página y las opciones, puntúa cada opción y devuelve la más probable. Devuelve una probabilidad para cada opción en lugar de texto generado, por lo que un paso no necesita una salida larga. Si los modelos de decisión se vuelven lo suficientemente precisos, la misma automatización podría ejecutarse mucho más rápido y a una fracción del coste de un LLM.
Los modelos de decisión, tal como los servimos, devuelven puntuaciones de opciones y ningún texto, por lo que un modelo de texto independiente, Mercury 2.5,3 escribe los valores que se teclean en los campos de formulario. Lo llamamos el ayudante de texto y estaba disponible para todos los modelos.
Ejecutamos todos los modelos en el runtime de código abierto jev-ultrafast de browser-use,4 creado para Jev 1.13 de TypeSafe.5 GPT-6 Astra sirve como referencia de LLM de gama alta y Gemini 3.8 Flash como uno de bajo coste. Todos los modelos se enumeran en la metodología.
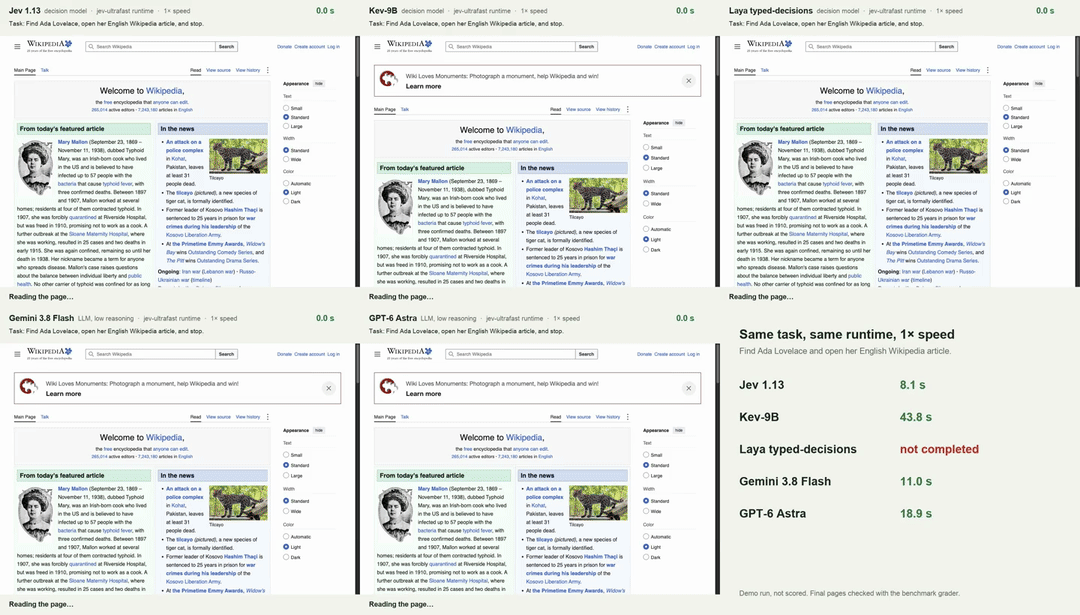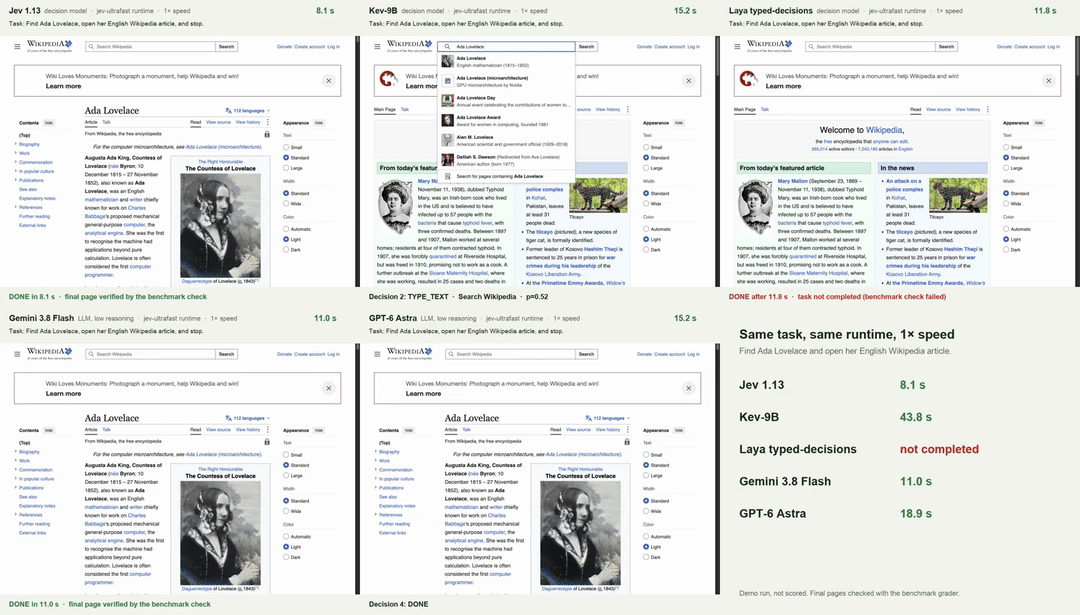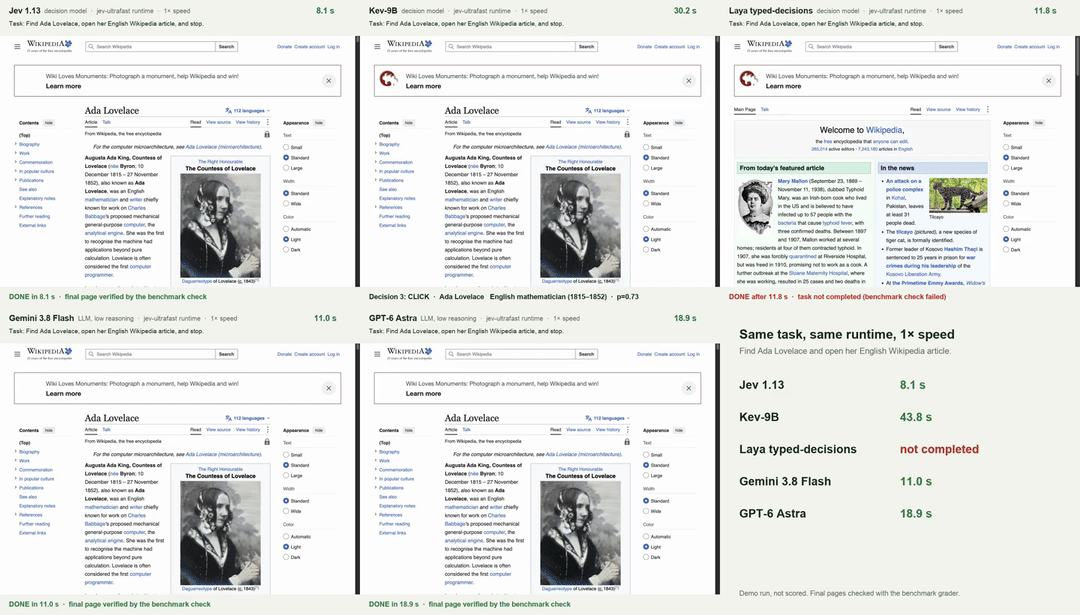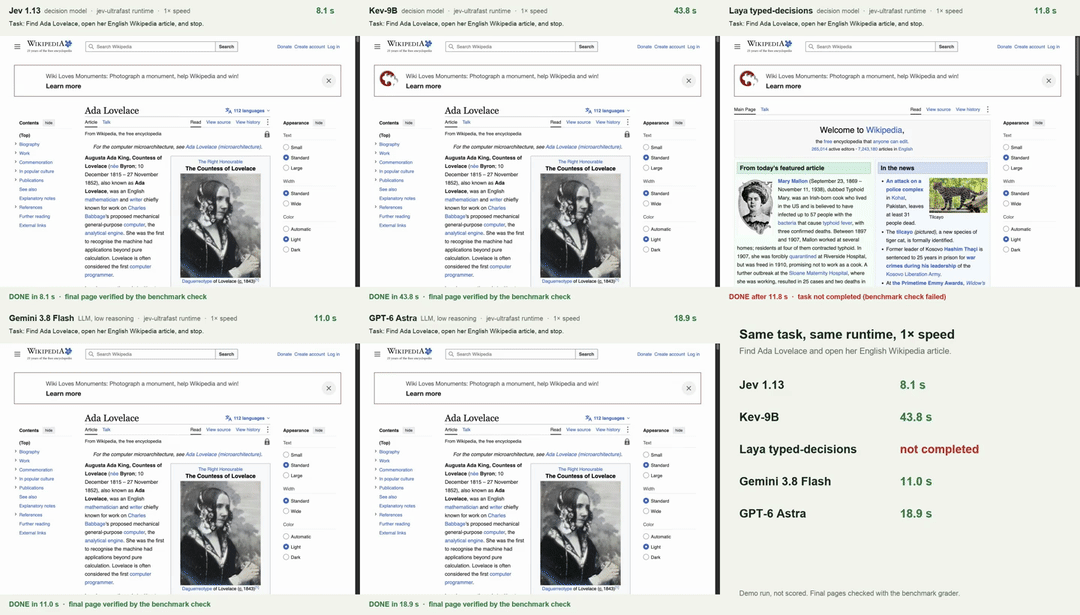
Cinco modelos en la misma tarea
En Wikipedia, todos los modelos excepto Laya escribieron en el cuadro de búsqueda, el ayudante de texto escribió “Ada Lovelace” y el modelo eligió la sugerencia correcta. Jev llegó al artículo en 8,1 segundos, Gemini en 11.0, Astra en 18.9 y Kev-9B en 43.8. Laya declaró la tarea terminada en la página principal sin realizar ninguna acción.
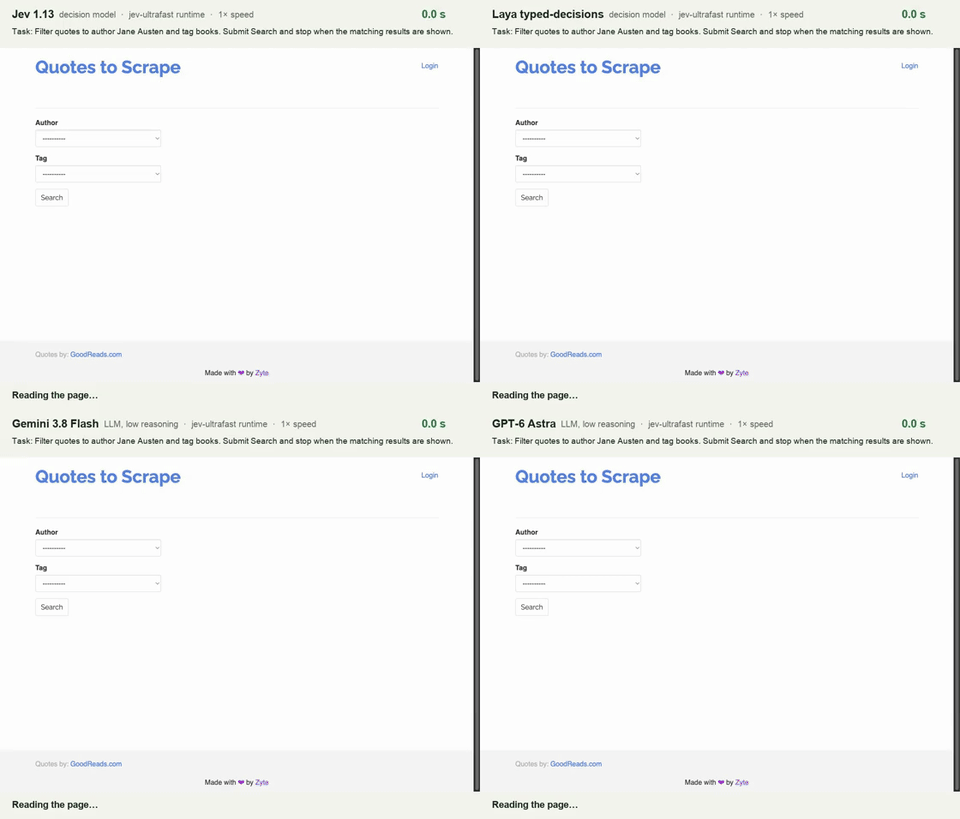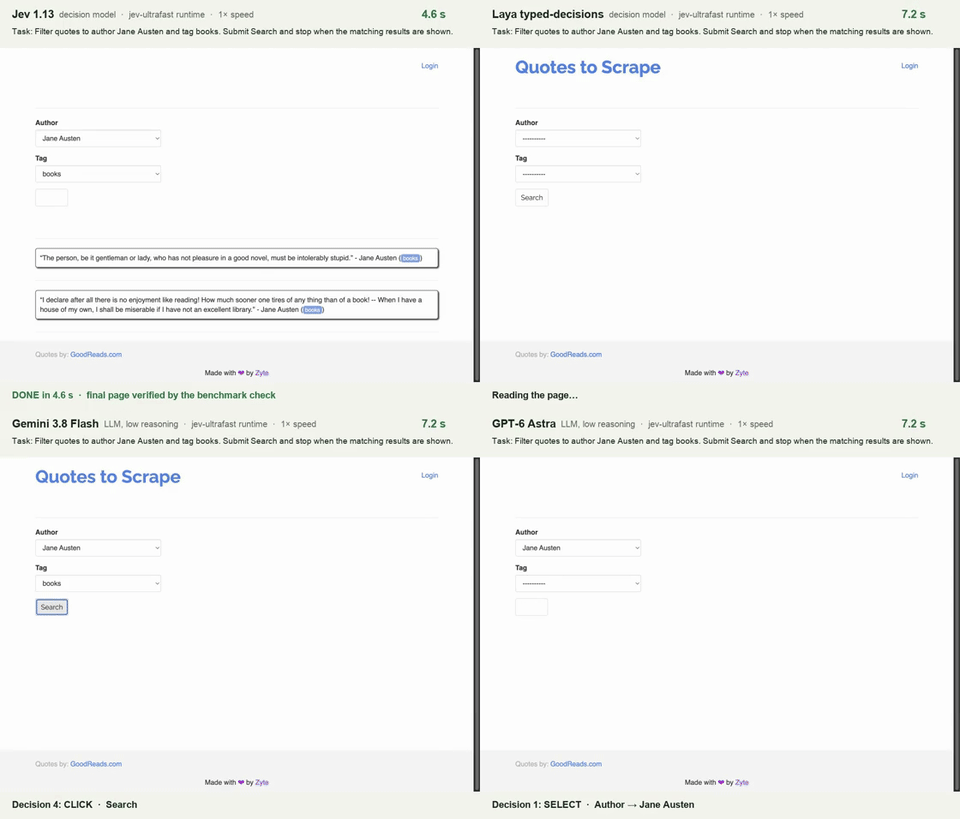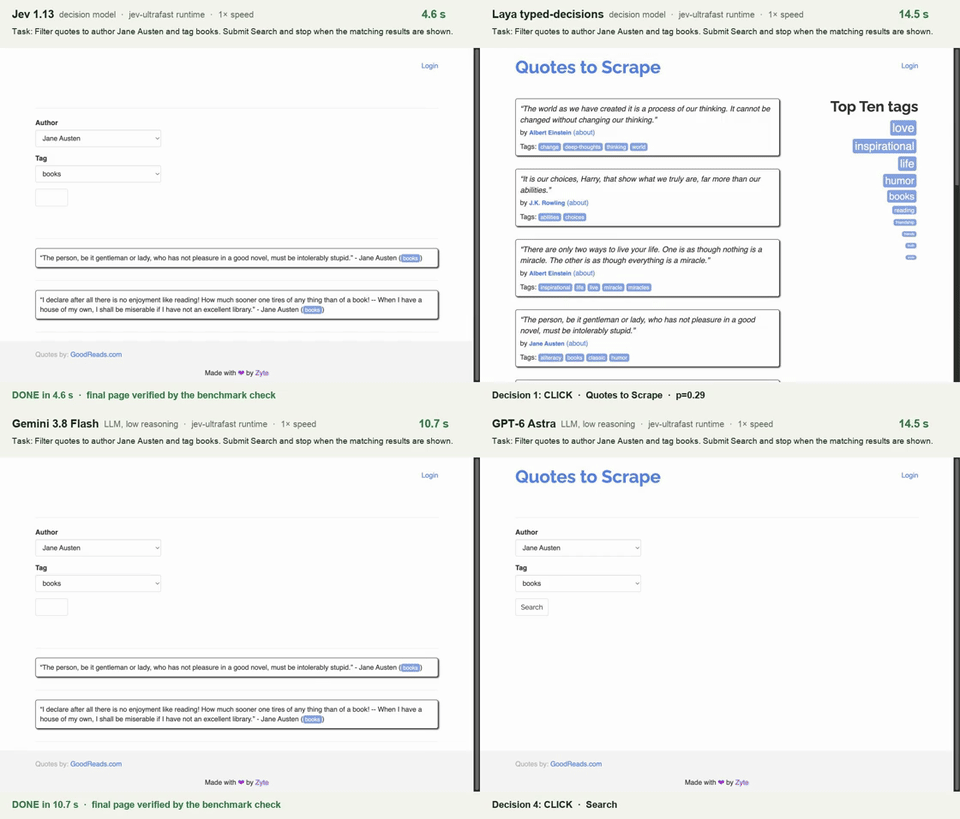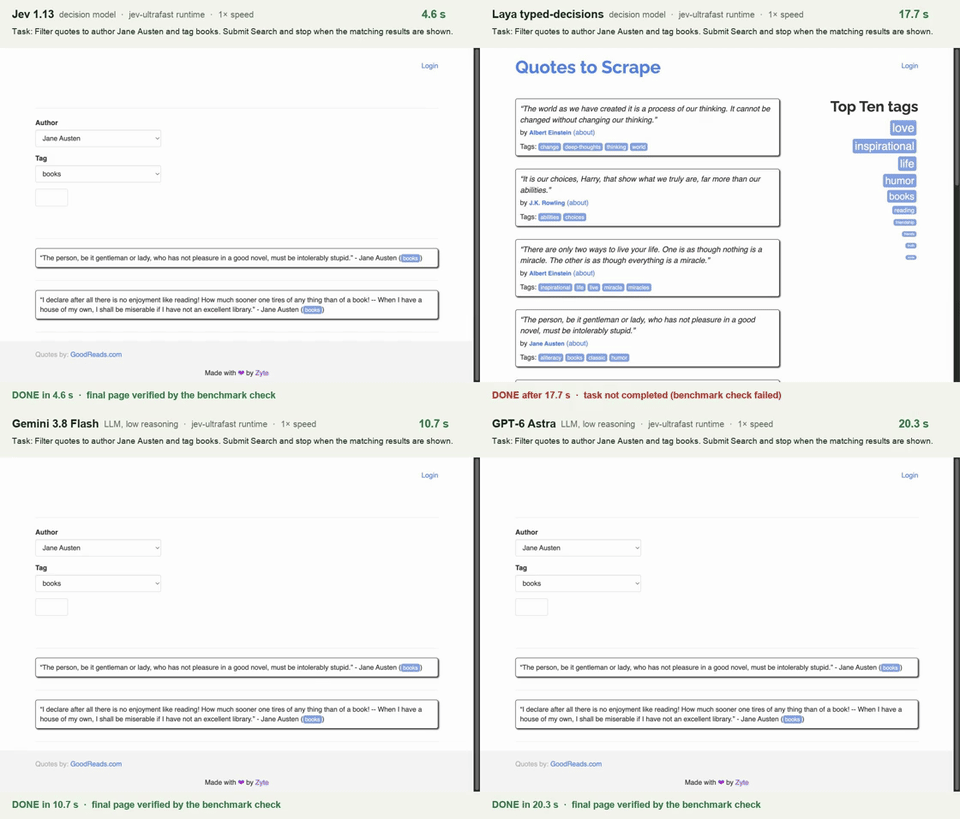
La tarea de filtro necesita dos menús desplegables y un botón de búsqueda. Jev, Gemini y Astra siguieron los mismos cuatro pasos y terminaron en 4.6, 10.7 y 20,3 segundos. Laya hizo clic en el logotipo del sitio y declaró la tarea terminada. Kev-9B falló esta tarea en el benchmark y, en la demostración, seguía haciendo clic después de 11 minutos, por lo que se deja fuera de este clip.
Los subtítulos muestran la operación y el objetivo elegidos por cada modelo y, en los modelos de decisión, la probabilidad de esa operación. Los clips provienen de una ejecución de demostración independiente a velocidad 1×, no del benchmark puntuado, y cada página final se comprobó con el evaluador del benchmark.
Cómo fallaron los modelos
Jev y Kev-9B completaron juntos 26 tareas distintas. Ambos completaron las dos tareas de Wikipedia y la tarea del menú desplegable de Web Scraper, al igual que ambos LLMs. En Books to Scrape, donde cada tarea pasa de una lista de categorías a una página de producto, Jev completó una de las seis y Kev-9B completó tres. Kev-27B, Eikos-27B y AutoJev-27B completaron las seis.
- Jev declaró la tarea bloqueada en 24 de sus 32 fallos, 16 veces antes de realizar cualquier acción.
- Kev-9B tomó una mediana de 9.5 acciones en las tareas fallidas, frente a 3 en las tareas que completó. Diez intentos alcanzaron el límite de acciones o de llamadas de decisión, y cinco más se detuvieron después de que tres acciones seguidas dejaran la página sin cambios.
- Kev-4B, del desarrollador de Kev-9B, declaró la tarea bloqueada en su primera decisión en 29 de las 50 tareas.
- Kev-27B, Eikos-27B y GLiDE fallaron las mismas siete tareas. Declararon cuatro de ellas bloqueadas, dos búsquedas de productos de ScrapeMe y dos tareas de Web Scraper, y ninguno de los tres terminó la casilla de verificación ni el formulario de calculadora.
- GPT-6 Astra falló 3 tareas. Marcó una tarea de categoría de ScrapeMe como bloqueada, siguió escribiendo en el mismo campo de calculadora hasta que lo detuvieron, y en la tarea de formulario T02 el ayudante de texto no devolvió ningún valor válido después de que Astra llenara y enviara el formulario.
- Gemini 3.8 Flash falló 7, incluido el mismo final de T02. Tres fallos llegaron a la página correcta pero no terminaron, dos fueron detenidos por nuestra salvaguarda de costes cuando OpenRouter no informó de una tarifa, y uno alcanzó el límite de acciones.
Por qué algunos modelos obtuvieron 0/50
GLiNER2.5-Decide
GLiNER2.5-Decide de Fastino6 declaró las 50 tareas terminadas demasiado pronto, 49 de ellas en su primera decisión. En las 37 tareas que comparten una página de inicio con otra tarea, sus probabilidades de operación difirieron en no más de 6 puntos entre objetivos.
Fastino describe a GLiNER2.5-Decide como un clasificador para decisiones como el enrutamiento de tickets, la intención, la urgencia y si un agente ha terminado, y afirma que el modelo no razona. El modelo está construido para entradas de hasta 512 tokens, pero acepta entradas más largas. Nuestras solicitudes del primer paso tenían una mediana de 1.915 tokens.
CLM-v0.1-8B
CLM-v0.1-8B de Contrastive-LM7 eligió esperar en 2.199 de sus 2.288 decisiones de operación, por lo que 36 intentos se quedaron sin acciones. En las mismas páginas de inicio, sus probabilidades difirieron como máximo 13 puntos entre objetivos.
Contrastive-LM afirma que CLM-v0.1-8B, sin fine-tuning, rinde a la par de Jev en tareas de uso de computadora, juegos y llamada de herramientas, y que acepta el formato de solicitud de Jev sin cambios.8 Le enviamos solicitudes en ese formato.
Velocidad y éxito
Kev-27B, Eikos-27B y AutoJev-27B completaron del 68 % al 80 % de las tareas con una mediana de unos 7 segundos por intento, más rápido que Gemini con 12,7 segundos y Astra con 17.4. SubQ Snap, pplx-decider-v1.1-27b y Mercury Decide completaron del 72 % al 82 % en 5.3 a 6,3 segundos.
decider-4b, decider-12b y Jev tardaron de 2.5 a 4,2 segundos por intento y declararon bloqueadas de 19 a 24 tareas.
GLiDE completó el 76 % con una mediana de 46,8 segundos por intento, y 3 de sus intentos alcanzaron el límite de 900 segundos. NeoHorse-Jev-4B fue el más lento, con 78,6 segundos y 15 tareas completadas. GLiDE v2 completó el 72 % con una mediana de 6,0 segundos.
GLiNER2.5-Decide (0,2 segundos) declaró 49 de 50 tareas terminadas en su primera decisión, y Kev-4B declaró 29 tareas bloqueadas en la suya.
Kev-9B tomó una mediana de 38,3 segundos por intento, cinco veces Kev-27B. Cada decisión de Kev-9B tomó una mediana de 3,7 segundos de tiempo de servidor, frente a aproximadamente 1 segundo para una llamada completa a la API de Jev. La sobrecarga de la solicitud añadió aproximadamente medio segundo.
Kev-9B promedió 26 decisiones por intento, frente a aproximadamente 4 en Jev, y el 90 % de ellas se produjeron en intentos fallidos.
Coste
Coste de la automatización del navegador
† Estimación: coste de A100 por token de entrada, medido en las propias solicitudes de navegador del modelo con la GPU llena, multiplicado por sus tokens de entrada de navegador, más las tarifas del ayudante de texto. Método en metodología.
‡ La cifra más alta añade 17 solicitudes que fallaron sin informar tokens, contadas a 120.000 tokens de entrada cada una; Fastino podría no facturarlas.
Astra, Gemini y Jev utilizaron de 3.150 a 3.470 tokens de entrada por decisión. El precio de entrada de Astra es aproximadamente 240 veces el de Jev.910
Con razonamiento bajo, Astra produjo 6.599 tokens de salida en 307 decisiones, frente a 968.376 tokens de entrada. El precio de salida de Jev es $0.
Al precio de entrada de Jev, los 968.376 tokens de entrada de decisión de Astra habrían costado alrededor de $0,04 en lugar de $9.68. Kev-27B se quedó a siete tareas de Astra por un coste estimado de $0,24 en las 50 tareas, frente a los $10,63 de Astra.
Con estas estimaciones, todos los modelos de decisión de la tabla que completaron una tarea, excepto Celeris 1.1 Decision, Kev-4B, Kev-9B y NeoHorse-Jev-4B, costaron menos por tarea completada que Gemini. Nueve modelos costaron menos que Jev 1.13 por tarea completada: Mercury Decide, Decider V1.2, pplx-decider-v1.1-27b, Span-02, Drex v1.5, SubQ Snap, H2O-Lightning-4B, Jev 1.14 y Drex v2.0. Mercury Decide cuesta menos de un tercio de lo que cuesta Jev.
- Kev-9B costó aproximadamente 5 veces Gemini y 84 veces Jev por tarea completada. Su coste estimado de A100 fue de aproximadamente $0,80 por millón de tokens de entrada, 19 veces el precio de Jev en su API, y tomó 1.321 decisiones frente a las 185 de Jev.
- Kev-4B tuvo un coste estimado de GPU por token aproximadamente 12.1 veces su precio en OpenRouter.
El tiempo de A100 que alquilamos para la ejecución de Kev-9B, 3.32 horas incluyendo configuración y tiempo inactivo, ascendió a aproximadamente $5.31. Una tarifa de Jev y dos tarifas de Gemini no se registraron y faltan en la tabla.
Coste de clasificación
Los modelos alojados tienen el precio de lista de su API, excepto los modelos en OpenRouter, que se facturan según las tarifas que OpenRouter cobró. Mercury Decide se ejecutó en la ruta gratis de OpenRouter y tiene el precio de lista de su ruta de pago. Los modelos autoalojados se facturan por 1.000 decisiones según la mayor tasa de transferencia que medimos en una A100 alquilada con la GPU llena.
A nuestra tarifa de $1,673 por hora, una A100 alquilada cuesta aproximadamente $40 al día, ocupada o inactiva. A la tarifa que registramos, $40 compran alrededor de un millón de decisiones de Jev.
 Añadir como fuente preferida
Entrenamiento de modelos de decisión
Hicimos fine-tuning de Kev-9B y Laya en decisiones que GLM-5.3-Flash, el modelo de etiquetado, tomó en tareas de navegador de ocho sitios web fuera del benchmark. Luego volvimos a ejecutar las 50 tareas. Cada modelo con fine-tuning se compara con su versión original, ejecutada el mismo día y en el mismo hardware.
El Kev con fine-tuning y ambas versiones de Laya están en Hugging Face.
p proviene de una prueba pareada en las mismas 50 tareas (McNemar exacto), y p por debajo de 0.05 se considera significativo. El Kev original completó 21 tareas en esta comparación, una más que en los resultados anteriores. Una de las 12 ganancias de Kev, C02, fue un tiempo de espera del navegador en la ejecución original y no un fallo del modelo. Sin esta, Kev ganó 11 tareas y perdió 1 (p = 0.006).
- El Kev con fine-tuning ganó tareas en seis de los nueve sitios web, tres en Quotes to Scrape y tres en Scrape This Site. Sus resultados en Web Scraper, Wikipedia y los formularios de TestPages no cambiaron.
- El Kev con fine-tuning terminó 5 intentos bloqueados frente a 12 y alcanzó el límite de acciones 6 veces frente a 11. Declaró terminada una tarea inacabada 7 veces, frente a 4.
- En 41 tareas de los sitios web de entrenamiento que se dejaron fuera del entrenamiento, Kev completó 21 frente a 13 antes. En 101 decisiones individuales de 19 de esas tareas, eligió la operación del modelo de etiquetado el 94 % de las veces, frente al 62 % anterior.
- El primer fine-tune de Laya eligió la operación del modelo de etiquetado en el 75 % de las 88 decisiones que pudo leer, frente al 19 % del Laya original. Llamó terminada una tarea en una página que aún necesitaba una acción 2 veces en lugar de 53.
- En el benchmark, el primer fine-tune de Laya declaró terminada una tarea inacabada 36 veces, una antes de realizar cualquier acción. El Laya original lo hizo 32 veces, 17 de ellas antes de cualquier acción.
Casos de uso de los modelos de decisión
- Comprobar la señal de finalización de un agente. En la última página que un agente de navegador vio antes de declarar una tarea terminada, 41 de los 59 modelos de decisión obtuvieron una puntuación superior a 90 al distinguir terminada de no terminada, y AutoJev-27B, Clef, d1-ultra, Decision-2.0-Vega-27B y Kev-27B obtuvieron 99.5. No probamos comprobaciones en páginas anteriores de una ejecución.
- Triaje con etiquetas fijas, como calificar avisos de seguridad o retiros. decider-12b obtuvo 21 puntos por encima del nivel de azar en gravedad y 29 en retiros. En temas de artículos, un clasificador de palabras clave entrenado en 28.595 artículos etiquetados obtuvo 70.4, y ningún modelo de decisión obtuvo una puntuación significativamente más alta; el mismo tipo de clasificador obtuvo casi al azar en gravedad y retiros.
- Elegir cada acción en la automatización del navegador. SubQ Snap completó 41 de 50 tareas, frente a 43 y 47 para los dos LLMs. Hacer fine-tuning de Kev-9B en 606 decisiones de otros sitios web lo elevó de 21 a 32.
En las dos tareas principales de clasificación, los modelos de decisión locales costaron un estimado de $0,007 a $0,57 por 1.000 decisiones en una GPU alquilada, y todos excepto NeoHorse-Jev-4B y Shisa DE-2 promediaron menos de un segundo por decisión. En las tareas de navegador, el precio de entrada de Jev fue aproximadamente 1/240 del de GPT-6 Astra.
Cada respuesta también incluye una probabilidad por opción, que una aplicación podría usar para pasar casos inciertos a un LLM. No probamos en qué medida esas probabilidades coinciden con la precisión real.
36 de los 59 modelos se ejecutaron en una sola GPU alquilada; los otros 23 son APIs alojadas.
Metodología
Benchmark de automatización del navegador
Todos los modelos usaron el mismo runtime de navegador jev-ultrafast. En cada paso, convertía la página actual en texto de página más una lista numerada de controles visibles. El modelo elegía una operación, como clic, escribir, seleccionar, terminada o bloqueada, y un objetivo de esa lista. El runtime ejecutaba la acción y volvía a leer la página.
Los modelos de decisión clasifican las opciones suministradas y no devuelven texto. Cuando un modelo elegía escribir, el ayudante de texto escribía el valor en el campo del formulario. Cada intento comenzaba en una sesión de navegador nueva.
Todos los modelos se conectaron mediante una API; Kev-9B y Laya se ejecutaron con el navegador en un Mac, en Chrome 153 hasta el 30 de septiembre y Chrome 154 desde el 2 de octubre. Los demás modelos autoalojados se ejecutaron con Chrome en Linux en sus GPUs alquiladas.
Ninguna solicitud se acortó para ajustarse a un modelo. Solar Decide, Solar Decide Flash y Ollama aceptan de 2 a 26 opciones por pregunta. Una solicitud fuera de esos límites terminaba el intento, como ocurría con las solicitudes excesivamente grandes para Laya. Ollama solo acepta descripciones de opciones como texto, por lo que las opciones estructuradas se enviaron como texto JSON compacto. Tev1 se distribuye con un contexto de 2.050 tokens; lo aumentamos a 8.194, el ajuste propio de Nimble, para que las páginas no se cortaran.
Classify-1 rechaza las instrucciones estructuradas, las descripciones de opciones y el estado de página que reciben los demás modelos, por lo que en ambos benchmarks se los enviamos como texto JSON compacto.
Strands Decider 2B lee como máximo 4.096 tokens y rechazó las páginas más largas, lo que terminó 11 intentos.
El servicio de Cloudflare lee solo los primeros 2.048 tokens del texto de la página para Clef y Clef-Flash. No enviamos páginas más largas, lo que terminó un intento para cada modelo.
Para 21 modelos, entre ellos Clef, decider y Eikos, una pregunta con una sola opción, como el único campo de texto de una página, se enviaba con esa opción dos veces, y la respuesta se mapeaba de nuevo a ella. Sus servicios rechazan preguntas con una sola opción.
Ejecutamos Kev-9B con el código de referencia del productor en precisión completa de 32 bits. No instalamos paquetes de kernel opcionales que aceleran su modelo base, por lo que el modelo recurrió a kernels de referencia más lentos. No probamos una configuración de GPU más rápida.
El propio código de CLM convierte cada solicitud en texto. GLiNER recibió el mismo texto, con el objetivo y las reglas de cada pregunta como su prompt. Kev-4B también se sirve en OpenRouter a través de SiliconFlow en precisión de 8 bits.11 Ejecutado a través de él desde el Mac el 29 de septiembre, Kev-4B completó 8 tareas.
GPT-6 Luna Decisions también se sirve en OpenRouter, que devuelve un error para toda la solicitud cuando el modelo rechaza una pregunta; la API de OpenAI responde las demás preguntas.12 A través de OpenRouter, Luna completó 1 tarea, por lo que los resultados anteriores usan la API de OpenAI.
Para Celeris 1.1 Decision, 4 de las 50 tareas de navegador usaron Mercury 3 como ayudante de texto en lugar de Mercury 2.5. Celeris falló las cuatro con cualquiera de los dos ayudantes.
Modelos de navegador
El razonamiento bajo es un ajuste de esfuerzo definido por el proveedor. Las 307 decisiones de Astra incluyeron 791 tokens de razonamiento reportados. Kev-9B13 y Kev-4B14 provienen del mismo desarrollador, y Nimble 9B es de Bespoke Labs.15 GLiDE proviene de Fastino, el desarrollador de GLiNER2.5-Decide,16 y Clef y Clef-Flash de Cloudflare.17
La ficha de modelo de MATILDA JEV v1.5 dice que un entrenamiento anterior en su linaje utilizó material relacionado con el benchmark.18
Dataset
Las 50 tareas cubren nueve sitios web: ocho sitios de práctica creados para scraping y pruebas, más Wikipedia. Las tareas incluyen navegación por catálogos, búsqueda, ordenación, paginación, opciones de producto, formularios y consultas de artículos. Cada tarea comienza desde una URL fija y establece el estado final en una frase; por ejemplo, «Cambia a Ciencia Ficción, encuentra Dune (Dune #1), abre los detalles del producto y detente».
Antes de ejecutar los modelos, una ejecución guionizada completó las 50 tareas usando solo las acciones admitidas por el runtime. Todas las tareas se pueden resolver sin contraseñas, CAPTCHAs ni la tecla Enter.
Tareas de ejemplo
Diez de las 50 tareas están publicadas en Hugging Face con las instrucciones, la URL de inicio, las condiciones de aprobación y el resultado de cada modelo. Las otras 40 se reservan para ejecuciones posteriores.
Evaluación
Una tarea se consideraba aprobada cuando el modelo la declaraba terminada dentro de los límites y una comprobación independiente de la página final confirmaba cada condición: una URL final aceptada, los hechos de la tarea visibles en la página, más de 100 caracteres de texto de página y una página completamente cargada.
Cada intento tenía 900 segundos, 60 acciones de navegador y 120 llamadas de decisión. Los errores de API contaban como fallos. El tiempo se mide desde la primera página cargada hasta la comprobación final.
La comprobación lee la página final después de que termine de cargarse.
Cálculo de costes
El coste de API cubre las llamadas de decisión y el ayudante de texto, en los 50 intentos por modelo. OpenRouter informó de las tarifas de GPT-6 Astra, Gemini y Mercury 2.5. El coste de Jev son sus tokens reportados al precio de lista del 22 de septiembre de 2026: $0,042 por millón de tokens de entrada y sin cargo por la salida.5 GLiDE, Clef y Clef-Flash también se valoran a sus precios de lista.
GLiDE v2, GPT-6 Luna Decisions, SubQ Snap y Celeris 1.1 Decision se valoran a sus precios de lista, y los demás modelos de decisión en OpenRouter a las tarifas que OpenRouter informó. Mercury Decide, ejecutado en la ruta gratis, se valora al precio de lista de su ruta de pago.
Las ejecuciones de navegador autoalojadas usaron una A100, A6000, RTX 4090 o un Mac. Las valoramos todas en una A100 alquilada a $1,673 por hora. Enviamos las propias solicitudes de navegador de cada modelo de nuevo con la GPU llena. El coste de un modelo en la tabla es su coste por token de entrada a la mayor tasa de transferencia, multiplicado por sus tokens de entrada de navegador, más las tarifas del ayudante de texto.
Ambas cargas de trabajo son casi en su totalidad de entrada, porque estos modelos devuelven puntuaciones de opciones o unos pocos tokens.
Fine-tuning
Las 327 tareas, 286 para entrenamiento y 41 reservadas, provienen de ocho sitios web que no están en el benchmark, incluidos Demo Web Shop, Automation Exercise y Project Gutenberg. Cada tarea se comprobó en un navegador: su página de inicio falla el evaluador, y donde la tarea termina en una URL diferente, esa página aprueba.
GLM-5.3-Flash, un modelo de pesos abiertos bajo licencia MIT,19 intentó 300 de las tareas en el runtime del benchmark con razonamiento bajo. Errores del proveedor le impidieron las otras 27. No usamos GPT-6 Astra ni Gemini para esto, porque los términos de OpenAI y Google prohíben usar su salida para construir modelos competidores.2021
Las 184 ejecuciones de entrenamiento exitosas dieron 606 registros de decisión. Una ejecución se consideraba exitosa cuando el evaluador la aprobaba, o cuando llegaba a la página de producto correcta mediante la búsqueda del sitio y solo fallaba la comprobación de URL exacta, como hicieron 11 ejecuciones en todas las tareas.
La prueba de decisión única reproduce 103 decisiones grabadas de 19 tareas reservadas y cuenta con qué frecuencia un modelo elige la operación del modelo de etiquetado. Kev pudo leer 101 de ellas. Laya pudo leer 88 cuando se le enviaban solo las preguntas que cada paso necesita, y 34 en la solicitud completa que envía el benchmark. En esas 34, el Laya original coincidió el 29 % de las veces, el primer fine-tune el 71 % y el segundo el 41 %.
Ambos modelos partieron de los pesos originales que evaluamos y usaron las recetas de entrenamiento de sus productores con los límites de entrada del benchmark. Kev también entrenó durante dos epochs en lugar de una, sin los registros de repetición del productor. Cada ejecución de entrenamiento duró menos de 20 minutos en una H100 GPU.
El primer fine-tune de Laya usó los mismos 606 registros, omitiendo los que fueran demasiado largos para Laya. El segundo conservó solo los 292 que cabían en la solicitud completa que envía el benchmark y añadió 102 de las propias ejecuciones de Laya, donde GLM-5.3-Flash tomó el control después de que Laya declarara una tarea terminada o bloqueada (73) o agotara su presupuesto de 10 acciones (29). Kev no tuvo segunda ronda.
La pareja de Kev y la primera pareja de Laya se ejecutaron en una H100 alquilada en Francia, con Chrome en Linux. La segunda pareja de Laya se ejecutó en el Mac del benchmark principal. Cada pareja usó las 50 tareas, el runtime, los límites y el evaluador del benchmark principal, con un intento por tarea.
Benchmark de clasificación
Cada elemento es una decisión con un conjunto fijo de opciones. Los elementos provienen de registros publicados entre julio y septiembre de 2026 y de instantáneas no publicadas de páginas finales de nuestras propias ejecuciones de navegador. Muchos de los modelos se publicaron después de que estos registros se hicieran públicos, por lo que un modelo podría haber visto un elemento y su respuesta registrada durante el entrenamiento. No podemos comprobar con qué se entrenó cada modelo.
Las tres primeras tareas piden al modelo que reproduzca, solo con el texto, una decisión registrada por una institución. GitHub y la FDA pueden haber usado evidencia que el texto no contiene. Los niveles de gravedad de GitHub coinciden con las cuatro calificaciones por encima de None en CVSS, el sistema estándar de puntuación de vulnerabilidades.22
Todos los modelos recibieron las mismas instrucciones y definiciones de opciones para una tarea: las definiciones de clase de la FDA, las bandas de gravedad de GitHub y las descripciones de categoría de arXiv. El orden de las opciones se barajó por elemento y fue el mismo para todos los modelos. La gravedad de fallos de seguridad y el nivel de peligro de retiro son las tareas principales, fijadas antes de cualquier ejecución; los temas de artículos y la comprobación de tarea terminada son complementarios.
La puntuación es exactitud equilibrada: la tasa de éxito dentro de cada respuesta posible, promediada entre las respuestas.
Un modelo que siempre da la respuesta más común obtiene 25 en gravedad, 33 en retiros y 5 en temas de artículos. La puntuación del gráfico es el promedio de las dos tareas principales, donde esa respuesta obtiene aproximadamente 29. Los intervalos son intervalos bootstrap del 95 % que remuestrean juntos elementos relacionados: avisos del mismo paquete, retiros del mismo evento de retiro, páginas de la misma tarea de navegador.
Para comprobar si algún modelo obtuvo una puntuación significativamente superior a decider-12b, extrajimos 1.000 de estos remuestreos, los mismos para cada modelo, y tomamos el intervalo del 95 % de la diferencia de cada modelo en cada tarea principal; un modelo solo se considera superior si ese intervalo queda por encima de cero, sin ajuste por comparaciones múltiples. Cada modelo se comparó de la misma manera con el clasificador de palabras clave en temas de artículos.
Dos LLMs, Qwen 3.8 Max y Claude Opus 5.5, etiquetaron una muestra de 350 elementos de prueba, 100 por tarea y 50 páginas de navegador, sin ver la respuesta registrada.
Coincidieron entre sí en 62 de 100 avisos, 69 de 100 retiros, 84 de 100 artículos y 49 de 50 páginas de navegador. Donde no coincidieron con el registro en avisos y retiros, en su mayoría se desviaron un nivel, hacia los niveles intermedios. Coincidieron con la gravedad de GitHub en 55 y 56 de 100 avisos.
Ambos jueces dieron la misma respuesta, diferente del registro, en 54 elementos. Comprobamos los 53 registros de GitHub, FDA y arXiv contra la fuente en vivo, y todos coincidieron, por lo que no se cambió ninguna etiqueta.
La única página de navegador se etiquetó como terminada porque el evaluador contaba al menos 40 reseñas en la página completa, mientras que la instantánea que ven los modelos muestra aproximadamente nueve. La eliminamos junto con los otros 48 elementos de tarea terminada cuya respuesta dependía de contar 10 o más elementos, lo que deja 155.
Los costes locales son válidos para el ajuste que probamos en esa GPU; otro ajuste de servidor u otra GPU los cambiarían. Cuando medimos las primeras versiones de Ollama de Nimble 9B y los modelos Tev1 para el coste, Tev1 0.8B difirió de su ejecución puntuada en el 1,2 % de las preguntas, y Nimble 9B y Tev1 4B en menos del 1 %.
En el ajuste elegido, los demás modelos autoalojados coincidieron con al menos el 98 % de sus respuestas puntuadas, excepto Shisa DE-1 y Shisa DE-2. Estos varían de una ejecución a otra incluso una solicitud a la vez, por lo que su umbral fue su propia coincidencia una a una menos 2 puntos porcentuales; coincidieron un 97,6 % y un 96,4 %. En sus propias solicitudes de navegador, CLM-v0.1-8B, Shisa DE-2 y GEV-26B-Decide coincidieron un 90,7 %, 77,9 % y 83,1 % bajo la misma regla.
Excepciones a la ejecución de cada modelo tal como se publicó:
- Laya Typed-Decisions se ejecutó con un contexto de 8.192 tokens en lugar de los 1.024 publicados, y Tev1 con 8.194 en lugar de 2.050, como en nuestras ejecuciones de navegador.
- Donde el propio código de Laya habría cortado una opción o entrada larga, nuestro conector rechazaba la solicitud, y un rechazo cuenta como respuesta incorrecta. Todas las solicitudes de tema de artículo fueron rechazadas porque las descripciones de tema son más largas que los 48 tokens que Laya lee por opción.
- El contexto del codificador de CLM se aumentó de 2.048 a 16.384 tokens; GLiNER se ejecutó más allá de su entrada documentada de 512 tokens. Shisa DE-1 usó un contexto de 32.768 tokens para caber en la memoria de la GPU.
- d3, d3-flash, d3-mini, Decision-2.0-Vega-27B, Decision-1.0-Lux-9B y MATILDA JEV v1.5 se ejecutaron en una NVIDIA A100, que sus productores no han validado; los tres d3 y Decision-2.0-Vega-27B se ejecutaron sin sus rutas rápidas exclusivas de AMD. JEV-27B-VL y GEV-26B-Decide se ejecutaron en vLLM 0.29.0; sus fichas de modelo nombran una compilación de vLLM no publicada.
- NeoHorse-Jev-4B se ejecutó mediante el adaptador vLLM de su productor, porque su propio servidor rechaza texto de página de más de 2.048 tokens por defecto.
- APUS Reflex 35B-A3B acepta de 2 a 16 opciones por pregunta, por lo que rechazó las 500 preguntas de tema de artículo (20 opciones), que cuentan como respuestas incorrectas, y no ejecutó las tareas de navegador.
- Together AI no había publicado una licencia para los pesos de Tev1 al 30 de septiembre de 2026.
- El servicio de Cloudflare lee solo los primeros 2.048 tokens del texto del elemento para Clef y Clef-Flash, aunque los modelos aceptan 65.536. Los 12 elementos más largos, 9 de gravedad y 3 de retiros, cuentan como respuestas incorrectas.
Limitaciones
Cada modelo intentó cada tarea de navegador una vez, por lo que una diferencia de unas pocas tareas entre dos modelos no muestra cuál es mejor.
Las 50 tareas provienen de nueve sitios web, y las tareas del mismo sitio comparten diseños de página. Los modelos se ejecutaron en sitios web en vivo, que pueden cambiar entre ejecuciones.
El formato de paso, una lista de operaciones más listas de objetivos, se creó primero para Jev. Todos los modelos recibieron el mismo formato. No probamos si otro formato cambiaría los resultados. Laya se ejecutó con límites de entrada por encima de sus ajustes publicados para que las páginas largas no se cortaran.
En el benchmark de clasificación, cada modelo respondió cada elemento una vez. Las respuestas de GitHub y la FDA son las decisiones registradas por esas instituciones, que pueden basarse en evidencia que el aviso o el texto de retiro no contiene.
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{AIM-Decision: Jev frente a Clef frente a LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/decision-models}},
  note   = {AIMultiple. Recuperado el 21 de octubre de 2026}
}Resultados y marcas de tiempo de 389 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 10 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia






Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.