


Optimización de costes de Kubernetes: 8 pasos y 23 herramientas

Los clústeres de Kubernetes pueden parecer totalmente sanos mientras la factura sube. El autoscaling está configurado, los paneles están en verde y, aun así, el gasto aumenta. En una encuesta, el 42 % de 455 ingenieros de plataformas señaló el coste como su principal desafío de Kubernetes, mientras que el 88 % vio aumentar el coste total de propiedad año tras año.1
Recopilamos 68 estudios de caso sobre optimización de costes de Kubernetes y asignamos cada caso de uso mencionado a cada proveedor que lo publicó:
Las celdas más oscuras significan más menciones. Las celdas en blanco significan que esa herramienta no tiene ningún caso publicado para ese caso de uso.
Continúa desplazándote para ver la guía de 8 pasos con ejemplos reales para reducir el gasto en clústeres y la comparación de herramientas de optimización de costes de Kubernetes.
1. Mide antes de cambiar nada
Cada cifra del resto de esta guía es una delta, y una delta necesita un punto de partida. Sin una línea base registrada antes del primer cambio, no hay forma de saber si el paso 1 funcionó, ni de atribuir los ahorros del paso 3 a la consolidación y no al redimensionamiento que la precedió. Esto importa más aquí que en la mayoría de los trabajos de ingeniería, porque las seis acciones reducen la misma factura y sus ahorros no se suman. Liberar capacidad en el paso 1 no produce nada en la factura hasta que el paso 3 elimina los nodos.
Mide cuatro cosas:
- Solicitados frente a utilizados: CPU y memoria, por carga de trabajo. La brecha es tu lista de pendientes del paso 1, ordenada por tamaño.
- Coste por namespace y por carga de trabajo. Esto es lo que convierte las cuotas del paso 2 en una negociación y no en una imposición.
- Eficiencia de bin-packing, asignable frente a solicitado por nodo. El objetivo del paso 3.
- Coste inactivo por hora del día y día de la semana en no producción. Dimensiona el paso 5 antes de construirlo.
Mide a lo largo de al menos un ciclo de negocio completo. Siete días es el mínimo y treinta es mejor. La ventana no es una precaución de procedimiento. El paso 1 establece las solicitudes de memoria en el máximo observado, y un máximo observado es tan bueno como la ventana que lo observó. Un máximo tomado durante 48 horas omite un trabajo por lotes semanal y produce un OOMKill el domingo siguiente.
Herramientas
- Asignación de costes: OpenCost, el proyecto de la CNCF detrás del modelo de asignación, es la base gratis. El nivel gratis de Kubecost envuelve el mismo motor en una interfaz de usuario hasta 250 núcleos.
- Utilización: Prometheus con kube-state-metrics es el sustrato. Robusta KRR lo lee directamente sin instalar nada en el clúster.
- Gasto más amplio: Cuando Kubernetes es una parte de una factura que finanzas también tiene que explicar, CloudZero, Vantage y Finout se sitúan por encima de esta capa en lugar de reemplazarla.
Ambas herramientas de coste atribuyen por etiqueta, así que el etiquetado es lo primero. El gasto sin etiquetar es la razón más común por la que una línea base resulta inútil tres semanas después.
Cada acción a continuación indica la recomendación, el método, la configuración y una empresa que dio ese paso. Cada caso de estudio y cada estadística incluye un enlace a la fuente.
2. Establece cuotas de namespace como barreras de protección
Los ahorros decaen a medida que los equipos despliegan nuevas cargas de trabajo sin solicitudes especificadas. Un LimitRange proporciona solicitudes predeterminadas a los contenedores que las omiten, y un ResourceQuota limita lo que un namespace puede consumir en total.
Implementa el LimitRange antes que el ResourceQuota. Una vez que una cuota restringe un recurso, cualquier pod sin una solicitud para ese recurso se rechaza en la admisión, por lo que el orden inverso rompe los despliegues.2
Cada balanceador de carga se factura por separado por el proveedor de nube, y los volúmenes huérfanos siguen facturando después de que sus pods hayan desaparecido.
2. Redimensiona las solicitudes de CPU y memoria
Las solicitudes determinan el número de nodos, y el número de nodos determina la factura. La mayoría de los clústeres funcionan muy por debajo de la capacidad que pagan, porque las solicitudes se calcularon una vez y nunca se revisaron. Un análisis de 23.000 clústeres de producción en AWS, Azure y Google Cloud halló una utilización media de CPU del 8 %, de memoria del 20 % y de GPU del 5 %. 3
Establece las solicitudes de CPU cerca del percentil 95 del uso observado. Establece las solicitudes de memoria en el máximo observado en lugar de un percentil, y establece el límite de memoria igual a la solicitud. Un percentil deja al contenedor corto durante el tráfico restante y, como el límite coincide con la solicitud, esa escasez llega como un OOMKill en lugar de una ralentización.
Omite el límite de CPU. El throttling de CPU degrada la latencia sin matar el pod, y la solicitud reserva lo que la carga de trabajo necesita.
El Vertical Pod Autoscaler en modo de solo recomendación produce estas cifras sin riesgo para producción.
Lee las recomendaciones con kubectl describe vpa payments-api y compara el valor objetivo con la solicitud actual.
Caso de estudio real: Tryg Insurance
Tryg Insurance es la mayor aseguradora general de la región nórdica y ejecuta Kubernetes en Oracle Cloud Infrastructure. Su equipo de ingeniería combinó el Horizontal Pod Autoscaler y el Vertical Pod Autoscaler para redimensionar las cargas de trabajo de forma dinámica manteniendo los niveles de servicio, y redujo los costes de nube de Kubernetes en un 50 % usando únicamente autoscalers de código abierto, sin ninguna plataforma comercial de optimización.4
4. Consolida nodos con Karpenter y escala a cero las cargas de trabajo inactivas
El redimensionamiento libera capacidad, pero esa capacidad permanece en nodos que siguen ejecutándose hasta que algo los elimina. Karpenter aprovisiona instancias a tiempo y reempaqueta las cargas de trabajo en menos nodos. KEDA escala a cero réplicas las cargas de trabajo basadas en colas, algo que un Horizontal Pod Autoscaler estándar no puede hacer.
Configura la política de consolidación en WhenEmptyOrUnderutilized. La alternativa, WhenEmpty, restringe la interrupción a nodos que no contienen ningún pod de carga de trabajo, y esos rara vez se producen sin intervención. 5
Una lista reducida de instancias anula esto, porque Karpenter no puede encontrar valores atípicos baratos y tu resiliencia de spot disminuye. Debes dejar que elija entre familias de instancias completas.
Caso de estudio real: Adidas
Adidas ejecuta varios clústeres de Kubernetes en AWS EKS. Su equipo de ingeniería de plataformas adoptó Karpenter para el aprovisionamiento de nodos, añadió KEDA para el escalado basado en eventos, creó automáticamente objetos Vertical Pod Autoscaler mediante políticas de Kyverno y utilizó kube-downscaler para entornos inactivos. Redujeron el coste de ejecutar sus clústeres de Kubernetes en AWS hasta en un 50 %, utilizando una pila totalmente de código abierto.6
5. Prepárate adecuadamente antes de mover cargas de trabajo a spot
Las instancias spot ofrecen el mayor descuento disponible y la aplicabilidad más limitada. Nada debe moverse a spot hasta que los PodDisruptionBudgets, la diversificación de instancias, la dispersión topológica y la gestión de terminaciones estén todos en su sitio.
Un PodDisruptionBudget que no deja margen bloquea toda interrupción voluntaria, incluida la consolidación de Karpenter, por lo que los valores necesitan holgura. 7
Caso de estudio real: Delivery Hero
Delivery Hero opera 390 aplicaciones en 43 países, con aproximadamente el 90 % de las cargas de trabajo ejecutándose en AWS EKS. Su equipo migró a instancias spot a lo largo de aproximadamente seis meses, incorporando la gestión de terminaciones y un descheduler en el proceso en lugar de cambiar directamente los tipos de capacidad.
- Los costes de infraestructura se redujeron alrededor de un 70 %
- Los descuentos de spot alcanzaron hasta un 90 % frente al precio bajo demanda
- La plataforma absorbe picos de tráfico de 4 a 5 veces el volumen normal.8
6. Apaga los entornos no productivos según un horario
Los entornos de desarrollo y staging soportan poca o ninguna carga por la noche y los fines de semana. El apagado programado es técnicamente simple y políticamente indiscutible, lo que lo convierte en el ahorro más rápido de conseguir y en una primera acción útil cuando cambios más difíciles necesitarán apoyo más adelante.
Aplica el horario por defecto en todos los namespaces no productivos y exige a los equipos que se excluyan explícitamente. Una política que exige una acción para participar llega a menos equipos que una que exige una acción para salir.
El ahorro llega a la factura si la consolidación de nodos está en marcha, ya que los despliegues escalados a cero dejan nodos vacíos.
Caso de estudio real: Bud Financial
Bud Financial enriquece datos de transacciones financieras para el sector de servicios financieros y ejecuta aproximadamente 25 clústeres en Google Kubernetes Engine. Su equipo utilizó pausas y reanudaciones programadas para reducir los nodos del clúster por la noche y los fines de semana, junto con un reequilibrado diario.
- Los costes se redujeron un 47 % solo con el cambio de programación
- El horario eliminó 80 horas de funcionamiento del clúster por semana
- La utilización de recursos superó el 90 %.9
7. Migra las cargas de trabajo compatibles a ARM
Las instancias basadas en ARM cambian el precio unitario en lugar de competir por la misma capacidad inactiva que las acciones anteriores, por lo que estos ahorros se suman de verdad al resto. Los bloqueos serán las dependencias sin compilaciones para ARM64.
Los usuarios deben limitar esto a cada carga de trabajo en lugar de a todo el parque, y crear imágenes multiarquitectura antes de programar nada.
Caso de estudio real: Pinterest
Pinterest migró su carga de trabajo de web API a instancias AWS Graviton que se ejecutan en ARM64, motivado tanto por la reducción de costes como de carbono.
- Los costes se redujeron un 47 %
- El consumo de cómputo se redujo un 38 %
- Las emisiones de carbono se redujeron un 62 %.10
8. Cuando el ajuste se agota, cambia la arquitectura
Las seis acciones anteriores ajustan las cargas de trabajo dentro de los clústeres existentes. Una vez agotadas, las ganancias adicionales requieren un cambio de arquitectura en lugar de más ajustes.
Dos resultados publicados marcan el límite práctico. InCred Finance redujo el gasto en un 30 % en clústeres que su equipo consideraba optimizados11, y Yotpo consiguió 30–40 % mientras ejecutaba el 80 % de las cargas de trabajo en instancias spot12. Más allá de ese rango, el desperdicio restante ya no está dentro de los clústeres, sino en el número de clústeres. Cada uno conlleva un cargo por plano de control y forma una isla de programación que el bin-packing no puede cruzar.
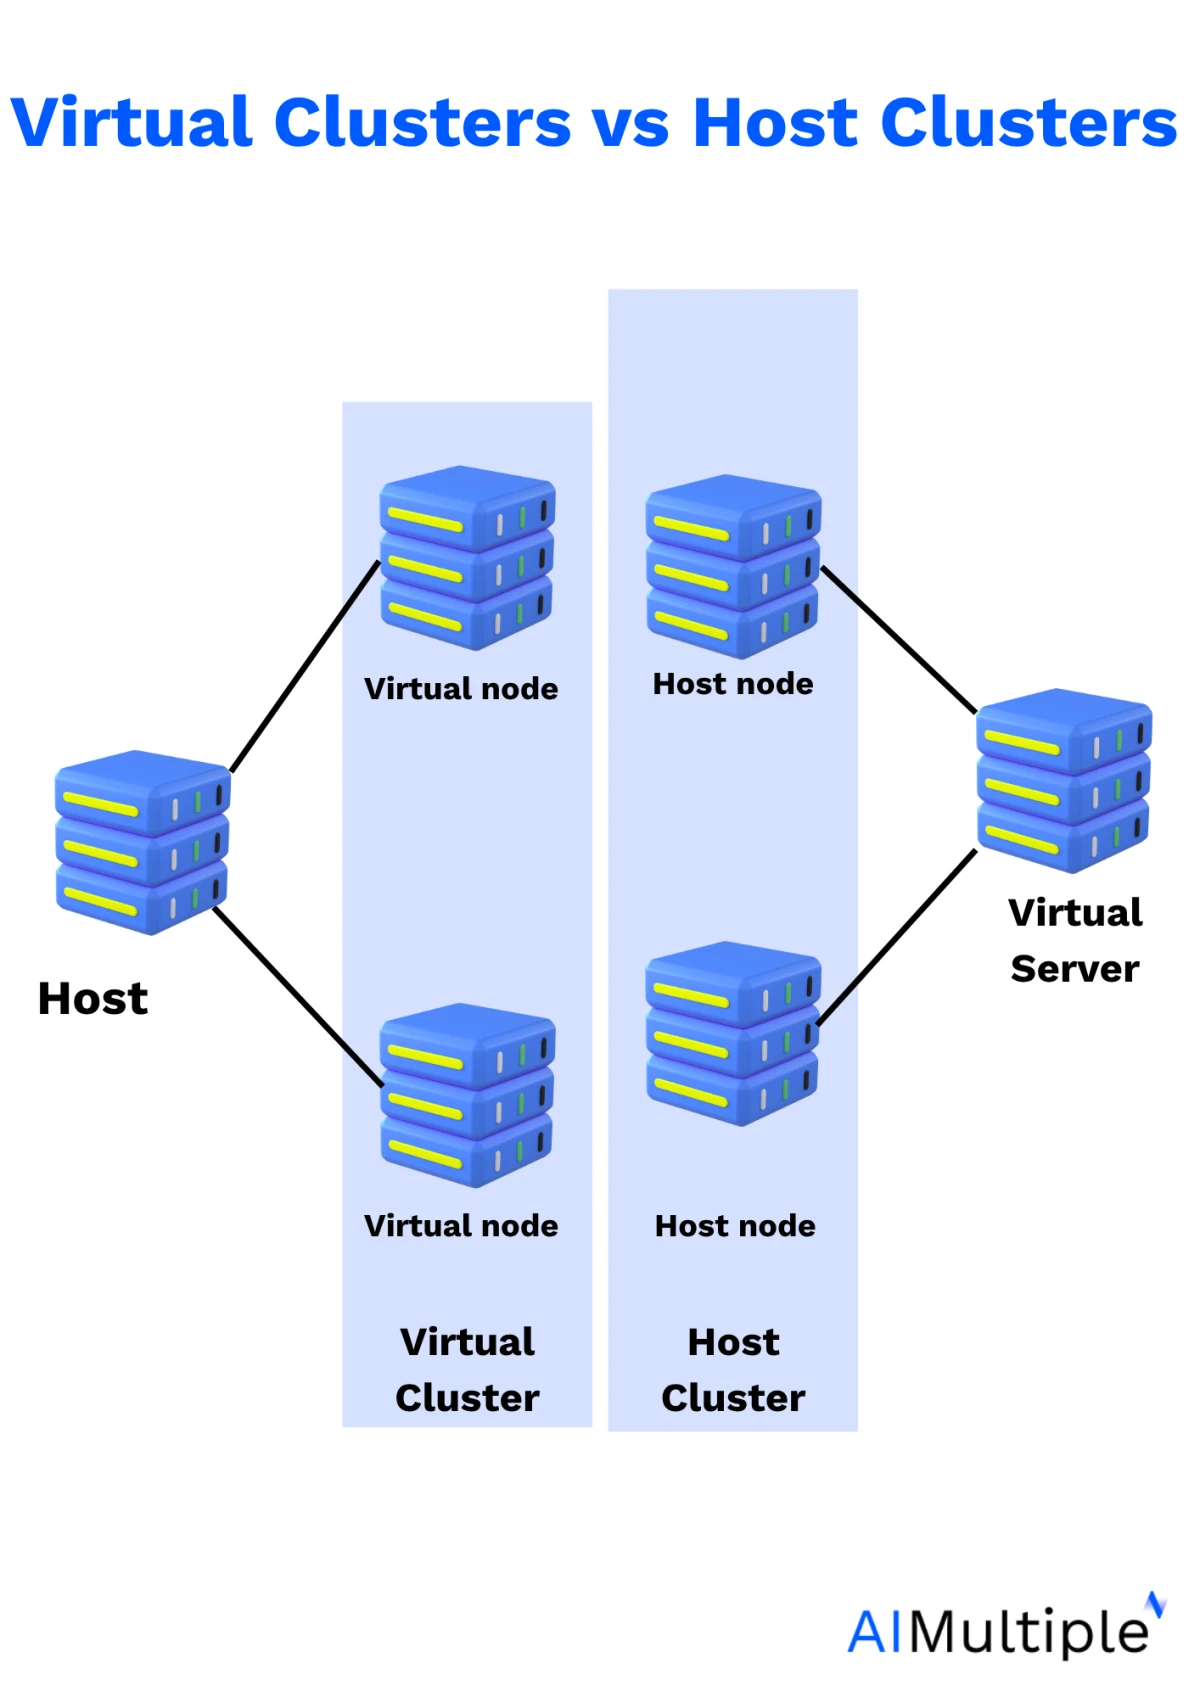
La multitenencia elimina ambos costes. En lugar de dedicar un clúster a cada cliente, equipo o entorno, los clústeres virtuales se ejecutan en infraestructura física compartida. Cada inquilino recibe su propio servidor de API y su plano de control virtual, mientras que los nodos se agrupan. Esto elimina el cargo por plano de control de cada clúster y permite el bin-packing en todo el grupo de nodos compartido, en lugar de dentro de dominios aislados.
yaml
bash
Hay dos mecanismos disponibles. Los namespaces siempre son más baratos, por lo que la elección se hace en función de la separación que requieren los inquilinos, no del coste.
- Los namespaces particionan un único clúster y no añaden un plano de control propio. Son suficientes cuando los inquilinos confían entre sí y pueden compartir un servidor de API y un conjunto de CRDs.
- Los clústeres virtuales dan a cada inquilino su propio servidor de API, que se ejecuta como una carga de trabajo en el host. Ese coste se justifica en dos casos: inquilinos que necesitan sus propios recursos de ámbito de clúster y requisitos de aislamiento que un servidor de API compartido no puede cumplir.
Caso de estudio real: Atlan
Atlan es una empresa de catálogo de datos que aloja la plataforma para aproximadamente el 95 % de sus clientes, muchos de ellos en sanidad y finanzas, donde el aislamiento de datos es contractual. Gestionaba un clúster EKS completo por cliente y superó los 100 clústeres, un parque caro de ejecutar las 24 horas y difícil de mantener. Desde el primer trimestre de 2022 evaluó opciones de multitenencia y se reconstruyó sobre vCluster, dando a cada cliente un clúster virtual en lugar de uno físico.
- Los clústeres EKS físicos pasaron de más de 100 a 20, y siguen sirviendo a más de 100 clientes
- El gasto en Kubernetes se redujo en 600.000 dólares.13
 Añadir como fuente preferida
Orden de ejecución
Los compromisos se dejan para el final a pesar de ser la acción más fácil. Comprarlos antes de redimensionar fija de uno a tres años del desperdicio que el redimensionamiento estaba a punto de eliminar. Es el error de secuenciación más caro disponible, y es común porque requiere una compra en lugar de trabajo de ingeniería.
La acción 7 es una rama, no un paso. Tómala una vez que las seis primeras estén completas y el resultado siga siendo insuficiente, ya que cambia cuántos clústeres se ejecutan y no lo eficientemente que se ejecuta cada uno.
Herramientas de optimización de costes de Kubernetes
Representamos las herramientas con tres o más casos de estudio publicados que cubren 47 de los 68 casos de estudio del dataset:
- Horizontal: cuántos casos de estudio tiene cada herramienta, contados una vez cada uno.
- Vertical: cuántas categorías distintas de casos de uso abarcan esos casos, de un total de diez. Una herramienta cuenta una vez por categoría sin importar la frecuencia con la que aparezca allí, por lo que CAST IA tiene 12 menciones separadas de redimensionamiento que contribuyen con 1 a su puntuación de 10.
- Tamaño de la burbuja: en cuántas de las ocho etapas de la estrategia aparece la herramienta.
Frameworks de código abierto
Los frameworks de código abierto pueden desplegarse para las etapas de 0 a 6. Los usuarios asumen las actualizaciones, la rotación de versiones, la factura de retención de Prometheus y las decisiones de criterio que un recomendador comercial tomaría por ellos.
Cada una de estas herramientas domina un campo distinto, por eso varias se ejecutan a la vez.
- Robusta KRR o VPA en
updateMode: "Off"produce la lista de pendientes del paso 1. No escribe nada. - Karpenter domina los nodos: aprovisionamiento, consolidación, selección de instancias, diversificación de spot, arquitectura. Asume los pasos 3, 4 y 6.
- KEDA domina el número de réplicas, incluido el escalado a cero, algo que HPA por sí solo no puede hacer.
- py-kube-downscaler o kube-green domina el horario no productivo. El ahorro más barato de la lista.
- OpenCost mide de principio a fin y no participa en nada.
Plataformas comerciales
Toda herramienta comercial adopta una de tres posturas en la capa de nodos. Esa es la decisión, e importa más que el precio o el número de funciones, porque el manifiesto de NodePool del paso 3 sobrevive o no.
- Déjalas en paz: StormForge, PerfectScale, Sedai y Kubex redimensionan las cargas de trabajo. Necesitan Karpenter o Cluster Autoscaler por debajo y no lo tocan nunca. La incorporación más segura a una configuración existente.
- Trabaja con ello: ScaleOps añade bin packing sobre Karpenter. nOps ajusta un Cluster Autoscaler o Karpenter existente en lugar de sustituir el suyo. Más cobertura, el provisionador sigue siendo tuyo.
- Reemplázalo: CAST IA y Spot Ocean instalan su propio provisionador y descartan el manifiesto. La cobertura más amplia, el menor control.
- Las herramientas de visibilidad se sitúan fuera: OpenCost, Kubecost, CloudZero, Vantage y Finout son de solo lectura, por lo que no entran en conflicto con nada y se combinan libremente. Ejecuta una independientemente de lo demás que se adopte.
Cómo combinar estas herramientas
La factura se basa en los nodos en ejecución, no en las solicitudes declaradas. El redimensionamiento reduce las solicitudes, lo que libera espacio en los nodos existentes pero no elimina ninguno de ellos, por lo que la factura no cambia hasta que una herramienta de nodos consolida ese espacio. Las herramientas de nodos por sí solas fallan por la razón contraria: empaquetan las solicitudes que se les dan, de modo que las solicitudes sobredimensionadas se empaquetan más apretadamente.
Dos formas de cubrir ambas capas:
- Dos herramientas: VPA, StormForge o PerfectScale para las solicitudes, más Karpenter para los nodos. Más barato y la capa de nodos permanece bajo control directo.
- Una plataforma: CAST IA, Zesty o Spot Ocean hacen ambas cosas en un único producto. Más caro y su provisionador reemplaza a Karpenter.
Cinco combinaciones de herramientas que rompen cosas:
- Dos redimensionadores mutantes en un despliegue: VPA en
Autojunto con StormForge, ScaleOps, PerfectScale o Zesty significa dos controladores escribiendo números diferentes en el mismo campo. Un controlador de admisión mutante por carga de trabajo. - Karpenter y Cluster Autoscaler en un grupo de nodos: Ambos aprovisionan contra los mismos pods no programables, por lo que el clúster acaba con aproximadamente el doble de nodos de los que necesita.
- VPA y HPA sobre la misma métrica: El uso sube, VPA aumenta la solicitud, la utilización medida baja porque es uso entre solicitud, HPA elimina réplicas, la carga por pod sube, y se repite. Es seguro cuando HPA escala sobre algo que VPA no toca, como la profundidad de la cola mediante KEDA.
- Dos herramientas de compromisos en una cuenta de pago: Ambas compran contra el mismo gasto no cubierto, fijando el exceso de compromiso durante uno a tres años.
- Dos plataformas completas: CAST IA, Zesty y Spot Ocean instalan cada uno su propio provisionador y cada uno espera ser su dueño.
Filtra todos los casos de estudio que recopilamos:
Lecturas adicionales sobre costes en la nube
Lee más para dominar la colocación de pods y reducir tu gasto en cómputo en la nube:
- Compara las mejores herramientas de orquestación de contenedores
- Compara 20+ orquestadores en la nube
- Mejores programadores de trabajos de nube híbrida
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{Optimización de costes de Kubernetes: 8 pasos y 23 herramientas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/kubernetes-cost-optimization}},
  note   = {AIMultiple. Recuperado el 15 de octubre de 2026}
}Resultados y marcas de tiempo de 249 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 6 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Enlaces de referencia
Siguiente para leer
Las 15 mejores herramientas de optimización para motores de respuesta

Optimización de motores de respuestas (AEO): consejos y mejores prácticas
Las 10 mejores nubes de GPU sin servidor y 14 GPU rentables


Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.