


Las mejores herramientas de web scraping con IA evaluadas

Evaluamos las principales herramientas de web scraping con IA con 25.000 solicitudes, 5.000 por herramienta, en 500 URLs en cada uno de 10 de los dominios más visitados para ver su rendimiento, y también comparamos cómo cada una aprovecha la IA.
Benchmark de web scraping con IA
Consulte la sección metodología del benchmark para obtener más detalles sobre el proceso de prueba.
Comparación de exhaustividad y precisión
Para cada dominio pedimos los campos que importan en ese tipo de página: precio y moneda en páginas de comercio electrónico; texto de la publicación, me gusta y autor en las redes sociales. Para medir el rendimiento de estas herramientas, usamos tres métricas: éxito, exhaustividad y precisión. Se necesitan tres porque una herramienta puede devolver algo sin devolverlo todo, y todo sin que nada sea correcto.
Éxito: la proporción de solicitudes que volvieron con al menos uno de los campos que pedimos.
Exhaustividad: la proporción de los campos que pedimos que realmente volvieron, promediada entre las solicitudes.
Precisión: la proporción de campos verificables que volvieron con un valor correcto, comprobada con una referencia o con lo que acordaron las demás herramientas. Un campo que nunca volvió cuenta como incorrecto.
Metodología estadística
Los intervalos de confianza se calcularon mediante remuestreo bootstrap por percentiles:
Remuestras: 10.000
Nivel de confianza: 95 %
Unidad de remuestreo: URL, con los cinco proveedores remuestreados en la misma extracción
Métricas: tasa de éxito, exhaustividad, precisión y tiempo de finalización
Tamaño de la muestra: N = 5.000 URLs por proveedor (500 en cada uno de 10 dominios)
Las puntuaciones de dominio se calculan primero y luego se promedian entre los diez dominios
Resultados del benchmark de web scraping con IA
En los 5.000 URLs de los 10 dominios, llamamos a cada herramienta de la forma en que está construida su propia API. Bright Data, Apify y Firecrawl aceptan una lista de URLs en una sola solicitud, por lo que enviamos 100 URLs por solicitud. Oxylabs y ScrapingBee aceptan una URL por solicitud, por lo que las enviamos de una en una. La concurrencia fue la misma para todas las herramientas, cinco solicitudes en paralelo, por lo que la única diferencia es lo que admite cada API.
- Bright Data obtuvo la puntuación más alta en las tres medidas de calidad: 85 % de éxito, 76 % de exhaustividad y 60 % de precisión.
- La mayor precisión del sector fue del 60 %. Dos de cada cinco campos verificables volvieron como faltantes o incorrectos.
- La exhaustividad varió desde Bright Data con su 76 % hasta Apify con su 32 %, con Oxylabs en el 59 %, Firecrawl en el 53 % y Scraping Bee en el 41 %.
- Firecrawl fue el más rápido, con menos de medio segundo por URL frente a Bright Data con sus 4,6 segundos, y 22 puntos menos en precisión. Oxylabs fue el más lento, con 35 segundos.
Cada proveedor adopta un enfoque diferente de la IA, y nuestro objetivo era comparar esos enfoques y las ventajas y desventajas que conllevan.
Conclusiones clave sobre las herramientas de web scraping con IA según el benchmark
- Los fallos pueden parecer datos. Cuando una herramienta no puede leer un precio, a menudo porque la página chocó con un muro antibot, puede devolver 0 en lugar de un fallo. Un valor null puede reintentarse u omitirse, pero un 0 pasa la validación sin que se note. Apify y Oxylabs devolvieron null en estos casos. La documentación de Firecrawl recomienda añadir «Devuelve null si no se encuentra en la página» a cada campo del esquema para que el modelo no adivine un valor.
- Campos adicionales: un prompt que pide precio y moneda también puede devolver marca, descripción o URLs de imágenes. Un esquema limita la respuesta a los campos que usted indica. Bright Data fija el esquema de salida en el momento de la compilación, por lo que cada llamada devuelve los mismos campos.
- Elemento incorrecto: en páginas que muestran un precio con descuento y otro original, precios con y sin impuestos u opciones de precio regionales, una herramienta puede extract el número equivocado.
- Números modificados: las herramientas de prompt a JSON pueden añadir decimales, recortar valores o devolver aproximaciones convertidas de moneda que no aparecen en la página.
- La ubicación cambia el precio: algunos sitios fijan los precios según la ubicación IP del visitante, por lo que una herramienta que usa proxies de EE. UU. ve un precio diferente al de un usuario europeo.
El esquema y la región del proxy son los parámetros que le permiten detectar la mayor parte de esto antes de que llegue a sus datos.
Precios de las herramientas de web scraping con IA
Kadoa no aparece en la tabla de precios porque no publica tarifas. Kadoa ofrece un plan Flex basado en el consumo y un plan Enterprise con precios a través de ventas.
Comparación de las herramientas de web scraping con IA
Tiempo hasta el primer scraper: Para las herramientas que crean un scraper que luego se llama por ID, cuánto tarda la configuración. «Una sola llamada HTTP» significa que no hay ningún paso de compilación.
Esquema de salida definido por el usuario: Si puede definir los campos de salida y sus tipos usted mismo antes de que se ejecute el scraping, en lugar de describirlos en un prompt y dejar que el LLM decida la estructura en tiempo de ejecución.
Endpoint de crear una vez y llamar muchas veces: Si el scraper se crea una vez, se almacena en el lado del proveedor y luego se llama solo con una URL. Aquí el LLM (o, en las herramientas basadas en grabación, su recorrido de clics) se ejecuta en el momento de la compilación y su salida se congela en un scraper que usted posee y puede modificar en su lugar, que es a lo que se vinculan las programaciones, los webhooks y las integraciones. Cuando esto falta, la extracción se resuelve de nuevo en cada llamada y la definición completa viaja con cada solicitud.
Scraper guardado con autorreparación: Si un scraper guardado se repara cuando el sitio objetivo cambia, sin reconstruirlo desde cero. La corrección se aplica al mismo scraper almacenado con su identificador existente, de modo que los disparadores, las programaciones y las integraciones siguen funcionando.
* Kadoa almacena el scraper y lo llama por ID, pero las URLs de destino se vinculan cuando se crea el flujo de trabajo. Apuntarlo a una nueva URL requiere una actualización de metadatos separada antes de la ejecución.
Las herramientas que ejecutan un LLM sobre la página en cada llamada no se cuentan aquí: no hay lógica de extracción persistente que reparar, lo que las hace tolerantes a los cambios de diseño, pero también significa que no hay ningún artefacto que inspeccionar, versionar o aprobar. Tampoco se cuentan las cachés internas sin un identificador al que se pueda apuntar, ya que de nuevo no hay nada que inspeccionar, versionar o aprobar.
Además de aspectos como el cambio constante de las páginas, en los pipelines agénticos a menudo necesita una API sencilla que pueda llamar: dar una URL y recibir datos estructurados. Pero no siempre puede encontrar una API de scraper lista para cada dominio que necesite raspar con regularidad; y cuando la encuentra, los campos que desea pueden no estar ahí, o necesita personalizar el esquema según sus propias necesidades. Existen diferentes enfoques que abordan estos problemas.
Plataformas de web scraping con IA de crear una vez y llamar muchas veces
Si crea su propio scraper, tiene que escribir el crawler, configurar los proxies, ejecutar navegadores headless y gestionar colas, reintentos y antibot por su cuenta.
Las herramientas de web scraping con IA reducen ese trabajo. Las plataformas de crear una vez y llamar muchas veces, como Bright Data Scraper Studio, Browse IA y Kadoa, crean un scraper una vez, a partir de un prompt o de una grabación de clics, y lo almacenan para que pueda llamarlo con una URL.
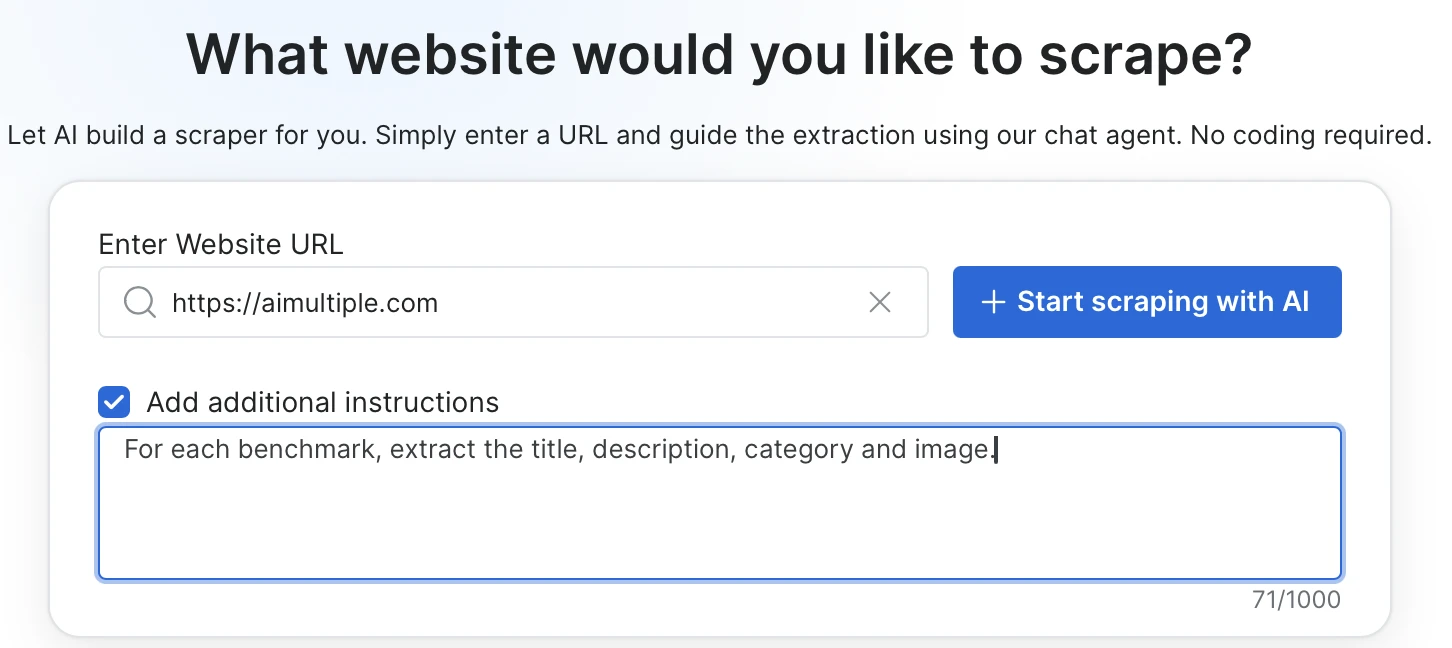
Bright Data Scraper Studio crea un scraper a partir de un prompt y luego lo sirve como una API estable. Después de la configuración única, cada llamada solo requiere una URL.
Usted describe los campos que desea extract en lenguaje natural y, opcionalmente, puede añadir selectores CSS, acciones requeridas en la página o comportamiento de carga de página.
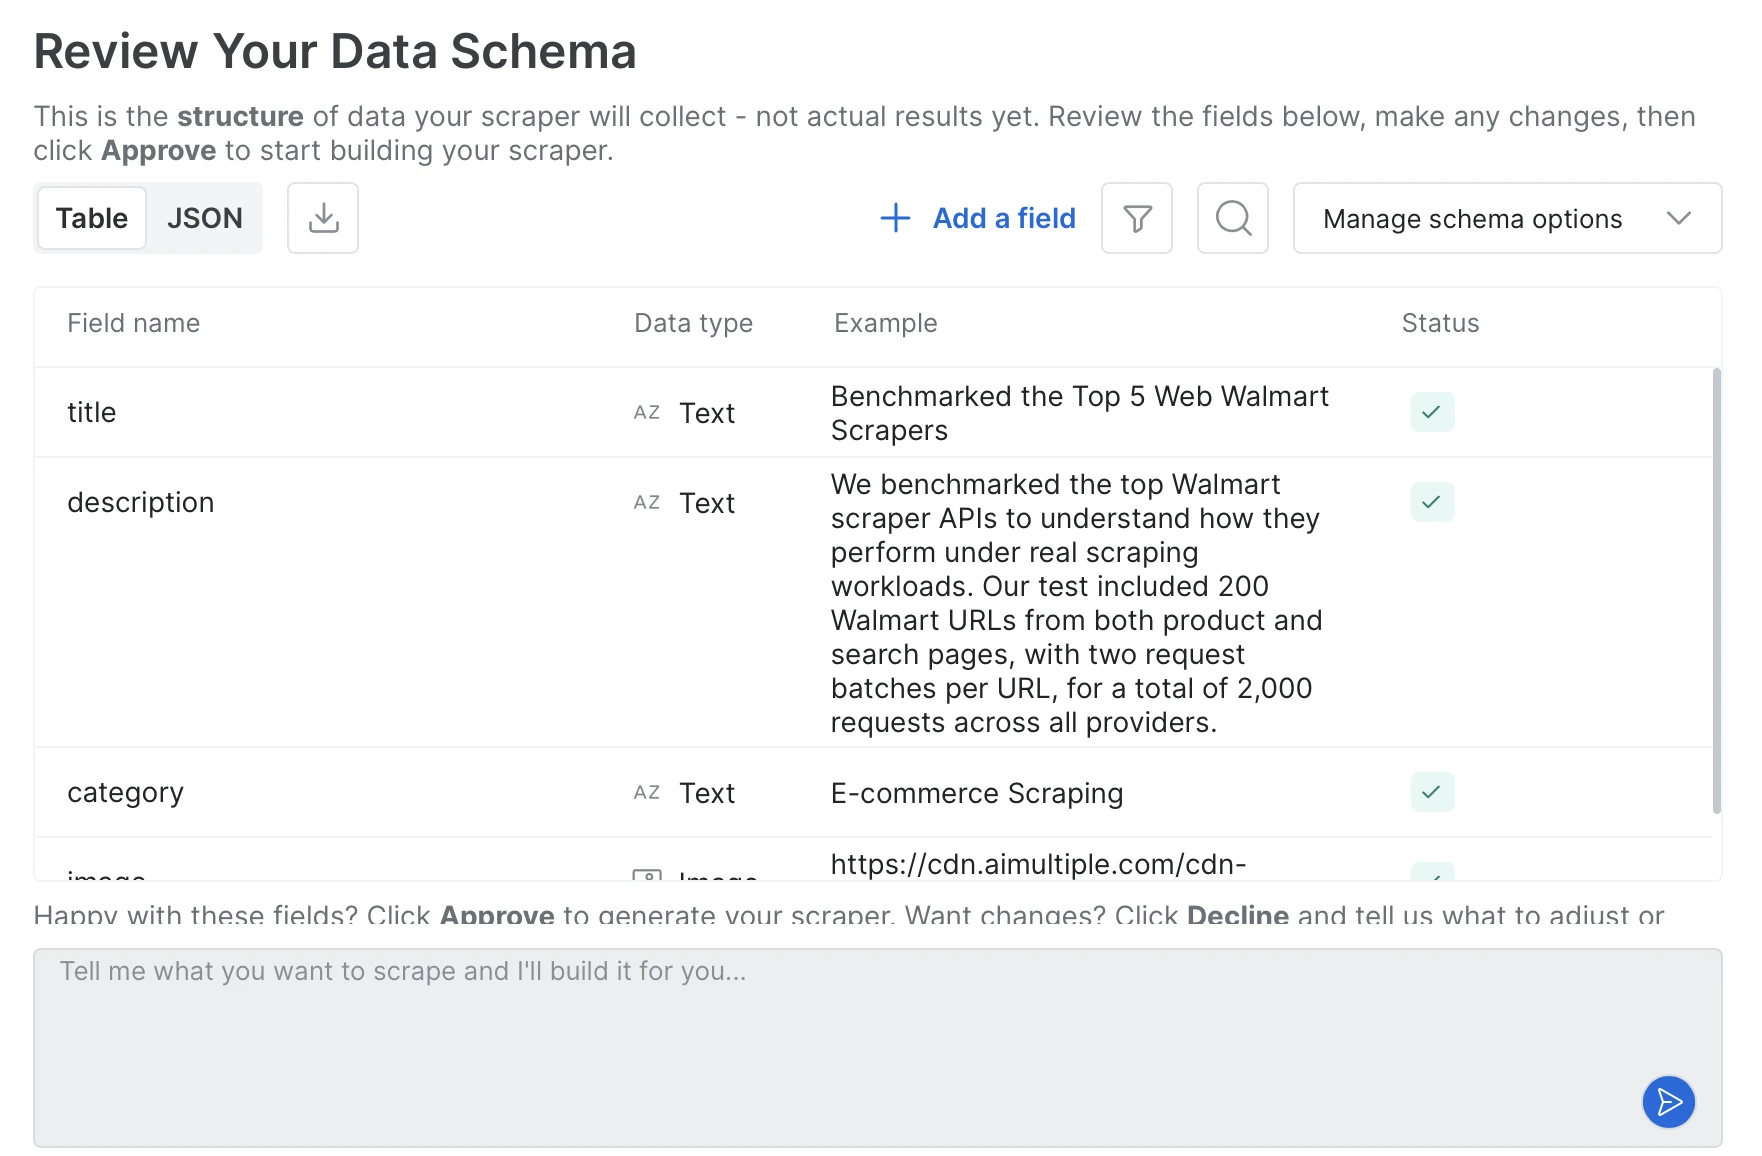
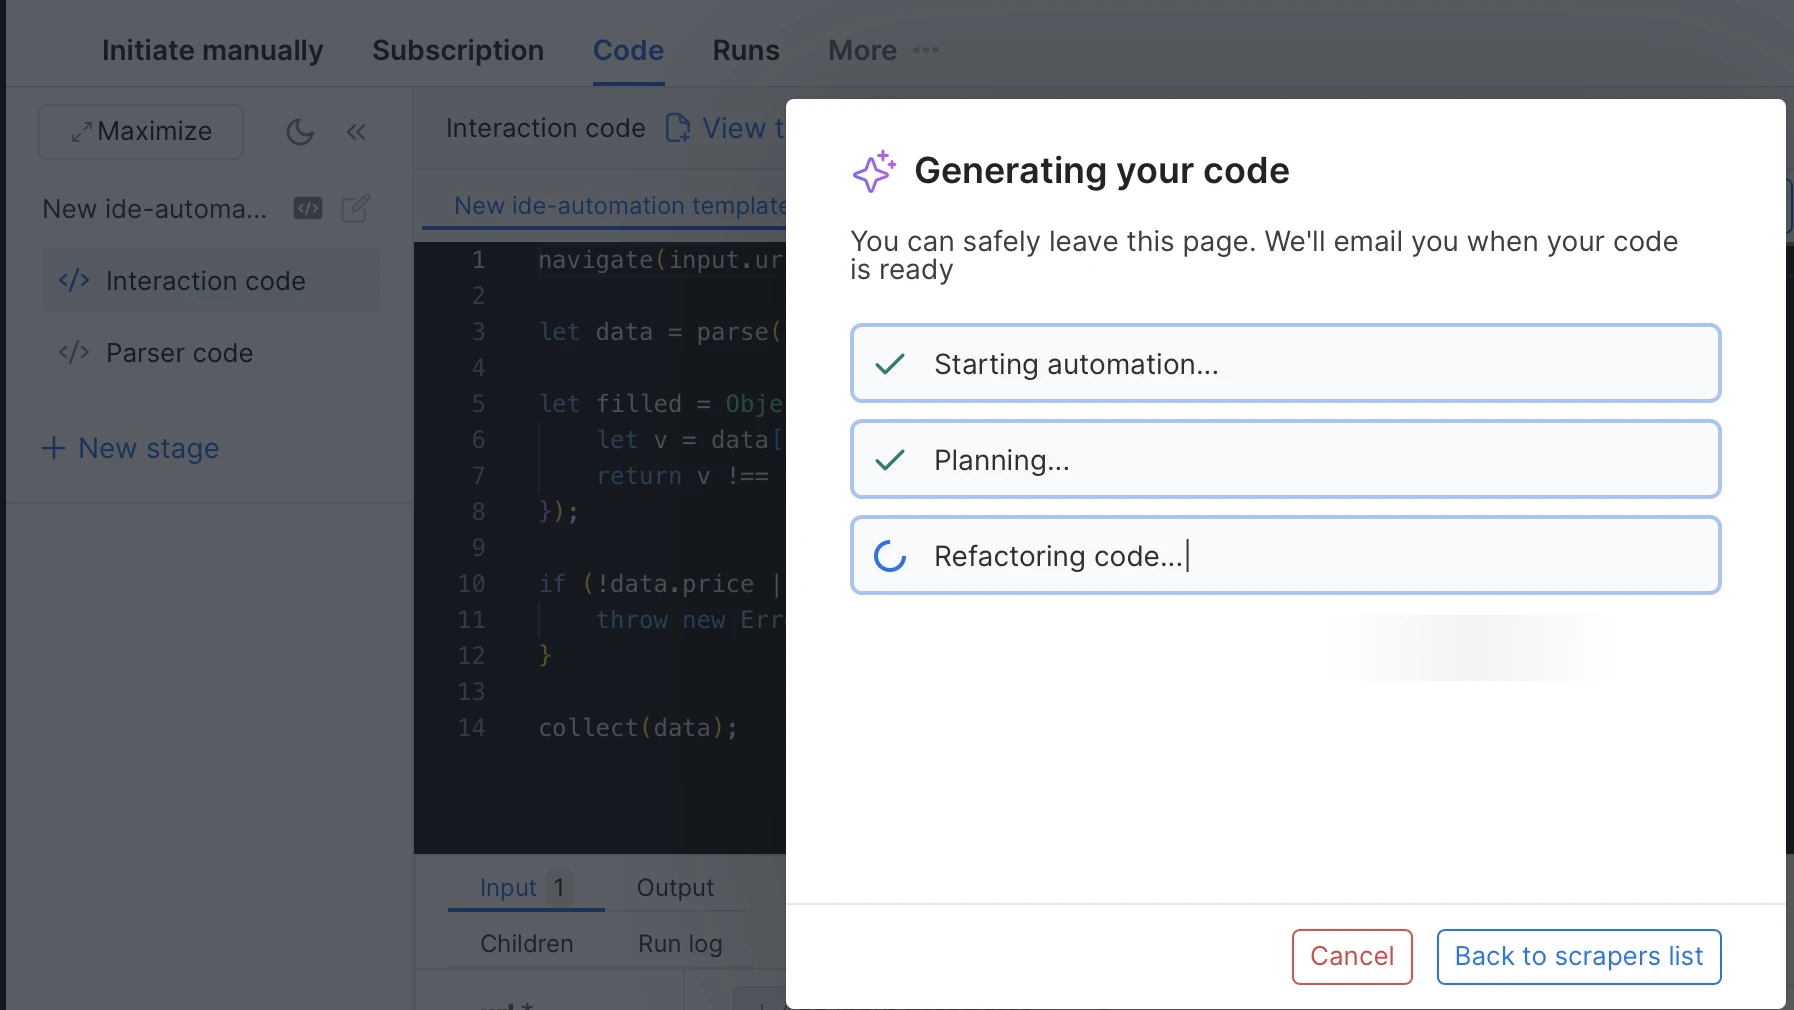
El agente de Scraper Studio genera el esquema de salida a partir del prompt. Usted revisa el esquema, añade o elimina campos o cambia tipos, y el agente escribe el código del scraper.
- Endpoint de crear una vez y llamar muchas veces: Una vez que apruebe el esquema, el scraper se registra como un endpoint de larga duración con un identificador fijo. Cada llamada llega al mismo endpoint solo con una URL, y el esquema de salida permanece igual entre llamadas. En nuestras pruebas, crear un scraper dedicado llevó alrededor de 10 minutos de media.
- Dos métodos de creación: Puede chatear con el agente en el navegador o usar la CLI de Bright Data para crear el scraper desde su terminal con un solo comando que toma una URL y un prompt. Ambos producen el mismo scraper.
- Flujo de trabajo con agentes de código: Los comandos de terminal se ejecutan sin cambios dentro de Claude Code, Cursor y Codex, de modo que el agente puede crear, ejecutar o autorreparar un scraper sin salir del editor. También puede fijar el identificador del scraper en el archivo de reglas del agente para que las sesiones futuras lo reutilicen.
- Entrega: API, SDK, CLI, webhooks o entrega directa al almacenamiento en la nube en S3, GCS, Azure u OSS.
- Combinado con scrapers prediseñados: Bright Data mantiene una biblioteca de scrapers listos para sitios populares como Amazon, LinkedIn y Zillow.
Autorreparación automatizada
Bright Data Scraper Studio puede reparar un scraper guardado por sí solo. Lo probamos en páginas de producto que alojamos, pidiendo título, precio, moneda, vendedor y disponibilidad. La primera ejecución devolvió registros con un 100 % de éxito.
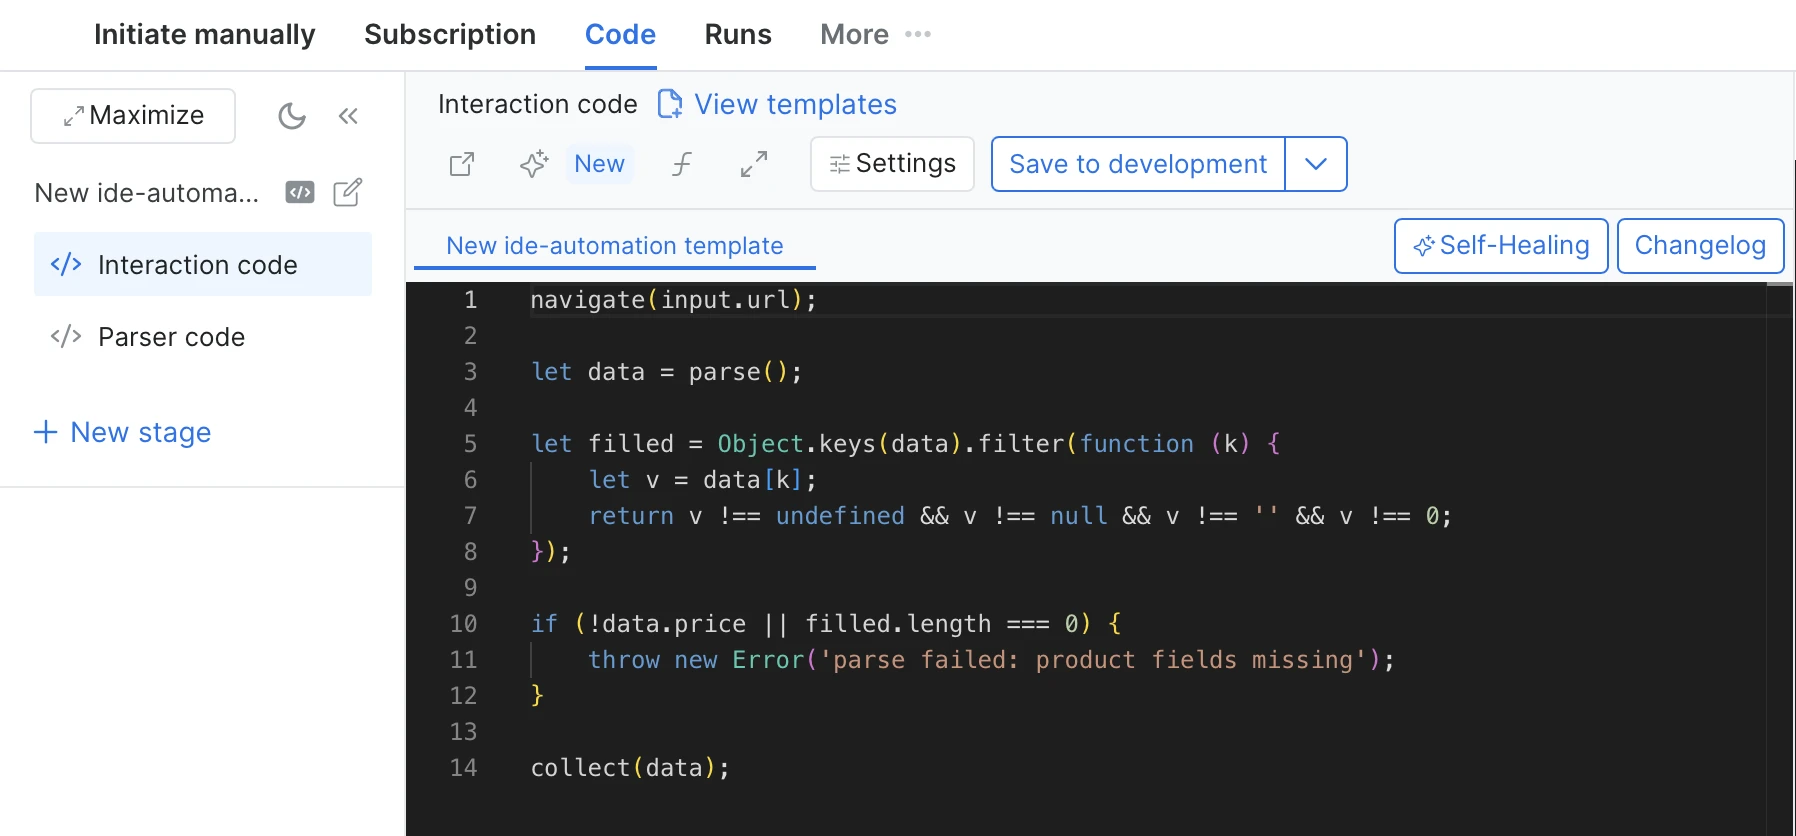
Añadimos una comprobación al código generado. Si falta el precio o no vuelve ningún campo, la ejecución lanza un error en lugar de recopilar un registro vacío.
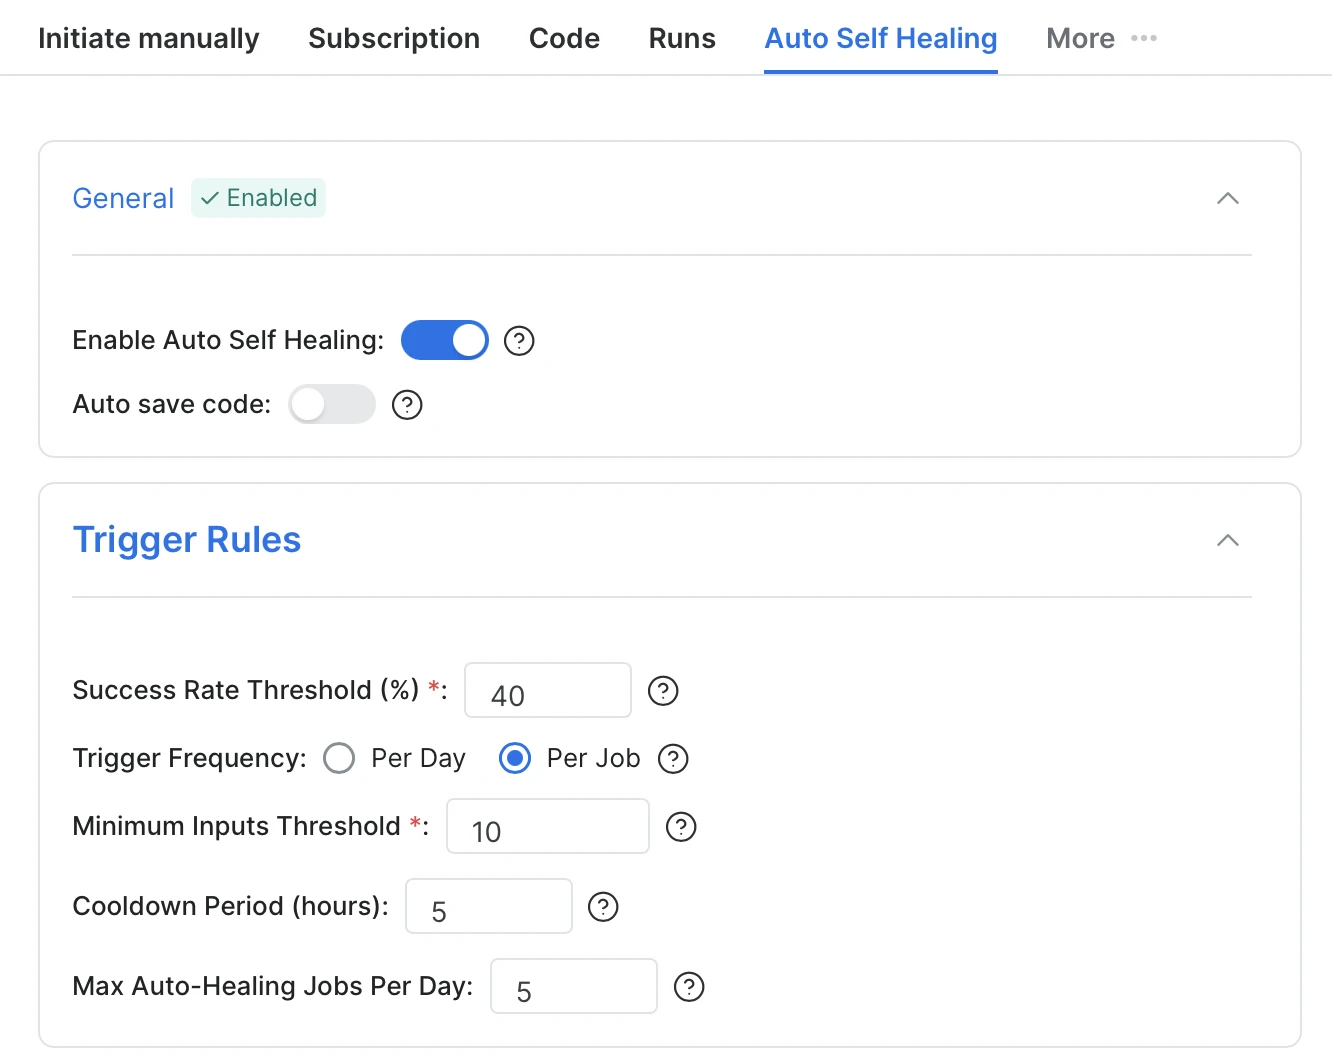
Activamos la autorreparación automática con las reglas de activación predeterminadas: la reparación comienza cuando la tasa de éxito cae por debajo del 40 %, comprobada después de cada trabajo, en ejecuciones con al menos 10 entradas. Dejamos desactivado el guardado automático de código, de modo que cualquier reescritura esperaría aprobación.
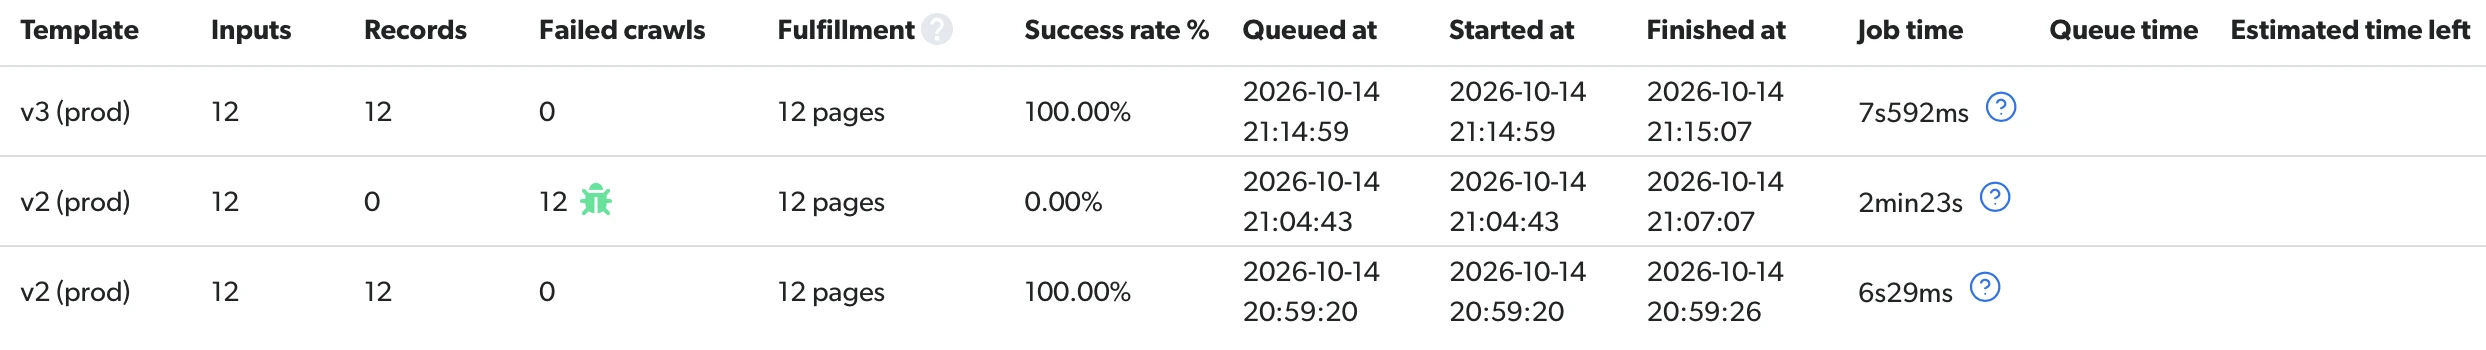
Luego rediseñamos las páginas detrás de las mismas URLs, cambiando etiquetas y nombres de clase, dejando todos los valores del HTML como texto plano. La siguiente ejecución informó de 12 rastreos fallidos y un 0 % de éxito, y la reparación comenzó sin que la pidiéramos.
La versión reparada devolvió todos los registros con un 100 % en las mismas URLs.
Las mismas URLs obtuvieron un 100 % en el diseño original, un 0 % después del rediseño y de nuevo un 100 % después de que la autorreparación automática reescribiera el colector.
Esto es importante para los scrapers que mantiene en un pipeline: cuando el sitio cambia su diseño, el scraper que creó se repara solo y reanuda, siempre que el fallo haga caer la tasa de éxito por debajo del umbral que haya configurado.
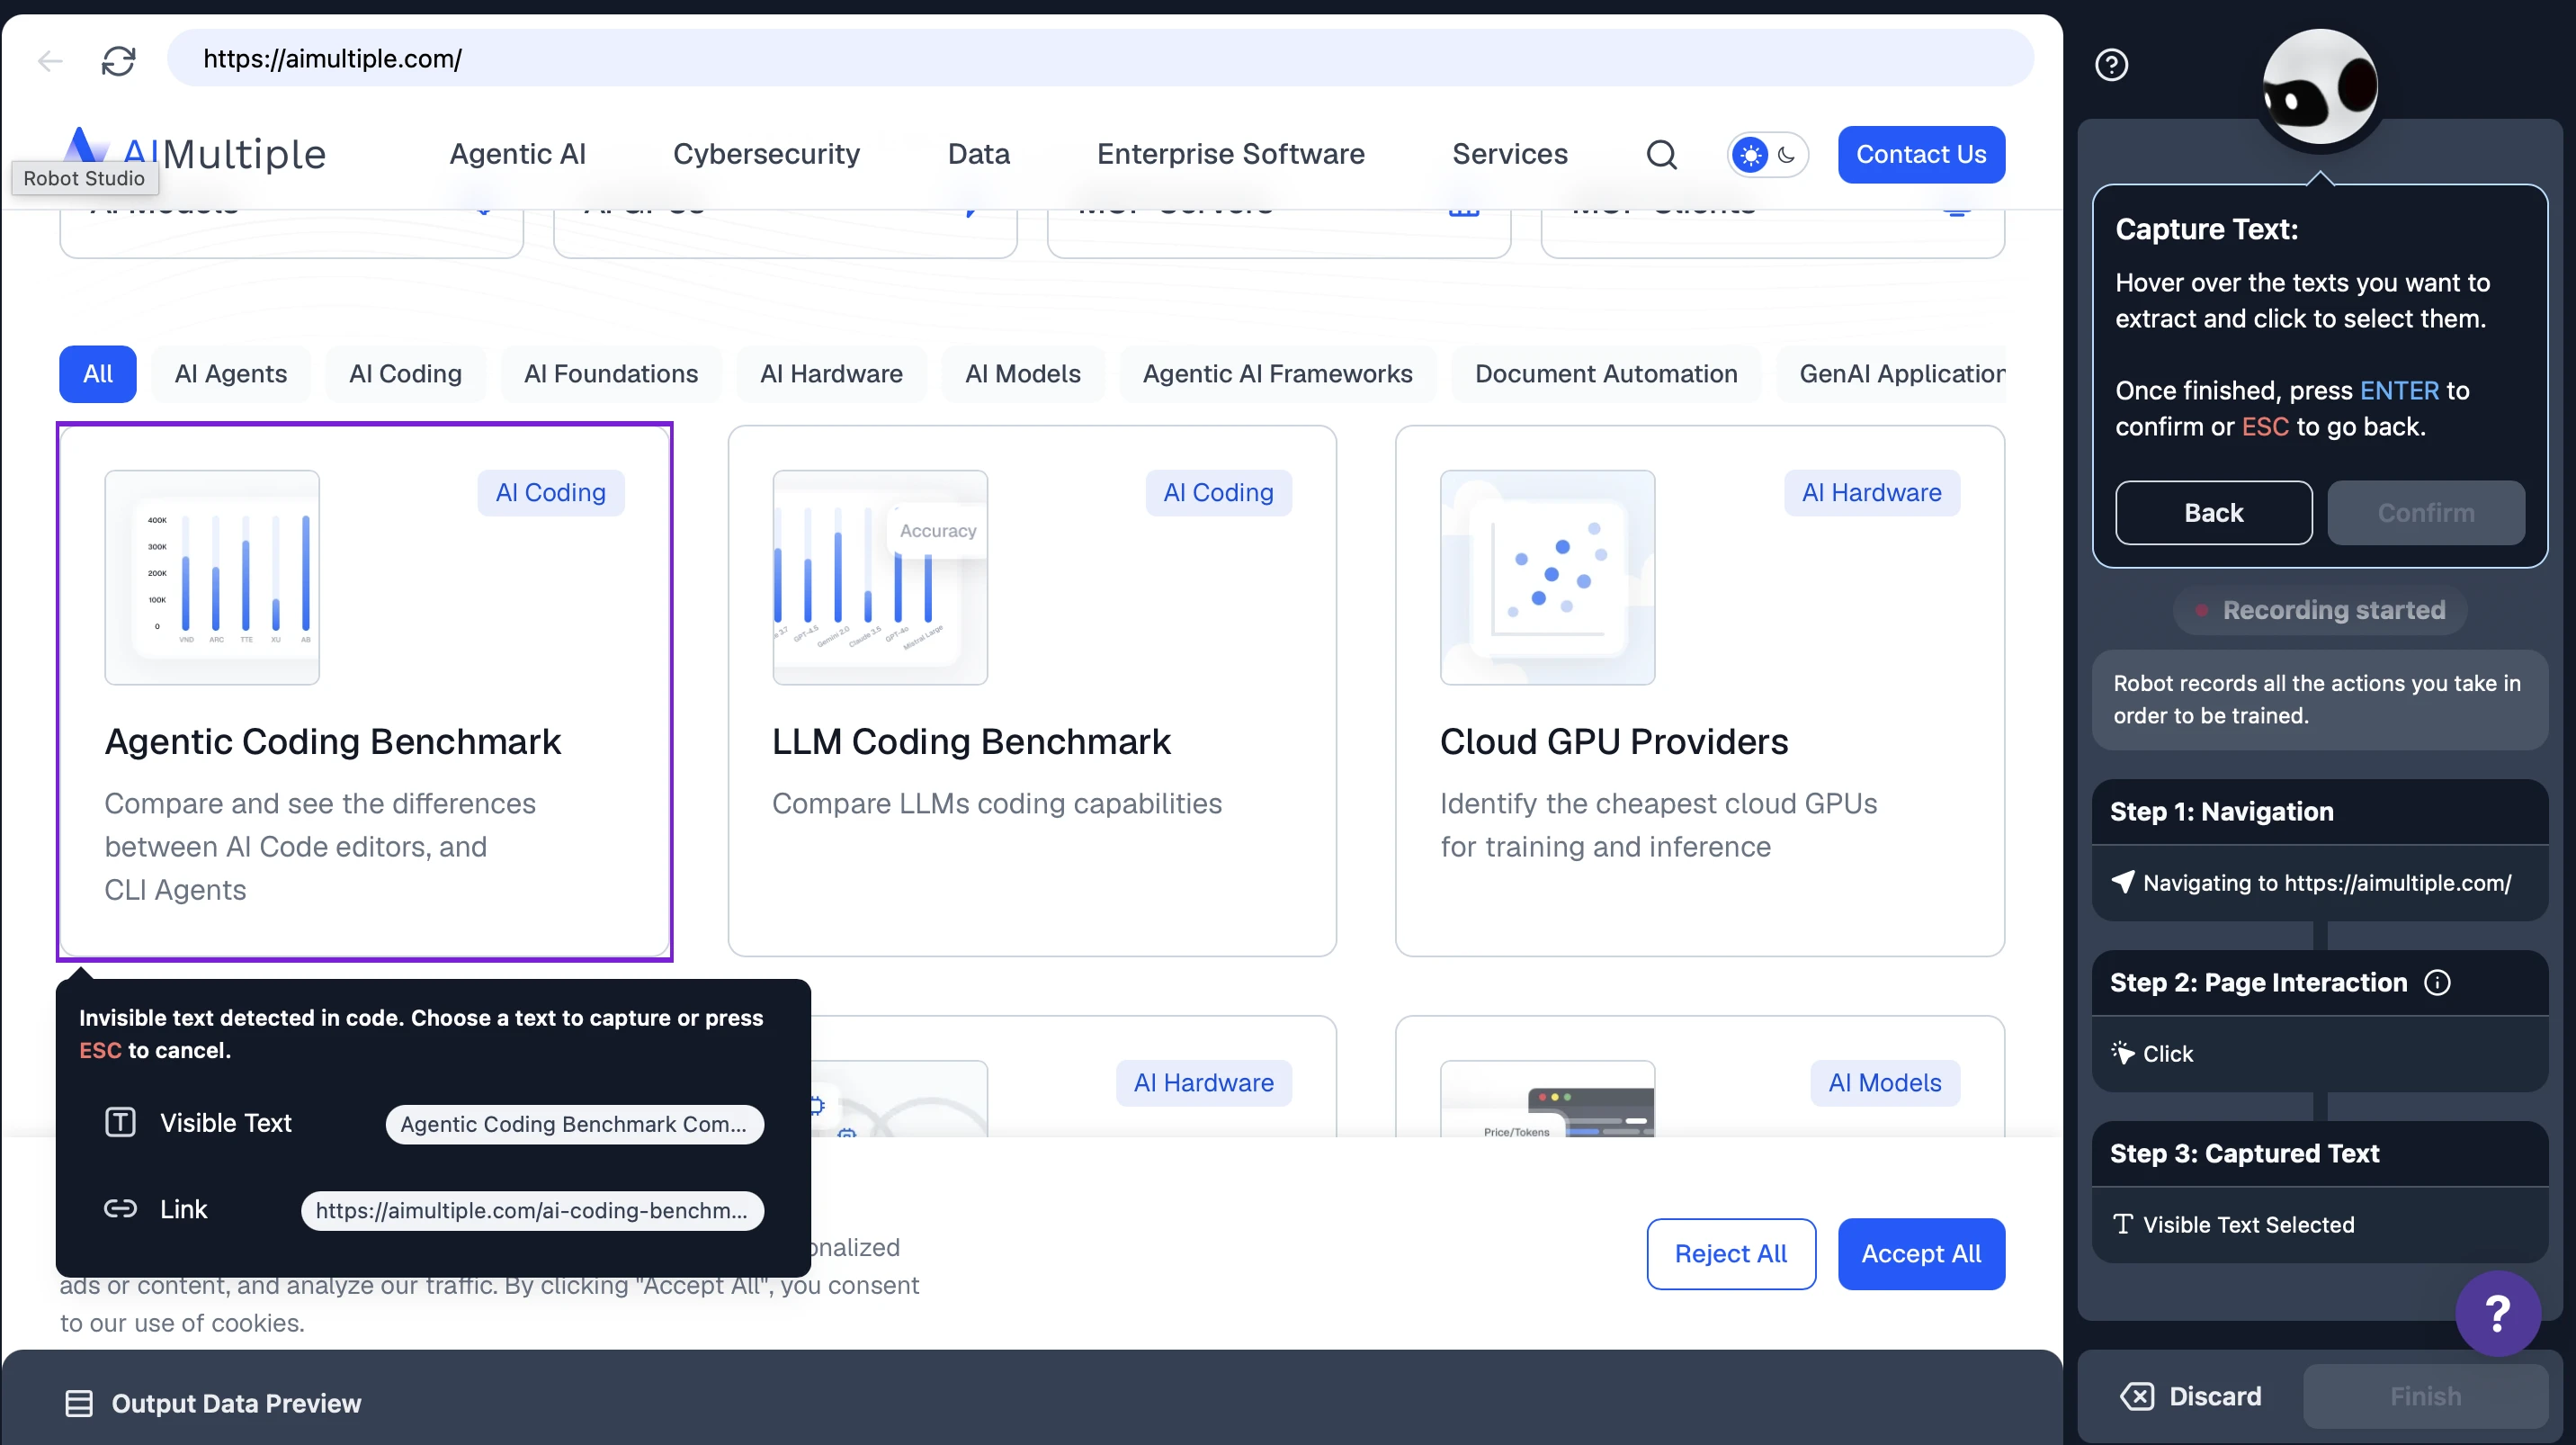
Browse IA crea scrapers, llamados robots, a partir de una grabación visual. Usted abre la página de destino y hace clic en los campos que desea capturar. El robot guarda los pasos de navegación y los campos seleccionados como una grabación y la reproduce en cada ejecución.
- Configuración visual con Robot Studio: Los scrapers se crean con un flujo de clic → capturar campo → guardar.
- Supervisión y alertas integradas: Programaciones por hora, diarias o semanales, detección de cambios y alertas por correo electrónico o webhook en el mismo producto.
- El esquema se forma a partir de los campos capturados: Se añade un paso de captura separado para cada campo; no hay generación de esquema a partir de prompt.
- Adaptación automática: el motor de Browse IA adapta el código de scraping cuando un sitio cambia, y la mayoría de los robots siguen funcionando sin intervención. Cuando la adaptación no es suficiente, se reentrena el robot, lo que conserva su historial, ejecuciones y flujos de trabajo.
Kadoa crea un scraper, llamado flujo de trabajo, a partir de un prompt y lo almacena como código generado, de modo que hay un artefacto concreto que supervisar y reparar.
- Endpoint de crear una vez y llamar muchas veces: Un flujo de trabajo guardado obtiene un ID persistente y se llama con
PUT /v4/workflows/{id}/run. La solicitud solo lleva variables y un límite de filas; el esquema y el código de extracción permanecen en el lado de Kadoa. Apuntar el mismo flujo de trabajo a una URL diferente significa actualizar primero sus metadatos, por lo que no es una sola llamada con una URL. - De prompt a esquema tipado: Describa los datos en el prompt de configuración y Kadoa propone un esquema que puede editar en una vista visual o JSON. Los campos llevan tipos como STRING, NUMBER, MONEY, DATE y LINK, y se pueden marcar como claves.
- Scraper guardado con autorreparación: La reparación se activa por una ejecución fallida y no por una programación. Kadoa regenera el código de extracción y lo valida con los datos extraídos previamente, bajo el mismo ID de flujo de trabajo, de modo que las programaciones e integraciones siguen funcionando. No hay un paso de aprobación antes de que la corrección entre en producción. Cuando la recuperación automática falla, se envía un ticket al equipo de operaciones de Kadoa.
- Flujo de trabajo con agentes de código: Un servidor MCP alojado con más de 40 herramientas, además de SDKs propios de Node y Python y una CLI (
kadoa create,kadoa run,kadoa export). - Entrega: API, SDK, CLI, MCP y Google Sheets para extracción; S3, GCS, Azure Blob, webhooks, WebSockets, correo electrónico y Slack para envío; Snowflake y Databricks para compartir. Los conectores de almacenamiento en la nube se configuran mediante soporte y no por autoservicio.
Extracción con IA de un solo paso mediante APIs
Las APIs de extracción con IA de un solo paso no guardan ningún scraper. Cada llamada envía una URL con un prompt o un esquema, y la herramienta obtiene la página y ejecuta la extracción con LLM en el momento de la solicitud. Oxylabs IA Studio, el Actor IA Web Scraper de Apify, Firecrawl y ScrapingBee funcionan de esta manera.
Oxylabs IA Studio es un conjunto de cinco aplicaciones de IA independientes bajo un único SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch y AiMap. No se persiste nada en el lado del servidor; cada llamada de scraping ejecuta una obtención nueva más una extracción LLM.
- Flujo de AiScraper: generate_schema(prompt=…) llama opcionalmente al LLM para producir un esquema JSON; luego, scrape(url, schema) obtiene la página y ejecuta la extracción con LLM. Puede conservar y reutilizar el esquema por su cuenta, pero el servidor no registra un scraper de larga duración.
- Cinco aplicaciones, un SDK: AiScraper para extracción estructurada de una sola URL, AiCrawler para recorrido de sitios guiado por prompt, BrowserAgent para acciones en la página, AiSearch para búsqueda en lenguaje natural más extracción, y AiMap para mapas filtrados de URLs de un sitio.
- Formatos de salida: markdown (predeterminado), json, csv, toon (un formato optimizado para tokens), captura de pantalla y html (solo agente de navegador).
- Esquemas escritos a mano:
generate_schemaes opcional. El parámetroschemaacepta cualquier esquema JSON que escriba, y los propios ejemplos de Oxylabs pasan un modelo Pydantic escrito a mano. Un esquema es obligatorio para la salida de JSON, CSV y TOON. - Parámetros destacados: render_javascript=”auto” deja que el servicio decida si se necesita el renderizado de JS, geo_location toma un código de país ISO o un nombre para la ubicación del proxy, y max_credits establece un límite de gasto por solicitud.
Apify ofrece un ecosistema abierto para desarrolladores en el que los «Actors», programas ejecutables de scraping y automatización, se crean y ejecutan en su plataforma. Puede escribir su propio Actor desde cero, partir de una plantilla lista para usar o emplear Actors que otros han publicado en la Apify Store.
- Actor de extracción con IA: Apify también tiene un Actor listo para usar, apify/ai-web-scraper, que toma un prompt en lenguaje natural y devuelve JSON estructurado de cualquier URL. Debe volver a introducir el prompt en cada ejecución, y no se garantiza que la salida JSON se mantenga coherente entre llamadas, lo que es un comportamiento habitual en las herramientas basadas en prompts.
- Solo prompt: La entrada del Actor tiene cinco campos:
startUrls,extractionMode,prompt,maxPagesToVisitymaxCrawlDepth. No hay ningún parámetro para un esquema de salida definido por el usuario. - Cree su propio Actor: Si no existe ningún scraper listo para su sitio de destino o ninguno extrae los campos de datos que desea, puede escribir su propio Actor y decidir qué campos extract, dónde se encuentran en la página y cómo gestionar el resto. El tiempo que lleva depende de sus conocimientos de programación y de la complejidad del sitio. Si prefiere no crearlo por su cuenta, también puede obtener ayuda de los servicios profesionales de Apify.
- Combinado con scrapers prediseñados: la Apify Store incluye Actors que publican los desarrolladores. La mayoría de los scrapers para sitios populares son publicados y mantenidos por desarrolladores externos.
- Servicios de la plataforma: Los Actors incluyen de serie programación, supervisión, almacenamiento de datasets, pool de proxies y acceso a la API.
- Acceso para agentes: El servidor MCP de Apify permite que un agente de código busque y ejecute Actors, pero no tiene un flujo integrado para crear o mantener un Actor desde dentro del agente.
- Responsabilidad del mantenimiento: Si usted creó el Actor, lo arregla cuando el sitio cambia. Si usa uno de la Store, espera a que su propietario publique la corrección según su propio calendario.
Firecrawl convierte una URL más un prompt o un esquema JSON en JSON en una sola llamada síncrona. Cada solicitud ejecuta el pipeline de extracción en el momento en que se realiza la llamada.
- Prompt o esquema: Un esquema fija los nombres y tipos de los campos antes de la llamada, de modo que la respuesta solo contiene los campos que usted indicó. Un prompt deja la estructura en manos del modelo, lo que es más rápido de escribir pero puede variar entre llamadas.
- Formatos por tipo de página:
product,menu,branding,audioyvideodevuelven una estructura fija definida por Firecrawl.productcubre título, precio, disponibilidad, variantes y precio de oferta. No aceptan parámetros y se ejecutan sin un LLM. deterministicJson: Acepta un esquema y almacena en caché un extractor generado por sitio, de modo que los raspados repetidos omiten el LLM. No se puede combinar con el formatojson.- Ejecución por solicitud: Cada llamada lleva su propio prompt o esquema y se ejecuta en el momento de la solicitud, de modo que la salida refleja la página tal y como está en ese instante y no hay nada que registrar de antemano.
- Soporte para agentes de código: Servidor MCP y CLI oficiales, con guías de inicio rápido para Claude Code, Cursor, Codex CLI y Gemini CLI, además de un plugin oficial de Claude.
- Agente: Firecrawl también ofrece un producto Agent en el que la URL es opcional. Usted describe lo que quiere y el agente navega por la web para encontrarlo.
ScrapingBee es una API de extracción de un solo paso como Firecrawl: cada llamada es independiente y no almacena nada. ScrapingBee se diferencia en cómo se describen los datos que desea.
- Tres modos de extracción: ai_query para un único campo en lenguaje natural (devuelve una cadena), ai_extract_rules para un esquema JSON en el que cada campo tiene su propia descripción, y una forma avanzada del mismo con tipos, enumeraciones y salida anidada.
- ai_selector: Pase un selector CSS para centrar el LLM en una parte específica de la página. Es más rápido y preciso que dejar que lea todo el DOM.
- Scraping clásico en la misma llamada: render_js para sitios con mucho JS, screenshot, extract_rules para extracción CSS/XPath sin IA, y json_response para obtener HTML, cookies, XHRs e iframes en un solo envoltorio.
Cómo elegir la herramienta adecuada para su pipeline
La herramienta adecuada depende de la frecuencia con la que su pipeline raspa los mismos sitios y de quién mantiene el scraper:
Scraping puntual u ocasional
Para el scraping puntual u ocasional, las APIs de extracción con IA de un solo paso, como Firecrawl, ScrapingBee y Oxylabs IA Studio, son la opción más rápida. Envíe un prompt o un esquema con cada llamada, y no hay que crear ningún scraper.
Scraping repetido en un pipeline
Para el scraping repetido, o cuando necesita campos de datos personalizados, una plataforma de crear una vez y llamar muchas veces, como Bright Data Scraper Studio, Browse IA o Kadoa, encaja mejor. El scraper almacenado devuelve el mismo esquema en cada llamada, y su pipeline solo introduce URLs.
Cuánto tarda la configuración
El tiempo de creación varía según el enfoque. Escribir un scraper o actor desde cero suele llevar de días a semanas, ya que el crawler, el cableado del proxy y los reintentos dependen de usted. Las plataformas basadas en prompts generan el esquema y el código en minutos. Las herramientas basadas en grabación también se configuran en minutos, con una instalación de apuntar y hacer clic en lugar de un prompt. Las APIs de extracción con IA de un solo paso omiten el paso de creación; la primera respuesta vuelve en una sola llamada HTTP.
Sitio ya cubierto por un scraper listo
Un scraper listo para un sitio popular suele ser más rápido que crear el propio, pero quién lo mantiene en funcionamiento depende de su origen. Una biblioteca mantenida por el proveedor, como la de Bright Data, la actualiza el proveedor cuando cambia el sitio. Un scraper de terceros, como la mayoría de los Actors de sitios populares de la Apify Store, se corrige según el calendario de su propietario.
Sitio no cubierto por nada listo
Para los sitios sin un scraper listo, la cuestión es quién arregla el scraper cuando cambia el diseño. Si crea el suyo, lo mantiene usted. Con una herramienta basada en grabación como Browse IA, el robot se adapta por sí solo a la mayoría de los cambios y usted lo reentrena cuando no puede. Con la autorreparación con IA, la herramienta repara su scraper almacenado bajo el mismo ID: Bright Data muestra la corrección para su aprobación antes de que entre en producción, mientras que Kadoa la aplica automáticamente.
Creación con agentes de código
Si su flujo de trabajo se ejecuta a través de Claude Code, Cursor o Codex, importa si la herramienta expone una CLI o una integración MCP que el agente pueda controlar de principio a fin, o si el agente solo puede llamar a una HTTP API simple.
 Añadir como fuente preferida
Metodología del benchmark de web scraping con IA
Dominios del benchmark:
Los diez dominios del benchmark de web scraping con IA proceden del ranking de los sitios más visitados de Semrush. Cinco son de comercio electrónico (amazon, ebay, etsy, aliexpress, walmart) y cinco son sociales (facebook, instagram, reddit, tiktok, x). Recopilamos 500 URLs de cada uno, 5.000 en total, y enviamos cada una a las cinco herramientas, lo que supone 25.000 solicitudes.
Prompts:
Cada herramienta recibió exactamente el mismo prompt para un tipo de página determinado, sin ajustes específicos por herramienta:
- Comercio electrónico: Extract precio y la moneda del producto y devuelve json
- Social: Extract el texto de la publicación, el número de me gusta y el nombre de usuario del autor de la publicación y devuelve json
Bright Data recibe el prompt un paso antes que los demás. En lugar de raspar a partir de un prompt en cada llamada, se le da el prompt una vez y crea un scraper, devolviendo un ID de colector al que luego se llama repetidamente. Ese paso de creación no es scraping, sino la herramienta generando una API, y ocurre una vez por dominio antes de que comience cualquier benchmarking, por lo que no se incluye en los tiempos. Medimos desde el ID de colector en adelante, donde el proceso coincide con los otros cuatro. Para mantenerlo de cero disparos, el esquema generado por Bright Data se aceptó automáticamente tal y como volvió de la API, sin revisión ni corrección.
Cada herramienta se llamó de la forma en que está construida su propia API. Bright Data, Apify y Firecrawl están diseñadas para recibir una lista de URLs en una sola solicitud, por lo que enviamos 100 URLs por solicitud. Oxylabs y ScrapingBee no están construidas de esa manera; sus APIs reciben una URL cada vez, por lo que así las llamamos. La concurrencia fue la misma para todas las herramientas, cinco solicitudes en paralelo.
Métricas:
El éxito es la proporción de solicitudes que volvieron con al menos uno de los campos solicitados. Las cadenas vacías, los ceros en lugar de un número y las respuestas que repiten el prompt no cuentan como un campo.
La exhaustividad es cuántos de los campos solicitados volvieron, promediados entre las solicitudes. Una página social en la que solo llega el autor obtiene una puntuación de uno sobre tres.
La precisión es la proporción de valores verificables que fueron correctos. Un campo que la herramienta nunca devolvió cuenta como incorrecto, porque aguas abajo un valor faltante y un valor incorrecto cuestan lo mismo.
Cada medida se calcula por dominio y luego se promedia entre los diez.
Cómo establecer la respuesta correcta
Utilizamos dos métodos. Cuando se disponía de una verdad de referencia, puntuamos contra ella: algunas respuestas se encuentran en la propia URL, como el identificador del autor en un enlace de x.com o tiktok.com, y para otras recopilamos una referencia independiente ajena a las cinco herramientas, como los precios de los productos y los recuentos de votos de Reddit.
Cuando no existía una verdad de referencia, puntuamos por consenso. Un campo solo se resuelve de esta manera cuando al menos cuatro de las cinco herramientas lo respondieron. A continuación, apartamos la herramienta que se está puntuando y observamos el resto: si el mismo valor aparece en más de la mitad de ellas, y en al menos dos, ese valor se convierte en la referencia. Una herramienta nunca vota sobre su propia respuesta, y un campo en el que las demás no pudieron ponerse de acuerdo queda fuera de la puntuación de precisión.
Los números no tienen que coincidir exactamente. Un valor se considera correcto dentro del 10 % de la referencia, con un pequeño margen absoluto adicional, de modo que una publicación con 5 me gusta no falle por una diferencia de uno, mientras que una publicación con 90.000 se sigue juzgando por el porcentaje.
Intervalos de confianza
Todas las cifras llevan intervalos de confianza del 95 % a partir de 10.000 remuestras bootstrap a nivel de URL. Los datos por solicitud que respaldan cada número se publican junto con los resultados.
Preguntas frecuentes
Sí. Las bibliotecas de código abierto como Crawl4AI, Skyvern y Browser Use son gratis para autoalojar, y la mayoría de las herramientas comerciales, incluidas Browse IA, Firecrawl y Thunderbit, ofrecen un plan gratis con límites de uso.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Las mejores herramientas de web scraping con IA evaluadas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Recuperado el 14 de octubre de 2026}
}Resultados y marcas de tiempo de 25.1 mil puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 7 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
5 actualizacionesAñadido un apartado de benchmark que compara herramientas de scraping web con IA en los principales sitios de comercio electrónico.
Reemplazó la lista de herramientas con entradas nombradas para Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern y otras, y añadió una sección de preguntas frecuentes.
Se reemplazó la introducción a las herramientas de web scraping de IA con una descripción de los agentes de IA autónomos, el scraping basado en visión (VLM) y los scrapers autorreparables.
Siguiente para leer
Las 5 mejores extensiones gratuitas de Chrome para web scraping

Navegadores web con IA: Guía de selección

¿Es legal el web scraping? Leyes y buenas prácticas






Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.