


Comparer 9 grands modèles de langage dans le domaine de la santé

Nous avons évalué 9 LLMs à l'aide du dataset MedQA, un benchmark d'examen clinique de niveau universitaire dérivé des questions de l'USMLE. Chaque modèle a répondu aux mêmes scénarios cliniques à choix multiples à l'aide d'un prompt standardisé, permettant une comparaison directe de la précision.
Nous avons également enregistré la latence par question en divisant le temps d'exécution total par le nombre d'éléments MedQA traités.
Résultats du benchmark des LLMs de santé
Méthodologie du benchmark : Ce benchmark évalue les performances de fine-tuning supervisé des LLMs de santé par rapport aux grands modèles généralistes (GPT-4) sur des réponses à des questions médicalestâches. Voir les sources de données du benchmark.
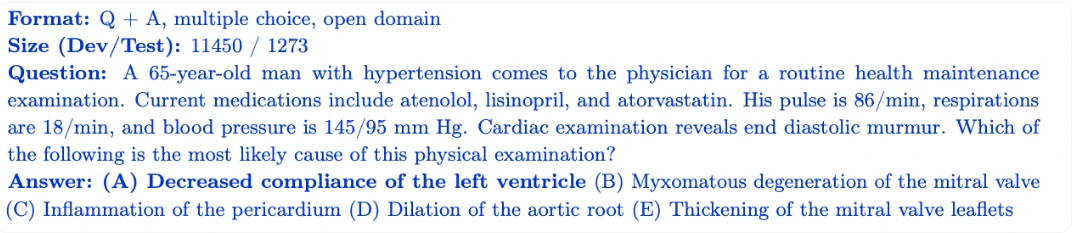
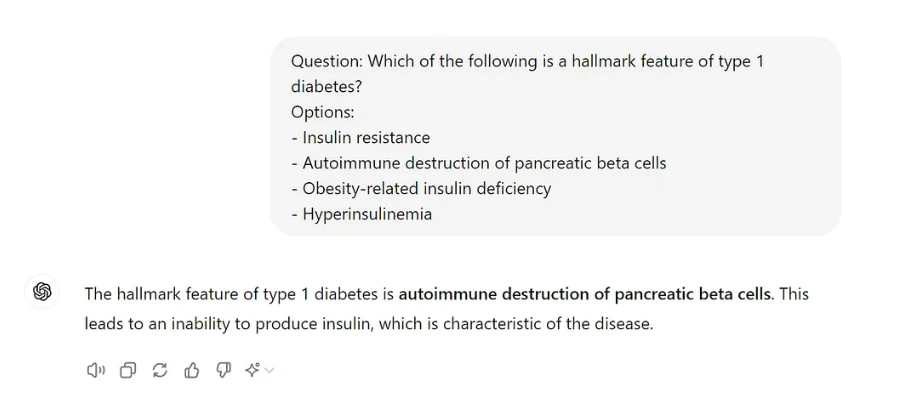
MedQA : Questions d'examen médical à choix multiples basées sur le United States Medical Licensing Examination.
Figure 1 : Exemple de question clinique à choix multiples de type USMLE.
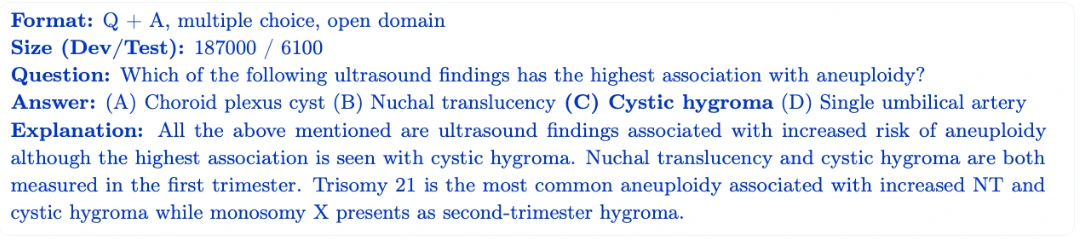
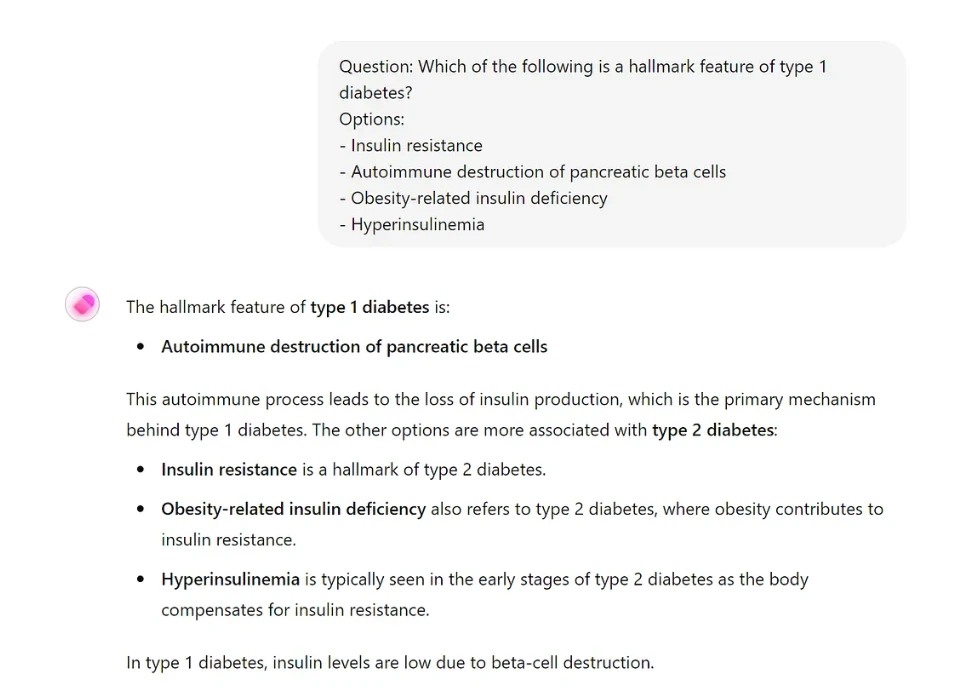
MedMCQA : dataset de réponse à des questions à choix multiples (MCQA) à grande échelle conçu pour traiter des questions d'examens d'entrée en médecine du monde réel.
Figure 2 : Question à choix multiples d'examen d'entrée en médecine à grande échelle demandant au modèle de sélectionner la bonne réponse et d'interpréter les explications associées sur les résultats cliniques.
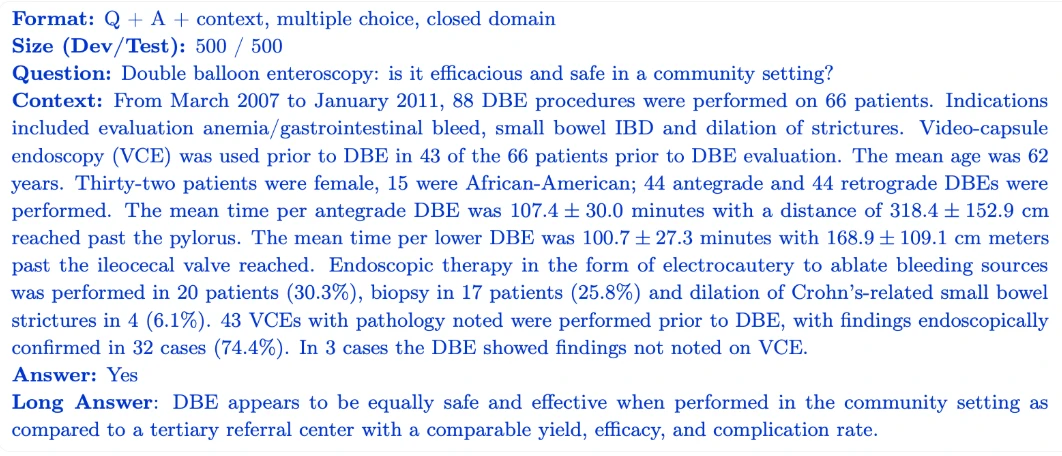
PubMedQA : benchmark biomédical de réponse à des questions utilisant des réponses oui/non/peut-être.
Figure 3 : Question biomédicale à réponse oui/non/peut-être, où le modèle doit juger de la justesse d'une affirmation clinique en utilisant le contexte d'étude fourni.
Exemples de LLM dans le domaine de la santé
Type BERT (encodeur uniquement)
Optimisés pour encoder et représenter le texte biomédical, ces modèles excellent dans l'extraction de caractéristiques pour des tâches telles que la classification.
De type ChatGPT / LLaMA (décodeur, ajusté pour instructions/chat)
Basés sur des architectures de type LLaMA et optimisés pour des tâches interactives et des dialogues cliniques.
De type GPT / PaLM (décodeur uniquement, génératif)
Construits de manière similaire à GPT-3 ou PaLM, ces modèles sont fine-tunés pour la génération de texte généraliste et la synthèse.
LLMs à usage général dans le domaine de la santé
*Llama 3.1 Instruct Turbo avec 405B paramètres. Voir la méthodologie du benchmark.
Points clés :
- o1 : meilleur modèle
- 03 mini : meilleure option économique
- GPT 4.1 : meilleure vitesse et temps de réponse
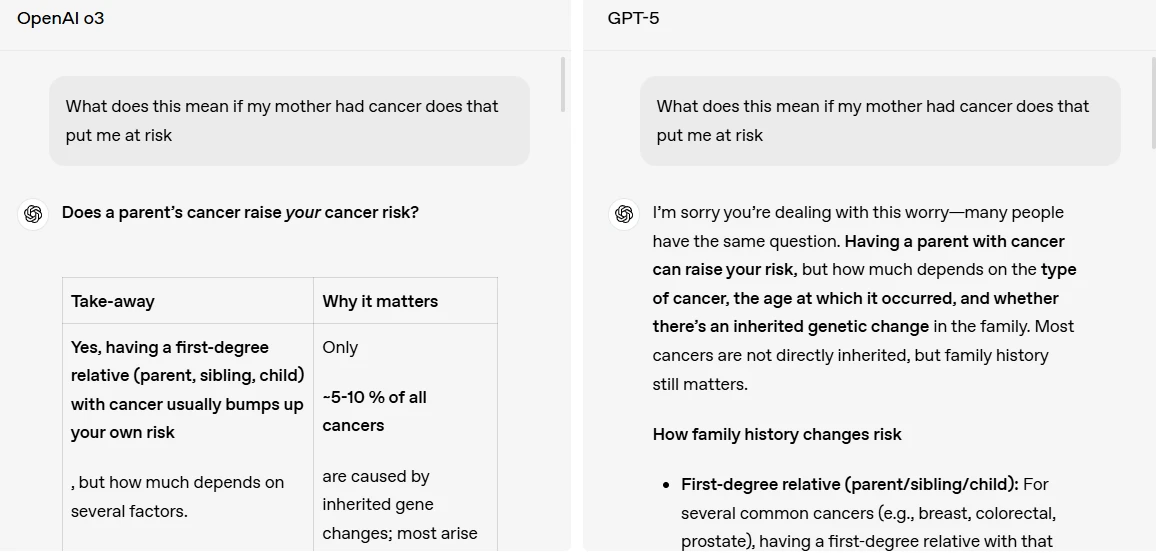
- Au-delà de la précision et du coût d'entrée, les modèles diffèrent également dans leurs approches sous-jacentes de la réponse à des questions médicales
Figure 4 : Figure montrant les différences entre les réponses de GPT-5 et d'o3.
Fine-tuning des LLMs médicaux
Les performances du ChatGPT par défaut (modèle 4o) sont comparées à celles de l'assistant existant « Clinical Medicine Handbook ». Les deux modèles reçoivent le même prompt et leurs réponses sont analysées :
GPT 4o
Figure 5 : La figure montre que la réponse du modèle GPT 4o par défaut est exacte, mais aussi très résumée.1
Fine-tuned médical LLM
Figure 6 : La figure montre la réponse de l'agent spécialisé.1
Applications des LLMs généralistes
Vous pouvez utiliser ces modèles dans le domaine de la santé en tirant parti de :
- Pré-entraînement continu sur des données médicales pour aider le modèle à mieux identifier le langage médical en l'exposant à des notes cliniques et à la littérature biomédicale (comme PubMed).
- RAG pour extraire des données de documents cliniques vérifiés afin de produire des réponses précises au moment de l'exécution.
- Fine-tuning d'instructions pour permettre au modèle d'apprendre à répondre à des questions cliniques ou extraire des symptômes du texte.
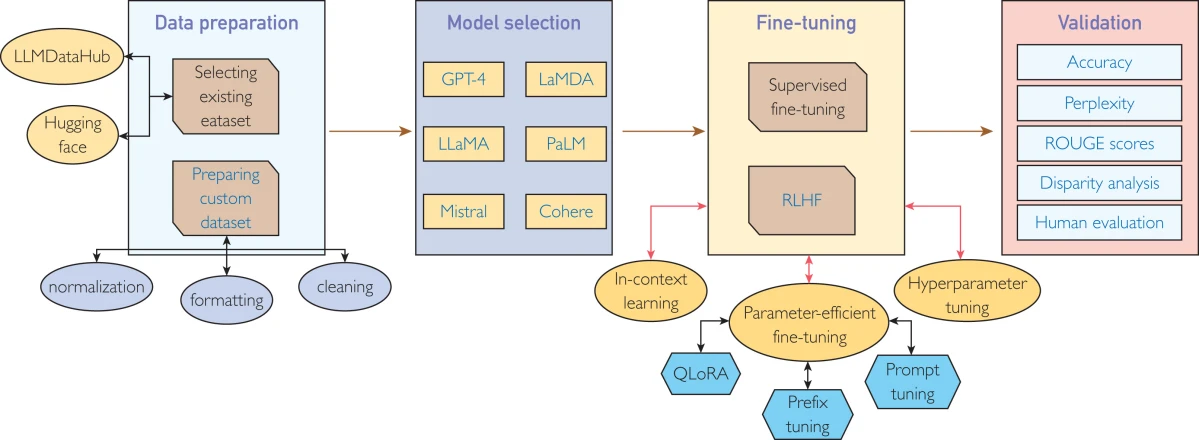
Figure 7 : Un flux de travail général de fine-tuning de LLM pour des cas d'utilisation spécialisés.
Où les organisations de santé utilisent les LLMs
Les organisations de santé testent les LLMs dans les flux de travail cliniques et administratifs. Les applications courantes incluent la documentation clinique et la transcription, la synthèse des dossiers de santé électroniques (DSE), la recherche documentaire, la rédaction de messages aux patients, le codage médical, l'autorisation préalable, la formation des cliniciens et les explications destinées aux patients.
Le modèle approprié dépend moins du libellé du cas d'utilisation que des exigences de la charge de travail. Les applications destinées aux patients et d'aide à la décision clinique nécessitent généralement une précision médicale plus forte, une évaluation de la sécurité, une auditabilité et des contrôles de protection des données, tandis que les charges de travail administratives peuvent accorder davantage d'importance au coût, à la latence, à la longueur du contexte et à l'intégration avec les systèmes existants.
 Ajouter comme source préférée
Méthodologie des grands modèles de langage dans le domaine de la santé
Méthodologie du benchmark : Ce benchmark évalue 9 LLMs généralistes populaires sur des questions médicales de niveau universitaire à l'aide du dataset MedQA, dont le contenu provient de l'United States Medical Licensing Examination (USMLE). Chaque question comprend un scénario clinique et des options de réponse à choix multiples.
Sorties des LLM : Chaque modèle a été invité à renvoyer une réponse structurée (par ex., « Answer : C »).8
Latence : Le temps moyen qu'un modèle met pour générer une réponse à un seul prompt MedQA. Par exemple, si 100 questions prennent 1 115 secondes au total, la latence moyenne est de 11,15 secondes par question.
Sources de données du benchmark des LLMs dans le domaine de la santé
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Comparer 9 grands modèles de langage dans le domaine de la santé}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-language-models-in-healthcare}},
  note   = {AIMultiple. Consulté le 4 septembre 2026}
}Résultats et horodatages de 25 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 4 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Journal des modifications
15 mises à jourAjout de trois cas d'usage : découverte et développement de médicaments, radiologie et imagerie médicale, et littératie en santé.
La section « Aide à la décision clinique » a été étendue avec MedGemma et une nouvelle figure.
Liens de référence
Le travail de Cem chez AIMultiple a été cité par des publications mondiales de premier plan, notamment Business Insider, Forbes, Morning Brew et Washington Post, par des entreprises mondiales comme Deloitte et HPE, par des ONG comme World Economic Forum et par des organisations supranationales comme European Commission. [1], [2], [3], [4], [5]
Tout au long de sa carrière, Cem a été consultant en technologies, acheteur de technologies et entrepreneur technologique. Il a conseillé des entreprises sur leurs décisions technologiques chez McKinsey & Company et Altman Solon pendant plus de dix ans. Il a également publié un rapport McKinsey sur la digitalisation.
Il a dirigé la stratégie technologique et les achats d'un opérateur télécom, sous la responsabilité du PDG. Il a également dirigé la croissance commerciale de l'entreprise de technologie profonde Hypatos, qui a atteint un revenu récurrent annuel à 7 chiffres et une valorisation à 9 chiffres, passant de 0 à ce résultat en deux ans. Le travail de Cem chez Hypatos a été couvert par des publications technologiques de premier plan comme TechCrunch et Business Insider.
Cem intervient régulièrement lors de conférences technologiques internationales. Il est diplômé de Bogazici University en tant qu'ingénieur informatique et titulaire d'un MBA de la Columbia Business School.

Elle a précédemment travaillé comme recruteuse dans des cabinets de gestion de projet et de conseil. Sıla est titulaire d’un master en psychologie sociale et d’une licence en relations internationales.



Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.