


Comparação de 9 Large Language Models em Saúde
Avaliamos 9 LLMs usando o dataset MedQA, um benchmark de exame clínico em nível de pós-graduação derivado de perguntas do USMLE. Cada model respondeu os mesmos cenários clínicos de múltipla escolha usando um prompt padronizado, permitindo comparação direta de acurácia.
Também registramos a latência por pergunta dividindo o tempo total de execução pelo número de itens MedQA concluídos.
Resultados de benchmark de LLMs em saúde
Metodologia do benchmark: Este benchmark avalia o desempenho de fine-tuning supervisionado de saúde LLMs vs. grandes models de propósito geral (GPT-4) em perguntas e respostas médicastarefas. Veja fontes de dados do benchmark.
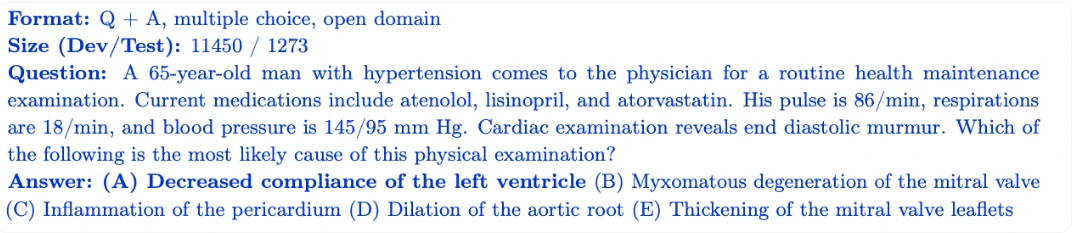
MedQA: Perguntas de múltipla escolha de exame médico baseadas no United States Medical Licensing Examination.
Figura 1: Exemplo de pergunta clínica de múltipla escolha no estilo USMLE.
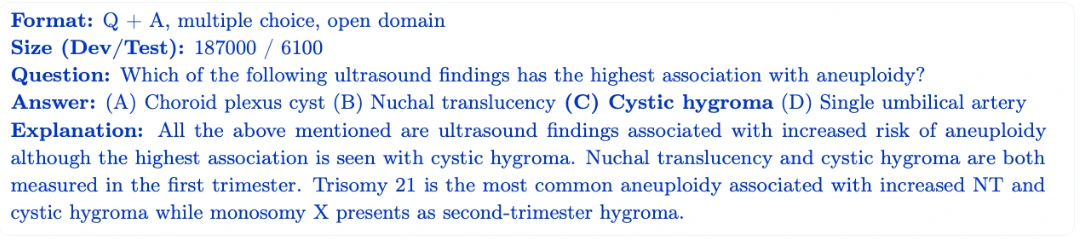
MedMCQA: Dataset de Multiple-Choice Question Answering (MCQA) em larga escala, projetado para abordar questões reais de exames de admissão médica.
Figura 2: Uma pergunta de múltipla escolha de exame de admissão médica em larga escala que exige que o model selecione a resposta correta e interprete as explicações associadas sobre achados clínicos.
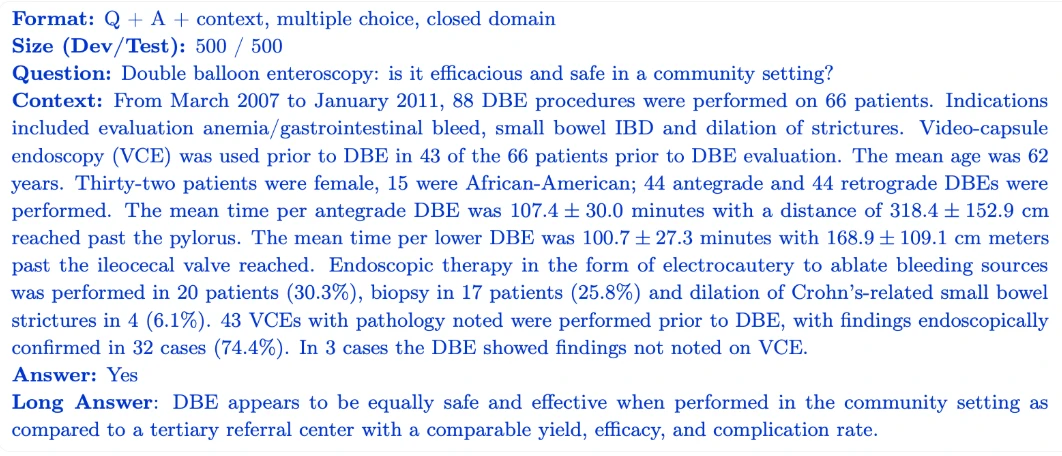
PubMedQA: Benchmark biomédico de question answering usando respostas sim/não/talvez.
Figura 3: Uma pergunta biomédica de sim/não/talvez, onde o model deve julgar a correção de uma afirmação clínica usando o contexto do estudo fornecido.
Saúde LLM exemplos
BERT-like (somente Encoder)
Otimizados para codificar e representar texto biomédico, esses models se destacam na extração de características para tarefas como classificação.
ChatGPT / LLaMA-like (Decoder, instrução/chat-ajustado)
Baseado em arquiteturas estilo LLaMA e otimizado para tarefas interativas e diálogos clínicos.
GPT / PaLM-like (somente Decoder, generativo)
Construídos de forma semelhante ao GPT-3 ou PaLM, esses models são fine-tuned para geração de texto de propósito geral e sumarização.
De propósito geral LLMs em saúde
*Llama 3.1 Instruct Turbo com 405B parâmetros. Veja metodologia do benchmark.
Principais conclusões:
- o1: Model com melhor desempenho
- 03 mini: Melhor opção de orçamento
- GPT 4.1: Melhor velocidade e tempo de resposta
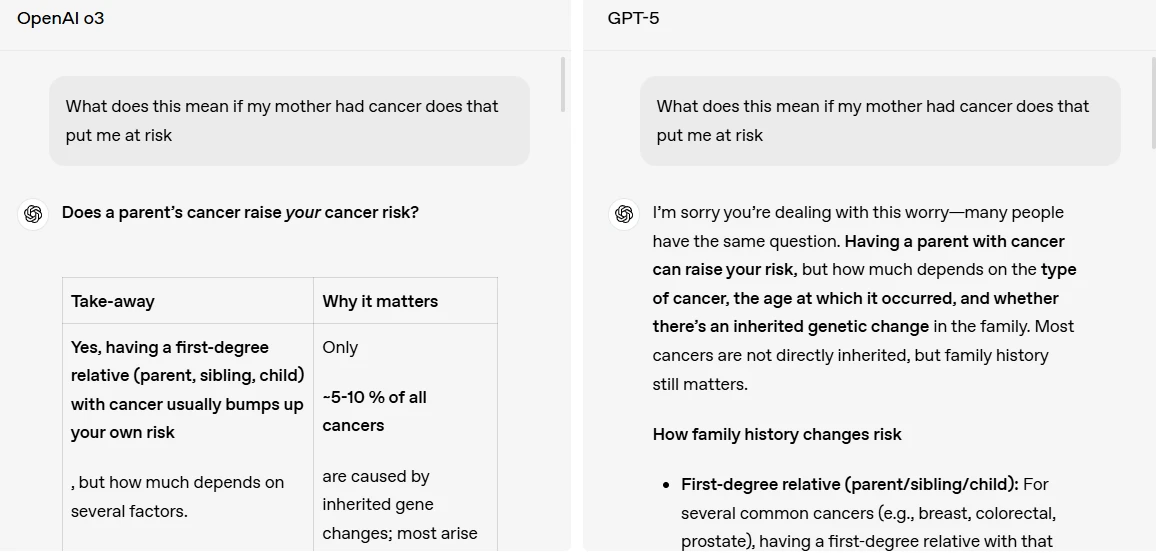
- Além da acurácia e do custo de entrada, os models também diferem em suas abordagens subjacentes ao question answering médico
Figura 4: Figura mostrando as diferenças entre as respostas do GPT-5 e do o3.
Fine-tuning médico LLMs
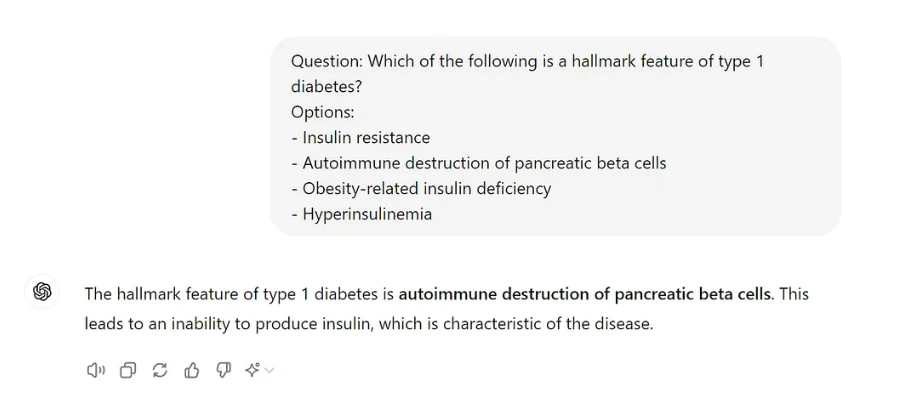
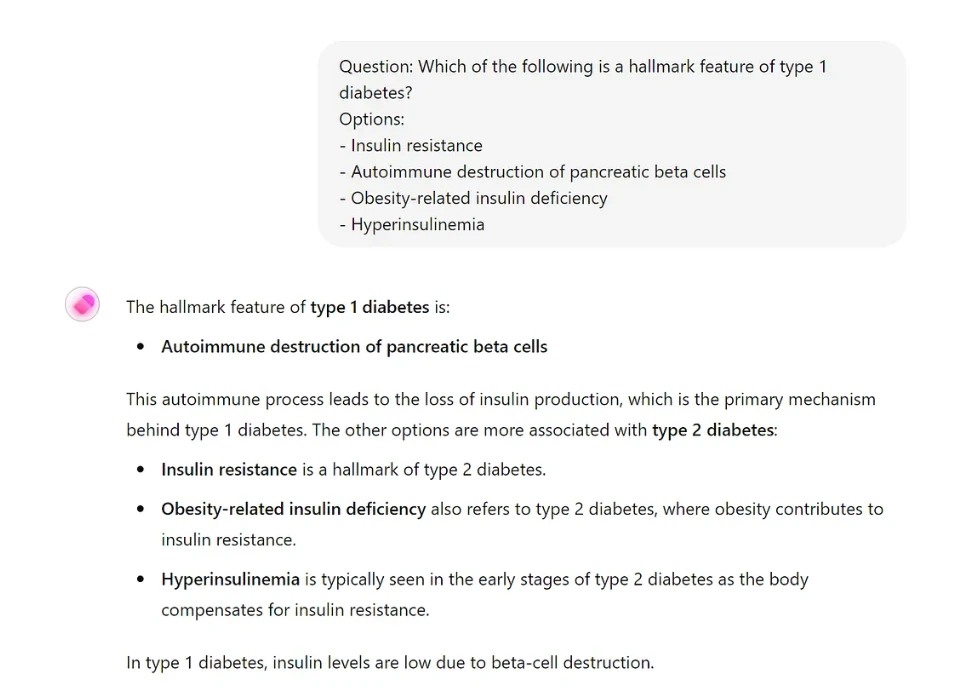
O desempenho do ChatGPT padrão (4o model) é comparado com o assistente existente ‘Clinical Medicine Handbook’. Ambos os models recebem o mesmo prompt, e suas respostas são analisadas:
GPT 4o
Figura 5: A figura mostra que a resposta do model GPT 4o padrão é precisa, mas também altamente resumida.1
Fine-tuned médico LLM
Figura 6: A figura mostra a resposta do agente especializado.1
Aplicações de propósito geral LLMs
Você pode usar esses models em saúde aproveitando:
- Pré-treinamento contínuo em dados médicos para ajudar o model a identificar melhor a linguagem médica, expondo-o a anotações clínicas e literatura biomédica (como PubMed).
- RAG para extrair dados de documentos clínicos verificados para produzir respostas precisas em tempo de execução.
- Fine-tuning de instrução para permitir que o model aprenda a responder a perguntas clínicas ou extract sintomas do texto.
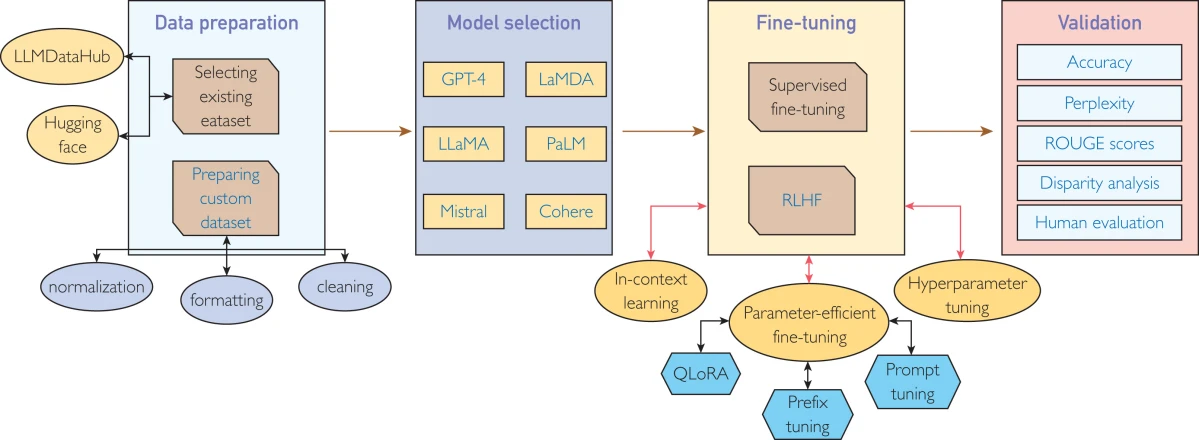
Figura 7: Um fluxo de trabalho geral de LLM fine-tuning para casos de uso especializados.
Onde as organizações de saúde usam LLMs
Organizações de saúde estão testando LLMs em fluxos de trabalho clínicos e administrativos. As aplicações comuns incluem documentação clínica e transcrição, sumarização de EHR, busca de literatura, redação de mensagens para pacientes, codificação médica, autorização prévia, educação de clínicos e explicações voltadas ao paciente.
O model apropriado depende menos do rótulo do caso de uso do que dos requisitos de carga de trabalho. Aplicações voltadas ao paciente e de suporte à decisão clínica geralmente exigem maior precisão médica, avaliação de segurança, auditabilidade e controles de proteção de dados, enquanto cargas de trabalho administrativas podem dar mais peso a custo, latência, comprimento de contexto e integração com sistemas existentes.
 Adicionar como fonte preferencial
Metodologia de large language models em saúde
Metodologia do benchmark: Este benchmark avalia 9 populares de uso geral LLMs em questões médicas de nível de pós-graduação usando o dataset MedQA, que extrai seu conteúdo United States Medical Licensing Examination (USMLE). Cada pergunta inclui um cenário clínico e opções de resposta de múltipla escolha.
LLM saídas: Cada model foi solicitado a retornar uma resposta estruturada (por exemplo, “Answer: C”).8
Latência: O tempo médio que um model leva para gerar uma resposta a um único prompt do MedQA. Por exemplo, se 100 perguntas levam 1.115 segundos no total para serem concluídas, a latência média é de 11,15 segundos por pergunta.
LLMs em fontes de dados do benchmark em saúde
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Comparação de 9 Large Language Models em Saúde}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-language-models-in-healthcare}},
  note   = {AIMultiple. Acessado em 4 setembro 2026}
}Resultados e carimbos de data/hora de 62 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 6 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
15 atualizaçõesAdicionados três casos de uso: descoberta e desenvolvimento de medicamentos, radiologia e imagem médica, e literacia em saúde.
Expandida a seção "Suporte à decisão clínica" com MedGemma e uma nova figura.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.



Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.