


AIM-Decision: Jev vs Clef vs LLMs
Les modèles de décision, aussi appelés modèles System One,1 évaluent un ensemble fixe d’options au lieu de générer du texte token par token. Nous avons testé 59 modèles de décision sur 1 655 questions de classification, comme l’évaluation de la gravité d’une faille de sécurité ou d’un rappel de produit, et avons exécuté 46 d’entre eux sur 50 tâches de navigateur. Voir AIM System One Index pour les résultats combinés.
Résultats du benchmark de classification
- decider-12b a obtenu 46.4 sur les failles de sécurité et 62.4 sur les rappels, à $0,06 pour 1 000 décisions. Aucun modèle de décision n’a obtenu un score significativement supérieur sur l’une ou l’autre tâche.
- Jev 1.13 a coûté $0,039 pour 1 000 décisions et a obtenu 47.9, environ un point de moins que Kev-9B et Nimble 9B, qui coûtent environ 7 et 9 fois plus.
- pplx-decider-v1.1-27b et Mercury Decide ont obtenu 48.7 et 48.1, au-dessus du 47.9 de Jev, pour environ un tiers de son coût.
- Eikos-27B, avec 27 milliards de paramètres, a coûté $0,073 pour 1 000 décisions. Tev1 4B, avec 4 milliards, a coûté $0.34.
- Strands Decider 2B a obtenu 62.6 sur les rappels, le score le plus élevé de tous les modèles, et 33.9 sur les failles de sécurité, où les réponses aléatoires atteignent en moyenne 25.
- GLiDE a obtenu 46.5 sur les failles de sécurité contre 46.4 pour decider-12b, mais a mis 15,7 secondes par décision contre 0.13 et a coûté $0,48 pour 1 000 décisions. GLiDE v2 a obtenu en moyenne 49.0 sur les deux tâches en 0,47 seconde et $0.10. Clef a obtenu en moyenne 51.0 pour $0,17 via l’API de Cloudflare.
Taux de réussite de l’automatisation de navigateur
Une tentative par tâche ; les LLM ont été exécutés avec le réglage à faible effort de raisonnement de leur API.
- Solar Decide, Solar Decide Flash et les deux versions de Nimble 9B, Tev1 4B et Tev1 0.8B ne sont pas classés car ils acceptent au plus 26 options par question, et 17 des 50 tâches s’ouvrent sur une page qui en contient davantage. Laya et Strands Decider 2B sont également exclus, car leurs limites d’entrée ont rejeté des requêtes que les autres modèles ont reçues intégralement.
- SubQ Snap a terminé 41 tâches, deux de moins que Gemini 3.8 Flash et six de moins que GPT-6 Astra. Il a coûté environ $0,001 par tâche terminée, contre $0,025 pour Gemini et $0,226 pour Astra.
- Les modèles de décision ont ensemble terminé 49 des 50 tâches, dont les trois qu’Astra a échouées.
- decider-12b, premier en classification, a terminé 16 tâches de navigateur ; Kev-27B, qui a obtenu un score inférieur à Jev en classification, a terminé 40 tâches. JEV-27B-VL, distillé à partir de Jev 1.13 selon sa fiche de modèle,2 a obtenu 45.8 contre 47.9 pour Jev et a terminé 24 tâches de navigateur contre 18 pour Jev.
Voir 10 tâches d’exemple et le résultat de chaque modèle sur Hugging Face, ainsi que la façon dont nous avons exécuté le benchmark sous méthodologie.
Modèles de décision vs LLM sur les tâches de navigateur
La plupart des LLM écrivent leur réponse token par token, et chaque token coûte du calcul et du temps. Pour la plupart des étapes de navigateur, l’agent se contente de choisir une opération et un contrôle sur la page.
Un modèle de décision lit la page et les options, évalue chaque option et renvoie la plus probable. Il renvoie une probabilité pour chaque option au lieu de texte généré, de sorte qu’une étape n’a pas besoin d’une longue sortie. Si les modèles de décision deviennent suffisamment précis, la même automatisation pourrait s’exécuter beaucoup plus vite et pour une fraction du coût d’un LLM.
Les modèles de décision, tels que nous les avons servis, renvoient des scores d’options et aucun texte ; un modèle de texte distinct, Mercury 2.5,3 écrit donc les valeurs saisies dans les champs de formulaire. Nous l’appelons l’assistant de texte, et il était disponible pour tous les modèles.
Nous avons exécuté chaque modèle sur le runtime open source jev-ultrafast de browser-use,4 qui a été conçu pour Jev 1.13 de TypeSafe.5 GPT-6 Astra sert de référence haut de gamme parmi les LLM et Gemini 3.8 Flash de référence à bas coût. Tous les modèles sont répertoriés dans la méthodologie.
Cinq modèles sur la même tâche
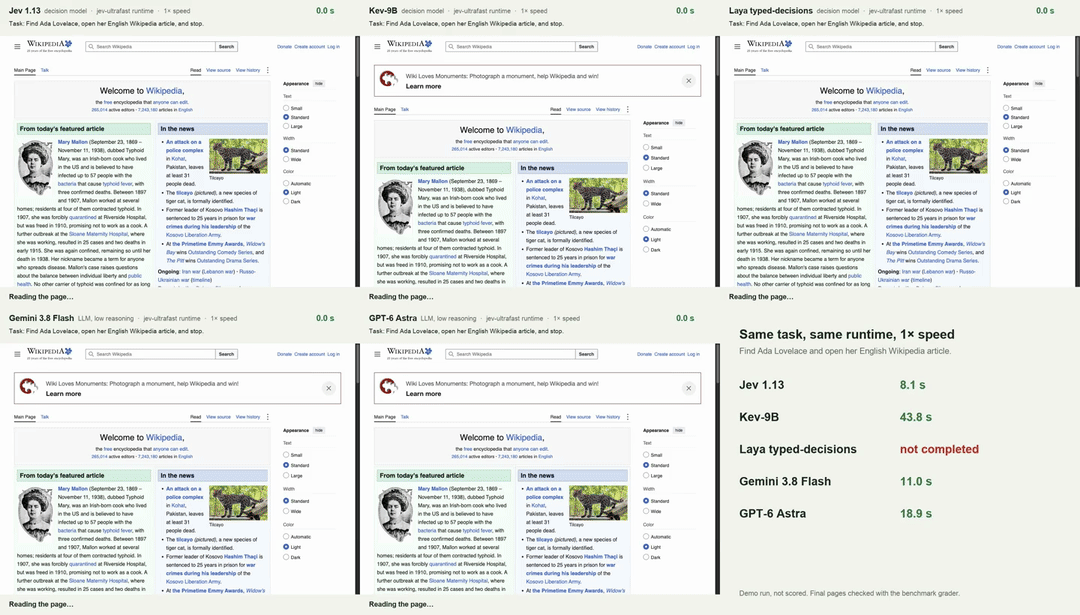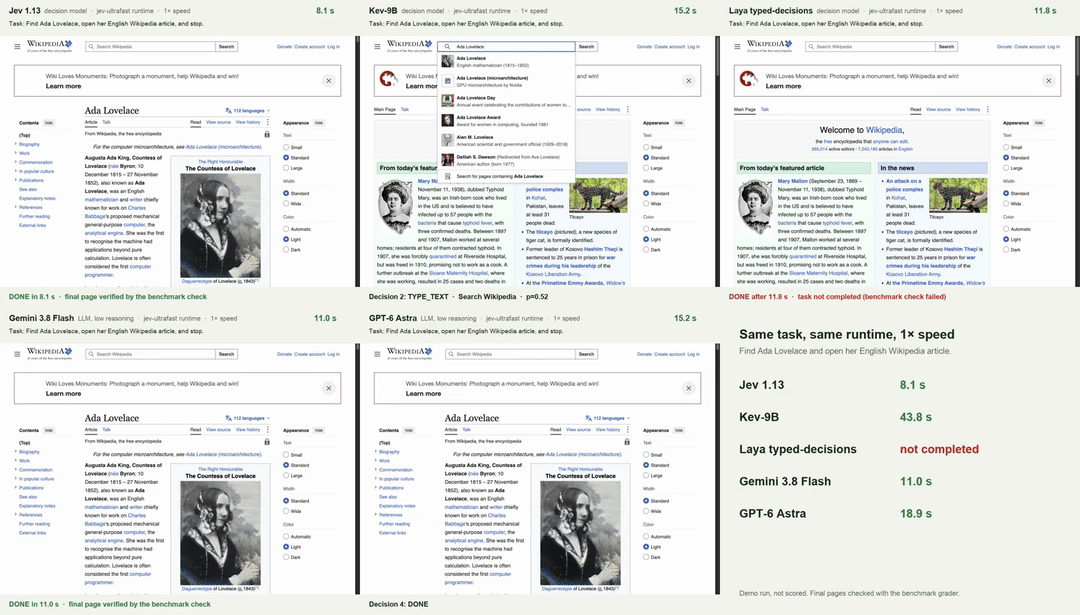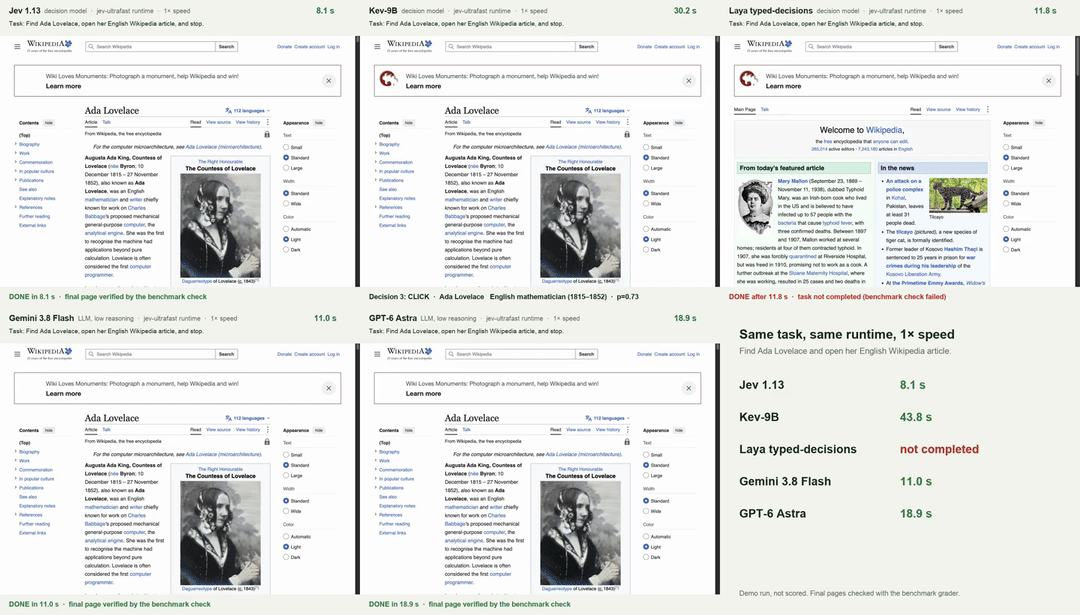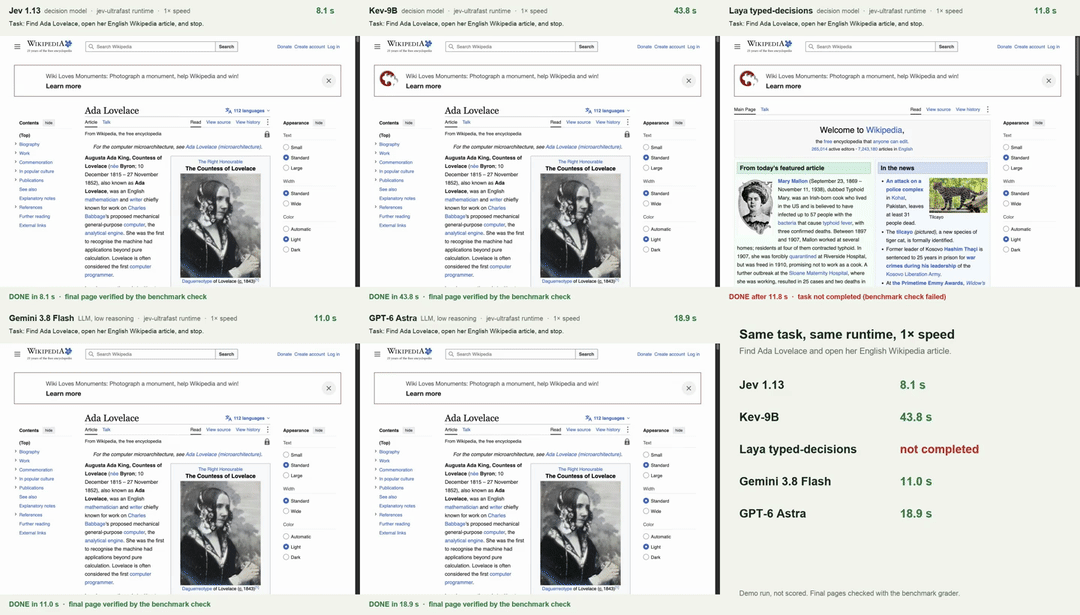
Sur Wikipédia, tous les modèles sauf Laya ont saisi du texte dans la zone de recherche, l’assistant de texte a écrit « Ada Lovelace », et le modèle a choisi la bonne suggestion. Jev a atteint l’article en 8,1 secondes, Gemini en 11.0, Astra en 18.9 et Kev-9B en 43.8. Laya a déclaré la tâche terminée sur la page principale sans effectuer d’action.
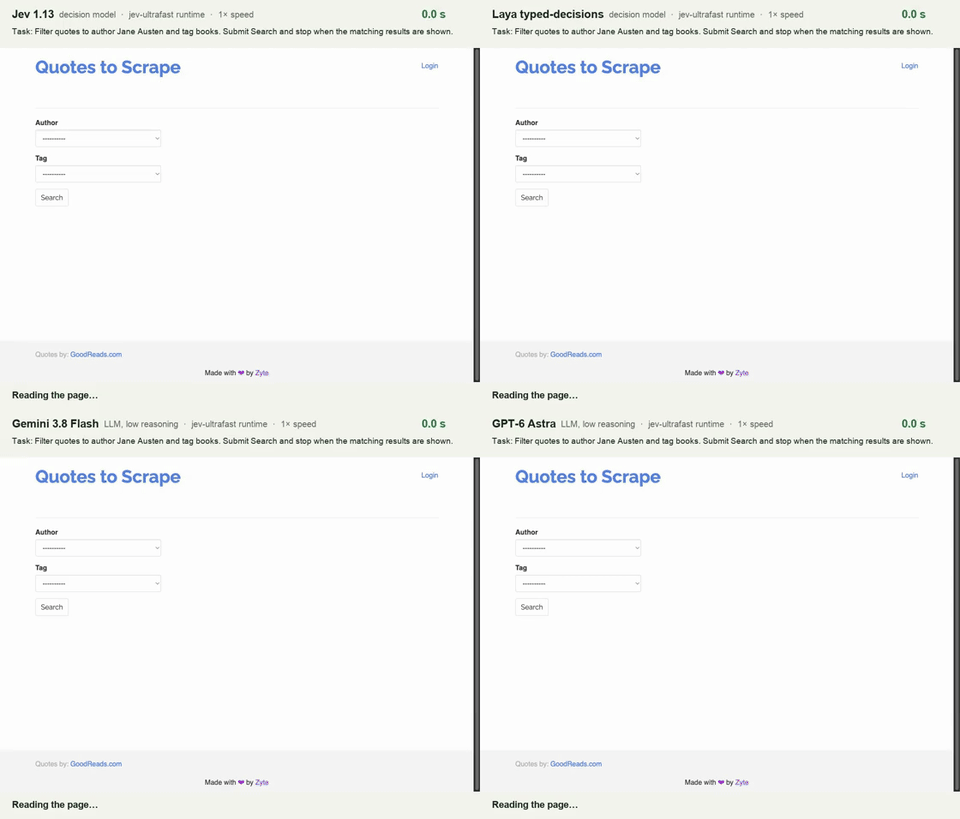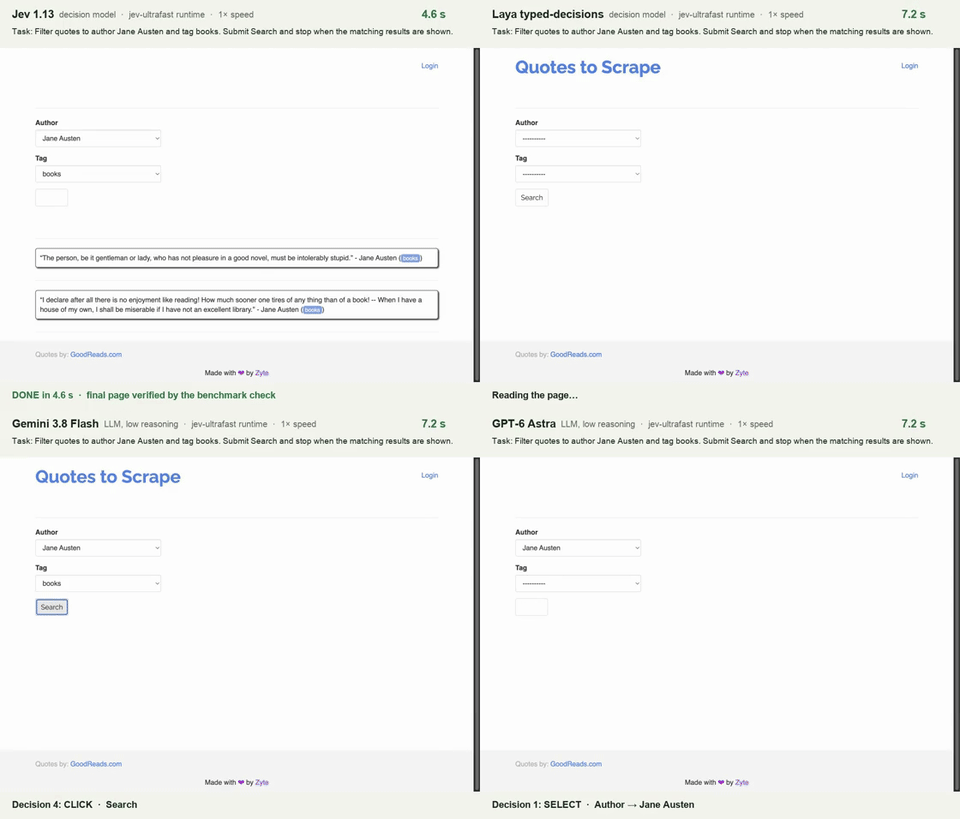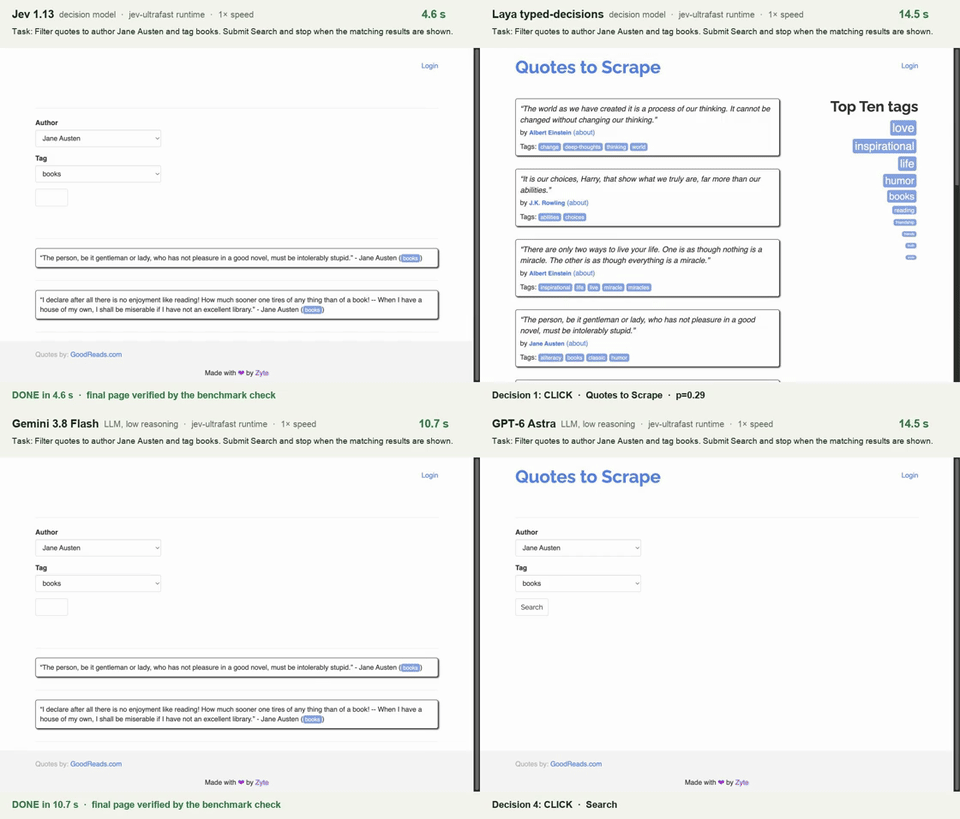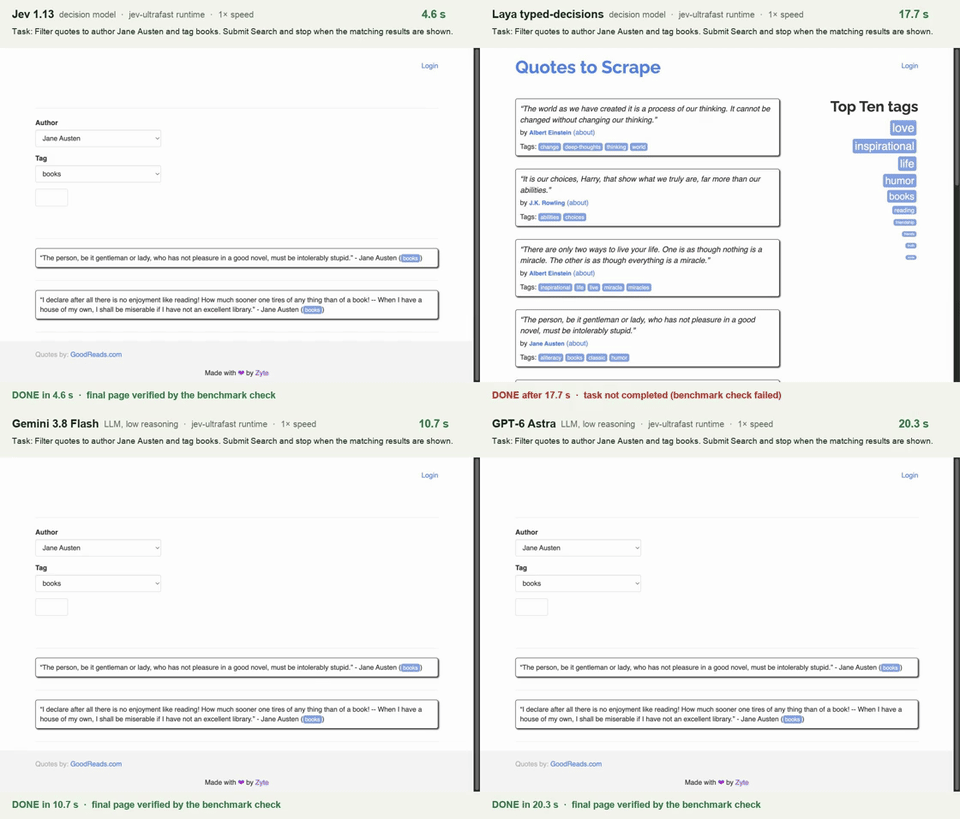
La tâche de filtre nécessite deux listes déroulantes et un bouton de recherche. Jev, Gemini et Astra ont suivi les quatre mêmes étapes et ont terminé en 4.6, 10.7 et 20,3 secondes. Laya a cliqué sur le logo du site et a déclaré la tâche terminée. Kev-9B a échoué cette tâche dans le benchmark, et dans la démonstration, il cliquait encore après 11 minutes, il est donc laissé hors de cet extrait.
Les légendes montrent l’opération et la cible choisies par chaque modèle, et, pour les modèles de décision, la probabilité de cette opération. Les extraits proviennent d’une démonstration distincte exécutée à vitesse 1×, et non du benchmark noté, et chaque page finale a été vérifiée avec le correcteur du benchmark.
Comment les modèles ont échoué
Jev et Kev-9B ont terminé ensemble 26 tâches distinctes. Tous deux ont terminé les deux tâches Wikipédia et la tâche de liste déroulante Web Scraper, tout comme les deux LLM. Sur Books to Scrape, où chaque tâche passe d’une liste de catégories à une page produit, Jev a terminé l’une des six et Kev-9B en a terminé trois. Kev-27B, Eikos-27B et AutoJev-27B ont terminé les six.
- Jev a déclaré la tâche bloquée dans 24 de ses 32 échecs, 16 fois avant d’entreprendre la moindre action.
- Kev-9B a effectué en médiane 9.5 actions sur les tâches échouées, contre 3 sur les tâches qu’il a terminées. Dix tentatives ont atteint la limite d’actions ou d’appels de décision, et cinq autres ont été arrêtées après que trois actions consécutives ont laissé la page inchangée.
- Kev-4B, du développeur de Kev-9B, a déclaré la tâche bloquée dès sa première décision sur 29 des 50 tâches.
- Kev-27B, Eikos-27B et GLiDE ont tous échoué sept tâches en commun. Ils en ont déclaré quatre bloquées, deux recherches de produit ScrapeMe et deux tâches Web Scraper, et aucun des trois n’a terminé la case à cocher ni le formulaire de calculatrice.
- GPT-6 Astra a échoué 3 tâches. Il a marqué une tâche de catégorie ScrapeMe comme bloquée, a continué à taper dans le même champ de calculatrice jusqu’à ce qu’il soit arrêté, et sur la tâche de formulaire T02, l’assistant de texte n’a renvoyé aucune valeur valide après qu’Astra a rempli et soumis le formulaire.
- Gemini 3.8 Flash a échoué 7 tâches, dont la même fin T02. Trois échecs ont atteint la bonne page mais n’ont pas terminé, deux ont été arrêtés par notre protection des coûts lorsque OpenRouter n’a pas signalé de frais, et un a atteint la limite d’actions.
Pourquoi certains modèles ont obtenu 0/50
GLiNER2.5-Decide
GLiNER2.5-Decide de Fastino6 a déclaré les 50 tâches terminées trop tôt, dont 49 dès sa première décision. Sur les 37 tâches qui partagent une page de départ avec une autre tâche, ses probabilités d’opération ne différaient pas de plus de 6 points entre les objectifs.
Fastino décrit GLiNER2.5-Decide comme un classifieur pour des décisions telles que le routage des tickets, l’intention, l’urgence et le fait qu’un agent ait terminé ou non, et indique que le modèle ne raisonne pas. Le modèle est conçu pour des entrées allant jusqu’à 512 tokens, mais accepte des entrées plus longues. Nos requêtes de première étape avaient une médiane de 1 915 tokens.
CLM-v0.1-8B
CLM-v0.1-8B de Contrastive-LM7 a choisi l’attente pour 2 199 de ses 2 288 décisions d’opération, de sorte que 36 tentatives ont épuisé leurs actions. Sur les mêmes pages de départ, ses probabilités différaient d’au plus 13 points entre les objectifs.
Contrastive-LM indique que CLM-v0.1-8B, sans fine-tuning, obtient des performances comparables à Jev sur les tâches d’utilisation d’ordinateur, de jeu et d’appel d’outils, et qu’il accepte le format de requête de Jev inchangé.8 Nous lui avons envoyé des requêtes dans ce format.
Vitesse et réussite
Kev-27B, Eikos-27B et AutoJev-27B ont terminé de 68 % à 80 % des tâches avec une médiane d’environ 7 secondes par tentative, plus vite que Gemini à 12,7 secondes et Astra à 17.4. SubQ Snap, pplx-decider-v1.1-27b et Mercury Decide ont terminé de 72 % à 82 % en 5.3 à 6,3 secondes.
decider-4b, decider-12b et Jev ont mis de 2.5 à 4,2 secondes par tentative et ont déclaré de 19 à 24 tâches bloquées.
GLiDE a terminé 76 % des tâches avec une médiane de 46,8 secondes par tentative, et 3 de ses tentatives ont atteint la limite de 900 secondes. NeoHorse-Jev-4B a été le plus lent, à 78,6 secondes, avec 15 tâches terminées. GLiDE v2 a terminé 72 % des tâches avec une médiane de 6,0 secondes.
GLiNER2.5-Decide (0,2 seconde) a déclaré 49 des 50 tâches terminées dès sa première décision, et Kev-4B a déclaré 29 tâches bloquées dès la sienne.
Kev-9B a mis une médiane de 38,3 secondes par tentative, soit cinq fois Kev-27B. Chaque décision de Kev-9B a pris une médiane de 3,7 secondes de temps serveur, contre environ 1 seconde pour un appel API Jev complet. Le surcoût de requête ajoutait environ une demi-seconde.
Kev-9B a effectué en moyenne 26 décisions par tentative, contre environ 4 pour Jev, et 90 % d’entre elles sont survenues lors de tentatives échouées.
Coût
Coût de l’automatisation de navigateur
† Estimation : coût d’un A100 par token d’entrée, mesuré sur les propres requêtes de navigateur du modèle avec le GPU à pleine charge, multiplié par ses tokens d’entrée de navigation, plus les frais de l’assistant de texte. Méthode sous méthodologie.
‡ Le chiffre le plus élevé ajoute 17 requêtes qui ont échoué sans signaler de tokens, comptées à 120 000 tokens d’entrée chacune ; Fastino pourrait ne pas les facturer.
Astra, Gemini et Jev ont chacun utilisé de 3 150 à 3 470 tokens d’entrée par décision. Le prix d’entrée d’Astra est environ 240 fois celui de Jev.910
À faible raisonnement, Astra a produit 6 599 tokens de sortie sur 307 décisions, contre 968 376 tokens d’entrée. Le prix de sortie de Jev est $0.
Au prix d’entrée de Jev, les 968 376 tokens d’entrée de décision d’Astra auraient coûté environ $0,04 au lieu de $9.68. Kev-27B s’est approché d’Astra à sept tâches près pour un coût estimé à $0,24 sur les 50 tâches, contre $10,63 pour Astra.
Selon ces estimations, chaque modèle de décision du tableau ayant terminé une tâche, à l’exception de Celeris 1.1 Decision, Kev-4B, Kev-9B et NeoHorse-Jev-4B, a coûté moins par tâche terminée que Gemini. Neuf modèles ont coûté moins par tâche terminée que Jev 1.13 : Mercury Decide, Decider V1.2, pplx-decider-v1.1-27b, Span-02, Drex v1.5, SubQ Snap, H2O-Lightning-4B, Jev 1.14 et Drex v2.0. Mercury Decide coûte moins d’un tiers de celui de Jev.
- Kev-9B a coûté environ 5 fois Gemini et 84 fois Jev par tâche terminée. Son coût A100 estimé était d’environ $0,80 par million de tokens d’entrée, soit 19 fois le prix de l’API de Jev, et il a pris 1 321 décisions contre 185 pour Jev.
- Le coût GPU estimé par token de Kev-4B était environ 12.1 fois son prix sur OpenRouter.
Le temps A100 que nous avons loué pour l’exécution de Kev-9B, 3.32 heures incluant l’installation et les temps morts, a représenté environ $5.31. Un frais Jev et deux frais Gemini n’ont pas été enregistrés et sont absents du tableau.
Coût de classification
Les modèles hébergés sont tarifés selon les prix catalogue de leur API, à l’exception des modèles sur OpenRouter, qui sont tarifés selon les frais facturés par OpenRouter. Mercury Decide a été exécuté sur la route gratuit d’OpenRouter et est tarifé au prix catalogue de sa route payante. Les modèles auto-hébergés sont tarifés pour 1 000 décisions au débit le plus élevé que nous ayons mesuré sur un A100 loué avec le GPU à pleine charge.
À notre tarif de $1 673 par heure, un A100 loué coûte environ $40 par jour, qu’il soit occupé ou inactif. Au tarif que nous avons enregistré, $40 permettent d’acheter environ un million de décisions Jev.
 Ajouter comme source préférée
Entraînement des modèles de décision
Nous avons fine-tuné Kev-9B et Laya sur des décisions que GLM-5.3-Flash, le modèle d’étiquetage, a prises sur des tâches de navigateur provenant de huit sites web extérieurs au benchmark. Ensuite, nous avons exécuté à nouveau les 50 tâches. Chaque modèle fine-tuné est comparé à sa version d’origine, exécutée le même jour et sur le même matériel.
Le modèle Kev fine-tuné et les deux versions de Laya sont sur Hugging Face.
p provient d’un test apparié sur les mêmes 50 tâches (McNemar exact), et une valeur de p inférieure à 0.05 est considérée comme significative. Le Kev d’origine a terminé 21 tâches dans cette comparaison, soit une de plus que dans les résultats ci-dessus. L’un des 12 gains de Kev, C02, était un délai d’attente du navigateur lors de l’exécution d’origine plutôt qu’un échec du modèle. Sans lui, Kev a gagné 11 tâches et en a perdu 1 (p = 0.006).
- Le Kev fine-tuné a gagné des tâches sur six des neuf sites web, trois sur Quotes to Scrape et trois sur Scrape This Site. Ses résultats sur Web Scraper, Wikipédia et les formulaires TestPages n’ont pas changé.
- Le Kev fine-tuné a terminé 5 tentatives bloquées contre 12 et a atteint la limite d’actions 6 fois contre 11. Il a déclaré une tâche inachevée comme terminée 7 fois, contre 4.
- Sur 41 tâches des sites web d’entraînement qui ont été exclues de l’entraînement, Kev en a terminé 21 contre 13 auparavant. Sur 101 décisions uniques provenant de 19 de ces tâches, il a choisi l’opération du modèle d’étiquetage 94 % du temps, contre 62 % auparavant.
- Le premier fine-tune de Laya a choisi l’opération du modèle d’étiquetage sur 75 % des 88 décisions qu’il pouvait lire, contre 19 % pour Laya d’origine. Il a déclaré une tâche terminée sur une page qui nécessitait encore une action 2 fois au lieu de 53.
- Dans le benchmark, le premier fine-tune de Laya a déclaré une tâche inachevée comme terminée 36 fois, dont une avant d’entreprendre la moindre action. Laya d’origine l’a fait 32 fois, dont 17 avant toute action.
Cas d’usage des modèles de décision
- Vérification du signal de fin d’un agent. Sur la dernière page qu’un agent de navigateur a vue avant de déclarer une tâche terminée, 41 des 59 modèles de décision ont obtenu un score supérieur à 90 pour distinguer une tâche terminée d’une tâche non terminée, et AutoJev-27B, Clef, d1-ultra, Decision-2.0-Vega-27B et Kev-27B ont obtenu 99.5. Nous n’avons pas testé les vérifications sur des pages plus tôt dans une exécution.
- Triage avec des étiquettes fixes, comme l’évaluation des avis de sécurité ou des rappels. decider-12b a obtenu 21 points au-dessus du niveau de hasard sur la gravité et 29 sur les rappels. Sur les thèmes d’articles, un classifieur par mots-clés entraîné sur 28 595 articles étiquetés a obtenu 70.4, et aucun modèle de décision n’a obtenu un score significativement supérieur ; le même type de classifieur a obtenu des résultats proches du hasard sur la gravité et les rappels.
- Choix de chaque action dans l’automatisation de navigateur. SubQ Snap a terminé 41 des 50 tâches, contre 43 et 47 pour les deux LLM. Le fine-tuning de Kev-9B sur 606 décisions provenant d’autres sites web l’a fait passer de 21 à 32.
Sur les deux tâches de classification principales, les modèles de décision locaux ont coûté environ de $0,007 à $0,57 pour 1 000 décisions sur un GPU loué, et tous sauf NeoHorse-Jev-4B et Shisa DE-2 ont mis en moyenne moins d’une seconde par décision. Sur les tâches de navigateur, le prix d’entrée de Jev représentait environ 1/240 de celui de GPT-6 Astra.
Chaque réponse est également accompagnée d’une probabilité par option, qu’une application pourrait utiliser pour transmettre les cas incertains à un LLM. Nous n’avons pas testé dans quelle mesure ces probabilités correspondent à la précision réelle.
36 des 59 modèles ont été exécutés sur un seul GPU loué ; les 23 autres sont des API hébergées.
Méthodologie
Benchmark d’automatisation de navigateur
Tous les modèles ont utilisé le même runtime de navigateur jev-ultrafast. À chaque étape, il transformait la page courante en texte de page plus une liste numérotée de contrôles visibles. Le modèle choisissait une opération, comme cliquer, taper, sélectionner, terminer ou bloquer, et une cible dans cette liste. Le runtime exécutait l’action puis relisait la page.
Les modèles de décision classent les options fournies et ne renvoient aucun texte. Lorsqu’un modèle choisissait de taper, l’assistant de texte écrivait la valeur dans le champ de formulaire. Chaque tentative démarrait dans une nouvelle session de navigateur.
Tous les modèles ont été contactés via une API. Kev-9B et Laya ont été exécutés avec le navigateur sur un Mac, dans Chrome 153 jusqu’au 30 septembre et Chrome 154 à partir du 2 octobre. Les autres modèles auto-hébergés ont été exécutés avec Chrome sous Linux sur leur GPU loué.
Aucune requête n’a été raccourcie pour correspondre à un modèle. Solar Decide, Solar Decide Flash et Ollama acceptent de 2 à 26 options par question. Une requête hors de ces limites mettait fin à la tentative, comme le faisaient les requêtes trop volumineuses pour Laya. Ollama n’accepte les descriptions d’options que sous forme de texte, donc les options structurées ont été envoyées sous forme de texte JSON compact. Tev1 est livré avec un contexte de 2 050 tokens ; nous l’avons porté à 8 194, le réglage propre de Nimble, afin que les pages ne soient pas tronquées.
Classify-1 rejette les instructions structurées, les descriptions d’options et l’état de page que reçoivent les autres modèles ; dans les deux benchmarks, nous les avons donc envoyés sous forme de texte JSON compact.
Strands Decider 2B lit au maximum 4 096 tokens et a refusé les pages plus longues, ce qui a mis fin à 11 tentatives.
Le service de Cloudflare ne lit que les 2 048 premiers tokens du texte de page pour Clef et Clef-Flash. Nous n’avons pas envoyé les pages plus longues, ce qui a mis fin à une tentative pour chacun de ces modèles.
Pour 21 modèles, parmi lesquels Clef, decider et Eikos, une question avec une seule option, comme l’unique champ de texte d’une page, a été envoyée avec cette option en double, et la réponse a été réattribuée à celle-ci. Leurs services refusent les questions à une seule option.
Nous avons exécuté Kev-9B avec le code de référence du producteur en précision 32 bits complète. Nous n’avons pas installé les paquets de noyau optionnels qui accélèrent son modèle de base ; le modèle est donc revenu à des noyaux de référence plus lents. Nous n’avons pas testé de configuration GPU plus rapide.
Le code propre de CLM transforme chaque requête en texte. GLiNER a reçu le même texte, avec l’objectif et les règles de chaque question comme prompt. Kev-4B est également servi sur OpenRouter par SiliconFlow en précision 8 bits.11 Exécuté via ce service depuis le Mac le 29 septembre, Kev-4B a terminé 8 tâches.
GPT-6 Luna Decisions est également servi sur OpenRouter, qui renvoie une erreur pour toute la requête lorsque le modèle refuse une question ; l’API propre d’OpenAI répond aux autres questions.12 Via OpenRouter, Luna a terminé 1 tâche ; les résultats ci-dessus utilisent donc l’API d’OpenAI.
Pour Celeris 1.1 Decision, 4 des 50 tâches de navigateur ont utilisé Mercury 3 comme assistant de texte au lieu de Mercury 2.5. Celeris a échoué ces quatre tâches avec l’un ou l’autre assistant.
Modèles de navigateur
Le raisonnement faible est un réglage d’effort défini par le fournisseur. Les 307 décisions d’Astra comprenaient 791 tokens de raisonnement signalés. Kev-9B13 et Kev-4B14 proviennent du même développeur, et Nimble 9B provient de Bespoke Labs.15 GLiDE provient de Fastino, le développeur de GLiNER2.5-Decide,16 et Clef et Clef-Flash de Cloudflare.17
La fiche de modèle de MATILDA JEV v1.5 indique qu’un entraînement antérieur dans sa lignée a utilisé du matériel lié au benchmark.18
Dataset
Les 50 tâches couvrent neuf sites web : huit sites d’entraînement conçus pour le scraping et les tests, plus Wikipédia. Les tâches comprennent la navigation dans des catalogues, la recherche, le tri, la pagination, les options de produit, les formulaires et les recherches d’articles. Chaque tâche part d’une URL fixe et décrit l’état final en une phrase, par exemple « Passez à Science Fiction, trouvez Dune (Dune #1), ouvrez ses détails de produit, puis arrêtez-vous. »
Avant l’exécution des modèles, une exécution scriptée a terminé les 50 tâches en utilisant uniquement les actions prises en charge par le runtime. Chaque tâche peut être résolue sans mots de passe, CAPTCHA ni touche Entrée.
Tâches d’exemple
Dix des 50 tâches sont publiées sur Hugging Face avec les instructions, l’URL de départ, les conditions de réussite et le résultat de chaque modèle. Les 40 autres sont réservées pour des exécutions ultérieures.
Évaluation
Une tâche était réussie lorsque le modèle la déclarait terminée dans les limites et qu’une vérification distincte de la page finale confirmait chaque condition : une URL finale acceptée, les faits de la tâche visibles sur la page, plus de 100 caractères de texte de page et une page entièrement chargée.
Chaque tentative disposait de 900 secondes, de 60 actions de navigateur et de 120 appels de décision. Les erreurs d’API comptaient comme des échecs. Le chronométrage va de la première page chargée à la vérification finale.
La vérification lit la page finale après la fin de son chargement.
Calcul des coûts
Le coût d’API couvre les appels de décision et l’assistant de texte, pour les 50 tentatives de chaque modèle. OpenRouter a signalé les frais pour GPT-6 Astra, Gemini et Mercury 2.5. Le coût de Jev correspond à ses tokens signalés au prix catalogue du 22 septembre 2026 : $0,042 par million de tokens d’entrée et aucun frais de sortie.5 GLiDE, Clef et Clef-Flash sont également tarifés à leurs prix catalogue.
GLiDE v2, GPT-6 Luna Decisions, SubQ Snap et Celeris 1.1 Decision sont tarifés à leurs prix catalogue, et les autres modèles de décision sur OpenRouter au tarif signalé par OpenRouter. Mercury Decide, exécuté sur la route gratuit, est tarifé au prix catalogue de sa route payante.
Les exécutions de navigateur auto-hébergées ont utilisé un A100, une A6000, une RTX 4090 ou un Mac. Nous les tarifons toutes sur un A100 loué à $1 673 par heure. Nous avons renvoyé à chaque modèle ses propres requêtes de navigateur avec le GPU à pleine charge. Le coût d’un modèle dans le tableau est son coût par token d’entrée au débit le plus élevé, multiplié par ses tokens d’entrée de navigation, plus les frais de l’assistant de texte.
Les deux charges de travail sont presque entièrement constituées d’entrées, car ces modèles renvoient des scores d’options ou quelques tokens.
Fine-tuning
Les 327 tâches, dont 286 pour l’entraînement et 41 mises de côté, proviennent de huit sites web qui ne figurent pas dans le benchmark, notamment Demo Web Shop, Automation Exercise et Project Gutenberg. Chaque tâche a été vérifiée dans un navigateur : sa page de départ échoue au correcteur et, lorsque la tâche se termine sur une URL différente, cette page réussit.
GLM-5.3-Flash, un modèle à poids ouverts sous licence MIT,19 a tenté 300 des tâches sur le runtime du benchmark avec un raisonnement faible. Des erreurs de fournisseur l’ont empêché de traiter les 27 autres. Nous n’avons pas utilisé GPT-6 Astra ni Gemini pour cela, car les conditions d’OpenAI et de Google interdisent d’utiliser leur sortie pour construire des modèles concurrents.2021
Les 184 exécutions d’entraînement réussies ont donné 606 enregistrements de décision. Une exécution comptait comme réussie lorsque le correcteur la validait, ou lorsqu’elle atteignait la bonne page produit via la recherche du site et n’échouait qu’à la vérification exacte de l’URL, comme l’ont fait 11 exécutions sur l’ensemble des tâches.
Le test à décision unique rejoue 103 décisions enregistrées provenant de 19 tâches mises de côté et compte la fréquence à laquelle un modèle choisit l’opération du modèle d’étiquetage. Kev pouvait en lire 101. Laya pouvait en lire 88 lorsqu’on lui envoyait uniquement les questions nécessaires à chaque étape, et 34 dans la requête complète envoyée par le benchmark. Sur ces 34, Laya d’origine était d’accord 29 % du temps, le premier fine-tune 71 % et le second 41 %.
Les deux modèles sont partis des poids d’origine que nous avons évalués et ont utilisé les recettes d’entraînement de leurs producteurs avec les limites d’entrée du benchmark. Kev a en outre été entraîné pendant deux époques au lieu d’une, sans les enregistrements de rejeu du producteur. Chaque exécution d’entraînement a pris moins de 20 minutes sur un H100 GPU.
Le premier fine-tune de Laya a utilisé les mêmes 606 enregistrements, en ignorant ceux trop longs pour Laya. Le second n’a conservé que les 292 qui tiennent dans la requête complète envoyée par le benchmark et a ajouté 102 enregistrements provenant des propres exécutions de Laya, où GLM-5.3-Flash a pris le relais après que Laya a déclaré une tâche terminée ou bloquée (73) ou a épuisé son budget de 10 actions (29). Kev n’a pas eu de seconde passe.
Le couple Kev et le premier couple de Laya ont été exécutés sur un H100 loué en France, avec Chrome sous Linux. Le second couple de Laya a été exécuté sur le Mac du benchmark principal. Chaque couple a utilisé les 50 tâches du benchmark principal, le runtime, les limites et le correcteur, avec une tentative par tâche.
Benchmark de classification
Chaque élément est une décision avec un ensemble fixe d’options. Les éléments proviennent de documents publiés de juillet à septembre 2026 et de captures d’écran non publiées de pages finales issues de nos propres exécutions de navigateur. Beaucoup de modèles sont sortis après la publication de ces documents ; un modèle peut donc avoir vu un élément et sa réponse enregistrée pendant l’entraînement. Nous ne pouvons pas vérifier sur quoi chaque modèle a été entraîné.
Les trois premières tâches demandent à un modèle de reproduire une décision enregistrée par une institution, à partir du texte seul. GitHub et la FDA ont pu utiliser des preuves que le texte ne contient pas. Les niveaux de gravité de GitHub correspondent aux quatre évaluations au-dessus de None dans le CVSS, le système standard de notation des vulnérabilités.22
Chaque modèle a reçu les mêmes instructions et définitions d’options pour une tâche : les définitions de classes de la FDA, les bandes de gravité de GitHub, les descriptions de catégories d’arXiv. L’ordre des options était mélangé pour chaque élément et identique pour tous les modèles. La gravité des failles de sécurité et le niveau de danger des rappels sont les tâches principales, fixées avant toute exécution ; les thèmes d’articles et la vérification de fin de tâche sont supplémentaires.
Le score est la précision équilibrée : le taux de réussite au sein de chaque réponse possible, moyenné sur les réponses.
Un modèle qui donne toujours la réponse la plus courante obtient 25 sur la gravité, 33 sur les rappels et 5 sur les thèmes d’articles. Le score du graphique est la moyenne des deux tâches principales, où cette réponse obtient environ 29. Les intervalles sont des intervalles bootstrap à 95 % qui rééchantillonnent ensemble les éléments liés : les avis pour le même paquet, les rappels du même événement de rappel, les pages de la même tâche de navigateur.
Pour tester si un modèle a obtenu un score significativement supérieur à decider-12b, nous avons tiré 1 000 tels rééchantillonnages, les mêmes pour chaque modèle, et avons retenu l’intervalle à 95 % de la différence de chaque modèle sur chaque tâche principale ; un modèle n’est considéré comme supérieur que si cet intervalle se situe au-dessus de zéro, sans ajustement pour comparaisons multiples. Chaque modèle a été comparé de la même manière au classifieur par mots-clés sur les thèmes d’articles.
Deux LLM, Qwen 3.8 Max et Claude Opus 5.5, ont étiqueté un échantillon de 350 éléments de test, 100 par tâche et 50 pages de navigateur, sans voir la réponse enregistrée.
Ils étaient d’accord entre eux sur 62 des 100 avis, 69 des 100 rappels, 84 des 100 articles et 49 des 50 pages de navigateur. Lorsqu’ils n’étaient pas d’accord avec l’enregistrement sur les avis et les rappels, ils se trompaient le plus souvent d’un niveau, vers les niveaux intermédiaires. Ils correspondaient à la gravité de GitHub sur 55 et 56 des 100 avis.
Les deux juges ont donné la même réponse, différente de l’enregistrement, sur 54 éléments. Nous avons vérifié les 53 enregistrements GitHub, de la FDA et d’arXiv par rapport à la source en direct, et tous correspondaient, donc aucune étiquette n’a été modifiée.
La page de navigateur unique a été étiquetée comme terminée parce que le correcteur comptait au moins 40 avis sur la page complète, tandis que la capture que voient les modèles en montre environ neuf. Nous l’avons retirée, ainsi que les 48 autres éléments de vérification de fin de tâche dont la réponse dépendait du comptage de 10 éléments ou plus, ce qui laisse 155 éléments.
Les coûts locaux valent pour le réglage que nous avons testé sur ce GPU ; un autre réglage de serveur ou un autre GPU les modifierait. Lorsque nous avons mesuré le coût des premières versions Ollama de Nimble 9B et des modèles Tev1, Tev1 0.8B différait de son exécution notée sur 1,2 % des questions, et Nimble 9B et Tev1 4B sur moins de 1 %.
Au réglage choisi, les autres modèles auto-hébergés correspondaient à au moins 98 % de leurs réponses notées, à l’exception de Shisa DE-1 et Shisa DE-2. Ils varient d’une exécution à l’autre, même une requête à la fois ; leur seuil était donc leur propre concordance une-à-une moins 2 points de pourcentage ; ils ont correspondu à 97,6 % et 96,4 %. Sur leurs propres requêtes de navigateur, CLM-v0.1-8B, Shisa DE-2 et GEV-26B-Decide ont correspondu à 90,7 %, 77,9 % et 83,1 % selon la même règle.
Exceptions à l’exécution de chaque modèle tel que publié :
- Laya Typed-Decisions a été exécuté avec un contexte de 8 192 tokens au lieu de 1 024, et Tev1 avec 8 194 au lieu de 2 050, comme dans nos exécutions de navigateur.
- Là où le code propre de Laya aurait tronqué une option ou une entrée longue, notre connecteur rejetait la requête à la place, et un rejet compte comme une mauvaise réponse. Toutes les requêtes sur les thèmes d’articles ont été rejetées car les descriptions des thèmes dépassent les 48 tokens que Laya lit par option.
- Le contexte de l’encodeur de CLM a été porté de 2 048 à 16 384 tokens ; GLiNER a été exécuté au-delà de son entrée documentée de 512 tokens. Shisa DE-1 a utilisé un contexte de 32 768 tokens pour tenir dans la mémoire du GPU.
- d3, d3-flash, d3-mini, Decision-2.0-Vega-27B, Decision-1.0-Lux-9B et MATILDA JEV v1.5 ont été exécutés sur un NVIDIA A100, ce que leurs producteurs n’ont pas validé ; les trois d3 et Decision-2.0-Vega-27B ont été exécutés sans leurs chemins rapides réservés à AMD. JEV-27B-VL et GEV-26B-Decide ont été exécutés sur vLLM 0.29.0 ; leurs fiches de modèle mentionnent une version non publiée de vLLM.
- NeoHorse-Jev-4B est passé par l’adaptateur vLLM de son producteur, car son propre serveur refuse par défaut les textes de page de plus de 2 048 tokens.
- APUS Reflex 35B-A3B accepte de 2 à 16 options par question ; il a donc rejeté les 500 questions sur les thèmes d’articles (20 options), qui comptent comme de mauvaises réponses, et il n’a pas exécuté les tâches de navigateur.
- Together AI n’avait pas publié de licence pour les poids Tev1 au 30 septembre 2026.
- Le service de Cloudflare ne lit que les 2 048 premiers tokens du texte de l’élément pour Clef et Clef-Flash, bien que les modèles acceptent 65 536. Les 12 éléments plus longs, 9 sur la gravité et 3 sur les rappels, comptent comme de mauvaises réponses.
Limitations
Chaque modèle a tenté chaque tâche de navigateur une seule fois ; un écart de quelques tâches entre deux modèles ne montre donc pas lequel est meilleur.
Les 50 tâches proviennent de neuf sites web, et les tâches d’un même site partagent des mises en page. Les modèles ont été exécutés sur des sites web en direct, qui peuvent changer entre les exécutions.
Le format d’étape, une liste d’opérations plus des listes de cibles, a d’abord été conçu pour Jev. Chaque modèle a reçu le même format. Nous n’avons pas testé si un autre format modifierait les résultats. Laya a été exécuté avec des limites d’entrée supérieures à ses réglages publiés afin que les longues pages ne soient pas tronquées.
Dans le benchmark de classification, chaque modèle a répondu une fois à chaque élément. Les réponses de GitHub et de la FDA sont les décisions enregistrées par ces institutions, qui peuvent reposer sur des preuves que le texte de l’avis ou du rappel ne contient pas.
Citez ce benchmark
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{AIM-Decision: Jev vs Clef vs LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/decision-models}},
  note   = {AIMultiple. Consulté le 21 octobre 2026}
}Résultats et horodatages de 389 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 10 fichiers CSV et un README.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Liens de référence




Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.