


LLM Routeur Benchmark: 8 routeurs sur 523 tâches de base de données agentiques

Nous avons testé 8 routeurs LLM sur 523 tâches de base de données agentiques et comparé chacun à des modèles seuls en précision et en coût.
Résultats du benchmark des routeurs agentiques
| Name | Series | $ per 1,000 questions, router fees included (log scale) | Score (%) | Score | Cost | Pool | Label |
|---|---|---|---|---|---|---|---|
| Fireworks Nexus Auto | Fireworks Nexus Auto | 1.93 | 35.95 | 35.9% | 1.9 | Router's own, open models | Fireworks Nexus Auto |
| Not Diamond | Not Diamond | 50.52 | 50.86 | 50.9% | 50.5 | 19 models | Not Diamond |
| NVIDIA Switchyard (Sol + Luna) | NVIDIA Switchyard (Sol + Luna) | 16.6 | 56.21 | 56.2% | 16.6 | GPT-6.1 Sol + GPT-6 Luna | NVIDIA Switchyard (Sol + Luna) |
| OpenRouter Auto | OpenRouter Auto | 1.97 | 28.68 | 28.7% | 2.0 | Router's own | OpenRouter Auto |
| OpenRouter Auto Code | OpenRouter Auto Code | 24.62 | 52.77 | 52.8% | 24.6 | Router's own | OpenRouter Auto Code |
| Sakana Fugu Max | Sakana Fugu Max | 29.96 | 27.34 | 27.3% | 30.0 | Router's own | Sakana Fugu Max |
| TypeSafe Jev | TypeSafe Jev | 2.09 | 29.45 | 29.4% | 2.1 | Router's own | TypeSafe Jev |
| Unbiased Pareto 26.10 | Unbiased Pareto 26.10 | 13.18 | 44.17 | 44.2% | 13.2 | Router's own | Unbiased Pareto 26.10 |
| Claude Fable 5 | Anthropic | 150.34 | 60.04 | 60.0% | 150.3 | single model | Claude Fable 5 |
| Claude Fable 5.1 | Anthropic | 718.96 | 62.91 | 62.9% | 719.0 | single model | Claude Fable 5.1 |
| Claude Fable 5.2 | Anthropic | 109.43 | 85.28 | 85.3% | 109.4 | single model | Claude Fable 5.2 |
| Claude Haiku 5.5 | Anthropic | 1.92 | 26.2 | 26.2% | 1.9 | single model | Claude Haiku 5.5 |
| Claude Opus 4.8 | Anthropic | 148.83 | 50.67 | 50.7% | 148.8 | single model | Claude Opus 4.8 |
| Claude Opus 5 | Anthropic | 77.8 | 60.99 | 61.0% | 77.8 | single model | Claude Opus 5 |
| Claude Opus 5.5 | Anthropic | 236.55 | 84.89 | 84.9% | 236.5 | single model | Claude Opus 5.5 |
| Claude Sonnet 5 | Anthropic | 76.64 | 34.42 | 34.4% | 76.6 | single model | Claude Sonnet 5 |
| Claude Sonnet 5.5 | Anthropic | 53.81 | 70.36 | 70.4% | 53.8 | single model | Claude Sonnet 5.5 |
| Command A Plus | Cohere | 9.19 | 30.21 | 30.2% | 9.2 | single model | Command A Plus |
| DeepSeek V4 Flash | DeepSeek | 2.91 | 30.4 | 30.4% | 2.9 | single model | DeepSeek V4 Flash |
| DeepSeek V4 Flash 0731 | DeepSeek | 1.66 | 33.84 | 33.8% | 1.7 | single model | DeepSeek V4 Flash 0731 |
| DeepSeek V4 Pro | DeepSeek | 11.28 | 35.37 | 35.4% | 11.3 | single model | DeepSeek V4 Pro |
| DeepSeek V4 Pro 0813 | DeepSeek | 13.95 | 40.92 | 40.9% | 13.9 | single model | DeepSeek V4 Pro 0813 |
| DeepSeek V4.1 Flash | DeepSeek | 4.25 | 30.78 | 30.8% | 4.2 | single model | DeepSeek V4.1 Flash |
| DeepSeek V4.1 Flash 1017 | DeepSeek | 2.05 | 20.65 | 20.7% | 2.0 | single model | DeepSeek V4.1 Flash 1017 |
| Gemini 3 Flash Preview | 9.37 | 59.66 | 59.7% | 9.4 | single model | Gemini 3 Flash Preview | |
| Gemini 3.1 Flash Lite | 6.95 | 42.07 | 42.1% | 6.9 | single model | Gemini 3.1 Flash Lite | |
| Gemini 3.1 Pro Preview | 90.04 | 60.42 | 60.4% | 90.0 | single model | Gemini 3.1 Pro Preview | |
| Gemini 3.5 Flash Lite | 8.52 | 48.76 | 48.8% | 8.5 | single model | Gemini 3.5 Flash Lite | |
| Gemini 3.6 Flash | 27.38 | 58.89 | 58.9% | 27.4 | single model | Gemini 3.6 Flash | |
| Gemini 3.7 Flash | 25.08 | 69.41 | 69.4% | 25.1 | single model | Gemini 3.7 Flash | |
| Gemini 3.8 Flash | 32.67 | 65.39 | 65.4% | 32.7 | single model | Gemini 3.8 Flash | |
| Gemini 4 Argon | 48.44 | 77.82 | 77.8% | 48.4 | single model | Gemini 4 Argon | |
| Gemini 4 Carbon | 75.67 | 77.25 | 77.2% | 75.7 | single model | Gemini 4 Carbon | |
| GLM 4.7 | Zhipu AI | 10.84 | 25.05 | 25.0% | 10.8 | single model | GLM 4.7 |
| GLM 5.1 | Zhipu AI | 12.8 | 38.43 | 38.4% | 12.8 | single model | GLM 5.1 |
| GLM 5.2 | Zhipu AI | 6.71 | 39.2 | 39.2% | 6.7 | single model | GLM 5.2 |
| GLM 5.3 | Zhipu AI | 24.27 | 38.62 | 38.6% | 24.3 | single model | GLM 5.3 |
| GLM 5.3 Flash | Zhipu AI | 4.22 | 36.14 | 36.1% | 4.2 | single model | GLM 5.3 Flash |
| GLM 5.3 Prime | Zhipu AI | 69.86 | 35.18 | 35.2% | 69.9 | single model | GLM 5.3 Prime |
| GPT-5.2 | OpenAI | 29.97 | 31.93 | 31.9% | 30.0 | single model | GPT-5.2 |
| GPT-5.4 Mini | OpenAI | 7.03 | 24.28 | 24.3% | 7.0 | single model | GPT-5.4 Mini |
| GPT-5.4 Nano | OpenAI | 2.85 | 21.03 | 21.0% | 2.8 | single model | GPT-5.4 Nano |
| GPT-5.5 | OpenAI | 75.52 | 44.93 | 44.9% | 75.5 | single model | GPT-5.5 |
| GPT-5.6 Luna | OpenAI | 13.87 | 33.46 | 33.5% | 13.9 | single model | GPT-5.6 Luna |
| GPT-5.6 Sol | OpenAI | 60.83 | 49.9 | 49.9% | 60.8 | single model | GPT-5.6 Sol |
| GPT-5.6 Terra | OpenAI | 30.71 | 39.39 | 39.4% | 30.7 | single model | GPT-5.6 Terra |
| GPT-6 Luna | OpenAI | 1.34 | 38.81 | 38.8% | 1.3 | single model | GPT-6 Luna |
| GPT-6 Luna Pro | OpenAI | 3.91 | 38.24 | 38.2% | 3.9 | single model | GPT-6 Luna Pro |
| GPT-6 Sol | OpenAI | 21.83 | 50.48 | 50.5% | 21.8 | single model | GPT-6 Sol |
| GPT-6 Sol Pro | OpenAI | 59.11 | 50.67 | 50.7% | 59.1 | single model | GPT-6 Sol Pro |
| GPT-6.1 Sol (reference) | OpenAI | 15.45 | 61.19 | 61.2% | 15.4 | single model, run with the routers | GPT-6.1 Sol (reference) |
| GPT-6.1 Sol (text-to-SQL) | OpenAI | 15.91 | 61.38 | 61.4% | 15.9 | single model | GPT-6.1 Sol (text-to-SQL) |
| GPT-6.1 Sol Pro | OpenAI | 44.12 | 59.85 | 59.8% | 44.1 | single model | GPT-6.1 Sol Pro |
| GPT-6.1 Terra | OpenAI | 8.76 | 53.54 | 53.5% | 8.8 | single model | GPT-6.1 Terra |
| GPT-OSS 120B | OpenAI | 0.597 | 19.89 | 19.9% | 0.6 | single model | GPT-OSS 120B |
| Grok 4.3 | xAI | 16.13 | 41.68 | 41.7% | 16.1 | single model | Grok 4.3 |
| Grok 4.5 | xAI | 26.24 | 48.57 | 48.6% | 26.2 | single model | Grok 4.5 |
| Grok 4.6 | xAI | 41.78 | 58.32 | 58.3% | 41.8 | single model | Grok 4.6 |
| Grok 4.7 | xAI | 37.1 | 48.37 | 48.4% | 37.1 | single model | Grok 4.7 |
| HY4 Preview | Tencent | 12.78 | 45.12 | 45.1% | 12.8 | single model | HY4 Preview |
| Kimi K2.6 | Moonshot AI | 19.13 | 43.79 | 43.8% | 19.1 | single model | Kimi K2.6 |
| Kimi K3 | Moonshot AI | 48.24 | 45.32 | 45.3% | 48.2 | single model | Kimi K3 |
| Kimi K3.1 Pro | Moonshot AI | 32 | 49.14 | 49.1% | 32.0 | single model | Kimi K3.1 Pro |
| Llama 4 Maverick | Meta | 6.1 | 28.11 | 28.1% | 6.1 | single model | Llama 4 Maverick |
| MiMo V2.6 Pro | Xiaomi | 4.93 | 38.81 | 38.8% | 4.9 | single model | MiMo V2.6 Pro |
| MiniMax M2.5 | MiniMax | 3.45 | 29.45 | 29.4% | 3.5 | single model | MiniMax M2.5 |
| MiniMax M3 | MiniMax | 4.85 | 34.03 | 34.0% | 4.9 | single model | MiniMax M3 |
| MiniMax M3.1 Flash | MiniMax | 2.71 | 33.84 | 33.8% | 2.7 | single model | MiniMax M3.1 Flash |
| Mistral Large 4.0 | Mistral AI | 18.65 | 26.77 | 26.8% | 18.7 | single model | Mistral Large 4.0 |
| Mistral Small 2603 | Mistral AI | 1.74 | 23.33 | 23.3% | 1.7 | single model | Mistral Small 2603 |
| Muse Ember | Meta | 2.99 | 37.48 | 37.5% | 3.0 | single model | Muse Ember |
| Muse Glimmer 30B | Meta | 6.4 | 31.17 | 31.2% | 6.4 | single model | Muse Glimmer 30B |
| Muse Spark 1.1 | Meta | 27.77 | 39.01 | 39.0% | 27.8 | single model | Muse Spark 1.1 |
| Muse Spark 1.2 | Meta | 39.56 | 45.89 | 45.9% | 39.6 | single model | Muse Spark 1.2 |
| Muse Spark 1.3 | Meta | 38.67 | 43.98 | 44.0% | 38.7 | single model | Muse Spark 1.3 |
| Muse Spark Open | Meta | 27.1 | 41.87 | 41.9% | 27.1 | single model | Muse Spark Open |
| Muse Wonder | Meta | 94.28 | 54.49 | 54.5% | 94.3 | single model | Muse Wonder |
| Nemotron 3 Ultra 550B A55B | NVIDIA | 25.28 | 31.93 | 31.9% | 25.3 | single model | Nemotron 3 Ultra 550B A55B |
| Qwen3.5 27B | Alibaba | 12.49 | 37.28 | 37.3% | 12.5 | single model | Qwen3.5 27B |
| Qwen3.6 27B | Alibaba | 19.48 | 47.8 | 47.8% | 19.5 | single model | Qwen3.6 27B |
| Qwen3.6 Flash | Alibaba | 8.69 | 34.23 | 34.2% | 8.7 | single model | Qwen3.6 Flash |
| Qwen3.7 Plus | Alibaba | 8.88 | 39.77 | 39.8% | 8.9 | single model | Qwen3.7 Plus |
| Qwen3.8 2.4T A95B | Alibaba | 32.28 | 48.76 | 48.8% | 32.3 | single model | Qwen3.8 2.4T A95B |
| Qwen3.8 27B | Alibaba | 14.25 | 43.4 | 43.4% | 14.2 | single model | Qwen3.8 27B |
| Qwen3.8 Flash | Alibaba | 2.5 | 41.68 | 41.7% | 2.5 | single model | Qwen3.8 Flash |
| Qwen3.8 Max | Alibaba | 30.54 | 46.27 | 46.3% | 30.5 | single model | Qwen3.8 Max |
| Qwen3.8 Max 0902 | Alibaba | 31.52 | 36.33 | 36.3% | 31.5 | single model | Qwen3.8 Max 0902 |
| Qwen3.8 Max Prime | Alibaba | 62.91 | 34.99 | 35.0% | 62.9 | single model | Qwen3.8 Max Prime |
| Solar Pro4 | Upstage | 2.14 | 23.33 | 23.3% | 2.1 | single model | Solar Pro4 |
| Tencent HY3 | Tencent | 2.05 | 43.21 | 43.2% | 2.1 | single model | Tencent HY3 |
Pour chacun des 8 routeurs, au moins un modèle seul que nous avons exécuté a obtenu un score aussi élevé ou plus élevé et a coûté autant ou moins par question. Dans le graphique, la zone verte indique les résultats qui coûtent moins que GPT-6.1 Sol et qui ont obtenu un score supérieur à 50 %.
Pour chaque question, l’agent choisit d’abord l’une des 11 bases de données, puis écrit des requêtes SQL contre elle. Il peut appeler un modèle jusqu’à 10 fois par question, et le routeur choisit le modèle pour chaque appel. Un pool est l’ensemble des modèles parmi lesquels un routeur peut choisir.
Scores par routeur
| Label | Label short | CI low | CI high | Score (%) |
|---|---|---|---|---|
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 57.17 | 65.39 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 51.82 | 60.42 | 56.21 |
| OpenRouter Auto Code | Auto Code | 48.37 | 56.98 | 52.77 |
| Not Diamond (19 models) | Not Diamond | 46.46 | 55.07 | 50.86 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 39.96 | 48.37 | 44.17 |
| Fireworks Nexus Auto | Nexus Auto | 31.74 | 40.15 | 35.95 |
| TypeSafe Jev | TypeSafe Jev | 25.62 | 33.27 | 29.45 |
| OpenRouter Auto | OpenRouter Auto | 24.86 | 32.7 | 28.68 |
| Sakana Fugu Max | Fugu Max | 23.52 | 31.36 | 27.34 |
Les 8 routeurs ont obtenu un score clairement inférieur à GPT-6.1 Sol. Switchyard s’en rapproche le plus, à 5.0 points en dessous. Son intervalle à 95 % chevauche celui de Sol, mais le test sur les mêmes questions distingue les deux (voir Statistiques).
Chaque routeur face à son modèle plus utilisé
| Label | Label short | Router score | Alone score | Main model name | Main model short | Main model share | Router | Most used model |
|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 28.7% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 99% | 28.68 | 26.2 |
| TypeSafe Jev | TypeSafe Jev | 29.4% | 26.2% | Claude Haiku 5.5 | Haiku 5.5 | 98% | 29.45 | 26.2 |
| Fireworks Nexus Auto | Nexus Auto | 35.9% | 36.1% | GLM 5.3 Flash | GLM 5.3 Flash | 99% | 35.95 | 36.14 |
| Not Diamond (19 models) | Not Diamond | 50.9% | 49.9% | GPT-5.6 Sol | GPT-5.6 Sol | 100% | 50.86 | 49.9 |
| OpenRouter Auto Code | Auto Code | 52.8% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 71% | 52.77 | 61.19 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 56.2% | 61.2% | GPT-6.1 Sol | GPT-6.1 Sol | 75% | 56.21 | 61.19 |
Parmi les six routeurs qui indiquent leur modèle, quatre ont obtenu un score à moins de 3.3 points de leur modèle plus utilisé. Switchyard a réparti ses appels entre GPT-6.1 Sol et GPT-6 Luna, et Auto Code entre GPT-6.1 Sol et GLM 5.3. Ils ont obtenu respectivement 5.0 et 8.4 points de moins que Sol.
Les routeurs ne partageaient pas le même pool, donc ces écarts reflètent à la fois le routeur et les modèles qu’il pouvait choisir. La section sur le pool partagé compare trois routeurs sur les deux mêmes modèles. Nous avons défini les pools pour Switchyard et Not Diamond (voir Routeurs et pools).
Temps par question
| Label | Label short | Sec label | Seconds |
|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 8.8 s | 8.8 |
| TypeSafe Jev | TypeSafe Jev | 9.0 s | 8.96 |
| OpenRouter Auto Code | Auto Code | 10.4 s | 10.42 |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | 10.7 s | 10.69 |
| Fireworks Nexus Auto | Nexus Auto | 10.8 s | 10.81 |
| Unbiased Pareto 26.10 | Unbiased Pareto | 12.7 s | 12.68 |
| Sakana Fugu Max | Fugu Max | 13.3 s | 13.28 |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | 15.4 s | 15.44 |
| Not Diamond (19 models) | Not Diamond | 17.3 s | 17.28 |
Not Diamond avec 19 modèles et Switchyard ont été les routeurs les plus lents. Ils ont mis 17.3 et 15,4 secondes par question en médiane. GPT-6.1 Sol a mis 10,7 secondes. OpenRouter Auto et Jev ont été les plus rapides, avec 8.8 et 9,0 secondes. Tous deux ont envoyé presque chaque appel à Claude Haiku 5.5.
Les appels d’Auto Code vers GPT-6.1 Sol ont été exécutés sur le niveau prioritaire. Ils ont généré en 1,5 seconde en médiane, contre 1,8 seconde pour GPT-6.1 Sol sans routeur. Le routage via Auto Code a ajouté environ 0,2 seconde par appel. Par question, les deux ont mis à peu près le même temps, 10.4 et 10,7 secondes en médiane.
Coûts et frais des routeurs
| Label | Label short | Total | Per correct | Billed | Computed from list prices |
|---|---|---|---|---|---|
| Fireworks Nexus Auto | Nexus Auto | $1.9 | $5.4 | — | 1.93 |
| OpenRouter Auto | OpenRouter Auto | $2.0 | $6.9 | 1.97 | — |
| TypeSafe Jev | TypeSafe Jev | $2.1 | $7.1 | 2.09 | — |
| Unbiased Pareto 26.10 | Unbiased Pareto | $13.2 | $29.8 | 13.18 | — |
| GPT-6.1 Sol (reference) | GPT-6.1 Sol (ref.) | $15.4 | $25.2 | 15.45 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard | $16.6 | $29.5 | 16.6 | — |
| OpenRouter Auto Code | Auto Code | $24.6 | $46.6 | 24.62 | — |
| Sakana Fugu Max | Fugu Max | $30.0 | $109.6 | 29.96 | — |
| Not Diamond (19 models) | Not Diamond | $50.5 | $99.3 | 43.76 | 6.76 |
Le coût d’un routeur est la facture des modèles plus tout frais de juge ou de sélection. Si une tentative a échoué et que la question a été relancée, nous ne comptons que la dernière tentative. Dans le graphique, les parties rayées sont calculées à partir des grilles tarifaires et le reste provient des factures.
Fireworks Nexus Auto a coûté le moins cher par réponse correcte, 5,4 $ pour 1 000 réponses correctes aux prix catalogue. Parmi les routeurs avec un coût facturé, OpenRouter Auto a coûté le moins cher, 6,9 $.
Certains routeurs ont coûté plus cher que leur modèle plus utilisé. Le surcoût est venu du juge de Switchyard, des frais de sélection de Not Diamond et du niveau prioritaire sur les appels de Auto Code vers GPT-6.1 Sol. Dans chaque cas, le routeur n’a pas obtenu un score clairement supérieur à celui de son modèle plus utilisé.
Coût par rapport aux modèles seuls
Quatre routeurs ont coûté plus cher que GPT-6.1 Sol, qui a obtenu 61,2 % pour 15,4 $ par 1 000 questions. Tous les quatre ont obtenu un score inférieur :
- Not Diamond avec 19 modèles : 50,9 % pour 50,5 $. L’essentiel de ce coût venait de ses appels GPT-5.6 Sol, et ses frais de sélection ont ajouté 6,8 $ (voir Frais et niveaux de prix).
- Sakana Fugu Max : 27,3 %, le score le plus bas des 8 routeurs, pour 30,0 $. Il n’indique pas son modèle. Il a effectué 6.8 appels de modèle par question, contre 5.5 pour GPT-6.1 Sol. Son appel moyen a coûté environ 1.6 fois un appel GPT-6.1 Sol.
- OpenRouter Auto Code : 52,8 % pour 24,6 $. Il a envoyé 71 % des appels à GPT-6.1 Sol, et presque tous ceux-ci ont été exécutés sur le niveau prioritaire de OpenAI (voir Frais et niveaux de prix).
- NVIDIA Switchyard : 56,2 % pour 16,6 $. Ses appels vers GPT-6.1 Sol et GPT-6 Luna ont coûté 13,7 $, moins que les 15,4 $ de Sol. Son modèle juge a ajouté 2,9 $ (voir Frais et niveaux de prix).
Aucun des trois routeurs les moins chers n’a obtenu un score supérieur à GPT-6 Luna, qui a obtenu 38,8 % pour 1,3 $ par 1 000 questions. OpenRouter Auto et TypeSafe Jev ont obtenu environ 10 points de moins, 28,7 % et 29,4 %, pour 2,0 $ et 2,1 $. Fireworks Nexus Auto a obtenu 35,9 % pour 1,9 $, sans différence claire par rapport à Luna.
Frais et niveaux de prix
- Pour choisir un modèle à chaque appel, Switchyard vérifie d’abord les résultats des outils obtenus jusque-là. Les erreurs et les échecs répétés orientent vers le modèle plus fort. Lorsque les résultats des outils ne permettent pas de trancher, comme lors du premier appel d’une question, un petit modèle juge, Gemini 3.5 Flash Lite, lit la question et choisit le modèle.1 Chaque appel de juge est facturé comme un appel de modèle normal. Sur le pool partagé, le juge a ajouté 3,2 $ par 1 000 questions.
- Not Diamond facture des frais pour chaque choix de modèle. Nous avons compté chaque choix à 0,001 $, le prix indiqué sur sa grille tarifaire.2 Sur le pool partagé, les frais ont atteint 6,3 $ par 1 000 questions, soit 40 % du total de 15,8 $ de Not Diamond.
- Auto Code a obtenu le niveau prioritaire d’OpenAI sur presque tous ses appels GPT-6.1 Sol. Il a payé 2.04 fois le prix par appel de GPT-6.1 Sol. OpenRouter indique que le niveau prioritaire d’un modèle fermé ne sert que lorsqu’une requête le demande ou épingle le fournisseur,3 mais nos requêtes n’ont fait ni l’un ni l’autre. Sans ce niveau, Auto Code aurait coûté environ 13 $ par 1 000 questions au lieu de 24,6 $.
Avec 19 modèles, les appels GPT-5.6 Sol de Not Diamond ont coûté 43,8 $ par 1 000 questions, contre 60,8 $ pour GPT-5.6 Sol dans notre benchmark text-to-SQL. Une remise de cache peut expliquer l’écart. Not Diamond a obtenu le prix de cache sur 69,5 % de ses tokens d’entrée. Notre exécution text-to-SQL n’a pas enregistré l’utilisation du cache, nous ne pouvons donc pas le confirmer.
Choix des modèles et changement de modèle
| Label | Label short | Claude Haiku 5.5 | DeepSeek V4.1 Flash | GLM 5.3 | GLM 5.3 Flash | GPT-5.6 Sol | GPT-6 Luna | GPT-6.1 Sol | Other |
|---|---|---|---|---|---|---|---|---|---|
| OpenRouter Auto | OpenRouter Auto | 98.63 | 1.37 | — | — | — | — | — | — |
| TypeSafe Jev | TypeSafe Jev | 98.29 | 1.03 | 0.3206 | — | — | — | 0.1425 | 0.2138 |
| Fireworks Nexus Auto | Nexus Auto | — | — | 1.15 | 98.85 | — | — | — | — |
| Not Diamond (19 models) | Not Diamond, 19 models | — | — | — | — | 100 | — | — | — |
| OpenRouter Auto Code | Auto Code | — | — | 29.43 | — | — | — | 70.57 | — |
| NVIDIA Switchyard (Sol + Luna) | Switchyard, Sol + Luna | — | — | — | — | — | 25.02 | 74.98 | — |
Sur les 9 exécutions de routeurs avec réglages par défaut qui indiquent le modèle, cinq ont envoyé au moins 98 % de leurs appels à un seul modèle. Il s’agissait de OpenRouter Auto sur son propre pool, de Jev, de Nexus Auto et de Not Diamond sur les deux pools.
La liste de 19 modèles de Not Diamond contenait aussi Gemini 3 Flash Preview, qui a obtenu 59,7 % pour 9,4 $ par 1 000 questions. Aucun des choix de Not Diamond n’est allé vers Gemini 3 Flash Preview. Tous les appels sont allés à GPT-5.6 Sol, qui a obtenu 49,9 %.
Changement de modèle au sein d’une question
Aux réglages par défaut, seul Switchyard a changé de modèle dans plus de 5 % des questions. Il l’a fait dans 308 des 523 questions avec GPT-6.1 Sol et GPT-6 Luna, et dans 35 questions sur le pool partagé.
Chaque question a été exécutée comme une seule session de routeur, avec la même clé de session à chaque appel. OpenRouter recommande la Switchyard documentation et la Pareto documentation pour les agents. Une clé de session n’empêche pas un routeur de changer de modèle. La plupart des routeurs peuvent choisir un modèle à chaque appel. OpenRouter a indiqué dans la documentation Auto qu’un changement coûte plus cher, car le nouveau modèle doit reconstruire le cache de prompt. Auto ne change donc que lorsque cela en vaut la peine. Fireworks a indiqué dans la documentation Nexus Auto qu’elle choisit un modèle pour chaque nouveau message utilisateur et le conserve pour les appels d’outils de ce message. Notre agent envoie un message utilisateur avec la question et un second qui demande la réponse finale. Les 9 changements de Nexus Auto ont eu lieu à ce second message.
Comparaison avec un mélange aléatoire
Nous avons comparé Switchyard sur les deux pools et Auto Code avec un mélange aléatoire. Le mélange aléatoire répond à chaque question avec un seul modèle, choisi au hasard selon la part d’appels du routeur. Son score attendu provient de nos exécutions de modèles seuls.
Switchyard avec Sol et Luna a obtenu 56,2 %, contre 55,7 % pour son mélange aléatoire. Switchyard sur le pool partagé a obtenu 55,1 % contre 52,4 %. Auto Code a obtenu 52,8 % contre 54,7 %. Aucun des trois routeurs n’a fait clairement mieux ni moins bien que son mélange aléatoire.
Trois routeurs avec un seul pool
| Label | Label short | Cost label | Same two models, three routers |
|---|---|---|---|
| Not Diamond, cost setting | Not Diamond, cost | $12.8 | 59.66 |
| Gemini 3 Flash Preview (no router) | Gemini (no router) | $9.4 | 59.66 |
| Not Diamond, default setting | Not Diamond, default | $15.8 | 59.27 |
| NVIDIA Switchyard | Switchyard | $11.2 | 55.07 |
| OpenRouter Auto | OpenRouter Auto | $3.4 | 32.89 |
| DeepSeek V4 Flash (no router) | DeepSeek (no router) | $2.9 | 30.4 |
Pour séparer les modèles du routage, nous avons donné aux trois routeurs les deux mêmes modèles. Gemini 3 Flash Preview est le modèle fort, et DeepSeek V4 Flash est le modèle bon marché.
Résultats du pool partagé
Aux réglages par défaut, aucun routeur n’a montré une différence claire par rapport à son modèle plus utilisé, et aucun n’a obtenu un score supérieur à Gemini 3 Flash Preview.
Not Diamond a obtenu 1.9 point de moins que GPT-6.1 Sol, et Switchyard 6.1 points de moins. Notre test n’a pas confirmé ces écarts.
- À son réglage par défaut, Not Diamond a envoyé 100 % des appels à Gemini 3 Flash Preview. Il a obtenu 59,3 % contre 59,7 % pour Gemini 3 Flash Preview. Il a coûté 15,8 $ par 1 000 questions contre 9,4 $.
- Avec son réglage de coût, Not Diamond a envoyé 62 % des appels à DeepSeek V4 Flash. Il a tout de même donné chaque réponse finale avec Gemini 3 Flash Preview. Il a obtenu 59,7 %, soit le même score que Gemini 3 Flash Preview, pour 12,8 $ contre 9,4 $. Ses frais de sélection, 7,5 $, ont été supérieurs au coût de ses appels de modèle.
- Switchyard a envoyé 75 % des appels à Gemini 3 Flash Preview et a obtenu 55,1 %, sans différence claire par rapport à Not Diamond.
- Auto a envoyé 97 % des appels à DeepSeek V4 Flash et a obtenu 32,9 %, proche des 30,4 % de DeepSeek V4 Flash.
Adéquation du modèle et limite d’appels
Nous n’avons trouvé aucun signe clair qu’un routeur ait choisi le modèle adapté à la question sur ce pool. Il y a 170 questions que Gemini 3 Flash Preview résout et que DeepSeek V4 Flash manque, et 17 où l’inverse se produit. Chaque routeur a envoyé une part similaire de ses appels à DeepSeek V4 Flash dans les deux ensembles, avec au plus 10 points d’écart. L’ensemble de 17 est trop petit pour montrer une petite différence.
Auto a atteint la limite de 10 appels le plus souvent, sur 37,3 % des questions, contre 18,9 % pour Switchyard et 16,8 % pour Not Diamond.
OpenRouter Auto a aussi été le plus long sur ce pool, avec 17,5 secondes par question en médiane. Not Diamond a mis 9,0 secondes sur les deux mêmes modèles.
Chaque routeur en bref
Not Diamond
Le routeur par défaut de Not Diamond est pré-entraîné, vous n’avez donc pas besoin de l’entraîner avant de l’utiliser. Vous pouvez aussi entraîner un routeur personnalisé sur vos propres données.4 Not Diamond n’appelle pas le modèle. Il renvoie le nom du modèle qu’il choisit, puis votre propre code appelle ce modèle. Les autres routeurs effectuent eux-mêmes l’appel. Par défaut, Not Diamond choisit pour la qualité. Un paramètre de compromis sur chaque requête peut lui faire privilégier plutôt le coût ou la latence.5 Nous avons utilisé le routeur par défaut et exécuté une fois son réglage de coût, sur le pool partagé.
NVIDIA Switchyard
Switchyard fonctionne sur OpenRouter. Vous listez jusqu’à trois modèles, et il choisit entre le moins cher et le plus cher d’entre eux. Il n’ajoute aucun frais de routage propre.1
OpenRouter Auto
OpenRouter Auto choisit un modèle et un niveau de raisonnement pour chaque requête et n’ajoute aucun frais.6 Une liste dans `allowed_models` constitue une limite stricte, et un niveau de coût low, medium ou high définit la politique. La documentation indique que le réglage par défaut coûte plus cher que l’ancien Auto et suggère le niveau low pour maintenir des coûts plus proches de celui-ci. Lors de notre test, le niveau low a obtenu 28,3 % contre 28,7 % pour le réglage par défaut, pour le même coût de 2,0 $ par 1 000 questions, sans différence claire.
OpenRouter Auto Code
Auto Code fonctionne sur le même moteur qu’Auto, avec une politique adaptée aux agents de codage, et n’ajoute aucun frais.7 Il préfère modifier le niveau de raisonnement plutôt que de changer de modèle, afin de conserver le cache de prompt. Il traite `allowed_models` comme une limite stricte. Lorsque nous lui avons donné le pool partagé, chaque requête a échoué avec une erreur indiquant qu’aucun modèle mesuré ne satisfaisait la requête.
TypeSafe Jev
Jev choisit un modèle et un niveau de raisonnement pour chaque requête, et chaque requête est facturée au prix du modèle vers lequel elle est envoyée.8 Une liste de modèles n’est qu’une préférence, et seul `excluded_models` bloque un modèle.9 Son score n’a montré aucune différence claire par rapport à OpenRouter Auto. Au 14 novembre 2026, la page du benchmark de routeurs d’OpenRouter indique qu’Auto est désormais propulsé par Jev.10
Fireworks Nexus Auto
Nexus Auto est un routeur Fireworks, appelé avec l’identifiant de modèle auto. Il n’accepte aucune liste de modèles. Avec une clé Fireworks, il choisit parmi les modèles ouverts Fireworks.11
Unbiased Pareto 26.10
OpenRouter répertorie Unbiased Pareto 26.10 à 0,80 $ par million de tokens d’entrée et 3,20 $ par million de tokens de sortie.12 Il n’accepte aucune liste de modèles, et la page n’indique pas comment il choisit un modèle ni quels modèles il utilise. Ses réponses ne mentionnent que le routeur. Il a obtenu 44,2 % pour 13,2 $ par 1 000 questions, un score inférieur et un coût plus élevé que Gemini 3 Flash Preview.
Sakana Fugu Max
Sakana indique que Fugu Max fonctionne avec son plus grand pool de modèles. Le pool est fixe, et Sakana n’en répertorie pas tous les membres. Il coûte 2 $ par million de tokens d’entrée et 6 $ par million de tokens de sortie, plus 0,007 $ pour chaque appel d’outil web interne.13
Méthodologie du benchmark des routeurs agentiques
Chaque routeur a reçu le même agent, le même prompt, les mêmes outils et le même ordre de questions. Un proxy local a enregistré le modèle, les tokens, le coût et la durée de chaque appel.
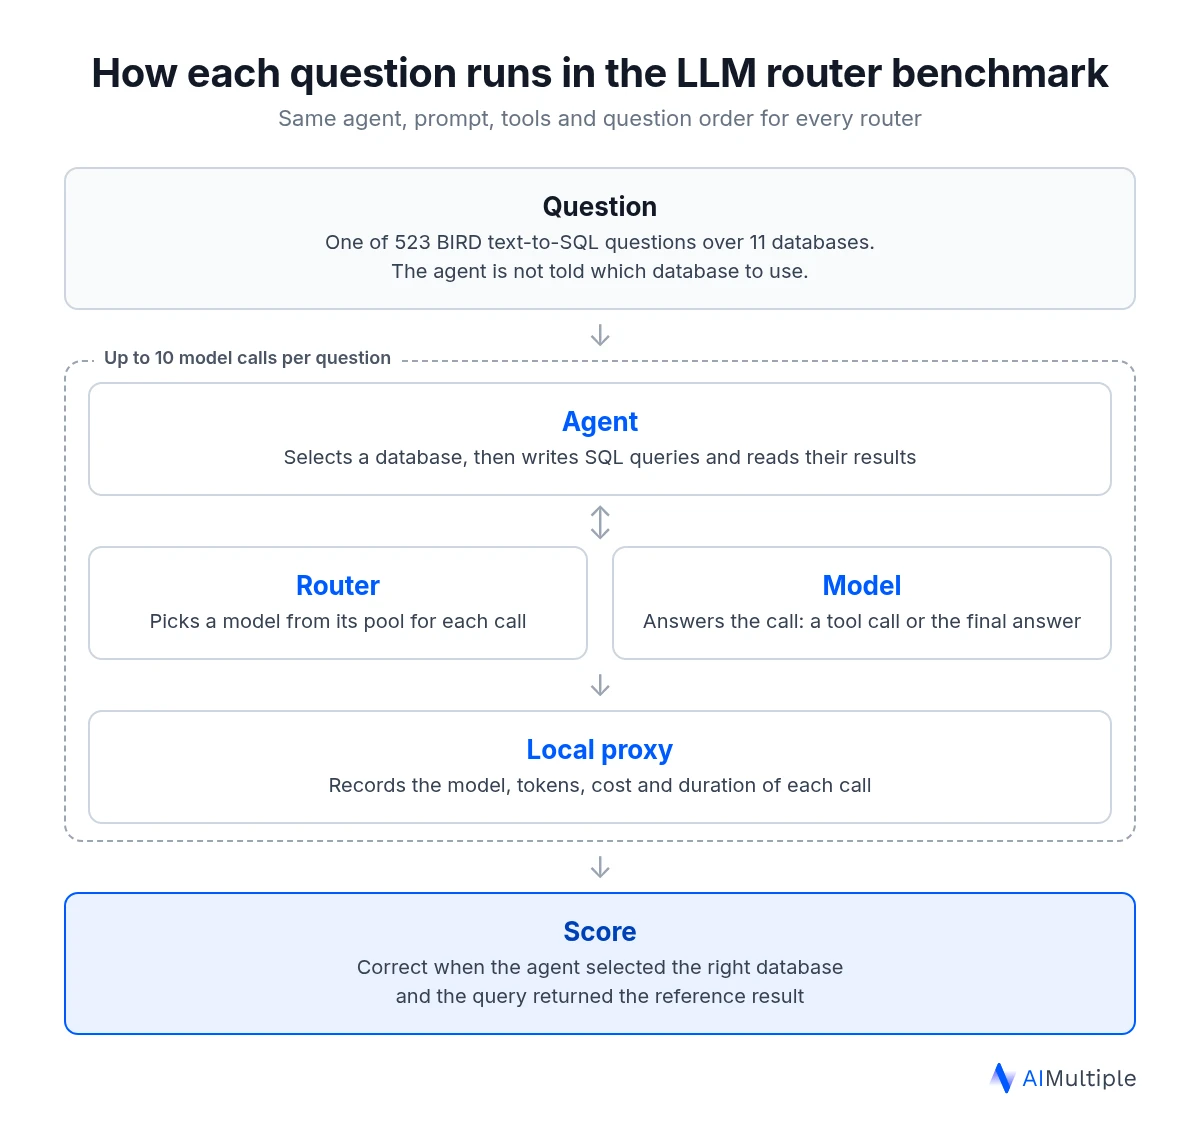
Nous avons utilisé 523 questions de notre benchmark text-to-SQL, qui s’appuie sur BIRD, un jeu de données public text-to-SQL. L’agent ne sait pas laquelle des 11 bases de données utiliser, et les noms des bases de données sont remplacés par des alias. Une question est considérée comme correcte lorsque l’agent choisit la bonne base de données et que sa requête renvoie le résultat de référence. Une erreur est comptée comme un échec. Chaque requête peut durer jusqu’à 600 secondes.
Nous avons appelé six routeurs via OpenRouter avec les identifiants openrouter/auto, openrouter/auto-code, typesafe/jev-router, nvidia/switchyard, unbiased/pareto-26.10 et sakana/fugu-max. Not Diamond a fonctionné via son API modelSelect, et nous avons appelé chaque modèle qu’il choisissait via OpenRouter. Fireworks Nexus Auto a fonctionné via l’API Fireworks. Nous avons également exécuté GPT-6.1 Sol sans routeur dans la même configuration. Les scores des autres modèles seuls proviennent de notre benchmark text-to-SQL sur les mêmes 523 questions.
Le temps est la médiane des secondes par question, mesurée de notre côté sur toutes les étapes de l’agent. Chaque routeur et chaque pool ont été exécutés une seule fois, du 13 au 16 novembre 2026. Chaque question s’est terminée sans erreur.
Routeurs et pools
Nous avons inclus les routeurs qui disposaient d’une API publique au moment de l’exécution et qui acceptaient les appels d’outils. OpenRouter Auto et Auto Code ont été exécutés après le 6 novembre 2026, lorsque OpenRouter a reconstruit Auto et lancé Auto Code.14
Six routeurs ont été exécutés sur leur propre pool avec les réglages par défaut du fournisseur. Nous avons défini le pool pour Switchyard et Not Diamond. Sans liste de modèles, Switchyard prend deux des 20 modèles ayant les dépenses les plus élevées sur OpenRouter au cours des sept derniers jours, de sorte que la paire change au fil du temps. Pour que la paire reste fixe, nous lui avons donné GPT-6.1 Sol et GPT-6 Luna. Not Diamond exige une liste de modèles. Nous lui avons donné 19 modèles qu’il prend en charge et que nous avons également testés dans notre benchmark text-to-SQL.
Pour comparer le routage sur les mêmes modèles, nous avons exécuté Not Diamond, NVIDIA Switchyard et OpenRouter Auto sur un pool partagé. Ces exécutions ne sont pas classées.
Un routeur ne pouvait participer que s’il respectait la liste de modèles que nous lui avions donnée. Not Diamond ne prend pas en charge GPT-6.1 Sol ni GPT-6 Luna, la paire utilisée plus haut par Switchyard. Nous avons donc choisi Gemini 3 Flash Preview et DeepSeek V4 Flash, un modèle fort et un modèle bon marché qu’il prend en charge.15 Switchyard et OpenRouter Auto ont accepté la même liste. Les cinq autres routeurs n’ont pas pu être contraints à cette liste (voir Chaque routeur en bref).
Nous avons également testé OpenRouter Pareto Code, mais ne l’avons pas classé. L’utilisateur choisit l’un des trois niveaux. Au sein d’un niveau, il envoie les appels au modèle disponible le moins cher et n’adapte pas son choix à chaque tour.
Le 13 novembre, le niveau par défaut de Pareto Code ne contenait qu’un seul modèle, Claude Fable 5.2. Au niveau Medium que nous avons choisi, Pareto Code a envoyé les 3 083 appels à Kimi K3 et a obtenu 43,0 % pour 28,4 $ par 1 000 questions.
Statistiques
Les crochets dans le graphique des scores montrent un intervalle de confiance à 95 %, calculé par bootstrap sur les 523 questions. Cela montre à quel point un score dépend des questions choisies.
Pour comparer deux résultats sur les mêmes questions, nous avons utilisé un test exact de McNemar. Il ne compte que les questions pour lesquelles un résultat était correct et l’autre incorrect. Comme nous avons effectué de nombreuses comparaisons, nous avons ajusté les résultats avec la méthode de Holm à un niveau de 5 %. Lorsque le test ne distingue pas deux résultats, nous disons qu’il n’y a pas de différence claire.
Par exemple, Switchyard sur le pool partagé était 6.1 points en dessous de GPT-6.1 Sol, sans différence claire. Avec Sol et Luna, il était 5.0 points en dessous, et cet écart est clair. Sur le pool partagé, Switchyard et Sol se sont départagés sur 146 questions, où l’un était correct et l’autre incorrect. Avec Sol et Luna, ils ne se sont départagés que sur 44 questions. Lorsque davantage de questions se départagent, un écart doit être plus grand avant que nous le considérions comme clair.
Les comparaisons de routeurs avec GPT-6.1 Sol utilisent son exécution à 61,2 % dans la même configuration que les routeurs. Les mélanges aléatoires et les autres comparaisons de modèles seuls utilisent l’exécution de Sol à 61,4 % issue de notre benchmark text-to-SQL. Dans le premier graphique, elle est étiquetée GPT-6.1 Sol (text-to-SQL). Il n’y a pas de différence claire entre les deux exécutions.
Limitations
- Une seule exécution par routeur et par pool. Au cours des deux exécutions de GPT-6.1 Sol, 33 questions étaient correctes dans une exécution et incorrectes dans l’autre.
- Un seul type de tâche, avec jusqu’à 10 appels de modèle par question. Des tâches d’agent plus longues peuvent donner d’autres résultats.
- Les choix de modèles changent avec la date. Nous avons réexécuté 17 questions sur OpenRouter Auto, Auto Code et Jev le 17 novembre, quatre jours après le début de leurs exécutions. Les routeurs ont choisi deux modèles que nous n’avions pas vus lors de ces exécutions. Auto Code a envoyé 63 % de ses appels à l’un d’eux.
- La limite de 10 appels a touché Sakana Fugu Max sur 16,1 % des questions. Même s’il avait répondu correctement à toutes ces questions, il aurait tout de même obtenu un score inférieur à GPT-6.1 Sol.
- Les pools autres que les trois que nous avons définis peuvent donner d’autres résultats.
- Les frais de sélection de Not Diamond utilisent 0,001 $ par choix, le tarif figurant sur son ancienne page de prix. Sa page actuelle facture plutôt 0,05 $ par million de tokens routés.
- Les questions proviennent des ensembles publics de BIRD, de sorte que les modèles ont peut-être vues lors de l’entraînement.
 Ajouter comme source préférée
FAQ
Un LLM routeur se situe entre une application et un ensemble de modèles et choisit un modèle pour chaque requête. L’objectif est d’envoyer le travail facile à un modèle bon marché et le travail difficile à un modèle fort. Dans un agent, une question entraîne plusieurs appels, de sorte qu’un routeur peut choisir un autre modèle à chaque appel.
Parmi les 8 routeurs, NVIDIA Switchyard a obtenu le score le plus élevé, 56,2 %. OpenRouter Auto Code a obtenu 52,8 % et Not Diamond avec 19 modèles a obtenu 50,9 %. Il n’y a pas de différence claire entre Switchyard et Auto Code, ni entre Auto Code et Not Diamond.
Sur le pool partagé, Not Diamond a obtenu 59,3 %, le score le plus élevé de tous les routeurs à son réglage par défaut. Switchyard a obtenu 55,1 % sur ce pool, sans différence claire par rapport à Not Diamond.
Pas dans ce test. Chacun des 8 routeurs a obtenu un score clairement inférieur à GPT-6.1 Sol.
Sur le pool partagé, Not Diamond était 1.9 point en dessous de GPT-6.1 Sol et Switchyard 6.1 points en dessous. Notre test n’a pas confirmé ces écarts.
Fireworks Nexus Auto a eu le coût le plus bas, 1,9 $ par 1 000 questions, calculé à partir des prix catalogue. OpenRouter Auto a coûté 2,0 $ et TypeSafe Jev 2,1 $. Chacun a envoyé presque chaque appel à un seul modèle bon marché : Claude Haiku 5.5 pour OpenRouter Auto et TypeSafe Jev, et GLM 5.3 Flash pour Nexus Auto.
Not Diamond a obtenu 59,3 % sur le pool partagé et 50,9 % avec 19 modèles. OpenRouter Auto a obtenu 32,9 % sur le pool partagé et 28,7 % sur son propre pool. Switchyard a obtenu 56,2 % avec GPT-6.1 Sol et GPT-6 Luna et 55,1 % sur le pool partagé, soit un écart de 1.1 point sans différence claire.
Lectures complémentaires
Citer cette recherche
Choisissez le format qui correspond à votre lieu de publication. Coller la version avec lien dans votre CMS préserve le lien retour.
@misc{yila2026,
  author = {Yıla, Berkay},
  title  = {{LLM Routeur Benchmark: 8 routeurs sur 523 tâches de base de données agentiques}},
  year   = {2026},
  month  = nov,
  howpublished    = {\url{https://aimultiple.com/llm-router}},
  note   = {AIMultiple. Consulté le 18 novembre 2026}
}Résultats et horodatages de 135 points de données. Téléchargez les données de synthèse présentées dans les graphiques et les tableaux de cet article sous forme de fichier ZIP contenant 7 fichiers CSV.
Vous voulez les données détaillées derrière ? Rejoindre Premium
Liens de référence





Soyez le premier à commenter
Votre adresse courriel ne sera pas publiée. Tous les champs sont obligatoires. Les commentaires sont laissés dans leur langue d'origine.