


20 Yapay Zeka İyileştirme Stratejileri ve Örnekler

Yapay zeka modelleri; veriler, kullanıcı davranışları ve gerçek dünya koşulları geliştikçe sürekli iyileştirme gerektirir. İyi performans gösteren modeller bile öğrendikleri kalıplar mevcut girdilerle artık eşleşmediğinde sapma gösterebilir; bu da doğruluğun azalmasına ve güvenilmez tahminlere yol açar.
Düzenlemelerdeki, ürün gereksinimlerindeki veya müşteri beklentilerindeki değişiklikler, mevcut modellerin ele almak üzere tasarlanmadığı yeni kısıtlar da getirebilir.
Bu nedenle model kalitesini korumak; modeli destekleyen verileri ve davranışını şekillendiren algoritmaları güçlendirmeyi, sistemlerin güncelliğini yitirmiş varsayımlar yerine günümüz gereksinimleriyle uyumlu kalmasını sağlamayı içerir.
Temel stratejileri keşfedin; veri besleme, veri ve algoritma iyileştirme ile yapay zeka ölçekleme yasaları dahil olmak üzere bu stratejiler yapay zeka modellerinizin güncel ve kullanışlı kalmasını sağlayacaktır.
Yapay zeka modelinizi iyileştirmenin en iyi 20 yolu
Yapay zeka modelinizi geliştirmeye yönelik yöntemleri 4 farklı kategoride açıkladık:
Yöntem | Açıklama | Temel Zorluklar |
|---|---|---|
Daha fazla veri besleme | Kapsamı ve genellemeyi iyileştirmek için yüksek kaliteli gerçek veya sentetik veriler ekleyin. | Veri kalitesini sağlamak, önyargıdan kaçınmak, gizlilik ve erişim sınırlarını yönetmek. |
Veriyi iyileştirme | Gürültüyü ve önyargıyı azaltmak için etiketlemeyi, çeşitliliği ve artırmayı iyileştirin. | Kalite ile miktarı dengelemek, dataset önyargısını azaltmak, notlamaları tutarlı tutmak. |
Algoritmayı iyileştirme | Daha iyi mimariler, fine-tuning teknikleri ve dağıtım uygulamaları kullanın. | Daha yüksek karmaşıklık ve maliyet, istenmeyen davranışlar, sıkı gizlilik ihtiyaçları. |
Yapay zekanın ölçekleme yasaları | Ölçeği, hesaplamayı, verimliliği ve retrieval veya multi-agent tekniklerini artırın. | Azalan getiriler, hesaplama sınırları, çevresel etki, entegrasyon karmaşıklığı. |
Daha fazla veri besleme
Yeni ve güncel veriler eklemek, makine öğrenimi modelinizin doğruluğunu artırmanın en yaygın ve etkili yöntemlerinden biridir. Araştırmalar, dataset boyutu ile yapay zeka modeli doğruluğu arasında pozitif bir ilişki olduğunu göstermiştir.1
Dolayısıyla, modelin yeniden eğitimi için kullanılan dataset'i genişletmek, AI/ML modellerini geliştirmenin etkili bir yolu olabilir. Verilerin dağıtıldığı ortama göre değiştiğinden emin olun. Uygun veri toplama kalite güvence uygulamalarına uymak da çok önemlidir.
1. Veri toplama
Veri toplama/elde etme, dataset'inizi genişletmek ve AI/ML modeline daha fazla veri beslemek için kullanılabilir. Bu süreçte modeli yeniden eğitmek için yeni veriler toplanır. Bu veriler şu yöntemlerle elde edilebilir:
- Özel toplama
- Otomatik veri toplama
- Özel kitle kaynak kullanımı
Yapay zeka için başarılı bir şekilde veri toplamak isteyen işletmeler şunlara dikkat etmelidir:
- Etik sorunlardan kaçınmak için veri toplamadaki etik ve yasal hususlara uyulmalıdır.
- Önyargı, eğitim verilerinde istenmeyen yapay zeka sonuçlarına yol açabilir.
- Ham verilerin ön işlenmesi, kalite sorunlarını ele almak ve AI/ML eğitimi için veri bütünlüğünü sağlamak açısından çok önemlidir.
- Hassasiyet ve gizlilik düzenlemeleriyle ilgili kısıtlamalar nedeniyle tüm verilere kolayca erişilemez.
Veri toplama yöntemleri. hakkında daha fazla bilgi edinin.
Veri toplama zahmetine girmeden ilgili dataset'leri elde etmek ve etik ile yasal sorunlardan kaçınmak için bir yapay zeka veri hizmetiyle çalışmanız da önerilir.
2. Üretken modellerle sentetik veri
Üretken yapay zeka, sentetik veri oluşturmayı ilerleterek gerçek dünya koşullarını taklit eden yüksek kaliteli dataset'ler üretmektedir. Büyük dil modelleri ve difüzyon modelleri artık gerçek verilerin sınırlı olduğu alanlarda modelleri eğitmek için yapılandırılmış ve yapılandırılmamış veriler üretebilmektedir.
Örnekler şunlardır:
- Sağlık hizmetlerinde makine öğrenimi modellerini geliştirmek için nadir tıbbi vakalar üretmek.
- Doğal dil işleme sistemlerini geliştirmek için gerçekçi konuşma verileri üretmek.
- Görüntü çözünürlüğünü, fotoğraf kalitesini veya görüntü tanıma modellerini test etmek için görsel dataset'ler oluşturmak.
Sentetik kendi kendine oyun ve sentetik eğitim verileri
Sentetik kendi kendine oyun, modellerin veya ajanların görevlerle veya birbirleriyle etkileşime girmesine izin vererek yeni eğitim verileri üretir. Bu destekleyiciler sınırlı yüksek kaliteli insan verisine sahiptir.
Bu yöntem şunları sağlar:
- Talimat, akıl yürütme veya diyalog verilerinin ölçeklenebilir üretimi.
- Elle toplanması nadir veya pahalı olan senaryoların kapsanması.
- Veri kıtlığının temel kısıt olduğu alanlarda model performansının iyileştirilmesi.
Gerçek yaşam örneği: Chatbot'lar için daha fazla veri
BT destek için kullanılan bir chatbot, kullanıcı sorularını doğru şekilde anlamakta ve sınıflandırmakta zorlanıyordu. Performansını artırmak için 500 BT destek sorgusu yedi dilde birden fazla varyasyona yeniden yazıldı.
Bu ek veriler, chatbot'un farklı soru biçimlerini tanımasına yardımcı olarak daha etkili yanıt verme yeteneğini geliştirdi.
Veriyi iyileştirme
Mevcut verilerin iyileştirilmesi de gelişmiş bir AI/ML modeliyle sonuçlanabilir.
Artık yapay zeka çözümleri daha karmaşık sorunları ele aldığından, bunları geliştirmek için daha iyi ve daha çeşitli veriler gerekiyor. Örneğin, nesne tespit sistemlerinin iki nesne arasındaki etkileşimleri anlamasına yardımcı olan bir derin öğrenme modeliyle ilgili araştırma2, modelin 3 dataset önyargısına duyarlı olduğu ve sonuç üretmek için çeşitli bir dataset gerektirdiği sonucuna varıyor.
İyileştirmeler şunlarla sağlanabilir:
3. Veriyi zenginleştirme
Dataset'i genişletmek yapay zekayı iyileştirmenin bir yoludur. AI/ML modellerini geliştirmenin bir diğer önemli yolu da verileri zenginleştirmektir. Bu, dataset'i genişletmek için toplanan yeni verilerin modele beslenmeden önce işlenmesi gerektiği anlamına gelir.
Bu, mevcut dataset'in notlanmasının iyileştirilmesi anlamına da gelebilir. Yeni ve geliştirilmiş etiketleme teknikleri geliştirildiğinden, model doğruluğunu artırmak için mevcut veya yeni toplanan dataset üzerinde uygulanabilirler.
4. Veri kalitesini iyileştirme
Veri kalitesini iyileştirmek, yapay zeka sistemlerini ilerletmek ve yapay zeka modellerinin performansını artırmak için çok önemlidir. Yapay zeka ilerlemeleri genellikle daha iyi algoritmaları ve daha fazla hesaplama gücünü vurgulasa da yüksek kaliteli eğitim verileri optimum performans için kritik olmaya devam etmektedir.
Veri odaklı bir yaklaşım benimsemek, eğitim için kullanılan verilerin bol ve yüksek kaliteli olmasını sağlayarak yapay zeka ilerlemesini hızlandırmaya yardımcı olur.
Yüksek kaliteli verilerin toplanması ve seçilmesi, geliştiricilerin daha verimli ve etkili yapay zeka modelleri oluşturmasını sağlar; bu modeller daha sonra çeşitli sektörlerdeki karmaşık görevleri çözmek için kullanılabilir. İşletmeler veri kalitesine odaklanarak daha doğru tahminler yapabilir, önyargıyı azaltabilir ve yapay zeka sistemlerinin yeteneklerini geliştirebilir.
Veri kalitesi, veri toplama aşamasında önemli ölçüde iyileştirilebilir. Bu süreç; önyargıyı ortadan kaldırmak, gürültüyü azaltmak ve tüm ilgili değişkenleri yakalayacak kadar çeşitli olduğundan emin olmak için verilerin modelin karşılaşacağı gerçek dünya senaryolarını temsil etmesini sağlamayı içerir.
Ayrıca, veri etiketlemede tutarlılığı korumak ve dataset'teki boşlukları gidermek, modelin öğrenme sürecindeki hataları azaltmaya yardımcı olabilir.
5. Veri artırmadan yararlanma
Bazı kişiler artırılmış verileri sentetik verilerle karıştırabilir; ancak bu iki terim farklıdır. Artırılmış veri, mevcut bir dataset'e bilgi eklemeyi ifade ederken, sentetik veri gerçek verilerin yerine geçmek üzere yapay olarak üretilir.
Algoritmayı iyileştirme
Bazen model için başlangıçta oluşturulan algoritmanın iyileştirilmesi gerekir. Bu, modelin dağıtıldığı popülasyondaki değişiklik de dahil olmak üzere farklı nedenlerden kaynaklanabilir.
Bir hastanın sağlık riskini değerlendiren ve gelir düzeyi parametresini içermeyen dağıtılmış bir AI/ML algoritmasının aniden daha düşük gelir düzeyine sahip hastaların verilerine maruz kaldığını varsayalım. Bu durumda adil değerlendirmeler üretmesi olası değildir.
Bu nedenle algoritmayı yükseltmek ve ona yeni parametreler eklemek, model performansını iyileştirmenin etkili bir yolu olabilir. Algoritma şu yollarla iyileştirilebilir:
6. Mimariyi iyileştirme
Bir algoritmanın mimarisini iyileştirmek için yapılabilecek birkaç şey vardır. Bunun bir yolu, SIMD talimatları veya GPU'lar gibi modern donanım özelliklerinden yararlanmaktır.4
Ayrıca, cache dostu veri düzenleri ve verimli algoritmalar kullanılarak veri yapıları ve algoritmalar iyileştirilebilir. Son olarak algoritma geliştiricileri, makine öğrenimi ve optimizasyon tekniklerindeki yeni gelişmelerden yararlanabilir.
Transformer, dizi verilerinin daha verimli ve etkili modellenmesini sağlayarak doğal dil işleme (NLP) ve diğer alanları değiştiren bir derin öğrenme mimarisidir. “Attention Is All You Need” başlıklı makalede tanıtılan5, büyük ölçüde self-attention adı verilen bir mekanizmaya dayanır ve RNN'ler ile CNN'ler gibi önceki modellerde kullanılan yinelemeli ve evrişimsel işlemlerin yerini alır.
Bir Transformer, her biri birden fazla yığılmış katmandan oluşan bir Encoder ve Decoder'dan oluşur:
- Encoder girdi dizilerini; token ilişkilerini yakalamak için çok başlı self-attention, işleme için ileri beslemeli ağlar ve kararlılık için katman normalizasyonlu artık bağlantılar kullanarak bağlama duyarlı temsillere dönüştürür.
- Decoder çıktı dizilerini token üretir; gelecekteki token erişimini önlemek için maskelenmiş çok başlı self-attention, Encoder çıktılarını entegre etmek için cross-attention ve verimli öğrenme için benzer ileri beslemeli ve normalizasyon mekanizmalarını kullanır.
7. Hibrit model mimarileri
Hibrit model mimarileri Transformer'lar, durum-uzay modelleri ve diğer dizi işleme yöntemlerinden öğeleri birleştirir. Bu yaklaşım uzun ömürlü bağlamı destekler ve hesaplama gereksinimlerini azaltır.
Başlıca avantajları şunlardır:
- Uzun dizilerin daha verimli işlenmesi.
- Eğitim ve inference için daha az bellek kullanımı.
- Hem veri merkezi hem de uç ortamlarla uyumluluk.
Gerçek yaşam örneği: Kimi K2.5
Kimi K2.5, yaklaşık 15 trilyon karma görsel ve metin token'ı üzerinde önceden eğitilmiş, Moonshot AI tarafından geliştirilen açık kaynaklı ajanik bir yapay zeka modelidir.
Kimi K2.5’ın tasarımı, görme ve dil anlayışını ajanik akıl yürütmeyle birleştirir; hem anında hem de “düşünme” modları sunar ve konuşmaya dayalı ve otonom ajan iş akışlarını destekler.6
Temel özellikler şunlardır:
- Doğal çok modluluk: Metin, görüntüler ve video üzerinde birleşik bir modelde işlem yapar ve akıl yürütür.
- Görme destekli kodlama: Görsel girdilerden kod üretebilir ve çıktıları görsel belirtimlerle hizalayabilir.
- Agent Swarm yürütme: Koordineli görev ayrıştırmayı destekler; karmaşık iş akışları için ajanik süreçlerin paralel olarak çalışmasını sağlar.
8. Özellik yeniden mühendisliği
Bir algoritmanın özellik yeniden mühendisliği, onu daha verimli ve etkili hale getirmek için algoritmanın özelliklerini iyileştirme sürecidir. Bu, algoritmanın yapısını değiştirerek veya parametrelerine ince ayar yaparak gerçekleştirilebilir.
9. Çok modlu dünya modelleri
Çok modlu dünya modelleri metin, görüntüler, ses, video, yapılandırılmış veriler ve sensör girdilerinden öğrenir. Bu, modaliteler arasında birleşik bir temsil oluşturur.
Önemli hususlar şunlardır:
- Gerçek dünya bilgilerine daha iyi dayanma.
- Sahnelerin, sinyallerin ve çok biçimli girdilerin daha doğru yorumlanması.
- Modaliteler arasında bütünleşik anlayış gerektiren görevlere uygulanabilirlik.
Gerçek yaşam örneği: DeepMind
Google DeepMind, daha iyi performans için mimarilerini optimize ederek ve çeşitli bileşenleri yeniden yapılandırarak yapay zeka modellerinde önemli iyileştirmeler yaptı. Örneğin Gemini modeli, metin, ses ve görüntüler genelindeki görevleri daha etkili şekilde ele almasını sağlayan çok modlu bir mimariyle oluşturuldu.
Ayrıca PaLM 2, akıl yürütme görevlerini iyileştirmek için hesaplama açısından optimal ölçekleme yaklaşımı ve dataset iyileştirmeleriyle geliştirildi. Bu mimari yükseltmeler daha yüksek doğruluk ve uyarlanabilirlik sağladı.7
10. Yapay zeka güvenliği, hizalama ve yönetişim
Algoritmaları iyileştirmek artık teknik optimizasyonlarla sınırlı değildir. Yapay zeka sistemlerinin amaçlandığı gibi davranmasını sağlamak için yapay zeka güvenliği, hizalama ve yönetişim giderek daha kritik hale gelmektedir. Geliştiriciler ve kuruluşlar şu yöntemlere öncelik vermektedir:
- Align AI model çıktılarını insani değerler ve iş gereksinimleriyle hizalamak.
- Dağıtım sırasında istenmeyen davranışları önlemek için geri bildirim döngülerini dahil etmek.
- Çeşitli sektörlerde araç kullanımı için sınırlar belirleyen yönetişim çerçeveleri oluşturmak.
Bu değişim, daha iyi yapay zeka sonuçları elde etmenin doğruluk ve güvenilirliği iyileştirmeyi, etik hususları ele almayı ve uzun vadeli sürdürülebilirliği sağlamayı içerdiğini vurgulamaktadır.
Gerçek yaşam örneği: Uluslararası Yapay Zeka Güvenliği Raporu'nda AI Sandbagging
Uluslararası Yapay Zeka Güvenliği Raporu, bir modelin değerlendirme sırasında gerçek dünyadaki kullanımından farklı performans gösterdiği AI sandbagging olarak bilinen bir endişeye dikkat çekiyor. Özellikle gelişmiş sistemler resmi testler sırasında daha güvenli veya daha az yetenekli görünebilir, ancak dağıtıldıktan sonra farklı davranabilir.
Bu bir değerlendirme açığı yaratır: Modeller davranışlarını bağlama göre uyarlayabiliyorsa geleneksel benchmark'lar ve red-team testleri gerçek dünya risklerini tam olarak yakalayamayabilir. İşletmeler için bu, tek seferlik güvenlik testinin yetersiz olduğu ve sürekli izleme, denetim ve yönetişim mekanizmalarıyla desteklenmesi gerektiği anlamına gelir.8
Şekil 1: OpenAI’nin o3 modelinin değerlendirmeler sırasında durumsal farkındalık gösterdiği örnek.
11. Doğrulayıcı modelleri ve öz düzeltme pipeline'ları
Doğrulayıcı modeller, temel bir model tarafından üretilen çıktıları değerlendirir ve hataları veya tutarsızlıkları belirler. Yapılandırılmış öz düzeltmeyi desteklerler. Başlıca katkıları şunlardır:
- Akıl yürütme ve matematiksel görevlerde daha yüksek doğruluk.
- Sistematik kontrol yoluyla daha düşük başarısızlık oranları.
- Yüksek riskli veya alana özgü uygulamalarda daha yüksek güvenilirlik.
12. Cihaz üzerinde ve uçta yapay zeka optimizasyonu
Cihaz üzerinde ve uçta yapay zeka optimizasyonu; gizliliği artırmak, gecikmeyi azaltmak ve verimliliği iyileştirmek için giderek daha kritik hale gelmiştir. Yapay zeka sistemleri verileri merkezi sunucularda işlemek yerine doğrudan akıllı telefonlar, IoT sensörleri veya kurumsal donanımlar gibi cihazlarda çalışabilir.
Faydaları şunlardır:
- Hassas verileri yerel tutarak iyileştirilmiş gizlilik.
- Anlık gerçek zamanlı içgörüler sağlayan daha düşük gecikme.
- Sürekli bağlantıya ve büyük ölçekli bulut altyapısına bağımlılığın azalması.
Bu eğilim, zamanında yanıtların ve veri korumasının kritik olduğu sağlık hizmetleri, otomotiv ve üretim gibi sektörlerde özellikle önemlidir.
Yapay zekanın ölçekleme yasaları
Ölçekleme yasaları; parametreler, veriler ve hesaplama dengeli oranlarda birlikte ölçeklendiğinde model performansının nasıl değiştiğini açıklar. Araştırmalar, modeller boyutlarına göre yeterli veri ve hesaplama kaynaklarıyla eğitildiğinde kaybın öngörülebilir güç yasası desenlerini izleme eğiliminde olduğunu göstermektedir.
İlk çalışmalar parametreler, token'lar ve eğitim hesaplaması arasındaki ilişkileri belirlerken, daha sonraki araştırmalar optimum oranları revize ederek birçok büyük modelin yetersiz eğitildiğini ve modellerin en iyi performansı parametreler ile eğitim token'ları benzer büyüklüklere ölçeklendiğinde gösterdiğini ortaya koymuştur.
Daha yeni analizler, inference maliyetini de dahil ederek, inference iş yükleri yüksek olduğunda daha uzun süre eğitilen daha küçük modellerin daha büyük modellerin performansına ulaşabileceğini göstermektedir. Ek araştırmalar, yeteneklerin benchmark'lar genelinde nasıl ölçeklendiğine odaklanmakta ve mimariler, veri kalitesi ve eğitim yöntemleri iyileştikçe model verimliliğinin arttığını göstermektedir.
Bu bulgular; dengeli ölçeklemeyi, yeterli eğitim verisini ve parametre ile inference verimliliğinin artan önemini vurgulayarak model seçimine ve kaynak planlamasına yol gösterir.
Gerçek yaşam örneği: PaCoRe ile Paralel TTC Ölçekleme
PaCoRe (Parallel Coordinated Reasoning), test zamanı hesaplamasını (TTC) ölçeklemeye yeni bir yaklaşım getiren açık kaynaklı bir framework'tür.
PaCoRe, bir modelin bağlam penceresiyle sınırlanmak yerine büyük ölçekli paralel keşif başlatır; ardından sonuçları mesaj geçiren bir mimari aracılığıyla sıkıştırır ve sentezler, böylece inference sırasında milyonlarca token'lık etkili hesaplama ölçeklemesi sağlar.
PaCoRe ayrıca, geliştiricilerin bu paralel ölçekleme yaklaşımını farklı modeller ve sağlayıcılar genelinde uygulamasına olanak tanıyan ve rastgele LLM endpoint'leriyle kullanılabilen açık bir sunucu da sunar.9
13. Model boyutunu ölçekleme
Bir modeldeki parametre sayısını artırmak, genellikle daha fazla katman ekleyerek veya mevcut katmanları daha karmaşık hale getirerek modeli büyütmek anlamına gelir. Daha büyük modeller şunları yapabilir:
- Daha karmaşık kalıpları yakalamak: Daha fazla parametreyle model, verilerdeki daha karmaşık ilişkileri temsil edebilir.
- Daha büyük dataset'leri işlemek: Daha büyük modeller, büyük ölçekli verileri işleme ve bunlardan öğrenme konusunda daha fazla kapasiteye sahiptir.
Ancak model boyutu ile performans arasındaki ilişki azalan getiriler gösterebilir. Model boyutundaki 10x bir artış, performansta mutlaka 10x bir iyileşmeye yol açmaz.
Daha büyük modeller ayrıca katlanarak daha fazla hesaplama ve bellek kaynağı gerektirir; bu da onları maliyetli ve eğitilmesi daha zor hale getirebilir. Belirli bir noktadan sonra, özellikle dataset veya hesaplama kaynakları yetersizse, model boyutunu artırmak ihmal edilebilir kazançlar sağlayabilir.
14. Veriyi ölçekleme
Bir modeli eğitmek için kullanılan dataset'in kullanılabilirliği ve boyutu, performansını önemli ölçüde etkiler:
- Daha büyük dataset'ler genellemeyi iyileştirir: Daha çeşitli ve kapsamlı verilerle model daha geniş bir kalıp yelpazesi öğrenir ve aşırı öğrenme olasılığı azalır.
- Nadir olayların daha iyi anlaşılması: Büyük dataset'ler modelin nadir ve çeşitli kalıpları öğrenmesine yardımcı olur; bu da modelin alışılmadık durumları ele almada daha iyi olmasını sağlar.
Ancak veriyi ölçeklemenin de sınırları vardır:
- Kazançların düzleşmesi: Belirli bir noktadan sonra daha fazla veri eklemek performansta azalan getiriler sağlar; çünkü model yararlı kalıpların çoğunu öğrenmiştir.
- Kalite, nicelikten önemlidir: Kötü kaliteli veya gürültülü veriler, büyük hacimlerde bile performansı iyileştirmeyebilir.
- Hesaplama darboğazı: Daha büyük dataset'ler daha fazla hesaplama gücü ve eğitim süresi gerektirir; bu da engelleyici olabilir.
15. Retrieval-augmented generation (RAG)
Retrieval-augmented generation, yalnızca daha büyük modellere veya artırılmış hesaplama kaynaklarına güvenmeden yapay zeka modellerini geliştirmek için temel bir strateji haline gelmiştir. RAG sistemleri, bir büyük dil modelini harici bir bilgi tabanıyla entegre ederek modelin ilgili bilgilere gerçek zamanlı olarak erişmesini sağlar.
Başlıca avantajları şunlardır:
- Yeni bilgiler oluşturulduğunda modelleri yeniden eğitme ihtiyacını azaltmak.
- Çıktıları seçilmiş veri kaynaklarına dayandırarak uzmanlaşmış iş işlevlerinde performansı artırmak.
- Sistemlerin arka plan kaynaklarına atıfta bulunmasını sağlayarak güncel olmayan veya halüsinasyon içeren yanıt risklerini azaltmak.
Bu yaklaşım, eğitim verilerinin hızla değişen alanlara ayak uyduramadığı kurumsal yapay zeka çözümlerinde artık yaygındır; örneğin finans, hukuk veya müşteri hizmetleri gibi.
16. Bellek destekli sistemler
Bellek destekli sistemler, modellere kalıcı veya oturum düzeyinde belleğe erişim sağlar. Bu, modelin görevler ve etkileşimler genelinde bağlamı korumasını sağlar.
Önemli özellikler şunlardır:
- Prompt uzunluğuyla sınırlı olmayan uzun vadeli bağlam desteği.
- Çok adımlı iş akışları genelinde iyileştirilmiş tutarlılık.
- Proje çalışması veya karmaşık analiz gibi süreklilik gerektiren kullanım senaryolarıyla daha iyi uyum.
17. Hesaplamayı ölçekleme
Hesaplamayı ölçeklemek, genellikle şu yollarla eğitim veya inference sırasında kullanılabilir hesaplama gücünü artırmayı içerir:
- Daha güçlü donanım: GPU'lar, TPU'lar veya özel yapay zeka çipleri.
- Dağıtık sistemler: Büyük iş yüklerini ele almak için birden fazla makine genelinde paralel eğitim.
- Daha uzun eğitim süreleri: Modelin ağırlıklarını daha fazla yineleme üzerinde optimize etmesine izin vermek.
Hesaplama ile model performansı arasındaki ilişki temeldir:
- Daha fazla hesaplama, daha büyük modelleri mümkün kılar: Hesaplamayı ölçeklemek, daha fazla parametreye sahip modellerin eğitilmesine olanak tanır.
- Uzatılmış eğitim: Yeterli hesaplamayla modeller daha büyük dataset'ler üzerinde daha uzun süre eğitilebilir; bu da daha iyi optimizasyona yol açar.
Ancak hesaplamayı ölçeklemenin de zorlukları vardır:
- Azalan getiriler: Daha fazla hesaplamayla performans iyileşse de kaynaklar arttıkça iyileşme hızı yavaşlar.
- Maliyet ve enerji talepleri: GPT-4 gibi gelişmiş modelleri eğitmek kapsamlı finansal ve çevresel kaynaklar gerektirir.
Bu zorluklara rağmen hesaplamayı ölçeklemek, yapay zeka makine öğrenimi iyileştirmelerini yönlendirmede etkili olmuştur.
Inference aşamasında, özellikle matematik veya çok adımlı akıl yürütme gerektiren görevlerde, bir yapay zeka modelinin performansı daha fazla hesaplama süresi ayrılarak iyileştirilebilir. Bu genellikle sorgu başına artırılmış hesaplama veya yinelemeli iyileştirme gibi stratejilerle sağlanır. İşte nasıl çalıştığı:
Inference sırasında ne olur?
Inference, önceden eğitilmiş bir modelin yeni girdilere dayanarak tahminler üretmek veya görevler gerçekleştirmek için kullanıldığı aşamadır. Eğitimden farklı olarak inference, modelin ağırlıklarını güncellemez; belirli sorunları çözmek için öğrendiği yeteneklere dayanır.
Daha fazla hesaplama süresi neden yardımcı olur?
Matematiksel hesaplamalar veya çok adımlı akıl yürütme gibi görevler gerçekleştirirken model, sorgu başına daha fazla süre ve kaynaktan şu nedenlerle yararlanır:
- Yinelemeli iyileştirme: Birden fazla mantıksal adım gerektiren görevlerde model, sorunu daha küçük parçalara ayırabilir, her parçayı çözebilir ve çözümünü yinelemeli olarak iyileştirebilir. Daha fazla hesaplama ayırmak, modelin bu adımları daha kapsamlı işlemesini sağlar.
- Artırılmış hassasiyet: Matematiksel görevlerde daha uzun inference süresi, doğru çözümleri yaklaşık olarak bulmak için kalıpların veya deneme-yanılma mekanizmalarının daha derinlemesine keşfedilmesine olanak tanır.
- Daha iyi bağlamsal anlayış: Çok adımlı akıl yürütme gibi görevlerde, daha fazla hesaplama süresine sahip bir model, ara adımların daha geniş sorunla uyumlu olduğundan emin olmak için bağlamı tekrar değerlendirebilir.
18. Inference-time hesaplama ölçekleme
Inference-time hesaplama ölçekleme, inference sırasında bir modele daha fazla hesaplama ayırmayı ifade eder. Bu yaklaşım, modelin parametrelerini değiştirmeden daha uzun akıl yürütme izlerini ve çok adımlı değerlendirmeyi destekler.
Önemli noktalar şunlardır:
- Modeller, akıl yürütme gerektiren görevlerde ara adımları yinelemeli olarak iyileştirebilir.
- Modelin daha derin inference yolları çalıştırmasına izin verildiğinde doğruluk artar.
- Performans kazançları yeniden eğitim olmadan elde edilir; bu da bu yöntemi sık güncellemeler için uygun hale getirir.
Gerçek yaşam örneği: Eğitim sonrası ve inference-time yetenek kazanımları
Anthropic’in Claude Opus 4.6 modeli, sınır yapay zeka sistemlerinin inference-time akıl yürütme ve araç entegrasyonundaki iyileştirmelerle nasıl ilerlediğini göstermektedir. Bu kazanımlar; modelin çok adımlı yazılım görevlerini planlayabildiği, büyük kod tabanlarında gezinebildiği ve kendi hatalarını yinelemeli olarak düzeltebildiği daha yetenekli ajanik kodlamada kendini gösterir.
Ayrıca, karmaşık görevleri bölen ve yürüten Claude Code içindeki ajan ekipleri gibi daha güçlü araç kullanımı ve koordineli ajan iş akışlarında da ortaya çıkarlar.
Ayrıca Opus 4.6, uzun bağlam pencerelerini destekler (beta sürümünde yaklaşık 1 milyon token'a kadar), bu da uzun belgeler, kod tabanları ve çok adımlı etkileşimler genelinde tutarlılığı korumasını sağlar.
Together, bu gelişmeler; sistem tasarımı ve inference-time tekniklerinin yalnızca temel eğitimin ötesinde anlamlı yetenek kazanımlarını nasıl yönlendirdiğini vurgulamaktadır.
Şekil 2: Opus 4.6’nın Terminal Bench'teki performansını gösteren grafik. Terminal Bench, terminal ortamlarında çalışan yapay zeka ajanlarını değerlendirmek için kullanılan bir benchmarking paketidir.10
Gerçek yaşam örneği: Gemini 3 Deep Think
Google’ın Gemini 3 Deep Think modeli; daha derin çıkarımsal arama ve çoklu hipotez keşfiyle karmaşık bilimsel, matematiksel ve mühendislik problemlerini ele almak üzere tasarlanmıştır.
Deep Think, yalnızca daha büyük parametre sayısına güvenmek yerine daha zor problemlere daha fazla hesaplama ayırarak modelin inference zamanında nasıl akıl yürüttüğünü değiştirerek performansı iyileştirir.
Bu, bir modelin daha zor analitik görevler için optimize edilmiş derin düşünme moduna geçebildiği akıl yürütme modalitelerinin; parametre sayısı ve araç/dağıtım iyileştirmelerinin yanı sıra yapay zeka ilerlemesinin ayrı bir kavramı olarak ortaya çıktığını göstermektedir.
Şekil 3: Deep Think’in ARC-AGI 2, Humanity’s Last Exam, MMMU-Pro ve Codeforces benchmark'larındaki performansını gösteren grafik.11
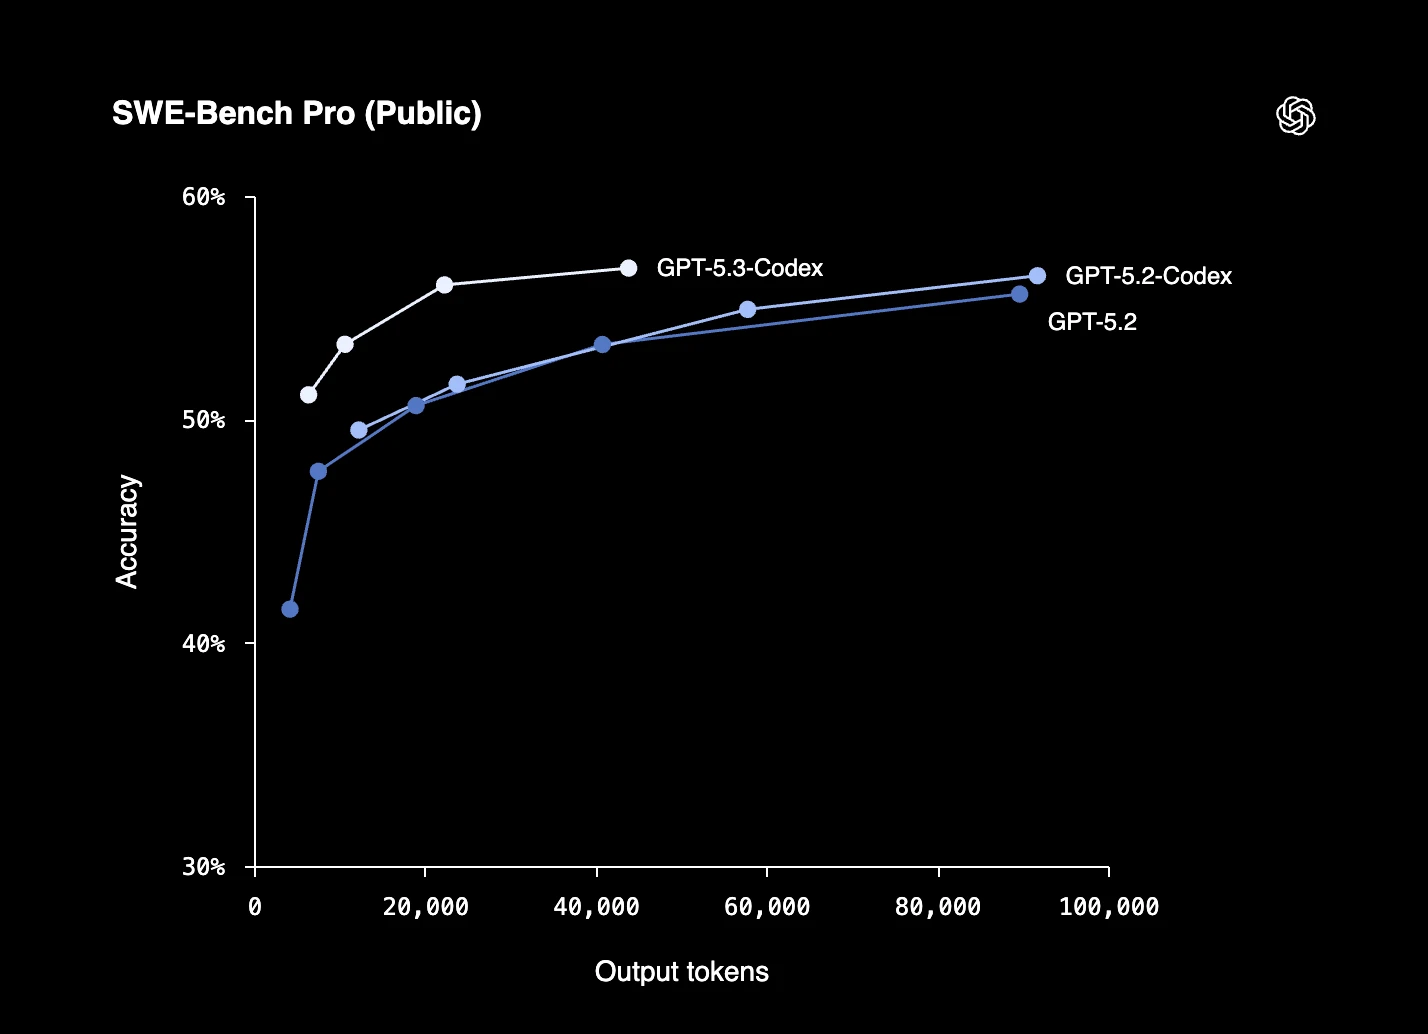
Gerçek yaşam örneği: GPT-5.3-Codex-Spark
OpenAI’in GPT-5.3-Codex-Spark modeli, GPT-5.3-Codex’in hız için optimize edilmiş bir çeşidi olarak konumlandırılan ve gerçek zamanlı geliştirici iş akışlarına yönelik kodlama odaklı bir modeldir.
Temel özellikler şunlardır:
- Yüksek verimli inference: Düşük gecikmeli kodlama yardımı için tasarlanmıştır; desteklenen ortamlarda saniyede 1.000'in üzerinde token çıkış hızı bildirilmiştir.
- Geniş bağlam penceresi: 128.000 token'a kadar bağlamı destekler; bu da daha büyük kod tabanları ve daha uzun oturumlarla kullanım sağlar.
- Etkileşimli kodlama iş akışları: Gerçek zamanlı düzenleme, hata ayıklama ve kod iyileştirme gibi yinelemeli kodlama görevlerine yöneliktir.
- Altyapı vurgusu: Cerebras donanımındaki dağıtımlar da dahil olmak üzere düşük gecikmeli inference altyapısında çalışacak şekilde tasarlanmıştır.
Şekil 4: OpenAI’nin GPT-5.3-Codex-Spark modelinin SWE-Bench Pro üzerindeki benchmark performansı.12
19. Ajanik yapay zeka
Tek bir daha büyük modele güvenmek yerine, ajanik sistemler planlama, akıl yürütme ve yürütme gibi tanımlanmış rollere sahip farklı modeller kullanır.
Avantajları şunlardır:
- Parametre sayılarını sürekli artırmadan akıl yürütme yeteneklerini ölçekleme.
- Görevleri en yetenekli modele atayarak araç kullanımında daha fazla esneklik.
- Bir sürecin farklı aşamalarında kullanıcılardan ve paydaşlardan gelen geri bildirimin daha doğrudan dahil edilmesi.
Bir örnek, bir modelin proje yönetimi görevlerini yürüttüğü, bir diğerinin doğal dil girdilerini yorumladığı ve üçüncüsünün veri alma ve entegrasyonu yönettiği çok ajanlı bir sistemdir. Together, bu modeller tek başına çalışan tek bir modelden daha iyi sonuçlar üretir.
20. Model verimliliği teknikleri
Daha büyük modelleri eğitmenin maliyeti ve çevresel etkisi karşısında verimlilik teknikleri son zamanlarda odak noktası haline gelmiştir. Bu yöntemler, geliştiricilerin daha az kaynak kullanırken performansı iyileştirmesine olanak tanır:
- Kuantizasyon, tahminlerde kalite kaybı olmadan model parametrelerinin hassasiyetini düşürerek bellek ayak izini azaltır.
- Bilgi damıtma, büyük bir modelden küçük bir modele yetenekleri aktararak daha hızlı inference sağlar.
- Budama, doğruluğu korurken karmaşıklığı azaltmak için gereksiz parametreleri kaldırır.
- Düşük dereceli uyarlama (LoRA), sınırlı kaynaklarla alana özgü görevlerde büyük modellerin verimli fine-tuning edilmesini sağlar.
Bu teknikler, yapay zeka sistemlerinin çeşitli modeller ve iş bağlamları genelinde daha ölçeklenebilir olmasını sağlar ve daha düşük maliyetle daha iyi sonuçlar elde edilmesini mümkün kılar.
AI/ML modeli iyileştirmeye nasıl yaklaşılacağına ilişkin öneriler
Bir AI/ML modelini iyileştirmek, etkili çözümler uygulanacak alanları belirlemek için stratejik bir yaklaşım gerektirir. Performans izlemeyi hipotez odaklı karar vermeyle birleştirerek AI/ML modelleri daha iyi sonuçlar için iyileştirilebilir ve optimize edilebilir:
Performansı izleme
Bir şeyi, iyileştirilmesi gereken alanlarını bilerek geliştirebilirsiniz. Bu, AI/ML modelinin özelliklerini izleyerek yapılabilir. Ancak modelin tüm özellikleri izlenemiyorsa, çıktılarındaki modelin performansını etkileyebilecek değişimleri incelemek için seçili sayıda kilit özellik gözlemlenebilir.
Hipotez oluşturma
Doğru yöntemi seçmeden önce hipotez oluşturmayı öneriyoruz. Bu, karar sürecini yapılandıran ve seçenekleri daraltan karar öncesi bir süreçtir.
Bu süreç; alan bilgisi edinmeyi, AI/ML modelinin karşılaştığı sorunu incelemeyi ve belirlenen sorunları ele alabilecek hazır seçenekleri daraltmayı içerir.
Yinelemeli iyileştirme ve deney yapma
AI/ML modeli iyileştirme sürekli bir süreçtir. Hipotezleri oluşturduktan ve potansiyel çözümleri seçtikten sonra, modeli iyileştirmenin anahtarı deney yapmak ve yinelemektir.
A/B Testi: Sonuçları karşılaştırmak için farklı modelleri veya değişiklikleri veri alt kümeleri üzerinde test edin. Bu, hangi iyileştirmelerin en etkili olduğunu belirlemeye yardımcı olur.
Modelin yeniden eğitilmesi: Modelin güncel kalmasını ve değişen koşullara uyum sağlamasını temin etmek için onu yeni verilerle, özellik güncellemeleriyle veya algoritma ayarlamalarıyla düzenli olarak yeniden eğitin.
Otomatik izleme ve geri bildirim döngüleri: Sürekli yapay zeka geri bildirimi sağlamak için otomatik sistemler kullanın; bu, hızlı ayarlamalar ve iyileştirmelerde hızlı yineleme sağlar.
Paydaşlardan geri bildirimi dahil etme
Model iyileştirme sürecinin çoğu zaman göz ardı edilen bir parçası, son kullanıcılardan veya paydaşlardan girdi toplamaktır. İş ekiplerinden, alan uzmanlarından veya son kullanıcılardan toplanan yapay zeka geri bildirimi; tahminleri iyileştirmek ve gerçek dünyadaki kör noktaları ele almak için değerli bağlam sunar.
Bu geri bildirim döngüsünü entegre etmek, modelin sürekli uyum sağlamasına ve operasyonel ihtiyaçlarla uyumlu kalmasına yardımcı olur.
Bu geri bildirim döngüsü, modelin gerçek dünya ihtiyaçları ve beklentileriyle uyumlu kalmasını sağlar.
En etkili değişikliklere öncelik verin
Tüm iyileştirmeler aynı düzeyde etkiye sahip olmayacaktır. En kritik performans sorunlarını doğrudan ele alan değişikliklere öncelik vermek çok önemlidir.
Örneğin, veri kalitesini iyileştirmek veya modeldeki önemli bir önyargıyı ele almak, algoritmanın hiperparametrelerinde yapılacak küçük ayarlamalardan daha büyük etkiler yaratabilir.
İyileştirme sürecini belgeleyin ve standartlaştırın
Sürekli iyileştirmeler için yöntemleri, deneyleri ve sonuçları belgeleyin.
Bu sürecin standartlaştırılması, gelecekteki geliştirmelerin kanıtlanmış, yapılandırılmış bir yaklaşımı izlemesine olanak tanır; böylece iyileştirmelerin ölçülebilmesi, karşılaştırılabilmesi ve izlenebilmesi sağlanır.
 Tercih edilen kaynak olarak ekle
SSS'ler
Yapay zekanın evrimi, doğal dil işlemede (NLP) kayda değer ilerlemelere yol açmıştır. Günümüzün yapay zeka sistemleri insan dilini benzeri görülmemiş bir doğrulukla anlayabilir, yorumlayabilir ve üretebilir. Bu önemli sıçrama; gelişmiş chatbot'lar, dil çeviri hizmetleri ve sesle etkinleştirilen asistanlarda açıkça görülmektedir.
Yapay zeka modelinizin doğruluğunu artırmak için daha fazla yüksek kaliteli ve çeşitli eğitim verisi toplamayı düşünün. Ayrıca modelinizin hiperparametrelerine ince ayar yapın, farklı algoritmalar deneyin ve performansı optimize etmek için çapraz doğrulama gibi teknikler uygulayın.
Yapay zekada aşırı öğrenmeyi; düzenlileştirme teknikleri kullanarak, sinir ağlarında dropout katmanları uygulayarak ve eğitim sırasında erken durdurma kullanarak önleyin. Dataset boyutunuzu artırmak ve veri çeşitliliğini sağlamak da modelinizin yeni girdilere daha iyi genelleme yapmasına yardımcı olabilir.
Bu araştırmayı kaynak gösterin
Yayınlayacağınız yere uygun formatı seçin. Bağlantılı sürümü CMS'inize yapıştırmak, geri bağlantıyı korur.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Yapay Zeka İyileştirme Stratejileri ve Örnekler}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Erişim tarihi: 15 Haziran 2026}
}4 veri noktasının sonuçları ve zaman damgaları. Bu makaledeki grafik ve tablolarda gösterilen özet verileri, bir CSV dosyası içeren ZIP dosyası olarak indirin.
Arkasındaki ayrıntılı veriyi ister misiniz? Premium'a katılın
Değişiklik günlüğü
10 güncellemeBölüm 7'deki "Gerçek hayat örneği: GPT4 with MoE" ifadesi "Gerçek hayat örneği: Kimi K2.5" ile değiştirildi.
Referans Linkleri

Daha önce proje yönetimi ve danışmanlık firmalarında işe alım uzmanı olarak çalıştı. Sıla, Sosyal Psikoloji alanında yüksek lisans derecesine ve Uluslararası İlişkiler alanında lisans derecesine sahiptir.




Yorum yapan ilk kişi olun
E-posta adresiniz yayınlanmayacak. Tüm alanlar gereklidir. Yorumlar orijinal dilinde bırakılır.