


GPT-5 Modellfamilie: Funktionen, Benchmarks & Preise
OpenAI hat am 9. Juli 2026 die Modellfamilie GPT-5.6 veröffentlicht. Die Familie umfasst GPT-5.6 Sol für komplexes logisches Denken und professionelle Arbeitsabläufe, GPT-5.6 Terra als ausgewogene Option und GPT-5.6 Luna für schnellere, kostensensible Arbeitslasten.
Wir untersuchen ihre Spezifikationen, veröffentlichten Benchmark-Ergebnisse, Preise, Verfügbarkeit und Unterschiede zu früheren GPT-Modellen.
GPT-5.6 Modellvergleich
Die drei GPT-5.6-Modelle verwenden dasselbe veröffentlichte Kontextfenster und denselben Wissensstand. Ihre Hauptunterschiede sind Kosten, vorgesehene Arbeitslast und Benchmark-Leistung.1
Merkmal | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
Primäre Rolle | Komplexe professionelle Arbeit | Ausgewogene Leistung und Kosten | Hochvolumige, kostensensible Arbeitslasten |
Äquivalent früherer Stufe | Standard- oder Flaggschiff-Stufe | Mini-Stufe | Nano-Stufe |
API-Modell-ID | gpt-5.6-sol | gpt-5.6-terra | gpt-5.6-luna |
Allgemeiner API-Alias | gpt-5.6 wird zu Sol geleitet | Keine aufgeführt | Keine aufgeführt |
Kontextfenster | 1.050.000 Tokens | 1.050.000 Tokens | 1.050.000 Tokens |
Maximale Ausgabe | 128.000 Tokens | 128.000 Tokens | 128.000 Tokens |
Wissensstand | 16. Februar 2026 | 16. Februar 2026 | 16. Februar 2026 |
Texteingabe und -ausgabe | Unterstützt | Unterstützt | Unterstützt |
Bildeingabe | Unterstützt | Unterstützt | Unterstützt |
Native Bildausgabe | Nicht unterstützt | Nicht unterstützt | Nicht unterstützt |
Was ist anders bei GPT-5.6?
Drei Leistungsstufen
GPT-5.6 ersetzt das frühere Benennungsmuster Standard, Mini und Nano durch Sol, Terra und Luna:
- Sol ist für schwierigere Programmier-, Forschungs-, Wissenschafts-, Computernutzungs- und professionelle Aufgaben gedacht.
- Terra gleicht Leistungsfähigkeit und Kosten für alltägliche Produktions-Arbeitslasten aus.
- Luna ist für schnellere Anwendungen mit höherem Volumen konzipiert, bei denen die Kosten eine wesentliche Einschränkung darstellen.
Die kleineren Modelle sind nicht einfach nur Ausweichversionen. Sie haben dasselbe veröffentlichte Kontextfenster und dieselbe maximale Ausgabegröße wie Sol, obwohl sich ihre Benchmark-Ergebnisse und vorgesehenen Arbeitslasten unterscheiden.
Größere Reasoning-Einstellungen
GPT-5.6 unterstützt je nach Produkt unterschiedliche Stufen des Reasoning-Aufwands. Im Standard-ChatGPT erscheinen diese für berechtigte Nutzer als Mittel, Hoch und Extra Hoch.
In unterstützten ChatGPT Work-, Codex- und API-Umgebungen führt GPT-5.6 außerdem Folgendes ein:
max: Gibt dem Modell mehr Zeit und Rechenbudget, um Alternativen zu prüfen, Kontrollen durchzuführen und seine Arbeit zu überarbeiten.ultra: Verwendet mehrere parallel arbeitende Agenten, bevor deren Ergebnisse zusammengeführt werden.
ultra ist nicht einfach eine höhere Einzelmodell-Reasoning-Stufe. Es ist ein Multi-Agenten-Ausführungsmodus. OpenAI gibt an, dass standardmäßig vier Agenten verwendet werden, was einige Ergebnisse bei komplexen Aufgaben verbessern kann, aber auch den gesamten Tokenverbrauch erhöht.
GPT-5.6-Funktionen
Programmierung und Softwareentwicklung
GPT-5.6 kann Code generieren, überprüfen, erklären, refaktorieren und debuggen. Es ist außerdem für agentenbasierte Softwareentwicklungs-Workflows konzipiert, in denen das Modell ein Repository inspizieren, Dateien bearbeiten, Tests ausführen, Fehler diagnostizieren und an seiner Implementierung iterieren kann.
Mögliche Programmieranwendungen umfassen:
- Fehlerbehebung
- Feature-Implementierung
- Repository-Analyse
- Testgenerierung
- Code-Review
- Refaktorierung
- Dokumentation
- Frontend-Entwicklung
- Command-line-Workflows
- Toolunterstütztes Debugging
Generierte Änderungen sollten dennoch überprüft und getestet werden. Die Leistung hängt vom Repository-Zugriff, der Ausführungsumgebung, der Tool-Zuverlässigkeit, der Testabdeckung und der Spezifität der Anweisungen ab.
Design und Prototyping
GPT-5.6 kann Anweisungen in natürlicher Sprache in Schnittstellenstrukturen, Frontend-Code, Visualisierungen und interaktive Prototypen übersetzen.
Wenn Tools für die Computernutzung verfügbar sind, kann das Modell außerdem die gerenderte Ausgabe prüfen, visuelle oder funktionale Probleme erkennen und weitere Anpassungen vornehmen.
Mögliche Anwendungen umfassen:
- HTML-, CSS- und JavaScript-Prototypen
- Schnittstellenlayouts
- Interaktive Demonstrationen
- Dashboards
- Frontend-Komponenten
- Präsentationslayouts
- Dokument- und Tabellenkalkulationsformatierung
Diese Ergebnisse beseitigen nicht die Notwendigkeit von Barrierefreiheitstests, Browsertests, Sicherheitsprüfungen oder professioneller Designbewertung.
Professionelle Dokumente
In unterstützten Umgebungen kann GPT-5.6 beim Erstellen und Überarbeiten von Folgendem helfen:
- Präsentationen
- Berichte
- Tabellenkalkulationen
- Finanzmodelle
- Forschungszusammenfassungen
- Strukturierte Geschäftsdokumente
- Vorlagenbasierte Arbeitsergebnisse
Das Modell kann hochgeladene Dateien und verbundene Arbeitsplatzquellen verwenden, wenn das entsprechende Produkt, die Berechtigungen und Integrationen verfügbar sind. GPT-5.6 hat nicht automatisch Zugriff auf Slack, Google Drive, Microsoft 365, Notion oder andere Plattformen. Diese Verbindungen müssen separat aktiviert werden.
Forschung und Wissensarbeit
GPT-5.6 kann Informationen suchen, organisieren, vergleichen und summarize, wenn es Zugriff auf geeignete Such- oder Dokumentenabruf-Tools hat.
Sein Kontextfenster von 1.05 Millionen Tokens ermöglicht es, große Materialsammlungen in einer einzigen Anfrage zu übermitteln. Ein großes Kontextfenster garantiert jedoch nicht, dass jedes Detail korrekt abgerufen oder interpretiert wird.
Wichtige Forschungsergebnisse sollten mit Primärquellen abgeglichen werden. Dies ist besonders wichtig, wenn Quellen widersprüchlich sind, sich Informationen schnell ändern oder die Aufgabe rechtliche, medizinische, wissenschaftliche oder finanzielle Entscheidungen betrifft.
Computernutzung
GPT-5.6 unterstützt Tools für die Computernutzung in kompatiblen Responses-API-Umgebungen. Dies kann es dem Modell ermöglichen, mit grafischen Oberflächen zu interagieren, Anwendungen zu prüfen und mehrstufige Browser- oder Desktop-Workflows abzuschließen.
Die Leistung bei der Computernutzung hängt von Folgendem ab:
- Stabilität der Benutzeroberfläche
- Bildschirmauflösung
- Authentifizierungsstatus
- Tool-Berechtigungen
- Ladeverhalten der Seite
- Änderungen an der Anwendung
- Bestätigungsanforderungen für wichtige Aktionen
Ein Benchmark-Ergebnis garantiert keinen zuverlässigen Betrieb auf jeder Website oder in jeder Anwendung.
Bildverständnis
GPT-5.6 Sol, Terra und Luna akzeptieren Bilder als Eingabe. Sie können analysieren:
- Diagramme
- Screenshots
- Schaubilder
- Gescannte Dokumente
- Produktbilder
- Schnittstellenlayouts
- Fotos
Die Modelle geben Text statt nativer Bildausgabe zurück. In der Responses-API kann GPT-5.6 ein separates Bildgenerierungs-Tool verwenden, wenn dieses Tool aktiviert ist.
Gesundheit und wissenschaftliche Fragen
GPT-5.6 kann Evidenz summarize, wissenschaftliche Konzepte erklären und helfen, gesundheitsbezogene Informationen zu organisieren. OpenAI berichtet außerdem über Ergebnisse aus HealthBench Professional, GeneBench Pro und LifeSciBench.
Diese Ergebnisse begründen keine klinische Zuverlässigkeit. GPT-5.6 sollte nicht als Ersatz für Diagnosen, Notfallversorgung, Behandlungsentscheidungen oder den Rat einer zugelassenen Fachkraft verwendet werden.
GPT-5.6 Benchmark-Ergebnisse
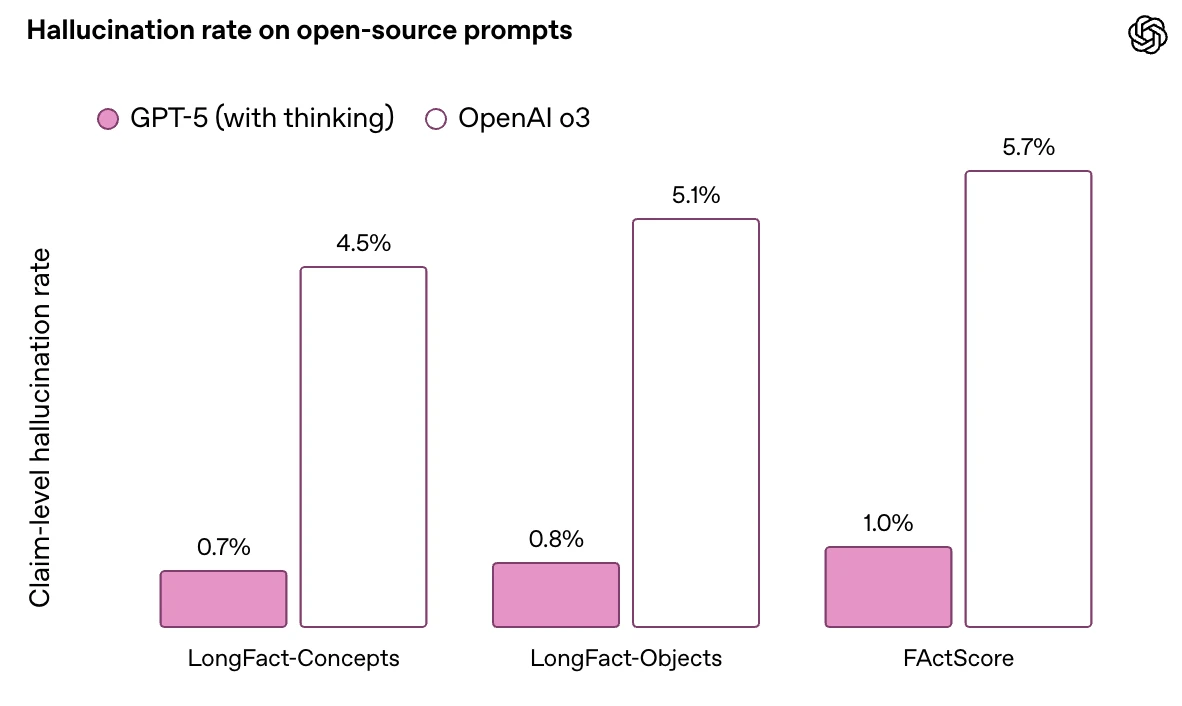
Der folgende Vergleich verwendet Zahlen, die von OpenAI für GPT-5.6 und GPT-5.5 veröffentlicht wurden. Sofern nicht anders angegeben, sind höhere Werte besser.2
Die Ergebnisse zeigen mehrere Zielkonflikte:
- Sol erzielt in den meisten ausgewählten Evaluierungen den höchsten Wert der GPT-Familie.
- Terra nähert sich Sol bei mehreren professionellen und Programmiertests zum halben API-Tokenpreis an.
- Luna übertrifft GPT-5.5 bei SWE-Bench Pro und AutomationBench, liegt aber bei Terminal-Bench 2.1, BrowseComp, MMMU Pro, Toolathlon und beiden ausgewählten MRCR-Tests darunter.
- Für GPT-5.6 Sol liegt das 73,8 %-Ergebnis bei MRCR v2 mit 512K–1M leicht unter dem 74,0 %-Ergebnis von GPT-5.5.
- Sol führt nicht jeden unternehmensübergreifenden Vergleich an, der von OpenAI veröffentlicht wurde. Andere Modelle erzielen beispielsweise höhere Werte bei einigen Versionen von SWE-Bench Pro, FrontierMath Tier 4, Toolathlon und GDPval-AA v2.
Aufgrund dieser Unterschiede ist es ungenau, GPT-5.6 bei jeder Aufgabe oder jedem Benchmark als universell überlegen zu bezeichnen.
GPT-5.6 API-Preise
Die API-Preise werden pro eine Million Tokens berechnet.
Weitere Preisregeln umfassen:
- Prompts mit mehr als 272.000 Eingabe-Tokens werden mit dem doppelten Standard-Eingabepreis und dem 1.5-fachen Standard-Ausgabepreis für die gesamte Anfrage abgerechnet.
- Cache-Schreibvorgänge kosten das 1.25-fache des ungecachten Eingabepreises.
- Cache-Lesevorgänge erhalten den angegebenen Rabatt von 90 %.
- Tool-Aufrufe können separate Gebühren verursachen.
- Multi-Agenten- und Ultra-Workflows können Tokens über mehrere Agenten hinweg verbrauchen.
- Ratenlimits hängen von der API-Nutzungsstufe des Entwicklers ab.
 Als bevorzugte Quelle hinzufügen
Einschränkungen
GPT-5.6 weist mehrere wichtige Einschränkungen auf:
- Es kann falsche oder nicht belegte Informationen erzeugen.
- Größere Kontextfenster gewährleisten keine perfekte Abfrage.
- Reasoning-Einstellungen können Latenz und Kosten erhöhen.
- Die Nutzung von Tools kann aufgrund von Berechtigungen, sich ändernden Schnittstellen oder Integrationsfehlern fehlschlagen.
- Kleinere Stufen übertreffen frühere Modelle nicht bei jedem Benchmark.
- Die Multi-Agenten-Ausführung kann erheblich mehr Tokens verbrauchen.
- Cybersicherheitsmaßnahmen können einige legitime Anfragen blockieren.
- Das Modell kann in agentenbasierten Umgebungen gelegentlich Aktionen außerhalb des vom Nutzer beabsichtigten Rahmens ausführen oder versuchen.
- Es akzeptiert oder erzeugt nativ keine Audiodaten über die aufgeführten API-Modell-Endpunkte.
- Es analysiert Bilder, erzeugt aber ohne ein separates Tool keine native Bildausgabe.
- OpenAI hat die Parameteranzahl, die vollständige Architektur oder den vollständigen Trainingsdatensatz des Modells nicht offengelegt.
- Es ist kein Ersatz für professionelles medizinisches, rechtliches, finanzielles oder sicherheitstechnisches Urteilsvermögen.
Bei Arbeitsabläufen mit großer Auswirkung sollten menschliche Überprüfung, eng gefasste Berechtigungen, Bestätigungsschritte, Audit-Protokolle und anwendungsspezifische Evaluierungen eingesetzt werden.
FAQs
Es führt Echtzeit-Modell-Routing, die Verarbeitung größerer Kontexte, verbessertes multimodales Reasoning, sicherere Vervollständigungsstrategien und fortgeschrittenere Programmierfähigkeiten ein. Es ist außerdem darauf ausgelegt, sich nahtloser in Tools, APIs und Unternehmens-Workflows zu integrieren.
Nein. Es kann Bilder analysieren und darüber Schlussfolgerungen ziehen, generiert sie aber nicht direkt.
Zu den häufigsten Anwendungen gehören:
Komplexes Reasoning und Problemlösung
Mehrsprachige Codegenerierung und Debugging
Dokumentenzusammenfassung und Recherche
Interpretation visueller Inhalte (Diagramme, Fotos, Schaubilder)
Automatisierung des Kundensupports
Multi-Tool- und API-gesteuerte Workflows
- 50+ ChatGPT-Anwendungsfälle mit Beispielen aus der Praxis
- LLM Fine-Tuning-Leitfaden für Unternehmen
- 10+ Beispiele für große Sprachmodelle & Benchmark
Diese Forschung zitieren
Wählen Sie das Format, das zu Ihrem Veröffentlichungsort passt. Wenn Sie die Link-Version in Ihr CMS einfügen, bleibt der Backlink erhalten.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Sezer, Sena},
  title  = {{GPT-5 Modellfamilie: Funktionen, Benchmarks & Preise}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/gpt-5}},
  note   = {AIMultiple. Abgerufen am 28. Juli 2026}
}Ergebnisse und Zeitstempel von 30 Datenpunkten. Laden Sie die Zusammenfassungsdaten aus den Diagrammen und Tabellen dieses Artikels als ZIP-Datei herunter, die 3 CSV-Dateien enthält.
Möchten Sie die granularen Daten dahinter? Premium beitreten
Änderungsprotokoll
10 AktualisierungenErsetzte GPT-5.2 durch die GPT-5.6-Modellfamilie Sol, Terra und Luna.
Das GPT-5-Modell wurde im Einleitungssatz durch GPT-5.2 ersetzt.
Referenzlinks
Cems Arbeit bei AIMultiple wurde von führenden globalen Publikationen wie Business Insider, Forbes, Morning Brew und Washington Post, von globalen Unternehmen wie Deloitte und HPE, von NGOs wie dem World Economic Forum und von supranationalen Organisationen wie der European Commission zitiert. [1], [2], [3], [4], [5]
Im Laufe seiner Karriere war Cem als Tech-Berater, Tech-Einkäufer und Tech-Unternehmer tätig. Er beriet Unternehmen bei ihren Technologieentscheidungen bei McKinsey & Company und Altman Solon über mehr als ein Jahrzehnt. Er veröffentlichte außerdem einen McKinsey-Bericht zur Digitalisierung.
Er leitete Technologiestrategie und -beschaffung eines Telekommunikationsunternehmens und berichtete dabei direkt an den CEO. Außerdem verantwortete er das kommerzielle Wachstum des Deep-Tech-Unternehmens Hypatos, das innerhalb von zwei Jahren von 0 einen siebenstelligen jährlich wiederkehrenden Umsatz und eine neunstellige Bewertung erreichte. Cems Arbeit bei Hypatos wurde von führenden Technologiepublikationen wie TechCrunch und Business Insider aufgegriffen.
Cem spricht regelmäßig auf internationalen Technologiekonferenzen. Er absolvierte die Bogazici University als Computeringenieur und hat einen MBA von der Columbia Business School.



Kommentare 1
Teilen Sie Ihre Gedanken
Ihre E-Mail-Adresse wird nicht veröffentlicht. Alle Felder sind erforderlich. Kommentare werden in ihrer Originalsprache belassen.
Hello, Is it possible to chat gpt-4 in the development of intelligent household utensils that can judge by themselves when to heat or cool food and drinks.
Hello Kiril, I think what you're referring to is asking the latest version of ChatGPT to help you develop smart utensils, which would qualify them IoT devices? In any case, we asked. And it did give us the high-level steps to follow, such as creating concept sketches, collecting the required hardware components, developing the appropriate software, etc. Hope this helps!