


Las mejores herramientas de web scraping con IA evaluadas

Los sitios cambian su diseño y los campos que necesitas de una página varían con el tiempo. Estos cambios rompen los scrapers codificados manualmente. Los scrapers con IA se pueden actualizar con prompts simples, y algunos pueden reparar un scraper guardado cuando el sitio cambia.
Hemos evaluado las mejores herramientas de web scraping con IA en los 10 principales dominios de e-commerce para ver su rendimiento, y también comparamos cómo aprovecha cada una la IA.
La clasificación se basa en la tasa de éxito para los proveedores evaluados y en la cobertura de funciones para el resto.
Comparativa de herramientas de web scraping con IA
Cada proveedor adopta un enfoque diferente hacia la IA, y nuestro objetivo era comparar esos enfoques y las ventajas e inconvenientes que conllevan. Consulta la sección de metodología del benchmark para obtener más detalles sobre el proceso de prueba.
Los datos de precio y moneda se extrajeron de los 10 principales sitios de e-commerce del mundo.
Hallazgos clave sobre las herramientas de web scraping con IA del benchmark
- Los fallos regresan con apariencia de datos. Cuando una herramienta no puede leer un precio, a menudo porque la página se topó con un muro anti-bot, la respuesta puede volver como 0 en lugar de como un fallo. Un valor nulo se puede reintentar u omitir; un 0 pasa la validación sin ser detectado. Por ejemplo, Apify y Oxylabs devolvieron null en estos casos, y la documentación de Firecrawl recomienda añadir “Devuelve null si no se encuentra en la página” a cada campo del esquema para que el model no adivine un valor.
- Llegan campos adicionales sin ser invitados. Si pides precio y moneda, es posible que también recibas marca, descripción o URLs de imágenes. Un esquema limita la respuesta a los campos que indiques. Por ejemplo, Bright Data te permite bloquear el esquema de salida en el momento de la compilación, de modo que en cada llamada se devuelva la misma forma.
- Se extrae el elemento equivocado. Precio con descuento frente al original, con impuestos frente a sin impuestos, opciones regionales: la herramienta puede capturar el número que no querías.
- Los números varían. Las herramientas de prompt a JSON pueden añadir decimales, truncar valores o devolver aproximaciones convertidas de moneda que no aparecen en ningún lugar de la página.
- La localización cambia la respuesta. Algunos sitios fijan precios según la IP geográfica, por lo que un proveedor con proxies estadounidenses ve un número distinto al que ve un usuario europeo.
El esquema y la región del proxy son los parámetros que te permiten detectar la mayor parte de esto antes de que llegue a tus datos.
Precios de las herramientas de web scraping con IA
Kadoa no publica tarifas; ofrece un plan Flex basado en consumo y un plan Enterprise de contacto con ventas.
Comparación de herramientas de web scraping con IA
Tiempo hasta el primer scraper: Para las herramientas que crean un scraper al que luego llamas por ID, cuánto tarda la configuración. “Una sola llamada HTTP” significa que no hay ningún paso de compilación.
Esquema de salida definido por el usuario: si puedes definir los campos de salida y sus tipos tú mismo antes de que se ejecute el scraping, en lugar de describirlos en un prompt y dejar que el LLM decida la estructura en tiempo de ejecución.
Endpoint de compilación única y múltiples llamadas: si el scraper se compila una vez, se almacena en el lado del proveedor y luego se le llama únicamente con una URL. Aquí el LLM (o, en las herramientas basadas en grabación, tus clics) se ejecuta en el momento de la compilación y su salida se congela en un scraper que te pertenece y que puedes modificar in situ, que es a lo que se vinculan las programaciones, los webhooks y las integraciones. Cuando esto no existe, la extracción se recalcula en cada llamada y la definición completa viaja con cada solicitud.
Scraper guardado con autorreparación: si un scraper guardado se repara cuando cambia el sitio objetivo, sin reconstruirlo desde cero. La corrección se aplica al mismo scraper almacenado con su identificador existente, de modo que los activadores, las programaciones y las integraciones siguen funcionando.
* Kadoa almacena el scraper y lo llama por ID, pero las URLs de destino se vinculan cuando se crea el flujo de trabajo. Apuntarlo a una URL nueva requiere una actualización de metadatos por separado antes de la ejecución.
Las herramientas que ejecutan un LLM sobre la página en cada llamada no se contabilizan aquí: no hay una lógica de extracción persistida que reparar, lo que las hace tolerantes a los cambios de diseño, pero también significa que no hay ningún artefacto que inspeccionar, versionar o aprobar. Tampoco se cuentan las cachés internas sin un identificador al que se pueda apuntar, ya que de nuevo no hay nada que inspeccionar, versionar o aprobar.
Más allá de aspectos como que las páginas cambian constantemente, en los pipelines agénticos a menudo necesitas una API sencilla a la que llamar: le das una URL y obtienes datos estructurados a cambio. Pero no siempre encuentras una API de scraper lista para cada dominio que necesitas rastrear con regularidad; y cuando la encuentras, puede que los campos que quieres no estén allí, o que necesites personalizar el esquema según tus propias necesidades. Existen distintos enfoques que abordan estos problemas.
Plataformas de web scraping con IA de compilación única y múltiples llamadas
Si construyes tu propio scraper, tienes que escribir el crawler, configurar los proxies, ejecutar navegadores headless y encargarte tú mismo de las colas, los reintentos y las medidas anti-bot.
La IA ha entrado en el scraping para reducir ese trabajo manual y simplificar la configuración. Está presente en la mayoría de estas herramientas, pero cada proveedor la utiliza de forma diferente y responde a un conjunto distinto de necesidades.
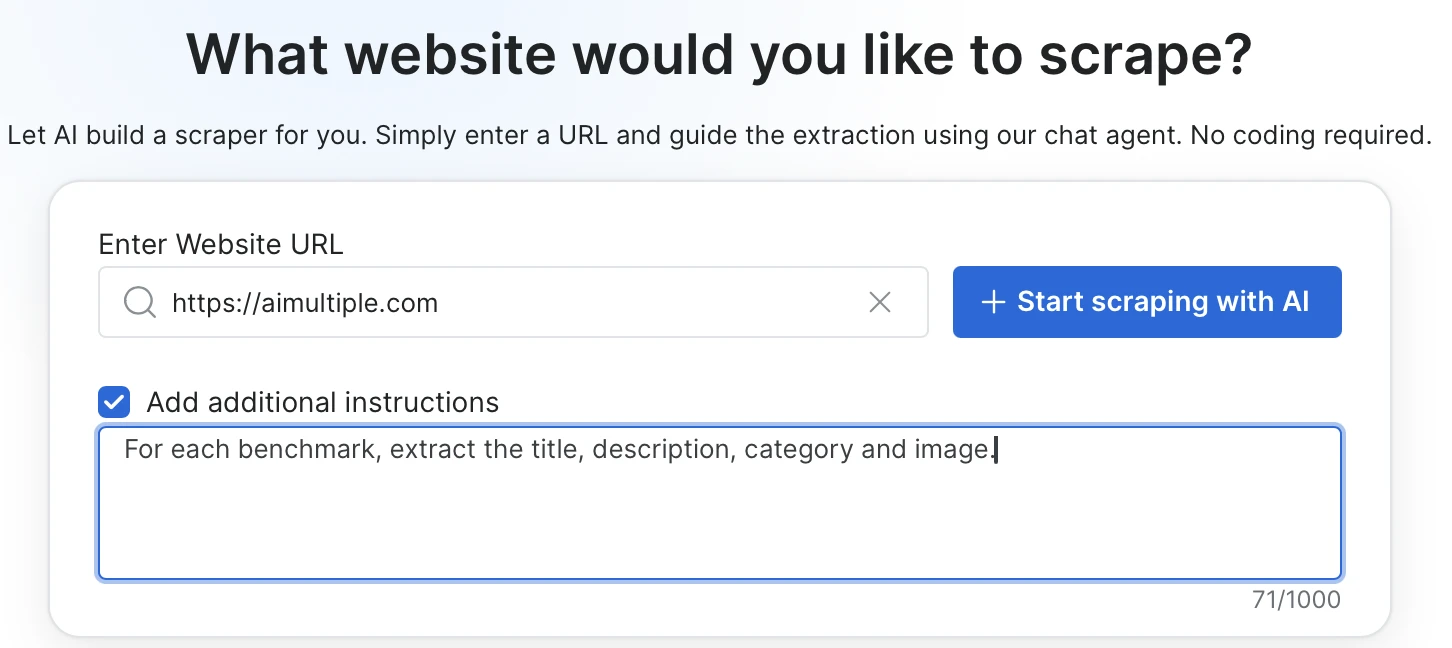
Bright Data Scraper Studio ofrece un enfoque en dos fases: primero creas el scraper para cualquier URL con un prompt y luego lo invocas como una API estable. Lo configuras una vez y, a partir de entonces, solo tienes que pasar URLs.
Describe los campos que quieres extraer en lenguaje natural y, opcionalmente, puedes añadir selectores CSS, acciones obligatorias en la página o el comportamiento de carga de la página.
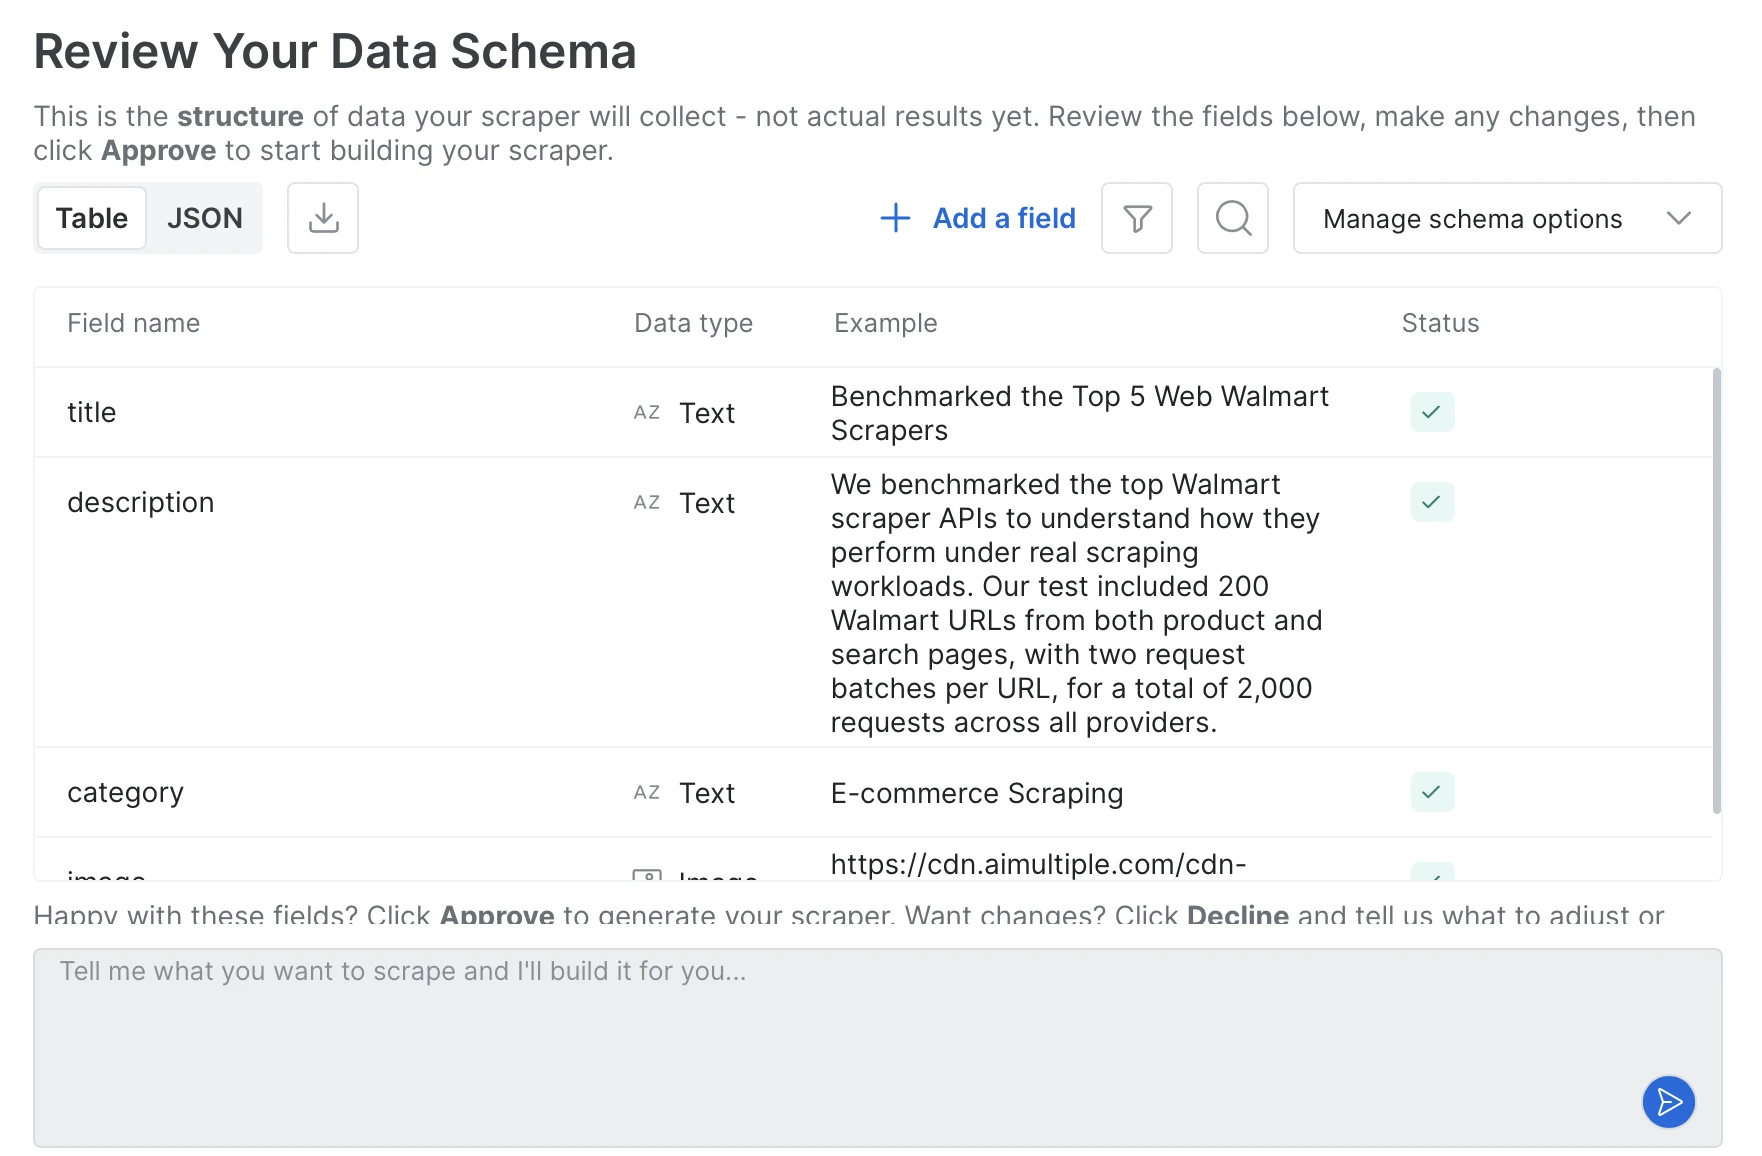
El agente genera el esquema de salida a partir del prompt; lo apruebas añadiendo o eliminando campos o cambiando tipos, y después se escribe el código del scraper.
- Endpoint de compilación única y múltiples llamadas: Una vez que apruebas el esquema, el scraper se registra como un endpoint de larga duración con un identificador fijo. Cada llamada llega al mismo endpoint únicamente con una URL, y el esquema de salida se mantiene igual en todas las llamadas. En nuestras pruebas, crear un scraper dedicado llevó alrededor de 10 minutos de media.
- Dos métodos de creación: puedes chatear con el agente en el navegador o usar la CLI de Bright Data para crear el scraper desde tu terminal con un único comando que recibe una URL y un prompt. Ambos producen el mismo scraper.
- Flujo de trabajo con agentes de codificación: los comandos de terminal se ejecutan sin cambios dentro de Claude Code, Cursor y Codex, de modo que el agente puede crear, ejecutar o autorreparar un scraper sin salir del editor. También puedes fijar el identificador del scraper en el archivo de reglas del agente para que las sesiones futuras lo reutilicen. Los resultados pueden entregarse a través de API, SDK, CLI, webhooks o directamente al almacenamiento en la nube en S3, GCS, Azure u OSS.
- Combinado con scrapers preconstruidos: Bright Data mantiene una biblioteca de scrapers listos para sitios populares como Amazon, LinkedIn y Zillow.
- Scraper guardado con autorreparación: cuando el sitio cambia y el scraper se rompe, describes en lenguaje natural qué falló; la IA genera una corrección y la muestra con una salida de ejemplo, y nada se publica hasta que lo apruebas. Como el identificador del scraper no cambia, todos los activadores, programaciones e integraciones vinculados a él siguen funcionando.
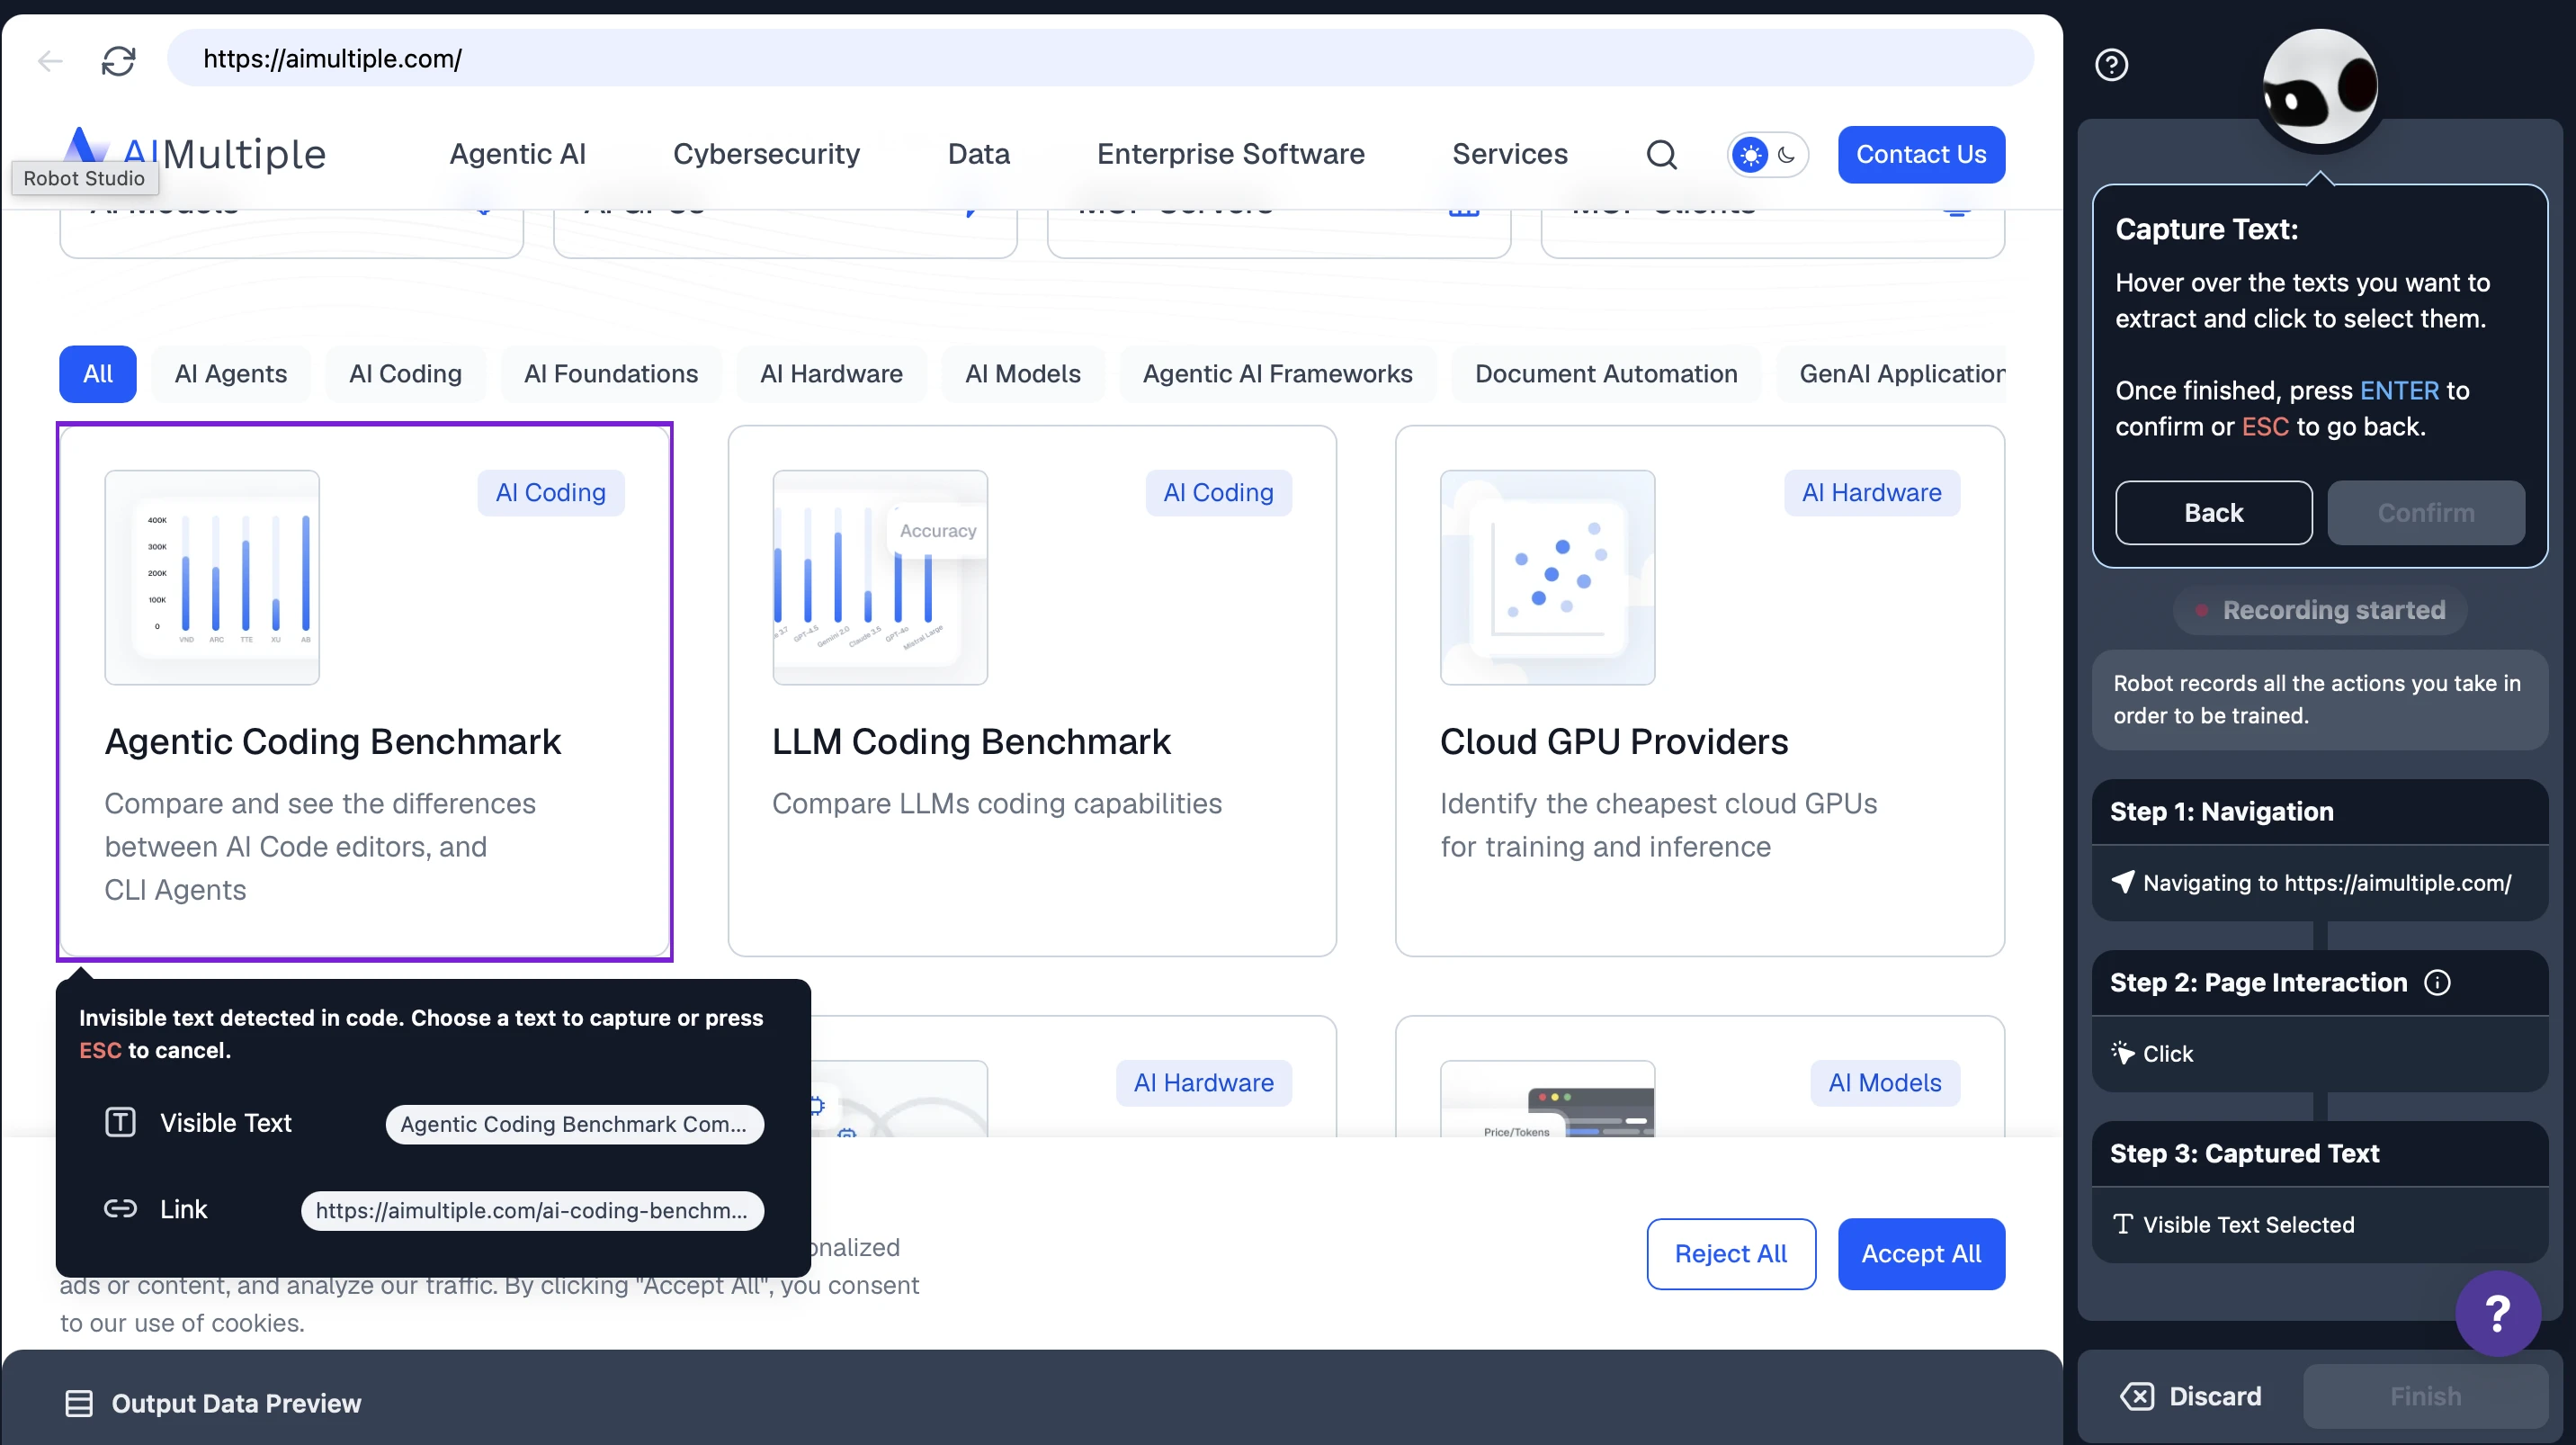
En Browse IA sigues creando el scraper tú mismo, pero la configuración es visual: vas a la página de destino y haces clic para marcar qué campos se deben capturar, y el robot guarda los pasos de navegación y los campos seleccionados como una grabación. Esa grabación se ejecuta una y otra vez; cuando la página cambia, el robot se adapta por sí solo en la mayoría de los casos y, cuando no puede, se vuelve a entrenar.
- Configuración visual con Robot Studio: los scrapers se crean con un flujo de clic → capturar campo → guardar.
- Monitoreo y alertas integrados: programaciones por hora, diarias o semanales + detección de cambios + alertas por correo electrónico y webhook en el mismo producto.
- El esquema se forma a partir de los campos capturados: se añade un paso de captura independiente para cada campo; no hay paso de prompt a esquema.
- Adaptación automática: el motor de Browse IA adapta el código de scraping cuando cambia un sitio, y la mayoría de los robots siguen funcionando sin intervención. Cuando la adaptación no es suficiente, vuelves a entrenar al robot, lo que conserva su historial, sus ejecuciones y sus flujos de trabajo.
Kadoa también crea el scraper a partir de un prompt, pero vincula las URLs de destino cuando se crea el flujo de trabajo, en lugar de aceptarlas en cada llamada. Lo que almacena es código generado, en lugar de un prompt, por lo que hay un artefacto concreto que supervisar y reparar.
- Endpoint de compilación única y múltiples llamadas: un flujo de trabajo guardado obtiene un ID persistente y se le llama con
PUT /v4/workflows/{id}/run. La solicitud solo lleva variables y un límite de filas; el esquema y el código de extracción permanecen del lado de Kadoa. Apuntar el mismo flujo de trabajo a una URL diferente implica actualizar primero sus metadatos, por lo que no es una única llamada con una URL dentro. - Del prompt al esquema tipado: describes los datos en el prompt de configuración y Kadoa propone un esquema que puedes editar en una vista visual o de JSON. Los campos tienen tipos como STRING, NUMBER, MONEY, DATE y LINK, y se pueden marcar como claves.
- Scraper guardado con autorreparación: la reparación se activa con una ejecución fallida, no con una programación. Kadoa regenera el código de extracción y lo valida con los datos extraídos anteriormente, bajo el mismo ID de flujo de trabajo, de modo que las programaciones e integraciones siguen funcionando. No hay un paso de aprobación antes de que la corrección entre en producción. Cuando la recuperación automática falla, se crea un ticket para el equipo de operaciones de Kadoa.
- Flujo de trabajo con agentes de codificación: un servidor MCP alojado con más de 40 herramientas, además de SDKs propios de Node y Python y una CLI (
kadoa create,kadoa run,kadoa export). - Entrega: API, SDK, CLI, MCP y Google Sheets para extracción; S3, GCS, Azure Blob, webhooks, WebSockets, correo electrónico y Slack para envío; Snowflake y Databricks para compartir. Los conectores de almacenamiento en la nube se configuran a través del soporte, no de autoservicio.
APIs de extracción con IA de un solo disparo
Oxylabs IA Studio es un conjunto de cinco aplicaciones de IA independientes bajo un único SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch y AiMap. No se persiste nada en el lado del servidor; cada llamada de scraping ejecuta una obtención nueva más extracción mediante LLM.
- Flujo de AiScraper: generate_schema(prompt=…) llama opcionalmente al LLM para producir un esquema JSON; después, scrape(url, schema) obtiene la página y ejecuta la extracción con LLM. Puedes conservar y reutilizar el esquema por tu cuenta, pero el servidor no registra un scraper de larga duración.
- Cinco aplicaciones, un solo SDK: AiScraper para extracción estructurada de una sola URL, AiCrawler para recorrido de sitios guiado por prompts, BrowserAgent para acciones en la página, AiSearch para búsqueda en lenguaje natural más extracción, y AiMap para mapas filtrados de URLs de un sitio.
- Formatos de salida: markdown (predeterminado), json, csv, toon (un formato optimizado para tokens), screenshot y html (solo con el agente de navegador).
- Esquemas escritos a mano:
generate_schemaes opcional. El parámetroschemaacepta cualquier esquema JSON que escribas, y los propios ejemplos de Oxylabs pasan un Pydantic model escrito a mano. Un esquema es obligatorio para la salida en JSON, CSV y TOON. - Parámetros destacados: render_javascript=”auto” permite que el servicio decida si se necesita renderizado de JS; geo_location acepta un código de país ISO o un nombre para la ubicación del proxy, y max_credits establece un límite de gasto por solicitud.
Apify ofrece un ecosistema abierto para desarrolladores en el que los “Actors”, programas ejecutables de scraping y automatización, se crean y se ejecutan en su plataforma. Puedes escribir tu propio Actor desde cero, empezar a partir de una plantilla ya preparada o usar Actors que otros han publicado en la Apify Store.
- Actor de extracción con IA: Apify también tiene un Actor apify/ai-web-scraper ya preparado que acepta un prompt en lenguaje natural y devuelve JSON estructurado desde cualquier URL. Debes volver a introducir el prompt en cada ejecución, y no se garantiza que la salida JSON sea coherente entre llamadas, un comportamiento habitual en las herramientas guiadas por prompts.
- Solo prompt: la entrada del Actor tiene cinco campos:
startUrls,extractionMode,prompt,maxPagesToVisitymaxCrawlDepth. No hay ningún parámetro para un esquema de salida definido por el usuario. - Crea tu propio actor: si no existe un scraper listo para tu sitio objetivo o ninguno extrae los campos de datos que quieres, escribes tu propio Actor y decides qué campos extraer, dónde se encuentran en la página y cómo gestionar el resto. Cuánto tarda esto depende de tus habilidades de programación y de la complejidad del sitio. Si prefieres no crearlo por tu cuenta, también puedes obtener ayuda de los servicios profesionales de Apify.
- Combinado con scrapers preconstruidos: un marketplace donde los desarrolladores publican sus propios Actors. Los scrapers para sitios populares son en su mayoría publicados y mantenidos por terceros.
- Servicios de la plataforma: los Actors incluyen de serie programación, monitoreo, almacenamiento de datasets, pool de proxies y acceso a API.
- Acceso del agente, no autoría del agente: el servidor MCP de Apify permite que un agente de codificación busque y ejecute Actors, pero no existe un flujo integrado para crear o mantener un Actor desde dentro del agente.
- Responsabilidad del mantenimiento: si creaste el Actor tú mismo, lo reparas cuando el sitio cambia. Si usas uno de la Store, esperas a que el propietario del Actor publique la corrección según su propio calendario.
Firecrawl convierte una URL más un prompt o un esquema JSON en JSON en una única llamada síncrona. Cada solicitud ejecuta el pipeline de extracción en el momento en que se realiza la llamada.
- Prompt o esquema: un esquema fija los nombres y tipos de los campos antes de la llamada, de modo que la respuesta solo contiene los campos que indicaste. Un prompt deja la estructura en manos del model, lo que es más rápido de escribir, pero puede variar entre llamadas.
- Formatos de tipo de página:
product,menu,branding,audioyvideodevuelven una estructura fija establecida por Firecrawl.productcubre título, precio, disponibilidad, variantes y precio de venta. No aceptan parámetros y se ejecutan sin un LLM. deterministicJson: acepta un esquema y cachea un extractor generado por sitio, de modo que los scrapes repetidos se saltan el LLM. No se puede combinar con el formatojson.- Ejecución por solicitud: cada llamada lleva su propio prompt o esquema y se ejecuta en el momento de la solicitud, por lo que la salida refleja la página tal como se ve en ese instante y no hay nada que registrar por adelantado.
- Soporte para agentes de codificación: servidor MCP y CLI oficiales, con guías de inicio rápido para Claude Code, Cursor, Codex CLI y Gemini CLI, además de un plugin oficial de Claude.
- Agente: Firecrawl también ofrece un producto Agent en el que la URL es opcional. Describes lo que quieres y el agente navega por la web para encontrarlo.
ScrapingBee usa el mismo modelo de una sola llamada y sin estado que Firecrawl. La diferencia está en cómo describes lo que quieres.
- Tres modos de extracción: ai_query para un solo campo en lenguaje natural (devuelve un string), ai_extract_rules para un esquema JSON donde cada campo tiene su propia descripción, y una forma avanzada del mismo con tipos, enums y salida anidada.
- ai_selector: pasa un selector CSS para centrar el LLM en una parte concreta de la página. Es más rápido y preciso que dejar que lea todo el DOM.
- Scraping clásico en la misma llamada: render_js para sitios con mucho JS, screenshot, extract_rules para extracción CSS/XPath sin IA y json_response para obtener HTML, cookies, XHRs e iframes en un solo paquete.
¿Cómo elegir la herramienta adecuada para tu pipeline?
En la práctica, la herramienta adecuada depende menos de las listas de funciones y más de lo que tu pipeline hace con los datos a lo largo del tiempo. Vale la pena tener en cuenta algunos patrones:
Scraping puntual u ocasional
Si solo necesitas datos de una URL una vez y te parece bien describirlos o pasar un esquema cada vez, las APIs de extracción con IA de un solo disparo son la vía más rápida. No hay que crear ningún scraper ni registrar ningún esquema.
Scraping repetido en un pipeline
Si ejecutas el mismo scraper una y otra vez y necesitas un endpoint estable que devuelva el mismo esquema cada vez, o si necesitas personalizar los campos de datos para las URLs que quieres, una plataforma de compilación única y múltiples llamadas encaja mejor. Tu pipeline simplemente le pasa URLs y la forma de la salida se mantiene predecible.
Cuánto se tarda en llegar hasta ahí
El tiempo de creación varía según el enfoque. Escribir un scraper o actor desde cero suele llevar de días a semanas, ya que el crawler, la configuración de proxies y los reintentos dependen de ti. Las plataformas basadas en prompts generan el esquema y el código en minutos. Las herramientas basadas en grabación también están listas en minutos, con una configuración de apuntar y hacer clic en lugar de un prompt. Las APIs de extracción con IA de un solo disparo se saltan el paso de creación; la primera respuesta llega en una sola llamada HTTP.
Sitio ya cubierto por un scraper listo
Usar un scraper listo para sitios populares suele ser más rápido que crear el tuyo, pero quién lo mantiene en funcionamiento depende de su procedencia. Una biblioteca mantenida por el proveedor la actualiza el proveedor cuando cambia el sitio.
Sitio no cubierto por nada listo
Entonces la pregunta es quién repara las cosas cuando cambian los diseños. Crear el tuyo implica que el mantenimiento recae sobre ti. Una herramienta basada en grabación implica volver a entrenar al robot cuando algo se rompe. La autorreparación con IA sobre código de tu propiedad se sitúa en un punto intermedio: la corrección se propone sobre tu código existente y la apruebas antes de que entre en producción.
Crear con agentes de codificación
Si tu flujo de trabajo pasa por Claude Code, Cursor o Codex, importa si la herramienta expone una CLI o una integración MCP que el agente pueda controlar de principio a fin, o si el agente solo puede llamar a una API HTTP simple.
 Añadir como fuente preferida
Metodología del benchmark de web scraping con IA
Para crear el dataset, seleccionamos los 10 principales sitios de moda y ropa del mundo de Semrush. Para cada sitio, se eligió una única página de producto y se registró manualmente la verdad de referencia (precio y moneda) visitando la página directamente.
Se probaron cinco herramientas de scraping con IA: la API Scrape de Firecrawl, Scraper Studio de Bright Data, IA Extract de ScrapingBee, el actor IA Web Scraper de Apify y IA Scraper de Oxylabs IA Studio. Cada proveedor recibió el mismo prompt de una sola frase: “Extrae el precio y la moneda del producto y devuelve json.”
Cada URL se envió una sola vez a cada proveedor. No hubo reintentos, alternativas, aplicación del esquema ni pasos de posprocesamiento. La respuesta bruta se almacenó tal cual, exactamente como la devolvió el proveedor.
Para la validación, se analizó la salida JSON bruta con una expresión regular en busca del precio y la moneda esperados. La coincidencia de precios tolera variaciones de formato habituales como 26.49 y 26,49, 2.140 y 2140, y pequeñas diferencias de precisión decimal. La coincidencia de monedas acepta el código ISO (USD) o el símbolo ($).
Se registraron dos métricas. La tasa de éxito se calcula por URL como una comprobación binaria de si el precio se devolvió correctamente y otra para la moneda; después se promedian las dos para producir una única puntuación de éxito por URL, y las puntuaciones se promedian entre las diez URLs para cada proveedor. El tiempo de finalización de extremo a extremo es la duración de reloj desde la solicitud hasta la respuesta, promediada entre las diez URLs. En el caso de Bright Data, se excluye la compilación única del colector.
Cómo seleccionamos estas herramientas
Incluimos herramientas que usan IA, como LLMs, NLP o vision models, para interpretar la estructura de la página sin reglas codificadas de forma rígida o para extraer datos a partir de un prompt. Excluimos las bibliotecas de propósito general sin IA integrada, como Scrapy y Playwright, aunque ambas se usan ampliamente para scraping.
En las secciones anteriores, las herramientas están agrupadas por cómo funcionan y no por quién las usa. La línea divisoria es dónde se ejecuta el model: las plataformas de compilación única resuelven la estructura de la página una vez y almacenan el resultado como un scraper al que llamas por ID, mientras que las APIs de un solo disparo la resuelven de nuevo en cada solicitud. Esa distinción determina el coste, la coherencia de la salida y quién repara las cosas cuando cambia un sitio, por lo que separa las herramientas de forma más útil que una división entre sin código y desarrolladores.
Preguntas frecuentes
Sí. Las bibliotecas de código abierto como Crawl4AI, Skyvern y Browser Use son gratis para autoalojar, y la mayoría de las herramientas comerciales, incluidas Browse IA, Firecrawl y Thunderbit, ofrecen un plan gratis con límites de uso.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Las mejores herramientas de web scraping con IA evaluadas}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Recuperado el 25 de agosto de 2026}
}Resultados y marcas de tiempo de 56 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 2 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
5 actualizacionesAñadido un apartado de benchmark que compara herramientas de scraping web con IA en los principales sitios de comercio electrónico.
Reemplazó la lista de herramientas con entradas nombradas para Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern y otras, y añadió una sección de preguntas frecuentes.
Se reemplazó la introducción a las herramientas de web scraping de IA con una descripción de los agentes de IA autónomos, el scraping basado en visión (VLM) y los scrapers autorreparables.









Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.